

Meta Muse Spark 1.3 ist ein wirklich starkes Modell für Coding und langen Kontext, das am 2026-09-02 erschien, und es verdient seine Schlagzeile: ein Artificial Analysis Intelligence Index von 62 für die oberste Stufe, Platz 6 von 636 Modellen. Aber drei Dinge dämpfen den Hype. Erstens: Die Stufe mit 62 Punkten ist max, und max-Reasoning war zum Start noch hinter Sicherheitstests gesperrt, die Stufe, die Sie tatsächlich nutzen können, ist xhigh. Zweitens: Metas Rahmung "verbesserte Agentenfähigkeiten" ist in Wahrheit eine Geschichte verbesserten Codings: Opus 5 max schlägt es in Metas eigenem Diagramm weiterhin bei vier von sechs Agenten-Zeilen. Drittens: Es ist wortreich und verbraucht etwa 3x so viele Tokens wie Muse Spark 1.2, sodass Ihre echte Rechnung über dem Listenpreis liegt.
Der Preis ist der interessanteste Teil: Ein Standard-Endpunkt für $1.25 / $4.25 pro Million (Daten bleiben privat) steht neben einem Contributor-Endpunkt für etwa $0.10 / $0.20 (Meta trainiert mit Ihrem Traffic). Wenn Sie das für den Kundensupport prüfen, bedenken Sie: Ein Modell ist Infrastruktur, kein Kollege. eesel stellt Ihnen einen einsatzbereiten KI-Support-Agenten zur Verfügung, der auf Modellen wie diesem läuft, sich in Ihren Helpdesk einklinkt und an Ihren früheren Tickets simuliert, bevor er jemandem antwortet.
Was "Test" hier bedeutet und was ich nicht testen konnte
Ich baue beruflich Integrationen und APIs. Wenn ich einen Modellstart lese, interessiert mich weniger die Pressemitteilung als vielmehr, was das Ding tut, sobald man es anbindet. Das ist die Brille für diesen Test. Ich habe Metas Research-Blog und die Evaluationsmethodik genau gelesen, die Zahlen von Artificial Analysis gezogen und den gesamten Hacker-News-Launch-Thread gelesen, in dem an einem Tag 261 Kommentare zusammenkamen.
Was ich nicht konnte: max von Anfang bis Ende laufen lassen, und das ist keine Abkürzung meinerseits. Metas eigener Blog sagt, dass die bisher verfügbaren Reasoning-Modi heute erscheinen, "with max reasoning coming shortly after we finish additional safety testing." Der Modus, der die 62 erreicht, ist also nicht der Modus, den die meisten bereits aufrufen können. Wenn ich über Live-Verhalten spreche, meine ich xhigh, die tatsächlich verfügbare Stufe, die eine 61 erreicht. Behalten Sie diese Lücke für den Rest des Artikels im Kopf, denn Metas Marketing tut es nicht.
Das eine Diagramm, das Meta Sie lesen lassen will
Jeder Muse-Spark-1.3-Test wird mit dieser Übersicht beginnen. Ich zeige sie also zuerst und sage dann, was sie nicht sagt.
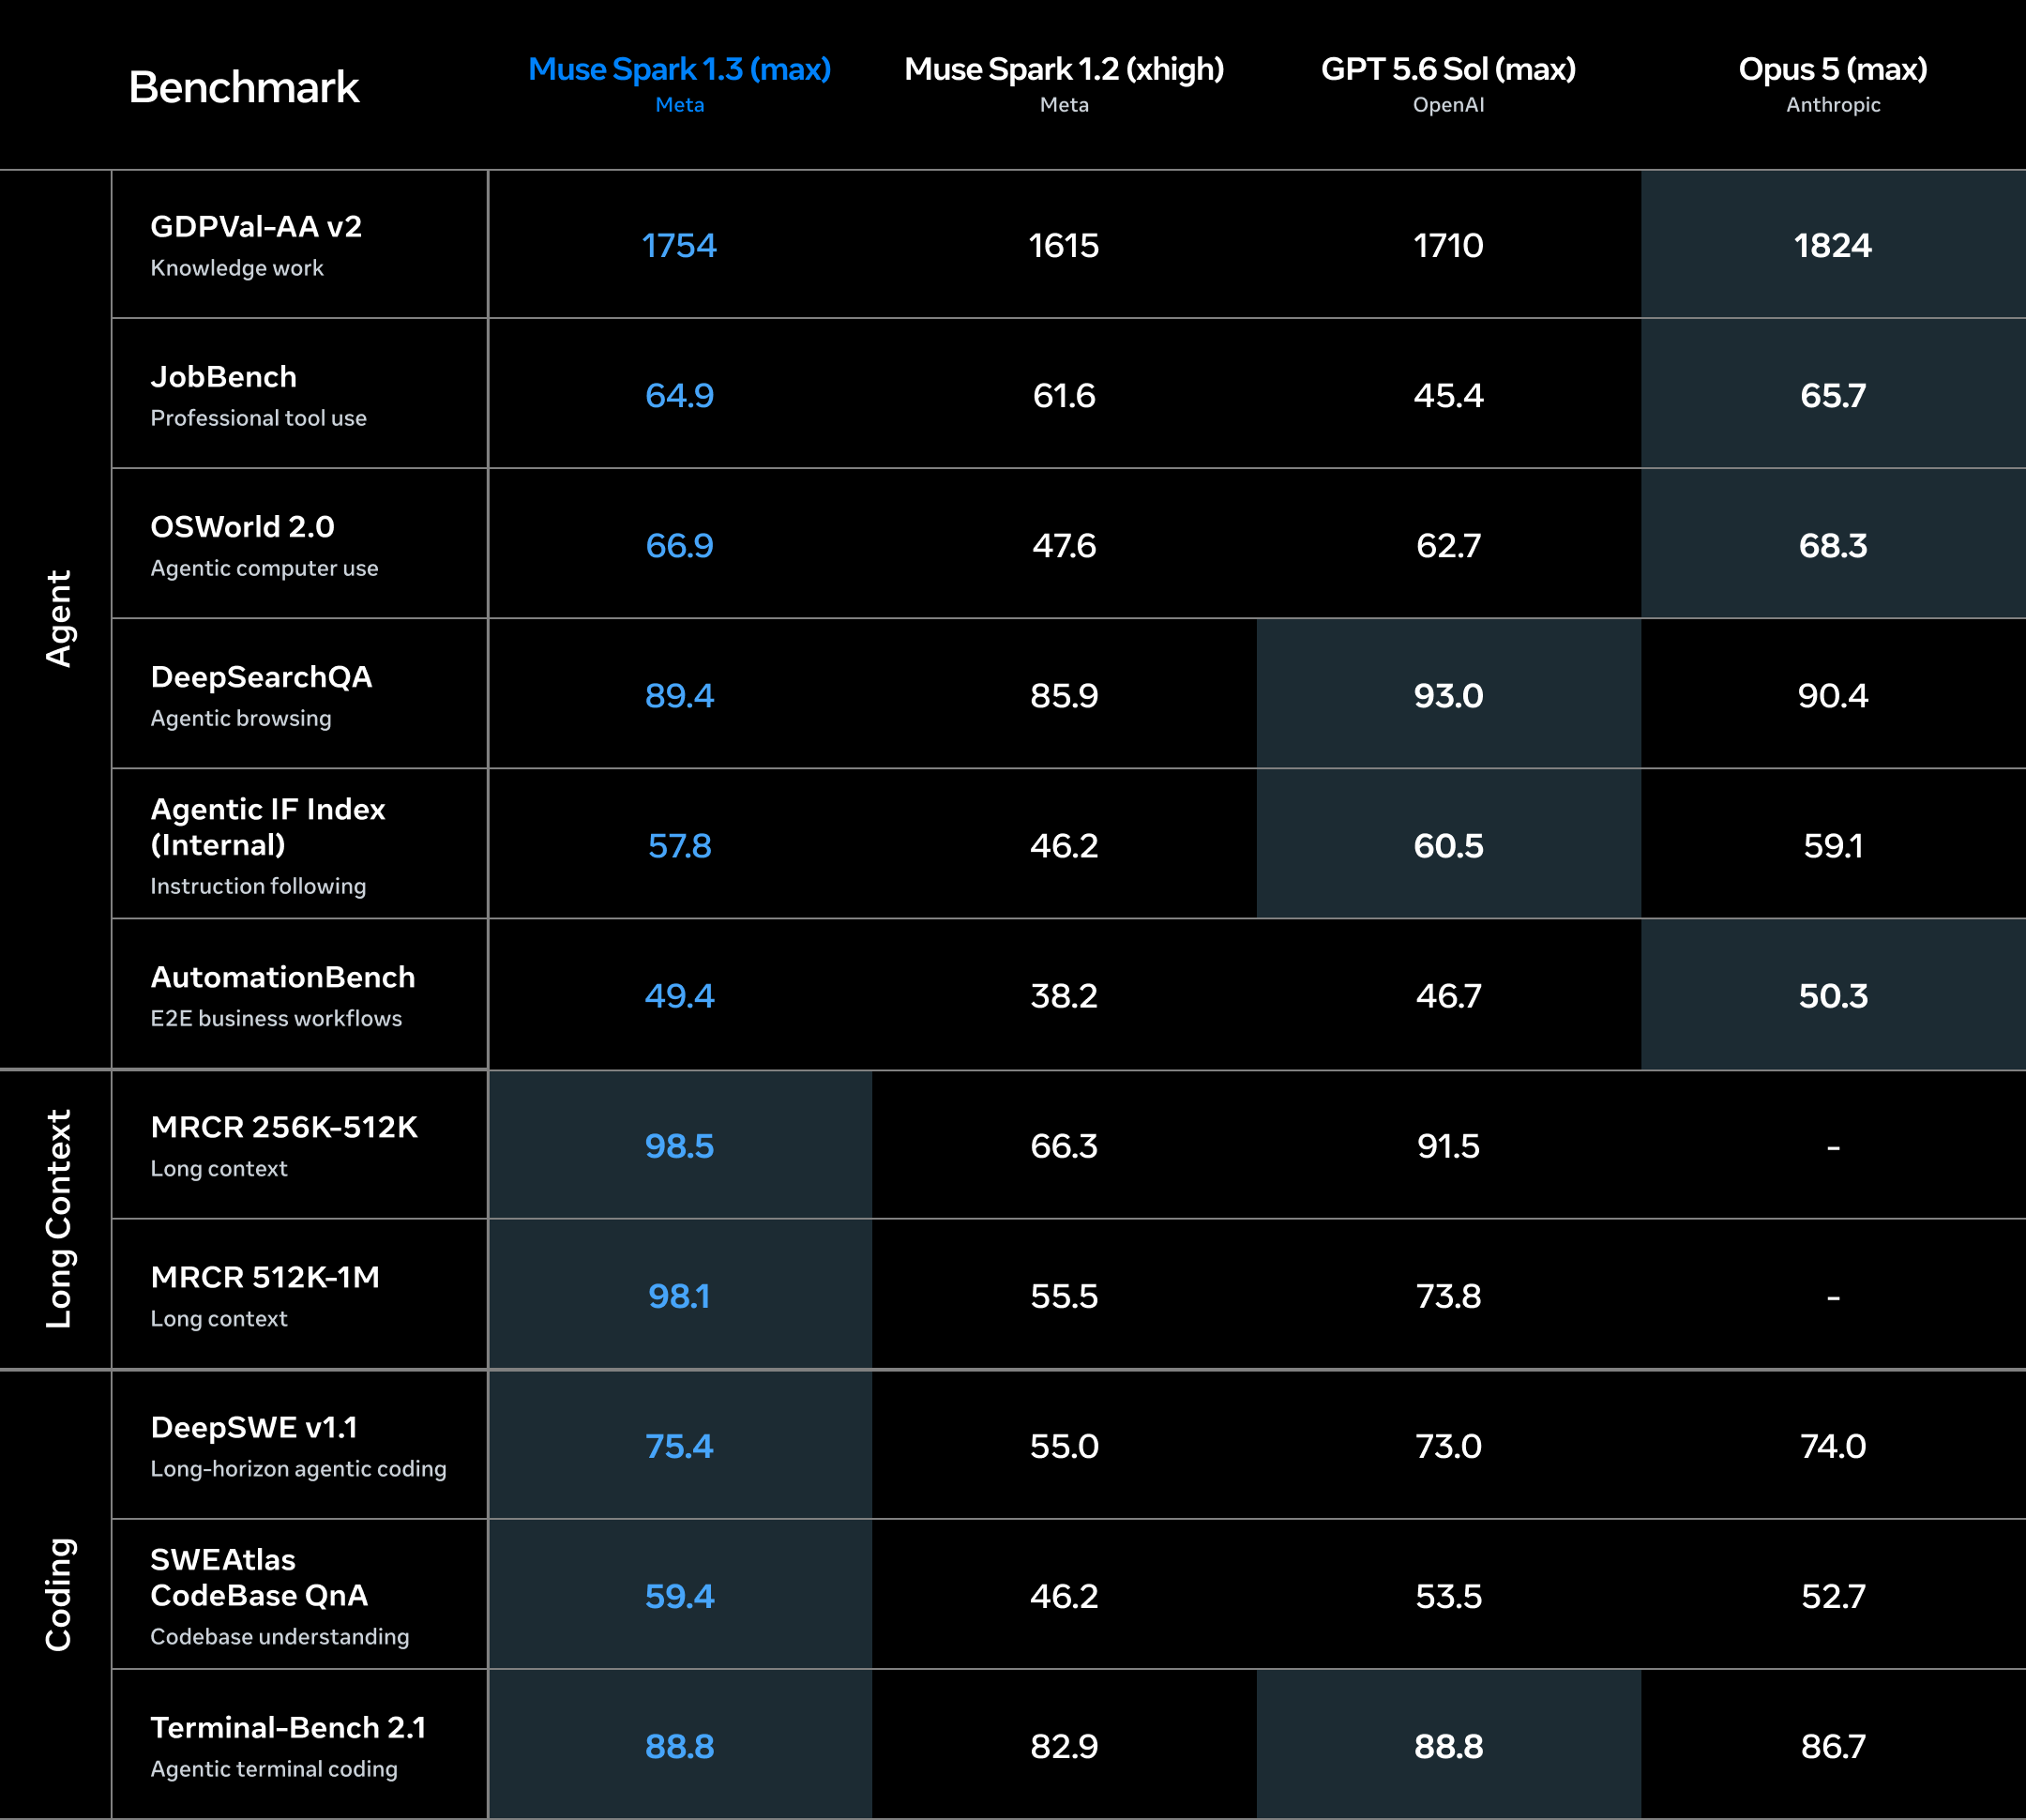
Die vier Spalten sind Muse Spark 1.3, Muse Spark 1.2, GPT-5.6 Sol und Opus 5, über die Bereiche Agenten, Coding, Befolgen von Anweisungen und langer Kontext. Es liest sich wie ein klarer Sieg für 1.3. Hier ist der Haken: Die 1.3-Spalte ist max, und die 1.2-Spalte, mit der verglichen wird, ist xhigh. Das ist kein Vergleich unter gleichen Bedingungen. Ein Teil des Sprungs ist ein Wechsel der Reasoning-Stufe, kein Wechsel der Modellgeneration. Ein HN-Kommentator, sunaookami, wies darauf hin, dass die Übersicht "only shows max reasoning", obwohl max genau der gesperrte Modus ist, und nannte das unehrlich. Man zeigt Ihnen die bestmögliche Version von 1.3 gegen eine mittlere Version von 1.2.
Das macht das Modell nicht schlecht. Es macht das Diagramm zu einem Marketing-Artefakt, was Launch-Diagramme immer sind. Lesen Sie es für die Richtung, nicht für die genaue Größe des Abstands.
Wo es wirklich gewinnt: langer Kontext und Coding
Ohne die Rahmung bleiben die echten Siege echt, und sie konzentrieren sich auf zwei Bereiche.
Beim langen Kontext ist 1.3 exzellent. Im MRCR-Recall-Test von Meta erreicht es 98.5 im Band 256K-512K und 98.1 bei 512K-1M, deutlich vor den danebenstehenden 1.2-Werten. Wenn Ihre Aufgabe lautet "lies diese riesige Codebasis oder Dokumentensammlung und denke über alles nach", ist dieser Abruf ein legitimer Grund, genauer hinzusehen. Das 1M-Token-Kontextfenster ist hier nicht nur Marketing-Spielraum: Die Recall-Werte zeigen, dass es das Fenster tatsächlich nutzt.
Beim Coding sind die Verbesserungen gegenüber 1.2 der glaubwürdigste Teil von Metas Blog, weil sie konkret sind. Metas Ingenieure berichten von etwa 20% weniger Tool-Aufrufen und 25% weniger Tokens bei denselben Coding-Aufgaben, mit einem saubereren, weniger geschwätzigen Stil. Bei DeepSWE v1.1 erreicht es 75.4 gegenüber 55.0 bei 1.2, und bei Terminal-Bench 2.1 gleichauf mit GPT-5.6 Sol bei 88.8. Ein Community-Tester, majerep, nannte die Vorgängerversion "the best free model available on OpenCode" für präzise, mittelgroße Aufgaben, und die Coding-Zahlen sagen, dass 1.3 diesen Vorsprung ausbaut. Wenn ich nach einem günstigen Modell für eine agentische Coding-Schleife greifen würde, stünde dieses neben Kimi K3 und DeepSeek V4 Flash auf der Auswahlliste.
Wo die "agentische" Geschichte eigentlich eine Coding-Geschichte ist
Das ist die Erkenntnis, die ich nicht erwartet hatte. Metas Schlagzeile lautet "improved performance across agentic and coding tasks", und die agentische Hälfte davon hält gegenüber dem Modell, das Meta selbst zum Vergleich gewählt hat, nicht stand.
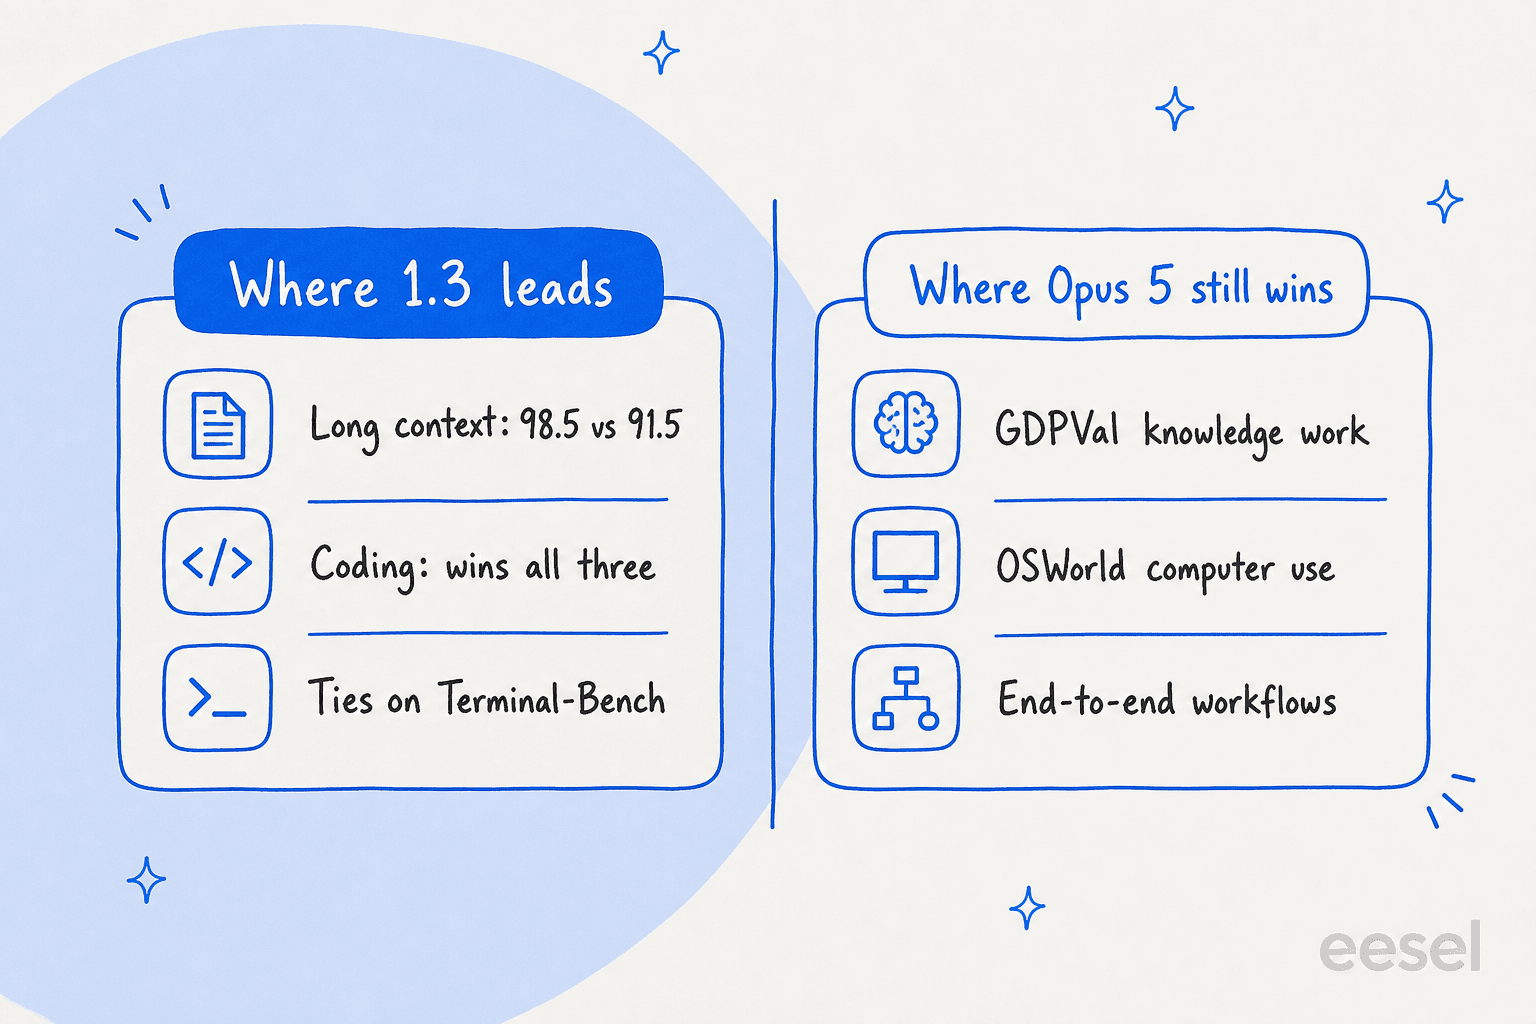
Gehen Sie die sechs Agenten-Zeilen in Metas Übersicht durch. Opus 5 max gewinnt GDPVal-AA v2 (1824 zu 1754), JobBench (65.7 zu 64.9), OSWorld 2.0 (68.3 zu 66.9) und AutomationBench (50.3 zu 49.4). GPT-5.6 Sol holt DeepSearchQA (93.0) und den Agentic Instruction-Following Index (60.5). Das heißt: Muse Spark 1.3 verliert jede Agenten-Zeile an den einen oder anderen Rivalen. Dominant ist es bei Coding und langem Kontext, und das ist eine andere Aussage als "bester Agent". Die ehrliche Lesart: "verbesserte Agentenfähigkeiten" heißt größtenteils "verbessertes Coding", und das Coding ist tatsächlich verbessert.
Ich will fair sein, denn das ist weiterhin ein Top-Ten-Modell, und die Abstände bei den Agenten sind klein. Aber wenn Sie ein Modell gezielt für mehrstufigen Tool-Einsatz und Computersteuerung wählen, sagt Ihnen die von Meta veröffentlichte Übersicht leise, dass Opus 5 für diese Aufgabe die sicherere Wahl ist. Bei Support-Automatisierung, wo eine falsche "agentische" Aktion eine falsche Antwort an einen echten Kunden bedeutet, zählt diese Unterscheidung enorm, und deshalb simulieren wir jeden Agenten an früheren Tickets, bevor er live geht, statt einer Benchmark-Zeile zu vertrauen.
Die Wortreichtums-Steuer, die niemand in die Übersicht schreibt
Geschwindigkeit und Preis sehen großartig aus, bis man die Tokens zählt. Um den Artificial Analysis Intelligence Index abzuschließen, gab Muse Spark 1.3 120 Millionen Output-Tokens aus, gegenüber einem Feldmedian von 72 Millionen. Das ergibt Platz 139 von 636 bei der Wortreichheit, es ist also gesprächiger als der Großteil des Feldes.
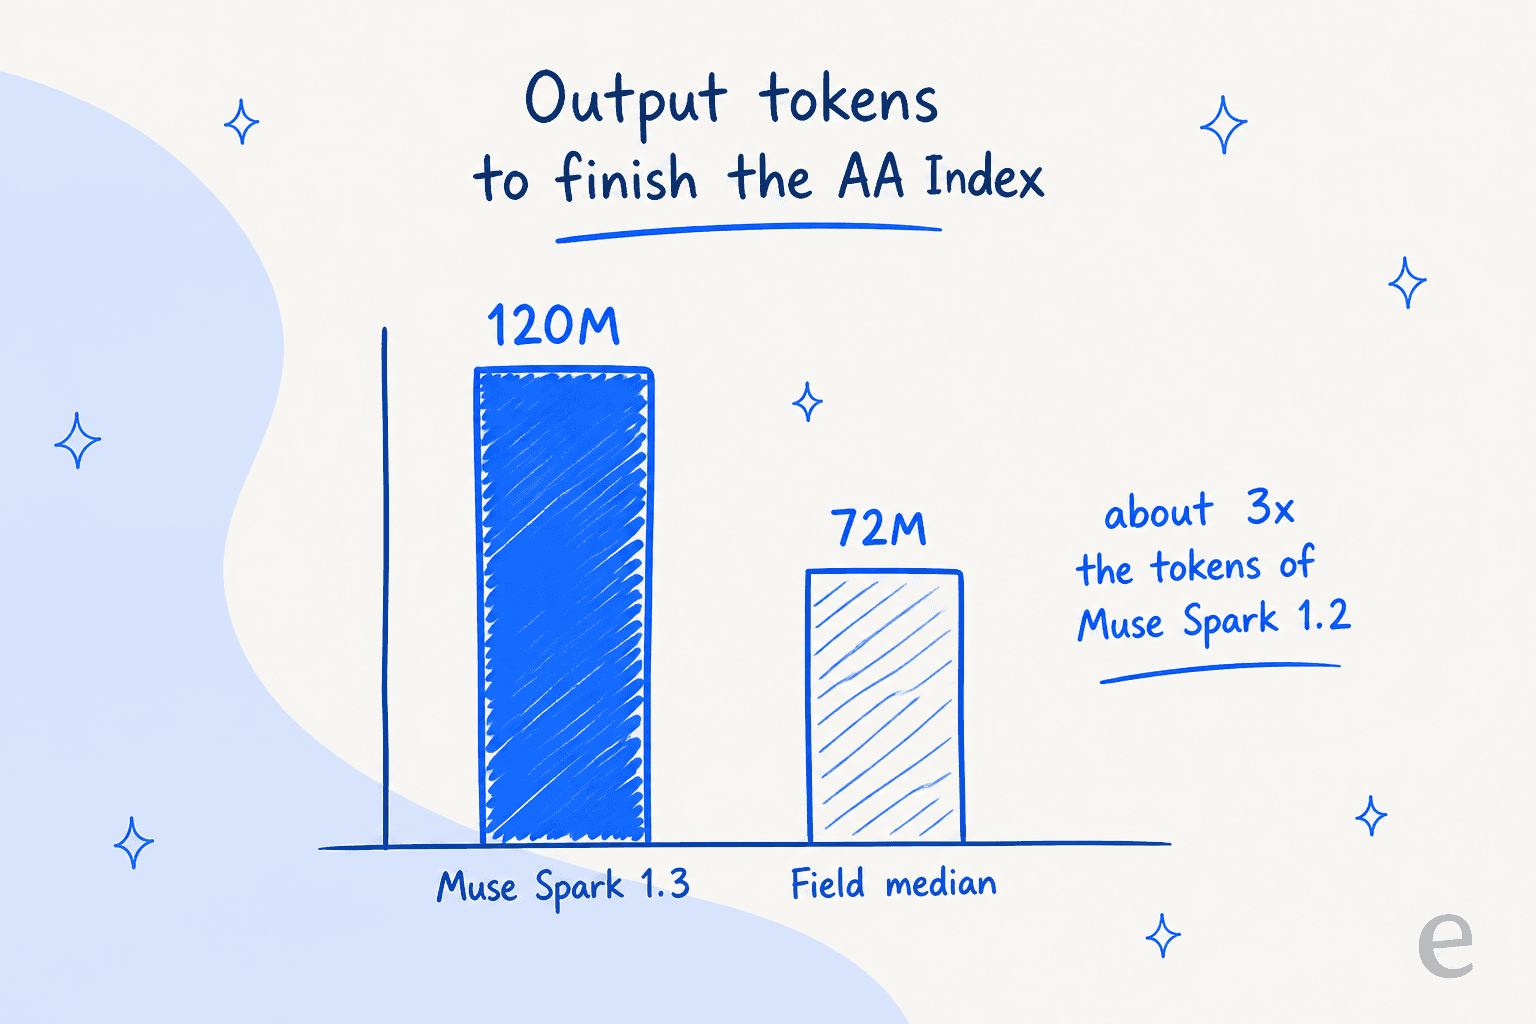
Die Hacker-News-Community, die ihren üblichen SVG-Stresstest "Pelikan auf einem Fahrrad" laufen ließ, kam unabhängig auf etwa 3x den Token-Verbrauch von 1.2. Da Sie pro Output-Token zahlen, ist Wortreichheit ein direkter Kostenmultiplikator. Ein Output-Preis von $4.25 pro Million, der dreimal so viele Tokens erzeugt, ist in der Praxis kein $4.25-Modell. Diese Zahl würde ich neben die Preistabelle legen, bevor ich irgendetwas unterschreibe, und genau diese Art versteckter Gesamtkosten verbirgt ein roher Token-Zähler, ein Pauschalpreis pro Lösung dagegen nicht.
Der Preis sind zwei Preise, und die Lücke ist die ganze Geschichte
Die Preisgestaltung von Muse Spark 1.3 ist das meistdiskutierte Thema, und zu Recht, denn es sind eigentlich zwei Preise mit einer Daten-Maut dazwischen.
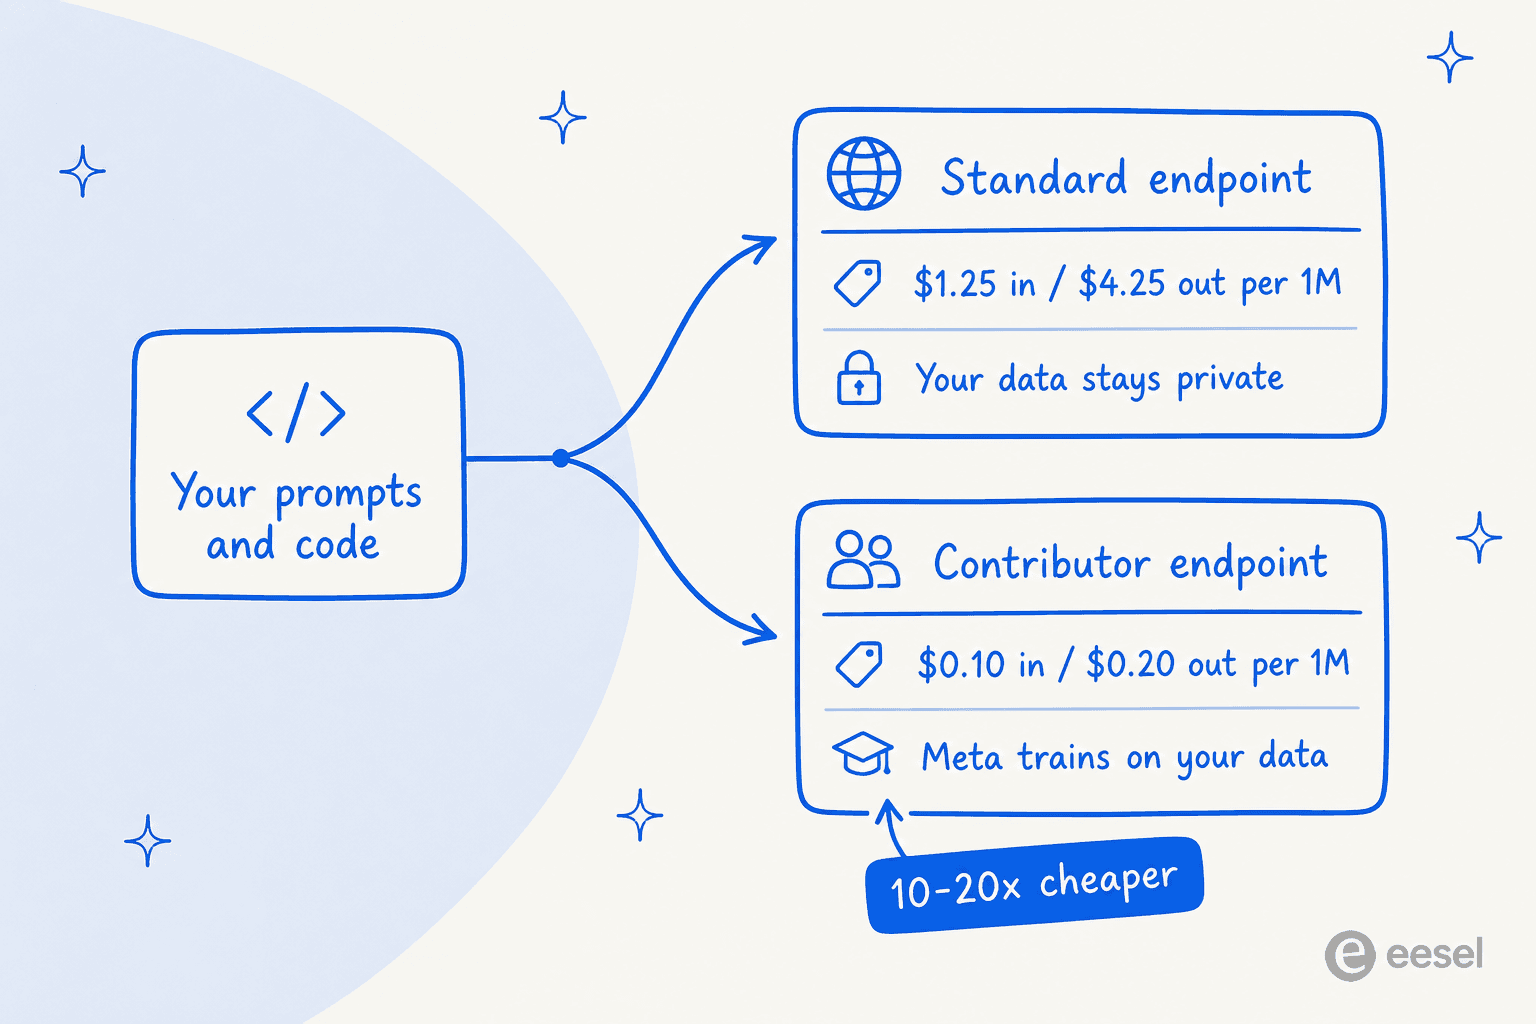
| Endpunkt | Input / 1M | Output / 1M | Meta trainiert mit Ihren Daten? |
|---|---|---|---|
| Standard (xhigh) | $1.25 | $4.25 | Nein |
| Contributor | ~$0.10 | ~$0.20 | Ja |
Der Standardpreis ist moderat gegenüber einem Input-Median von $1.75, und Artificial Analysis maß $0.55 pro Index-Aufgabe. Der Contributor-Endpunkt ist 10-20x günstiger, weil Sie Meta mit Daten statt mit Dollar bezahlen. Die Deutung der Community, warum es diese Aufteilung gibt, ist schärfer als Metas eigene Rahmung:
"It's not that Meta really wants your data and they're willing to pay top dollar for it. It's that companies really don't want Meta to have their data and they're willing to pay top dollar for that."

Das ist alles in zwei Sätzen. Der Aufpreis gilt nicht einem besseren Modell, sondern dem Preis dafür, Meta aus Ihrem Traffic herauszuhalten. Für ein Hobbyprojekt ist das egal. Für alles, was personenbezogene Daten von Kunden berührt, ist der "günstige" Endpunkt keine echte Option, sodass die Zahl, mit der Sie planen sollten, der Standardpreis $1.25 / $4.25 ist, mal dem oben genannten Wortreichtums-Multiplikator.
Was die Community tatsächlich denkt
Die Stimmung am Starttag war wirklich gemischt, und die Mischung ist aufschlussreich. Die Optimisten mögen das Verhältnis von Preis zu Intelligenz. Wie HDBaseT anmerkte, ist der Contributor-Endpunkt "by far the cheapest, significantly cheaper per M than ChatGPT Luna, significantly smarter than Luna too." Die Skeptiker waren von der Leistung nicht überzeugt und sagten über die Vorgängerversion:
"Used Muse Spark 1.2 and was not impressed at all. Fast and cheap but even GPT 5.6 Terra felt much more capable."
Und mromanuk beschrieb, wie er mit 1.2 an einer echten Web-App scheiterte und zu Claude, Kimi K3 oder DeepSeek V4 zurückging, in der Hoffnung, dass 1.3 die Latte reißt. Der rote Faden: Schnell und günstig ist echt, Spitzenleistung ist umstritten, und das Werkzeug, mit dem Sie es steuern, spielt eine Rolle. Mehrere Kommentatoren, darunter meric_, betonten, dass man es in Metas eigenem Muse-Code-Harness laufen lassen sollte, mit dem es gemeinsam trainiert wurde, sonst lasse man Effizienz liegen.
Wer es einsetzen sollte und wer verzichten sollte
Ich werde konkret, denn ein Test, der mit "kommt drauf an" endet, hat Ihre Zeit verschwendet.
- Einsetzen, wenn Ihre Arbeit Coding oder Reasoning über langen Kontext ist, Sie in Muse Code arbeiten können und Ihre Daten nicht sensibel sind, sodass der Contributor-Endpunkt infrage kommt. An dieser Schnittstelle ist es eine starke, günstige Wahl.
- In Betracht ziehen für kostensensible Coding-Agenten, bei denen Sie sonst zu Kimi K3 oder DeepSeek V4 Flash greifen würden. Planen Sie die Wortreichheit ins Budget ein.
- Vorerst verzichten, wenn Sie erstklassigen agentischen Tool-Einsatz brauchen (die Übersicht deutet auf Opus 5), wenn Sie
maxheute brauchen (noch gesperrt) oder wenn Sie regulierte Daten verarbeiten und den Standardaufpreis nicht zahlen können. - Auf das rohe Modell ganz verzichten, wenn Sie eigentlich Kundensupport-Automatisierung wollen. Das ist ein anderes Produkt, und ich erkläre als Nächstes, warum.
Ein Modell ist kein Kollege: was das für ein Support-Team bedeutet
Hier ist die Falle, in die Support-Leiter jedes Mal tappen, wenn ein Modell wie dieses im Trend liegt. Sie lesen "Top-Ten-Agentenmodell, spottbillig" und denken, sie könnten es auf ihren Posteingang richten. Ein rohes Modell ist Infrastruktur, wie eine Datenbank oder eine Zahlungs-API. Es ist mächtig und generisch. Es kennt Ihre Erstattungsrichtlinie nicht, ist nicht mit Ihrem Helpdesk verbunden, hat keine Erinnerung an die Tickets der letzten Woche und hat keine eingebaute Bremse, bevor es eine selbstsichere falsche Antwort an einen zahlenden Kunden schickt. Meta sagt sogar, 1.3 sei besser darin, "confirming before consequential actions", was ein Eingeständnis ist, dass ein rohes Modell diese Schutzvorrichtung nachgerüstet bekommen muss.
Genau diese Lücke zwischen einem Modell und einem arbeitsfähigen Teammitglied schließt eesel. eesel ist eine Plattform für KI-Teammitglieder, und Sie stellen einsatzbereite Teammitglieder für bestimmte Aufgaben ein. Das aktuelle Angebot besteht aus einem KI-Support-Agenten und einem KI-Blog-Autor. Der Support-Agent kommt schon mit dem Wissen, wie der Job geht: Er trainiert mit Ihrer Wissensdatenbank und früheren Tickets, steigt in Ihre bestehende Warteschlange ein, entwirft Antworten oder löst automatisch und eskaliert sauber, wenn es nötig ist. Das Modell darunter ist eine austauschbare Komponente; ein Frontier-Modell wie Muse Spark 1.3 ist genau die Art von Motor, auf dem er laufen kann, aber der Wert liegt in allem, was drumherum gebaut ist.
Der Teil, der direkt zu einem Coding-Modell-Start wie diesem passt, ist das eesel CLI. Wenn Sie Muse Code mögen, weil Sie einen Agenten vom Terminal aus steuern können, verstehen Sie, warum das wichtig ist. Das CLI ist ein agentenfreundlicher Weg, dasselbe eesel-Teammitglied und denselben Workspace zu bedienen, die im Dashboard leben: Ein Mensch kann es von Hand im Terminal ausführen, Skripte können es in der CI automatisieren, und Coding-Agenten wie Claude Code, Codex und Cursor können es direkt steuern. Es ist dasselbe Teammitglied, kein abgespecktes separates Produkt, sodass Sie Quellen verwalten, Läufe auslösen und Aktivitäten abrufen können, ohne sich durch eine Oberfläche zu klicken. Das ist der Unterschied zwischen "hier ist ein Modell-Schlüssel, viel Glück" und "hier ist ein Kollege, den Sie auch skripten können".
eesel statt eines rohen Modell-Schlüssels ausprobieren
Wenn Sie zu diesem Test gekommen sind, weil Sie überlegen, Support-Automatisierung auf einem günstigen Frontier-Modell aufzubauen, lautet die ehrliche Antwort: Das Modell ist der einfache Teil und Ihr geringstes Problem. eesel gibt Ihnen den KI-Support-Agenten, der bereits für die Aufgabe vorbereitet ist: Er läuft auf Frontier-Modellen wie diesem, verbindet sich mit Zendesk, Freshdesk und dem Rest Ihres Stacks und lässt Sie, und das senkt das Risiko wirklich, ihn an Tausenden Ihrer früheren Tickets simulieren, sodass Sie seine echte Lösungsquote sehen, bevor er je einem Kunden antwortet.
Dieser Simulationsschritt ist die Lektion, die wir nach Jahren mit KI in Live-Support-Warteschlangen auf die harte Tour gelernt haben: Wir haben gesehen, wie selbstsicher klingende Bots leise falsche Antworten gaben, weshalb bei eesel nichts an einen Kunden geht, ohne vorher einen Probelauf mit Ihrer eigenen Historie zu durchlaufen. Sie können kostenlos starten und die Zahl an Ihren eigenen Daten sehen.
Das Fazit
Muse Spark 1.3 ist ein echter Fortschritt bei Coding und langem Kontext, und zum Contributor-Preis ist es eine der besten Optionen beim Wert pro Token. Als "Top-Agentenmodell" ist es überverkauft: Metas eigene Übersicht zeigt Opus 5 als Sieger bei den Agenten-Zeilen, die Flaggschiff-Stufe max ist gesperrt, und die 3x Wortreichheit bedeutet, dass der günstige Listenpreis nicht der Preis ist, den Sie zahlen. Nehmen Sie es als das, was es ist, ein schneller, günstiger, wortreicher Coding-Spezialist mit starker Gewohnheit bei langem Kontext, und es ist leicht zu mögen. Verwechseln Sie nur kein starkes Modell mit einem arbeitsfähigen Teammitglied. Wenn die Aufgabe das Beantworten von Kunden ist, stellen Sie das Teammitglied ein, nicht den Motor.