

Meta hat Muse Spark 1.2 am 5. August 2026 veröffentlicht und es als Coding-Release bezeichnet. Wer die unabhängigen Zahlen liest, sieht: Genau das ist es kaum. Bei Artificial Analysis bewegte sich Terminal-Bench um 2,2 Punkte, während der Agentic Index um 9,6 und der GDPval Elo um 254 stiegen. Der Einbruch bei allgemeinen Agenten, der 1.1 plagte, wurde behoben, und Meta hat das in einem einzigen Satz erwähnt.
Das Zweite: Metas wichtigste Coding-Diagramme ändern zwei Variablen gleichzeitig. Muse Spark 1.2 wird innerhalb von Muse Code getestet, Metas neuem Terminal-Agenten, während 1.1 auf mini-swe-agent getestet wird. Die Modelle wurden außerdem gemeinsam mit diesem Harness trainiert. Der Abstand, den du siehst, ist also ein Modell plus ein Harness, und das Diagramm kann beides nicht für dich trennen.
Das Dritte ist der Preis, und er ist der interessanteste Teil des Releases. Dasselbe Modell hat zwei IDs: $1,25/$4,25 pro Million Tokens, oder $0,10/$0,20, wenn du Meta mit deinem Traffic trainieren lässt. Das ist bei einer normalen Mischung etwa das 16-Fache. Ich baue bei eesel KI-Agenten für Support-Warteschlangen, und das Muster, auf das ich hinweisen würde, habe ich schon Deals kosten sehen: Das Modell war nie der Engpass. Ein Käufer führte einmal eine methodische Evaluierung mit 67 Tests an unserem Agenten durch, nannte die Wissensantworten solide und sprang trotzdem ab, weil das Chat-Widget langsam war und ständig hängen blieb. Günstigere Tokens beheben nicht das, was um die Tokens herum liegt.
Was Meta am 5. August tatsächlich veröffentlicht hat
Zwei Dinge kamen zusammen, von Matthias Reso und Josh Walters im Entwickler-Blog von Meta: das Modell und der Agent, der es ausführen soll.
Muse Spark 1.2 ist das Modell. Metas eigene Beschreibung ist ungewöhnlich zurückhaltend: Es nennt 1.2 „a moderate improvement over Muse Spark 1.1“, optimiert für „multi-file refactors, long debugging sessions and tasks that run well past a single prompt“. Der Research-Beitrag ist noch nüchterner und beschreibt das Release als „our next step toward the frontier, with larger and much more capable models on the way.“ Niemand bei Meta behauptet hier ein Frontier-Modell, und ich würde sie beim Wort nehmen. Das ist eine andere Haltung als im Rest von Metas KI-Offensive, wo die Arbeit für Endverbraucher größere Versprechen bekommt.
Muse Code ist der Agent, in der Beta. Er lässt sich mit einem Befehl installieren, läuft in deinem Terminal, startet parallele Subagenten und protokolliert alles, was er tut. Das ist der Teil dieses Releases, der neu ist, und ich glaube, die meiste Berichterstattung hat ihn übersprungen. Falls du noch kein KI-Coding-Tool fürs Terminal genutzt hast: Das ist die Kategorie, zu der er gehört.
Drei Dinge wurden unverändert von Muse Spark 1.1 übernommen: das Kontextfenster mit 1.048.576 Tokens, die Standard-Preisliste und die Closed Weights. Was sich außerhalb des Modells geändert hat, ist die Verfügbarkeit. Meta hat die öffentliche Vorschau über die USA hinaus ausgeweitet, was für alle, die 1.1 von außerhalb der USA erreichen wollten, die eigentliche Schlagzeile war.
Artificial Analysis hat Muse Spark 1.1 bereits als veraltet markiert und verweist auf 1.2, was zeigt, wie Meta die Modellreihe verstanden haben will.
Wo sich Muse Spark 1.2 tatsächlich verbessert hat
Das ist der Teil, den ich ans Whiteboard schreiben würde. Meta hat dies als Coding-Modell verkauft. Die Coding-Zahlen haben sich am wenigsten bewegt.
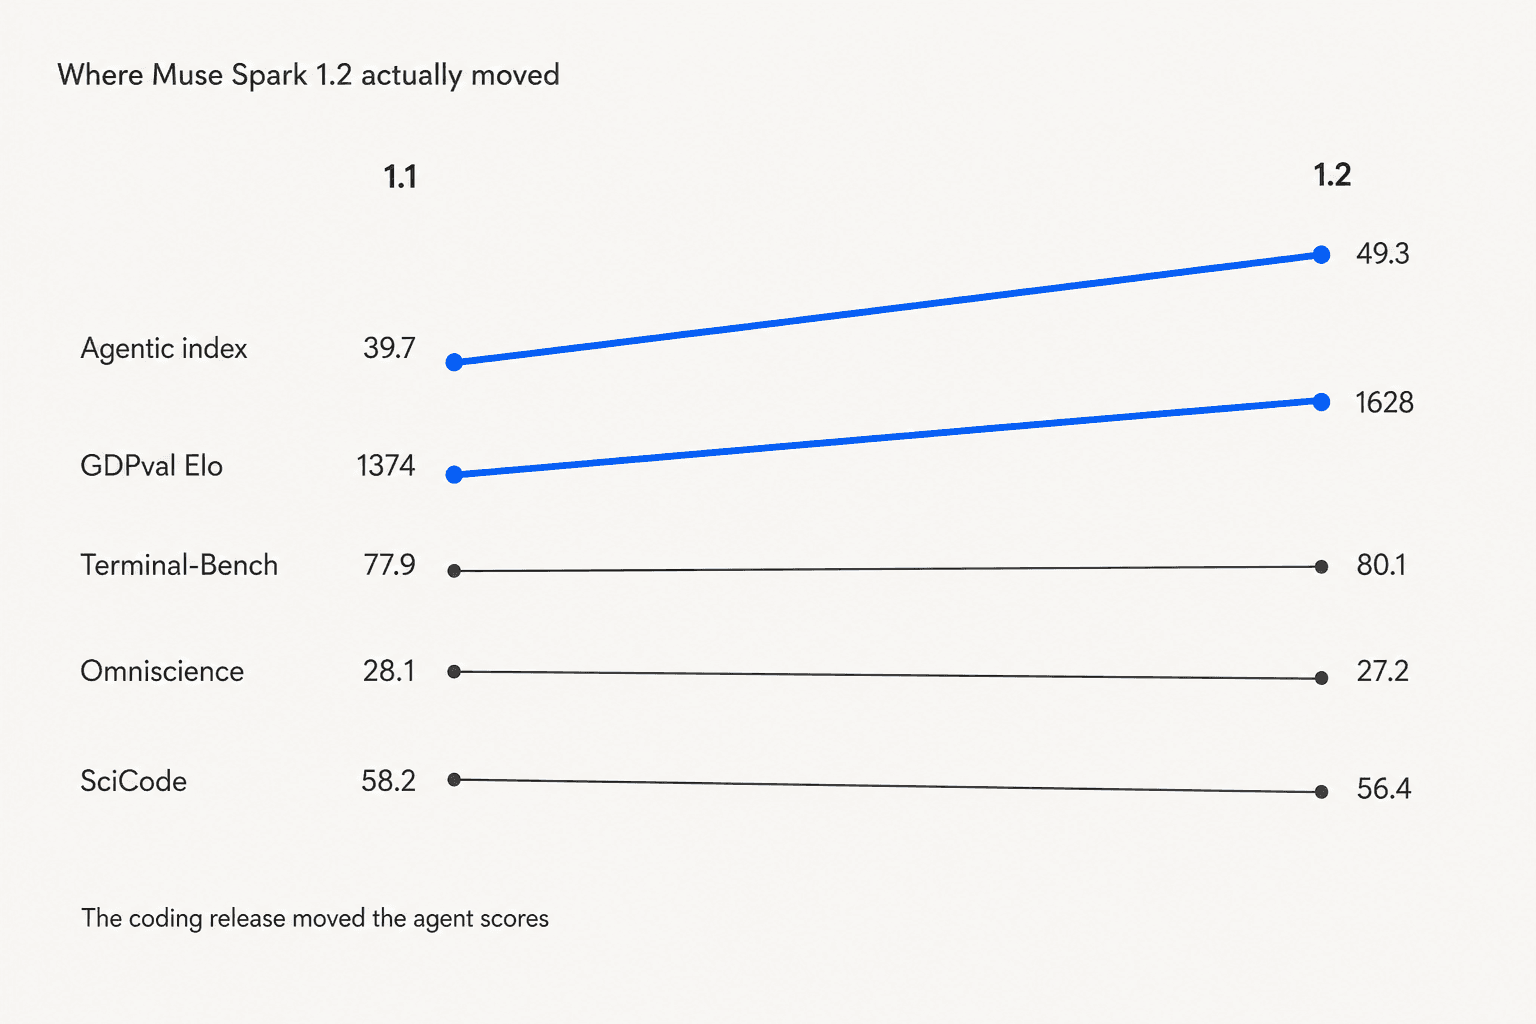
Alle Zahlen stammen von Artificial Analysis, das beide Versionen im selben Harness laufen ließ, und genau das macht den Vergleich etwas wert:
| Benchmark | Muse Spark 1.1 | Muse Spark 1.2 | Veränderung |
|---|---|---|---|
| Agentic Index | 39.7 | 49.3 | +9.6 |
| GDPval-AA v2 (Elo) | 1374 | 1628 | +254 |
| Intelligence Index | 53.2 | 56.8 | +3.6 |
| tau-3 Banking | 31.8% | 34.9% | +3.1 |
| CritPt | 15.1% | 17.7% | +2.6 |
| Terminal-Bench 2.1 | 77.9% | 80.1% | +2.2 |
| AA-LCR (langer Kontext) | 81.3% | 83.3% | +2.0 |
| GPQA Diamond | 89.8% | 90.4% | +0.6 |
| Humanity's Last Exam | 46.2% | 45.5% | -0.7 |
| AA-Omniscience Index | 28.1 | 27.2 | -0.9 |
| SciCode | 58.2% | 56.4% | -1.8 |
SciCode, ein Coding-Benchmark, ist schlechter geworden. Terminal-Bench, der Coding-Benchmark, mit dem Meta eröffnet hat, bewegte sich etwa ein Fünftel so stark wie der Agentic Index. GDPval-AA v2 dagegen, der Test, der blinde paarweise Vergleiche echter professioneller Arbeitsergebnisse bewertet, stieg um 254 Elo-Punkte und hob das Modell vom Ende dieser Rangliste auf Platz zwei hinter Opus 5 in Metas eigenem Diagramm.
In meinem Muse-Spark-1.1-Review habe ich darauf hingewiesen, dass das Seltsamste an diesem Modell der Widerspruch in seinem Kern war: Meta vermarktete ein Agenten-Modell, und die unabhängigen Agenten-Evaluierungen waren seine schlechtesten Ergebnisse. Genau diese Lücke schließt 1.2. Es ist nur nicht die Lücke, auf die Metas Launch-Beitrag zeigt.
Zur Einordnung der Gesellschaft, in der es sich jetzt befindet: Mit 56,8 liegt Muse Spark 1.2 auf Platz dreizehn von zwanzig in dieser Rangliste, hinter Claude Opus 5 mit 63,1 und Grok 4.6 mit 60,9 und knapp vor GPT-5.6 Terra mit 56,6.
Die Halluzinationsrate muss man zweimal lesen
Noch eine Zeile aus derselben Quelle, weil sie genau das ist, was ein einzelner Index-Wert verbirgt. Artificial Analysis teilt AA-Omniscience in Genauigkeit und Halluzinationsrate auf:
| Kennzahl | Muse Spark 1.1 | Muse Spark 1.2 |
|---|---|---|
| Genauigkeit | 52.0% | 45.4% |
| Halluzinationsrate | 50.0% | 33.3% |
1.2 halluziniert etwa ein Drittel weniger und beantwortet etwa ein Achtel weniger richtig. Es hat gelernt, abzulehnen. Das ist eine echte Verbesserung für alles, an dessen Ende ein Kunde sitzt, und ein echter Rückschritt für alles, was eine Antwort braucht, und unterm Strich ergibt es einen leicht schlechteren Gesamtindex. Wenn du ein Modell für einen Workflow auswählst, in dem eine falsche Antwort teuer ist, ist dieser Kompromiss wahrscheinlich die relevanteste Zahl in diesem Beitrag, und sie steht in keinem von Metas Diagrammen. Die breitere Version dieses Problems steht in KI-Halluzinationen im Support, und die Werkzeugseite beim Aufspüren steht in LLM-Tracking-Tools.
Der Harness-Haken in Metas eigenen Diagrammen
Jetzt der Teil, der mich dazu gebracht hat, den Launch-Beitrag noch einmal zu lesen.
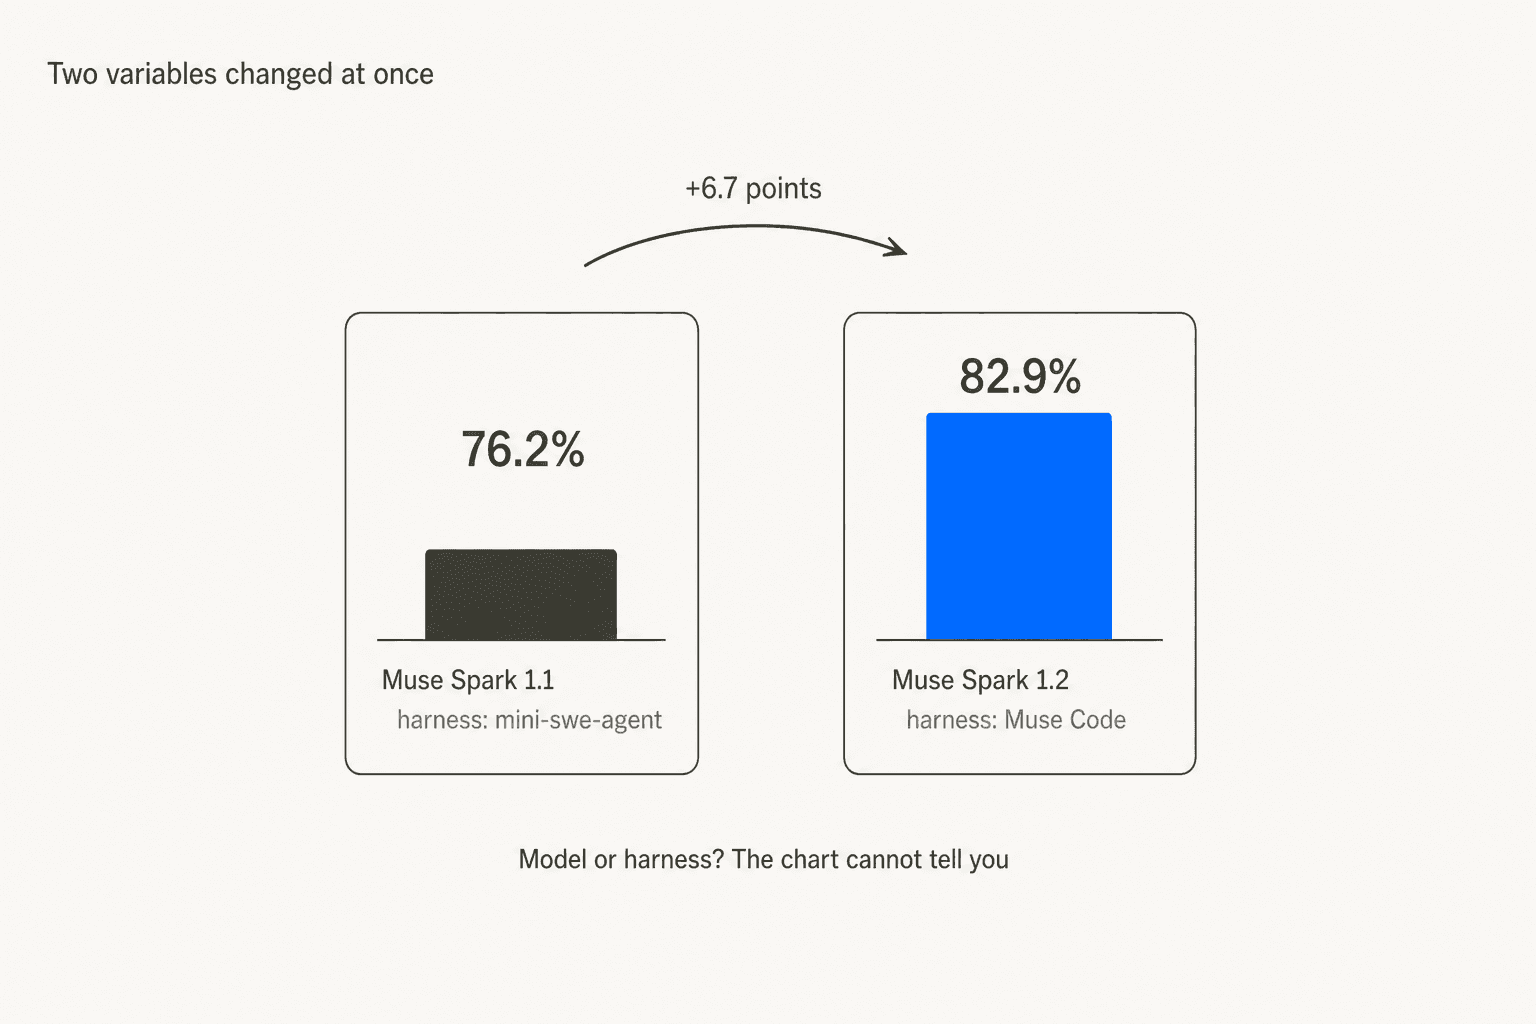
Metas Terminal-Bench-2.1-Diagramm zeigt Muse Spark 1.2 mit 82,9 % und Muse Spark 1.1 mit 76,2 %. Im kleinen grauen Text unter jedem Balken steht außerdem, in welchem Harness das jeweilige Modell lief: 1.2 lief in Muse Code, 1.1 lief in mini-swe-agent. Dasselbe gilt für das DeepSWE-Diagramm. Meta versteckt das nicht, es steht direkt da, aber das Auge liest die Balken und nicht die Fußnote.
Meta sagt auch ausdrücklich, es habe „co-trained Muse Spark 1.2 with Muse Code“, einschließlich „rejection sampled harness trajectories“ und Rezept-Optimierungen für Ziele, Compaction und Subagenten. Das Modell wurde also auf das Harness abgestimmt, in dem es bewertet wird.
Das einzige Diagramm, in dem kein Harness genannt wird, ist Metas interner Coding-Benchmark, und es ist das flachste auf der Seite:
| Modell | Meta Internal Coding Bench |
|---|---|
| Opus 5 (max) | 79.4% |
| Muse Spark 1.2 | 70.6% |
| Muse Spark 1.1 | 68.3% |
| GPT 5.6 Terra (max) | 65.4% |
| Gemini 3.6 Flash (high) | 63.9% |
2,3 Punkte, auf dem Diagramm, in dem das Harness keine Variable mehr ist. Vergleiche das mit den 6,7 Punkten bei Terminal-Bench und den 6,3 bei DeepSWE, wo es eine ist. Ich sage nicht, dass Meta etwas frisiert hat. Ich sage: Wenn du dieses Modell in deinem eigenen Tooling betreiben willst, ist die Zahl mit kontrolliertem Harness diejenige, die deine Erfahrung vorhersagt, und sie ist die kleinste Zahl auf der Seite.
Ein Kommentator im Hacker-News-Launch-Thread hat die allgemeine Version davon besser formuliert, als ich es kann:
"Outputs are a little bit more deterministic if you control the harness. It is easy to benchmark across one harness, one system prompt and extract the most performance when you control the harness."

Das ist übrigens kein Meta-spezifisches Problem. Jedes Labor liefert inzwischen einen eigenen Agenten aus und testet darin, von Claude Code über Codex bis Grok Build. Hier ist es nur ungewöhnlich gut sichtbar, weil Meta die Harness-Namen ins Diagramm geschrieben hat.
Muse Code, der wirklich neue Teil
Muse Code lässt sich in einer Zeile installieren und läuft als muse in jedem Projektverzeichnis:
curl -fsSL https://dev.meta.ai/install.sh | bash
Die Grundidee ist Fan-out. Du gibst dem übergeordneten Agenten in einem Prompt einen Stapel Aufgaben, und er startet pro Aufgabe ein schreibfähiges Kind, jeweils in einem eigenen Git-Worktree, sodass parallele Kinder nie dieselben Dateien anfassen.
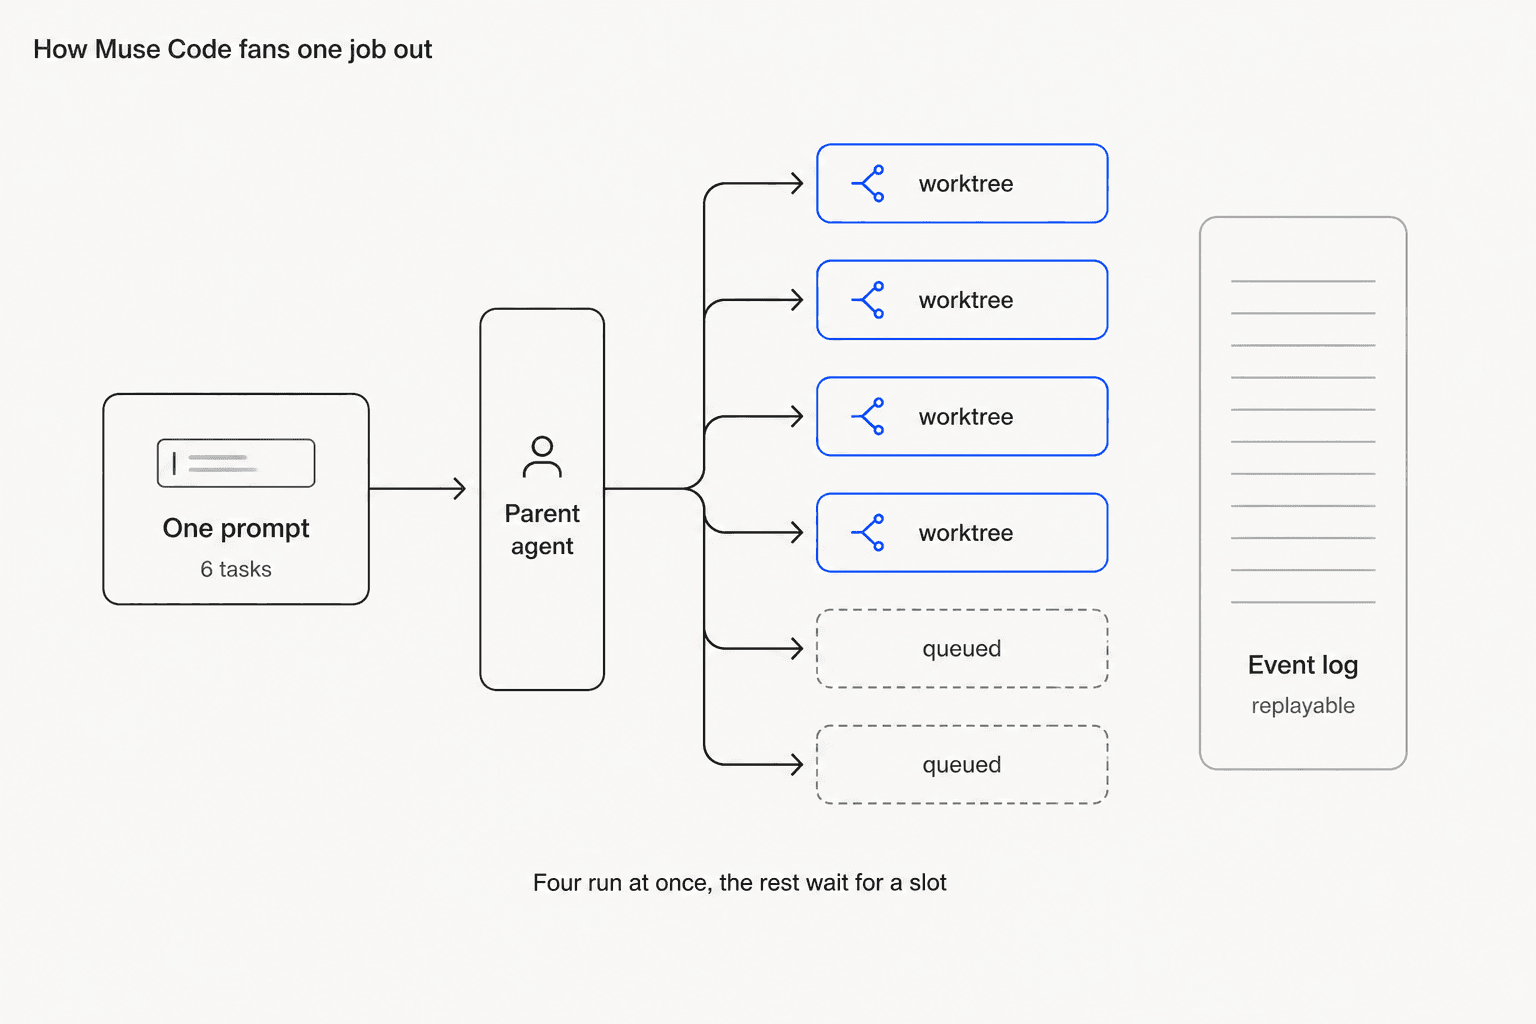
Metas eigenes Fan-out-Cookbook führt einen Stapel mit sechs Aufgaben an einem Beispiel-Spiele-Repo vor. Der übergeordnete Agent startet sechs Kinder, das Concurrency-Limit des Hosts ergibt vier, und die Aufgaben fünf und sechs warten, bis Plätze frei werden.
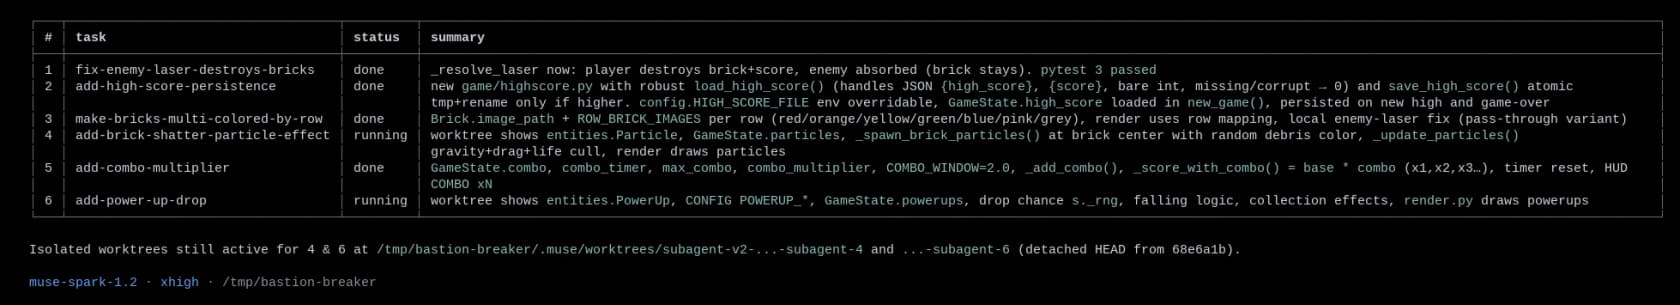
subagent_status liefert diese Übersicht mit Aufgabe, Status und einer einzeiligen Zusammenfassung dessen, was jedes Kind geändert hat. Beachte die Statusleiste in Metas eigenem Screenshot: muse-spark-1.2 · xhigh. Der Aufwand ist in der Demo hoch eingestellt, was man im Kopf behalten sollte, wenn man die Zahlen mit der eigenen Rechnung vergleicht. Die Worktrees landen unter .muse/worktrees/ im Detached-HEAD-Zustand, ausgecheckt vom HEAD des übergeordneten Agenten, ohne manuellen git worktree-Befehl. In Metas Lauf besteht das Kind, das den Bug behoben hat, die komplette Testsuite in seinem eigenen Worktree, während der master des übergeordneten Agenten denselben Test noch nicht besteht.
Zwei weitere Bausteine verdienen eine Erwähnung:
- Ein wiedergebbares Ereignisprotokoll. Jeder Modellaufruf, jede Tool-Ausführung, Freigabe und Änderung wird als einfaches JSONL auf deine Platte geschrieben, das du mit
jqdurchsuchen kannst. Dasselbe Protokoll steuertmuse resume, sodass eine abgestürzte Sitzung ab dem letzten aufgezeichneten Schritt weitermacht, statt von vorn neu angestoßen zu werden. - Mitgelieferte Skills. Vier Playbooks sind eingebaut:
/plan(verankert einen Plan in deinen echten Dateien und hält dann zur Freigabe an),/grilling(befragt dich mit je einer entscheidungserzwingenden Frage),/grill-with-docsund/taste(eine Anti-Slop-Checkliste visueller Standards, die man vermeiden sollte). Sie werden nur auf ausdrücklichen Aufruf aktiv, der Agent greift also nicht von selbst zu/grill, und ein Skill wird nur für den Zug geladen, in dem du ihn aufrufst.
Wenn du genauer wissen willst, wie sich diese Kategorie entwickelt, behandelt mein Beitrag zur agentischen Coding-CLI das Feld. Etwas Eigenes zu bauen ist ein anderes Projekt, und die Anleitung zum Claude Code SDK kommt dem, was Meta hier gebaut hat, am nächsten.
Für den breiteren Tool-Markt gibt es die Übersicht der besten KI-Coding-Assistenten. Wer das gegen den Platzhirsch abwägt, sollte mit der Übersicht zum Claude-KI-Coding-Assistenten beginnen.
Mein ehrliches Fazit zu Muse Code: Worktree-Isolation pro Subagent und ein exakt wiedergebbares Ereignisprotokoll sind gute Technik, und die Reaktion eines Hacker-News-Kommentators entsprach meiner, dass „Muse code is more interesting than the new model.“ Ob es das Harness schlägt, das du schon nutzt, kann eine Beta und ein Blogbeitrag nicht beantworten.
Muse-Spark-1.2-Preise und der Contributor-Tausch
Meta veröffentlicht zwei Modell-IDs für ein Modell, und die Lücke zwischen ihnen ist die eigentliche Geschichte.
| Modell-ID | Kontext | Input / Mtok | Gecachter Input / Mtok | Output / Mtok | Datenrichtlinie |
|---|---|---|---|---|---|
muse-spark-1.2-contributor | 1M | $0.10 | $0.002 | $0.20 | "Used to improve our products" |
muse-spark-1.2 | 1M | $1.25 | $0.15 | $4.25 | "Not used to improve our products" |
Diese Labels sind Metas eigene Formulierungen, von der Modellseite. Der Standardpreis ist gegenüber 1.1 unverändert. Wenn du also schon für das alte Modell bezahlt hast, ist 1.2 preislich ein kostenloses Upgrade.
Die Contributor-Stufe wird über Tokens in einem rollierenden 5-Stunden-Fenster begrenzt statt über die Anzahl der Anfragen, und Meta sagt, sie sei in ausgewählten Ländern verfügbar. Meta weist außerdem darauf hin, dass es jetzt Zero-Data-Retention-Anfragen über den Vertrieb annimmt, was die Enterprise-Tür bei der Standardstufe ist.
Bei einer normalen Mischung aus Input und Output von 3:1 ergibt das $0,125 pro Million Tokens bei der Contributor-ID gegenüber $2,00 bei der Standard-ID. 16-mal, und der Wechselkurs ist dein Traffic.
Zwei Zahlen zum Gegenprüfen. Artificial Analysis hat Muse Spark 1.2 mit $0,399 pro Intelligence-Index-Aufgabe zum Standardpreis gemessen, 37 % mehr als die $0,292 von 1.1, weil das Modell mehr nachdenkt. Wendet man dieselbe Token-Mischung auf die Contributor-Preisliste an, landet man bei etwa $0,017 pro Aufgabe, was unter DeepSeek V4 Flash mit $0,027 läge, dem günstigsten Modell dieser Rangliste. Diese zweite Zahl ist meine eigene Rechnung auf Basis der veröffentlichten Token-Kosten pro Aufgabe von AA, kein gemessenes Ergebnis, und sie nimmt an, dass Cache-Schreibvorgänge zum Input-Preis abgerechnet werden, was Meta nicht veröffentlicht. Der DeepSeek-Vergleich ist der, bei dem man verweilen sollte, denn dieses Modell hat offene Gewichte, und du kannst es dort betreiben, wo niemand mit dir trainiert. Mein DeepSeek-V4-Flash-Review zeigt das ganze Bild.
Auch zum Standardpreis trägt das Wertargument. Muse Spark 1.2 erreicht 56,8 im Intelligence Index bei $0,399 pro Aufgabe; Claude Opus 5 erreicht 63,1 bei $2,34. Das Sechsfache an Kosten für elf Prozent mehr Index. Ob diese elf Prozent zählen, ist ganz eine Frage deiner Arbeitslast, und das ist dasselbe Argument wie in Claude-Opus-5-Alternativen.
Ein Vorbehalt zur Reasoning-Rechnung: $339,82 der $639,27, die Artificial Analysis für den Lauf des gesamten Index gekostet haben, gingen für Reasoning-Tokens drauf, die man nie sieht. Metas /effort-Regler dreht das hoch und runter, und bei einfachen Aufgaben wäre er mein erster Hebel. Es ist derselbe versteckte Posten, der die Anthropic-API-Preise allein anhand einer Preisliste schwer vorhersagbar macht.
Was Entwickler sagen
Der Launch-Thread sammelte 333 Punkte und 266 Kommentare, und die Reaktion teilte sich entlang einer klaren Linie: Der Preis ist interessant, die Vertrauensfrage ist nicht geklärt, und die Bindung ans Harness ist real.
Zum Preis war die Lesart sofort da:
"If you are happy to share data for training, the contributor mode offers amazing price $0.10 / $0.20"
Jemand anderes formulierte dieselbe Tatsache als offene Frage danach, was die Daten wert sind:
"Very interesting they have a way cheaper "contributor" version "used to improve our products", how much of that is price discrimination vs the data being that valuable? Roughly DeepSeek V4 Flash pricing, though you can get V4 from providers that don't train on your data"
Der schärfste Datenpunkt für alle, die das Modell außerhalb von Metas eigenem Agenten nutzen wollen, kam von einem Entwickler, der genau das versucht hat:
"It's useless. Tried with OpenCode + OpenRouter and it couldn't complete an simple task. It stuck using grep/search tools. I think Muse Spark was so heavily RL'd on the Meta harness that it make it useless or very token inneficient to use in other harness like Opencode."
Das ist der Lauf einer einzelnen Person, und er steht in direktem Gegensatz zu Metas Aussage, man habe über mehrere Harnesses hinweg trainiert, sodass das Modell „still generalizes to other coding agents you already use.“ Ich würde keines von beidem als erledigt betrachten. Ich würde es als genau das Ding sehen, das man zuerst testen sollte, mit einem kleinen bezahlten Lauf im eigenen Tooling, bevor man einen Workflow darauf umstellt. Derselbe Rat gilt für jedes domänenspezifische Modell, das stark auf eine Umgebung abgestimmt wurde.
Ein weiterer Kommentator maß bei OpenRouter einen Durchsatz von rund 150 Tokens pro Sekunde, was für diese Klasse schnell ist. Die API selbst nimmt Anfragen im OpenAI-Format an, der Austausch ist also meist nur eine Änderung der Basis-URL, dieselbe Art von Migration wie in OpenAI vs. Anthropic APIs beschrieben.
Und die Zeile zum „erweiterten globalen Zugang“ wurde von mindestens einem Nutzer klar widerlegt, der berichtete, die Contributor-Stufe sei weiterhin nur in den USA verfügbar. Metas eigene Formulierung ist enger als die Schlagzeile: Die günstige ID ist „available in select countries“, was nicht dasselbe Versprechen ist wie ein global verfügbares Modell.
Open Weights kommen, ohne Datum
Vier Tage nach dem Launch machte Metas Chief AI Officer die Ankündigung, auf die viele drei Modellgenerationen lang gewartet hatten:
"1/ big announcement today: we will be releasing an open weight version of muse spark 1.2 soon. we also are releasing muse glimmer, a 30B agentic model with open weights under apache 2.0. muse glimmer can run on 24GB of VRAM without losing agentic reliability. 🧵"
Glimmer ist erschienen. Die Gewichte von Spark 1.2 nicht, und „soon“ kommt ohne Lizenz und ohne Datum. Ich würde mit dem planen, was heute tatsächlich herunterladbar ist, nämlich Glimmer mit 30B unter Apache 2.0, und Open-Weight-Spark als nette Überraschung behandeln, falls es kommt. Meta hat Übung darin, zuerst das Benachbarte auszuliefern: Dasselbe Muster zeigte sich bei Muse Image.
Wenn Open Weights der ganze Grund sind, warum du das hier liest, ist Qwen3.8 Max die ernstzunehmende Alternative, die heute verfügbar ist. Der Vergleich DeepSeek vs. Kimi K3 ist der, den ich lesen würde, bevor ich zwischen den anderen beiden wähle.
Wer sollte Muse Spark 1.2 also tatsächlich nutzen?
Wo es nach einer Woche mit den Zahlen landet:
- Einen Versuch wert, wenn du lange agentische Jobs mit kleinem Budget betreibst. Der Sprung beim Agentic Index ist real, der Kontext sind echte 1M, und mit $0,40 pro Aufgabe zum Standardpreis ist es etwa ein Sechstel von Opus 5. Die Kernel-Optimierungs-Fallstudie zeigt es ehrlich: Über 1.000 Tool-Aufrufe und bis zu 24 Stunden erreichte Muse Spark 1.2 +68,7 % gegenüber der Baseline, Platz vier von sechs, hinter Opus 5 mit +74,0 %, GPT-5.6 Sol mit +71,2 % und Opus 4.8 mit +69,6 %. Wer die Kurve statt des Endpunkts liest, sieht, dass es auch langsamer startet: Es lag bei 200 Tool-Aufrufen bei etwa 27 %, während Opus 5 schon über 60 % war. Es kommt an. Es nimmt den langen Weg.
- Einen Versuch wert, wenn dein Code nicht sensibel ist. Die Contributor-Stufe ist wie ein Open-Weights-Modell bepreist, und Meta sagt dir genau, womit du bezahlst. Für Nebenprojekte, OSS-Arbeit und Wegwerf-Prototypen ist das ein klares Ja.
- Eher nicht, wenn du die Spitze der Rangliste brauchst. Opus 5 führt in jedem einzelnen von Meta veröffentlichten Diagramm, auch in Metas eigenem internen. GPT-5.6 Sol liegt beim Index ebenfalls vorn. Wenn dir eher rohe Geschwindigkeit fehlt als Intelligenz, ist Gemini 3.6 Flash die günstigere Antwort.
- Eher noch nicht, wenn du dich auf ein Harness festlegst. Die stärksten Coding-Zahlen stammen vom Muse-Code-Paar, Muse Code ist in der Beta, und der einzige öffentliche Bericht über den Betrieb des Modells anderswo war schlecht. Diese Kombination spricht für einen Test, nicht für eine Migration.
- Nicht allein, wenn die Aufgabe Kundensupport ist. Der Rückgang bei der Genauigkeit neben dem Rückgang bei den Halluzinationen ist genau der Kompromiss, der für eine Support-Arbeitslast zählt, und keine der beiden Zahlen lässt sich über die API korrigieren. Die Auswahl, die für eine Warteschlange wirklich trägt, steht in meiner Übersicht der besten KI-Agenten, und der Budgetrahmen steht in Kosten im KI-Kundenservice.
eesel ausprobieren
Bei diesem letzten Punkt möchte ich enden, denn es ist der Fehler, den ich jedes Quartal bei Teams beobachte. Ein Modell-Release wie dieses lässt ein Support-Automatisierungsprojekt wie eine Preisentscheidung aussehen. Das ist es nicht. Zwischen muse-spark-1.2 und einer KI, die einen echten Kunden sicher beantworten kann, liegen Retrieval über deine eigenen Inhalte, Confidence-Schwellen, Eskalationsregeln und eine Möglichkeit zu wissen, was sie tun wird, bevor sie es tut. Das ist der Unterschied zwischen einem KI-Agenten und einem Chatbot, und dort liegt das Projekt tatsächlich.
eesel ist diese Schicht. Es verbindet sich mit dem Helpdesk, den du bereits nutzt, lernt aus deinen eigenen gelösten Tickets statt aus einem generischen Web-Crawl und simuliert zuerst auf deiner Ticket-Historie, sodass du die Lösungsquote und die Antworten siehst, bevor ein einziger Kunde sie sieht. Diesen Simulationsschritt gibt es, weil ich erlebt habe, wie ein selbstsicher klingender Bot still falsche Antworten gab, und eine Halluzinationsrate von 33 % ist keine Zahl, die man in der Produktion entdecken möchte.

Wenn du Modelle evaluierst, weil deine Warteschlange überläuft, fang am anderen Ende an. Führe eine Simulation auf deinen letzten paar tausend Tickets durch, sieh, was tatsächlich abgefangen wird, und streite dann über Tokens. Kostenlos testen, ohne Karte zum Start.
Zwei weitere Lektüren, wenn du früher in dieser Entscheidung steckst. Mein Beitrag zum besten LLM für den Support behandelt die Modellwahl gründlich. Für den Business Case stehen die Zahlen in KI-Agent vs. menschliche Kosten.
Häufig gestellte Fragen
Was kostet Meta Muse Spark 1.2?
muse-spark-1.2 kostet $1,25 pro Million Input-Tokens, $0,15 für gecachte Tokens und $4,25 für Output, identisch mit den Preisen von Muse Spark 1.1. Die ID muse-spark-1.2-contributor kostet $0,10 Input, $0,002 gecacht und $0,20 Output, und laut Metas Modellseite wird der Traffic zur Verbesserung der Meta-Produkte verwendet. Reasoning-Tokens werden bei beiden zum Output-Preis berechnet.