

Was ist Meta Muse Wonder?
Muse Wonder ist die neueste Modellreihe der Meta Superintelligence Labs, und Meta nennt das Paar seine „leistungsfähigsten Modelle“ bisher. Es steht über der Muse Spark 1.3-Modellreihe und ist etwas anderes als Meta Muse, der persönliche Consumer-Agent, der im September startete. Stell dir Wonder als Motor vor und Muse als eines der Autos, in die er bald eingebaut wird.
Bei eesel baue ich Integrationen und APIs, also lese ich Launch-Seiten wie die Dokumentation jedes Anbieters: Was kann ich tatsächlich aufrufen, zu welchem Preis und mit welchen Bedingungen? Ich habe die Launch-Woche in Metas Modelldokumentation, auf der Seite zu Preisen und Rate Limits, in der Benchmark-Tabelle und im Hacker-News-Thread mit 362 Kommentaren verbracht. Dieser Test basiert darauf, nicht auf einer Pressemitteilung.
Das liefert Meta, in einer Tabelle:
| Muse Wonder | Muse Wonder Full | |
|---|---|---|
| Modell-ID | muse-wonder-1.0 | muse-wonder-full-1.0 |
| Wo du es bekommst | Meta Model API, OpenRouter, jeder Muse-Code-Tarif | Nur Muse-Code-Tarife Power Usage und Maximum Usage |
| Kontextfenster | 1.048.576 Tokens | 1M Tokens |
| Eingabetypen | Text, Bild, Video, Audio, PDF | Nicht separat dokumentiert |
| Reasoning-Aufwand | „minimal“ bis „max“ | Bei max gezeigt (xhigh bei SWE-Marathon) |
| Preis | 4,00 $ Input / 0,20 $ gecacht / 20,00 $ Output pro 1M Tokens | Im Monatstarif für 50 $ oder 200 $ enthalten |
| Status | Preview | Nur im Abo |
Zwei Details in der Modelldokumentation wiegen schwerer, als es scheint. Erstens ist Muse Wonder als Preview gekennzeichnet. Zweitens stellt Meta klar, dass das „Setzen des Reasoning-Aufwands auf ‚max‘ bei Muse Wonder“ Wonder Full nicht auswählt. Es gibt kein API-Flag, das das größere Modell freischaltet.
Die Benchmarks: wo Wonder Full gewinnt und wo nicht
Metas Modellseite veröffentlicht eine Tabelle mit 14 Zeilen, die beide Wonder-Modelle mit Claude Fable 5.1, GPT-6 Astra und Claude Opus 5.5 vergleicht, alle bei maximalem Reasoning. Ich habe in jeder Zeile den fett markierten Sieger gezählt.
| Benchmark | Was er testet | Wonder Full | Wonder | Fable 5.1 | GPT-6 Astra | Opus 5.5 |
|---|---|---|---|---|---|---|
| Personal Superintelligence Index | Metas interner Gesamtwert | 59.1 | 54.3 | 49.9 | 54.5 | 55.2 |
| Harvey LAB-AA | Rechtliche Agentenarbeit | 13.1 | 10.0 | 6.4 | 8.6 | 4.2 |
| Vals Finance Agent V2 | Finanzrecherche | 59.1 | 56.6 | 58.9 | 53.5 | 58.6 |
| HealthBench Pro | Offene Gesundheitsfragen | 62.3 | 60.5 | 62.1 | 65.3 | 65.6 |
| AutomationBench-AA | Durchgängige Geschäftsprozesse | 45.4 | 39.1 | 32.1 | 41.6 | 41.2 |
| GDP.pdf | Professionelle Arbeit | 33.2 | 30.8 | 27.6 | 34.2 | 30.6 |
| JobBench | Professioneller Werkzeugeinsatz | 75.3 | 70.5 | 73.1 | 66.1 | 75.4 |
| OSWorld V2.1 (partial) | Computer-Nutzung | 78.4 | 72.6 | 80.7 | 75.8 | 81.8 |
| MemoryBench | Kontext im Gedächtnis behalten | 85.5 | 85.6 | 79.0 | 81.4 | 81.5 |
| Terminal-Bench 4.0-AA | Terminal-Coding | 57.1 | 52.0 | 52.0 | 59.1 | 59.6 |
| DeepSWE 1.1 | Langstrecken-Coding | 79.0 | 78.8 | 67.4 | 74.1 | 74.2 |
| SWE-Marathon | Ultralange Entwicklungsaufgaben | 57.5 (xhigh) | 53.1 | 45.6 | 42.5 | 46.3 |
| ProgramBench | Programmieren von Grund auf | 59.0 | 50.0 | 55.5 | 52.5 | 70.5 |
| Artificial Analysis Index | Gesamt | 56 | 52 | 53 | 53 | 58 |
Die Bilanz: Wonder Full gewinnt 6 Zeilen, Opus 5.5 gewinnt 6, GPT-6 Astra gewinnt 1, das schlichte Muse Wonder gewinnt 1 (MemoryBench, mit 0,1 Punkten Vorsprung vor dem eigenen größeren Geschwistermodell). Claude Fable 5.1 gewinnt keine.
Das ist ein echtes Ergebnis. Vor einem Jahr zählte niemand Meta zu den Frontier-Labs, und dass Wonder Full GPT-6 Astra in 11 von 14 Zeilen schlägt, ist ein großer Sprung. Die Rechtszahl sticht am meisten heraus: 13,1 im Rechts-Agenten-Benchmark von Harvey ist absolut gesehen niedrig, aber mehr als dreimal so viel wie die 4,2 von Opus 5.5. Wenn du Harvey AI verfolgst, weißt du, wie schwer dieser Benchmark für jedes Modell ist.
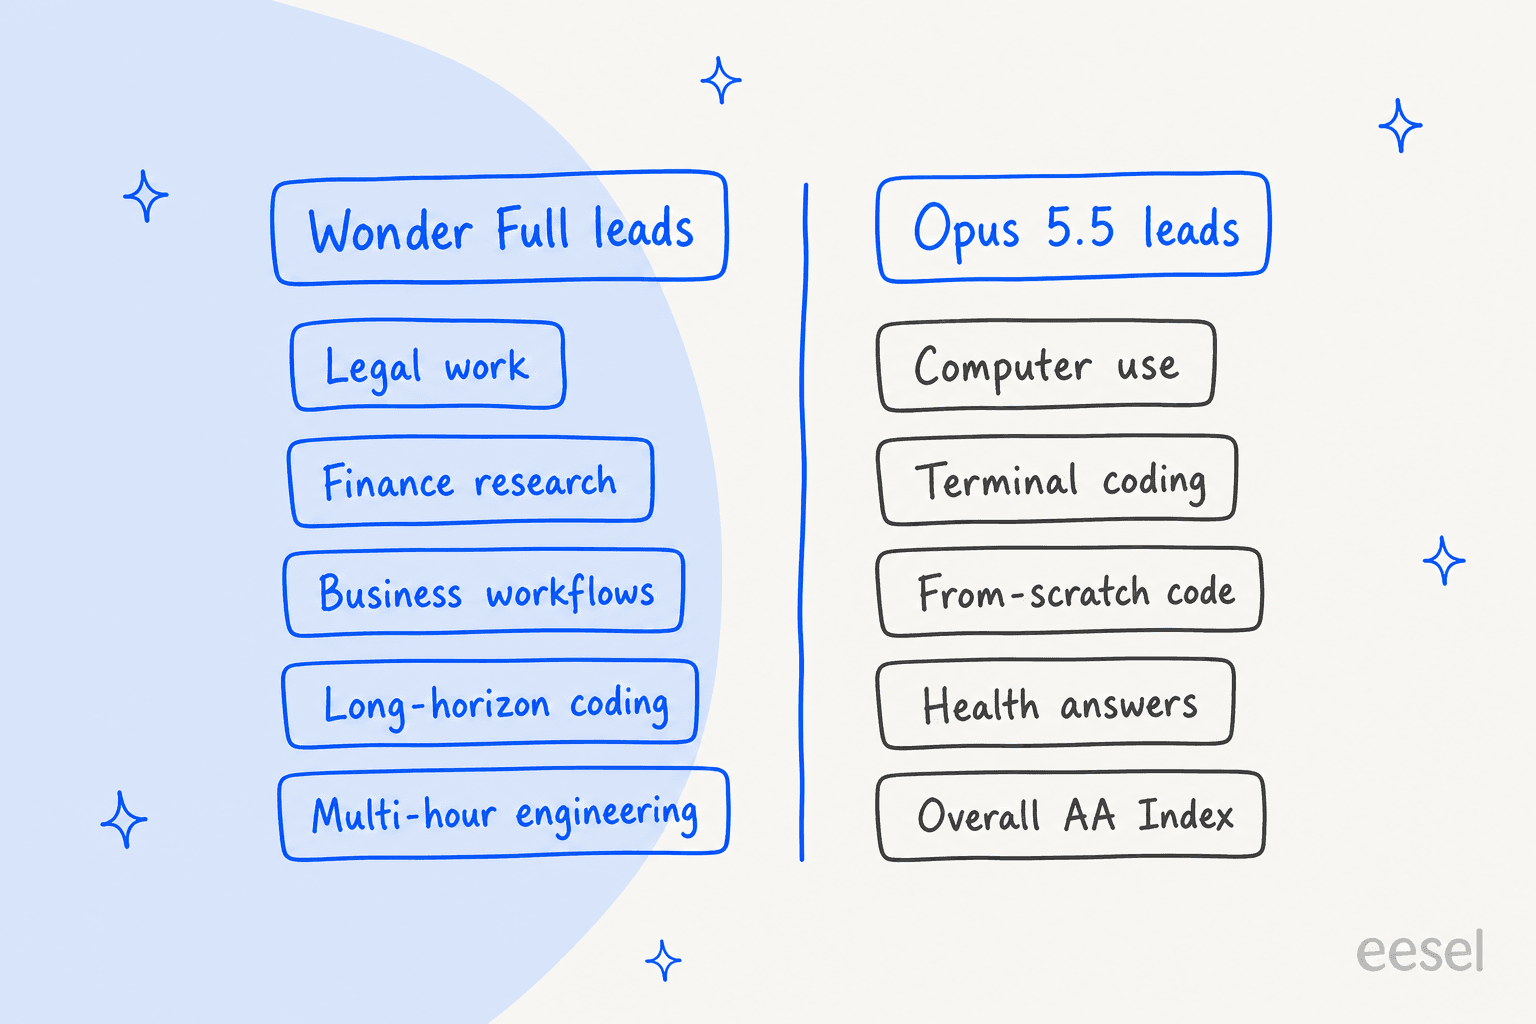
Die Aufteilung hat ein Muster. Wonder Full gewinnt dort, wo die Aufgabe lang und dokumentenlastig ist: ein juristisches Arbeitsergebnis, ein Finanz-Recherchebericht, ein mehrstündiges Coding-Projekt. Opus 5.5 gewinnt weiterhin dort, wo das Modell einen Computer bedienen oder etwas von Grund auf schreiben muss, und sein Vorsprung bei ProgramBench (70,5 gegen 59,0) ist die größte Lücke der ganzen Tabelle. Ein Vorbehalt zu Metas Darstellung: Der Personal Superintelligence Index ist Metas eigener interner Gesamtwert, ich würde ihn also niedriger gewichten als die Zeilen von Drittanbietern.
Metas Launch-Blog zeigt außerdem das unabhängige Ranking von Artificial Analysis vom 12. Oktober, in dem Wonder Full auf Platz zwei steht.
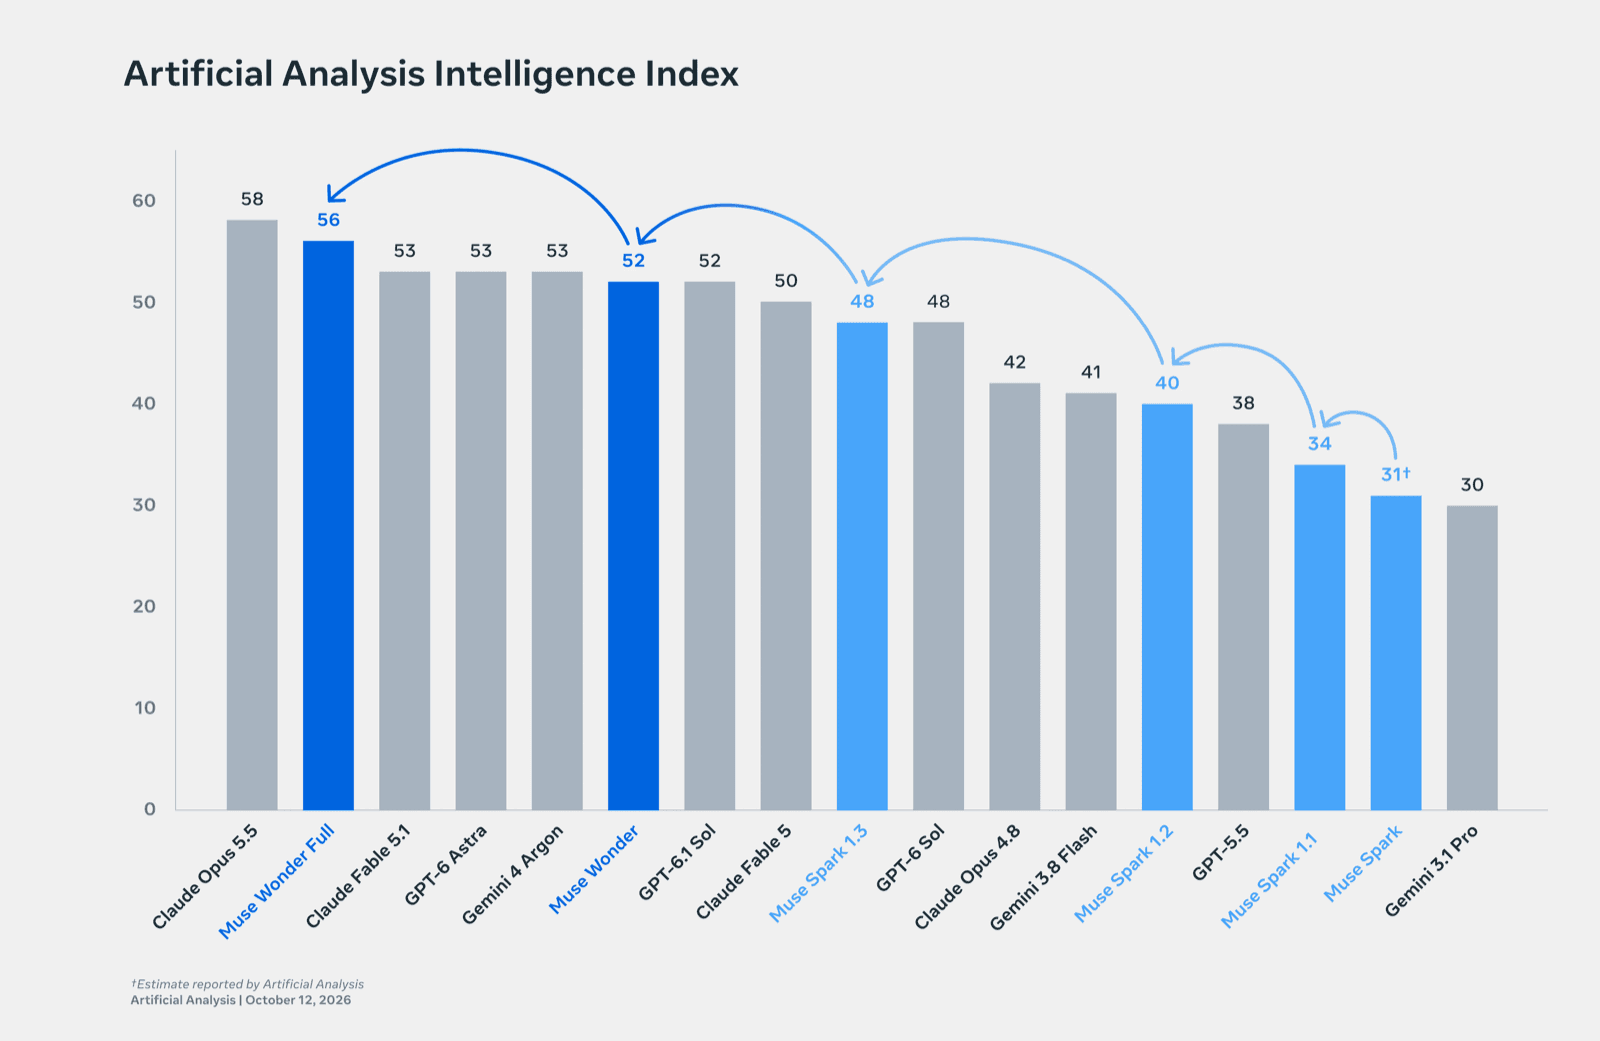
Die HN-Community reagierte auf diesen zweiten Platz so, wie man es erwartet:
"2nd place model on aa according to them, losing only to opus 5.5 is really really not bad"

Rankings ändern sich allerdings schnell. Später am selben Tag meldete ein anderer Kommentator, Wonder Full sei auf dem Live-Board auf Platz fünf gerutscht, hinter Gemini 4 Argon. Betrachte jeden einzelnen Leaderboard-Screenshot als Momentaufnahme.
Der Haken: Das Wonder, das du kaufen kannst, ist nicht das Wonder aus dem Diagramm
Das ist der Teil, den die meiste Launch-Berichterstattung übergeht. Schau dir das AA-Diagramm noch einmal an: Das Modell, das du über die API aufrufen kannst, erreicht 52. Das liegt unter Fable 5.1, GPT-6 Astra und Gemini 4 Argon (alle 53) und gleichauf mit GPT-6.1 Sol. Es ist trotzdem ein starkes Modell, etwa vier Punkte über Muse Spark 1.3 im selben Diagramm. Aber es ist nicht das Modell, das Opus 5.5 schlägt.
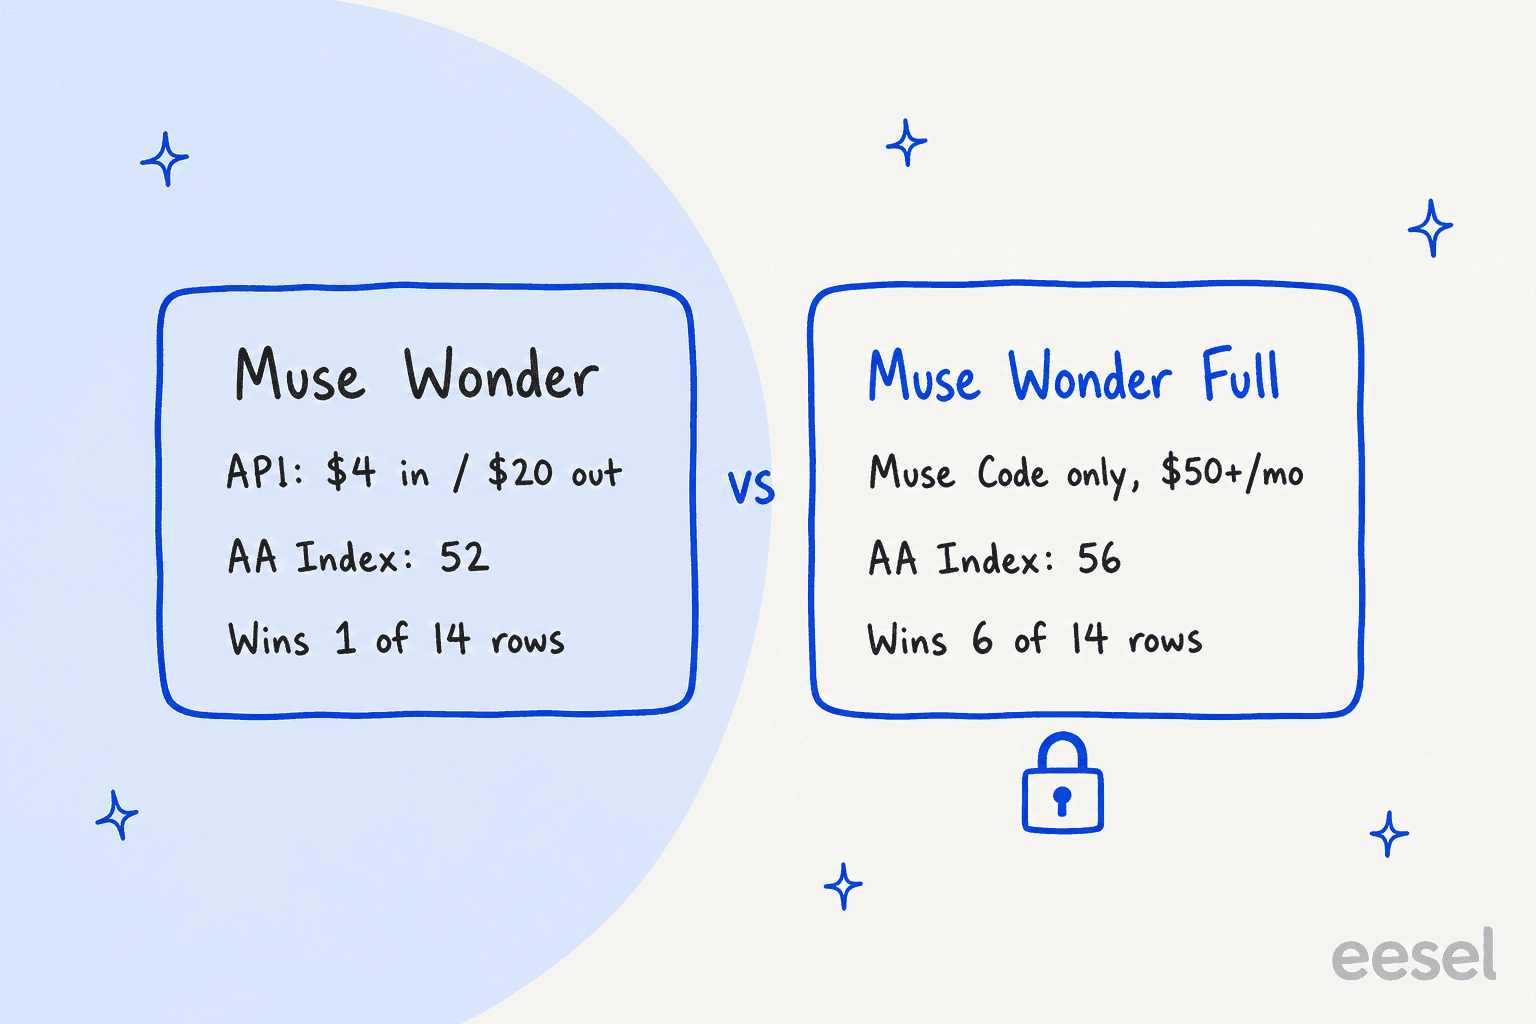
Ein HN-Kommentator bemerkte das schon wenige Stunden nach dem Launch:
"Upon closer inspection, the benchmark scores for "Muse Wonder" on the main marketing page are actually for "Muse Wonder Full," which is only available on the higher-tier subscription plans. This pricing is for "Muse Wonder.""
Simon Willison listete die Modelle auf, die sein API-Schlüssel sehen konnte, und muse-wonder-1.0 war das einzige Wonder in der Liste. Wenn du also als Entwickler ein Produkt baust, lautet die Entscheidung nicht „Muse Wonder Full gegen Opus 5.5“. Sie lautet „Muse Wonder mit 52 gegen Opus 5.5 mit 58, zum selben Preis“. Das ist schwerer zu verkaufen.
Muse-Wonder-Preise
Die Preise haben zwei getrennte Formen, die sich nicht überschneiden.
Nutzungsbasiert in der Meta Model API (aus Metas Preisliste):
| Nutzung | Muse Wonder (Standard-Modus) | Contributor-Modus |
|---|---|---|
| Input | 4,00 $ pro 1M Tokens | Nicht verfügbar |
| Gecachter Input | 0,20 $ pro 1M Tokens | Nicht verfügbar |
| Output | 20,00 $ pro 1M Tokens | Nicht verfügbar |
| Web-Search-Grounding | 2,50 $ pro 1.000 Anfragen | Nicht verfügbar |
| Rate Limit | 3.000 Anfragen und 4M Tokens pro Minute | Nicht verfügbar |
Meta gibt außerdem an, dass es keinen Aufschlag für langen Kontext gibt und die Steering-Tokens, die in jeden Prompt eingefügt werden, nicht abgerechnet werden. Das ist eine faire, saubere Preisliste. Es ist aber auch ein großer Bruch mit Metas bisheriger Gewohnheit, alle zu unterbieten. Muse Spark 1.3 kostet 1,25 $/4,25 $, und die Contributor-Stufe sinkt auf 0,10 $/0,20 $. Wonder hat in der API gar keine Rabattstufe.
"$4/$20 in vs out making it higher than Sol and on par with Opus."
So schneidet das im Vergleich zu den Konkurrenten in Metas Tabelle ab, jeweils zu den Standard-API-Preisen von der Preisseite des Anbieters:
| Modell | Input pro 1M | Gecachter Input pro 1M | Output pro 1M |
|---|---|---|---|
| Muse Wonder | 4,00 $ | 0,20 $ | 20,00 $ |
| Claude Opus 5.5 | 4,00 $ | 0,20 $ | 20,00 $ |
| GPT-6 Astra | 10,00 $ | 1,00 $ | 50,00 $ |
| Claude Fable 5.1 | 10,00 $ | 0,25 $ | 50,00 $ |
| Muse Spark 1.3 | 1,25 $ | 0,15 $ | 4,25 $ |
Muse Wonder und Opus 5.5 kosten auf den Cent genau dasselbe, auch beim gecachten Preis. Gib unten dein eigenes Monatsvolumen ein, um die Lücke zu den anderen zu sehen.
Muse-Code-Abos, der einzige Weg zu Wonder Full, gibt es in vier Tarifen:
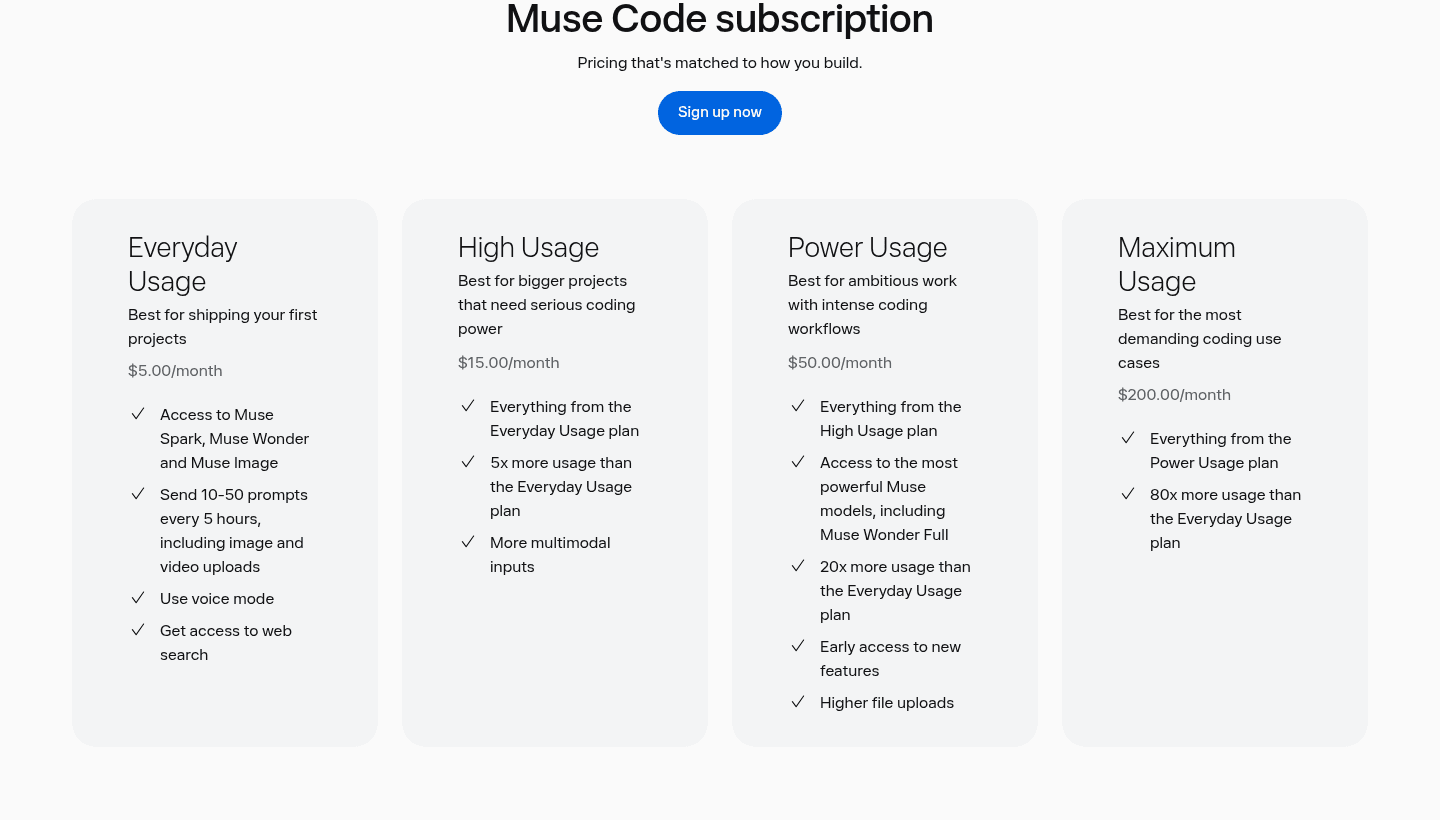
| Tarif | Preis | Nutzung | Wonder | Wonder Full |
|---|---|---|---|---|
| Everyday Usage | 5 $/Monat | 10-50 Prompts alle 5 Stunden | Ja | Nein |
| High Usage | 15 $/Monat | 5x Everyday | Ja | Nein |
| Power Usage | 50 $/Monat | 20x Everyday | Ja | Ja |
| Maximum Usage | 200 $/Monat | 80x Everyday | Ja | Ja |
Die Preise stammen von der Muse-Code-Seite; die Tarifregeln stehen in der Abo-Dokumentation. Das Kleingedruckte lohnt sich: Du musst mindestens 18 sein, die Verfügbarkeit „kann je nach Region variieren“, bei Kündigung gibt es keine Rückerstattung, und Meta kann ein Abo bei einem Richtlinienverstoß sofort entziehen. Ein Abo-Schlüssel funktioniert außerdem nur innerhalb der Muse-Code-CLI, du kannst also den Traffic deiner App nicht über einen 50-$-Tarif leiten. Die vollen Kosten des Coding-Agenten selbst findest du in meiner Aufschlüsselung zu den Muse-Code-Preisen.
Beim Einstiegstarif fand ein früher Nutzer die Limits knapp:
"The usage limits on their basic $5 code plan to try things out are ludicrously low?"
Er berichtete, dass drei kurze Prompts 17 % seines Wochenkontingents verbraucht hätten. Da Wonder Full ohnehin erst ab der 50-$-Stufe beginnt, würde ich für Power Usage budgetieren, wenn Full dein Grund ist.
Active Memory und Active Focus: was wirklich neu ist
Meta stellt Wonder um zwei benannte Fähigkeiten herum auf. Active Memory bedeutet, „wichtigen Kontext über dich über Gespräche hinweg mitzuführen und die für die aktuelle Aufgabe relevanten Details aktiv abzurufen“. Active Focus beschreibt, wie das Modell auf ein schwieriges Ziel hinarbeitet: „alternative Ansätze ausprobieren, Hindernisse durcharbeiten und sich an neue Informationen anpassen“, während es Rückfragen stellt und sich „vor wichtigen Aktionen“ rückversichert.
Beide spiegeln sich in Zeilen der Tabelle. MemoryBench ist die einzige Stelle, an der das schlichte Wonder klar gewinnt (85,6), und SWE-Marathon ist die Stelle, an der Fulls Vorsprung am größten ist (57,5 gegen 46,3 bei Opus 5.5). Das passt zu Metas Entwicklerdokumentation, die Wonder für „lang laufende, komplexe Aufgaben anpreist, bei denen Leistungsfähigkeit wichtiger ist als Kosten pro Token, etwa Änderungen über mehrere Dateien, mehrstündige Agentenläufe und Sub-Agent-Orchestrierung“, und alles mit hohem Volumen oder Latenzempfindlichkeit zurück zu Muse Spark verweist.
Die Launch-Demos sind eher persönlich als unternehmensbezogen: ein App-übergreifend erstellter Laufplan, individuelle Merchandise-Artikel aus Instagram-Fotos bestellt, ein Sitzplan für eine Hochzeit, ein Versicherungsfall. Das ist ein Vorgeschmack darauf, wohin dieses Modell geht, nämlich in den persönlichen Agenten Muse, den Wonder laut Meta „bald antreiben wird“, beginnend mit Abonnenten.
Zur Sicherheit nennt Meta Wonder sein „bisher am besten ausgerichtetes Modell“ mit den stärksten Schutzmaßnahmen gegen chemischen, biologischen und Cyber-Missbrauch, wobei defensive Cyber-Arbeit im Rahmen seines Scaling-Frameworks weiterhin erlaubt ist. Der vollständige Sicherheitsbericht ist als „bald verfügbar“ angegeben, dieser Teil lässt sich also noch nicht prüfen.
Daten und Zugang: Der Contributor-Modus ist standardmäßig an
Das ist die Einstellung, die ich vor allem anderen prüfen würde.
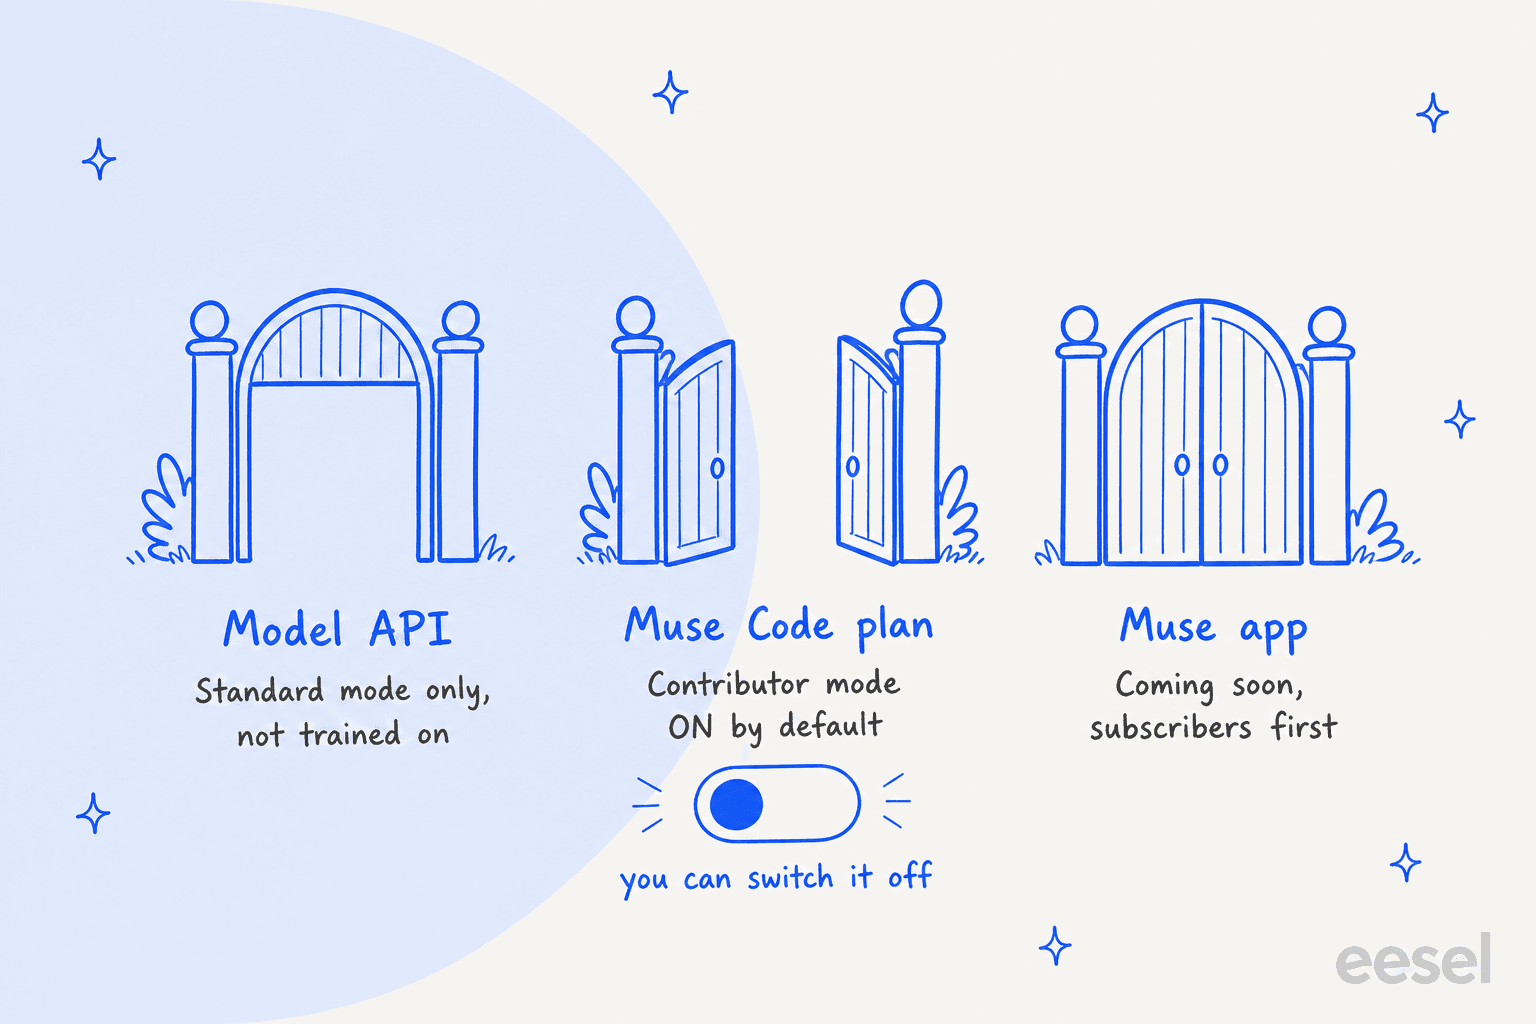
In der API läuft Muse Wonder nur im Standard-Modus: Laut Metas Dokumentation werden deine Inhalte „nicht zum Training von Meta-Modellen verwendet“. In Muse Code ist es umgekehrt. Die Abo-Seite sagt: „Muse-Code-Abos nutzen standardmäßig den Contributor-Modus“, der dir mehr Nutzung gibt, „im Gegenzug dafür, dass Meta deine Inhalte zum Training künftiger Meta-Modelle nutzt“. Inhalte bedeutet deine Prompts, deinen Code, deine Dateien und deinen Kontext, plus die Antworten. Du kannst ihn jederzeit abschalten, und ab dann werden neue Inhalte nicht mehr verwendet.
Der günstigste Weg zu Wonder Full, ein Muse-Code-Tarif, ist also auch der, der mit deinem Code trainiert, solange du keine Einstellung änderst. Für ein Hobbyprojekt ist das ein fairer Tausch. Bei einem Firmen-Repository solltest du es gleich am ersten Tag abschalten.
Diese Frage kommt in Verkaufsgesprächen bei eesel häufiger auf als jeder Benchmark. Ein technischer Evaluator eines Hardware-Unternehmens fragte einmal in einer Demo, ob eesel heimlich auf ein anderes ChatGPT zurückfällt, wenn es eine Antwort nicht kennt, und ob sich das abschalten lässt. Was er wollte, war einfach: Antworten nur aus seinem freigegebenen Wissen, und sein Wissen bleibt seins. Welches Frontier-Modell darunter liegt, war ihm weit weniger wichtig als diese Regel.
Was frühe Nutzer sagen
Das Urteil der Community nach zwei Tagen lautet: „beeindruckende Zahlen, prüf es selbst nach“. Ein paar Praxisberichte stachen heraus.
Beim Sehen hatte das schlichte Wonder im Test eines Entwicklers Schwierigkeiten:
"Image->HTML test for Muse Wonder. It's much worse than Opus 5.5. IMO it's closer to Sonnet or Haiku for this test."
Er bestätigte später, dass es das schlichte Wonder war, da Full nicht auf OpenRouter verfügbar war, also dieselbe Lücke wie im Abschnitt oben, nur in der Praxis sichtbar.
Beim Harness hatte ein zahlender Nutzer Einrichtungsprobleme, noch bevor das Modell überhaupt eine Rolle spielte:
"I paid them for a month to try out Muse Code, but their sandbox never worked across Mac or Linux (both very stock installs, nothing special)."
Und zur Muse-Reihe insgesamt sind regelmäßige Nutzer des Vorgängermodells optimistisch. Einer schrieb, Muse Spark 1.3 sei „sehr schnell und leistungsstark“ und sein „Arbeitspferd für Open-Source-Entwicklung“. Ein anderer Kommentator merkte an, das Abo gebe es vorerst nur in Nordamerika, während die API über OpenRouter erreichbar ist.
Vor- und Nachteile
Vorteile
- Wonder Full liegt mit Opus 5.5 gleichauf, je sechs Siege in Metas Tabelle mit 14 Zeilen, und führt klar bei Recht (13,1 gegen 4,2) und ultralangen Entwicklungsaufgaben (57,5 gegen 46,3)
- Zum Launch Platz zwei im Artificial-Analysis-Index (56), Metas mit Abstand bestes Ergebnis
- Saubere API-Preisliste: kein Aufschlag für langen Kontext, nicht abgerechnete Steering-Tokens, gecachter Input für 0,20 $
- 1M-Token-Kontext, fünf Eingabetypen und großzügige Limits von 3.000 RPM / 4M TPM von Anfang an
- Auf OpenRouter verfügbar, du kannst es also in Tools testen, die du schon nutzt
Nachteile
- Das API-Modell (52 bei AA) ist nicht das Modell hinter den Spitzenwerten und kostet dasselbe wie Opus 5.5 (58)
- Wonder Full ist an Muse-Code-Abos für 50 $ oder 200 $ im Monat gebunden, ohne Weg über Token-Preise
- Muse-Code-Tarife nutzen standardmäßig den Contributor-Modus, der mit deinen Inhalten trainiert, bis du ihn abschaltest
- Preview-Status, ein Sicherheitsbericht, der noch „bald verfügbar“ ist, und Leaderboard-Platzierungen, die sich noch am selben Tag verschoben
- Das schlichte Wonder liegt bei Computer-Nutzung, Terminal-Coding und Programmieren von Grund auf hinter Opus 5.5
Wer sollte Meta Muse Wonder nutzen?
Wähle Wonder Full, wenn du als einzelner Entwickler oder kleines Team lange Coding-Projekte, juristische Entwürfe oder Finanzrecherche machst und 50 $ im Monat für Muse Code leicht zu rechtfertigen sind. Schalte vorher den Contributor-Modus ab. Es ist der bisher stärkste Grund, Metas Coding-Agenten auszuprobieren, und die Muse-Code-Alternativen sind beim gleichen Budget einen Blick wert.
Wähle das schlichte Muse Wonder in der API, wenn du lange Agentenläufe mit starkem Gedächtnis brauchst und neben Anthropic einen zweiten Frontier-Anbieter willst. Bei identischem Preis würde ich es an deinen eigenen Aufgaben gegen Opus 5.5 testen, bevor ich Produktions-Traffic verschiebe.
Lass es vorerst bleiben, wenn du vor allem Computer-Nutzung oder Code-Generierung von Grund auf brauchst, wo Opus 5.5 weiter führt, oder wenn dein Workload hohes Volumen hat und preissensibel ist, wo Metas eigene Dokumentation dich zu Muse Spark verweist. Wenn du breit vergleichst, decken meine Übersicht der besten KI-Coding-Assistenten und der Leitfaden zu den Claude-Code-Preisen die anderen Optionen ab.
Und wenn du Support-Leiter bist, ist eine Modellveröffentlichung der falsche Startpunkt. Wonder kann einen KI-Agenten antreiben, aber jemand muss es trotzdem an dein Helpdesk anbinden, es in deinem Wissen halten, entscheiden, wann es übergibt, und beweisen, dass es richtig liegt, bevor es einen Kunden berührt. Das ist der Unterschied zwischen einem Modell und einem Teammate, und deshalb ist die Wahl des besten Modells für Support-Tickets nur der erste Schritt. Meine Notizen zur Nutzung von Muse für Zendesk zeigen, wie viel Klebearbeit dafür nötig ist.
eesel einstellen, statt ein Modell zu verdrahten
Muse Wonder ist Infrastruktur; eesel ist die Fachkraft. eesel ist eine KI-Teammate-Plattform, auf der du einsatzbereite Teammates für bestimmte Aufgaben einstellst, und derzeit sind das zwei Rollen: ein KI-Helpdesk-Teammate und ein KI-Blog-Autor.
Für Support-Teams bindet sich das Helpdesk-Teammate an Zendesk, Freshdesk oder Gorgias an, lernt aus deinen bisherigen Tickets, deinem Help Center und deinen Dokumenten und antwortet nur mit dem, was du freigegeben hast. Bevor es irgendjemandem antwortet, kannst du es an deinen historischen Tickets simulieren und genau sehen, was es gesagt hätte. Ich habe einen selbstsicher klingenden Bot in einer Live-Warteschlange eine falsche Antwort geben sehen, deshalb gibt es diesen Testlauf. Die Tarife sind eine monatliche Pauschale, bei der ein Ticket einem Credit entspricht, ab 299 $/Monat für 500 Credits, mit 100 kostenlosen Credits zum Ausprobieren, laut eesel-Preisseite.

Wenn du über Muse Wonder gelesen hast, weil du KI willst, die deine Warteschlange abarbeitet, spar dir die Modellsuche. Probier eesel kostenlos aus und sieh zu, wie es Antworten auf deine eigenen Tickets entwirft.