

Was ist Meta Muse Spark Open?
Ich baue bei eesel beruflich KI-Agenten, und das Erste, was ich bei jedem neuen Modell tue, ist, die Model Card vor dem Launch-Beitrag zu lesen. Die Muse Spark Open Model Card auf Hugging Face beschreibt ein Mixture-of-Experts-Modell mit 816B Parametern, das pro Token 42B Parameter aktiviert, mit 256 Experten und 8 aktiven pro Token, einem Kontextfenster von 1M Tokens und einem angeflanschten Vision-Encoder mit 1,8B Parametern für Bilder und Video.
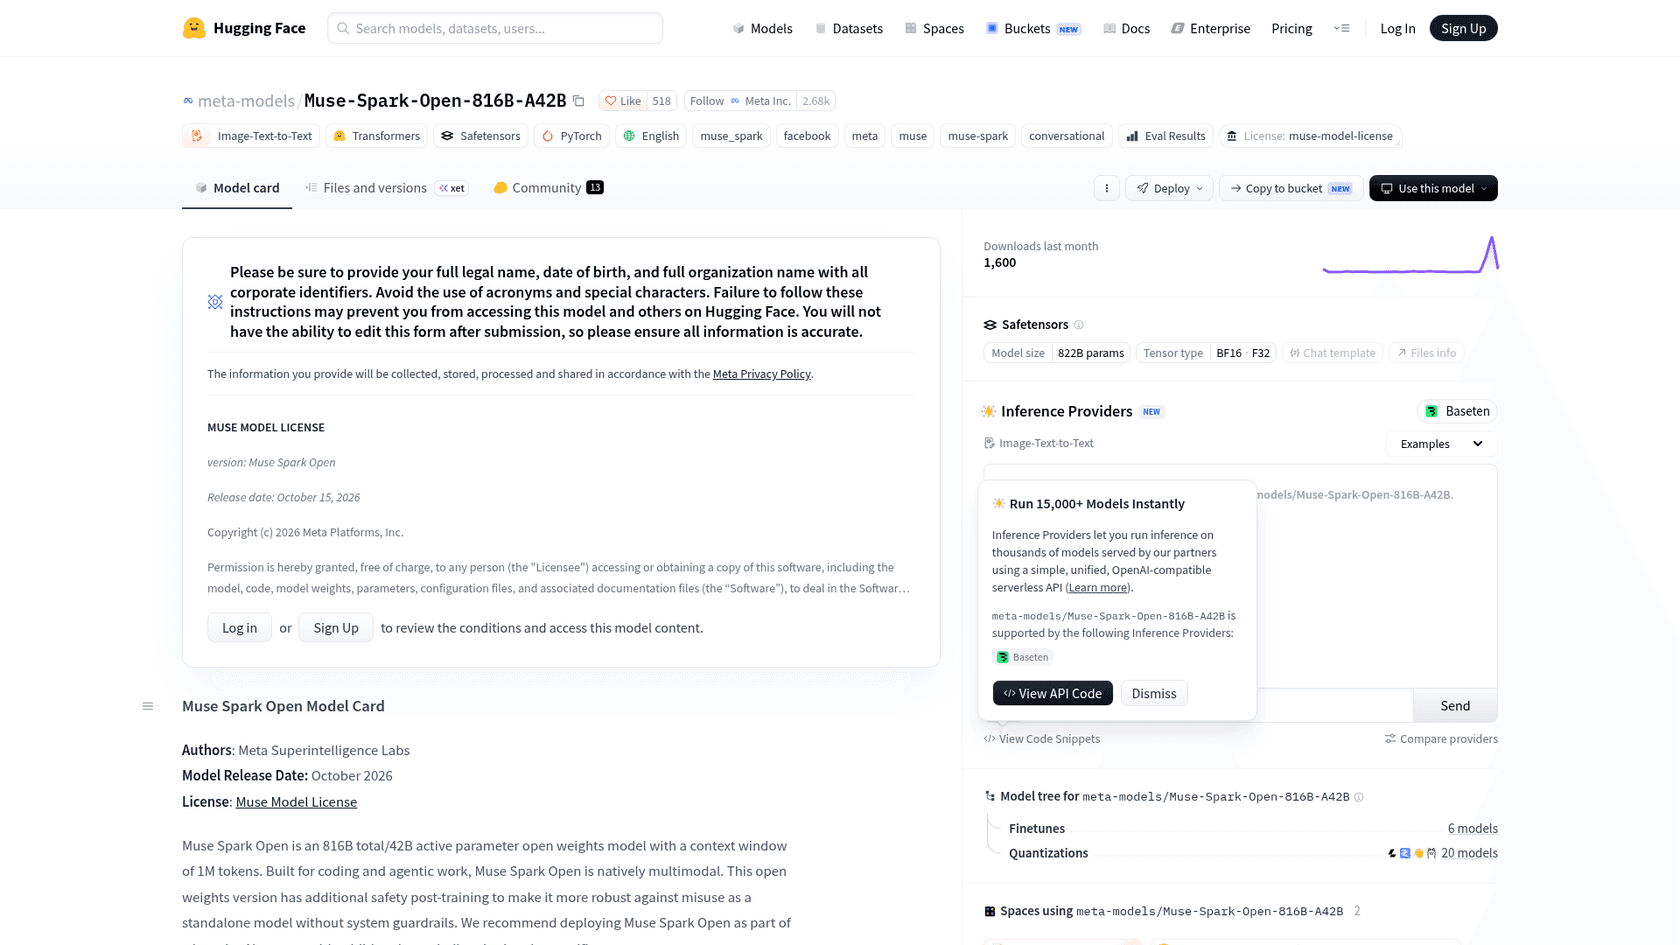
Es ist das Open-Weight-Schwestermodell der geschlossenen Muse Spark-Reihe, keine eigene Familie. Der Name Muse umfasst auch Muse Code, Metas Coding-Umgebung, und den persönlichen Muse-Agenten.
Metas Forschungsbeitrag nennt es "das leistungsfähigste offene US-Modell bisher" und sagt, es werde mit zusätzlichem Sicherheits-Post-Training ausgeliefert, weil nach der Veröffentlichung der Gewichte niemand mehr serverseitig Leitplanken hinzufügen kann. Der Entwicklerbeitrag ergänzt ein Detail, das für meine Welt zählt: Meta hat es für langfristige Agenten-Arbeit trainiert, "wie Coding- und Kundenservice-Agenten".
Ein paar praktische Eckdaten aus der Card:
| Spezifikation | Muse Spark Open |
|---|---|
| Parameter | 816B insgesamt, 42B aktiv |
| Kontext | 1M Tokens |
| Eingabe | Text, Bild, Video, Audio |
| Ausgabe | Text |
| Reasoning-Aufwand | low, medium, high, xhigh (Standard xhigh) |
| Gewichte | BF16 (etwa 1,6 TB) und NVFP4 (etwa 530 GB) |
| Veröffentlichung | 15. Oktober 2026 |
Eines noch: Reasoning ist immer an. Groqs Modellseite sagt, es "denkt immer nach, bevor es antwortet", und der Standardaufwand ist die teuerste Stufe, xhigh. Wenn Sie kurze, günstige Antworten wollen, müssen Sie selbst low oder medium anfordern.
Wie ich es bewertet habe
Ich habe dieses Modell nicht ein Jahr lang in einer Support-Warteschlange laufen lassen und tue nicht so, als hätte ich es. Dieser Test basiert auf Metas eigener Benchmark-Tabelle, den unabhängigen Ergebnissen von Artificial Analysis, den Live-Preis- und Geschwindigkeitsdaten bei jedem Launch-Anbieter, dem vollständigen Lizenztext und dem, was Entwickler in den ersten 72 Stunden auf Hacker News sagten. Wo Metas Zahlen und unabhängige Zahlen voneinander abweichen, sage ich das.
Meine Perspektive ist dieselbe, mit der ich bei eesel Modelle für den Helpdesk-Teamkollegen auswähle: Ruft es Tools zuverlässig auf, hält es sich an die Regeln, und was kostet ein Monat echter Traffic. Ich habe bei eesel jahrelang gesehen, wie selbstsichere Modelle in Live-Warteschlangen falsche Antworten geben, weshalb jeder eesel-Rollout zuerst gegen historische Tickets simuliert wird. Ein Benchmark-Sieg zählt nur, wenn er sich dort zeigt, und genau das ist die Idee hinter KI-Teamkollegen, die vor dem Livegang an Ihren Daten getestet werden.
Wo Muse Spark Open vorne liegt
Meta vergleicht das Modell mit sieben anderen Open-Weight-Modellen: Inkling, Nemotron 3 Ultra, Reflection Beam, Mistral Large 4, Qwen 3.8, GLM 5.3 und Kimi K3. Hier ist die Ergebnistabelle, wie Meta sie veröffentlicht hat.
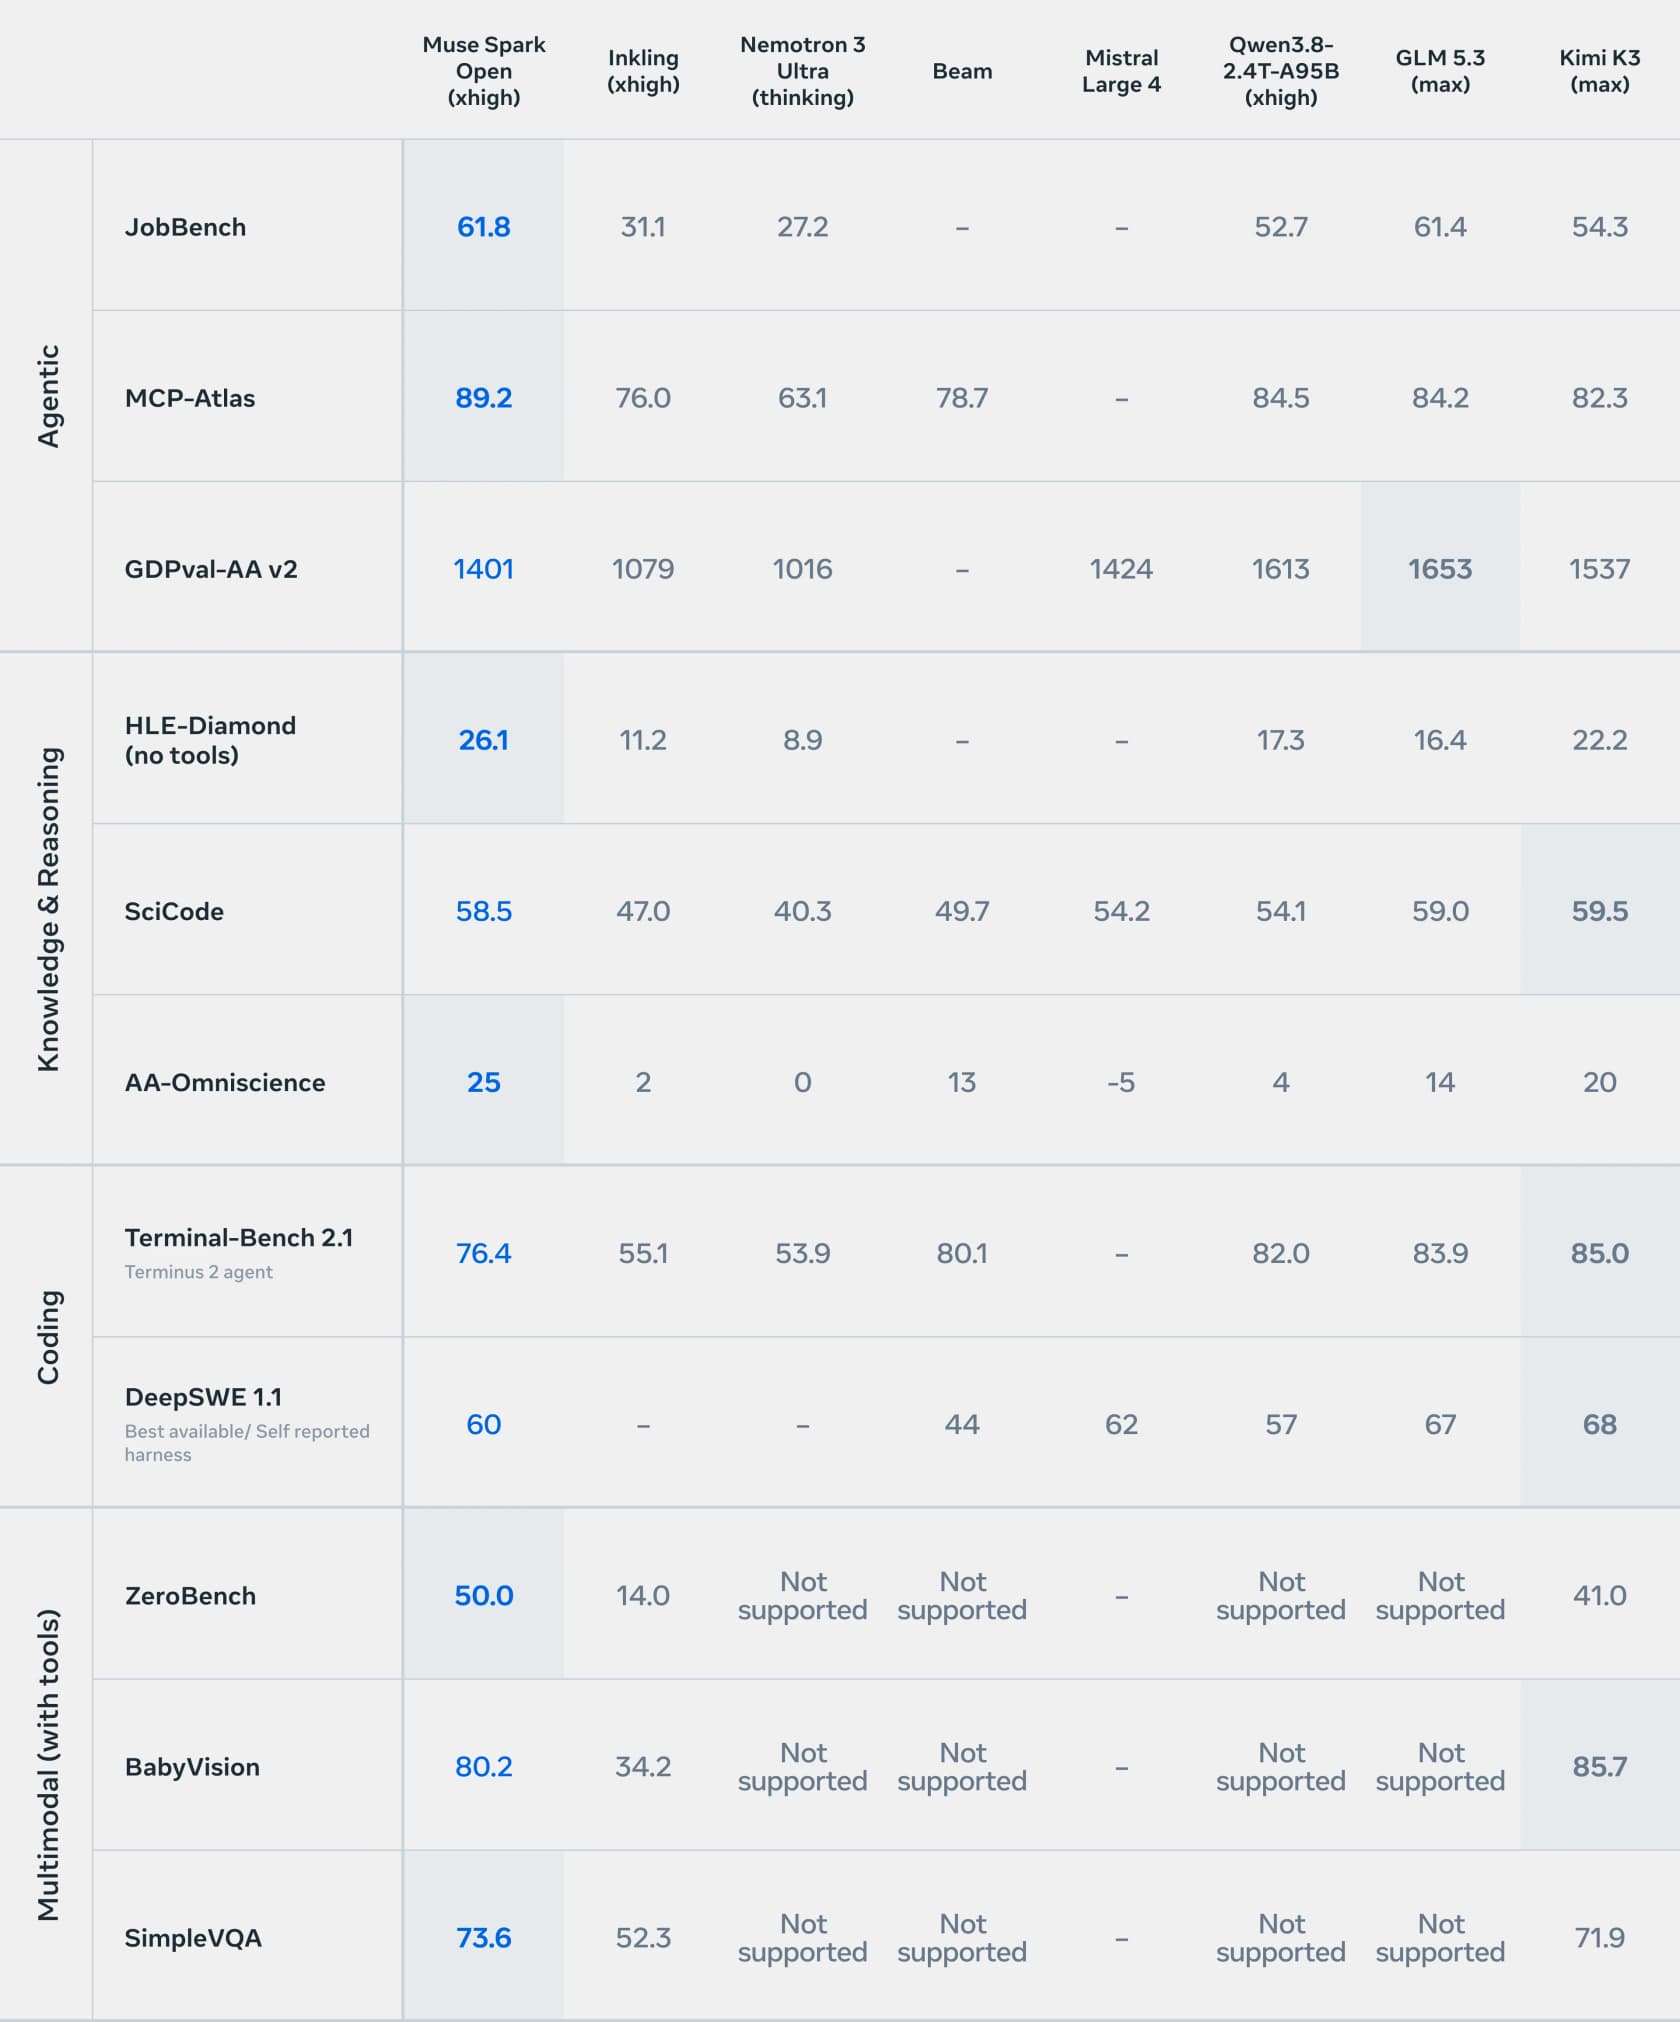
Die Siege sind real, und sie bündeln sich an einer Stelle: Agenten, die Tools aufrufen.
- MCP-Atlas
89.2, der Spitzenwert der Tabelle. Das testet den Aufruf von Tools, die über MCP-Server bereitgestellt werden, die Infrastruktur, über die die meisten Agenten heute Helpdesk, CRM oder Datenbank erreichen. - JobBench
61.8, knapp vor GLM 5.3 mit61.4und deutlich vor Kimi K3 mit54.3. - HLE-Diamond
26.1ohne Tools und AA-Omniscience25, jeweils das Beste im Feld bei schwierigen Wissensfragen, bei denen Erfundenes bestraft wird. - Multimodal: Es führt bei ZeroBench (
50.0) und SimpleVQA (73.6) gegenüber dem einzigen anderen Modell, das diese Tests unterstützt, Kimi K3.
Die beiden Launch-Partner, die Meta zitiert, passen zu diesem Bild.
"Muse Spark Open hat durchgehend das richtige nächste Tool gewählt und seine Antworten kompakt gehalten, genau die Entschlossenheit, die produktive Agenten brauchen."
Zimu Li, Member of Technical Staff bei Factory, zitiert im Entwicklerbeitrag von Meta
Unabhängige Daten bestätigen die Effizienz. Artificial Analysis maß 110M Output-Tokens, um den gesamten Index abzuschließen, unter dem Median von 130M, und 130.7 Tokens pro Sekunde. Das ist wichtig, weil das geschlossene Schwestermodell in die andere Richtung ging: Wie ich in meinem Muse Spark 1.3 Test beschrieben habe, verbrauchte 1.3 120M Tokens und sorgte für Beschwerden über Weitschweifigkeit.
Wo es zurückliegt
Dieselbe Tabelle, die es bei der Tool-Nutzung krönt, zeigt es als Verlierer in den Kategorien, nach denen die meisten Entwickler einkaufen.
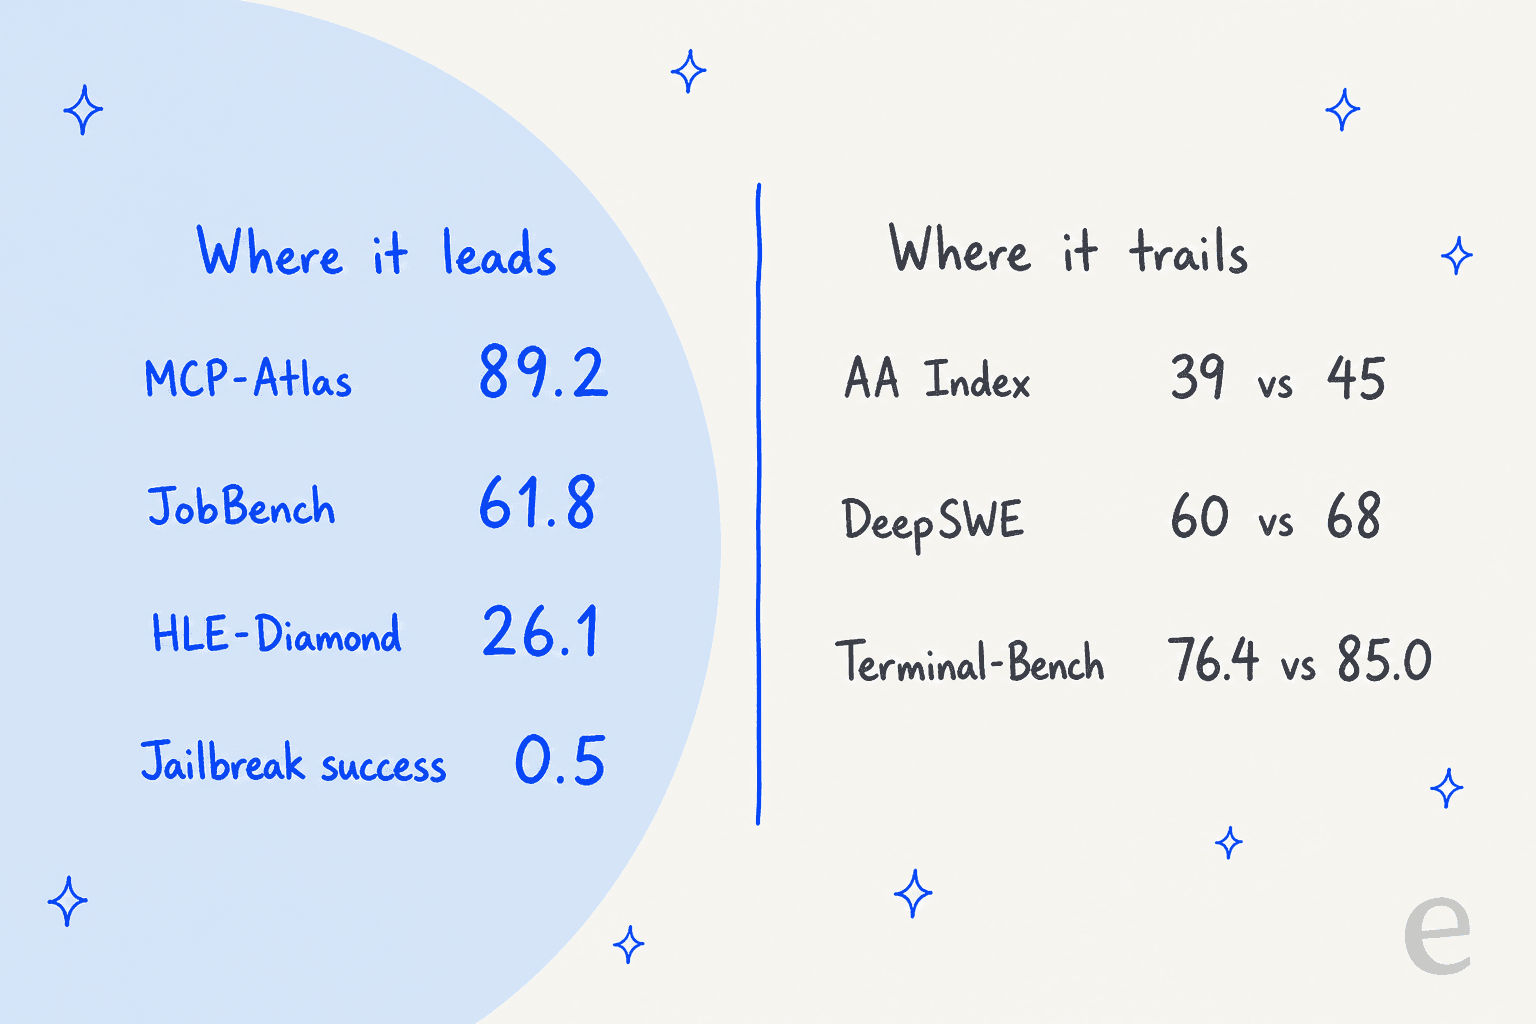
- Allgemeine Intelligenz. In der Zeile des Artificial Analysis Intelligence Index in Metas eigener Tabelle erreicht es
39, hinter GLM 5.3 (45), Kimi K3 (44) und Qwen 3.8 (40), und einen Punkt vor Mistral Large 4 (38). Artificial Analysis stuft es auf Platz#10von 120 verfolgten Modellen ein. - Coding. Bei DeepSWE 1.1 erreicht es
60gegenüber68bei Kimi K3 und67bei GLM 5.3. Bei Terminal-Bench 2.1 erreicht es76.4gegenüber85.0bei Kimi K3. Selbst Reflection Beam schlägt es dort mit80.1. - Praxisnahe Arbeitsaufgaben. Bei GDPval-AA v2 erreicht es
1401, unter Mistral Large 4 (1424), Kimi K3 (1537), Qwen 3.8 (1613) und GLM 5.3 (1653).
Entwicklern ist das aufgefallen. Der am häufigsten zitierte frühe Eindruck im Launch-Thread war kurz:
"Fühlt sich dümmer an als GLM 5.3 (das einzige offene Modell, das ich intensiv nutze). Aber ist wirklich schnell (fireworks.ai)."

Ein anderer Kommentator ordnete es zwischen seinen beiden geschlossenen Geschwistern ein: "etwas schlechtere Benchmarks als Muse Spark 1.3, eher bei 1.2" (modeless, Hacker News). Das deckt sich mit den Zahlen. Wenn Ihre Hauptaufgabe das Schreiben von Code ist, ist Kimi K3 oder GLM 5.3 heute die bessere offene Wahl.
Der Sicherheits-Kompromiss, den niemand erwähnt
Meta stellt die Sicherheit in den Vordergrund, und die Schlagzeilenzahl ist beeindruckend. Bei StrongREJECT v2, einem adaptiven Jailbreak-Test, bei dem niedriger besser ist, erreicht Muse Spark Open 0.5. Kimi K3 erreicht 66.6, GLM 5.3 62.9, Qwen 3.8 65.6. Die Card nennt außerdem 99.2% Ablehnung von Cyber-Jailbreaks im internen Benchmark von Meta und eine Ehrlichkeitsrate von 98.1% bei MASK.
Doch dieselbe Tabelle enthält eine zweite Zahl, die die meiste Berichterstattung übersprungen hat. FORTRESS meldet zwei Werte: einen Adversarial Risk Score (ARS, wie oft es schädliche Hilfe gibt) und einen Over-Refusal Score (ORS, wie oft es Dinge ablehnt, die es beantworten sollte). Bei beiden ist niedriger besser.
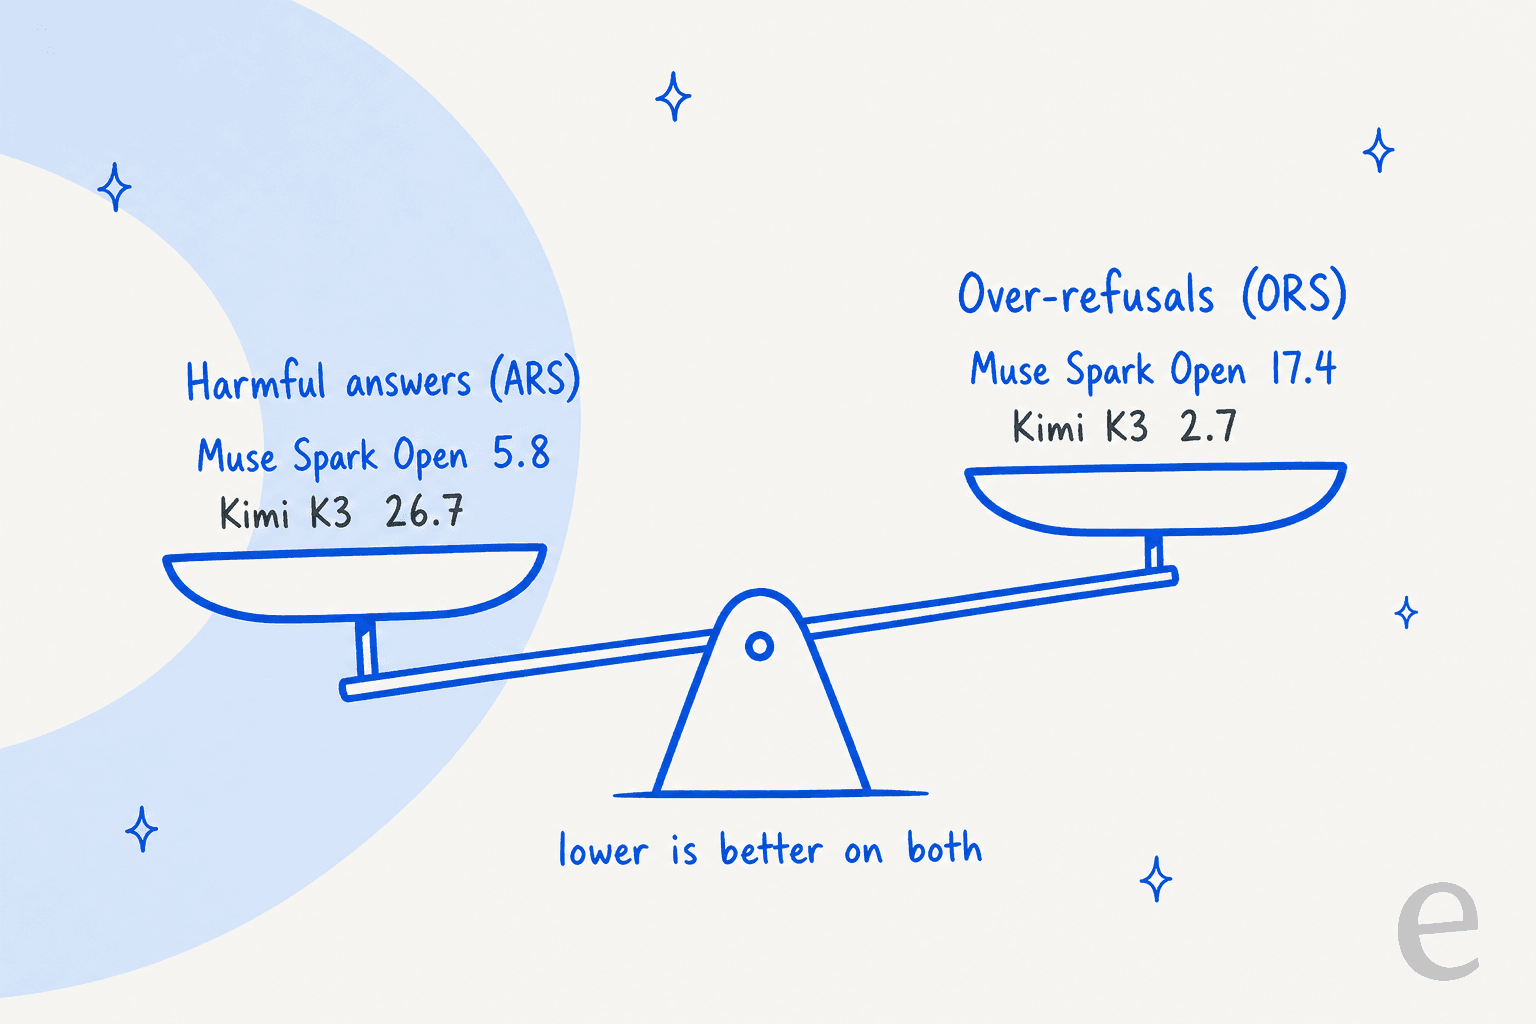
Der ORS von Muse Spark Open liegt bei 17.4. Bei Kimi K3 sind es 2.7, bei GLM 5.3 3.2. Einfach gesagt: Es ist das Modell in der Tabelle, das sich am schwersten austricksen lässt, und das, das am ehesten Nein zu einer berechtigten Anfrage sagt. Für einen Kundenservice-Agenten ist das ein echter Kompromiss. Eine ungeschickt formulierte Erstattungsfrage oder ein Kunde, der einen Defekt an einem Medizinprodukt beschreibt, sind genau die harmlosen Nachrichten, die ein übervorsichtiges Modell ablehnen kann. Ich würde es an Ihren eigenen unordentlichen Tickets testen, bevor ich der Sicherheits-Schlagzeile in die eine oder andere Richtung traue.
Preise: offene Gewichte, Tarife wie bei geschlossenen Modellen
Das hat mich am meisten überrascht. Jeder Launch-Anbieter auf OpenRouter verlangt exakt denselben Preis.
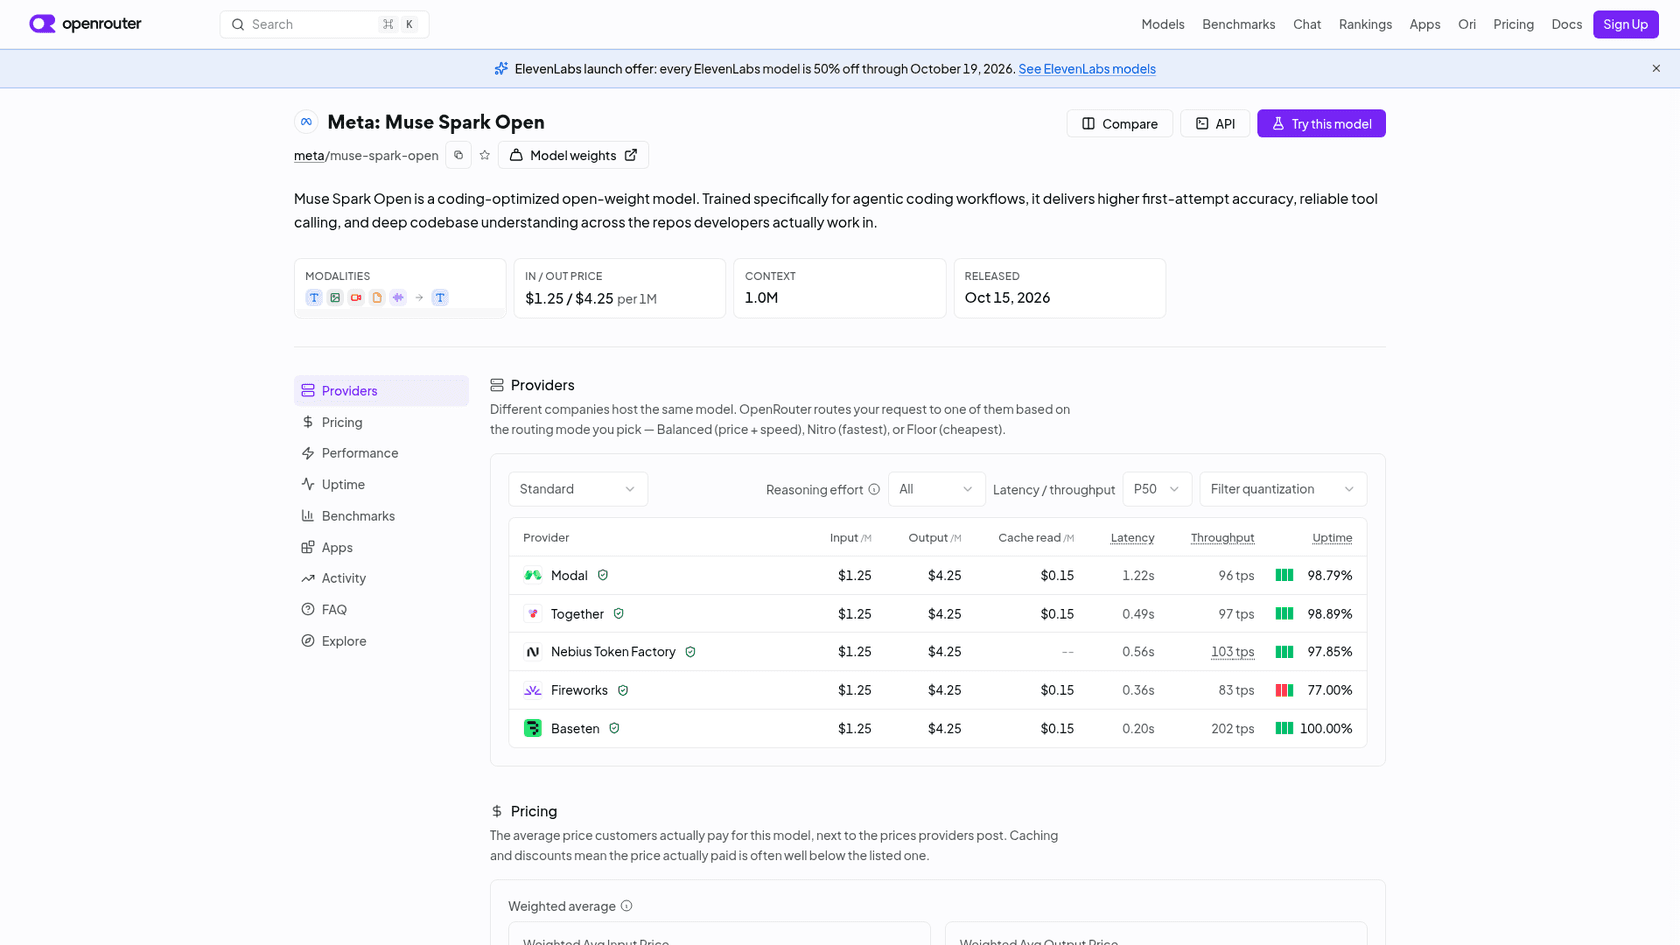
| Anbieter | Input / 1M | Output / 1M | Gecachter Input / 1M | Hinweise |
|---|---|---|---|---|
| Baseten | $1.25 | $4.25 | $0.15 | NVFP4, 1M Kontext, etwa 200 Tokens/Sek., siehe Baseten-Preise |
| Fireworks AI | $1.25 | $4.25 | $0.15 | Serverless-LoRA-Fine-Tuning, siehe Fireworks-Preise |
| Together AI | $1.25 | $4.25 | $0.15 | Dedizierte Endpunkte mit 99,9 % SLA, siehe Together-Preise |
| Modal | $1.25 | $4.25 | $0.15 | Geteilte oder dedizierte Endpunkte |
| Nebius Token Factory | $1.25 | $4.25 | n/a | |
| Groq | Nicht gelistet | Nicht gelistet | n/a | Limitierte Vorschau, 131K Kontext, ~350+ Tokens/Sek. |
Dieser Tarif von $1.25 / $4.25 ist identisch mit dem, was Meta für sein geschlossenes Muse Spark 1.3 bei xhigh verlangt. Artificial Analysis sagt es direkt: Das Modell sei "besonders teuer im Vergleich zu anderen Open-Weight-Modellen ähnlicher Größe", bei einem Median von $0.43 für Input und $1.68 für Output. Die Kosten für eine Index-Aufgabe liegen bei $0.84.
Warum landen fünf konkurrierende Anbieter beim selben Preis? Die Lizenz ist der wahrscheinliche Grund. Ein Entwickler im Launch-Thread hat es ausgesprochen:
"Die Modelllizenz verlangt von großen Inferenz-Anbietern, sich separat an Meta zu wenden, um eine Lizenz zum Betrieb des Modells zu erhalten... Der übliche Effekt separater Lizenzierung ist weniger Preiswettbewerb unter öffentlichen Anbietern."
Das faire Gegenargument aus demselben Thread: Ein fester Preis hindert Anbieter auch daran, eine kaputte oder abgespeckte Version anzubieten, um sich gegenseitig zu unterbieten (dannyw, Hacker News). Beides kann stimmen.
Was kostet das in der Praxis? Ein grobes Rechenbeispiel für einen Agenten, der viel liest und wenig schreibt (Output mit $4.25 pro Million):
| Monatliches Volumen | Input | Output | Ungefähre Monatsrechnung |
|---|---|---|---|
| Kleiner Pilot | 10M Tokens | 2M Tokens | $21 |
| Ein ausgelasteter Agent | 100M Tokens | 20M Tokens | $210 |
| Rollout im ganzen Team | 1B Tokens | 200M Tokens | $2,100 |
Das Cachen wiederholten Kontexts für $0.15 statt $1.25 kann die Input-Seite deutlich senken, wenn Ihr Agent bei jedem Aufruf dieselbe Wissensbasis nutzt. Denken Sie daran, dass xhigh-Reasoning der Standard ist; wechseln Sie für kurze Antworten auf medium.
Selbst betreiben: was die Hardware wirklich verlangt
Der Pitch, der am meisten Aufmerksamkeit bekam, kam von Apple: ein Frontier-Modell auf dem eigenen Schreibtisch betreiben. Apples MLX-Beitrag ist ehrlich darüber, was das bedeutet. Die NVFP4-Gewichte brauchen etwa 493GB, und mit Arbeitsspeicher obendrauf "passt das Modell nicht auf eine einzelne Maschine".
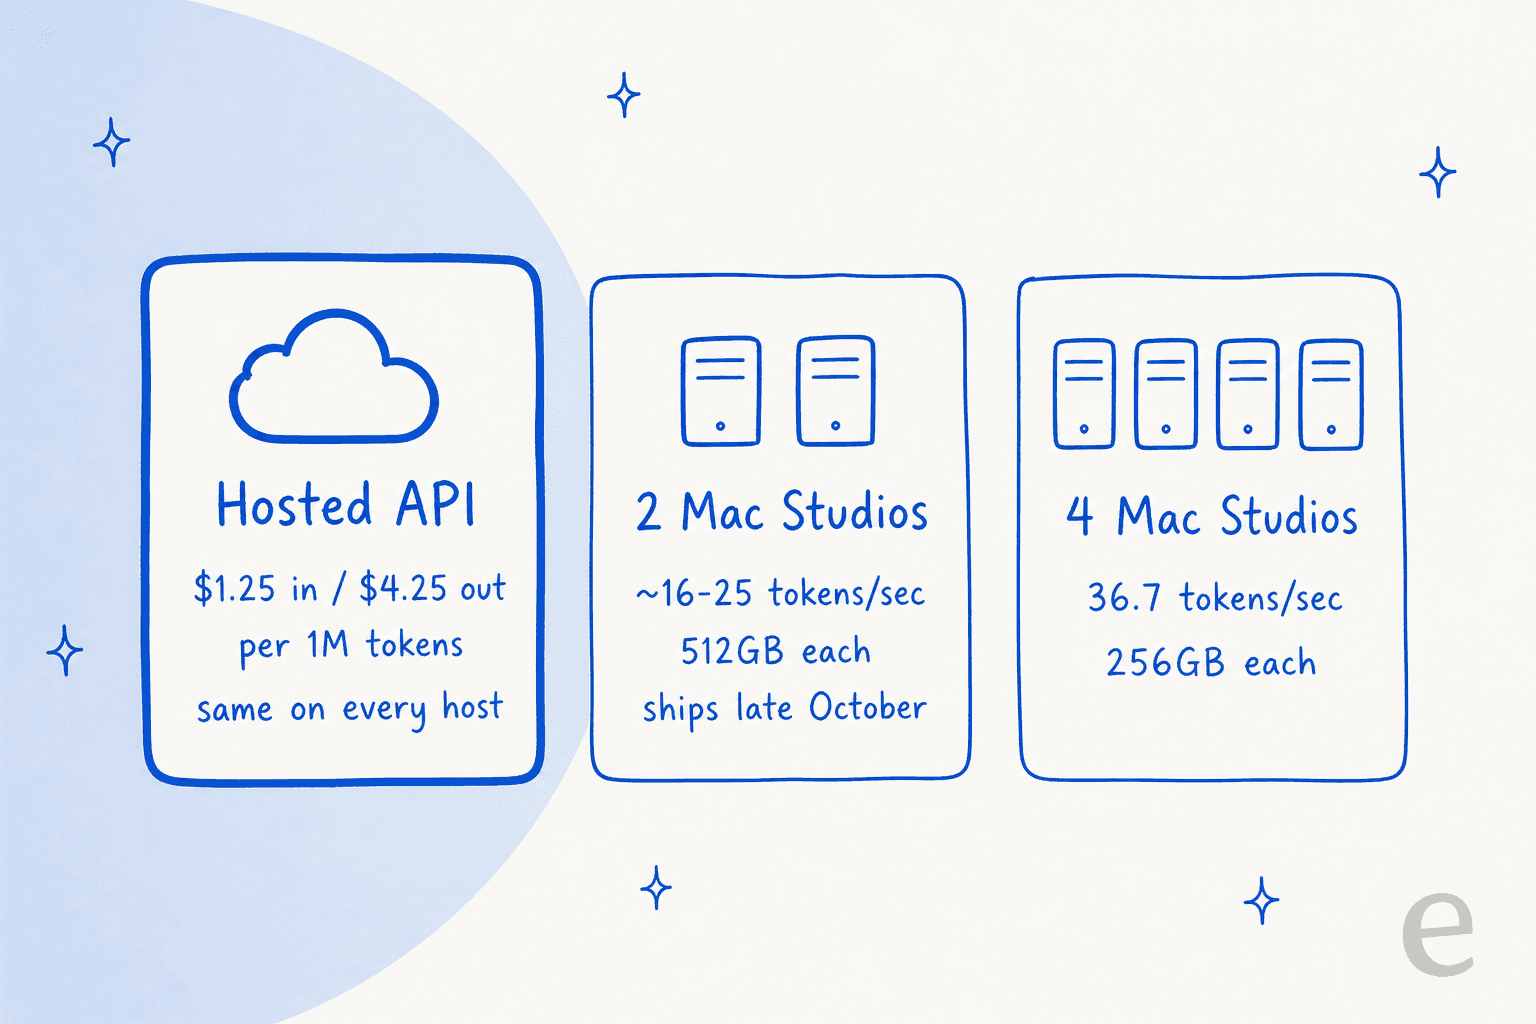
Apples gemessene Decode-Geschwindigkeiten bei einem Kontext von 8.192 Tokens:
| Aufbau | Decode-Geschwindigkeit |
|---|---|
| 2 Mac Studios (M5 Ultra), Pipeline-Split | 15.74 Tokens/Sek. |
| 2 Mac Studios (M5 Ultra), Tensor-Split | 24.99 Tokens/Sek. |
| 4 Mac Studios (M5 Ultra), Tensor-Split | 36.73 Tokens/Sek. |
Der Aufbau mit zwei Maschinen braucht den M5 Ultra mit 512 GB, den Apples Store mit "erscheint Ende Oktober" listet, noch ohne Preisangabe. M5-Ultra-Konfigurationen mit deutlich weniger Speicher starten bei $5,499. Ein Kommentator fasste die Reaktion zusammen:
"Ein einzelner Mac Studio mit M5 Ultra und halb so viel RAM (256 GB) kostet etwa 11.000 Dollar, und die 512-GB-Option ist noch nicht einmal verfügbar. Also... ja."
Auf GPUs verlangt die Model Card mindestens 700GB VRAM für NVFP4 und 2TB für BF16; Metas Entwicklerbeitrag sagt, NVFP4 laufe auf vier Blackwell-Ultra-GPUs oder acht H200. Unsloths 2-Bit-Build bringt es mit gewissen Qualitätseinbußen auf etwa 300GB kombinierten Speicher.
Metas Verdienst ist, dass die Unterstützung am ersten Tag ungewöhnlich vollständig ist: SGLang, vLLM, TensorRT-LLM, Transformers, MLX, llama.cpp und Unsloth funktionierten zum Launch, mit Fine-Tuning über TorchTitan, Fireworks und Together. Wie ein Entwickler anmerkte, hat Meta "die eigentliche Arbeit gemacht, Deployments auf mehreren Plattformen zu testen und zu dokumentieren" (bahmboo, Hacker News).
Wer sollte also selbst hosten? Die Antwort aus dem Thread deckt sich mit meiner: Teams mit einem vertraglichen oder rechtlichen Grund, Daten auf eigener Hardware zu halten (mbreese, Hacker News). Für alle anderen bleibt eine gehostete API bei $210 im Monat für einen ausgelasteten Agenten noch lange günstiger als ein Aufbau mit zwei Macs, den Kommentatoren bereits über $20,000 ansetzen.
Das Kleingedruckte der Lizenz
Die Muse Model License ist an der Oberfläche großzügig: kostenlose Nutzung, Fine-Tuning, Distillation und Weiterverkauf. Die Bedingungen, auf die es ankommt:
- Namensnennung in Ihrem Produkt. Sie müssen "Built with Muse Spark Open" gut sichtbar in der Oberfläche, den Dokumenten, der Website oder den Einstellungen jedes Produkts anzeigen, das es oder etwas daraus Abgeleitetes nutzt, einschließlich Modellen, die auf seinen Ausgaben trainiert wurden.
- Eine Grenze von 20 Millionen Dollar für Anbieter. Wenn Sie Modellzugang als Dienst verkaufen und der Umsatz Ihres Unternehmens in einem beliebigen Zeitraum von 12 Monaten über
$20 millionliegt, brauchen Sie zuerst eine separate schriftliche Vereinbarung mit Meta. - Keine Nutzung unter 18. Die Nutzungsrichtlinie sagt, das Modell sei "nicht für Personen unter 18 Jahren vorgesehen", und Betreiber tragen die Verantwortung, wenn Minderjährige darauf zugreifen können.
- Eine weit gefasste Nutzungsrichtlinie. Sie untersagt die nicht lizenzierte Ausübung von Berufen (Recht, Medizin, Finanzen), die Verarbeitung sensibler personenbezogener Daten ohne entsprechendes Recht und die Darstellung von Ausgaben als von Menschen geschrieben.
Der vierte Punkt ist für Support-Teams in regulierten Branchen wichtig. Ein Agent, der Antworten für ein Gesundheits- oder Finanzunternehmen entwirft, braucht ohnehin ein Human-in-the-Loop-Design, und Metas eigene Card empfiehlt "Human-in-the-Loop-Bestätigung für nicht umkehrbare Aktionen". Ob es "Open Source" ist, ist eine berechtigte Debatte; im Launch-Thread nannten mehrere Entwickler es bestenfalls "Open-Weight" (isityettime, Hacker News).
Muse Spark Open im Vergleich zu den Alternativen
| Modell | AA Index (Metas Tabelle) | DeepSWE 1.1 | MCP-Atlas | StrongREJECT (niedriger ist besser) | Am besten für |
|---|---|---|---|---|---|
| Muse Spark Open | 39 | 60 | 89.2 | 0.5 | Agenten mit vielen Tools, vorsichtige Deployments |
| Kimi K3 | 44 | 68 | 82.3 | 66.6 | Offenes Coding und Terminal-Arbeit |
| GLM 5.3 | 45 | 67 | 84.2 | 62.9 | Bester offener Gesamtwert |
| Qwen 3.8 | 40 | 57 | 84.5 | 65.6 | Breite allgemeine Nutzung |
| Mistral Large 4 | 38 | 62 | n/a | n/a | In der EU gehostete Deployments |
Wenn Sie ein geschlossenes Modell nutzen können, wird der Abstand größer. Metas eigene Frontier-Stufe behandle ich in meinem Muse Wonder Test, und Claude Opus 5.5 bekommt dieselbe Behandlung in meinem Opus 5.5 Test. Beide erreichen im selben Index deutlich mehr als 39.
Wenn der Preis wichtiger ist als die Tool-Nutzung, starten Sie mit meinem DeepSeek V4 Flash Test. Qwen 3.8 ist das andere offene Modell, das einen Blick lohnt, behandelt in meinem Qwen 3.8 Test.
Fazit: für wen Muse Spark Open taugt
Bewertung: 3.5/5.
- Wählen Sie es, wenn Sie herunterladbare Gewichte brauchen, Ihr Agent davon lebt, das richtige Tool aufzurufen, und Sie lieber zu oft als zu selten eine Ablehnung in Kauf nehmen. Die MCP-Werte und das Sicherheits-Tuning sind echte Stärken.
- Lassen Sie es aus, wenn Sie hauptsächlich Code schreiben (Kimi K3 oder GLM 5.3), die günstigsten offenen Tokens wollen (die Untergrenze von
$1.25 / $4.25steht fest) oder erwartet haben, es auf einer Maschine zu betreiben. - Testen Sie vor dem Vertrauen die Über-Ablehnungsrate an Ihrem eigenen Traffic.
Die größere Lehre für Support-Teams ist, dass selten das Modell das Problem ist. In den eigenen Verkaufsgesprächen von eesel höre ich am häufigsten von einem Bot, der echten Kunden erfundene Details nannte, wenn die Wissensbasis nichts Passendes hatte. Ein anderer Käufer, ein technischer Evaluator bei einem Hardware-Unternehmen, fragte direkt, ob die KI auf allgemeines Webwissen zurückgreife, wenn sie etwas nicht weiß, und ob sich das abschalten lasse. Das sind Probleme von Retrieval, Leitplanken und Übergabe. Ein klügeres oder sichereres Modell löst sie nicht von allein. Mein Leitfaden zum Automatisieren des Supports mit KI-Agenten führt durch die Schichten, die das tun.
eesel für Ihren Helpdesk testen
Wenn Sie sich Muse Spark Open angesehen haben, weil Sie einen KI-Agenten für Ihre Support-Warteschlange wollen, erspart Ihnen der KI-Helpdesk-Teamkollege von eesel den GPU-Einkauf. Er verbindet sich in Minuten mit Zendesk, Freshdesk, Gorgias und mehr, lernt aus Ihren bisherigen Tickets und Ihrem Help Center und wird gegen Ihre historischen Tickets simuliert, bevor er einem einzigen Kunden antwortet. Sie entscheiden, welche Tickets er beantwortet, welche er als interne Notizen entwirft und wann er an einen Menschen übergibt.

Wenn Sie lieber selbst ein Modell einbinden möchten, zeigt mein Leitfaden zum Verbinden von Claude mit Ihrem Helpdesk, welcher Aufwand dahintersteckt. Metas eigener Weg wird in Muse für den Kundensupport behandelt.
Die Tarife starten bei $299 im Monat auf der eesel-Preisseite, und Sie können es vorher kostenlos testen. eesel testen und sehen, was es bei den Tickets des letzten Monats geantwortet hätte.