

Meta hat am 2. September 2026 Muse Spark 1.3 veröffentlicht, etwa vier Wochen nach Version 1.2, integriert in den Coding-Agenten Muse Code und die Meta Model API. Es handelt sich um einen echten Sprung: Das Modell belegt Platz 6 von 636 Modellen im Artificial Analysis Intelligence Index, bietet ein Kontextfenster von 1 Million Token und verarbeitet Text-, Bild- sowie Video-Inputs.
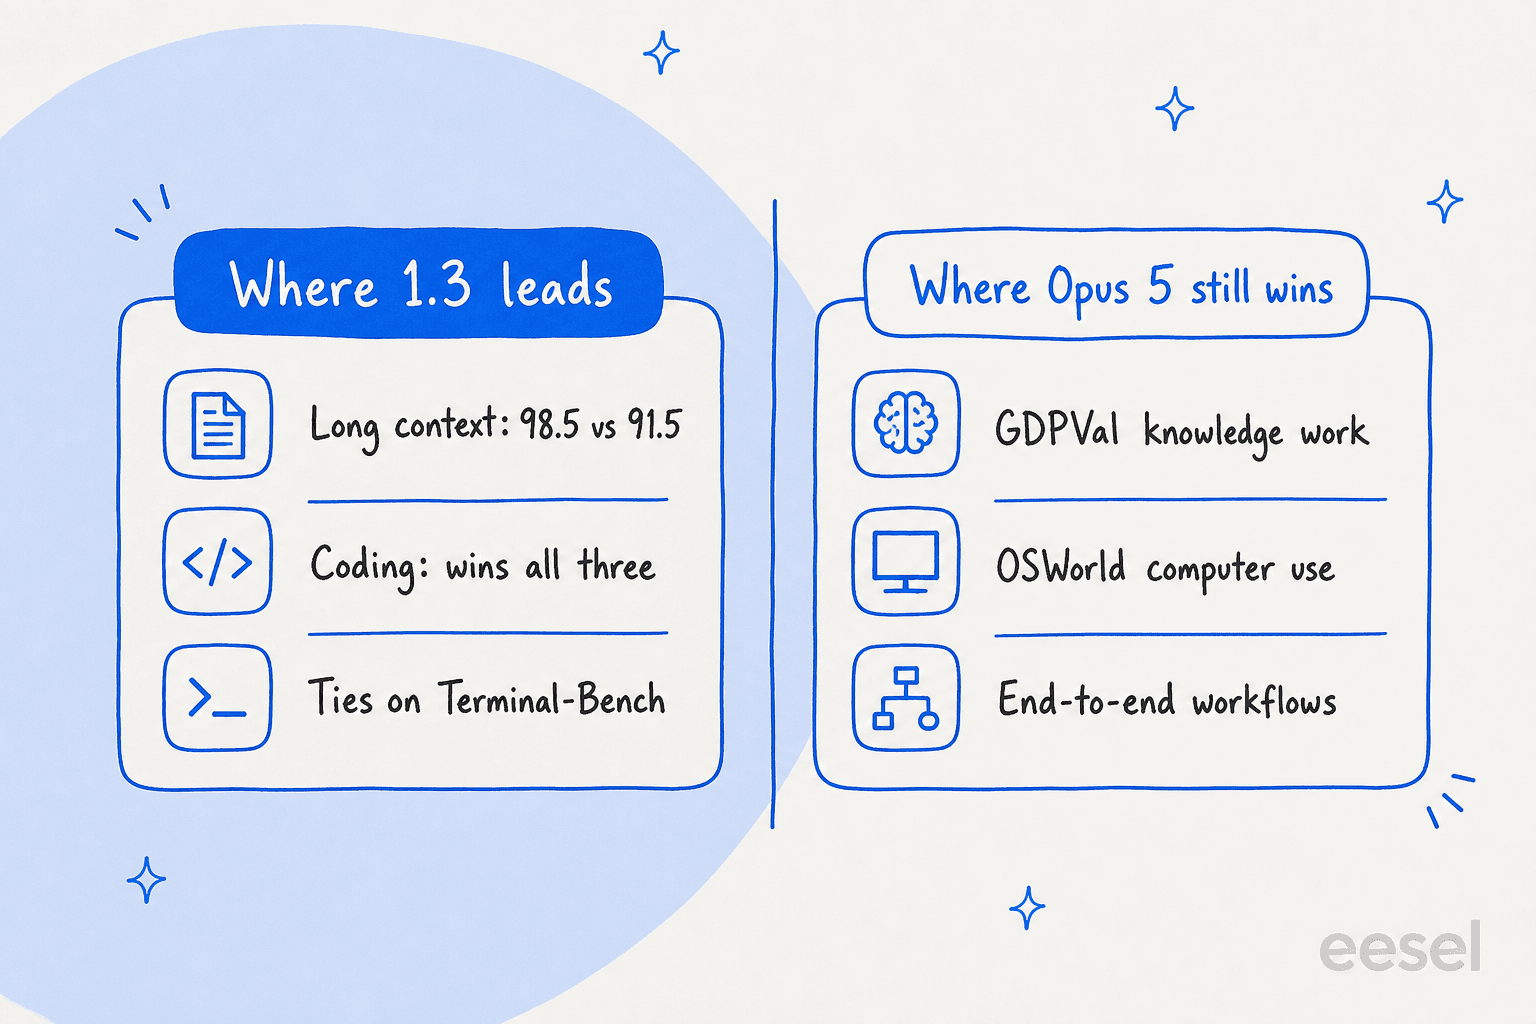
Die ehrliche Einschätzung, wo es punktet: Langer Kontext und Programmierung sind die eigentlichen Gewinne. Es liefert nahezu perfekte Ergebnisse beim Abrufen von Informationen aus langem Kontext (98,5 und 98,1) und gewinnt jede Zeile im Bereich Programmierung in Metas eigenem Scorecard. Bei reinen Agenten-Benchmarks führt Opus 5 (max) jedoch weiterhin in vier von sechs Kategorien. Zudem haben die Schlagzeilen-Zahlen einen Haken: Metas Scorecard vergleicht den max-Modus von 1.3 (der zum Start aufgrund von Sicherheitstests noch eingeschränkt ist) mit dem xhigh-Modus von 1.2. Ein Teil des Sprungs resultiert also aus einem Wechsel der Reasoning-Stufe und ist kein rein generationaler Sprung. Zudem ist es etwa dreimal gesprächiger als Version 1.2.
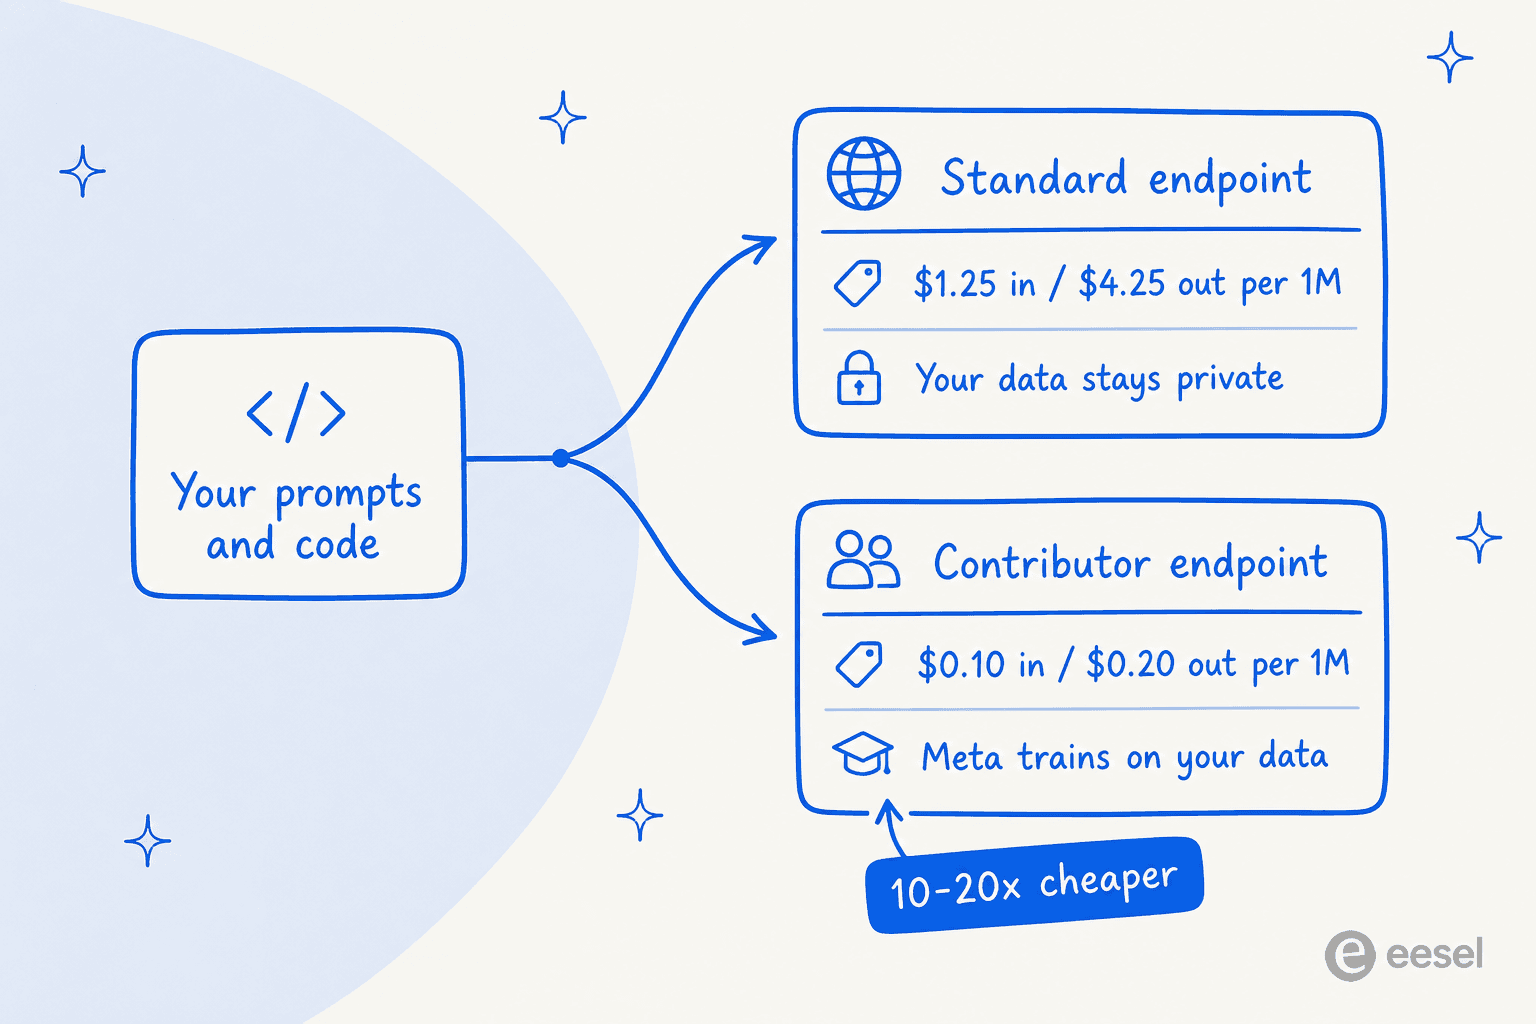
Die Preisgestaltung ist der am meisten diskutierte Teil. Der Standard-Endpunkt kostet 1,25 $ / 4,25 $ pro 1 Million Token; ein „Contributor“-Endpunkt ist etwa 10- bis 20-mal günstiger, wenn Sie Meta erlauben, mit Ihren Daten zu trainieren. Egal, wofür Sie sich entscheiden: Ein rohes Modell ist Infrastruktur, kein fertiger Mitarbeiter. Wenn Sie eigentlich einen Support-Agenten oder einen Blog-Autor suchen, der Ihr Unternehmen bereits kennt, ist das die Aufgabe, die ein KI-Teamkollege wie eesel AI auf Basis solcher Modelle übernimmt.
Was Muse Spark 1.3 tatsächlich ist
Ich entwickle beruflich auf diesen Modell-APIs, daher trenne ich bei jeder Veröffentlichung zuerst das Modell vom Marketing. Muse Spark 1.3 ist Metas fortschrittlichstes Reasoning-Modell mit geschlossenen Gewichten. Meta positioniert es in seiner Ankündigung im Forschungsblog als weiteren Schritt „in Richtung persönlicher Superintelligenz“. Sie können auf zwei Arten darauf zugreifen: über Muse Code, Metas eigenem Framework für Coding-Agenten, oder direkt über die Meta Model API.
Ein paar Fakten, die man vor dem Benchmark-Rauschen festhalten sollte:
- Es wird in zwei veröffentlichten Varianten ausgeliefert:
max(der höchste Reasoning-Modus) undxhigh(schneller). Metas Blog merkt an, dass das Max-Reasoning „kurz nach Abschluss zusätzlicher Sicherheitstests“ folgen wird, sodass der zum Start vollständig verfügbare Modus xhigh ist, nicht max. - Das Kontextfenster beträgt 1 Million Token, und es akzeptiert Text, Bilder und Videos als Input.
- Es handelt sich um ein proprietäres Modell. Artificial Analysis listet es als geschlossen, und es wurde keine Open-Weights-Veröffentlichung angekündigt, was es in eine andere Kategorie als Metas offene Llama-Serie einordnet.
Diese Aufteilung der Varianten ist wichtiger, als es scheint, und ich werde darauf zurückkommen, da sie in den Veröffentlichungszahlen im Stillen eine große Rolle spielt.
Die Benchmarks: Wo 1.3 gewinnt und wo nicht
Meta eröffnete die Veröffentlichung mit einem Scorecard für vier Modelle: Muse Spark 1.3, Muse Spark 1.2, GPT-5.6 Sol und Claude Opus 5, in den Bereichen Agenten-Aufgaben, Programmierung, Befolgung von Anweisungen und Aufgaben mit langem Kontext. Hier sind die Daten direkt von der Quelle.
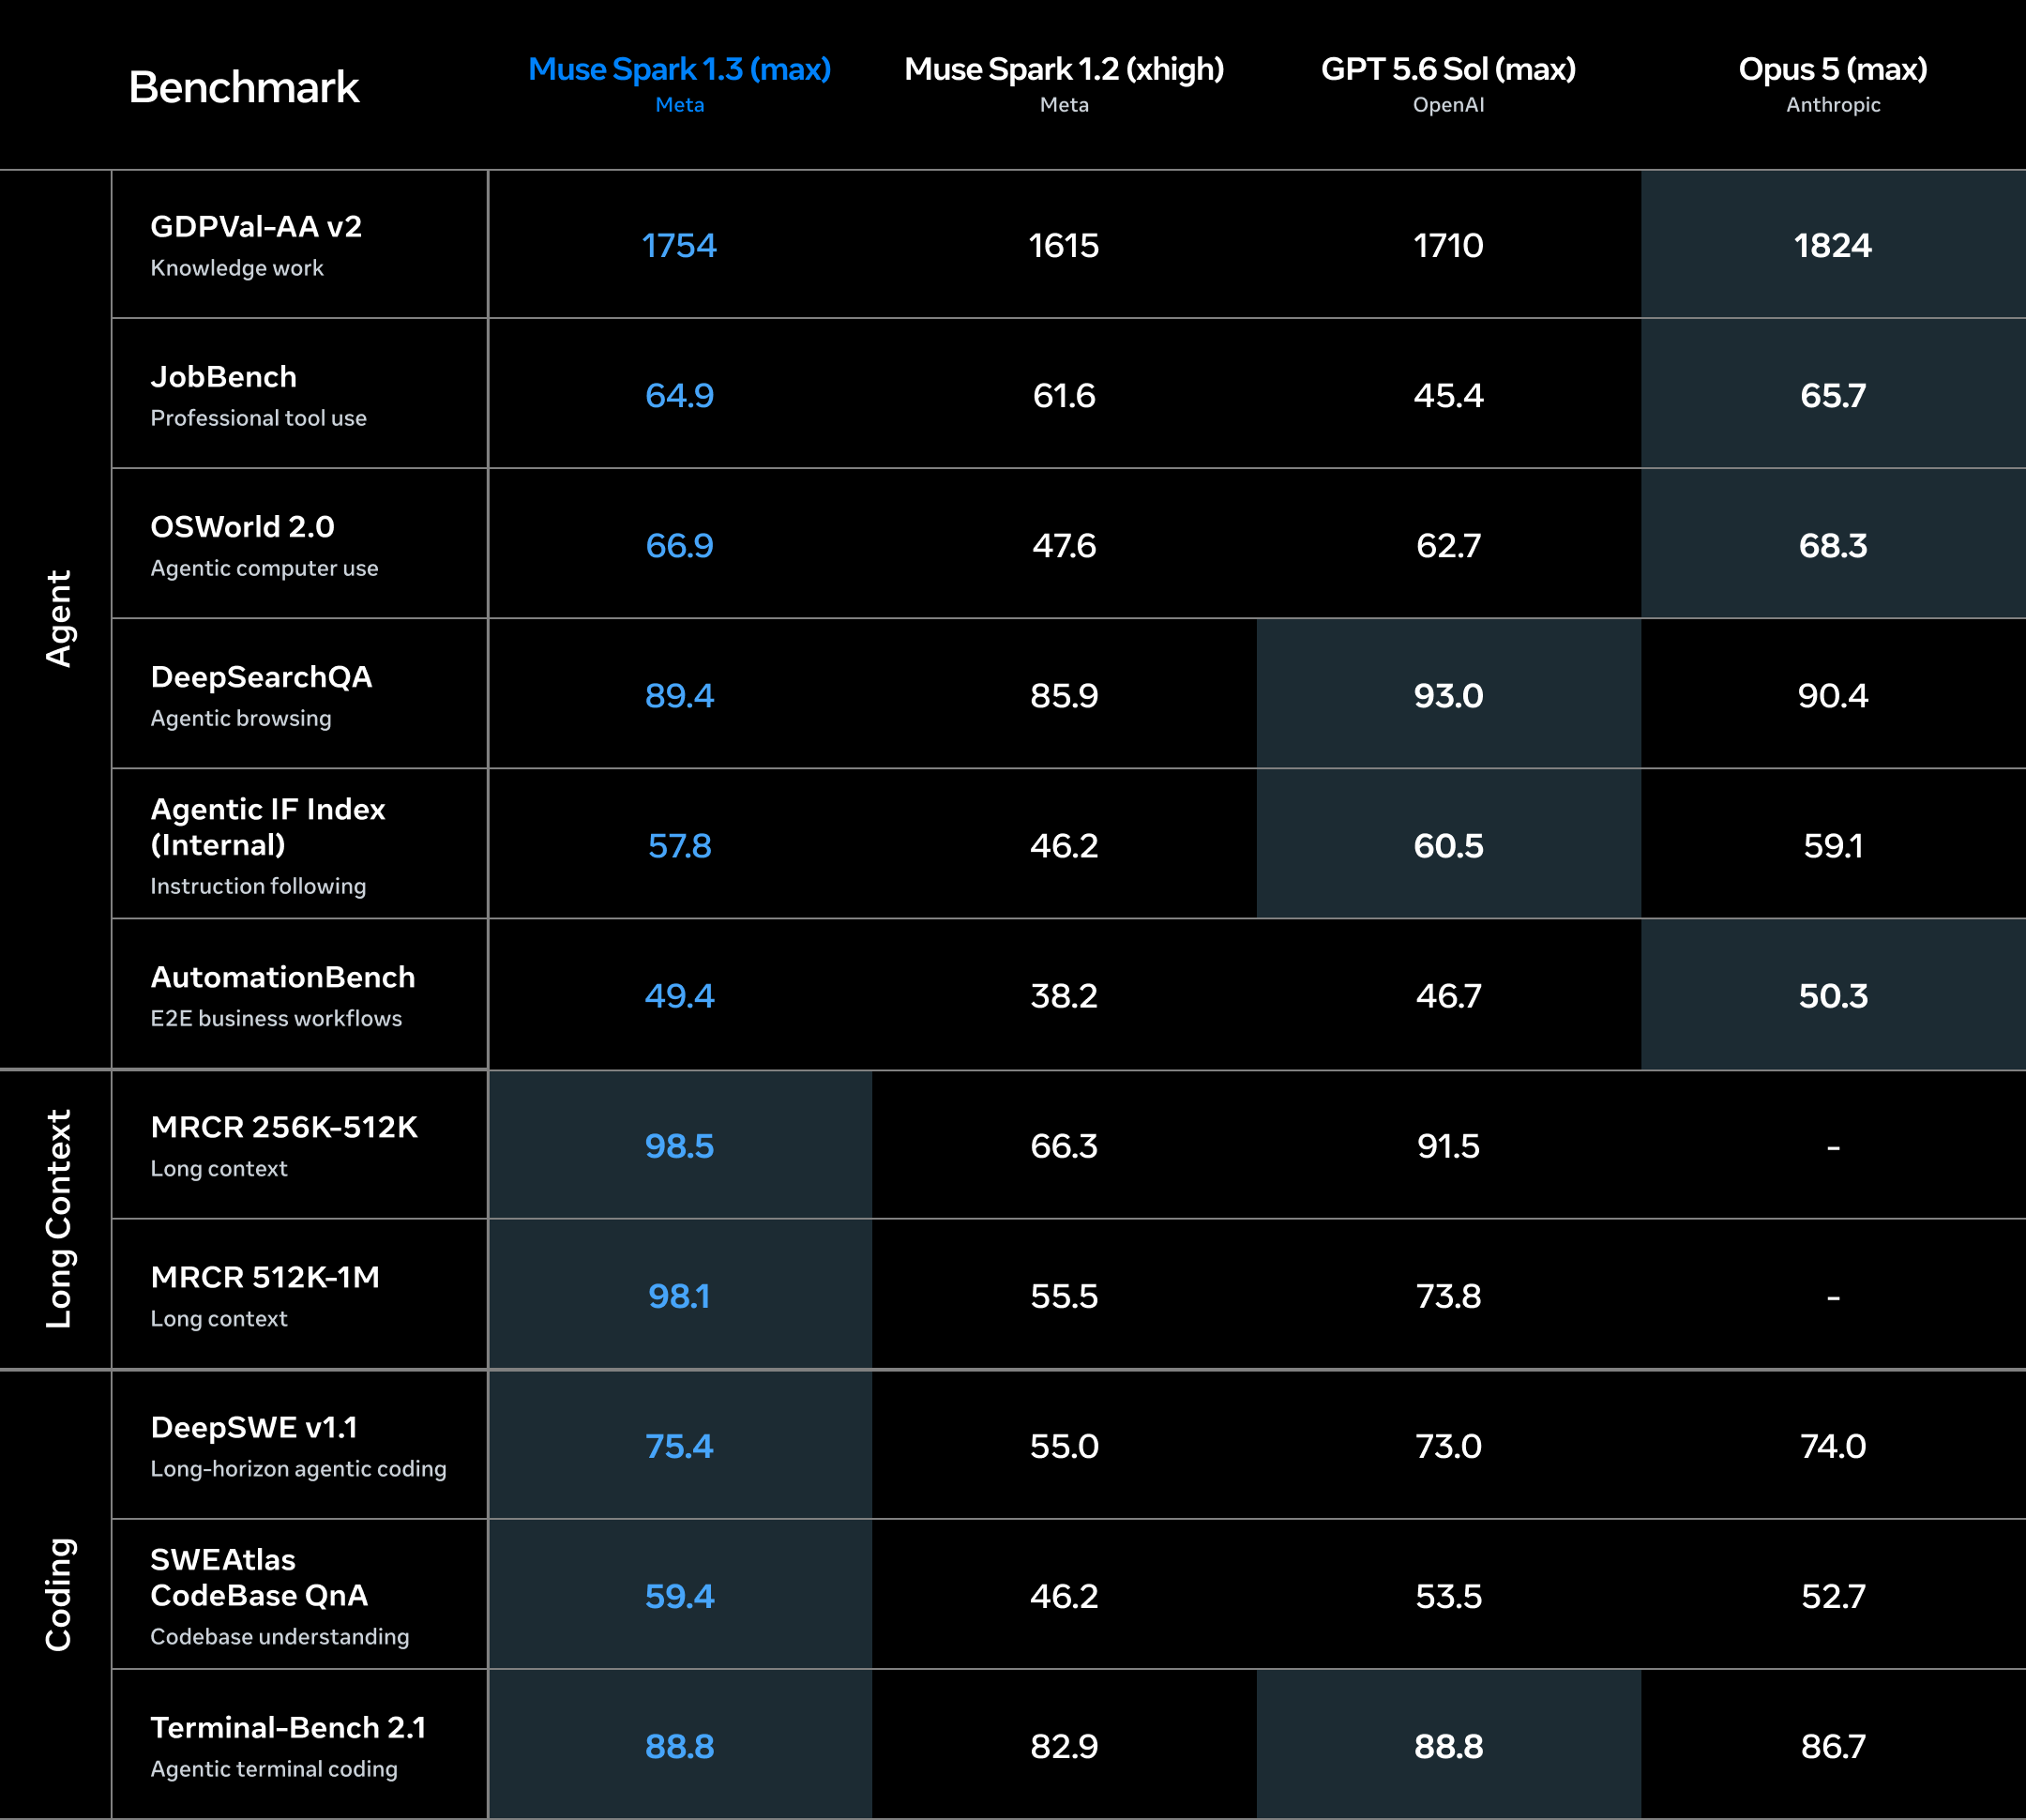
Betrachtet man die Zeilen, zeigt sich ein klares Muster, das nützlicher ist als eine einzelne Schlagzeile:
| Benchmark | Muse Spark 1.3 (max) | Muse Spark 1.2 (xhigh) | GPT-5.6 Sol (max) | Opus 5 (max) |
|---|---|---|---|---|
| GDPVal-AA v2 (Wissensarbeit) | 1754 | 1615 | 1710 | 1824 |
| JobBench (Professionelle Tool-Nutzung) | 64,9 | 61,6 | 45,4 | 65,7 |
| OSWorld 2.0 (Computer-Nutzung) | 66,9 | 47,6 | 62,7 | 68,3 |
| DeepSearchQA (Agentenbasiertes Browsing) | 89,4 | 85,9 | 93,0 | 90,4 |
| Agentic IF Index (Befolgung von Anweisungen) | 57,8 | 46,2 | 60,5 | 59,1 |
| AutomationBench (E2E-Workflows) | 49,4 | 38,2 | 46,7 | 50,3 |
| MRCR 256K-512K (Langer Kontext) | 98,5 | 66,3 | 91,5 | – |
| MRCR 512K-1M (Langer Kontext) | 98,1 | 55,5 | 73,8 | – |
| DeepSWE v1.1 (Agentenbasiertes Coding) | 75,4 | 55,0 | 73,0 | 74,0 |
| SWEAtlas CodeBase QnA | 59,4 | 46,2 | 53,5 | 52,7 |
| Terminal-Bench 2.1 (Terminal-Coding) | 88,8 | 82,9 | 88,8 | 86,7 |
Die Geschichte, die diese Tabelle erzählt: Muse Spark 1.3 dominiert bei langem Kontext und Programmierung. Die Werte von 98,5 und 98,1 in den MRCR-Tests für langen Kontext sind nicht nur Siege, sie lassen GPT-5.6 Sol (91,5 und 73,8) sowie den eigenen Vorgänger (66,3 und 55,5) weit hinter sich, während Opus 5 hier gar keine Zahlen lieferte. Beim Programmieren gewinnt es bei DeepSWE v1.1 (75,4), beim Verständnis von Code-Basen (59,4) und zieht mit GPT-5.6 Sol an der Spitze von Terminal-Bench (88,8) gleich. Das ist ein reales, überprüfbares Ergebnis und deckt sich mit Metas eigener Behauptung, dass 1.3 etwa 20 % weniger Tool-Aufrufe und etwa 25 % weniger Token als 1.2 benötigt, um eine Programmieraufgabe abzuschließen.
Doch schauen Sie ehrlich auf die Agenten-Spalte. In den sechs Agenten-Benchmarks schlägt Opus 5 (max) die Version 1.3 in vier Kategorien (GDPVal, JobBench, OSWorld, AutomationBench), und GPT-5.6 Sol entscheidet die anderen zwei für sich (DeepSearchQA, Agentic IF). Die Aussage „verbessertes Agenten-Verhalten und Coding“ ist also für das Programmieren zutreffend, aber bei den Agenten-Evaluierungen ist 1.3 ein starker Zweiter, nicht der Anführer. In der Gesamtschau ordnet Artificial Analysis die max-Variante bei einem Intelligence Index von 62 ein, was Platz 6 von 636 Modellen entspricht, gegenüber einem Median von 17 für vergleichbare Modelle. Gut, aber die Platzierung ist so eng, dass ein Konkurrent sie in einer Woche zurückerobern kann, und ein Kommentator auf HN merkte an, dass Gemini 3.8 Flash am selben Tag kurzzeitig den Spitzenplatz innehatte.
Der Haken bei den Schlagzeilen-Zahlen
Hier ist eine Sache, auf die ich einen Kollegen hinweisen würde. Schauen Sie sich noch einmal die Spaltenüberschriften des Scorecards an: Die 1.3-Spalte ist max, die 1.2-Spalte ist xhigh. Das sind unterschiedliche Reasoning-Stufen. Einige der auffälligen Sprünge von 1.2 zu 1.3, wie der Anstieg bei OSWorld von 47,6 auf 66,9 oder bei MRCR von 66,3 auf 98,5, sind teilweise auf die Differenz zwischen max und xhigh zurückzuführen und kein reiner Gewinn von Version zu Version. Ein direkter xhigh-Vergleich würde diese Abstände mit Sicherheit verringern.
Diese Darstellung stieß einigen sauer auf. Wie ein Kommentator im Thread zur Veröffentlichung schrieb:
„Es ist irgendwie unehrlich, dass der Benchmark nur Max-Reasoning zeigt.“

Dieser Haken hat echtes Gewicht, da der max-Modus, der diese Schlagzeilen-Ergebnisse liefert, derjenige ist, der zum Start noch hinter Sicherheitstests verborgen bleibt. Was Sie heute tatsächlich aufrufen können, ist xhigh, das im Intelligence Index einen Wert von 61 erreichte. Kein riesiger Unterschied zu 62, aber es ist die ehrliche Zahl für das, was jetzt ausgeliefert wird.
Der zweite Asterisk ist die Ausführlichkeit. Artificial Analysis hat gemessen, dass 1.3 120 Millionen Output-Token ausgestoßen hat, um den vollständigen Intelligence Index abzuschließen (der Median im Feld liegt bei 72 Millionen), und Tests der Community bezifferten den Token-Verbrauch auf das etwa Dreifache von Version 1.2. Da Sie pro Output-Token bezahlen, ist ein Modell, das dreimal so viel „laut denkt“, nicht automatisch billiger, nur weil sein Preis pro Token niedrig ist. Es lohnt sich, dies mit der eigenen Arbeitslast zu simulieren, bevor man vom Listenpreis ausgeht.
Preisgestaltung: Die Aufteilung zwischen Daten und Rabatt
Hier wurde der Start interessant, und es ist ein typischer Meta-Schachzug. Es gibt zwei Endpunkte für dasselbe Modell, und der Preisunterschied hängt vollständig von Ihren Daten ab.
| Endpunkt | Input / 1 Mio. | Output / 1 Mio. | Ihre Daten |
|---|---|---|---|
| Standard (xhigh) | 1,25 $ | 4,25 $ | Bleiben privat, werden nicht zum Training verwendet |
| Contributor | ~0,10 $ | ~0,20 $ | Werden zur Verbesserung von Metas Produkten verwendet |
Die Standard-xhigh-Zahlen sind auf Artificial Analysis bestätigt, wo auch Kosten von 0,55 $ pro Intelligence-Index-Aufgabe, 182 Token/Sekunde Output und eine Zeit von 38,51 Sekunden bis zum ersten Antwort-Token gemessen wurden. Die Contributor-Zahlen stammen von Nutzern, die Metas Preis-Seite im Veröffentlichungsthread zitieren, daher sollten Sie die genauen Cent-Beträge eher als Richtwert mit hoher Konfidenz betrachten, bis Metas Seite leichter lesbar ist. In jedem Fall beträgt der Unterschied etwa das 10- bis 20-fache.
Die Einschätzung der Community, warum diese Aufteilung existiert, war schärfer als jeder Pressebericht:
„Es ist nicht so, dass Meta Ihre Daten unbedingt will und bereit ist, Höchstpreise dafür zu zahlen. Es ist so, dass Unternehmen absolut nicht wollen, dass Meta ihre Daten hat, und sie bereit sind, Höchstpreise dafür zu zahlen, dass das nicht passiert.“
Das ist der Tausch in einem Satz. Der Contributor-Endpunkt ist pro Million günstiger als ChatGPT Luna und sogar als das ältere DeepSeek V4 Flash, wie ein Kommentator anmerkte, was ein echtes Schnäppchen für ein Hobbyprojekt oder ein Einweg-Skript ist. Für alles, was Kundendaten oder proprietären Code berührt, ist der Aufpreis des Standard-Endpunkts Sinn der Sache, kein Fehler. Wählen Sie den Endpunkt passend zur Sensibilität des Inputs, nicht nur nach der kleinsten Zahl.
Was die Community tatsächlich denkt
Die Stimmung am Tag der Veröffentlichung war auf Hacker News (391 Punkte, 261 Kommentare) spürbar gemischt und keine reine Hype-Welle. Leute, die 1.2 in einem echten Coding-Framework genutzt hatten, mochten die Geschwindigkeit und den Preis, waren aber neugierig, ob 1.3 alte Macken ablegt:
„Ich nutze 1.2 teilweise, um eine alte Spiele-Binary zu analysieren und neu zu implementieren, und es war ziemlich gut und schnell... 1.2 kann stecken bleiben und ähnliche Zusammenfassungen der Gedankengänge ohne sichtbaren Fortschritt ausgeben, wenn es Fehler beheben soll.“
Andere waren von der vorherigen Generation schlichtweg nicht überzeugt, was eine berechtigte Warnung davor ist, Benchmarks als gelebte Erfahrung zu interpretieren:
„Habe Muse Spark 1.2 genutzt und war überhaupt nicht beeindruckt. Schnell und billig, aber selbst GPT 5.6 Terra fühlte sich deutlich fähiger an.“
Ein praktischer Tipp tauchte immer wieder auf und ist es wert, übernommen zu werden: Meta hat das Modell zusammen mit dem eigenen Framework trainiert, daher neigt die Nutzung innerhalb von Muse Code dazu, weniger Token und Durchläufe zu verbrauchen als in Agenten von Drittanbietern. Wenn Sie es im Framework eines anderen Anbieters testen und es teuer erscheint, ist das ein Teil des Grundes.
Wie Meta das Agenten-Verhalten entworfen hat
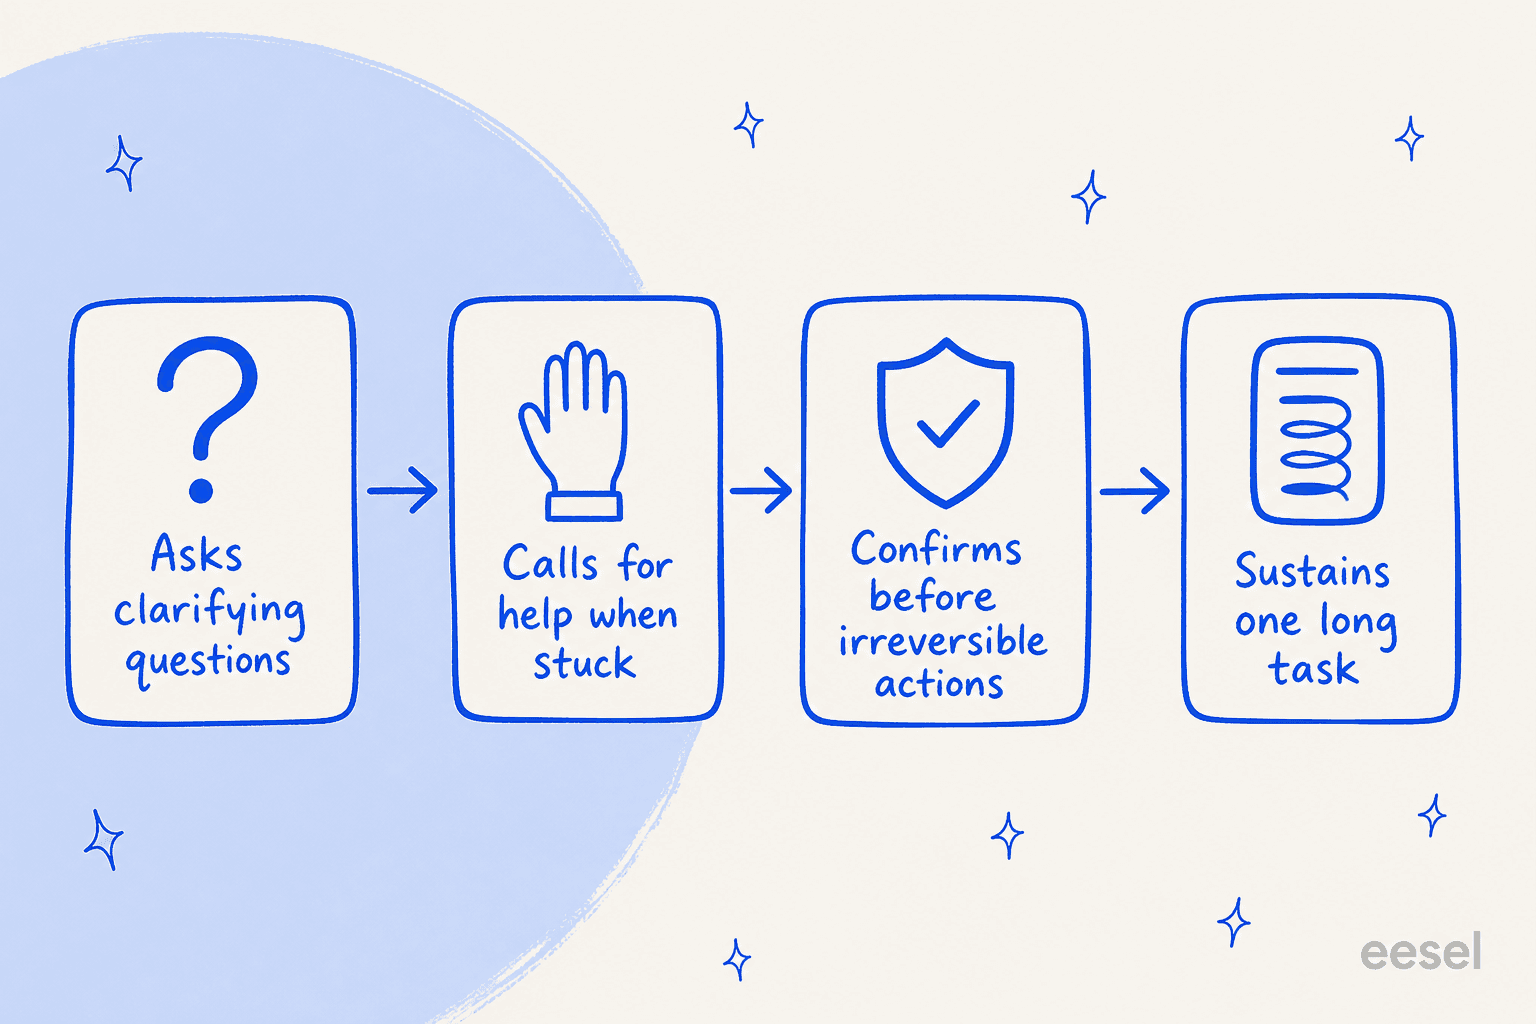
Abgesehen von den Benchmarks ist die interessantere technische Behauptung die über das Verhalten. Meta gibt an, dass 1.3 darauf trainiert wurde, sich weniger wie ein übereifriger Praktikant und mehr wie ein sorgfältiger Mitarbeiter zu verhalten: klärende Fragen stellen, um Hilfe rufen, wenn es feststeckt, vor folgenschweren oder irreversiblen Aktionen rückfragen und einen einzelnen langen, komplexen Thread zusammenhalten, ohne die frühen Anforderungen aus den Augen zu verlieren.
Meta kombiniert dies mit Sicherheitsversprechen: stärkere Resistenz gegen Angriffe, besserer Schutz vor Prompt-Injections und eine bessere Kalibrierung bei irreversiblen Aktionen. Da ich über drei Jahre lang beobachtet habe, wie KI-Agenten in Live-Warteschlangen arbeiten, halte ich „bestätigt vor irreversiblen Aktionen“ für den wichtigsten Satz in der gesamten Ankündigung. Ein selbstbewusstes Modell, das stillschweigend das Falsche tut, ist schlimmer als ein zögerliches, das nachfragt. Genau deshalb simulieren wir bei den Produkten, an denen ich arbeite, jeden Agenten mit echten historischen Daten, bevor er jemals einen Live-Kunden berührt, anstatt darauf zu vertrauen, dass ein Benchmark-Wert das Produktionsverhalten vorhersagt.
Dieser Instinkt ist auch die Brücke zu dem Teil, den die meisten dieser Veröffentlichungsposts auslassen: Ein starkes Modell ist Rohmaterial, kein fertiger Mitarbeiter.
Vom Frontier-Modell zum eingestellten Teammitglied
Hier ist die ehrliche Meinung eines Entwicklers: Muse Spark 1.3 ist ein großartiger Motor. Aber für sich genommen ist es kein Mitarbeiter. Das Modell kennt Ihr Produkt nicht, ist nicht mit Ihrem Helpdesk oder Ihrem CMS verbunden, wurde nicht gegen Ihre speziellen Einzelfälle getestet und wird nicht nachfragen, bevor es eine E-Mail an einen Kunden sendet, es sei denn, Sie bauen all das drumherum. Diese Lücke zwischen „Frontier-Modell“ und „Etwas, das eine Aufgabe erledigt“ ist genau die Ebene, die eesel AI ausfüllt.
Ich würde es so formulieren: Modelle wie dieses sind die Infrastruktur; eesel AI ist der Teamkollege, den Sie darauf aufbauend einstellen. Sie wählen nicht das Modell aus, verkabeln die Integrationen und schreiben das Sicherheitsgerüst. Sie stellen einen einsatzbereiten Teamkollegen für eine spezifische Rolle ein, der bereits die Fähigkeiten, Integrationen und den Unternehmenskontext für diesen Job mitbringt.
eesel ausprobieren
Wenn Sie diesen Beitrag lesen, weil Sie entscheiden, womit Sie mit Muse Spark 1.3 etwas bauen wollen, dann ist das genau der Moment, für den eesel AI entwickelt wurde. eesel AI ist eine Plattform für KI-Teamkollegen: Anstelle einer rohen Modell-API stellen Sie einen einsatzbereiten Teamkollegen für eine definierte Aufgabe ein. Derzeit umfasst dieses Team einen KI-Helpdesk-Mitarbeiter, der sich Ihrer Support-Warteschlange anschließt, Bestellungen nachschlägt und Entwürfe erstellt oder Antworten direkt in Ihrem bestehenden Helpdesk versendet, sowie einen KI-Blog-Autor, der ausführliche Beiträge wie diesen recherchiert und entwirft.
Das konkrete Unterscheidungsmerkmal ist der Teil, den Ihnen ein rohes Modell nicht bieten kann: Der Helpdesk-Teamkollege wird anhand Ihrer eigenen vergangenen Tickets simuliert, bevor er live geht, sodass Sie sehen, wie er reale Gespräche geführt hätte, anstatt zu hoffen, dass sich ein Benchmark-Wert überträgt. Er lässt sich in Minuten in Ihre Tools einbinden, es gibt einen kostenlosen Plan mit 100 Credits und die Preisgestaltung liegt bei 0,40 $ pro Ticket/Chat-Sitzung, 4,00 $ pro Blogbeitrag, mit einer kostenlosen Testversion im Wert von 50 $ (keine monatlichen Mindestumsätze oder Plattformgebühren). Damit ist ein ausführliches Modell, das laut denkt, preislich nicht Ihr Problem.