

Zusammenfassung (TL;DR)
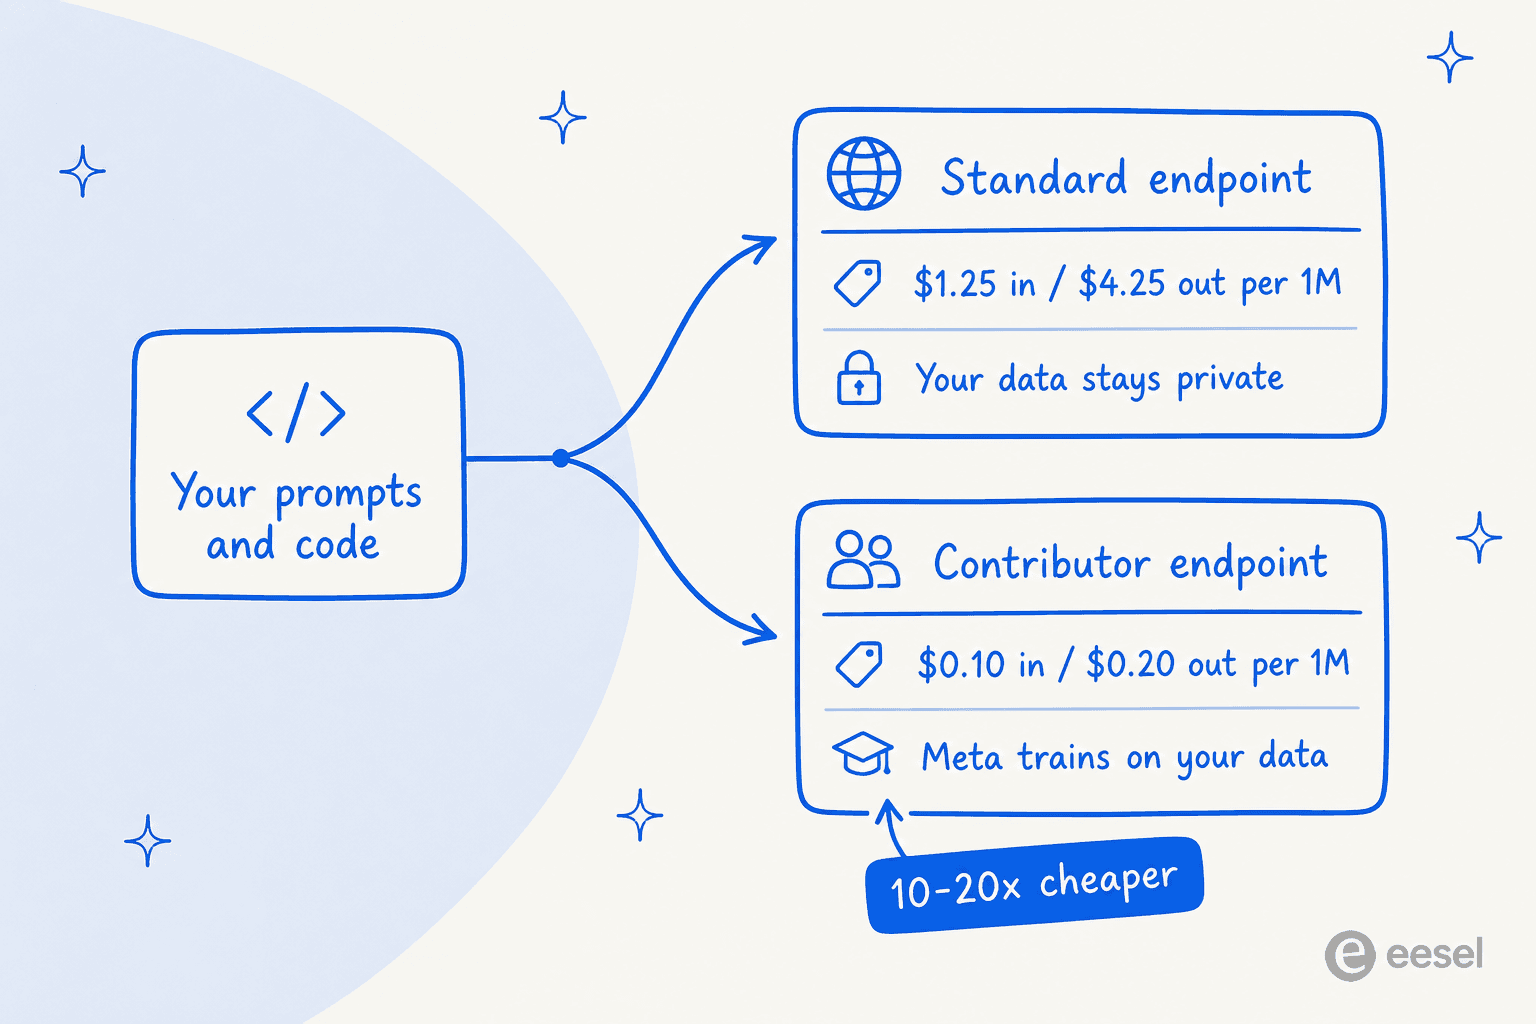
Meta's Muse Spark 1.3 hat zwei Preise für dasselbe Modell, und der Unterschied hängt allein von Ihren Daten ab. Der Standard-Endpunkt kostet 1,25 $ pro 1 Mio. Eingabe-Token und 4,25 $ pro 1 Mio. Ausgabe-Token in der xhigh-Stufe, wobei Ihr Datenverkehr privat bleibt. Der Mitwirkenden-Endpunkt (contributor endpoint) kostet etwa 0,10 $ / 0,20 $ pro 1 Mio., was etwa 10 bis 20 Mal günstiger ist, als Gegenleistung dafür, dass Meta mit Ihren gesendeten Daten trainiert.
Der Listenpreis ist nur die halbe Wahrheit. Muse Spark 1.3 ist ungewöhnlich ausführlich, sodass eine niedrige Rate pro Token dennoch zu einer hohen Rechnung pro Aufgabe führen kann. Artificial Analysis schätzt die Kosten am Standard-Endpunkt auf etwa 0,78 $ pro 1 Mio. Token und rund 1,37 $, um eine Aufgabe im Intelligence Index abzuschließen. Zudem gibt es einen nützlichen Cache-Rabatt von 88 %.
Ich beobachte seit zwei Jahren, wie Teams ein Modell basierend auf dem Eingabepreis wählen und dann von der Ausgabezeile auf der Rechnung überrascht werden. Hier ist die ehrliche Meinung für Entwickler: Eine reine Modell-API ist eine Kostenstelle, die Sie Token für Token verwalten müssen. Wenn Sie eigentlich einen Support-Agenten oder einen Blog-Autor suchen, der eine Aufgabe zu einem vorhersehbaren Preis erledigt, ist das die Ebene, auf der ein KI-Teamkollege wie eesel ansetzt, der pro Lösung statt pro Token abrechnet.
Wofür Sie tatsächlich bezahlen
Zuerst muss klargestellt werden, dass die Preisgestaltung von Muse Spark 1.3 nicht aus einer einzigen Zahl besteht. Meta bietet dasselbe Modell über zwei Endpunkte der Meta Model API an, die sehr unterschiedlich bepreist sind.
| Produkt / Endpunkt | Eingabe / 1 Mio. | Ausgabe / 1 Mio. | Ihre Daten | Ideal für |
|---|---|---|---|---|
| eesel AI | 0,40 $ pro Ticket | 4,00 $ pro Blog | Sicher & Privat | Unternehmen, Support, Content |
| Standard (xhigh) | 1,25 $ | 4,25 $ | Bleiben privat, kein Training | Produktion, Kundendaten, geschützter Code |
| Mitwirkender | ~0,10 $ | ~0,20 $ | Nutzung zur Produktverbesserung | Hobbyprojekte, Wegwerfskripte, unkritische Batch-Jobs |
Die Standard-xhigh-Raten wurden von Artificial Analysis bestätigt. Sie sind im Vergleich zu Muse Spark 1.2 stabil geblieben, statt mit der neuen Version zu steigen, was eine gute Nachricht ist. Die Zahlen für Mitwirkende stammen von Nutzern, die Metas eigene Preisseite im Launch-Thread zitiert haben: betrachten Sie die genauen Cent-Beträge also als sehr wahrscheinlich, aber noch nicht als absolut gesichert, bis die Seite leichter zugänglich ist. In jedem Fall beträgt der Unterschied etwa das 10- bis 20-fache und ist die wichtigste Preisentscheidung, die Sie bei diesem Modell treffen werden.
Die Einschätzung der Community dazu, warum diese Aufteilung existiert, war treffender als jeder Pressebericht:
„Es ist nicht so, dass Meta Ihre Daten unbedingt will und bereit ist, Höchstpreise dafür zu zahlen. Es ist so, dass Unternehmen absolut nicht wollen, dass Meta ihre Daten hat, und sie sind bereit, Höchstpreise dafür zu zahlen, dass das so bleibt.“

Das fasst den Tausch in einem Satz zusammen. Der Aufpreis für den Standard-Endpunkt ist keine Steuer, sondern das Produkt selbst. Wählen Sie den Endpunkt, der zur Vertraulichkeit der Eingaben passt, nicht den mit der kleineren Zahl.
Schätzen Sie Ihre monatliche Rechnung
Listenpreise sind abstrakt, bis man das eigene Volumen einsetzt. Hier ist ein Rechner: Geben Sie an, wie viele Millionen Token Sie monatlich etwa verarbeiten, wählen Sie einen Endpunkt aus und das Tool berechnet die Kosten für die Eingabe und die bekanntermaßen umfangreiche Ausgabeseite.
Achten Sie besonders auf das Feld für die Ausgabe-Token. Da Muse Spark 1.3 stark auf Ausgabe-Token setzt und die Ausgabe 3,4 Mal so teuer ist wie die Eingabe, beeinflusst dieses Feld Ihre Rechnung weitaus stärker als die Eingabe. Dies führt uns zu dem Teil, den der Listenpreis verschweigt.
Die Steuer auf Ausführlichkeit
Hier ist der Haken, der auf keiner Preisseite steht: Muse Spark 1.3 „denkt“ sehr viel laut nach. Artificial Analysis stellte fest, dass das Modell 140 Mio. Ausgabe-Token erzeugte, um den vollständigen Intelligence Index abzuschließen, während der Median des restlichen Feldes bei etwa 90 Mio. lag. Eigene Tests der Community zum Start schätzten den Token-Verbrauch auf das etwa Dreifache im Vergleich zu Version 1.2.
Sie zahlen pro Ausgabe-Token. Ein Modell mit einer niedrigen Rate pro Ausgabe-Token, das aber eine Unmenge an Token generiert, ist also nicht automatisch die günstigste Option. Wenn Sie denselben Auftrag mit einem prägnanteren Modell zu einer höheren Rate ausführen, kann das prägnantere Modell am Ende auf der Rechnung gewinnen. Dies ist genau die Falle, die ich in der Zusammenfassung erwähnt habe, und deshalb sind die Kosten pro Aufgabe wichtiger als die Rate pro Token. Artificial Analysis beziffert den Standard-Endpunkt auf etwa 1,37 $, um eine Aufgabe im Intelligence Index abzuschließen, wenn man die Ausführlichkeit einbezieht: zusammen mit einer Ausgabegeschwindigkeit von fast 198 Token/Sekunde und einer Zeit bis zum ersten Token von etwa 29 Sekunden.
Zwei Faktoren drücken die tatsächlichen Kosten wieder nach unten:
- Der Cache-Rabatt von 88 %. Wiederholte Eingabe-Token (ein langer System-Prompt, eine Wissensdatenbank (knowledge base), die Sie bei jedem Aufruf mitsenden) werden zu einem Bruchteil der Eingaberate abgerechnet. Für abruforientierte oder agentenbasierte Workloads, die denselben Kontext immer wieder senden, ist dies eine erhebliche Ersparnis.
- Metas eigene Optimierung. Meta hat das Modell zusammen mit Muse Code trainiert. Die Nutzung innerhalb von Muse Code verbraucht daher tendenziell weniger Token und Schritte als ein Agent eines Drittanbieters. Wenn Sie das Modell woanders testen und es teuer erscheint, liegt das zum Teil an der fehlenden Optimierung der Umgebung.
Das Fazit für Ihre Budgetplanung: Bewerten Sie dieses Modell nicht nach der Eingaberate. Schätzen Sie Ihr Ausgabevolumen ehrlich ein, nutzen Sie den Cache-Rabatt dort, wo Ihr Workload Kontext wiederholt, und simulieren Sie die Kosten mit einem echten Teil Ihres eigenen Datenverkehrs, bevor Sie sich festlegen.
Die Max-Stufe, die Sie noch nicht kaufen können
Es gibt einen preislichen Hinweis, den man leicht übersehen kann. Meta hat seine besten Benchmark-Ergebnisse mit der max-Reasoning-Stufe erzielt, aber Max ist zum Start hinter zusätzlichen Sicherheitstests gesperrt. Die Stufe, die Sie heute tatsächlich aufrufen und bezahlen können, ist xhigh. Es gibt noch keinen öffentlichen Standardpreis für max.
Das ist aus zwei Gründen wichtig. Erstens: Wenn Sie Ihr Budget nach den Start-Ergebnissen planen, planen Sie nach einer Stufe, die Sie gar nicht kaufen können. Zweitens: Wenn max verfügbar wird, ist damit zu rechnen, dass es teurer und noch ausführlicher als xhigh sein wird, da mehr Reasoning mehr Ausgabe-Token zu 4,25 $ pro Million bedeutet. Die vollständige Benchmark-Analyse zeigt auf, wie viel des Sprungs von 1.2 auf 1.3 tatsächlich der Unterschied zwischen max und xhigh ist und kein reiner Generationensprung. Das sollten Sie lesen, bevor Sie annehmen, dass die Top-Tier-Zahlen für das gelten, wofür Sie bezahlen.
Wie der Preis im Vergleich zum Wettbewerb abschneidet
Rein nach Listenpreis liegt der Standard-Endpunkt von Muse Spark 1.3 im günstigen Spitzenfeld. Hier sehen Sie, wo er im Vergleich zu Modellen steht, die viele Teams in Betracht ziehen. Dies sind Listenpreise für Eingabe/Ausgabe einer vergleichbaren Stufe: die tatsächlichen Kosten hängen weiterhin von der Ausführlichkeit und Ihrem eigenen Mix ab.
| Modell | Eingabe / 1 Mio. | Ausgabe / 1 Mio. | Anmerkungen |
|---|---|---|---|
| eesel AI | 0,40 $ pro Ticket | 4,00 $ pro Blog | Abrechnung pro Ergebnis; 50 $ Gratis-Testversion |
| Muse Spark 1.3 (Standard xhigh) | 1,25 $ | 4,25 $ | Sehr ausführlich; 88 % Cache-Rabatt; Mitwirkender ~10-20x günstiger |
| Muse Spark 1.3 (Mitwirkender) | ~0,10 $ | ~0,20 $ | Meta trainiert mit Ihren Daten |
| Claude Opus 5 | höher | höher | Schlägt 1.3 in den meisten Agent-Evals; Premium-Stufe |
| GPT-6 Astra | mittel | mittel | Andere Preisstruktur; siehe eigene Analyse |
| Gemini 3.8 Flash | niedrig | niedrig | Führte kurzzeitig denselben Index an, als 1.3 erschien |
| DeepSeek V4 Flash | sehr niedrig | sehr niedrig | Offen, MIT-Lizenz; der wahre Preisboden |
| Kimi K3 | mittel | mittel | Ein weiterer Open-Weights-Konkurrent |
Die ehrliche Einschätzung: Am Mitwirkenden-Endpunkt ist 1.3 pro Million günstiger als die meisten gehosteten Frontier-Optionen und unterbietet sogar einige ältere Budget-Modelle, wie ein Kommentator anmerkte. Am Standard-Endpunkt ist es preislich wettbewerbsfähig, aber nicht der absolute Tiefstpreis: und die Ausführlichkeit bedeutet, dass die effektiven Kosten schneller steigen, als der Listenpreis vermuten lässt. Wenn Ihr einziges Kriterium der Preis pro Token für unkritische Arbeiten ist, sind der Mitwirkenden-Endpunkt oder ein offenes Modell wie DeepSeek V4 Flash kaum zu schlagen. Wenn Ihr Kriterium der Preis pro erledigter Aufgabe mit echten Daten ist, wird die Rechnung interessanter.
Vom Preis pro Token zu einem Preis pro Ergebnis
Hier ist die Sichtweise für Entwickler, die in den meisten Preisbeiträgen fehlt: Jeder oben genannte Wert stellt die Kosten für Rohmaterialien dar, nicht die Kosten für die Erledigung von Arbeit. Ein Token-Preis sagt Ihnen, was der Motor kostet. Er sagt Ihnen nichts über die Anbindung des Modells an Ihren Helpdesk, das Füttern mit Ihrem Unternehmenskontext, das Testen gegen Sonderfälle oder die Bestätigung, bevor eine E-Mail an einen Kunden gesendet wird. All das bauen und bezahlen Sie zusätzlich.
In dieser Lücke liegt eesel. Ich würde es so formulieren: Modelle wie Muse Spark 1.3 sind die Infrastruktur, und eesel ist der Teamkollege, den Sie darauf aufbauend einstellen. Sie müssen nicht selbst eine Stufe wählen, Integrationen verkabeln und die Ausführlichkeit auf Ihrer eigenen Rechnung tragen. Sie stellen einen einsatzbereiten Teamkollegen für eine definierte Aufgabe ein, der bereits die Fähigkeiten, Integrationen und den Unternehmenskontext für diese Rolle mitbringt.
Das Preismodell ist der entscheidende Unterschied. eesel rechnet pro Lösung ab, nicht pro Token. Ein Modell, das dreimal so viel laut nachdenkt, ist also kein Posten, den Sie prognostizieren müssen. Der KI-Helpdesk-Teamkollege klinkt sich in Ihre Support-Warteschlange ein, sucht Bestellungen heraus und entwirft oder versendet Antworten direkt in Ihrem bestehenden Helpdesk: und der KI-Blog-Autor recherchiert und entwirft ausführliche Beiträge wie diesen hier. In beiden Fällen ist der Preis an die geleistete Arbeit gebunden, nicht an die verbrauchten Token.
Probieren Sie eesel aus
Wenn Sie diesen Beitrag zu den Preisen von Muse Spark 1.3 lesen, weil Sie entscheiden, was Sie bauen wollen: genau für diesen Moment ist eesel gemacht. Sie erhalten einen einsatzbereiten KI-Teamkollegen statt einer reinen Modell-API, sodass die oben genannte Token-Mathematik nicht mehr Ihr Problem ist.
Das konkrete Unterscheidungsmerkmal ist der Teil, den ein reines Modell nicht bieten kann: Der Helpdesk-Teamkollege wird anhand vergangener Tickets simuliert, bevor er live geht. So sehen Sie, wie er reale Gespräche gehandhabt hätte, anstatt zu hoffen, dass sich ein Benchmark überträgt. eesel ist in wenigen Minuten in Ihre Tools integriert und kann kostenlos getestet werden. eesel AI kostet 0,40 $ pro Ticket/Chat-Sitzung, 4,00 $ pro Blog-Beitrag, mit einer kostenlosen Testversion im Wert von 50 $ (keine monatlichen Mindestbeträge oder Plattformgebühren). Da eesel pro Lösung abrechnet und nicht pro Token, belastet ein ausführliches Modell, das laut nachdenkt, nicht Ihr Budget.