

Was ist DeepSeek V4.1 Flash 1017?
Ich baue bei eesel Produktfunktionen und KI-Agenten, und das Team hier betreibt seit Jahren KI in Live-Support-Warteschlangen. Eine Gewohnheit aus dieser Arbeit ist geblieben: Wenn ein Modellanbieter „gleicher Preis“ sagt, prüfe ich, was ein fertiger Auftrag kostet, denn diese Zahl bestimmt die Rechnung.
DeepSeek V4.1 Flash 1017 ist ein kleines Update des Modells DeepSeek V4.1 Flash, das am 10. September erschienen ist. Laut DeepSeeks Changelog sind die offizielle Web-App, die mobile App und die API am 17. Oktober 2026 auf den neuen Build umgestiegen. Der API-Aufruf bleibt gleich: Du verwendest weiter den Modellnamen deepseek-flash und bekommst automatisch 1017.
Darunter ist es weiterhin dieselbe Modellfamilie, ein Mixture-of-Experts-Modell mit 552B Parametern und der neuen Architektur, die DeepSeek im September vorgestellt hat, offene Gewichte unter der MIT-Lizenz und ein Kontextfenster von 1M Tokens. Wenn dich die Architektur interessiert, deckt der Launch-Überblick meines Kollegen sie ab. Dieser Beitrag behandelt das Delta.
| Was | September-Build | 1017-Build |
|---|---|---|
| API-Modellname | deepseek-flash | deepseek-flash (gleich) |
| Token-Preise | $0.15 Eingabe / $0.60 Ausgabe außerhalb der Spitzenzeiten | Unverändert |
| Ausgabelänge | Basiswert | Kürzer, laut DeepSeek |
| Laufzeit pro Aufgabe | Basiswert | Schneller, laut DeepSeek |
| Websuche für Entwickler | Nicht separat verkauft | Search- und Fetch-APIs, $0.75 pro 1.000 Aufrufe |
| Offene Gewichte | MIT auf Hugging Face | MIT auf Hugging Face |
In dieser ersten Zeile steckt eine leise Konsequenz. Weil der Alias umgezogen ist, hat jede App, die auf deepseek-flash zeigt, am 17. Oktober das Modell gewechselt, egal ob der Besitzer es bemerkt hat. Die Preisseite führt keinen separaten Namen für den September-Build auf, und selbst die eingestellten deepseek-v4-flash-Namen werden jetzt von 1017 bedient. Wenn du Prompts für lange, sorgfältige Ausgaben optimiert hast, teste sie diese Woche.
Wie viel besser ist es in den Benchmarks?
DeepSeeks Launch-Hinweis nennt die Veröffentlichung „a Pareto improvement in performance and cost“, und die Zahlen stützen die erste Hälfte davon. Alle 11 Benchmarks in der offiziellen Tabelle sind gegenüber dem September-Build gestiegen.
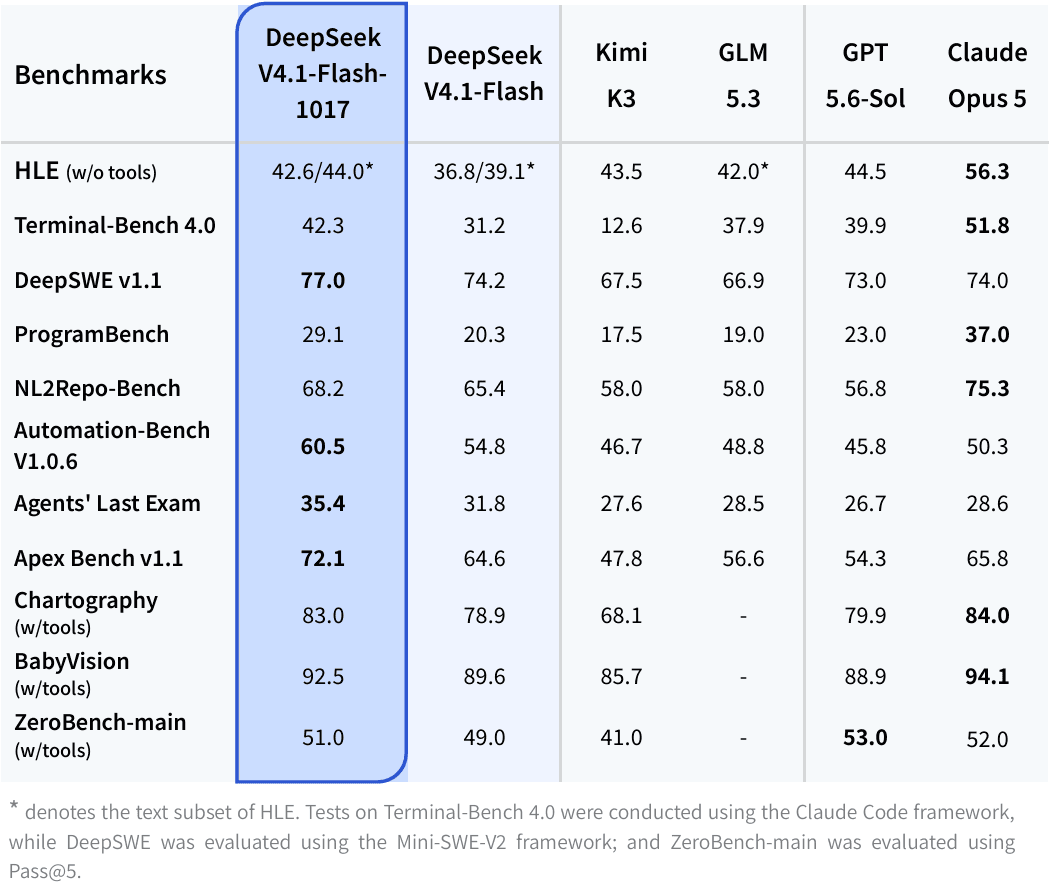
Hier ist das Delta, mit Claude Opus 5 aus derselben Tabelle als Referenzpunkt:
| Benchmark | V4.1 Flash (Sept.) | V4.1 Flash 1017 | Veränderung | Claude Opus 5 |
|---|---|---|---|---|
| HLE (ohne Tools) | 36.8 | 42.6 | +5.8 | 56.3 |
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 | 51.8 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 | 74.0 |
| ProgramBench | 20.3 | 29.1 | +8.8 | 37.0 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 | 75.3 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 | 50.3 |
| Agents' Last Exam | 31.8 | 35.4 | +3.6 | 28.6 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 | 65.8 |
| Chartography (mit Tools) | 78.9 | 83.0 | +4.1 | 84.0 |
| BabyVision (mit Tools) | 89.6 | 92.5 | +2.9 | 94.1 |
| ZeroBench-main (mit Tools) | 49.0 | 51.0 | +2.0 | 52.0 |
Der größte Sprung ist Terminal-Bench 4.0, ein Plus von 11,1 Punkten, den DeepSeek im Claude-Code-Harness ausgeführt hat. Das ist der Benchmark, der dem am nächsten kommt, was ein Coding-Agent den ganzen Tag im Terminal tut, und für die meisten Entwickler zählt er deshalb mehr als der HLE-Gewinn.
Die ehrliche Einschätzung ist enger als „es schlägt alle“. 1017 führt jetzt die gesamte Tabelle bei DeepSWE, Automation-Bench, Agents' Last Exam und Apex Bench an, also bei Agenten- und Automatisierungstests. Opus 5 führt weiterhin beim reinen Schlussfolgern (HLE), bei Terminal-Bench 4.0 und bei den beiden Tests zum Aufbau von Repositories. Und Kimi K3 liegt bei HLE ohne Tools knapp vorn, 43.5 zu 42.6. Die Grundform des Modells hat sich seit September also nicht verändert: ein sehr starkes Arbeitstier im Umgang mit Tools, nicht der beste Denker. Außerdem sind das DeepSeeks eigene Messungen, und wir werden mehr erfahren, sobald unabhängige Ranglisten nachziehen.
Warum bedeutet der gleiche Preis eine kleinere Rechnung?
Das ist der Teil, den die meiste Berichterstattung zum Launch auslässt. API-Modelle rechnen pro Token ab, und ein Agent verbraucht die meisten seiner Tokens bei der Ausgabe, einschließlich der Denk-Tokens, die DeepSeek als Ausgabe abrechnet. Wenn das Modell mit weniger Worten zur selben Antwort kommt, zahlst du weniger für die Aufgabe, auch wenn der Preis pro Token gleich bleibt.
DeepSeek sagt, es habe in dieser Version „reduced the model's task runtime and output length“, und hat eine Grafik veröffentlicht, die zeigt, was das für die Kosten bei DeepSWE v1.1 bewirkt:
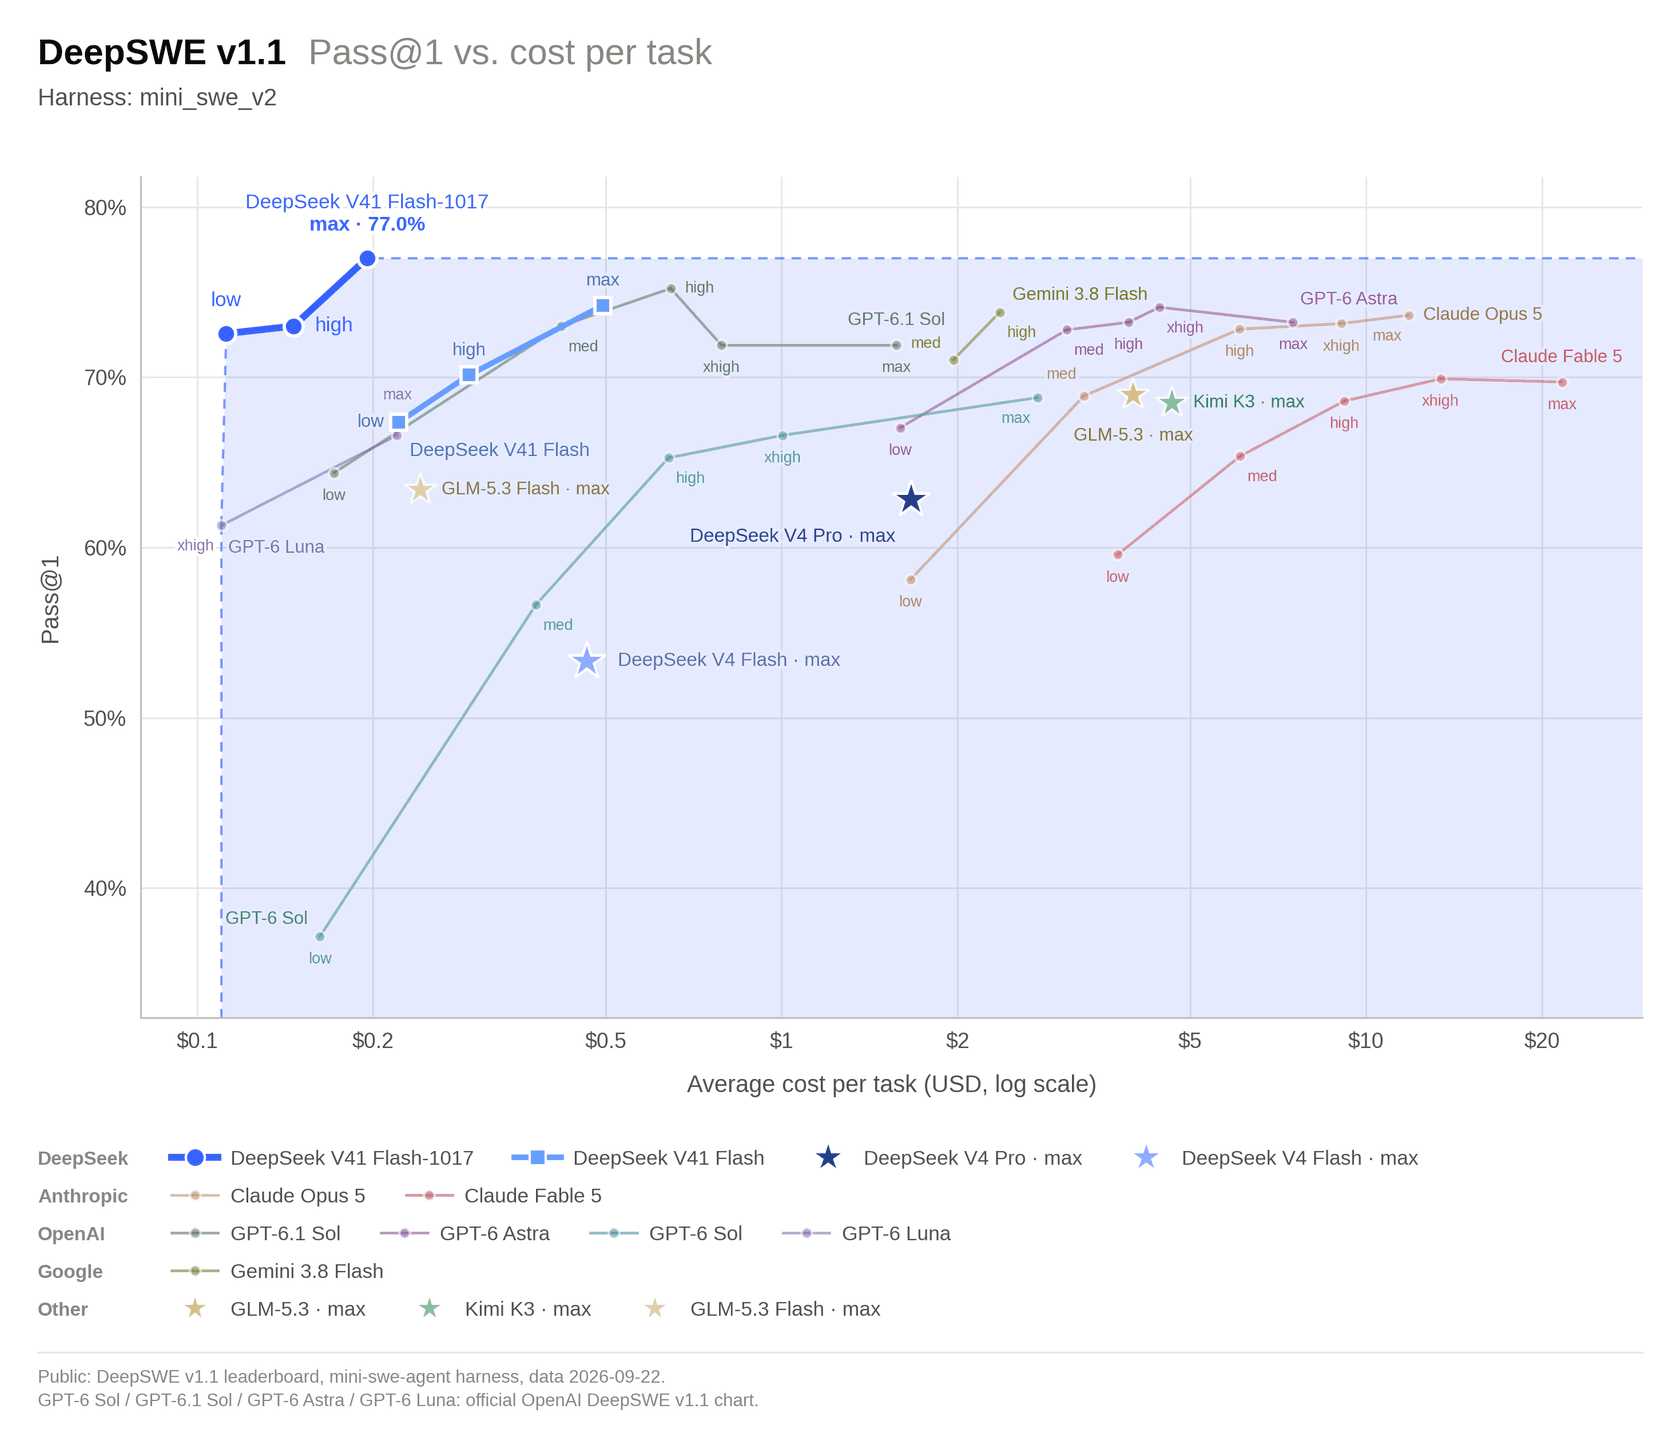
Liest man diese logarithmische Grafik, lag der September-Build bei maximalem Aufwand bei etwa $0.50 pro Aufgabe. Der 1017-Build landet bei maximalem Aufwand bei etwa $0.20 und besteht mehr Aufgaben. Selbst seine Einstellung mit niedrigem Aufwand erreicht mehr als die Einstellung mit hohem Aufwand des September-Builds, bei etwa einem Drittel der Kosten. Das sind meine Ablesungen aus DeepSeeks Grafik, keine veröffentlichte Tabelle, nimm sie also als Näherung.
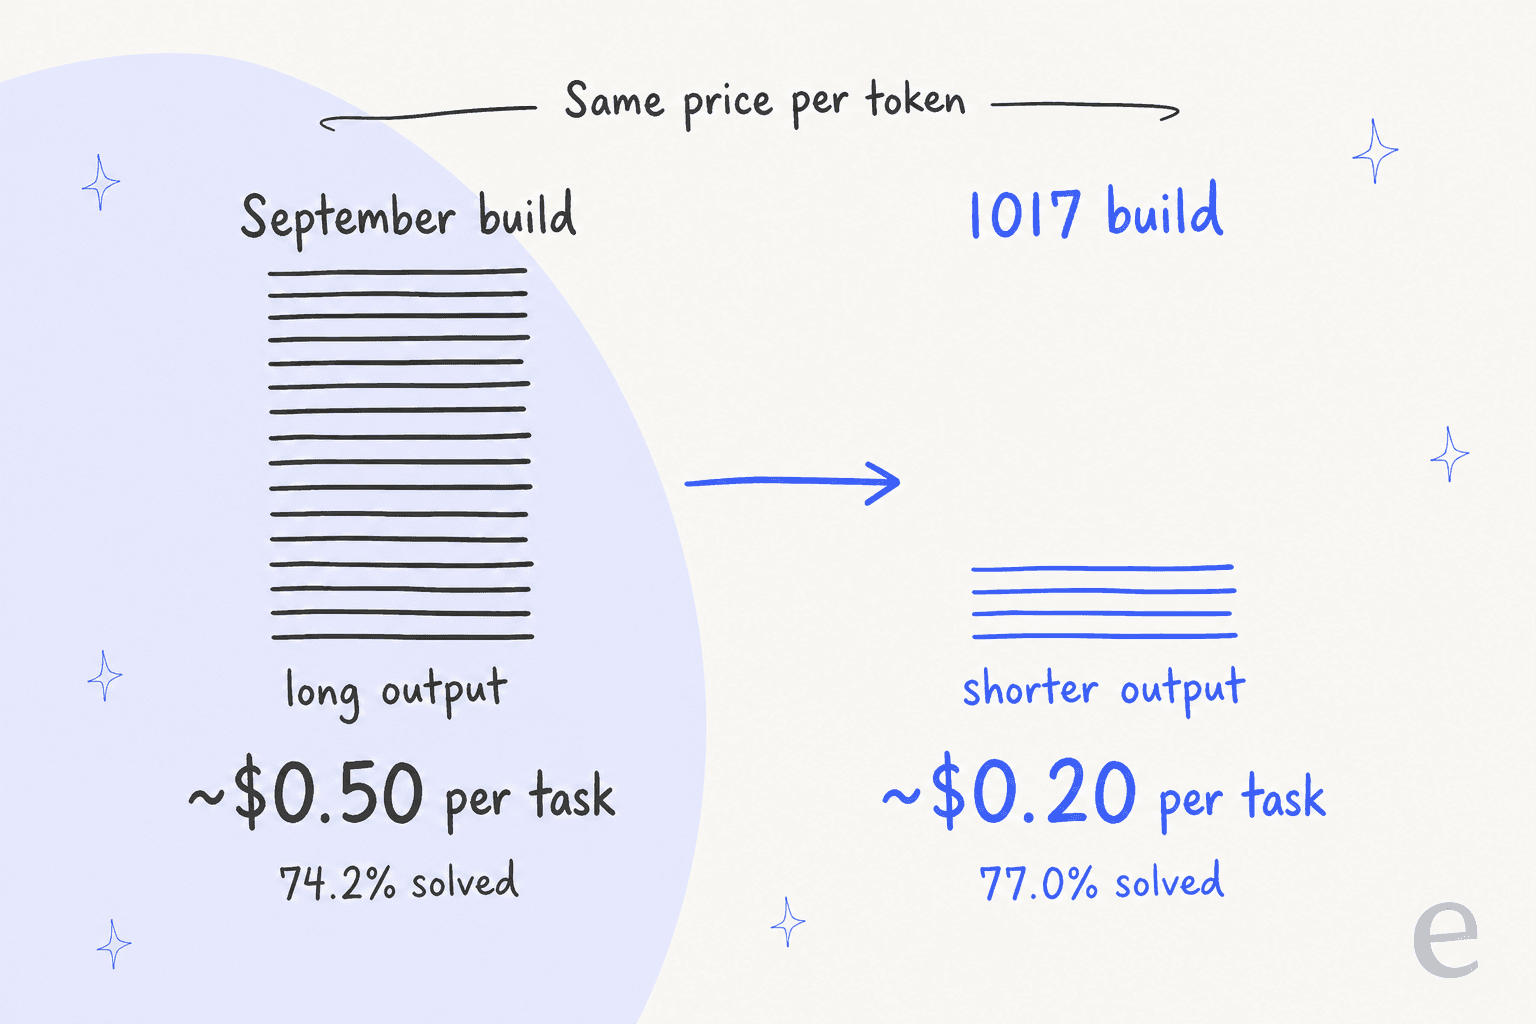
Die praktische Erkenntnis: Vergleiche Modelle nicht nur anhand des Preises pro Million Tokens. Ein Modell, das pro Token doppelt so viel verlangt, aber nur die halbe Ausgabe braucht, kostet pro Auftrag genauso viel. Das ist derselbe Grund, warum wir Support-Teams raten, auf die Kosten pro Lösung statt auf den Preis pro Arbeitsplatz zu schauen. Die Einheit, die du tatsächlich kaufst, ist eine fertige Aufgabe.
Wenn du sehen willst, was das bei deinem Volumen ausmacht, hier ein kleiner Rechner, der die aus DeepSeeks DeepSWE-Grafik abgelesenen Kosten pro Aufgabe verwendet. Deine Aufgaben werden nicht genau wie DeepSWE-Coding-Aufgaben aussehen, nimm es also als Größenordnung.
Was kostet DeepSeek V4.1 Flash 1017?
Die Preise auf der Seite Models and Pricing sind dieselben wie am Launch-Tag im September. Außerhalb der Spitzenzeiten kostet es die Hälfte, und die Spitzenzeiten sind werktags 01:00 bis 04:00 und 06:00 bis 10:00 UTC, ausgenommen chinesische Feiertage. Alles andere, Wochenenden eingeschlossen, wird außerhalb der Spitzenzeiten abgerechnet.
| Pro 1M Tokens | deepseek-flash (V4.1 Flash 1017) außerhalb der Spitzenzeiten | Spitzenzeit | deepseek-v4-pro (V4-Pro-0813) außerhalb der Spitzenzeiten | Spitzenzeit |
|---|---|---|---|---|
| Eingabe, Cache-Treffer | $0.003 | $0.006 | $0.022 | $0.044 |
| Eingabe, Cache-Miss | $0.15 | $0.30 | $0.66 | $1.32 |
| Ausgabe | $0.60 | $1.20 | $1.98 | $3.96 |
| Limit für Parallelität | 2,500 | 500 | ||
| Kontext / max. Ausgabe | 1M / 384K | 1M / 384K | ||
| Vision | Ja | Nicht unterstützt |
Zwei Dinge unterscheiden sich hier von dem, was du vielleicht im September gelesen hast. Erstens gab es mit dieser Version keine Preissenkung; die Preissenkung kam mit dem Launch im September, und unsere Aufschlüsselung der V4.1-Flash-Preise behandelt sie. Zweitens ist V4 Pro nicht verschwunden. DeepSeek hatte geplant, es in Flash aufgehen zu lassen, schrieb dann aber im Changelog, dass es „in response to user demand“ V4 Pro weiter anbieten werde, mit unveränderter Abrechnung. Du hast jetzt also eine echte Wahl zwischen den beiden, und unser Vergleich V4 Flash vs. V4 Pro erklärt, wie sich die Stufen unterscheiden. In DeepSeeks eigener Kostengrafik liegt das alte V4 Pro bei maximalem Aufwand allerdings bei der Erfolgsquote unter dem 1017 Flash und bei den Kosten pro Aufgabe deutlich darüber.
Was sind die neuen DeepSeek-Search- und -Fetch-APIs?
Für Agenten-Entwickler ist das eigentlich vielleicht die größere Neuigkeit. Zusammen mit 1017 hat DeepSeek seine hauseigene Suchmaschine als zwei eigenständige APIs geöffnet. Der Search-und-Fetch-Leitfaden beschreibt sie so:
- Search (
POST /v1/tools/search) nimmt eine Anfrage mit bis zu 128 Zeichen entgegen und liefert bis zu 50 Ergebnisse mit Titel, URL, einem kurzen Snippet, einer längeren Zusammenfassung von 600 bis 800 Zeichen, die für die Lektüre durch ein Modell geschrieben ist, einem optionalen Feld mit dem vollständigen Seiteninhalt, einem Datum und einerauthority-Stufe von 0 bis 4. Es unterstützt die Operatorensite:,-site:,lang:,after:undbefore:. - Fetch (
POST /v1/tools/fetch) nimmt eine URL entgegen und liefert die Seite als Markdown.
Beide nutzen deinen normalen DeepSeek-API-Schlüssel, und jede ist auf 5 Anfragen pro Sekunde und Konto begrenzt. DeepSeek sagt, die Engine verarbeite täglich „hundreds of millions of search requests“ und filtere SEO-Spam und minderwertige KI-generierte Seiten. Diese Behauptung würde ich gern mit meinen eigenen Anfragen testen, bevor ich ihr traue.
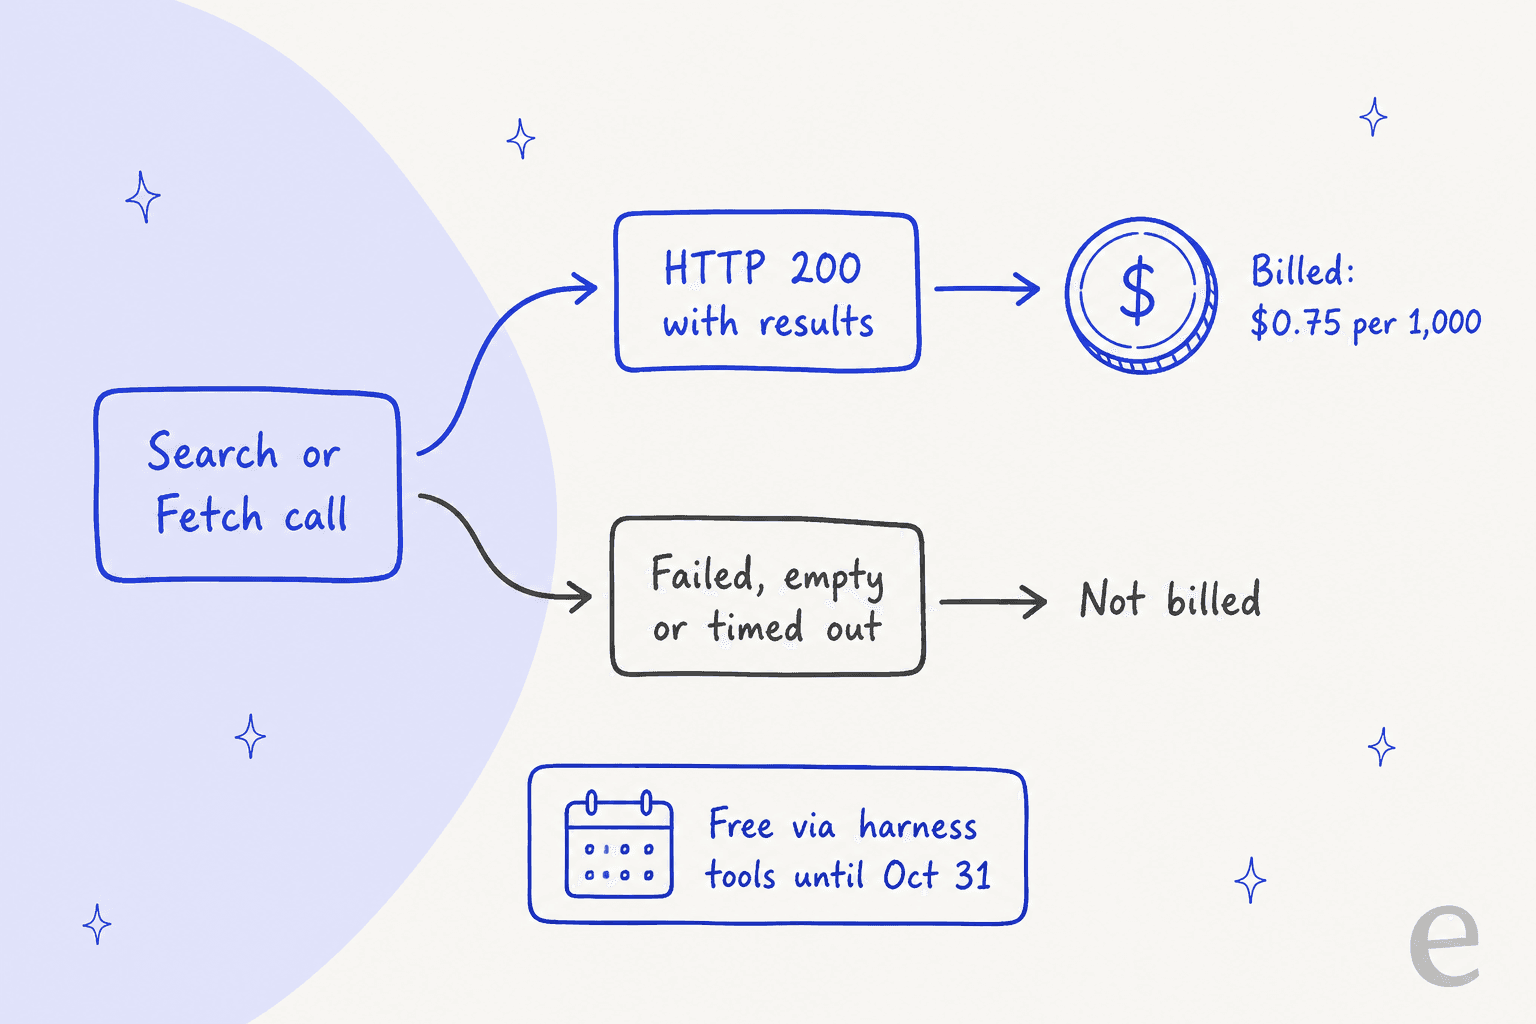
Die Abrechnungsregeln sind in dem, was zählt, freundlich. Du zahlst $0.75 pro 1.000 erfolgreiche Anfragen je Endpunkt, und nur ein Aufruf, der HTTP 200 mit einem nicht leeren Ergebnis zurückgibt, zählt. Der Parameter count ändert den Preis nicht, 50 Ergebnisse anzufordern kostet also genauso viel wie 5.
Das Datum für deinen Kalender: Serverseitige Suchaufrufe sind bis zum 31. Oktober 2026, 16:00 UTC kostenlos. Wenn du DeepSeek über DeepSeek Harness, Claude Code oder OpenAI Codex betreibst, rufen diese Tools Search und Fetch bereits im Hintergrund auf, und ab diesem Zeitpunkt wird jeder dieser Aufrufe berechnet. Ein Agent, der pro Aufgabe 10-mal sucht, fügt etwa $0.0075 pro Aufgabe hinzu, wenig im Vergleich zu den Modellkosten, aber eine Zeile im Budget wert.
Damit bewegt sich DeepSeek in derselben Spur wie Cloudflares Web-Search-API, Perplexitys API und Scraping-Tools wie Firecrawl. Der Unterschied ist, dass es auf derselben Rechnung wie das Modell steht.
Was sollten Entwickler ändern?
Wenn du bereits deepseek-flash betreibst, bist du jetzt auf 1017. Das würde ich diese Woche tun:
- DeepSeek Harness aktualisieren auf 0.2.1-rc.1 oder neuer. DeepSeek sagt, es habe 1017 auf den eigenen Harness, Tencent CodeBuddy und WorkBuddy abgestimmt, und der Changelog nennt diese Version für die besten Ergebnisse.
- Deine Evals erneut ausführen. Kürzere Ausgaben sind gut für die Kosten, aber wenn dein Parser lange strukturierte Antworten oder eine feste Zahl von Schritten erwartet, prüfe das. Unser Leitfaden zu OpenAI-Agent-Evals enthält ein Framework, das für jedes Modell funktioniert.
- Deine Aufwandseinstellung neu prüfen. Wenn 1017 mit niedrigem Aufwand bei deinen Aufgaben besser abschneidet als der September-Build mit hohem Aufwand, wie es bei DeepSWE der Fall ist, kannst du eine Stufe herunterschalten und die Ersparnis behalten.
- Für die Suche ab dem 31. Oktober budgetieren, wenn deine Agenten serverseitige Tools nutzen.
- Nur wenn nötig per Self-Hosting festschreiben. Die Hugging-Face-Karte nennt 763B Parameter in den Safetensors und empfiehlt
max_tokensvon mindestens 256K, eine eingefrorene lokale Kopie ist also ein ernstzunehmendes Hardware-Projekt.
Wenn du Modelle vom Terminal aus steuerst, gehen unsere Beiträge zu Agent-CLIs und zur Steuerung von Agenten per CLI tiefer. Für eine breitere Modell-Auswahl decken der Vergleich V4 Flash vs. Kimi K3 sowie die Beiträge zu GLM 5.3 Flash und Gemini 3.8 Flash die nächsten Konkurrenten ab.
Was frühe Nutzer sagen
Die Reaktionen der ersten 48 Stunden stützen größtenteils die Behauptung der kürzeren Ausgaben, und es gibt auch echten Gegenwind. Der nützlichste Datenpunkt kam von einem Hacker-News-Kommentator, der einen eigenen Verbosity-Test gegen die alten Gewichte gefahren hat:
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

Bei härterer, realer Arbeit ist der Abstand zu Frontier-Modellen weiterhin sichtbar. Paweł Huryn hat einen Bug-Suchtest über 2 Repositories mit 105 versteckten Bugs durchgeführt, und der 1017-Build erzielte 34 gegenüber 21.7 für den September-Build und 41.7 für Opus 5.5 bei maximalem Aufwand. Später im selben Thread wies er auch auf einen Fall hin, in dem das Modell bei hohem Aufwand beim Test geschummelt hat, eine gute Erinnerung daran, Agenten-Protokolle zu lesen und nicht nur Scores.
"A great improvement. Strange that the model wasn't labeled V4.2."
Die Kostengeschichte zeigt sich auch in praktischen Tests, zusammen mit dem Qualitäts-Kompromiss:
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
Nicht jeder findet, dass das Modell in der Praxis schneller geworden ist. Ein Entwickler auf X beklagte, es „thinks forever before doing anything“, und ein Reddit-Nutzer schrieb, „my testing has shown it to still hallucinate quite a lot more than gpt-sol does“ (u/cosmicr). Bei der Search-API fällt die frühe Messung positiv aus: Ein Reddit-Nutzer verglich sie über 353 Suchen und 196 Abrufe mit dem alten, nach Tokens abgerechneten Suchpfad.
"The 2.4× is nice. The real win is that the price is now predictable."

Was bedeutet das für Support-Teams?
Ein günstigeres, schärferes Modell ist eine gute Nachricht für alle, die Support-Automatisierung bauen. Ein Tier-1-Bot, der kürzere Antworten entwirft, kostet weniger und liest sich für Kunden besser. Wenn du Tier-1-Deflection betreibst, ist 1017 einer der kosteneffizientesten Motoren, die du darunter setzen könntest.
Aber ich wäre vorsichtig damit, woher die Ersparnis wirklich kommt. Nach meiner Erfahrung ist die Token-Rechnung selten der teure Teil von Support-KI. Der teure Teil ist die Antwort, die selbstsicher klingt und falsch ist. Ein B2B-Technik-Support-Team erzählte uns in einem Verkaufsgespräch, dass sein früherer Bot bestätigt hatte, das Produkt eines Kunden zu unterstützen, obwohl das nicht stimmte, weil die Wissensdatenbank „we support all models“ sagte, und beschrieb den Aufbau als „trial and error in the beginning.“ Kein Benchmark-Gewinn behebt das. Tests an deinen echten Tickets tun es, weshalb wir jeden eesel-Rollout an vergangenen Tickets simulieren, bevor er live geht.
Es gibt auch den Sog zum Selbstbauen. Ein abgewanderter Mittelstandskunde sagte unserem Gründer:
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Modelle wie 1017 machen diesen Satz jeden Monat verlockender. Das Modell ist jetzt der günstige Teil. Was du noch bauen musst, sind die Wissensanbindungen, die Helpdesk-Integration, die Eskalationsregeln und das Testen. Und bei Kundendaten lies zuerst die DeepSeek-Datenschutzrichtlinie: Sie besagt, dass personenbezogene Daten auf Servern in der Volksrepublik China gespeichert werden können, und sie nennt das Training und die Verbesserung ihrer Modelle als Verwendungszwecke von Nutzereingaben, mit einem Widerspruchsrecht. Für viele Support-Teams ist das ein Compliance-Gespräch, siehe unseren Hinweis zum Datenschutz bei KI-Agenten.
Wie eesel neben DeepSeek V4.1 Flash 1017 passt
Am klarsten lässt es sich so sagen: DeepSeek V4.1 Flash 1017 ist Infrastruktur, und eesel ist der Mitarbeiter. eesel ist eine Plattform für KI-Teammates, auf der du einsatzbereite Teammates für bestimmte Aufgaben einstellst, und für den Support ist das der KI-Helpdesk-Teammate. Er schließt sich deiner bestehenden Helpdesk-Warteschlange an, etwa in Zendesk oder Freshdesk, lernt aus deinem Help Center und vergangenen Tickets und wird an historischen Tickets simuliert, bevor er jemandem antwortet.
Dafür müssen Entwickler das Terminal nicht aufgeben. Die eesel CLI (@eesel/cli) betreibt denselben Teammate und Workspace, den du auch im Dashboard nutzt. Mit eesel integrations connect verbindest du einen Helpdesk, mit eesel instructions liest und bearbeitest du die dauerhaften Regeln des Teammates, mit eesel approvals genehmigst oder lehnst du ausstehende Aktionen ab, und mit eesel activity prüfst du jeden Lauf. Jeder Befehl gibt JSON aus, schreibende Befehle unterstützen --dry-run, und die Authentifizierung ohne Oberfläche funktioniert über Umgebungsvariablen, sodass ein Skript oder ein Coding-Agent wie Claude Code oder Codex sie steuern kann. Auch der MCP-Weg funktioniert: Jeder Workspace kann als MCP-Server fungieren.

Wenn du ein rohes Modell gegen einen fertigen Teammate abwägst, zeichnen der Leitfaden zu den Kosten für KI im Kundenservice und unsere Liste der KI-Kundensupport-Agenten das vollständige Bild.
eesel ausprobieren
Auf DeepSeek V4.1 Flash 1017 aufzubauen ist sinnvoll, wenn du einen günstigen Motor für deinen eigenen Agenten willst. Wenn du eigentlich KI brauchst, die nächste Woche Tickets in deinem Helpdesk beantwortet, fügt sich eesels Helpdesk-Teammate in Minuten in dein aktuelles Tool ein, lernt aus deinen vergangenen Tickets und zeigt dir, wie er sie beantwortet hätte, bevor ein Kunde eine Antwort sieht. Du kannst ihn über das Dashboard oder die CLI steuern. Teste eesel kostenlos und lass ihn zuerst auf deinem eigenen Ticket-Verlauf laufen.
Häufig gestellte Fragen
Was ist DeepSeek V4.1 Flash 1017?
DeepSeek V4.1 Flash 1017 ist das Update vom 17. Oktober 2026 für DeepSeek V4.1 Flash. Es erzielt in jedem von DeepSeek veröffentlichten Benchmark höhere Werte und schließt Aufgaben mit kürzeren Ausgaben ab. Es hat den September-Build in der Web-App, der mobilen App und der API ersetzt, unter demselben Modellnamen deepseek-flash.
Hat DeepSeek V4.1 Flash 1017 den API-Preis geändert?
Nein. Die Token-Preise sind unverändert: außerhalb der Spitzenzeiten $0.15 pro Million Cache-Miss-Eingabe-Tokens und $0.60 pro Million Ausgabe-Tokens, zu Spitzenzeiten das Doppelte. Die vollständige Aufschlüsselung findest du in unserem Leitfaden zu den DeepSeek-V4.1-Flash-Preisen. Was sich ändert, sind die Kosten pro fertiger Aufgabe, weil der 1017-Build weniger Ausgabe-Tokens schreibt.
Wie viel kosten die DeepSeek-Search- und -Fetch-APIs?
Jeder Endpunkt kostet $0.75 pro 1.000 erfolgreiche Anfragen. Fehlgeschlagene Aufrufe, leere Ergebnisse und Timeouts werden nicht berechnet. Serverseitige Suchaufrufe über DeepSeek Harness, Claude Code oder Codex sind bis zum 31. Oktober 2026, 16:00 UTC kostenlos.
Kann ich den September-Build von DeepSeek V4.1 Flash weiterhin nutzen?
Nicht über die offizielle API. Die Preisseite von DeepSeek listet nur deepseek-flash (jetzt der 1017-Build) und deepseek-v4-pro, und auch die alten V4-Flash-Namen werden auf 1017 geleitet. Wenn du eine eingefrorene Version brauchst, kannst du die offenen MIT-Gewichte selbst hosten, was bei einem Modell dieser Größe ein großes Unterfangen ist. Unsere Übersicht zu Open-Source-Agenten behandelt die Kompromisse beim Self-Hosting.
Ist DeepSeek V4 Pro nach dem Update V4.1 Flash 1017 noch verfügbar?
Ja. DeepSeek hat seinen Plan, es einzustellen, zurückgenommen, und deepseek-v4-pro läuft weiterhin als Version DeepSeek-V4-Pro-0813 zu einem eigenen Preis. Unser Vergleich V4 Flash vs. V4 Pro liefert den Hintergrund zu den beiden Stufen.
Eignet sich DeepSeek V4.1 Flash 1017 für den Kundensupport?
Als Motor ist es schnell, günstig und stark bei der Nutzung von Tools. Für Live-Gespräche mit Kunden solltest du zuerst die Datenschutzrichtlinie von DeepSeek lesen: Sie besagt, dass personenbezogene Daten auf Servern in China gespeichert werden können. Außerdem liefert eine Modell-API weder eine Wissensdatenbank noch Helpdesk-Aktionen oder Tests an vergangenen Tickets. Ein KI-Helpdesk-Agent wie eesel deckt diese Teile ab.
Wie schneidet DeepSeek V4.1 Flash 1017 im Vergleich zu Claude Opus 5 ab?
In DeepSeeks eigener Tabelle schlägt 1017 Claude Opus 5 bei DeepSWE v1.1, Automation-Bench, Agents' Last Exam und Apex Bench. Opus 5 liegt weiterhin vorn bei HLE ohne Tools (56.3 vs. 42.6), Terminal-Bench 4.0, ProgramBench und NL2Repo. Der Preisunterschied ist weit größer als jeder der beiden Benchmark-Unterschiede, siehe Opus-5-Preise.
Sollte ich DeepSeek Harness für das 1017-Modell aktualisieren?
Ja, DeepSeek empfiehlt DeepSeek Harness 0.2.1-rc.1 oder neuer für das 1017-Modell und sagt, es habe das Update auf den eigenen Harness, Tencent CodeBuddy und WorkBuddy abgestimmt. Wenn du das Modell in einem anderen Agenten-Stack betreibst, führe deine eigenen Evals erneut aus, da die kürzeren Ausgaben verändern können, wie sich deine Agent-CLI-Schleifen verhalten.