

ERNIE 5.5 Flash ist ein offenes 280B-Parameter-Basismodell von Baidu mit 14B aktiven Parametern pro Token, veröffentlicht am 5. November 2026. In Baidus eigener Tabelle schlägt es DeepSeek V4 Flash Base in 26 von 30 Tests. Aber es ist ein Pre-Training-Checkpoint: Es gibt keine Chat- oder Tool-Use-Version, keinen gehosteten API-Preis, und die Lizenz schließt die EU, das Vereinigte Königreich und Südkorea aus. Für einen Helpdesk-Agenten lohnt es sich, auf das nachtrainierte Modell zu warten. Das hier ist das Modell; eesel ist das Teammitglied.
Was ist ERNIE 5.5 Flash?
ERNIE 5.5 Flash ist ein spärliches Mixture-of-Experts-Transformer-Modell von Baidu. Was Baidu am 5. November 2026 veröffentlicht hat, ist ERNIE-5.5-Flash-Base, der Checkpoint "am Ende des Pre-Trainings, vor jeglichem Mid- oder Post-Training". Baidu sagt, das sei Absicht: Entwickler können die Gewichte nehmen und selbst entscheiden, wohin sie als Nächstes trainiert werden.
Ich arbeite an eesels KI-Agenten, daher ist das Erste, was ich bei jedem Modell-Launch prüfe, in welcher Trainingsphase die Gewichte stehen. Hier lautet die Antwort: die früheste nutzbare Phase, und das verändert fast alles daran, wie der Rest dieses Beitrags zu lesen ist.
Das Datenblatt, aus Baidus Modellkarte:
| Spezifikation | ERNIE-5.5-Flash-Base |
|---|---|
| Gesamt- / aktive Parameter | 280B / 14B pro Token |
| Layer | 43 (1 dicht, 42 Mixture-of-Experts) |
| Experten | 512 geroutet (Top 10 pro Token) plus 1 geteilt |
| Pre-Training-Daten | 33.5T Tokens |
| Kontext | 128K im Training, 1M für Fine-Tuning und Inferenz |
| Modalität | Nur Text |
| Gewichte | FP8- und BF16-Safetensors |
| Vokabular | 201,216 Tokens |
| Lizenz | ERNIE 5.5 Flash Base Model License v1.0 |
Nur etwa 5% der Parameter arbeiten an einem einzelnen Token, so kann ein 280B-Modell wie ein 14B-Modell laufen. Das ist derselbe Kompromiss, den auch DeepSeek V4 Flash bei 284B gesamt und 13B aktiv eingeht.
Was ist neu am Design?
Baidus technischer Blog dreht sich größtenteils um Kosten: wie viel Speicher ein langer Kontext verbraucht, und wie günstig man weiter trainieren kann. Vier Entscheidungen fallen auf.
- Günstige Attention. Jeder siebte Layer behält die volle Kontext-Attention. Der Rest nutzt "Heavily Compressed Attention", das einen einzigen Cache-Eintrag pro 128 Tokens speichert, sodass das Kontextfenster deutlich weniger Speicher kostet.
- Mehrere Router pro Layer. Statt dass ein Router die Experten auswählt, nutzt jeder Mixture-of-Experts-Layer mehrere unabhängige Router, nach dem Argument, dass die Bewertung eines einzelnen Routers ein schwacher Hinweis darauf ist, welcher Experte hilft.
- Eingebautes spekulatives Decoding. Der letzte Layer des Modells fungiert zugleich als Entwurfsmodell, ein Design, das Baidu ECHO nennt, sodass schnellere Generierung kein separates Hilfsmodell braucht.
- Code und lange Dokumente in den Daten. Das Pre-Training stützt sich stark auf Code auf Repository-Ebene und Long-Context-Daten, einschließlich Commits, Pull Requests und Code-Reviews.
Nichts davon sagt, ob sich das Modell gut unterhalten lässt. Es sagt, dass das Modell darauf ausgelegt ist, günstig zu fine-tunen und zu servieren, wofür eine Basisveröffentlichung gedacht ist.
Ist ERNIE 5.5 Flash ein Chat-Modell?
Nein, und das ist die wichtigste Tatsache dazu. Die Gewichte sind der Pre-Training-Checkpoint, und Baidu sagt, das nachtrainierte ERNIE 5.5 Flash werde folgen. Kein Datum wurde genannt. Die Modellkarte sagt, es werde über den Completions-Endpunkt bedient, das heißt, man sendet Text und es setzt den Text fort, ohne Chat-Format.
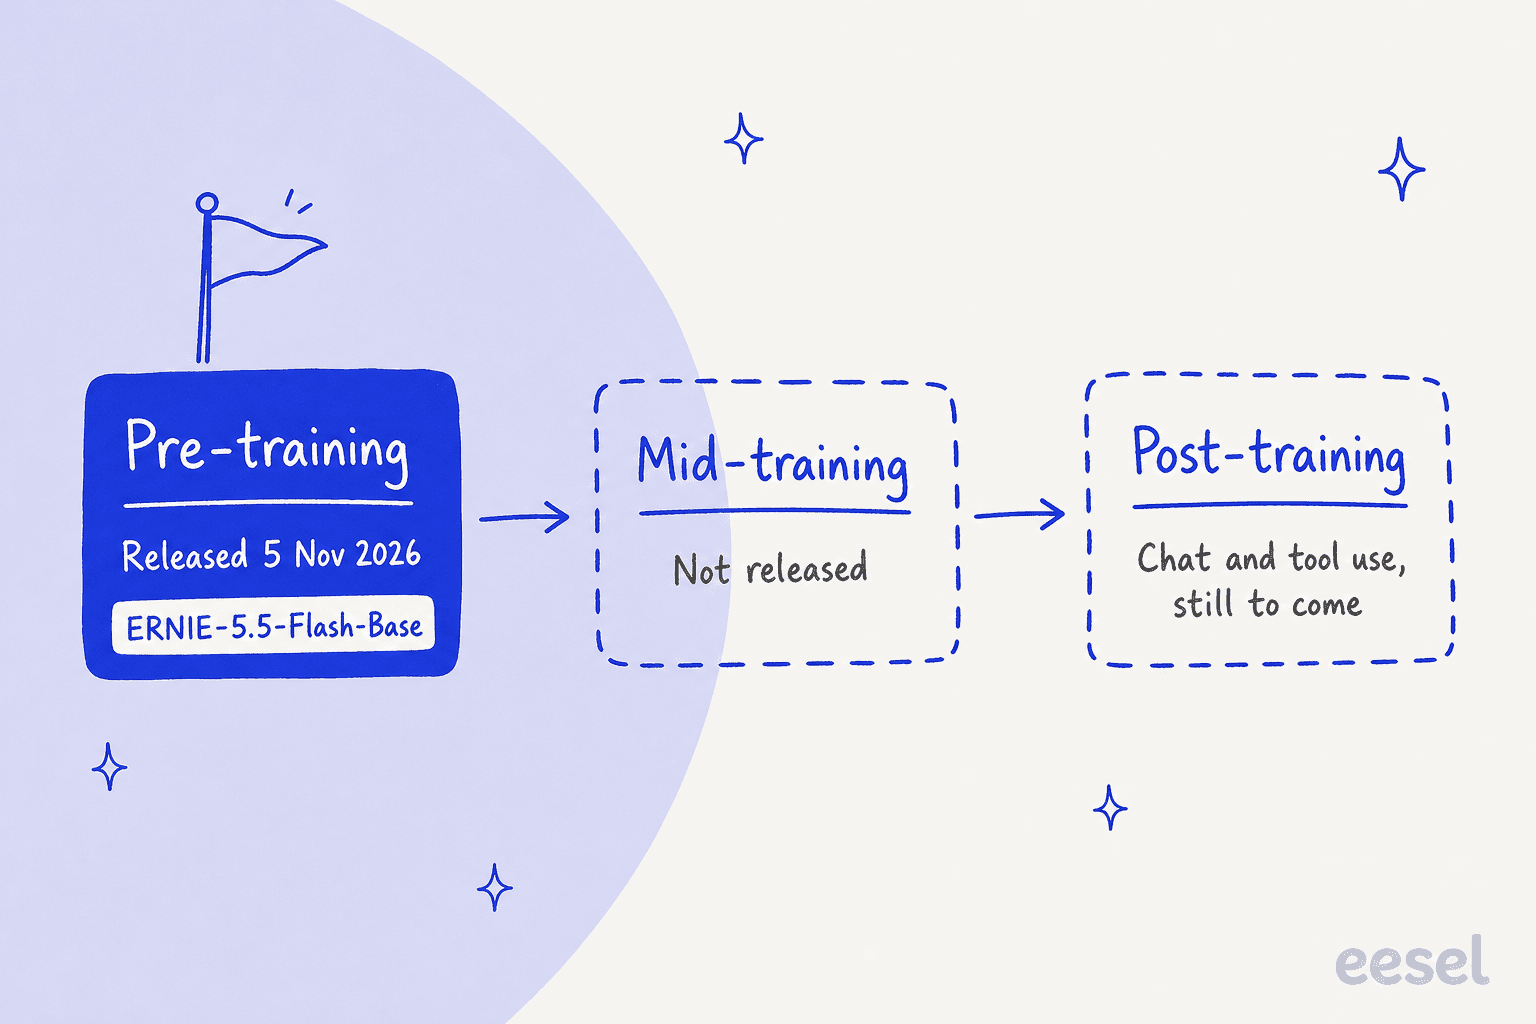
Ein nachtrainiertes Modell ist dasjenige, das Anweisungen befolgt, in einer Persona bleibt, Tools aufruft und Nein sagt. Baidus Flaggschiff-Reihe ist davon getrennt: Die ERNIE-5.1-Veröffentlichung ist auf den 9. Mai 2026 datiert, und ERNIE 5.0 ist ein multimodales Modell mit 2,4 Billionen Parametern. ERNIE 5.5 Flash ist eine andere, auf Effizienz ausgerichtete Reihe, und vorerst sind nur ihre rohen Zutaten öffentlich.
Ein Hacker-News-Kommentator brachte die praktische Bedeutung im Launch-Thread, der 162 Punkte erreichte, klar auf den Punkt:
"It's not instruction finetuned, so no, it's not good to use for anything like coding agents."

Was sagen die Benchmarks von ERNIE 5.5 Flash?
In Baidus Tabelle gewinnt das Basismodell die meisten Zeilen. Baidu verglich es mit drei anderen Basismodellen, DeepSeek-V4-Flash-Base (284B gesamt, 13B aktiv), Hy3-preview-Base (295B, 21B) und MiMo-V2.5-Base (310B, 15B), "alle mit derselben Pipeline, denselben Prompts und denselben Few-Shot-Einstellungen bewertet". Gegen DeepSeek erzielt ERNIE auf 26 von 30 Zeilen höhere Werte.
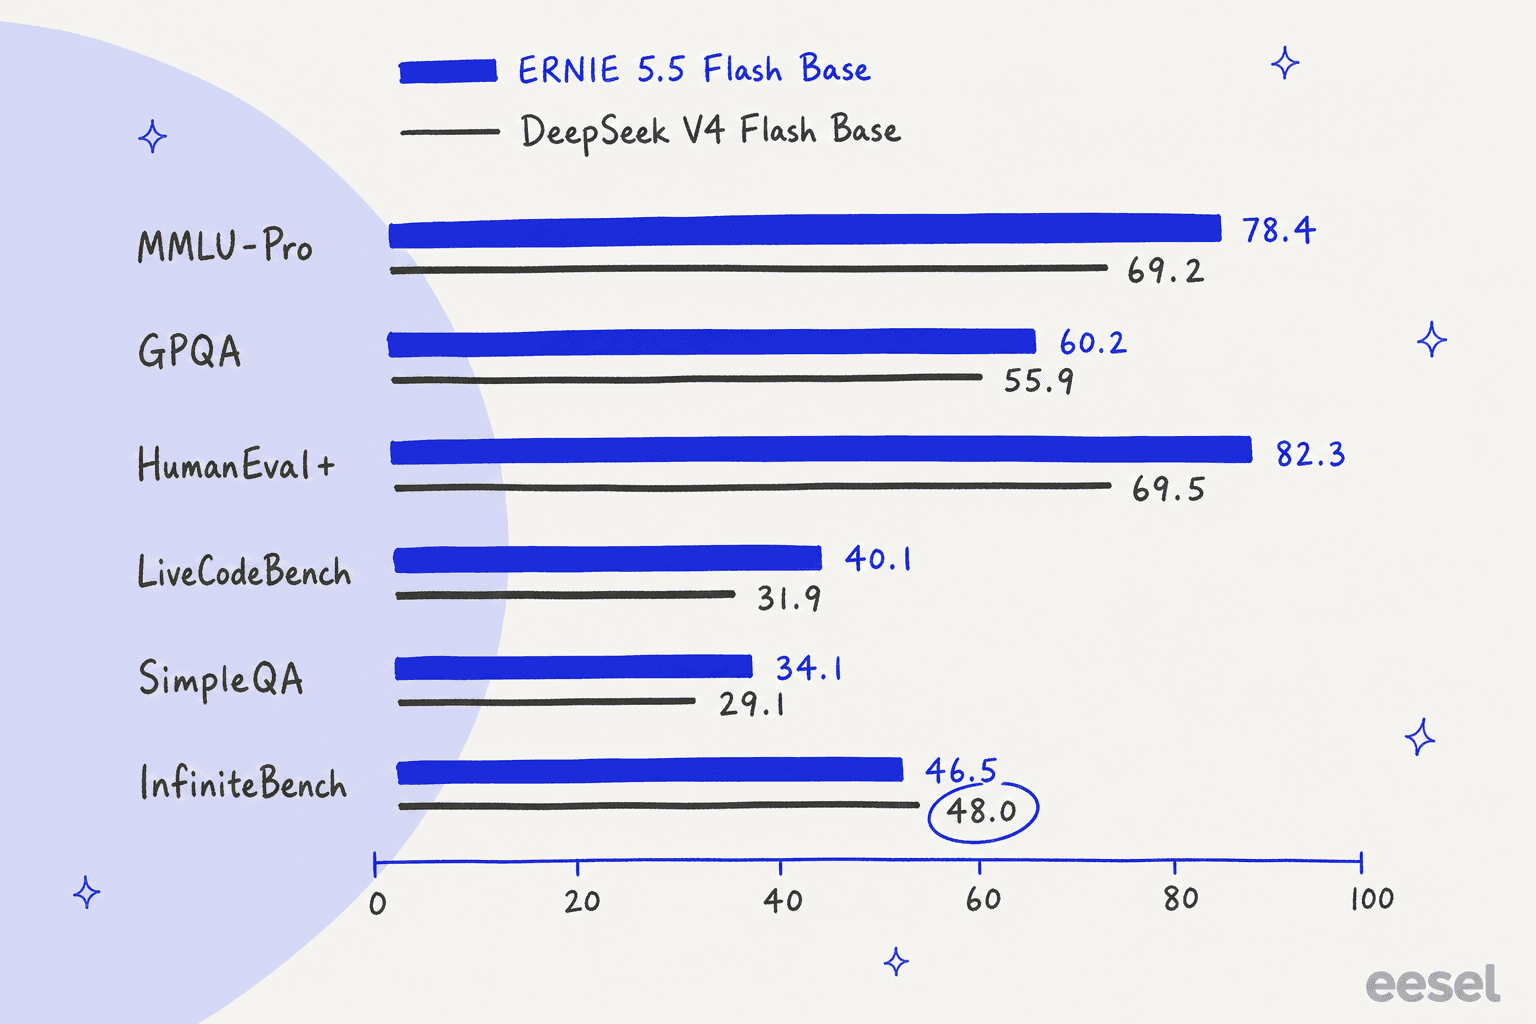
Hier ein Ausschnitt aus der vollständigen Tabelle, einschließlich jeder Zeile, in der ERNIE gegen DeepSeek verlor:
| Benchmark | ERNIE 5.5 Flash Base | DeepSeek V4 Flash Base |
|---|---|---|
| MMLU-Pro | 78.4 | 69.2 |
| GPQA | 60.2 | 55.9 |
| HumanEval+ | 82.3 | 69.5 |
| LiveCodeBench | 40.1 | 31.9 |
| RepoQA (langer Kontext) | 91.7 | 81.0 |
| SimpleQA | 34.1 | 29.1 |
| ChineseSimpleQA | 73.0 | 75.3 |
| INCLUDE-lite (mehrsprachig) | 79.5 | 79.8 |
| HELMET-Rerank (langer Kontext) | 56.2 | 60.0 |
| InfiniteBench (langer Kontext) | 46.5 | 48.0 |
Drei Gründe, diese Zahlen mit Vorsicht zu genießen:
- Es sind Baidus eigene Durchläufe. Ich konnte keine unabhängige Auswertung finden. Artificial Analysis hat noch keine ERNIE-5.5-Seite.
- Es sind Basismodell-Tests. Few-Shot-Wissen und Code-Benchmarks messen, was das Pre-Training aufgebaut hat. Sie messen nicht, ob das Modell einem System-Prompt folgt oder eine mehrstufige Aufgabe abschließt.
- Der Rivale ist nicht der neueste. Ein Hacker-News-Kommentator merkte an, dass Baidu gegen die ältere V4-Flash-Base verglich, im Grunde zwei Versionen hinter der neuesten DeepSeek-Flash-Version.
"They're comparing it to Deepseek-v4-Flash, not 4.1 and not the 4.1 1017 update, so essentially two versions behind the latest version of Deepseek Flash."
Die faire Lesart ist, dass das Pre-Training stark aussieht, besonders bei Code und Wissen, und dass die Long-Context-Zeilen durchwachsen sind. Ob das das Post-Training überlebt, ist die offene Frage.
Wie viel kostet ERNIE 5.5 Flash?
Die Gewichte kosten nichts zum Herunterladen, und es gibt keinen Baidu-API-Preis zu nennen. Die Hugging-Face-Seite sagte, als ich sie erfasste, dass das Modell "isn't deployed by any Inference Provider" ist, und ich fand auch keinen OpenRouter-Eintrag.
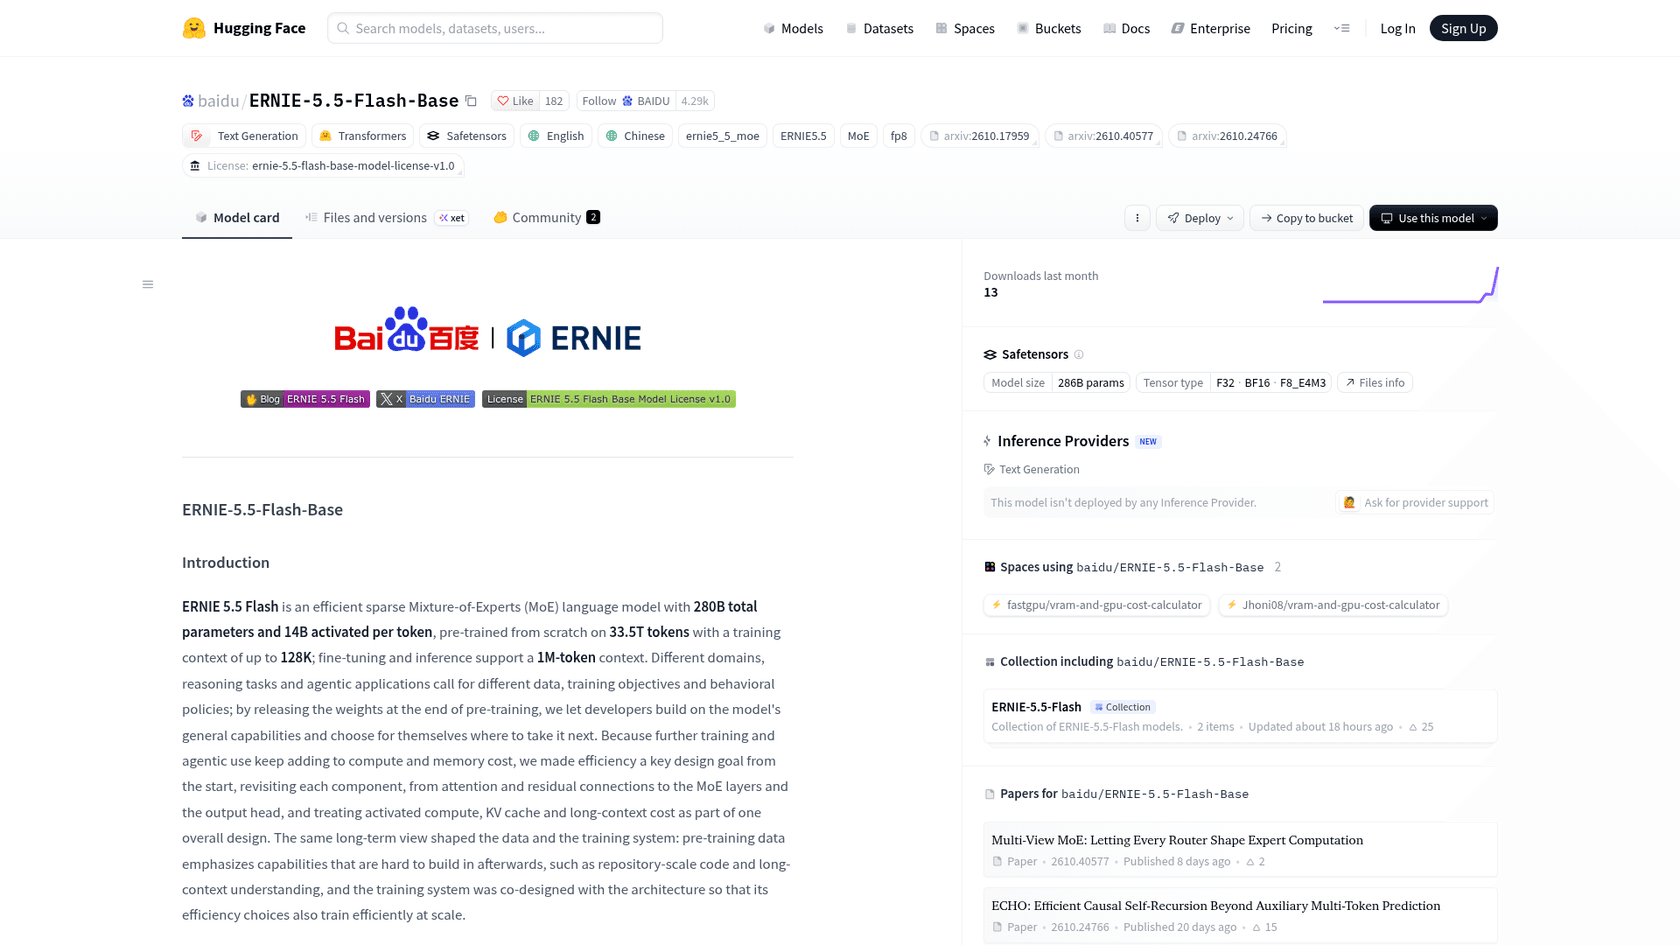
Der reale Preis sind also Hardware und Engineering. Hugging Face listet 286B Parameter, und FP8-Gewichte brauchen etwa ein Byte pro Parameter, sodass Sie nach meiner Rechnung grob 286 GB brauchen, nur um das Modell zu halten, noch bevor ein KV-Cache dazukommt. Baidus eigene Launch-Befehle sind auf Vierfach-Parallelität ausgelegt: --tp 4 für SGLang und --data-parallel-size 4 für vLLM.
Um zu sehen, wo das im Vergleich zu gehosteten Optionen steht, hier eine angenommene Workload: 10,000 Support-Gespräche im Monat, je 3,000 Eingabe- und 500 Ausgabe-Tokens, also 30M Eingabe- und 5M Ausgabe-Tokens, ohne Caching und ohne Reasoning-Tokens. Die Preise stammen von der jeweiligen Anbieterseite.
| Modell | Eingabe / Ausgabe pro 1M Tokens | Monatsrechnung für diese Workload |
|---|---|---|
| ERNIE 5.5 Flash | Kein gehosteter Preis veröffentlicht | Ihre eigenen GPUs |
| Claude Haiku 5.5 (Prompts bis 100K) | $0.10 / $0.50 | $5.50 |
| GPT-6 Luna | $0.10 / $0.50 | $5.50 |
| Qwen3.8-Flash (international) | $0.15 / $0.47 | $6.85 |
| DeepSeek V4.1 Flash (Nebenzeit) | $0.15 / $0.60 | $7.50 |
| DeepSeek V4.1 Flash (Spitzenzeit) | $0.30 / $1.20 | $15.00 |
| Gemini 3.8 Flash (bis 31. Dez. 2026) | $0.75 / $3.75 | $41.25 |
Das sind winzige Rechnungen. Bei diesem Volumen werden gehostete Tokens fast sicher günstiger sein als ein Multi-GPU-Server, der rund um die Uhr läuft, obwohl ich die Hardware nicht bepreist habe. Ein offenes Modell selbst zu hosten lohnt sich aus anderen Gründen, etwa um Daten im eigenen Netz zu halten oder ein Modell auf den eigenen Hausstil zu trainieren, und genau dafür ist ein Basismodell gedacht: ein Fine-Tune. Tiefere Preisbeiträge gibt es zu DeepSeek V4.1 Flash Preisen und Claude Haiku 5.5 Preisen.
Wer darf ERNIE 5.5 Flash nutzen?
Weniger Menschen, als das Wort "offen" vermuten lässt. Die ERNIE 5.5 Flash Lizenz ist Baidus eigene Vereinbarung, und vier Klauseln zählen in der Praxis.
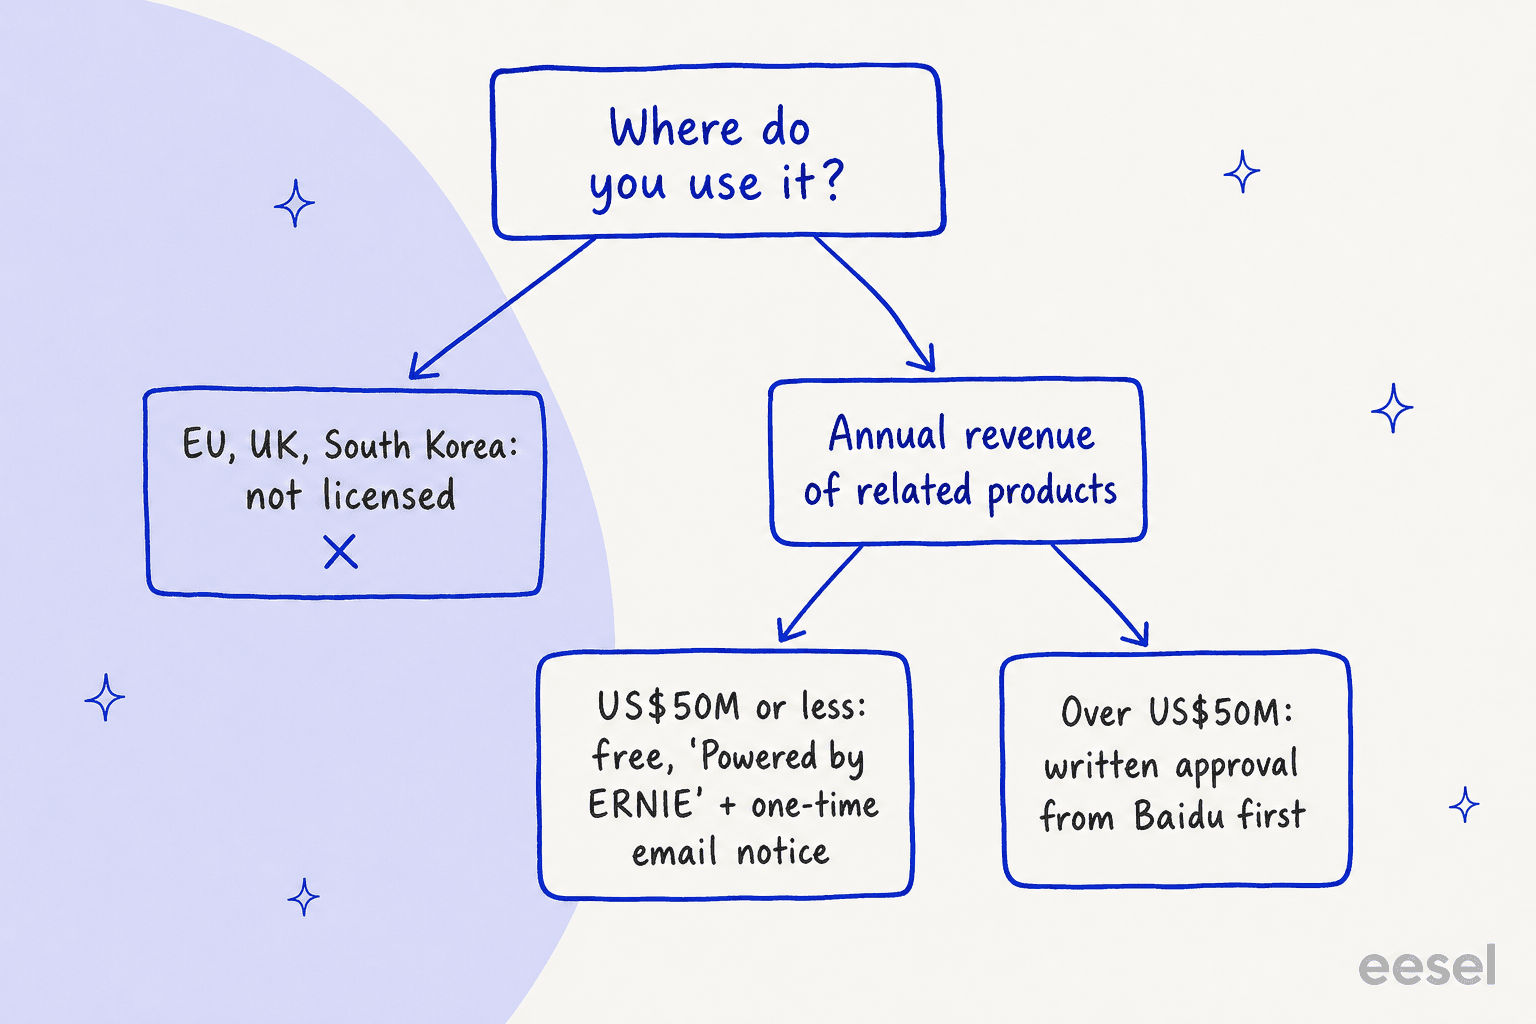
- Gebiet. Die Freigabe gilt überall "außer der Europäischen Union, dem Vereinigten Königreich und Südkorea". Abschnitt 5.3 verbietet außerdem, die Ausgaben des Modells außerhalb dieses Gebiets zu nutzen.
- Umsatz. Kommerzielle Nutzung ist bis zu US$50 Millionen Jahresumsatz des betreffenden Produkts, über alle verbundenen Unternehmen gerechnet, lizenzkostenfrei. Darüber brauchen Sie Baidus schriftliche Genehmigung, bevor Sie anfangen.
- Namensnennung. Ein kommerzielles Produkt muss die genauen Worte "Powered by ERNIE" in seiner Oberfläche, Website oder Dokumentation zeigen, und Sie schicken Baidu einmalig eine Benachrichtigung per E-Mail.
- Kein Distillieren. Abschnitt 5.5 verbietet, das Modell oder seine Ausgaben zu nutzen, um ein anderes KI-Modell zu verbessern, außer eigenen Derivaten des Modells.
Entwickler haben das bemerkt. Auf Hacker News war die Lizenz die Hauptbeschwerde:
"The license seems really restrictive for something intended to be built on. Entire countries are forbidden to use it at all (European Union, the United Kingdom and South Korea), and you are responsible for making sure no one in those places uses your derivative."
Ein Kommentator hatte eine entspanntere Sicht und argumentierte, der Ausschluss sei eher ein Weg, regulatorisches Risiko zu vermeiden, als etwas, das Baidu aktiv durchsetzen will. Wie auch immer: Wenn Ihre Kunden in Europa sitzen, ist es Ihr Problem, das zu lösen, und der EU-AI-Act-Leitfaden und der Leitfaden zur Datenresidenz zeigen, wie viel Gewicht das im Support hat.
Fans von Basismodellen fanden auch viel zum Mögen:
"Absolutely glad to see the release of a base model, I think the trend away from that has been an issue for the field."
Wie betreibt man ERNIE 5.5 Flash außerhalb Chinas?
Sie laden die Gewichte herunter und servieren sie selbst, wenn Ihr Standort innerhalb des Lizenzgebiets liegt. Die Gewichte liegen auf Hugging Face und ModelScope in FP8, zusätzlich mit einer BF16-Kopie.
- SGLang: Das vorgefertigte Image ist
lmsysorg/sglang:dev-ernie-55-flash, gestartet mit--tp 4 --attn-dp-size 4. - vLLM: Version 0.32.0 plus Baidus vLLM-ERNIE-Plugin, mit
--data-parallel-size 4. - Kontext: Beide Server akzeptieren bis zu 1,048,576 Tokens, und der Trainingskontext war 128K.
- Fine-Tuning: Baidu verweist auf ein Megatron-Bridge-Beispiel von NVIDIA.
Es gibt noch keine gehostete Abkürzung. Wenn Sie heute nur ein günstiges, gehostetes Flash-Tier-Modell wollen, ist die Tabelle oben Ihre Einkaufsliste, und die Qwen 3.8 Flash Bewertung deckt eines davon ausführlich ab.
Ist ERNIE 5.5 Flash etwas für einen Helpdesk-KI-Agenten?
Noch nicht. Ich würde diesen Checkpoint aus vier Gründen nirgendwo nahe an eine Kundenwarteschlange lassen.
- Es folgt noch keinen Anweisungen. Ein Support-Agent muss einem System-Prompt gehorchen, Guardrails nutzen und wissen, wann er eskalieren muss. Das sind Post-Training-Verhaltensweisen, und genau das fehlt.
- Es gibt nichts aufzurufen. Kein gehosteter Endpunkt bedeutet, Sie tragen die Serving-Kosten, die Verfügbarkeit und die Sicherheitsprüfung selbst.
- Die Lizenz blockiert europäische Kunden. Ein Support-Team in Kopenhagen oder London darf die Ausgaben laut der Freigabe, wie sie geschrieben ist, nicht nutzen.
- Niemand hat es an Support-Arbeit gemessen. Baidus Tabelle hat keinen τ-bench-artigen Test zur Richtlinienbefolgung, keinen Tool-Use-Test und keine Halluzinations-Quote.
Das Modell ist auch nur die kleinere Hälfte der Aufgabe. Selbst eine perfekt nachtrainierte Version würde noch eine Wissensdatenbank, Übergabe-Regeln, Retrieval und einen Weg brauchen, Antworten zu prüfen, bevor Kunden sie sehen. Das ist die echte Kostenfrage hinter Bauen versus Kaufen, und der Grund, warum ein Modell allein nie zu einem Support-Agenten wird. Meine kurze Regel: Das hier ist das Modell; eesel ist das Teammitglied.
eesel ist eine KI-Teammitglied-Plattform, und ihr KI-Helpdesk-Teammitglied tritt der Warteschlange bei, die Sie in Zendesk, Freshdesk, Gorgias und anderen bereits betreiben. eesel setzt seit Jahren KI in Live-Support-Warteschlangen ein, weshalb jeder Rollout zuerst gegen Ihre historischen Tickets simuliert wird. Sie lesen, was das Teammitglied gesagt hätte, bevor es irgendjemandem antwortet.
Timengo, ein dänisches Unternehmen für sichere E-Mail, betreibt eesel auf Freshdesk. Das Teammitglied entwirft Antworten auf Dänisch aus rund 5,300 vergangenen Tickets und Hilfe-Center-Artikeln, bereitete 300 Tickets in einem Monat vor und schrieb 180 Antwortentwürfe. Ein Support-Ingenieur prüft und sendet jeden einzelnen, und eesel sendet nie von sich aus. SamCart betreibt einen Agenten auf Freshdesk-Tickets und einen weiteren auf dem Website-Chat, beide antworten aus rund 280 Hilfe-Center-Artikeln. Der Ticket-Agent antwortet nur, solange niemand zugewiesen ist, und tritt zurück, sobald ein Teammitglied das Ticket übernimmt.
Dieses Zurücktreten-Verhalten ist genau die Art von Sache, die ein Basismodell nicht gelernt hat. Es ist auch der Grund, warum ich auf das nachtrainierte ERNIE 5.5 Flash warten würde, statt diese Veröffentlichung als Agent zu beurteilen. Wenn es da ist, zeigen unser Leitfaden zur Wahl eines LLM für den Support und das beste Modell für Support-Tickets, was zuerst zu testen ist, und Halluzinationsprävention ist der Teil, der am meisten zuschlägt.
Wenn Sie gerne vom Terminal aus arbeiten, ist die eesel CLI einen Blick wert. Damit kann ein KI-Coding-Agent freigegebenes Wissen wie exportierte Hilfeartikel und Makros hochladen, die Anweisungen des Teammitglieds bearbeiten und Testfragen stellen, um die Antworten zu prüfen, bevor etwas live geht. Den Helpdesk selbst zu verbinden, braucht weiterhin jemanden mit Admin-Zugriff, der zustimmt. Mehr dazu in Agenten vom Terminal aus verwalten.
Wer sollte ERNIE 5.5 Flash nutzen?
Hier meine Einschätzung, nachdem ich Baidus Blog, Modellkarte und Lizenz vollständig gelesen habe:
- Ausprobieren sollten es Forschungsteams oder Unternehmen außerhalb der EU, des Vereinigten Königreichs und Südkoreas, die eine starke, effiziente Basis zum Fine-Tunen wollen. Ein Mixture-of-Experts-Modell mit 14B aktiv und 1M Kontext ist ein guter Ausgangspunkt, und ein Basis-Checkpoint ist genau das, was man fürs Fine-Tuning will.
- Warten sollten Sie, wenn Sie ein Chat- oder Agenten-Modell wollen. Baidu hat eines ohne Datum versprochen, und externe Tests sagen mehr aus als eine Anbietertabelle.
- Überspringen sollten Sie es, wenn Sie europäische Kunden bedienen oder nur günstige gehostete Tokens brauchen. DeepSeek V4.1 Flash, Claude Haiku 5.5 und GPT-6 Luna sind heute einsatzbereit.
- Vergleichen Sie es mit anderen offenen Modellen, wenn Sie sich umsehen: Kimi K3, GLM 5.3 Flash und Ripple-65B wägen jeweils anders zwischen Größe, Preis und Lizenz ab.
Die Zusammenfassung, die ich einem Kollegen geben würde: ERNIE 5.5 Flash ist eine vielversprechende Zutat. Die Pre-Training-Zahlen sind in Baidus eigener Tabelle stark, und das kostensparende Design ist real, aber das Chat-Modell fehlt, und die Lizenz hat geografische Grenzen.
eesel ausprobieren
Wenn Sie zu ERNIE gekommen sind, in der Hoffnung, ein neues offenes Modell würde Ihrem Team Tickets abnehmen, können Sie sich das Bauen der Support-Schicht selbst sparen. eesels KI-Helpdesk-Teammitglied klinkt sich in Minuten in Zendesk, Freshdesk, Gorgias und mehr ein, lernt aus Ihren vergangenen Tickets und zeigt Ihnen, wie es geantwortet hätte, bevor es live geht. Die Pläne starten bei $299 im Monat, und es gibt eine kostenlose Stufe zum Testen.

eesel ausprobieren, kostenlos.