

Eine Woche Lesearbeit, alles rund um deepseek-v4-flash-vision-exp. Die Dokumentation. Die vollständige Benchmark-Tabelle. Drei Tage Produktions-Telemetrie, und dann alle 153 Kommentare im Launch-Thread. Die nützlichste Erkenntnis: Das ist ein besseres Textmodell im Gewand eines Vision-Releases. Sechs von sieben Text-Agenten-Zeilen gehen laut DeepSeeks eigener Tabelle an dieses Modell gegenüber V4-Flash. Und der größte öffentliche Nutzer bisher? Ein Coding-Tool, das nie ein Bild schickt.
Beim Vision-Teil selbst fällt das ehrliche Fazit enger aus als die Launch-Meldung und auch enger als die Gegenreaktion. Layout beherrscht es, Diagrammformen ebenfalls, ebenso die Struktur eines Screenshots. Bei kleinen Zeichen bricht es zusammen, denn jedes Bild wird vor allem anderen auf etwa 800 mal 800 verkleinert, und es gibt keinen hochauflösenden Modus zum Einschalten. Ein Test zur Prüfung von Bildunterschriften: 6 von 12, gegen einen Konkurrenten mit 11 von 12. Wichtiger als die Punktzahl ist aber die Art des Fehlers. Als man ihm ein Foto der Kathedrale von Wells mit der Beschriftung "Salisbury" zeigte, stimmte es zu. Auch die Benchmark-Geschichte wird beim zweiten Lesen weicher. Die Schlagzeilenzahl bei DeepSWE liegt innerhalb der Fehlerbalken eines Konkurrenten, die multimodalen Gewinne messen teilweise nur "das eine Modell kann sehen, das andere nicht", und die ganze Tabelle stammt aus DeepSeeks eigenem Harness am Launch-Tag.
Wenn Sie das Ganze auf eine Support-Warteschlange richten, sollten Sie beim Zustimmungsfehler länger verweilen. Ein Modell, das jedes Label bestätigt, das man ihm gibt, ist genau die Fehlerart, die im Support Geld kostet, und ein größeres Modell behebt das nicht. Es hilft, den Agenten in Ihren echten Hilfeinhalten zu verankern und ihn dann über Ihre eigenen früheren Tickets laufen zu lassen, bevor ein Kunde ein Wort davon sieht. Genau dafür ist eesel gebaut.
Was ich getestet habe und was nicht
Ich baue bei eesel KI-Agenten, also gehe ich bei einem solchen Release zuerst den Mechanismus an. Was dem Modell tatsächlich gezeigt wird. Was das Harness tut, bevor die Gewichte je ein Pixel sehen. Und wo der Fehler landet, sobald echte Eingaben ankommen. Das ist die Linse für den ganzen Test.
Hier die Methodik, klar benannt, damit Sie sie im richtigen Maß abwerten können. Ich habe den Vision-Leitfaden Zeile für Zeile gelesen, dasselbe mit der Preisseite gemacht und danach drei Tage echte Produktions-Telemetrie von OpenRouter gezogen.
Dann habe ich jeden einzelnen Kommentar im Launch-Thread durchgearbeitet, der es auf 495 Punkte und 153 Kommentare brachte. Wo hier ein Praxisergebnis zitiert wird, stammt es von jemand anderem, und ich nenne, von wem.
Was ich nicht getan habe: eine eigene kontrollierte Vision-Evaluierung über ein paar hundert Bilder. Das ist wichtig, denn die größte einzelne Lehre aus diesem Thread ist, dass Vision-Tests mit kleiner Stichprobe selbstbewusste, falsche Schlüsse liefern, und genau den Fehler zu begehen, um den es in diesem Beitrag geht, wäre ein schlechter Auftritt. Verstehen Sie dies also als Prüfung der Belege, nicht als eigenen Benchmark.
Wenn Sie das Release von Anfang bis Ende erklärt haben wollen, mit der Preisrechnung und der vollständigen Limit-Tabelle, finden Sie das in meiner Launch-Analyse. Dieser Beitrag beantwortet nur, ob das Ding etwas taugt.
Der Uhrentest ist ein Lehrstück dafür, wie man ein Vision-Modell nicht testet
Der meistgelesene Austausch im ganzen Launch-Thread dreht sich um eine Uhr. Der Reihe nach durchzugehen lohnt sich, denn es ist die klarste Illustration, die ich dafür kenne, wie Vision-Tests schiefgehen.
Es begann mit einem schlichten Fehlerbericht:
"It fails the simple clock test for me which Qwen3.8 27B got (nearly) right."

Die Details sind schlimmer als diese Zusammenfassung. Bei einer gerenderten analogen Uhr antwortete DeepSeek mit 5:10, verfehlte den Stundenzeiger um drei Stunden und verwechselte obendrein, welcher Zeiger welche Farbe hatte. Qwen3.8 27B sagte 8:10. Die wahre Zeit war 08:09:25, also lagen beide falsch, nur auf unterschiedliche Weise, und die Einschätzung eines Kommentators zum Unterschied ist schärfer als das meiste Benchmark-Gerede:
"Also worth noting that both models got it wrong. Qwen made a mistake that humans very good at reading clocks would make. Deepseek made a mistake that a human who had just learned to read clocks would make."
Dann wiederholte jemand den Test, und der Befund kippte.
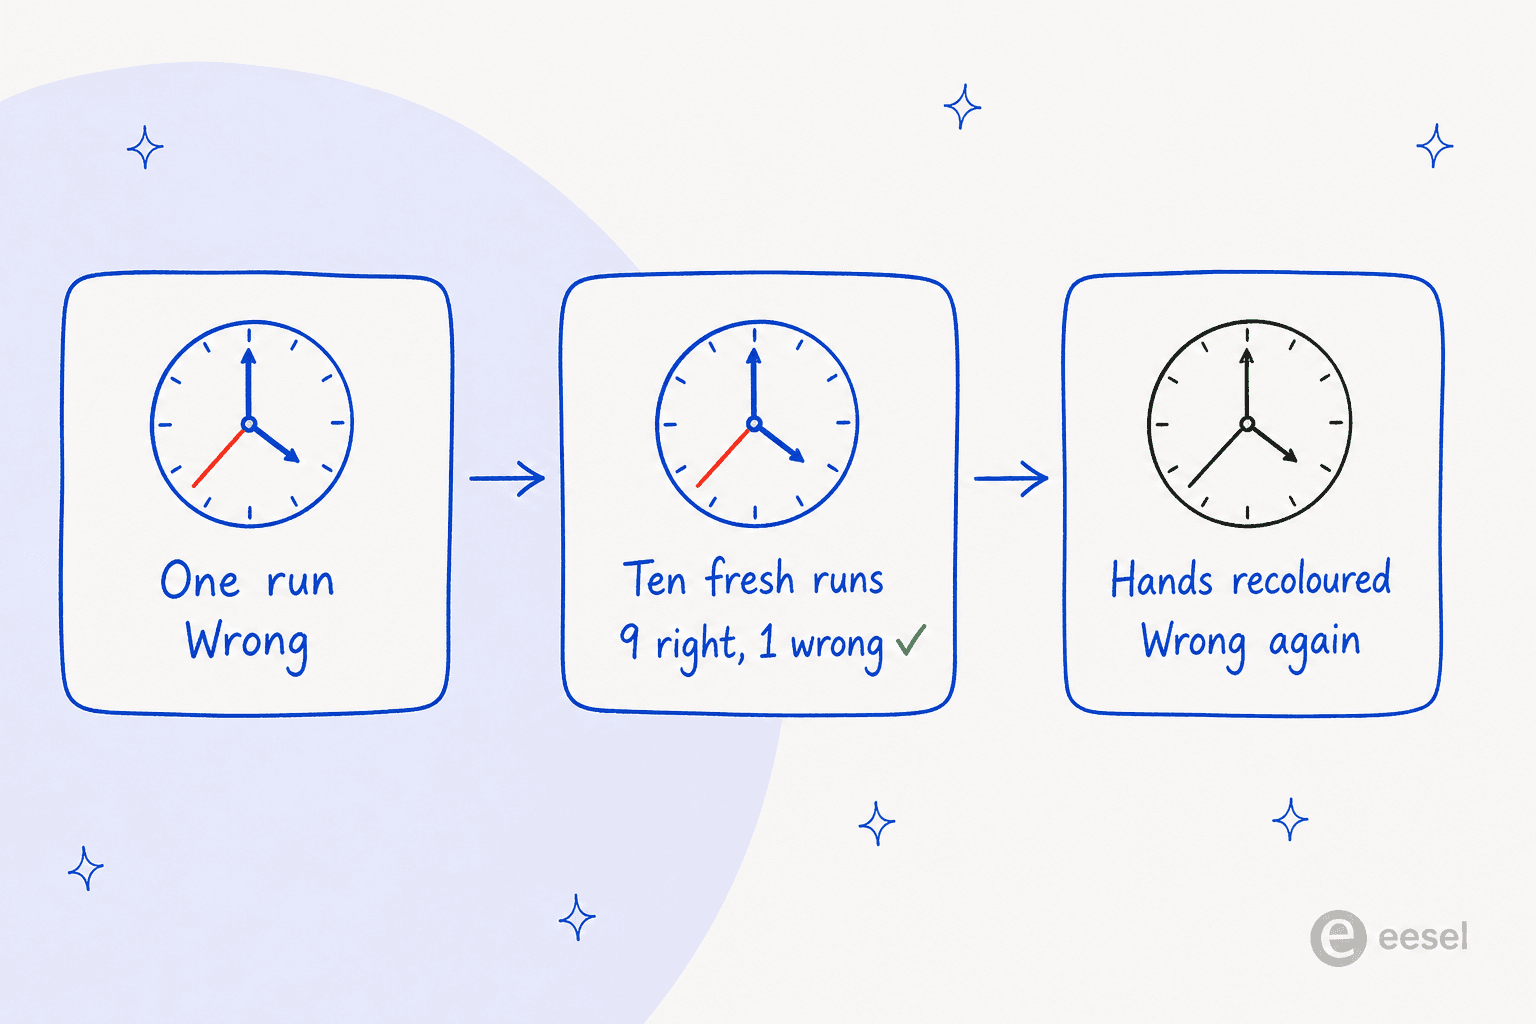
"I now ran the test 10 times total, fresh session every time, and DS4 got it right 9 out of 10 times. Lesson learned to double check what I read on the internet."
Ist das Modell also in Ordnung? Nicht ganz, und jetzt wird es interessant. Drei verschiedene Leute nahmen die Wiederholung auseinander.
Erstens war die Bewertung großzügig. Die neun "richtigen" Antworten lauteten alle 8:10, während die tatsächliche Zeit auf dem Zifferblatt 8:09:25 war, und ein Leser wies direkt darauf hin:
"fwiw the clock reads 8:09:25 not 8:10:25 although it would be passable to read it as 8:10 if there were no second hand"
Zweitens war das Testbild selbst merkwürdig. Jeder Zeiger der Uhr hatte eine andere Farbe, was überhaupt nicht dem üblichen Aussehen von Uhren entspricht, und ein Leser gab zu, dass ihn das Design ebenfalls getäuscht hatte:
"I know that the hand lengths and thicknesses on this image are correct but for some reason I, a totally human person who grew up when analog clocks were still common, see this and think the hand on the 5 is the minute hand."
Drittens, und das ist der diagnostische Punkt, griff der Urheber diesen Vorschlag auf und wiederholte den Test mit komplett schwarz gezeichneten Zeigern. DeepSeek antwortete dann 8:25, verlor den Sekundenzeiger völlig und beförderte ihn zum Minutenzeiger. Das ist ein starker Hinweis darauf, dass es die ganze Zeit auf die Farbe der Zeiger geachtet hatte und nicht auf ihre Länge. Die 9 von 10 waren also echt. Der Grund dahinter war nicht der, den alle angenommen hatten.
Und der Befund, der den ganzen Teil-Thread neu einordnet, kam von jemandem, der dasselbe Bild einfach überall sonst laufen ließ:
"Gemini 3.7 Flash and 5.6-Sol (on all reasoning levels) also answer 8:10:25. The new "stealth" Ox Alpha also replies with the same. Opus 5 replies with 8:10 (no seconds). Not sure why this is so hard for them; Gemini is especially good at vision and I would have expected better from it."
Keines der getesteten Modelle landete bei 8:09:25. Weder Gemini noch Opus 5, auf keiner Reasoning-Stufe. Was bei n=1 wie eine DeepSeek-Schwäche aussah, entpuppte sich also als blinder Fleck der gesamten Spitzenklasse, und der ganze Wirbel löste sich in eine Aussage über analoge Uhren auf statt in eine Aussage über dieses Modell.
Es gibt ein faires Gegenargument, ob dieser Test überhaupt relevant ist, und ein Leser brachte es gut vor:
"Reading any analog clock at any time level (edit: and a non-noisy vector rendered image at that) is absolutely table stakes for an allegedly frontier flagship vision model. As much as 1:1 OCR."
Ich habe Verständnis für diese Sicht. Und es ist auch keine hypothetische Aufgabe: Ein Kommentator beschrieb, wie er einen Coding-Agenten bat, ein Uhrenlese-Spiel für seine Kinder per Screenshot des Godot-Builds zu testen, also genau dieses Problem mitten in einem echten Software-Workflow.
Die operative Lehre aber würde ich an die Wand hängen. Ein einzelner Vision-Test sagt fast nichts aus. Die Streuung zwischen identischen Läufen war groß genug, um das Urteil allein zu kippen. Das Design des Stimulus veränderte die Fehlerart, und die Bewertungsschwelle veränderte das Ergebnis. Wenn Sie ein Vision-Modell für echte Arbeit bewerten, auch dieses, lassen Sie es viele Male auf Ihren eigenen Eingaben laufen und bewerten Sie dann streng. Es ist dasselbe Prinzip, das hinter ordentlicher Support-QA steht, statt einer Demo zu vertrauen.
Wo die Verkleinerung wirklich schadet und wo nicht
Der Mechanismus ist einfach, und er ist zugleich das Wichtigste an diesem Modell. Vor der Inferenz skaliert DeepSeek jedes Bild so, dass die Gesamtpixelzahl ungefähr bei der eines 800-mal-800-Bildes liegt, bei beibehaltenem Seitenverhältnis. Daraus ergibt sich eine harte Obergrenze von 384 Token pro Bild, und die Dokumentation nennt die Folge nüchtern: Ein Bild mit 2000 mal 2000 und eines mit 5000 mal 5000 verbrauchen gleich viele Token.
Ein Kommentator brachte diese Zahl besser auf den Punkt, als es die Dokumentation schafft:
"800x800 is 640,000 pixels, or 0.64 Megapixels. That is less than the resolution of computer screens from 1995, Super VGA which has around 0.79 MPs."
Die nützliche Frage ist nicht, ob 0,64 MP genug sind, sondern wofür. Und die Antwort sortiert sich fast vollständig nach der Zeichengröße, die Schwierigkeit der Aufgabe spielt kaum eine Rolle.
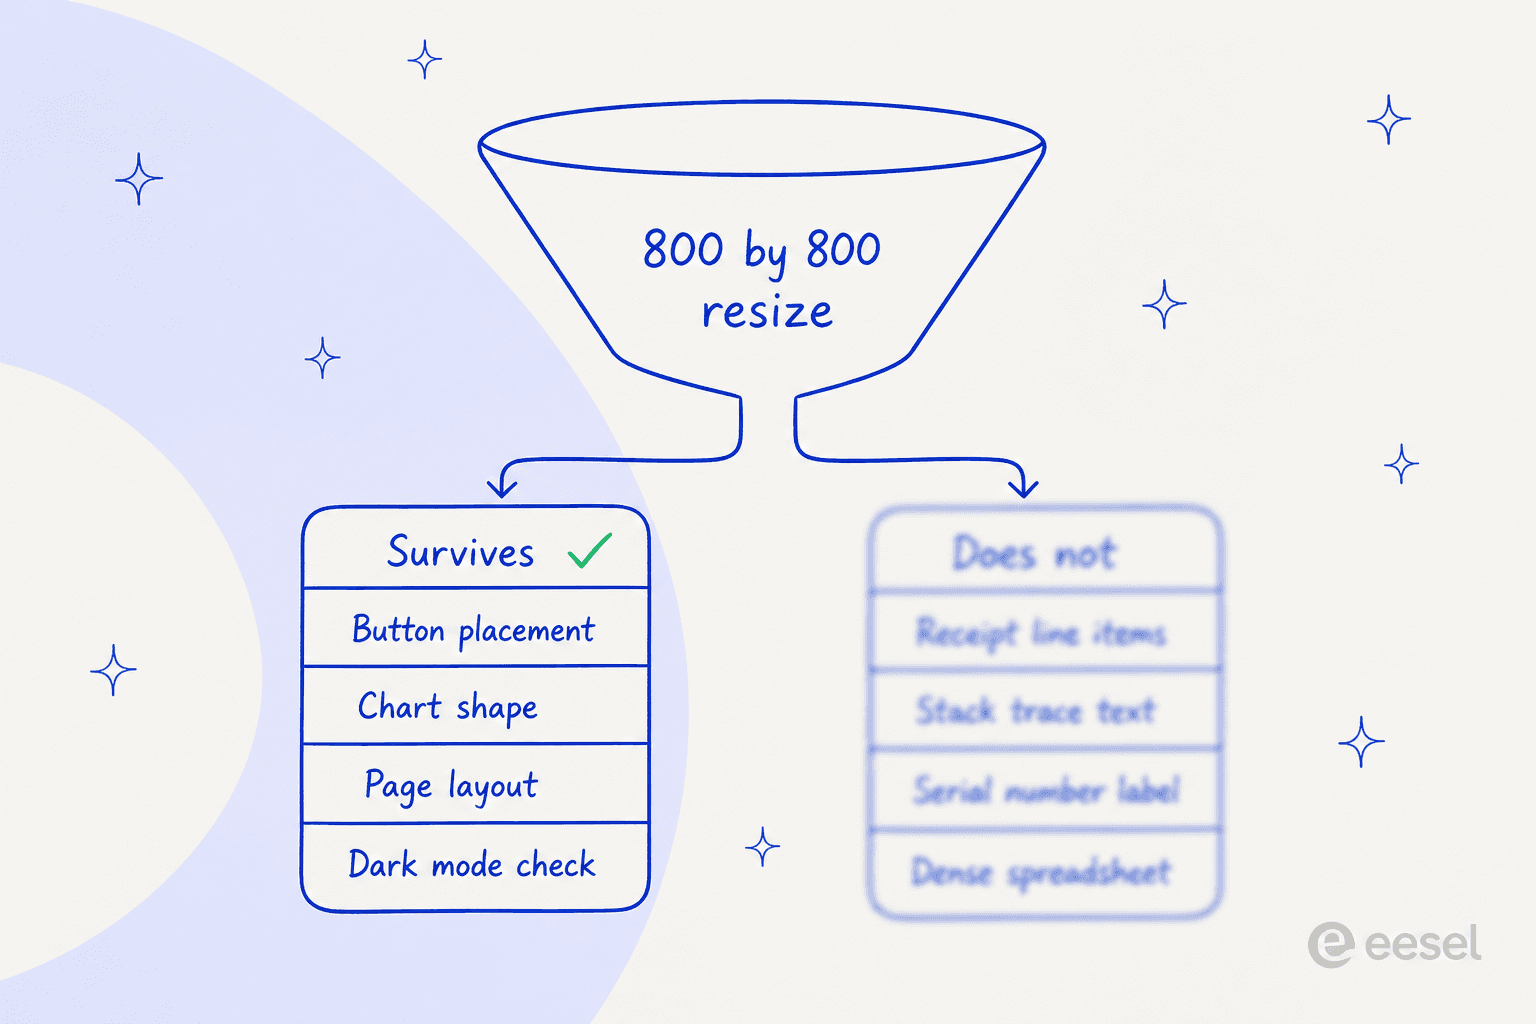
Prüfen, ob ein Button an der richtigen Stelle gerendert wurde, die Form eines Diagramms lesen, ein Dark-Mode-Layout verifizieren, die Struktur einer Seite bestätigen: All das übersteht eine Verkleinerung mühelos. Positionen auf einem Kassenbon lesen, einen Stack Trace in einem Fehlerdialog, eine Seriennummer auf einem Produktetikett oder eine dichte Tabelle: Dort fällt es auseinander. Eine ganze Dokumentseite liegt genau an der Grenze, und ein Leser merkte das sofort an:
"It's useful but for OCR and a lot of other applications it needs to be a bit higher (eg: putting in a full A4 / Letter sized page)"
Damit es konkret wird und keine Faustregel bleibt, hier die Rechnung mit Ihren eigenen Eingaben. Geben Sie die Abmessungen eines Bildes ein, das Sie wirklich schicken würden, sowie die Pixelhöhe des kleinsten Textes darin.
Bei einem 2560-mal-1440-Screenshot mit 14-px-Oberflächentext landet der kleinste Text bei 5,8 px. Mit einem schlichten 1920-mal-1080-Bild kommen Sie auf 7,8 px. Ein normaler Screenshot mit normalem Oberflächentext erreicht die Schwelle nicht, und das ist die unbequeme Version der Geschichte, denn zurück kommt eine plausible Antwort, die manchmal falsch ist, nie ein offensichtlicher Fehler.
Der Workaround, auf den sich der Thread gemeinsam geeinigt hat, ist ein Crop-Tool, und ein Kommentator beschrieb die genaue Pipeline, die er nutzt:
"When the LLM tries to read an image, it will be resized by DeepSeek's server to 800x800, which might be a bit blurry. The LLM will then crop a smaller image from the high resolution image (using e.g. the
converttool via bash) and will then read the small cropped image. This image will still be resized to 800x800 by DeepSeek's server, but since it is already small, there is no or little loss of quality."
Das funktioniert, und mehrere Leute bestätigten, dass es bei ihnen klappt. Kostenlos ist es aber nicht. Die Raster-Variante derselben Idee, bei der man ein großes Bild in Kacheln zerlegt und jede Zelle verarbeitet, kostet nach der Schätzung eines Kommentators mindestens doppelt so viele Token, und neun Ausschnitte wieder zu einem räumlichen Gesamtverständnis zusammenzusetzen ist ein eigenes Problem. Wenn Sie das selbst bauen, ist es ein ordentliches Stück Harness-Arbeit obendrauf auf einer Tool-Calling-Schleife, die Sie ohnehin pflegen müssen. Einige der Open-Source-Agenten, die einen Blick wert sind, liefern schon etwas Ähnliches mit.
Und die Verteidigung, ein günstiges, schnelles Modell müsse seine Auflösung eben begrenzen, übersteht den Kontakt mit der Konkurrenz nicht ganz. Jemand argumentierte genau das, und die Antwort kam sofort:
"Gemini "flash" models have an option for media resolution, including a high resolution option for screenshots."
Das ist der fairste einzelne Vergleich im ganzen Thread. Ein Konkurrent in derselben Klasse bei Tempo und Kosten bietet die Steuerung an, und Google baut darauf agentische Bildverarbeitung auf. DeepSeeks Parameter detail sieht so aus, als sollte er dasselbe tun, tut es aber nicht. low skaliert tatsächlich auf 512 mal 512 herunter, während high, original und auto derzeit alle dasselbe bedeuten: das Original behalten und trotzdem die Standard-Verkleinerung anwenden.
Zu sagen ist auch, dass viele berichteten, die Begrenzung sei für ihre tatsächliche Arbeit kein Problem. Einer sagte es klar:
"It can read and extract information from screenshots and PDFs just fine (my setup). No need to worry about edge cases."
Ein anderer merkte an, dass er seine Screenshots, wenn sie über 800 px hinausgehen, wahrscheinlich ohnehin besser zuschneiden könnte. Beides ist berechtigt. Die Begrenzung ist eine Einschränkung und kein Defekt, und ob sie Sie trifft, hängt ganz davon ab, worauf Sie das Modell richten.
Die Benchmark-Tabelle ist weicher, als sie aussieht
Jetzt die Zahlen, die meisten Tests nachdrucken, ohne sie genau zu lesen.
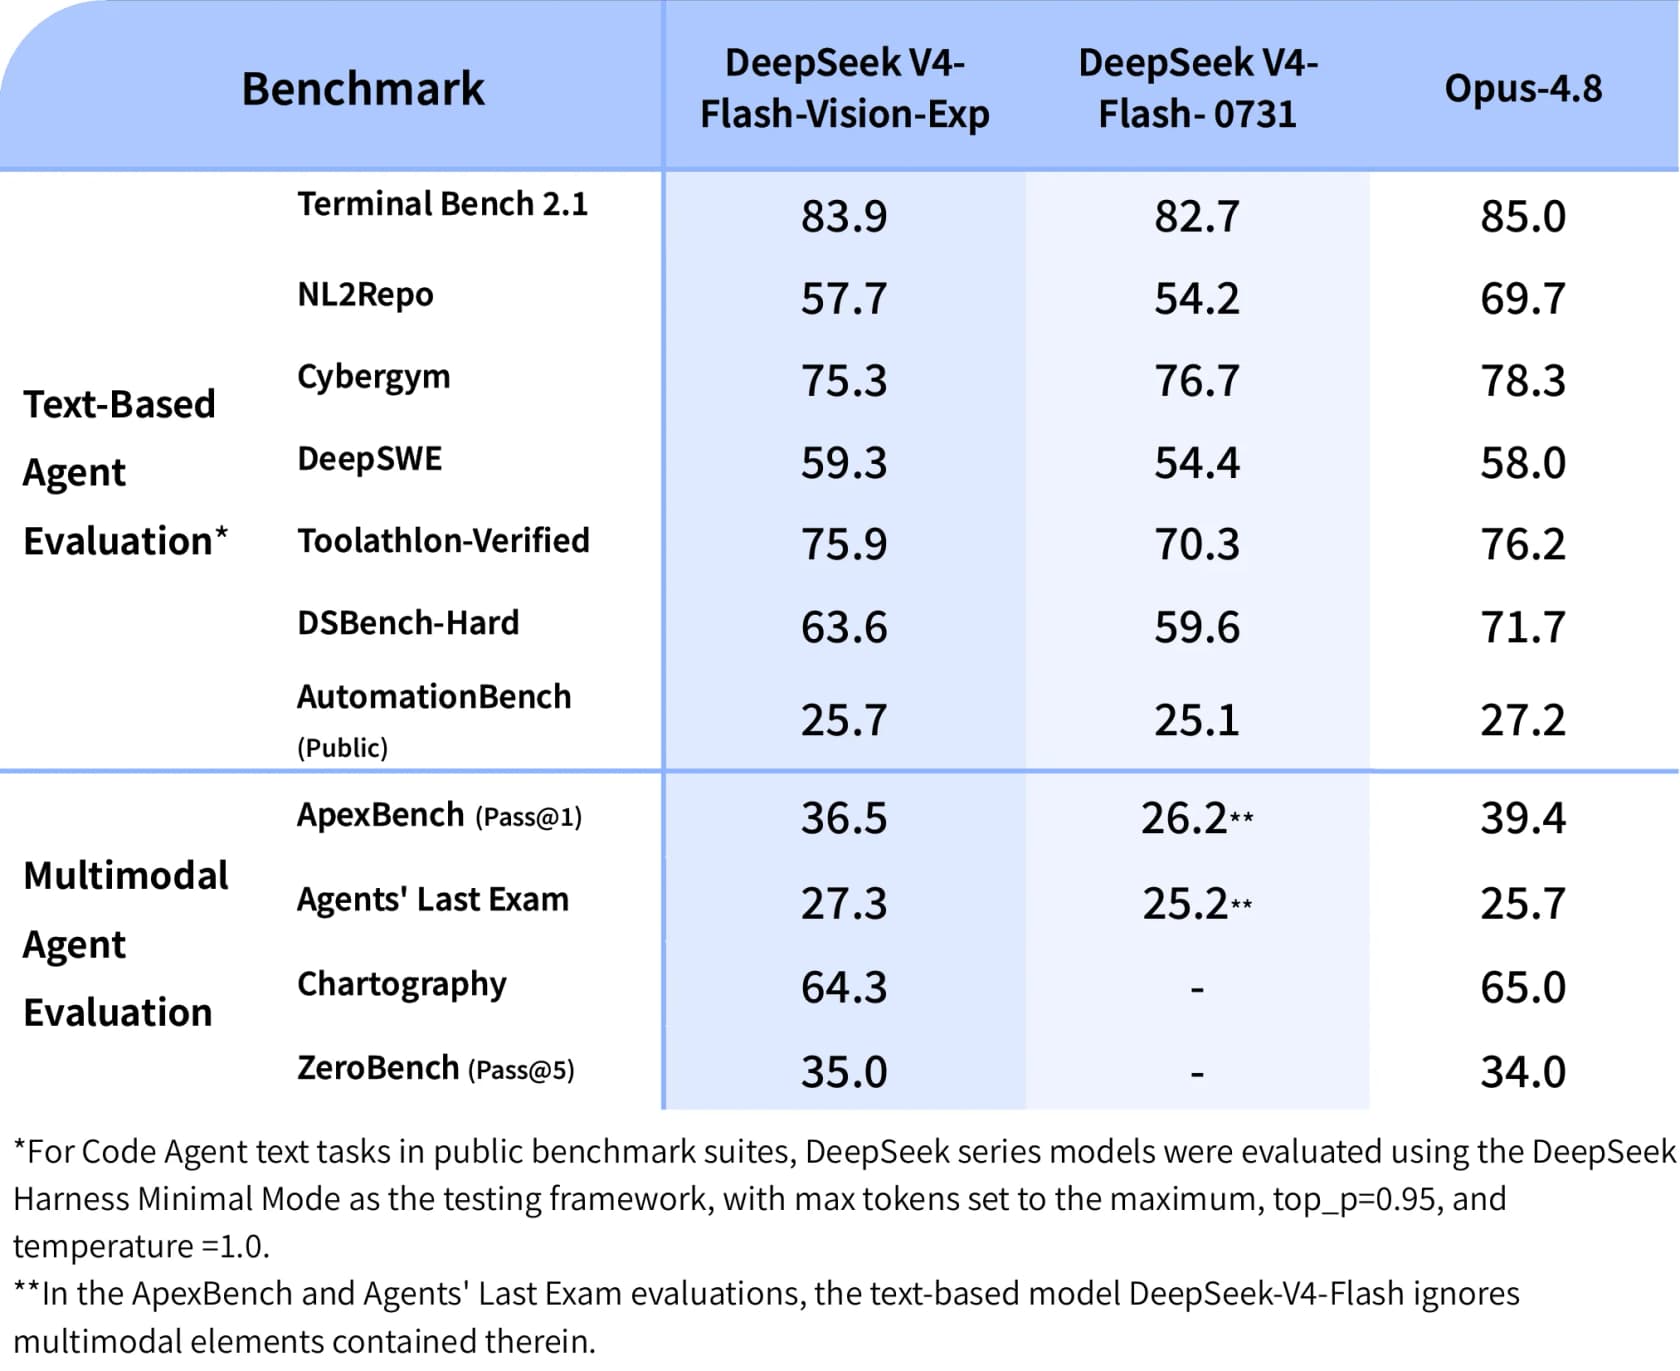
Zunächst das, was hält. Über die sieben Text-Agenten-Zeilen schlägt der Vision-Build das reine Text-Modell V4-Flash in sechs: DeepSWE 59,3 gegen 54,4, Toolathlon-Verified 75,9 gegen 70,3, NL2Repo 57,7 gegen 54,2, DSBench-Hard 63,6 gegen 59,6, Terminal Bench 2.1 83,9 gegen 82,7, AutomationBench 25,7 gegen 25,1. Die einzige Niederlage ist Cybergym, 75,3 gegen 76,7. DeepSeeks eigene Release-Notiz spricht bei Text von "matching" gegenüber V4-Flash, was das eigene Ergebnis deutlich untertreibt.
Dazu kommen drei Vorbehalte, und jeder stammt von jemandem, der die Tabelle sorgfältiger las als die Berichterstattung zum Launch.
Die Schlagzeilenzahl überlappt den Fehlerbalken eines Konkurrenten. Bei der DeepSWE-Zeile legte ein Leser die Intervalle übereinander:
"The DeepSWE benchmark they report (59.3%) overlaps with the confidence interval of 5.6-Sol Medium (61% +/- 2%), but likely at 1/18th the cost (they did not report the DeepSWE benchmark cost, but v4-flash had this cost ratio against Sol Medium)."
"Schlägt ein Spitzenmodell bei DeepSWE" heißt also eigentlich "statistisch nicht von einem zu unterscheiden, zu einem Bruchteil des Preises". Immer noch ein gutes Ergebnis, aber eine andere Aussage. Außerdem gilt: Das Kostenverhältnis von 1/18 wird aus V4-Flash abgeleitet und ist für diesen Lauf nicht veröffentlicht, und das Ganze ist von DeepSWE offiziell nicht verifiziert.
Das Vergleichsmodell ist schmeichelhaft. Ein zweiter Leser wies darauf hin, dass der für die Kostengeschichte gewählte Vergleichspartner nicht der engste verfügbare ist:
"The closer comparison would be 5.6-Luna. On DeepSWE at Xhigh it's 57% at 1/6 the cost of Sol M, on Max it's 67% at 1/3rd the cost."
Gegen eine vergünstigte GPT-5.6-Variante schrumpft der Abstand bei Kosten und Leistung deutlich. Immer noch ein Fortschritt. Viel weniger ein Sprung.
Der multimodale "Sprung" misst teils die Fähigkeit zu sehen. Das steht in DeepSeeks eigener Fußnote. Bei ApexBench und Agents' Last Exam wurde die Spalte des reinen Text-Modells V4-Flash bewertet, während die multimodalen Elemente der Aufgabe ignoriert wurden, weshalb sie bei 26,2 und 25,2 liegt. Der Vergleich von 36,5 mit 26,2 misst also ebenso sehr "das eine Modell kann sehen, das andere nicht", wie er einen Fähigkeitsgewinn misst. Der ehrliche Vergleich ist die Opus-4.8-Spalte, in der DeepSeek bei ApexBench um 2,9 und bei Chartography um 0,7 zurückliegt und dann bei Agents' Last Exam und bei ZeroBench knapp vorn liegt.
Noch ein Hinweis zur Einordnung, der leicht übersehen wird. Jede Zahl der DeepSeek-Reihe in dieser Tabelle stammt aus dem DeepSeek Harness Minimal Mode mit top_p=0.95 und temperature=1.0, also aus dem eigenen Gerüst des Anbieters, am Launch-Tag. Tabellen des Herstellers sind nützlich, aber keine Replikationen. Behandeln Sie sie, wie Sie jede Herstellertabelle behandeln würden, auch die in meinen eigenen Modellvergleichen.
Selbstbewusste Zustimmung ist der schlimmere Fehler
Hier das Praxisergebnis, auf das ich immer wieder zurückkomme, denn es ist das einzige in diesem Thread mit einem bewerteten Set und einem benannten Fehlermuster.
Ein Kommentator betreibt einen kleinen Benchmark zur Prüfung von Bildunterschriften: Man gibt dem Modell ein Bild plus eine behauptete Bezeichnung und fragt, ob die Behauptung stimmt. Die Frage lautet dort "ist das, was ich sage", nie "was ist das". Er ließ ihn über DeepSeek und über ByteDances seed 2.1 turbo laufen:
"Asked "Is this Salisbury Cathedral" and supplied a picture of Wells Cathedral, it answers "Yes, the west facade of Salisbury Cathedral". Bytedance seed 2.1 turbo correctly says no. Similar results for a picture of Manhattan Bridge sent as Brooklyn Bridge, Chartres Cathedral sent as Notre Dame, etc."
Das Ergebnis über sein 12-Bilder-Set: DeepSeek 6, seed 2.1 turbo 11. Das breitere Ranking auf demselben Set setzte Gemini 3.7 Flash an die Spitze, dann seed, dann GPT-5.6-Luna und danach zwei Qwen-Builds, ungefähr in der Reihenfolge, auf die auch mein Vergleich Qwen gegen V4-Flash bei Text kommt. Er nennt den Vorbehalt selbst, dass dies ein winziges Set im Vergleich zu einer echten VLM-Benchmark-Suite ist, und jemand im Thread argumentierte zu Recht, dass ein kleines, auf Coding ausgerichtetes Modell nie auf Wahrzeichenerkennung trainiert wurde.
Beides stimmt. Dennoch ist nach meiner Lesart nicht der Wahrzeichen-Wert der interessante Teil. Interessant ist, dass es nicht "nein" sagte, sondern "ja, und hier ist ein selbstbewusstes Detail, das ich erfunden habe". Die Westfassade der Kathedrale von Salisbury ist eine konkrete, autoritativ klingende Ausschmückung, die am falschen Gebäude hängt. Das ist kein Auflösungsproblem, und kein hochauflösender Modus würde es beheben. Das Modell stimmt der Prämisse zu, die man ihm gegeben hat.
Wer im Support arbeitet, kennt genau diesen Fehler. In einem Gespräch, das ich in meinen Notizen nachgelesen habe, hatte ein technisches B2B-Support-Team erlebt, wie ein Bot "ja, wir unterstützen Ihr Automodell" für Marken antwortete, die gar nicht in ihrer Datenbank standen, weil im Help Center stand "wir unterstützen alle Modelle". Der Bot las korrekt und folgerte aus der falschen Prämisse, und ihr eigenes Wort für die Einrichtungsphase war "trial and error in the beginning". Gleiche Form, anderer Bereich. Selbstbewusste Zustimmung ist gefährlicher als ein unscharfes Fehllesen, weil ein unscharfes Fehllesen meist falsch aussieht und selbstbewusste Zustimmung nie falsch aussieht. Sie ist auch die Grenze zwischen einem echten Agenten und einem skriptgesteuerten Chatbot, und sie entscheidet, ob Ticket-Deflection ein Gewinn oder eine Beschwerde-Warteschlange wird.
Deshalb ist "kann das Modell den Screenshot sehen" die leichte Hälfte der Support-Frage, und die leichte Hälfte ist die, die ein Modell-Release beantworten kann. Die schwere Hälfte ist, ob die Antwort stimmt. Das hängt davon ab, worauf der Agent zurückgreifen darf und wie er sich in dem Moment verhält, in dem er etwas nicht weiß. Ein Problem von Retrieval und Leitplanken also, kein Vision-Problem, und es ist der Unterschied zwischen RAG und einem rohen LLM-Aufruf.
Das Zuverlässigkeitsbild, das niemand als Screenshot teilt
In 153 Kommentaren berichtete niemand von einem API-Fehler, einem 5xx, einem Rate Limit oder einem Ausfall, was für einen experimentellen Endpunkt, der drei Tage alt ist, ein gutes Zeichen ist. Latenzverteilungen berichtete allerdings auch niemand, und genau dort liegt die interessante Zahl.
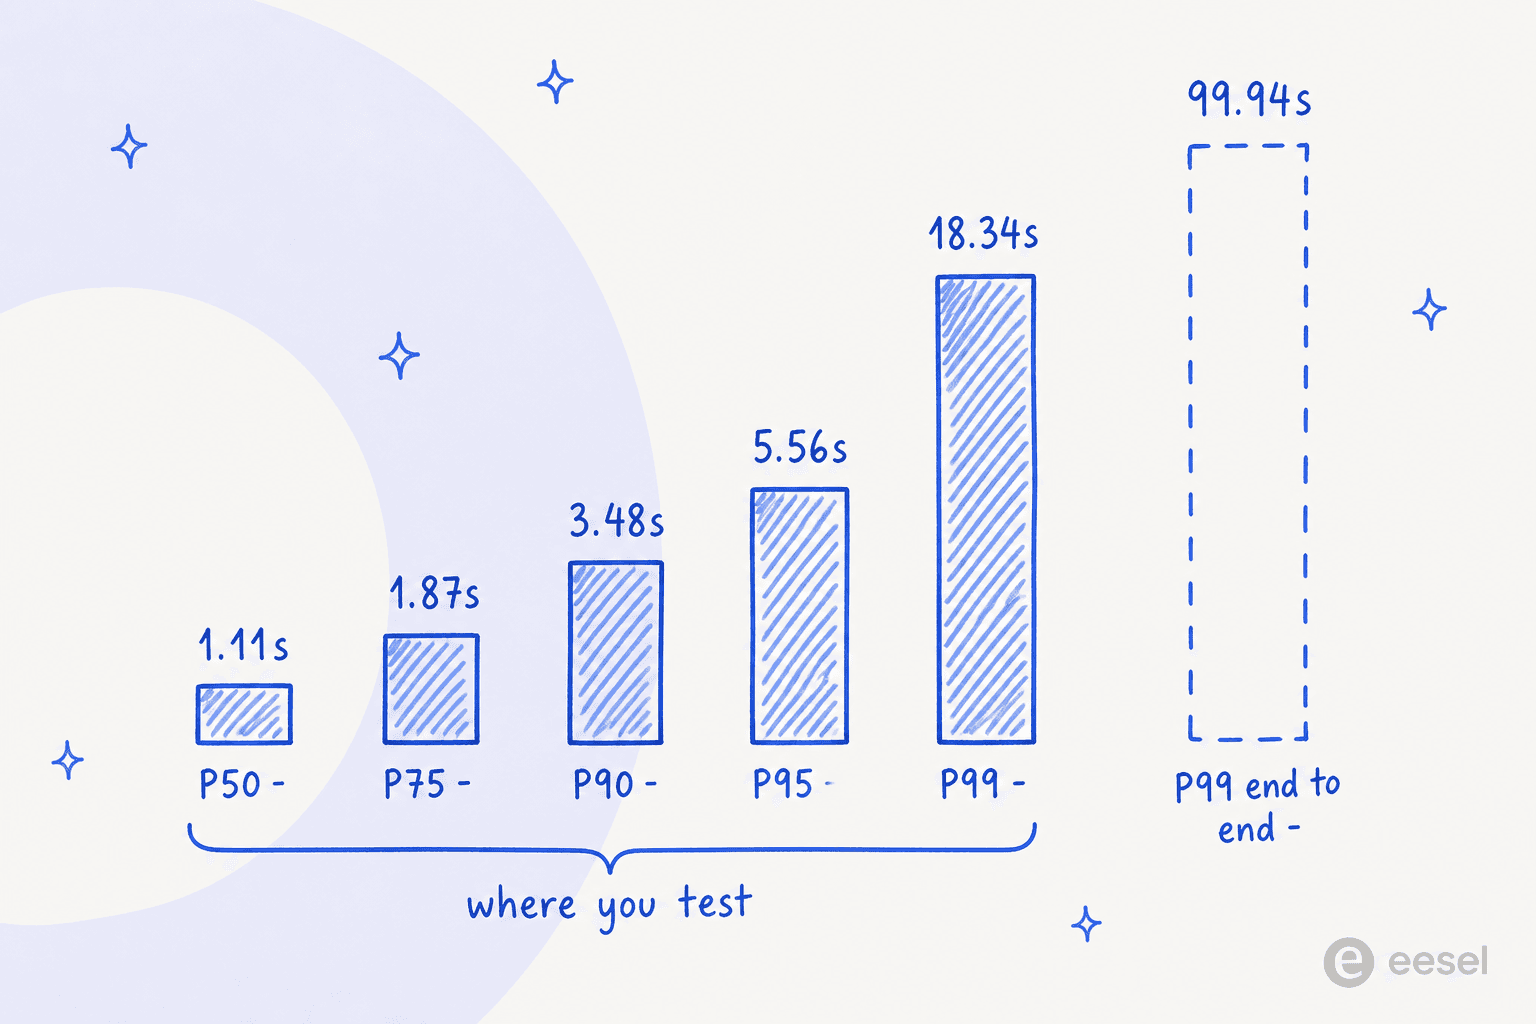
Aus drei Tagen Produktions-Traffic: P50-Latenz 1,11 Sekunden, Durchsatz 85 Token pro Sekunde, Verfügbarkeit 100 %. Ein schnelles Modell also, und der Median ist für diese Preisklasse ausgezeichnet. Das Protokoll eines Kommentators belegt das, mit 368 ms Denkzeit und 4,4 Sekunden insgesamt für ein einzelnes Bild.
Dann schauen Sie nach rechts. P90 liegt bei 3,48 s, P95 bei 5,56 s und P99 bei 18,34 Sekunden. Ende-zu-Ende steigt P99 auf 99,94 Sekunden. Die Fehlerrate bei Tool-Calls liegt im Schnitt bei 1,27 %, was konkurrenzfähig ist (Gemini 3.7 Flash liegt bei seinem besten Endpunkt bei 1,41 %), und die Verfügbarkeit im selben Zeitraum betrug 99,93 %.
Die praktische Folge ist ein Timeout-Budget, kein Benchmark. Setzen Sie ein Client-Timeout von 10 Sekunden, weil Ihr Median bei einer Sekunde liegt, verlieren Sie ungefähr eine von hundert Anfragen. In einer Agentenschleife mit zwölf Tool-Calls pro Aufgabe wird aus einem Prozent pro Aufruf eher eine Aufgabe von neun. Ein Failover gibt es ebenfalls nicht: Ein einziger Anbieter bedient dieses Modell, sodass ein Router in dem Moment, in dem es langsam wird, keinen anderen Ort hat, an den er die Anfrage schicken kann. Wenn Sie irgendeine Art von Erstantwort-Automatisierung aufgebaut haben, erleben Ihre Kunden den Tail, nicht den Median.
Wer dieses Modell tatsächlich aufruft
Diese Erkenntnis habe ich überhaupt nicht erwartet, und sie hat mein Urteil verschoben.
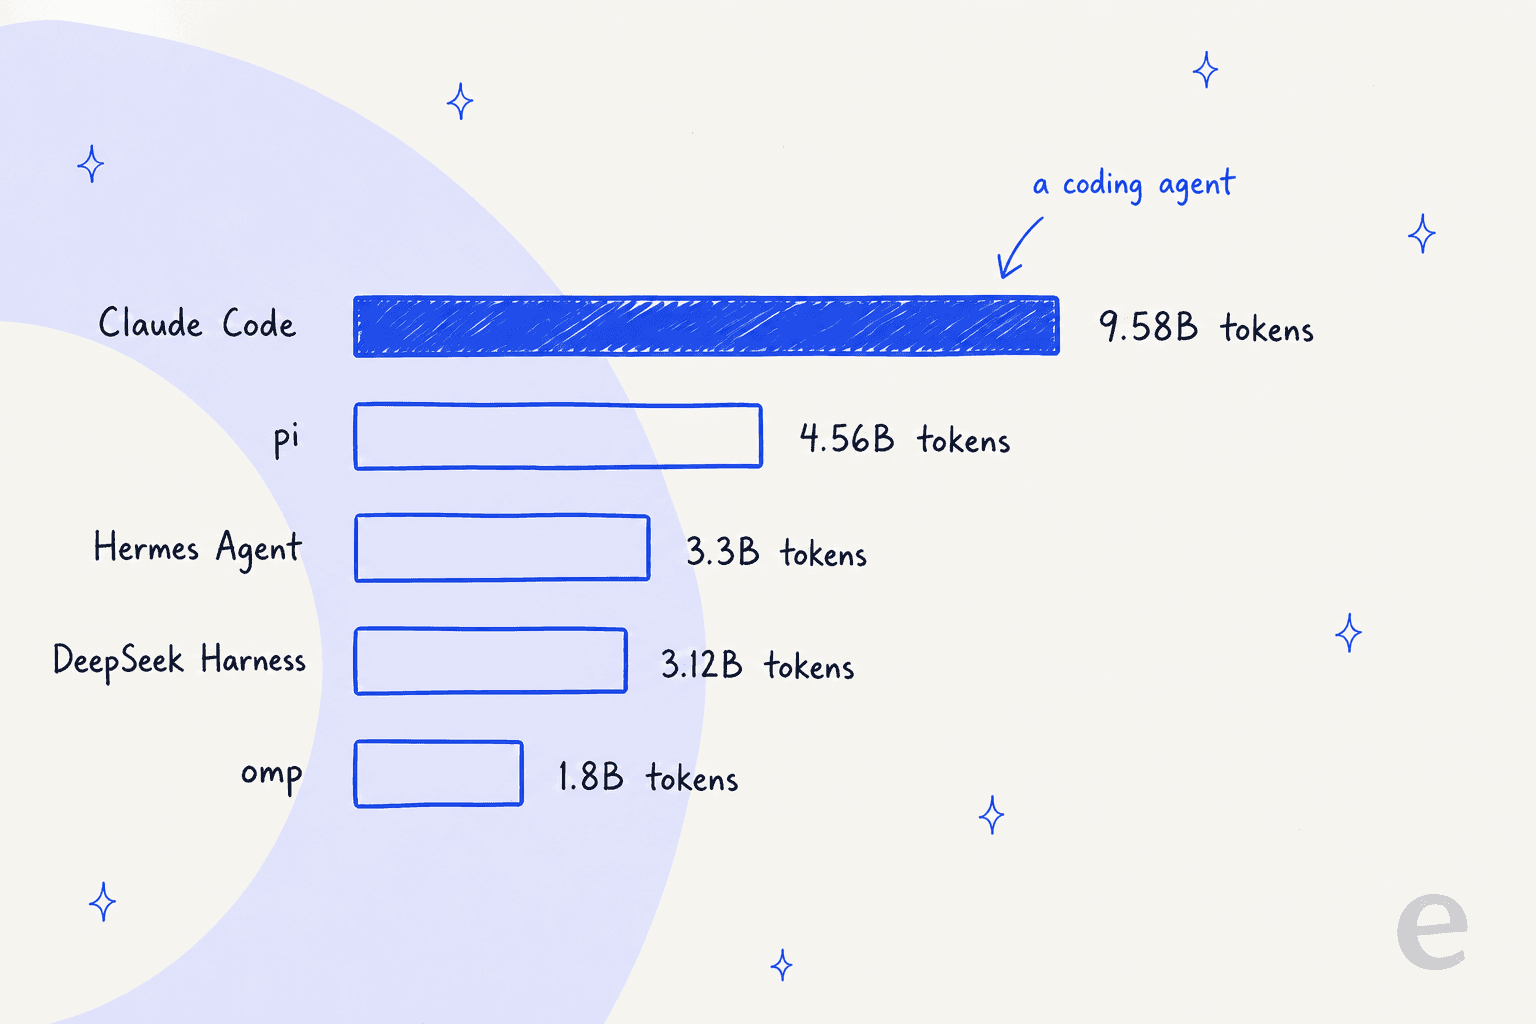
Die öffentlichen Apps, die in den ersten Tagen den meisten Traffic in deepseek-v4-flash-vision-exp schickten, der Reihe nach: Claude Code mit 9,58 Mrd. Token, pi mit 4,56 Mrd., Hermes Agent mit 3,3 Mrd., DeepSeeks eigenes Multimodal-Bridge-Harness mit 3,12 Mrd. und omp mit 1,8 Mrd. Der größte einzelne Nutzer von DeepSeeks erstem Vision-Modell ist ein Coding-Tool. In dieser Top Five geht es nur bei einem Eintrag ausdrücklich um Bilder.
Der Token-Mix erzählt dieselbe Geschichte aus anderer Richtung. In diesen ersten Tagen: 25 Mrd. Prompt-Token, 69,6 Mio. Completion-Token und 139 Mio. Reasoning-Token. Das Verhältnis von Prompt zu Completion liegt bei etwa 359 zu 1, was die Signatur eines Agenten ist, der große Codebasen und Tool-Ausgaben in ein Kontextfenster stopft, und nicht die Signatur einer Bildbeschriftungs-Last. Es zeigt auch eine Kostenfalle, die man kennen sollte. Reasoning läuft bei etwa dem Doppelten der Completion, der Thinking-Modus ist standardmäßig an, und Reasoning wird zum Output-Preis abgerechnet. Wenn Ihr Kostenmodell Output als Länge der Antwort behandelt, liegt es also um etwa das Dreifache daneben, dieselbe Falle, die die Preisaufschlüsselung zu V4-Flash durchgeht.
Jemand im Thread stellte die naheliegende Folgefrage, und ich halte sie für die richtige:
"I've been using v4-flash without vision for this months — it's my go-to for code tasks. Now with vision, I'm wondering: if this model can do everything the text-only version does (plus see images), why keep the text-only one around?"
Niemand gab eine klare Antwort zurück, und nach den veröffentlichten Belegen gibt es keine, außer den zwei fehlenden Funktionen unten und dem Wort exp im Namen.
Zwei Dinge fehlen stillschweigend
Beides taucht nur in der Spezifikationstabelle auf, und beides ist wichtiger als das Marketing.
FIM-Completion ist weg. Die Preisseite führt Fill-in-the-Middle-Completion im Nicht-Thinking-Modus sowohl für deepseek-v4-flash als auch für deepseek-v4-pro als verfügbar auf, für den Vision-Build dagegen als "Not supported". Wenn Sie FIM für Inline-Code-Vervollständigung nutzen, ist dieses Modell kein Drop-in-Ersatz für das Modell, von dem es abzweigt, egal wie gut die DeepSWE-Zeile aussieht.
Es gibt keinen Datumsstempel. Das Feld MODEL VERSION lautet DeepSeek-V4-Flash-Vision-Exp, während die Geschwister DeepSeek-V4-Flash-0731 und DeepSeek-V4-Pro-0813 heißen. Den Build festzuschreiben ist nicht möglich. Angesichts all dessen, was oben zur Streuung zwischen Läufen steht, wird das zu einem echten Evaluierungsproblem: Das Modell, das Sie am Montag getestet haben, ist nicht garantiert das Modell, das am Freitag Ihren Traffic bedient, und es gibt keine Versionsangabe, um das Gegenteil zu belegen. Bei einem experimentellen Endpunkt ist das vertretbar. Bei allem, was Sie Kunden vorsetzen, nicht.
Eine dritte Lücke sollte man mit Vorsicht melden, denn der Thread hat sich dazu selbst korrigiert. Ein Kommentator sagte, Bilder könnten nicht als Tool-Call-Ergebnisse zurückkommen, was für jede Screenshot-Verifizierungsschleife eines Agenten eine ernste Einschränkung wäre. Ein anderer korrigierte ihn: Die Beschränkung gilt für Chat Completions, während die Responses API und der Anthropic-kompatible Messages-Endpunkt Bilder in Tool-Ausgaben akzeptieren. Der ursprüngliche Kommentator zitierte daraufhin die Dokumentation zurück und bestätigte, dass input_image innerhalb von function_call_output für dieses Modell als echtes Bild verarbeitet wird. Die Fähigkeit ist also auf zwei von drei Oberflächen vorhanden. Wenn Sie auf Chat Completions aufbauen, bedeutet das für Sie eine Neuschreibung.
Apropos Neuschreibungen: Eine weitere Einschränkung, die einen bestehenden Agenten treffen wird: Bilder werden nur in user-Nachrichten akzeptiert. Legt man eines in eine system- oder assistant-Nachricht, kommt ein 400 zurück. Viele Agentenschleifen legen ihre Tool-Ausgabe in einem Assistant-Zug ab, und diese Schleifen müssen zuerst geändert werden, bevor ein einziges Bild durchkommt. Wer schon einmal zwischen OpenAIs Dateiverarbeitung und der eines anderen Anbieters migriert hat, weiß, wie sich solche kleinen Formunterschiede aufsummieren.
Wie es sich gegen die anderen Vision-Modelle schlägt
Preisliste und real gemessene Leistung, alles aus derselben Quelle, damit die Spalten vergleichbar bleiben. Ein Vorbehalt: DeepSeeks Zeitfenster beträgt drei Tage, weil das Modell drei Tage alt ist, während die anderen Ein-Wochen-Fenster haben. Für den direkten Vergleich bei Text statt bei Bildern siehe V4-Flash gegen Kimi K3.
| Modell | Input /M | Output /M | Cache-Read /M | Beste P50-Latenz | Bester Durchsatz | Verfügbarkeit | Auflösungssteuerung? |
|---|---|---|---|---|---|---|---|
| DeepSeek V4 Flash Vision Exp | $0.22 | $0.66 | $0.007 | 1.11s | 85 tps | 100.00% | Kein Hochauflösungsmodus |
| Gemini 3.7 Flash | $1.50 | $7.50 | $0.15 | 1.70s | 197 tps | 99.74% | Ja, Medienauflösung |
| Qwen3.8-Max | $2.00 | $6.00 | $0.25 | 1.83s | 45 tps | 100.00% | Nicht dokumentiert |
| GPT-5.6 | $4.00 | $20.00 | $0.40 | 3.55s | 45 tps | 98.50% | Ja, Detailstufen |
Beim Preis ist es nicht knapp. DeepSeek ist beim gelisteten Input etwa 6,8-mal günstiger als Gemini 3.7 Flash und 18-mal günstiger als GPT-5.6, und es hat außerdem die niedrigste Median-Latenz der vier. Zwei ehrliche Sternchen dazu. Gemini hat auf OpenRouter derzeit Aktionsrabatte (75 % über Vertex, 50 % über AI Studio), die einen großen Teil dieses Abstands vorübergehend schließen, und derselbe Tester, dessen Caption-Benchmark Gemini auf Platz eins setzte, merkte an, dass es nur wegen des Rabatts auf seine Auswahlliste kam.
Auch die Cache-Ökonomie verdient eine Zeile, weil sie das Bild stärker verschiebt als der Listenpreis. Die beobachtete Cache-Trefferquote bei DeepSeek liegt bei 88,9 %, und das senkt den effektiven Input-Preis auf 0,03073 $ pro Million gegenüber gelisteten 0,22 $. Der Output bewegt sich kaum, effektiv 0,6595 $ gegen gelistete 0,66 $. Ihre Rechnung ist hier also eine Output-Rechnung mit einem Rundungsfehler obendrauf, und jeder Vergleich, der gelistete Input-Preise nebeneinanderstellt, vergleicht die falsche Spalte. Wenn Sie ausrechnen, was ein KI-Workload Sie wirklich kostet, sind meine Hinweise zu den Kosten pro Lösung ein nützlicherer Rahmen als jeder Preis pro Million. Der Vergleich mit menschlichen Agenten ist die andere Hälfte derselben Rechnung.
Mein Urteil
Nutzen Sie es, wenn Ihre Arbeitslast aus Text-Agenten, Coding oder Tool-Nutzung besteht und Sie heute auf DeepSeek V4 Flash sitzen. Sechs von sieben Benchmark-Zeilen zeigen in eine Richtung und das tatsächliche Traffic-Profil in dieselbe, der Preis ist identisch, und die gesamte Migration besteht darin, den Modell-String zu tauschen. Mein V4-Flash-Test ist die Basis, an der dies gemessen wird. Prüfen Sie vor allem anderen Ihre FIM-Nutzung.
Nutzen Sie es, wenn Ihre Bildarbeit strukturell ist: Layout-Prüfungen, Diagrammformen, UI-Verifizierung, Screenshot-Triage, Design-to-Code. Bei etwa 0,00008 $ pro Bild außerhalb der Stoßzeiten rundet sich der Preis des Hinsehens auf nichts ab, und 0,64 MP reichen locker für "wurde das korrekt gerendert". Dieselbe Logik macht es günstig für die massenhafte Ticket-Klassifizierung bei Anhängen.
Bauen Sie ein Crop-Tool, wenn es auf feine Details ankommt. Das Muster ist erprobt und mehrere Leute setzen es schon produktiv ein, und es kostet Sie Token und Harness-Komplexität, nicht Genauigkeit. Ein vernünftiger Tausch bei diesem Preis.
Schauen Sie sich anderswo um, wenn das feine Detail die Aufgabe ist, besonders wenn das Modell einer Behauptung widersprechen soll, statt sie zu bestätigen. Kleine Schrift, Dokument-OCR im Format ganzer Seiten, Prüfung von Bildunterschriften: All das ist bei etwas besser aufgehoben, das eine Auflösungssteuerung bietet. Geminis Flash-Reihe ist hier der naheliegende Vergleich. Meine Übersicht der V4-Flash-Alternativen deckt den Rest der Preisklasse ab. Und wenn offene Gewichte für Sie zählen: Mehrere Leute im Thread erwarten eine Veröffentlichung, aber niemand hat eine bestätigt, planen Sie also nicht damit.
Warten Sie, wenn Reproduzierbarkeit für Sie Pflicht ist. Kein Datumsstempel plus echte Streuung zwischen Läufen ist eine schlechte Kombination für alles, was Sie zertifizieren müssen. Das exp im Namen leistet dort ehrliche Arbeit.
Das größere Fazit, für alle, die Modelle auswählen statt sie zu testen: Dieses Release liefert ein besseres Argument für DeepSeeks Text-Reihe als für die Vision. Stellen Sie es neben V4 Pro, dann neben Kimi K3 und neben den Stand von V3.2 vor einem Jahr, und die Preis-Leistungs-Kurve bei Text-Agenten biegt sich immer in dieselbe Richtung. Der Vision-Teil ist ein solider, günstiger Bonus, der absichtlich unscharf ist.
eesel für Support-Warteschlangen, in denen die Antwort stimmen muss
Wenn Sie hier gelandet sind, weil Ihre Warteschlange voller Kunden-Screenshots ist, sage ich Ihnen offen, was ein Modell-Release löst und was nicht.
Kunden schicken Screenshots, weil etwas Kleines und Konkretes schiefgegangen ist. Ein Fehlerdialog. Eine Zeile auf einer Rechnung oder ein Feld, das sich nicht speichern lässt. Es ist der wertvollste Input im Support und der denkbar schlechteste Fall für eine Auflösungsgrenze, denn die kleine Schrift ist die Information. Und selbst wenn das Modell sie perfekt liest, wartet das schwierigere Problem noch: das Salisbury-Kathedrale-Problem, eine flüssige und selbstbewusste Antwort auf falscher Prämisse, unter Ihrer eigenen Marke an einen echten Kunden geschickt.

eesels Antwort darauf ist, dass Sie sich die falschen Antworten ansehen, bevor es Ihre Kunden tun. Sie verbinden Ihr Helpdesk und Ihre Hilfeinhalte, und bevor etwas live geht, spielen Sie den Agenten über Ihre eigenen früheren Tickets ab. So sehen Sie genau, welche er bearbeitet hätte, welche er vermasselt hätte und mit welchen Worten. Sie legen fest, was er allein beantworten darf und was direkt an einen Menschen geht, und jede Aktion bleibt im oben gezeigten Protokoll sichtbar und umkehrbar. Starten Sie ihn als KI-Copilot, der Entwürfe für Ihre Agenten schreibt, wenn es Ihnen zu viel erscheint, ihm am ersten Tag die Warteschlange zu übergeben. Es ist das Gegenteil davon, einen Schalter umzulegen und hinterher das Postmortem zu lesen.
Das ist das Stück, das Ihnen ein günstiges Vision-Modell nicht liefert, und es entscheidet, ob KI in Ihrer Warteschlange Geld spart oder Vertrauen kostet. Wenn Sie sehen wollen, wie es auf Ihren eigenen Tickets läuft, testen Sie eesel kostenlos.
Wenn Sie noch bei der Vorauswahl sind, beginnen Sie mit meinen praktischen Hinweisen zur Wahl eines Support-Modells. Danach ist welches LLM zur Support-Arbeit passt ein guter Text, und was ein KI-Helpdesk-Agent im Alltag tatsächlich tut, ist der andere lesenswerte.