

DeepSeek hat ein Modell veröffentlicht, das sehen kann. 21. August 2026. deepseek-v4-flash-vision-exp kostet genau so viel wie das normale V4-Flash, das 1M-Kontextfenster bleibt, und Bilder werden als gewöhnliche Eingabe-Token abgerechnet.
Die Ankündigung versteckt allerdings den interessanten Teil. DeepSeek selbst schreibt, der Vision-Build "matches" V4-Flash bei Text. Die eigene Benchmark-Tabelle sagt mehr: Die Vision-Variante schlägt das reine Text-Modell bei sechs von sieben Text-Agenten-Benchmarks. Knapp fünf Punkte bei DeepSWE. Fünfeinhalb bei Toolathlon-Verified. Die eigentlich lohnende Frage betrifft also gar nicht die Bilder, sondern ob Sie Ihren Text-Traffic auf einen experimentellen Build umziehen.
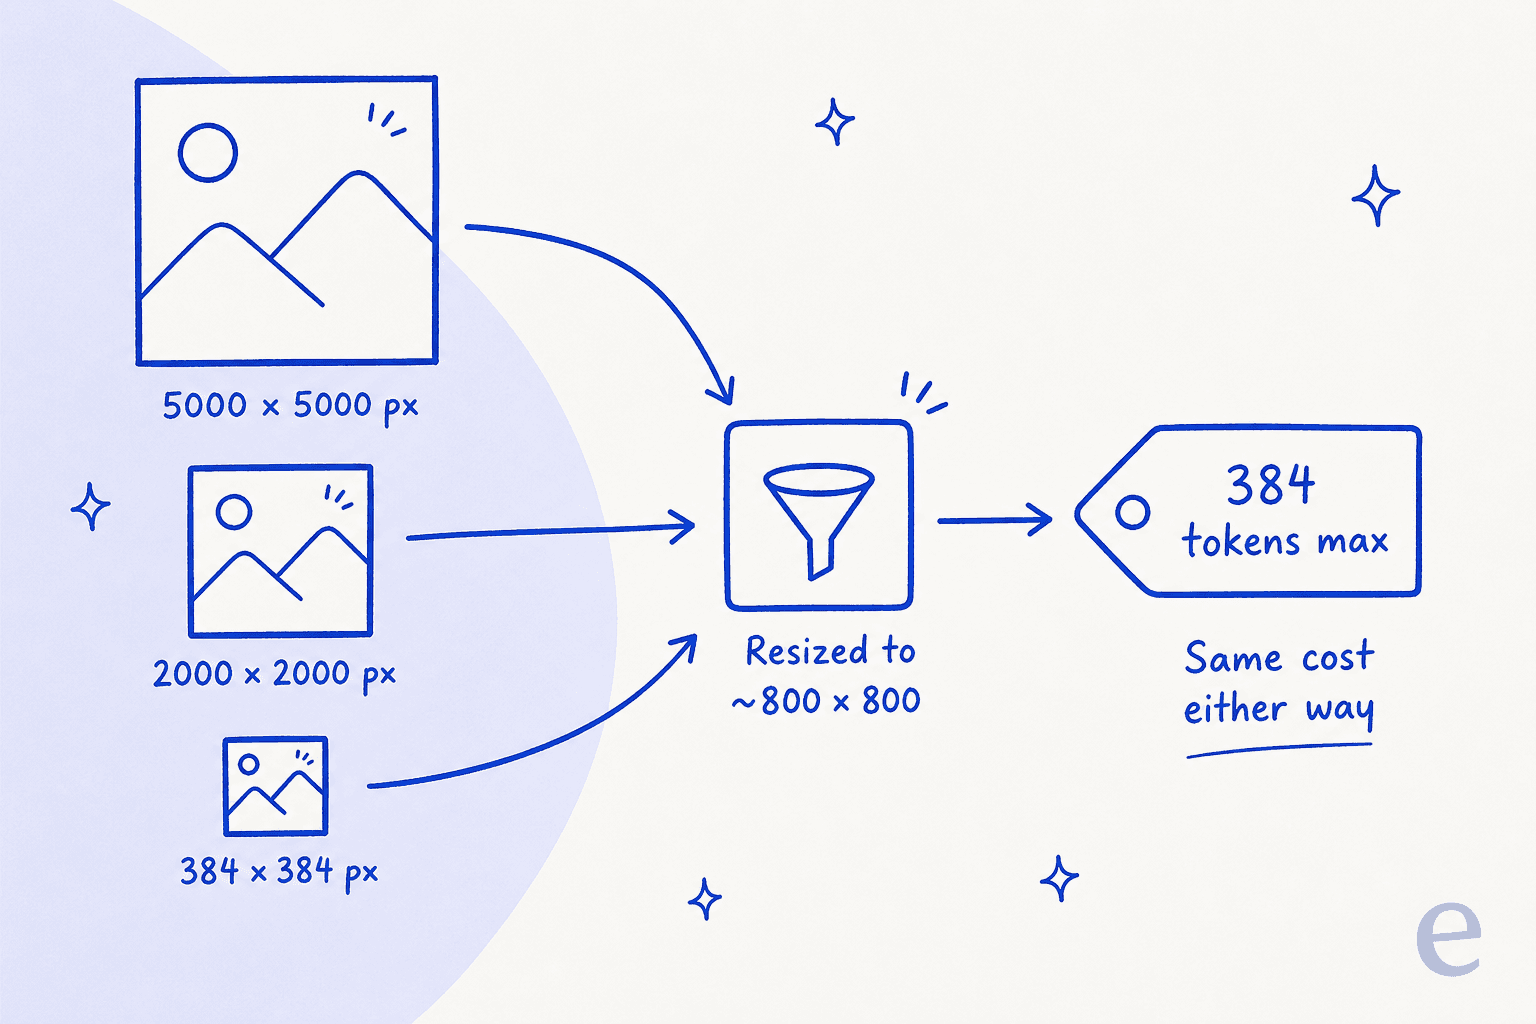
Dann der Haken. Jedes Bild wird auf etwa 800 mal 800 Pixel gestaucht, bevor das Modell es ansieht, begrenzt auf 384 Token. Ein Screenshot mit 5000 Pixeln und ein Thumbnail kosten dasselbe, weil sie nach der Skalierung dasselbe sind. Der Pauschalpreis ist also keine Großzügigkeit. Er ist die Auflösungsgrenze, als Preisliste ausgeschrieben.
Ich baue bei eesel die Integrationen und die API-Anbindung und lese Release Notes so, wie man einen Diff liest: was sich geändert hat, was stillschweigend nicht, und was mich um 2 Uhr nachts aus dem Bett holt. Hier sind die interessanten Zeilen zwei Funktionen, die leise verschwunden sind. FIM-Completion ist weg, und die Modellbezeichnung hat kein Build-Datum, sodass das, was Sie am Montag getestet haben, nicht zwingend das ist, was am Freitag den Traffic bedient.
Und wenn Sie das Ganze auf eine Support-Warteschlange richten, seien Sie klar darüber, was es löst. Den Screenshot eines Kunden zu lesen ist die leichte Hälfte. Die schwere Hälfte ist zu wissen, dass die Antwort korrekt ist, bevor sie den Kunden erreicht, und das ist ein Problem von Grounding und Tests, nicht der Modellgröße. Genau deshalb spielt eesel einen Agenten auf Ihren echten vergangenen Tickets ab, bevor er je ein Live-Ticket beantwortet.
Was DeepSeek tatsächlich veröffentlicht hat
Die Veröffentlichung besteht aus drei Dingen auf einmal, und nur eines davon hat es in die Schlagzeilen geschafft.
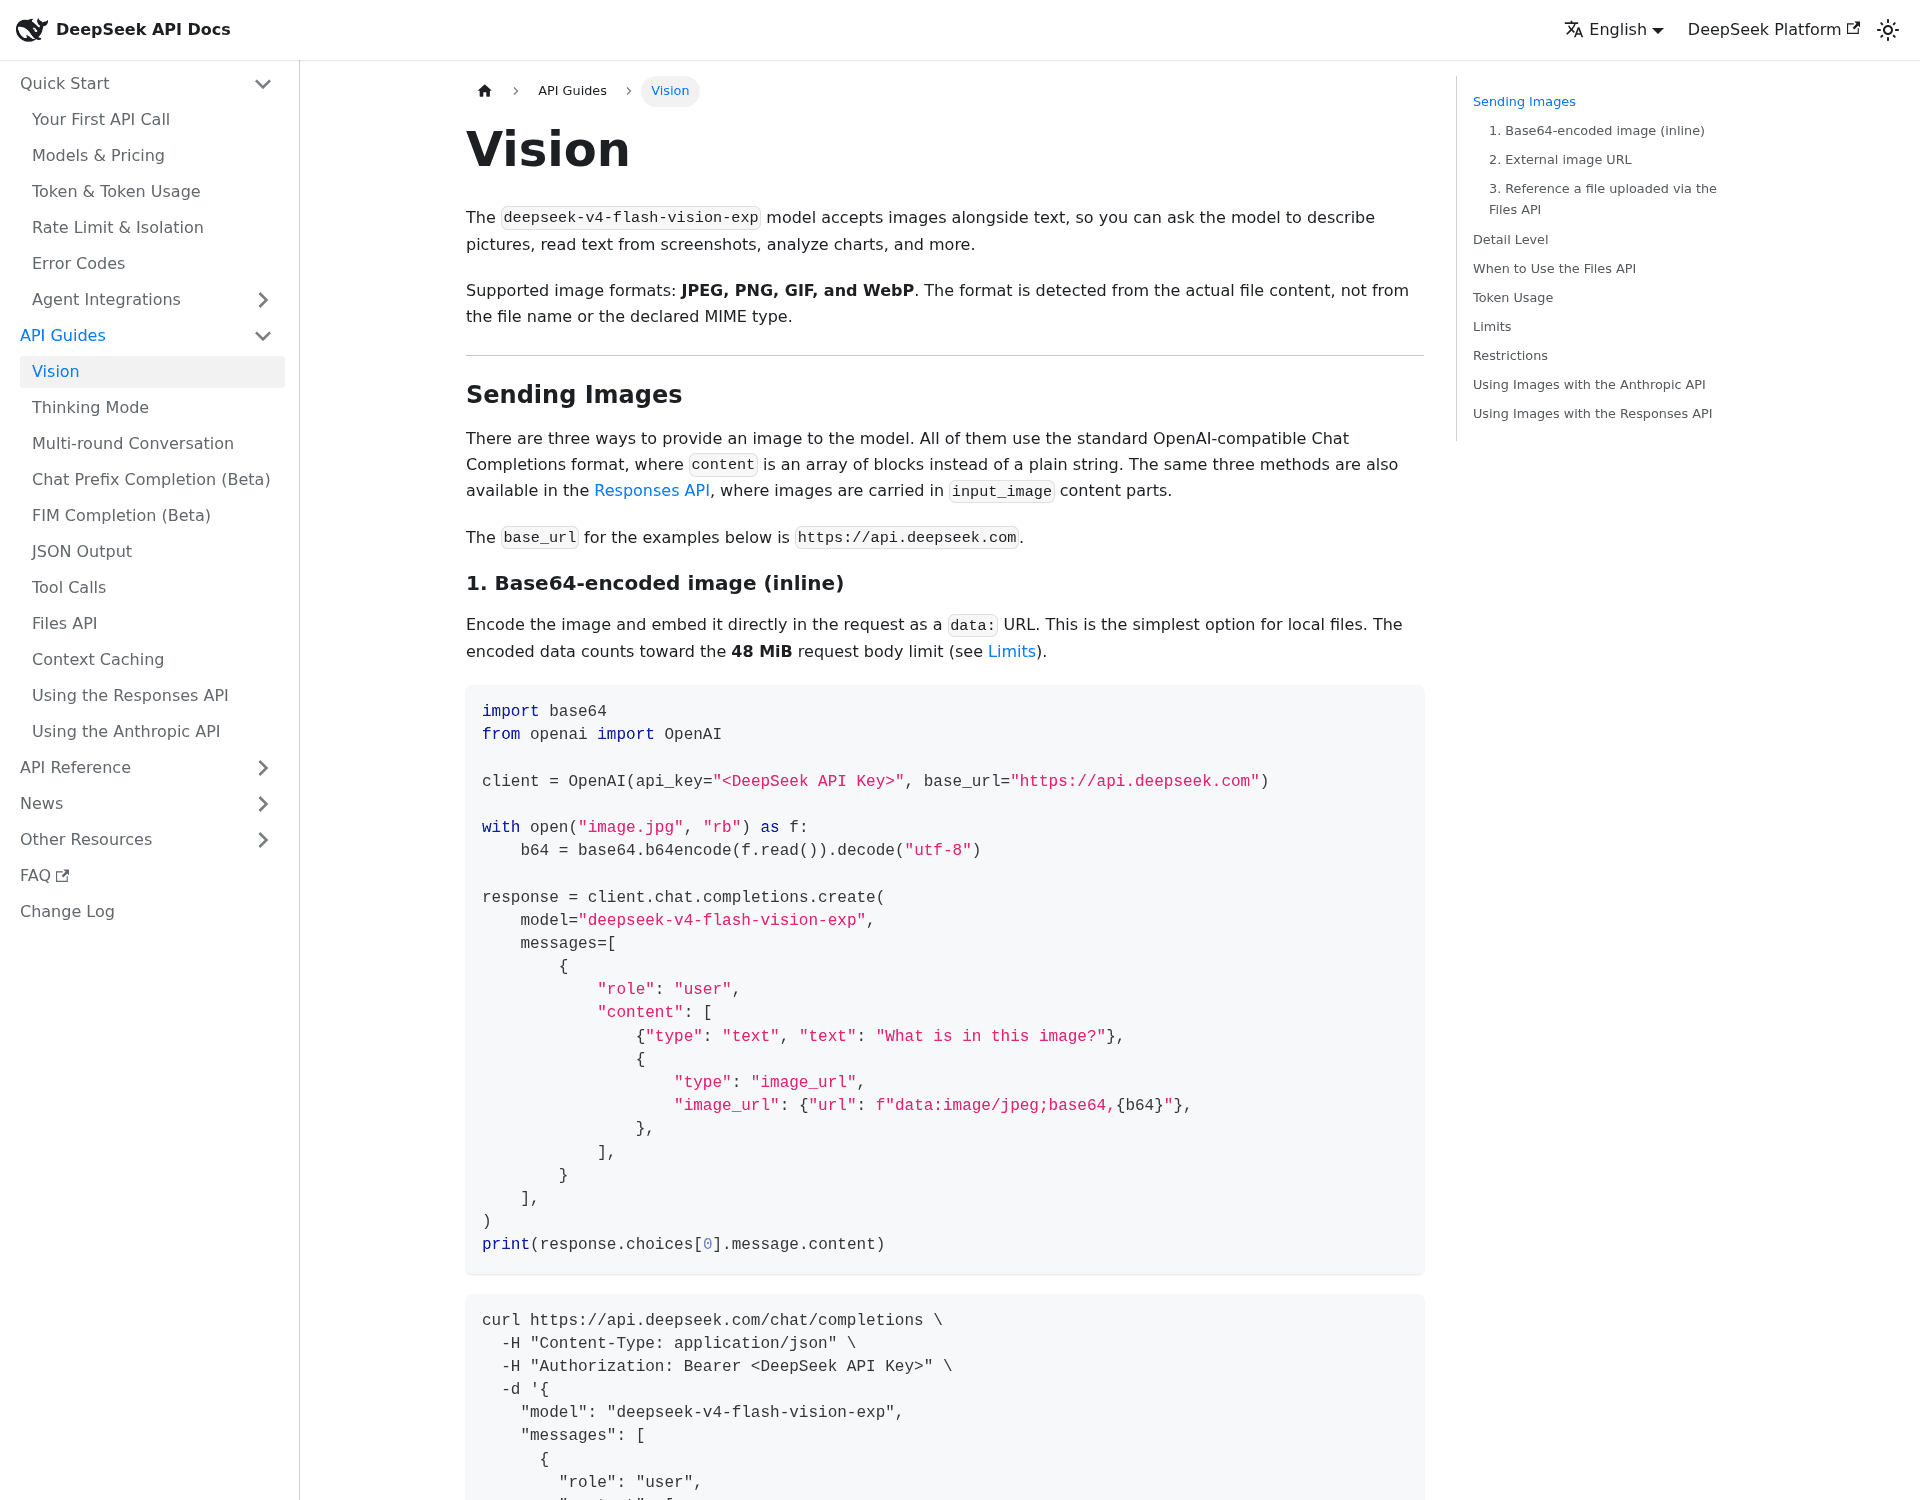
Ein Vision-Modell. deepseek-v4-flash-vision-exp nimmt Bilder in derselben Anfrage wie Ihren Text entgegen, über Chat Completions, den Anthropic-kompatiblen /messages-Endpunkt oder die Responses API. Unterstützte Formate sind JPEG, PNG, GIF und WebP, und laut Vision-Leitfaden wird das Format aus dem Dateiinhalt erkannt, nicht aus dem Dateinamen oder dem angegebenen MIME-Typ.
Eine kostenlose Files API. Sie laden ein Bild einmal hoch und verweisen dann per file_id darauf, über mehrere Anfragen hinweg. Außerdem hebt sie die Grenze pro Bild von 32 MiB auf 64 MiB, was wichtiger ist, als es klingt.
Ein Harness-Release. DeepSeek Harness 0.1.1 erschien am selben Tag, mit bereits eingebauter Unterstützung.
Bei der Architektur hat sich gegenüber dem Modell, von dem es abzweigt, nichts geändert: ein spärliches Mixture-of-Experts mit 13B aktiven von 284B Gesamtparametern, laut Modellseite von OpenRouter. Der Kontext bleibt bei 1M Token, die maximale Ausgabe bei 384K und die Parallelität bei 2.500. Wenn Sie bereits auf DeepSeek V4 Flash aufgebaut haben, besteht die gesamte Migration darin, die Modellbezeichnung auszutauschen.
Ein Detail, das wie eine Fußnote klingt, aber keine ist: Bilder werden nur in user-Nachrichten akzeptiert. Setzen Sie eines in eine system- oder assistant-Nachricht, erhalten Sie ein 400 zurück. Wenn Ihre Agentenschleife Tool-Ausgaben in einen Assistant-Zug packt, ist das für Sie ein Umbau und keine Konfigurationsänderung.
Die 384-Token-Grenze ist das ganze Design
Diesen Teil sollten Sie verstehen, bevor Sie irgendetwas um das Modell herum planen.
Vor der Inferenz skaliert DeepSeek jedes eingehende Bild. Alles unter etwa 384 mal 384 Pixeln wird hochskaliert, das Seitenverhältnis bleibt erhalten. Alles Größere wird herunterskaliert, wieder mit erhaltenem Seitenverhältnis, bis die Gesamtpixelzahl ungefähr der eines 800-mal-800-Bildes entspricht. Das Ergebnis ist eine feste Obergrenze von 384 Token pro Bild, und die Dokumentation nennt die Folge deutlich: Ein Bild mit 2000 mal 2000 und eines mit 5000 mal 5000 verbrauchen dieselbe Anzahl Token.
Bilder sind also fast kostenlos. Beim Preis außerhalb der Spitzenzeit von $0,22 pro Million Eingabe-Token kosten 384 Token etwa $0,00008. Ein Kommentator auf Hacker News rechnete nach und kam ungefähr auf dasselbe:
"400 tokens per image results in 2,500 images per dollar, if I'm not mistaken."

Er hatte recht, und die Zahl verdient einen Moment Aufmerksamkeit. Bei diesem Satz rundet sich der Preis des Hinsehens in fast jedem Agenten-Budget auf null.
Aber Preis und Auflösung sind hier eine einzige Entscheidung, nicht zwei. Es ist billig, weil es weniger genau hinsieht. Die schärfste Reaktion in dem ganzen Thread bestand aus wenigen Worten:
"Oof 800 by 800 kills a lot of use cases"
Das ist berechtigt, und der Thread stritt dann lange darüber, wie sehr es tatsächlich ins Gewicht fällt. Der Workaround, auf den sich die Leute einigten, ist ein Crop-und-Zoom-Tool: Man gibt dem Modell die Möglichkeit, einen Teilbereich eines hochauflösenden Bildes anzufordern, sodass es einen 600-mal-600-Ausschnitt in nativer Detailtiefe liest statt das ganze Bild verwaschen. Mehrere berichteten, dass das gut funktioniert. Andere verwiesen auf die offensichtliche Grenze: Neun Ausschnitte wieder zu einem räumlichen Verständnis zusammenzusetzen ist ein eigenes schweres Problem, und Dinge zählen oder Beziehungen in einem Schaltplan nachverfolgen ist genau dort, wo es zusammenbricht.
Beide Lager haben recht, nur bei unterschiedlichen Aufgaben. Zu prüfen, ob ein Button an der richtigen Stelle gerendert wurde, übersteht eine Herunterskalierung auf 800 mal 800 problemlos. Text in 8 pt von einem Beleg zu lesen nicht.
Es gibt auch einen Parameter detail, den man vor allem wegen dessen kennen sollte, was er nicht tut. low skaliert für mehr Tempo auf 512 mal 512 herunter. high, original und auto bedeuten derzeit alle dasselbe: das Original behalten und danach trotzdem die Standardskalierung anwenden. Einen Hochauflösungsmodus, nach dem Sie greifen könnten, gibt es nicht.
Die Benchmark-Tabelle sagt mehr als die Ankündigung
DeepSeeks Release Note beschreibt die Textseite des Vision-Modells mit einem Wort: Es "matches" V4-Flash. Die zusammen veröffentlichte Tabelle sagt das nicht ganz.
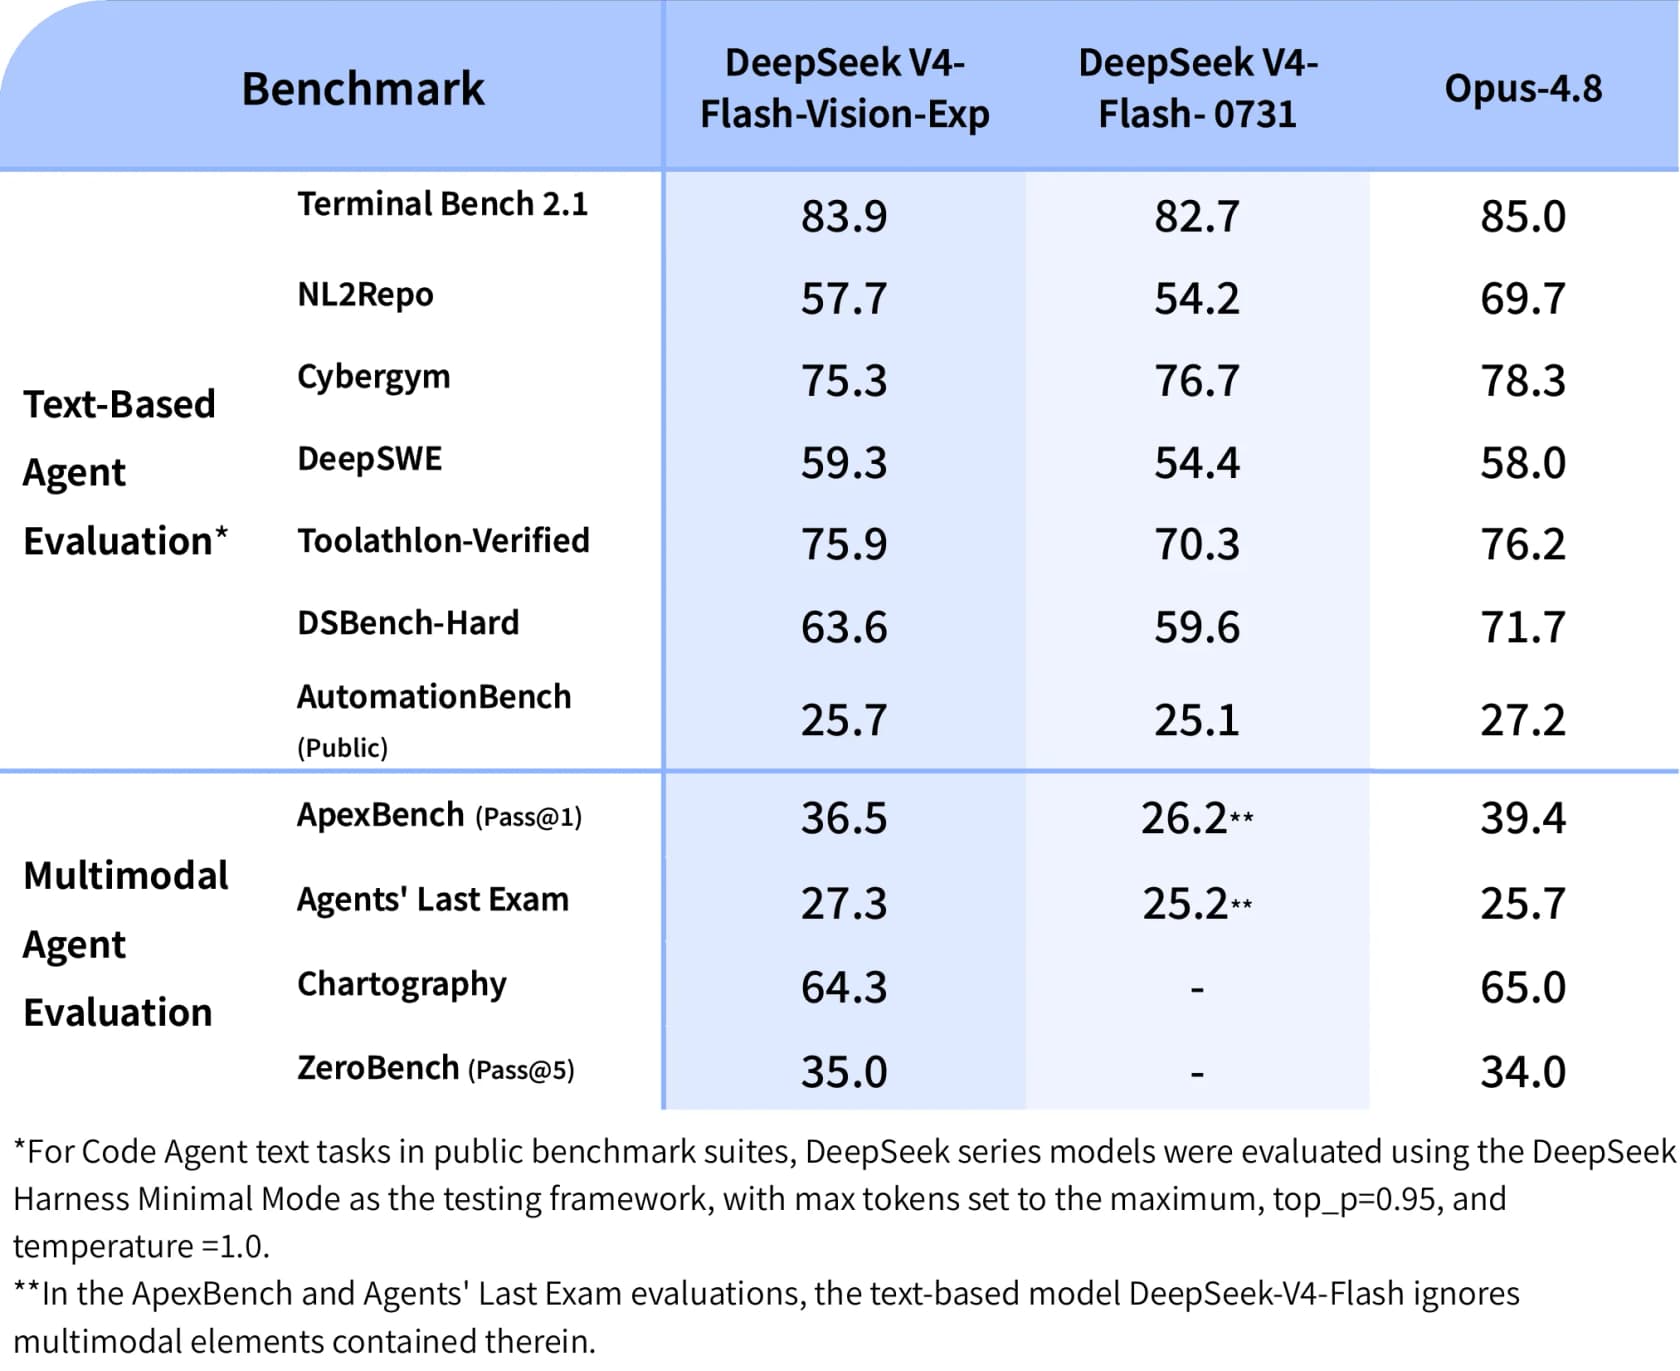
Legt man die textbasierten Agenten-Zeilen nebeneinander, gewinnt der Vision-Build sechs von sieben:
| Text-Agenten-Benchmark | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| Terminal Bench 2.1 | 83.9 | 82.7 | 85.0 |
| NL2Repo | 57.7 | 54.2 | 69.7 |
| Cybergym | 75.3 | 76.7 | 78.3 |
| DeepSWE | 59.3 | 54.4 | 58.0 |
| Toolathlon-Verified | 75.9 | 70.3 | 76.2 |
| DSBench-Hard | 63.6 | 59.6 | 71.7 |
| AutomationBench (Public) | 25.7 | 25.1 | 27.2 |
DeepSWE bewegt sich um 4,9 Punkte und Toolathlon-Verified um 5,6. Das sind keine Rundungsfehler. Bei DeepSWE liegt die Vision-Variante außerdem knapp vor Opus-4.8, 59,3 gegenüber 58,0. "Matches on text" untertreibt, was DeepSeeks eigenes Harness hier gemessen hat, und wenn Sie ein Coding- oder Tool-Use-Modell anhand dieser Zeilen auswählen, ist der Vision-Build die bessere Wahl, auch wenn Sie ihm nie ein einziges Bild schicken.
Nun die multimodale Hälfte, bei der die Darstellung einen zweiten Blick verdient:
| Multimodaler Benchmark | Vision-Exp | V4-Flash-0731 | Opus-4.8 |
|---|---|---|---|
| ApexBench (Pass@1) | 36.5 | 26.2* | 39.4 |
| Agents' Last Exam | 27.3 | 25.2* | 25.7 |
| Chartography | 64.3 | – | 65.0 |
| ZeroBench (Pass@5) | 35.0 | – | 34.0 |
*DeepSeeks eigene Fußnote: Bei ApexBench und Agents' Last Exam ignoriert das textbasierte V4-Flash die multimodalen Elemente der Aufgabe.
Diese Fußnote trägt viel. Der "große Sprung gegenüber V4-Flash" bei multimodalen Agenten-Benchmarks misst teilweise schlicht, dass das eine Modell sehen kann und das andere nicht, was zwar stimmt, aber etwas anderes ist als ein Fähigkeitsgewinn. Der ehrliche Vergleich steht in der Opus-4.8-Spalte, und dort ist das Bild eng: DeepSeek liegt bei ApexBench 2,9 zurück und bei Chartography 0,7, geht dann bei Agents' Last Exam und bei ZeroBench knapp in Führung. "Nah an Opus-4.8" ist eine faire Aussage, und für ein Modell zu einem Bruchteil der API-Preise von Anthropic ist das tatsächlich die Schlagzeile.
Zwei Vorbehalte, damit die Lesart stimmt. Alle Zahlen der DeepSeek-Reihe stammen aus dem DeepSeek Harness Minimal Mode mit top_p=0.95 und temperature=1.0, also aus dem eigenen Gerüst des Anbieters. Außerdem sind das Zahlen des Anbieters vom Starttag und keine unabhängige Replikation. Behandeln Sie sie wie jede Tabelle aus erster Hand, unsere eingeschlossen.
Was es tatsächlich kostet
Die Preisliste ist identisch mit dem normalen V4-Flash, wahrscheinlich die nützlichste einzelne Tatsache der ganzen Veröffentlichung. Außerhalb der Spitzenzeit, pro Million Token: $0,007 bei Cache-Treffer, $0,22 bei Cache-Miss und $0,66 für die Ausgabe. In der Spitzenzeit verdoppeln sich alle drei. Die Spitzenzeiten laufen von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC, Montag bis Freitag, was bedeutet, dass eine US- oder EU-Last meist rein geografisch zufällig zum günstigeren Satz abgerechnet wird.
Der Listenpreis ist außerdem nicht das, was die meisten tatsächlich zahlen. OpenRouters eigene Telemetrie nennt einen effektiven Eingabepreis von $0,03073 pro Million gegenüber gelisteten $0,22, weil die beobachtete Cache-Trefferquote bei 88,9 % liegt. Die Ausgabe bewegt sich kaum, effektiv $0,6595 gegenüber den gelisteten $0,66. Beim Blick darauf, wohin das Geld fließt, leistet der Cache also fast die ganze Arbeit auf der Eingabeseite und gar keine auf der Ausgabeseite, sodass Ihre Rechnung eine Ausgabe-Token-Rechnung mit einem Rundungsfehler obendrauf ist.
Setzen Sie Ihre eigenen Zahlen ein:
Lassen Sie einen realistischen, screenshotgetriebenen Agenten da durchlaufen, und das Muster hält: Bilder fallen kaum ins Gewicht, die Rechnung besteht aus Ausgabe-Token. Das bringt eine Zahl auf, die man markieren sollte. In den ersten drei Tagen auf OpenRouter verbrauchte das Modell 25B Prompt-Token, 69,6M Completion-Token und 139M Reasoning-Token, das Reasoning läuft also bei etwa dem Doppelten der Completion. Der Denkmodus ist standardmäßig an, und Reasoning-Token werden zum Ausgabesatz abgerechnet. Wenn Ihr Kostenmodell Ausgabe also als "Länge der Antwort" ansetzt, liegt es etwa um den Faktor 3 daneben. Dieselbe Falle taucht in unserer Aufschlüsselung der DeepSeek-V4-Flash-Preise auf, und sie erklärt einen guten Teil davon, warum der Vergleich roher Preislisten über Anbieter hinweg so in die Irre führt. Wer die OpenAI-API mit einem Support-Tool mit Abrechnung pro Auflösung verglichen hat, kennt dasselbe Problem aus der Gegenrichtung.
Die Grenzen, die Sie tatsächlich treffen werden
Die meisten davon sind großzügig. Zwei nicht.
| Grenze | Wert |
|---|---|
| Unterstützte Formate | JPEG, PNG, GIF, WebP |
| Max. Bilder pro Anfrage | 600 |
| Größe des Request-Bodys | 48 MiB |
| Max. Einzelbild (Base64 / URL) | 32 MiB |
| Max. Einzelbild (Files API) | 64 MiB |
| Max. Gesamtbildgröße pro Anfrage | 64 MiB oder 200 MiB mit file_id |
| Max. Bildabmessung | 8192 px pro Seite |
| Max. Abmessung ab 15+ Bildern | 4096 px pro Seite |
| Länge externer URLs | 8192 Zeichen |
| Zeitlimit für Download externer Bilder | 60 Sekunden |
Sechshundert Bilder in einer Anfrage sind viel Spielraum. Aber beachten Sie, wie sich die Abmessungsregel still halbiert, sobald eine Anfrage fünfzehn oder mehr Bilder enthält, genau die Form eines Batch-Dokumentenjobs. Und das 60-Sekunden-Fenster für den Download externer URLs ist die Art Ding, die im Test einwandfrei läuft und dann sporadisch Fehler wirft, sobald Sie es auf ein langsames Kunden-CDN richten. Wenn Bilder für Ihre Pipeline wichtig sind, ist die Files API der sicherere Standard und keine Optimierung für später.
Was Sie aufgeben
Zwei Dinge, und keines steht in der Aufzählung der Ankündigung.
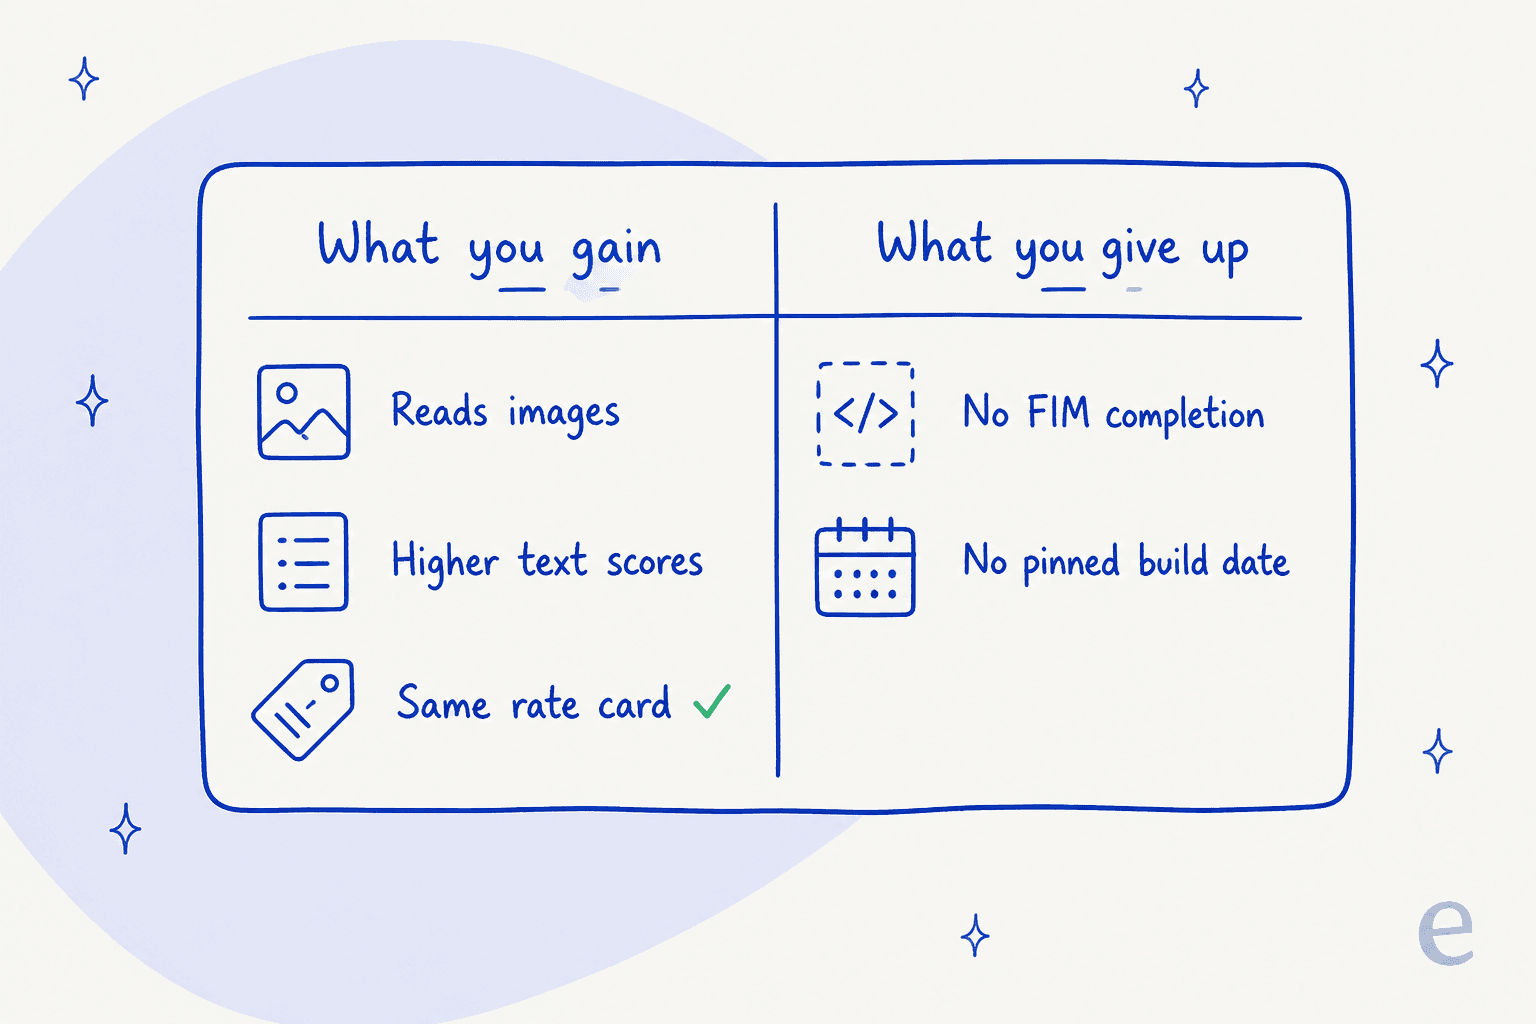
FIM-Completion wird nicht unterstützt. Das normale V4-Flash und V4-Pro bieten beide Fill-in-the-Middle im Nicht-Denkmodus an, während die Preisseite es für den Vision-Build als "Not supported" ausweist. Wenn Sie FIM für Inline-Code-Completion nutzen, kann dieses Modell also kein Drop-in-Ersatz sein, und das ist das einzige harte Hindernis der Veröffentlichung.
Es gibt kein Build-Datum. Das ist subtiler, und es ist der Grund, warum ich Produktions-Traffic noch nicht umziehen würde. Sehen Sie sich an, wie die Preisliste ihre Versionen benennt: Das normale Flash heißt DeepSeek-V4-Flash-0731, Pro DeepSeek-V4-Pro-0813, und der Vision-Build dann nur DeepSeek-V4-Flash-Vision-Exp. Ein datierter Build lässt sich nachvollziehen. Ein exp-Label ohne Stempel ist ein bewegliches Ziel, und ein Hacker-News-Kommentator las die Roadmap genauso:
"most likely a preview. they often release the preview via API, get more training data, post train some more then release the weight. i would expect to see it perform better in a few weeks or a month."
Stimmt das, haben die Zahlen in diesem Beitrag ein Haltbarkeitsdatum, ebenso jede Evaluation, die Sie diese Woche laufen lassen. Das sind normale Kosten experimenteller Endpunkte. Zum Problem wird es erst, wenn man vergisst, dass man es in Kauf genommen hat.
Was die ersten 72 Stunden echten Traffics zeigen
Anbieter-Benchmarks sind eine Sache. Hier steht, was die Routing-Schicht selbst gemessen hat, laut OpenRouter über die ersten drei Tage des Modells.
- 85 Token/Sekunde beim P50-Durchsatz, bei einer P50-Latenz von 1,11 Sekunden.
- 1,27 % Fehlerquote bei Tool-Aufrufen. Bei einem Modell, dessen ganzes Argument multimodale Agentenarbeit ist, würde ich diese Zahl zuerst prüfen, und sie ist in Ordnung.
- 100 % Uptime, 99,93 % Verfügbarkeit, bei einem einzigen Anbieter. DeepSeek betreibt es direkt, einen Failover zum Umleiten gibt es also nicht.
- 90,4 % Cache-Trefferquote, die den effektiven Eingabepreis auf etwa ein Siebtel des Listenpreises drückt.
Das Ende der Verteilung ist aber einen Blick wert. Die P99-Latenz liegt bei 18,34 Sekunden und die P99-Ende-zu-Ende-Zeit bei 99,94 Sekunden. Das ist eine gute Verteilung für einen Batch-Job und eine harte für alles, worauf ein Mensch wartet, derselbe Zielkonflikt wie bei jedem KI-Agenten vor einem Kunden.
Der Traffic-Mix ist der interessanteste Teil. Die größten Verbraucher sind allesamt Coding-Harnesses: Claude Code mit 9,58B Token, pi mit 4,56B, Hermes Agent mit 3,3B, dazu DeepSeeks eigenes Multimodal-Bridge-Harness mit 3,12B. Niemand betreibt das als Chat-Modell. Sie richten es auf Codebasen und auf Bildschirme, was gut zu den sechs von sieben Text-Benchmark-Siegen passt.
Noch ein Stück Kontext, warum ein billiges Vision-Modell hier so eingeschlagen hat. Das normale V4-Flash hat offenbar monatelang so getan, als könne es sehen:
"It tried to recreate vision by analyzing pixels on 3 separate projects I had it working on."
Ein anderer Kommentator beschrieb, wie er 0731 anweisen musste, keine Screenshots mehr zu öffnen, weil die Versuche ständig Sitzungen zerstörten. Verglichen damit ist ein Modell, das sich das Bild einfach ansieht, ein echtes Upgrade, auch ein unscharfes.
Wer es nutzen sollte und wer warten sollte
Nutzen Sie es jetzt, wenn Sie Agentenschleifen über Bildschirme und Codebasen betreiben, ohnehin auf V4-Flash saßen und nicht auf FIM angewiesen sind. Die Text-Benchmarks allein rechtfertigen den Tausch der Modellbezeichnung, und die Vision ist ein Bonus. Batch-Dokumentenarbeit passt ebenfalls, solange Sie Ihre eigenen Dokumente vorher gegen die Skalierung geprüft haben.
Warten Sie, wenn Sie einen fixierten Build brauchen oder FIM oder Ihre Bilder von feinen Details abhängen. Analoge Zifferblätter, dichte Schaltpläne, Kleingedrucktes auf Belegen: Testen Sie all das, bevor Sie darauf planen. Die Debatte um das Uhrenlesen im Hacker-News-Thread zeigt gut, wie verrauscht einzelne Vision-Urteile sind, denn der Fehlschlag eines Kommentators wurde zu 9 von 10 richtig, als jemand anderes es zehnmal laufen ließ, was zu einem Satz führte, den wir alle an den Monitor kleben sollten:
"Lesson learned to double check what I read on the internet."
Denken Sie genauer nach, wenn Sie das auf eine Support-Warteschlange richten. Kunden-Screenshots gehören zu den wertvollsten Eingaben im Support und sind zugleich die schlechteste Passung für eine 800-mal-800-Grenze, weil der ganze Grund, warum ein Kunde einen Screenshot schickt, der kleine Text darin ist. Lesen Sie unsere Hinweise zur Wahl eines Support-Modells und dazu, welches LLM zum Support passt, bevor Sie ein rohes Modell an eine Live-Warteschlange anschließen.
eesel für Support-Warteschlangen voller Screenshots
Ich möchte präzise sagen, was dieses Modell für ein Support-Team löst, denn das Nachfragesignal liegt uns vor. Ein Kunde, ein Support-Outsourcer für Ferienwohnungen, der eesel als Zendesk-Copilot einsetzt, sagte uns klar, was ihn am vollständig autonomen Betrieb hinderte:
"Eesel is currently unable to analyze images, and our customers frequently share screenshots. Our agents are currently required to read these images and manually transfer the knowledge to Eesel."
Das ist ein echter unerfüllter Bedarf, und ein Modell wie dieses schließt ihn irgendwann. Aber man sollte klar sagen, welche Hälfte ein Vision-Modell tatsächlich schließt. Die Pixel zu lesen ist die leichte Hälfte. Daraus eine korrekte, richtlinienkonforme Antwort zu erzeugen ist die schwere Hälfte, und es ist auch die Hälfte, an der jeder gescheitert ist, der je KI-Support ausgeliefert hat.
Wir haben erlebt, wie ein selbstsicher klingender Bot Kunden stillschweigend erzählte, wir unterstützten Fahrzeugmodelle, die wir nicht unterstützten, weil die Wissensdatenbank "we support all models" sagte und der Bot das wörtlich nahm. Das war ein Telematik-Team auf Zendesk mit etwa 200 Tickets im Monat. Nichts an einem Vision-Encoder behebt genau diesen Fehler. Was ihn behebt, ist, den Agenten in Ihrer echten Historie zu verankern und das Verhalten zu belegen, bevor ein Kunde damit in Kontakt kommt, weshalb jeder eesel-Rollout zuerst gegen vergangene Tickets abgespielt und jeweils auf einen Tickettyp begrenzt wird.

Wenn Sie DeepSeeks Vision-Modell also bewerten, weil Ihre Warteschlange voller Screenshots ist, führen Sie die beiden Tests in der richtigen Reihenfolge durch. Erstens: Kann das Modell Ihre tatsächlichen Bilder lesen, nachdem sie skaliert wurden? Zweitens, und das ist wichtiger: Ist die Antwort, die es zurückgibt, eine, die Sie selbst so gesendet hätten? eesel erledigt diesen zweiten Test, indem es auf Ihrem Ticketverlauf simuliert, bevor es live geht, pro Ticket statt pro Platz abrechnet und alles unter Ihrer Konfidenzschwelle an einen Menschen weiterleitet. Testen Sie eesel kostenlos oder buchen Sie eine Vorführung mit Ihren eigenen Tickets.
Wo es in der DeepSeek-Reihe steht
Wenn Sie die Familie einordnen wollen, ist die Kurzfassung: deepseek-v4-flash-vision-exp ist ein Fork des Flash-Builds 0731, mit angeschraubtem Vision-Encoder und entferntem FIM. Es ist kein Modell der Pro-Klasse und ersetzt nichts.
- DeepSeek V4 Flash ist die Text-Basis und weiterhin der fixierte Build für die Produktion.
- Flash gegen Pro behandelt die seltsame Lage, in der die günstigere Stufe derzeit die teure übertrifft.
- Flash gegen Kimi K3 und Flash gegen GPT-5.6 übernehmen die Vergleiche über Anbietergrenzen hinweg.
- Qwen 3.8 Max gegen Flash ist der engste Kampf unter offenen Gewichten, und Kimi K3 ist der andere, den man im Auge behalten sollte.
- DeepSeek V3.2 ist die Vorgängergeneration, falls Sie sie noch betreiben.
- Unser V4-Flash-Test und die Übersicht der Alternativen zeigen das größere Bild.
Und wenn Sie aus der Support-Automatisierung statt aus der Modellauswahl hergekommen sind, liegt die nützlichere Lektüre weiter unten im Stack:
- Wo ein Modell tatsächlich sitzt: KI-gestütztes Ticketing und KI-Helpdesk-Agenten.
- Die Retrieval-Frage, die meist wichtiger ist als das Modell: RAG gegen ein LLM.
- Wie die Arbeit in der Warteschlange aussieht: Ticket-Deflection und Ticket-Klassifizierung.
- Reihenfolge und Volumen beim Triagieren: Ticket-Priorisierung, Automatisierung der Erstantwort und Ticket-Reduzierung.
- Das Human-in-the-Loop-Muster: KI-Copiloten für den Support.
- Begriffe, falls die Anbieter-Pitches verschwimmen: Agenten gegen Chatbots.
- Die beiden Vergleiche, die über Budgets entscheiden: Kosten pro Lösung und Kosten KI-Agent gegen menschlichen Agenten, vor dem Hintergrund der Kosten für KI-Kundenservice.
Das Fazit
DeepSeek hat ein Modell veröffentlicht, das Bilder praktisch gratis liest, und nebenbei ein besseres Text-Modell als das, von dem es abgezweigt wurde. Beides ist real, und beides ist billig.
Abzuwägen sind die beiden Dinge, mit denen die Ankündigung nicht eröffnet. Jedes Bild wird auf etwa 800 mal 800 geplättet, bevor das Modell es ansieht, die Vision ist hier also ein Blick und keine Inspektion. Und der Build trägt kein Datum, sodass alles, was Sie diese Woche messen, eine Messung an einem beweglichen Ziel ist.
Für Agentenschleifen über Bildschirme und Code ist das bei $0,22 Eingabe und $0,66 Ausgabe ein guter Handel. Für eine Support-Warteschlange, in der der Screenshot das Ticket ist, testen Sie die Skalierung, bevor Sie darauf planen, und bedenken Sie, dass das Lesen des Bildes nie der Teil war, der schiefgehen würde.
Häufig gestellte Fragen
Was ist DeepSeek V4 Flash Vision Exp?
model='deepseek-v4-flash-vision-exp' auf, und es akzeptiert Bilder zusammen mit Text in derselben Anfrage. Es ist eine Variante von DeepSeek V4 Flash mit derselben Mixture-of-Experts-Architektur (284B gesamt, 13B aktiv) und demselben 1M-Kontextfenster.Was kostet DeepSeek V4 Flash Vision Exp?
Wie rechnet DeepSeek Bilder ab?
Ist DeepSeek V4 Flash Vision Exp besser als V4-Flash?
Was ist der Haken bei DeepSeek V4 Flash Vision Exp?
DeepSeek-V4-Flash-Vision-Exp, nicht mit einem festen Stempel im Stil von 0731, sodass sich ein experimenteller Build zwischen Testtag und Starttag unter Ihnen verändern kann.Kann DeepSeek V4 Flash Vision Exp Kunden-Screenshots für den Support lesen?
Wie sende ich ein Bild an die DeepSeek-API?
file_id aus der neuen Files API, die kostenlos nutzbar ist. Der Weg über die Files API hebt außerdem die Grenze pro Bild von 32 MiB auf 64 MiB an. Unsere Anleitung zur DeepSeek-API behandelt Authentifizierung und die OpenAI-kompatible Basis-URL.