

Was kostet die DeepSeek Search API?
Ich bin Rama und baue bei eesel die Integrationen und die API-Anbindungen. Ich habe viel Zeit damit verbracht, Suchwerkzeuge in Agenten einzubauen, und das Muster ist immer gleich: Der Preis pro Aufruf wirkt winzig, dann taucht die echte Rechnung an anderer Stelle auf. Deshalb habe ich die DeepSeek-Dokumentation komplett gelesen, bevor ich etwas gerechnet habe.
DeepSeek hat Search und Fetch am 17. Oktober 2026 veröffentlicht, am selben Tag wie DeepSeek V4.1 Flash 1017. Beides sind eigenständige JSON-Endpunkte auf api.deepseek.com, mit demselben API-Schlüssel wie die Modelle. Hier die vollständige Preisliste von der Seite Models & Pricing:
| API | Endpunkt | Abrechnungseinheit | Preis | Rate Limit |
|---|---|---|---|---|
| Search | POST /v1/tools/search | Pro 1.000 erfolgreiche Anfragen | $0.75 | 5 QPS pro Konto |
| Fetch | POST /v1/tools/fetch | Pro 1.000 erfolgreiche Anfragen | $0.75 | 5 QPS pro Konto, plus Limit pro Domain |
Pro Aufruf sind das $0.00075. Tausend Suchen kosten weniger als ein Kaffee, eine Million kostet $750.
Bei diesen beiden Zeilen gibt es keine Aufteilung in Spitzen- und Nebenzeiten. Die DeepSeek-Modelle halbieren ihre Token-Preise außerhalb der Spitzenzeiten, aber Search und Fetch haben zu jeder Tageszeit einen festen Preis pro Anfrage.
Der Leitfaden zu Search & Fetch sagt, dass Search auf DeepSeeks eigener Engine läuft, die laut Changelog "hundreds of billions of web pages" indexiert. Jedes Ergebnis enthält Titel, URL, ein kurzes Snippet, eine längere summary, die für ein Modell geschrieben ist, ein Datum, einen authority-Wert von 0 bis 4 und optional den vollständigen Seiteninhalt.
Was wird genau abgerechnet?
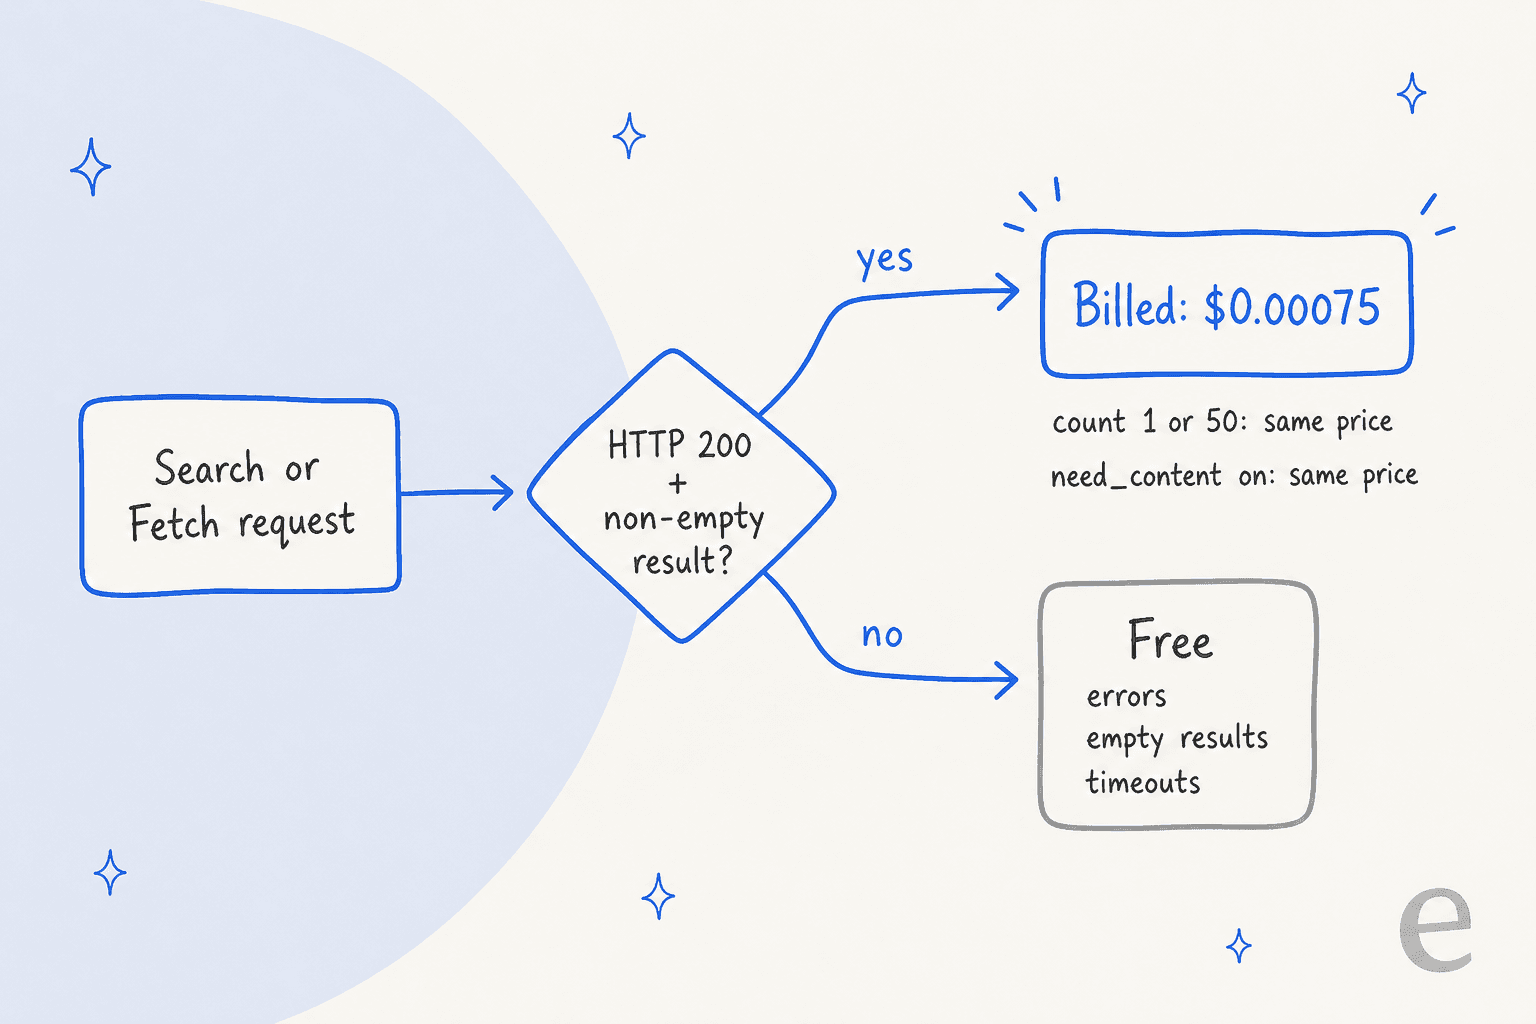
Dieser Teil der DeepSeek-Search-API-Preise ist großzügiger, als er aussieht, deshalb lohnt sich langsames Lesen. Laut Abrechnungsabschnitt des Leitfadens ist eine Anfrage nur abrechenbar, wenn sie HTTP 200 zurückgibt und tatsächlich etwas liefert: ein nicht leeres results-Array bei Search, Seiteninhalt bei Fetch.
Drei Details, an denen echtes Geld hängt:
- Leere Suchen sind kostenlos. Wenn Ihr Agent eine enge Abfrage mit
site:- undafter:-Filtern abschickt und nichts zurückbekommt, zahlen Sie nichts. Perplexitys Search API macht das Gegenteil: Laut Preisseite wird eine erfolgreiche Antwort auch dann berechnet, wenn sie keine Ergebnisse enthält. countändert den Preis nicht. 50 Ergebnisse kosten dieselben$0.00075wie 1 Ergebnis. Exa berechnet$1pro 1.000 Anfragen für jedes Ergebnis ab dem zehnten, und Firecrawl berechnet 2 Credits pro 10 Ergebnisse.need_content: trueist enthalten. Wenn Sie es aktivieren, kommt der Seitentext ohne Aufpreis in jedem Suchergebnis mit. Eine Suche mit Inhalt kann eine Suche plus mehrere Fetch-Aufrufe ersetzen.
Auch fehlgeschlagene Fetch-Aufrufe sind kostenlos. Ein 403 durch DeepSeeks Sicherheitsrichtlinie, ein 404, weil die Seite kein extrahierbares Markdown hatte, oder ein 504-Timeout kosten nichts. Ein schlechter Aufruf kostet nur dann Geld, wenn er technisch erfolgreich ist, aber Müll liefert, dasselbe Risiko tragen Sie bei jedem Scraper.
Wann endet die kostenlose Phase?
Kurz gesagt: am 1. November 2026 um 00:00 Uhr Pekinger Zeit, das entspricht 16:00 UTC am 31. Oktober.
Stolpern lassen sich viele über die Frage, was die kostenlose Phase abdeckt. DeepSeeks Hinweis, wiederholt auf der Preisseite und im Leitfaden, besagt: Wenn Sie die API über DeepSeek Harness, Claude Code oder Codex nutzen, "server-side tool calls already hit the Search and Fetch APIs. These calls are currently free of charge". Das kostenlose Fenster nennt diese drei Clients. Direkte Aufrufe von /v1/tools/search aus Ihrem eigenen Code sind eigenständige, kostenpflichtige APIs ab dem Start.
So sieht serverseitige Suche aus, wenn Claude Code auf DeepSeek läuft. Eine Frage, zwei Suchen:
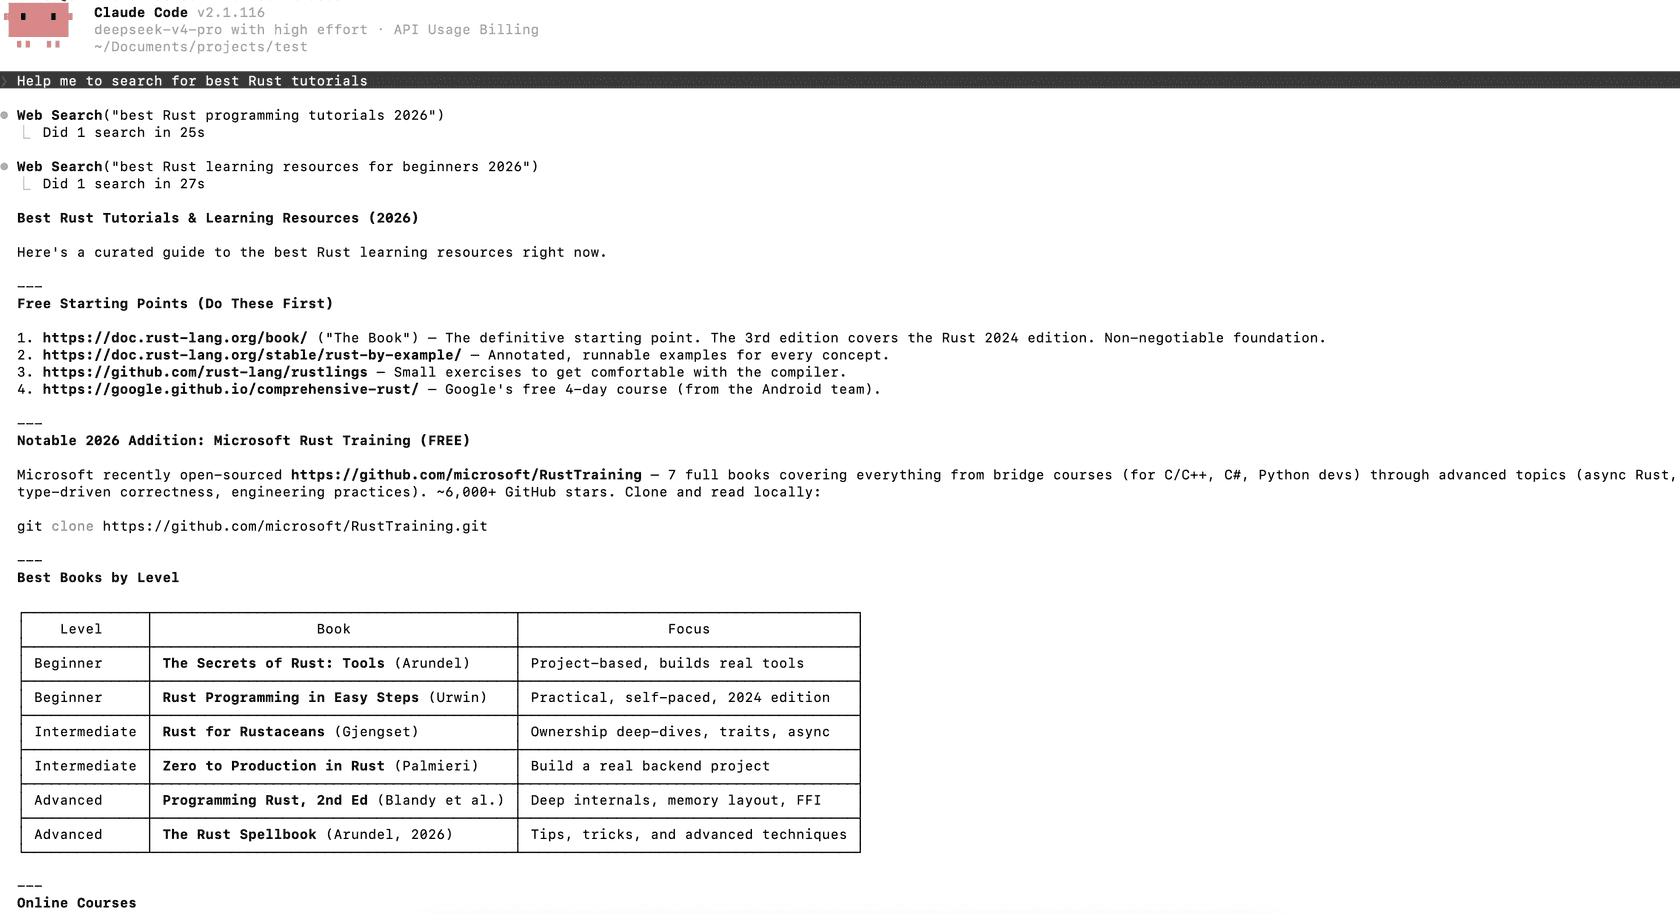
Nach dem 1. November kosten diese zwei Suchen $0.0015. Die Integrationsseite für Claude Code sagt offen, dass die Suchgebühr nicht die ganze Rechnung ist: Der Aufruf des Werkzeugs "generates additional LLM API requests to summarize the retrieved search content, additional model token costs will be incurred."
Welches Modell serverseitig suchen kann, hängt außerdem von der Oberfläche ab:
| Oberfläche | Serverseitige Suche | Modellbeschränkung |
|---|---|---|
Responses API web_search-Werkzeug | Ja | Nur deepseek-v4-pro, bei deepseek-flash ignoriert |
| Codex | Ja, mit web_search = "live" | Nur deepseek-v4-pro |
| Claude Code | Ja, native Web Search | Keine Modellbeschränkung angegeben |
| Anthropic-Format-API | server_tool_use und web_search_tool_result unterstützt | Nicht angegeben |
| Chat Completions | Kein eingebautes Suchwerkzeug | Standalone-API verwenden |
Läuft Ihr Agent also über die Responses API auf Flash, wird das eingebaute Werkzeug stillschweigend ignoriert. Sie rufen dann die Standalone-Search-API selbst auf und geben die Ergebnisse als Werkzeugausgabe zurück, was bei den Token ohnehin günstiger ist.
Was kostet eine Agenten-Aufgabe wirklich?
Ein Reddit-Nutzer hat die echte Frage besser gestellt, als ich es könnte:
"At $0.75 per 1000 requests, I want to know how many calls an agent makes in the background. Has anyone calculated the cost for typical research task?"

Hier meine Rechnung. Nehmen wir eine Recherche-Aufgabe, bei der der Agent 20 Suchen ausführt und 10 Seiten öffnet. Das sind 30 abrechenbare Aufrufe, also $0.0225 an Gebühren.
Nun die Lesekosten. Laut Leitfaden umfasst jede summary "typically 600 to 800 characters", grob 200 Token, 10 Ergebnisse sind also etwa 2.000 Token pro Suche. Für jede abgerufene Seite habe ich 5.000 Token angenommen. Das summiert sich auf rund 90.000 Eingabe-Token. Zu DeepSeeks Cache-Miss-Preisen außerhalb der Spitzenzeit von $0.15 pro Million bei Flash und $0.66 bei V4 Pro:
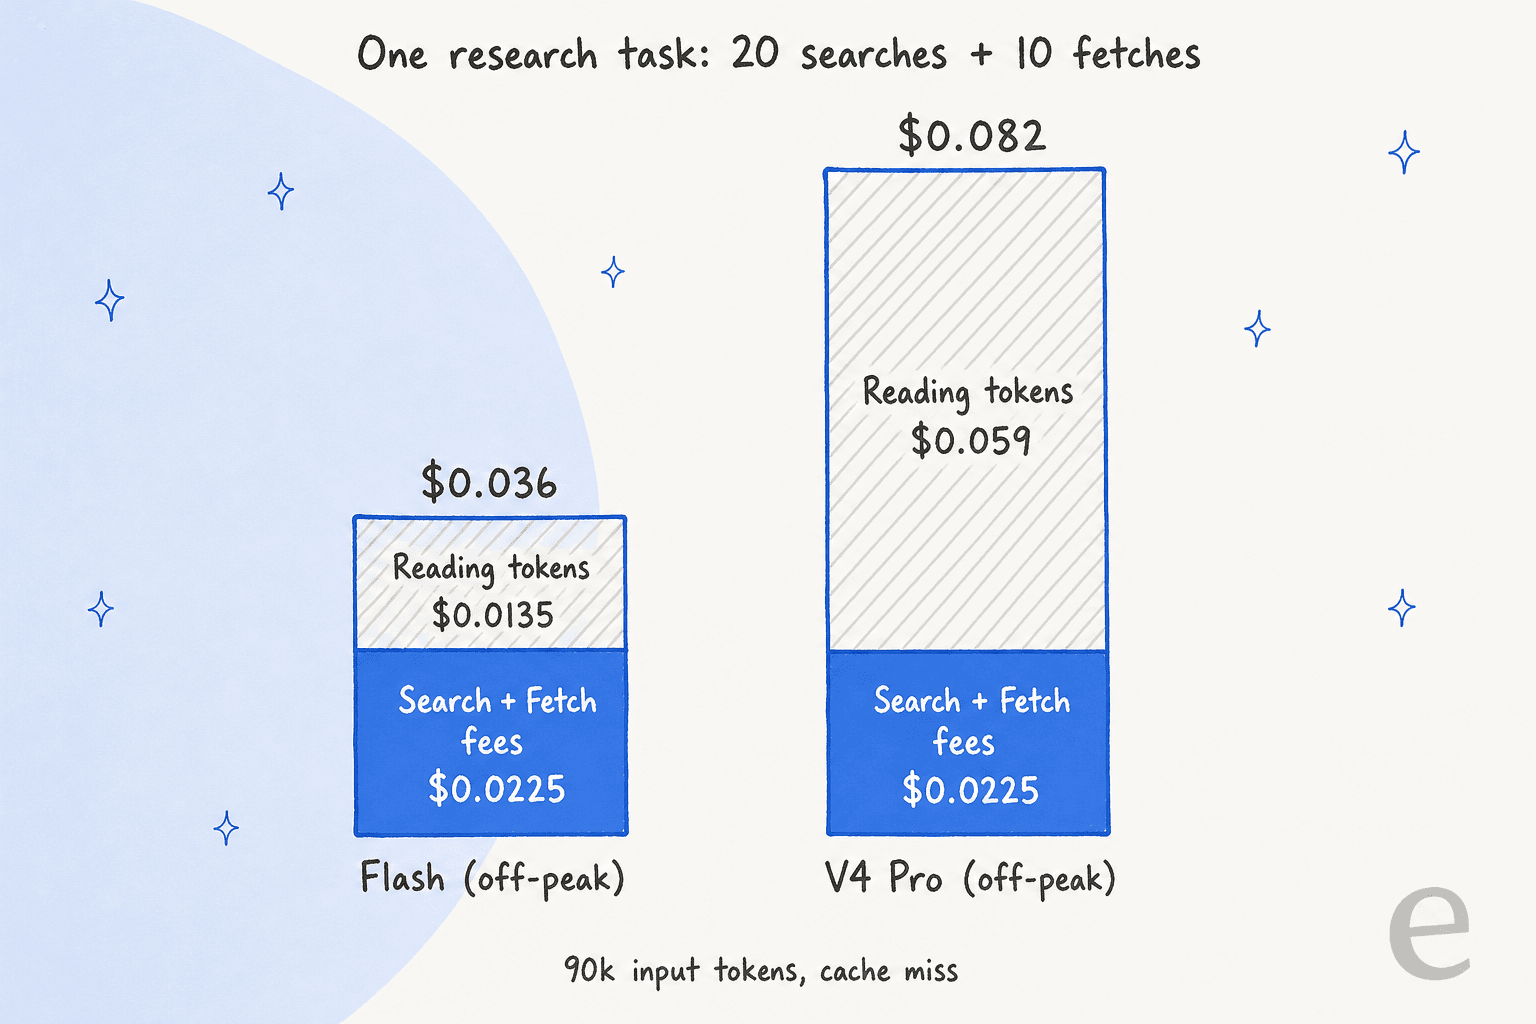
Das ist die Erkenntnis, die man mitnehmen sollte. Bei den meisten Suchwerkzeugen ist die Gebühr pro Aufruf der kleine Teil, und die Modell-Token dominieren. Bei Flash kehrt sich das um: Die Suchgebühren machen etwa 60 % der Recherchekosten der Aufgabe aus, weil Flash-Eingabe-Token so günstig sind. Bei V4 Pro übernehmen die Token wieder. In den Spitzenzeiten (werktags 01:00 bis 04:00 und 06:00 bis 10:00 UTC) verdoppelt sich der Token-Anteil, während der Gebührenanteil gleich bleibt.
Ausgabe-Token und das Reasoning des Modells sind in diesen Zahlen nicht enthalten, und bei Agentenarbeit sind sie oft der größte Posten. Meine Aufschlüsselung der DeepSeek-V4.1-Flash-Preise behandelt diese Seite.
Wenn Sie die Agentenschleife selbst bauen, statt sich auf Claude Code zu stützen, behandelt mein Leitfaden zur DeepSeek-V4-Flash-API Tool Calls und das Setup der Responses API, und Claude Codes MCP-Werkzeuge sind der andere verbreitete Weg, einem Agenten ein Suchwerkzeug zu geben.
Wie schneidet sie im Vergleich mit anderen Such-APIs ab?
Ich habe alle Preise unten am selben Tag von der jeweiligen Preisseite des Anbieters übernommen. Die Abrechnungseinheiten unterscheiden sich, die Spalte "pro 1.000" bezeichnet daher die Standardsuche jedes Anbieters.
| Such-API | Abrechnungseinheit | Pro 1.000 Suchen | Modell-Token extra? | Freikontingent | Rate Limit |
|---|---|---|---|---|---|
| DeepSeek Search | Erfolgreiche Anfrage mit Ergebnissen | $0.75 | Nur das kombinierte Modell | Keines angegeben | 5 QPS |
| Perplexity Fast Search | Erfolgreiche Anfrage (bis zu 5 Abfragen) | $1.00 | Nein | Keines angegeben | 50 Einheiten/s |
| Firecrawl Scale | Credits (2 pro 10 Ergebnisse) | $1.20 (erfordert $599/Monat jährlich) | Nein | 500 Suchen/Monat | 10.000/Min. |
| Exa Instant | Anfrage, bis zu 10 Ergebnisse | $4.00 | Nein | $10/Monat Guthaben | 10 bis 25 QPS |
| Brave Search API | Anfrage | $5.00 | Nein | $5/Monat Guthaben | 50 Anfr./s |
| Perplexity Search | Erfolgreiche Anfrage | $5.00 | Nein | Keines angegeben | 50 Einheiten/s |
| Tavily | Credit (Basissuche = 1) | $8.00 Pay-as-you-go | Nein | 1.000 Credits/Monat | 1.000 RPM |
| OpenAI Web-Search-Werkzeug | Werkzeugaufruf | $10.00 | Ja | Keines angegeben | Modell-Limits |
| Anthropic Web-Search-Werkzeug | Durchgeführte Suche | $10.00 | Ja | Keines angegeben | Pro Organisation |
| Gemini Grounding (Gemini 3+) | Suchabfrage | $14.00 | Nur Modell-Token | 5.000/Monat | Modell-Limits |
Rechnet man das auf ein Produkt mit 100.000 Suchen im Monat hoch, ist der Abstand kaum zu übersehen:
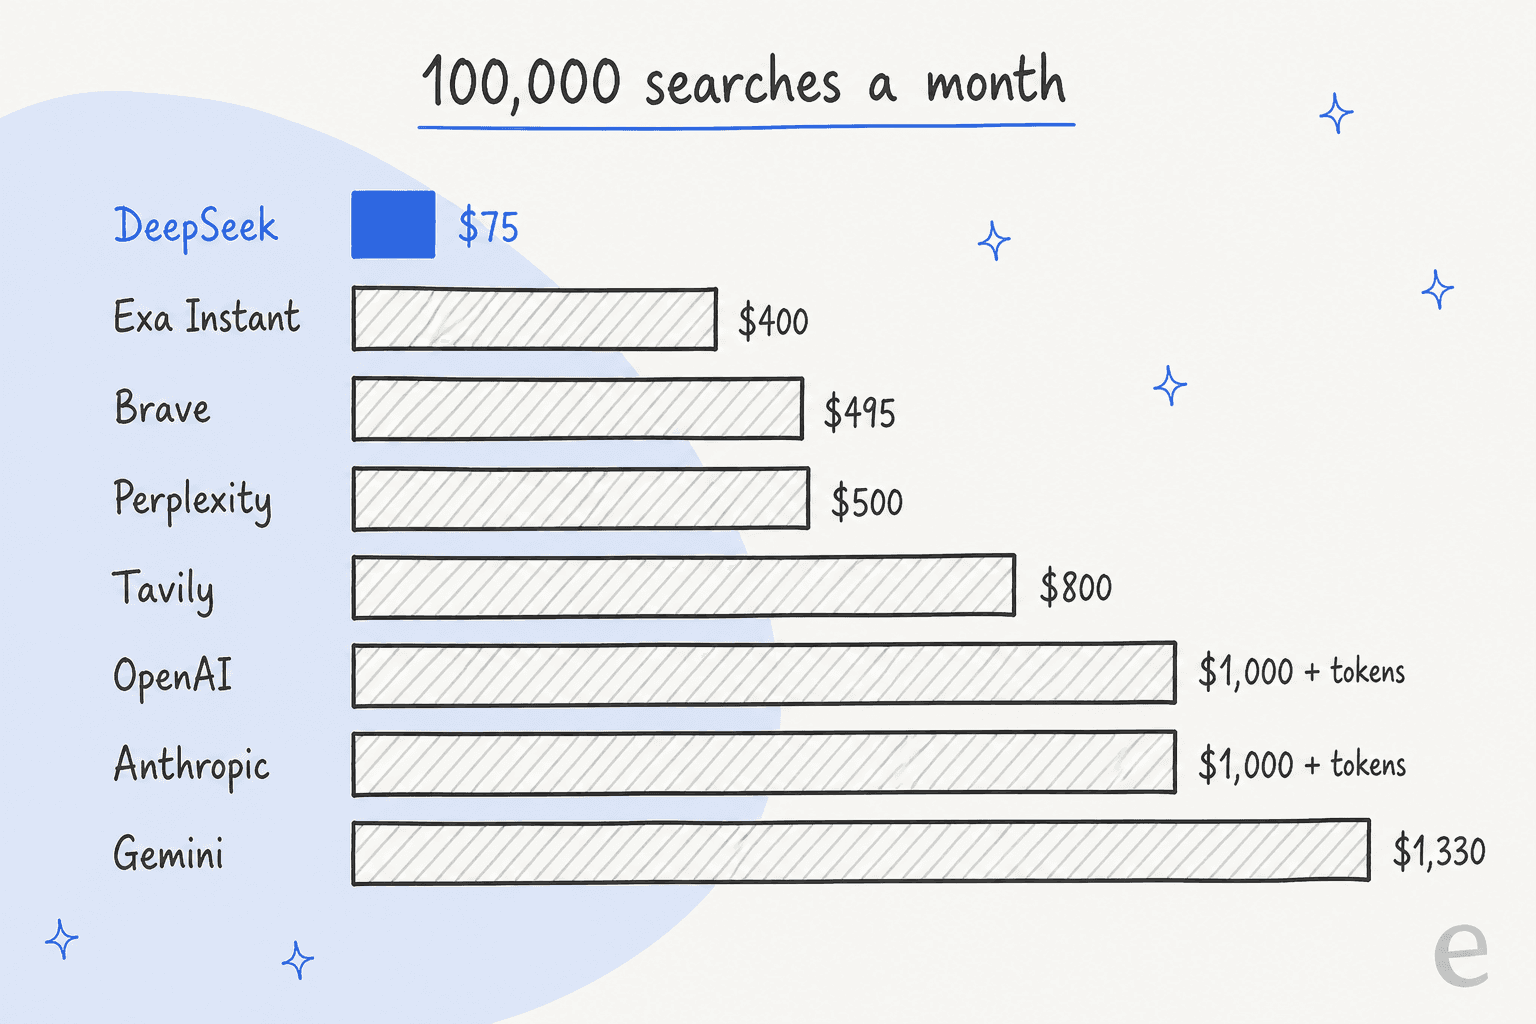
Bei Brave ist das monatliche Guthaben von $5 abgezogen, bei Gemini die 5.000 kostenlosen Suchen. Auch dann liegt DeepSeek bei etwa 1/7 von Brave und 1/18 von Gemini. Kommentatoren im Launch-Thread haben es mit den Werkzeugen verglichen, die sie schon bezahlen:
"For comparison that's $5 with Brave Search API and $12 with Kagi API"

Ein anderer Entwickler, der bereits einen eigenen Such-Stack gebaut hatte, beschrieb den Abstand zu den eingebauten Werkzeugen der Modellanbieter so:
"About a year ago I built my own search and fetch MCP tools for agents based on third-party scraping providers. It is about 15-20x more cost-effective than what OpenAI and Anthropic is offering with their integrated web search and fetch tools. Very impressive that DeepSeek has such a competitive offering today."
Wo der niedrigere Preis nicht gewinnt:
- Durchsatz. 5 QPS ist das niedrigste angegebene Limit in dieser Liste. Brave erlaubt 50 pro Sekunde, Exa bis zu 25 bei Pay-as-you-go und Tavily 1.000 pro Minute bei Produktionsschlüsseln.
- Datenverarbeitung. Brave verkauft Zero Data Retention als Teil seiner Architektur, Exa und Firecrawl bieten sie im Enterprise-Tarif an. In DeepSeeks Search-Dokumentation steht nichts zur Aufbewahrung, und die Datenschutzerklärung besagt, dass personenbezogene Daten in der Volksrepublik China gespeichert werden können. Bei regulierten Daten sollten Sie das lesen, bevor Sie die API einbinden.
- Gratis-Kontingent zum Prototyping. Tavily, Exa, Brave und Firecrawl bieten alle ein monatliches Kontingent ohne Karte. Bei DeepSeek zahlen Sie ab dem ersten erfolgreichen Aufruf, wobei ein Dollar Guthaben für etwa 1.333 Suchen reicht.
Wenn Sie sich nicht auf einen Anbieter festlegen möchten, leitet Cloudflares Web-Search-API an mehrere Anbieter mit großer Preisspanne weiter. Für die Scraping-Seite des Stacks lohnen sich außerdem Firecrawl-Alternativen und Perplexity-Alternativen.
Ihre eigene Rechnung schätzen
Tragen Sie Ihr monatliches Volumen und das Modell ein, das Sie damit kombinieren. Die Standardwerte entsprechen dem Rechenbeispiel oben: 2.000 Token zum Lesen einer Suche und 5.000 zum Lesen einer abgerufenen Seite.
Die Vergleichsspalte zeigt nur Suchgebühren, weil die Fetch- und Inhaltspreise der anderen Anbieter anders funktionieren (Exa berechnet Contents pro Seite, Anthropics Web Fetch kostet keine Gebühr, Tavily rechnet Extract in Credits ab).
Wo wird das Rate Limit zum Problem?
5 Anfragen pro Sekunde klingt unproblematisch, bis man multipliziert. Das ergibt 432,000 Suchen pro Tag und Konto, oder grob 13 Millionen im Monat bei perfekt gleichmäßigem Verkehr. Ausgabenseitig deckelt das ein Konto bei etwa $324 pro Tag für Search.
Der Leitfaden beschreibt genau, wie das Limit funktioniert:
- Es gilt pro Konto, nicht pro API-Schlüssel, zusätzliche Schlüssel helfen also nicht.
- Search und Fetch haben getrennte Budgets von je 5 QPS, der Verkehr der einen API verbraucht das Budget der anderen nicht.
- Fetch hat zusätzlich ein Limit pro Domain, ein Agent, der eine einzelne Website bombardiert, bekommt also HTTP 429, bevor das Kontolimit greift.
- Das Search-Limit ist unabhängig von der Modell-Parallelität (
2,500bei Flash,500bei V4 Pro).
Für einen einzelnen Entwickler oder einen Batch-Job reichen 5 QPS locker. Wenn Sie andere günstige Modell-APIs zur Kombination abwägen, sind Kimi K3 Preise und Qwen 3.8 Max Preise die engsten Konkurrenten. Bei einem kundennahen Produkt, in dem 30 Personen in derselben Sekunde Fragen stellen, ist es die erste Wand, an die Sie stoßen. Der Verkehr kommt in Schüben, planen Sie also nach Spitzen, nicht nach Durchschnitten. Eine Warteschlange mit Retry bei 429 ist das Minimum. Die Dokumentation rät, bei 408, 429 und 5xx zu warten und es erneut zu versuchen, und andere 4xx-Fehler nicht zu wiederholen, ohne die Anfrage zu ändern.
Wie halten Sie die Rechnung niedrig?
Da DeepSeek pro erfolgreichem Aufruf abrechnet und nicht pro Ergebnis oder Token, ändern sich die üblichen Spartricks. Was ich tun würde:
- Mehr Ergebnisse anfordern, dafür seltener. Setzen Sie
countbei der ersten Suche auf 20 oder 50, statt drei enge Suchen auszuführen. Gleicher Preis, weniger Aufrufe. need_contentnutzen, bevor Sie zu Fetch greifen. Wenn der Suchinhalt genügt, sparen Sie einen Fetch für$0.00075und eine zweite Runde.- Abfrageoperatoren nutzen.
site:,-site:,lang:,after:und exakte Phrasen werden unverändert durchgereicht. Eine präzise Abfrage ohne Treffer ist kostenlos, eine vage, die Müll liefert, wird berechnet. - Vor dem Lesen durch das Modell nach
rerank_scoreundauthorityfiltern. DeepSeek bezeichnet einenrerank_scoreab 1,5 als hochwertig und eineauthorityab 3 als sehr autoritativ. Schwache Ergebnisse auszusortieren, bevor sie das Modell erreichen, senkt den Token-Anteil der Rechnung. ori_questionsenden. Es gibt die ursprüngliche Frage des Nutzers weiter und verbessert das Abfrageverständnis, sodass der Agent weniger Folgesuchen braucht.- Batch-Jobs in Nebenzeiten legen. Die Suchgebühr ändert sich nicht, aber das Modell, das die Ergebnisse liest, kostet außerhalb der Spitzenzeiten die Hälfte.
Wenn Sie Claude Code über DeepSeek leiten, prüfen Sie auch Ihre Modellauswahl und bedenken Sie, dass die DeepSeek-Rechnung Ihre übliche Claude-Code-Preisgestaltung ersetzt, statt sie zu ergänzen. DeepSeek ordnet claude-opus-Modellnamen V4 Pro zu und claude-sonnet sowie claude-haiku Flash, dieselbe Suche kann also je nach gesendetem Namen in Ihrer Konfiguration etwa 4x mehr im Lesen kosten.
Lohnt es sich für Support oder RAG?
Für Entwickler, die einen der besten KI-Agenten für Recherche oder Coding bauen: ja. Bei diesem Preis ist Websuche kein Posten mehr, den man rationiert, und sie macht DeepSeek Harness und Codex auf DeepSeek günstiger im Betrieb als dieselbe Schleife auf GPT-5.6. Kombiniert mit Flash kostet eine typische Recherche-Aufgabe ein paar Cent.
Beim Kundensupport würde ich vor dem Einbau innehalten. Nach meiner Erfahrung beantwortet Ihr eigenes Help Center, Ihre Makros und frühere Tickets die meisten Support-Fragen, nicht das offene Web. Eine Web-Such-API ist das richtige Werkzeug für "Was bedeutet der Tracking-Status dieses Versanddienstleisters" und das falsche für "Wie lautet unsere Erstattungsrichtlinie". Die zweite Frage gehört in Retrieval über Ihre eigenen Inhalte, und dort gehen Support-Bots tatsächlich schief. Ein günstiger Suchaufruf repariert keinen Agenten, der selbstsicher einen Blogbeitrag statt Ihrer tatsächlichen Richtlinie herauszieht, weshalb Hybrid Search über Ihre eigenen Dokumente hier wichtiger ist als Reichweite im Web.
Dort liegt auch der größte Teil der Kosten. Die API-Rechnung für einen Support-Bot ist klein neben dem Zeitaufwand für die Retrieval-Pipeline, die Anbindung der Helpdesk-API, das Schreiben von Eskalationsregeln und das Testen, bevor Kunden den Bot sehen. Wohin dieses Geld fließt, habe ich in KI-Kundenservice-Kosten aufgeschlüsselt.
Ein Support-Teammitglied statt einer Such-Pipeline
Die DeepSeek Search API ist Infrastruktur, und zwar sehr preiswerte. eesel ist der Mitarbeiter. Das KI-Helpdesk-Teammitglied bindet sich in Zendesk, Freshdesk, Gorgias und weitere ein, lernt aus Ihrem Help Center und früheren Tickets und entwirft oder sendet Antworten direkt in der Warteschlange, in der Sie ohnehin arbeiten. Bevor es ein Live-Ticket anfasst, können Sie es gegen Ihre historischen Tickets laufen lassen und sehen, was es geantwortet hätte. Diesen Schritt würde ich nie überspringen, nachdem ich gesehen habe, wie ein selbstsicherer Bot in einer echten Warteschlange eine falsche Antwort gab.

Wenn Sie zu den Teams gehören, die API-Preisseiten zum Vergnügen lesen, wird Ihnen die eesel CLI vertraut vorkommen. Sie bringt dasselbe Teammitglied in Ihr Terminal: eesel init chat-bubble --site https://your-site.com erstellt einen Agenten, der Ihre Website zu lesen beginnt, eesel files upload fügt ein Richtliniendokument hinzu, eesel integrations connect zendesk verbindet den Helpdesk, und eesel approvals listet Aktionen auf, die auf einen Menschen warten. Jeder Befehl gibt JSON aus, sodass Claude Code oder Codex das gesamte Setup für Sie ausführen kann, und jeder Workspace ist zugleich ein MCP-Server. Alles, was Sie im Terminal einrichten, erscheint im Dashboard, weil es derselbe Agent ist.
Sie können eesel testen, ohne eine Karte zu hinterlegen. Das ist der schnellere Weg, wenn Sie beantwortete Tickets brauchen und keine Such-Pipeline.
Häufig gestellte Fragen
Was kostet die DeepSeek Search API?
$0.75 pro 1.000 erfolgreiche Anfragen, die Fetch API kostet dasselbe. Für den Aufruf selbst fallen keine Token-Kosten an, aber das DeepSeek-Modell, das die Ergebnisse liest, rechnet Token zum normalen Tarif ab.Ist die DeepSeek Search API kostenlos?
$0.75 pro 1.000.Berechnet DeepSeek fehlgeschlagene oder leere Suchen?
Ändert der Parameter count die Preise der DeepSeek Search API?
count kann zwischen 1 und 50 Ergebnissen liegen, der Preis pro Anfrage bleibt gleich. Auch need_content (Seitentext direkt in den Suchergebnissen) ist enthalten, sodass eine Suche manchmal eine Suche plus mehrere Fetches ersetzt.Wie schneiden die DeepSeek-Search-API-Preise gegenüber Brave, Exa und Tavily ab?
$0.75 pro 1.000 Suchen, gegenüber $5 bei Brave, $4 bei Exa Instant und $8 bei Tavily Pay-as-you-go. Der Haken ist das Kontolimit von 5 QPS, weit unter dem von Firecrawl oder Brave in bezahlten Tarifen.