

Das Ein-Minuten-Fazit
Ich bringe seit einigen Jahren KI in Live-Support-Warteschlangen, daher lese ich jeden Modellstart gleich: nicht „ist der Benchmark hübsch“, sondern „könnte ich dem morgen einen echten Job übergeben“. Bei diesem Test ist Step 5 eine starke Preview und ein schwacher Kauf, und die Lücke zwischen beiden ist der ganze Test.
Hier die Bewertungstabelle vor den Details.
| Was ich mir angesehen habe | Meine Einschätzung | Note |
|---|---|---|
| Preis-Intelligenz-Verhältnis | Bestwert im günstigeren Segment | 9/10 |
| Langer Kontext (1M) | Eine echte, nutzbare Stärke | 9/10 |
| Coding-Qualität | Auf Augenhöhe mit offenen Modellen, hinter der geschlossenen Spitze | 7/10 |
| Glaubwürdigkeit der Benchmarks | Selbst bewertet, kein Paper, ein selbstgebauter Test | 4/10 |
| Verfügbarkeit | Nur API, Gewichte noch nicht da | 5/10 |
| Bereit für einen echten Job | Es ist ein Motor, keine Fachkraft | 4/10 |
Wenn Sie nur einen Satz mitnehmen: Die Preisgeschichte ist legitim, die Benchmark-Geschichte braucht unabhängige Läufe, und „günstiges Modell“ und „fertiges Produkt“ sind nicht dasselbe Kaufobjekt.
Was StepFun Step 5 Preview eigentlich ist
StepFun (阶跃星辰) ist ein Labor aus Shanghai, das seit ein paar Jahren die „Step“-Familie für Text, Bild und Audio veröffentlicht, mit einem soliden Open-Weights-Angebot auf Hugging Face. Step 5 Preview ist das neue Flaggschiff, auf der Produktseite beschrieben als Frontier-Modell „for complex work and agentic tasks“, mit starkem Schwerpunkt auf Softwareentwicklung und Finanzen.
Der Rahmen, auf den StepFun immer wieder zurückkommt, ist „advancing the Pareto frontier“, die Linie der bestmöglichen Kompromisse zwischen Intelligenz und Kosten. Das eigene Launch-Diagramm sagt es klar: bei der Intelligenz mit dem günstigeren offenen Segment gleichziehen, bei den Kosten es unterbieten.
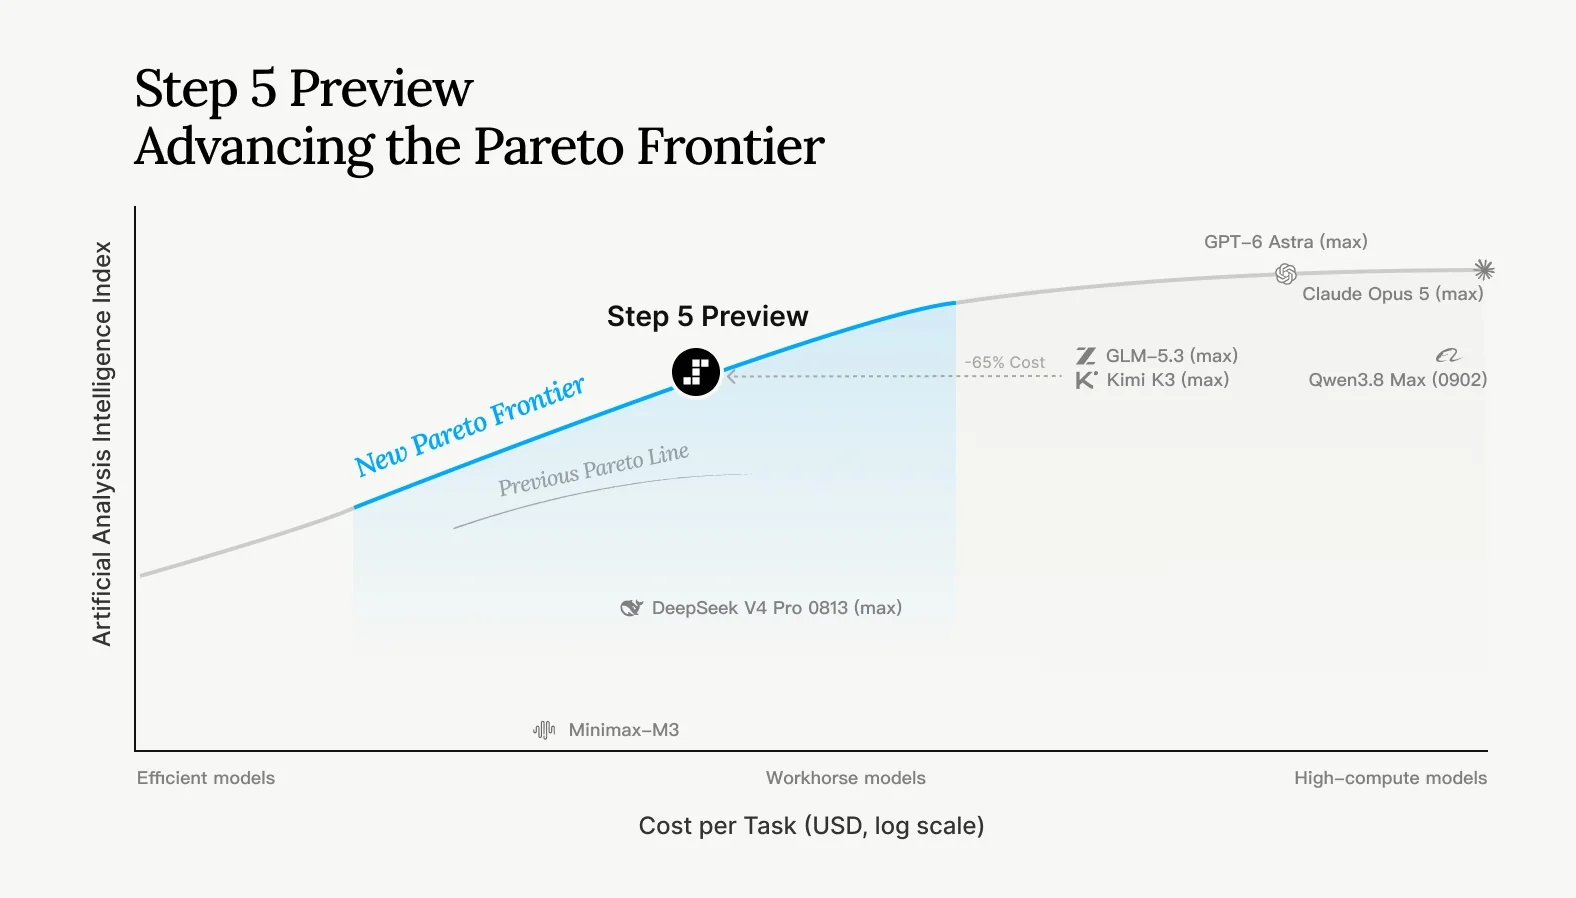
Beachten Sie die in diesem Diagramm steckende Aussage: 65 % niedrigere Kosten als GLM-5.3 und Kimi K3 bei vergleichbarem Intelligenzniveau. Es ist ein Herstellerdiagramm, also lese ich es als Pitch und nicht als Urteil, aber der Pitch ist zumindest schlüssig.
Die Architektur: 600B gesamt, 27B aktiv
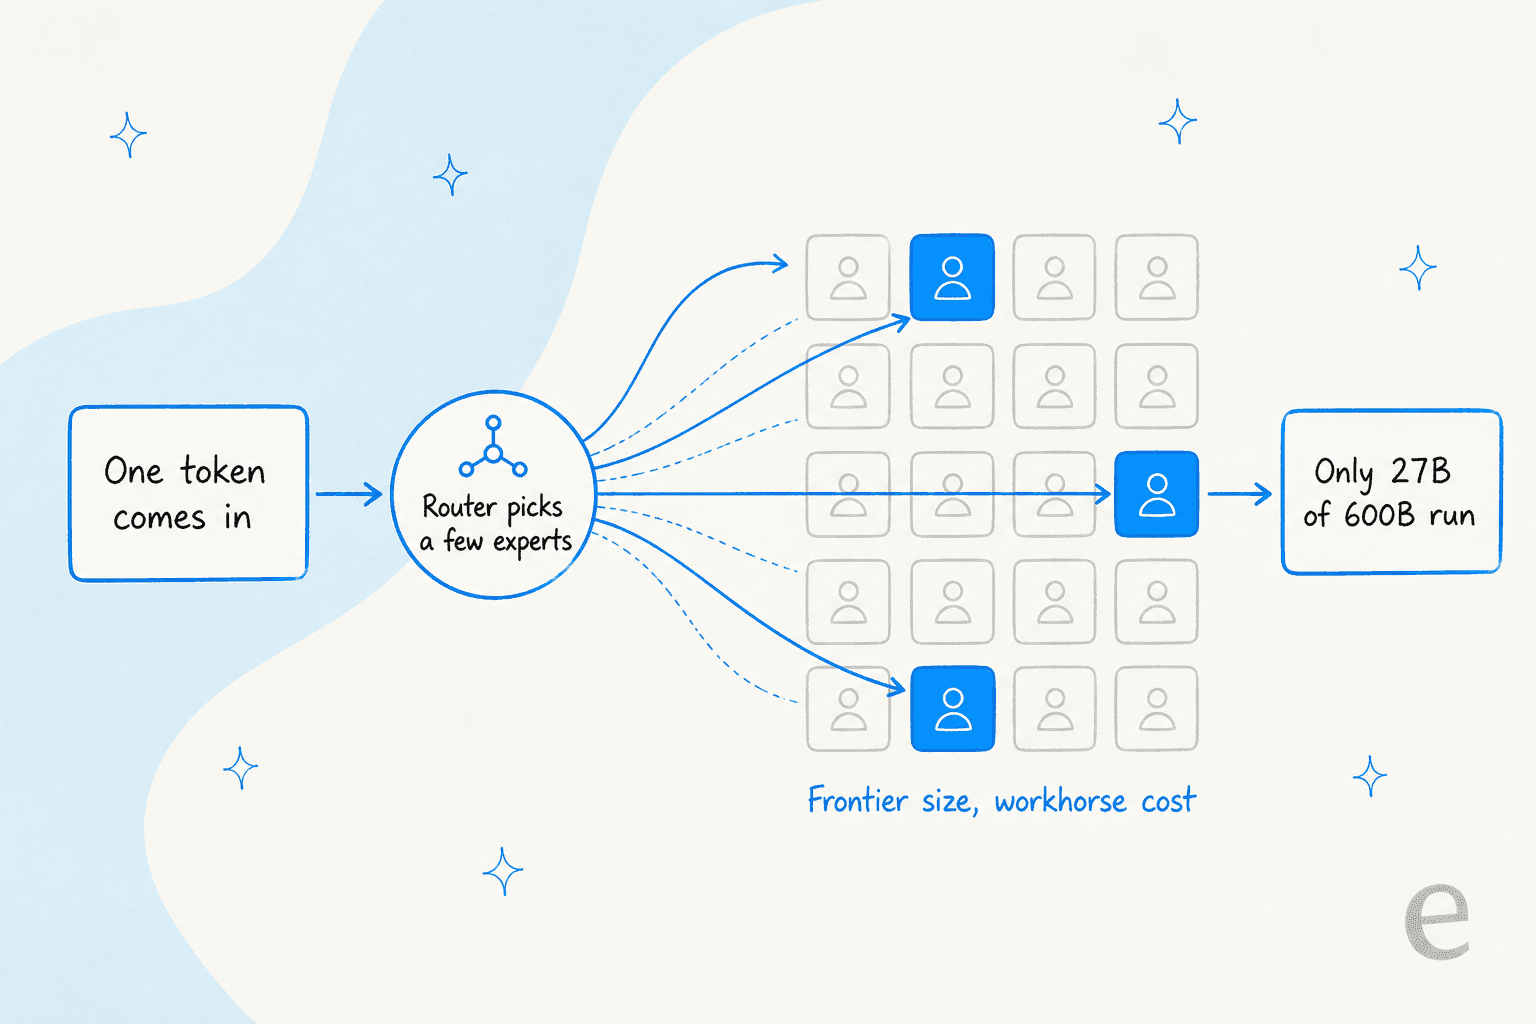
Die Kernzahl, auf die sich alle stürzten, ist die Form des Modells: 600B Gesamtparameter, 27B aktiv pro Token, laut Produktseite. Das ist ein spärliches Mixture-of-Experts-Design, und es ist die ganze Kostengeschichte in einer Zahl.
In einem dichten Modell läuft jeder Parameter für jedes Token. In einem Mixture-of-Experts-Modell wählt ein kleiner Router pro Token eine Handvoll „Experten“-Teilnetze aus, sodass nur ein Teil des Modells feuert. Step 5 hält frontier-große 600B im Speicher, aktiviert aber nur 27B auf einmal, weshalb StepFun es wie ein Mittelklassemodell bepreisen kann.
Nicht jeder glaubt, dass die Rechnung zugunsten von Step 5 aufgeht. Die Zahl der aktiven Parameter kam auf Hacker News schnell zur Sprache:
"600b-a27b doesn't sound enticing. Also with the higher number of active parameters compared to GLM 5.3 flash and DeepSeek V4/4.1 flash, I don't see how they want to be more efficient at inference."

Das ist eine berechtigte Frage. 27B aktiv ist mehr als bei manchen konkurrierenden „Flash“-Stufen, der Effizienzgewinn liegt also in der Intelligenz pro aktivem Parameter und nicht in der Zahl der aktiven Parameter allein. Genau das werden unabhängige Inferenz-Benchmarks klären, StepFuns eigene Diagramme nicht.
Es ist ein Reasoning-Modell mit einem reasoning_effort-Regler, einstellbar auf low, medium oder high. Höherer Aufwand bedeutet eine längere interne Denkspur, und da Output-Tokens inklusive dieser Spur abgerechnet werden, ist der Aufwand ein direkter Kostenregler. Merken Sie sich das, es zählt im Preisabschnitt.
Preise: der Teil, der mir wirklich gefallen hat
Die Preise sind das Leichteste an diesem Launch, was man mögen kann. Von der StepFun-Preisseite, pro 1 Mio. Tokens:
| Abrechnungseinheit | Input (Cache-Miss) | Input (Cache-Hit) | Output |
|---|---|---|---|
step-5-preview | 1,00 $ | 0,05 $ | 2,70 $ |
step-3.7-flash (zum Vergleich) | 0,20 $ | 0,04 $ | 1,15 $ |
Der 95-%-Rabatt bei Cache-Treffern auf den Input ist das Highlight, und er ist ein großer Vorteil für agentische Workloads, die bei jedem Schritt einen großen, größtenteils statischen System-Prompt erneut senden. Der Output für 2,70 $ deckt sowohl die Reasoning-Spur als auch die endgültige Antwort ab, ein gesprächiger Lauf mit hohem Aufwand kostet also echtes Geld.
Da sich diese Kosten aus Output plus Reasoning leicht unterschätzen lassen, hier ein schneller Rechner, in den Sie Ihre eigenen Zahlen eintragen können.
Es gibt außerdem eine kostenlose V0-Stufe zum Ausprobieren (5 Parallelzugriffe, 10 Anfragen pro Minute), wobei die Ratenlimits mit dem aufgeladenen Guthaben steigen. Beim reinen Preis pro Token ist das eines der besseren Angebote in der Klasse der Reasoning-Modelle. Es spielt im selben Budgetbereich wie DeepSeek V4 Flash und nicht im Premiumsegment, und unterbietet das meiste davon.
Benchmarks und der Vorbehalt, der diesen Test dominiert
StepFun hat einen vollständigen Vergleich mit offenen Konkurrenten (Kimi K3, GLM-5.3) und der geschlossenen Spitze (GPT-6 Astra, Claude Opus 5) veröffentlicht. Hier die Form davon, alle Zahlen stammen von StepFuns eigener Produktseite.
| Benchmark | Step 5 Preview | Kimi K3 | GLM-5.3 | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
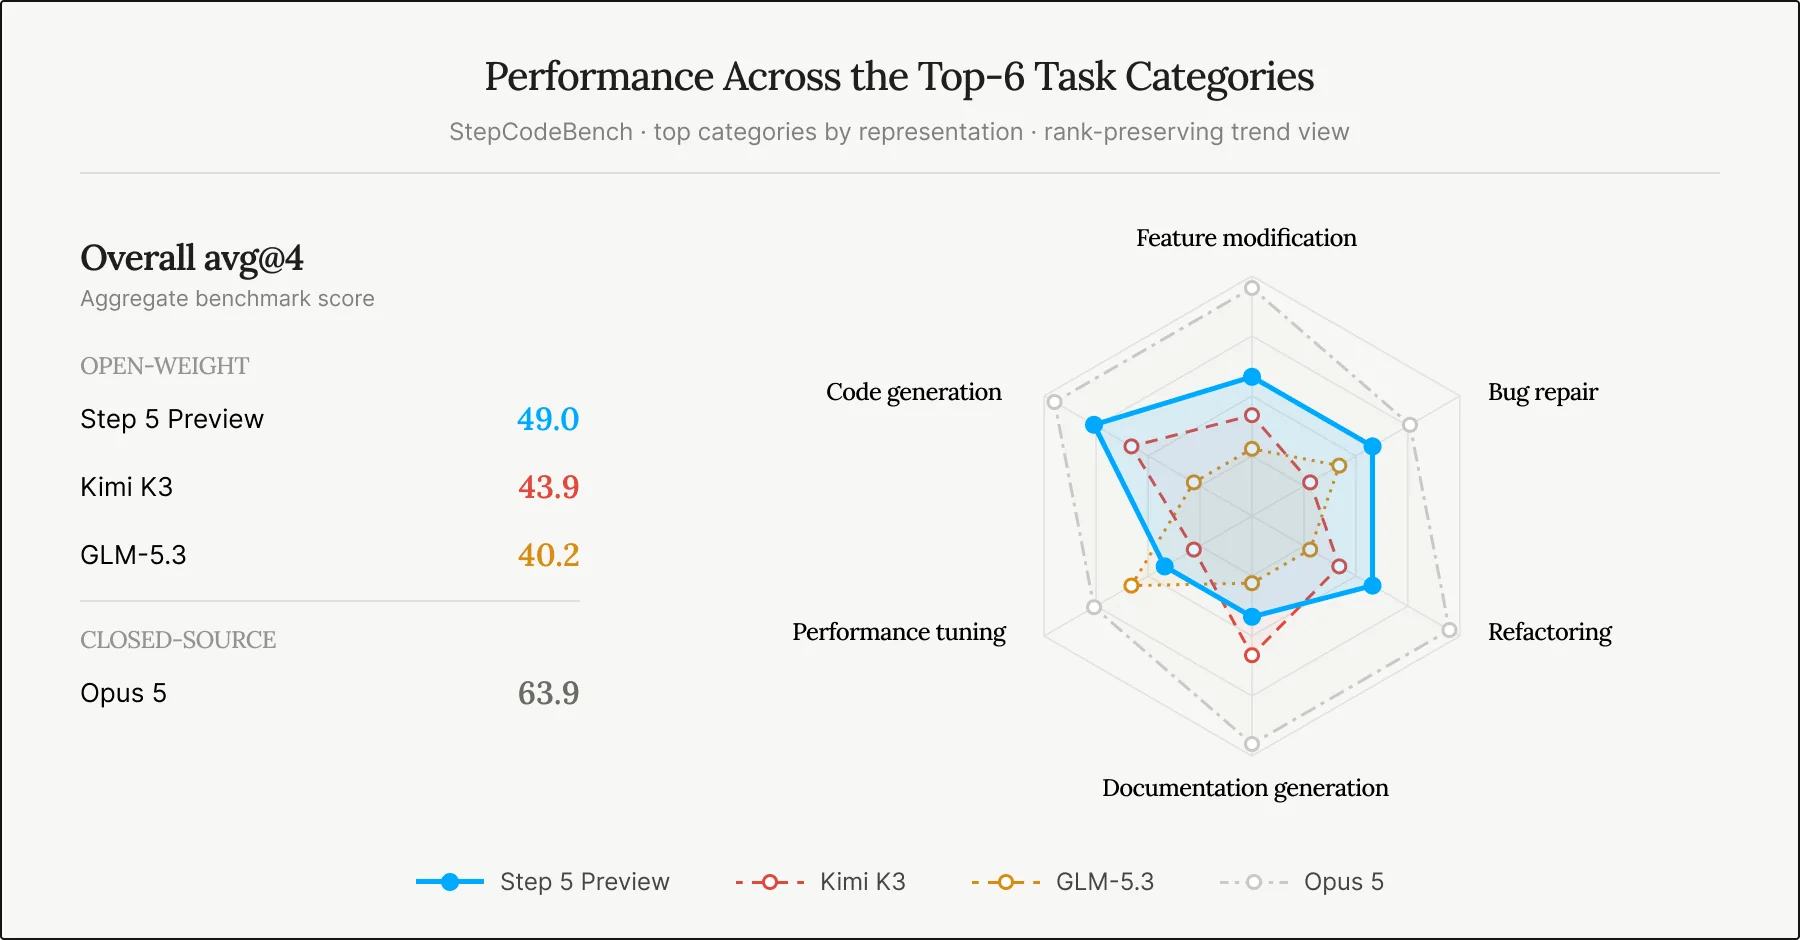
| StepCodeBench | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| FrontierFinance | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
Das Bild ist konsistent: Step 5 liegt auf Augenhöhe mit den anderen führenden offenen Modellen und hinter den besten geschlossenen Modellen bei der reinen Coding-Qualität, gewinnt aber bei den Kosten. Bei den harten Coding-Tests liegt es am weitesten hinter Claude Opus 5. Finanzen sind seine Paradedisziplin, wo es die offenen Konkurrenten übertrifft und GPT-6 Astra schlägt. Sein eigenes StepCodeBench-Radar erzählt gegenüber dem offenen Segment dieselbe Geschichte.
Nun der Vorbehalt, und er ist der Grund, warum meine Note für die Glaubwürdigkeit der Benchmarks eine 4 ist. Jede Zahl oben ist selbst berichtet, es gibt noch keinen technischen Bericht oder ein Paper, und StepCodeBench ist StepFuns eigener Benchmark (553 Repositories, 33 Sprachen). Ein Modell sieht in dem Test gut aus, den sein eigenes Team entworfen hat. Die Community hat die schwächeren Stellen schnell benannt, vor allem die Weitschweifigkeit:
"Based on the examples, it's like the thing took a writing class from Claude, but isn't quite as smart, kind of worst of both worlds. The 'Interactive Reporting' one is particularly terrible. A huge amount of waffly padding around a thesis that may or may not exist."
Und ein Kommentator bemerkte, wie sich das Launch-Demo selbst verriet, genau die Art von Sache, die mich vor jedem Vertrauen in ein Launch-Diagramm eigene Evaluierungen laufen lassen will:
"In their first demo video, to make a 3D render of the photo, the thinking trace gives away the game [...] I'm always astounded how little effort is put into checking the AI answers displayed in these announcements."
Nichts davon macht Step 5 zu einem schlechten Modell. Es macht es zu einem unbewiesenen, und das ist etwas anderes. Die richtige Reaktion ist, es an Ihrer eigenen Arbeitslast zu simulieren, statt dem Launch-Diagramm blind zu glauben, und dieser Instinkt gilt genauso dafür, wie Sie jeder KI im Kundensupport vertrauen sollten.
Wo es glänzt: langer Kontext und Finanzen
Zwei Stärken hielten bei allem, was ich gelesen habe, stand. Der Kontext von 1M Tokens ist die Spezifikation, auf die ich mich am stärksten stützen würde. Er reicht, um eine ganze Codebasis, ein Quartal an Support-Transkripten oder einen Stapel PDFs in einen einzigen Aufruf zu werfen und dokumentübergreifendes Schlussfolgern zu verlangen. Multimodal können Sie bis zu 60 Bilder pro Anfrage plus kurze Videos übergeben, die Ausgabe ist aber nur Text.
StepFun setzt auch stark auf die Coding-Geschichte. Es behauptet, Step 5 könne „from software engineering and visual applications to programmable hardware“ reichen, und dass in Expertenbewertungen etwa 70 % der Teilnehmer es für fähig hielten, Coding-Aufgaben mittlerer bis hoher Komplexität autonom zu lösen, laut Produktseite. Es gibt eine Claude-Code-Integration über „Step Plan“, die den vollen 1M-Kontext bereitstellt, ein kluger Ort, um Entwickler abzuholen. Das Finanzergebnis bei FrontierFinance ist der eine Benchmark, bei dem es das Feld klar anführt, geschlossene Modelle eingeschlossen.
Vor- und Nachteile
Den Test fasse ich in den beiden Listen zusammen, die ich tatsächlich nutze, wenn ich entscheide, ob ich etwas ausprobiere:
Was gut ist
- Bestes Preis-Intelligenz-Verhältnis im günstigeren Segment, bei 1,00 $ / 2,70 $ pro 1 Mio. Tokens.
- Ein echter Kontext von 1M Tokens, keine Marketingzahl, die in der Praxis bei 128k endet.
- 95 % Rabatt bei Cache-Treffern, der agentische Workloads mit wiederholten Prompts belohnt.
- Ehrliche Positionierung: Es sagt „das Beste im günstigeren Segment“, nicht „wir schlagen die Spitze“.
- Eine Open-Weights-Veröffentlichung auf der Roadmap, mit einem Apache-2.0-Präzedenzfall aus der Flash-Linie.
Was mich zögern lässt
- Jeder Benchmark ist selbst berichtet, ohne technischen Bericht und mit einem selbstgebauten Test.
- Die Community sieht ausschweifenden Output, der die Output-Token-Rechnung leise aufbläht.
- 27B aktiv ist mehr als bei manchen konkurrierenden Flash-Stufen, der Effizienzgewinn ist also ungeklärt.
- Heute nur per API; die Gewichte, die den „offenen“ Pitch interessant machen, sind noch nicht da.
- Es ist ein Rohmodell, die Arbeit, daraus ein Produkt zu machen, liegt also ganz bei Ihnen.
Für wen Step 5 gedacht ist und wer warten sollte
Hier lande ich. Wenn Sie ein Entwickler oder ein Labor sind, das ein leistungsfähiges, günstiges Modell mit langem Kontext als Grundlage sucht, besonders für Coding, Finanzen oder Recherche über große Dokumentmengen, ist Step 5 Preview einen echten Test wert. Die Geschichte vom Preis pro Intelligenz ist wirklich gut, und das Open-Weights-Versprechen macht es noch interessanter.
Wenn Sie auf ein gefestigtes, bewährtes Modell warten, warten Sie. Es ist eine Preview, die Benchmarks sind selbst bewertet, und die erste Einschätzung der Community lautet „vielversprechend, aber ausschweifend und unbewiesen“. Selbst ein wohlgesonnener Kommentator formulierte das Muster sanft:
"The previous Step models were pretty decent, but unfortunately for them, their model reasons too much and too long [...] Hopefully this doesn't reason too long to get to the answer. I welcome any open model, the more the merrier."
Ich rechne StepFun das hoch an, was die meisten Launches falsch machen: zu wissen, was sie sind:
"Their posisitoning is nice. Instead of saying they are cheaper and a bit less performant (in terms of intelligence), they say they are best among the cheaper and a bit less performant ones."
Wo ein Rohmodell endet und ein Teamkollege beginnt
Es gibt eine Sichtweise, der ich widersprechen möchte, und das ist nicht StepFuns Schuld, es gilt für jeden Modellstart. Ein Modell ist keine Lösung. Step 5 Preview ist ein Motor. Es gibt Ihnen eine API, eine Token-Rechnung und rohe Leistungsfähigkeit. Daraus etwas zu machen, das Ihre Kunden beantwortet, heißt: Sie bauen die App, binden Ihre Daten an, schreiben die Leitplanken und übernehmen die Wartung.
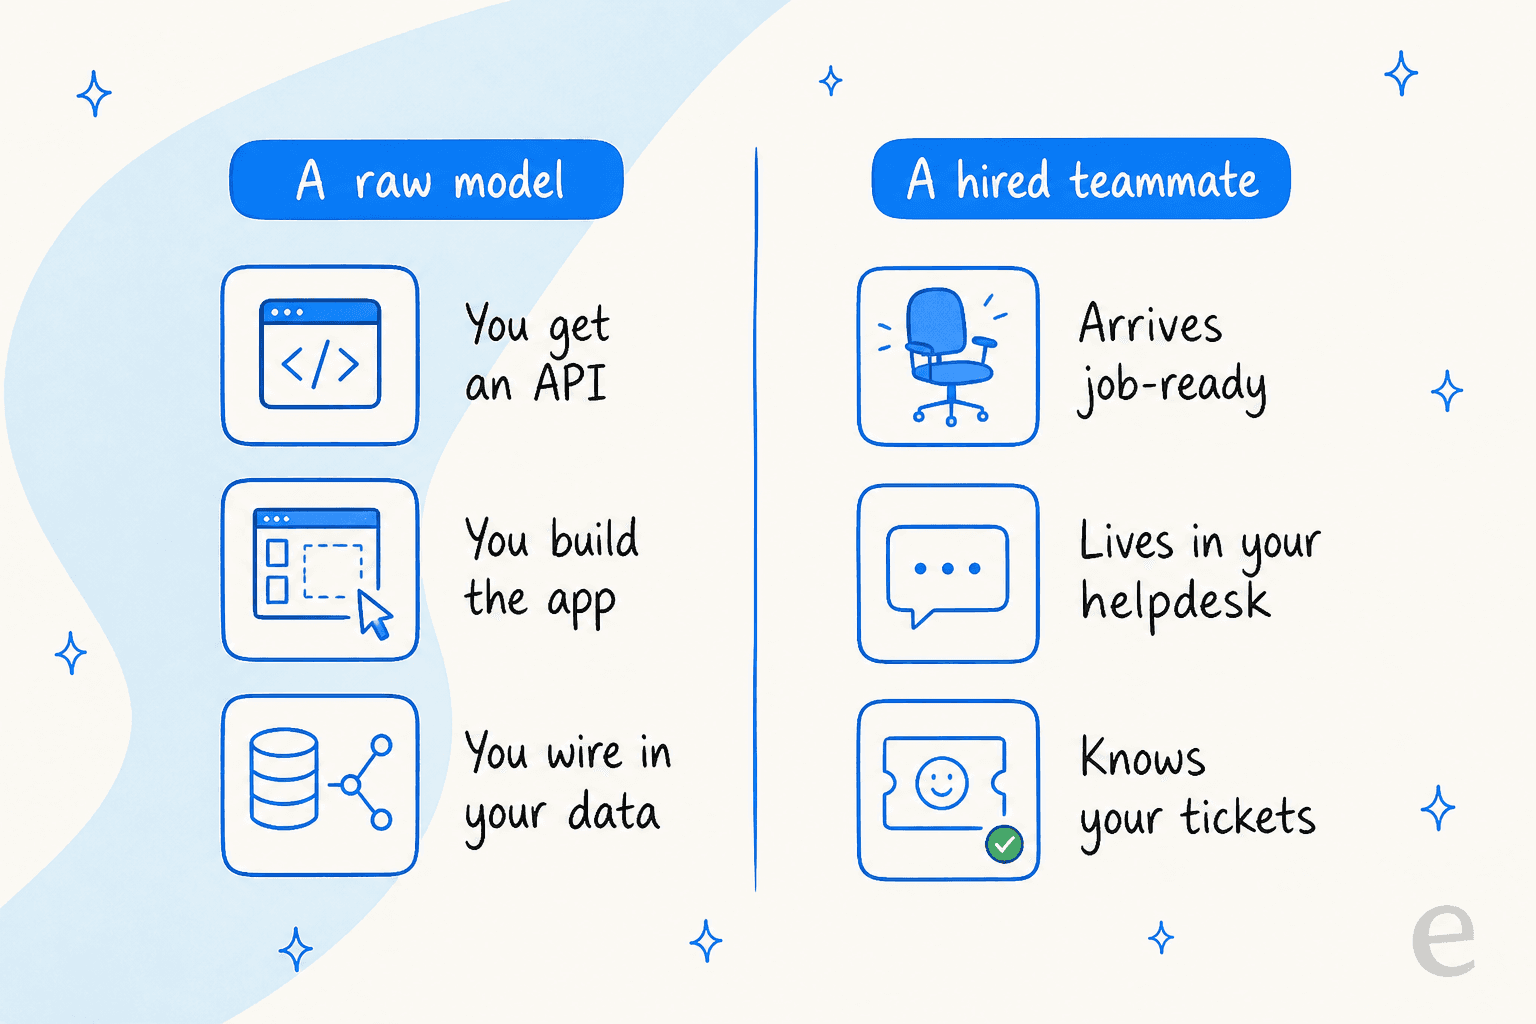
Diese Lücke ist der Grund, warum es eesel gibt. Statt eines Rohmodells stellen Sie einen einsatzbereiten Teamkollegen für eine bestimmte Aufgabe ein. Der KI-Helpdesk-Teamkollege zieht in Ihre bestehende Warteschlange ein, lernt aus Ihren vergangenen Tickets und Ihrem Help Center und entwirft oder sendet Antworten im Helpdesk, den Sie bereits nutzen, sei es Zendesk, Freshdesk oder Gorgias. Die Preisgestaltung ist ein Pauschalpreis pro gelöster Anfrage ohne Gebühr pro Arbeitsplatz, die Kosten orientieren sich also an erledigter Arbeit und nicht an verbrannten Tokens.

Der Teil, der mir angesichts des Problems selbst berichteter Benchmarks am wichtigsten ist: Sie können den Teamkollegen an Tausenden Ihrer eigenen vergangenen Tickets simulieren, bevor er je einen Live-Kunden berührt, und sehen so seine echte Lösungsquote bei Ihrer Arbeitslast statt dem Diagramm eines Herstellers. Und wenn Sie ihn lieber über ein Terminal als über ein Dashboard steuern, liefert eesel eine echte CLI und einen MCP-Server, sodass Coding-Agenten wie Claude Code denselben Teamkollegen direkt bedienen können. Neue Modelle wie Step 5 sind spannende Infrastruktur. Ein Teamkollege ist, was tatsächlich zur Schicht erscheint. Sie können eesel kostenlos testen.