

MiniCPM5-2B ist das neue offene 2B-Modell von OpenBMB und für seine Größe wirklich bemerkenswert. Es ist ein dichtes, rein textbasiertes Modell mit 2,52B Parametern, einem Kontextfenster von 128K und Apache-2.0-Gewichten, gebaut für den Einsatz auf dem Gerät: Smartphones, Laptops und Mini-PCs, nicht im Rechenzentrum. In der eigenen Testsuite von OpenBMB erreicht es im Schnitt 53,9 über 34 Benchmarks. Das bezeichnen sie als Open-Source-Bestwert der 2B-Klasse und, in ihrem eigenen Vergleichsfeld, als Vorsprung vor dem größeren Qwen3.5-4B (51,1).
Der Haken, den man vorab kennen sollte: Es ist rein textbasiert (keine Bildverarbeitung), die auffälligen Werte stammen vom Hersteller, und eine Kennzahl ist zwischen den Quellen widersprüchlich. Unabhängige Tracker setzen den Artificial Analysis Intelligence Index bei 15, dem höchsten Wert aller Open-Weight-Modelle mit 4B oder weniger; der eigene Launch-Beitrag von OpenBMB nennt 23. Beide sind unten aufgeführt.
Wenn Sie etwas entwickeln, ist MiniCPM5-2B eine großartige lokale Engine für Reasoning und Tool-Nutzung. Wenn Sie Kundentickets beantworten wollen, denken Sie daran: Das Modell ist nur der Motor. Ein funktionierender Support-Agent braucht obendrauf Ihr Unternehmenswissen, Integrationen, Leitplanken und Tests, also genau die Ebene, die eine Plattform wie eesel liefert.
Was MiniCPM5-2B tatsächlich ist
MiniCPM5-2B ist das zweite Modell der MiniCPM5-Reihe von OpenBMB (der Open-Model-Gruppe, die auch als ModelBest bekannt ist). Es erschien um den 6. bis 7. September 2026, nach MiniCPM5-1B im Mai. Das Versprechen ist eng gefasst und klar: ein kleines, dichtes Modell, das bei Reasoning, Coding und Tool-Nutzung gut genug ist, um nützlich zu sein, und klein genug, um dort zu laufen, wo die Daten ohnehin liegen.
Dieser Teil mit „wo die Daten liegen“ ist der interessante. Die meisten Modelle, über die Sie dieses Jahr lesen, sind Cloud-APIs, die Sie pro Token mieten. MiniCPM5-2B geht den anderen Weg: Sie laden die Gewichte herunter und betreiben sie auf einem Laptop, einem Smartphone oder einem Rockchip-Board in der Fabrikhalle. Die HuggingFace-Modellkarte beschreibt es als dichtes 2B-Modell „built for on-device, local deployment, and resource-constrained scenarios“, ausgerichtet auf „local assistants, coding agents, tool-use workflows, and reasoning scenarios where a compact model is preferred.“
Hier ist die Seite des Modells selbst, mit der Sie tatsächlich anfangen würden, wenn Sie es herunterladen wollten.
Eine ehrliche Einschränkung vorab: Dies ist ein rein textbasiertes Modell. Dieser Checkpoint enthält weder Bild- noch Audioverarbeitung, und Community-Tester stellen fest, dass es nur Englisch und Chinesisch beherrscht. Wenn Sie Multimodalität brauchen, hält OpenBMB diese in der separaten MiniCPM-V-Reihe bereit, und die Reaktion „hier keine Bildverarbeitung“ war eine der lautesten beim Launch (dazu unten mehr).
Die Spezifikationen, auf die es ankommt
Bei einem 2B-Modell liegen die Überraschungen im Datenblatt. Es nutzt eine schlichte LlamaForCausalLM-Architektur, bringt volle 128K Kontext mit und kommt unter einer wirklich freizügigen Lizenz.
| Feld | Wert |
|---|---|
| Gesamtparameter | 2.516.756.480 (~2,52B) |
| Parameter ohne Embeddings | 1.981.982.720 |
| Architektur | Standard-LlamaForCausalLM (keine eigenen Kernel) |
| Schichten | 42 |
| Attention | GQA, 16 Query-Heads, 2 KV-Heads |
| Kontextlänge | 131.072 Tokens (128K) |
| Modalität | Nur Text (Englisch / Chinesisch) |
| Lizenz | Apache-2.0 (Gewichte und Repo) |
| Tensor-Typ | BF16 (plus GGUF-, MLX-4bit-, GPTQ-4bit-Builds) |
Jede Zahl dort stammt aus dem Abschnitt „Model Information“ der Modellkarte. Zwei davon leisten mehr als der Rest.
Die erste ist die Standardarchitektur. OpenBMB hat MiniCPM5-2B bewusst auf schlichtem LlamaForCausalLM aufgebaut, damit, in ihren Worten, „mainstream inference engines can load it directly: no custom kernels, no model-code fork.“ Das klingt wie eine Fußnote, ist aber der Grund, warum die Day-0-Runtime-Unterstützung (unten) so breit ist. Ein Modell, das einen eigenen Kernel braucht, erscheint am Starttag für zwei Runtimes; ein Modell mit Standardarchitektur erscheint überall gleichzeitig.
Die zweite ist die Apache-2.0-Lizenz für Repo und Gewichte. Kommerzielle Nutzung ist erlaubt, und es gibt keine separate Community-Lizenz, die sie einschränkt, was nicht jeder „offene“ Release von sich sagen kann. Wenn Sie ein Produkt darauf aufbauen, zählt das mehr als ein oder zwei Benchmark-Punkte.
Es hat außerdem einen richtigen Deep-Reasoning-Modus: Das Transformers-Beispiel übergibt enable_thinking=True, und OpenBMB beziffert das Token-Budget einer Aufgabe auf etwa 21K Tokens (14K Denken plus 7K Antwort), mit empfohlenem Sampling von temperature=1.0, top_p=0.95.
Wie es abschneidet
Das ist die Schlagzeile, die MiniCPM5-2B bekannt gemacht hat: In der Evaluation von OpenBMB erreicht es im Schnitt 53,9 über 34 Benchmarks, was sie als Open-Source-Bestwert der 2B-Klasse darstellen und, in ihrem Vergleichsfeld, als Vorsprung vor dem besten Modell der 4B-Klasse, Qwen3.5-4B mit 51,1. Dass ein 2B-Modell ein 4B-Modell knapp schlägt, ist eine Behauptung, die einen zweiten Blick verdient.
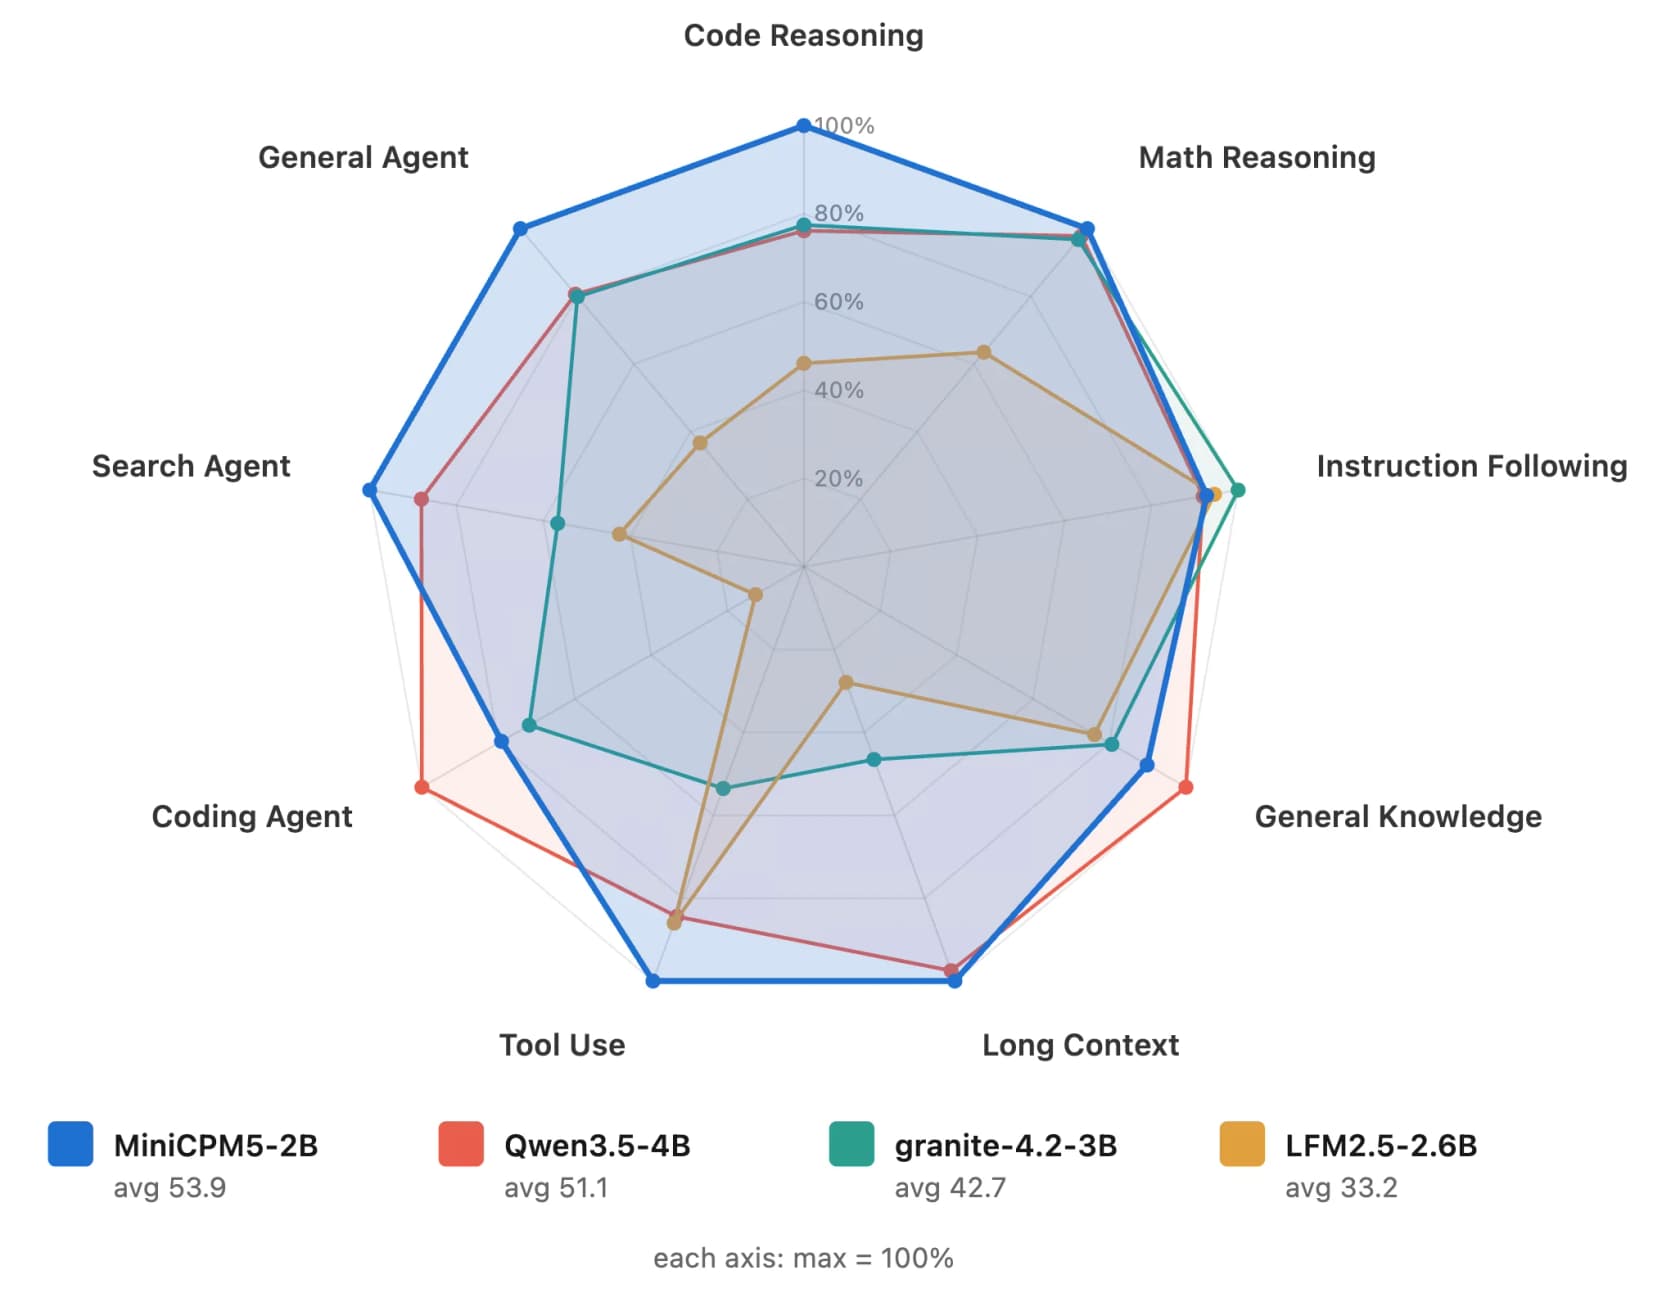
Das Radardiagramm zeigt, wo die Geschichte von Größe zu Leistung trägt und wo nicht. MiniCPM5-2B führt bei Agenten- und Suchaufgaben und bleibt bei Mathematik und langem Kontext konkurrenzfähig, während das 4B-Modell von Qwen bei reiner Coding-Agent-Arbeit weiterhin vorne liegt. Es ist ein zackiges Profil, kein gleichmäßiger Vorsprung, und so sollte man es ehrlicherweise lesen.
Die vollständige Tabelle lohnt einen langsamen Blick, denn „Durchschnitt 53,9“ verbirgt einige wirklich große Einzelwerte:
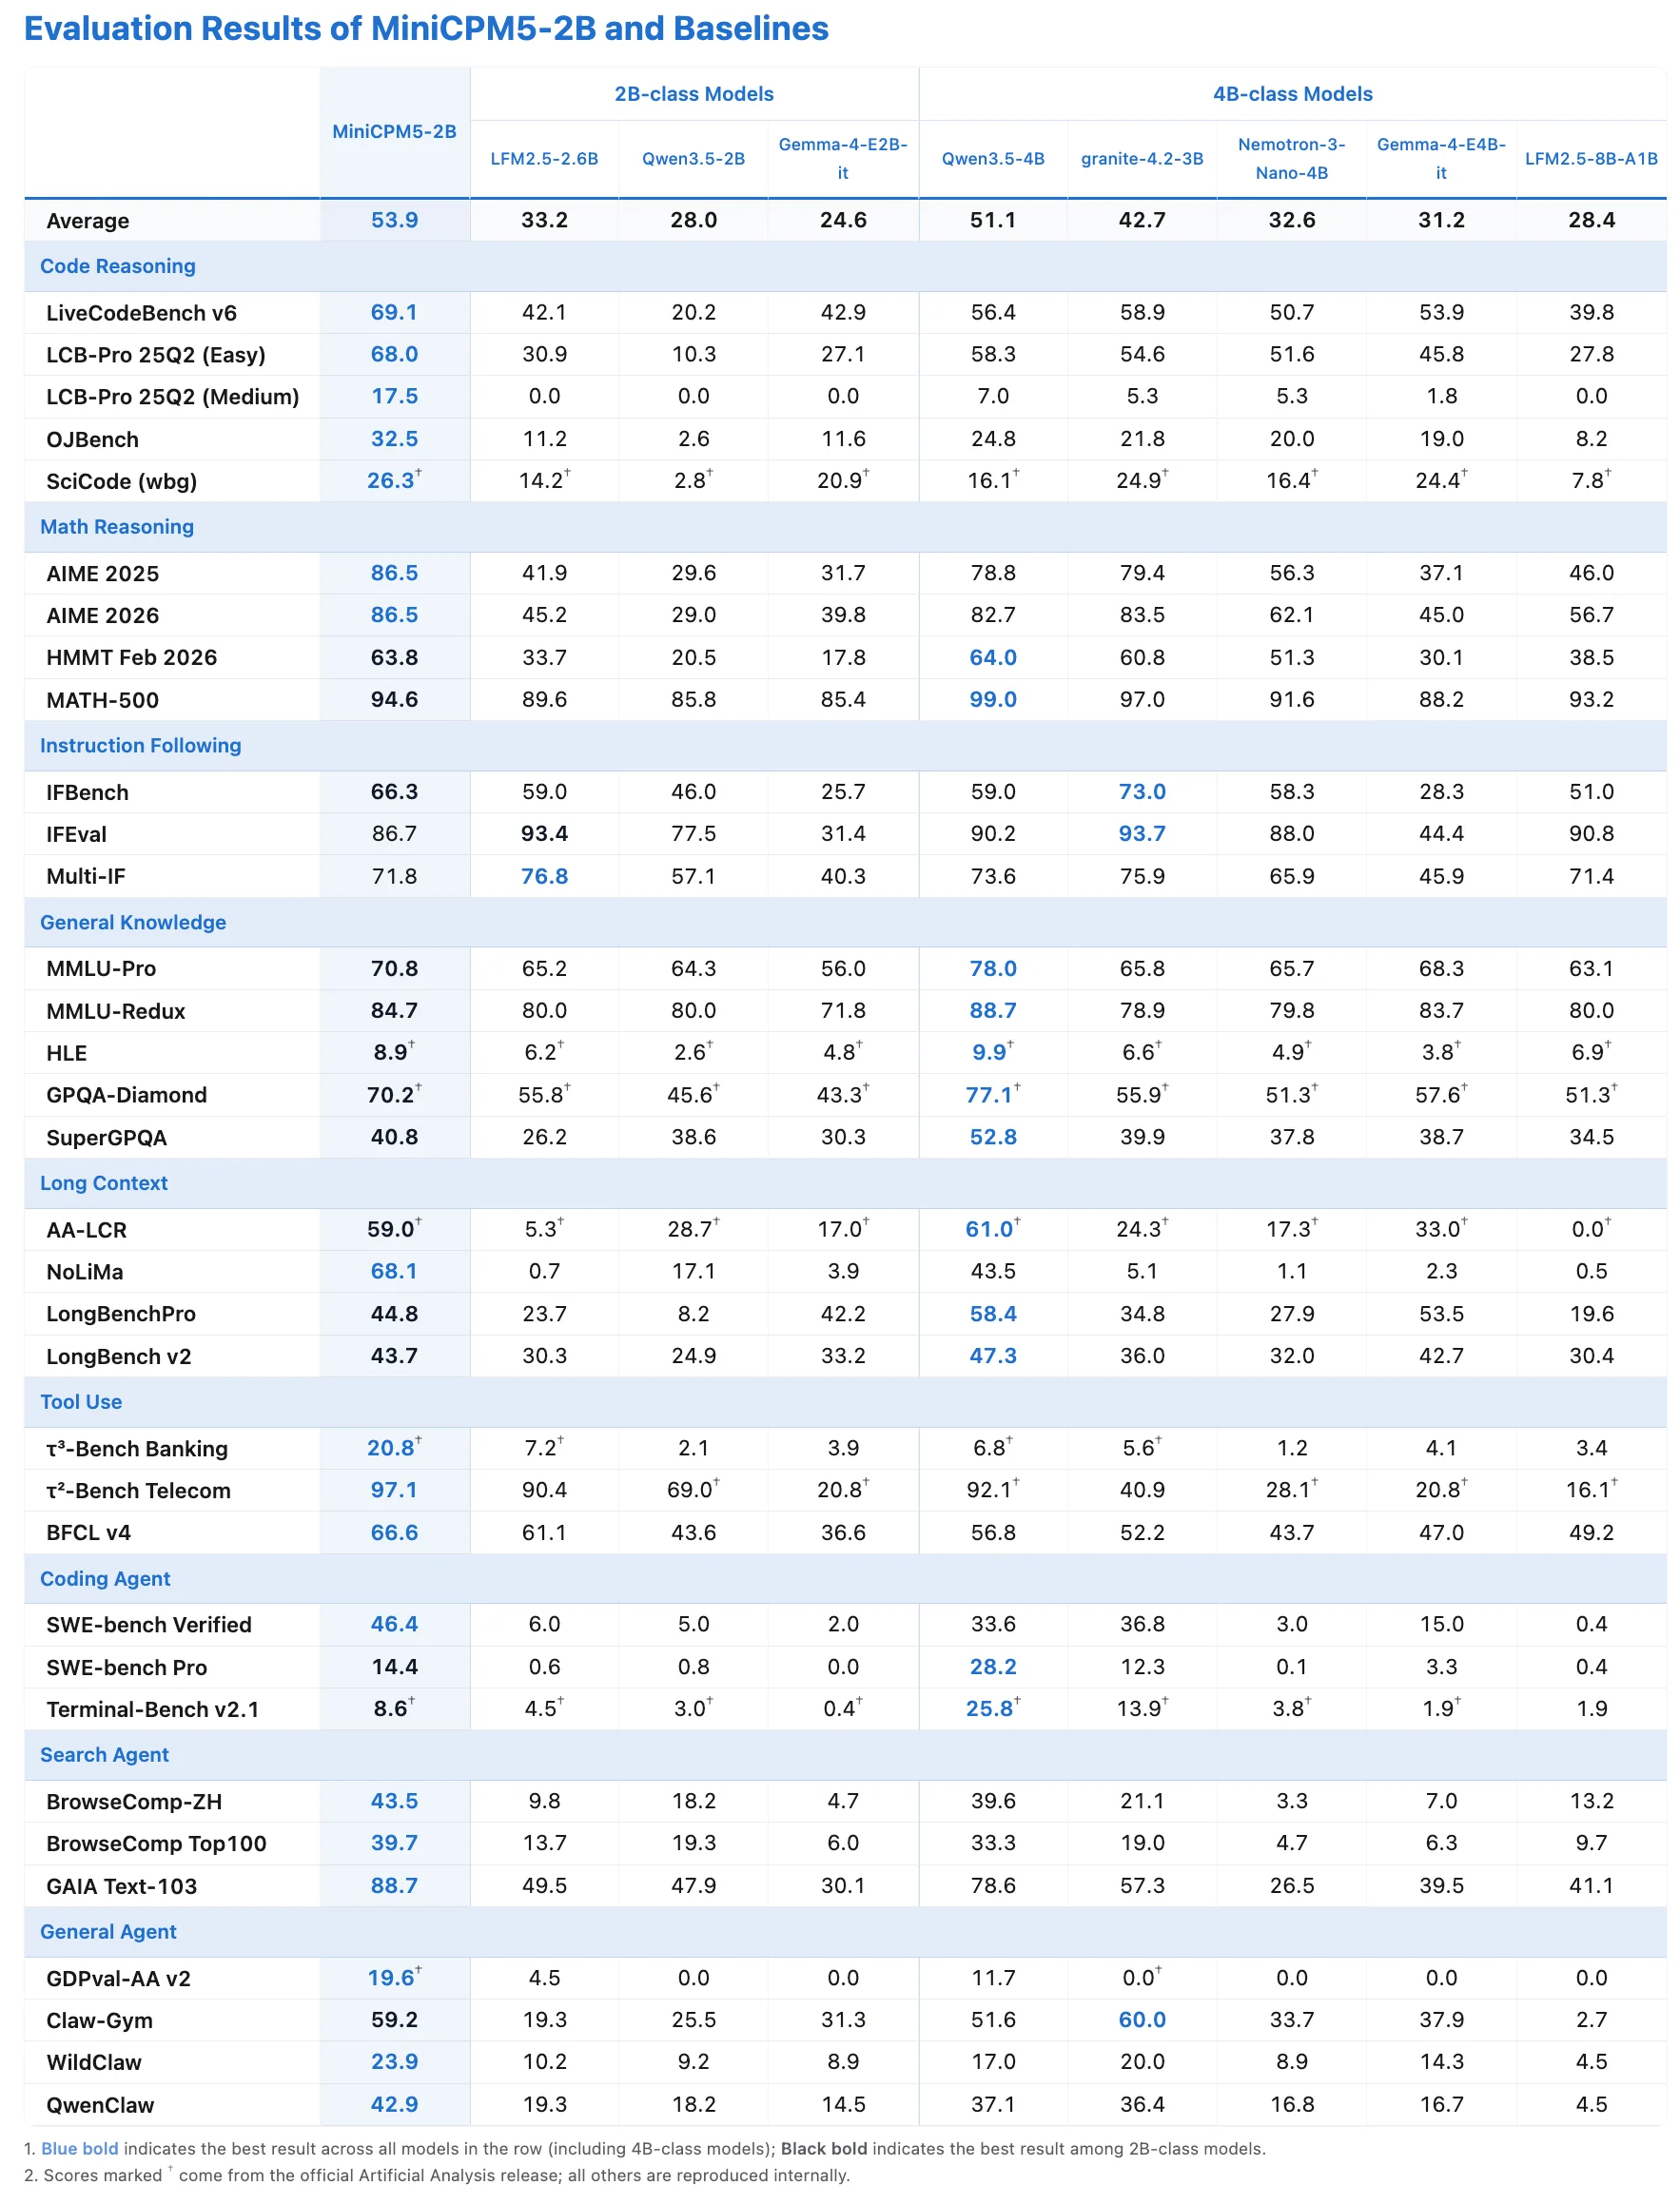
Die Spitzenwerte, alle aus dieser Tabelle: MATH-500 mit 94,6, AIME 2026 mit 86,5, LiveCodeBench v6 mit 69,1, SWE-bench Verified mit 46,4, τ²-Bench Telecom mit 97,1 und GAIA Text-103 mit 88,7. Beim Allgemeinwissen erreicht es MMLU-Pro 70,8. Für ein Modell, das auf einem Laptop läuft, sind diese Coding- und Tool-Nutzungswerte diejenigen, bei denen Entwickler aufhorchen.
Zwei Vorbehalte halten das Bild ehrlich. Erstens sind dies die selbst berichteten Zahlen von OpenBMB (einige Zeilen wurden intern reproduziert, andere stammen aus dem offiziellen Release von Artificial Analysis). Behandeln Sie sie also als starken Ausgangspunkt und testen Sie mit Ihren eigenen Aufgaben, statt sie als unabhängiges Urteil zu nehmen. Zweitens widerspricht sich eine Kennzahl zwischen den Quellen: Der r/LocalLLaMA-Release-Thread und dataconomy berichten beide einen Artificial Analysis Intelligence Index von 15, „the highest of any open weights model at 4B parameters or below“, während der eigene Launch-Beitrag von OpenBMB einen Wert von 23 plus 20 beim Agentic Index angibt. Ich kann diese beiden nicht in Einklang bringen, daher stehen beide hier. Und beachten Sie, was fehlt: OpenBMB veröffentlicht für dieses Modell weder klassisches MMLU noch GSM8K oder HumanEval. Wer es also mit älteren Bestenlisten vergleichen wollte, findet diese Zahlen in den offiziellen Quellen nicht.
Wie OpenBMB es trainiert hat
Der andere Grund, warum MiniCPM5-2B interessant ist: OpenBMB hat den Großteil des Rezepts als Open Source veröffentlicht, nicht nur die Gewichte. Wenn Sie wissen wollen, wie ein kleines Modell so leistungsfähig wird, ist die Pipeline die Antwort.
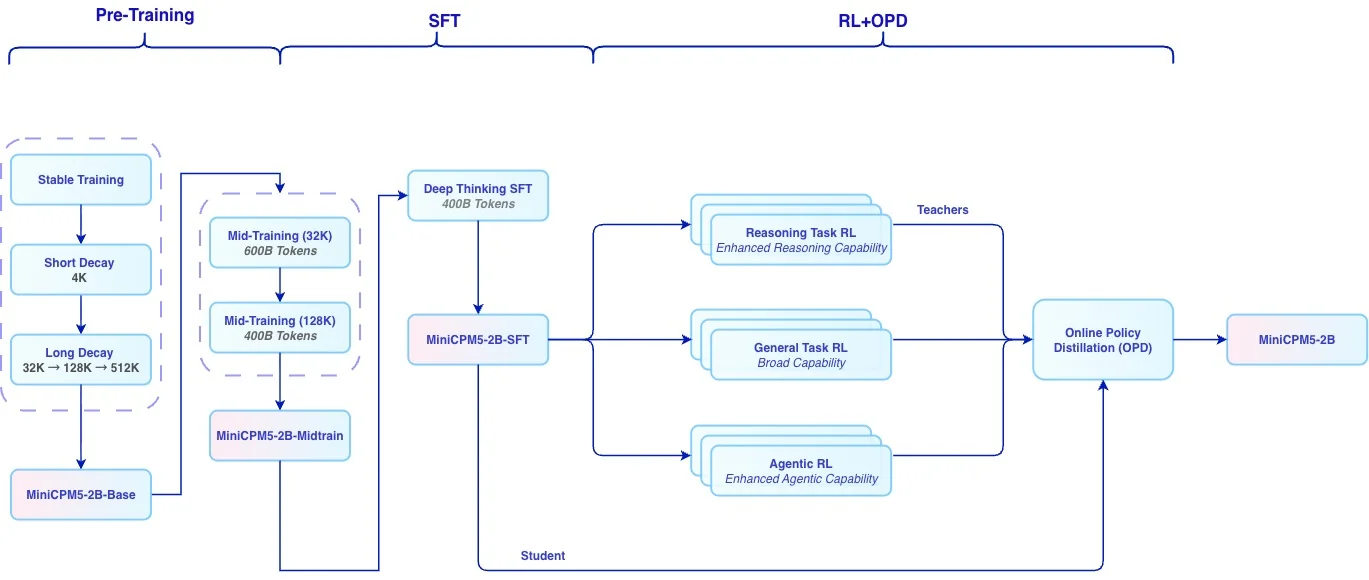
Sie läuft in drei Stufen, beschrieben auf der Modellkarte. Das Basistraining nutzt OpenBMBs Ultra-FineWeb und verwandte UltraData-Datensätze. Das Mid-Training passt das Modell an die Zielfähigkeiten an. Dann übernimmt das Post-Training die Hauptarbeit: 400B Tokens Deep-Thinking-SFT, Reinforcement Learning mit spezialisierten Lehrern für Mathematik-, Code-, Agenten- und Schreibaufgaben (mit dem Critic-basierten Algorithmus JustRL II) und schließlich On-Policy Distillation, die 16 Expertenmodelle zum einzelnen Release-Checkpoint verschmilzt.
OpenBMB berichtet, dass allein die RL-plus-OPD-Stufe 10,96 Punkte bei Reasoning- und allgemeinen Benchmarks sowie 6,96 Punkte bei Agentenaufgaben hinzugefügt hat. Ob Sie diese Gewinne reproduzieren oder nicht: Die Veröffentlichung der Datensätze und des RL-Frameworks ist ein Schritt, der die Open-Model-Community aufmerksam macht, weil er wiederholbar ist statt eine Blackbox.
Auf dem Edge betreiben
Der ganze Grund für die Existenz eines 2B-Modells ist, dort zu laufen, wo ein 200B-Modell nicht kann. Bei MiniCPM5-2B lautet die Frage also weniger „wie schlau ist es“, sondern „was bringt mir der lokale Betrieb tatsächlich“.
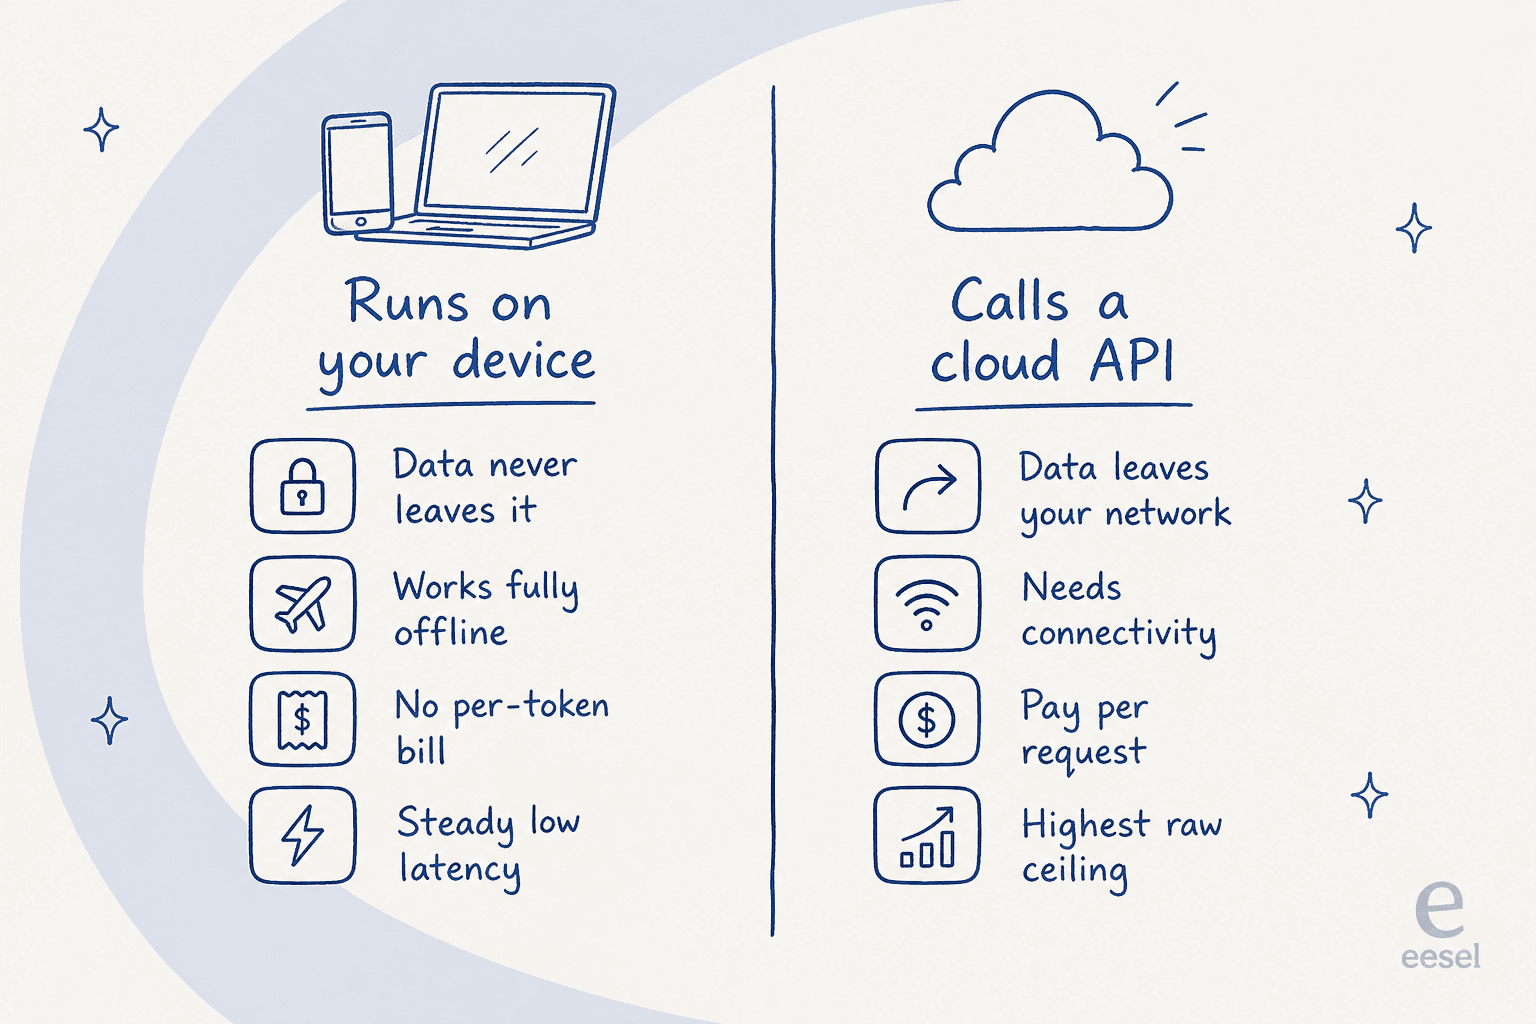
Der Tausch ist in beide Richtungen real. Läuft es auf dem Gerät, verlassen Ihre Daten nie die Maschine, es funktioniert ohne Verbindung, und es gibt keine Rechnung pro Token: Für datenschutzsensible oder Offline-Arbeit ist diese Kombination schwer zu schlagen. Wer die Cloud aufgibt, gibt aber auch die Leistungsobergrenze eines Frontier-Modells auf. MiniCPM5-2B setzt darauf, dass für eine wachsende Zahl von Aufgaben ein kleines lokales Modell, das „gut genug“ und privat ist, ein riesiges entferntes Modell schlägt, dem man seine Daten anvertrauen muss.
Die praktische Seite überzeugt. Ein Community-Eintrag beziffert den GGUF-Build auf etwa 1,6 GB (eine Angabe von Dritten, keine offizielle), und OpenBMB hat eine Demo geteilt, in der es auf einem MacBook mit 16 GB eine Websuche auf dem Gerät ausführt. Außerdem wurde es am ersten Tag angepasst für Intel Core Ultra mit OpenVINO, Arm v9 mit SME2 (wo es etwa 1,7-fach höheres Prefill und 1,2-fach höheres Decode berichtet) sowie die Rockchip-Boards RK3588 und RK1828.
Die Entscheidung für Standardarchitektur von vorhin zahlt sich hier aus. Derselbe Checkpoint lässt sich am Starttag in eine breite Palette von Runtimes laden, statt nur nach und nach in ein oder zwei.
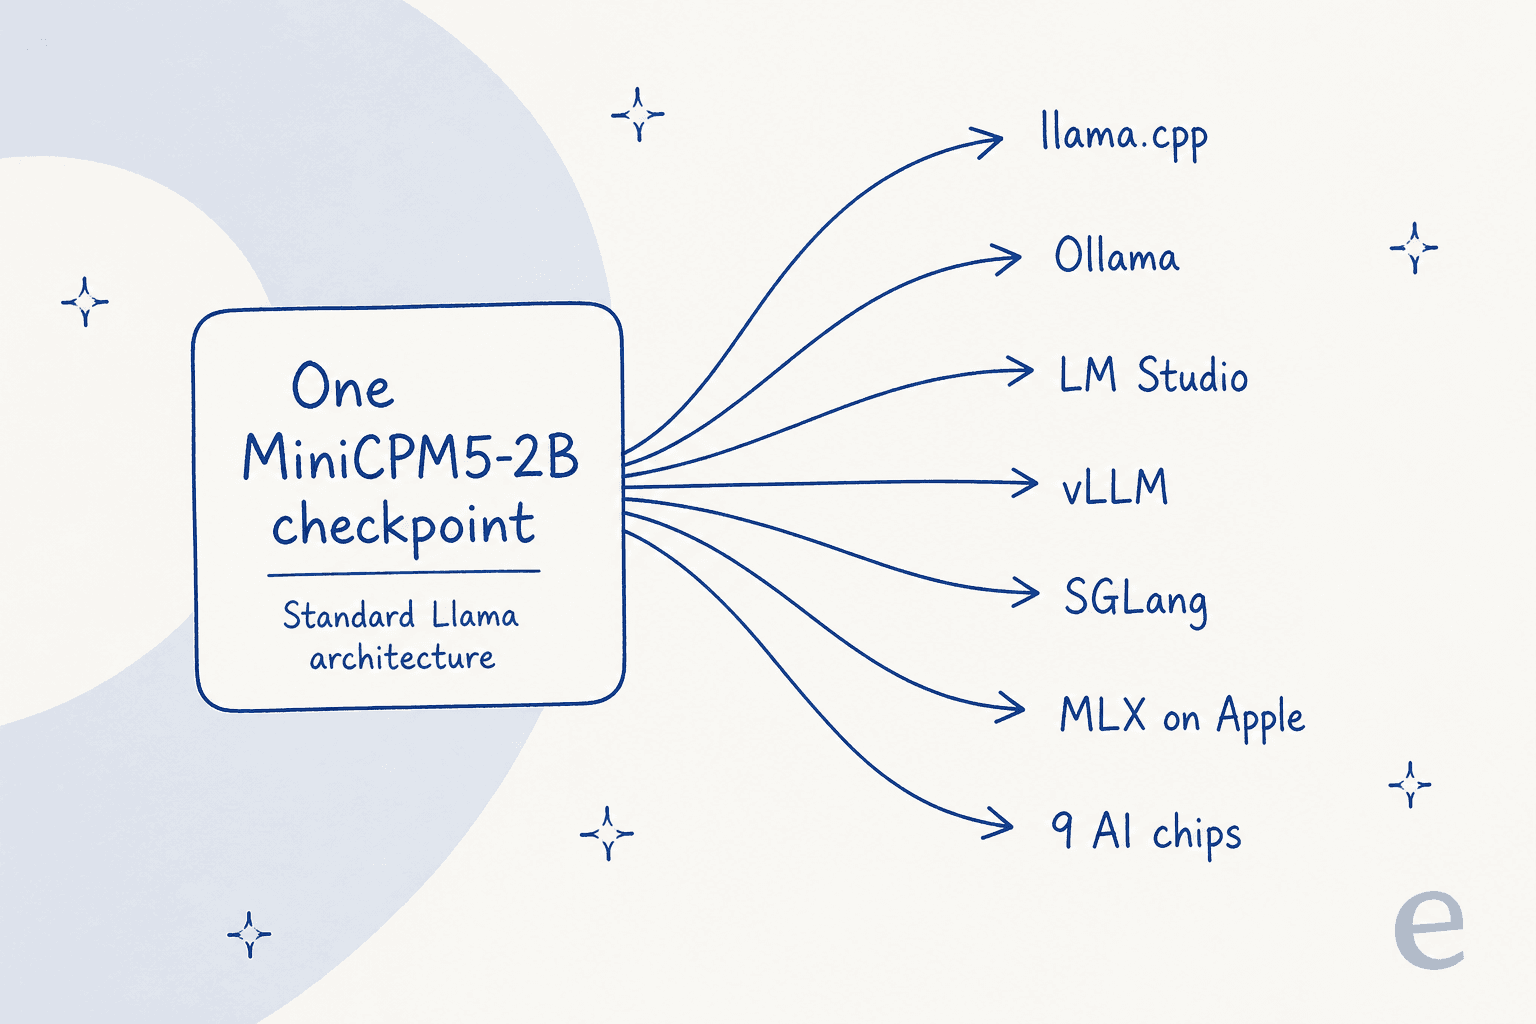
Laut der Deployment-Tabelle der Modellkarte läuft es auf Transformers, vLLM, SGLang, llama.cpp, Ollama, LM Studio, MLX für Apple Silicon und FlagOS, das es an neun verschiedene KI-Chips anpasst. Für Tool-Aufrufe ist SGLang das empfohlene Backend: Das Modell gibt Tool-Aufrufe im XML-Stil aus, und der integrierte minicpm5-Parser von SGLang wandelt sie in OpenAI-kompatible tool_calls um. Es gibt sogar ein DSpark-Draft-Modell für spekulatives Decoding, wenn Sie mehr Geschwindigkeit herausholen wollen, ohne die Ausgaben zu ändern.
Was die Community sagt
Die Reaktionen beim Launch bildeten zwei Lager, und beide sind nützliche Signale.
Das erste ist schlichte Begeisterung über das Verhältnis von Größe zu Leistung. Der offizielle Launch-Beitrag kam an einem Tag auf über 2.200 Likes, und ein Tester berichtete, auf einem einzelnen DGX Spark 32 gleichzeitige Subagenten mit durchschnittlich 931 Tokens pro Sekunde betrieben zu haben, mit einer Spitze von 1.364. Für ein lokal gehostetes 2B-Modell ist dieser Durchsatz genau das, was Lust macht, damit zu bauen.
Das zweite Lager ist skeptischer und gerade deshalb hörenswert, weil es nicht das Marketing ist. Die lauteste wiederkehrende Beschwerde war die fehlende Bildverarbeitung:
"Sad that there is no vision though."

Und einige Entwickler zweifelten daran, ob sich die Benchmark-Werte in echte Arbeit übersetzen, besonders in Coding-Harnesses:
"you get some likes here, but useful code? I don't think so"
Diese Lücke zwischen einer starken Benchmark-Zeile und gutem Verhalten in einer echten Agentenschleife lässt sich nicht aus einem Datenblatt ablesen. Sie ist zugleich das, was am meisten zählt, sobald Sie ein Modell an echten Aufgaben arbeiten lassen.
Ein offenes Modell ist ein Motor, kein Mitarbeiter
Hier ist die Neubewertung, die man mitnehmen sollte, und sie ist der Teil, den Entwickler und Käufer am häufigsten überspringen. MiniCPM5-2B ist ein großartiger Motor. Für sich allein ist es kein Arbeiter. Ein starkes Open-Weight-Modell herunterzuladen ist der Anfang eines Projekts, nicht sein Ende, und die Lücke zwischen beidem ist größer als das Modell.
Ich arbeite an der KI von eesel, und diese Unterscheidung begleitet uns jeden Tag. Wir haben Jahre damit verbracht, KI-Agenten auf Live-Support-Warteschlangen zu setzen, und die wiederkehrende Lektion ist, dass die rohe Modellqualität selten darüber entscheidet, ob ein Rollout gelingt. Entscheidend ist alles, was um das Modell herum liegt.
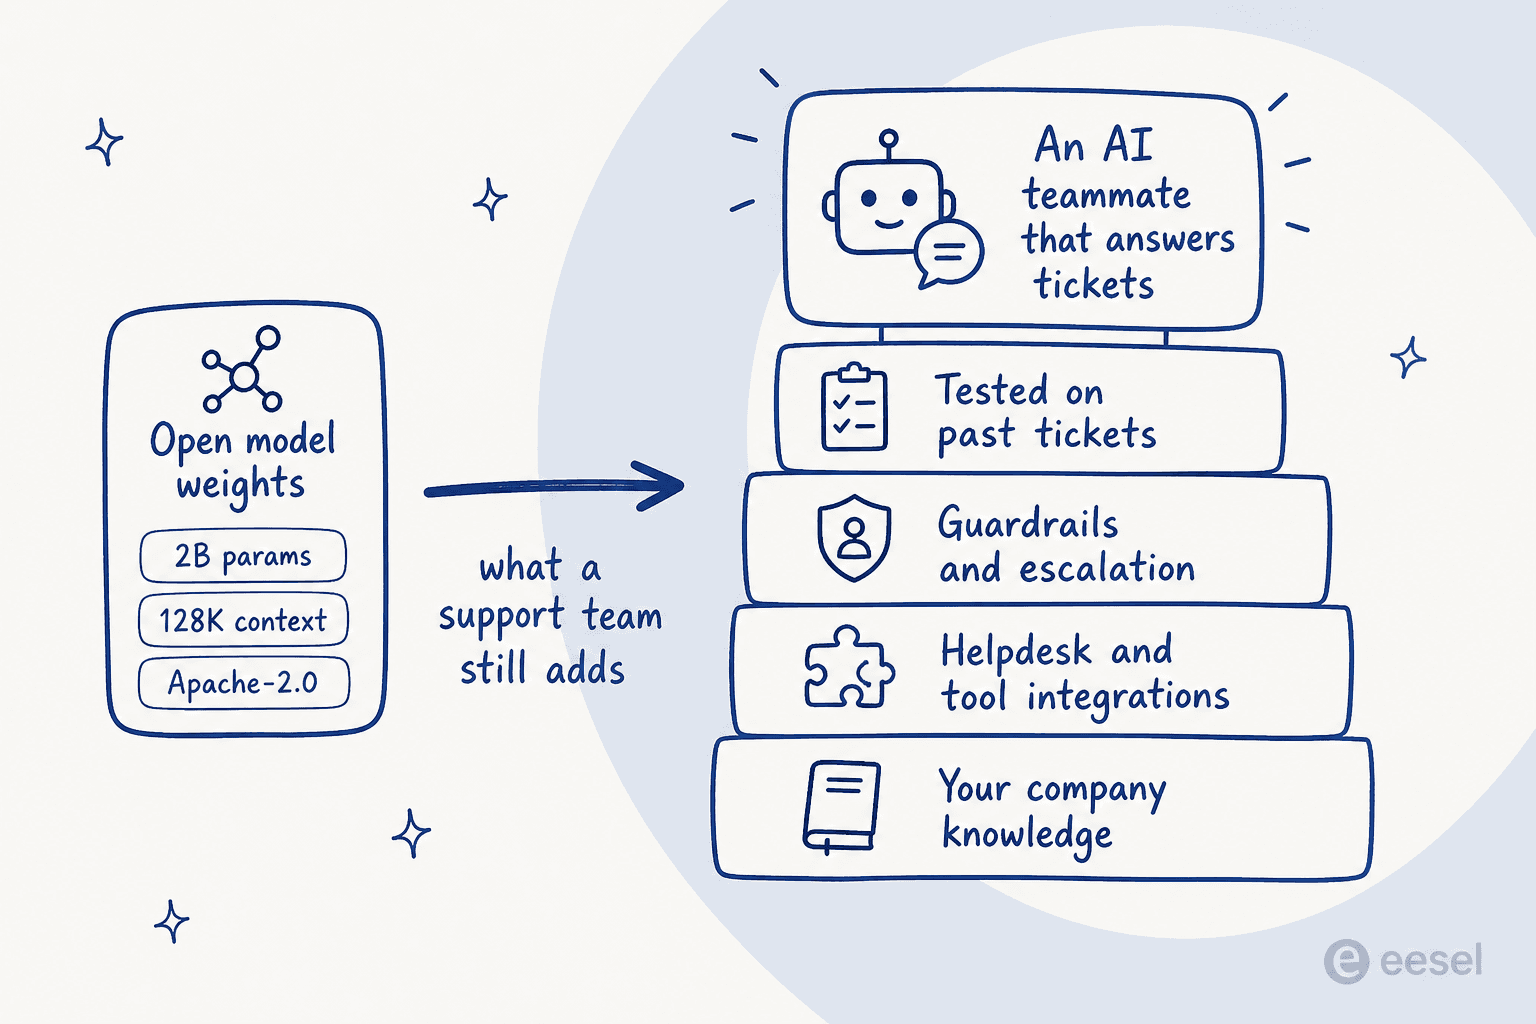
Nehmen wir den Kundensupport als konkreten Fall. Um ein Modell wie MiniCPM5-2B in etwas zu verwandeln, das ein echtes Ticket beantworten kann, müssen Sie es mit dem tatsächlichen Wissen Ihres Unternehmens füttern, es an den Helpdesk und die Tools anbinden, die es zum Handeln braucht, Leitplanken ergänzen, damit es eskaliert statt zu raten, und es vor dem ersten Kontakt mit einem Live-Kunden an echten früheren Gesprächen testen. Gerade dort haben wir erlebt, wie selbstsicher klingende Bots stillschweigend falsche Antworten gaben, weshalb wir heute jeden Rollout an historischen Tickets simulieren, bevor er live geht. Das Modell macht davon vielleicht 20 % aus. Die anderen 80 % sind das langweilige, unverzichtbare Gerüst, und das steckt nicht im Download.
Das ist kein Argument gegen offene Modelle. Es ist ein Argument dafür, klar zu sein, was man in der Hand hält. MiniCPM5-2B ist ein wirklich guter kompakter Motor zum Bauen. Wenn das, was Sie bauen wollen, aber ein Support-Agent ist, können Sie entweder diese ganzen 80 % selbst zusammensetzen oder sie fertig einstellen.
eesel ausprobieren
Wenn Ihr eigentliches Ziel ist, Kundenfragen zu beantworten, statt ein Modell zu betreiben, ist das genau das Problem, für das eesel da ist. eesel stellt ein einsatzbereites KI-Helpdesk-Teammitglied in Ihre bestehende Warteschlange ein: Es lernt aus Ihren früheren Tickets und Ihrem Help Center, bindet sich in Minuten an Tools wie Zendesk, Freshdesk und Slack an und, entscheidend, simuliert an Ihren echten historischen Tickets, sodass Sie sehen können, wie es sich verhalten wird, bevor es jemandem live antwortet.

Und wenn Sie gern nah an der Maschine arbeiten, so wie bei einem lokalen Modell, hat eesel eine öffentliche CLI plus einen MCP-Server. Dasselbe Teammitglied, das Sie im Dashboard konfigurieren, lässt sich also aus einem Terminal steuern, in Skripten automatisieren oder an einen Coding-Agenten wie Claude Code oder Cursor übergeben. Sie bekommen den fertigen Arbeiter und die programmierbare Oberfläche, ohne die 80 % selbst bauen zu müssen. Der Einstieg ist kostenlos.