

Groq 3 LPX ist NVIDIAs Rack-Scale-Beschleuniger für Inferenz mit niedriger Latenz, gedacht für die Vera-Rubin-Plattform. Er ist wirklich beeindruckend, aber die meisten Teams können ihn nicht einfach kaufen. Er wird als Teil einer Vera-Rubin-Installation ausgeliefert, ist Rack-Scale-Infrastruktur, und bisher haben ihn nur Clouds wie Nebius in Produktion. Wenn du also nach Alternativen gesucht hast, stellst du mit ziemlicher Sicherheit eine von zwei echten Fragen: Welche schnelle Inferenz-Option kann ich jetzt wirklich nutzen? Oder: Auf welches Silizium sollte meine Plattform setzen?
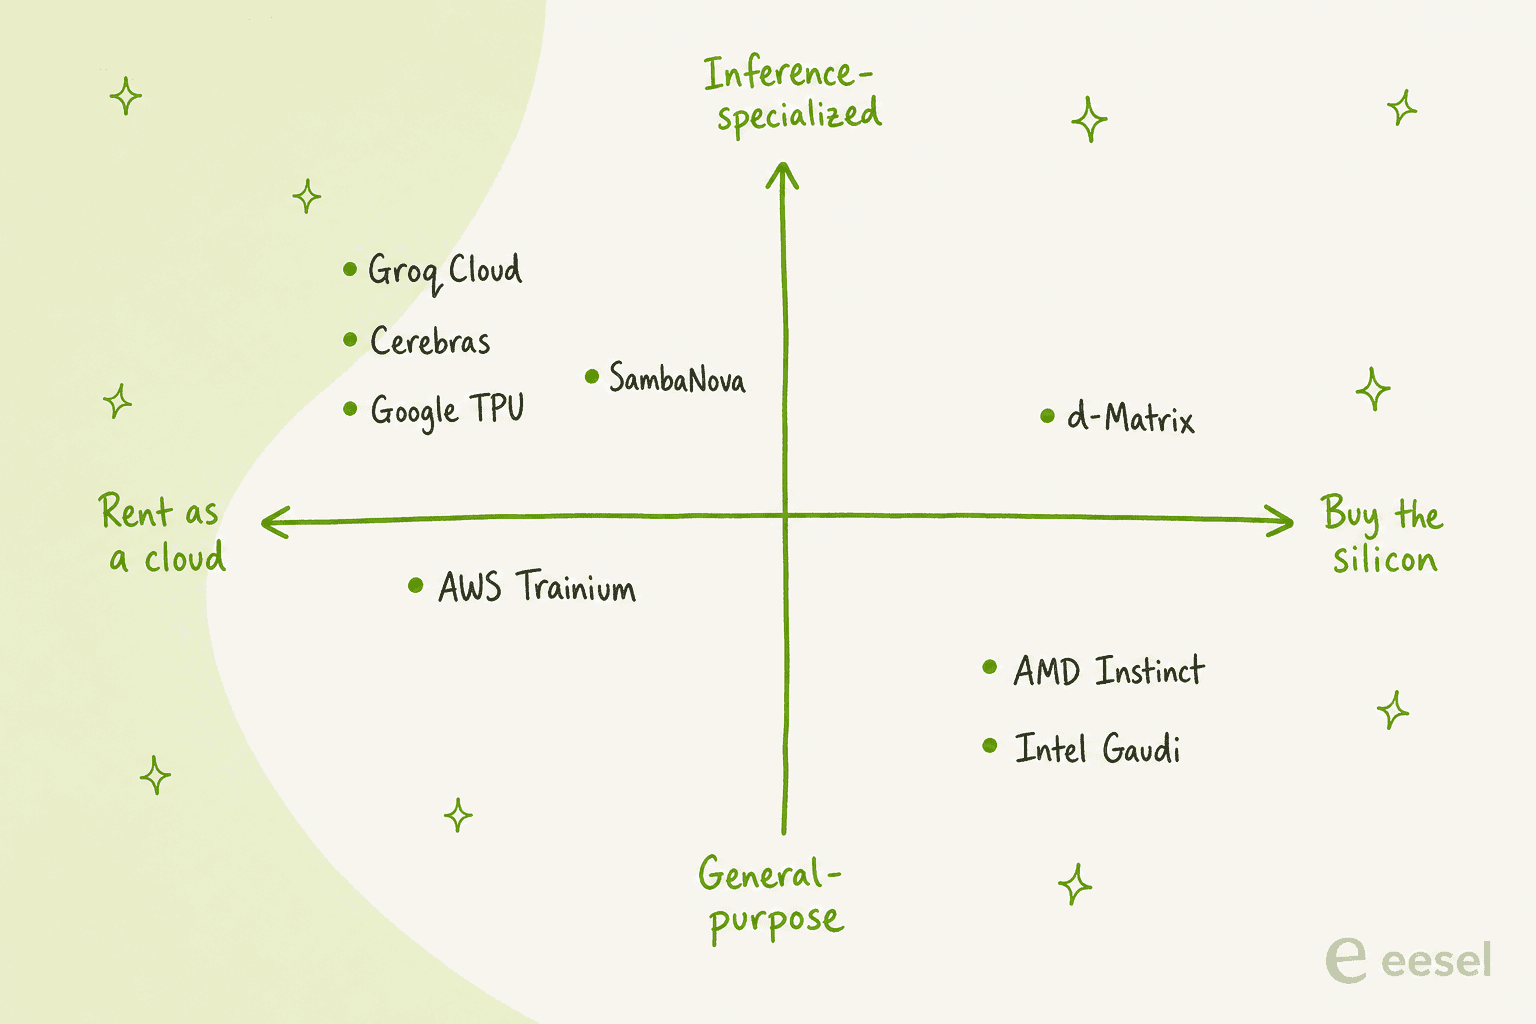
Das sind die acht, die ich mir ansehen würde, gruppiert danach, wie du sie bekommst:
- Heute per API nutzen: Cerebras (reine Single-Stream-Geschwindigkeit), SambaNova (größte offene Modelle und Agenten-Workloads) und die unabhängige Groq-Cloud (die Groq-LPU, ohne auf NVIDIA-Racks zu warten).
- Hyperscaler-Silizium mieten: Google TPU Ironwood (Google Cloud, auf Inferenz ausgelegt) und AWS Trainium (beste Token-Wirtschaftlichkeit innerhalb von AWS).
- Hardware besitzen: AMD Instinct (mehr Speicher pro GPU, offene Software) und Intel Gaudi (Preis-Leistung und Standard-Ethernet).
- Früh auf einen Spezialisten setzen: d-Matrix Corsair (In-Memory-Compute für niedrige Latenz).
Die ehrliche Neubetrachtung, und das Wichtigste, was ich dir mitgeben möchte: Wenn du keine Cloud betreibst, wirst du nichts davon kaufen. Du spürst sie als schnellere, günstigere Tokens in den APIs, die du ohnehin nutzt, und was du tatsächlich einsetzt, ist der Arbeiter darüber, etwa ein KI-Helpdesk-Agent. Dort sitzt eesel.
Warum du überhaupt über Groq 3 LPX hinausschauen solltest
Zuerst möchte ich dem Platzhirsch gegenüber fair sein, denn er ist ein ernstzunehmendes Stück Ingenieurskunst. Groq 3 LPX ist NVIDIAs Inferenz-Beschleuniger für Vera Rubin, gebaut auf Groqs LPU-Design unter einer nicht exklusiven Lizenz. Jedes Rack enthält 256 LPU-Chips, die neben Rubin-GPUs arbeiten, und NVIDIA nennt einen Benchmark von 3.400 Tokens pro Sekunde bei Gemma 4 31B mit 100K Kontext. Er ist schnell, und die Architektur ist clever.
Warum also woanders suchen? Ein paar sehr praktische Gründe:
- Du kannst ihn nicht einfach kaufen. LPX ist eine Rack-Scale-Erweiterung von Vera Rubin NVL72, keine Karte, die du in einen Server steckst. Für die meisten Teams ist das eine Rechenzentrums-Verpflichtung und keine Kaufentscheidung.
- Die Verfügbarkeit ist dünn. NVIDIA hat die volle Produktion im August 2026 angekündigt, aber Nebius ist nur die erste Cloud, die ihn einsetzt. Wenn du heute Kapazität willst, ist die Warteschlange kurz und die Liste der Anbieter noch kürzer.
- Die Zahlen stammen von NVIDIA selbst. Die Kennzahl von 35-fachem Durchsatz pro Megawatt wird gegen NVIDIAs vorherige Generation gemessen. Das ist eine stimmige Aussage, aber eine Herstellerangabe, und unabhängige Tests stehen noch aus.
- Lock-in. LPX ergibt nur innerhalb eines Vera-Rubin-Aufbaus Sinn. Wenn dein Stack, deine Cloud oder dein Budget woandershin zeigt, ist das eine harte Abhängigkeit.
Nichts davon macht LPX schlecht. Es bedeutet nur, dass „Sollte ich Groq 3 LPX nutzen?“ für die meisten die falsche Frage ist. Die bessere lautet: „Woher bekomme ich schnelle Inferenz?“, und darauf gibt es viele gute Antworten.
Wie ich ausgewählt habe und wie du diese Liste liest
Ich arbeite auf der Produktseite, deshalb liegt meine Tendenz bei dem, was du tatsächlich einsetzen kannst, nicht bei dem, was auf einer Folie am besten abschneidet. Ich habe die Dokumentation, Preise und Datenblätter jedes Anbieters gelesen, und wo es eine Geschwindigkeitsangabe gibt, habe ich die Zahl des Anbieters verwendet und das gekennzeichnet. Drei Dinge haben das Ranking geprägt:
- Kannst du es jetzt nutzen? Eine API, die du heute Nachmittag ansprechen kannst, schlägt ein Rack, auf das du wartest. Zugänglichkeit wird stark gewichtet.
- Was ist der eigentliche Workload? Schneller Single-Stream-Chat, riesige offene Modelle oder günstiges Batch-Serving sind verschiedene Aufgaben, die verschiedene Chips belohnen.
- Was kostet der Betrieb? Mieten oder Kaufen, die Software, an die du dich bindest, und die Gesamtbetriebskosten zählen mehr als die Spitzen-FLOPS.
Ein Vorbehalt, der offen gesagt werden muss: Die Stimmen aus der Community zu genau dieser Hardware-Generation sind noch dünn, weil fast nichts davon schon lange im Einsatz ist. Die folgenden Einschätzungen stützen sich daher auf Primärspezifikationen und die wenigen echten Benchmarks, nicht auf jahrelange Nutzerbewertungen. Wo es eine echte Stimme gibt, habe ich sie zitiert.
Hier ist das gesamte Feld auf einen Blick, bevor wir ins Detail gehen.
| Alternative | Typ | Zugang | Wichtigste Inferenz-Zahl (laut Hersteller) | Grober Kostenhinweis | Am besten für |
|---|---|---|---|---|---|
| Groq (GroqCloud) | LPU-Inferenz-Cloud + Chips | API heute, pro Token | Am schnellsten bei kleinen/mittleren Modellen | Pro Token, veröffentlicht | Groq-LPU-Geschwindigkeit, ohne auf NVIDIA-Racks zu warten |
| Cerebras | Wafer-Scale (WSE-3) | API + Kauf von CS-4/CS-3 | ~3.000 tok/s (GPT OSS 120B) | 0,35 $ In / 0,75 $ Out pro Mio. | Reine Single-Stream-Geschwindigkeit |
| SambaNova | RDU, dreistufiger Speicher | API + On-Prem-Racks | ~850 tok/s (MiniMax M2.7) | 0,22 $ In / 0,59 $ Out pro Mio. (gpt-oss-120b) | Größte offene Modelle, Agenten, On-Prem |
| Google TPU (Ironwood) | Eigener ASIC | Nur auf Google Cloud mieten | 4.614 FP8 TFLOPs/Chip | Ab 12,00 $/Chip-Stunde | Teams, die schon auf GCP sind, Hyperscale-Serving |
| AWS Trainium | Eigener ASIC | Nur auf AWS mieten | Trn2: 30-40 % bessere Preis-Leistung vs. H200 | Inf2 ab 0,76 $/Std. | Günstigere Tokens innerhalb von AWS |
| AMD Instinct | GPU (CDNA) | Kaufen oder über Cloud-Partner | MI355X: 288 GB HBM3E, 8 TB/s | Kapitalkauf / Angebot | Eigenes Silizium, speicherintensive Modelle, kein Lock-in |
| Intel Gaudi 3 | KI-Beschleuniger | Kaufen oder über IBM Cloud | 128 GB HBM, 1.200 GB/s Ethernet | „Halbe Kosten“-Positionierung | Preisbewusste Käufer, Ethernet-native Betriebe |
| d-Matrix Corsair | In-Memory-Compute (DIMC) | Nur Hardware kaufen | 60.000 tok/s (Llama3 8B, Server) | Kapitalkauf | Latenz-Fanatiker, die früh wetten |
| Groq 3 LPX (Platzhirsch) | LPU + GPU-Rack | Über Clouds (Nebius) | 3.400 tok/s (Gemma 4 31B) | Rechenzentrums-Maßstab | Hyperscale-Agenten-Inferenz |
Du weißt nicht, welche Zeile du bist? Mit dieser Auswahl kommst du mit einem Klick zu einer Shortlist.
1. Groq (GroqCloud): die Groq-LPU, die du heute wirklich nutzen kannst
Am besten für: Teams, die die Low-Latency-Geschwindigkeit der Groq-LPU jetzt per API wollen, ohne zu warten, bis NVIDIAs Racks in ihrer Cloud ankommen.
Hier kommt die Wendung, über die viele stolpern. Das Unternehmen Groq gibt es weiterhin, es betreibt weiterhin GroqCloud und verkauft weiterhin die LPU-Geschwindigkeit, die es berühmt gemacht hat. Als NVIDIA Groqs Technologie lizenzierte, war das ein nicht exklusiver Deal plus ein Teamwechsel, keine Schließung. Groq blieb unter einem neuen CEO unabhängig, und GroqCloud lief ohne Unterbrechung weiter. Eine Reaktion auf X hat die Verwirrung perfekt getroffen:
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
Wenn dich an LPX also die Geschwindigkeit der LPU angezogen hat, ist die direkteste „Alternative“ oft das Original: GroqCloud. Du bekommst eine OpenAI-kompatible API, deterministische Token-Generierung mit niedriger Latenz, und du kannst heute starten, statt auf eine Vera-Rubin-Installation in deiner Nähe zu warten. Auf Hacker News las einer der schärferen Kommentare den LPX-Benchmark als Fortsetzung von Groqs bekannter Stärke:
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

Vorteile: heute verfügbar, vertraute API, stark bei kleinen und mittleren Modellen und dieselbe LPU-Linie, die NVIDIA lizenziert hat. Nachteile: Die Markenverwirrung ist real, und die größten Modelle sind woanders besser aufgehoben. Für das ganze Kostenbild haben wir Groq-Preise und die breitere Auswahl an Groq-Alternativen separat aufgeschlüsselt.
Preise und Zugang: Self-Service, Pay-per-Token über GroqCloud. Fazit: Wenn dir „Groq 3 LPX“ wegen der LPU aufgefallen ist, fang vor allem anderen hier an. Es ist der kürzeste Weg zum eigentlichen Produkt.
2. Cerebras: der engste reine Geschwindigkeitsrivale
Am besten für: reine Single-Stream-Token-Geschwindigkeit bei kleinen und mittleren Modellen, ob per API oder mit eigenem System.
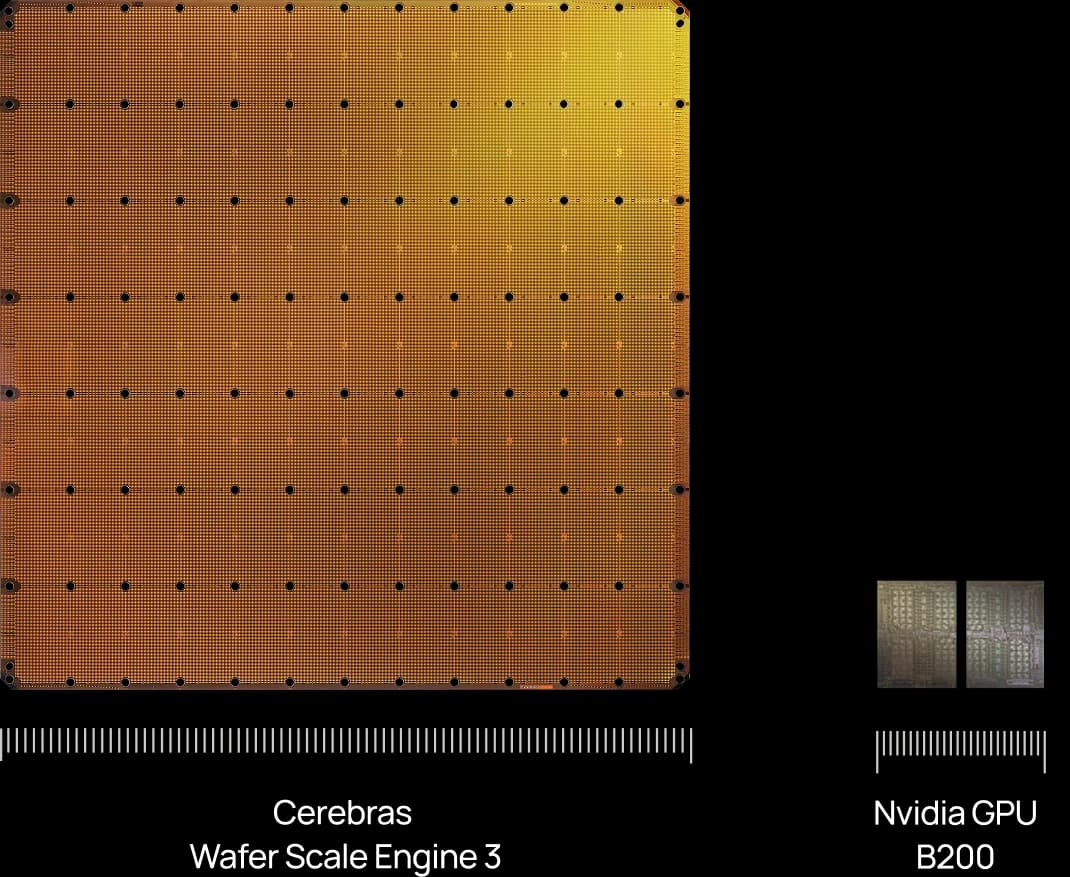
Cerebras ist der andere Name, der in der Diskussion um „schnellste Inferenz“ immer fällt, und das aus gutem Grund. Seine Wafer-Scale Engine ist ein einzelner Chip in der Größe eines Essentellers: 4 Billionen Transistoren, 900.000 Kerne und 125 Petaflops auf einem Stück Silizium. Cerebras spricht von 19-mal mehr Transistoren als bei einer NVIDIA B200. Die ganze Designphilosophie ist das Gegenteil eines Clusters kleiner Chips, die über ein Netzwerk kommunizieren.
Den Teil, den du tatsächlich nutzt, ist Cerebras Inference, eine OpenAI-kompatible Cloud, die stark auf Geschwindigkeit setzt: Die Preisseite behauptet, sie sei 20-mal schneller als OpenAI und Anthropic, und das neue CS-4-System soll „bis zu 30-mal schnellere Inferenz im Vergleich zu GPUs“ liefern. Konkret nennt Cerebras rund 3.000 Tokens pro Sekunde bei GPT OSS 120B und etwa 1.800 bei Gemma 4 31B.
Vorteile: wirklich führende Single-Stream-Geschwindigkeit, eine saubere Pay-per-Token-API und namhafte Nutzer wie OpenAI, Meta und Perplexity. Nachteile: Wafer-Scale-Systeme sind bei On-Prem-Betrieb eine schwere Anschaffung, und die öffentliche Preisliste nennt nur ein paar Modelle, sodass die Budgetierung für einen konkreten Workload ein Verkaufsgespräch erfordert.
Preise und Zugang: 5 $ Startguthaben, dann eine Developer-Stufe ab 10 $ mit veröffentlichten Token-Preisen (GPT OSS 120B mit 0,35 $ Input / 0,75 $ Output pro Million Tokens), außerdem Enterprise und CS-4/CS-3-Systeme zum Kauf. Fazit: Wenn dir allein Tokens pro Sekunde bei einem von Cerebras bedienten Modell wichtig sind, ist es die stärkste Alternative dieser Liste und tritt direkt gegen Groq an.
3. SambaNova: gebaut für große offene Modelle und Agenten
Am besten für: die größten offenen Modelle schnell betreiben, viele Modelle für Agenten-Workloads gleichzeitig im Speicher halten oder Inferenz im eigenen Rechenzentrum bereitstellen.
SambaNovas gesamter Pitch für 2026 lautet „Premium-Inferenz“, und sein Unterscheidungsmerkmal ist der Speicher. Während Groqs Design auf riesige SRAM-Bandbreite bei winziger Kapazität pro Chip setzt, nutzt die SN50 RDU drei Stufen: 432 MB On-Chip-SRAM, 64 GB HBM2E und bis zu 512 GB DDR5. So können mehrere große Modelle geladen bleiben und mit minimaler Latenz gewechselt werden, was Mitgründer Kunle Olukotun die „Goldilocks Zone“ für Agenten nennt.
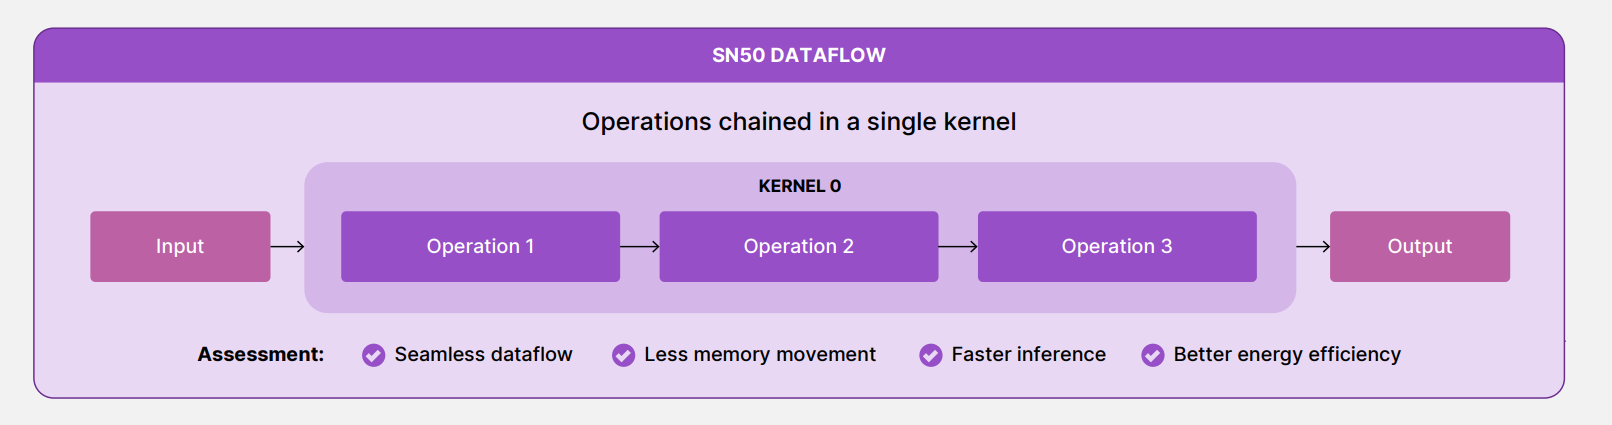
Den Geschwindigkeitsbeleg, dem ich am meisten traue, kommt von Dritten: Artificial Analysis hat den SN50 gemessen, der MiniMax M2.7 mit bis zu 850 Tokens pro Sekunde bei kurzem Kontext und über 450 bei langem Kontext ausführt, und nannte es das schnellste MiniMax der Welt. Es gibt auch eine kluge Nuance: SambaNova kombiniert sich zunehmend mit NVIDIA, statt gegen es zu kämpfen, und nutzt GPUs für die rechenintensive Prefill-Phase und RDUs für die speichergebundene Decode-Phase.
Vorteile: Der dreistufige Speicher eignet sich für riesige Modelle und Multi-Modell-Agenten-Workloads, veröffentlichte Preise für offene Modelle, eine echte On-Prem-Geschichte für souveräne und Enterprise-Deployments und eine frische Finanzierungsrunde über 1 Mrd. $ bei einer Bewertung von 11 Mrd. $. Nachteile: Es ist weniger ein reines „schnellstes winziges Modell“-Angebot als Groq oder Cerebras, und die größten Deployments laufen über den Vertrieb.
Preise und Zugang: SambaNova Cloud ist eine Pay-per-Token-API (gpt-oss-120b mit 0,22 $ Input / 0,59 $ Output pro Million Tokens; DeepSeek-V3.1 mit 3,00 $ / 4,50 $), mit SambaRack-Systemen für On-Prem. Fazit: die richtige Wahl, wenn dein Workload große offene Modelle sind oder ein Agent, der mehrere Modelle gleichzeitig jongliert, und erst recht, wenn du ihn im eigenen Rechenzentrum brauchst.
4. Google TPU (Ironwood): die Hyperscaler-Antwort
Am besten für: Teams, die bereits auf Google Cloud sind, und alle, die Hyperscale-Serving-Kapazität brauchen statt einer einzelnen Low-Latency-Box.
Wenn Groq 3 LPX für „NVIDIAs Inferenz-zuerst-Chip“ steht, ist Ironwood Googles Version derselben Idee. Google nennt Ironwood seine TPU der siebten Generation und „die erste, die speziell für Inferenz entwickelt wurde“, gebaut für das „Zeitalter der Inferenz“ und Reasoning-Modelle. Jeder Chip liefert 4.614 FP8-TFLOPs und 192 GB HBM bei etwa 7,37 TB/s, und ein vollständiger Superpod verbindet 9.216 flüssigkeitsgekühlte Chips zu 42,5 ExaFLOPs mit 1,77 Petabyte gemeinsamem HBM.
Der schärfste Kontrast zu Groq ist das Kaufmodell: Eine TPU kann man nicht kaufen. Sie wird nur gemietet, nur auf Google Cloud, abgerechnet pro Chip-Stunde. Die Skalierungsgeschichte ist allerdings real. Googles prominentester Kunde ist Anthropic, das plant, auf bis zu 1 Million TPUs zuzugreifen, um Claude zu trainieren und bereitzustellen.
Vorteile: Inferenz-zuerst-Design, enorme Pod-Skalierung, starke Preis-Leistung im großen Maßstab und ein Portabilitätspfad (vLLM auf TPU erlaubt den Wechsel zwischen GPU und TPU mit kleinen Konfigurationsänderungen). Nachteile: vollständiger Lock-in bei Google Cloud, keine Karte zum Kaufen, und On-Demand-Ironwood ist nicht günstig.
Preise und Zugang: pro Chip-Stunde gemietet, ab 12,00 $ on-demand in us-central1, sinkend auf 5,40 $ bei dreijähriger Bindung. Fazit: Wenn du schon auf Google Cloud lebst oder eine Serving-Flotte statt einer schnellen Einzelbox brauchst, ist Ironwood die naheliegende Alternative. Wenn du Silizium willst, das du kontrollierst, ist es das Gegenteil davon.
5. AWS Trainium: die beste Token-Wirtschaftlichkeit innerhalb von AWS
Am besten für: Teams auf AWS, die günstigere Tokens wollen und gern über Bedrock oder EC2 bereitstellen, statt Spitzengeschwindigkeit zu jagen.
AWS' Pitch lautet nicht „am schnellsten“, sondern „am günstigsten pro Token“, und das ist eine wirklich andere Achse. Trainium wird inzwischen sowohl für Inferenz als auch für Training positioniert: AWS behauptet, Trn2-Instanzen liefern 30-40 % bessere Preis-Leistung als seine auf NVIDIA H200 basierenden P5e- und P5en-Instanzen, und der angekündigte Trainium3 (der erste 3-nm-KI-Chip von AWS) verspricht bis zu 4,4-fache Leistung gegenüber Trn2-UltraServern. Die ältere Inferentia2-Linie verspricht 40 % bessere Preis-Leistung und 50 % bessere Leistung pro Watt bei Inf2-Instanzen.
Der wichtigste Beleg ist Anthropic, direkt auf der Trainium-Seite zitiert: ein latenzoptimiertes Claude 3.5 Haiku, das auf Trainium2 60 % schneller über Bedrock läuft, und Project Rainier, ein Cluster aus Hunderttausenden Trainium2-Chips.
Vorteile: echte Kosteneinsparungen innerhalb von AWS, tiefe Integration mit Bedrock und SageMaker und Rack-Scale-UltraServer (64 Chips bei Trn2, 144 bei Trn3) für die größten Jobs. Nachteile: nur AWS und nur Miete, und es läuft auf dem Neuron SDK statt CUDA, sodass gängige PyTorch- und vLLM-Workloads leicht umziehen, handgeschriebene CUDA-Kernel aber portiert werden müssen.
Preise und Zugang: Miete über EC2 oder Nutzung über Bedrock. Inf2 hat veröffentlichte Stundenpreise von 0,76 $ bis 12,98 $ on-demand; Trn2- und Trn3-UltraServer sind angebotsbasiert. Fazit: Wenn deine Infrastruktur schon auf AWS liegt, ist das die Preis-Leistungs-Option, besonders für stetiges Serving, bei dem Kosten pro Token wichtiger sind als die letzten Millisekunden.
6. AMD Instinct: Silizium besitzen, mehr Speicher behalten
Am besten für: Teams, die Standard-Silizium kaufen, große Modelle im Speicher halten und einen reinen NVIDIA-Stack vermeiden wollen.
Wenn du eine echte GPU besitzen willst, ist AMD die wichtigste Alternative zu NVIDIA, und sein ganzes Argument für Inferenz ist der Speicher. Die ausgelieferte MI355X bietet 288 GB HBM3E mit 8 TB/s und 10,1 PFLOPs MXFP4, und die angekündigte MI400-Serie geht bis zu 432 GB HBM4 mit 23,3 TB/s. AMD behauptet, dass seine MI455X und MI430X 50 % mehr Speicherkapazität bieten als NVIDIAs Vera-Rubin-GPU, was zählt, wenn ein größeres Modell oder ein längerer KV-Cache auf einem Chip Platz findet, statt aufgeteilt zu werden.
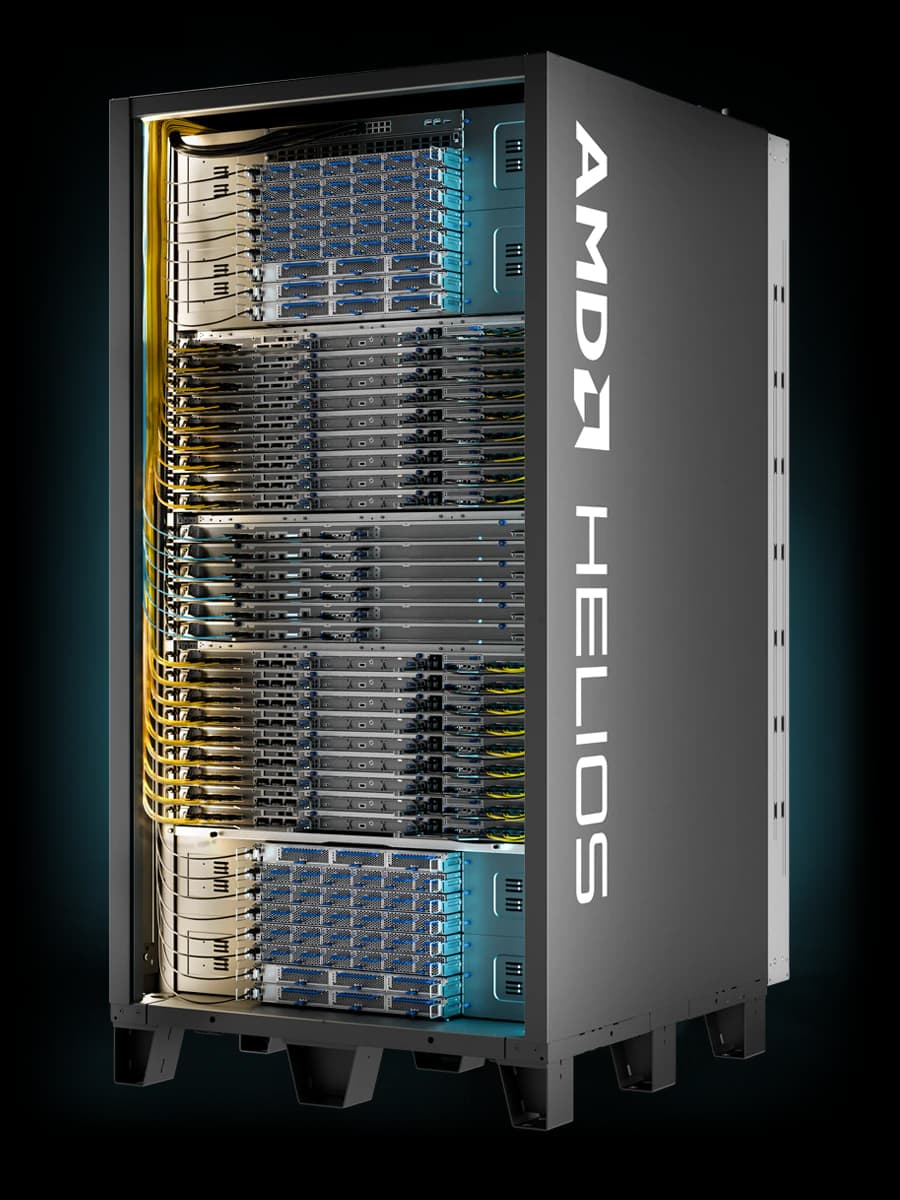
Im Rack-Maßstab packt das AMD-Helios-System 72 MI455X-GPUs für bis zu 2,9 ExaFLOPS MXFP4 und 31 TB HBM4. Die Software läuft auf dem offenen ROCm-Stack, inzwischen bei ROCm 10.0, mit vLLM und SGLang fürs Serving.
Vorteile: mehr HBM pro GPU als das NVIDIA-Pendant, ein offener Software-Stack, echte Rack-Scale-Optionen und kein Lock-in durch proprietäre Fabric. Nachteile: ROCm hat viel aufgeholt, aber der ehrliche Kritikpunkt bleibt die Reife des Ökosystems im Vergleich zu CUDA, und einige der stärksten Spezifikationen gehören zur noch nicht ausgelieferten MI400-Generation.
Preise und Zugang: Kauf über OEMs oder MI300X in der AMD Developer Cloud über Partner wie DigitalOcean und Vultr testen. Fazit: die Standardwahl, wenn du Inferenz-Silizium besitzen, speicherhungrige Modelle betreiben und bei der Software flexibel bleiben willst. Es konkurriert über Kapazität und Offenheit, nicht darüber, der schnellste Einzelstream zu sein.
7. Intel Gaudi 3: Preis-Leistung und Standard-Ethernet
Am besten für: kostenbewusste Käufer, die einen leistungsfähigen Beschleuniger wollen und lieber über Standard-Ethernet statt über eine proprietäre Fabric skalieren.
Intels Gaudi 3 spielt die Preis-Karte, und seine Besonderheit ist das Netzwerk. Jeder Gaudi-3-Beschleuniger hat 24 Ports mit 200 GbE RoCE direkt auf der Karte, für 1.200 GB/s bidirektionale Bandbreite über Standard-Ethernet. Intels Formulierung ist unverblümt, was den Tausch angeht, den es dir anbieten will: „verriegelte, proprietäre Technologien wie NVLink, NVSwitch und InfiniBand“ vermeiden und die Netzwerkhardware nutzen, die du schon hast. Auf der Rechenseite bringt er 128 GB HBM mit 3,7 TB/s und 1,8 PFLOPS FP8.
Gut zu wissen für die Roadmap: Gaudi 3 ist spät in seiner Produktlinie. Intels erklärter künftiger Inferenz-Chip ist eine neue GPU, „Crescent Island“, gebaut auf der Xe3P-Architektur mit 160 GB LPDDR5X und Luftkühlung, mit Kunden-Sampling in der zweiten Hälfte 2026. Wenn du Gaudi 3 heute kaufst, kauf ihn also wegen des Preis-Leistungs-Verhältnisses jetzt und nicht wegen einer langen Roadmap.
Vorteile: aggressive Preispositionierung, großer HBM pro Karte und Standard-Ethernet, das proprietären Interconnect-Lock-in umgeht. Nachteile: Er konkurriert über Kosten statt über reine Geschwindigkeit, und die Roadmap wechselt klar zu einer anderen Chip-Linie, also ist es ein Value-Kauf, keine langfristige Wette.
Preise und Zugang: Kauf über OEMs wie Dell, HPE und Supermicro oder Nutzung auf der IBM Cloud, die ihn mit dem Slogan „halbe Kosten“ bewirbt. Fazit: eine vernünftige Wahl, wenn das Budget knapp ist und dein Rechenzentrum Ethernet-nativ ist. Geh nur mit dem Wissen hinein, dass Crescent Island Intels echte Inferenz-Zukunft ist.
8. d-Matrix Corsair: der Spezialist mit der Wette auf Speicher
Am besten für: latenzbesessene Teams, die eigene Hardware betreiben können und früh auf eine speziell gebaute Inferenz-Architektur wetten wollen.
d-Matrix ist der Wildcard-Kandidat und zielt auf genau das Problem, das LPX angeht: Token-Generierung mit extrem niedriger Latenz und kleinen Batches für agentische und Reasoning-Workloads. Die Corsair-Karte nutzt Digital In-Memory Compute und platziert die Berechnung direkt neben dem On-Chip-SRAM, um die Speichermauer zu umgehen. Die Kennzahlen sind auffällig: 60.000 Tokens pro Sekunde bei 1 ms pro Token für Llama3 8B in einem einzelnen Server und 30.000 Tokens pro Sekunde bei 2 ms für Llama3 70B in einem Rack, wobei d-Matrix etwa die zehnfache interaktive Geschwindigkeit und bis zu fünffache Energieeffizienz gegenüber einer H100 beansprucht (eigene Projektionen).
Corsair ging im Juni 2026 in volle Produktion, und das Unternehmen sammelte im November 2025 eine Series C über 275 Millionen $ ein (berichtet bei einer Bewertung von rund 2 Milliarden $), mit Geldgebern wie Microsofts M12 und Temasek.
Vorteile: eine von Grund auf für Inferenz mit niedriger Latenz entworfene Architektur, starke Effizienzangaben und ernsthafte Finanzierung dahinter. Nachteile: nur Hardware ohne öffentliche API, die Zahlen sind Herstellerprojektionen statt unabhängiger Tests, und eine Wette auf das Silizium eines Startups ist ein anderes Risiko als die Miete bei einem Hyperscaler.
Preise und Zugang: Kauf der Karten, Server oder SquadRack-Systeme; es gibt keinen Self-Service-Cloud-Endpunkt. Fazit: der interessanteste Außenseiter dieser Liste. Wenn du das Team hast, Silizium aufzubauen, und früh bei In-Memory-Compute dabei sein willst, lohnt sich ein ernsthafter Blick. Für alle anderen: eins zum Beobachten.
Der eigentliche Unterschied zwischen diesen Chips ist die Speicherwette
Wenn du dich vom Marketing löst, sortieren sich die acht Alternativen anhand einer Entscheidung in drei Lager: wie sie mit Speicher umgehen. Diese eine Wahl erklärt die meisten Unterschiede in den Datenblättern, die du gerade gelesen hast.
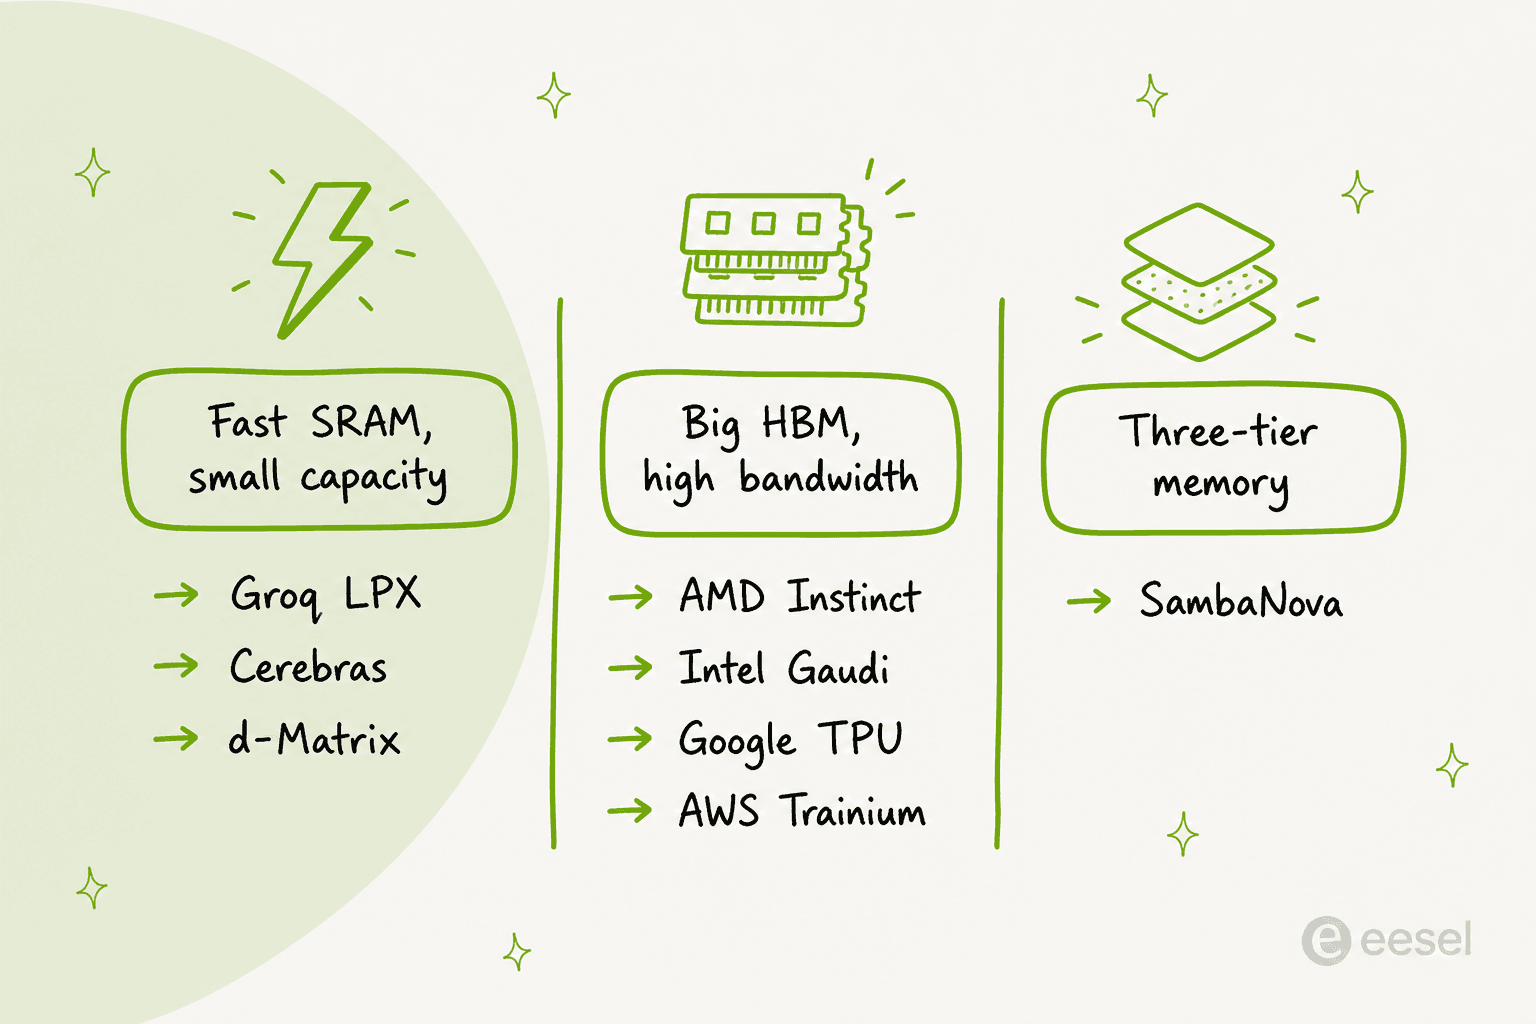
- Schneller SRAM, kleine Kapazität. Groq, Cerebras und d-Matrix halten die Arbeitsdaten im ultraschnellen On-Chip-SRAM. Das lässt die Token-Generierung sofort wirken, aber jeder Chip fasst sehr wenig, du brauchst also viele davon für ein großes Modell.
- Großer HBM, hohe Bandbreite. AMD, Intel, Google und AWS laden pro Beschleuniger viel High-Bandwidth-Memory auf. So passen ein großes Modell und ein langer KV-Cache auf weniger Chips, weshalb AMD so stark auf seinen Vorteil beim Speicher pro GPU setzt.
- Dreistufiger Speicher. SambaNova liegt mit SRAM, HBM und DDR5 dazwischen, kann also viele große Modelle im Speicher halten und schnell zwischen ihnen wechseln, eine Eigenschaft, die Agenten-Workloads belohnen.
Es gibt hier keine universell richtige Antwort. Wenn dein Workload schneller Chat auf einem kleinen Modell ist, gewinnt das SRAM-Lager. Wenn es ein riesiges Modell oder ein Multi-Modell-Agent ist, gewinnt die Kapazität. Zu benennen, in welchem Lager du bist, sagt dir schneller als jeder Benchmark, welche der acht du auf die Shortlist setzen solltest.
Die größere Frage: Du kaufst wahrscheinlich kein Rack
Das ist der Teil, bei dem ich am ehrlichsten sein möchte, weil man sich leicht in Petaflops verliert. Wenn du keine Cloud oder keine sehr große KI-Plattform betreibst, wirst du weder Groq 3 LPX noch die meisten seiner Alternativen kaufen. Das ist Infrastruktur, die mehrere Schichten unter dem liegt, wo die Arbeit tatsächlich passiert. Du spürst sie als schnellere, günstigere Tokens in den Modell-APIs und Clouds, die du ohnehin nutzt, genauso wie du nie eine GPU gekauft hast, um einen KI-Agenten zu nutzen.
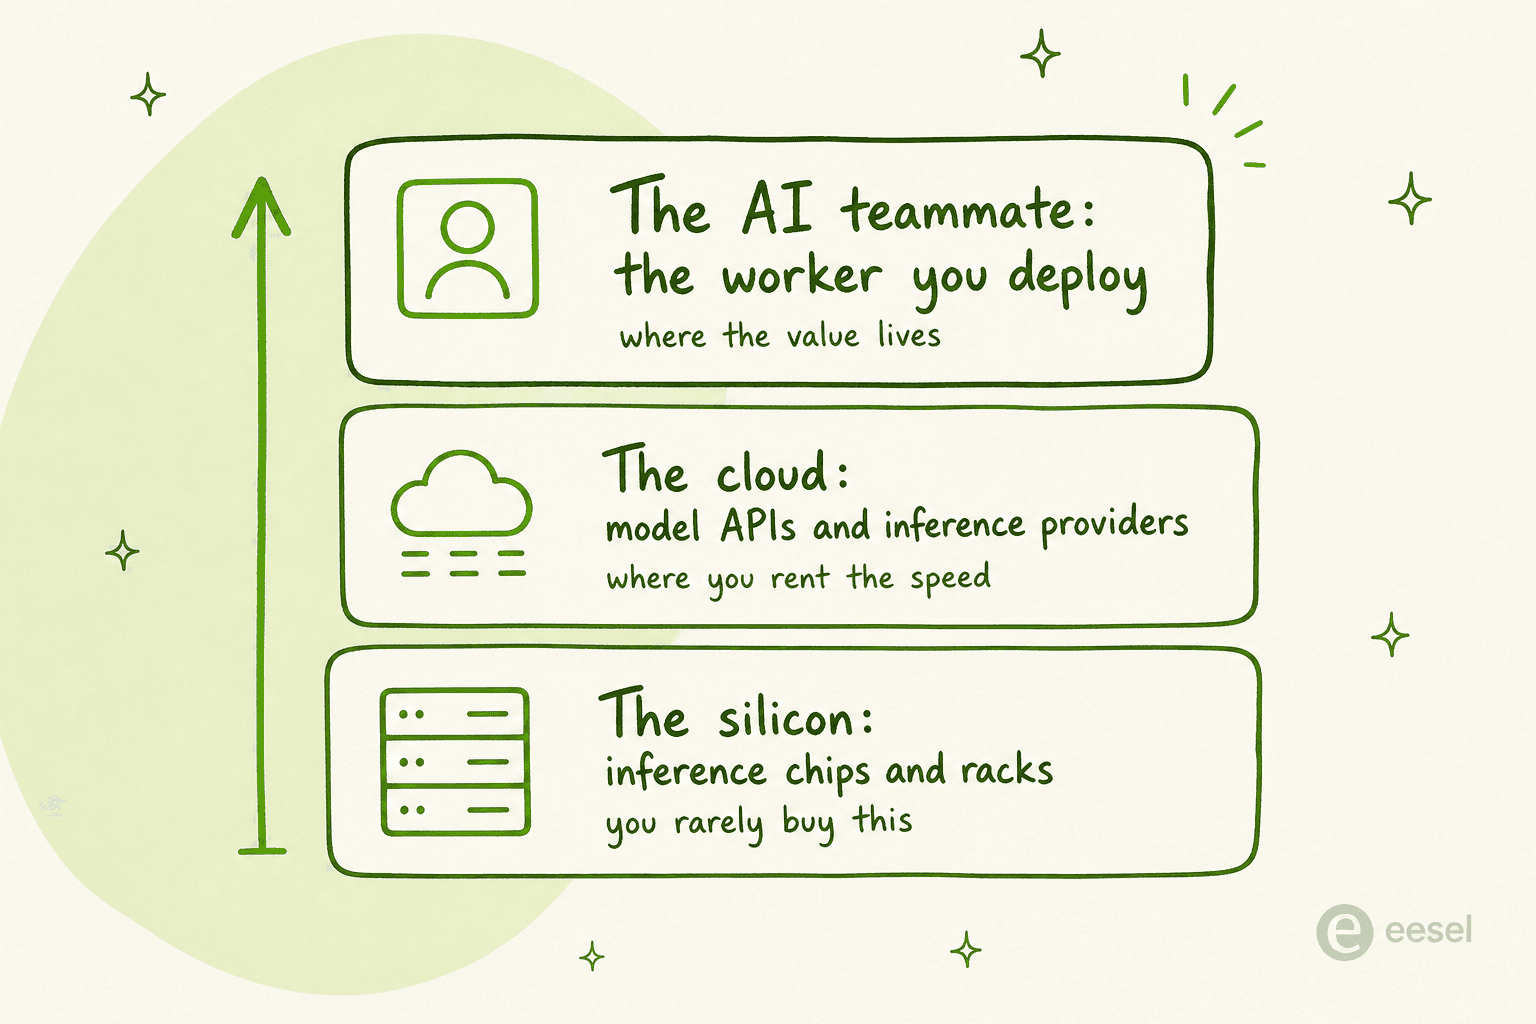
Und genau diese Verschiebung bei den Workloads ist der Grund, warum es all dieses Silizium überhaupt gibt. Wie ein Analyst auf X sagte:
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
Die nützliche Neubetrachtung ist, dass der Chip der Motor ist und das, was du tatsächlich einsetzt, der Arbeiter obendrauf. Schnellere Inferenz macht Agenten flotter und günstiger im Betrieb, senkt die Hürde, echte Automatisierung in Produktion zu bringen, und verschiebt die Kostenrechnung gegen die Handarbeit, ob das nun ein Coding-Agent, ein Recherche-Agent oder ein KI-Helpdesk-Agent ist, der deine Support-Warteschlange abarbeitet. Beim Hardware-Rennen geht es darum, diese Schicht im großen Maßstab tragfähig zu machen. Der Wert liegt weiterhin in der Schicht. Wenn du verstehen willst, warum Latenz überhaupt so empfindlich ist, haben wir uns separat mit LLM-Inferenzkosten beschäftigt.
Wo eesel hineinpasst, und warum es egal ist, welchen Chip du gewählt hast
Jeder Chip auf dieser Liste ist Rohrleitung. eesel ist das, was du einstellst, um darauf die eigentliche Arbeit zu erledigen. eesel ist eine Plattform für KI-Teammitglieder: Statt Inferenz bereitzustellen oder eine Pipeline zu verdrahten, holst du ein einsatzbereites Teammitglied für eine bestimmte Rolle an Bord und verbindest es mit deinen Apps. Das aktuelle Angebot umfasst ein KI-Helpdesk-Teammitglied, das deiner Support-Warteschlange als weit mehr als ein einfacher Support-Chatbot beitritt, und einen KI-Blog-Autor, der Inhalte wie diesen Beitrag erstellt.

Der Grund, warum die Chipwahl dich nicht wirklich betrifft, ist, dass eesel auf jeder Inferenz-Infrastruktur darunter läuft, und was entscheidet, ob es gut ist, sind nicht Tokens pro Sekunde. Es ist Genauigkeit. Die Jahre, in denen wir KI auf echten Support-Warteschlangen betrieben haben, haben uns die unglamouröse Hälfte beigebracht: Ein Support-Teammitglied, das in einer Sekunde statt in acht antwortet, ist für den wartenden Kunden das ganze Erlebnis, aber Geschwindigkeit hilft nur, wenn die Antwort stimmt. Das ist der Unterschied zwischen einem Agenten, der Tier-1-Tickets tatsächlich abfängt, und einem, der Leute nur frustriert, weshalb eesel einen Rollout an deinen früheren Tickets simuliert, bevor es je einem Live-Kunden antwortet. Alles Silizium der Welt behebt keine selbstbewusste falsche Antwort. Wenn du das Teammitglied lieber einsetzen willst, als ein Rack zu suchen, kannst du eesel kostenlos testen.