

Groq 3 LPX ist NVIDIAs neuer Inferenz-Beschleuniger im Rack-Maßstab für die Vera-Rubin-Plattform und ging am 24. August 2026 in die Serienproduktion. Jedes Rack bündelt 256 Groq-3-LPU-Chips, die neben Vera-Rubin-NVL72-GPUs arbeiten. Die GPUs übernehmen die speicherintensive Kontextarbeit, die LPUs die latenzempfindliche Aufgabe, Token schnell zu erzeugen. Der Sinn der Aufteilung: Agentische KI soll sich schnell anfühlen, ohne Durchsatz zu opfern.
Der Name ist absichtlich verwirrend. NVIDIA hat Groqs LPU-Technologie lizenziert (nicht exklusiv) und den Gründer sowie wichtige Teammitglieder eingestellt. Es ist also ein NVIDIA-Produkt auf Basis von Groqs Design, das den Namen Groq unter Lizenz trägt. Das Unternehmen Groq ist weiterhin unabhängig, und GroqCloud läuft weiter.
Zu den Kennzahlen: NVIDIA nennt 3.400 Token pro Sekunde bei Gemma 4 31B mit 100K Kontext sowie einen prognostizierten 35-fachen Durchsatz pro Megawatt und 10-fachen Umsatz pro Watt gegenüber der letzten Generation. Das sind Herstellerangaben, gemessen an NVIDIAs eigenen Vergleichswerten. Lies sie also als Zielwert, nicht als unabhängig getestetes Ergebnis. Wenn du Agenten baust oder Support automatisierst, ist die praktische Erkenntnis einfacher: Du wirst dieses Rack mit ziemlicher Sicherheit nicht kaufen, sondern die damit mögliche Geschwindigkeit über ein Modell oder eine Cloud nutzen. Und was du tatsächlich einsetzt, ist ein Teamkollege wie eesel, der darüber sitzt.
Was Groq 3 LPX eigentlich ist
NVIDIA beschreibt Groq 3 LPX als "den interaktiven KI-Inferenz-Beschleuniger für NVIDIA Vera Rubin". Einfacher gesagt: Es ist ein ganzes Rack aus spezialisierten Chips, deren einzige Aufgabe es ist, Token schnell zu erzeugen. Es fügt sich neben den Allzweck-GPUs in NVIDIAs neueste Rechenzentrumsplattform ein.
NVIDIA argumentiert mit einem klassischen Dreiklang-Zielkonflikt. Jahrelang boten Inferenz-Hardware immer nur zwei von drei Eigenschaften: Intelligenz plus Durchsatz oder Intelligenz plus Interaktivität, aber nie alle drei zu geringen Kosten. Große Modelle sind träge im Dialog, schnelle Modelle sind klein. Groq 3 LPX soll es einem großen Modell ermöglichen, reaktionsschnell zu bleiben, indem der latenzempfindliche Teil jedes Tokens an einen Chip übergeben wird, der genau dafür gebaut ist.
Man sollte genau sagen, was es nicht ist. Es ist kein eigenständiges Produkt, das man in beliebige Server steckt, und kein Ersatz für die GPU. Es ist eine gemeinsam entworfene Erweiterung von Vera Rubin NVL72, die neben Rubin-GPUs läuft. Beide berechnen gemeinsam jede Schicht des Modells für jedes Ausgabe-Token. NVIDIA nennt die LPU sogar "den siebten Chip" der Vera-Rubin-Plattform.
Moment, ist das das Startup Groq?
Das ist die häufigste Reaktion, die ich gesehen habe, und sie ist berechtigt. Groq war jahrelang das aufstrebende Inferenz-Startup, dessen LPU das Gegenbeispiel zu "nimm einfach mehr GPUs" war. Jetzt ist "Groq 3 LPX" eine NVIDIA-Produktlinie. Eine Person auf X fasste die Stimmung gut zusammen:
"so groq the company is now also an nvidia product line, that's going to confuse people for months"
Hier die korrekte Fassung direkt aus den Primärquellen. Groq hat mit NVIDIA eine nicht exklusive Lizenzvereinbarung für seine Inferenz-Technologie geschlossen, dieselbe Technik, die hinter GroqClouds Preisen und seinen Groq-Alternativen steckt. Im Zuge dessen wechselten Gründer Jonathan Ross und weitere Groq-Teammitglieder zu NVIDIA, um das lizenzierte Design zu skalieren. Groq bleibt unter einem neuen CEO, Simon Edwards, unabhängig, und GroqCloud wird weiter betrieben. Auf NVIDIAs eigener Pressseite steht der Hinweis, dass "Groq and LPU are used under license from Groq, Inc."
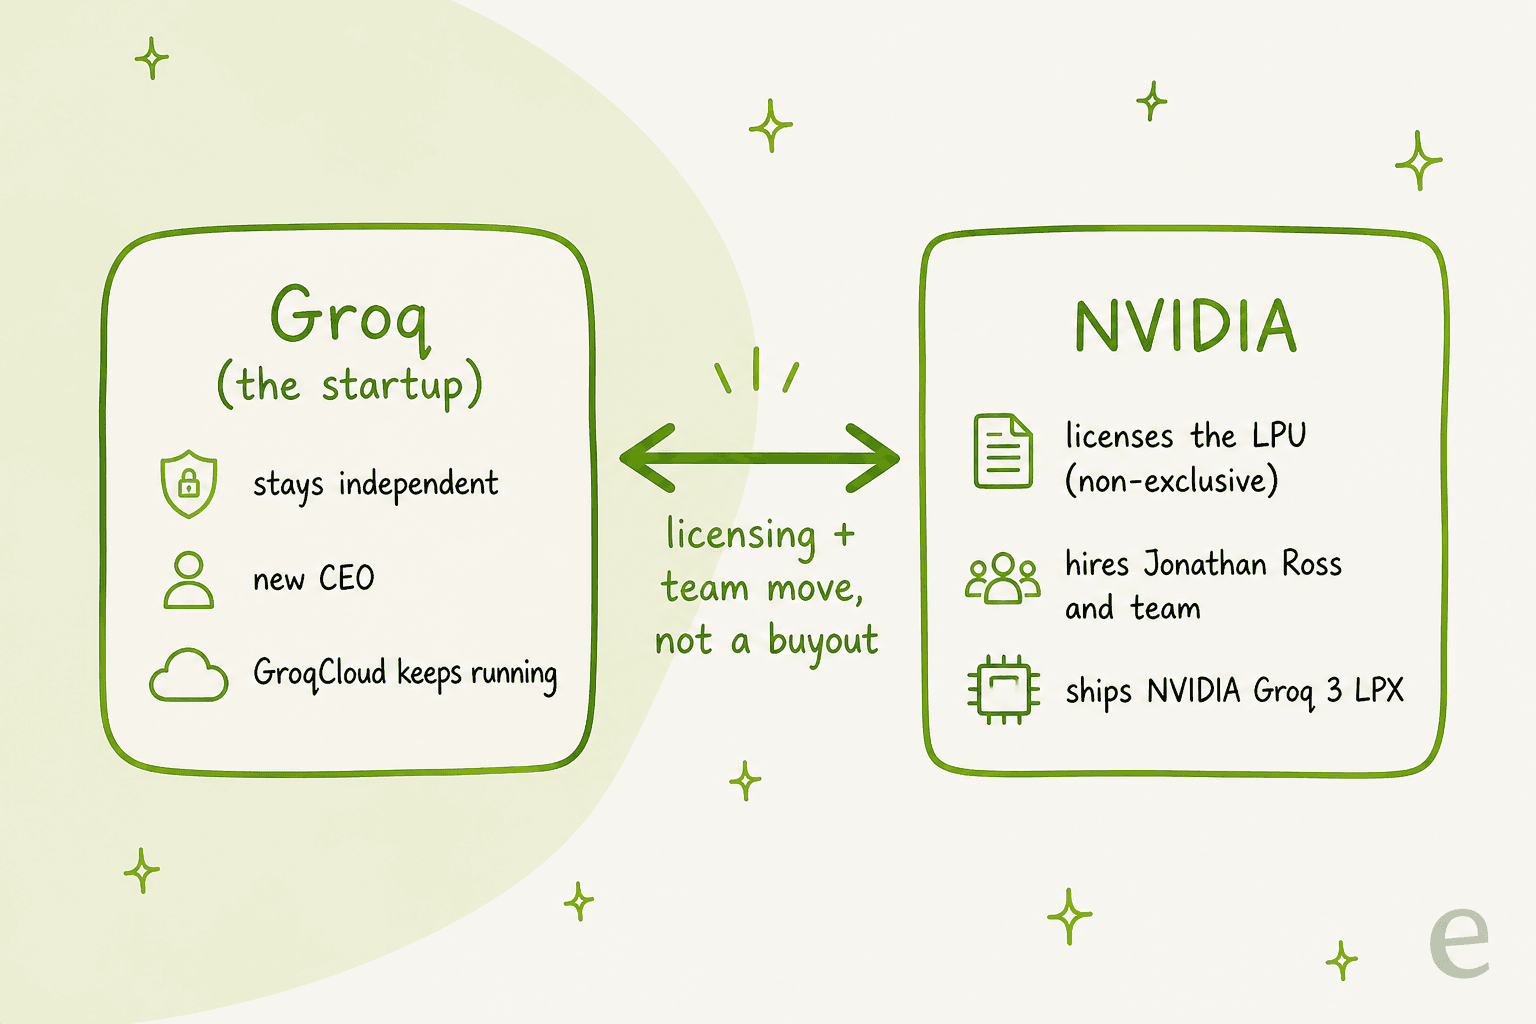
Wenn du also "NVIDIA Groq 3 LPX" liest, denk an eine Lizenz und eine Teameinstellung, nicht an eine klare Übernahme. In der Presse kursieren hohe Summen für den Deal, aber diese Zahlen tauchen in keiner der beiden Unternehmensmitteilungen auf, deshalb lasse ich sie weg. Was die Primärquellen belegen, ist die oben beschriebene Struktur, und auf die kommt es für das Verständnis des Produkts an.
Das Ganze in einem Rack
Die technischen Daten sind der spannende Teil, denn sie sind wirklich ungewöhnlich. Das nennt NVIDIA für ein einzelnes Groq 3 LPX Rack.
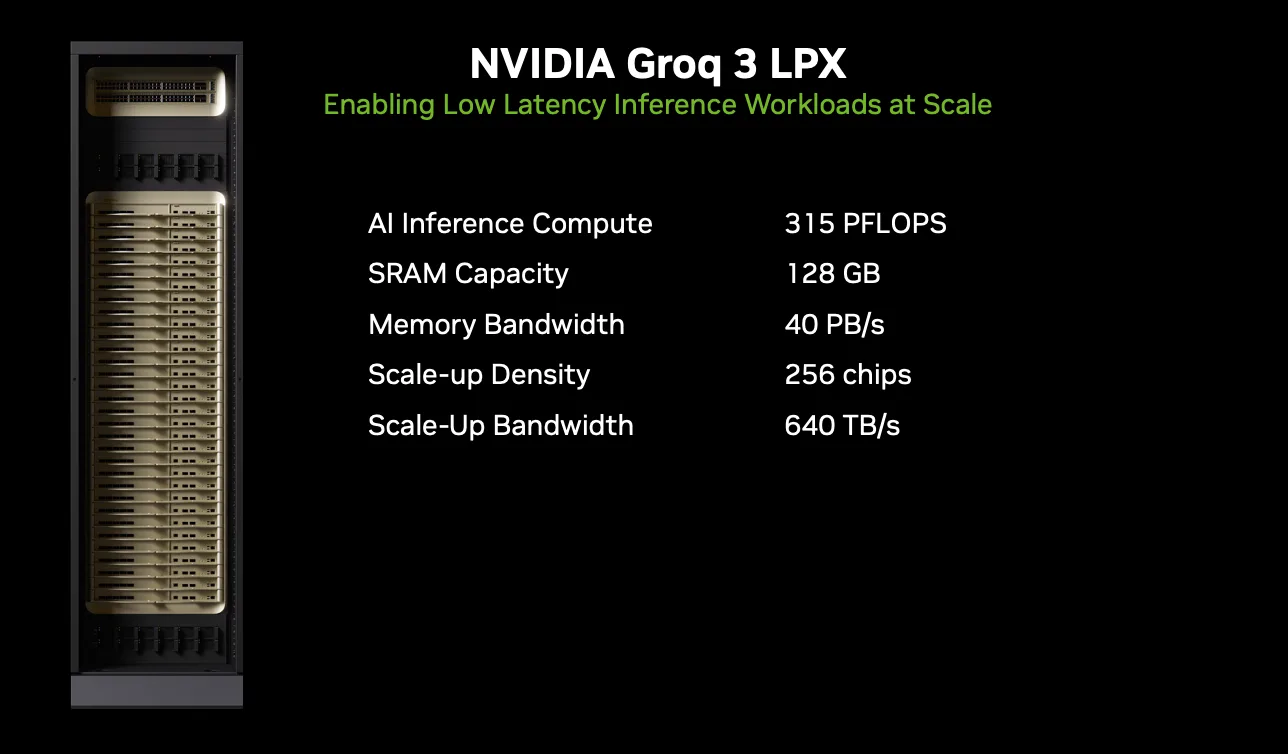
| Daten auf Rack-Ebene | NVIDIA Groq 3 LPX |
|---|---|
| Chips pro Rack | 256 Groq-3-LPU-Beschleuniger |
| KI-Inferenz-Rechenleistung | 315 PFLOPS (FP8) |
| Gesamte SRAM-Kapazität | 128 GB |
| On-Chip-SRAM-Bandbreite | 40 PB/s |
| Scale-up-Bandbreite | 640 TB/s |
| Aufbau | 32 flüssigkeitsgekühlte 1U-Compute-Trays mit je 8 LPUs |
Die Zahl, die ins Auge springt, sind 40 Petabyte pro Sekunde On-Chip-SRAM-Bandbreite. Das ist kein Tippfehler, und es ist die gesamte Designthese in einer Zahl. Statt Chips aus langsamerem externem Speicher zu füttern, hält die LPU die Arbeitsdaten auf dem Chip und bewegt sie mit einer Bandbreite, an die ein herkömmlicher Speicheraufbau nicht heranreicht. Der Preis dafür ist die Kapazität: 128 GB SRAM in einem Rack sind winzig im Vergleich zu den Terabytes an HBM eines GPU-Racks. Genau deshalb brauchen die LPUs die GPUs an ihrer Seite.
Warum einen ganz neuen Chip bauen?
Um zu verstehen, warum sich NVIDIA die Mühe macht, hilft es, die beiden Chips nebeneinander zu stellen. NVIDIAs eigenes Diagramm zeigt das übersichtlich.
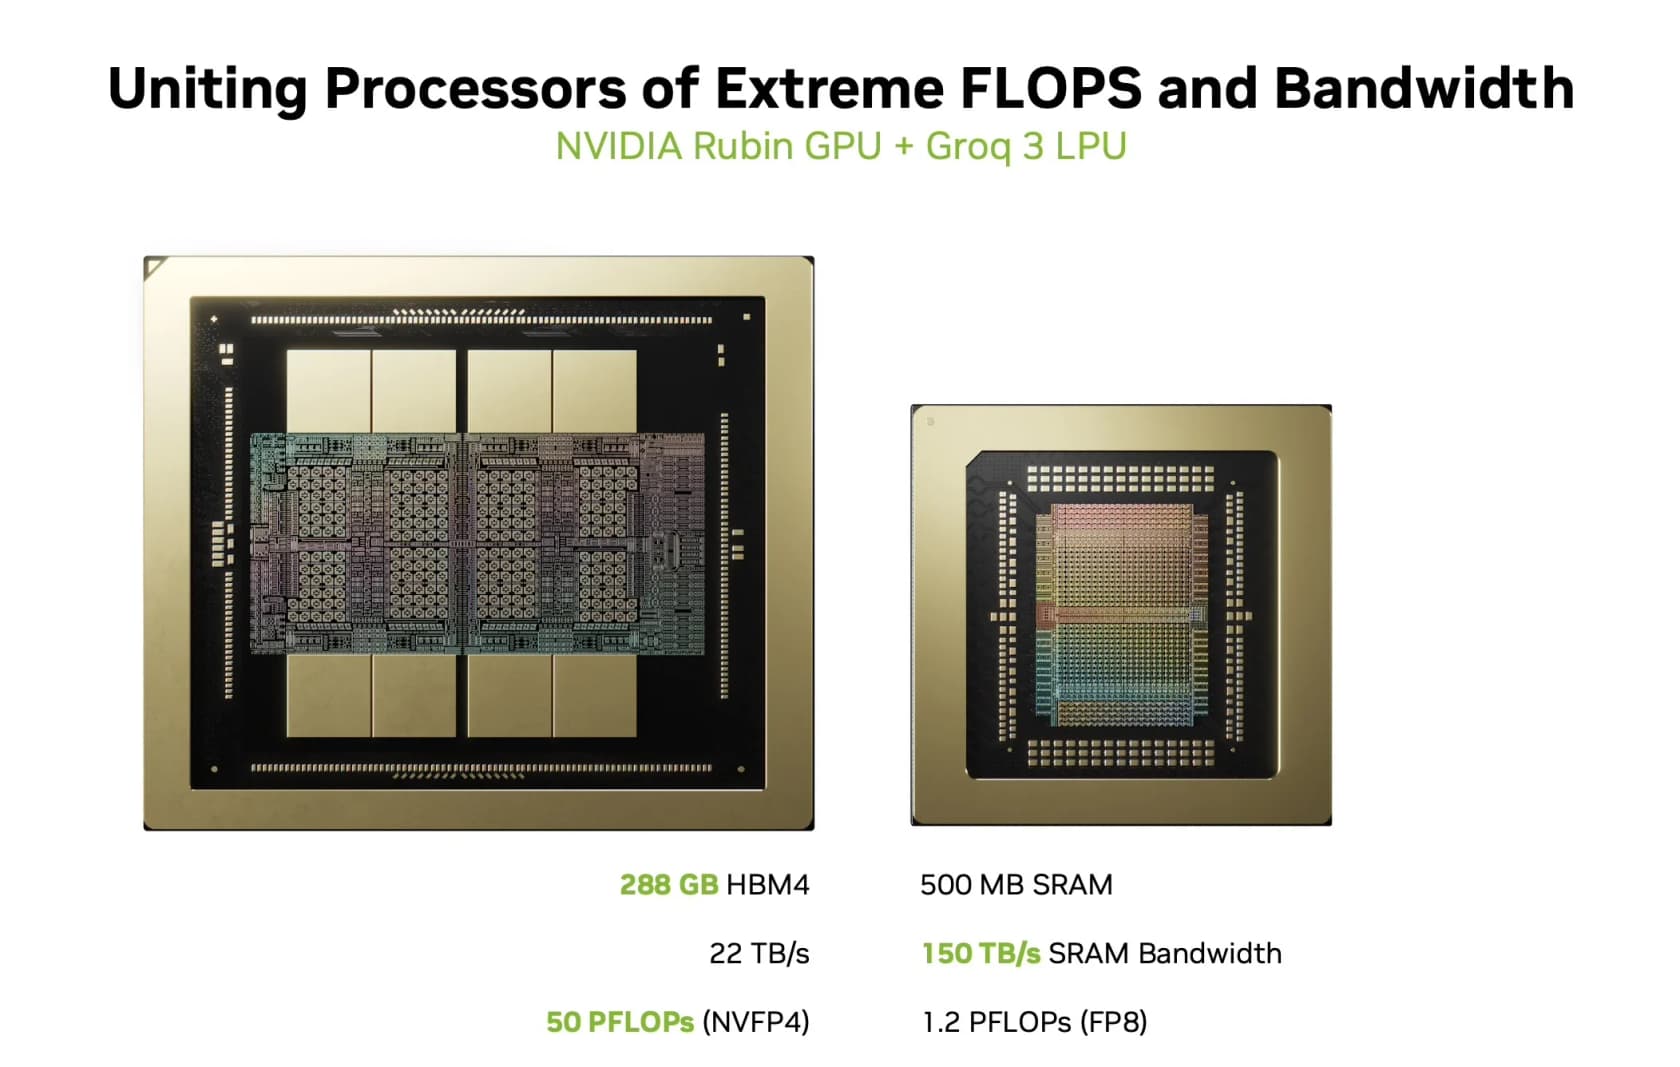
Eine Rubin-GPU bringt rund 288 GB HBM4, etwa 22 TB/s Speicherbandbreite und etwa 50 PFLOPs Rechenleistung mit. Eine einzelne Groq-3-LPU bringt 500 MB SRAM, aber mit 150 TB/s Bandbreite und 1,2 PFLOPs FP8-Rechenleistung. Die GPU ist ein Arbeitstier, optimiert auf Spitzendurchsatz und großen Speicher. Die LPU ist auf eines optimiert: einen Strom von Token mit vorhersehbarer, niedriger Latenz am Laufen zu halten.
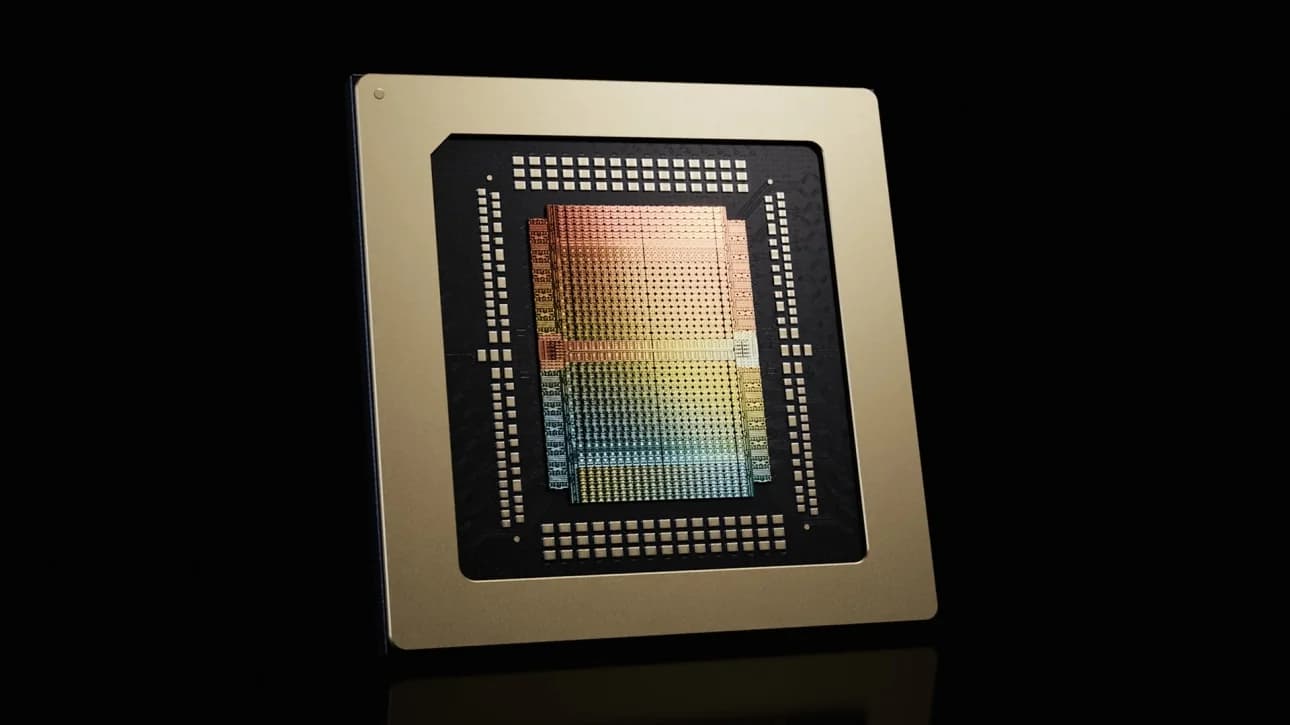
Die Designentscheidungen unter der Haube machen die LPU anders als eine GPU. Ich finde sie spannend, weil sie einiges umkehren, was GPU-Programmierer für selbstverständlich halten:
- SRAM ist der Hauptspeicher, kein Cache. Jede LPU hat 500 MB On-Chip-SRAM, der die aktiven Gewichte, Aktivierungen und den KV-Zustand direkt hält. Auf dem Chip gibt es überhaupt keinen HBM.
- Keine hardwareverwalteten Caches. Compiler und Laufzeitumgebung platzieren und bewegen Daten explizit, statt sich auf Cache-Heuristiken zu verlassen. Das verringert unvorhersehbare Aussetzer und hält die Latenz stabil.
- Deterministische, vom Compiler geplante Ausführung. Der Chip baut auf Groqs räumlichem Ausführungsmodell auf, bei dem Berechnung, Datenbewegung und Synchronisation im Voraus eingeplant werden. NVIDIA beschreibt ein Hardware-Protokoll, das Taktdrift aufhebt, sodass Hunderte LPUs als ein koordiniertes System arbeiten.
- Explizite, tensorzentrierte Datenbewegung. Alles arbeitet mit Vektoren fester Größe von 320 Byte über dedizierte Matrix-, Vektor- und Switch-Einheiten, sodass die Planung vorhersehbar bleibt.
Wenn du schon einmal darüber nachgedacht hast, warum LLM-Inferenzkosten so empfindlich auf Latenz reagieren, ist das die Hardware-Antwort darauf: einen Chip bauen, dessen Timing bekannt ist, und dann Hunderte davon verbinden, ohne diese Eigenschaft zu verlieren.
Wie es tatsächlich funktioniert: eine Schleife mit zwei Engines
Hier macht es klick. NVIDIAs Erkenntnis ist, dass Inferenz keine einheitliche Arbeitslast ist. Eine Anfrage hat zwei sehr verschiedene Phasen, und sie wollen unterschiedliche Hardware.
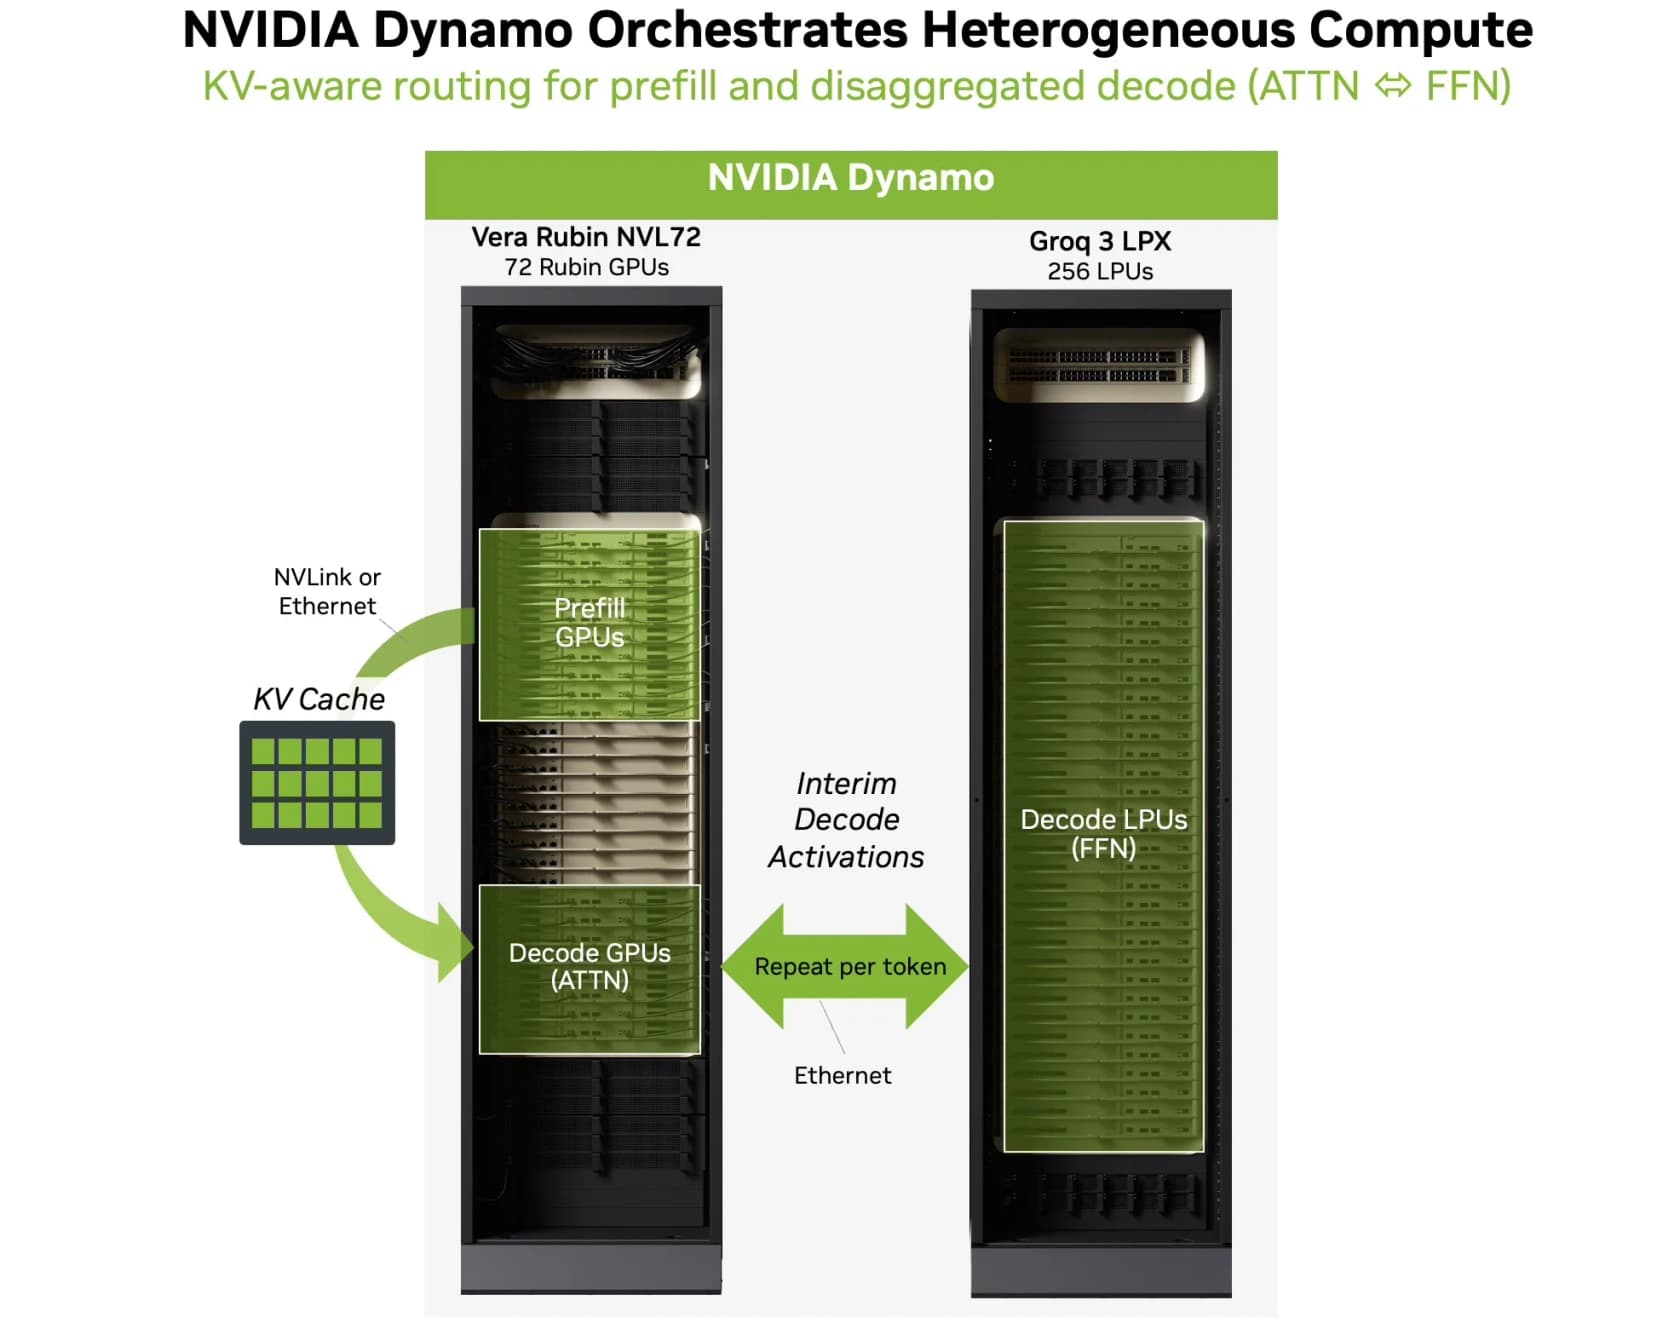
Die erste Phase, Prefill, nimmt deinen Prompt auf und baut den KV-Cache auf. Das ist dichte, parallele, speicherhungrige Arbeit und passt gut zur GPU. Die zweite Phase, Decode, erzeugt die Antwort Token für Token in einer Schleife. NVIDIA teilt diese Schleife auf beide Chips auf, mit einer Technik namens Attention-FFN-Disaggregation: Die Rubin-GPUs berechnen Attention über den angesammelten Kontext, und Groq 3 LPX übernimmt die Feed-Forward- und Mixture-of-Experts-Berechnungen, die am latenzempfindlichsten sind. Für jedes einzelne Token tauschen beide Zwischenaktivierungen aus.
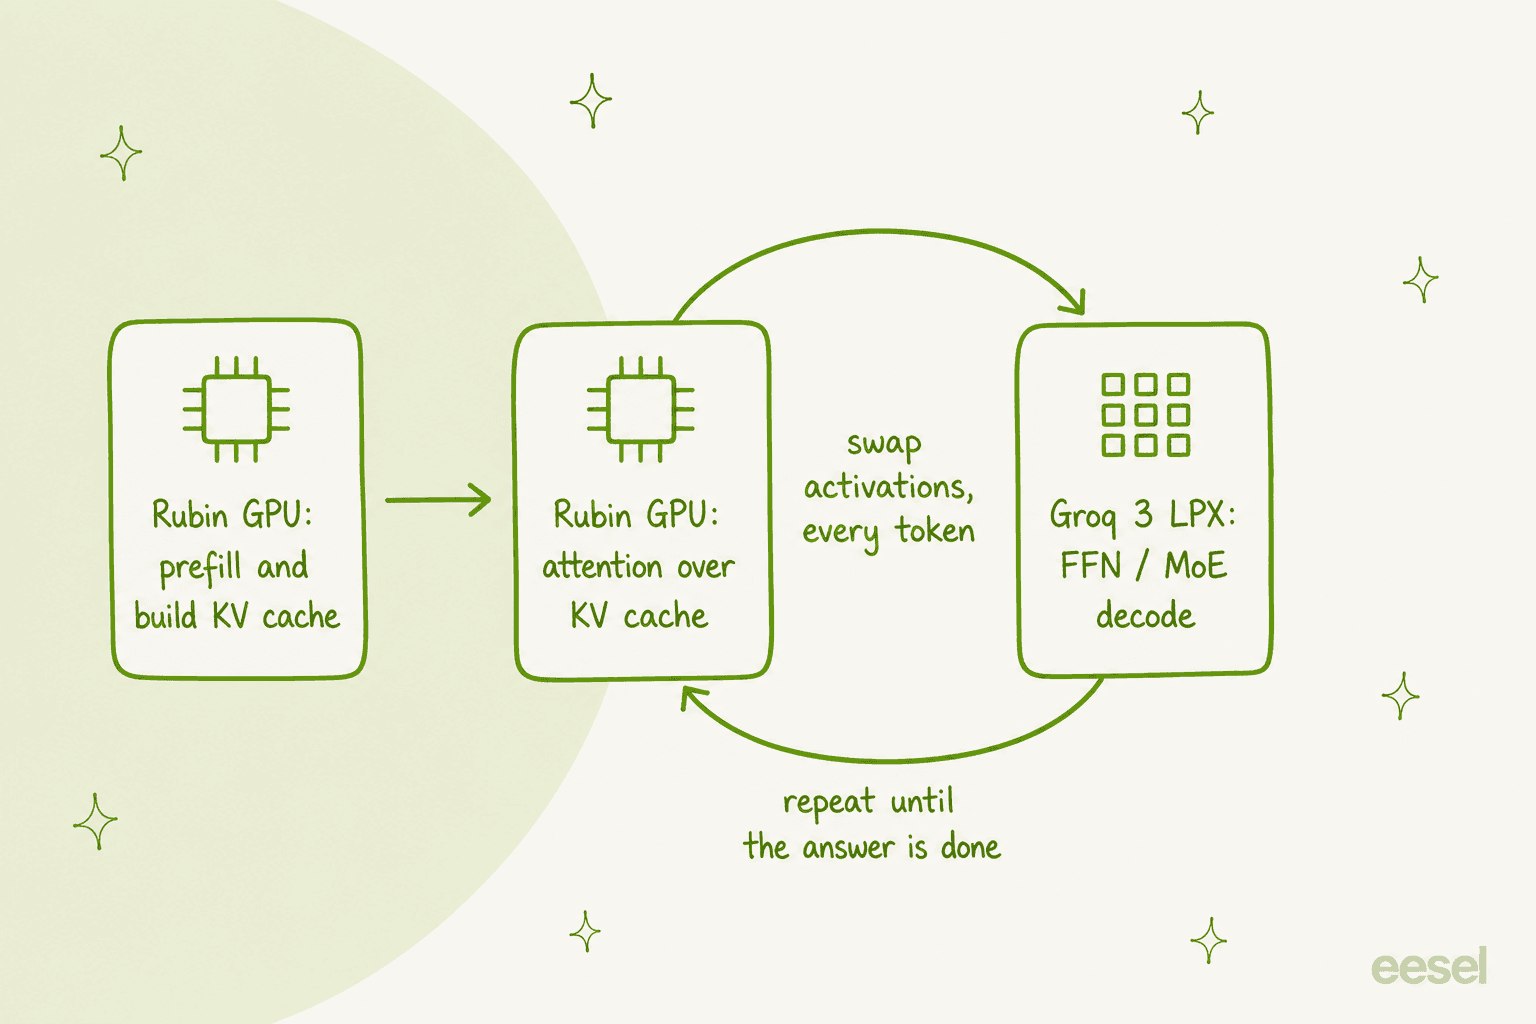
Den Verkehr regelt NVIDIA Dynamo, die Orchestrierungsschicht. Sie leitet Prefill an GPU-Worker, bewegt die Aktivierungen pro Token zwischen den Engines und plant alles gegen Latenzziele, damit eine interaktive Sitzung nicht hinter einem Batch-Job hängen bleibt.
LPX hat noch eine weitere Rolle: Es dient als Draft-Engine für spekulatives Decoding. Dank deterministischer Ausführung und enormer SRAM-Bandbreite erzeugt es schnell Entwurfs-Token und läuft der GPU voraus, die sie verifiziert. Auch so teilen sich die beiden Chips die Arbeit, statt sie doppelt zu erledigen.
Im Inneren des Racks
Wenn du sehen willst, wo die Teile physisch sitzen, ist NVIDIAs Diagramm des Compute-Trays der klarste Einblick. Ein Rack besteht aus 32 dieser flüssigkeitsgekühlten 1U-Trays, und jedes Tray enthält acht LPUs.
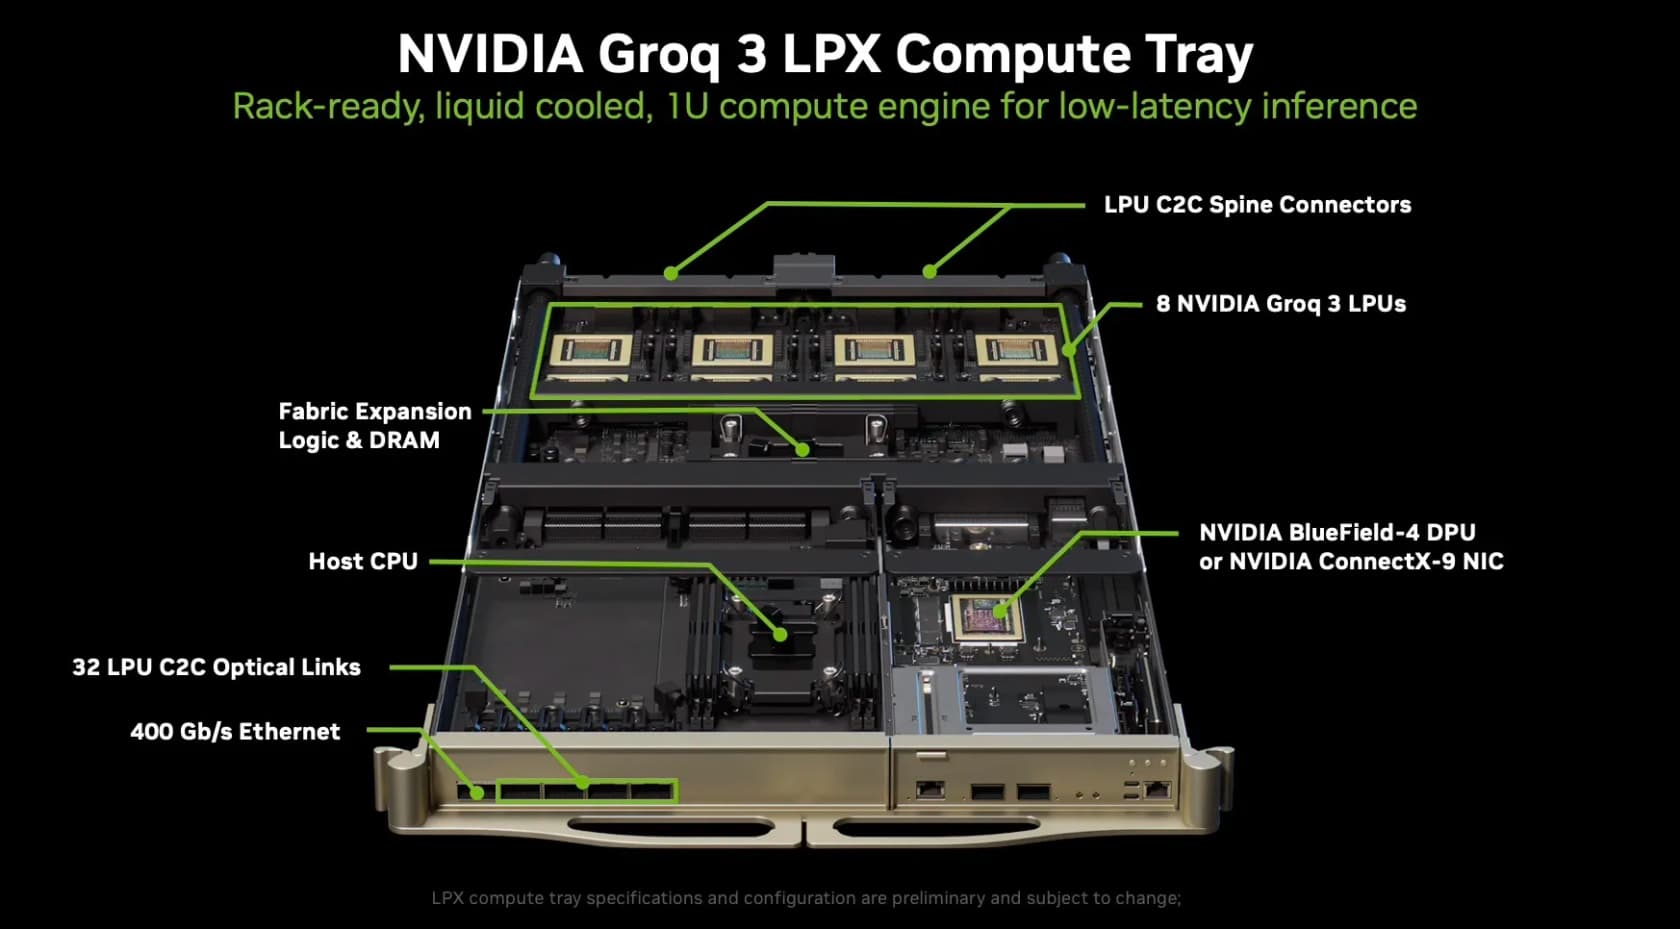
An diesem Aufbau fallen ein paar Dinge auf. Jede LPU ist über 96 Chip-zu-Chip-Verbindungen mit je 112 Gbps angebunden, zusammen 2,5 TB/s Scale-up-Bandbreite pro Chip, weshalb sich 256 davon wie eine einzige Maschine verhalten. Jedes Tray trägt außerdem eine BlueField-4-DPU und eine Host-CPU, und das Ganze ist kabellos und flüssigkeitsgekühlt. Es basiert auf NVIDIAs MGX-Rack-Architektur, sodass ein Rechenzentrum für seine Vera-Rubin-Installation eine gemeinsame Rack-Bauweise planen kann, statt eine Sonderlösung für den Inferenzpfad.
Die Leistungsangaben und wie man sie liest
Nun zu den Zahlen, die jeder zitiert. NVIDIAs Schlagzeile lautet: bis zu 35-fach höherer Durchsatz pro Megawatt für Modelle mit Billionen Parametern, wenn Vera Rubin NVL72 mit LPX kombiniert wird, im Vergleich zur vorherigen GB200-Generation, gemessen bei 400 Token pro Sekunde pro Nutzer. Außerdem prognostiziert NVIDIA bis zu 10-fach mehr Umsatz pro Watt für die latenzempfindlichsten Arbeitslasten. Am anschaulichsten ist NVIDIAs eigenes Pareto-Diagramm.
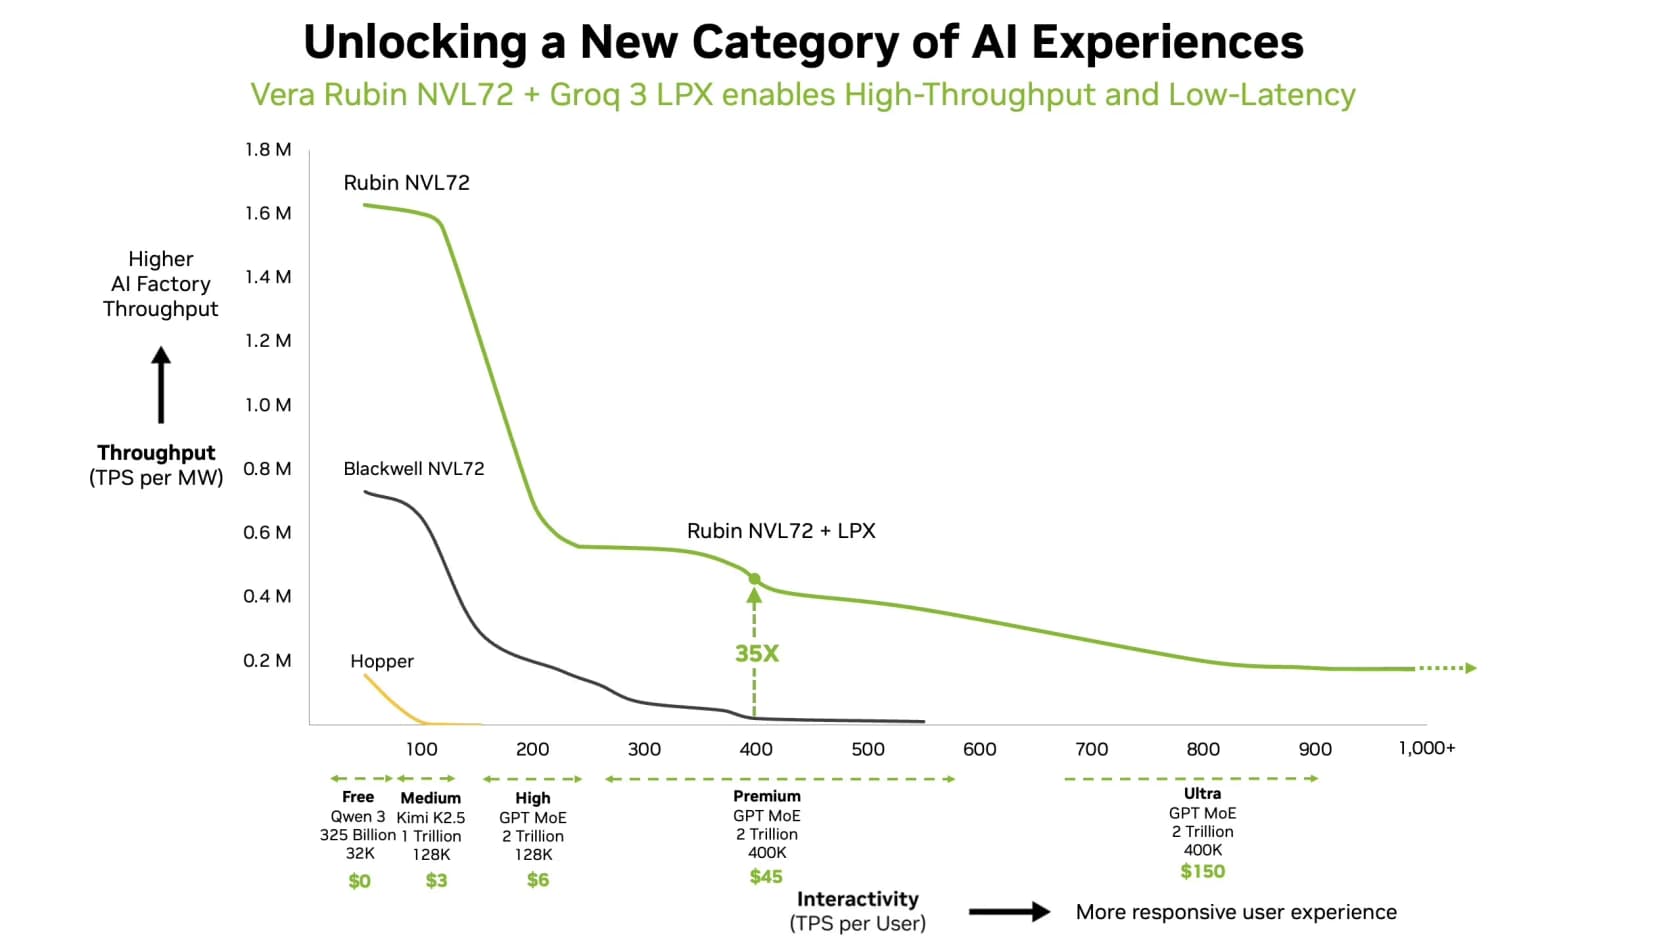
Liest man das Diagramm ehrlich, sagt es etwas Reales: Die Lücke zwischen der grünen Linie (Rubin plus LPX) und den älteren Systemen öffnet sich auf der rechten Seite dramatisch, wo jeder Nutzer Token schnell erhält. Bei geringer Interaktivität sehen alle ähnlich aus. Bei hoher Interaktivität bleibt der LPX-Pfad hoch, während die reinen GPU-Linien steil abfallen. Das ist die eigentliche Aussage, und sie ist schlüssig.
Der ehrliche Vorbehalt betrifft, wer gemessen hat. Es sind NVIDIAs Zahlen gegen NVIDIAs eigene Vergleichswerte, und das modellierte "Premium"-Szenario ist ein bestimmtes Modell mit 2 Billionen Parametern bei 400K Kontext. Der einzige halbwegs unabhängige Datenpunkt, den ich finden konnte, ist ein von NVIDIA zitierter Artificial-Analysis-Benchmark mit 3.400 Token pro Sekunde bei Gemma 4 31B und 100K Kontext. Das ist eine starke Zahl, aber fast die gesamte öffentliche Diskussion wiederholt bisher NVIDIAs Folien, statt die Hardware zu testen, denn Nebius ist erst die erste Cloud, die sie einsetzt. Auf Hacker News las einer der wenigen fundierten Beiträge sie vor dem Hintergrund von Groqs Erfolgsbilanz statt der Marketingaussagen:
"Gemma 31B dense at 3k TPS seems like a pretty big deal. Groq has always been more efficient than Cerebras at running very small models and this release seems to be no exception."

Mein Fazit: Die Architektur ist wirklich clever, der Benchmark vielversprechend, und die 35x sind eine Best-Case-Marketingzahl, die du lose halten solltest, bis Dritte sie nachgemessen haben.
Warum jetzt: Inferenz wurde zum teuren Teil
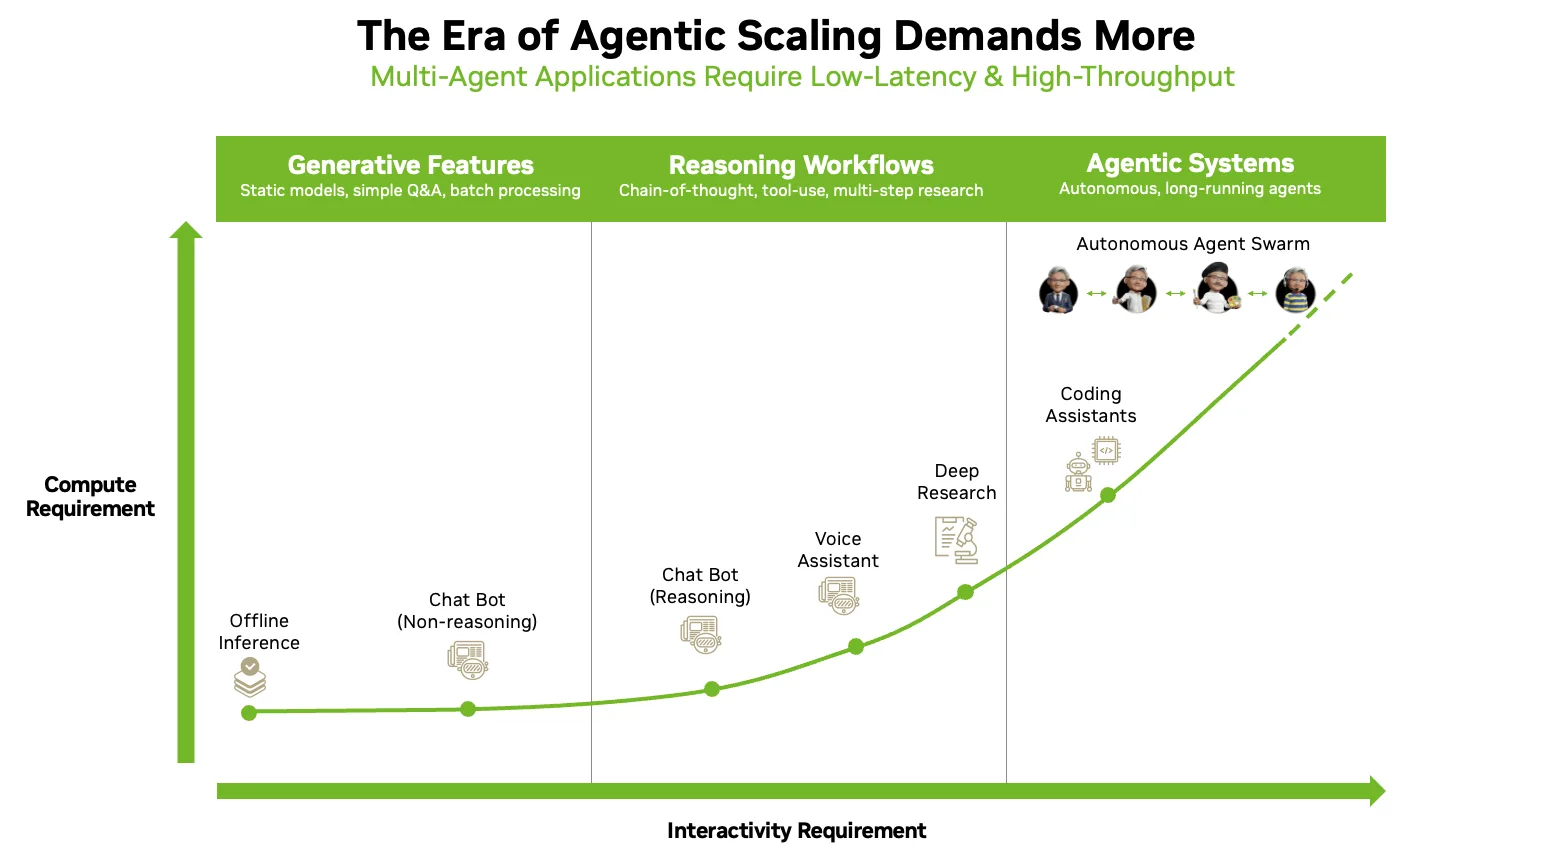
Ein Chip wie dieser existiert, weil sich die Form der KI-Arbeitslasten verändert hat. Als Inferenz meist eine einzelne Chatbot-Antwort war, spielte die Decode-Latenz kaum eine Rolle. Agentische Systeme haben das geändert. Sie erzeugen Token über Hunderte oder Tausende Schritte, und NVIDIA verweist auf Daten, wonach agentische Arbeitslasten etwa 15-mal mehr Token verbrauchen als eine einfache Chat-Anfrage. Jede kleine Verzögerung pro Token multipliziert sich nun über eine lange Kette.
Dieselbe Verschiebung sieht man daran, wohin das Geld des Marktes fließt. NVIDIAs Rechenzentrumsgeschäft reitet diese Welle kräftig: Das Unternehmen meldete für sein Quartal bis Ende Juli 2026 einen Umsatz von 96,2 Milliarden Dollar, ein Plus von 106 % gegenüber dem Vorjahr. Inferenz, nicht Training, ist jetzt der Wachstumsmotor, und ein Chip, der gezielt für latenzarme, mehrstufige Generierung gebaut wurde, ist eine direkte Wette darauf. Eine Analystenmeinung auf X brachte den strategischen Aspekt treffend auf den Punkt:
"Nvidia moving its Groq 3 LPX inference accelerator into full production signals a key shift from model training to continuous agentic AI workloads."
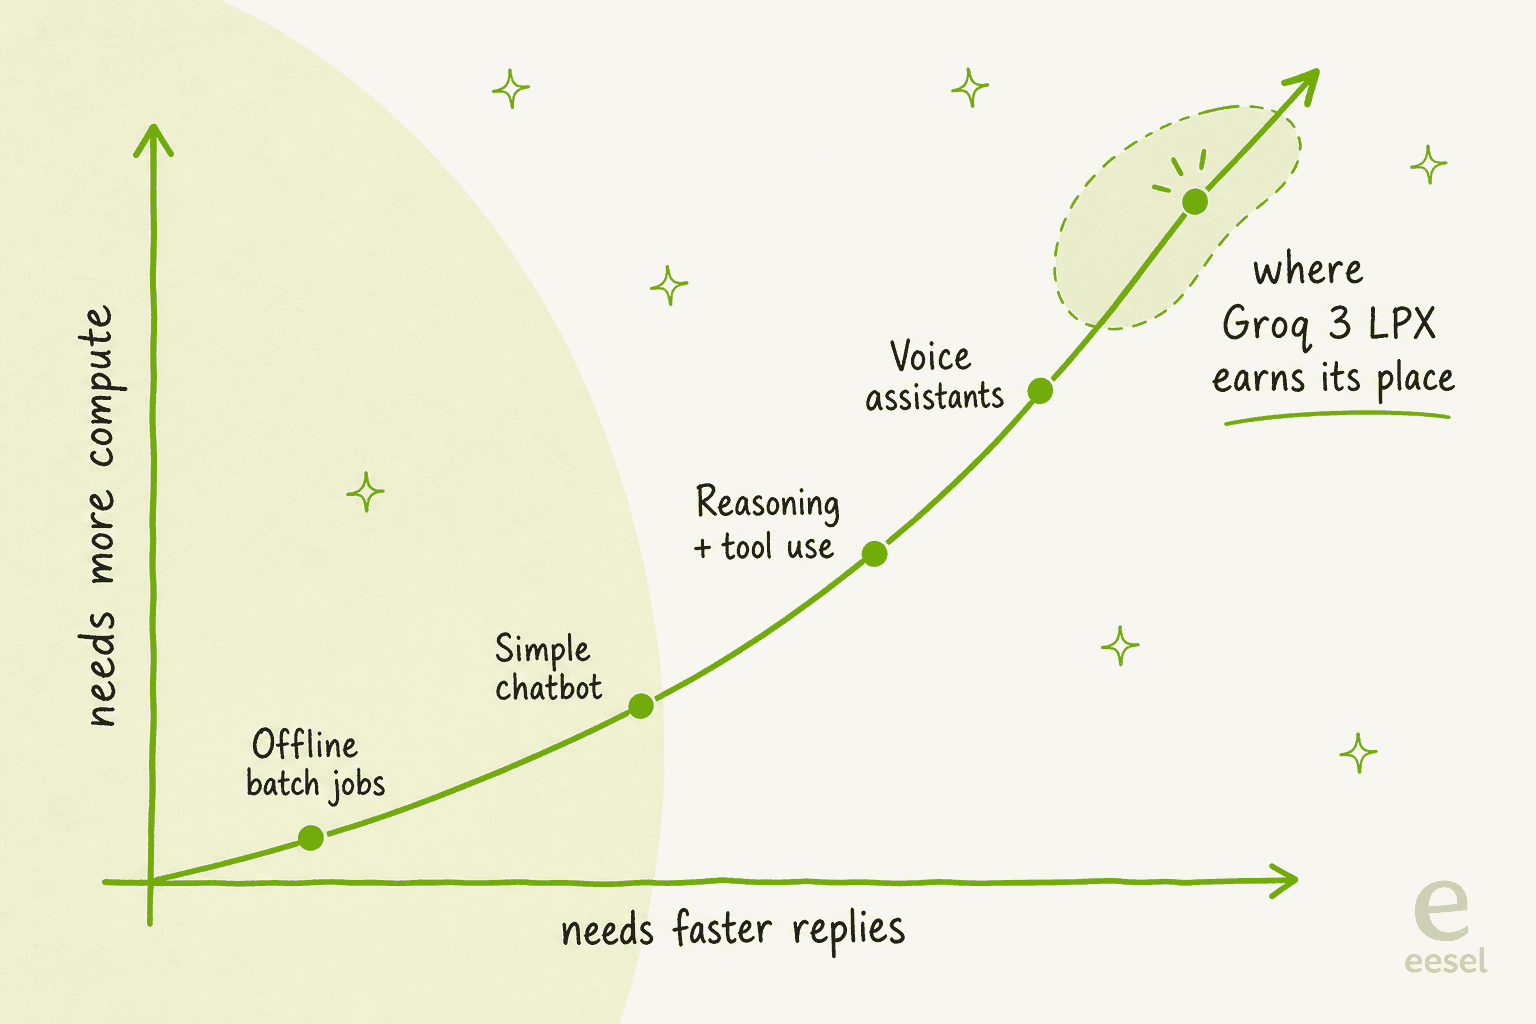
Das hilfreiche Denkmodell: Je mehr deine Arbeitslast in Richtung "viele schnelle Runden" geht, desto wichtiger ist eine dedizierte latenzarme Engine. Batch-Jobs kümmert das nicht. Coding-Assistenten, Agenten-Schwärme und Sprachanwendungen sehr wohl.
Was das bedeutet, wenn du mit KI baust
Hier will ich ehrlich sein, denn man lässt sich leicht vom Datenblatt mitreißen. Wenn du keine Cloud und keine sehr große KI-Plattform betreibst, wirst du kein Groq 3 LPX Rack kaufen. Das ist Infrastruktur, die mehrere Schichten unter dem liegt, wo die meisten Teams arbeiten. Du wirst sie als schnellere, günstigere Token spüren, die in den Modell-APIs und Clouds auftauchen, die du ohnehin nutzt, so wie du nie eine GPU gekauft hast, um einen KI-Agenten zu nutzen.
Und das ist die nützliche Umdeutung. Der Chip ist der Motor, was du tatsächlich einsetzt, ist der Arbeiter obendrauf. Schnellere Inferenz macht Agenten flotter und günstiger im Betrieb, senkt die Hürde, echte Automatisierung in Produktion zu bringen, und verschiebt die Kostenrechnung gegenüber einem menschlichen Mitarbeiter, ob das nun ein Coding-Agent, ein Recherche-Agent oder ein KI-Helpdesk-Agent in deiner Support-Warteschlange ist. Im Hardware-Rennen geht es darum, diese Schicht im großen Maßstab tragfähig zu machen. Der Wert liegt weiterhin in dieser Schicht.
Wo eesel hineinpasst
Chips wie Groq 3 LPX sind die Installation. eesel ist das, was du darauf einstellst, um die Arbeit zu erledigen. eesel ist eine Plattform für KI-Teamkollegen: Du stellst keine Inferenz bereit und baust keine Pipeline, sondern holst einen einsatzbereiten Teamkollegen für eine bestimmte Rolle und verbindest ihn mit deinen Apps. Aktuell gibt es einen KI-Helpdesk-Teamkollegen, der in deine Support-Warteschlange einsteigt und mehr ist als ein einfacher Support-Chatbot, sowie einen KI-Blog-Autor, der Inhalte wie diesen Beitrag erstellt.

Der konkrete Unterschied liegt darin, wo die schnellen Token landen. Ein Support-Teamkollege, der in einer Sekunde statt in acht antwortet, ist für die wartende Person das gesamte Erlebnis. Und die Jahre, in denen wir KI in echten Support-Warteschlangen betrieben haben, haben uns die unglamouröse Hälfte gelehrt: Geschwindigkeit hilft nur, wenn die Antwort stimmt, weshalb eesel einen Rollout gegen deine vergangenen Tickets simuliert, bevor er je einem echten Kunden antwortet. Alles Silizium der Welt behebt keine selbstsichere falsche Antwort. Wenn du den Teamkollegen statt des Racks sehen willst, kannst du eesel kostenlos testen.