

Was StepFun Step 5 Preview wirklich ist
Ich habe die letzten Jahre damit verbracht, KI in echte Support-Queues zu bringen, und lese deshalb jeden Modell-Launch gleich: nicht „ist der Benchmark hübsch", sondern „könnte ich dem morgen eine echte Aufgabe geben". Step 5 ist ein wirklich interessantes Modell und zugleich ein gutes Beispiel dafür, warum die zweite Frage zählt.
StepFun (阶跃星辰) ist ein Shanghaier Labor, das seit einigen Jahren die „Step"-Familie für Text, Bild und Audio ausliefert, mit einem soliden Open-Weights-Angebot auf Hugging Face. Step 5 Preview ist das neue Flaggschiff, auf der Produktseite als Frontier-Modell „für komplexe Arbeit und agentische Aufgaben" beschrieben, mit besonderem Schwerpunkt auf Softwareentwicklung und Finanzen.
Der Rahmen, auf den StepFun immer wieder zurückkommt, ist „die Pareto-Grenze voranbringen", also die Linie der bestmöglichen Kompromisse zwischen Intelligenz und Geld. Das eigene Launch-Diagramm sagt es deutlich: bei der Intelligenz mit der günstigeren offenen Klasse gleichziehen, bei den Kosten unterbieten.
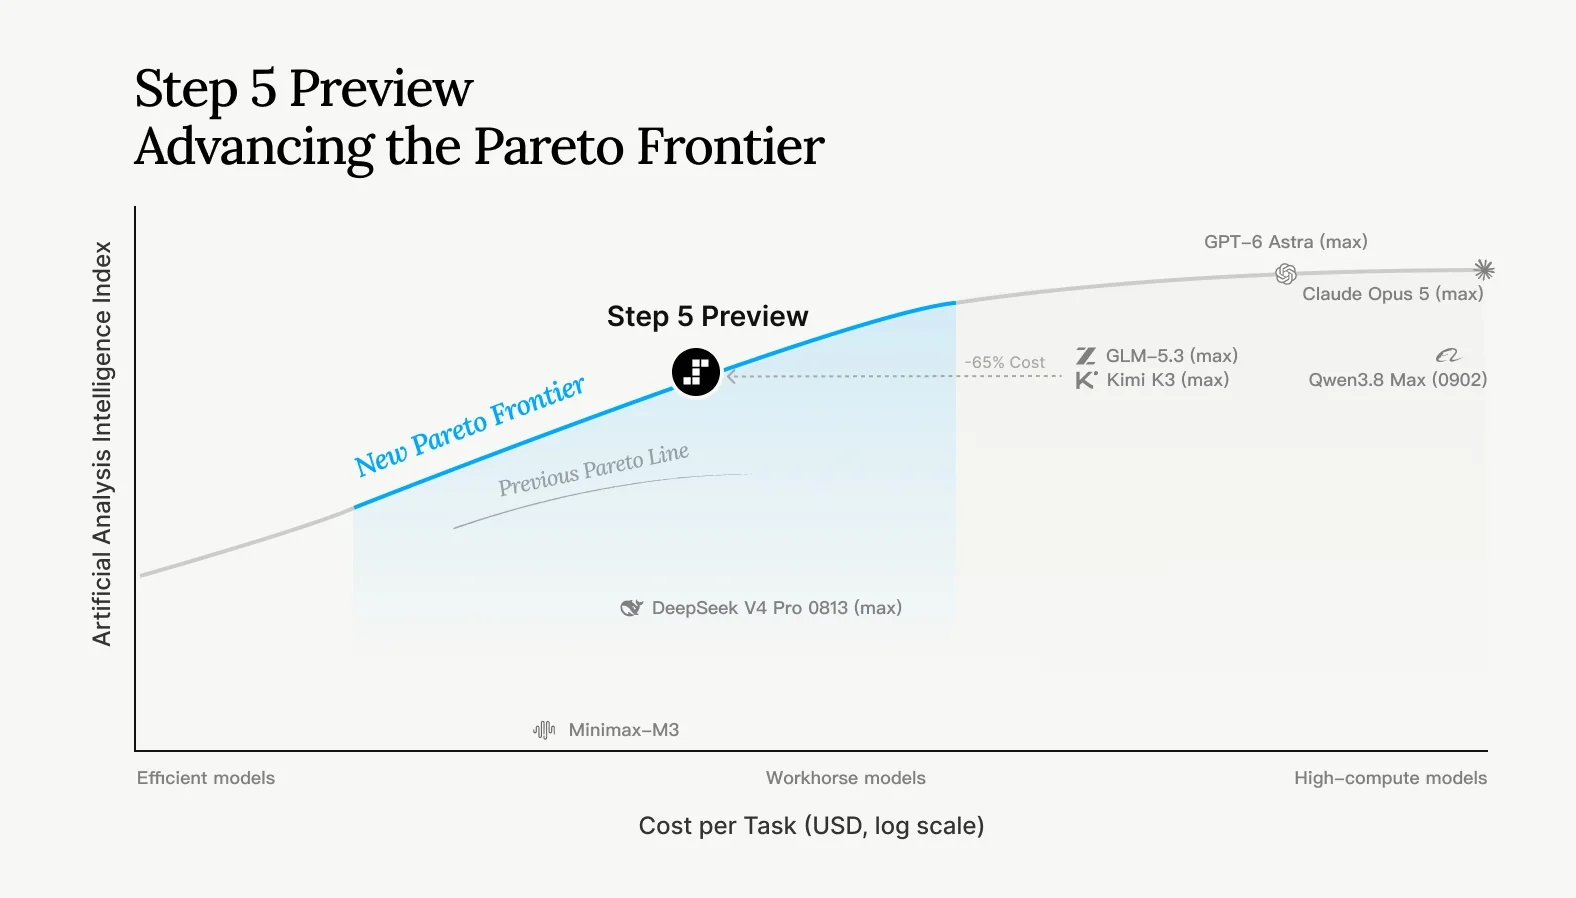
Beachten Sie die Behauptung in diesem Diagramm: 65 % niedrigere Kosten als GLM-5.3 und Kimi K3 bei vergleichbarer Intelligenz. Es ist ein Herstellerdiagramm, lesen Sie es also als Verkaufsargument und nicht als Urteil, aber das Argument ist zumindest schlüssig.
Wie das Sparse MoE funktioniert: 600B gesamt, 27B aktiv
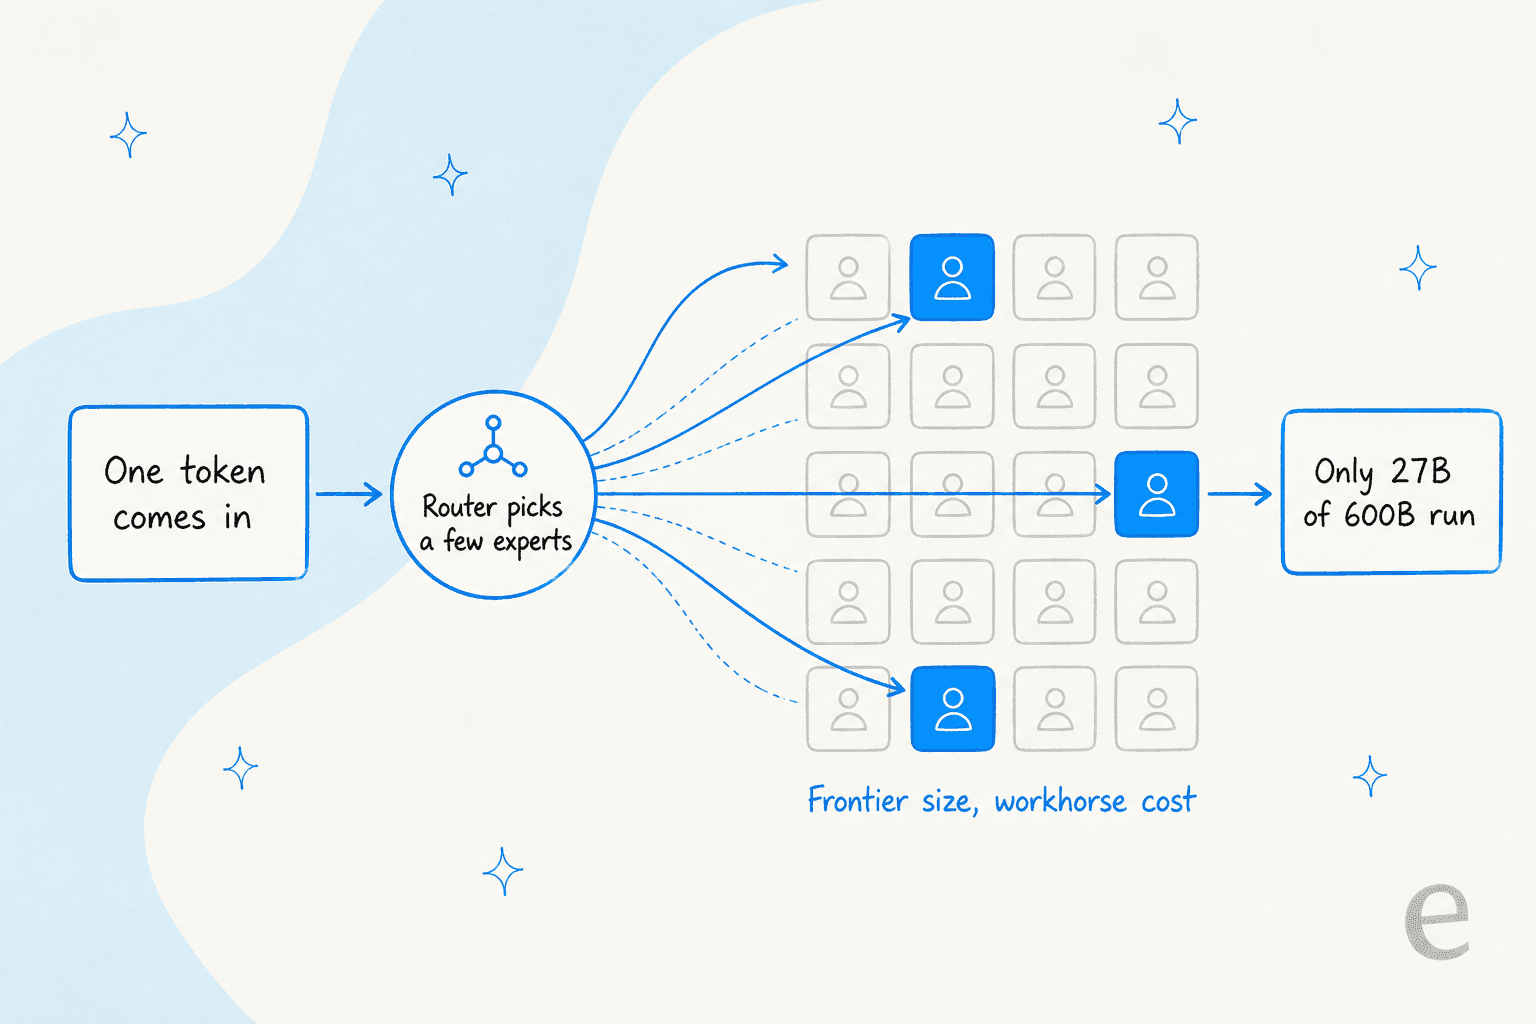
Die Kennzahl, auf die sich alle gestürzt haben, ist die Form des Modells: 600B Gesamtparameter, 27B aktiv pro Token. Das ist ein Sparse-Mixture-of-Experts-Design, und es ist die gesamte Kostengeschichte in einer Zahl.
In einem dichten Modell läuft für jedes Token jeder Parameter. In einem Mixture-of-Experts-Modell wählt ein kleiner Router für jedes Token eine Handvoll „Experten"-Teilnetze aus, sodass nur ein Ausschnitt des Modells tatsächlich feuert. Step 5 hält frontier-große 600B im Speicher, aktiviert aber nur 27B davon gleichzeitig, weshalb StepFun es wie ein Mittelklasse-Modell bepreisen kann.
Nicht alle glauben, dass die Rechnung zugunsten von Step 5 aufgeht. Die Zahl der aktiven Parameter kam auf Hacker News schnell zur Sprache:
"600b-a27b doesn't sound enticing. Also with the higher number of active parameters compared to GLM 5.3 flash and DeepSeek V4/4.1 flash, I don't see how they want to be more efficient at inference."

Das ist eine berechtigte Frage. 27B aktiv ist schwerer als manche konkurrierende „Flash"-Klasse, der Effizienzgewinn bezieht sich also auf die Intelligenz pro aktivem Parameter und nicht auf die Zahl der aktiven Parameter für sich. Genau das werden unabhängige Inferenz-Benchmarks klären, nicht StepFuns eigene Diagramme.
Es ist außerdem ein Reasoning-Modell, mit einem reasoning_effort-Regler auf low, medium oder high. Höherer Aufwand bedeutet eine längere interne Denkspur, und da Output-Tokens inklusive dieser Spur abgerechnet werden, ist der Aufwand ein direkter Kostenregler.
Was es kann: Kontext, Modalitäten und Fähigkeiten
Hier das Datenblatt aus StepFuns eigenen Plattform-Dokumenten, das wichtigste Stück, wenn Sie tatsächlich darauf aufbauen wollen.
| Spec | Step 5 Preview |
|---|---|
| Modell-ID | step-5-preview |
| Architektur | Sparse MoE, 600B gesamt / 27B aktiv |
| Kontextfenster | 1M Tokens |
| Max. Output | 64k Tokens |
| Eingabetypen | Text, Bilder, Video |
| Ausgabetyp | Text |
| Reasoning | reasoning_effort: low / medium / high |
Der 1M-Token-Kontext ist die Spec, auf die ich mich am stärksten stützen würde. Er reicht, um eine komplette Codebasis, ein Quartal an Support-Transkripten oder einen Stapel PDFs in einen einzigen Aufruf zu packen und dokumentübergreifendes Schlussfolgern zu verlangen. Multimodal können Sie bis zu 60 Bilder pro Anfrage übergeben, dazu kurze Videoclips, die Ausgabe ist aber nur Text.
StepFun setzt stark auf die Coding-Story. Es behauptet, Step 5 reiche „von Softwareentwicklung und visuellen Anwendungen bis zu programmierbarer Hardware", und in Experten-Evaluierungen hielten rund 70 % der Teilnehmenden es für fähig, Coding-Aufgaben mit mäßig hoher Komplexität autonom zu lösen. Dazu gibt es eine Claude-Code-Integration über „Step Plan", die den vollen 1M-Kontext bereitstellt, ein kluger Ort, um Entwickler abzuholen.
Die Benchmarks und der ehrliche Vorbehalt
StepFun hat eine vollständige Vergleichstabelle gegen offene Konkurrenten (Kimi K3, GLM-5.3) und die geschlossene Spitze (GPT-6 Astra, Claude Opus 5) veröffentlicht. Hier ihre Grundform, alle Zahlen von StepFuns eigener Produktseite.
| Benchmark | Step 5 Preview | Kimi K3 | GLM-5.3 | GPT-6 Astra | Claude Opus 5 |
|---|---|---|---|---|---|
| DeepSWE v1.1 | 67.7 | 67.5 | 66.9 | 74.1 | 74.0 |
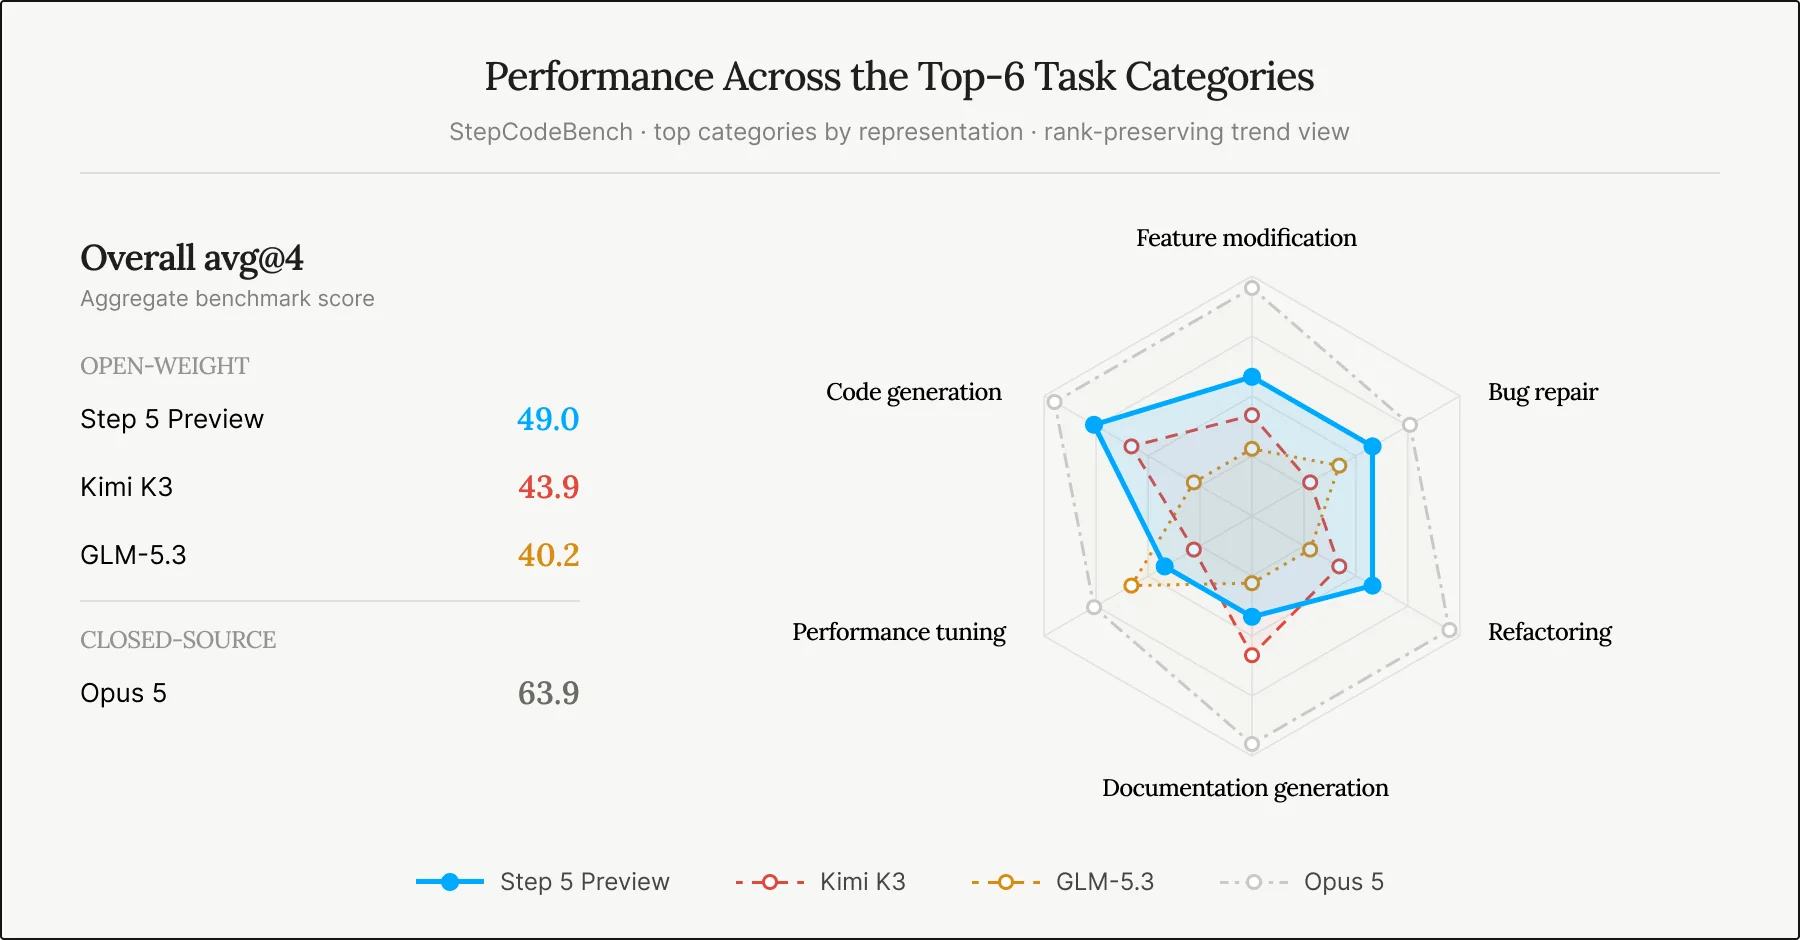
| StepCodeBench | 49.0 | 43.9 | 40.2 | 61.0 | 63.9 |
| ProgramBench | 80.5 | 77.8 | 72.0 | 85.4 | 82.3 |
| Terminal-Bench v4 | 33.3 | 12.6 | 41.9 | 57.9 | 52.3 |
| FrontierFinance | 66.4 | 62.6 | 64.1 | 55.0 | 69.7 |
Das Bild ist einheitlich: Step 5 Preview liegt auf Augenhöhe mit den anderen führenden offenen Modellen und hinter den besten geschlossenen Modellen bei der reinen Coding-Qualität, gewinnt aber bei den Kosten. Finanzen ist seine Paradedisziplin, dort schlägt es die anderen offenen Modelle knapp und übertrifft GPT-6 Astra. Das eigene StepCodeBench-Radar erzählt dieselbe Geschichte gegenüber der offenen Klasse.
Nun der Vorbehalt, und er ist groß. Jede Zahl oben ist selbst gemeldet, es gibt noch keinen technischen Bericht und kein Paper, und StepCodeBench ist StepFuns eigener Benchmark (553 Repositories, 33 Sprachen). Ein Modell schneidet tendenziell gut bei dem Test ab, den das eigene Team entworfen hat. Die Community hat auch schnell auf die schwächeren Stellen hingewiesen, besonders bei der Weitschweifigkeit:
"Based on the examples, it's like the thing took a writing class from Claude, but isn't quite as smart, kind of worst of both worlds. The 'Interactive Reporting' one is particularly terrible. A huge amount of waffly padding around a thesis that may or may not exist."
Und ein Kommentator hat das Launch-Demo dabei erwischt, sich selbst zu verraten, was mich dazu bringt, eigene Evals laufen zu lassen, bevor ich irgendetwas glaube:
"In their first demo video, to make a 3D render of the photo, the thinking trace gives away the game [...] I'm always astounded how little effort is put into checking the AI answers displayed in these announcements."
Nichts davon macht Step 5 zu einem schlechten Modell. Es macht es zu einem unbewiesenen, und das ist etwas anderes. Die richtige Reaktion ist, es an Ihrer eigenen Arbeitslast zu simulieren, statt dem Launch-Diagramm einfach zu glauben.
Was es kostet und wie Sie es bekommen
Die Preise sind der Teil dieses Launches, den man wirklich leicht mögen kann. Von der StepFun-Preisseite, pro 1M Tokens:
| Abrechnungseinheit | Input (Cache-Miss) | Input (Cache-Hit) | Output |
|---|---|---|---|
step-5-preview | $1.00 | $0.05 | $2.70 |
step-3.7-flash (zum Vergleich) | $0.20 | $0.04 | $1.15 |
Der 95-%-Rabatt bei Cache-Hits auf den Input ist das Highlight und für agentische Workloads, die bei jedem Schritt einen großen, größtenteils statischen System-Prompt erneut senden, ein großer Vorteil. Der Output zu $2,70 deckt sowohl die Reasoning-Spur als auch die endgültige Antwort ab, ein redseliger High-Effort-Lauf kostet also echtes Geld. Es gibt eine kostenlose V0-Stufe zum Ausprobieren (5 Parallelität, 10 Anfragen pro Minute), wobei die Rate Limits mit Ihrem aufgeladenen Guthaben wachsen.
Beim Zugang zeigt sich, wozu das Label „Preview" da ist. Das Modell gibt es heute nur über die API, und StepFun betreibt einen öffentlichen Countdown bis zu den Open Weights.
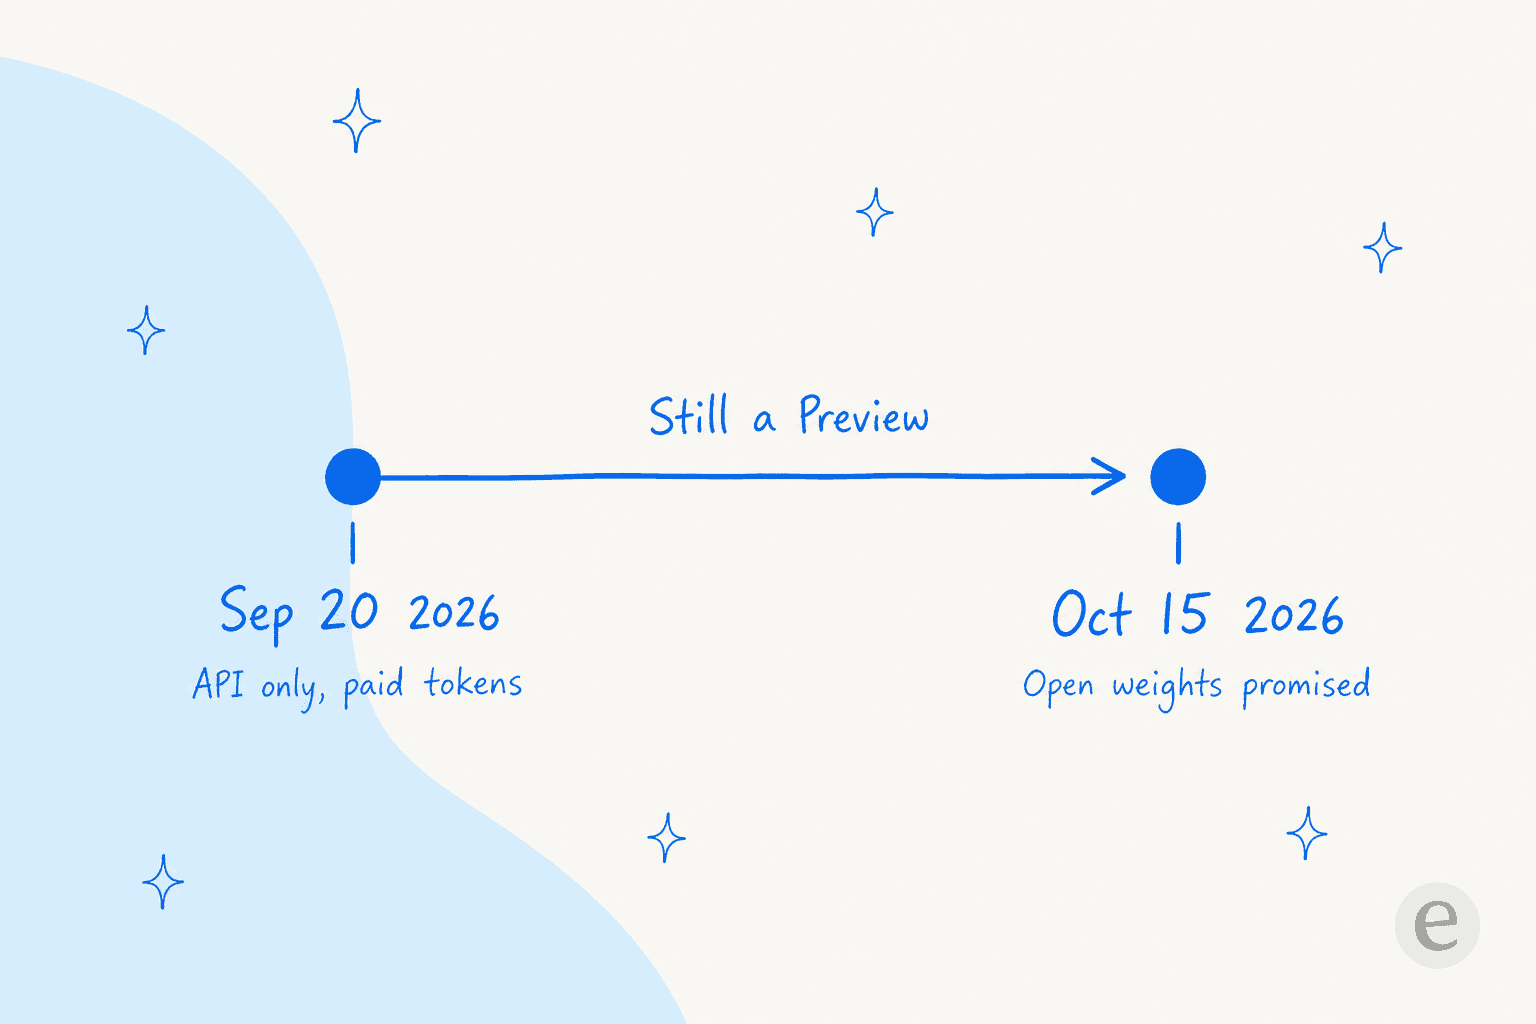
Das Hugging-Face-Repo existiert bereits, ist aber zum Zeitpunkt des Schreibens ein leerer Platzhalter ohne Model Card, Gewichte oder Lizenz. StepFuns Flash-Reihe erschien unter Apache 2.0, eine freizügige Open-Veröffentlichung ist also wahrscheinlich, aber ich würde keinen On-Prem-Plan auf Gewichte bauen, die noch nicht erschienen sind.
Für wen Step 5 gedacht ist und wer warten sollte
So würde ich es einordnen. Wenn Sie Entwickler oder ein Labor sind und ein leistungsfähiges, günstiges Modell mit langem Kontext als Grundlage suchen, besonders für Coding, Finanzen oder Recherche über große Dokumentmengen, lohnt sich ein echter Test von Step 5 Preview. Die Preis-Leistungs-Story ist wirklich gut, und das Open-Weights-Versprechen macht es noch interessanter.
Wenn Sie auf ein gefestigtes, bewährtes Modell warten, warten Sie. Es ist eine Preview, die Benchmarks sind selbst bewertet, und die frühe Einschätzung der Community lautet „vielversprechend, aber weitschweifig und unbewiesen". Selbst ein wohlgesinnter Kommentator beschrieb das Muster behutsam:
"The previous Step models were pretty decent, but unfortunately for them, their model reasons too much and too long [...] Hopefully this doesn't reason too long to get to the answer. I welcome any open model, the more the merrier."
Eines rechne ich StepFun an, was die meisten Launches falsch machen: zu wissen, was man ist. Wie ein Kommentator sagte, ist die Positionierung ehrlich darüber, das Beste der günstigeren Klasse zu sein, statt so zu tun, als führe man die Charts an:
"Their posisitoning is nice. Instead of saying they are cheaper and a bit less performant (in terms of intelligence), they say they are best among the cheaper and a bit less performant ones."
Wo ein rohes Modell endet und ein Teammate beginnt
Es gibt einen Punkt, dem ich widersprechen würde, und er ist nicht StepFuns Schuld, er gilt für jeden Modell-Launch. Ein Modell ist keine Lösung. Step 5 Preview ist ein Motor. Es gibt Ihnen eine API, eine Token-Rechnung und rohe Leistungsfähigkeit. Daraus etwas zu machen, das Ihre Kunden beantwortet, heißt: Sie bauen die App, binden Ihre Daten an, schreiben die Leitplanken und übernehmen die Wartung.
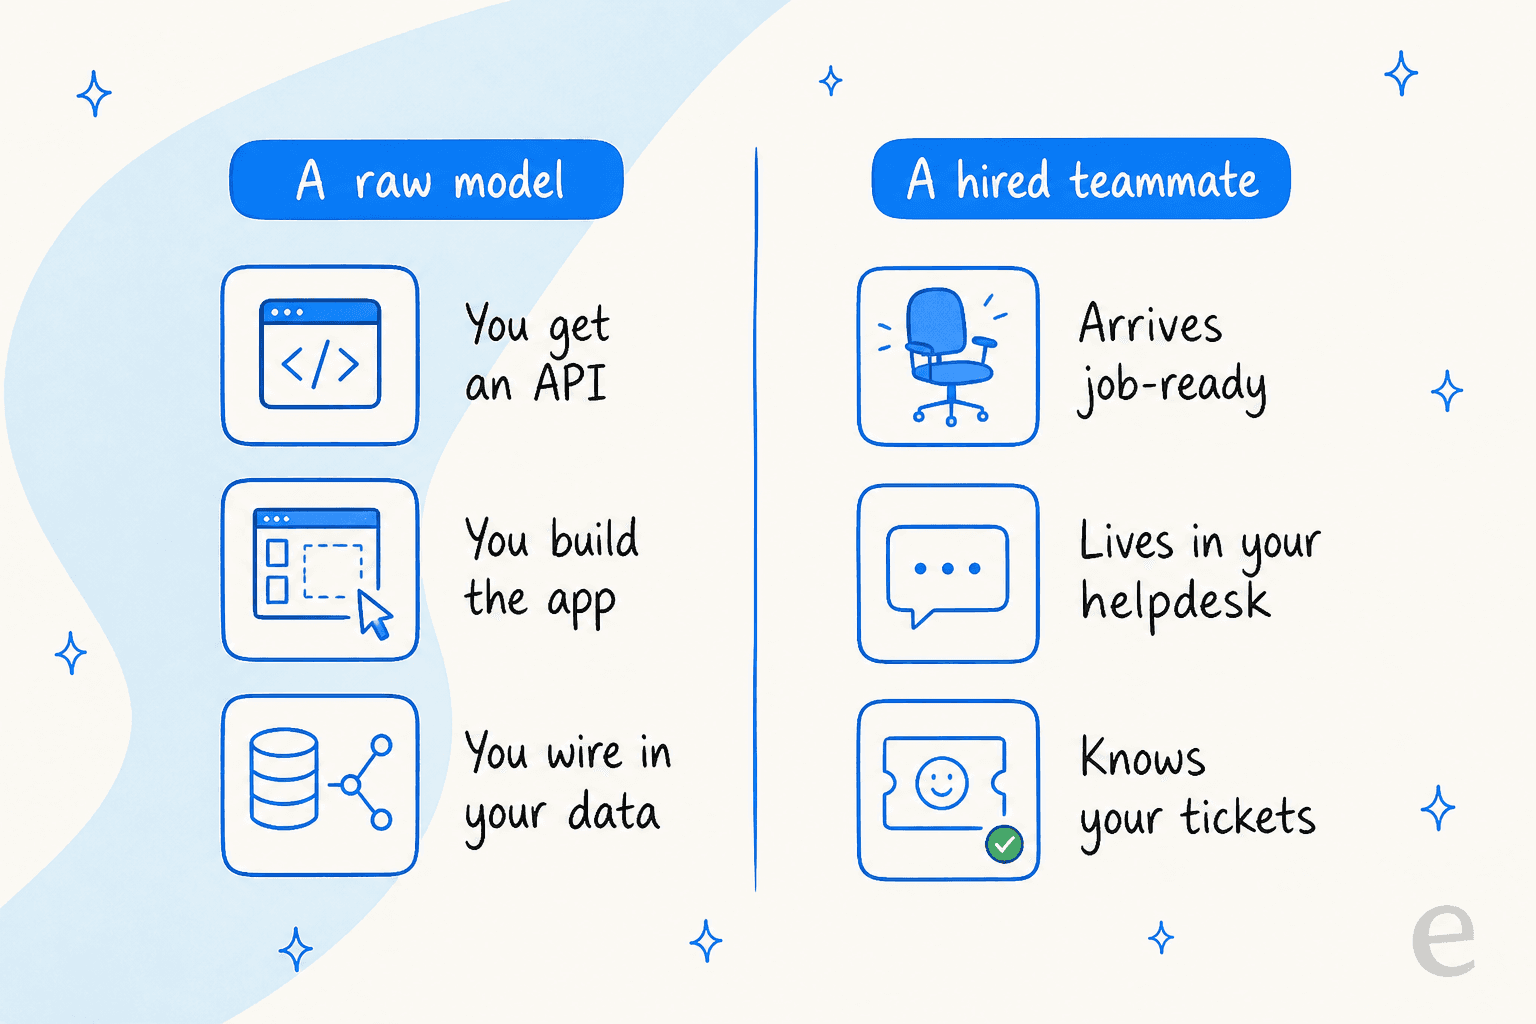
Genau diese Lücke ist der Grund, warum es eesel gibt. Statt eines rohen Modells stellen Sie ein einsatzbereites Teammate für eine bestimmte Aufgabe ein. Das KI-Helpdesk-Teammate steigt in Ihre bestehende Queue ein, lernt aus Ihren vergangenen Tickets und Ihrem Help Center und entwirft oder sendet Antworten in dem Helpdesk, den Sie bereits nutzen, sei es Zendesk, Freshdesk oder Gorgias. Die Preise sind ein Pauschalbetrag pro gelöster Anfrage, ohne Gebühr pro Arbeitsplatz, die Kosten entsprechen also erledigter Arbeit statt verbrannter Tokens.

Am wichtigsten ist mir, gerade wegen des Problems mit den selbst gemeldeten Benchmarks oben, dass Sie das Teammate an Tausenden Ihrer eigenen vergangenen Tickets simulieren können, bevor es je einen Live-Kunden berührt. So sehen Sie seine echte Lösungsquote an Ihrer Arbeitslast statt am Diagramm eines Herstellers. Und wenn Sie es lieber über ein Terminal oder ein Skript steuern als über ein Dashboard, liefert eesel ein echtes CLI und einen MCP-Server, damit Coding-Agenten wie Claude Code dasselbe Teammate direkt bedienen können. Neue Modelle wie Step 5 sind spannende Infrastruktur. Ein Teammate ist das, was tatsächlich zur Schicht erscheint. Sie können eesel kostenlos testen.