Ein Modell, das vor seiner eigenen Pressemitteilung erschien
Die meisten Modellstarts bestehen aus einem Blogpost, einem Benchmark-Diagramm und einer Modellkarte, alles auf einmal. M3.1 Flash lief andersherum. Es erschien im Modellauswahlmenü von MiniMax Code, neben M3 und M2.7, und die Community fand es dort, bevor MiniMax ein Wort sagte. Der Entwickler, der es entdeckte, bemerkte sofort das neue Reasoning-Menü:
"🚨重磅!MiniMax M3.1-Flash 预览版疑似已上线 MiniMax Code!推理等级单独成菜单:low / medium / high / xhigh / max。目前还没有官方公告,属于先露在产品里的灰度上线。" (Übersetzung: „Große Neuigkeit! Die Preview von MiniMax M3.1-Flash scheint in MiniMax Code live zu sein. Die Reasoning-Stufen haben ein eigenes Menü: low / medium / high / xhigh / max. Noch keine offizielle Ankündigung, es ist ein gestaffelter Rollout, der zuerst im Produkt sichtbar wird.“)
Der Rollout kam auch mit einem leichten Seufzer an. MiniMax hat zuletzt in hohem Tempo Video- und Musikmodelle veröffentlicht, die M-Serie (Text) war ruhig geworden, und die meistgeliked Antwort unter dem Launch-Post las sich wie liebevolle Ungeduld:
"You finally remembered the M series"
Auch der Hype hat eine Vorgeschichte. Tagelang hatten Entwickler ein kostenloses Stealth-Modell namens „Space Bunny“ ausgereizt und gerätselt, was dahintersteckt. Die Antwort kam wenige Tage vor dem Launch:
"Confirmed, Space Bunny Alpha is Minimax M3.1"
Die Aufregung ist also echt, aber der „Launch“ ist eine gestaffelte Preview, die zuerst im Produkt landet. Wenn du entscheidest, ob du darauf aufbaust, zählt diese Unterscheidung mehr als der Hype: Eine Grey-Rollout-Preview ohne Preis und ohne Gewichte ist nicht dieselbe Verpflichtung wie ein GA-Modell.
Was MiniMax M3.1 Flash tatsächlich ist
Lässt man das Launch-Theater weg, sind die Plattform-Docs bei der Substanz klar. In der Tabelle der unterstützten Modelle wird M3.1 Flash als "frontier multimodal coding model with 1M context window and tunable thinking depth" beschrieben, gebaut für agentisches Reasoning, Tool-Nutzung, Coding und strukturierte Aufgabenausführung. Es nimmt Text, Bilder und Video als Eingabe.
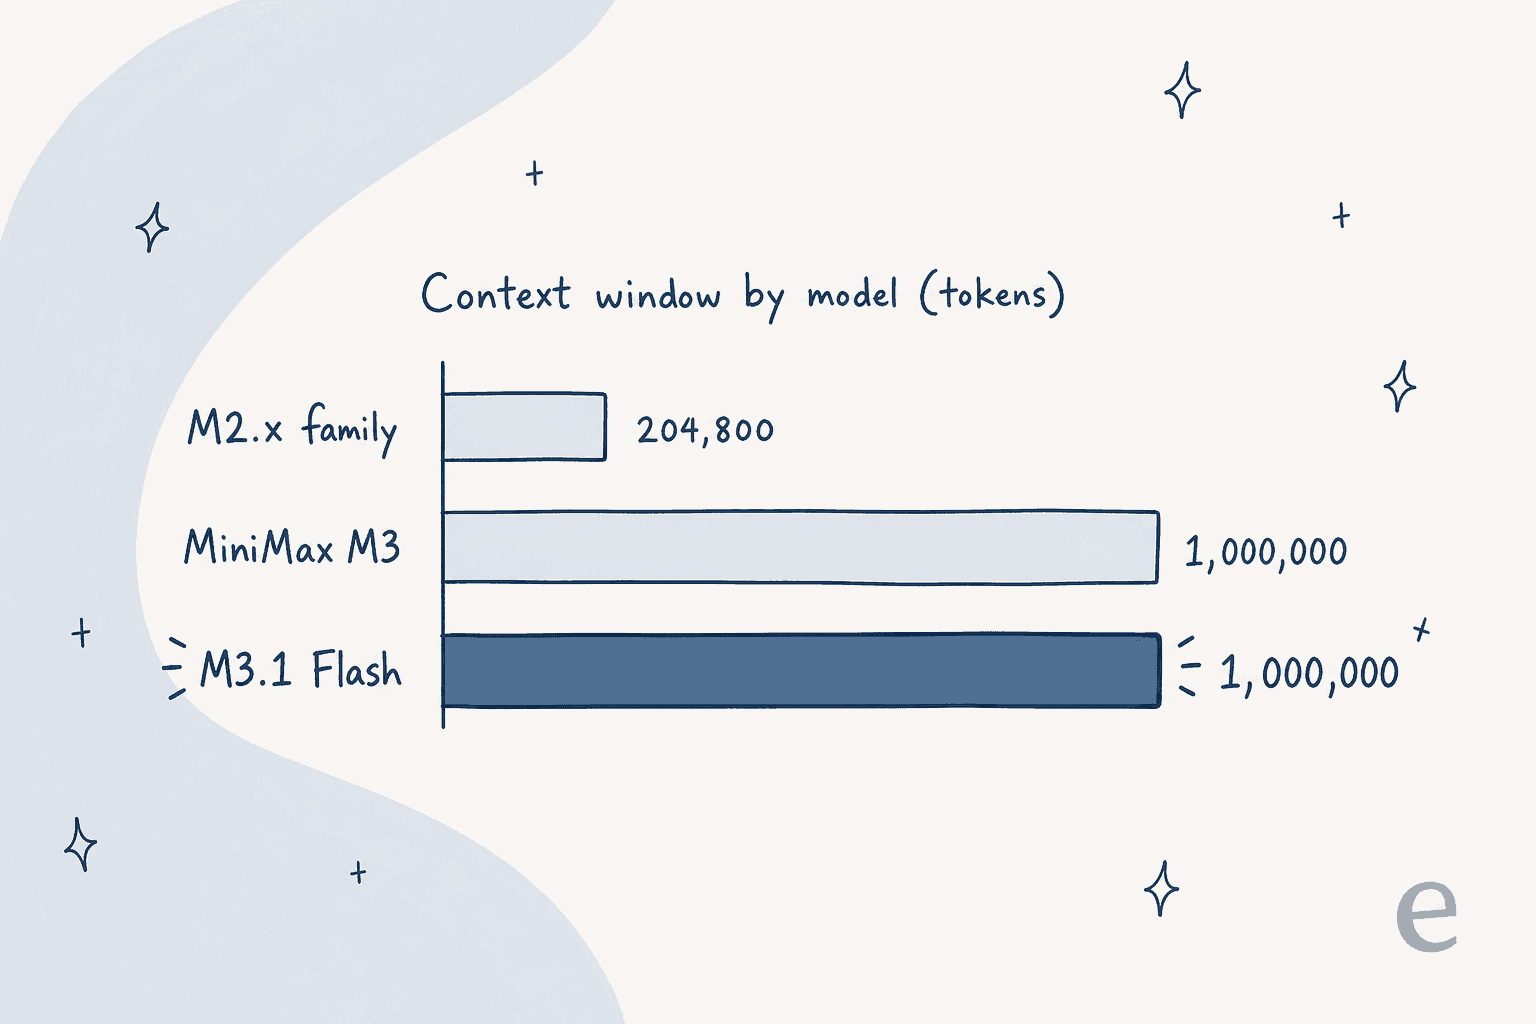
Der 1M-Kontext ist die Kernspezifikation, und er ist ein echter Sprung innerhalb der M-Serie, keine Marketing-Rundung. Die gesamte M2-Familie endete bei 204.800 Tokens; die M3-Generation, M3.1 Flash eingeschlossen, ist ein glatter Faktor fünf.
Das legen die Docs fest, und das nicht:
| Attribut | MiniMax M3.1 Flash |
|---|---|
| Modell-ID | MiniMax-M3.1-Flash-Preview |
| Kontextfenster | 1.000.000 Tokens |
| Eingabemodalitäten | Text, Bild, Video |
| Denken | Standardmäßig an, einstellbar über effort, nicht abschaltbar |
| Verfügbarkeit | Nur Token Plan + MiniMax Code |
| Offene Gewichte | Keine (keine Hugging-Face-Karte) |
| Parameterzahl | Nicht angegeben |
| Durchsatz (tps) | Nicht angegeben |
| Preis pro Token | Nicht veröffentlicht |
Die Tabelle ist bewusst ehrlich bei den Lücken. Es gibt keine angegebene Parameterzahl, keinen offiziellen Tokens-pro-Sekunde-Wert und keine Benchmark-Suite speziell für M3.1 Flash. Wenn dir eine Seite sagt, das Modell habe „428B Parameter“ oder einen Benchmark-Score nennt, stammt das vom Eltern-Modell M3 und nicht von M3.1 Flash. Ich weise lieber auf die Lücke hin, als sie zu überdecken.
Der eine Regler, der es definiert: effort
Das einzige Feature, das die Docs für M3.1 Flash hervorheben und nicht für M3, ist die einstellbare Denktiefe. Das Modell denkt immer nach, bevor es antwortet, und du steuerst mit einer effort-Einstellung, wie stark es denkt. Sie akzeptiert low, medium, high, xhigh und max. Lässt du sie weg, gilt max.
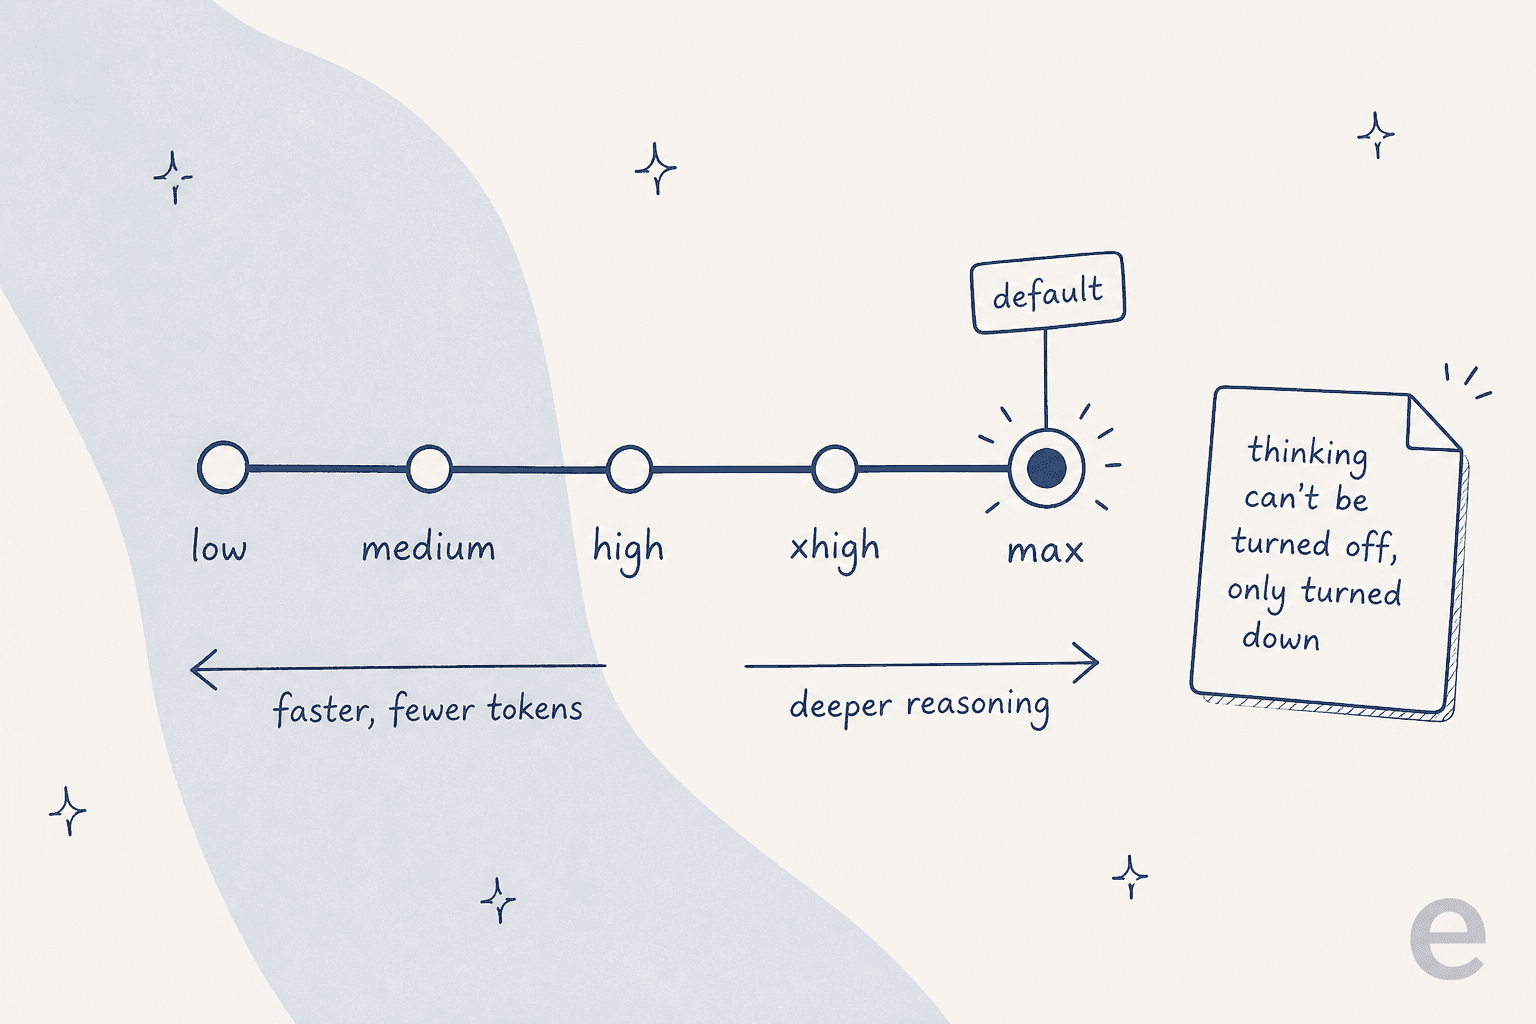
Das Detail, über das man stolpert: Du kannst das Denken nicht abschalten. Sendest du thinking: {"type": "disabled"} oder effort: "none", gibt die API einen 400 mit der Meldung requires adaptive thinking zurück (Docs). Brauchst du geringere Latenz oder weniger Ausgabe-Tokens, drehst du effort auf low; einen Modus ohne Denken gibt es nicht. Das ist eine echte Design-Entscheidung, und du solltest sie kennen, bevor du das Modell in einen latenzkritischen Pfad einbaust. Bei einem „Flash“-Modell ist max als Standard etwas überraschend, und es heißt, dass das günstige, schnelle Verhalten, das man vom Namen erwartet, erst aktiviert werden muss.
Ist es wirklich schnell?
MiniMax hat keinen Durchsatzwert veröffentlicht, die einzigen echten Geschwindigkeitsdaten stammen also von Entwicklern, die es am ersten Tag getestet haben. Die meistzitierte Messung liegt bei der Decode-Geschwindigkeit in einem soliden, aber nicht führenden Bereich:
"MiniMax-M3.1-flash-preview is hanging around 90 - 110 t/s range for decode. It's fast, love seeing it, def faster than MiMo-v2.6-flash but not as fast as deepseek-v4.1-flash"
Das ist die ehrliche Einordnung: schnell, vor manchen Flash-Konkurrenten, hinter anderen. Und nicht jeder findet, dass die reine Decode-Geschwindigkeit das Richtige zum Feiern ist:
"Decode speed is not equivalent to fast. The model is slow for the quality in my opinion, numbers dropping soon!"
Ich finde, der Skeptiker hat einen Punkt. Ein Modell, das standardmäßig auf max Effort läuft und nicht aufhören kann zu denken, fühlt sich bei echten Aufgaben langsamer an, als eine Tokens-pro-Sekunde-Zahl vermuten lässt, weil es vor der Antwort viele Reasoning-Tokens erzeugt. Die nützliche Frage ist nicht „wie viele Tokens pro Sekunde“, sondern „wie lange, bis ich eine korrekte Antwort habe, die ich ausliefern kann“, und diesen Benchmark hat für M3.1 Flash noch niemand gefahren.
Die Architektur darunter
Die Docs wiederholen die Interna für M3.1 Flash nicht, fair ist es also, die Architektur als von der M3-Generation geerbt zu behandeln und nicht als bestätigte M3.1-Flash-Spezifikation. Die M3-Linie führte MiniMax Sparse Attention (MSA) ein, ein Sparse-Attention-Design, das einen Kontext von einer Million Tokens praktikabel statt ruinös langsam macht.
MiniMax' eigener Vergleich mit Standard-Grouped-Query-Attention zeigt am klarsten, warum Sparse Attention bei dieser Kontextlänge wichtig ist:
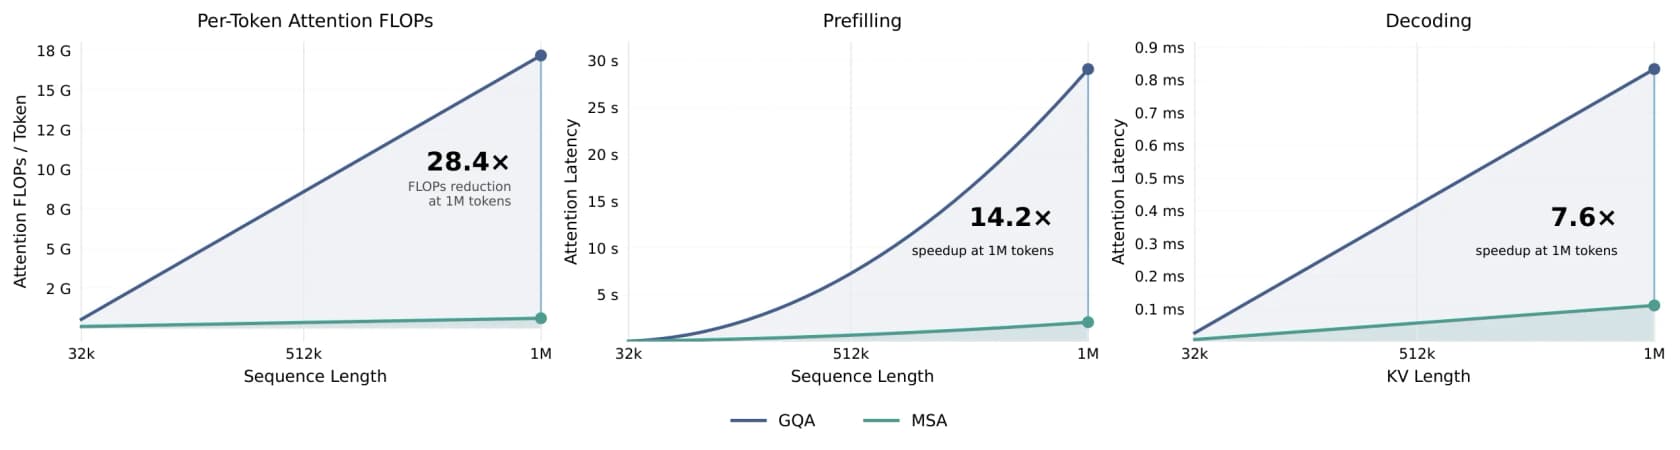
Bei einer Million Tokens zeigt MiniMax' Diagramm, dass MSA den Attention-Rechenaufwand pro Token um etwa das 28-Fache senkt und das Decoding ca. 7,6-fach beschleunigt, verglichen mit Standard-Attention. Das sind Zahlen der M3-Generation. Da M3.1 Flash dasselbe 1M-Fenster hat, nutzt es sehr wahrscheinlich dieselbe Architektur, aber ich würde sie erst als gemessene M3.1-Flash-Spezifikation zitieren, wenn MiniMax eine veröffentlicht.
Was es kostet
Hier wird M3.1 Flash wirklich ungewöhnlich: Es gibt nirgends einen Preis pro Token. Es steht nicht in der Pay-as-you-go-Tabelle, und MiniMax' eigene Docs sagen, dass es vorerst nur über den Token Plan und MiniMax Code verfügbar ist. Die echten Kosten sind also dein Abo geteilt durch deine Nutzung.
Hier der Token Plan, ein gemeinsames Kontingent für Text, Bild und Sprache:
| Plan | Monatlich | Jährlich (2 Monate gratis) | ~M3-Tokens / Monat | Videogenerierung |
|---|---|---|---|---|
| Plus | 20 $ | 220 $ | ~1,7 Mrd. | Keine |
| Max | 50 $ | 550 $ | ~5,1 Mrd. | 3 Clips/Tag |
| Ultra | 120 $ | 1.320 $ | ~12,5 Mrd. | 5 Clips/Tag |
Es gibt außerdem eine Prepaid-Option mit Credits (5 $ für 5.000, 25 $ für 25.000, 100 $ für 100.000, ein Jahr gültig) und keine kostenlose LLM-Stufe. Das Kontingent wird in rollierenden 5-Stunden- und Wochenfenstern zurückgesetzt, ungenutztes Monatskontingent verfällt.
Wenn du wissen willst, was eine öffentliche API womöglich einmal kostet: Das Schwestermodell MiniMax M3 mit 1M Kontext gibt es nutzungsbasiert. Das sind die Sätze von M3, nicht von M3.1 Flash, aber die Struktur dürfte ein Vorgeschmack sein:
| MiniMax M3 (Standardstufe) | Input | Output | Cache-Lesezugriff |
|---|---|---|---|
| ≤ 512K Input | 0,30 $ /M | 1,20 $ /M | 0,06 $ /M |
| > 512K Input | 0,60 $ /M | 2,40 $ /M | 0,12 $ /M |
Zwei strukturelle Punkte für später: eine Grenze bei 512K Input, ab der sich der Satz verdoppelt, und eine Priority-Servicestufe zum 1,5-fachen Standardsatz. Also günstig für die Klasse, aber mit eingebautem Aufschlag für langen Kontext.
So nutzt du es tatsächlich
Für eine Preview ist der Zugang überraschend entwicklerfreundlich. M3.1 Flash spricht zwei Protokolle: einen Anthropic-kompatiblen Endpunkt unter https://api.minimax.io/anthropic (MiniMax' empfohlener Weg, mit Thinking-Blöcken) und einen OpenAI-kompatiblen unter https://api.minimax.io/v1. Das effort-Feld sitzt je nach Protokoll an anderer Stelle: output_config.effort in der Anthropic-API, reasoning_effort in der OpenAI-API.
Weil es Anthropic- und OpenAI-kompatibel ist, kannst du bestehende agentische Coding-Tools direkt darauf richten. MiniMax nennt Claude Code, Cursor, Codex CLI und weitere als über den Token Plan unterstützt, ohne separaten API-Key. Das ist der eigentliche Anwendungsfall, auf den die Kombination „Flash + Preview“ zielt: ein günstiges, schnelles Standardmodell für alltägliches Coding und Agent-Loops, in den Tools, in denen Entwickler ohnehin arbeiten.
Wo ein solches Modell hinpasst
Das bringt mich zurück zum Gedanken vom Anfang. M3.1 Flash ist ein schneller Motor mit großem Kontextfenster und einem Denkregler. Das ist Infrastruktur. Es ist die rohe Fähigkeit, als Endpunkt bereitgestellt, und sie ist in dem, was sie tut, wirklich gut. Aber ein Endpunkt kennt dein Unternehmen nicht, sitzt nicht in deinem Helpdesk und verantwortet keine Aufgabe von Anfang bis Ende. All das musst du drumherum noch bauen.
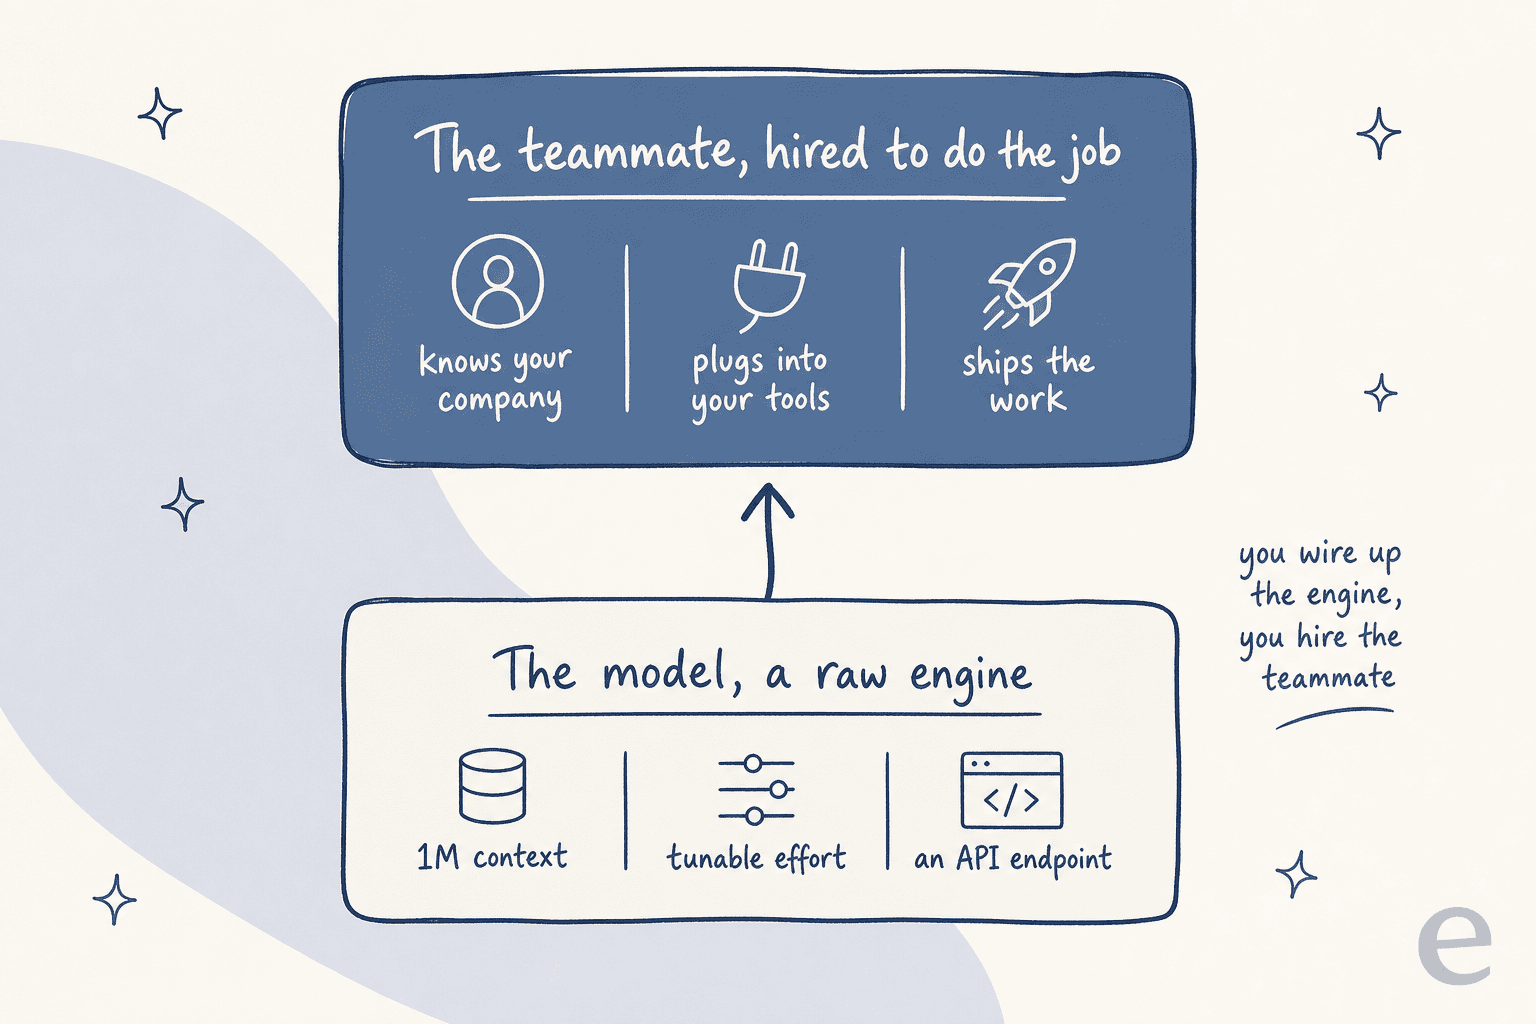
Diese Lücke zwischen „einem fähigen Modell“ und „Arbeit, die tatsächlich erledigt wird“ ist der ganze Grund, warum es eesel gibt. eesel ist eine Plattform für KI-Teammitglieder: Statt dir ein Modell und einen leeren Editor zu geben, stellst du ein einsatzbereites Teammitglied für einen bestimmten Job ein. Aktuell gibt es einen KI-Helpdesk-Teammitglied, das sich in deine bestehende Support-Queue einklinkt, und einen KI-Blog-Writer, der Beiträge in deinem Stil recherchiert und entwirft. Jedes kommt schon mit dem Wissen für seine Rolle und bindet sich in die Tools ein, die du bereits nutzt.
Wenn du im Terminal zuhause bist, ist die eesel CLI der Teil, der sich nach dem Lesen einer Docs-Seite wie der von MiniMax am vertrautesten anfühlt. Es ist dasselbe Teammitglied wie im Dashboard, gesteuert über die Kommandozeile: Du kannst einen Helpdesk verbinden, Wissen hochladen, Automatisierungen verdrahten und zurückgehaltene Aktionen freigeben, ohne je die UI zu öffnen. Jeder Befehl gibt JSON aus, und Fehler kommen als strukturierte {error, hint, retryable}-Objekte zurück, sodass ein Coding-Agent wie Claude Code, Cursor oder Codex das gesamte Setup steuern kann, indem er das hint-Feld liest und entscheidet, was er als Nächstes ausführt. Jeder Workspace ist außerdem ein MCP-Server, derselbe Agent, der M3.1 Flash aufruft, kann also auch eesel aufrufen. Das Denkmodell ist einfach: Das Modell ist der Motor, den du verdrahtest; das Teammitglied ist die Person, die du einstellst.
eesel ausprobieren
Wenn dich M3.1 Flash begeistert, weil du KI echte Arbeit erledigen lassen willst und nicht nur API-Aufrufe beantworten, übernimmt eesel diese letzte Meile. Richte es auf deine bisherigen Tickets und dein Help Center, und das KI-Helpdesk-Teammitglied beginnt in Minuten, echte Antworten zu entwerfen. Oder gib dem KI-Blog-Writer ein Thema, und er recherchiert, entwirft und illustriert einen kompletten Beitrag in deinem Stil, genauso wie dieser hier entstanden ist.
Das Beste: Du kannst ihm bei der Arbeit zusehen, bevor du dich festlegst, denn eesel läuft zuerst gegen deine eigene Historie, sodass du die Qualität an deinen echten Tickets siehst und nicht an einer Demo. Der Einstieg ist kostenlos, ohne Kreditkarte, damit du selbst den Unterschied zwischen einem gemieteten Modell und einem eingestellten Teammitglied siehst.
Häufig gestellte Fragen
Was ist MiniMax M3.1 Flash?
MiniMax-M3.1-Flash-Preview) ist das neueste Modell der M-Serie von MiniMax: ein multimodales Coding-Modell mit einem Kontextfenster von 1.000.000 Tokens und einstellbarer Denktiefe. Es erschien am 27. September 2026 als Preview in MiniMax Code und im Token Plan und zielt auf schnelle, alltägliche Coding- und Agent-Aufgaben. Wenn du ein solches Modell eine echte Aufgabe erledigen lassen willst, statt es nur hinter einer API zu haben, macht ein KI-Teammitglied wie eesel daraus tatsächliche Arbeit.Was kostet MiniMax M3.1 Flash?
Ist MiniMax M3.1 Flash Open Source oder auf Hugging Face?
Wie unterscheidet sich M3.1 Flash von MiniMax M3?
Kann man das Denken in MiniMax M3.1 Flash abschalten?
effort: "none" oder thinking: disabled sendet, bekommt einen 400-Fehler. Um Latenz und Token-Verbrauch zu senken, reduzierst du stattdessen die effort-Stufe.

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.