

GLM-5.3-Flash ist das erste nativ multimodale Modell von Z.ai in der GLM-5-Familie und wurde am 26. August 2026 veröffentlicht. Es ist ein Mixture-of-Experts-Modell mit 320B Parametern, von denen nur 18B aktiv sind, hat ein Kontextfenster von 1M Tokens, nimmt Bild- und Videoeingaben an und bietet offene Gewichte auf HuggingFace.
Die Schlagzeile ist der Preis. Es erreicht 57 im Artificial Analysis Intelligence Index bei etwa $0,045 pro Aufgabe, und die API-Preise beginnen bei $0,075 pro Million Eingabe-Tokens (ein Einführungsangebot bis zum 9. September 2026; Listenpreis $0,15/$0,50). Das ist grob GLM-5.2-Intelligenz zu einem Zehntel der Kosten.
Verwechseln Sie es nicht mit dem Flaggschiff GLM-5.3. Flash ist das günstige, multimodale Geschwister mit hohem Durchsatz; das Flaggschiff ist das reine Textmodell für Coding und Cybersicherheit zu $1,40/$4,40 pro Million Tokens.
Für Support- und Content-Teams ist das Modell der Motor, nicht das fertige Produkt. Ein günstiges, leistungsfähiges Modell braucht trotzdem Retrieval, Integrationen, Ihr Unternehmenswissen und Tests, bevor es sicher einem Kunden antworten kann. Genau diesen letzten Schritt übernimmt eesel.
Was GLM-5.3-Flash eigentlich ist
Ich baue beruflich KI-Agenten, und fast jede Woche erscheint ein neues Modell mit „Frontier-Niveau zu einem Bruchteil der Kosten“. GLM-5.3-Flash ist eines der wenigen jüngeren, bei denen die Behauptung einem Blick auf die Zahlen weitgehend standhält.
Z.ai (das Unternehmen, das früher als Zhipu AI aus Peking bekannt war) hat es mit dem GLM-5.3-Flash-Launch am 26. August 2026 veröffentlicht, unter dem Slogan „Frontier Intelligence, Flash Cost“. Es ist das erste Modell der GLM-5-Reihe, das nativ multimodal ist: Bild und Video gehen zusammen mit Text hinein, Text kommt heraus. Unter der Haube ist es ein Mixture-of-Experts-Modell mit insgesamt 320B Parametern, aber nur 18B aktiv pro Token. Das ist der Trick, der es schnell und günstig im Betrieb hält.
Ein paar Eckdaten vorab, alle aus der Modelldokumentation von Z.ai:
- Kontextfenster: 1M Tokens, mit 128K maximaler Ausgabe.
- Eingaben: Text, Bild, Video und Dateien. Die Ausgabe ist nur Text.
- Reasoning: Der Denkmodus ist immer aktiv und lässt sich anders als bei den älteren GLM-Modellen nicht abschalten.
- Tooling: Function Calling, strukturierte JSON-Ausgabe, Streaming und Context Caching werden unterstützt.
- Gewichte: öffentlich auf HuggingFace, selbst hostbar über SGLang, vLLM oder TokenSpeed.
Die eine Grafik, die erklärt, warum alle über dieses Modell reden, ist das Kosten-gegen-Intelligenz-Diagramm von Artificial Analysis. GLM-5.3-Flash landet in der oberen linken Ecke („günstig und schlau“), die fast kein anderes Modell besetzt.
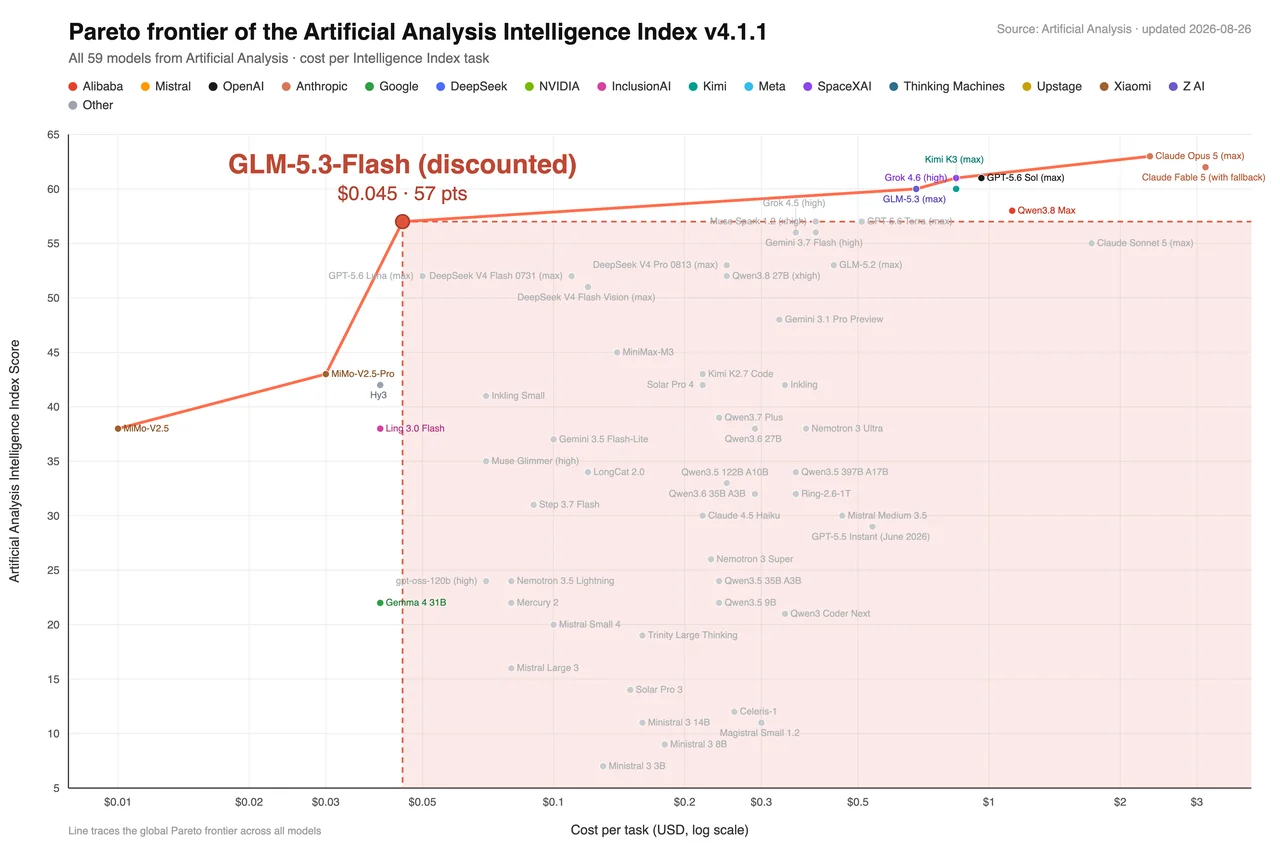
Z.ais eigene Darstellung lautet, dass es „ein Intelligenzniveau liefert, das zuvor nur zu etwa dem 10-fachen der Kosten verfügbar war“. Interessant ist, dass dies keine Marketing-Behauptung eines Aggregators ist, sondern die Zahl eines unabhängigen Benchmark-Aggregators, und die ist viel schwerer zu fälschen.
Der „Ox Alpha“-Stealth-Launch
Dieses Detail fand ich am aufschlussreichsten. Vor der offiziellen Veröffentlichung hat Z.ai es anonym betrieben, auf OpenCode und OpenRouter unter dem Namen „ox-alpha“, um echtes Nutzungsfeedback zu sammeln. Es wurde still und leise zum meistgenutzten Modell der Woche und verarbeitete mehr als doppelt so viele Tokens wie das nächstplatzierte Modell, und das alles auf chinesischen KI-Chips statt auf Nvidia-Hardware.
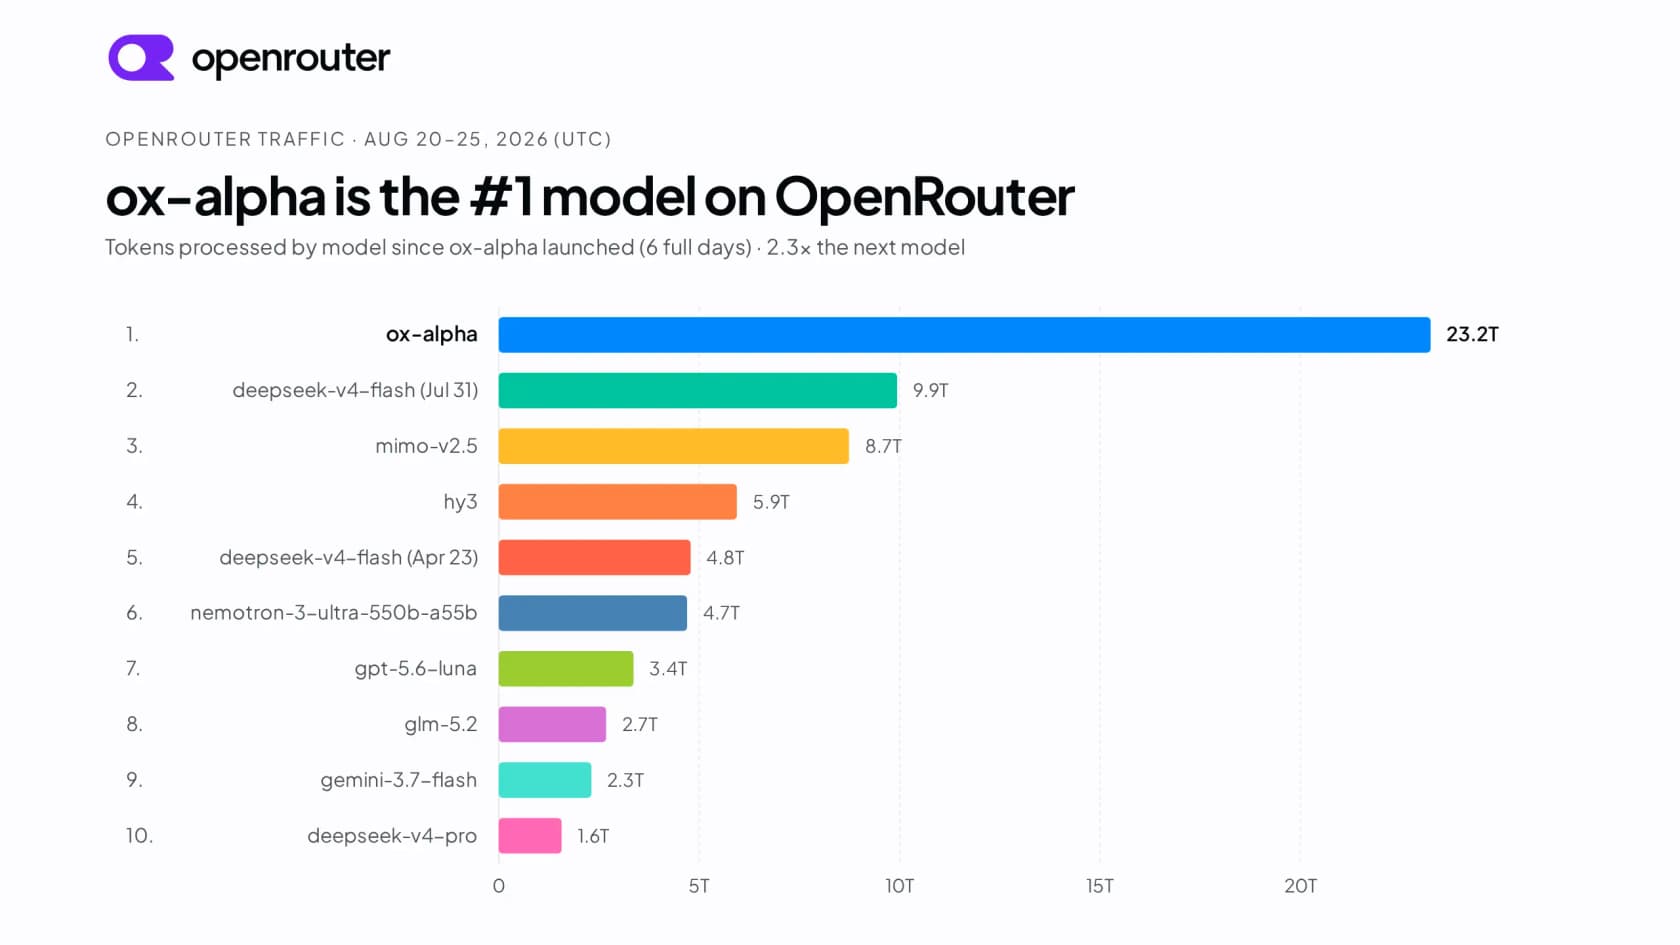
Zwei Dinge sind hier wichtig. Erstens ist ein Blindtest auf öffentlichen Plattformen etwa das ehrlichste Signal, das ein Labor erzeugen kann, denn niemand hat das Modell wegen seiner Marke gewählt. Zweitens ist der Aspekt der chinesischen Chips eine echte Geschichte. Z.ai behauptet, dies zeige, „dass chinesische Chips Frontier-Modell-Inferenz effizient und wirtschaftlich im großen Maßstab unterstützen können“. Wenn das stimmt, verändert es die Kostenrechnung für einen großen Teil des Marktes, der davon ausging, dass Frontier-Inferenz die GPUs eines ganz bestimmten Anbieters bedeutet.
Wie GLM-5.3-Flash die Kosten niedrig hält
Das ist der Teil, der mich wirklich interessiert, denn „es ist günstig“ ist nur dann interessant, wenn die Günstigkeit strukturell ist und keine Subvention, die in sechs Monaten verschwindet.
Z.ai teilt die Einsparungen in drei Ebenen auf, und das Architekturdiagramm lohnt einen genaueren Blick.
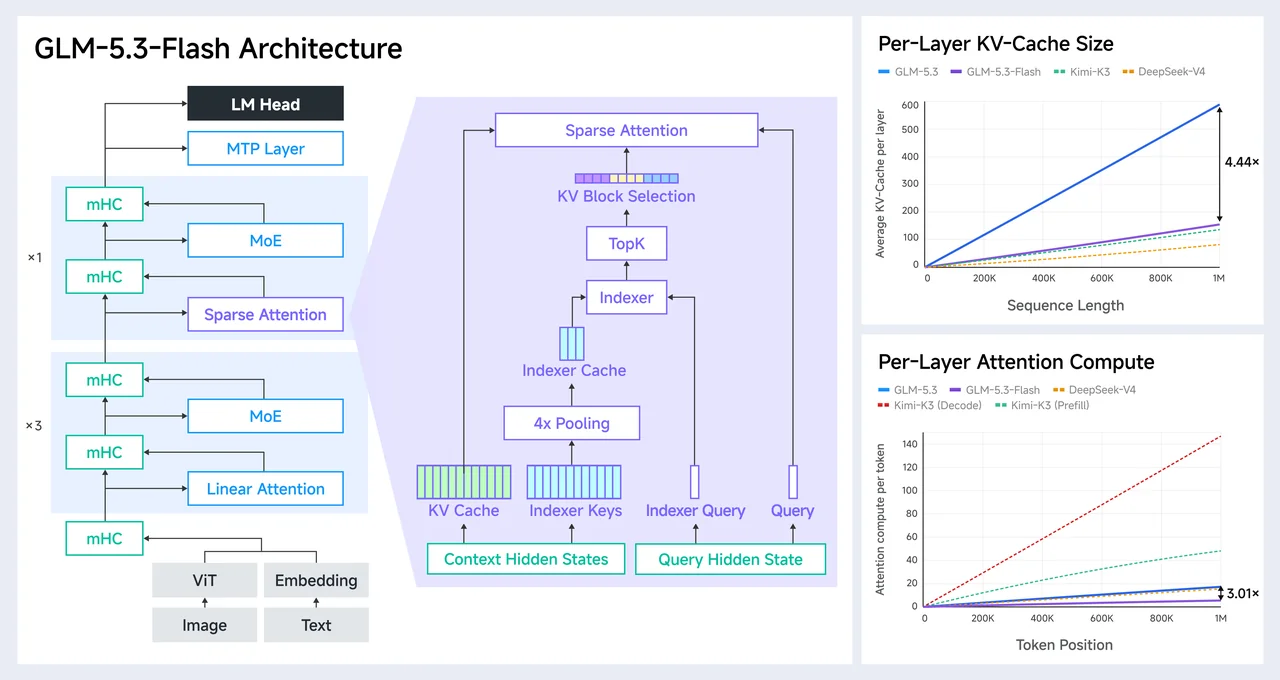
Die erste Ebene ist das Attention-Design. GLM-5.3-Flash kombiniert Sparse- und Linear-Attention: Linear Attention verarbeitet den lokalen Kontext über Zustandsmodellierung, und ein leichtgewichtiger Indexer ruft den globalen Kontext ab, der tatsächlich zählt. Der Nutzen ist konkret: Im Vergleich zum Flaggschiff GLM-5.3 senkt es den Attention-Rechenaufwand um das 3,0-Fache und die KV-Cache-Größe um das 4,4-Fache. Bei langem Kontext explodieren die Betriebskosten normalerweise, und ein kleinerer KV-Cache entscheidet darüber, ob ein 1M-Token-Fenster nur ein Demo-Feature oder bezahlbar ist.
Die zweite Ebene sind die Trainingsdaten, ein multimodaler Korpus mit 30 Billionen Tokens, der Bild- und Videoverständnis von Anfang an einbaut, statt nachträglich einen Vision-Encoder anzuflanschen. Die dritte ist das Co-Design des Gesamtsystems mit der Inferenz-Hardware, auf der es läuft.
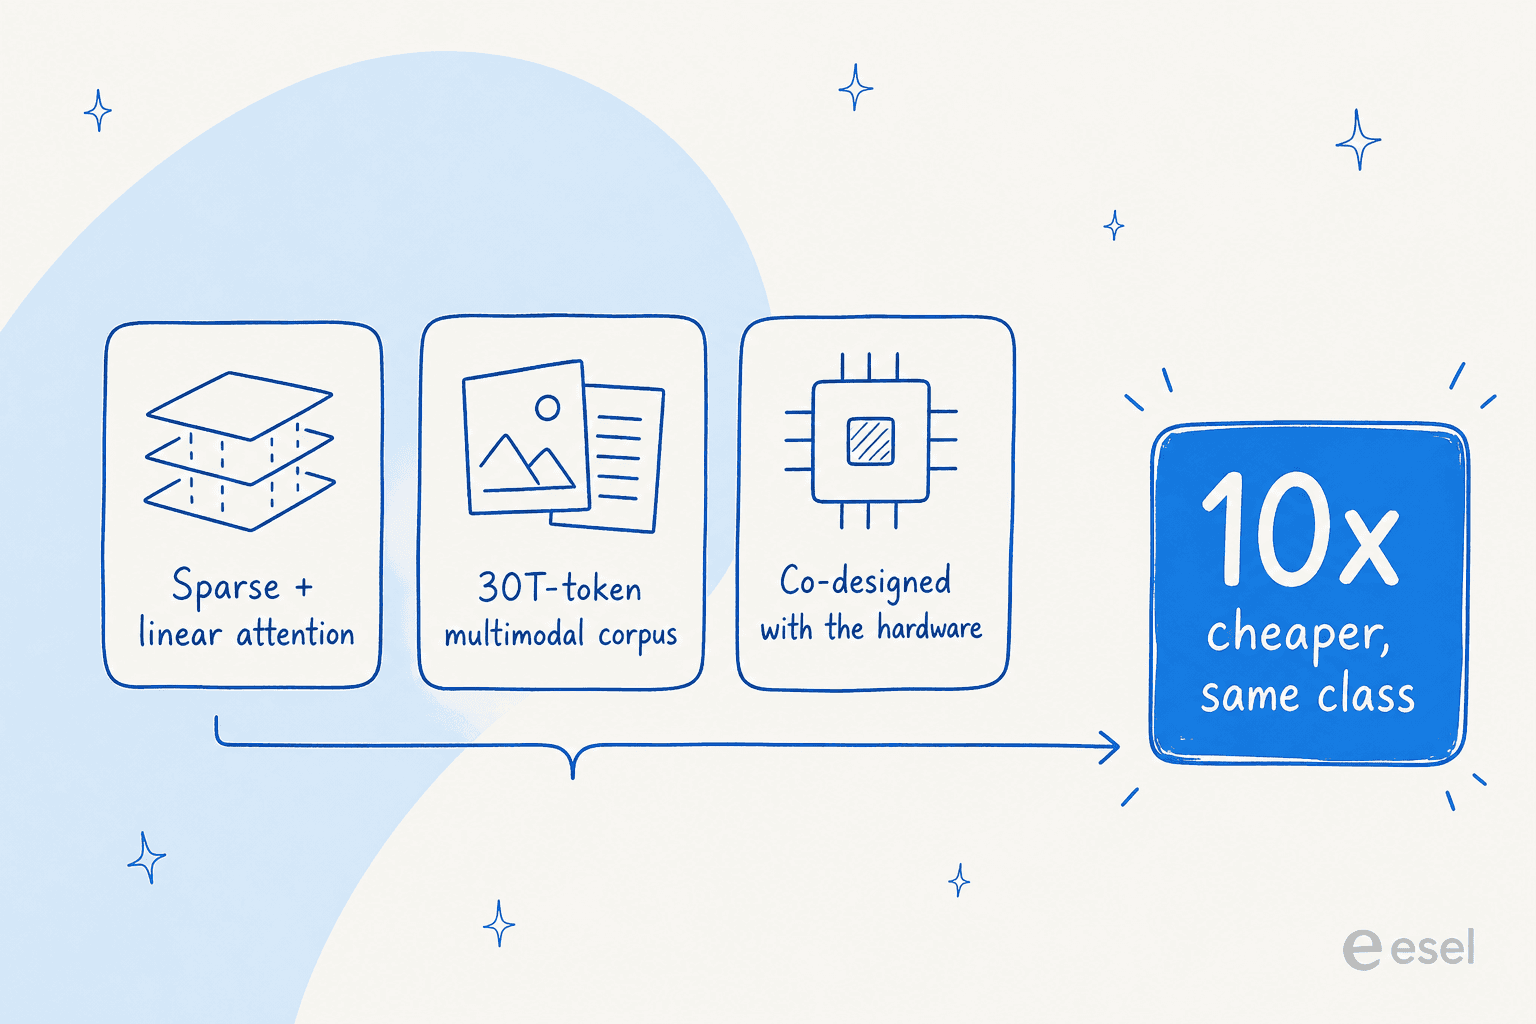
Zum Vergleich: GLM-5.3-Flash halbiert sowohl die Zahl der aktiven Parameter (18B vs. 32B) als auch die Zahl der Schichten (45 vs. 92) der älteren GLM-4.5-Reihe fast, bei ähnlicher Gesamtgröße. Weniger aktive Parameter pro Token sind der direkteste Hebel für die Kosten, und deshalb kann ein 320B-Modell wie ein kleines bepreist werden.
GLM-5.3-Flash-Benchmarks
Bei Benchmarks fliegt „günstig“ meist auf, deshalb würde ich diesen Abschnitt zweimal lesen. Z.ais eigener Vergleich stellt GLM-5.3-Flash GLM-5.2, DeepSeek-V4-Vision-Exp, Claude Opus 4.8, GPT-5.6 Terra und Gemini 3.7 Flash gegenüber.
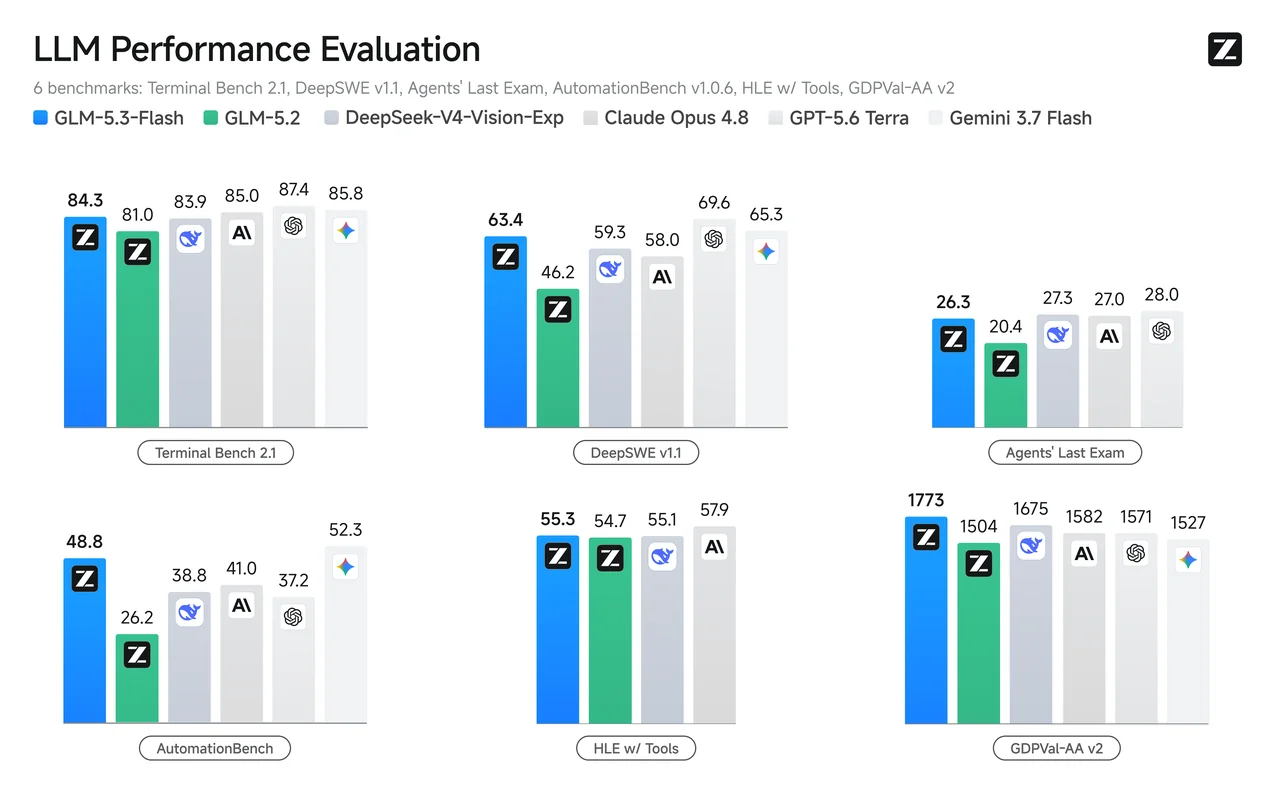
Der Sprung gegenüber der Vorgängergeneration ist die eigentliche Geschichte:
| Benchmark | GLM-5.3-Flash | GLM-5.2 | Opus 4.8 | GPT-5.6 Terra |
|---|---|---|---|---|
| DeepSWE v1.1 (Coding) | 63.4 | 46.2 | 58.0 | 69.6 |
| AutomationBench v1.0.6 | 48.8 | 26.2 | 41.0 | 37.2 |
| Toolathlon Verified | 78.4 | 59.9 | 76.2 | 74.9 |
| Terminal Bench 2.1 | 84.3 | 81.0 | 85.0 | 87.4 |
| GDPval-AA v2 | 1773 | 1504 | 1582 | 1571 |
Quelle: Z.ais GLM-5.3-Flash-Benchmarks.
Ehrlich gelesen sind zwei Dinge gleichzeitig wahr. GLM-5.3-Flash schlägt GLM-5.2 auf ganzer Linie, oft mit riesigem Abstand (bei AutomationBench fast eine Verdopplung), und es zieht bei mehreren Agenten-Aufgaben an Claude Opus 4.8 vorbei. Gleichzeitig liegt es beim reinen Coding weiterhin hinter den führenden geschlossenen Frontier-Modellen wie GPT-5.6 Terra. Auf Z.ais eigenem Code Bench bei maximalem Aufwand erreichte es 29,0 gegenüber 29,5 von Opus 4.8, „kommt fast an Opus 4.8 heran“ ist also eine faire Beschreibung und keine Übertreibung. Für ein Modell zu einem Zehntel des Preises ist es genau der Punkt, die Flaggschiffe der letzten Generation zu erreichen.
Bei der Multimodalität ist das Bild gemischter. Es erzielt starke Werte bei Diagramm- und Dokument-Reasoning (89,4 bei CharXiv, 78,0 bei Chartography), liegt aber bei reinen Video-Benchmarks wie MVbench und MMVU hinter Gemini 3.7 Flash. Wenn Ihre Aufgabe Dokument- und Oberflächenverständnis ist, ist das ermutigend; bei intensiver Videoanalyse testen Sie zuerst Gemini.
GLM-5.3-Flash-Preise
Hier ist die vollständige Preisliste, direkt aus der Preisdokumentation von Z.ai. Die Preise gelten pro Million Tokens.
| Modell | Eingabe | Eingabe aus Cache | Ausgabe | Hinweise |
|---|---|---|---|---|
| GLM-5.3-Flash | $0.075 (Liste $0.15) | $0.015 | $0.25 (Liste $0.50) | 50 % Einführungsrabatt bis 9. Sep 2026 |
| GLM-5.3 (Flaggschiff) | $1.40 | $0.26 | $4.40 | Coding und Cyber |
| GLM-5.2 | $1.40 | $0.26 | $4.40 | 1M Kontext |
| GLM-4.7-FlashX | $0.07 | $0.01 | $0.40 | Text |
| GLM-4.7-Flash | Kostenlos | Kostenlos | Kostenlos | Text, komplett kostenlos |
Ein paar Hinweise, damit niemand überrascht wird. Der Eingabepreis von $0,075 ist ein Einführungsangebot, das am 9. September 2026 um Mitternacht (Singapur-Zeit) endet und danach auf $0,15 zurückgeht. Selbst zum Listenpreis ist es mit großem Abstand das günstigste kostenpflichtige Modell der GLM-5-Reihe. Eingabe aus dem Cache ist weitere ca. 80 % günstiger, was bei Agenten-Workloads viel ausmacht, die in jedem Schritt denselben System-Prompt erneut senden. Die integrierte Websuche wird separat mit $0,01 pro Aufruf abgerechnet.
Es gibt auch einen Abo-Weg. Der GLM Coding Plan startet bei $18/Monat (Lite), $80/Monat (Pro) und $168/Monat (Max), funktioniert in Claude Code, Cline, OpenCode, Cursor und über 20 weiteren Tools und gibt GLM-5.3-Flash das 3-Fache des Kontingents des Flaggschiffs. In Nebenzeiten (dazu gehört das ganze Wochenende) wird zum halben Credit-Satz abgerechnet.
Damit die API-Seite greifbar wird, hier ein kleiner Rechner. Geben Sie Ihr tägliches Token-Volumen ein und sehen Sie die monatliche Rechnung im Vergleich zum Flaggschiff.
GLM-5.3-Flash vs. das Flaggschiff GLM-5.3 (und die kostenlosen Stufen)
Die Namen verwirren viele, deshalb sage ich offen, zu welchem Modell Sie greifen sollten.
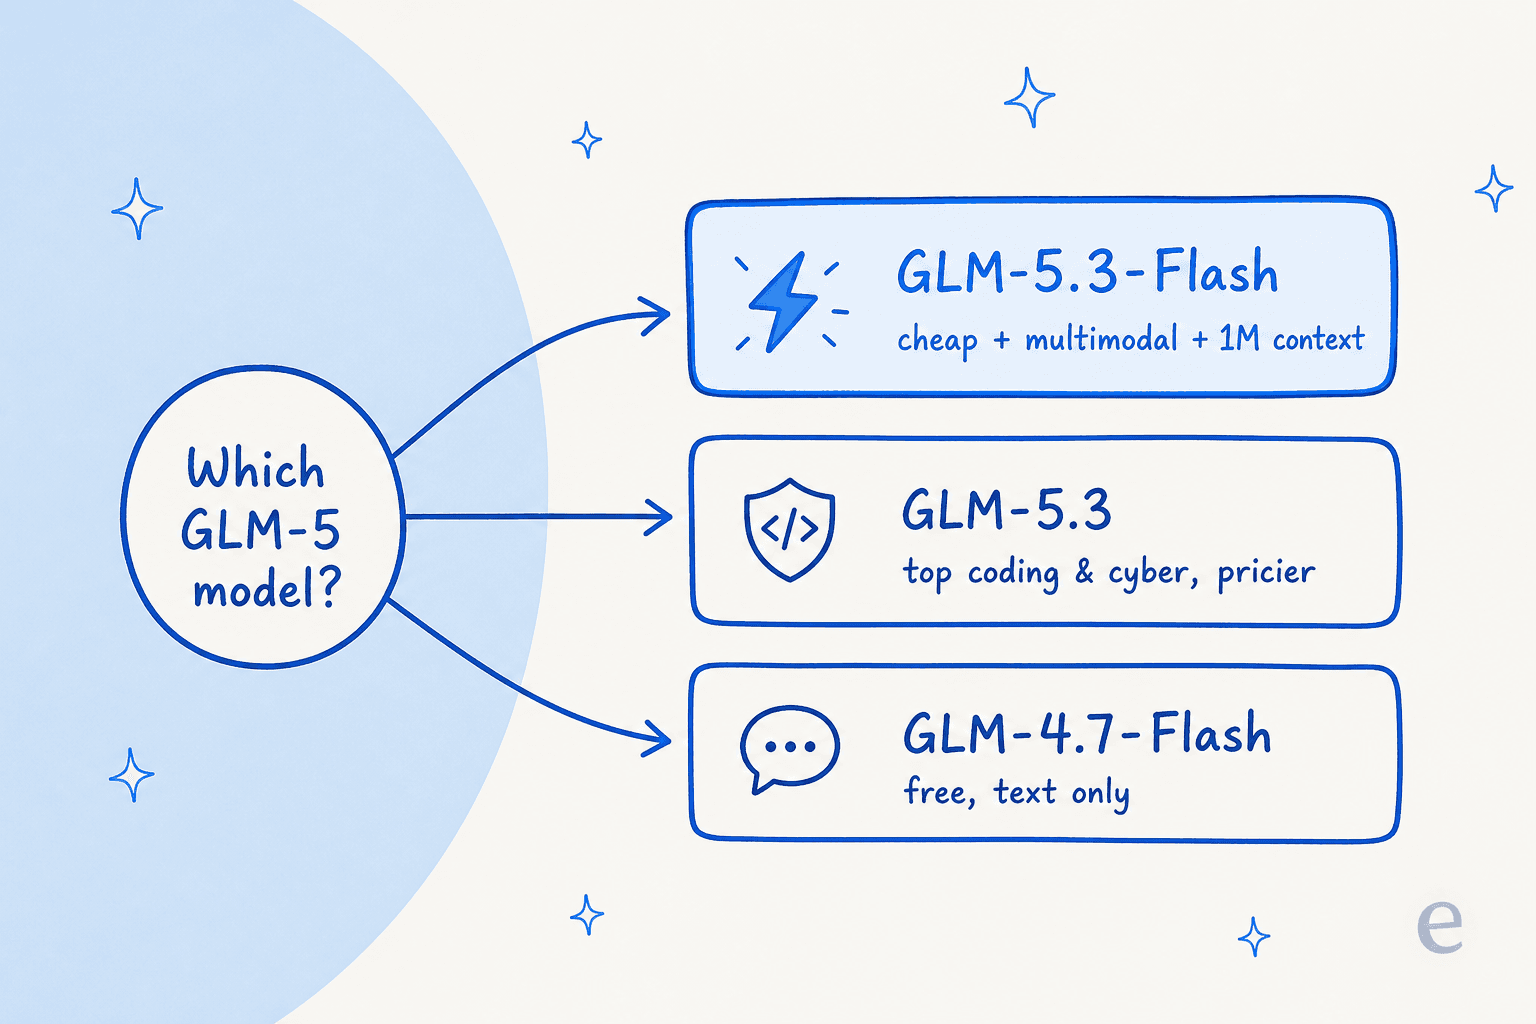
- GLM-5.3-Flash ist die Standardwahl: günstig, multimodal, 1M Kontext, hoher Durchsatz bei Drittanbietern. Am besten für Workloads mit hohem Volumen, Bild- und Dokumentaufgaben und alles, wo die Kosten pro Token den Ausschlag geben.
- GLM-5.3 (das Flaggschiff) ist ein wirklich anderes, reines Textmodell, gebaut für Coding und Cybersicherheit. Es führt seine Klasse bei CyberGym an und hat in einer Sicherheitsstudie von Z.ai 2.436 echte Schwachstellen in 269 Projekten gefunden, von denen einige jahrzehntelang unbemerkt geblieben waren. Wenn Sie anspruchsvolle Arbeit im SWE-bench-Stil oder Sicherheits-Reviews machen, zahlen Sie den Aufpreis.
- GLM-4.7-Flash und GLM-4.6V-Flash sind komplett kostenlos (Text bzw. Vision), aber älter und weniger leistungsfähig. Gut für Prototypen, nicht für Produktionsqualität.
Ein Vorbehalt, der ständig auftaucht: Die Geschwindigkeit hängt davon ab, wo Sie es betreiben. Auf Z.ais eigener API ist GLM-5.3-Flash langsam (~49 Tokens/Sekunde), und Community-Mitglieder waren dazu deutlich. Bei Drittanbietern ist es ein ganz anderes Tier: Databricks erreichte laut Artificial Analysis 272,9 Tokens/Sekunde. Wenn der Durchsatz zählt, wählen Sie Ihren Anbieter bewusst.
Was die Leute sagen
Die Reaktion der Community war laut und dreht sich um zwei Dinge: Unglauben über den Preis und Murren über die Geschwindigkeit beim Erstanbieter.
Beim Preis ist der immer wiederkehrende Vergleich der mit den anderen günstigen Open-Weight-Modellen, neben denen es jetzt steht, wie Qwen und Kimi K2.5. Aus einem viel geteilten Reddit-Thread:
"Noticeably cheaper even than Gemini Flash 3.7, while being only slightly worse performing. That's actually really impressive."

Sicherheitsforscher gehörten zu den Schnellsten, die echte Tests durchführten. Einer veröffentlichte eine konkrete Zahl zu Kosten und Funden, genau die Art spezifisches Ergebnis, dem ich mehr traue als einem Bauchgefühl:
"We benchmarked the new GLM-5.3 Flash on VulnPR-100. It found 34/100 vulnerabilities at a total model-review cost of just $4.21. That makes it the strongest sub-$10 model we've tested."
Und zur neuen Vision-Fähigkeit hat ein unabhängiger Tester eine ordentliche Stichprobe durchlaufen lassen:
"GLM-5.3-Flash vision. With 1,500 samples it scored an 81% accuracy rate, which is reasonable. It works very well."
Das ehrliche Gegengewicht ist die Geschwindigkeit. Ein r/opencode-Thread nannte den Endpunkt des Erstanbieters „one of the slowest models AA [has ever seen]“, was zu Z.ais eigener Angabe von ~49 t/s passt. Das ist eine echte Einschränkung, die anbieterspezifisch ist und keine Eigenschaft der Gewichte.
Wo ein rohes Modell aufhört und ein Teammitglied anfängt
Das ist der Teil, der bei jedem Launch eines „günstigen Frontier-Modells“ untergeht, und ich habe ihn in über drei Jahren mit KI in Live-Support-Warteschlangen auf die harte Tour gelernt: Ein Modell ist keine Lösung.
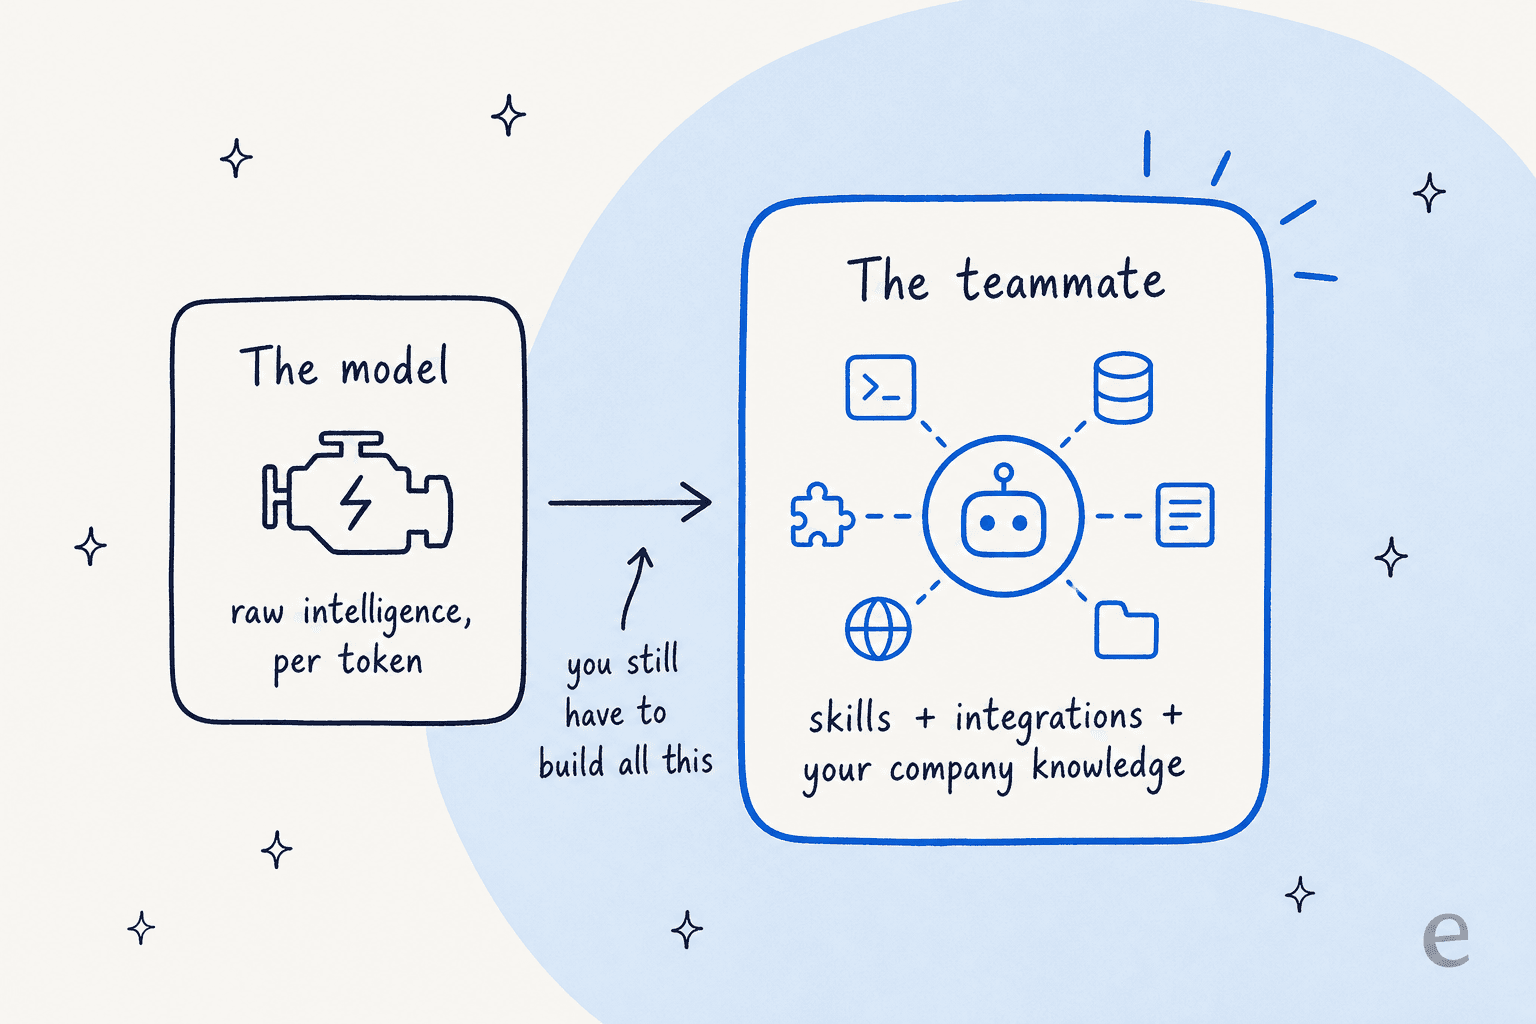
GLM-5.3-Flash liefert Ihnen günstige, leistungsfähige Intelligenz pro Token. Es liefert kein System, das Ihre Erstattungsrichtlinie kennt, den Zendesk-Verlauf eines Kunden lesen kann, per RAG das richtige Hilfedokument abruft, in Ihrem Helpdesk eine Aktion ausführt und getestet wird, bevor es mit einem echten Menschen spricht. Jeder dieser Punkte ist ein eigenes Projekt. Wir haben unser ganzes Produkt um diese Lücke herum gebaut, und die wichtigste Gewohnheit, die wir uns angeeignet haben, ist einfach: Vertrauen Sie einem Modell bei Live-Tickets nie, bevor Sie es gegen Ihren eigenen Verlauf simuliert haben. Eine selbstsicher klingende, aber unbemerkt falsche Antwort kostet mehr als eine langsame.
Wenn Sie also Entwickler sind und rohe Intelligenz in Ihren eigenen Stack einbauen wollen, ist GLM-5.3-Flash eine wirklich gute, günstige Wahl, und ich würde gern danach greifen. Wenn Sie ein Support- oder Content-Team sind, das einfach das Ergebnis will, ist das Modell der leichte Teil und der letzte Schritt die Arbeit. Dort zahlt sich eine KI-Agenten-Plattform aus. Aus demselben Grund raten wir, bei der Bewertung der KI für Kundensupport-Automatisierung fertige Agenten zu vergleichen und keine rohen Modelle.
eesel ausprobieren
Wenn Ihnen gefällt, wofür GLM-5.3-Flash steht (Antworten auf Frontier-Niveau ohne Frontier-Rechnungen), Sie es aber tatsächlich einen Job erledigen lassen wollen, statt es hinter einer API liegen zu haben, dann ist das eesel. Sie stellen ein KI-Teammitglied ein, verbinden es mit Ihren Apps, und es arbeitet ab dem ersten Tag: ein KI-Helpdesk-Teammitglied, das in Ihre bestehende Warteschlange in Zendesk, Freshdesk oder Gorgias einsteigt, und ein KI-Blog-Autor, der recherchierte, veröffentlichungsfertige Beiträge liefert.
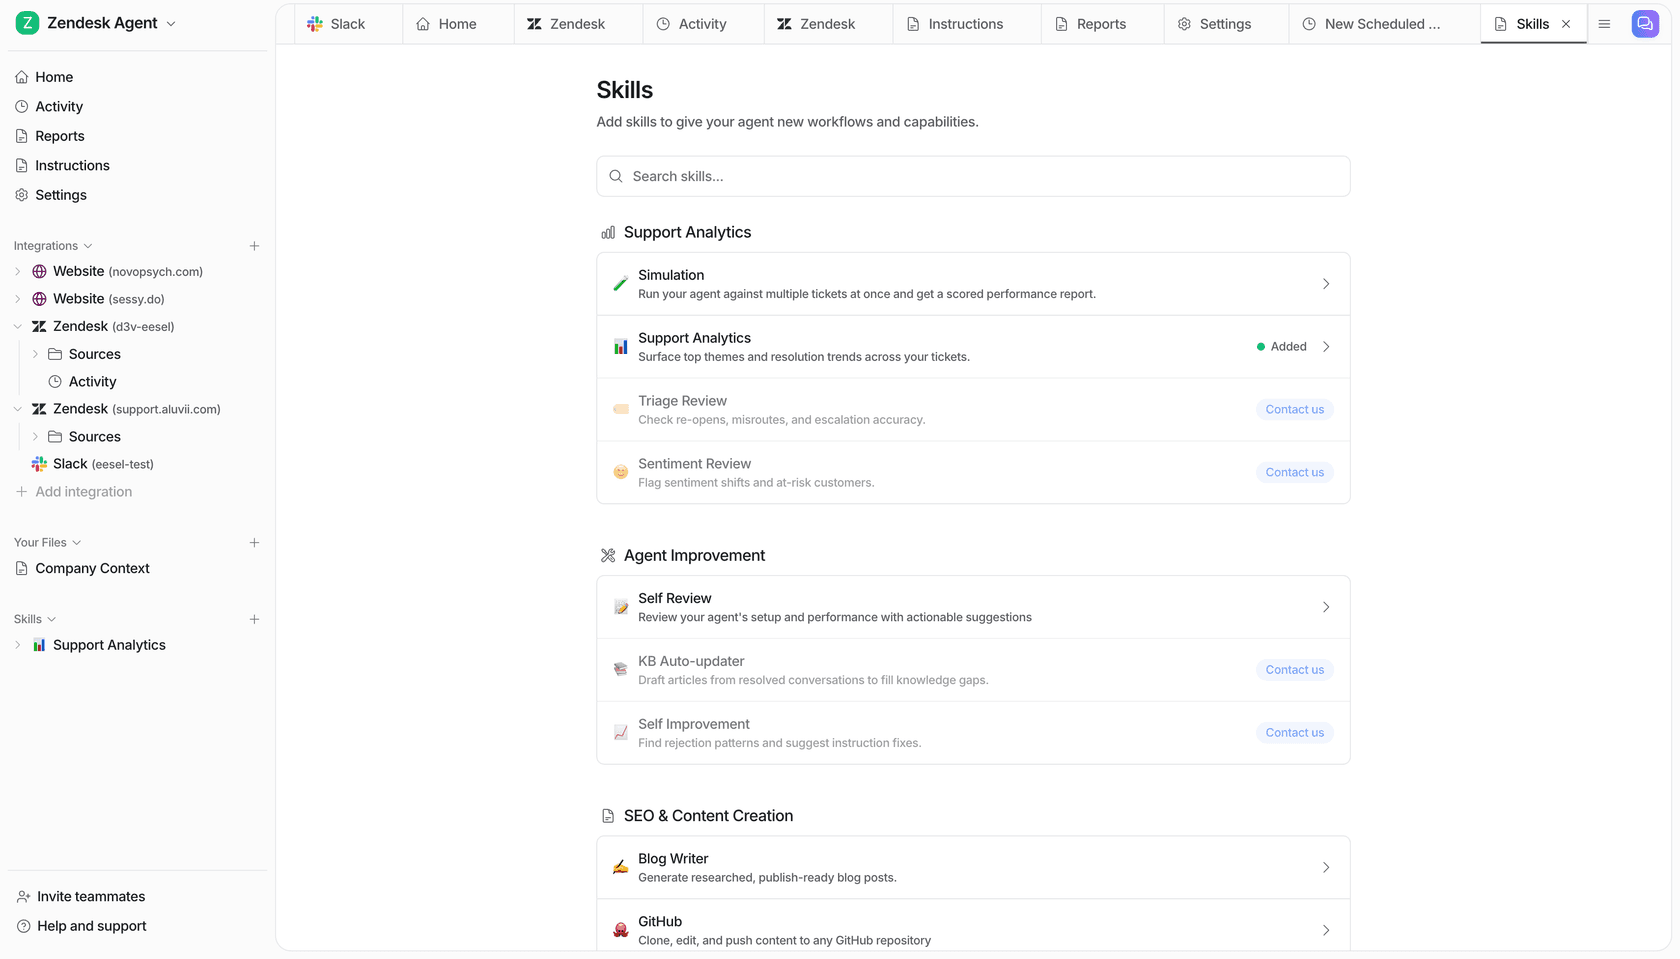
Der Unterschied zu einem rohen Modell ist die Anbindung, die schon erledigt ist: Es liest Ihre Wissensdatenbank und frühere Tickets, bringt die Integrationen und Skills für die Rolle mit, und (der Teil, der mir am wichtigsten ist) Sie können es gegen Tausende Ihrer historischen Tickets simulieren, bevor es auch nur ein einziges Live-Ticket beantwortet. Sie erhalten die Intelligenz des Modells mit dem Sicherheitsnetz, das eine rohe API nicht mitliefert. Es ist kostenlos testbar, ganz ohne Verkaufsgespräch.
Häufig gestellte Fragen
Was ist GLM-5.3-Flash?
GLM-5.3-Flash ist das erste nativ multimodale Modell der GLM-5-Reihe von Z.ai, ein Mixture-of-Experts-Modell mit 320B Parametern und 18B aktiven Parametern, einem Kontextfenster von 1M Tokens und offenen Gewichten auf HuggingFace. Z.ai positioniert es als Intelligenz auf GLM-5.2-Niveau zu etwa einem Zehntel des Preises.
Was kostet GLM-5.3-Flash?
Die API-Preise für GLM-5.3-Flash liegen laut Preisdokumentation von Z.ai bei einem Einführungspreis von $0,075 pro Million Eingabe-Tokens und $0,25 pro Million Ausgabe-Tokens bis zum 9. September 2026, danach bei einem Listenpreis von $0,15/$0,50. Außerdem ist es im GLM Coding Plan ab $18/Monat enthalten. Wenn Sie Modellkosten für den Support vergleichen, rechnet unser Leitfaden zum KI-Modell für Support-Tickets die Zahlen durch.
Ist GLM-5.3-Flash Open Source?
Die Gewichte sind auf HuggingFace öffentlich herunterladbar, und Sie können das Modell mit SGLang, vLLM oder TokenSpeed selbst hosten. Es ist also eine Veröffentlichung mit offenen Gewichten. Prüfen Sie vor der kommerziellen Nutzung die genauen Bedingungen in der Lizenzdatei. Wenn Ihnen offene Gewichte wichtig sind, behandelt unsere Übersicht der Open-Source-Chatbot-Plattformen die dazugehörigen Tools.
GLM-5.3-Flash vs. GLM-5.3: Was ist der Unterschied?
Es sind zwei verschiedene Modelle. GLM-5.3-Flash ist das günstige, multimodale Geschwister mit hohem Durchsatz (Bild- und Videoeingabe, 1M Kontext). Das Flaggschiff GLM-5.3 ist das reine Textmodell für Coding und Cybersicherheit und kostet $1,40/$4,40 pro Million Tokens. Wählen Sie Flash für Kosten und Bildverständnis, das Flaggschiff für die schwierigsten Coding-Aufgaben.
Kann ich GLM-5.3-Flash für den Kundensupport nutzen?
Sie können, aber ein rohes Modell ist noch kein Support-Agent. Es hat keinen Zugriff auf Ihre Wissensdatenbank, Ihr Helpdesk oder Ihre früheren Tickets, bis jemand all das anbindet. eesel bietet Ihnen ein KI-Helpdesk-Teammitglied, das diese Anbindung bereits erledigt hat. So erhalten Sie die Intelligenz des Modells, ohne Retrieval, Integrationen und Tests selbst aufzubauen.