

TorchNeuron ist das quelloffene PyTorch-Backend von AWS für die Trainium-Chips, seit dem 20. Oktober 2026 in der öffentlichen Beta. Es registriert Trainium als normales PyTorch-Device namens neuron, sodass die Portierung für die meisten Codebasen tatsächlich nur darin besteht, aus .to('cuda') ein .to('neuron') zu machen. Die Bibliothek ist unter Apache 2.0 kostenlos, bezahlt wird die Trainium-Zeit: 2,235 $ pro Trainium2-Chip-Stunde in EC2 Capacity Blocks, gegenüber 5,970 $ für eine H100.
Die Schlagzeile verschweigt den Haken. Der Eager-Modus ist der einfache, gut debugbare Weg, aber Produktionsgeschwindigkeit kommt von torch.compile, das auf Neuron statische Shapes braucht und bei jedem Operator scheitert, den es nicht übersetzen kann. Außerdem läuft es nur auf Trainium2 und Trainium3, Nutzer von Trainium1 und Inferentia bleiben also beim alten Stack.
Wenn du eigene Modelle auf AWS trainierst oder betreibst, ist jetzt die Woche für einen Pilotversuch. Wenn du einfach eine KI willst, die eine Aufgabe erledigt, etwa Tickets beantworten, kannst du die Chip-Frage überspringen: Ein eesel-KI-Teammate übernimmt die Modellebene, und SE Ranking betreibt einen über drei Produkte hinweg mit rund 4.650 Gesprächen im Monat.
Was ist TorchNeuron?
TorchNeuron ist ein natives PyTorch-Backend für AWS Trainium, die Familie eigener KI-Chips, die Amazon seit dem Kauf von Annapurna Labs im Jahr 2015 entwickelt. Es wurde am 19. Oktober 2026 im PyTorch-Blog angekündigt und ging am 20. Oktober auf der PyTorch Conference North America als quelloffene öffentliche Beta live. Der Code liegt unter aws-neuron/torch-neuronx unter Apache 2.0.
Ich baue Integrationen und APIs für eesel, und „funktioniert mit einer Zeile Änderung" ist die Aussage, der ich am wenigsten traue, vor allem weil ich sie selbst schon auf unseren eigenen Seiten geschrieben habe. Also habe ich die Dokumentation, das Repository und das Launch-Material gelesen, bevor ich es geglaubt habe. Die Kurzfassung: Die Aussage stimmt für den Eager-Modus, und die eigentliche Ingenieursarbeit verschiebt sich in den Compile-Schritt.
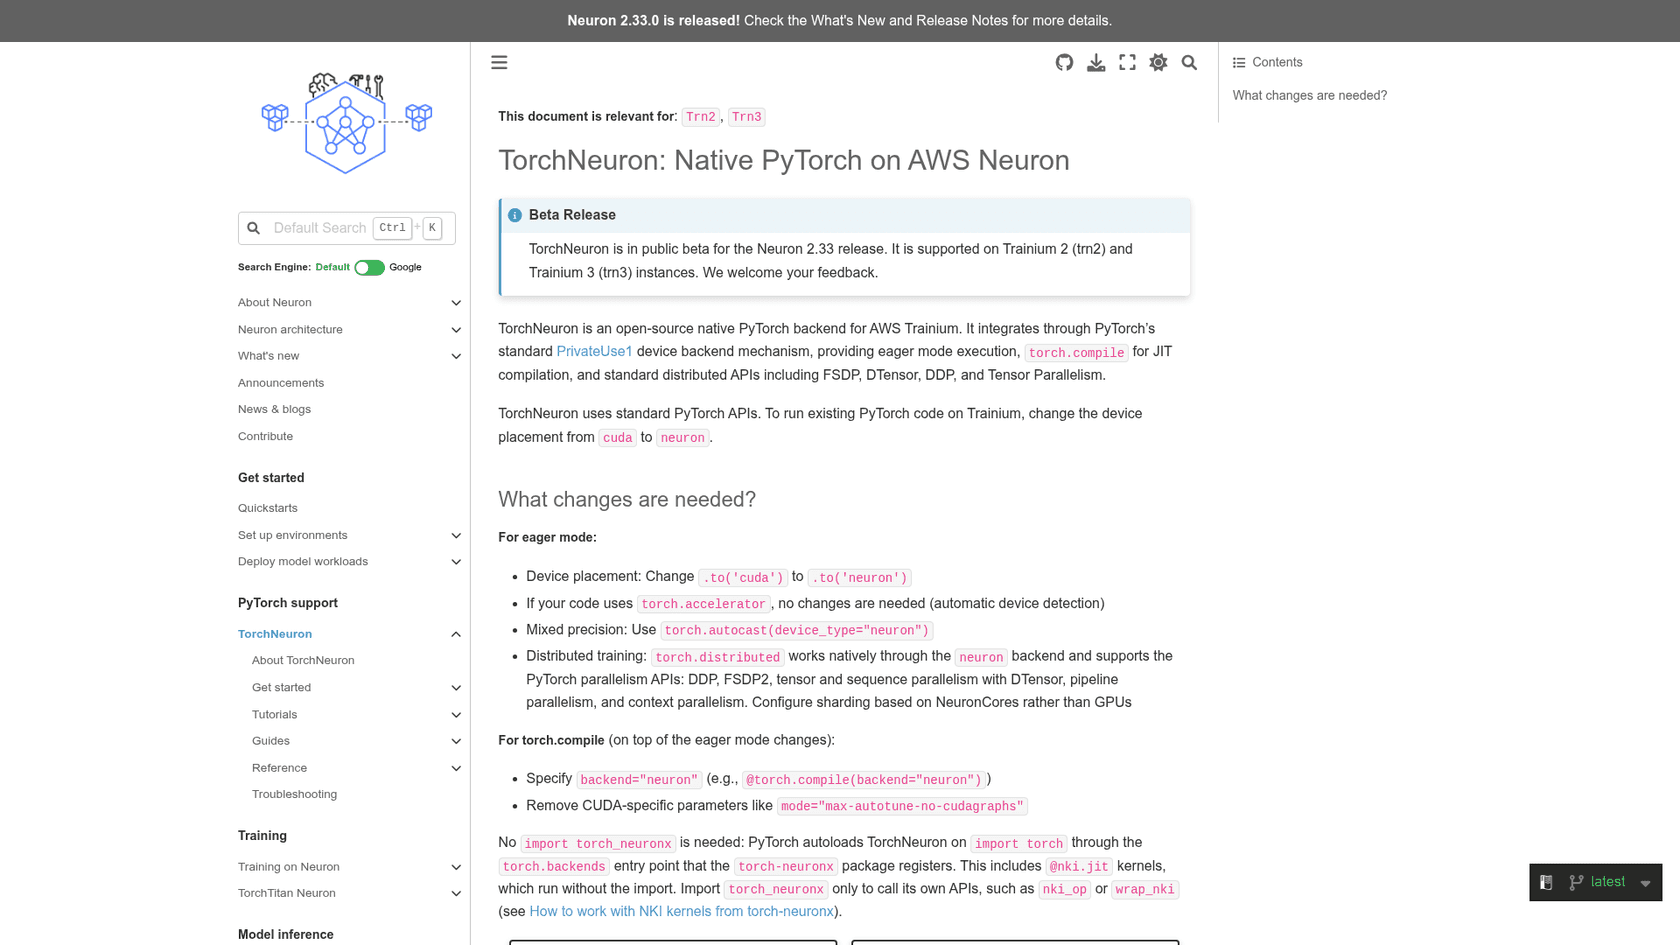
Die offizielle Dokumentation sagt es klar: TorchNeuron ist in der öffentlichen Beta für das Release Neuron 2.33 und läuft auf Trainium2-Instanzen (trn2) und Trainium3-Instanzen (trn3). Amazons eigene Darstellung auf About Amazon lautet, dass 85 % der KI-Forscher und Entwickler ihren Code in PyTorch schreiben, und dass die Übertragung dieses Codes auf neue Chips bisher Monate des Umschreibens und erneuten Validierens bedeutete.
Andy Jassy, CEO von Amazon, hat am selben Tag auf X das Geschäftsargument formuliert:
"Trying a new AI chip used to be a lot of work. You often had to rewrite your code, revalidate it, and sink many weeks in, betting this new chip is the right one for your workload."
Was ist hier eigentlich neu?
Trainium führt PyTorch schon seit Jahren aus, also ist die Frage berechtigt, was sich geändert hat. Die Antwort liegt in der Technik darunter. Bis PyTorch 2.9 lief PyTorch auf Neuron über PyTorch/XLA, das Lazy Tensors nutzte: Nichts lief, bevor ein Graph nachverfolgt und kompiliert war, weshalb Prints, Breakpoints und Python-Kontrollfluss sich seltsam verhielten. AWS kündigte an, dass PyTorch 2.9 die letzte XLA-basierte Version sein würde und 2.10 und später auf native Unterstützung umsteigen.
TorchNeuron hängt sich in PrivateUse1 ein, den offiziellen PyTorch-Erweiterungspunkt für eigene Hardware. Für PyTorch wird Trainium damit einfach ein weiteres Device neben CPU und CUDA. Deshalb kann der Launch-Beitrag sagen, dass torch.nn, torch.autocast, torch.distributed und torch.profiler auf dem neuron-Device wie geschrieben funktionieren.
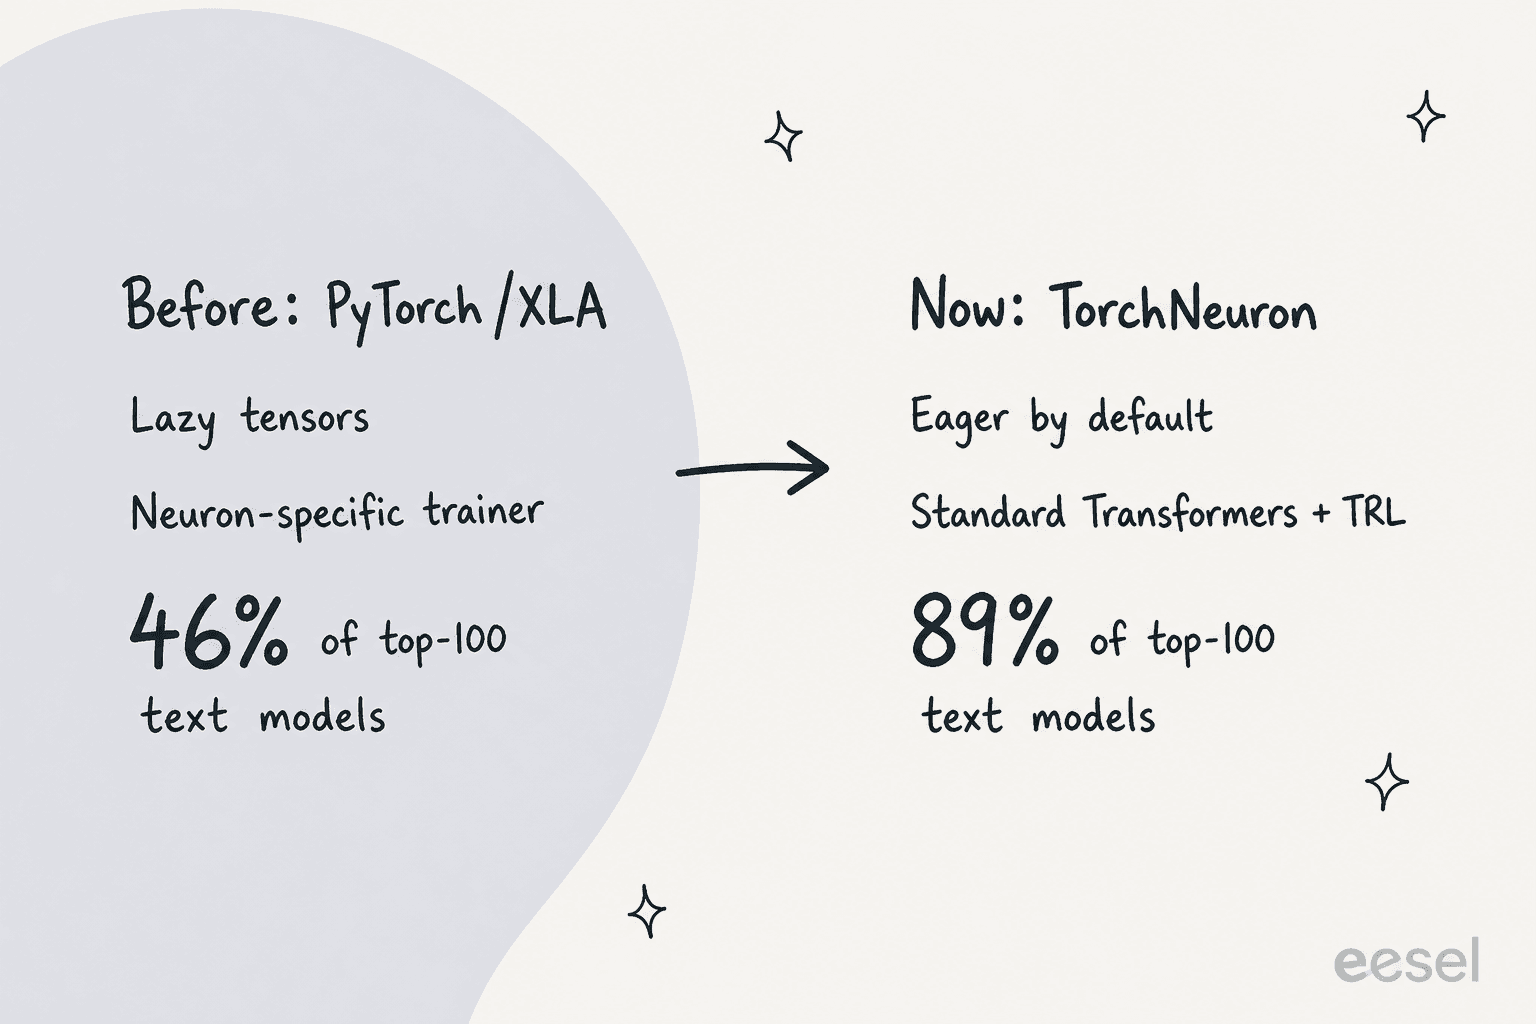
Das klarste Maß für die Veränderung liefert Hugging Face. In seinem Launch-Beitrag schreibt Hugging Face, dass 89 % der 100 wichtigsten Architekturen für Textgenerierung jetzt ohne Anpassung laufen, gegenüber 46 % mit der älteren Bibliothek Optimum Neuron v0.4.5. Es empfiehlt jetzt, Transformers, Diffusers, Accelerate, PEFT und TRL direkt auf Trainium zu nutzen, statt über Optimum Neuron zu gehen.
Hier das Vorher und Nachher in einer Tabelle:
| PyTorch/XLA (torch-neuronx vor 2.14) | TorchNeuron (torch-neuronx 2.14+) | |
|---|---|---|
| Ausführung | Lazy Tensors, nachverfolgte Graphen | Standardmäßig Eager, torch.compile optional |
| Debugging | Auf Graph-Ebene, Prints verzögert | Python-Prints und Breakpoints funktionieren |
| Hugging-Face-Pfad | Optimum-Neuron-Wrapper | Transformers, TRL, Diffusers direkt |
| Verteilt | Neuron-spezifische APIs | DDP, FSDP2, DTensor, TP, PP |
| Chips | Trn1, Trn2, Inferentia | Nur Trn2 und Trn3 |
| PyTorch-Versionen | Bis 2.9 | 2.14 im aktuellen Release |
Die letzte Zeile ist wichtiger, als die Berichterstattung zum Launch nahelegt, und ich komme im Abschnitt zu den Grenzen darauf zurück.
Wie TorchNeuron funktioniert
Unter der Haube hat TorchNeuron zwei Backends: eines, das für den Eager-Modus beim PyTorch-Dispatcher registriert ist, und eines, das für torch.compile bei TorchDynamo registriert ist. Beide übergeben die Arbeit an den Neuron-Compiler, der NEFF-Dateien (Neuron Executable File Format) erzeugt, die die Neuron-Runtime auf dem Chip ausführt.
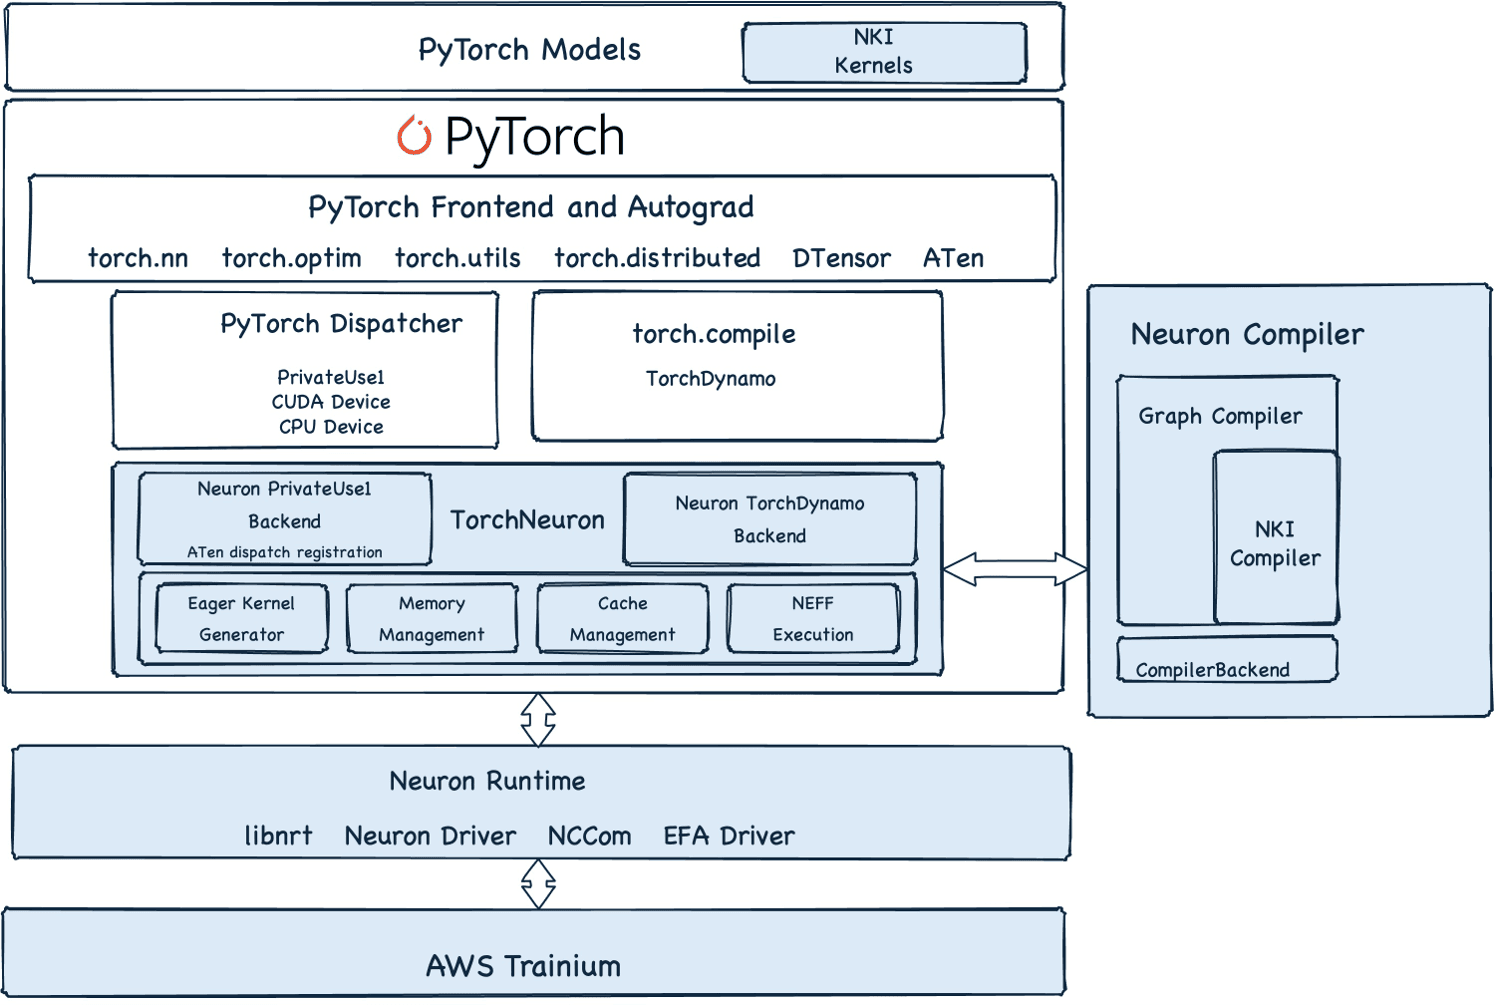
Die Seite About TorchNeuron erklärt die beiden Pfade im Detail. Sie verhalten sich so unterschiedlich, dass ich sie als zwei Produkte behandeln würde.
Eager-Modus führt jede Operation aus, sobald du sie aufrufst. Beim ersten Lauf eines Operators wird er zu einer eigenen NEFF kompiliert und landet in einem Cache auf der Festplatte; danach kommt er aus dem Cache. Hat ein Operator keine Neuron-Implementierung, fällt er mit einer Warnung auf die CPU zurück, das Modell läuft also trotzdem. Es gibt außerdem einen experimentellen adaptiven Eager-Modus (setze TORCH_NEURONX_ENABLE_CONCATENATION=1), der geeignete Operationen zusammenfasst, um den Start-Overhead zu senken.
torch.compile erfasst das Modell über TorchDynamo und AOTAutograd in einem Graphen, übersetzt es über Torch-MLIR in StableHLO und kompiliert den ganzen Graphen zu einer einzigen NEFF. Das ist der Produktionspfad. Der Preis ist Strenge: Laut GitHub-README muss dynamic auf False stehen, mode akzeptiert nur "default", Tensoren müssen zusammenhängend sein, und jede neue Eingabeform löst eine neue Kompilierung aus. Ein erfasster Operator, den das Backend nicht übersetzen kann, lässt die Kompilierung standardmäßig fehlschlagen.
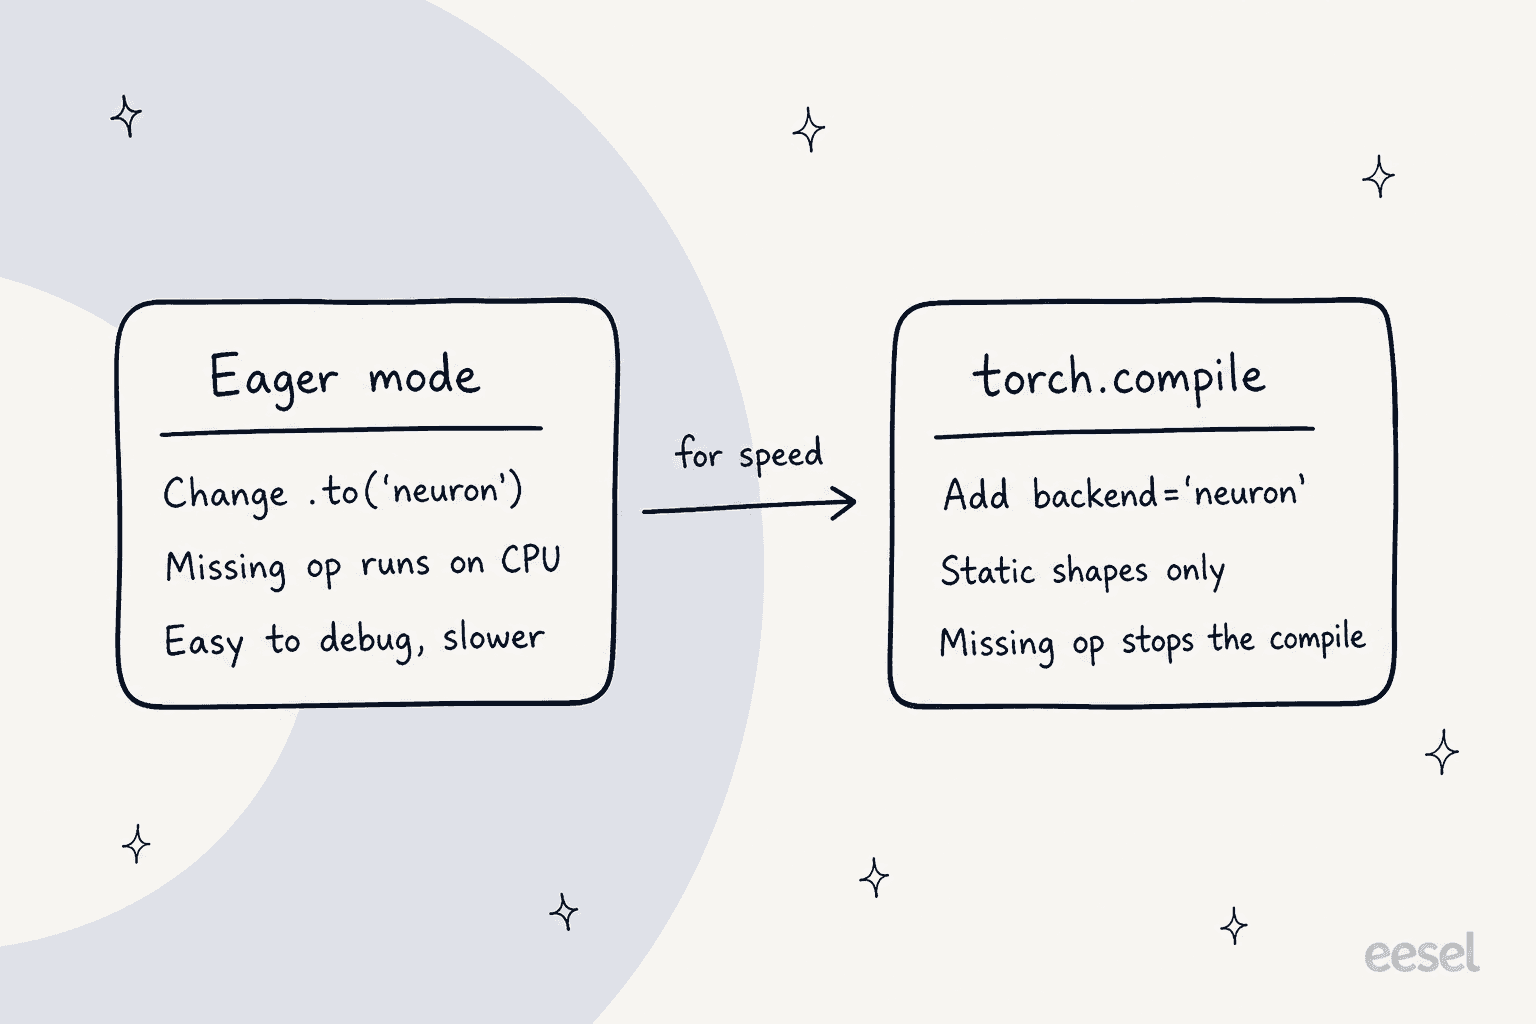
Die ehrliche Lesart von „eine Konfigurationsänderung" lautet also: eine Änderung zum Start und eine zweite Arbeitsrunde, um schnell zu werden. In der Praxis besteht diese zweite Runde meist darin, Eingaben auf wenige feste Shapes aufzufüllen oder zu bündeln und TORCH_NEURONX_NEFF_CACHE_DIR auf gemeinsamen Speicher zu setzen (die Dokumentation schlägt Amazon FSx vor), damit eine Flotte nicht auf jeder Instanz dieselben Graphen neu kompiliert.
Über beiden Modi sitzt NKI, das Neuron Kernel Interface, zum Schreiben eigener Kernel, wenn der Compiler nicht reicht. Du registrierst einen NKI-Kernel mit nki_op als normalen PyTorch-Operator, und er funktioniert im Eager-Modus und in einem kompilierten Graphen. AWS hat außerdem NKI-lib quelloffen gemacht, eine Sammlung optimierter Kernel, darunter FlashAttention und MoE-Blockwise-Kernel.
Wie die Codeänderung aussieht
Für eine Trainingsschleife zeigt der Launch-Beitrag den gesamten Diff als eine Zeile:
model = MyModel().to('neuron')   # the only change
optimizer = torch.optim.AdamW(model.parameters())
for batch in dataloader:
    optimizer.zero_grad()
    loss = criterion(model(batch), targets)
    loss.backward()
    optimizer.step()
Für die kompilierte Variante nennst du das Backend einmal mit torch.compiler.set_default_backend("neuron") oder pro Aufruf mit torch.compile(model, backend="neuron"). Code, der gegen torch.accelerator geschrieben ist, PyTorchs geräteunabhängige API, braucht gar keine Änderung. Du musst nicht einmal import torch_neuronx schreiben: Das Paket registriert sich über den Entry Point torch.backends und wird bei import torch geladen.
Die vollständige Liste der Änderungen aus der Dokumentation ist kurz:
- Ändere
.to('cuda')in.to('neuron')oder verlasse dich auftorch.accelerator. - Nutze
torch.autocast(device_type="neuron")für gemischte Präzision. - Konfiguriere bei verteilten Jobs das Sharding nach NeuronCores statt nach GPUs.
- Füge bei
torch.compilebackend="neuron"hinzu und entferne CUDA-spezifische Einstellungen wiemode="max-autotune-no-cudagraphs".
Für Hugging-Face-Modelle ist es noch kürzer. Wer ein Modell mit device_map="neuron" lädt, legt die Gewichte auf Trainium, und device_map="auto" findet das Device selbst. Das Hugging-Face-Beispiel feintunt mit einem Standard-TRL-SFTTrainer-Skript auf 8 Trainium2-Chips (eine halbe trn2.48xlarge), mit einer Neuron-spezifischen Einstellung: HF_DEACTIVATE_ASYNC_LOAD=1, weil asynchrones Laden von Gewichten noch nicht unterstützt wird. Der gespeicherte Checkpoint ist ein normaler Transformers-Checkpoint, den du auf jeder Hardware laden kannst.
Das ist die Art mechanischer Portierung, in der Coding-Agenten gut sind. Wenn du ein Repository umziehst, können Tools wie Claude Code oder OpenAI Codex die CUDA-spezifischen Aufrufe finden und austauschen, solange du die Compile-Logs selbst prüfst.
Was kostet TorchNeuron?
Die Bibliothek ist kostenlos. TorchNeuron steht unter Apache 2.0, wird mit pip install torch-neuronx aus dem Neuron-pip-Repository installiert und ist in der Neuron Deep Learning AMI und den Deep Learning Containers vorinstalliert. Kosten entstehen durch die Trainium-Zeit.
AWS veröffentlicht die Trainium-Preise auf seiner Capacity-Blocks-Preisseite, wo du Beschleunigerkapazität für einen festen Zeitraum reservierst. Das sind die effektiven Stundensätze vom 20. Oktober 2026, und AWS gibt an, dass das nächste geplante Preisupdate im Januar 2027 kommt:
| Instanz | Beschleuniger | Pro Instanz-Stunde | Pro Chip-Stunde | Funktioniert mit TorchNeuron? |
|---|---|---|---|---|
| trn2.48xlarge (US East, Ohio) | 16 x Trainium2 | 35,7608 $ | 2,235 $ | Ja |
| trn2.3xlarge (ausgewählte Regionen) | 1 x Trainium2 | 2,235 $ | 2,235 $ | Ja |
| trn1.32xlarge | 16 x Trainium | 9,532 $ | 0,596 $ | Nein |
| p5.48xlarge | 8 x H100 | 47,757 $ | 5,970 $ | GPU, nicht Neuron |
| p5e.48xlarge | 8 x H200 | 54,924 $ | 6,866 $ | GPU, nicht Neuron |
| p5en.48xlarge | 8 x H200 | 63,158 $ | 7,895 $ | GPU, nicht Neuron |
Für Linux fällt auf diesen Blocks keine zusätzliche Betriebssystemgebühr an. Für Trn3-UltraServer, die auf bis zu 144 Trainium3-Chips skalieren, gibt es auf dieser Seite keinen öffentlichen Stundenpreis.
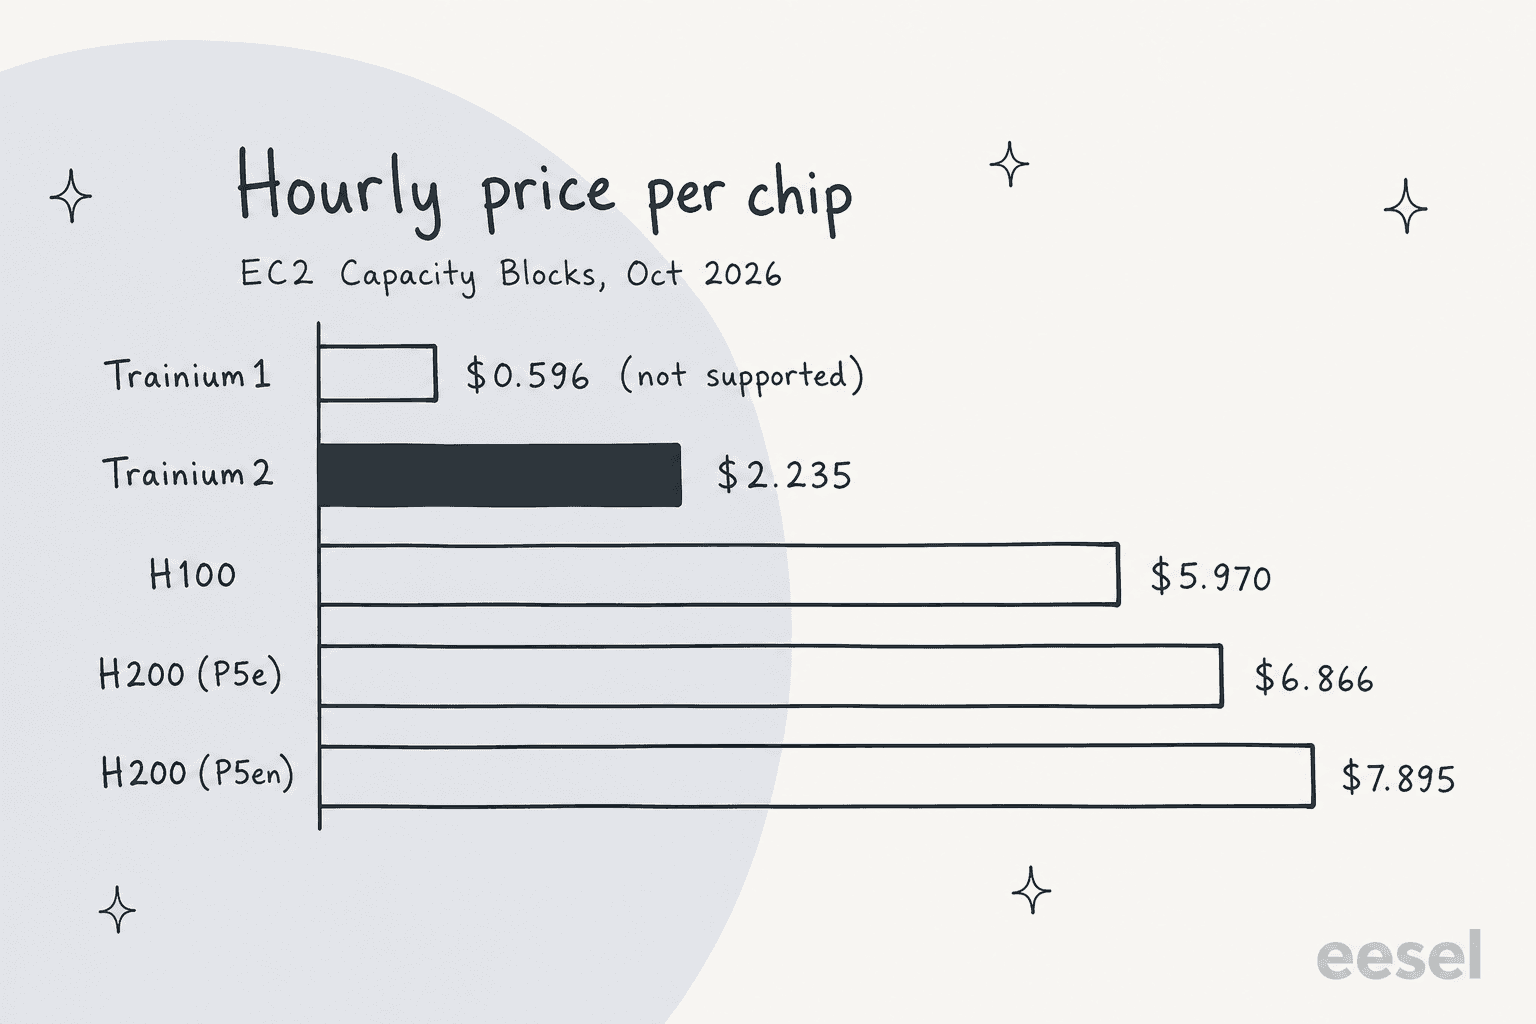
Pro Chip kostet eine Trainium2-Stunde etwa 37 % einer H100-Stunde. Das heißt nicht, dass dein Job nur 37 % kostet, denn ein Trainium2-Chip und eine H100 leisten unterschiedlich viel. AWS' eigene Aussage auf der Trn2-Seite ist enger gefasst: Trn2-Instanzen bieten „30-40% better price performance than GPU-based EC2 P5e and P5en instances." Eine trn2.48xlarge hat 16 Trainium2-Chips, 1,5 TB HBM und bis zu 20,8 FP8-Petaflops.
Die einzige Kundenzahl vom Launch stammt von Deepgram, dem Anbieter für Spracherkennung:
"In the benchmarks we evaluated, Trainium processes about 60% more input audio seconds per dollar than our existing GPU baselines, which helps us bring better models to customers at lower prices."
Adam Sypniewski, CTO of Deepgram, im PyTorch-Blog
Beachte den Rahmen hinter dieser Zahl: Deepgram hat sein Modell in einem mehrmonatigen Projekt mit dem AWS Generative AI Innovation Center portiert. Das ist ein echtes Ergebnis, aber eine begleitete Migration und kein Wechsel am Wochenende. Für den Preisvergleich zwischen GPU-Clouds decken meine Aufschlüsselungen zu CoreWeave-Preisen und Lambda-Preisen die andere Seite der Tabelle ab, und der AWS-Preisleitfaden den Rest der Rechnung.
Benchmarks und Testabdeckung
AWS hat zum Launch keine Rangliste zur Modellgeschwindigkeit veröffentlicht. Veröffentlicht hat es Abdeckungstests, die ich für eine Beta für die nützlichere Zahl halte. Laut Launch-Beitrag lässt AWS fortlaufend etwa 100.000 Hugging-Face-Modelle in reduzierter Konfiguration auf Trainium laufen, ausgewählt so, dass sie 99,9 % der realen Nutzung nach Downloadzahl abdecken. Jeder Lauf prüft, ob das Modell lädt, ob Forward- und Backward-Pass laufen und ob es kompiliert.
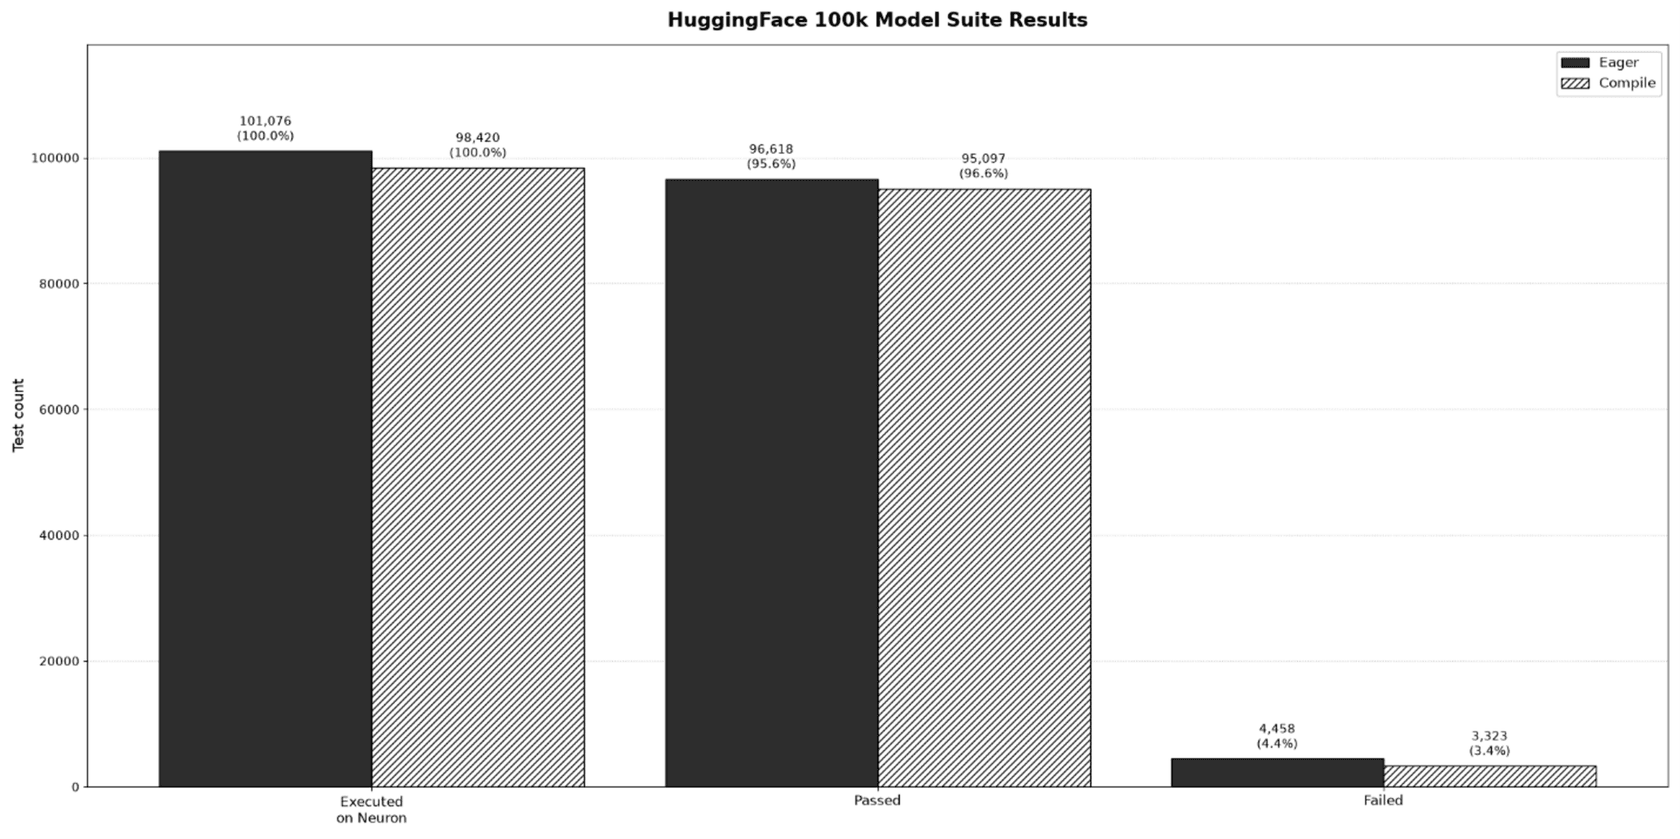
Die Ergebnisse vom September 2026: 95,6 % bestehen im Eager-Modus und 96,6 % unter torch.compile, mit 4.458 beziehungsweise 3.323 Fehlschlägen. Das ist eine starke Beta-Zahl und die richtige Art von Test. Bei eesel habe ich dieselbe Lektion von der anderen Seite gelernt: Ein Support-Agent, der in der Demo großartig aussieht, kann bei echten Tickets trotzdem selbstsicher falsche Antworten geben, weshalb wir jeden Rollout gegen die bisherigen Tickets eines Kunden simulieren, bevor er live geht. Ein Durchlauf über 100.000 echte Modelle ist AWS' Entsprechung dafür bei einem Compiler.
Die Upstream-Testsuite von PyTorch zeigt, wo die Lücken sind. Der Lauf vom August 2026 ergab etwa 154.000 Testergebnisse, von denen etwa 69.000 übersprungen wurden. Rund 30.000 wurden von PyTorchs eigenen Eignungsprüfungen übersprungen (reine CUDA- und reine CPU-Tests). Die übrigen ~39.000 waren bewusste Neuron-Skips, die größte Gruppe davon ~22.000 Tests für Operatoren, die noch keine native Neuron-Übersetzung haben.
Bei der Hardware behauptet die Trn3-Seite, dass Trn3-UltraServer bis zu 4,4-fache Leistung und 4-fache Leistung pro Watt gegenüber Trn2-UltraServern bieten, mit bis zu 362 MXFP8-Petaflops über 144 Chips. Das sind AWS' Zahlen für den Chip, keine TorchNeuron-Ergebnisse, und unabhängige Benchmarks für beides habe ich bisher nicht gesehen.
Was TorchNeuron noch nicht kann
Das ist ein erstes Release, und AWS ist ungewöhnlich direkt darin, was es weggelassen hat. Aus dem Launch-Beitrag und der README:
- Ältere Chips. Nur Trn2 und Trn3 werden unterstützt. Trainium1, mit 0,596 $ pro Chip-Stunde der günstigste Beschleuniger in der Tabelle oben, und Inferentia bleiben bei der XLA-basierten torch-neuronx-Linie (Versionen vor 2.14).
- Dynamische Shapes.
torch.compilebraucht statische Shapes. Eingaben variabler Länge bedeuten Auffüllen oder Bündeln, und jede neue Form kompiliert neu. - Präzision. float64 läuft als float32, was Ergebnisse verändern kann, die 64-Bit-Präzision brauchen. Die Unterstützung für int64 hängt von der Operation ab.
- Bewusst ausgelassene Funktionen. Sparse-Tensoren, NestedTensor, Forward-Mode-Autograd, beliebige Attention-Masken in nativer Multi-Head-Attention (ohne Maske und kausal funktionieren), Quantisierung pro Kanal und bilineares/bikubisches Upsampling sind in diesem Release nicht enthalten.
- FP8 und TorchAO. Diese sind in der privaten Beta, die allgemeine Verfügbarkeit ist für das nächste Release geplant. Die Unterstützung für FlexAttention ist begrenzt.
- Compile-Zeit beim ersten Lauf. Der erste Aufruf einer Operation oder eines kompilierten Graphen enthält die Kompilierung, die laut README „can be significant for a large model" sein kann.
Die Reaktion der Community ist bisher überwiegend vorsichtiger Optimismus von Leuten, die so eine Portierung schon gemacht haben. In einer Antwort an Jassy sagte es ein Ingenieur so:
"Big if this works flawlessly. I have been on the other end, it's not been pretty."
Eine andere Antwort unter dem Beitrag von AWS-CEO Matt Garman nannte den längerfristigen Test: ob AWS seine Änderungen weiter in PyTorch selbst einbringt.
"Open sourcing is the easy half, upstreaming is the harder promise."
AWS hat damit begonnen: Der Launch-Beitrag listet 26 Pull Requests an PyTorch und TorchTitan, die die Testqualität verbessern und hartcodierte CUDA-Annahmen entfernen sollen.
Bevor du einen Capacity Block buchst, lohnt es sich, deine Codebasis gegen diese Liste zu prüfen. Hake an, was zutrifft:
Hake an, was dein Workload nutzt, um die Lösung für jeden Blocker zu sehen, abgeleitet aus der TorchNeuron-Dokumentation und README.
Wie TorchNeuron im Vergleich zu anderen Wegen abschneidet, Modelle auszuführen
TorchNeurons eigentlicher Rivale ist die GPU. Für ein Team, das eigene Modelle trainiert oder betreibt, sieht die Wahl so aus:
| Option | Was du verwaltest | Codeänderungen | Am besten für |
|---|---|---|---|
| TorchNeuron auf Trainium | Instanzen, Compile-Cache, Shapes | Device-Name, statische Shapes für Compile | AWS-gebundene Teams mit stetigen, großen Jobs |
| NVIDIA-GPUs auf AWS (P5, P5e, P5en) | Instanzen | Keine für CUDA-Code | Code mit eigenen CUDA-Kerneln, schnellster Start |
| GPU-Clouds (CoreWeave, Lambda) | Instanzen oder Cluster | Keine für CUDA-Code | GPU-Kapazität außerhalb der großen Clouds |
| Serverless-GPUs (Modal, Baseten) | Dein Modellcode | Kleine Wrapper | Stoßweise Inferenz ohne Kapazitätsplanung |
| Gehostete Modell-APIs (Together AI, Groq) | Nichts | Nur API-Aufrufe | Offene Modelle, ohne Hardware anzufassen |
Das Interessante daran: In der ersten Zeile stand früher „Trainings-Stack neu schreiben" in der Spalte Codeänderungen. Jetzt liegt sie näher an den GPU-Zeilen, und genau das ist der Sinn des Launches. AWS nennt Partner, die bereits darauf aufbauen, darunter Anyscale, Modular und Nota AI, und dank der Hugging-Face-Unterstützung sind die meisten offenen Modelle aus meinen Beiträgen zu Kimi K3 oder DeepSeek V4 Flash nur ein device_map von Trainium entfernt.
Beim Serving speist TorchNeuron dasselbe torch.compile-Backend in vLLM Neuron ein, ein Plugin, das einen OpenAI-kompatiblen Server, Continuous Batching und einen paginierten KV-Cache ergänzt. Wenn dein Ziel ein verwalteter Agent auf AWS statt eines eigenen Serving-Stacks ist, sitzt Bedrock Managed Agents eine Ebene über all dem.
Erste Schritte
Du brauchst eine Trn2- oder Trn3-Instanz und Python 3.12, 3.13 oder 3.14. Auf der Neuron Deep Learning AMI ist TorchNeuron bereits installiert. Auf einer anderen Linux-Instanz lässt dich die README den Neuron-Treiber und die Runtime installieren und dann die Versionen festpinnen:
pip install torch==2.14.0 --index-url https://download.pytorch.org/whl/cpu
pip install "torch-neuronx==2.14.*" "neuronx-cc==2.*" "nki>=0.6" --extra-index-url https://pip.repos.neuron.amazonaws.com
python -m torch_neuronx.collect_env
Behalte die Pins bei: Frühere torch-neuronx-Versionen sind das XLA-basierte Produkt mit demselben Paketnamen, und so installiert man leicht das Falsche. Der collect_env-Check sollte das Device als von torch nutzbar melden.
Das Repository hatte 63 Sterne und 48 Mitwirkende, als ich es am Launch-Tag festgehalten habe, mit Beispielen für Llama, Whisper, Qwen2, ein Mixture-of-Experts-Modell, GPT-2-Training und Multi-Node-Läufe. Für Training im großen Maßstab liefert torchtitan-neuron auf Trainium abgestimmte TorchTitan-Rezepte. Der Launch-Beitrag führt durch das Training von Llama 3 8B mit SimpleFSDP und torch.compile auf einer einzelnen trn2.48xlarge.
Meine empfohlene Reihenfolge für einen Pilotversuch:
- Lasse dein Modell im Eager-Modus auf einer trn2.3xlarge oder trn2.48xlarge laufen und lies jede CPU-Fallback-Warnung.
- Korrigiere die Shapes und verlege dann den kritischen Pfad auf
torch.compilemitfullgraph=True. - Teile den NEFF-Cache zwischen Instanzen, bevor du hochskalierst.
- Vergleiche die Kosten pro Trainingsschritt oder pro Token mit deinen aktuellen GPUs, nicht die Kosten pro Stunde.
Für wen TorchNeuron gedacht ist
TorchNeuron ist für Teams, die eigene PyTorch-Modelle trainieren oder betreiben, bereits auf AWS laufen und genug für Beschleuniger ausgeben, dass sich eine Preis-Leistungs-Lücke von 30-40 % einen sprintlangen Entwicklungsaufwand lohnt. Forschungsteams profitieren am meisten vom Eager-Modus, weil Debugging endlich funktioniert wie auf jedem anderen Device. Produktionsteams profitieren am meisten von der Kostenseite, sobald Shapes und Caching geklärt sind.
Es ist nichts für dich, wenn dein Code auf eigene CUDA-Kernel baut, die du noch nicht umschreiben kannst, wenn du Trainium1 oder Inferentia brauchst oder wenn du nie Modellgewichte anfasst. Die meisten Unternehmen, die KI nutzen, auch die meisten, mit denen ich bei eesel spreche, gehören zur letzten Gruppe: Sie wollen, dass die KI eine Aufgabe erledigt, und der Chip dahinter ist das Problem von jemand anderem.
Wo eesel hineinpasst: Das ist Infrastruktur, eesel ist der Mitarbeiter
TorchNeuron macht die Hardwareebene günstiger und leichter austauschbar. Das ist eine gute Nachricht für alle, die Modelle bauen, und drückt mit der Zeit die Kosten der darauf aufbauenden KI-Produkte. Aber es beantwortet kein Ticket, entwirft keine Antwort und schreibt keinen Blogbeitrag. Das sind Aufgaben, und Aufgaben brauchen Kontext: dein Help Center, deine bisherigen Gespräche, deine Regeln zu Erstattungen.
Auf dieser Ebene arbeitet eesel. eesel ist eine Plattform für KI-Teammates: Du stellst einsatzbereite Teammates für bestimmte Aufgaben ein, heute einen KI-Helpdesk-Teammate und einen KI-Blogautor. Der Helpdesk-Teammate steigt in deine bestehende Queue ein, lernt aus deinem Help Center und früheren Tickets und wird gegen deine bisherigen Gespräche simuliert, bevor er einem echten Kunden antwortet.
SE Ranking ist ein gutes Beispiel für ein technisches Publikum. Dort läuft ein eesel-Agent pro Produkt für SE Ranking, Planable und SE Visible auf Zendesk, und zwischen dem 8. August und dem 8. September 2026 bearbeitete eesel rund 4.650 Gespräche, darunter etwa 2.100 Live-Chats. Fragen zu API und Looker Studio werden an eine Tier-2-Gruppe weitergeleitet, mit vorab gesammelten Belegen, statt dass der Bot rät.
Wenn du zu den Lesern gehörst, die gerade ein PyTorch-Backend aus einem gepinnten pip-Index installiert haben, richtest du das hier wahrscheinlich auch lieber im Terminal ein. Die eesel CLI bedient denselben Teammate und Workspace wie das Dashboard, alles, was du dort einrichtest, erscheint also in der Oberfläche und umgekehrt. npx @eesel/cli init chat-bubble --site https://your-site.com erstellt einen Agenten, fügt eine Chat-Blase auf der Website hinzu und beginnt, deine Seite zu lesen, ganz ohne Konto; eesel login behält den Workspace danach. Von dort aus spricht eesel chat mit dem Agenten, eesel files upload fügt Wissen hinzu, eesel integrations connect verbindet dein Helpdesk, eesel automations legt fest, was er selbstständig tut, und mit eesel approvals genehmigst du zurückgehaltene Aktionen.
Jeder Befehl gibt JSON aus, Fehler kommen als {error, hint, retryable} zurück, und --dry-run zeigt den genauen Serveraufruf, den ein Schreibvorgang auslösen würde. Dadurch ist er für Coding-Agenten wie Claude Code oder Cursor nutzbar: Der Agent kann das Setup ausführen und seine eigenen Ergebnisse lesen. Jeder Workspace ist außerdem ein MCP-Server, und eesel mcp token gibt eine fertig einfügbare Konfigurationszeile aus.

Dasselbe Protokoll, das du oben im Dashboard siehst, gibt eesel activity im Terminal aus, das Neueste zuerst.
eesel ausprobieren
Mit TorchNeuron wählst du den günstigsten Chip für deine Modelle. Mit eesel überspringst du diese Entscheidung für Support-Aufgaben: ein Helpdesk-Teammate, der sich in Zendesk, Freshdesk oder Gorgias einklinkt, auf deinen bisherigen Tickets trainiert und sich an historischen Gesprächen beweist, bevor er ein echtes berührt. Für SaaS-Teams mit API-lastigen Fragen sorgen die AI-Helpdesk-API und die CLI dafür, dass du das gesamte Setup skripten kannst. Teste eesel kostenlos oder starte im Terminal mit npx @eesel/cli.
Häufig gestellte Fragen
Was ist TorchNeuron?
neuron-Device hinzu, sodass Eager-Modus, torch.compile und torch.distributed auf Trainium2 und Trainium3 laufen. Die öffentliche Beta startete am 20. Oktober 2026. Wenn du eine KI suchst, die eine Aufgabe erledigt, statt eines Chips für den Modellbetrieb, ist ein KI-Teammate das andere Ende des Stacks.Ist TorchNeuron kostenlos?
Muss bei TorchNeuron wirklich nur eine Codezeile geändert werden?
.to('cuda') in .to('neuron') oder ändere nichts, wenn dein Code bereits torch.accelerator nutzt. Für Produktionsgeschwindigkeit fügst du außerdem backend="neuron" zu torch.compile hinzu, nutzt statische Shapes und entfernst CUDA-spezifische Optionen. Agentische Tools wie Claude Code übernehmen solche mechanischen Portierungen gut.