

Was ist Fish Audio Drama 3?
Ich baue bei eesel KI-Agenten und lese deshalb jede Sprachmodell-Ankündigung mit einer Frage: Verändert das, was ein Team ausliefern kann, oder nur, wie eine Demo klingt? Drama 3 ist die interessantere Sorte, denn die Änderung liegt in der Bedienung. Statt eine voreingestellte Emotion aus einem Menü zu wählen, schreibst du eine Regieanweisung.
Fish Audio beschreibt es als Modell für Regie: Neben dem Skript beschreibst du, wie eine Zeile gespielt werden soll, fügst Geräusche und Pausen hinzu und begrenzt einen Effekt auf bestimmte Wörter. Der technische Bericht liefert die Technik dazu. Das Rückgrat ist ein Mixture-of-Experts-Modell mit 35 Mrd. Parametern, das pro Token etwa 3 Mrd. Parameter aktiviert und aus Qwen3.5-35B-A3B initialisiert wurde (siehe meinen Qwen-Überblick, falls dir diese Familie neu ist), plus einen neuen Audio-Decoder, der zehn Codebooks pro Frame vorhersagt.
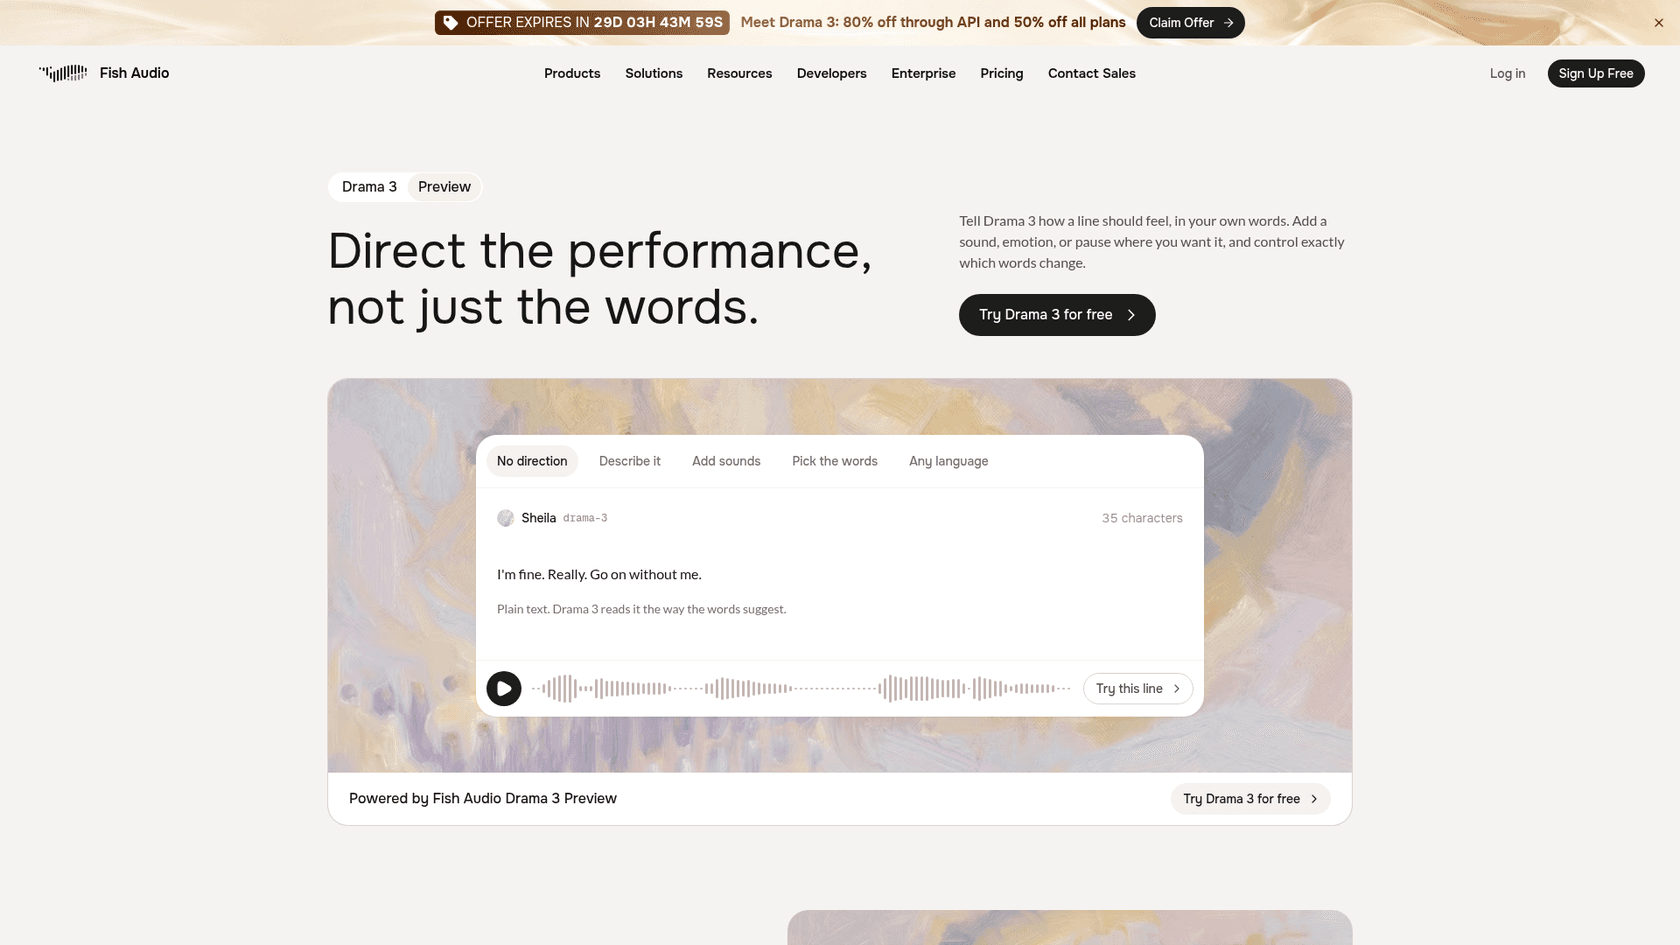
Es gibt auch eine kurze Vorgeschichte. Fish Audio kündigte am 23. September eine Vorschau an, die über den Modell-String drama-3-preview lief, und lieferte am 13. Oktober das fertige Modell aus. Die Landingpage trägt noch ein "Preview"-Badge, rechne also mit Feinschliff nach dem Launch. Fish Audio ist kein kleines Labor: Die Pressemitteilung zum Launch nennt 15 Millionen Nutzer und 21 Millionen $ wiederkehrenden Jahresumsatz.
Was ist gegenüber S2.1 Pro neu?
Ehrlich zusammengefasst: Die Bedienung ist geblieben, die Leistung hat sich geändert. Beide Modelle verstehen Regieanweisungen in Klammern, beide sprechen 83 Sprachen, und beide laufen über denselben POST /v1/tts-Endpunkt. Drama 3 bringt eine engere Befolgung der Anweisung, begrenzte Tags für einzelne Wörter und ein anderes Trainingsziel.
| S2.1 Pro | Drama 3 | |
|---|---|---|
Regieanweisung in [Klammern] | Ja | Ja, laut Fish Audio mit mehr Gefühl |
Begrenzte Tags (<whisper>, <emphasis>, <slow>...) | In der Modellübersicht nicht aufgeführt | Ja, sieben Tags |
| Sprachen | 83 | 83 |
| Pronunciation Robustness (Artificial Analysis) | 88,1 % | 93,2 % |
| API-Preis pro Million | 15 $ | 50 $ Liste, 10 $ bis 12. Nov. |
| Gewichte | Gehostete API | Offene Gewichte, Community License |
Quellen: Fish-Audio-Modellübersicht für S2.1 Pro, Drama-3-Launch-Beitrag für den Rest.
Die Änderung am Training halte ich für den glaubwürdigsten Teil. Fish Audio sagt, die meisten Sprachmodelle, auch das eigene S2, würden mit Belohnungen dafür abgestimmt, dass sie leicht zu transkribieren sind und wie der Referenzclip klingen, und diese Werte werten ein Lachen oder Flüstern ab. Drama 3 wird mit einem einzigen gelernten Modell abgestimmt, das abbildet, welche Aufnahmen Menschen bevorzugten, sodass ein gewünschtes Lachen nicht bestraft wird. Das ist eine plausible Erklärung dafür, wie ein Modell ausdrucksstärker werden kann, ohne bei den Wörtern schlampiger zu werden.
Wie führst du Regie bei einer Zeile?
Die Regieanweisung ist normaler Text im Skript, in drei Ebenen, die du frei mischen kannst. Eckige Klammern vor einer Zeile legen fest, wie sie gespielt wird, formuliert so, wie du eine Sprecherin oder einen Sprecher briefen würdest. Klammern können auch ein Geräusch oder eine Pause enthalten, genau an der Stelle, wo sie landen soll, etwa [shaky breath]. Paarweise Tags begrenzen einen Effekt auf wenige Wörter: <whisper>, <emphasis>, <soft>, <fast>, <slow>, <stress> und <forceful>.
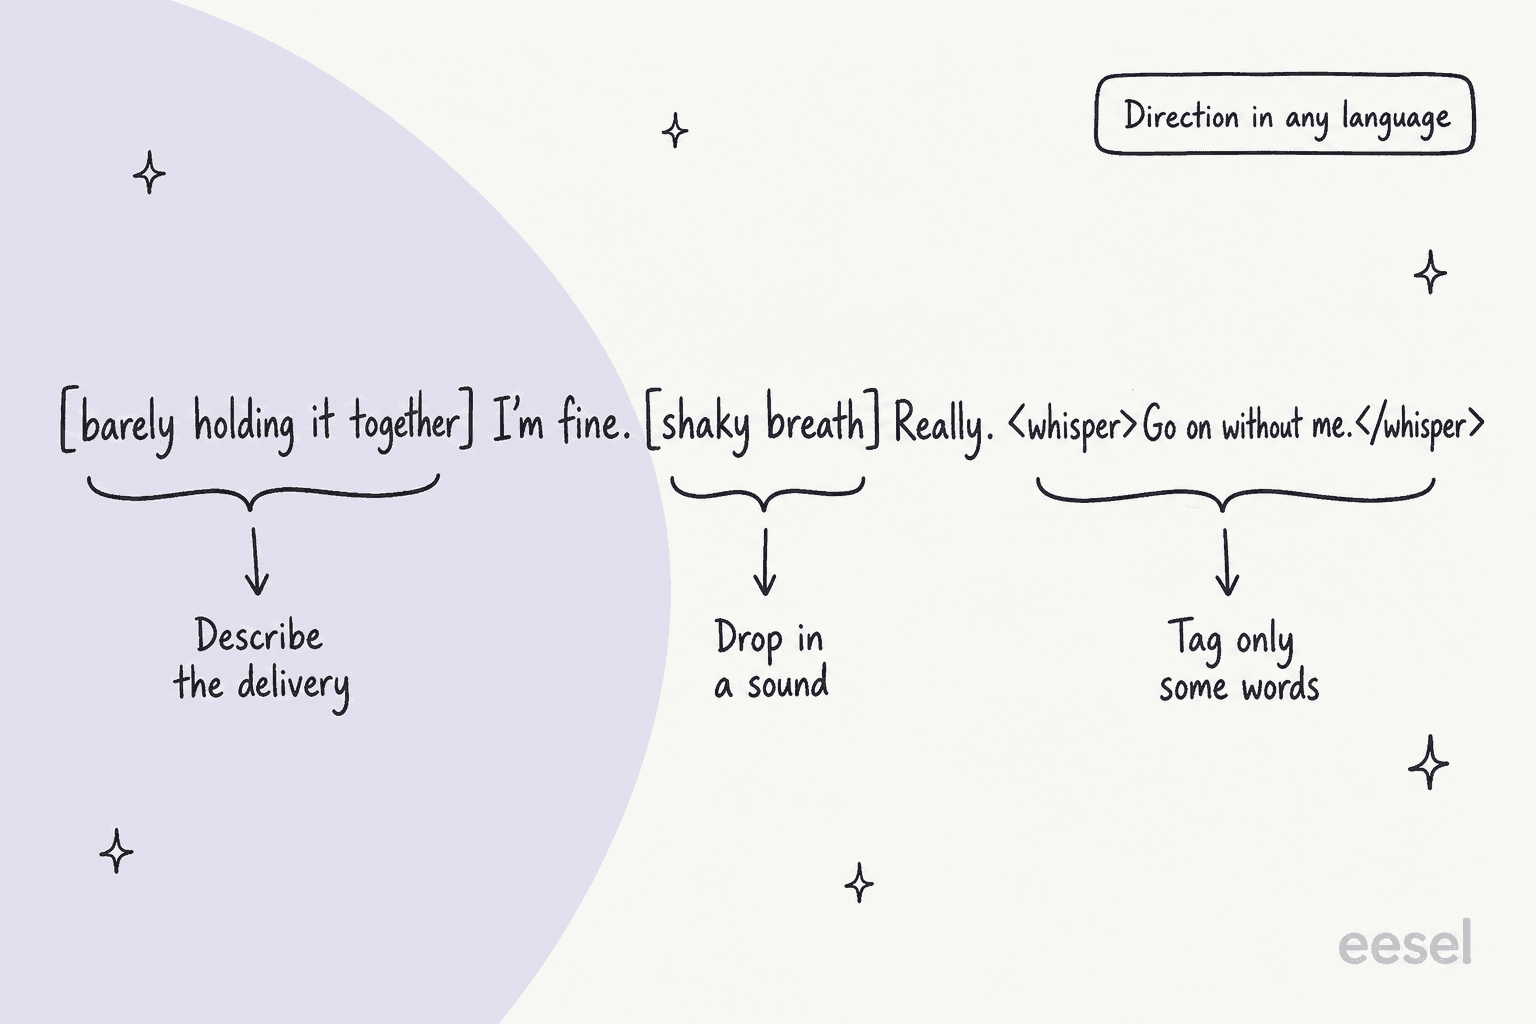
Die Regieanweisung muss nicht auf Englisch sein. Die Drama-3-Dokumentation zeigt eine chinesische, eine spanische und eine japanische Klammer auf derselben englischen Zeile, und Fish Audio sagt, die Darbietung folge der Anweisung, in welcher Sprache sie auch geschrieben sei. Ein Sprach-Tag zum Wechseln mitten in der Zeile, etwa <french>...</french>, existiert, ist aber als experimentell gekennzeichnet, mit je nach Sprache und Stimme schwankender Genauigkeit.
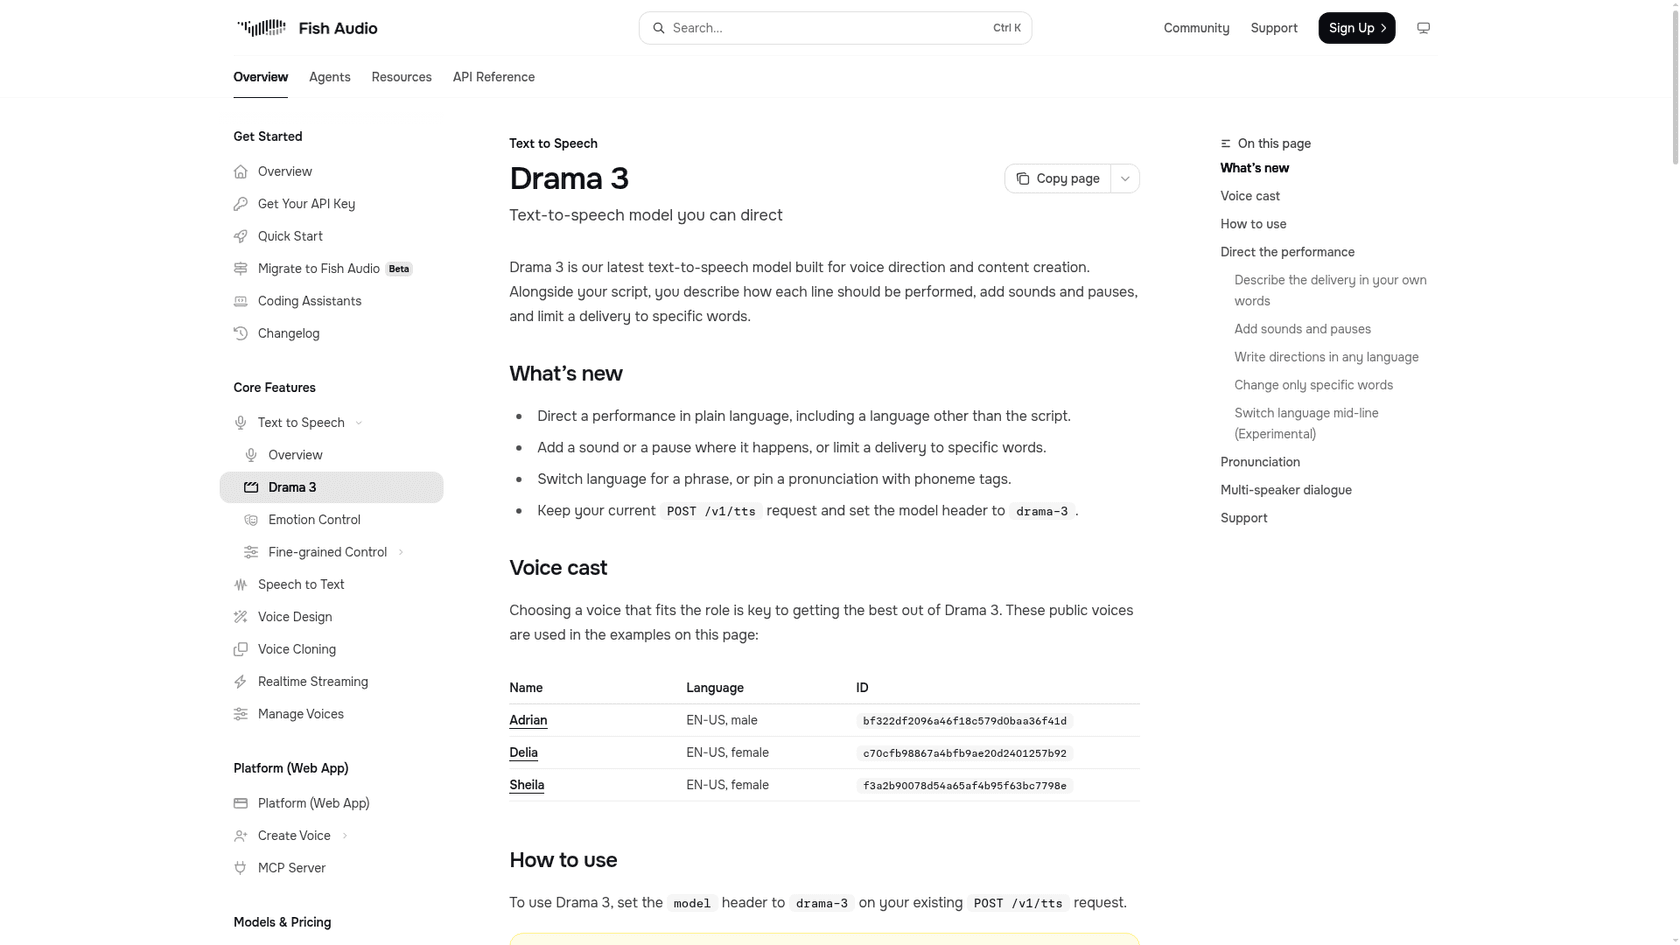
Zwei Details sind wichtig, wenn du das skriptest. Erstens verwenden Szenen mit mehreren Sprechern Tags im Stil von <|speaker:0|>, mit einer Stimmen-ID pro Sprecher, die als Array in reference_id übergeben wird, und laut Modellkarte auf Hugging Face kann ein Text bis zu 16 Figuren enthalten. Zweitens schlägt ein fehlender oder falsch geschriebener model-Header nicht fehl: Die Anfrage fällt stillschweigend auf s2.1-pro zurück. Wenn dein Audio plötzlich flacher klingt als die Demos, prüfe den Header, bevor du das Modell beschuldigst.
Ein Beispiel aus der Dokumentation, das sich zu klauen lohnt, ist [barely holding it together, forcing a smile] I'm fine. [shaky breath] Really. [small laugh] Go on without me. Es ist eine Zeile mit drei verschiedenen Aufgaben und der schnellste Weg herauszufinden, ob das Modell die Regieanweisung für deine Stimme befolgt.
Wie gut ist Drama 3 in unabhängigen Tests?
Der eigene Blog von Fish Audio sagt, Drama 3 liege bei Artificial Analysis bei der Pronunciation Robustness auf Platz eins. Artificial Analysis bestätigt das, und seine Zahlen ziehen auch die Grenzen dieser Aussage.
"Drama 3 Preview is the #1 open weights model on all three of our Text to Speech leaderboards."
| Messwert von Artificial Analysis | Drama 3 Preview | Referenzpunkt |
|---|---|---|
| Pronunciation Robustness | 93,2 %, Rang 1 | Eleven v4 91,7 %, Eleven v4 Turbo 90,1 %, S2.1 Pro 88,1 % |
| Provider-Voice-Arena (Elo) | 1.243, Rang 10 | S2.1 Pro 1.142 (101 Punkte Zuwachs) |
| Controlled-Voice-Arena (Elo) | 1.058, Rang 14 | k. A. |
| Bester Open-Weights-Konkurrent bei der Aussprache | k. A. | Mistrals Voxtral TTS mit 78,1 % |
Quelle: Artificial-Analysis-Thread, 13. Oktober 2026.
Lies diese Tabelle so, wie es ein Käufer tun sollte. Der Vorsprung bei der Aussprache ist real, und der Abstand zu jedem Open-Weights-Modell beträgt 15 Punkte, was zählt, wenn dein Skript voller Markennamen, Codes und Zahlen ist. Gegenüber Eleven v4 beträgt der Abstand 1,5 Punkte. Beim Blindhören liegt Drama 3 jedoch nur auf Platz 10 der Provider-Voice-Arena, "most emotive in the world" ist also die Beschreibung von Fish Audio, kein Ranking, das jemand anderes bisher erstellt hat. Der Sprung gegenüber S2.1 Pro ist die nützlichere Zahl: 101 Elo-Punkte zwischen zwei Modellen desselben Labors.
Die Reaktion der Community am ersten Tag passt zu dieser Spaltung. Ein Nutzer, der die Gewichte auf dem eigenen Rechner zum Laufen brachte, schrieb:
"It's fast and sounds great."

Ein anderer war beim Thema Größe deutlicher:
"barely better than breeze with nearly 10x the size"
Dieser Kommentar vergleicht Drama 3 mit Breeze TTS 2, einem offenen Modell, das Artificial Analysis in der Provider-Voice-Arena knapp dahinter einordnet (1.221 gegenüber 1.243). Beides stimmt: Der Vorsprung ist klein, und der Abstand zwischen offenen Modellen ebenso.
Wie bekommst du Zugang zu Drama 3?
Es gibt vier Wege, die zu unterschiedlichen Leuten passen.
- Web-App und mobile Apps. Öffne Text to Speech auf fish.audio mit
?version=drama-3oder nutze die iOS- und Android-Apps. Die Landingpage bietet Drama 3 zum kostenlosen Ausprobieren, und die lizenzierte Stimme von Uncle Roger steht für Roasts bereit. - API. Behalte deine
POST /v1/tts-Anfrage und füge den Headermodel: drama-3hinzu. Der Launch-Thread von Fish Audio nennt Launch-Partner wie ComfyUI, Runway, Pika, OpenRouter und Vercel, ich habe aber nur die Ankündigung von ComfyUI geprüft, die sagt, dass es als Partner Node läuft. Wenn du bereits Runway nutzt, prüfe, ob dessen Node dieselbe Regie-Syntax unterstützt. - Offene Gewichte. Das Modell liegt auf Hugging Face, mit SGLang-Omni-Serving ab Tag null.
- Enterprise. Laut Pressemitteilung von Fish Audio bekommen Unternehmen, die von einem anderen Sprachanbieter wechseln, die ersten drei Monate kostenlos. Das ist ein Vertriebsgespräch.
Für Support- und Operations-Teams, die ohnehin mehrere Sprachanbieter jonglieren, zeigen die Übersicht der Voice-Agenten und meine Liste der KI-Voice-Unternehmen, wo ein Modell wie dieses neben vollständigen Agenten-Plattformen steht.
Was kostet Drama 3?
Fang mit der API an, denn der Preis ist die verwirrendste Zahl dieses Launches. Laut Launch-Beitrag von Fish Audio steht Drama 3 mit 50 $ pro Million Zeichen in der Liste, und vom 13. Oktober bis 12. November gibt es 80 % Rabatt, also 10 $. Die eigenen Preisdokumente und die Entwicklerseite von Fish Audio führen zum Stand 14. Oktober weiterhin nur S2.1 Pro mit 15 $ und keine Zeile für Drama 3, und die Dokumente rechnen in UTF-8-Bytes statt in Zeichen ab. Bei einfachem englischem Text liegen beide nah beieinander, prüfe aber dein Dashboard, bevor du budgetierst.
"Drama 3 Preview is available via the Fish Audio API at $15/1M characters, the same as S2.1 Pro, compared to Eleven v4 at $80/1M characters and Eleven v4 Turbo at $40/1M characters."
Das ist ein Listing vom Launch-Tag für das Preview-Modell, ich würde es also als Vergangenheit behandeln. Budgetiere mit dem Listenpreis von 50 $ und betrachte die 10 $ als Rabatt für einen Monat. Die API-Preisseite von ElevenLabs führt v4 mit 0,08 $ pro 1.000 Zeichen und v4 Turbo mit 0,04 $, also 80 $ und 40 $ pro Million.
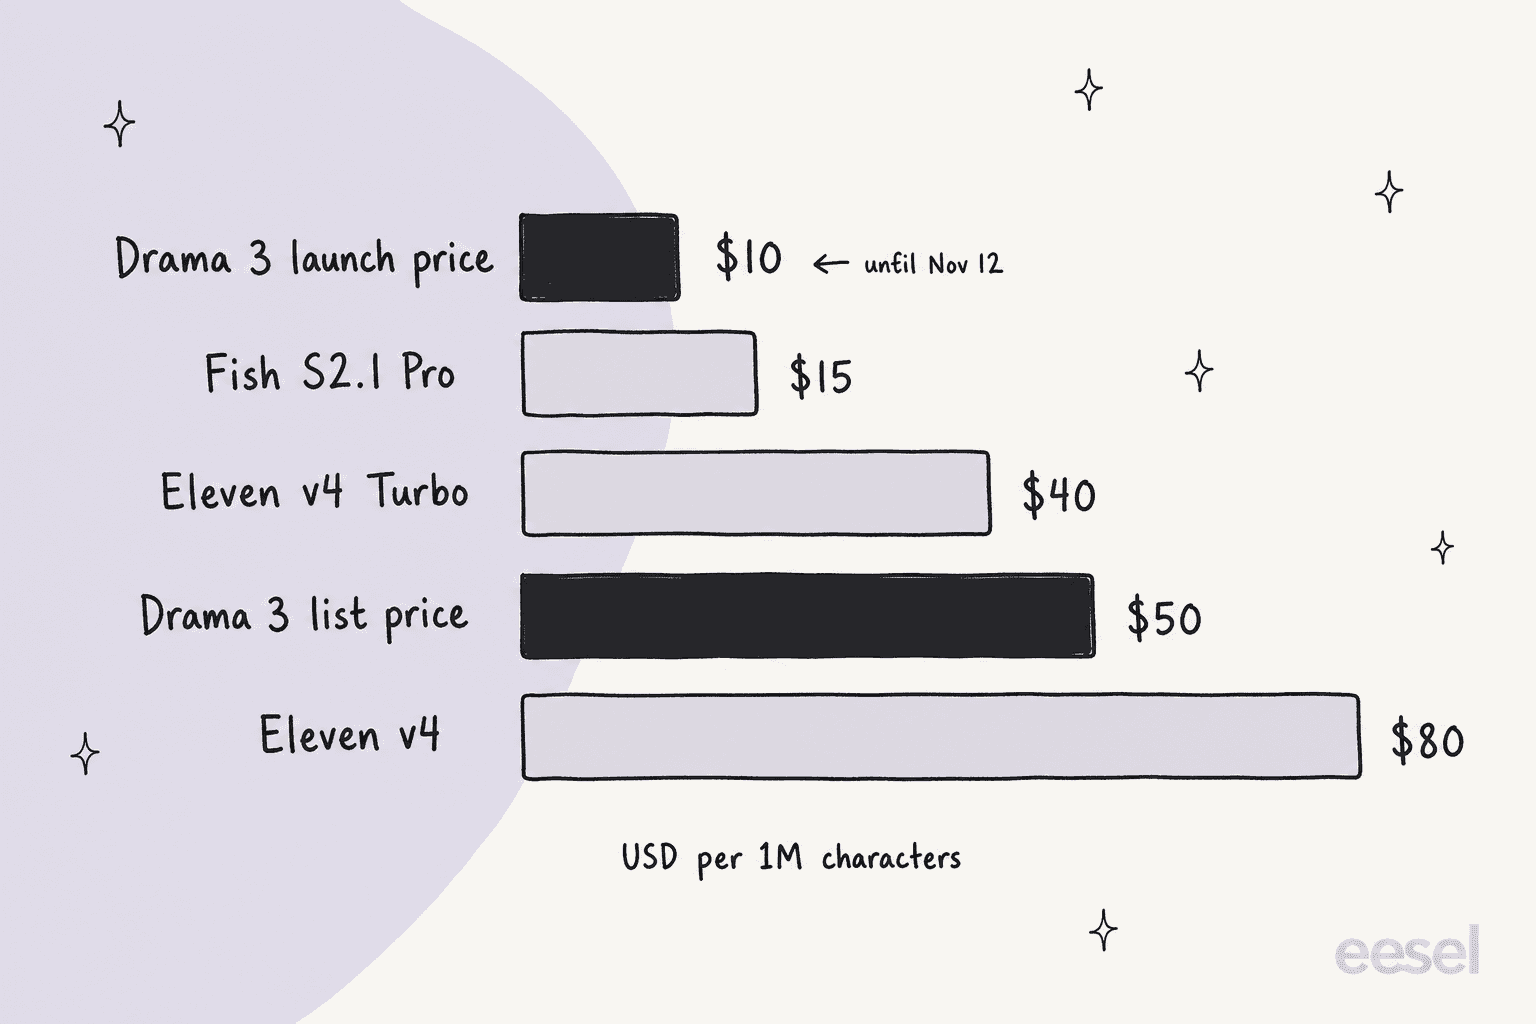
So viel kostet ein Auftrag mit 450.000 Zeichen, etwa ein Roman mit 80.000 Wörtern, mit derselben Zeichenzahl in jeder Zeile:
| Weg | Preis pro Million Zeichen | Kosten für 450.000 Zeichen |
|---|---|---|
| Drama 3, Einführungspreis (bis 12. Nov.) | 10 $ | 4,50 $ |
| Drama 3, Listenpreis | 50 $ | 22,50 $ |
| Eleven v4 Turbo | 40 $ | 18,00 $ |
| Eleven v4 | 80 $ | 36,00 $ |
| Selbst gehostetes Drama 3 | Nur GPU-Zeit | Kostenlos unter 500.000 US-$ Umsatz |
Zum Listenpreis ist Drama 3 günstiger als Eleven v4, aber teurer als Turbo. Die Wahl hängt also an der Stimme, nicht an der Rechnung. Ausführlichere Aufschlüsselungen findest du in meinen Leitfäden zu Eleven v4 Preisen und ElevenLabs Preisen sowie zu den Gemini 3.8 Flash TTS Preisen, falls du Google abwägst.
Bei den Apps ist es anders. Drama 3 kostet dieselben Credits wie S2.1 Pro, und bis 12. November ist ein neuer Plus-, Pro- oder Max-Tarif im ersten Monat bei monatlicher Abrechnung oder im ersten Jahr bei jährlicher Abrechnung 50 % günstiger.
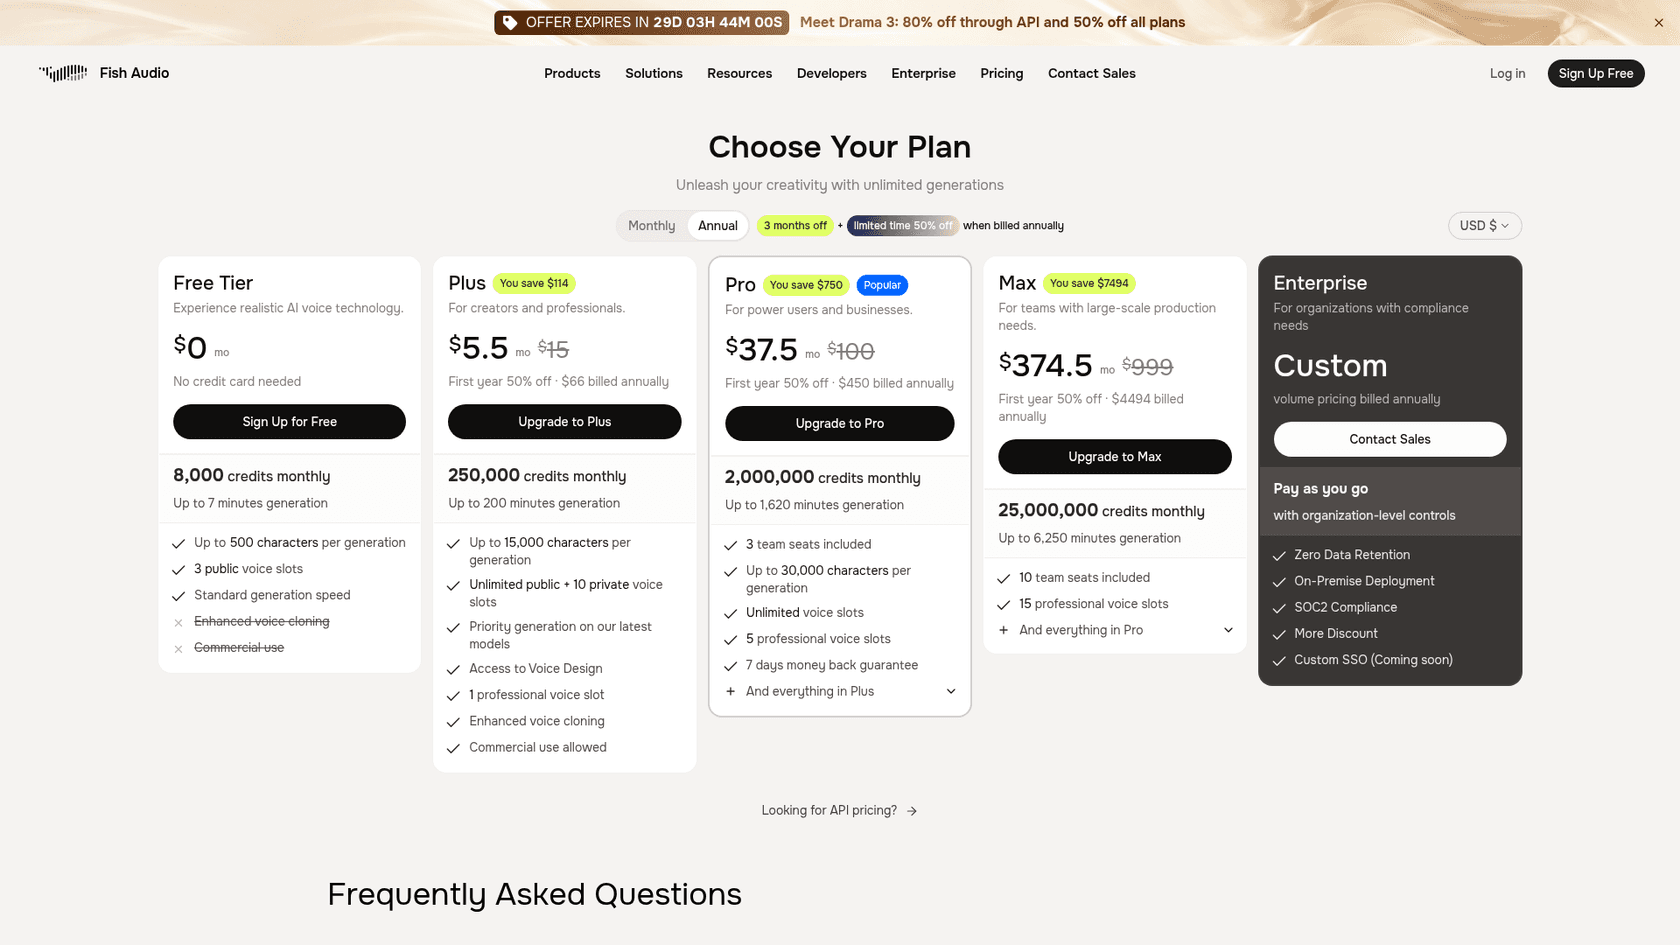
| Tarif | Angezeigter Preis (jährlich, erstes Jahr) | Credits pro Monat |
|---|---|---|
| Free | 0 $ | 8.000, bis zu 500 Zeichen pro Generierung, keine kommerzielle Nutzung |
| Plus | 5,50 $ pro Monat, 15 $ durchgestrichen | 250.000 |
| Pro | 37,50 $ pro Monat, 100 $ durchgestrichen | 2.000.000, 3 Team-Plätze |
| Max | 374,50 $ pro Monat, 999 $ durchgestrichen | 25.000.000, 10 Team-Plätze |
| Enterprise | Individuell | Pay as you go, SOC 2, Zero Data Retention |
Quelle: Tarifseite von Fish Audio, erfasst am 14. Oktober 2026. Die durchgestrichenen Preise sind die Sätze nach Ablauf des Angebots.
Kannst du Drama 3 selbst betreiben?
Ja, unter Bedingungen. Die Gewichte liegen auf Hugging Face unter der Fish Audio Community License v1.0. Sie ist kostenlos für Forschung und nicht kommerzielle Nutzung und kostenlos für die kommerzielle Nutzung, wenn du und deine verbundenen Unternehmen unter 500.000 US-$ Jahresumsatz liegen. Darüber oder um Drama 3 anderen als TTS-, Voice-Cloning- oder Inferenzdienst anzubieten, brauchst du eine Lizenz von Fish Audio. Außerdem ist es verboten, die Stimme einer realen Person ohne deren Einwilligung zu klonen. Fish Audio nennt die Veröffentlichung Open-Weight statt Open Source, und das ist das zutreffende Wort.
Die Hardware ist die andere Grenze. Die Modellkarte nennt 36 Mrd. Parameter in FP8 und bf16, und die Berichte aus der Community am Launch-Tag reichten von "needs a 48gb Cuda card" bis zu einem Lauf auf zwei Consumer-GPUs:
"Opus 5.5 was able to get it running on my two RTX 3090s at ~39gb of VRAM."
Die eigenen Zahlen von Fish Audio stammen von NVIDIA H200. Auf einer H200 mit einem Stream gibt die Hugging-Face-Karte eine mediane Zeit bis zum ersten Audio von 88,9 ms an, bei 16 gleichzeitigen Streams liegt der Median bei 210,1 ms. Die Lizenz sorgte für etwas Murren, und ein Kommentator antwortete fair darauf:
"License is a bit lame but I understand they need to make money too lol"
Wenn du Self-Hosting mit einem verwalteten Weg vergleichst, behandelt meine Übersicht zu Open-Source-KI-Agenten denselben Zielkonflikt für Agenten-Software.
Wo liegen die Grenzen von Drama 3?
Sechs Dinge, die du wissen solltest, bevor du ein Projekt darauf festlegst:
- Es zielt auf gerenderte Zeilen. Fish Audio selbst sagt im Launch-Beitrag, Drama 3 leiste am meisten bei geskripteten Zeilen, die du einmal renderst und behältst, etwa Hörbücher, Hörspiele, Spiele und kurze Videos. Live-Gespräche sind eine andere Aufgabe. Vergleiche dafür Eleven v4 Turbo oder Cartesia Sonic 3.
- Die Takes schwanken. Fish Audio rät, ein paar zu rendern und den zu behalten, der funktioniert.
- Bearbeiten ist noch nicht offen. Interaktives Bearbeiten und Audio-Inpainting sind in einem kleinen Test nur auf Einladung, mit einer Bearbeitungs-API "coming soon".
- Der Sprachwechsel ist experimentell. Die Tags im Stil von
<french>sind nicht für jede Sprache oder Stimme garantiert. - Die Lizenz hat Bedingungen. Die Umsatzgrenze und das Verbot von Diensten sind wichtig für alle, die darauf ein Sprachprodukt bauen.
- Die Preiszeile steht noch nicht in der Dokumentation. Siehe oben.
Ich würde die Zahl von 83 Sprachen auch nicht als 83 gleich gute Sprachen lesen. Die Aussprache-Werte von Fish Audio gelten nur für Englisch. Teste also die Sprache, die du wirklich brauchst, wie ein Reddit-Nutzer am Launch-Tag zu Deutsch fragte, noch ohne Antwort. Für mehrsprachige Arbeit mit Kundenkontakt zeigt mein Leitfaden zur QA für mehrsprachigen Support, wie du jede Sprache einzeln prüfst.
Wer sollte Drama 3 nutzen und wer sollte es lassen?
Nutze es für Hörbücher, fiktionale Podcasts, Spieldialoge und kurze Videos, bei denen jede Zeile gerendert, geprüft und behalten wird. Die begrenzten Tags sind das Feature, das das Upgrade rechtfertigt: Ein einzelnes Wort in einer Zeile zu korrigieren ist günstiger, als ein Kapitel neu zu generieren, was Fish-Audio-CEO Rissa Cao als den Sinn von Langformat-Arbeit beschreibt. Wenn du Videos oder Podcasts skriptest, passen KI-Podcast-Skript-Generatoren und KI-Videoskript-Tools gut dazu.
Schau dir die Alternativen an, wenn du die beim Blindhören bewährteste Stimme willst. Dann sind ElevenLabs und Cartesia die naheliegenden Vergleiche, oder eine Emotionsschicht im Stil von Hume AI. Mein Beitrag zu ElevenLabs-Alternativen stellt sie nebeneinander.
Lass es vorerst, wenn du sofort einen Live-Telefon-Agenten brauchst. Drama 3 ist eine Stimme, kein Agent, du brauchst also weiterhin etwas, das entscheidet, was gesagt wird und wann übergeben wird. Dafür siehe Retell AI, Vapi, Decagon Voice 3 und Grok Voice Think Fast 2. Wenn du Sprach-APIs nur nach Kosten und Einfachheit vergleichst, sind die Sprach-API von OpenAI und Whisper vs. die TTS-API die schlichteren Maßstäbe.
Was bedeutet ein Sprachmodell für ein Support-Team?
Ein Sprachmodell ändert, wie eine Antwort klingt, nicht, ob sie stimmt. Ein Kunde, der eine warm und gut getaktet gesprochene Erstattungsregel hört, bekommt trotzdem die falsche Erstattungsfrist, wenn der Agent dahinter geraten hat. Ausdrucksstarke Stimmen machen Fehler überzeugender, deshalb liegt mir die Schicht darunter am Herzen.
Das Muster, das ich in echten Warteschlangen immer wieder sehe: Teams wollen Sprache, fangen aber mit Tickets an. Ein Support-Team, das eesel nutzt, schrieb, dass fehlende Unterstützung für Sprachaufnahmen bedeute, dass Agenten Anrufe von Hand für die KI zusammenfassen müssten, und dass sie "would significantly increase our usage". Das ist ein Feature-Wunsch, und ich will ihn nicht überhöhen: eesel arbeitet heute textbasiert, mit Tickets und Chats statt Telefon-Audio. Das sinnvolle Setup ist, die Antworten zuerst im Text richtig zu bekommen und sie dann an das passende Sprachmodell weiterzugeben.
Wenn du über Sprache für den Support nachdenkst, sind Tools für Sprach-Kundensupport und Zendesk-Voice-KI-Agenten gute Startpunkte, und Conversational AI für den Kundenservice behandelt die Schicht vor der Stimme. Halte die Stimme auch zur Marke passend: Ein Modell, das Regieanweisungen befolgt, ist nur nützlich, wenn jemand die Regie aufschreibt.
eesel ausprobieren
Wenn dein Team Sprache prüft, weil sich Tickets und Chats stapeln, fang dort an, wo die Antworten entstehen. Das KI-Helpdesk-Teammitglied von eesel schließt sich dem Helpdesk an, den du bereits nutzt, lernt aus deinen bisherigen Tickets und deinem Help Center und antwortet in deinem Ton. Bevor es einen echten Kunden berührt, kannst du es gegen historische Tickets laufen lassen und sehen, was es gesagt hätte. So würde ich auch das Skript jeder Sprachschicht testen.

Wenn du lieber im Terminal arbeitest: Mit der eesel CLI kannst du, ein Skript oder ein Coding-Agent wie Claude Code die Anweisungen desselben Teammitglieds lesen und ändern und seine Aktivität prüfen, so wie du jeden anderen Dienst verwalten würdest. Der kostenlose Tarif enthält 100 Credits ohne Karte, und die Preisseite zeigt die bezahlten Stufen. Probiere eesel an den Tickets des letzten Monats aus, bevor du irgendetwas zum Thema Sprache entscheidest.
Häufig gestellte Fragen
Was ist Fish Audio Drama 3?
Was kostet Fish Audio Drama 3?
Ist Drama 3 Open Source und kostenlos für die kommerzielle Nutzung?
Wie nutze ich Drama 3 über die API?
POST /v1/tts-Anfrage bei und setze den Header model: drama-3. Ein fehlender oder falsch geschriebener Header fällt ohne Fehlermeldung auf s2.1-pro zurück. Prüfe ihn also zuerst, wenn das Audio flach klingt. Derselbe Aufruf funktioniert aus Skripten und Coding-Agenten, ähnlich wie die eesel CLI es für ein Support-Teammitglied tut.