

TorchTPU ist Googles quelloffenes PyTorch-Backend für Cloud TPUs, entwickelt mit Metas PyTorch-Team und am 20. Oktober 2026 als Open Source veröffentlicht. Es registriert die TPU als normales PyTorch-Device namens tpu, sodass die Portierung bei den meisten Codebasen damit beginnt, dass aus device="cuda" nun device="tpu" wird. Es ersetzt PyTorch/XLA, das Google inzwischen als veraltet bezeichnet.
Die Bibliothek ist unter Apache 2.0 kostenlos, bezahlt wird die TPU-Zeit: $12.00 pro Ironwood-Chipstunde on demand, $6.00 mit Flex-Start und $2.70 für Trillium. Google meldet, dass 98 % von knapp 5,000 Hugging-Face-Modellen sofort laufen. Der Haken: Es ist Version 0.2.0, torch.compile erzwingt weiterhin statische Shapes, und Google sagt klar, dass „läuft“ und „läuft schnell“ zwei verschieden große Aufgaben sind.
Wer eigene PyTorch-Modelle trainiert oder ausliefert, hat zum ersten Mal einen Grund, TPUs zu pilotieren, ohne JAX zu lernen. Wer nur will, dass KI eine Aufgabe erledigt, etwa Tickets beantworten, kann die Chipfrage überspringen: Ein eesel-KI-Teammate übernimmt die Modellebene, und SamCart betreibt vier davon auf Freshdesk und Website-Chat.
Was ist TorchTPU?
TorchTPU ist ein natives PyTorch-Backend für Google Cloud TPUs, die eigens entwickelten KI-Chips, mit denen Google Gemini trainiert und ausliefert. Google startete das Projekt Mitte 2025 mit dem PyTorch-Team bei Meta, beschrieb es im April 2026 im Google Developers Blog und machte es am 20. Oktober auf der PyTorch Conference 2026 zu Open Source. Der Code liegt unter google-pytorch/torch_tpu unter Apache 2.0, die aktuelle Version ist 0.2.0 auf PyPI.
Ich baue bei eesel Features und KI-Agenten, und die meiste Zeit der Woche verbringe ich mit dem Teil des Stacks oberhalb des Chips. Wenn ein Launch also „eine Zeile ändern“ verspricht, lese ich nach, wie diese Zeile tatsächlich ausgeführt wird. Die Kurzfassung ist gute Nachricht mit Sternchen: Die Zeile bringt Ihr Modell tatsächlich zum Laufen, und die Doku ist ungewöhnlich ehrlich, was die Arbeit danach angeht.
Die Ankündigung von Google Cloud beschreibt das Ziel schlicht: TPUs sollen neben GPUs und CPUs eine native Option für PyTorch werden. Meta ist der wichtigste Partner, und sein Director of PyTorch Engineering erklärt im Launch-Beitrag, warum:
"We cannot be constrained by a single hardware architecture."
Jana van Greunen, Director of PyTorch Engineering at Meta, im Google Cloud Blog
Als ich das Repo am 28. Oktober aufgenommen habe, hatte es 782 Sterne, 105 Contributors und 4,677 Commits, und stündlich kamen neue dazu. Laut PyTorch-Blog wird es bereits „used in production for both inference and training workloads for some of the largest Google Cloud customers.“
Was ist wirklich neu: Abschied von PyTorch/XLA
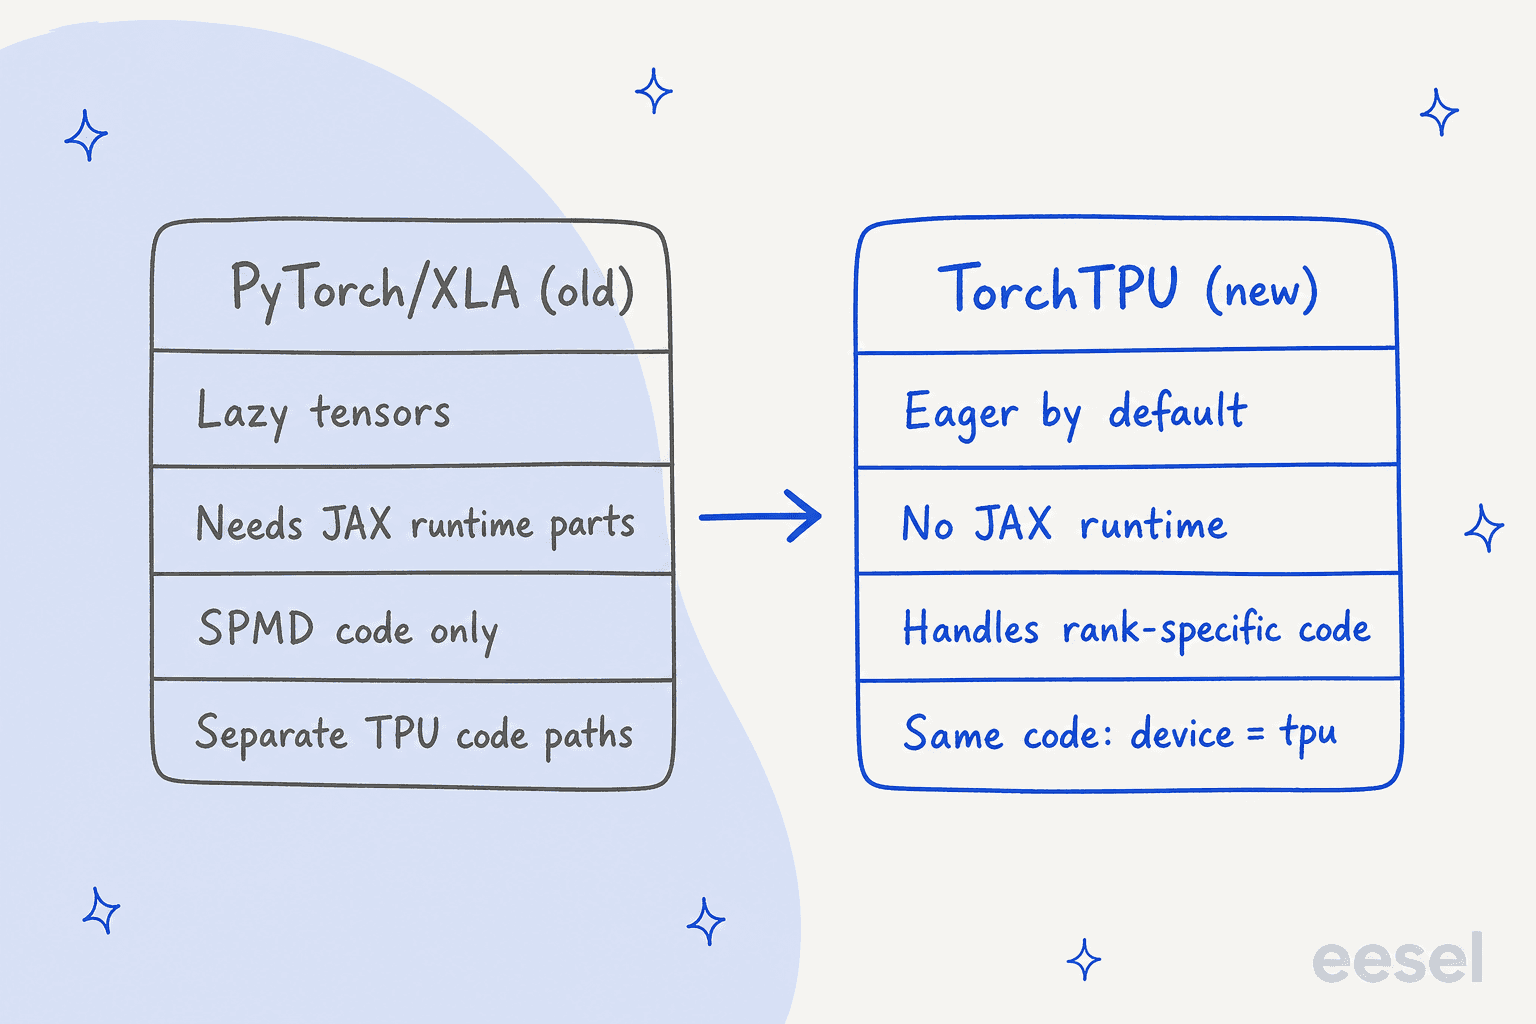
PyTorch läuft seit 2020 über PyTorch/XLA auf TPUs, also stellt sich die Frage, was sich geändert hat. Googles eigene Antwort im PyTorch-Blog ist deutlich: PyTorch/XLA nutzte Lazy Tensors, brauchte eingreifende Codeänderungen, um kompilierbare Bereiche zu markieren, hatte starke Latenzen beim Kompilieren und keinen echten Eager-Modus. Die TorchTPU-FAQ sagt jetzt: PyTorch/XLA ist veraltet und wird durch TorchTPU ersetzt.
Wer mit dem alten Stack gelebt hat, erinnert sich genauso daran. Aus dem Hacker-News-Thread zur April-Vorschau:
"I did trained some research models using the existing PyTorch/XLA on TPUs, and it was a mess of undocumented behavior and bugs (silently hanging after 8 hours of training!)."

TorchTPU klinkt sich in PrivateUse1 ein, PyTorchs offiziellen Platz für Hardware außerhalb des Hauptbaums, sodass ein TPU-Tensor ein gewöhnlicher PyTorch-Tensor ist. Es hat keine JAX-Runtime-Abhängigkeit, folgt PyTorchs Modell „ein Prozess pro Device“ und verarbeitet Code, bei dem Rank 0 etwas Extra-Arbeit leistet, was der alte reine SPMD-Stack nicht konnte.
Die andere bemerkenswerte Änderung ist das Ökosystem drumherum. Google lieferte TorchTPU zusammen mit Backends für vLLM (mit Inferact), SGLang (mit RadixArk), TorchTitan, Ray (mit Anyscale), TorchRec sowie nativer Unterstützung in Hugging Face Transformers v5 und Diffusers. Hugging Face sagt, sein Optimum-TPU-Wrapper werde nicht mehr gebraucht.
Auch das Timing ist bemerkenswert. AWS hat am selben Tag auf derselben Konferenz TorchNeuron gestartet, sein natives PyTorch-Backend für Trainium. Beide Clouds kamen zum selben Schluss: PyTorch ist, wo der Code lebt, also muss der Chip wie ein PyTorch-Device aussehen.
Wie TorchTPU funktioniert
Unter der Haube hat TorchTPU zwei Pfade, die beide in Googles XLA-Compiler enden. Der Eager-Pfad ist ein C++-Backend, das beim PyTorch-Dispatcher registriert ist. Der kompilierte Pfad ist ein TorchDynamo-Backend, das einen ganzen FX-Graphen in ein einziges StableHLO-Programm umwandelt, statt wie bei GPUs über TorchInductor zu gehen.
Der Eager-Modus hat laut den TorchTPU-Einführungsdokus drei Einstellungen:
- Strict (Standard) schickt jeweils eine ATen-Op asynchron an die TPU, wie PyTorch auf einer GPU.
- Debug (
TORCH_TPU_LAUNCH_BLOCKING=1) führt jede Op synchron mit Bounds-Checks aus, die TPU-Version vonCUDA_LAUNCH_BLOCKING. - DeferAndFuse (
TORCH_TPU_DEFER_AND_FUSE=1) hält Ops zurück, bis etwa.cpu()oder.item()einen Wert braucht, und fusioniert und kompiliert sie dann gemeinsam. Laut Google kann es 50 % oder mehr schneller als Strict sein und braucht weniger HBM-Speicher.
Alle drei teilen sich einen Compile-Cache mit drei Ebenen: pro Prozess, geteilt zwischen Prozessen auf einem Host und eine optionale persistente Ebene auf Cloud Storage, damit eine ganze Flotte nach jedem Neustart nicht dieselben Graphen neu kompiliert.
torch.compile(model, backend="tpu") ist der Produktionspfad. Der Preis ist Strenge: TorchTPU setzt derzeit dynamic=False für Sie, weil XLA statische Shapes will. Google baut „bounded dynamism“, bei dem Sie eine Maximalgröße angeben und der Graph einmal kompiliert wird. In frühen Tests lieferte es auf 834 von 839 kausalen LLMs korrekte Ergebnisse, aber die Feature-Tabelle führt es noch als experimentell.
Es gibt außerdem einen Präzisionsunterschied, den man kennen sollte, bevor man Loss-Kurven vergleicht. TPU-Matrixeinheiten multiplizieren in bfloat16 und akkumulieren in FP32, daher nutzt TorchTPU standardmäßig „medium“-Präzision, während PyTorch auf CUDA standardmäßig volles FP32 nutzt. Sie können „high“ oder „highest“ anfordern, die aber etwa das 3- bzw. 6-Fache an Matrix-Rechenleistung kosten.
Für eigene Kernel unterstützt TorchTPU Pallas (Googles Kernel-Sprache aus JAX) und die Kernel-Bibliothek Tokamax als produktionsreif, dazu Helion, PyTorchs portable Kernel-DSL, als experimentell. Eigene CUDA-Kernel lassen sich nicht übernehmen.
Um zu sehen, wie viel jede Ebene bringt, führt der PyTorch-Blog ein FLUX-Bildmodell Schritt für Schritt durch den Stack:
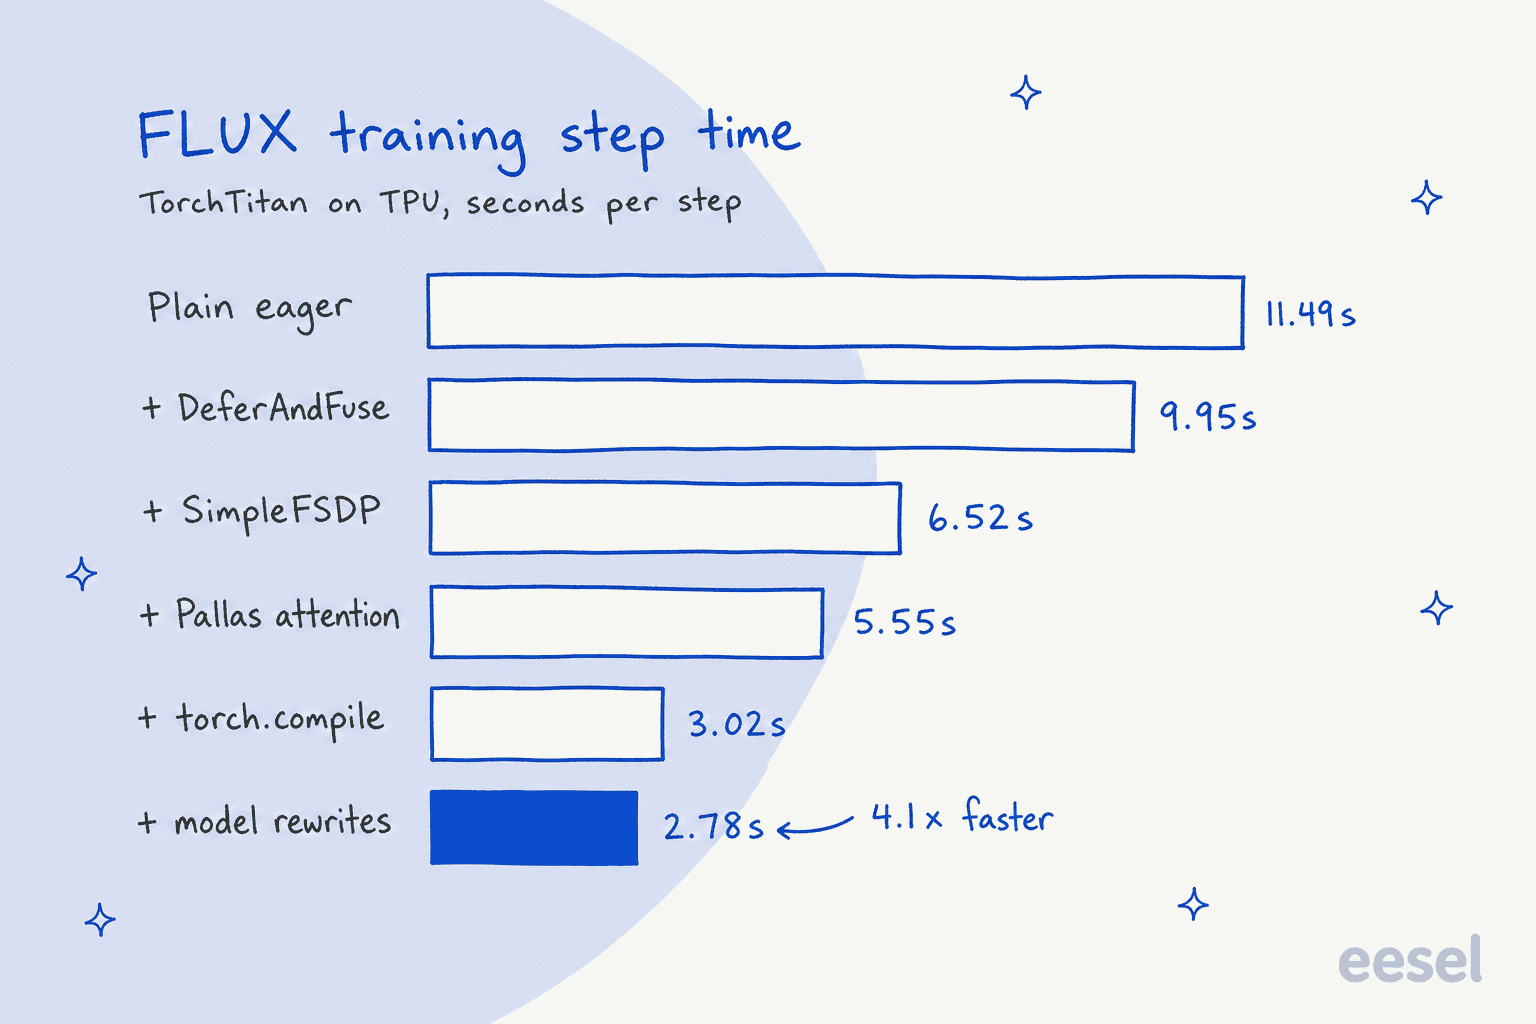
Für mich ist dieses Diagramm die ehrliche Version des „Eine-Zeile“-Versprechens. Die eine Zeile bringt den 11.49-Sekunden-Schritt. Der 2.78-Sekunden-Schritt kostet fünf weitere Runden Arbeit, und allein torch.compile ist der größte Einzelsprung.
Wie die Codeänderung aussieht
Die Einstiegsanleitung läuft auf einer TPU-VM (eine v6e ist am einfachsten) mit Python 3.11 oder neuer:
pip install torch_tpu==0.2.0 --extra-index-url https://download.pytorch.org/whl/cpu
Behalten Sie den Extra-Index: Ohne ihn zieht pip den CUDA-Build von PyTorch, der viel größer und auf einer TPU nutzlos ist. Dann die Device-Änderung:
import torch
device = torch.device("tpu")          # was "cuda"
model = MyModel().to(device)
compiled = torch.compile(model, backend="tpu")   # optional, for speed
Bei verteilten Jobs gibt es eine zweite Änderung. Aus dist.init_process_group(backend="nccl") wird backend="tpu_dist", und TorchTPU braucht zwei TPU-spezifische Einstellungen (die Slice-Topologie und die Chip-Adressen), die das normale torchrun nicht kennt. Ein Befehl gibt sie für Sie aus:
eval $(python -m torch.tpu.distributed | sed 's/^/export /')
torchrun --nproc_per_node=8 train.py
Bei Hugging-Face-Modellen ist es noch kürzer. Laut Hugging-Face-Launch-Beitrag lädt AutoModelForCausalLM.from_pretrained(model_id, device_map="tpu") die Gewichte direkt auf die TPU, und eine Diffusers-Pipeline braucht nur pipe.to("tpu").
Das heißt, die meisten offenen Modelle, die ich behandelt habe, wie Qwen, Gemma 4 oder DeepSeek V4 Flash, sind nur ein device_map von einer TPU entfernt.
Google hat außerdem eine TPU-Agent-Suite als Vorschau veröffentlicht: Skills, die sich in Coding-Agenten installieren (heute Claude Code und Antigravity, Codex und Cursor „coming soon“) und Onboarding, Profiling und Inferenz-Tuning übernehmen. Sie zeigt, wohin sich solche Portierungen entwickeln. Ein mechanischer Austausch wie dieser ist genau das, was Claude Code oder OpenAI Codex gut erledigen, solange Sie die Compile-Logs selbst lesen.
Was kostet TorchTPU?
Die Bibliothek ist kostenlos. TorchTPU steht unter Apache 2.0 und wird von PyPI installiert. Bezahlt wird TPU-Zeit, die Google pro Chipstunde auf seiner Cloud-TPU-Preisseite abrechnet. Die Kosten laufen, solange ein TPU-Knoten im Zustand READY ist, ein vergessener, untätiger Knoten wird also weiter berechnet.
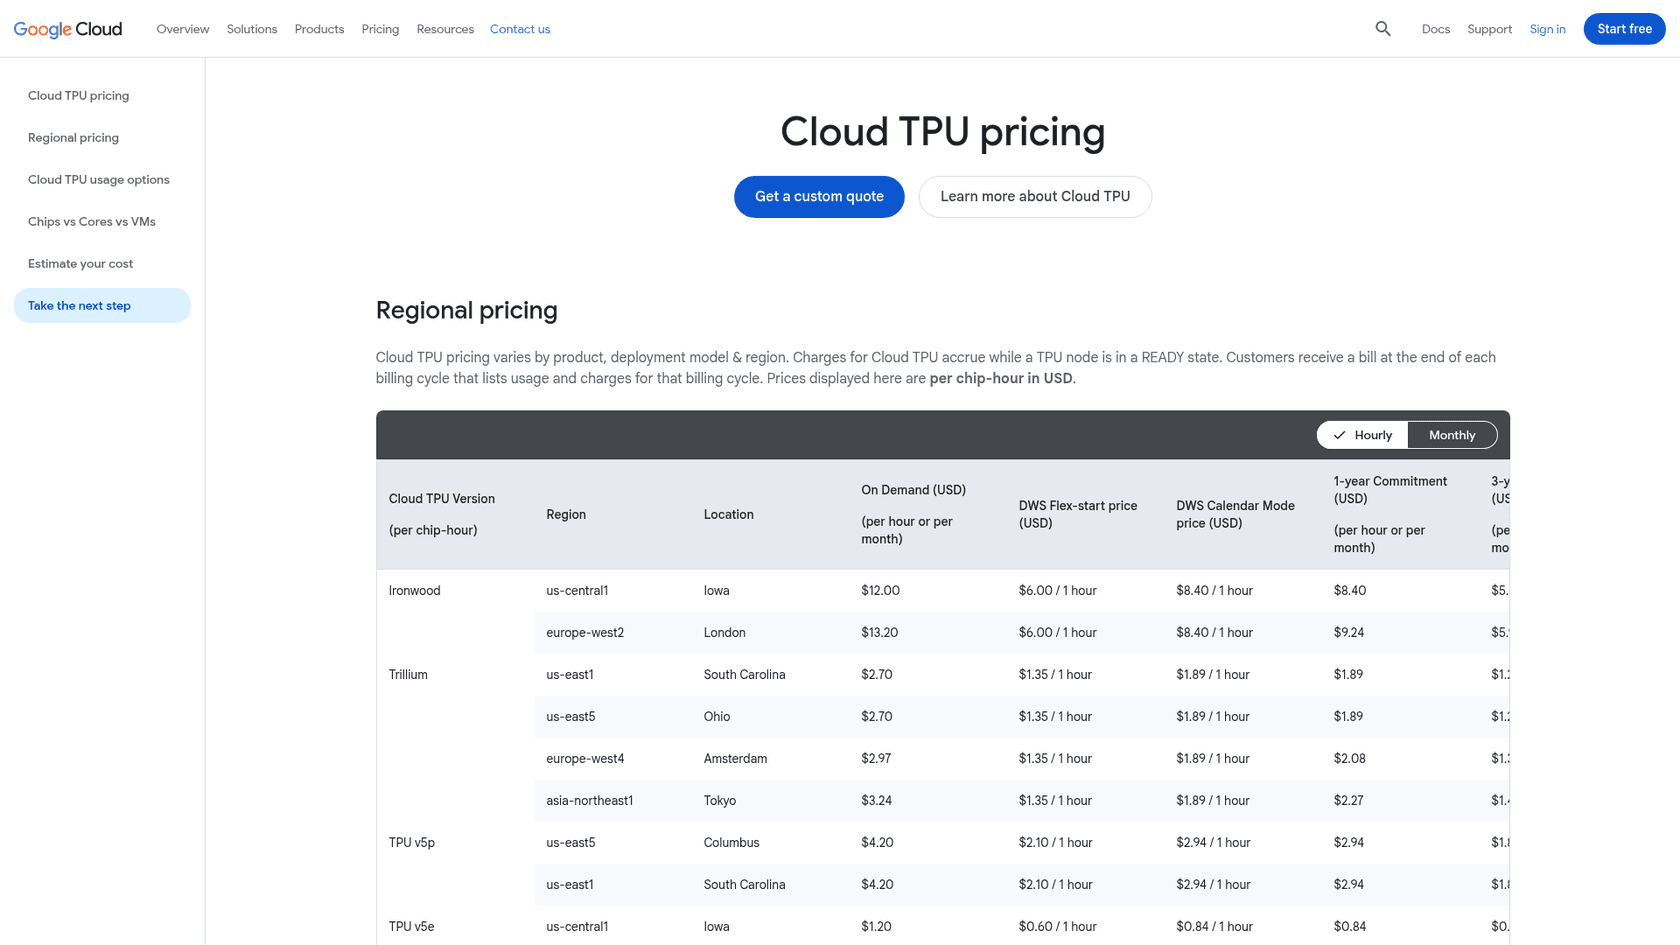
Das sind die US-Preise für die vier von TorchTPU unterstützten Generationen, geprüft am 28. Oktober 2026:
| TPU | Region | On demand | DWS Flex-start | 1-Jahres-Commit | 3-Jahres-Commit |
|---|---|---|---|---|---|
| Ironwood (v7) | us-central1 | $12.00 | $6.00 | $8.40 | $5.40 |
| Trillium (v6e) | us-east1 | $2.70 | $1.35 | $1.89 | $1.22 |
| TPU v5p | us-east5 | $4.20 | $2.10 | $2.94 | $1.89 |
| TPU v5e | us-central1 | $1.20 | $0.60 | $0.84 | $0.54 |
Flex-Start (Teil von Googles Dynamic Workload Scheduler) kostet die Hälfte des On-Demand-Preises bei jeder Generation, dafür wartet man, bis Kapazität frei wird. Die Google-Cloud-Konsole rechnet in VM-Stunden ab, nicht in Chipstunden, daher zeigt eine VM mit mehreren Chips eine größere Zahl als die Tabelle. Regionen in Europa und Asien kosten mehr: Ironwood kostet in London $13.20 on demand.
Eine Chipstunde ist allerdings keine Arbeitseinheit, und diesen Teil überspringen viele. Ein Ironwood-Chip stellt zwei PyTorch-Devices bereit, und eine GPU, ein Trainium2-Chip und eine TPU schaffen pro Stunde jeweils unterschiedlich viel Arbeit. Die einzige Drittzahl, die Google zitiert, stammt aus SemiAnalysis' InferenceX-Benchmark, in dem TPU v7 mit vLLM-TorchTPU Qwen 3.5 im 8K/1K-Test für 2.01 Cent pro Million Tokens auslieferte. Verstehen Sie das als Grund, Ihr eigenes Modell zu benchmarken, nicht als Ihren Preis.
Um die Preise pro Chip über die nativen PyTorch-Backends hinweg zu vergleichen, die es jetzt gibt, wählen Sie einen Beschleuniger:
Wählen Sie einen Chip, um Listenpreise und Backends zu vergleichen. Die Preise stammen von den Preisseiten für Google Cloud TPU und AWS Capacity Blocks; eine Chipstunde liefert auf jedem Chip unterschiedlich viel Arbeit.
Für die GPU-Seite des Vergleichs behandeln meine Übersichten zu CoreWeave-Preisen und Lambda-Preisen die Neoclouds, und der AWS-Preisguide behandelt Trainiums Heimat.
Benchmarks und Modellabdeckung
Google hat zu diesem Launch mehr Zahlen veröffentlicht als AWS zu TorchNeuron, und die meisten davon sind tatsächlich nützlich. Fangen wir mit der Abdeckung an, denn bei einem 0.2.0-Release zählt „läuft mein Modell überhaupt“ mehr als Geschwindigkeit. Laut PyTorch-Blog testet Google kontinuierlich etwa 5,000 beliebte Hugging-Face-Modelle im Eager- und im kompilierten Modus:
| Test | Ergebnis |
|---|---|
| Modelle durchgängig getestet | 4,917 über 500+ Architekturfamilien |
| Laufen ohne Absturz | 98 % (4,821 von 4,917) |
| Zahlen stimmen mit GPU überein | 97 % (638 von 657 repräsentativen Modellen) |
| Bounded Dynamism, korrekte Numerik | 99 % (834 von 839 kausalen LLMs) |
Die Zeile zur numerischen Übereinstimmung würde ich zuerst anschauen. Bei eesel habe ich auf die harte Tour gelernt, dass „es läuft“ und „es gibt die richtige Antwort“ verschiedene Tests sind: Ein Support-Agent kann in einer Demo glänzen und bei echten Tickets trotzdem selbstsicher falsche Antworten geben, weshalb jeder Rollout zuerst gegen die historischen Tickets eines Kunden simuliert wird. Dass Google die Ausgabe gegen eine GPU-Baseline prüft und nicht nur auf Abstürze, ist die Compiler-Variante derselben Gewohnheit.
Bei der Geschwindigkeit stechen drei Ergebnisse hervor:
- Reines PyTorch, keine eigenen Kernel. Ein in reinem PyTorch mit Standardmodulen geschriebenes Muse Glimmer 30B erreichte 59 % MFU beim Prefill auf einem TPU-v7-Chip und 38 % MFU im Training auf vier. Eine vom TorchTitan-Team für GPUs geschriebene, minimal portierte Version kam auf 36 %.
- Nah an JAX. Qwen3 MoE 235B in TorchTitan lief mit 1,828 Tokens pro Sekunde auf 64 TPU-v7-Chips, gegenüber 1,937 für dasselbe Modell in JAX auf MaxText. Das sind etwa 94 % von Googles Heim-Framework.
- Skalierung. Dasselbe Modell skalierte von 1,024 auf 8,192 Ironwood-Chips, wobei die MFU nur von 28.8 % auf 27.1 % sank. Googles Cloud-Blog nennt außerdem bis zu 52 % MFU bei Qwen 3 8B.
Empfehlungsmodelle bekamen ein eigenes Ergebnis: Ein DLRM v2 auf 32 TPU-v7x-Chips erreichte mit 18.3 ms Schrittzeit das Niveau von Googles abgestimmter JAX-Version und nutzte dabei TPU-SparseCores für die Embedding-Lookups. Das sind alles Googles eigene Zahlen auf Googles eigener Hardware, daher sehe ich sie als Obergrenze, bis unabhängige Ergebnisse auftauchen.
Was TorchTPU noch nicht kann
Google ist bei den Lücken direkt. Die Feature-Tabelle teilt alles in „Validated“ und „Experimental“ ein, und der PyTorch-Blog listet die rauen Kanten im Detail auf.
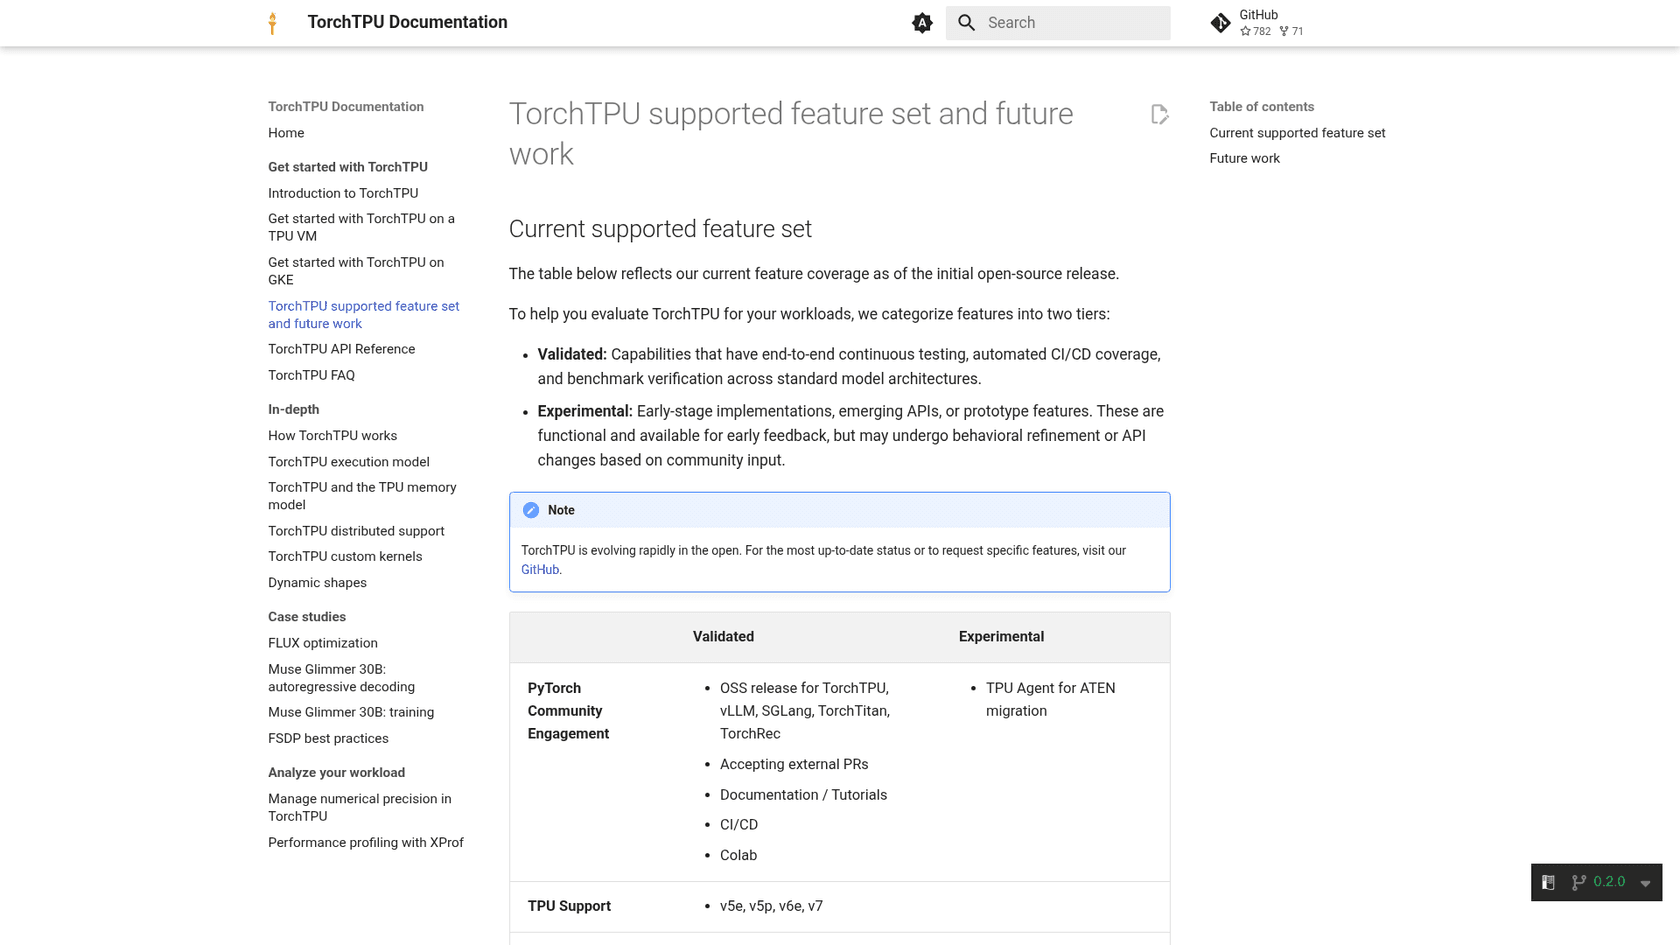
- Dynamische Shapes unter Compile.
torch.compileläuft heute mitdynamic=False. Variable Batchgrößen oder Sequenzlängen bedeuten Padding, Bucketing oder Neukompilierung, bis Bounded Dynamism erscheint. - FlexAttention. Noch nicht unterstützt; Google tauschte es beim Portieren eines GPU-Modells gegen
F.scaled_dot_product_attentionaus. - Randfälle bei verteiltem Training. FSDPv2 und rangabhängiger Code (MPMD) funktionieren, sind aber als „low perf“ markiert. Die standardmäßigen „Skinny Collectives“ können Ende-zu-Ende 30-40 % kosten; das holt man mit einem
@spmd_safe-Decorator oder SimpleFSDP zurück. - Ein Prozess pro TPU-Device. Eine TPU kann nur von einem Prozess geöffnet werden, daher funktionieren RL-Setups, die Trainer und Sampler auf denselben Chips betreiben, nicht ohne Weiteres.
- Auf GPUs zugeschnittene Modelle. TPU-Matrixeinheiten bevorzugen Dimensionen von 128 oder 256. Modelle, die Attention-Heads fest auf 64 setzen, was häufig vorkommt, laufen, lassen aber Geschwindigkeit liegen.
- Modellfamilien, die noch abgestimmt werden. GLM, Kimi, DeepSeek, GPT OSS, Mamba und LSTM/GRU sind als experimentell gelistet. Pre-Training im vollen Maßstab ist „future exploration“; Inferenz und Fine-Tuning sind die produktionsreifen Aufgaben.
Die größere Grenze liegt gar nicht im Code. TPUs sind Google-Cloud-Chips (plus On-Prem-Deals für sehr große Kunden), und der Hacker-News-Launch-Thread mit 379 Punkten und 93 Kommentaren drehte sich immer wieder darum:
"TPUs are unobtanium so while I appreciate Google's effort here I also recognize that it is not something that will be useful to me."
Ein anderer Kommentator, aus einem Team, das On-Prem-TPUs evaluiert hat, fasste die Käufersicht in einer Zeile zusammen:
"We've evaluated them but decided to stick with Nvidia, at least for one more generation."
Und zur April-Vorschau formulierte eine Antwort das Versprechen präziser als das Marketing: „just change one line and it works“ war nie dasselbe Versprechen wie „just change one line and you will get peak performance on the TPU“ (xrikcus, Hacker News). Das deckt sich mit Googles eigener Doku, was ein gutes Zeichen ist.
Wie TorchTPU im Vergleich zu anderen Wegen abschneidet, Modelle auszuführen
Für ein Team, das eigene PyTorch-Modelle trainiert oder ausliefert, sehen die Optionen jetzt so aus:
| Option | Was Sie verwalten | Codeänderungen | Am besten für |
|---|---|---|---|
| TorchTPU auf Cloud TPUs | TPU-VMs oder GKE, Compile-Cache, Shapes | "tpu", tpu_dist, statische Shapes für Compile | Google-Cloud-Teams mit großen, stetigen Jobs |
| TorchNeuron auf AWS Trainium | Instanzen, Compile-Cache, Shapes | "neuron", statische Shapes für Compile | Teams, die auf AWS festgelegt sind |
| NVIDIA-GPUs (CoreWeave, Hyperscaler) | Instanzen oder Cluster | Keine für CUDA-Code | Eigene CUDA-Kernel, schnellster Start |
| Serverless-GPUs (Modal, Baseten) | Ihr Modellcode | Kleine Wrapper | Stoßweise Inferenz ohne Kapazitätsplanung |
| Gehostete Modell-APIs (Groq, Fireworks AI) | Nichts | Nur API-Aufrufe | Offene Modelle ohne Hardware-Kontakt |
Die ersten beiden Zeilen hießen früher „in JAX neu schreiben“ und „den Trainings-Stack neu schreiben“. Jetzt sehen sie den GPU-Zeilen ziemlich ähnlich, und genau das ist der Sinn beider Launches. Bei der Wahl zwischen ihnen kommt es meist darauf an, welche Cloud Sie ohnehin bezahlen, und auch darauf, welcher Chip frei ist, wenn Sie ihn brauchen.
Wenn Ihr Endziel ein Agent auf Google Cloud ist statt eines eigenen Serving-Stacks, liegen Googles Agent Development Kit und die Gemini API eine Ebene über all dem, und Gemini selbst wird auf TPUs trainiert und ausgeliefert.
Für wen TorchTPU gedacht ist
TorchTPU ist für Teams, die bereits PyTorch schreiben, TPU-Kapazität auf Google Cloud bekommen können und genug für Beschleuniger ausgeben, dass sich ein Pilot lohnt. Forschungsteams profitieren am meisten vom Eager-Modus und der Debug-Einstellung, da sich TPUs im Debugger endlich wie jedes andere Device verhalten. Inferenz-Teams profitieren am meisten von vLLM-TorchTPU und SGLang-TorchTPU, die dieselben Server und APIs behalten und nur die Hardware darunter austauschen.
Es ist nichts für Sie, wenn Ihr Code von eigenen CUDA-Kernels abhängt, wenn Sie heute dynamische Shapes im kompilierten Modus brauchen oder wenn Sie keine TPU-Quota bekommen. Und es ist nichts für Sie, wenn Sie nie mit Modellgewichten arbeiten. Die meisten Unternehmen, mit denen ich bei eesel spreche, gehören zu dieser letzten Gruppe: Sie wollen, dass KI eine Aufgabe erledigt, und auf welchem Chip sie läuft, entscheidet jemand anderes.
Wo eesel hineinpasst: das ist Infrastruktur, eesel ist der Mitarbeiter
TorchTPU macht die Hardware-Ebene günstiger zum Ausprobieren und leichter zu wechseln. Das ist gut für alle, die Modelle bauen, und senkt mit der Zeit die Betriebskosten von KI-Produkten. Aber es beantwortet kein Ticket und schreibt keinen Blogbeitrag für Sie. Das sind Aufgaben, und Aufgaben brauchen Kontext: Ihr Help Center, Ihre bisherigen Tickets, Ihre Erstattungsregeln.
Auf dieser Ebene arbeitet eesel. eesel ist eine KI-Teammate-Plattform: Sie stellen einsatzbereite Teammates für bestimmte Aufgaben ein, heute einen KI-Helpdesk-Teammate und einen KI-Blogautor. Der Helpdesk-Teammate steigt in Ihre bestehende Warteschlange ein, lernt aus Ihrem Help Center und bisherigen Tickets und wird an Ihren historischen Gesprächen getestet, bevor er einem echten Kunden antwortet.
SamCart zeigt, wie das in der Praxis aussieht. Das Unternehmen betreibt eesel auf Freshdesk und Website-Chat, mit je einem eigenen Agenten pro Kanal, der aus etwa 280 Help-Center-Artikeln antwortet. Der Freshdesk-Agent sendet nur die erste Antwort, bis ein Mensch das Ticket übernimmt, und ein Plan mit 8,000 Interaktionen im Monat deckt das ab.
OroSoft, das Handelssoftware für Edelmetallhändler herstellt, nutzt es auf die vorsichtige Art: Support-Mitarbeiter erwähnen eesel in einem Freshdesk-Ticket und erhalten einen Entwurf, der auf etwa 6,100 gelösten Tickets basiert, mit genannter Quelle. Wenn nichts eine Antwort stützt, hinterlässt es eine Notiz mit der Bitte um einen Menschen, statt zu raten. Das ist dieselbe Disziplin wie Googles numerische Paritätsprüfungen, angewandt auf Kundenantworten.
Wenn Sie zu den Lesern gehören, die gerade ein Backend aus einem gepinnten pip-Index installiert haben, werden Sie das vermutlich auch lieber aus dem Terminal einrichten. Die eesel CLI steuert denselben Teammate und Workspace wie das Dashboard. npx @eesel/cli init chat-bubble --site https://your-site.com erstellt einen Agenten, fügt eine Website-Chatblase hinzu und beginnt ohne Konto, Ihre Website zu lesen, und eesel login behält den Workspace danach. Von dort verbindet eesel integrations connect freshdesk das Helpdesk, eesel files upload fügt Wissen hinzu, eesel chat spricht mit dem Agenten und mit eesel approvals genehmigen Sie zurückgehaltene Aktionen.
Dieses Design ist der Grund, warum es mit Coding-Agenten funktioniert, genau wie Googles TPU-Agent-Suite sich in sie einklinkt. Ein Agent wie Claude Code oder Cursor kann das Setup ausführen, die Ergebnisse lesen und beheben, was fehlschlug. Jeder Workspace ist außerdem ein MCP-Server, sodass derselbe Agent eesel direkt abfragen kann; sehen Sie meine Claude-Code-CLI-Referenz, wenn Sie das einrichten.

Das Protokoll oben ist das, was eesel activity im Terminal ausgibt, neueste zuerst. Die Preise sind in Einheiten angegeben, die Support-Teams ohnehin zählen: Auf der Preisseite kostet ein Ticket oder ein Chat 1 Credit, Pläne beginnen bei $299 im Monat für 500 Credits, und die kostenlose Stufe gibt Ihnen 100 Credits, um alles auszuprobieren.
eesel ausprobieren
Mit TorchTPU wählen Sie den günstigsten Chip für Ihre eigenen Modelle. Mit eesel sparen Sie sich diese Entscheidung für die Support-Arbeit: ein Helpdesk-Teammate, der sich in Freshdesk, Zendesk oder Gorgias einklinkt, aus Ihren bisherigen Tickets lernt und sich an historischen Gesprächen bewährt, bevor er ein Live-Ticket anfasst. Für SaaS-Teams mit technischen Fragen erlauben die KI-Helpdesk-API und die CLI, das ganze Setup zu skripten. eesel kostenlos testen oder im Terminal mit npx @eesel/cli starten.
Häufig gestellte Fragen
Was ist TorchTPU?
tpu-Device hinzu, sodass Eager-Modus, torch.compile und torch.distributed auf TPU v5e, v5p, Trillium und Ironwood laufen. Am 20. Oktober 2026 wurde es als Open Source veröffentlicht. Es ist die Chip-Ebene; wenn Sie eine KI wollen, die eine Aufgabe erledigt, sitzt ein KI-Teammate am anderen Ende des Stacks.Ist TorchTPU kostenlos?
torch_tpu installiert. Bezahlt wird die TPU-Zeit, auf der es läuft: von $1.20 pro Chipstunde für TPU v5e bis $12.00 für Ironwood on demand in us-central1. Mein Gemini-Preisguide behandelt die Modellseite von Googles Rechnung, falls Sie gar keine Chips betreiben wollen.Ersetzt TorchTPU PyTorch/XLA?
torch.compile-Backends nutzen. AWS hat mit TorchNeuron denselben Schritt für Trainium gemacht.Muss bei TorchTPU wirklich nur eine Codezeile geändert werden?
"cuda" in "tpu" und backend="nccl" in backend="tpu_dist" ändern. Damit es schnell läuft, nein. Googles eigene Doku sagt, dass Shapes, Sharding und Ops eines Modells auf GPUs abgestimmt sein können, daher braucht Spitzengeschwindigkeit Compile-Arbeit, breitere Attention-Heads oder Pallas-Kernel. Coding-Agenten wie Claude Code können einen Großteil dieser Portierung übernehmen, und Google liefert dafür eine TPU-Agent-Suite mit.Welche TPU-Generationen unterstützt TorchTPU?
Funktioniert TorchTPU mit Hugging Face Transformers?
device_map="tpu" direkt auf eine TPU, und Diffusers läuft mit pipe.to("tpu"). Google meldet, dass 98 % von 4,917 getesteten Hugging-Face-Modellen ohne Absturz laufen, und laut Hugging Face wird Optimum TPU nicht mehr gebraucht. Mehr zur Plattform in meinem Hugging-Face-Überblick.Wie schneidet TorchTPU im Vergleich zu TorchNeuron auf AWS Trainium ab?
torch.compile für Geschwindigkeit, vorerst statische Shapes. TorchTPU deckt vier TPU-Generationen ab und übersetzt nach XLA; TorchNeuron deckt Trainium2 und Trainium3 ab und übersetzt in den Neuron-Compiler. Eine Trainium2-Chipstunde kostet in EC2 Capacity Blocks $2.235, also zwischen Trillium und v5p on demand. Den Rest dieser Rechnung zeigt mein AWS-Preisüberblick.