

Kurzfassung
DeepInfer ist die Engine, die DeepSeeks eigene API antreibt, und seit dem 20. Oktober 2026 ist sie kostenlos auf GitHub unter Apache 2.0 verfügbar. Der Code kostet nichts; das Ticket, um ihn effizient zu betreiben, sind etwa 128 Blackwell-GPUs, die DeepSeek selbst als kleinste effiziente Einheit nennt. Zum günstigsten gelisteten Blackwell-Preis von AWS sind das ungefähr 32.500 $ pro Tag, also dasselbe Geld, für das man bei der DeepSeek-API zu Preisen außerhalb der Spitzenzeiten 54 Milliarden Ausgabe-Tokens bekommt.
Das Release ist also wichtig, nur nicht als Bausatz zum „DeepSeek selbst betreiben“. Es unterstützt ein Modell (V4.1 Flash), zwei Chip-Familien und wird ohne das KV-Cache-System und die Load Balancer ausgeliefert, die DeepSeeks Zahlen erst möglich machen. Das eigentliche Publikum sind Inferenz-Anbieter und Labs, und die eigentliche Wirkung betrifft die API-Preise aller anderen.
Wenn Sie DeepInfer lesen, weil Sie KI wollen, die Kunden antwortet, können Sie die GPU-Rechnung komplett überspringen. Ich baue die Agenten hinter eesel, und SE Ranking betreibt drei davon in Zendesk und bearbeitete damit in einem Monat 4.650 Gespräche, ganz ohne eigenen Inferenz-Stack.
Was ist DeepInfer?
DeepInfer ist DeepSeeks hauseigenes Inferenz-Framework: die Software, die ein trainiertes Modell nimmt und es Millionen von Nutzern schnell und günstig bereitstellt. Die GitHub-README nennt es „the high-performance inference framework that powers DeepSeek's large-scale production services.“ DeepSeek kündigte es auf X an am 20. Oktober 2026, und der Hacker-News-Thread erreichte innerhalb weniger Tage 2.353 Punkte und 892 Kommentare.
Falls „Inferenz-Framework“ neu für Sie ist: Training baut das Modell, Inferenz ist jedes Mal, wenn jemand ihm eine Frage stellt. Open-Source-Engines wie vLLM und SGLang erledigen diese Aufgabe für die meisten offenen Modelle bereits. DeepInfer ist DeepSeeks eigene Abwandlung dieser Idee, und die README sagt offen, dass es „was originally built primarily on vLLM, with additional inspiration from SGLang and TensorRT-LLM.“
Hier die Kurzfassung dessen, was veröffentlicht wurde, direkt aus der README:
| DeepInfer, Release Oktober 2026 | |
|---|---|
| Lizenz | Apache 2.0 |
| Unterstützte Modelle | Nur DeepSeek-V4.1-Flash |
| Unterstützte Hardware | NVIDIA-SM100-GPUs, Huawei-Ascend-950-NPUs |
| Software | Linux, GCC 13+, Python 3.12, CUDA 13 oder CANN 9.2 |
| Modus | Offline-Inferenz (Batch), kein fertiger API-Server |
| Sprache | Python 89,1 %, C++ 10,6 % |
| Begleit-Release | deepseek-recipe, der Encoder von API zu Tokens |
Das Modell, das es ausliefert, ist DeepSeek V4.1 Flash, ein Modell mit 1M-Kontext, Vision und Tool-Aufrufen, das ich in meinem V4.1-Flash-1017-Test behandelt habe. DeepSeek sagt, „inference code for future DeepSeek models“ werde im selben Repo landen.
Was hat DeepSeek tatsächlich veröffentlicht?
Die Schlagzeile sagt „vollständig Open Source“. Die README ist vorsichtiger, und genau diese Lücke ist das Nützlichste, um DeepInfer zu verstehen.
Was in der Box steckt, laut README:
- Optimierte Kernels aus DeepSeeks früheren offenen Releases: FlashMLA, DeepGEMM, DeepEP, TileKernels und DeepSelect, dazu eigene TileLang-Kernels.
- Parallelismus: Attention Data Parallelism, MoE Expert Parallelism mit Expert Load Balancing (EPLB).
- DSpark Speculative Decoding mit konfidenzgesteuerter Verifikation.
- SWA Bounded Replay, ein Trick, der Prefill-Arbeit reduziert (mehr dazu weiter unten).
- Asynchrones Scheduling, damit die GPU zwischen den Schritten nie auf die CPU wartet.
- Batch-invariante Inferenz und deterministisches Sampling, nur NVIDIA. Gleiche Eingabe, gleiche Ausgabe, unabhängig davon, was sonst im Batch steckt.
- Strukturierte Ausgaben: Einschränkungen per Regex, JSON-Schema oder EBNF-Grammatik.
Und was nicht dabei ist. Die README nennt drei Dinge, die „required for a complete inference service (not included in this release)“ sind:
- Ein KV-Cache-System.
- Trennung von Vision-Encoder / Prefill / Decode („most required engine functionality is already implemented“).
- Lastverteilung über Data-Parallel-Replikate, sowohl für Prefill als auch für Decode.
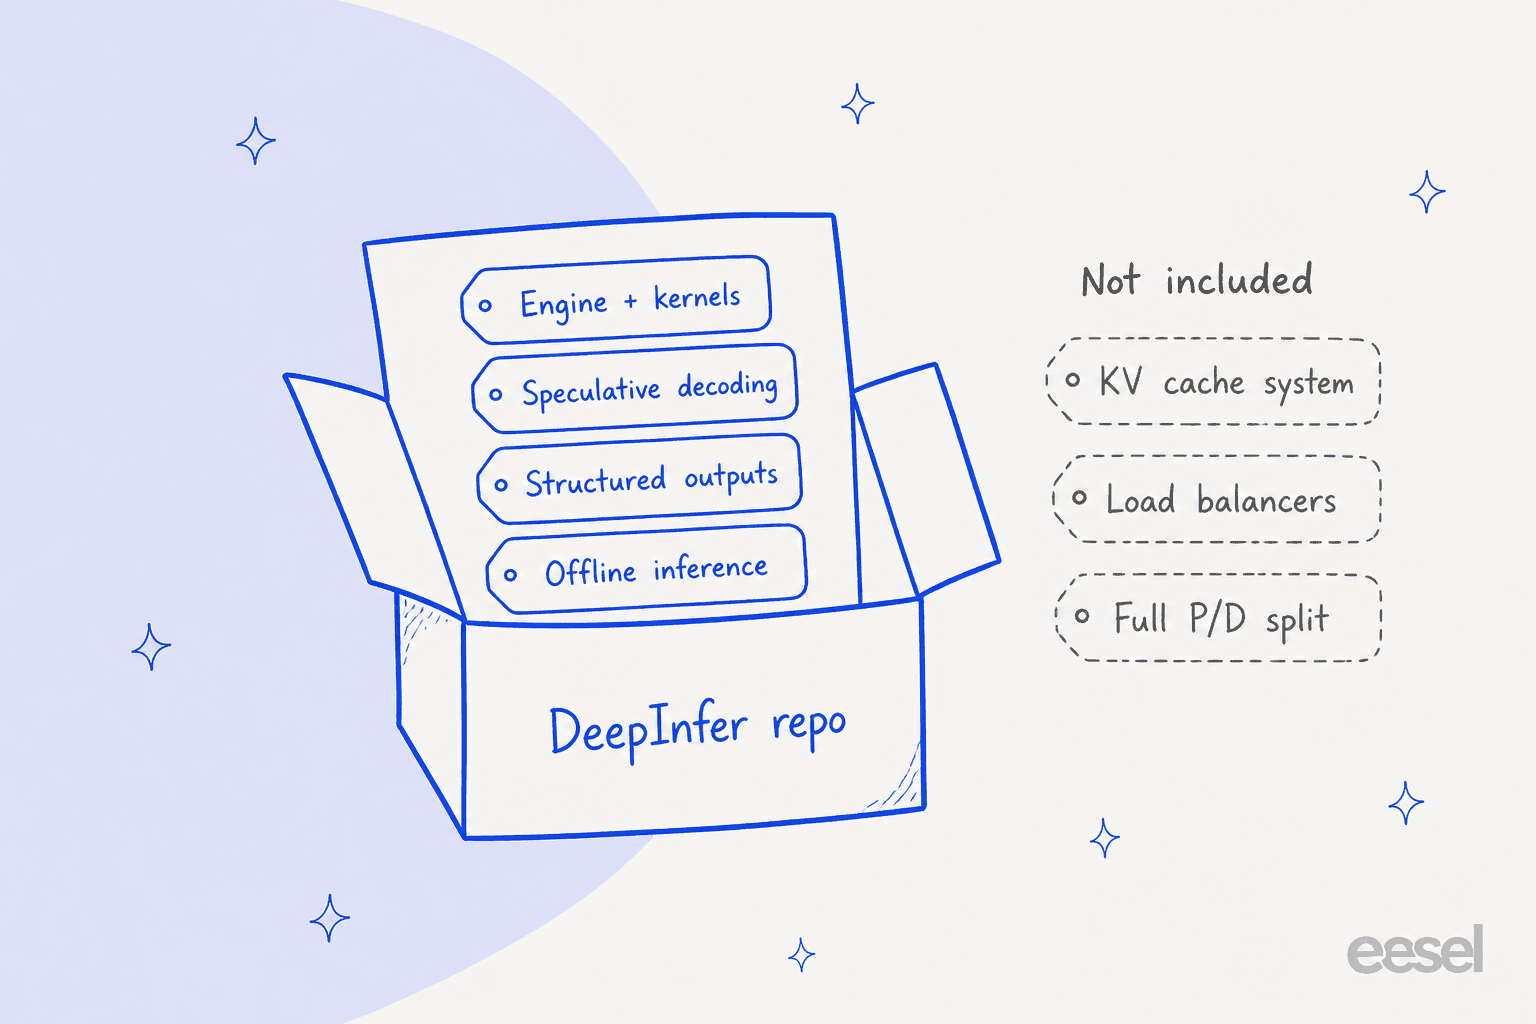
DeepSeeks Deployment-Q&A erklärt den Grund: Die KV-Cache- und Lastverteilungs-Teile „are tightly coupled to our internal infrastructure, so that code is not yet fully open-sourced.“ Dasselbe Dokument beschreibt dann sehr ausführlich, wie diese fehlenden Teile funktionieren, was großzügig ist. Es ist ein Designdokument für die Teile, die Sie selbst bauen müssten.
Hacker News hat das schnell bemerkt. Die kompakteste Version:
"Notably missing their kv cache system"

Das ist wichtig, weil der KV-Cache der Ort ist, an dem DeepSeeks niedrige Preise entstehen. Die API berechnet außerhalb der Spitzenzeiten 0,003 $ pro Million gecachter Eingabe-Tokens gegenüber 0,15 $ ungecacht, ein Faktor 50, und die Engine, die diese Lücke erwirtschaftet, ist genau der Teil, den Sie nicht bekommen.
Wie funktioniert DeepInfer?
DeepInfer teilt das Serving in getrennte Stufen auf, die auf getrennten GPU-Pools laufen, und verbindet sie dann über Load Balancer und einen gemeinsamen Cache. Das ist die Architektur, die DeepSeek in seiner Q&A veröffentlicht hat:
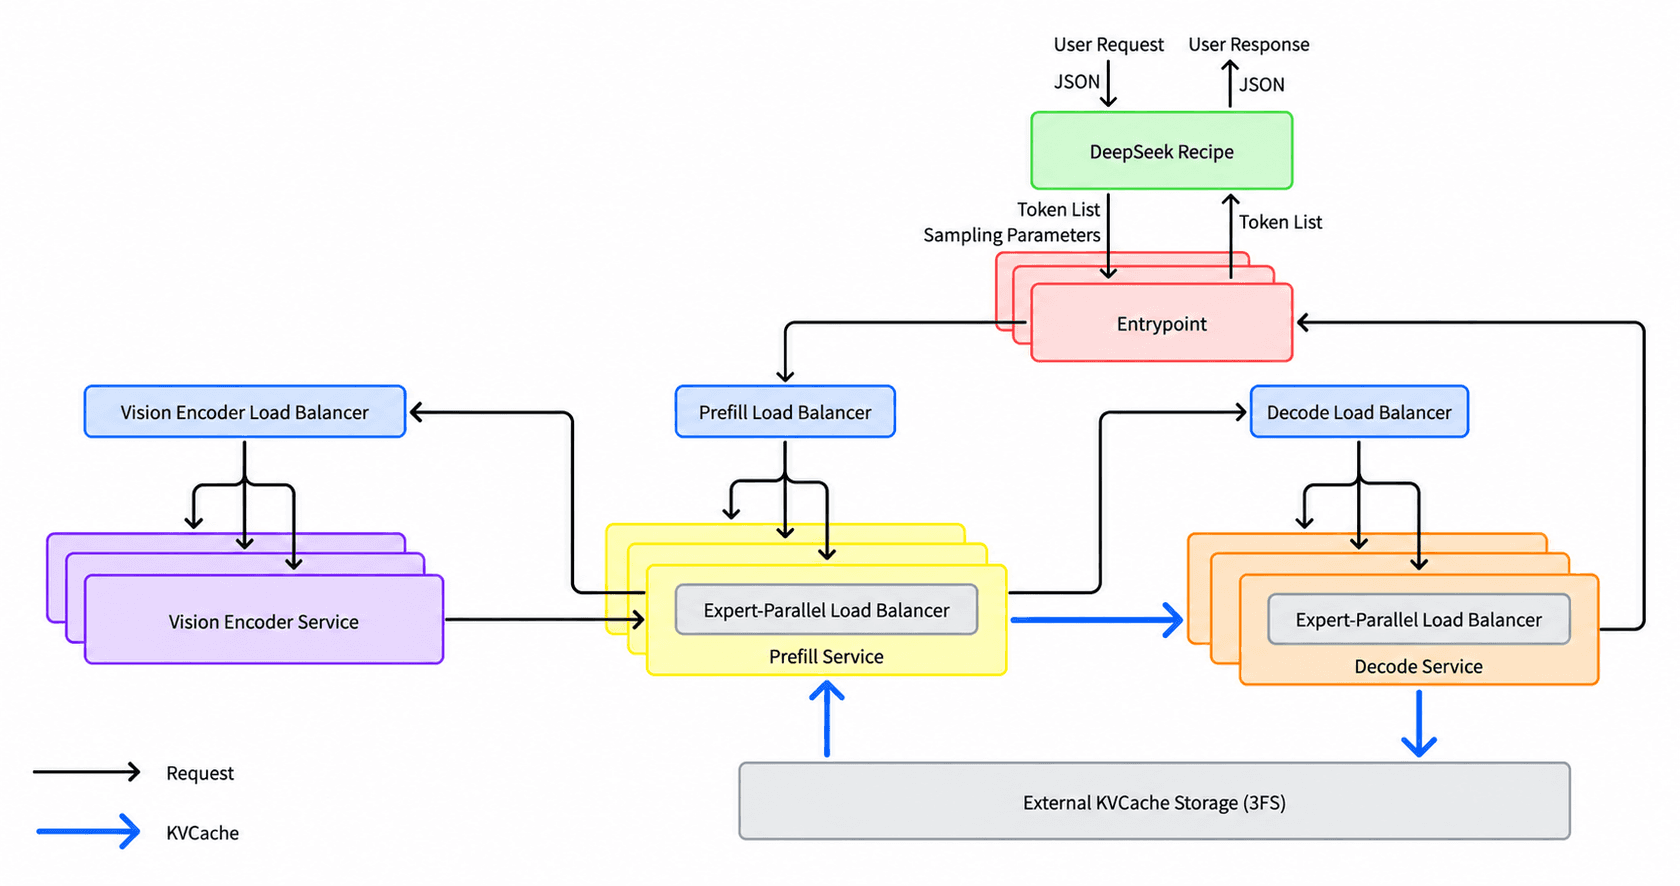
Von oben nach unten gelesen:
- DeepSeek Recipe wandelt eine eingehende JSON-Anfrage (im Format der Chat Completions, Responses oder Messages API) in Tokens um und die Ausgabe-Tokens zurück in eine Streaming-Antwort. Es ist in Rust mit Python-Bindings geschrieben.
- Der Entrypoint prüft den Cache auf ein passendes Präfix und leitet die Anfrage dann weiter.
- Prefill liest den gesamten Prompt und baut den Attention-Zustand auf. DeepSeek betreibt es auf „ordinary 8-GPU machines“ mit einem Expert Parallelism von 2 bis 8.
- Decode erzeugt die Antwort Token für Token. Das läuft breit: Expert Parallelism über 64 bis 128 GPUs.
- Der KV-Cache wird in einen dedizierten Speichercluster geschrieben, sodass die nächste Anfrage mit demselben Präfix das Prefill überspringt.
Die Trennung gibt es, weil die beiden Aufgaben die Hardware unterschiedlich belasten. Prefill ist ein großer Rechenstoß für einen langen Prompt; Decode ist ein langes Tröpfeln winziger Schritte, bei dem der Speicherverkehr der Engpass ist. Getrennte GPU-Pools erlauben DeepSeek, beide einzeln abzustimmen, sodass die Zeit bis zum ersten Token und die Geschwindigkeit jedes weiteren Tokens unabhängig voneinander gesteuert werden können.
Breiter Expert Parallelism
V4.1 Flash ist ein Mixture-of-Experts-Modell: Jedes Token aktiviert nur einige der „Experten“-Teilnetze des Modells. Verteilt man diese Experten auf 64 statt 8 GPUs, hält jede GPU weniger Experten und bewegt pro Schritt weniger Speicher. DeepSeeks eigenes Diagramm zeigt den Gewinn:
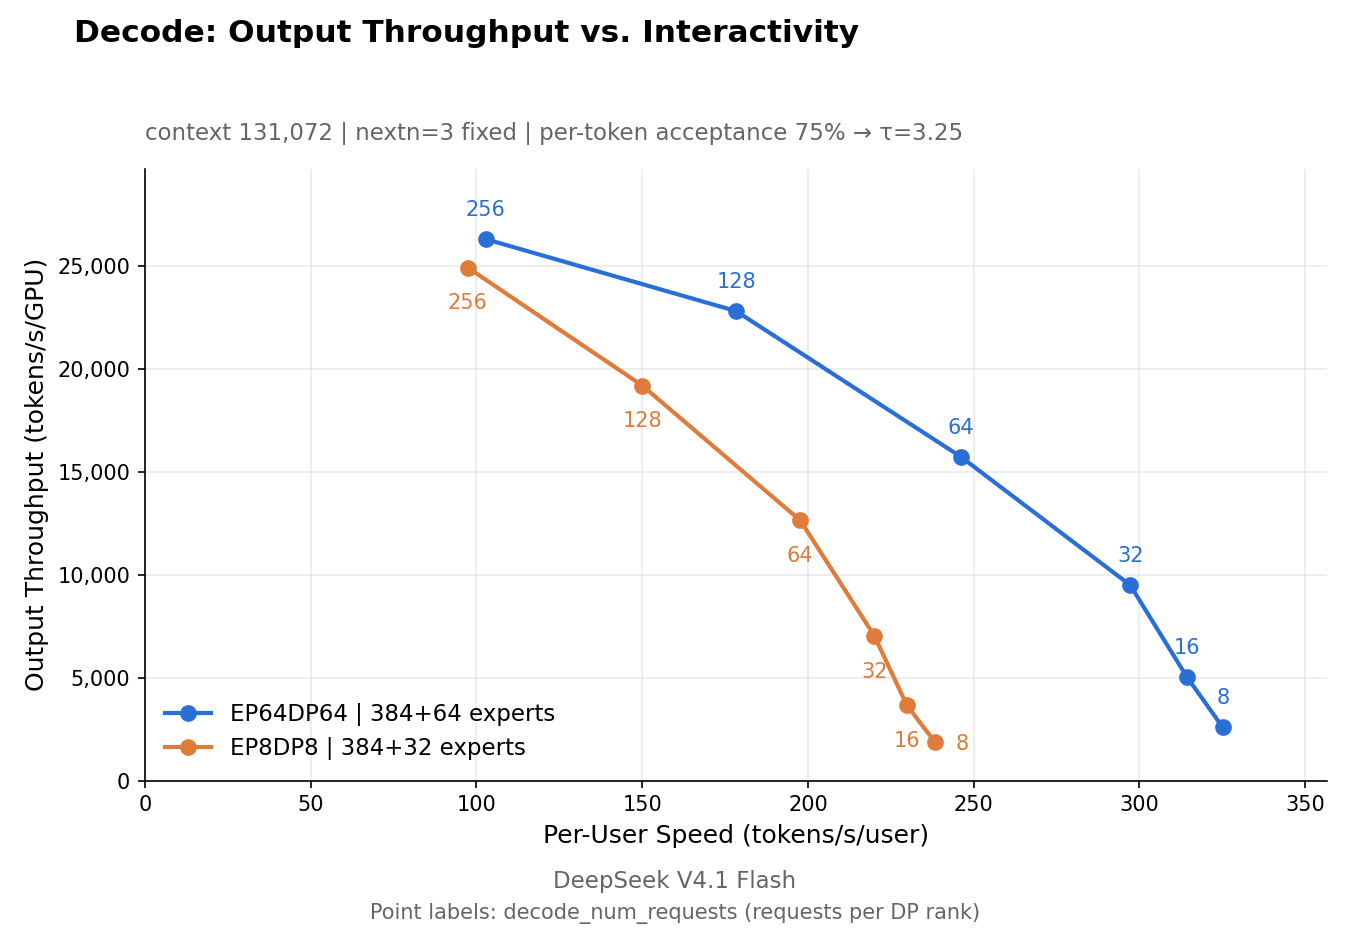
Bei 64 Anfragen pro Rank schafft das EP64-Setup etwa 15.700 Tokens pro Sekunde und GPU bei rund 246 Tokens pro Sekunde und Nutzer. EP8 kommt auf etwa 12.600 bei langsameren 198 pro Nutzer. Breites Parallelisieren ist es, was DeepSeek gleichzeitig schnell und günstig macht, und es ist auch der Grund, warum die Mindestbereitstellung so groß ist.
DSpark Speculative Decoding
Beim Speculative Decoding rät ein kleines Entwurfsmodell die nächsten Tokens, und das Hauptmodell prüft sie in einem Durchgang. DeepSeeks Dreh: Ein „Confidence Head“ sagt voraus, welche Vermutungen wahrscheinlich stimmen, sodass Verifikationsrechenzeit nur für die vielversprechenden aufgewendet wird. Laut Q&A senkt das die verifizierten Entwurfs-Tokens pro Schritt um etwa 30 % (von 5,00 auf 3,2-4,4) bei fast unveränderter akzeptierter Länge (3,29 vs. 3,20). Das Ergebnis ist +4-7 % Durchsatz am Produktions-Betriebspunkt. Bescheiden, aber bei 155 Billionen Tokens am Tag sind 5 % viele GPUs.
SWA Bounded Replay
Das ist der cleverste Teil. Fehlt einem gecachten Präfix ein Teil seines Sliding-Window-Attention-Zustands, berechnet DeepInfer nur die letzten 128 Tokens neu statt des ganzen Fensters. Die Q&A sagt, der Neuberechnungsaufwand werde „a constant, independent of context length and layer count“, und die Decoder-seitige Variante „nearly halving total prefill computation“. In der README aktivieren Sie das mit DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE=compact.
Der KV-Cache, den Sie selbst bauen müssten
DeepSeeks Cache-Schicht ist enorm. Die Q&A beschreibt etwa 100 PiB SSD-Speicher auf seinem 3FS-Dateisystem, wobei gecachte Prompts für Agenten-Traffic 3 Tage und für Chatbot-Traffic 7 Tage aufbewahrt werden, und etwa 14,4 TB logischer Cache pro GPU online. Diese lange Aufbewahrung ist der Grund, warum eine wiederkehrende Unterhaltung mit DeepSeek so günstig ist, und es ist der Teil, der „tightly coupled to our internal infrastructure“ ist.
Was braucht man, um DeepInfer zu betreiben?
Zwei Zahlen entscheiden, ob DeepInfer etwas für Sie ist: die Hardwareliste und die minimale Clustergröße.
Hardware. Nur NVIDIA-SM100-GPUs (Blackwell) und Huawei-Ascend-950-NPUs. Kein Hopper (H100/H200), keine Consumer-Karten. Ein Community-Repo, Deepinfer-SM80, portiert die Ideen bereits auf ältere Ampere-GPUs, was zeigt, wie groß die Nachfrage nach einer Version ist, die auf Hardware läuft, die Leute tatsächlich besitzen.
Einrichtung. Der Einstieg ist kurz, wenn man die Maschinen hat:
# Use `ascend` instead for the Ascend platform
export DEEPINFER_ACCELERATOR=nvidia
./build.sh
python examples/offline_inference.py --ep 8
Beim ersten Start wird der Checkpoint deepseek-ai/DeepSeek-V4.1-Flash-1017 von Hugging Face heruntergeladen. Das ist Offline-Inferenz (Batch): Sie übergeben Prompts, es gibt Ausgaben zurück. Ein OpenAI-kompatibler Server ist nicht dabei.
Minimaler Cluster. Das ist die Zahl, die die meiste Berichterstattung auslässt. Aus der Q&A: „the smallest efficient deployment unit is 64 GPUs of prefill plus 64 GPUs of decode.“ Technisch lässt sich ein Prefill- und ein Decode-Knoten betreiben, aber Decode ist auf EP64 und mehr abgestimmt, und die obigen Effizienzzahlen setzen das voraus.
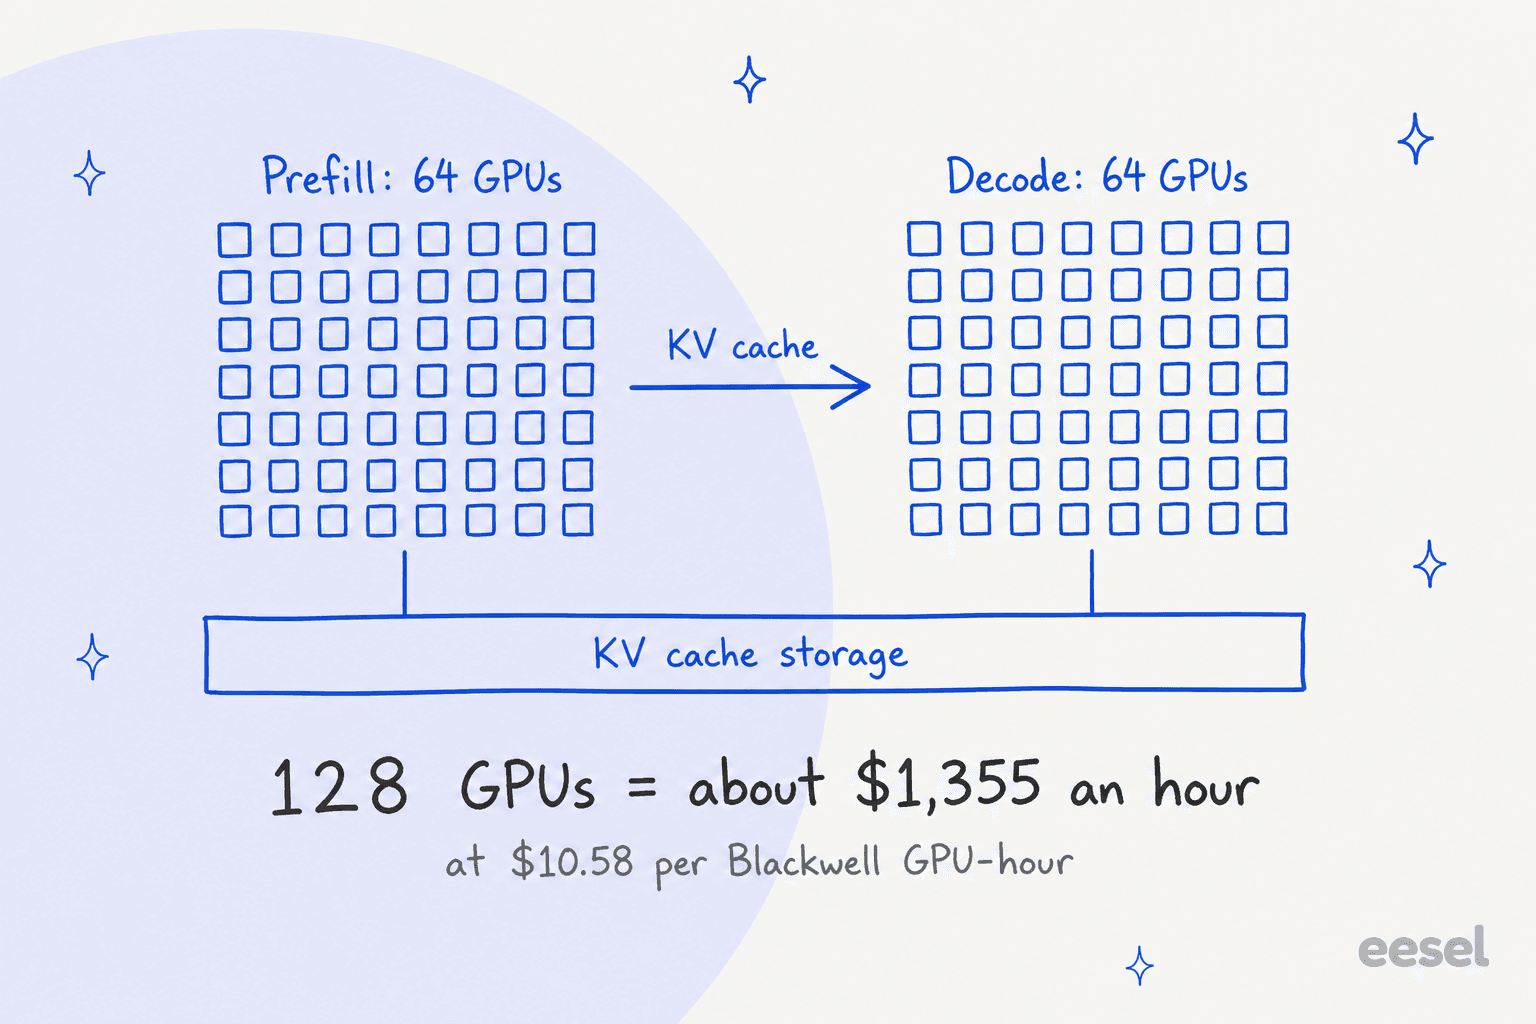
Dazu kommt der Speicher. DeepSeek empfiehlt 20 x 30,73-TB-SSDs pro KV-Cache-Speicherserver, jede mit mindestens 40 GB/s Leseleistung, dimensioniert für 24 Stunden an Daten. Die meisten Teams, die die README lesen, haben das nicht ungenutzt herumstehen.
Wie viel kostet DeepInfer?
DeepInfer selbst kostet 0 $. Alles andere ist Hardware, und der ehrliche Vergleich ist der mit dem direkten Aufruf der DeepSeek-API.
Das berechnet DeepSeek für dasselbe Modell, das DeepInfer ausliefert, laut Preisseite:
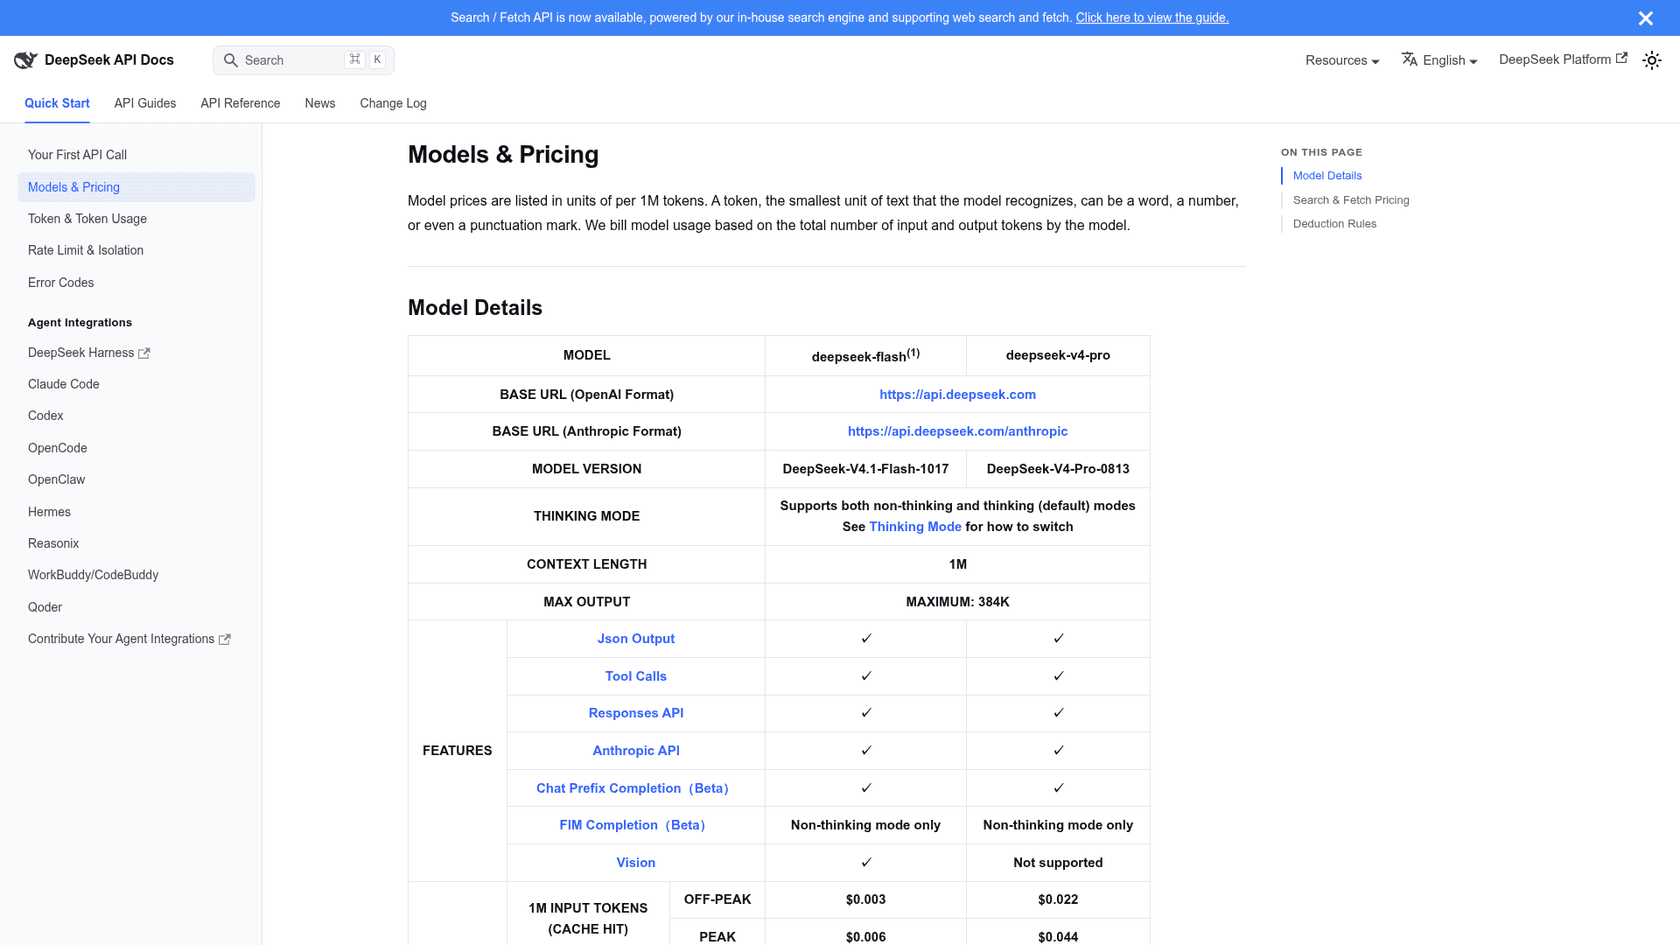
| Pro 1M Tokens | V4.1 Flash, Nebenzeit | V4.1 Flash, Spitzenzeit | V4 Pro, Nebenzeit | V4 Pro, Spitzenzeit |
|---|---|---|---|---|
| Eingabe, Cache-Treffer | $0.003 | $0.006 | $0.022 | $0.044 |
| Eingabe, Cache-Fehlschlag | $0.15 | $0.30 | $0.66 | $1.32 |
| Ausgabe | $0.60 | $1.20 | $1.98 | $3.96 |
Die Spitzenzeiten sind werktags 01:00-04:00 und 06:00-10:00 UTC; alles andere, auch Wochenenden, kostet den halben Preis. Mein Preisleitfaden zu V4.1 Flash geht diese Zeitfenster genauer durch, und der Vergleich V4 Flash vs. V4 Pro zeigt, wann sich das größere Modell lohnt.
Nun zur Self-Hosting-Seite. AWS EC2 Capacity Blocks listen GB200 mit 10,582 $ pro Beschleunigerstunde (US East Dallas Local Zone) und B200 mit 14,208 $ (Ohio, Virginia, Oregon und weitere). Beide sind SM100 Blackwell.
| 128-GPU-Cluster | Pro Stunde | Pro Tag | Pro 30 Tage |
|---|---|---|---|
| GB200 bei $10.582/GPU-Std. | $1,354 | $32,508 | $975,240 |
| B200 bei $14.208/GPU-Std. | $1,819 | $43,647 | $1,309,402 |
Das gilt vor Speicherservern, Netzwerk und den Ingenieuren, die den fehlenden KV-Cache und die Load Balancer bauen. 32.508 $ pro Tag kaufen bei DeepSeek zu Preisen außerhalb der Spitzenzeiten 54,2 Milliarden Ausgabe-Tokens, oder 27 Milliarden zur Spitzenzeit.
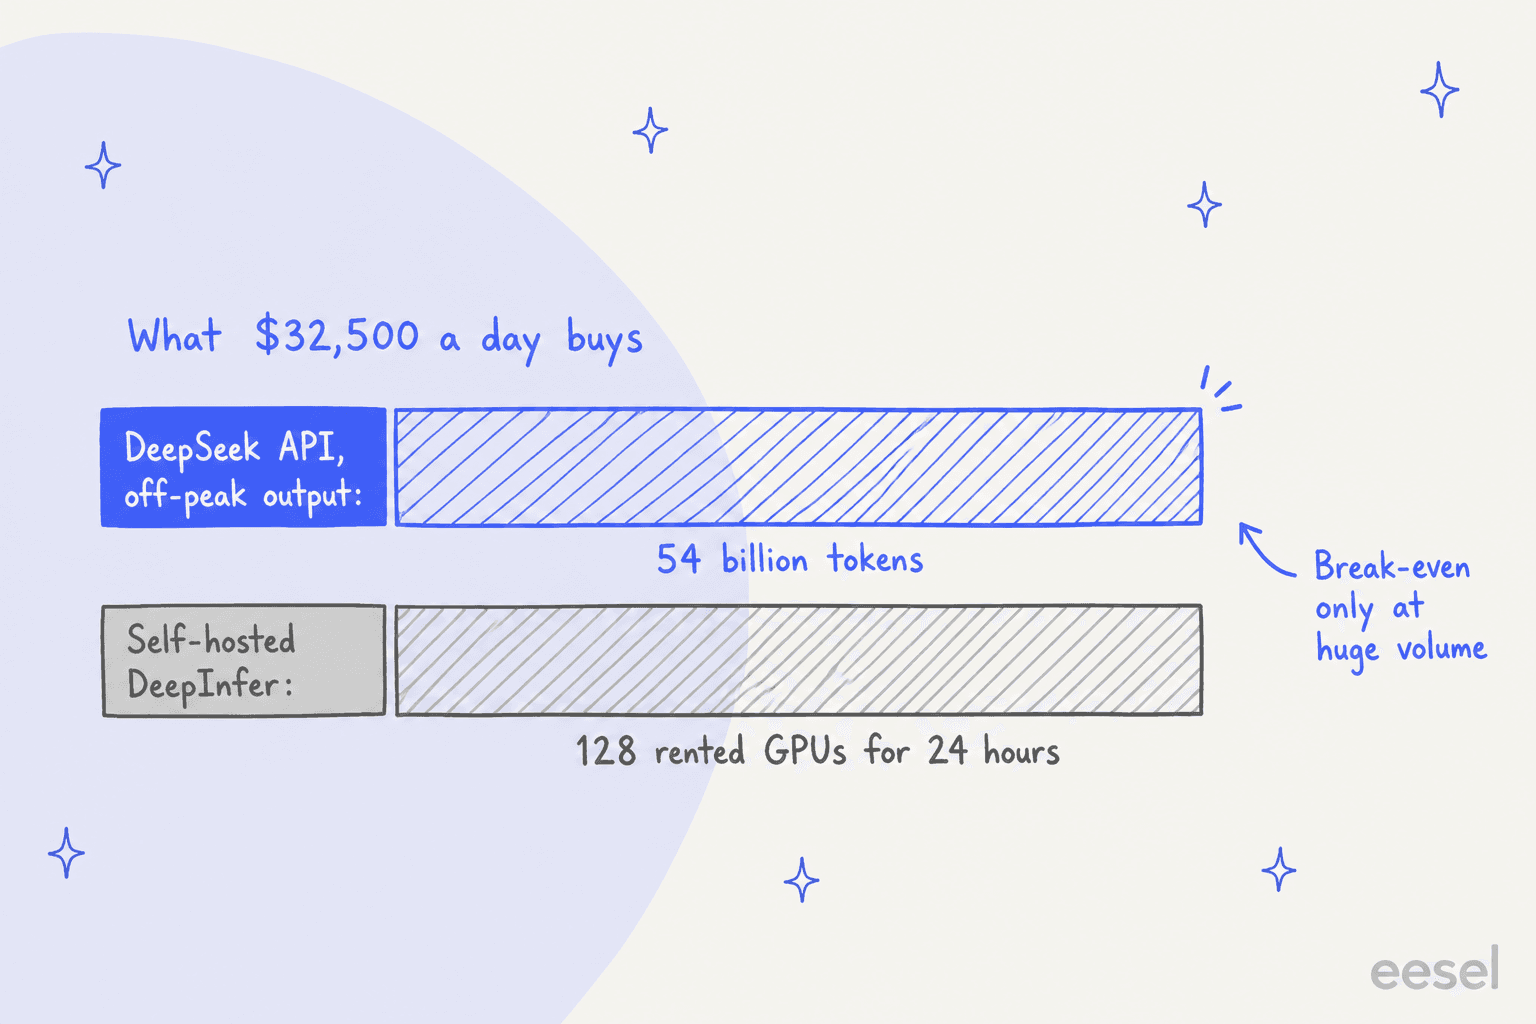
Können 128 GPUs überhaupt so viel erzeugen? Nach DeepSeeks eigenem Decode-Benchmark (etwa 15.700 Tokens pro Sekunde und GPU bei 64 Anfragen pro Rank) auf 64 Decode-GPUs liegt die Obergrenze bei etwa 87 Milliarden Ausgabe-Tokens pro Tag. DeepSeek sagt, die Lastverteilung erreiche „roughly 80% of a perfectly balanced offline benchmark“, was etwa 69 Milliarden ergibt. Self-Hosting schlägt die API zu Nebenzeit-Preisen also nur, wenn man den Cluster rund um die Uhr bei etwa 80 % von DeepSeeks eigener Produktionseffizienz hält, mit Infrastruktur, die DeepSeek nicht veröffentlicht hat. Das ist eine grobe Obergrenze, kein Angebot, aber sie zeigt die Form der Entscheidung.
Setzen Sie Ihr eigenes Volumen ein:
Bei den Standardwerten, einem stark genutzten Produkt mit 500 Millionen Ausgabe-Tokens und 3 Milliarden Eingabe-Tokens pro Tag, kostet die API etwa 680 $ am Tag gegenüber 32.508 $ für die GPUs. Sie bräuchten etwa das 48-Fache dieses Traffics, bevor der Cluster allein bei der Hardware gewinnt.
Was die Zahl von 38 $ pro GPU-Stunde verrät
Die meistzitierte Zeile des Launches steht nicht in der README. Sie steht in der Q&A: „A single cluster currently serves 155 trillion tokens per day, with overall revenue of US$38 per GPU-hour (at valley pricing).“ Valley Pricing bedeutet den Preis außerhalb der Spitzenzeiten.
Stellt man das neben die AWS-Preise oben, nimmt DeepSeek etwa das 2,7- bis 3,6-Fache dessen ein, was die Miete einer Blackwell-GPU für dieselbe Stunde kosten würde, und verlangt dabei trotzdem nur 0,60 $ pro Million Ausgabe-Tokens außerhalb der Spitzenzeiten. DeepSeek sagt nicht, auf welche Karte sich die Zahl bezieht, und nennt auch die eigenen Kosten nicht, also behandeln Sie sie als Umsatz, nicht als Marge. Auch HN fiel die Lücke auf:
"For comparison, rental prices seem to be ~$2.75/ per H-100-hour [1]. Meanwhile, Deepseek says "38 USD per hour per card". They haven't specified which card as far as I can tell."
Der Punkt ist nicht, dass DeepSeek reich ist. Er ist, dass günstige API-Preise ein echtes Geschäft sein können, wenn der Serving-Stack so effizient ist. Das setzt jeden Anbieter unter Druck, der für dieselben offenen Gewichte mehr verlangt, und DeepInfer gibt ihnen das Spielbuch in die Hand.
Was Entwickler über DeepInfer sagen
Die Reaktionen teilten sich in drei Richtungen: Begeisterung über die Offenheit, Skepsis gegenüber dem, was fehlt, und ein scharfer Hinweis darauf, wer profitiert.
Der skeptische Fall aus dem HN-Thread:
"Deepseek released just enough to stir the pot but not enough to cook your own from scratch. Wake me up when we can clone, point it at a dozen H100s we own, and get a working production service."
Das ist in beiden Punkten fair: H100s werden nicht unterstützt, und die Produktionsteile fehlen. Die andere Seite ist, dass Drittanbieter schon vor diesem Release hart mit DeepSeeks Modellen konkurriert haben:
"Together.ai, Baseten, and others have already achieved higher throughput, lower latency, and lower E2E latency for DeepSeek V4.1 Flash 1017 than DeepSeek's own inference service."
Anbieter wie Together AI, Baseten und Fireworks AI können DeepInfers Kernels und den deepseek-recipe-Encoder tatsächlich nutzen, der laut DeepSeek „fully aligned with the official DeepSeek API, so third-party deployments get the same API behavior as the official one“ ist. Für Entwickler heißt das: Ein DeepSeek-Modell bei einem Drittanbieter sollte Tool-Aufrufe und Reasoning genauso verarbeiten wie bei DeepSeek. Das ist eine unauffällige, aber echte Verbesserung.
Und ein Punkt zu Preismodellen, der mit Engines nichts zu tun hat:
"Even though their API price is cheap compared to OpenAI/Anthropic, I still can't "afford" to use their API because the subscriptions from OAI/Anthropic provide far higher value and peace of mind. I know for sure how much I need to pay each month."
DeepSeeks eigene Ankündigung nannte als Ziel, der Community zu helfen, „lower compute costs, reduce energy use, and make AI more affordable.“ Der Beitrag erhielt 43.339 Likes auf X.
Wie schneidet DeepInfer gegenüber vLLM und SGLang ab?
DeepInfer ist noch kein universeller Rivale von vLLM oder SGLang. Es ist ein Spezialist, der aus ihnen gebaut wurde. So stehen die drei da, basierend auf der README jedes Projekts:
| DeepInfer | vLLM | SGLang | |
|---|---|---|---|
| Modelle | Nur DeepSeek V4.1 Flash | Viele offene Modellfamilien | Viele offene Modellfamilien |
| Hardware | Blackwell (SM100), Ascend 950 | Mehrere GPU- und Beschleunigerhersteller | Mehrere GPU- und Beschleunigerhersteller |
| Online-API-Server | Nicht in diesem Release | Ja, OpenAI-kompatibel | Ja, OpenAI-kompatibel |
| Ursprung | Hauptsächlich auf vLLM aufgebaut | Originalprojekt | Originalprojekt |
| Am besten für | DeepSeeks Produktionstricks studieren oder wiederverwenden | Die meisten offenen Modelle ausliefern | Die meisten offenen Modelle ausliefern |
Wenn Sie diese Woche eine Engine für ein offenes Modell wählen, ist vLLM oder SGLang weiterhin die Antwort. DeepInfer ist der Ort, an dem man Ideen findet (breites EP, DSpark, Bounded Replay), die wahrscheinlich als Nächstes in diesen Projekten auftauchen. Googles TorchTPU startete am selben Tag und hat denselben Charakter: wichtige Basisarbeit für Leute, die Chips betreiben, unsichtbar für alle anderen.
Wer sollte sich für DeepInfer interessieren?
Kurze Antwort: weniger Leute, als die Sternezahl vermuten lässt.
- Inferenz-Anbieter und große Labs: ja. Das ist eine funktionierende Referenz, um ein MoE-Modell auf Frontier-Niveau günstig auszuliefern, mit dem aufgeschriebenen Design der fehlenden Teile.
- Forschende und Infrastruktur-Ingenieure: ja, als Lehrbuch. Das Q&A-Dokument gehört zu den detailliertesten öffentlichen Beschreibungen des Produktions-Servings von LLMs, die ich gelesen habe.
- Teams mit strengen Datenvorgaben, die DeepSeek auf eigener Hardware wollen: vielleicht, wenn Sie bereits Blackwell oder Ascend im großen Maßstab betreiben. Der deterministische Sampling-Modus ist ein echter Pluspunkt für Audits.
- Startups und App-Entwickler: nein. Nutzen Sie die API oder einen Host wie Fireworks AI, der offene Modelle für Sie betreibt. Vergleichen Sie mit Kimi K3.1 Pro oder Qwen 3.8 Max, bevor Sie sich auf eine Modellfamilie festlegen.
- Support- und Ops-Teams: nein. Sie brauchen Antworten, keine Engine.
DeepInfer senkt die Untergrenze dessen, was KI im Betrieb kostet; es senkt nicht, was es Sie kostet, KI selbst zu betreiben. Das sind zwei verschiedene Dinge, und die meiste begeisterte Berichterstattung verwischt sie.
Wo eesel hineinpasst: Das ist Infrastruktur, eesel ist der Mitarbeiter
DeepInfer ist Infrastruktur: Es macht Tokens günstiger in der Herstellung. eesel ist das andere Ende dieses Stacks, ein KI-Teammate, den Sie für eine Aufgabe einstellen. Aktuell sind das der KI-Helpdesk-Teammate und der KI-Blog-Autor, jeweils mit den Skills, Integrationen und dem Unternehmenskontext, die für ihre Rolle schon eingebaut sind.
Für ein Support-Team waren die Modellkosten nie der schwierige Teil. Zu DeepSeeks Preisen außerhalb der Spitzenzeiten kostet ein Ticket mit 6.000 ungecachten Eingabe-Tokens und 800 Ausgabe-Tokens etwa 0,0014 $, rund ein Siebtel Cent. Was echte Zeit kostet, ist, den Agenten so antworten zu lassen wie Ihr bester Mitarbeiter: Ihr Help Center und frühere Tickets lesen, wissen, wann übergeben wird, und das an echtem Verlauf beweisen, bevor Kunden es sehen. Ich habe erlebt, wie selbstsichere Bots in Live-Warteschlangen falsche Antworten gaben, weshalb jeder eesel-Rollout zuerst an historischen Tickets simuliert wird.
SE Ranking ist ein gutes Bild davon, wie das aussieht. Das Unternehmen verkauft drei Produkte aus einem Support-Team, betreibt also drei eesel-Agenten über drei Zendesk-Verbindungen, die jeweils für ihr eigenes Produkt aus etwa 16.800 Seiten Wissen antworten. Über einen Monat (8. August bis 8. September 2026) bearbeiteten sie 4.650 Gespräche: 2.554 Zendesk-Tickets und 2.102 Live-Chats, wobei etwa 2.100 Chats zuerst von eesel beantwortet wurden. Kein GPU-Cluster beteiligt.

Wenn Sie vergleichen wollen, was KI in Ihrem Helpdesk kostet, sind meine Aufschlüsselung der Zendesk-AI-Preise und der Leitfaden zu KI im Kundensupport bessere Startpunkte als jede Inferenz-Engine. Und wenn Sie wissen wollen, welche Modelle im Support wirklich gut sind, pflege ich eine laufende Einschätzung zum besten LLM für den Support.
Für Entwickler, die das Terminal mögen, hat eesel eine CLI, die denselben Teammate und Workspace steuert wie das Dashboard. Sie, ein Skript oder ein Coding-Agent wie Claude Code können einen Helpdesk verbinden, Wissen hinzufügen und den Agenten an früheren Tickets testen, ohne einen Browser zu öffnen. Das ist der agentenfreundliche Zugang, den die meisten Teams von „offener Infrastruktur“ eigentlich wollen.
eesel testen
DeepInfer ist für Leute, die GPU-Cluster betreiben. Wenn Ihr Ziel KI ist, die Kunden in Zendesk, Freshdesk oder Gorgias antwortet, ist eesel ein Helpdesk-Teammate, der aus Ihren früheren Tickets und Ihrem Help Center lernt, vor dem Livegang an Ihrem echten Verlauf getestet wird und auf der Preisseite bei 299 $ im Monat für 500 Tickets oder Chats startet. Testen Sie eesel kostenlos mit 100 Credits oder starten Sie im Terminal mit npx @eesel/cli.
