

Kurzfassung
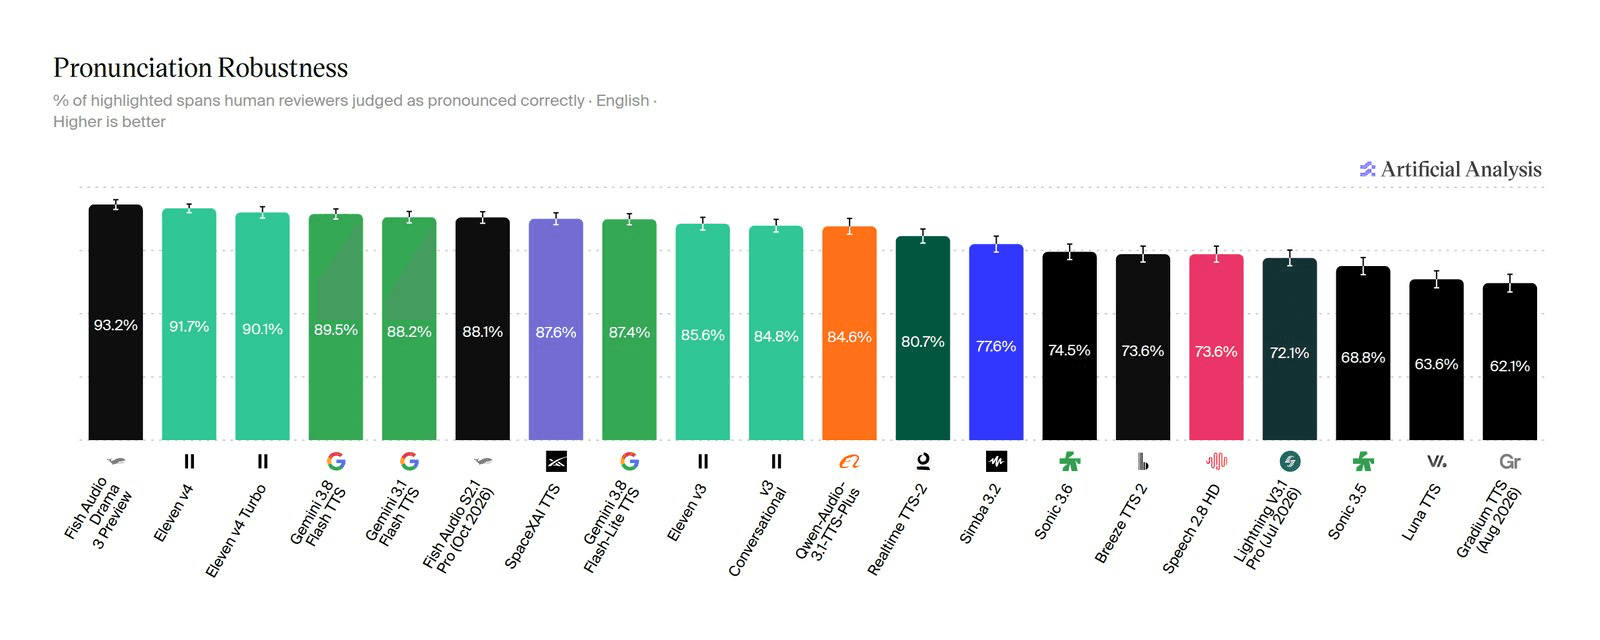
Fish Audio Drama 3 ist das beste Open-Weight-Text-to-Speech-Modell, das du heute herunterladen kannst, und das erste, das ich gesehen habe, bei dem du eine Zeile so regierst, wie du einen Schauspieler briefen würdest: [barely holding it together] I'm fine. Es liegt beim Aussprachetest von Artificial Analysis mit 93,2 % auf Platz 1, vor Eleven v4.
Die drei Haken: Es landet auf Platz 10, nicht auf Platz 1, wenn Hörer die Stimme wählen, die sie bevorzugen; die kostenlose kommerzielle Lizenz endet bei 500.000 US$ Jahresumsatz; und die 10 $ pro Million Zeichen der API sind ein 80-%-Einführungsrabatt, der nach dem 12. November auf 50 $ zurückspringt.
Nimm es für Hörbücher, Hörspiele, Spiele und Kurzvideos, wo du eine Zeile renderst, den besten Take behältst und weitermachst. Lass es bei Live-Sprache mit hohem Volumen sein, wo die Abweichung von Take zu Take schadet. Und wenn die Arbeit hinter deinem Audio das Schreiben selbst ist, passt hier der KI-Blog-Writer von eesel: Er liefert das recherchierte Skript, das ein Modell wie Drama 3 dann vorliest.
Was ist Fish Audio Drama 3?
Drama 3 ist das neue Text-to-Speech-Modell von Fish Audio, veröffentlicht am 13. Oktober 2026 in der Web-App fish.audio, den iOS- und Android-Apps und der API. Eine Vorschau ging am 23. September unter dem Namen drama-3-preview an API-Nutzer, und die Landingpage trägt heute noch ein „Preview“-Abzeichen.
Ich arbeite jeden Tag in der Support-Warteschlange von eesel, und ein großer Teil dieser Arbeit besteht darin, Tools, die in der Demo glänzen, von denen zu unterscheiden, die auch beim hundertsten Durchlauf halten. eesel setzt seit Jahren KI auf Live-Kundenwarteschlangen ein, und die wichtigste Lehre ist, dass eine selbstsichere Ausgabe trotzdem falsch sein kann, weshalb jeder eesel-Rollout zuerst an vergangenen Tickets simuliert wird. Ich habe Drama 3 durch dieselbe Brille gelesen: am Launch-Video vorbei, in die Docs, den technischen Bericht, die Preisseiten und die ersten Reaktionen der Community.
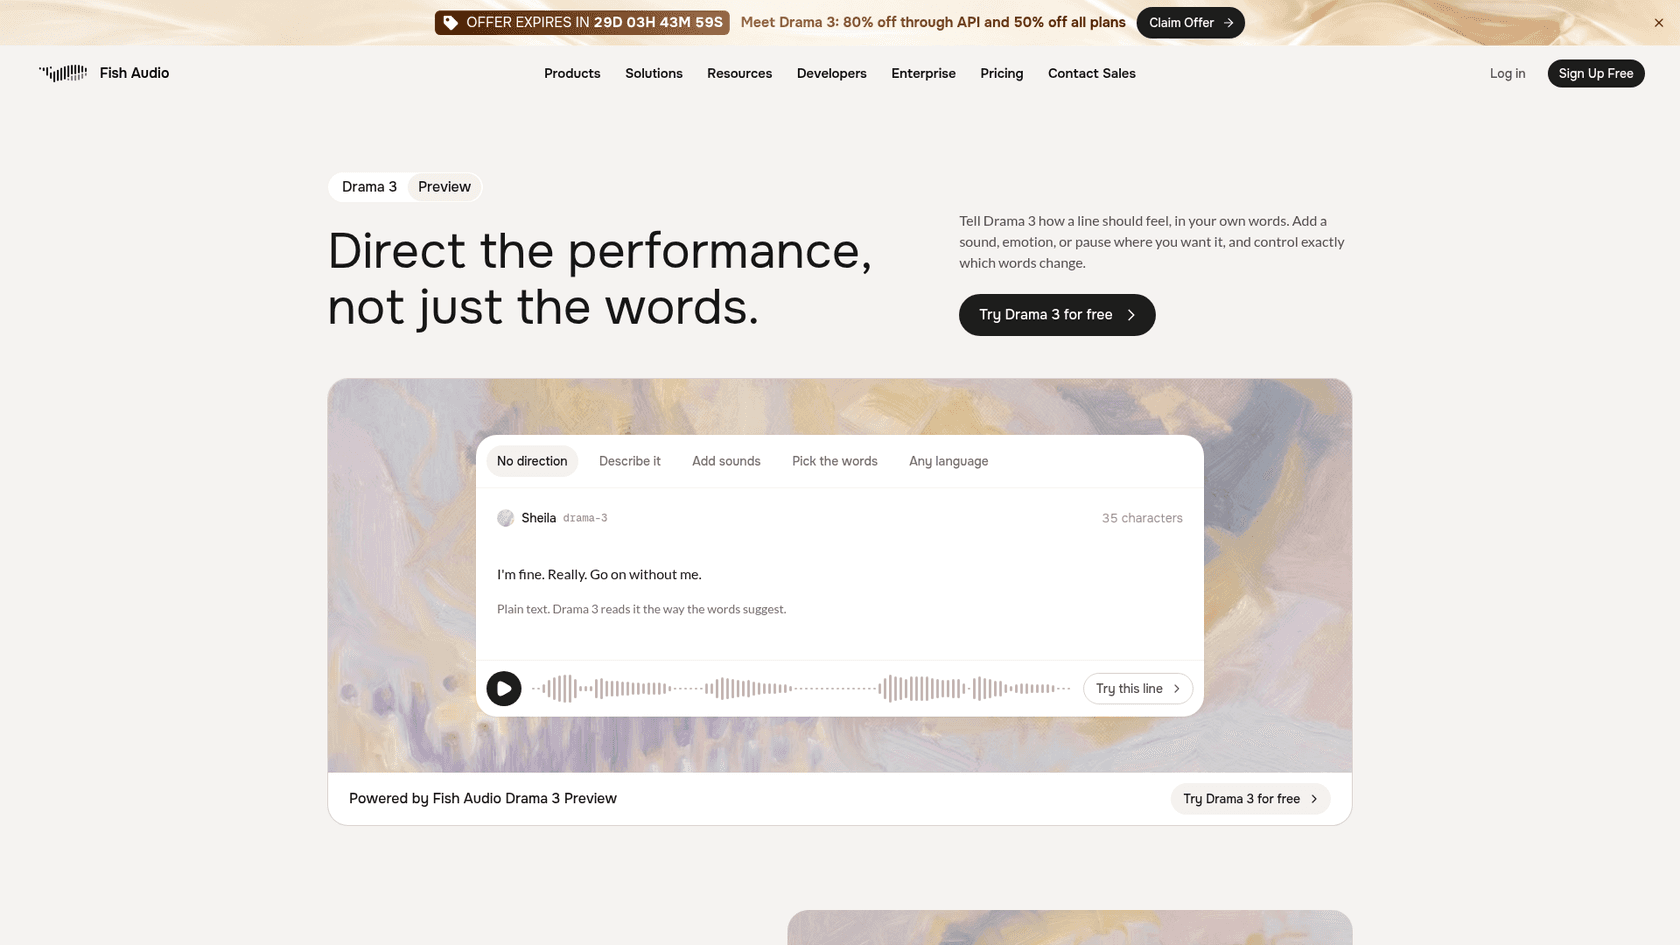
Die wichtigsten Fakten, alle von Fish Audios eigenen Seiten:
- 83 Sprachen, und die Anweisung kann in einer anderen Sprache als die Zeile geschrieben sein (Launch-Beitrag).
- Offene Gewichte auf Hugging Face unter der neuen Fish Audio Community License v1.0. Neu auf dem Hub? Mein Hugging-Face-Leitfaden erklärt die Grundlagen.
- Mixture-of-Experts mit 35 Mrd. Parametern, etwa 3 Mrd. aktiv pro Token, initialisiert aus dem Sprachmodell von Qwen3.5-35B-A3B, laut technischem Bericht.
- Derselbe API-Endpunkt wie S2.1 Pro, der Wechsel ist also ein Header:
model: drama-3.
Fish Audio selbst ist ein junges Unternehmen mit echter Traktion: 2025 gegründet, meldet es in seiner Pressemitteilung zum Launch 21 Millionen US-Dollar wiederkehrenden Jahresumsatz und mehr als 15 Millionen Nutzer, mit HeyGen, Runway und Vercel als genannten Kunden.
So funktioniert die Regie einer Zeile
Das ist der Teil, der Drama 3 vom Workflow mit ElevenLabs und der OpenAI Speech API unterscheidet, den die meisten kennen. Statt aus einer festen Liste von Emotions-Presets zu wählen, schreibst du Regieanweisungen direkt ins Skript.
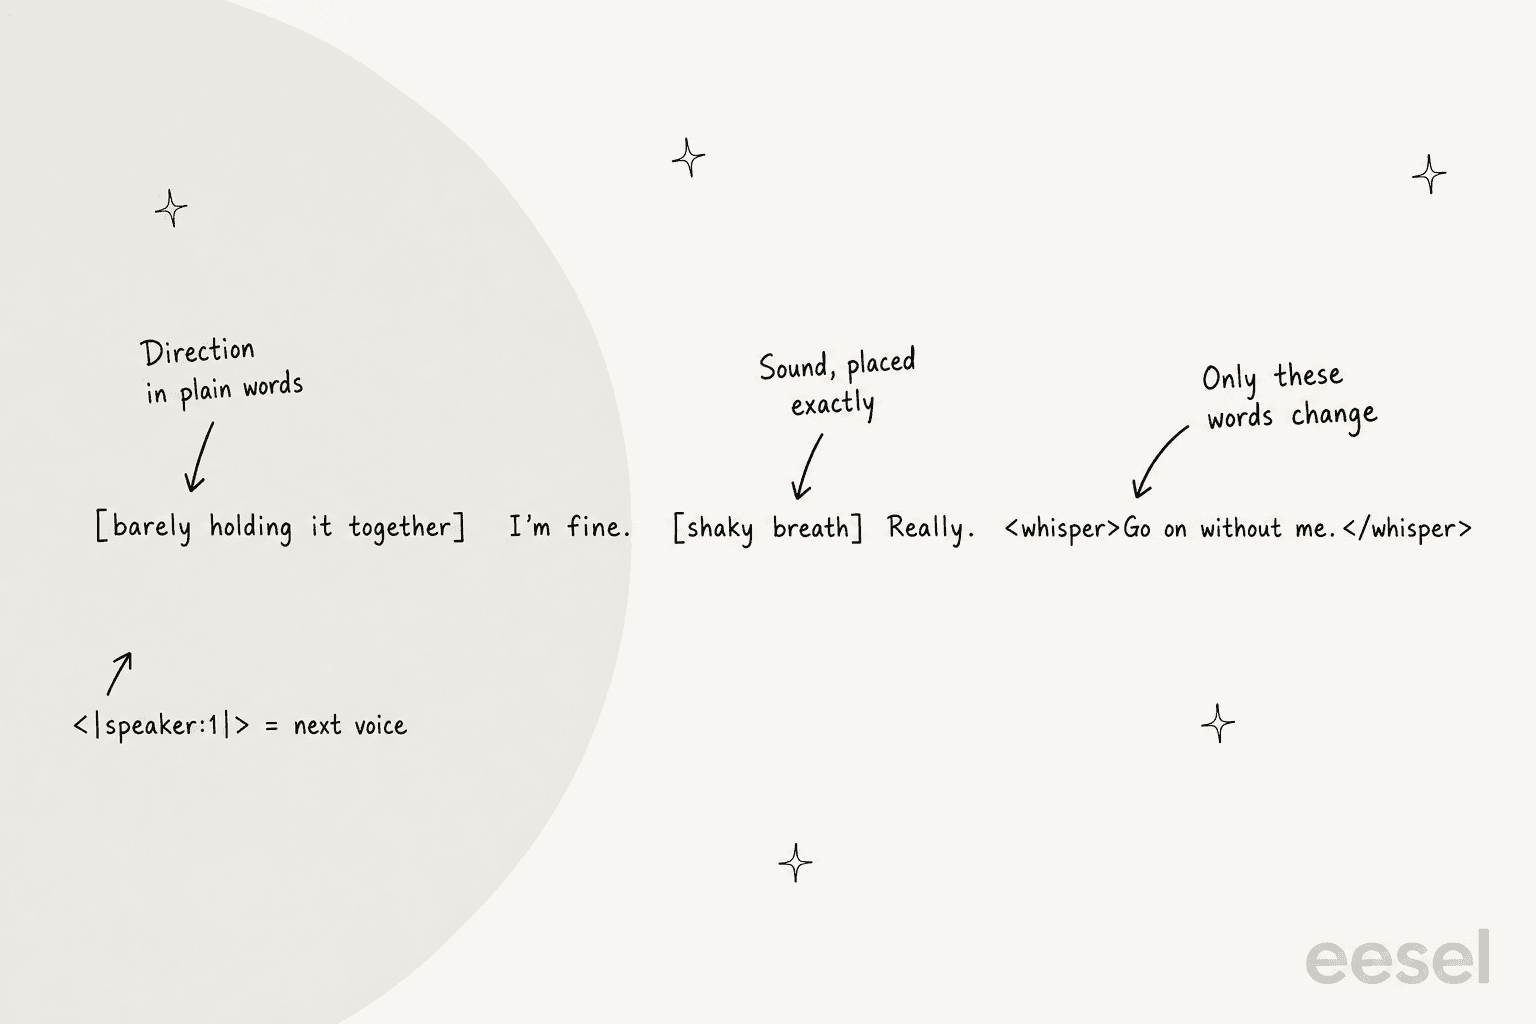
Die Drama-3-Docs beschreiben fünf Werkzeuge, und du kannst alle in einer Zeile mischen:
| Was du willst | So schreibst du es | Beispiel |
|---|---|---|
| Den Vortrag festlegen | Einfache Worte in eckigen Klammern | [slow, dangerously quiet] Just one. |
| Ein Geräusch oder eine Pause setzen | Eine Klammer dort, wo es passiert | I'm fine. [shaky breath] Really. |
| Nur einige Wörter ändern | Gepaarte Tags: <whisper>, <emphasis>, <soft>, <fast>, <slow>, <stress>, <forceful> | <whisper>Go on without me.</whisper> |
| Mitten in der Zeile die Sprache wechseln (experimentell) | Sprach-Tags | <french>Je voudrais une table pour deux</french> |
| Eine Aussprache festlegen | Phonem-Tags (CMU Arpabet, Pinyin, Romaji) | <|phoneme_start|>EH1 N JH AH0 N IH0 R<|phoneme_end|> |
Eine ganze Szene passt in eine Anfrage: Du übergibst pro Sprecher eine Stimm-ID in reference_id und beginnst jeden Redebeitrag mit <|speaker:0|>, <|speaker:1|> und so weiter. Die Modellkarte sagt, dass ein Text bis zu 16 Figuren tragen kann. In der Web-App schreibt ein Auto-Tag-Button erste Anweisungen für ein schlichtes Skript, ein netter Einstieg, wenn du noch nie Regieanweisungen geschrieben hast.
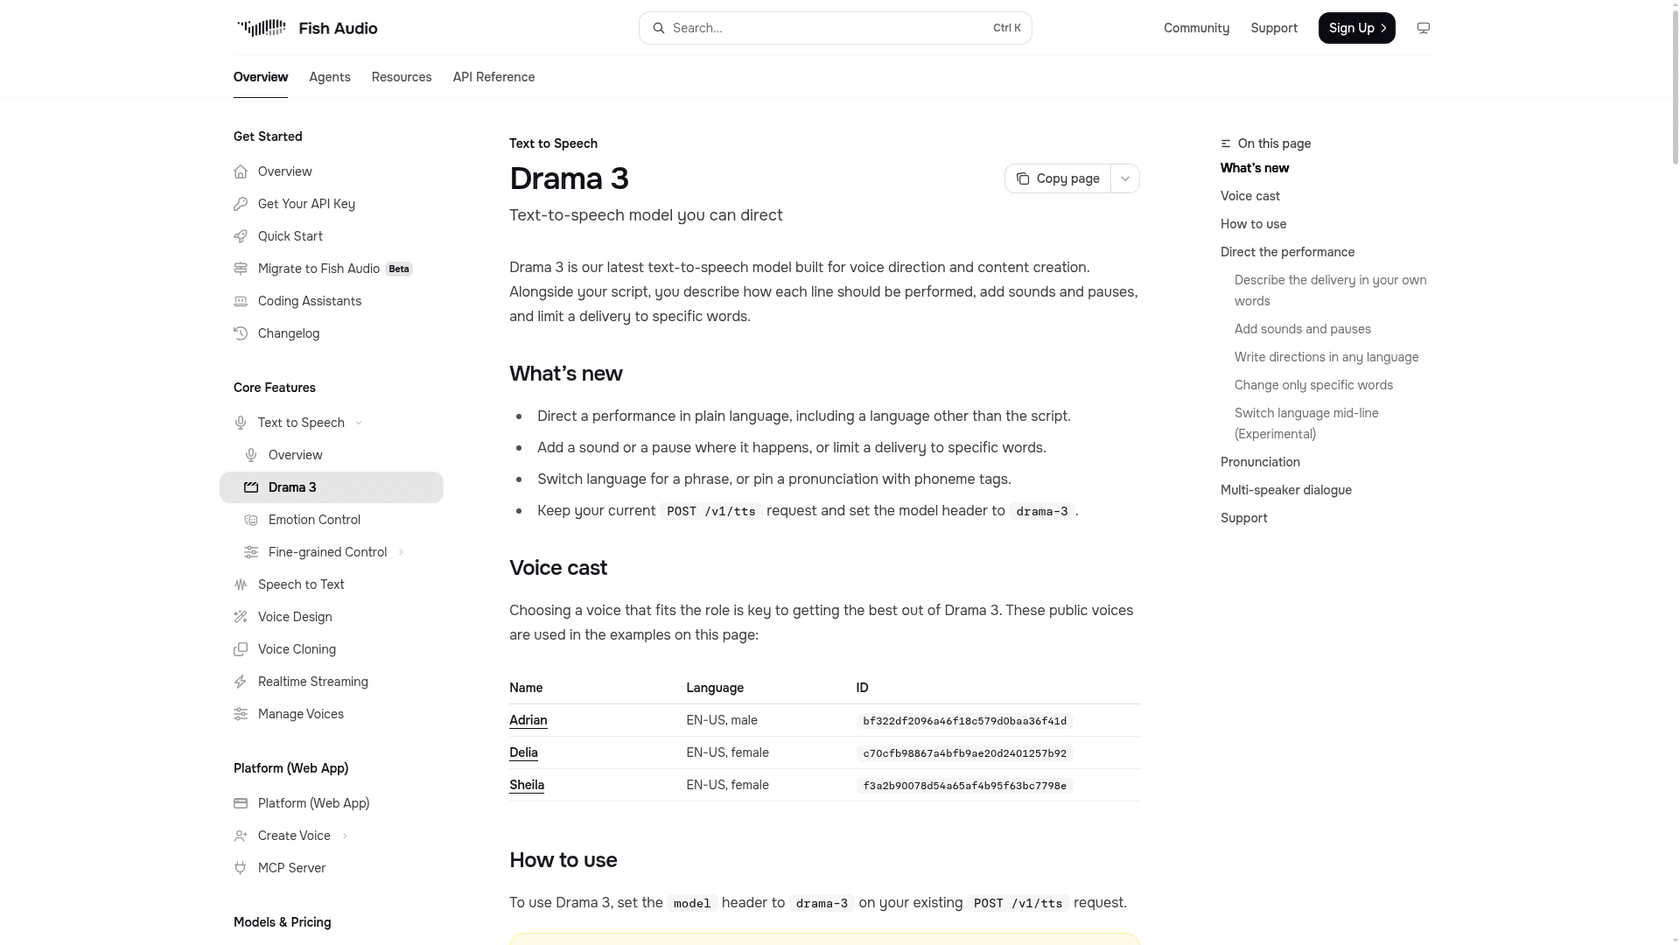
Ein Stolperstein aus den Docs verdient, irgendwo eingetragen zu werden: Fehlt der model-Header oder ist er falsch geschrieben, schlägt die Anfrage nicht fehl, sondern fällt stillschweigend auf s2.1-pro zurück. Du bekommst Audio, wirst abgerechnet und bekommst nie Drama 3. Klingen deine regierten Zeilen flach, prüfe den Header, bevor du dem Modell die Schuld gibst.
Was Drama 3 gut kann
Drei Dinge stechen heraus, und sie sind messbar statt Bauchgefühl.
Es liest schwierige Wörter richtig
Mehr Emotion hilft nur, wenn die Wörter sie überleben. Im Pronunciation-Robustness-Test von Artificial Analysis, bei dem menschliche Prüfer Markennamen, Zahlen, Codes und kontextabhängige Wörter kontrollieren, erreichte Drama 3 93,2 %, Platz 1 der Rangliste, vor Eleven v4 mit 91,7 % und Eleven v4 Turbo mit 90,1 %.
Die Aufteilung nach Kategorien aus Fish Audios Launch-Beitrag zeigt, woher der Sprung gegenüber dem eigenen Vorgänger kam:
| Was gelesen wird | Drama 3 | S2.1 Pro |
|---|---|---|
| Marken, Orte, Fachbegriffe | 95,9 % | 87,3 % |
| Wörter, deren Lesung vom Kontext abhängt | 95,3 % | 86,1 % |
| Zahlen, Daten, Einheiten | 93,6 % | 92,7 % |
| Codes, Dateipfade, E-Mails | 86,3 % | 79,4 % |
| Gesamt | 93,2 % | 88,1 % |
Bei einem Hörbuch, das „Chapter XVII“ sagt, oder einem Produkt-Erklärvideo voller SKUs ist der Zugewinn von 8,6 Punkten bei Marken- und Fachbegriffen der Unterschied zwischen einem Rendering und dreien.
Es nimmt Regie mitten in der Zeile an
Fish Audio hat Drama 3 anders trainiert als frühere Modelle. Sprachmodelle werden meist dafür belohnt, leicht transkribierbar zu sein und nah am Referenzclip zu liegen, was ein Lachen oder Flüstern stillschweigend bestraft. Drama 3 wurde laut Launch-Beitrag mit einem einzigen gelernten Belohnungsmodell darauf abgestimmt, welchen Take Menschen bevorzugten. In der Praxis heißt das: Eine Zeile kann atemlos beginnen, zu einem Flüstern absinken und todernst enden, und der Vortrag dreht sich dort, wo du die Klammer setzt.
Es erzeugt außerdem eine Szene mit mehreren Figuren in einem Durchgang, und ComfyUI hat es genau deshalb am ersten Tag als Partner-Node veröffentlicht. Wenn du Skripte für KI-Video oder Podcasts schreibst, ist es ein saubererer Workflow, die Emotion in die Skriptdatei selbst zu schreiben, als pro Clip an Reglern zu drehen.
Du kannst es tatsächlich herunterladen
Offene Gewichte sind der Grund, warum die TTS-Szene auf Reddit laut wurde. Fish Audio veröffentlicht die Gewichte, den Code auf GitHub und das Serving-Rezept für SGLang-Omni, und die Modellkarte nennt 88,9 ms bis zum ersten Audio für einen einzelnen Stream auf einer H200. Artificial Analysis führt es als das beste Open-Weights-Modell in allen drei TTS-Ranglisten, bei der Aussprache 15 Punkte vor Voxtral TTS von Mistral.
"After getting banned on Eleven Labs three times, I'm so happy something like this is finally open weight. It's fast and sounds great."

Derselbe Nutzer bekam es mit Hilfe von Claude Opus 5.5 auf zwei RTX 3090 mit etwa 39 GB VRAM zum Laufen, was zeigt, dass es auf Consumer-Hardware möglich ist und dass es keine Ein-Klick-Installation ist.
Wo Drama 3 schwächelt
Nichts davon ist ein K.-o.-Kriterium. Es sind die Dinge, die das Launch-Video nicht erwähnt und die ich wissen wollte, bevor ich eine Produktions-Pipeline darauf setze.
Es ist das beste offene Modell, nicht das bestklingende
Die Schlagzeile Platz 1 betrifft die Aussprachegenauigkeit. Fragt Artificial Analysis Hörer, welche Stimme sie bevorzugen, ändert sich das Bild.
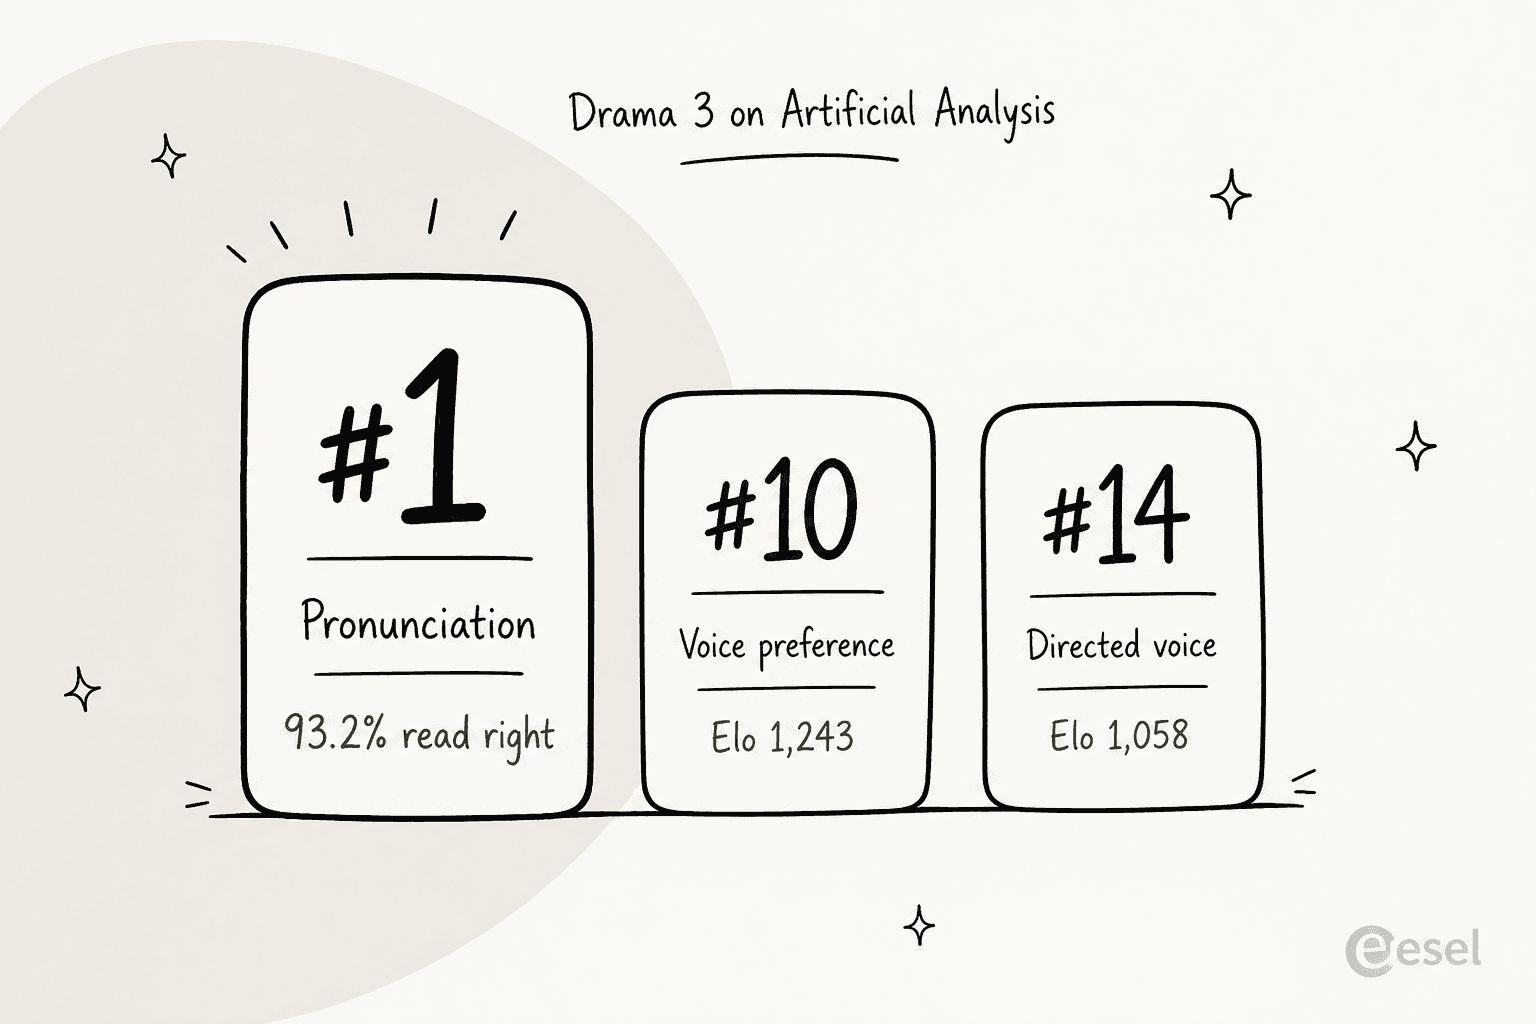
In der Provider-Voice-Arena hat Drama 3 ein Elo von 1.243 über 1.857 Duelle, Platz 10, knapp hinter Speechifys Simba 3.2, laut Artificial Analysis' Thread. Das ist ein Sprung von 101 Punkten gegenüber S2.1 Pro, ein großer Schritt. Aber neun Modelle gewinnen bei der allgemeinen Stimmqualität noch mehr Blindvergleiche, und in der Controlled-Voice-Arena liegt es auf Platz 14. Auch auf Reddit waren nicht alle überzeugt:
"barely better than breeze with nearly 10x the size"
Takes variieren, und die Bearbeitungswerkzeuge fehlen noch
Fish Audio ist hier ehrlich: „Takes vary, so render a few and keep the one that plays“, heißt es im Launch-Beitrag, und die FAQ der Landingpage erklärt das Preview-Label genauso. Für einen Sprecher, der ein Kapitel einmal rendert, ist das in Ordnung. Für jeden, der tausende Zeilen automatisch erzeugt und bei dem niemand den besten Take auswählt, ist es ein echter Kostenfaktor.
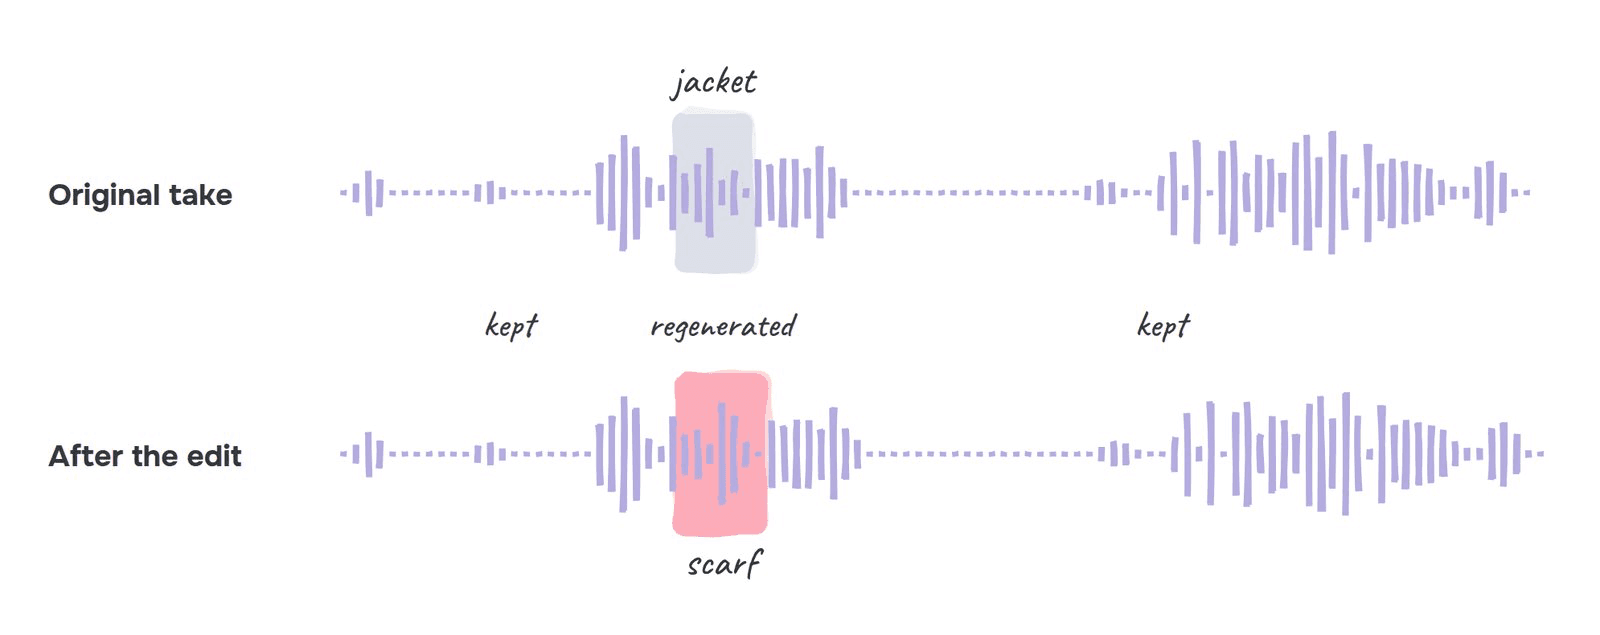
Die zwei Funktionen, die das meiste davon lösen würden, interaktives Bearbeiten („softer than that one“) und Audio-Inpainting (ein einzelnes Wort in einem freigegebenen Take neu erzeugen), sind im Test nur auf Einladung, mit einer Bearbeitungs-API „coming soon“.
Die Lizenz hat eine Decke, und die Hardware hat einen Boden
Die Fish Audio Community License ist nur kostenlos für kommerzielle Nutzung, solange du und deine verbundenen Unternehmen unter 500.000 US$ im Jahr verdienen. Darüber, oder wenn du Drama 3 anderen als Sprach-API anbieten willst, brauchst du eine kostenpflichtige Lizenz. Fish Audios eigene FAQ nennt es „open-weight rather than open source“, und die Community hat es bemerkt:
"Lame license."
Die Lizenz verbietet außerdem das Klonen der Stimme einer realen Person ohne Einwilligung, was ich als Pluspunkt werte. Bei der Hardware setzte der Ersteller des Threads die Messlatte bei einer 48-GB-CUDA-Karte; eine 4-Bit-Quantisierung der Community senkt sie auf 32 GB. In beiden Fällen ist das kein Laptop-Modell.
Fish Audio Drama 3 Preise
Es gibt zwei Wege zu zahlen: die Entwickler-API, abgerechnet nach Text, oder einen Creator-Tarif in der Web-App, abgerechnet in Credits. Der API-Preis hat eine Klippe eingebaut.
| API-Modell | Preis | Einheit | Quelle |
|---|---|---|---|
| Drama 3, Einführungsangebot (13. Okt. bis 12. Nov. 2026) | 10 $ | pro 1 Mio. Zeichen | Launch-Beitrag |
| Drama 3, Listenpreis | 50 $ | pro 1 Mio. Zeichen | Launch-Beitrag |
| S2.1 Pro | 15 $ | pro 1 Mio. UTF-8-Bytes | API-Preisdokumentation |
| S2.1 Pro Free | 0 $ | pro 1 Mio. UTF-8-Bytes | API-Preisdokumentation |
Zwei Dinge sind zu beachten. Erstens führt die offizielle Preistabelle in den Docs drama-3 Stand 14. Oktober gar nicht auf, der Launch-Beitrag ist also die einzige Stelle, an der Fish Audio die Zahl nennt. Zweitens: Zum Listenpreis kostet Drama 3 das 3,3-Fache von S2.1 Pro, nach dem 12. November zahlst du also einen Aufschlag für die Schauspielerei, nicht für die Stimme. Fish Audios Docs setzen 1 Mio. UTF-8-Bytes bei etwa 180.000 englischen Wörtern oder rund 12 Stunden Sprache an; bei englischem Text ist ein Zeichen ein Byte, die Einheiten passen also zusammen.
Trag dein eigenes Monatsvolumen ein, um zu sehen, wo die Änderung am 12. November landet:
Ein Rechenbeispiel: Ein Roman mit 90.000 Wörtern hat etwa eine halbe Million Zeichen. Ihn einmal zu sprechen kostet mit Drama 3 zum Einführungspreis etwa 5 $, zum Listenpreis 25 $ und mit S2.1 Pro 7,50 $. Renderst du jedes Kapitel dreimal, um den besten Take zu wählen, verdreifachen sich diese Zahlen. Für einen Solo-Creator ist das immer noch günstig; für eine Plattform, die Millionen Wörter im Monat vertont, ist der Listenpreis der, mit dem du planen solltest.
Auf der Creator-Seite sagt Fish Audio, dass Drama 3 dieselben Credits wie S2.1 Pro nutzt, laut Tarifseite etwa 600 bis 625 Credits pro Audiominute.
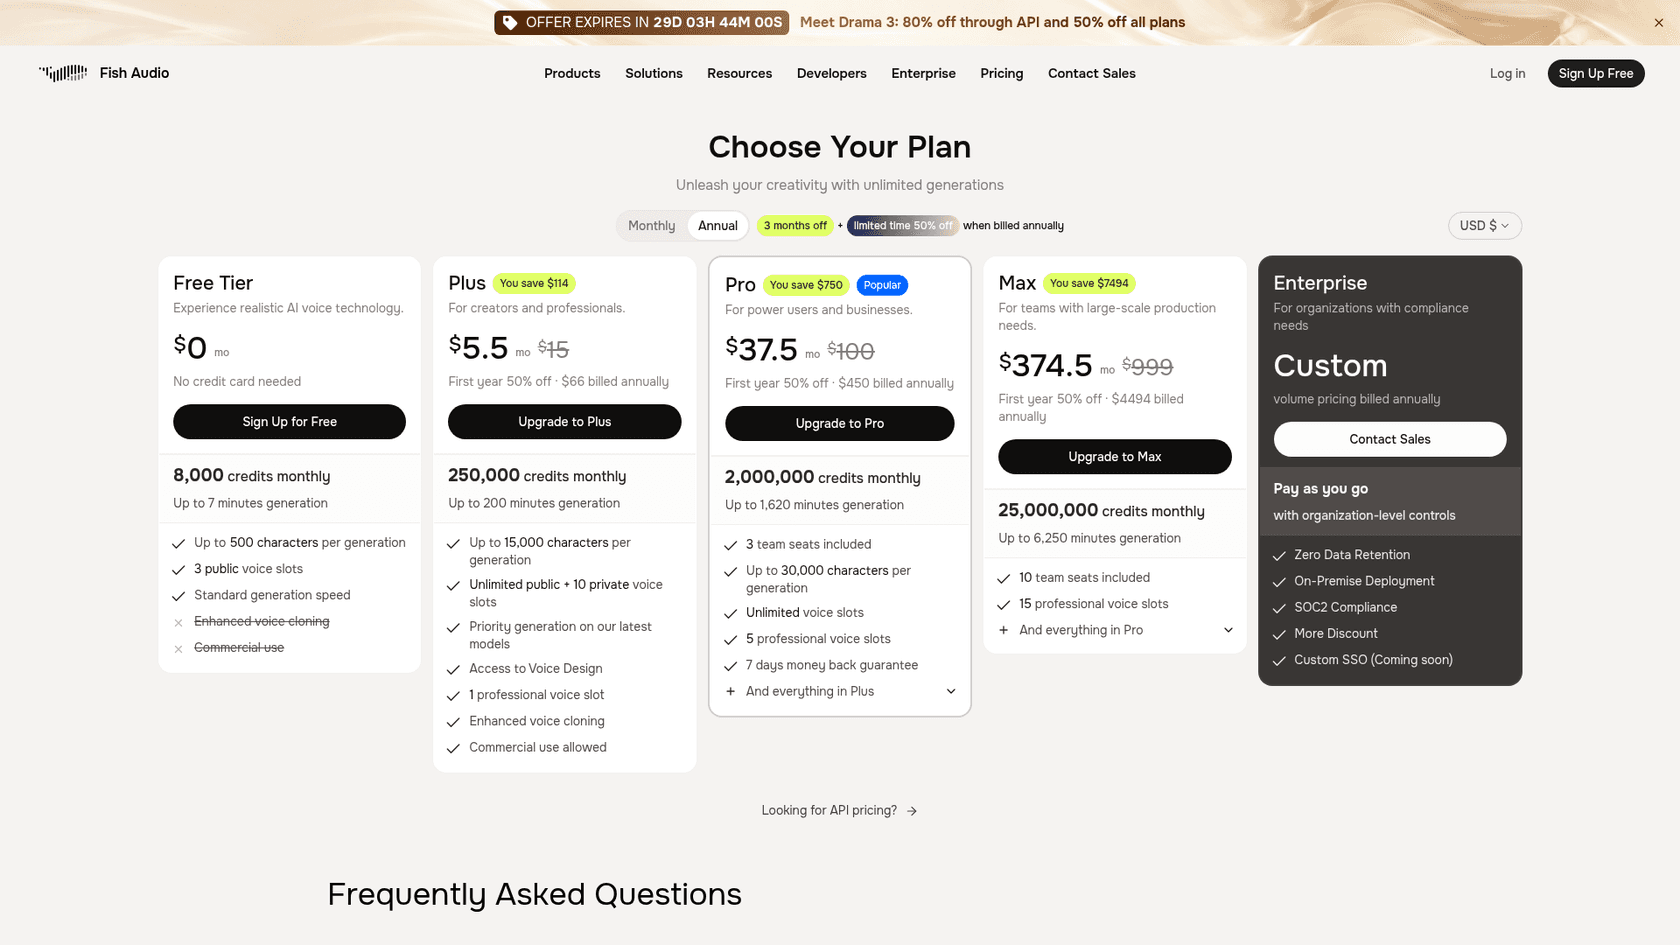
| Tarif | Monatlicher Listenpreis | Erstes Jahr, jährlich (Einführungsangebot) | Credits pro Monat | Audio pro Monat | Zeichen pro Generierung | Gut zu wissen |
|---|---|---|---|---|---|---|
| Free | 0 $ | 0 $ | 8.000 | Bis zu 7 Min. | 500 | Kein Stimmklonen, keine kommerzielle Nutzung |
| Plus | 15 $ | 66 $ | 250.000 | Bis zu 200 Min. | 15.000 | Kommerzielle Nutzung, Voice Design, 1 professioneller Stimm-Slot |
| Pro | 100 $ | 450 $ | 2.000.000 | Bis zu 1.620 Min. | 30.000 | 3 Team-Plätze, 5 professionelle Stimm-Slots |
| Max | 999 $ | 4.494 $ | 25.000.000 | Bis zu 6.250 Min. | 30.000 (wie Pro) | 10 Team-Plätze, 15 professionelle Stimm-Slots |
| Enterprise | Individuell | Individuell | Individuell | Individuell | Individuell | Zero Data Retention, On-Premise, SOC 2 |
Bis zum 12. November sind neue Plus-, Pro- und Max-Abos bei monatlicher Zahlung im ersten Monat oder bei jährlicher Zahlung im ersten Jahr 50 % günstiger. Nicht genutzte Credits werden nicht übertragen. Unternehmen, die von einem anderen Sprachanbieter wechseln, erhalten laut Pressemitteilung die ersten drei Monate kostenlos.
Wie Drama 3 im Vergleich abschneidet
So steht es gegenüber den Sprachmodellen, mit denen es am ehesten verglichen wird. Die Aussprachewerte stammen aus derselben Artificial-Analysis-Rangliste; für den Preis jedes Konkurrenten folge dem Link zu meiner Aufschlüsselung.
| Modell | Aussprache (AA) | Offene Gewichte | Test | Preise |
|---|---|---|---|---|
| Fish Audio Drama 3 | 93,2 % (#1) | Ja, Lizenz mit Umsatzgrenze | Du liest ihn gerade | 10 $ Einführung / 50 $ Liste pro 1 Mio. Zeichen |
| Eleven v4 | 91,7 % | Nein | ElevenLabs-Bewertungen | Eleven v4 Preise |
| Gemini 3.8 Flash TTS | 89,5 % | Nein | Gemini-TTS-Test | Gemini-TTS-Preise |
| Fish Audio S2.1 Pro | 88,1 % | S2-Familie, Forschungslizenz | Oben behandelt | 15 $ pro 1 Mio. Bytes, kostenlose Stufe |
Zwei Anmerkungen, die die Tabelle nicht fasst. Gemini 3.8 Flash TTS schlägt Drama 3 bei kontextabhängigen Wörtern (97,9 % vs. 95,3 %), teste also beide, wenn deine Skripte voller Wörter wie „read“ und „lead“ sind (AA-Thread). Und wenn ElevenLabs dein aktuelles Tool ist, ist meine Aufschlüsselung zu ElevenLabs-Preisen die faire Vergleichsbasis.
Geht es dir um einen Echtzeit-Sprachagenten statt um ein gerendertes Skript, ändert sich die Vergleichsgruppe komplett. Beginne mit meinem Cartesia-Sonic-3-Test, der um Latenz herum gebaut ist. Der Beitrag zu Grok Voice Think Fast 2 deckt die Speech-to-Speech-Seite ab.
Für emotionsgeführte Sprache im Besonderen ist Hume AI der andere Name, der einen Blick wert ist, und mein Beitrag zu Hume-AI-Preisen hat die Zahlen. Wenn du noch zwischen Sprach- und Transkriptionsmodellen schwankst, entwirrt Whisper vs. TTS API die beiden.
Wer Drama 3 nutzen sollte und wer es lassen kann
Fish Audio ist ungewöhnlich ehrlich über den eigenen Sweet Spot: „Drama 3 does its best work on scripted lines you render once and keep.“ Das würde ich so nehmen.
Nutze es, wenn du bist:
- Hörbuch- oder Hörspielproduzent. Regie im Skript, erstklassige Aussprache und Szenen mit mehreren Figuren in einem Durchgang sind genau dein Workflow.
- Ein Spiele- oder Animationsstudio. Regie pro Zeile und Tags auf Wortebene schlagen Neuaufnahmen, und die offenen Gewichte erlauben den Betrieb im Haus, solange du unter der Umsatzgrenze bleibst.
- Ein Kurzvideo-Creator. Auto Tag in der Web-App und der 50-%-Einführungsrabatt machen das Ausprobieren günstig. Für die Bilder passt ein Avatar-Tool wie HeyGen gut dazu. Mein Leitfaden zu KI-Content-Erstellung deckt den Rest des Stacks ab.
- Ein Entwickler, der eine selbst hostbare Stimme will. Es ist heute die stärkste offene Option bei Artificial Analysis, mit einem veröffentlichten Serving-Rezept.
Lass es sein oder warte, wenn du bist:
- Live-Sprache in hohem Volumen betreibst. Die Abweichung von Take zu Take und der 3,3-fache Listenpreis-Aufschlag gegenüber S2.1 Pro weisen dich stattdessen auf S2.1 Pro oder ein Echtzeitmodell. Meine Liste der besten KI-Sprachagenten behandelt sie.
- Ein Unternehmen über 500.000 US$ Umsatz, das selbst hosten will. Plane zuerst das Gespräch über die kommerzielle Lizenz ein.
- Jemand, der nur schlichte Erzählung braucht. S2.1 Pro liest schlichten Text gut und kostet weniger; du würdest für Schauspielerei zahlen, die du nicht nutzt.
Wenn du hier bist, weil du über Sprache für den Kundensupport nachdenkst, eine Warnung von der Support-Seite meiner Arbeit: Die Stimme ist selten das Schwierige. Eine ausdrucksstarke Stimme, die eine falsche Antwort vorliest, bleibt eine falsche Antwort, weshalb ich mich zu KI-Halluzinationen im Support einlesen und mir speziell gebaute KI-Sprachagenten für den Support wie Decagon Voice 3 ansehen würde, bevor ich zu einem Performance-Modell greife.
eesel für Teams, die Geschriebenes in Audio verwandeln
Drama 3 ist ein Sprachmodell. Es liest vor, was du ihm gibst, wunderschön, aber es entscheidet nicht, was sagenswert ist. Wenn du Blogbeiträge in vertontes Audio, Podcasts oder Videoskripte verwandelst, sitzt der Engpass meist einen Schritt früher: überhaupt ein recherchiertes, korrektes Skript zu bekommen.
Genau das ist die Aufgabe des KI-Blog-Writers von eesel. Er ist ein KI-Teammate, der ein Thema aus Primärquellen recherchiert, den langen Beitrag in deiner Markenstimme schreibt, die Bilder erzeugt und dir einen Entwurf übergibt, bereit zur Veröffentlichung oder zum direkten Einspeisen in Drama 3. Stell dir die Aufteilung so vor: Drama 3 ist der Darsteller, eesel der Autor, den du angestellt hast. Wie gut er sich schlägt, siehst du in meinem Test des KI-Blog-Writers, und wie er sich in Content-Repurposing einfügt.
Du willst ein Skript, das sich zu regieren lohnt? Schreibe deinen nächsten Beitrag mit eesel und sieh dir die Preise an, wenn du bereit bist. eesel testen.