

WikiSkill ist ein Framework von Google Research, das einem KI-Agenten ein dauerhaftes, wikiartiges Gedächtnis gibt, damit er nach jeder Aufgabe nicht mehr alles Gelernte verwirft. Es teilt den Arbeitsbereich des Agenten in drei Ebenen: ein Rohprotokoll dessen, was passiert ist, ein Wiki, das diese Durchläufe zu dokumentierten Fehlermustern und erfolgreichen Strategien verdichtet, und eine Reihe von Skill-Dateien, die der Agent tatsächlich liest. Das Wiki wächst nur, während einzelne Skills zurückgenommen werden, wenn sie einen Validierungswert nicht verbessern.
Die Ergebnisse sind echt. Auf fünf Benchmarks stieg Gemini-3.5-Flash von 49,5 % auf 68,1 % durchschnittliche Genauigkeit, und ein kleineres Modell mit WikiSkill schlug ein größeres Modell ganz ohne Skills. Skills lassen sich sogar zwischen Modellen übertragen.
Der ehrliche Haken: Das Modell wird dadurch nicht klüger. Wie ein Medium es ausdrückte, "schreibt der Agent bessere Anweisungen für sich selbst", statt wirklich zu lernen. Es ist ein Workaround, aber ein gut gemessener.
Wenn Sie ein Support-Team leiten, ist das Nützliche das Muster, nicht das Paper. Ein KI-Agent, der Ihren echten Ticketverlauf in wiederverwendbares Wissen verwandelt, ist genau das, was eesel AI schon heute für den Helpdesk tut, und Sie können es auf Ihren vergangenen Tickets simulieren, bevor es je einen Kunden beantwortet.
Was WikiSkill eigentlich ist
Die meisten KI-Agenten haben Amnesie. Man gibt ihnen eine Aufgabe, sie arbeiten sie ab, und alles, was sie unterwegs herausgefunden haben, der clevere Workaround, die Sackgasse, in der sie zehn Schritte verloren haben, verschwindet, sobald der Durchlauf endet. Die nächste Aufgabe beginnt bei null. Für einen einmaligen Einsatz ist das in Ordnung, aber es ist ein miserabler Weg, bei einer Aufgabe besser zu werden, die man tausendfach erledigt.
WikiSkill ist die Antwort von Google Research darauf. Das Framework wurde am 27. August 2026 von Liyan Tang, Cyrus Rashtchian und vier Kollegen auf arXiv veröffentlicht und entwickelt die Skills eines Agenten gemeinsam mit einer dauerhaften Wissensbasis, einem "Wiki", das sich über die Durchläufe hinweg ansammelt. Die zentrale Frage der Autoren ist unverblümt: Lässt sich die Erfahrung eines Agenten in dauerhaftes Wissen überführen, das die langfristige Skill-Entwicklung unterstützt?
Zuerst eine kurze Definition, denn "Skill" hat hier eine bestimmte Bedeutung. Ein Agent-Skill ist ein wiederverwendbares, dateibasiertes Modul, ein organisierter Ordner mit einer SKILL.md, die Anweisungen für das Vorgehen und die Bedingungen für ihre Anwendung enthält. Es erweitert, was ein Agent kann, ohne die Gewichte des Modells anzutasten. Frühere Forschung hat bereits versucht, solche Skills automatisch aus Agenten-Durchläufen zu entdecken. Der Beitrag von WikiSkill ist, was zwischen der Rohdaten-Erfahrung und diesen Skills sitzt: ein strukturiertes, wachsendes Wiki.
Die Idee hat eine bekannte Vorgeschichte. Das Paper verweist auf Andrej Karpathys "LLM Wiki"-Perspektive von 2026, das Argument, dass wir Modellerfahrung in dauerhaftes, sich verdichtendes Wissen überführen sollten, statt sie zerstreuen zu lassen. elvis (@omarsar0), Gründer von DAIR.AI, zog dieselbe Verbindung, als das Paper erschien:
"This WikiSkill paper from Google is a must-read. At a high level, it shows the effectiveness of persistent agents, knowledge bases, and skills. @karpathy popularized LLM Wikis. But this paper provides an actual framework for how agents can tap into a wiki of skills that evolve."
Die drei Ebenen: Raw, Wiki und Skill
Das gesamte Design läuft darauf hinaus, drei Dinge getrennt zu halten, die die meisten Systeme vermischen: was passiert ist, was man gelernt hat und was man als Nächstes tut. WikiSkill gibt jedem eine eigene Ebene.
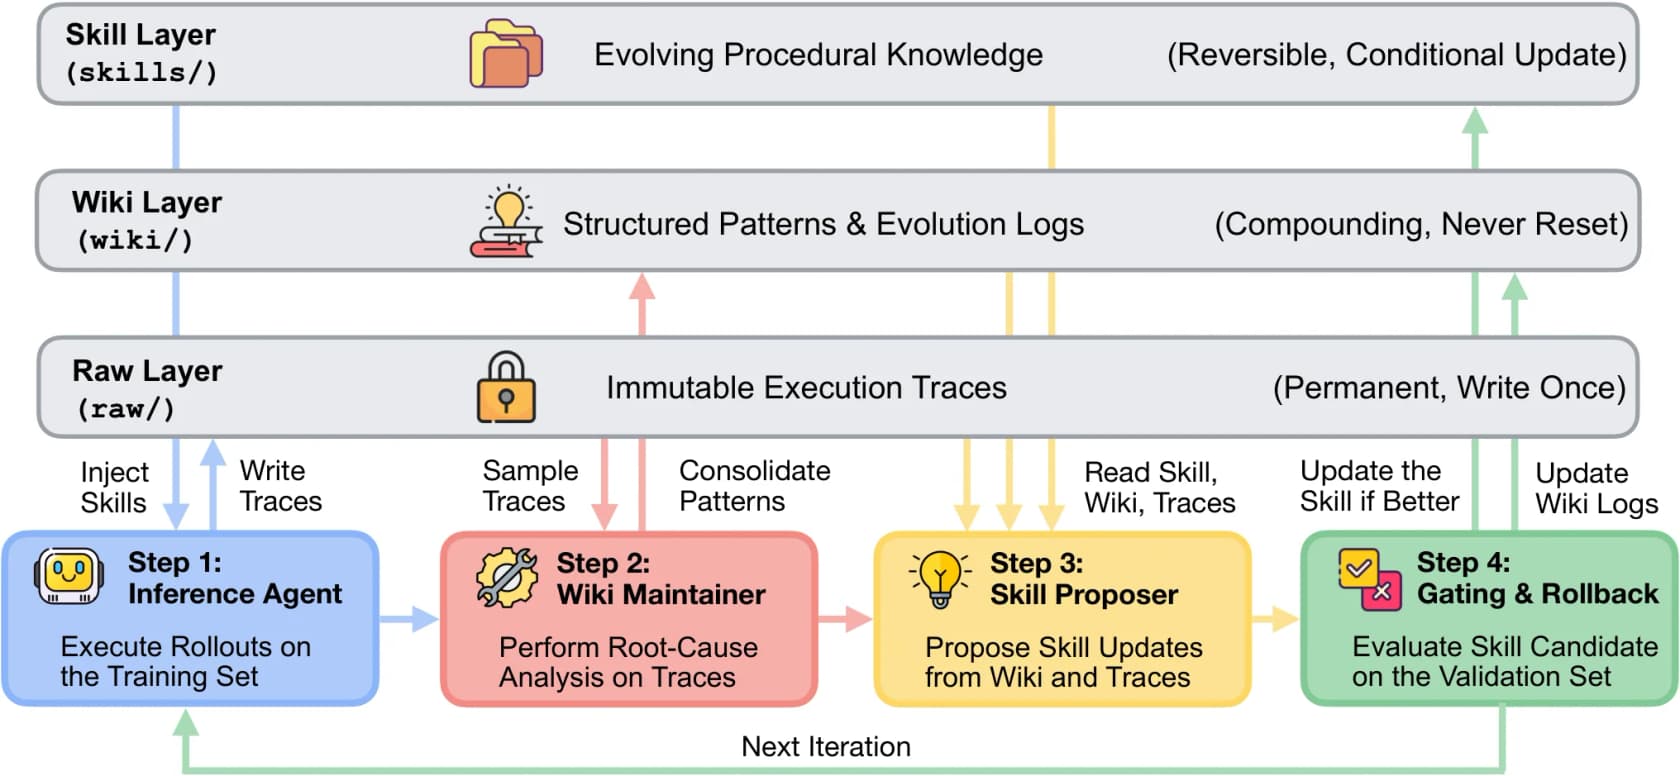
Die Raw-Ebene (raw/) ist das Tagebuch. Sie speichert vollständige Ausführungsprotokolle jedes Durchlaufs: die Überlegungen des Agenten, jeden Tool-Aufruf, jedes Ergebnis, die endgültige Antwort. Sie ist unveränderlich, nichts wird nachträglich umgeschrieben. Sie ist das Rohmaterial, aus dem alles andere entsteht.
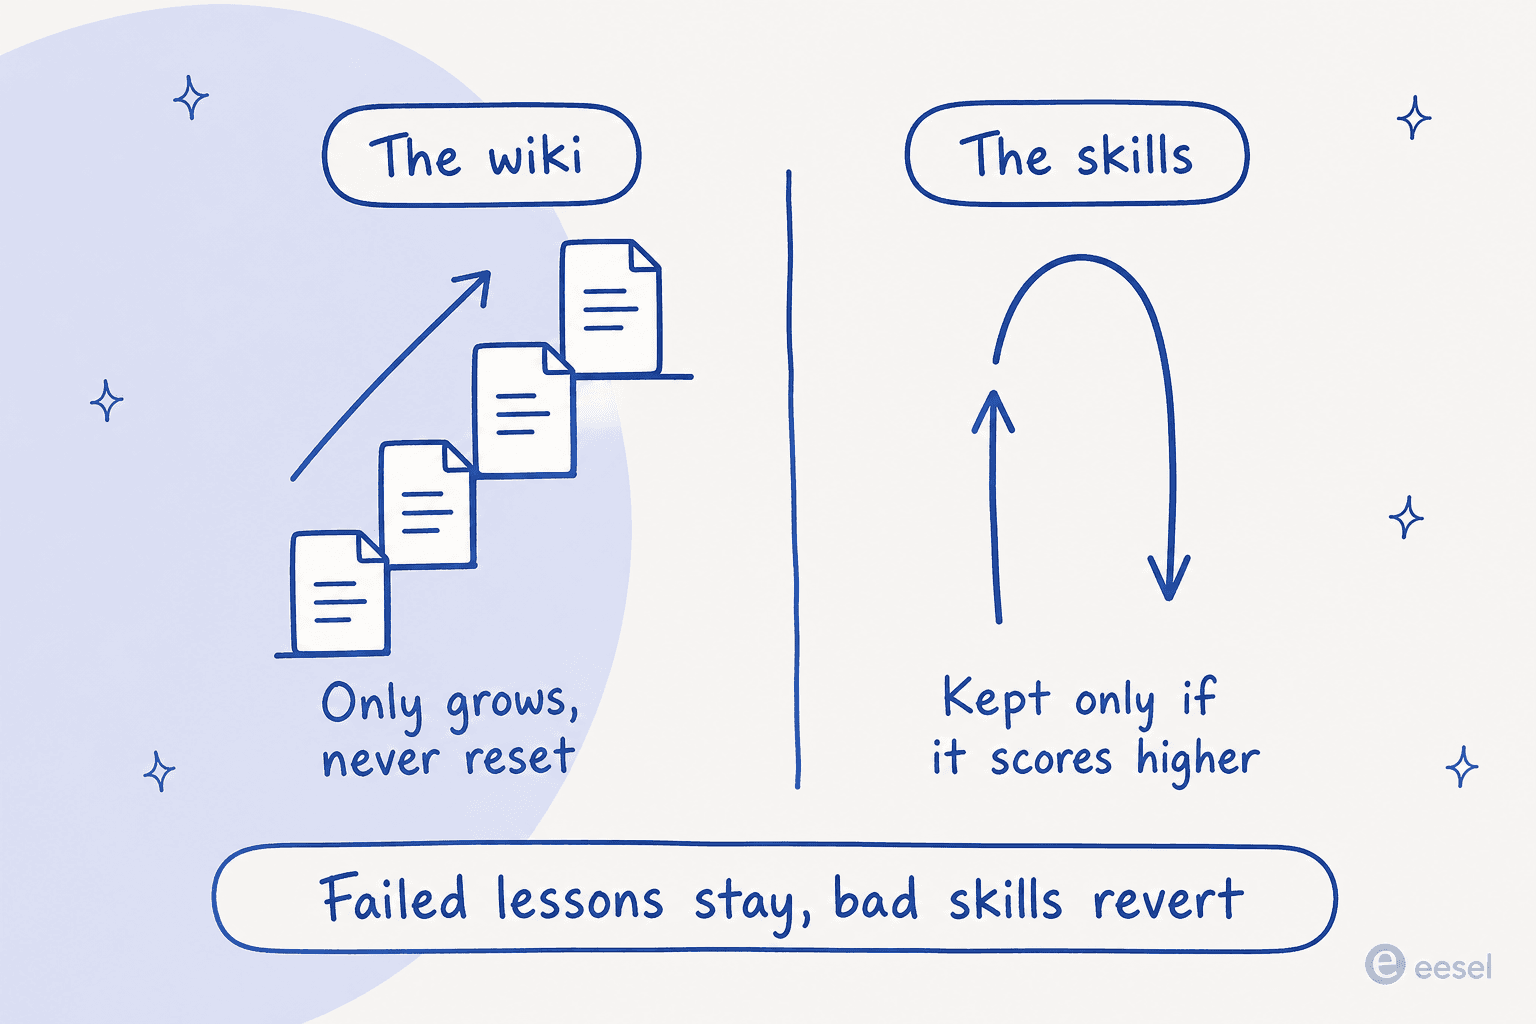
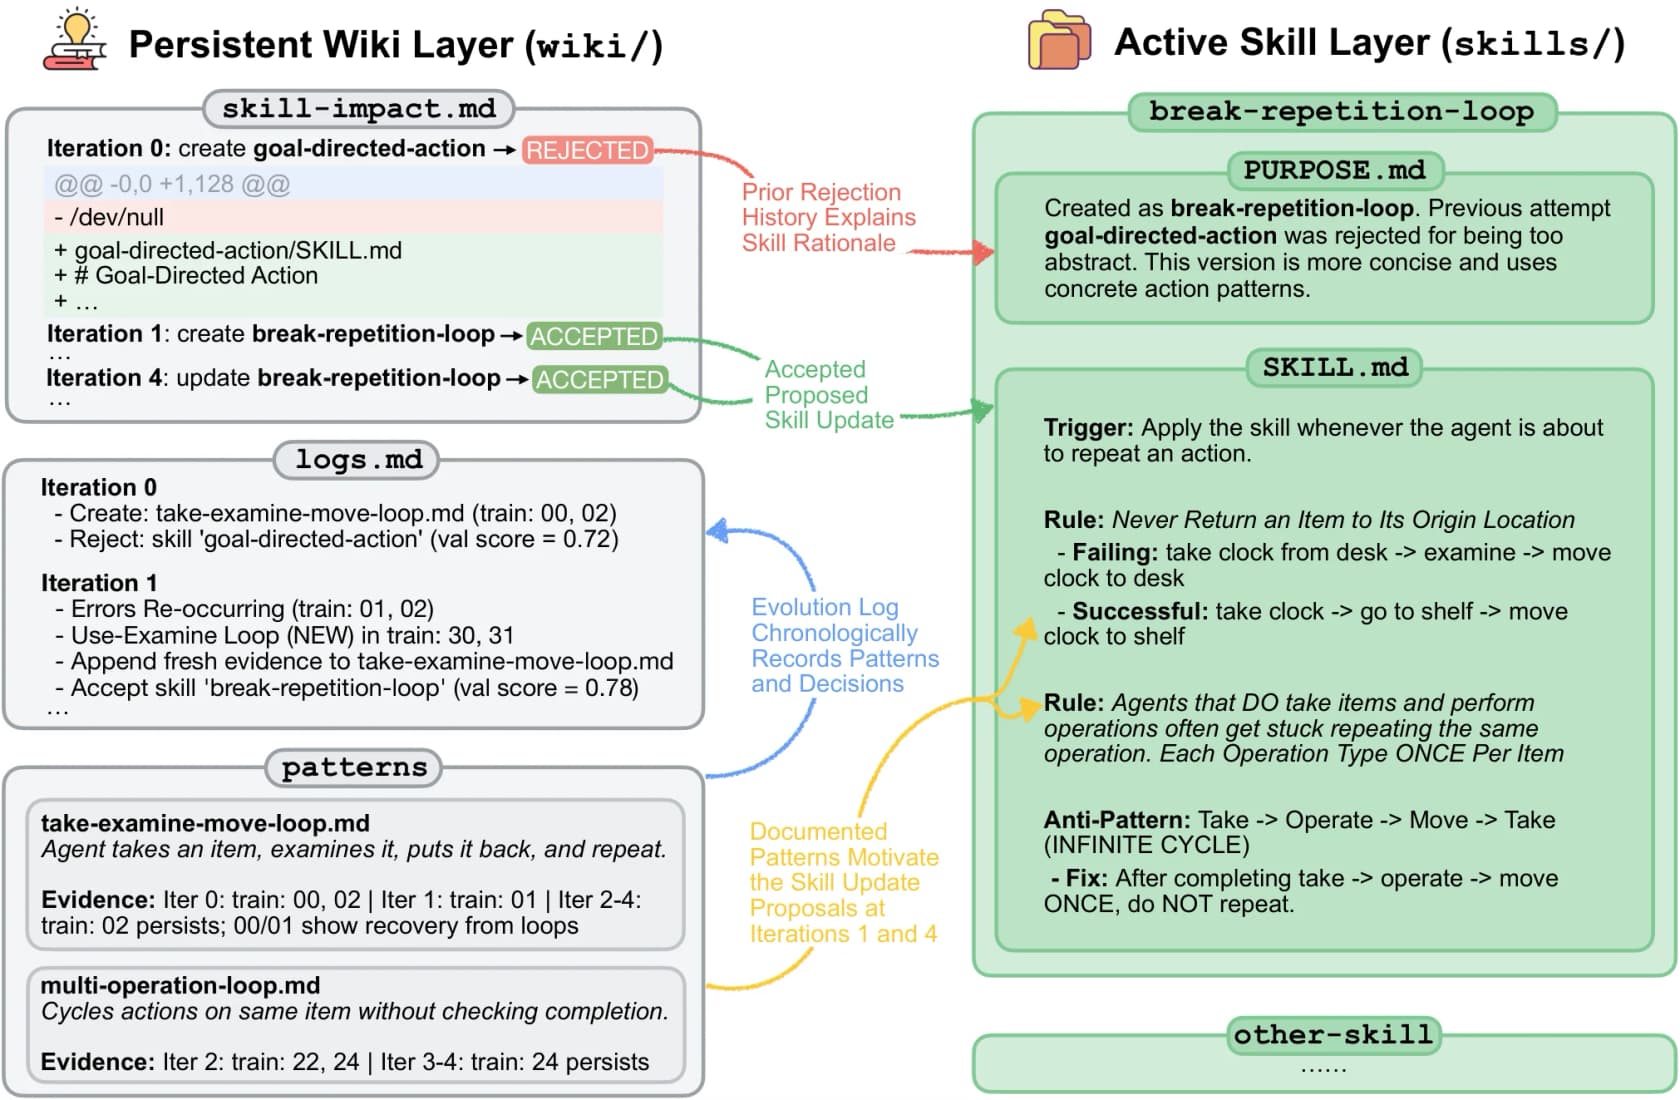
Die Wiki-Ebene (wiki/) ist der Ort, an dem aus Erfahrung Wissen wird, und sie ist das Herzstück des Frameworks. Sie enthält ein Verzeichnis von Musterseiten, die jeweils einen Fehlermodus oder eine erfolgreiche Strategie mit einem konkreten Workaround dokumentieren, dazu ein Entwicklungsprotokoll und einen Tracker für die Auswirkungen der Skills. Die tragende Regel: Das Wiki wird nie zurückgesetzt und nie zurückgerollt. Es sammelt sich nur an. Selbst wenn ein Skill-Experiment scheitert, bleibt die Lehre daraus festgehalten.
Die Skill-Ebene (skills/) ist der Teil, den der Agent bei der Arbeit tatsächlich liest. Jeder Skill-Ordner enthält eine SKILL.md mit den Anweisungen und eine PURPOSE.md, die den Skill auf die Wiki-Muster zurückführt, die ihn motiviert haben. Anders als das Wiki sind Skills hier umkehrbar. Eine Änderung, die die Leistung verschlechtert, wird zurückgenommen.
Diese Trennung, dauerhaftes Gedächtnis gegenüber umkehrbarem Handeln, ist der clevere Teil, und man übersieht ihn leicht. Hier ist dieselbe Idee als Bild.
Wie die Entwicklungsschleife funktioniert
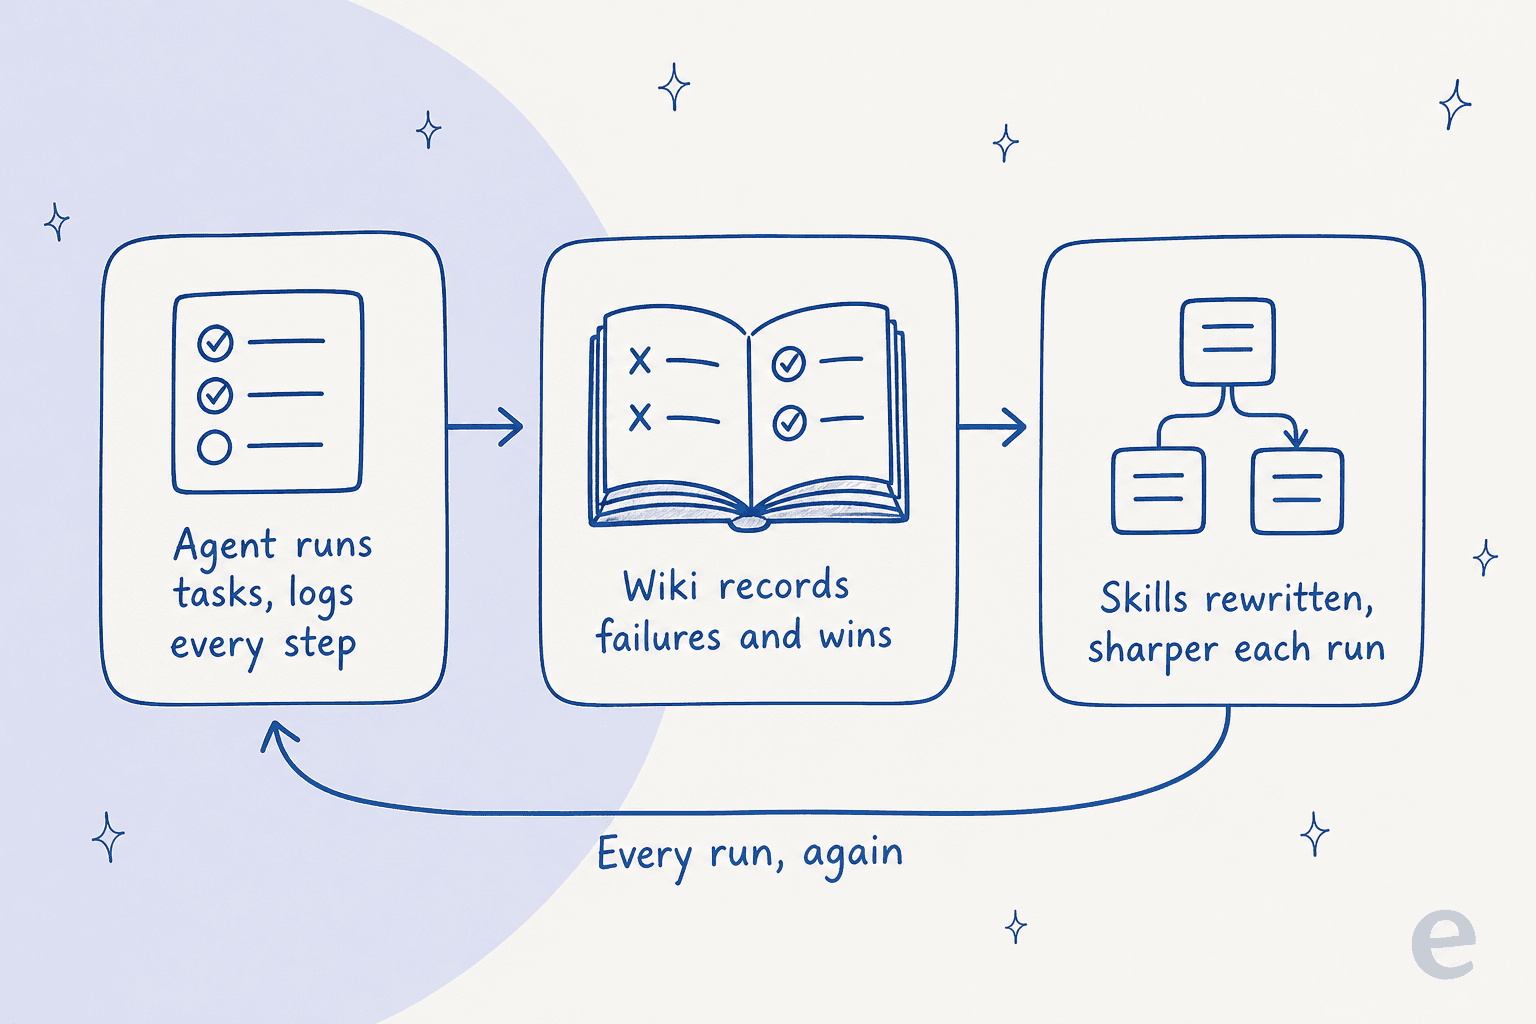
Jede Lernrunde durchläuft eine Schleife aus vier Schritten, und einer der Schritte ist wirklich kontraintuitiv.
- Inference Agent. Er führt die aktuellen Skills auf Trainingsaufgaben aus und erzeugt die Rohprotokolle. Bemerkenswert: Das Paper verwehrt diesem Agenten im Training bewusst den Zugriff auf das Wiki. Eine Ablation zeigte, dass ein Blick ins Wiki an dieser Stelle die endgültige Skill-Qualität sogar verschlechtert und den Durchschnitt von 63,7 % auf 60,9 % drückt. Die Hypothese: Wenn der Agent seine Antworten aus dem Wiki statt aus den Skills bezieht, taugen seine Protokolle nicht mehr als Beleg für die Verbesserung der Skills.
- Wiki Maintainer. Er liest eine Stichprobe erfolgreicher und fehlgeschlagener Protokolle, führt bei den Fehlschlägen eine Ursachenanalyse durch, zieht Strategien aus den Erfolgen und schreibt alles als Musterseiten ins Wiki.
- Skill Proposer. Ein mehrstufiger Agent, der mit dem Wiki-Index und dem laufenden Verlauf beginnt und dann bei Bedarf bestimmte Musterseiten liest. Er schlägt genau eine atomare Änderung vor, entweder einen neuen Skill oder eine Änderung an einem bestehenden.
- Gating und Rollback. Das vorgeschlagene Skill-Set wird auf einem separaten Validierungs-Split bewertet. Schlägt es den bisher besten Stand, wird es akzeptiert, andernfalls zurückgenommen. In beiden Fällen behält das Wiki die Aufzeichnung dessen, was versucht wurde.
Die Fallstudie des Google-Teams macht das konkret. Auf dem Benchmark ALFWorld wurde der erste Versuch des Proposers für einen "goal-directed-action"-Skill als zu abstrakt abgelehnt. Weil die Ablehnung samt Begründung im Wiki erhalten blieb, schrieb die nächste Iteration einen schärferen, akzeptierten Skill mit einer konkreten Regel ("Never return an item to its origin location") und verfeinerte ihn mehrere Iterationen später weiter, als neue Fehlervarianten auftauchten.
Eine Ablation im Paper belegt, warum das Wiki seinen Platz verdient: Der Zugriff des Skill Proposers auf das dauerhafte Wiki hob die durchschnittliche Benchmark-Leistung von 48,7 % auf 63,7 %, ein Sprung von 15 Punkten. Das Gedächtnis ist keine Dekoration, sondern der Ort, aus dem der größte Teil des Gewinns kommt.
Funktioniert es wirklich? Die Zahlen
Ja, und zwar durchgängig, und genau das unterscheidet es von der üblichen Einschränkung bei Forschungsdemos. Das Team testete fünf Modelle auf fünf Benchmarks (Mathematik, Websuche, Tabellenkalkulation, Dokumenten-QA mit langem Kontext und interaktive Aufgaben), jeweils gemittelt über drei vollständige Durchläufe.
| Modell | Durchschnitt, ohne Skills | Durchschnitt, mit WikiSkill |
|---|---|---|
| Qwen-3.5-4B | 26,2 % | 38,5 % |
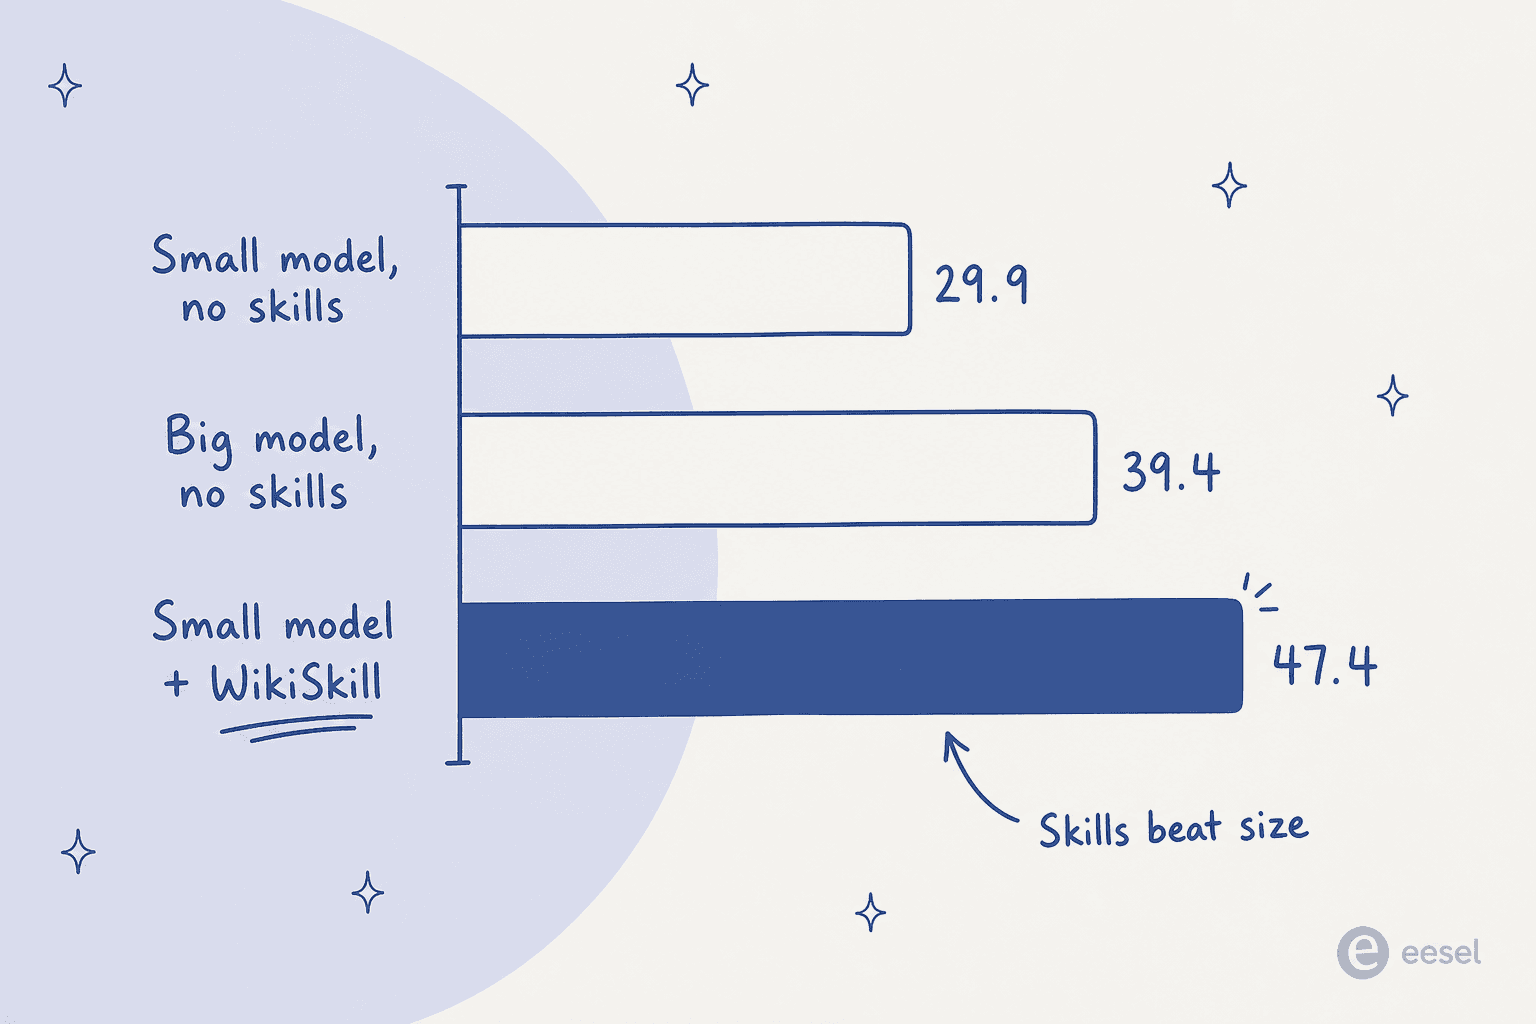
| Qwen-3.5-9B | 29,9 % | 47,4 % |
| Qwen-3.6-27B | 39,4 % | 63,3 % |
| Gemma-4-31B | 41,3 % | 54,9 % |
| Gemini-3.5-Flash | 49,5 % | 68,1 % |
Quelle: Tang et al., 2026. Einige Sprünge bei einzelnen Benchmarks waren noch größer: Gemini-3.5-Flash stieg auf dem Mathematik-Benchmark von 33,0 % auf 72,6 %, und Qwen-3.6-27B kletterte bei Tabellenkalkulationen von 40,8 % auf 81,7 %.
WikiSkill schlug im Durchschnitt auch jede konkurrierende Methode zur Skill-Entwicklung (Trace2Skill, EvoSkill und SkillOpt) bei allen fünf Modellen, und anders als diese Methoden verschlechterte es selten einen einzelnen Benchmark. Diese Verlässlichkeit ist die leise Schlagzeile. Eine Methode, die im Schnitt hilft, aber bei jeder dritten Aufgabe abstürzt, ist im Produktivbetrieb schwer vertrauenswürdig, und aus demselben Grund legen Support-Teams so viel Wert darauf, dass KI-Ticket-Lösungsquoten bei jeder Art von Anfrage stabil bleiben, nicht nur bei den einfachen.
Der Befund, auf den ich immer wieder zurückkomme: Skills können Größe ersetzen. Qwen-3.5-9B mit WikiSkill (47,4 %) schlug das deutlich größere Qwen-3.6-27B ohne Skills (39,4 %). Prozesswissen und reine Modellgröße ergänzen sich, sie sind nicht austauschbar.
Skills, die zwischen Modellen wandern
Dieses Ergebnis erhielt die meiste Aufmerksamkeit. Skills, die ein Modell entwickelt hat, lassen sich auf andere Modelle und Modellfamilien übertragen, und übertragene Skills schlagen häufig sowohl "keine Skills" als auch die selbst entwickelten Skills eines Modells. Auf ALFWorld erreichte Qwen-3.5-9B 70,2 % mit einem Skill, den Qwen-3.6-27B entwickelt hatte, gegenüber 63,4 % mit dem eigenen Skill. Auch klein zu groß funktioniert: Skills des winzigen Qwen-3.5-4B hoben das deutlich größere Gemma-4-31B bei den Mathematik- und interaktiven Benchmarks an.
Mark Kretschmann (@mark_k) nannte das den interessantesten Teil:
"'WikiSkill' lets agents turn their own experience into persistent knowledge that compounds over time... Even more interesting: skills transfer between models. In some cases, a model performed better using skills learned by another model than skills it developed itself."
Die Autoren deuten das so, dass das Entdecken eines guten Skills und seine Ausführung zwei verschiedene Fähigkeiten sind, die Selbstentwicklung normalerweise vermischt. Das ist eine nützliche Neubetrachtung, wenn Sie ein LLM für die Support-Arbeit auswählen: Das beste Modell darin, ein Playbook auszuführen, ist nicht automatisch das beste darin, eines zu schreiben.
Die Übertragung ist allerdings nicht gratis. Skills, die modellspezifische Workarounds festschreiben, können nach hinten losgehen. Die Tabellenkalkulations-Skills des winzigen Qwen-3.5-4B, voller Python-Hacks auf niedriger Ebene, senkten Gemini-3.5-Flash tatsächlich von 50,5 % auf 18,1 %, weil sie ein stärkeres Modell daran hinderten, saubereren Ende-zu-Ende-Code zu schreiben. "Skills lassen sich übertragen" ist also eine echte Eigenschaft, aber eine, die man von Fall zu Fall testen sollte, statt sie vorauszusetzen.
Der ehrliche Haken: Es ist ein Workaround, kein echtes Lernen
Das ist der Teil, den die meisten Berichte abschwächen, und es lohnt sich, hier klar zu sehen. WikiSkill bringt das zugrunde liegende Modell nicht zum Lernen. Die Gewichte ändern sich nie. THE DECODER sagte es deutlich: Der Agent "doesn't truly learn in a continuous sense, which remains an unsolved problem." Stattdessen "it writes better instructions for itself after each run and can pull them up the next time around." Ihr Urteil über den Ansatz lautete, er sei "not elegant, and it's probably more error-prone than real learning, but the study shows it's an effective workaround."
Diese Einordnung sollte man in jede Kaufentscheidung mitnehmen. Ein solches System ist nur so gut wie das Wissen, das es aufschreibt, und das Gate, das es filtert. Auch das Paper ist offen über die Grenzen:
- Kein Wiki-Pruning. Das Wiki wächst nur, daher braucht es bei sehr langen Läufen eine Möglichkeit, veraltete Muster zu vergessen, die es noch nicht gibt.
- Striktes Gating. Ein vorgeschlagener Skill muss den Validierungswert verbessern, um behalten zu werden, was neutrale Änderungen verwirft, die sich später vielleicht ausgezahlt hätten.
- Kein Skill-Retrieval getestet. Um die Skill-Qualität zu isolieren, wurden in der Studie alle Skills direkt in den Prompt eingefügt, statt die relevanten abzurufen, was ab einer größeren Zahl von Skills wichtig wird.
- Kein offizieller Code. Stand September 2026 hat Google keinen WikiSkill-Code veröffentlicht. Ein unabhängiger Entwickler hat ihn anhand des Papers nachgebaut und merkte an, dass das Validierungs-Gate in seinem Lauf zwei schädliche Skills abfing, was bestätigt, dass die Sicherheitsprüfung wirklich etwas leistet.
Nichts davon macht WikiSkill weniger interessant. Es macht es ehrlich, und eine ehrliche Beschreibung dessen, was ein KI-System tut und was nicht, suche ich, bevor ich ihm echte Arbeit anvertraue. Dieselbe Messlatte lege ich an, wenn ich KI gegen menschliche Agenten abwäge.
Was das für KI-Support-Agenten bedeutet
Streicht man die Benchmarks weg, beschreibt WikiSkill ein Muster, das Support- und CX-Teams sofort erkennen sollten: ein Agent, der bei einer wiederkehrenden Aufgabe messbar besser wird, indem er seine eigene Erfahrung in wiederverwendbares, überprüfbares Wissen überführt. Es ist ein Muster, auf das sich Unternehmen, die bereits KI nutzen, im Support stützen, keine Laborkuriosität. Es ist der ganze Sinn.
elvis zog denselben Sprung von der Forschung in die Praxis:
"The practical takeaway here is that we should all be thinking about how to build persistent knowledge bases across our companies and projects. And how to use that to upgrade and evolve our skills."
Eine Support-Warteschlange ist das ideale Zuhause für dieses Muster. Ihre vergangenen Tickets sind die Raw-Ebene. Ihre Makros, das Help Center und gelöste Threads sind das Wiki. Und die Idee "prüfen, bevor man eine Änderung akzeptiert" ist das Eine, das die meisten KI-Support-Rollouts auslassen und später bereuen, weil sie einen Bot live schalten und hoffen. Hier treffen Forschung und Realität der Kundensupport-Automatisierung aufeinander: Die Teams, die gewinnen, messen, bevor sie vertrauen, genau wie das Gate von WikiSkill einen Skill prüft, bevor es ihn behält. Es ist auch der Grund, warum der ehrliche Kostenvergleich von KI- und menschlichen Agenten immer wieder bei "erst die Lösungsquote messen" landet.
Probieren Sie eesel für Support, der aus Ihren Tickets lernt
WikiSkill kommt mir deshalb vertraut vor, weil der KI-Helpdesk-Teamkollege von eesel bereits nach diesem Prinzip arbeitet. Er ist kein generischer Chatbot, der auf Ihre Website geschraubt wird; er trainiert mit Ihrem vorhandenen Wissen, vergangenen Tickets, dem Help Center und den Dokumenten und reiht sich in die Warteschlange des Helpdesks ein, den Sie bereits betreiben, sei es Zendesk, Freshdesk, Gorgias oder Help Scout, über mehr als 1000 Integrationen.
Das Unterscheidungsmerkmal, das sich am direktesten auf das Gate von WikiSkill abbilden lässt, ist die Simulation. Bevor ein eesel-Teamkollege einen einzigen Live-Kunden beantwortet, können Sie ihn gegen Ihre historischen Tickets laufen lassen und sehen, wie er sie behandelt hätte, sodass die Lösungsquote eine Zahl ist, die Sie prüfen, kein Versprechen, das Sie auf Treu und Glauben annehmen. Es ist die Disziplin "validieren, bevor man akzeptiert", angewandt auf Ihre eigene Support-Historie. Sie können eesel kostenlos testen, ganz ohne Verkaufsgespräch, und ein Kunde, Global Pay, meldete bis zu 80 % Zeitersparnis nach dem Livegang.