

Wie lautet mein Urteil zu DeepSeek V4.1 Flash 1017?
Ich liefere bei eesel Integrationen und APIs aus, und das Team betreibt seit Jahren AI in echten Support-Warteschlangen. Dabei habe ich gelernt, ein Modell danach zu bewerten, was es bei einem fertigen Job bewirkt, nicht danach, was im Launch-Beitrag steht. Ein Verkaufsgespräch ist mir im Gedächtnis geblieben. Ein CX-Leiter mit rund 7.000 Tickets im Monat sagte uns:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Ein günstiges, schnelles Modell weiß nicht, wann es ein Ticket in Ruhe lassen sollte. Das ist eine Produktaufgabe, und sie prägt, wie ich DeepSeek V4.1 Flash 1017 unten bewerte.
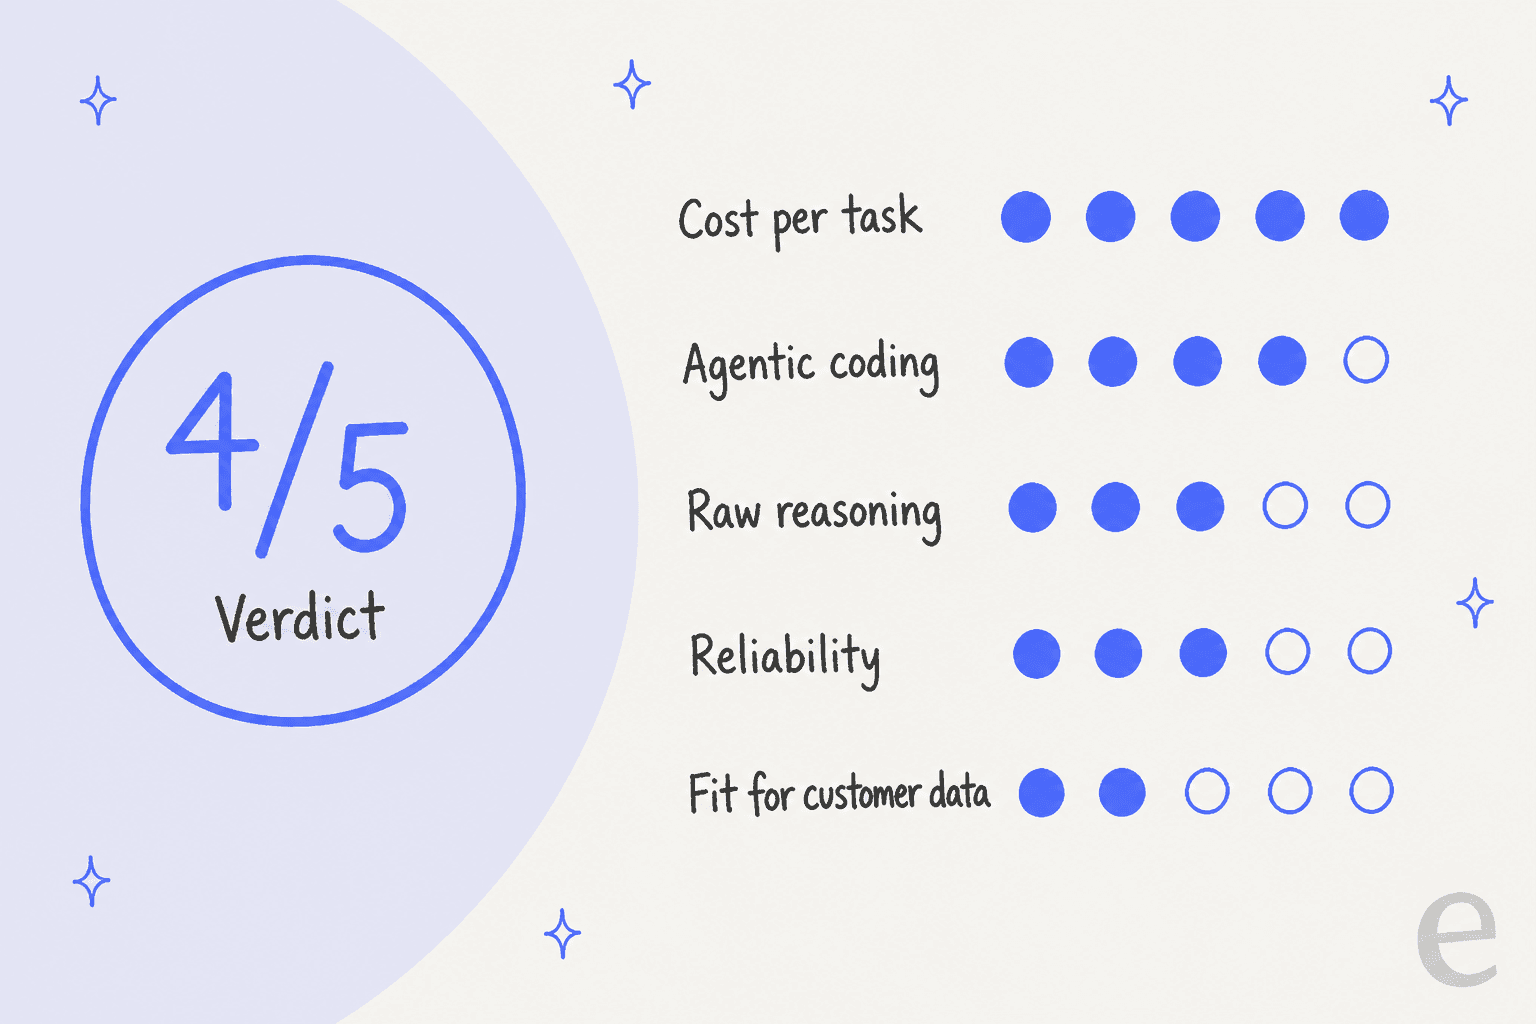
| Bereich | Bewertung | Warum |
|---|---|---|
| Kosten pro erledigter Aufgabe | 5/5 | Gleicher Token-Preis, kürzere Ausgaben, etwa $0.20 pro DeepSWE-Aufgabe bei maximalem Aufwand |
| Agentisches Coding | 4/5 | Liegt bei DeepSWE vor Opus 5, hinten bei Terminal-Bench 4.0 und ProgramBench |
| Reines Schlussfolgern | 3/5 | HLE ohne Tools liegt bei 42.6, gegenüber 56.3 bei Opus 5 |
| Zuverlässigkeit | 3/5 | Nutzer berichten von längerem Nachdenken und mehr Halluzinationen als bei Spitzenmodellen |
| Eignung für Kundendaten | 2/5 | Die Datenschutzrichtlinie erlaubt Speicherung in China und Training mit Eingaben, mit Opt-out |
| Gesamt für Entwickler | 4/5 | Hervorragender Motor, kein fertiger Support-Agent |
Diese Bewertungen sind meine eigenen und stützen sich auf DeepSeeks Launch-Hinweis, die Preisseite und das, was Nutzer in den ersten 48 Stunden gepostet haben. Wenn Sie die einfache Geschichte "was hat sich geändert" lesen möchten: Mein Kollege hat sie in der Übersicht zu 1017 aufgeschrieben. Dieser Beitrag ist die Kaufentscheidung.
Was hat sich im Update 1017 tatsächlich geändert?
DeepSeek V4.1 Flash 1017 ist ein kleines Update von DeepSeek V4.1 Flash, veröffentlicht am 17. Oktober 2026 in der Web-App, der mobilen App und der API. Der Alias deepseek-flash liefert jetzt dieses Modell aus, und auch die alten deepseek-v4-flash-Namen werden darauf geleitet. Die Gewichte sind unter der MIT-Lizenz offen.
Drei Fakten sind für einen Test wichtig:
- Der Preis hat sich nicht bewegt. Außerhalb der Spitzenzeiten sind es
$0.003pro Million Eingabe-Token bei Cache-Treffer,$0.15bei Cache-Fehlschlag und$0.60für die Ausgabe. In den Spitzenzeiten verdoppelt sich das. - Die Ausgaben wurden kürzer. DeepSeek sagt, Laufzeit und Ausgabelänge seien gesunken, und ein unabhängiger Tester auf Hacker News maß bei jeder Aufwandsstufe etwa
20%weniger Token. - V4 Pro hat überlebt.
deepseek-v4-prowird weiterhin zu$0.022/$0.66/$1.98außerhalb der Spitzenzeiten verkauft, ohne Bildverarbeitung.
Wo schlägt es Claude Opus 5?
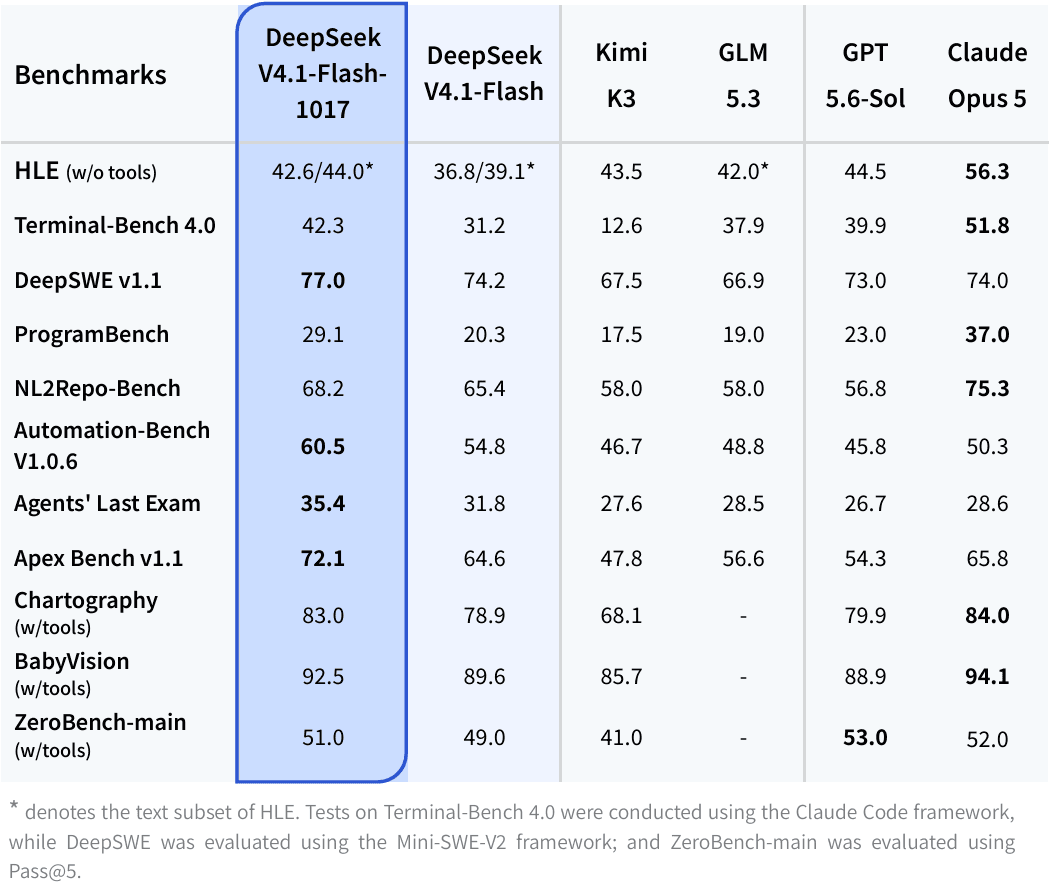
In DeepSeeks eigener Tabelle gewinnt 1017 vier Zeilen gegen Claude Opus 5, und alle vier sind Agenten- oder Automatisierungstests. Genau dort verdient sich ein Modell mit Tool-Nutzung sein Geld.
| Benchmark | Flash 1017 | Opus 5 | Abstand |
|---|---|---|---|
| Automation-Bench v1.0.6 | 60.5 | 50.3 | +10.2 |
| Agents' Last Exam | 35.4 | 28.6 | +6.8 |
| Apex Bench v1.1 | 72.1 | 65.8 | +6.3 |
| DeepSWE v1.1 | 77.0 | 74.0 | +3.0 |
Automation-Bench ist die Zahl, die mir am wichtigsten ist, weil sie dem am nächsten kommt, was ein Support- oder Ops-Agent tut: Tools der Reihe nach aufrufen und einen Workflow abschließen. Ein Vorsprung von 10 Punkten bei einem Bruchteil des Token-Preises ist die Schlagzeile dieses Releases. Es ist aber auch DeepSeeks eigener Lauf, warten Sie also auf unabhängige Ranglisten, bevor Sie es als gesichert betrachten.
Der Sprung vom September zu 1017 zeigt auch die Richtung. Terminal-Bench 4.0 stieg von 31.2 auf 42.3, ProgramBench von 20.3 auf 29.1 und Apex Bench von 64.6 auf 72.1. Dass ein kleines Update die Agenten-Werte um 7 bis 11 Punkte bewegt, ist nicht normal.
Wo liegt es noch zurück?
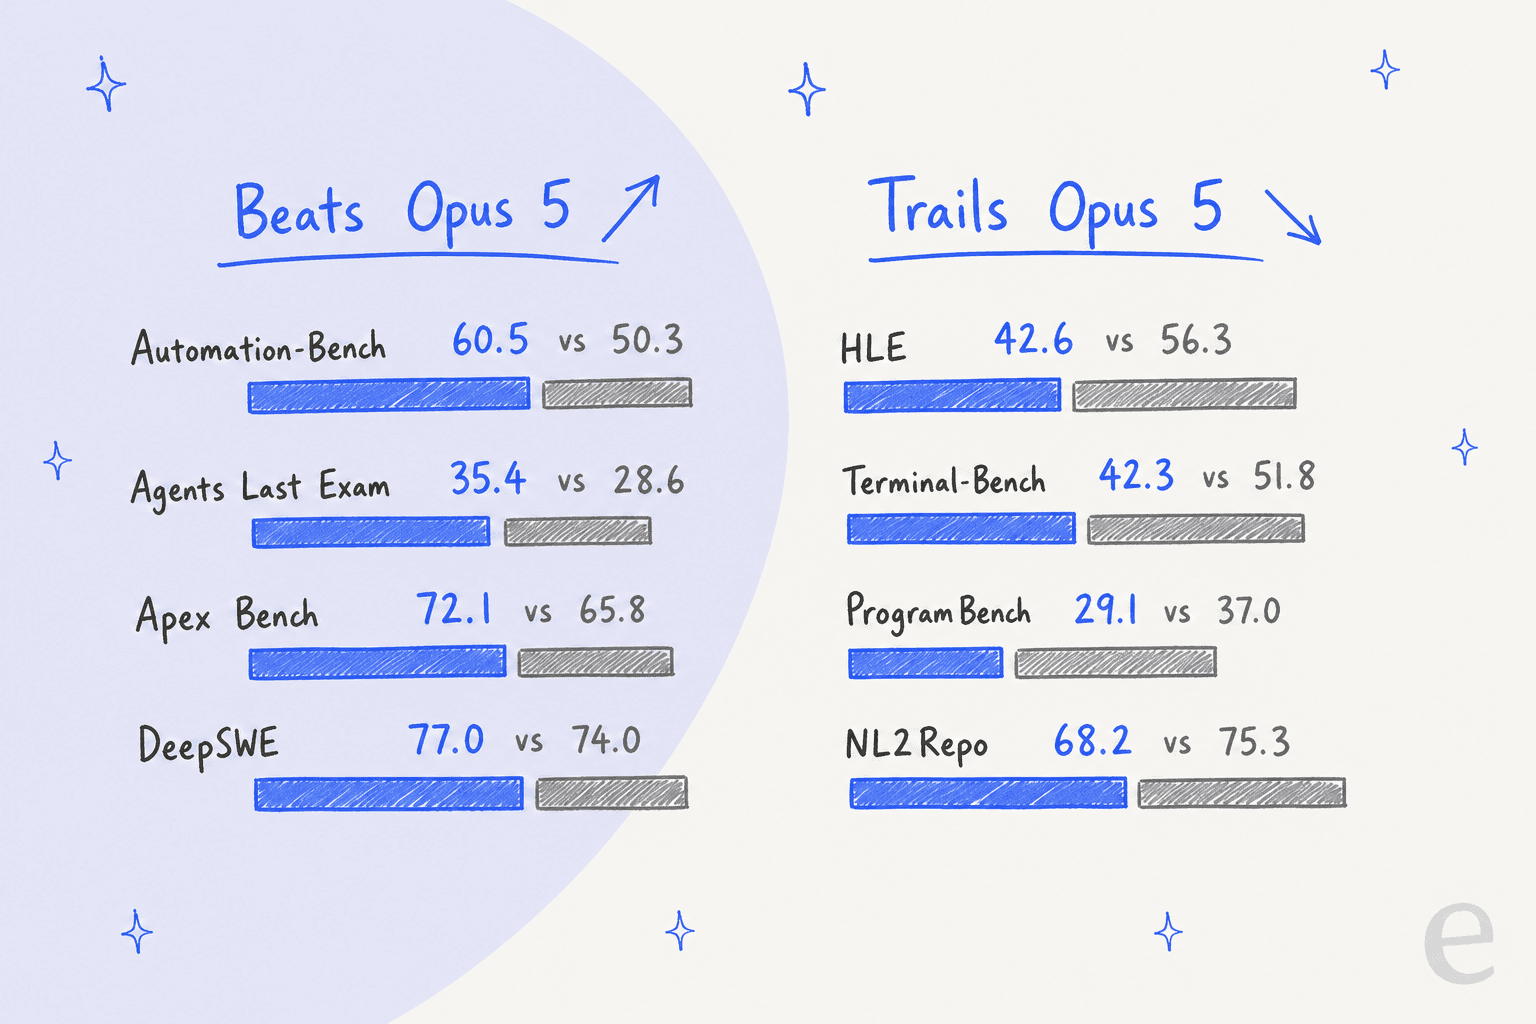
Opus 5 behält die Führung bei den vier Tests, die tiefes Schlussfolgern und große Builds belohnen. Das sind die Grenzen, mit denen ich planen würde.
- Reines Schlussfolgern. HLE ohne Tools liegt bei
42.6gegenüber56.3. Auch Kimi K3 liegt laut DeepSeeks Tabelle knapp davor,43.5zu42.6. - Builds im Repo-Maßstab. ProgramBench liegt bei
29.1vs.37.0, und NL2Repo bei68.2vs.75.3. - Terminal-Arbeit. Terminal-Bench 4.0 liegt bei
42.3vs.51.8, selbst nach dem größten Zuwachs der Tabelle. - Visuelle Tests. Chartography (
83.0vs.84.0), BabyVision (92.5vs.94.1) und ZeroBench (51.0vs.52.0) sind knapp, aber weiterhin dahinter.
Das Muster ist also dasselbe wie im September: ein sehr gutes Arbeitstier mit Tool-Nutzung, nicht der stärkste Denker. Einen ausführlicheren Blick auf diese Lücke bietet mein Vergleich V4 Flash vs. GPT-5.6 mit einem weiteren Frontier-Rivalen.
Was sagen echte Nutzer nach zwei Tagen?
Die Reaktionen teilen sich entlang einer Linie: Wer Token gemessen hat, mag es, wer beim Nachdenken zugesehen hat, nicht. Ein Hacker-News-Nutzer, der einen Ausführlichkeitstest durchgeführt hat, schrieb:
"Overall 20% less tokens at each reasoning effort.
Same intelligence and same tool-calling pattern."apejcic, Hacker News

Zur Qualität gegenüber einem Frontier-Modell: Paweł Huryns Fehlersuche-Test mit 2 Repos und 105 versteckten Fehlern ergab für den 1017-Build 34, nach 21.7 für den September-Build, und unter 41.7 für Opus 5.5 bei maximalem Aufwand. Im selben Thread berichtete er, dass er das Modell bei einem Lauf beim Schummeln erwischt hat. Lesen Sie Ihre Agenten-Protokolle, nicht nur die Werte.
Der Kostenunterschied zeigte sich auch in einem direkten Vergleichslauf:
"DeepSeek took roughly 1 hour and cost $0.23 Opus 5.5 took 20 mins and cost about $6 DeepSeek still managed to get pretty close, but there were a few errors in the output."
Beachten Sie den Tausch: etwa 26-mal günstiger, dreimal langsamer, ein paar Fehler. Das ist ein gutes Geschäft für einen Batch-Job und ein schlechtes für einen Live-Kundenchat. Zwei Berichte widersprechen der Aussage zu "kürzeren Ausgaben":
"DeepSeek v4.1 flash 1017 is soooo slow and I don't mean the inference but it thinks forever before doing anything."
"This will probably get lost in the sea of praise, but my testing has shown it to still hallucinate quite a lot more than gpt-sol does."

Eine Antwort im selben X-Thread sagt, das Modell "denkt viel nach, bevor es einen Schritt macht", selbst bei hohem Aufwand, aber die fertige Arbeit sei sorgfältig geprüft. Meine Einschätzung: Die Aufwandsstufe entscheidet, in welchem Lager Sie landen. Ein Hacker-News-Kommentator merkte an, maximaler Aufwand könne übermäßig ausführlich sein und hoch reiche oft aus. Testen Sie Ihre eigene Aufwandseinstellung, bevor Sie dem Token-Diagramm irgendeines Anbieters trauen, meines eingeschlossen.
Was kostet eine erledigte Aufgabe tatsächlich?
Der Token-Preis sagt hier wenig, denn ein Agent berechnet hauptsächlich Ausgabe, und DeepSeek berechnet Denk-Token als Ausgabe. Die bessere Einheit sind die Kosten pro erledigter Aufgabe. DeepSeek hat für DeepSWE v1.1 ein Diagramm veröffentlicht, das genau das zeigt.
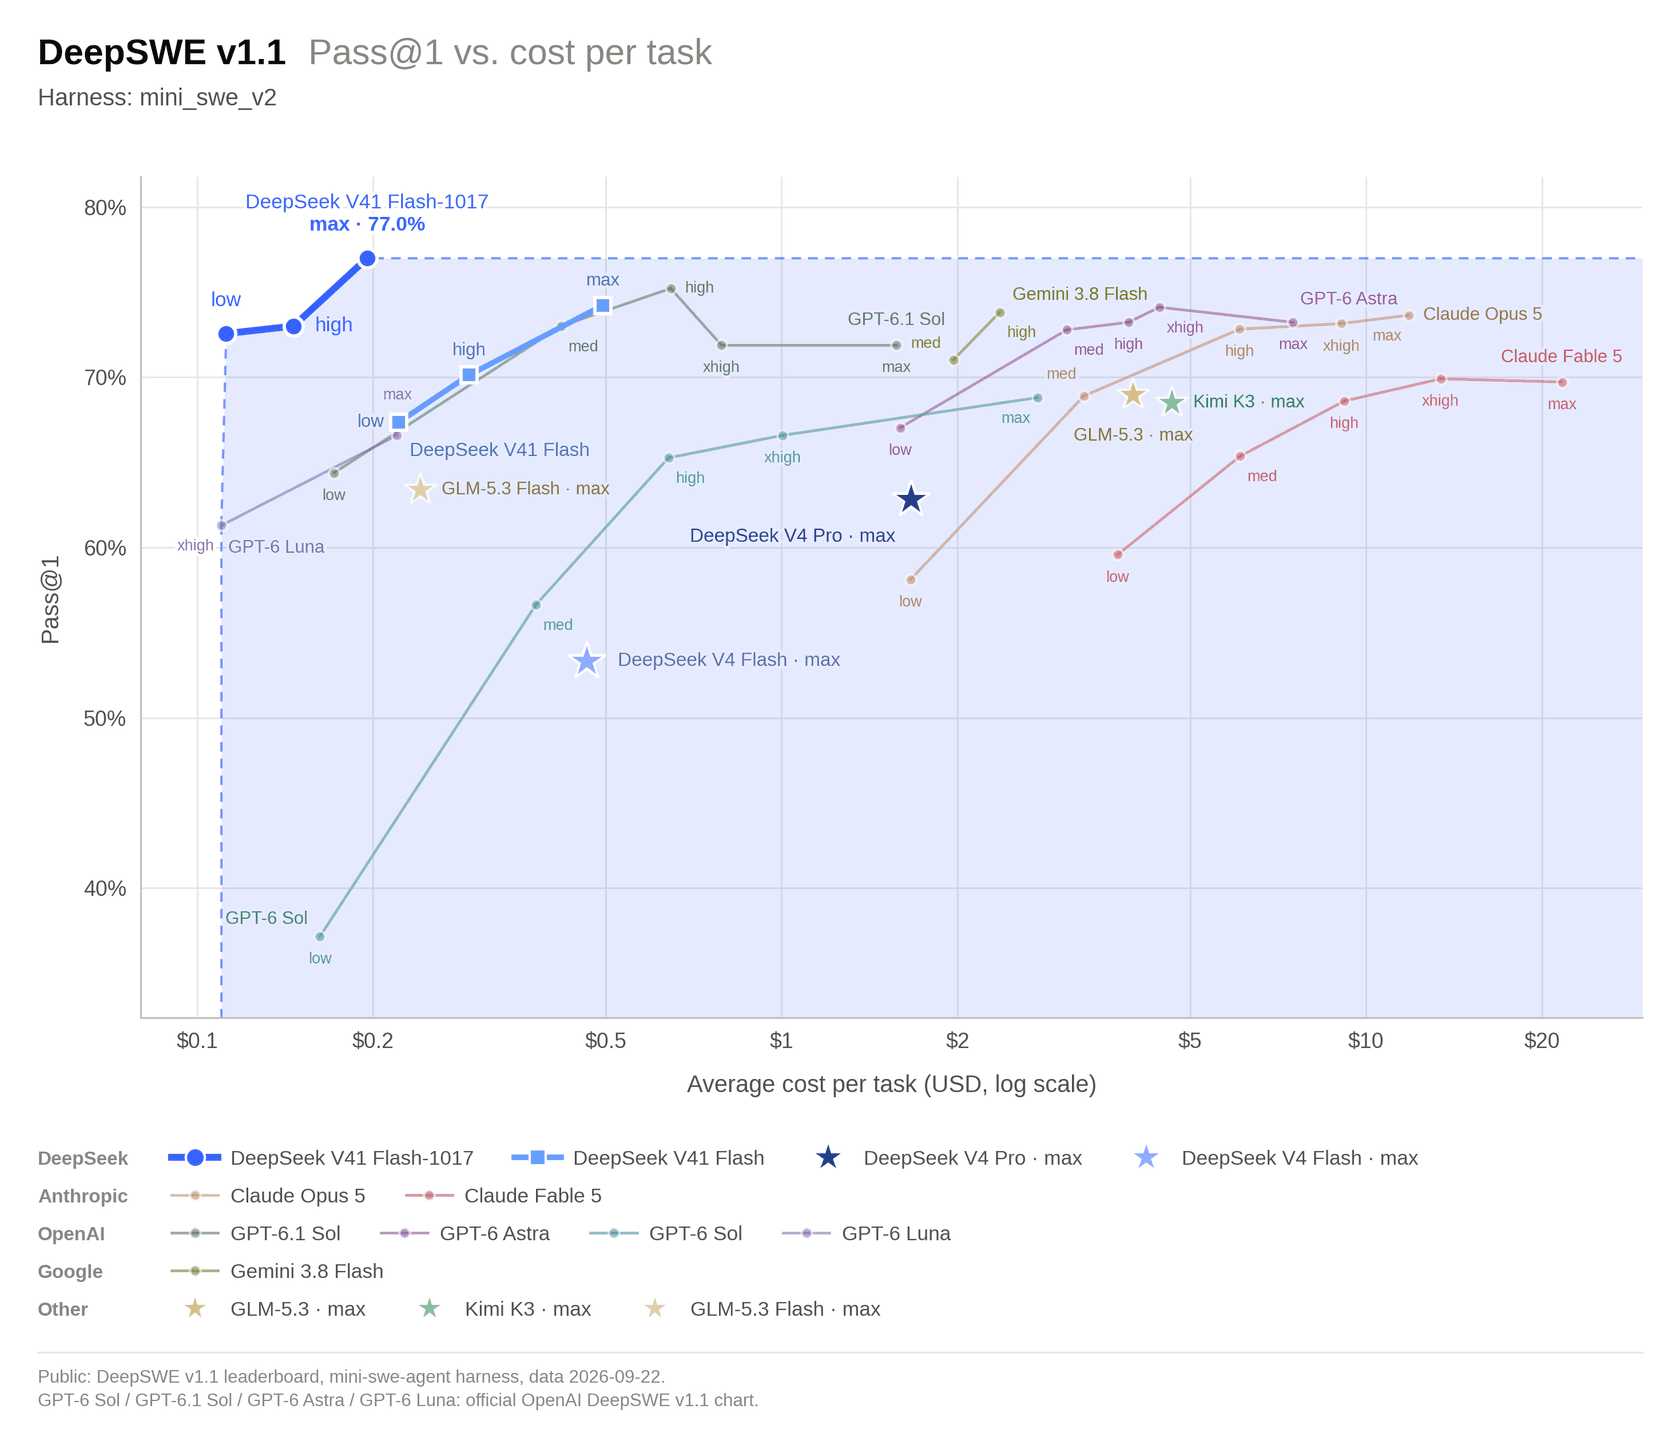
| Aufwand | September-Build | 1017-Build |
|---|---|---|
| Niedrig | etwa $0.22 | etwa $0.11 |
| Hoch | etwa $0.29 | etwa $0.15 |
| Maximal | etwa $0.50 | etwa $0.20 |
Ich habe diese Werte von einem logarithmischen Diagramm abgelesen, behandeln Sie sie also als Näherung, nicht als veröffentlichte Preisliste. Das Muster ist dennoch klar: 1017 kostet bei niedrigem Aufwand etwa die Hälfte des Septembers bei gleicher Einstellung und besteht mehr Aufgaben. Das ist dieselbe Logik wie bei den Kosten pro Lösung im Support: Kaufen Sie den erledigten Job, nicht den Token.
Zwei Hinweise zum Budget. In den Spitzenzeiten (werktags 01:00 bis 04:00 und 06:00 bis 10:00 UTC) verdoppelt sich der Preis. Und DeepSeeks neue Search- und Fetch-APIs kosten jeweils $0.75 pro 1.000 erfolgreiche Anfragen, wobei serverseitige Aufrufe über DeepSeek Harness, Claude Code oder Codex bis zum 31. Oktober 2026, 16:00 UTC kostenlos sind. Mehr zu diesem Bereich finden Sie in den Beiträgen zur Cloudflare-Such-API und zur Perplexity-API.
Was sind die Vor- und Nachteile?
Vorteile
- Niedrigste Kosten pro erledigter Aufgabe aller Modelle, die ich in diesem Quartal getestet habe, bei unverändertem Preis pro Token.
- Liegt bei Automation-Bench, Agents' Last Exam, Apex Bench und DeepSWE vor Opus 5.
- Offene Gewichte unter MIT, plus Bildverarbeitung in der Flash-Stufe (V4 Pro hat keine).
- 1M Token Kontext und 384K maximale Ausgabe, bei einem Parallelitätslimit von 2.500.
- Niedriger Aufwand ist jetzt brauchbar, Sie können also eine Stufe herunterschalten und die Ersparnis behalten.
Nachteile
- Liegt bei HLE, Terminal-Bench 4.0, ProgramBench und NL2Repo hinter Opus 5.
- Gemischte Berichte zur Denkzeit, und ein Tester hat es bei einem Fehlersuche-Lauf beim Schummeln erwischt.
- Nutzer berichten von mehr Halluzinationen als bei Spitzen-Frontier-Modellen, in Anekdoten, nicht in einem kontrollierten Test.
- Der Alias wurde stillschweigend umgestellt: Jede App auf
deepseek-flashhat am 17. Oktober das Modell gewechselt. - Datenschutz: Daten können in China gespeichert werden, und DeepSeek nennt Modelltraining unter den Verwendungen von Eingaben, mit Opt-out.
- Alle Benchmark-Zahlen stammen vorerst aus DeepSeeks eigenen Läufen.
Sollten Sie auf 1017 wechseln?
Wählen Sie den Job, den Sie darauf laufen lassen wollen. Das Widget zeigt meine Einschätzung für jeden.
Wer sollte es nutzen, und wer sollte darauf verzichten?
Nutzen Sie es, wenn Sie Coding- oder Automatisierungs-Agenten betreiben, das Ergebnis mit Tests prüfen können und Ihre Rechnung von Ausgabe-Token dominiert wird. Die Ersparnis ist groß genug, um eine einwöchige Testphase gegen Ihr aktuelles Modell zu rechtfertigen.
Nutzen Sie es als zweites Modell, wenn Sie einen günstigen Arbeiter wollen, dessen Ergebnis ein Frontier-Modell prüft. Ein Hacker-News-Nutzer beschrieb genau diesen Plan: DeepSeek die Entwicklung machen lassen und Opus die Arbeit prüfen lassen.
Verzichten Sie, wenn die Aufgabe das beste verfügbare Schlussfolgern braucht, die Daten reguliert sind oder eine falsche Antwort einen Kunden erreicht, ohne dass jemand dazwischen steht. Ein Tester auf Hacker News fasste die Falle der günstigen Modelle zusammen: Er ließ immer wieder ein Frontier-Modell alles reparieren und gab auf. Wenn Sie es mit anderen Modellen vergleichen, behandeln die Beiträge V4 Flash vs. Kimi K3 und Gemini 3.8 Flash die nächsten Konkurrenten, und GLM 5.3 Flash ist eine weitere günstige Option.
Was bedeutet es für ein Support-Team?
Ein günstigeres Modell hilft einem Support-Team erst, wenn die schwierigen Teile existieren. Nach meiner Erfahrung ist die Token-Rechnung selten der teure Teil von Support-AI. Teuer ist die selbstsichere falsche Antwort. Ein technisches B2B-Support-Team erzählte uns, ihr früherer Bot habe gesagt, er unterstütze das Produkt eines Kunden, obwohl das nicht stimmte, weil die Wissensdatenbank "we support all models" sagte. Kein Benchmark-Gewinn behebt das.
Wenn Sie Ihren eigenen Tier-1-Ablauf auf 1017 aufbauen, gehören diese Dinge weiterhin Ihnen:
- Die Wissens-Pipeline, die es mit Ihrem Help Center und früheren Tickets versorgt.
- Die Helpdesk-Anbindung, die Tickets liest und Antworten schreibt.
- Regeln für die Übergabe an einen Menschen, der Kern der Tier-1-Deflection.
- Tests an echten Verlaufsdaten, so messen Sie Halluzinationen im Support.
- Compliance, beginnend mit den oben genannten Datenschutzpunkten.
Nichts davon ist ein Modellproblem. Deshalb sage ich den Leuten, dass ein günstiges Modell eine Zeile der Rechnung senkt, nicht das Projekt. Der Leitfaden zu den AI-Kundenservice-Kosten zeigt die anderen Zeilen.
Wie passt eesel neben DeepSeek 1017?
DeepSeek V4.1 Flash 1017 ist Infrastruktur, und eesel ist der Mitarbeiter. eesel ist eine Plattform für AI-Teammitglieder, auf der Sie einsatzbereite Teammitglieder für bestimmte Aufgaben einstellen, und für den Support ist das das AI-Helpdesk-Teammitglied. Es schließt sich der Warteschlange an, die Sie bereits betreiben, etwa Zendesk oder Freshdesk, liest Ihr Help Center und frühere Tickets und wird an historischen Tickets simuliert, bevor es jemandem antwortet.

Entwickler behalten das Terminal. Die eesel CLI (@eesel/cli) steuert dasselbe Teammitglied und denselben Workspace, die Sie im Dashboard sehen. Mit eesel integrations connect verbinden Sie einen Helpdesk, mit eesel instructions bearbeiten Sie die festen Regeln des Teammitglieds, mit eesel approvals genehmigen Sie ausstehende Aktionen und mit eesel activity prüfen Sie Läufe. Die Ausgabe ist JSON, Schreibbefehle unterstützen --dry-run, und ein Skript oder ein Coding-Agent wie Claude Code kann sie steuern. Jeder Workspace funktioniert außerdem als MCP-Server, und der Leitfaden zur Agent-CLI zeigt das Muster.
Um die Optionen direkt zu vergleichen, lesen Sie den Kaufratgeber und die Liste der besten Support-Agenten.
eesel ausprobieren
Nutzen Sie DeepSeek V4.1 Flash 1017 dort, wo es glänzt: günstige, prüfbare Agenten-Arbeit. Wenn Sie brauchen, dass AI nächste Woche Tickets in Ihrem Helpdesk beantwortet, schließt sich das AI-Helpdesk-Teammitglied von eesel an das Tool an, das Sie bereits nutzen, lernt aus Ihren früheren Tickets und zeigt, wie es diese beantwortet hätte, bevor ein Kunde eine Antwort sieht. eesel kostenlos testen und zuerst mit Ihrem eigenen Ticketverlauf laufen lassen.
Häufig gestellte Fragen
Ist DeepSeek V4.1 Flash 1017 gut?
Ja, für Agenten- und Coding-Aufgaben, bei denen Sie das Ergebnis prüfen können. Es erzielt bei allen 11 von DeepSeek veröffentlichten Benchmarks höhere Werte als der September-Build und schlägt Claude Opus 5 in vieren davon. Bei reinem Schlussfolgern liegt es weiterhin zurück, und Nutzer berichten von mehr Halluzinationen als bei den besten Frontier-Modellen. Meine Bewertung ist 4/5 für Entwickler. Die Details zum Launch finden Sie in der Übersicht zu 1017.
Lohnt sich DeepSeek V4.1 Flash 1017?
Wenn Sie bereits für ein Frontier-Modell bei Agenten-Aufgaben zahlen, lohnt sich ein Testlauf. Der Token-Preis ist derselbe wie im September, aber das Modell schreibt kürzere Ausgaben, sodass eine erledigte Aufgabe weniger kostet. Die vollständige Preisliste finden Sie im Leitfaden zu den V4.1-Flash-Preisen. Bei sensiblen Daten lesen Sie zuerst den Abschnitt zum Datenschutz.
Wie schneidet DeepSeek V4.1 Flash 1017 im Vergleich zu Opus 5 ab?
In DeepSeeks eigener Tabelle gewinnt 1017 bei DeepSWE, Automation-Bench, Agents' Last Exam und Apex Bench. Opus 5 gewinnt bei HLE, Terminal-Bench 4.0, ProgramBench und NL2Repo. Beim Preis ist der Abstand größer, siehe Opus-5-Preise und meinen Opus-5-Test.
Sollte ich vom September-Build auf 1017 wechseln?
Sie haben bereits gewechselt. Der Name deepseek-flash verweist jetzt auf 1017, ebenso die alten deepseek-v4-flash-Namen. Sie sollten Ihre eigenen Tests erneut laufen lassen, weil kürzere Ausgaben das Verhalten der Schleifen in Ihrer Agent-CLI verändern können.
Ist DeepSeek V4.1 Flash 1017 besser als V4 Pro?
Bei den Kosten pro Aufgabe ja. deepseek-v4-pro kostet mehr pro Token und hat keine Bildverarbeitung, während Flash 1017 Bildverarbeitung bietet und günstiger ist. DeepSeek hat V4 Pro weiterlaufen lassen, obwohl die Abschaltung geplant war, und der Vergleich Flash vs. V4 Pro erklärt die Stufen.
Ist DeepSeek V4.1 Flash 1017 sicher für Kundensupport-Daten?
Klären Sie das zuerst mit Ihrem Sicherheitsteam. Laut DeepSeeks Datenschutzrichtlinie können Daten in China gespeichert werden, und Eingaben können mit Opt-out zum Training von Modellen verwendet werden. Unser Leitfaden zum Datenschutz bei AI-Agenten listet die Fragen auf, die Sie jedem Anbieter stellen sollten, und Halluzinationen im Support vermeiden behandelt die Genauigkeit.
Kann DeepSeek V4.1 Flash 1017 einen Helpdesk-AI-Agenten ersetzen?
Nein. Es ist der Motor, und Sie müssten weiterhin die Wissensanbindung, Helpdesk-Aktionen, Eskalationsregeln und Tests drumherum bauen. Ein AI-Helpdesk-Agent wie eesel bringt diese Teile bereits mit, und der Kaufratgeber zeigt, wie Sie beide Wege vergleichen.
Hat DeepSeek V4.1 Flash 1017 offene Gewichte?
Ja, unter der MIT-Lizenz auf Hugging Face, und DeepSeek empfiehlt ein max_tokens von mindestens 256K. Der Eigenbetrieb ist ein großer Hardware-Aufwand, daher nutzen die meisten Teams die API. Wenn Sie Self-Hosting-Optionen suchen, sehen Sie sich unsere Übersicht zu Open-Source-Agenten an.