

Mein Urteil zu MiniMax M3.1 Flash lautet 3,5/5: ein günstiges, schnelles Agenten-Arbeitstier, das DeepSeek bei Code nicht schlägt. MiniMax hat es am 19. Oktober 2026 zu einem Pauschalpreis von $0.15 Input und $0.60 Output pro Million Tokens auf seiner Preisseite veröffentlicht, ohne Aufschlag für langen Kontext im 1M-Fenster. Es führt MiniMax' eigene Tabelle bei Automation-Bench an (62.8) und zieht bei BankerToolBench mit Claude Opus 5 gleich (76.2).
Der Haken steckt in derselben Tabelle. Gegen DeepSeek V4.1 Flash 1017, das außerhalb der Spitzenzeiten gleich viel kostet, gewinnt M3.1 Flash einen von sechs gemeinsamen Benchmarks und liegt bei DeepSWE (73.7 vs. 77.0), Terminal-Bench 4.0 und NL2Repo zurück. Das Diagramm zu den Kosten pro Aufgabe setzt DeepSeek zu Spitzenpreisen an, was MiniMax schmeichelt. Die Gewichte sind für den 23. Oktober versprochen.
Ich würde es also für Agenten-Schleifen im Büroalltag, Tool-Aufrufe und die Arbeit mit langen Dokumenten nutzen und für harte Repo-Arbeit DeepSeek wählen. Für Support-Teams ist das Modell der kleinste Teil der Aufgabe: Das KI-Helpdesk-Teammitglied von eesel bringt die Helpdesk-Anbindung, das Wissen und einen Replay Ihrer früheren Tickets mit, und so lässt smava damit rund 27,000 Tickets im Monat laufen.
Wie lautet mein Urteil zu MiniMax M3.1 Flash?
Ich verbringe den Großteil meiner Woche damit, mir anzusehen, wonach Leute vor dem Kauf suchen, und die Suchanfragen rund um diesen Launch sind direkt: „is M3.1 Flash better than DeepSeek“, „is it open source“, „what does it cost“. Dieser Test beantwortet sie in genau dieser Reihenfolge. Wer das nüchterne Datenblatt aus den Preview-Tagen möchte: Die Übersicht zu M3.1 Flash meines Kollegen behandelt weiterhin den Effort-Regler und den 1M-Kontext.
Ich gehöre außerdem zu einem Team, das seit Jahren KI in echten Support-Warteschlangen betreibt, und diese Erfahrung prägt, wie ich ein Modell bewerte. Ein günstigeres Modell lässt „selbst bauen“ einfach klingen. Ein abgewanderter Mittelstandskunde sagte uns genau das beim Abschied:
"We switched to a system that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Modelle wie M3.1 Flash sind der Grund, warum sich dieser Satz wahr anfühlt. Ob er stimmt, hängt von allem rund um das Modell ab, deshalb bewerte ich sowohl den Motor als auch, wie weit er Sie bringt.
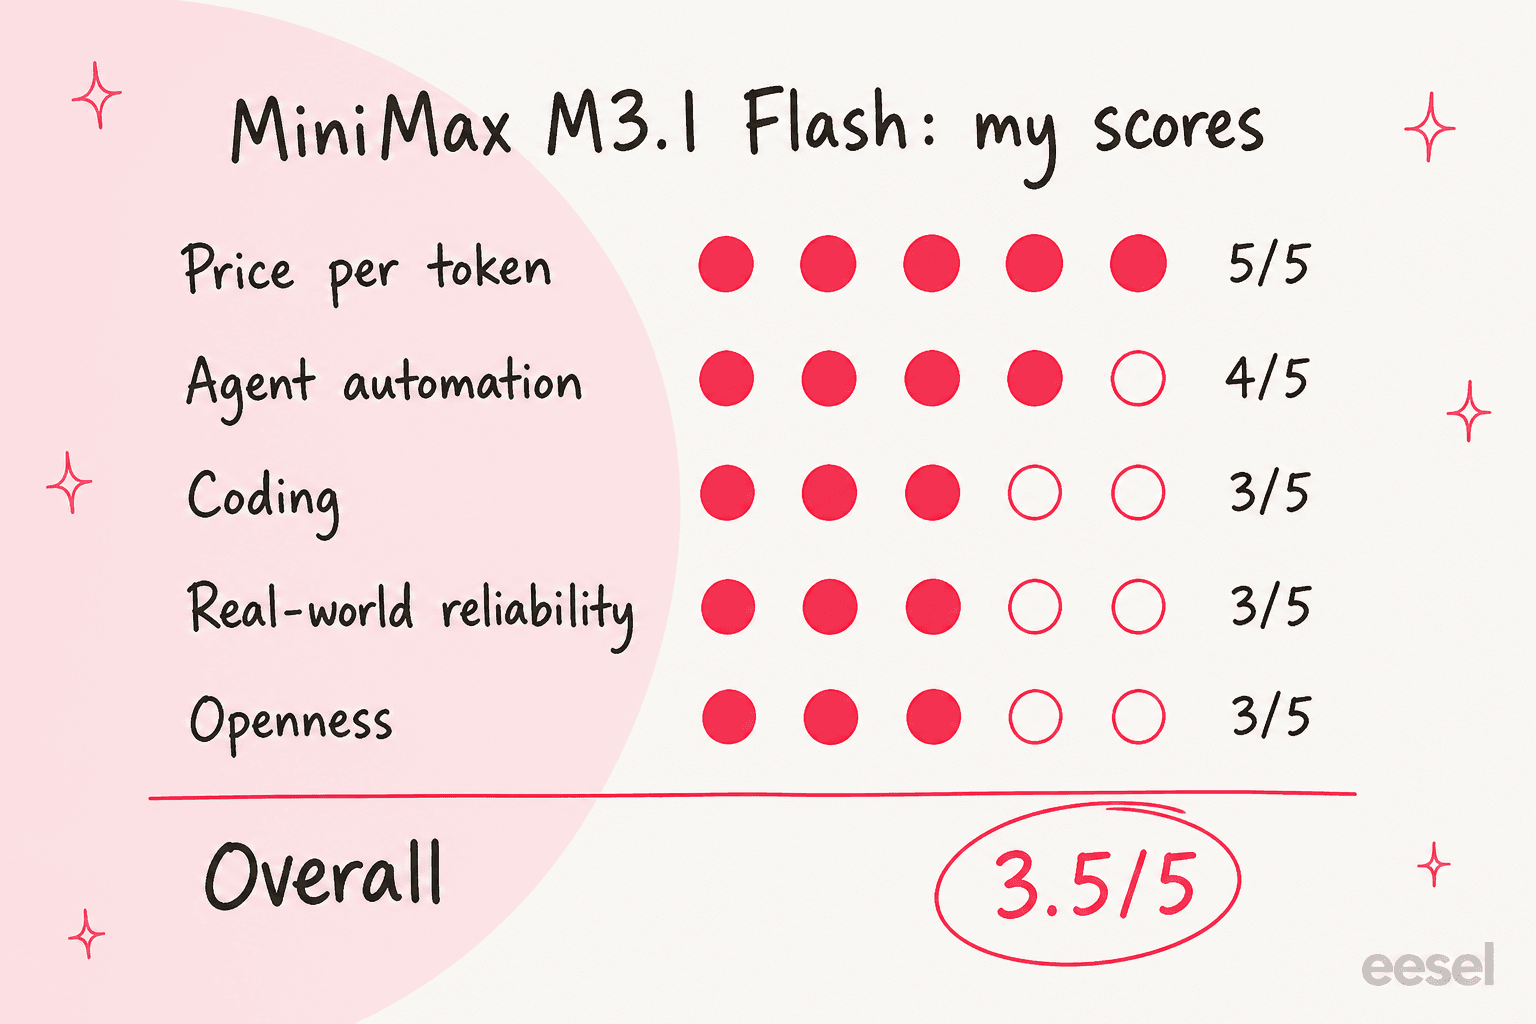
| Bereich | Note | Begründung |
|---|---|---|
| Preis pro Token | 5/5 | $0.15/$0.60 pauschal über 1M Tokens, die Hälfte des Kurzkontext-Preises von MiniMax M3 |
| Agenten-Automatisierung | 4/5 | Bestes Ergebnis bei Automation-Bench in MiniMax' Tabelle, gleichauf mit Opus 5 bei BankerToolBench |
| Coding | 3/5 | Liegt bei DeepSWE, Terminal-Bench 4.0 und NL2Repo hinter DeepSeek V4.1 Flash 1017 |
| Zuverlässigkeit im Alltag | 3/5 | Frühe Tester berichten von Trägheit und Abschweifen bei hohem Effort |
| Offenheit | 3/5 | Gewichte für den 23. Oktober versprochen, noch nicht veröffentlicht |
| Gesamt | 3,5/5 | Ein starker, günstiger Motor für Agenten-Schleifen, nicht der günstige Coding-König |
Diese Noten sind meine eigenen. Sie stützen sich auf MiniMax' Launch-Beitrag, die Dokumentations- und Preisseiten, die Preisseiten der Konkurrenz und das, was Entwickler in den ersten 24 Stunden gepostet haben.
Was ist am 19. Oktober tatsächlich erschienen?
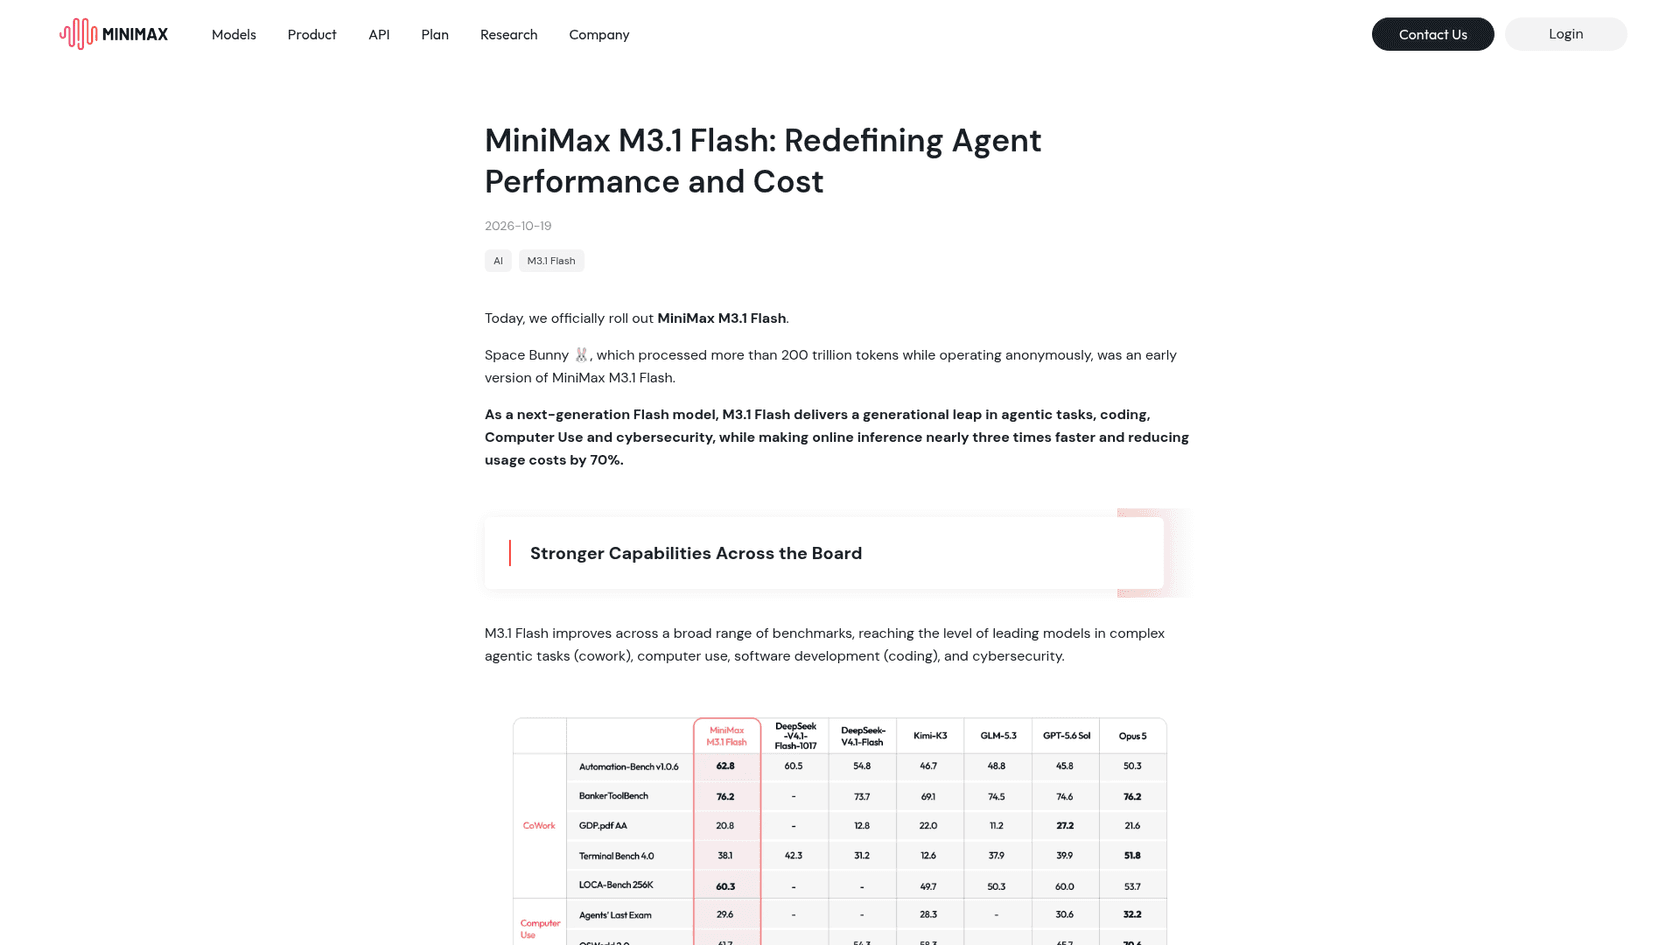
Die Preview, über die ich im September geschrieben habe, ist weg. MiniMax' Dokumentation führt jetzt MiniMax-M3.1-Flash als neuestes Modell der M-Serie, und die M-Plan-Dokumentation sagt, dass der alte Name MiniMax-M3.1-Flash-Preview eingestellt wurde und Anfragen nun vom neuen Modell bedient werden. Damit ist auch das Gerücht aus der Stealth-Phase bestätigt: „Space Bunny“, das anonyme Modell, das über 200 Billionen Tokens verarbeitet hat, war eine frühe Version.
Das hat sich zwischen Preview und allgemeiner Veröffentlichung geändert:
| Preview (27. Sept.) | Allgemeine Veröffentlichung (19. Okt.) | |
|---|---|---|
| Modell-ID | MiniMax-M3.1-Flash-Preview | MiniMax-M3.1-Flash |
| Verfügbar in | Nur MiniMax Code und Token Plan | API, M Plan und MiniMax Code |
| Preis pro Token | Keiner veröffentlicht | $0.15 Input / $0.60 Output / $0.015 gecacht |
| Geschwindigkeitsangabe | Keine | 200+ Tokens pro Sekunde, P50 170+ |
| Benchmarks | Keine | Tabelle mit 15 Zeilen gegen sechs Konkurrenten |
| Gewichte | Keine | Für den 23. Oktober versprochen |
Drei Dinge sind gleich geblieben, und sie bestimmen weiterhin, wie man es nutzt. Das Kontextfenster umfasst 1.000.000 Tokens. Als Input sind Text, Bilder oder Video möglich. Und Thinking ist immer aktiv: Man setzt effort von low bis max (Standard max), und effort: "none" liefert laut Textgenerierungs-Dokumentation einen 400-Fehler.
Ein weiteres Detail zählt für alle, die Self-Hosting planen. Der "Flash"-Name bedeutet nicht klein. MiniMax' Code-Seite nennt eine Mixture-of-Experts-Architektur mit 428 Mrd. Parametern insgesamt und rund 23 Mrd. aktiven, also dieselbe Größenklasse wie MiniMax M3. Ein Reddit-Kommentator hat es gut getroffen:
"yeah fair point, the "flash" name is kinda misleading. same 428b / 23b active as m3, so if you could run m3 you can run this."

Wo gewinnt es?
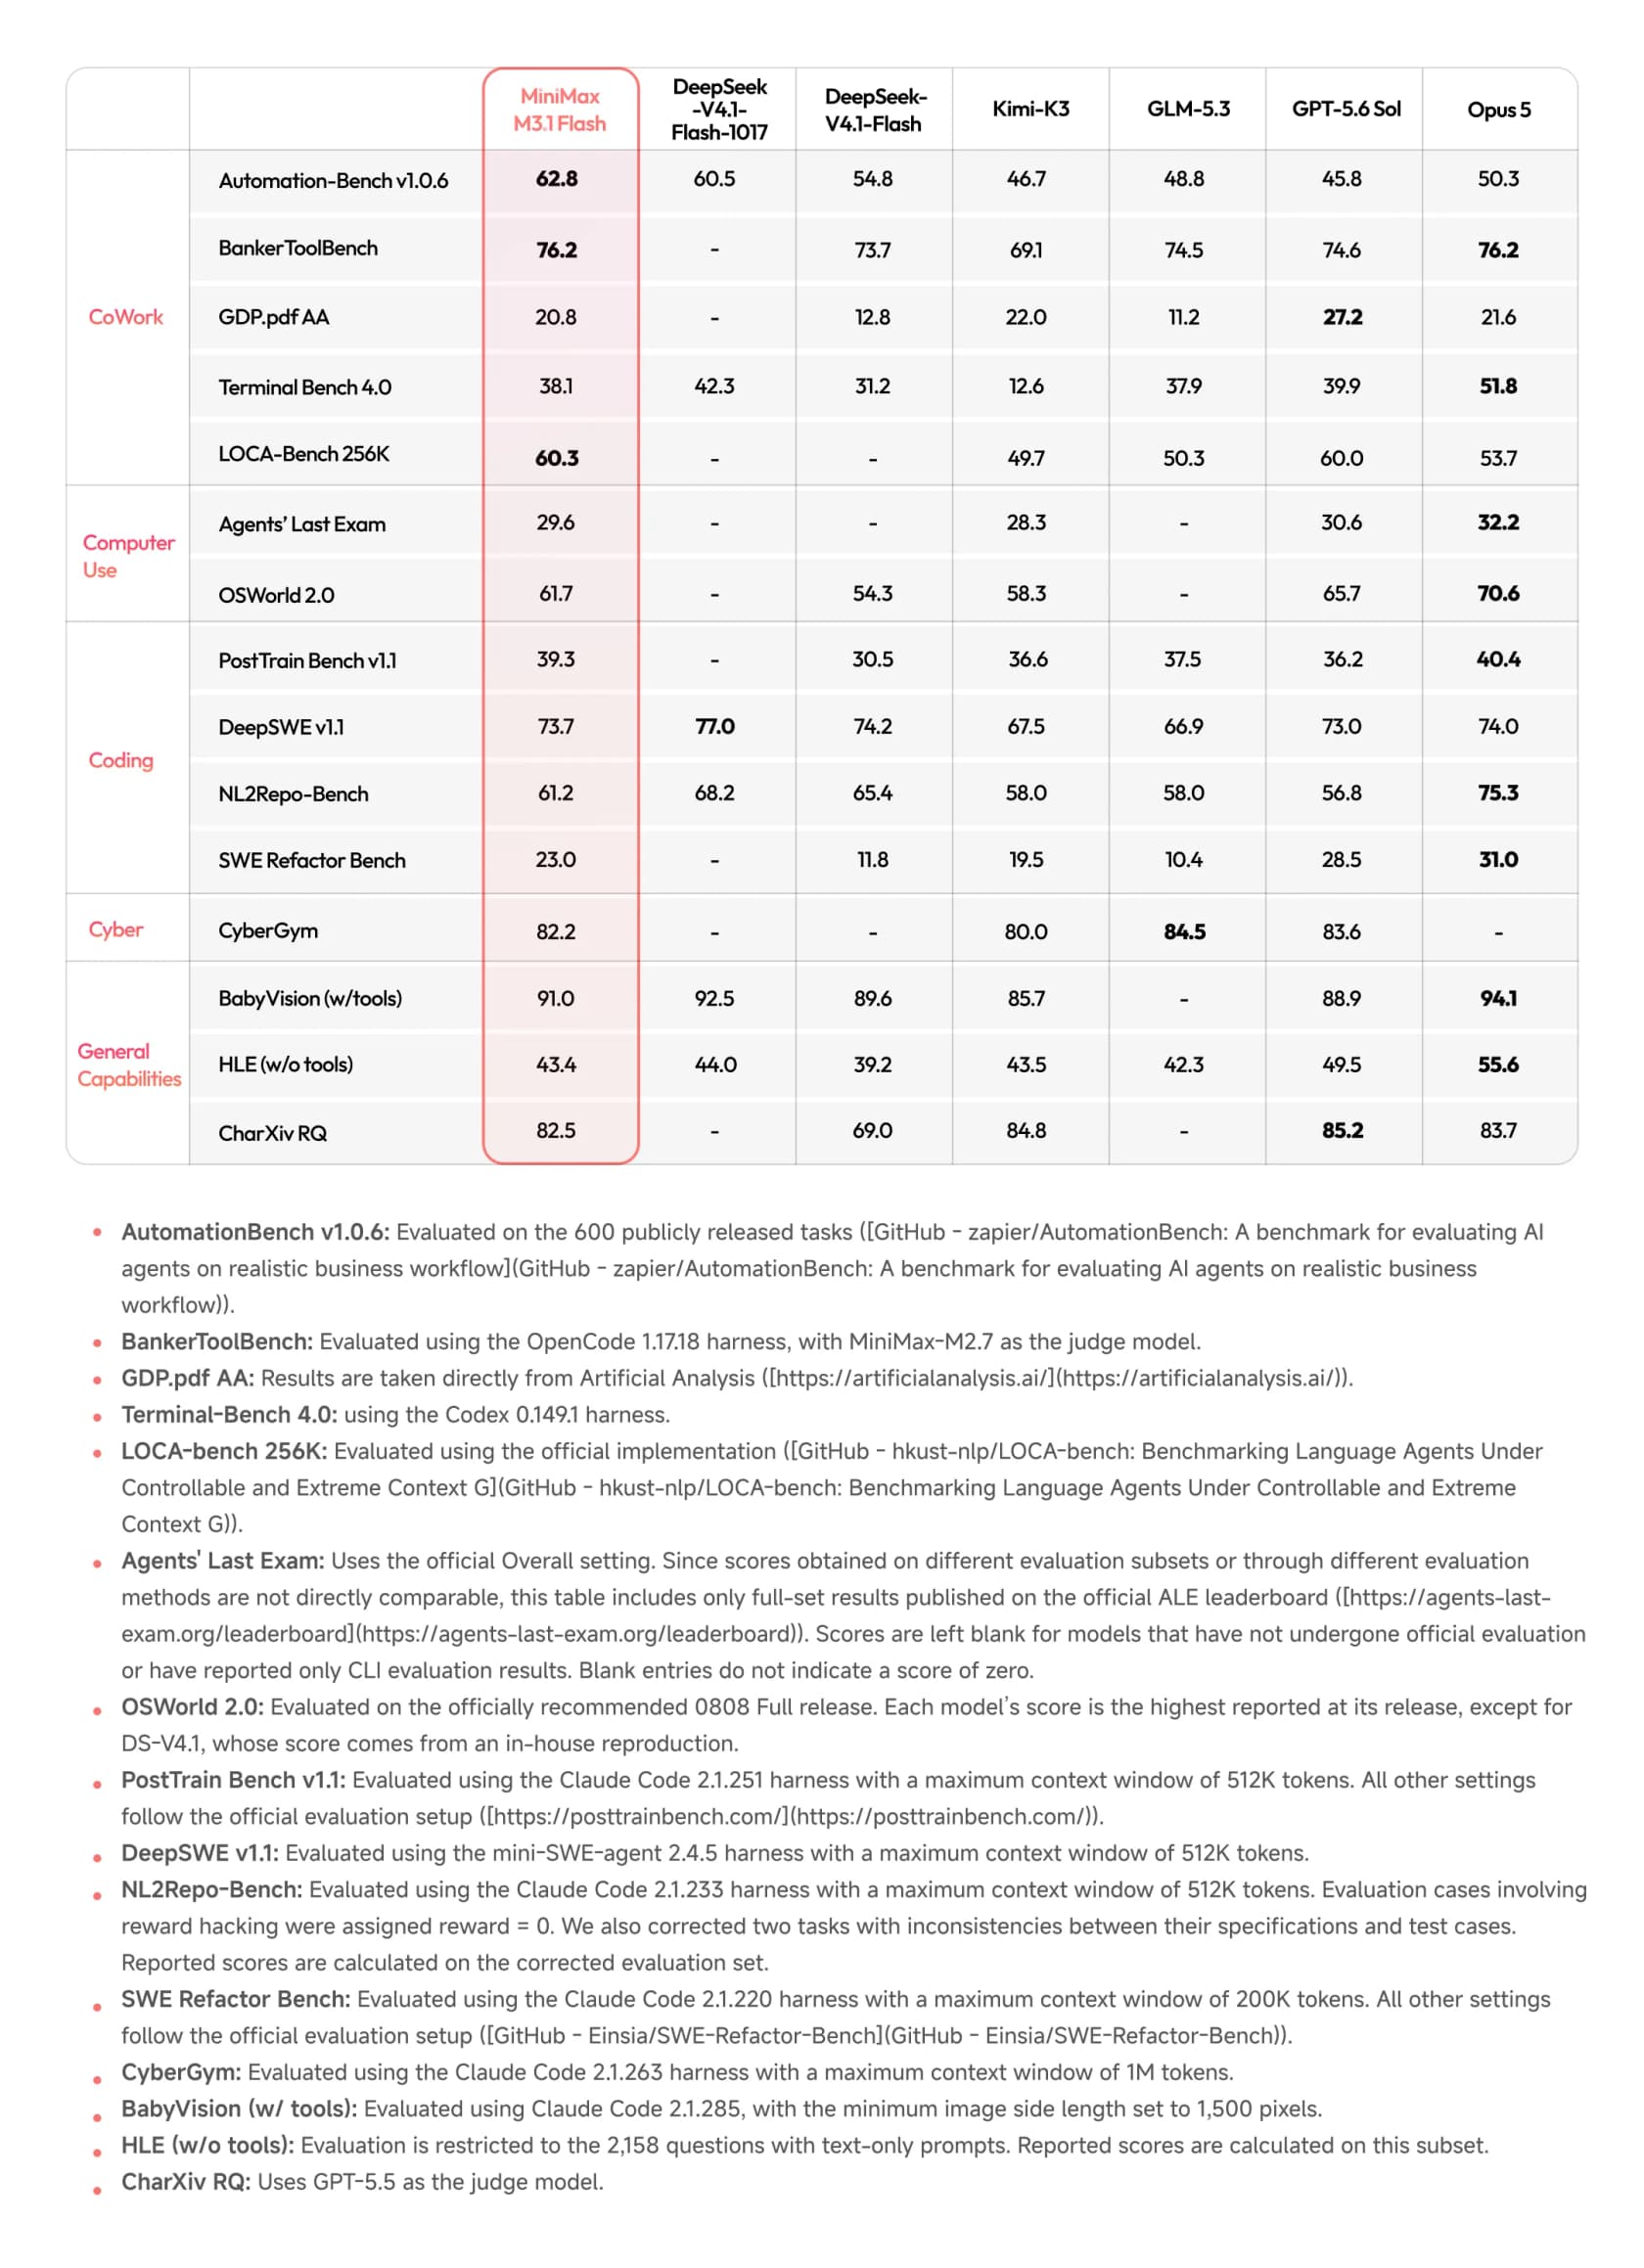
Die Siege konzentrieren sich auf Agenten-Arbeit im Büroalltag: mehrstufige Aufgaben über Business-Software hinweg, verkettete Tool-Aufrufe und lange Dokumente. Quelle ist hier MiniMax' eigene Tabelle, lesen Sie diese Werte also als vom Anbieter gemeldet.
- Automation-Bench
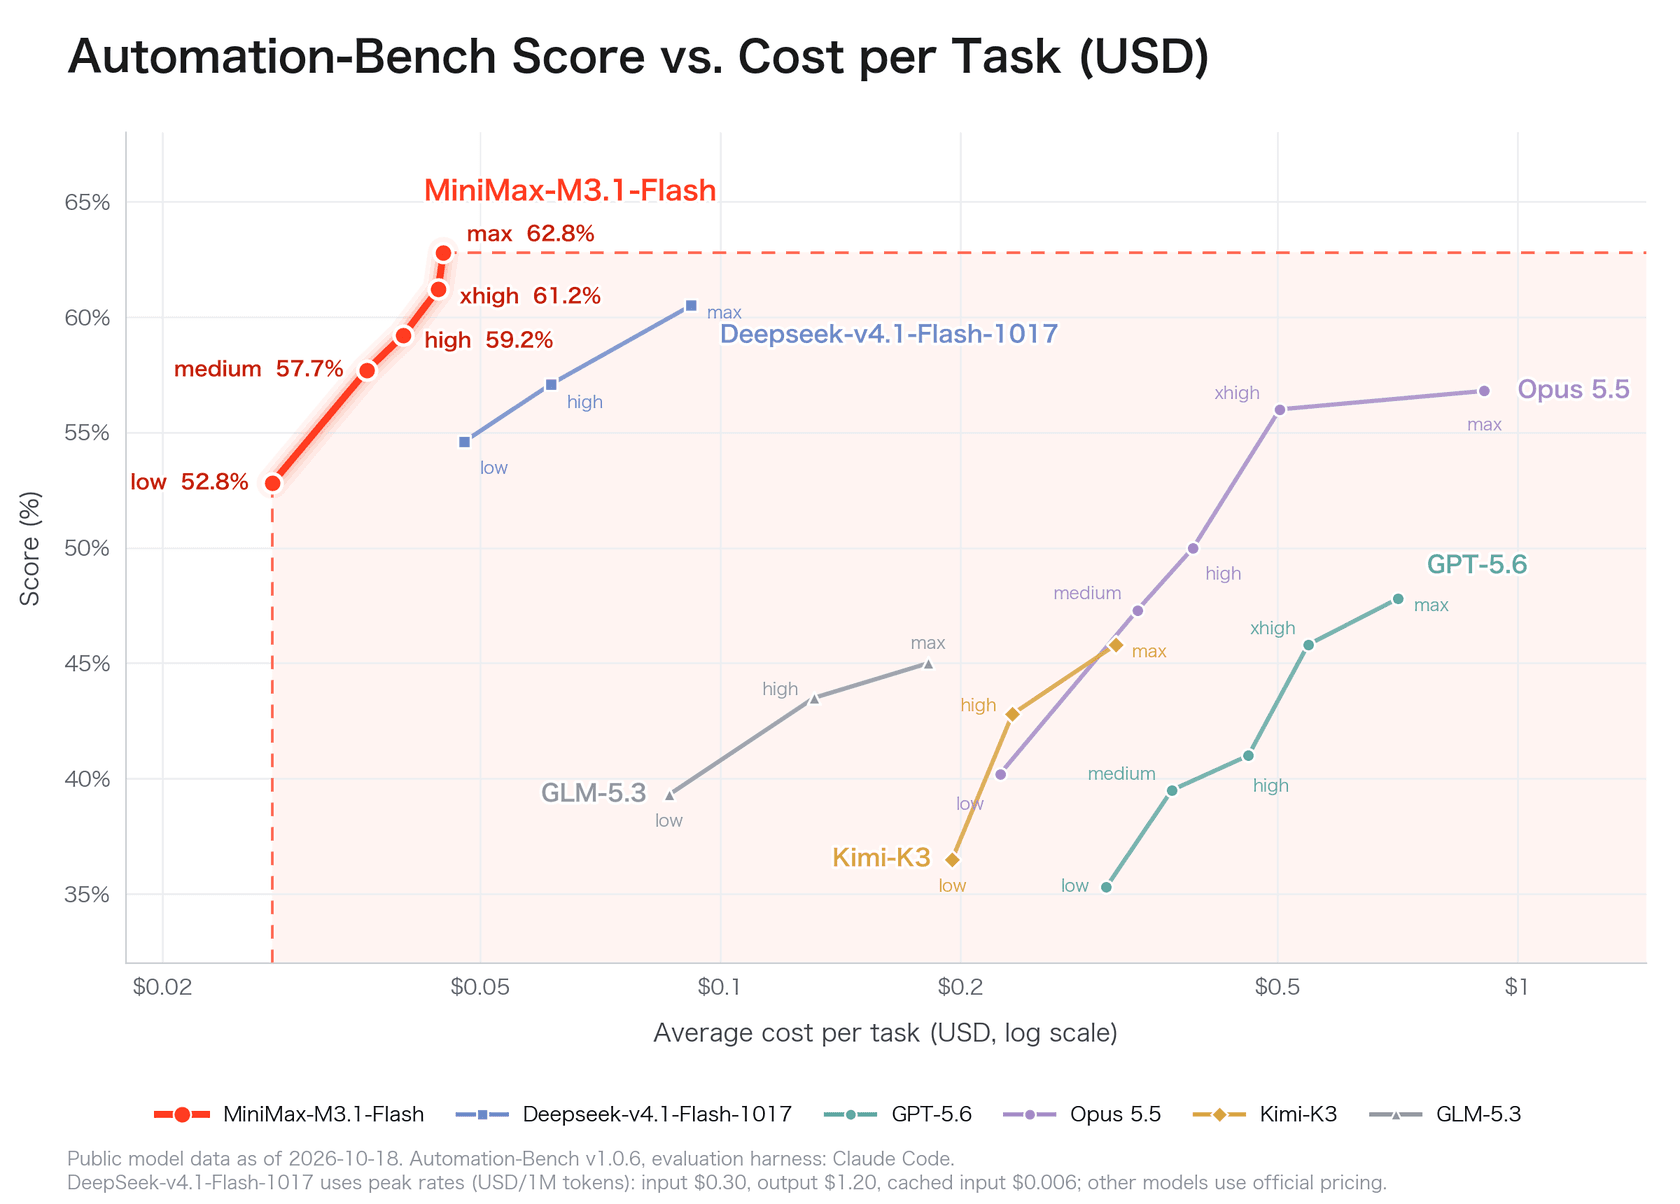
62.8, der Spitzenwert der Tabelle, vor DeepSeek 1017 (60.5), Claude Opus 5 (50.3) und GPT-5.6 Sol (45.8). MiniMax beschreibt es als echte Workflows in Vertrieb, Marketing, Betrieb, Kundenservice, Finanzen und Personal. - BankerToolBench
76.2, gleichauf mit Opus 5 und vor Kimi K3 (69.1). - LOCA-Bench 256K
60.3, der beste Wert der Tabelle für Langkontext-Agenten. - CyberGym
82.2, nur hinter GLM-5.3 (84.5) und GPT-5.6 Sol (83.6).
Bei den Kosten-Diagrammen sieht M3.1 Flash am besten aus. In MiniMax' Automation-Bench-Diagramm landet M3.1 Flash bei max Effort bei 62.8% für etwa $0.045 pro Aufgabe, und selbst low Effort erreicht 52.8%, mehr als GPT-5.6, Kimi K3 und GLM-5.3 in ihren besten Einstellungen. Im Diagramm zu Agents' Last Exam kommt es auf 29.6% bei $111 Gesamtkosten, der günstigste Punkt auf der Grenzlinie.
Geschwindigkeit ist der andere Pluspunkt. MiniMax sagt, die Ausgabe erreiche 200+ Tokens pro Sekunde, mit einem Median von 170+, fast dreimal so schnell wie M3. Frühe Nutzer bestätigten das Gefühl, wenn auch nicht die genaue Zahl:
"first impression of minimax m3.1 flash been using model for the last few hours and it's a huge step up from m3. pretty good for flash model"
Wo liegt es hinter DeepSeek V4.1 Flash 1017?
Diesen Abschnitt haben die meisten Launch-Berichte übersprungen. DeepSeek V4.1 Flash 1017 hat in sechs von MiniMax' Zeilen einen Wert und schlägt M3.1 Flash in fünf davon:
| Benchmark (MiniMax' Tabelle) | M3.1 Flash | DeepSeek V4.1 Flash 1017 | Sieger |
|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | M3.1 Flash |
| Terminal-Bench 4.0 | 38.1 | 42.3 | DeepSeek |
| DeepSWE v1.1 | 73.7 | 77.0 | DeepSeek |
| NL2Repo-Bench | 61.2 | 68.2 | DeepSeek |
| BabyVision (with tools) | 91.0 | 92.5 | DeepSeek |
| HLE (no tools) | 43.4 | 44.0 | DeepSeek |
Drei dieser Niederlagen sind Coding-Tests, deshalb gebe ich beim Coding eine 3. Im DeepSWE-Kostendiagramm von MiniMax liegt die Linie von DeepSeek 1017 sowohl höher als auch weiter links: etwa 77% bei rund $0.20 pro Aufgabe bei max, gegenüber 73.7% bei rund $0.27 für M3.1 Flash. Die Übersicht zu DeepSeek 1017 erklärt, warum dieses Modell pro Aufgabe so günstig wurde.
Dann gibt es die Fußnote. Das Automation-Bench-Diagramm setzt DeepSeek 1017 zu Spitzenpreisen an, $0.30 Input und $1.20 Output. Die Preisseite von DeepSeek berechnet diese nur wochentags von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC. Jede andere Stunde ist außerhalb der Spitzenzeiten zum halben Preis, $0.15/$0.60, exakt derselbe Tarif wie bei M3.1 Flash. Meine Rechnung: Zu Nebenzeit-Preisen rutscht DeepSeeks Max-Effort-Punkt von rund $0.09 auf rund $0.045 pro Aufgabe, genau dorthin, wo M3.1 Flash liegt, bei einem nur 2,3 Punkte niedrigeren Score.
Leser auf Hacker News bemerkten das Muster innerhalb von Stunden:
"Not as strong as DeepSeek V4.1 Flash 1017 on deepswe so it's already dead to me."

Das ist härter, als ich es formulieren würde. M3.1 Flash gewinnt weiterhin bei der Agenten-Automatisierung und kostet für nichts Zusätzliches weniger. Aber es ist nicht die saubere Geschichte von „günstiger und besser“, die der Launch-Beitrag erzählt.
Was kostet es wirklich?
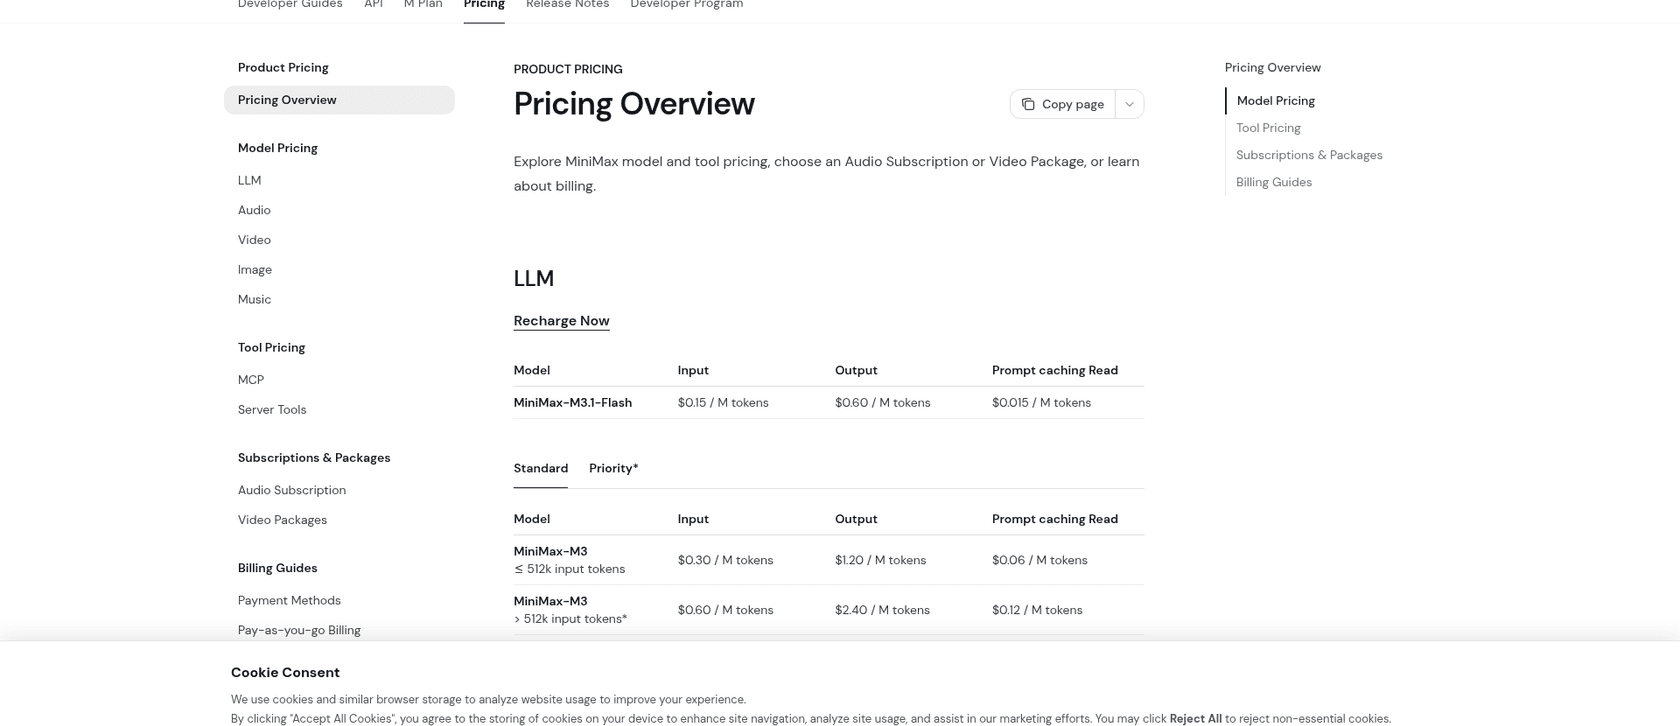
Der Preis ist einfach, was ich mag. M3.1 Flash hat einen Tarif über das gesamte 1M-Fenster, während sich der Preis bei MiniMax M3 oberhalb von 512K Input-Tokens verdoppelt.
| Modell (pro 1M Tokens) | Input | Gecachter Input | Output | Quelle |
|---|---|---|---|---|
| MiniMax M3.1 Flash | $0.15 | $0.015 | $0.60 | MiniMax |
| MiniMax M3 (bis 512K) | $0.30 | $0.06 | $1.20 | MiniMax |
| MiniMax M3 (über 512K) | $0.60 | $0.12 | $2.40 | MiniMax |
| DeepSeek V4.1 Flash, außerhalb der Spitzenzeiten | $0.15 | $0.003 | $0.60 | DeepSeek |
| DeepSeek V4.1 Flash, Spitzenzeiten | $0.30 | $0.006 | $1.20 | DeepSeek |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 | OpenAI |
| Gemini 3.8 Flash (bis 31. Dez. 2026) | $0.75 | $0.075 | $3.75 |
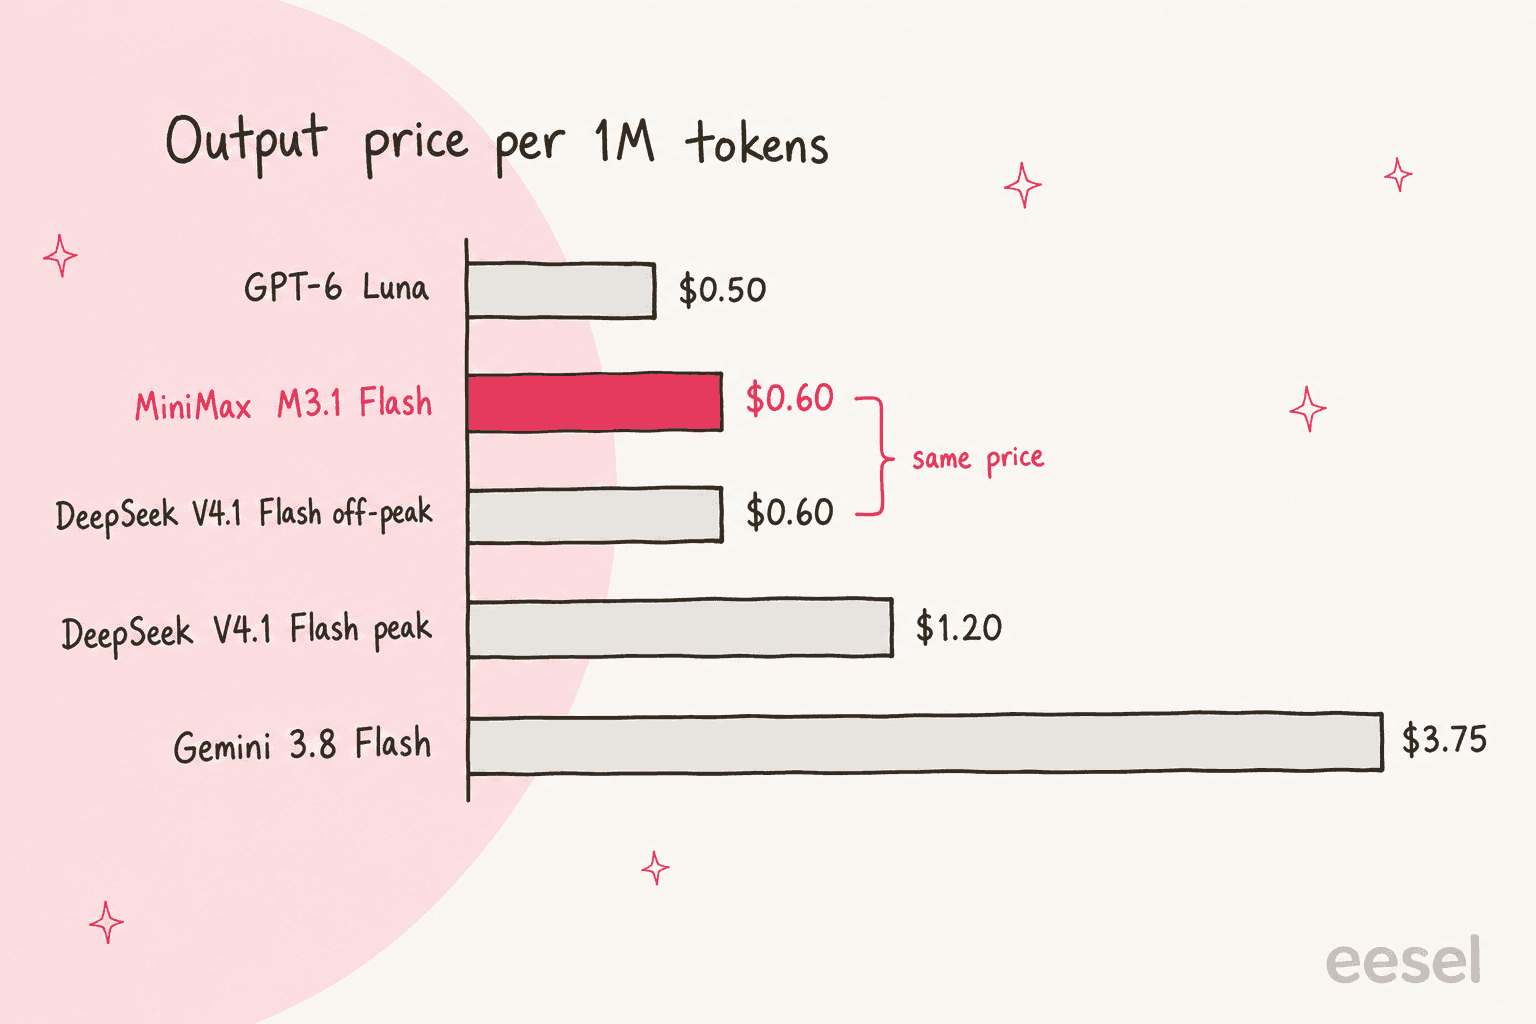
Zwei Dinge fallen auf. Erstens liegt DeepSeek bei gecachtem Input weiterhin vorn: $0.003 außerhalb der Spitzenzeiten gegenüber $0.015 bei M3.1 Flash, fünfmal günstiger. Agenten-Schleifen lesen denselben Kontext immer wieder, eine cache-lastige Arbeitslast kann die Rechnung also trotz gleichem Grundpreis zugunsten von DeepSeek kippen. Zweitens ist GPT-6 Luna pro Token günstiger als beide, und die Preisanalyse zu Luna zeigt auch dessen Cache-Tarif. Im Agents'-Last-Exam-Diagramm von MiniMax liegen die $111 Gesamtkosten von M3.1 Flash allerdings deutlich unter dem Punkt von GPT-5.6 Luna, der Token-Preis allein entscheidet es also nicht.
Wer lieber ein Abo zahlt: Der M Plan bündelt M3.1 Flash mit MiniMax Code und weiteren Modellen. Die jährliche Abrechnung beträgt $220, $550 oder $1,320 pro Jahr für die Stufen Go, Explore und Build, die das 1-, 3- und 7,5-Fache der Go-Nutzung bieten, zurückgesetzt in 5-Stunden- und Wochenfenstern. MiniMax' eigene M-Plan-FAQ sagt, der Plan sei für die individuelle, interaktive Nutzung gedacht, und empfiehlt für die Produktion Pay-as-you-go. Nehmen Sie das ernst: Das Abo ist für Ihre eigenen Coding-Sessions, nicht für ein Produkt, das Kunden bedient.
Was sagen echte Nutzer nach einem Tag?
Die ersten Reaktionen teilen sich sauber auf. Die Benchmarks beeindruckten. Praktische Tester waren gemischter, und die häufigste Beschwerde betrifft das Verhalten bei hohem Effort, was der Standard ist.
"I might get downvoted for this, but this model was WAY too lazy, even at Max effort"
Dasselbe Thema kam von einem X-Tester, dem es sonst gefiel:
"hallucinates alot on xhigh or max and starts doing stuff i didn't ask for, and cuz of that model ends up being slow despite giving 100+ tok/s"
Auf Hacker News wies ein Nutzer, der die Stealth-Version ausprobiert hatte, auf eine Lücke zwischen den Scores und den Alltagsergebnissen hin:
"The deepswe and terminalbench4.0 scores don't seem to jive with what many opencode users' experience has been of this model while it was being tested as "space bunny"."
MiniMax sagt, Space Bunny sei ein früherer Checkpoint gewesen, einiges davon könnte also behoben sein. Nicht jeder Bericht war negativ. Ein Entwickler, der die Preview in MiniMax Code genutzt hatte, mochte den Umgang mit Unsicherheit:
"it found the real bug instead of patching around it, refused to pad weak results, wrote its own tests and got to 12/12 green, and said UNVERIFIED when it couldn't confirm something"
Der fairste einzelne Kommentar, den ich las, ging um Zeit, nicht um Tokens. Günstige Modelle, die doppelt so lange brauchen, sind bei der Arbeit schwer zu verkaufen:
"For a hobby project I do not mind that a cheaper model takes twice as long but at work it's hard to justify using a "cheaper" model if the time per task is so much higher than the frontier models."
Was sind die Vor- und Nachteile?
Vorteile
- Pauschalpreis von
$0.15/$0.60über 1M Tokens, ohne Langkontext-Stufe. - Bester Automation-Bench-Wert in MiniMax' Tabelle und Gleichstand mit Opus 5 bei BankerToolBench.
- 200+ Tokens pro Sekunde angegeben, etwa dreimal so viel wie M3.
- Funktioniert mit Clients im Anthropic- und OpenAI-Stil, sodass Claude Code, Codex, Cursor und OpenClaw darauf zeigen können.
- Offene Gewichte für den 23. Oktober versprochen.
Nachteile
- Liegt bei fünf von sechs gemeinsamen Benchmarks hinter DeepSeek V4.1 Flash 1017, darunter jeder Coding-Test.
- Gecachter Input kostet das Fünffache des Nebenzeit-Tarifs von DeepSeek.
- Thinking lässt sich nicht abschalten, und der Standard ist
max, wo Tester Trägheit und Abdriften melden. - 428 Mrd. Parameter insgesamt, lokale Nutzung braucht also eine große Maschine.
- Der M Plan ist für den persönlichen Gebrauch, Produktionsverkehr läuft daher über Pay-as-you-go-Schlüssel.
Welches günstige Modell passt zu Ihrer Aufgabe?
Wählen Sie die Aufgabe, die Sie ausführen wollen. Das Widget zeigt das Modell, mit dem ich beginnen würde, und warum.
Wer sollte es nutzen, und wer sollte es auslassen?
Nutzen Sie es, wenn Sie Agenten-Schleifen über Business-Tools, Tabellen oder lange Dokumente laufen lassen und auf die Kosten pro Aufgabe achten. Die Ergebnisse bei Automation-Bench und BankerToolBench zeigen direkt auf diese Arbeit, und der Pauschalpreis macht lange Kontexte schmerzlos. Es passt auch zu Entwicklern, die bereits in MiniMax Code arbeiten und ein schnelles Standardmodell wollen.
Lassen Sie es vorerst aus, wenn Ihre Hauptaufgabe harte Repo-Arbeit ist. DeepSeek V4.1 Flash 1017 erzielt in jeder Coding-Zeile der Tabelle höhere Werte, zum selben Preis außerhalb der Spitzenzeiten, und Qwen 3.8 Flash Next wird bei Leuten, die selbst hosten, oft genannt.
Wenn Sie ein Frontier-Modell wollen und dafür zahlen können, sind GPT-6 Sol und Claude Opus 5.5 weiterhin eine Klasse darüber.
Warten Sie, wenn Sie es selbst betreiben möchten. Die Gewichte sind für den 23. Oktober fällig, und die Größe bedeutet, dass Sie eine große Multi-GPU-Maschine oder einen Rechner mit großem Unified Memory brauchen.
Was bedeutet es für ein Support-Team?
AutomationBench führt den Kundenservice unter seinen Workflows auf, es ist also verlockend, einen hohen Score als „bereit für meine Warteschlange“ zu lesen. Das würde ich nicht tun. Ein Benchmark prüft, ob das Modell eine geskriptete Aufgabe erledigt hat. Ihre Warteschlange fragt, ob die Antwort für diesen Kunden richtig war, nach Ihrer Richtlinie, mit Ihren Erstattungsregeln, und ob das Modell wusste, dass es ein Ticket in Ruhe lassen soll.
Wenn Sie Ihren eigenen Support-Ablauf auf M3.1 Flash aufbauen, bleibt Folgendes bei Ihnen:
- Die Wissens-Pipeline, die ihm Ihr Help Center und frühere Tickets liefert.
- Die Helpdesk-Anbindung, die Tickets liest und Antworten schreibt.
- Die Regeln, wann übergeben wird, der Kern von Tier-1-Deflection.
- Tests mit echter Historie, womit Sie Halluzinationen im Support aufspüren.
Nichts davon ist ein Modellproblem, weshalb ein günstigeres Modell eine Zeile der Rechnung senkt, nicht das Projekt. Der Leitfaden zu den Kosten von KI im Kundenservice behandelt den Rest, und die Aufschlüsselung zu KI- vs. menschlichen Agenten-Kosten ordnet es ein.
Wie passt eesel zu M3.1 Flash?
MiniMax M3.1 Flash ist Infrastruktur. eesel ist der Mitarbeiter. eesel ist eine Plattform für KI-Teammitglieder, auf der Sie einsatzbereite Teammitglieder für bestimmte Aufgaben einstellen, und im Support ist das das KI-Helpdesk-Teammitglied. Es schließt sich der Warteschlange an, die Sie bereits betreiben, etwa Zendesk oder Freshdesk, lernt aus Ihrem Help Center und früheren Tickets und spielt historische Tickets nach, damit Sie seine Antworten sehen, bevor es ein Kunde tut.
So sieht das im großen Maßstab aus. smava, eine Berliner Kreditvergleichsplattform, betreibt drei eesel-Agenten auf einem Zendesk für zwei Marken: einer kategorisiert jedes Ticket, einer entwirft die Antwort aus rund 820 Makros und Help-Center-Artikeln, und einer pro Marke bereitet die kundenfertige Antwort vor. Zwischen dem 8. August und dem 8. September 2026 waren das rund 27,000 Tickets, wobei Menschen die Entwürfe freigaben. SE Ranking betreibt für jedes seiner drei Produkte einen eigenen Agenten im Zendesk-Live-Chat, rund 4,650 Gespräche in einem Monat, wobei Erstattungen und Tier-2-Fälle mit den Kundendaten an das Team übergeben werden.

Wenn Sie zu den Entwicklern gehören, die einen Modelltest lesen, wollen Sie wahrscheinlich das Terminal. Die eesel CLI (@eesel/cli) steuert dasselbe Teammitglied, das Sie im Dashboard sehen. eesel integrations connect zendesk verbindet einen Helpdesk, eesel files upload fügt Wissen hinzu, eesel instructions bearbeitet die festen Regeln, eesel approvals listet Aktionen auf, die auf einen Menschen warten, und eesel activity zeigt, was der Agent getan hat. Jeder Befehl gibt JSON aus, sodass Claude Code oder Cursor das Setup für Sie ausführen können, und jeder Workspace funktioniert auch als MCP-Server. Der Leitfaden zur Agenten-CLI zeigt das Muster.
Um Support-Optionen nebeneinander zu vergleichen, beginnen Sie mit der Liste der besten Kundenservice-Agenten oder dem breiteren Plädoyer für KI-Teammitglieder.
eesel ausprobieren
Nutzen Sie M3.1 Flash dort, wo es glänzt: günstige, schnelle Agenten-Schleifen, die Sie prüfen können. Wenn Sie nächste Woche KI brauchen, die Tickets in Ihrem Helpdesk beantwortet, dockt das KI-Helpdesk-Teammitglied von eesel an das Tool an, das Sie bereits nutzen, lernt aus Ihren früheren Tickets und zeigt, wie es diese beantwortet hätte, bevor ein Kunde eine Antwort sieht. So kommt smava auf 15,300 Entwürfe im Monat, ohne die Kontrolle aus der Hand zu geben. Testen Sie eesel kostenlos und lassen Sie es zuerst auf Ihrer eigenen Ticket-Historie laufen, oder sehen Sie sich die eesel-Preise an, bevor Sie starten.