

llama.cpp v1.0.0 erschien am 13. November 2026, und die Schlagzeile ist ein Versprechen, kein Geschwindigkeitssprung: eine Breaking Change an der öffentlichen C-API bedeutet jetzt einen Major-Versionssprung. Das zählt am meisten, wenn du auf libllama baust. Server-Nutzer merken zuerst die Sicherheit: llama-server verweigert jetzt, Tools auf einer Netzwerkadresse ohne API-Key offenzulegen. Installiere es mit einer Zeile von llama.app, oder nutze die neue 1-MB-Llama-App. Willst du stattdessen KI auf deiner Support-Warteschlange? eesel betreibt das auf hosteten Modellen, und die eesel-CLI lässt einen Coding-Agenten Hilfeartikel hochladen und Antworten vorab testen.
Was ist llama.cpp?
llama.cpp ist eine Open-Source-Engine, die große Sprachmodelle und Vision-Modelle auf deiner eigenen Hardware ausführt, geschrieben in reinem C/C++ ohne Abhängigkeiten. Das README beschreibt das Ziel als LLM-Inferenz "mit minimalem Setup und modernster Performance auf einer breiten Palette von Hardware", lokal und in der Cloud.
Ein paar Zahlen geben die Größenordnung. Das GitHub-Repo steht bei 135,055 Sternen und 25,608 Forks unter der MIT-Lizenz, wurde am 10. März 2023 erstellt, und die v1.0-Ankündigung sagt, es unterstütze jetzt mehr als 150 Modellarchitektur-Varianten. Das Projekt wird von ggml-org geführt, dem Team um Georgi Gerganov, das zu Hugging Face gehört.
Ich baue Integrationen und APIs für eesels Produkt, deshalb interessiert mich das Launch-Banner weniger als das, was eine Versionsnummer mit Code macht, der darauf aufbaut. Das ist die Linse für diesen ganzen Beitrag. Ich habe die Release Notes, die Versionierungs-Policy und die Pull Requests hinter den Änderungen gelesen; ich habe es nicht selbst auf meiner Maschine gebenchmarkt, also stammen die Geschwindigkeitsangaben unten aus den eigenen Zahlen der Maintainer.
Der Kern-Engine darunter ist ggml, eine Tensor-Bibliothek mit Backends für nahezu jeden Chip, den du nennen kannst:
| Backend | Läuft auf |
|---|---|
| Metal | Apple Silicon |
| CUDA | NVIDIA-GPUs |
| HIP | AMD-GPUs |
| Vulkan | Die meisten GPUs |
| SYCL | Intel-GPUs |
| OpenCL | Qualcomm Adreno GPUs |
| Hexagon | Snapdragon |
| CANN | Huawei Ascend NPUs |
| WebGPU | Browser und jedes WebGPU-fähige Gerät |
| CPU (AVX, NEON, RVV) | x86, Arm und RISC-V |
Diese Reichweite ist der Grund, warum so viele lokale KI-Tools darauf aufbauen. Wenn du eine Desktop-Chat-App für offene Modelle genutzt hast, lief im Hintergrund mit guter Chance llama.cpp. Es ist auch der Grund, warum Open-Weight-Modelle wie Gemma 4 und Qwen3.8-Flash-Next am ersten Tag meist GGUF-Dateien ausliefern, das llama.cpp-Modellformat.
Was verspricht das v1.0-Label wirklich?
Es verspricht stabile Grenzen, keine neuen Features. In der Ankündigung auf Hugging Face sagt das Team, dass sowohl llama.cpp als auch ggml "API- und ABI-Inkompatibilitäten mit Major-Versionssprüngen widerspiegeln werden". Die Regeln gelten jetzt für jedes ggml-org-Projekt:
| Versionssprung | Wann es passiert |
|---|---|
| Major (2.0.0) | Breaking Change an der öffentlichen C-API in ./include |
| Minor (1.1.0) | Abwärtskompatibles Feature, Backend-Update, neue Modellunterstützung oder API-Ergänzung |
| Patch (1.0.1) | Bugfix ohne API-Änderung |
Das übersieht die meiste Berichterstattung: Das Versprechen gilt für die öffentlichen C-Header, libllama und libggml. Es sagt nichts über die Kommandozeilen-Flags von llama-server, die Web-UI oder die Desktop-App. Dieser Unterschied entscheidet, ob v1.0 für dich überhaupt etwas ändert.
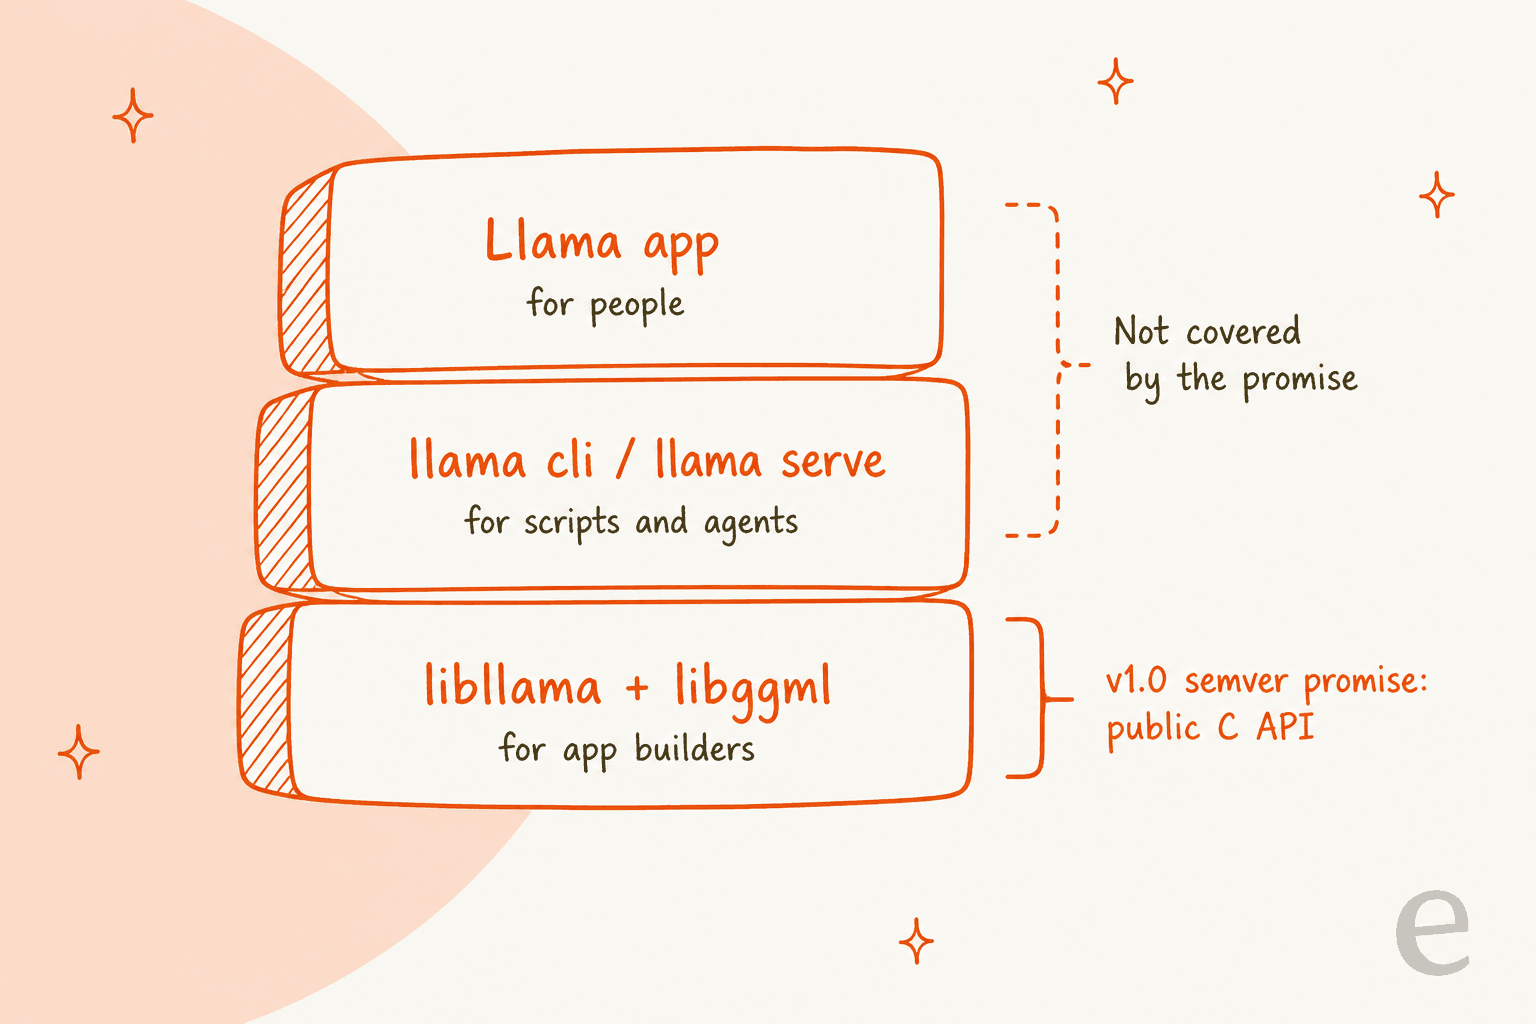
Wenn du llama.cpp in eine App einbettest, ist das die Version, auf die du drei Jahre gewartet hast. Auch Packager wollten das. In der Versionierungs-Diskussion schrieb jemand, der es für Debian paketiert, dass semantische Versionierung "es uns in Debian erlaubt, es als Bibliothek in öffentlichen Suchpfaden auszuliefern", weil Breaking Changes jetzt über Bibliotheks-Versionssprünge signalisiert werden können. So hört llama.cpp auf, etwas zu sein, das du in dein Repo vendorst, und wird zu einer Systembibliothek.
Wenn du Modelle nur über einen Server oder eine App betreibst, ist v1.0 vor allem ein Aufräum-Meilenstein. Nützlich, aber kein Grund, deinen Stack neu zu bauen.
Nightly-Builds laufen weiter
Ein Detail bringt Leute durcheinander. llama.cpp veröffentlicht weiterhin Nightly-Builds, benannt nach Commit-Anzahl wie b12387, und hat allein am 14. November fünf davon veröffentlicht, laut der Releases-Seite. Der v1.0.0-Tag ist ein separater, langsamerer Track. Die Versionierungs-Notizen sagen, ein Release-Tag wird nur geschnitten, wenn llama.cpps interne ggml-Kopie zum veröffentlichten ggml passt, sodass alles, was aus dem Tag gebaut wird, sicher gegen ein systemweites ggml linken kann.
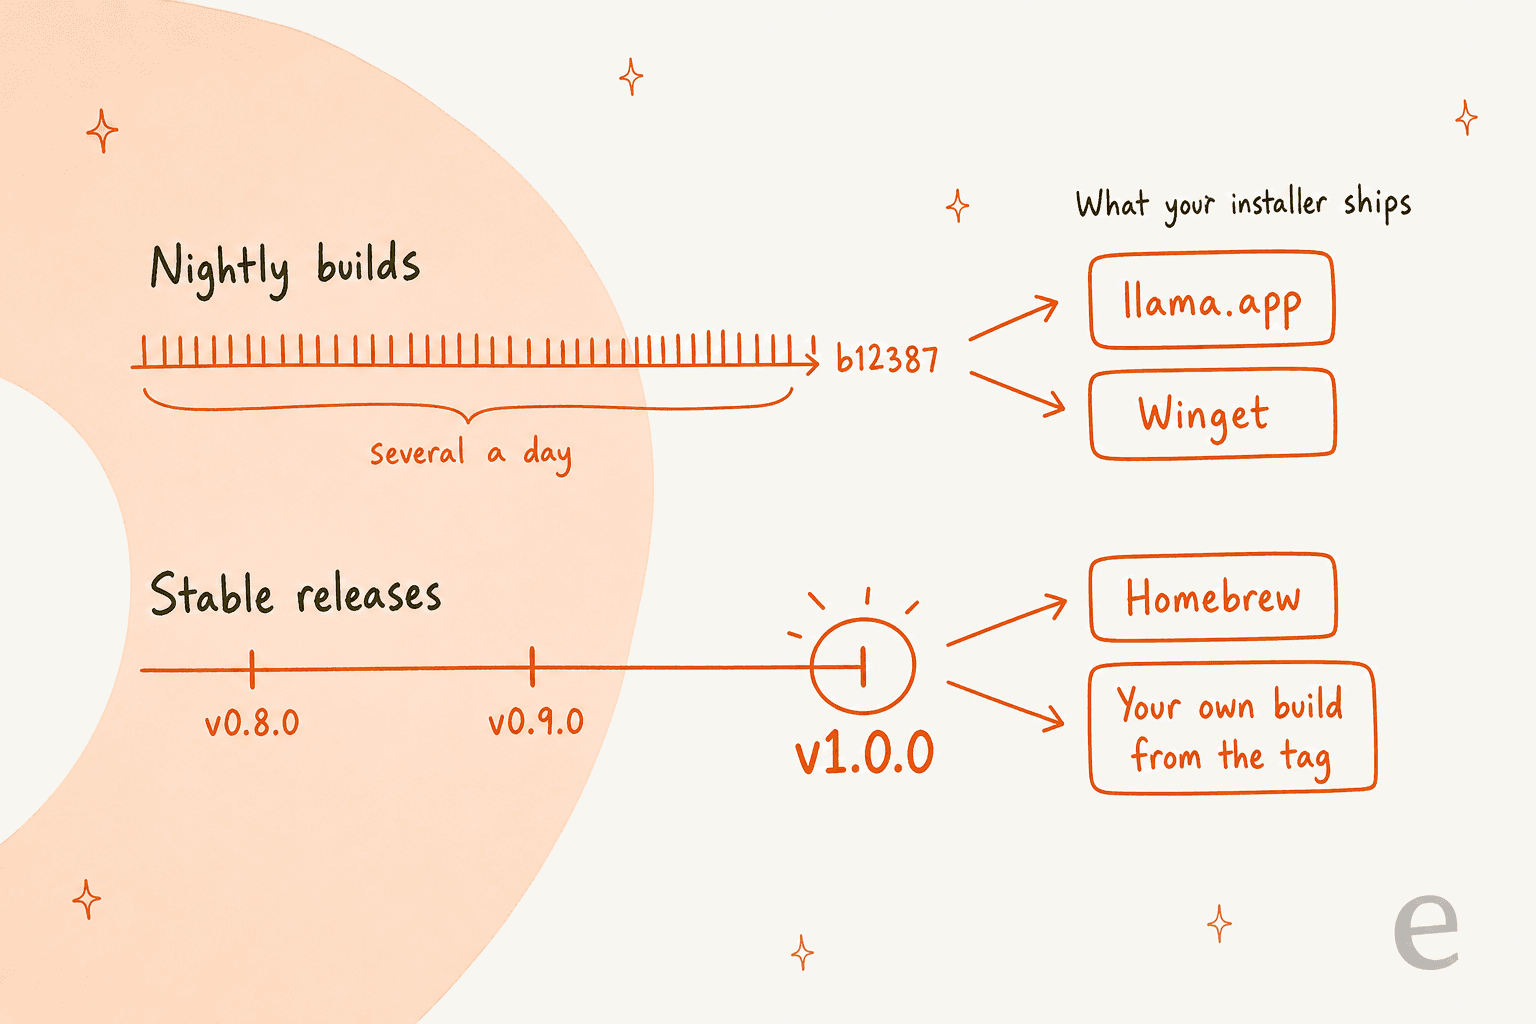
Welcher Track dich betrifft, hängt davon ab, wie du installiert hast. Laut diesen selben Notizen veröffentlichen der llama.app-Installer und Winget die Nightly-Builds, nicht die offiziellen Releases (als TODO zum Umschalten markiert), während die Homebrew-Formel jetzt vom Release-Tag baut. "Ich bin auf v1.0" stimmt also nur, wenn du es geprüft hast.
Was hat sich in llama.cpp v1.0.0 geändert?
Die Release Notes umfassen Hunderte von Commits seit v0.9.0. Das sind die Änderungen, die zählen, gruppiert danach, wen sie betreffen.
| Bereich | Änderung | Wen es betrifft |
|---|---|---|
| C-API | Entfernt llama_set_warmup, 35 veraltete Funktionen und --defrag-thold; verschiebt die NextN-API (spekulatives Decoding) von llama-ext.h nach llama.h | Jeden, der libllama einbindet |
| Memory | FP8-KV-Caches über -ctk/-ctv f8_e4m3 | Nutzer mit langem Kontext und wenig VRAM |
| Memory | Host-Memory-MoE-Expert-Cache mit konfigurierbarem CPU-Anteil | Große Mixture-of-Experts-Modelle auf kleinen GPUs |
| Modelle | Kimi-K3.1-Pro, Ripple-65B-Preview, xing4_0, drama-3 TTS; Kimi-K3.1 und MageVL-Cowork Vision | Jeden, der neue offene Modelle ausprobiert |
| Server | /v1/audio/speech-Endpunkt; Sicherheits-Fixes für CORS, DNS-Rebinding und SSRF | Jeden, der llama-server betreibt |
| Web-UI | Chat-Gruppen, Live-Markdown-Editor, Handy-Layout, PDF-Thumbnails | Leute, die den eingebauten Chat nutzen |
Neue Modelle am ersten Tag
Die neuen Architekturen passen zu aktuellen Launches, die ich schon behandelt habe: Kimi-K3.1-Pro, das die Notizen als K3 beschreiben, bei dem die Full-Attention-Schichten gegen DSA ausgetauscht wurden, und Ripple-65B, hinzugefügt als neue dichte 65B-Architektur. Wenn du meine Kimi-K3-Review oder die Ripple-65B-Review gelesen hast: Das sind dieselben Modelle, jetzt lokal aus GGUF-Dateien lauffähig.
FP8-KV-Caches
Der KV-Cache ist der Speicher, den ein Modell nutzt, um sich an das bisherige Gespräch zu erinnern, und bei langen Kontexten kann er so groß wie das Modell selbst werden. PR #28392 bringt OCP-FP8-Caches mit optionalen Per-Tensor-Skalen. Nicht jeder weiß schon, welche 8-Bit-Option er wählen soll:
"Sounds like now, 8 bit KV cache is ok for coding, but the question is which one? I see f8_e4m3, q8_0. Would be great to get more info about that."

Meine Einschätzung: Die Release Notes beantworten das nicht, also teste beide an einer langen Session deiner eigenen Arbeit, bevor du ein Coding-Setup umstellst.
Der MoE-Expert-Cache
Das ist die Änderung, die ich am meisten im Auge hätte. Mixture-of-Experts-Modelle nutzen pro Token nur einen Teil ihrer Gewichte, also hält PR #30966 die heißen Experten im GPU-Speicher und kann Cache-Misses auf der CPU ausführen. Der Tuning-Lauf des Autors auf Qwen3.8-Flash-Next zeigt, warum der CPU-Anteil wichtig ist: Mit einem 6.464-MiB-Cache stieg das Decoding von 24,2 Tokens pro Sekunde ohne CPU-Anteil auf 47,6 mit einem Anteil von 0,95. Mit einem größeren 19.392-MiB-Cache drehen sich die Zahlen um, und ein hoher CPU-Anteil wird langsamer. Der PR liefert ein Tuning-Skript, scripts/moe-cache-tune.py, um deinen eigenen Sweet Spot zu finden, statt zu raten.
Das ist derselbe Trick hinter Single-GPU-Giganten wie Edge0-145B, jetzt fest in die Haupt-Engine eingebaut.
Was hat sich bei der llama-server-Sicherheit geändert?
Das ist die Änderung, die am ehesten ein funktionierendes Setup am Upgrade-Tag kaputt macht. PR #32113 bedeutet, dass Tools oder MCP mit einem Nicht-Loopback---host ohne API-Key jetzt mit einem Fehler verweigert werden. Du musst --api-key ergänzen oder dich explizit mit --allow-unauthenticated-tools dafür entscheiden.
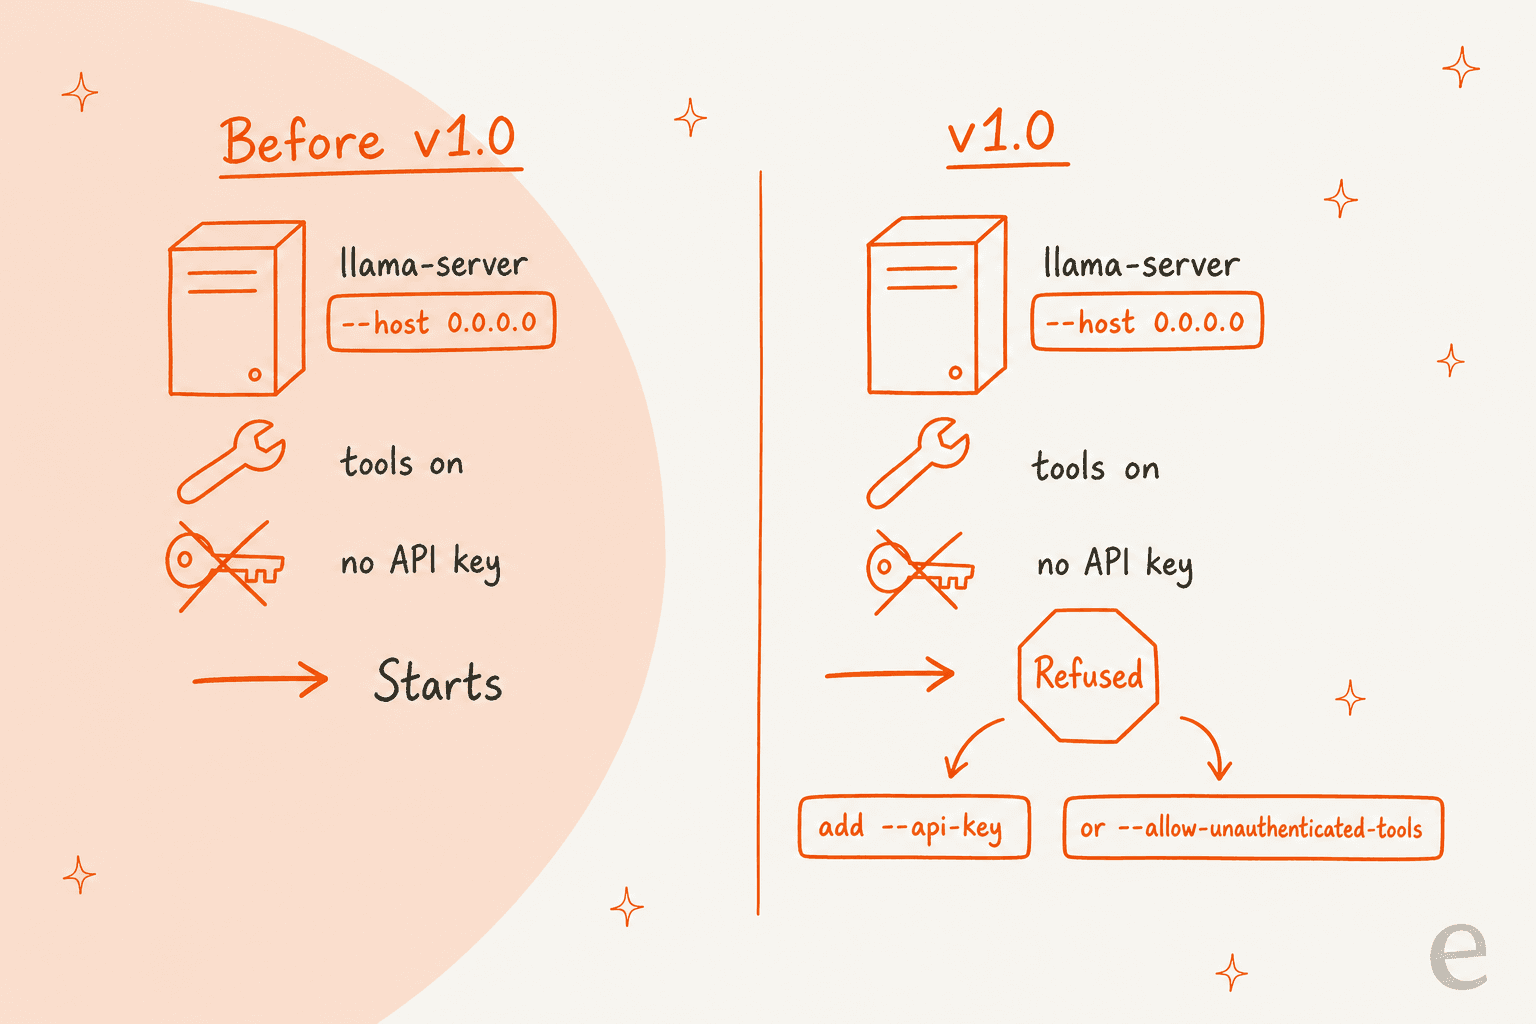
Der Maintainer, der das geschrieben hat, war in der PR-Beschreibung offen über den Tradeoff:
"None of those are actually vulnerability, but since people nitpick this too much, we now forced to hurt the UX a bit"
Ich würde trotzdem die strengere Voreinstellung nehmen. Tools in llama-server können Dateien lesen und Shell-Befehle ausführen, und das eingebaute Set in der Web-UI enthält read_file, exec_shell_command und write_file. Das offen in einem LAN ohne Key zu lassen, ist die Art von Setup, die so lange gut geht, bis jemand anderes im WLAN es findet. Das gleiche Release schränkt außerdem den HF_TOKEN auf huggingface.co-Hosts ein, behebt die Behandlung von --cors-origins und DNS-Rebinding, bringt ein Opt-in --media-allow-private-urls und bricht MCP-Tool-Aufrufe ab, wenn ein Client die Verbindung trennt.
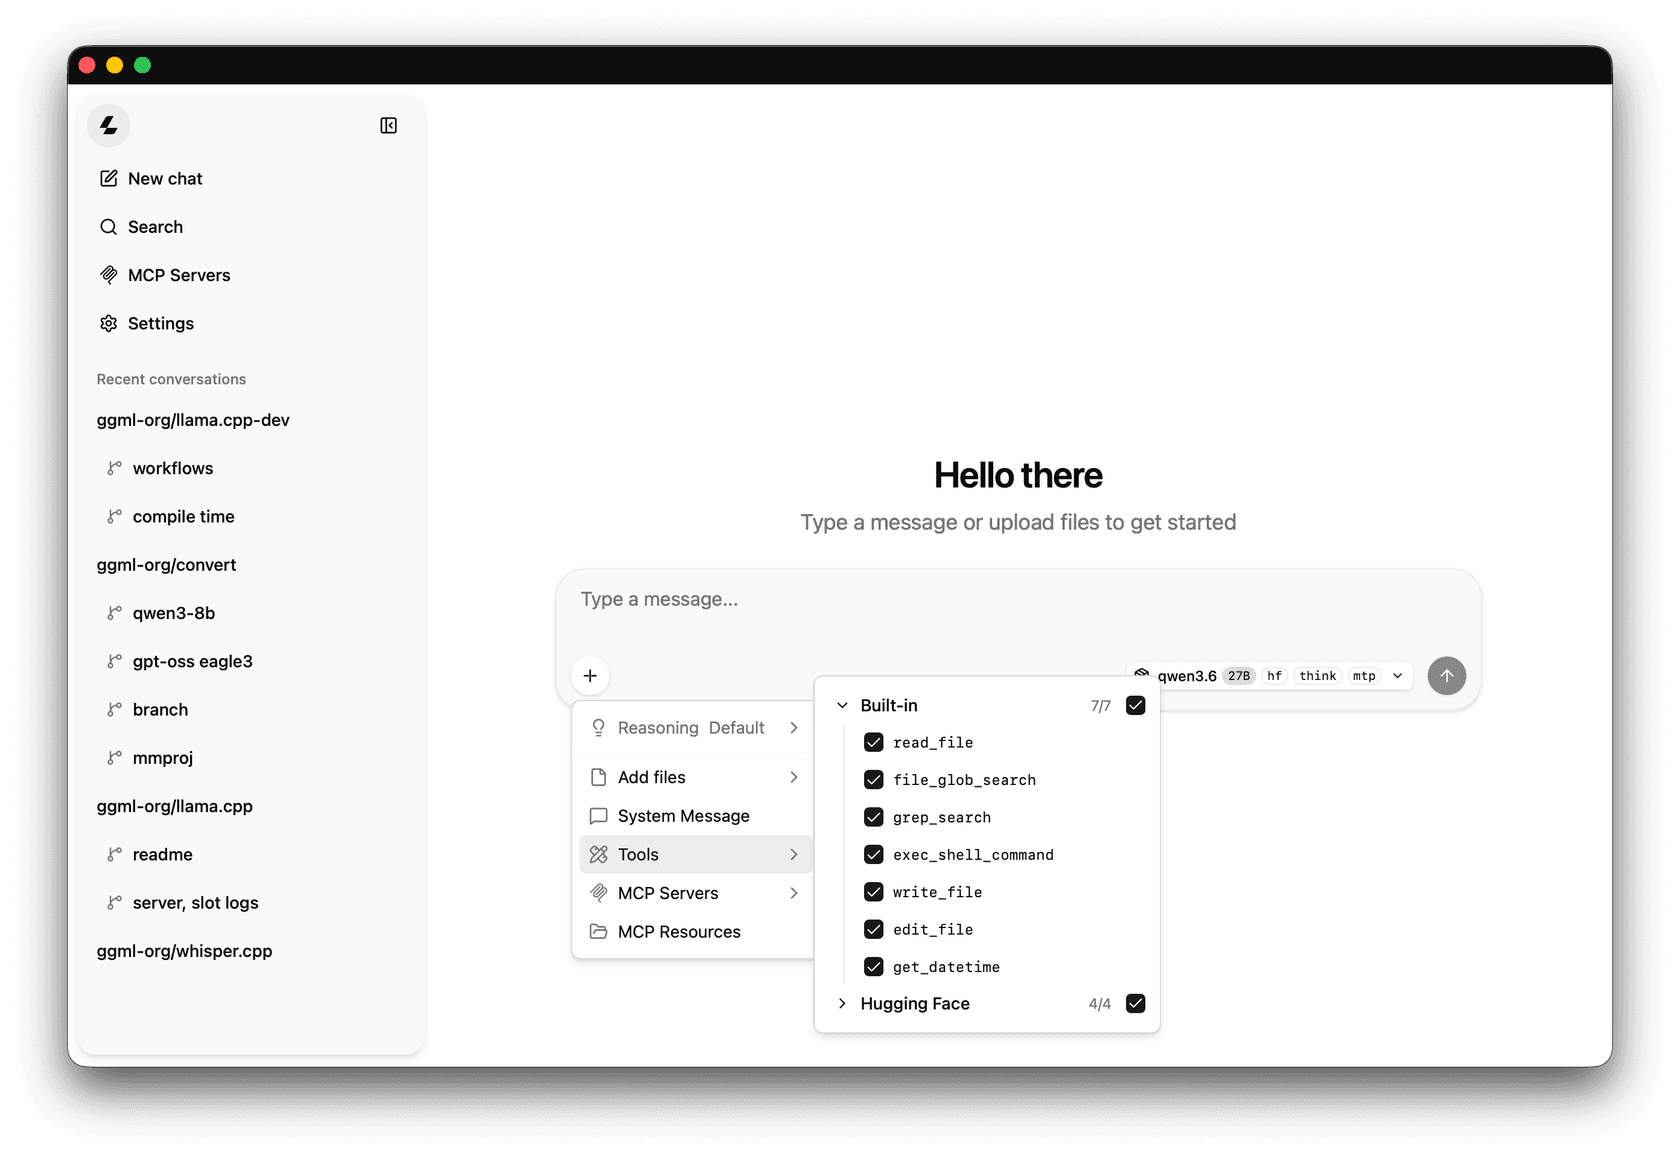
Wenn du ein lokales Modell in etwas einbaust, das Aktionen ausführen kann, behandeln meine Notizen zu MCP-Servern für KI-Agenten und Sicherheit in Claude Code dasselbe Prinzip: Toolzugriff ist die eigentliche Angriffsfläche, nicht das Modell.
Ändert llama.cpp v1.0 etwas für dich?
Wähle, wie du es nutzt, und du bekommst die Kurzversion.
Wie nutzt du llama.cpp?
--host und aktivierten Tools oder MCP läufst, verweigert v1.0 den Start ohne --api-key. Ergänze lieber einen Key statt --allow-unauthenticated-tools. Prüfe auch jeden --cors-origins-Wert erneut, da der Port jetzt strikt validiert wird.llama_set_warmup und 35 veralteten Funktionen, benenne llama_set_embd_state_src in llama_set_ctx_state_src um, und pinne auf v1.x. Von hier an bedeutet eine Breaking Change an der C-API ein 2.0.libggml linken und Bibliotheks-Versionssprünge nutzen, um Breaking Changes zu signalisieren.Wie installierst und betreibst du llama.cpp?
Es gibt drei Wege, und der neue ist der freundlichste. Alle Befehle unten stammen aus dem README und llama.app.
1. Die Llama-Desktop-App (Mac und Windows). Das gleiche Team liefert jetzt Llama, eine Menüleisten-App für Mac und eine Taskleisten-App für Windows 11. Die Seite listet sie als 1-MB-Download, 4 MB installiert, kostenlos, Open Source und offline-fähig. Sie prüft deine Hardware und wählt Quantisierung, Kontextgröße und spekulatives Decoding für jedes Modell, und Modelle werden nach fünf Minuten Leerlauf entladen.
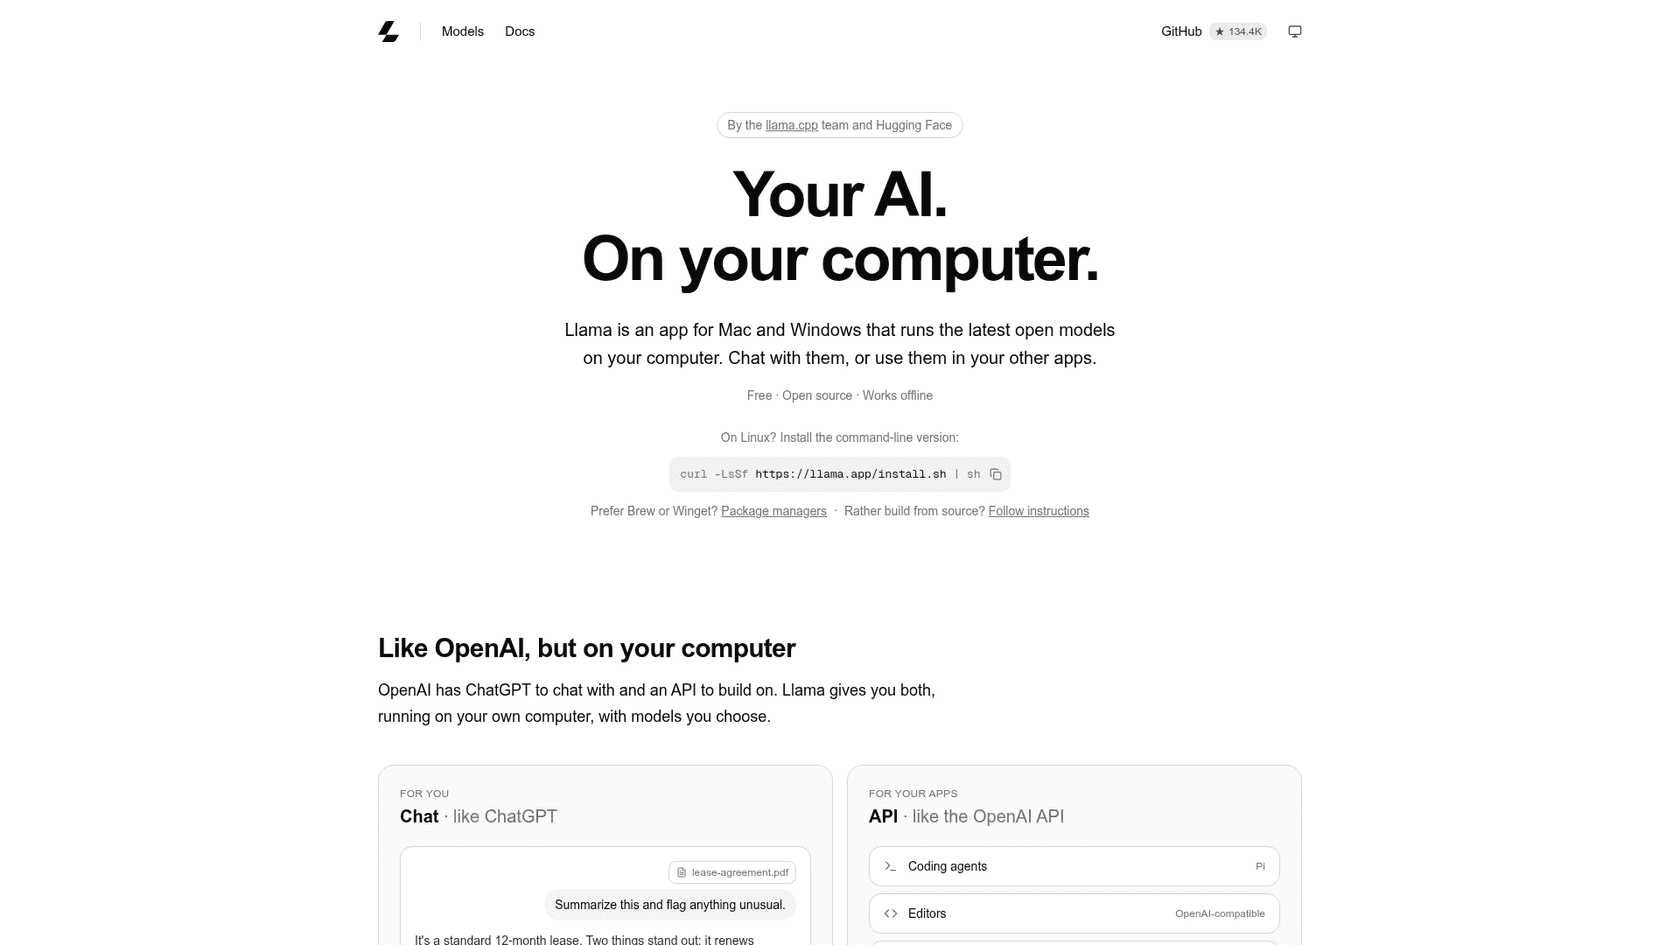
Sie schlägt ein Startmodell nach Speicher vor: Gemma 4 für einen 16-GB-Mac, GPT-OSS bei 24 GB, und Qwen 3.8 bei 32 GB. Auf dem Mac kannst du sie auch mit brew install --cask llama-app installieren.
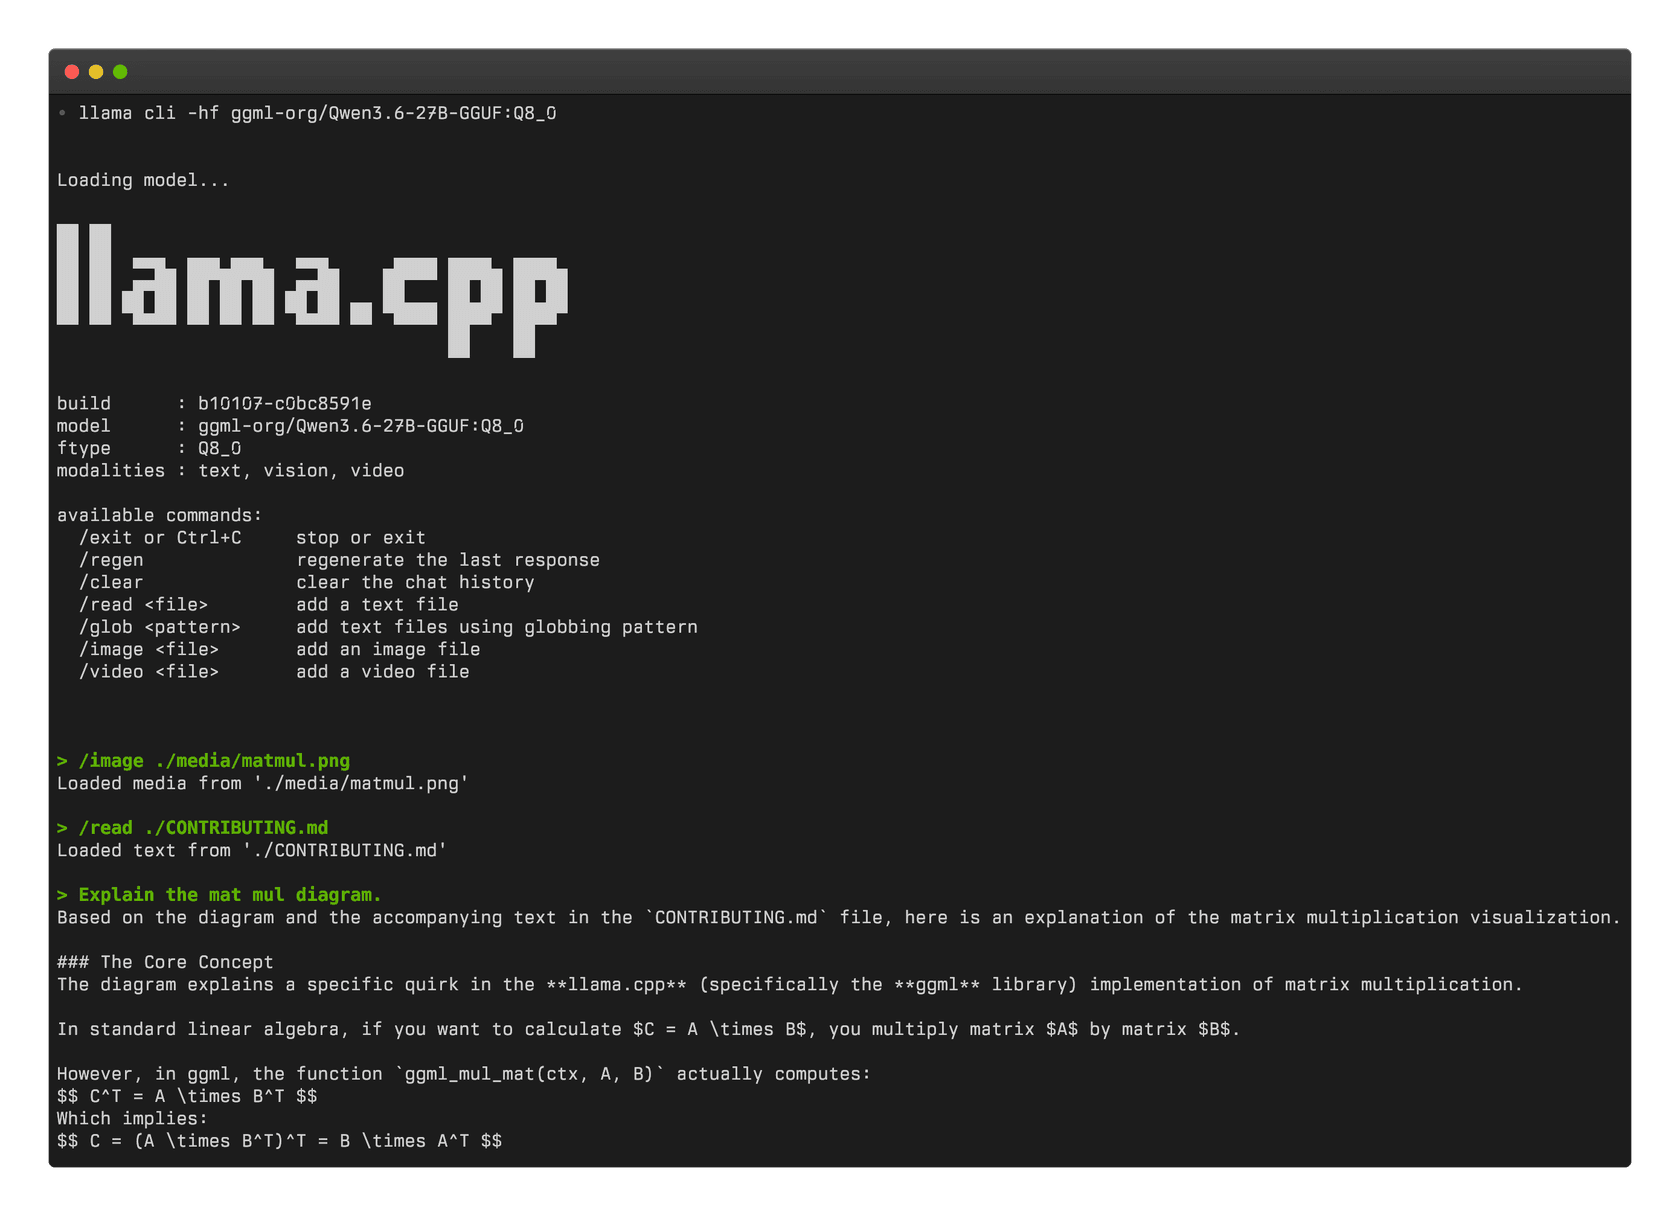
2. Die Kommandozeile (jedes Betriebssystem). Eine Zeile installiert das einheitliche llama-Binary:
curl -LsSf https://llama.app/install.sh | sh
In Windows PowerShell ist es irm https://llama.app/install.ps1 | iex. Dann lädst du ein Modell von Hugging Face und chattest, oder startest einen OpenAI-kompatiblen Server:
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
3. Paketmanager oder Quellcode. Die v1.0-Ankündigung listet Docker, Debian, Homebrew, conda-forge, MacPorts, Winget und ein XCFramework für iOS und macOS, plus vorgefertigte Binärdateien für Linux, macOS, Windows, Android und iOS. Das Bauen aus dem Quellcode ist im Build-Guide beschrieben.
Coding-Agenten darauf lenken
Die Llama-App stellt ihre API auf localhost:9931/v1 bereit, und laut der Seite spricht sie sowohl OpenAI- als auch Anthropic-kompatible Endpunkte, mit Streaming, Tool-Calling, strukturierter Ausgabe und Vision. Das heißt, Tools wie Cursor, OpenClaw oder Claude Code können auf ein lokales Modell zeigen, indem sie nur die Base-URL ändern, das gleiche Muster, das ich in meinem Leitfaden zu Claude-Code-Umgebungsvariablen beschrieben habe. Ich bin diesen Weg selbst nicht auf v1.0 gelaufen, behandle es also als die dokumentierte Route.
Ein schneller Realitätscheck zur Qualität: Ein kleines lokales Modell kommt bei harter Coding-Arbeit nicht an ein hostetes Frontier-Modell heran. Meine Vergleiche von DeepSeek V4 Flash und Qwen 3.8 Max sind ein besserer Leitfaden dafür, was jede Stufe kann.
Was fehlt noch?
Drei Lücken stechen aus dem Release und den Reaktionen darauf hervor.
- Keine Linux-Desktop-App. Llama ist nur für Mac und Windows; Linux-Nutzer bekommen die Kommandozeile. Ein Kommentator bei der Ankündigung hat genau danach gefragt.
- Prompt-Verarbeitung bei riesigen Eingaben. Ein anderer Kommentator beim selben Beitrag sagte, llama.cpp "braucht noch Verbesserung bei riesiger Prompt-Verarbeitung", also beim Prefill-Schritt vor dem ersten Token. Das Release hat Prefill-Arbeit (ein Intel-Vulkan-FlashAttention-Pfad, Few-Row-CUDA-Matmuls), aber keine Schlagzeilen-Zahl, auf die man zeigen könnte.
- Die Installer sind noch nicht auf v1.0. Wie oben erwähnt, liefern der llama.app-Installer und Winget noch Nightlies. Das ist für die meisten Nutzer in Ordnung, bedeutet aber, dass v1.0s Stabilitätsversprechen dich nur erreicht, wenn du vom Tag baust oder Homebrew nutzt.
Keiner dieser Punkte ist ein Grund, es zu überspringen. Es sind Gründe, zu prüfen, auf welchem Build du bist, bevor du dich auf das Versprechen verlässt.
Was bedeutet llama.cpp für Support-Teams?
Der Reiz ist offensichtlich: Kundendaten, die deine Hardware nie verlassen, und keine Pro-Token-Rechnung. Das ist ein Thema, das mir in eesels Verkaufsgesprächen begegnet. Ein Käufer bei einem dänischen B2B-Telematik-Unternehmen musste vor jedem Test eine harte interne Sicherheitsprüfung bestehen, und ihre erste Frage war, ob Ticketdaten mit Kartennummern und Passwörtern in ihrer Umgebung bleiben würden.
Ein lokales Modell beantwortet einen Teil davon. Es beantwortet nicht den Rest: welche Hilfeartikel der Agent nutzen darf, wann er ein Ticket an eine Person übergibt, wie du weißt, dass er richtig liegt, bevor Kunden es sehen. Das sind die Fragen hinter den meisten KI-Support-Sicherheitsprüfungen, die ich gesehen habe, und die Vendor-Sicherheits-Checkliste und der SOC-2-und-DSGVO-Leitfaden behandeln sie im Detail.
Diese Schicht ist der Job von eesels KI-Helpdesk-Teammitglied. Es tritt der Warteschlange bei, die du schon in Zendesk oder Freshdesk betreibst, antwortet aus deinem eigenen Wissen und wird vor dem Livegang an vergangenen Tickets simuliert. smava, ein Berliner Kreditvergleichs-Unternehmen, nutzt es auf 27.000 Zendesk-Tickets pro Monat, mit 15.300 Entwurfsantworten, vorbereitet in Deutsch aus 820 Makros und Help-Center-Artikeln. SE Ranking betreibt einen eesel-Agenten pro Produkt in Zendesk, mit Rückerstattungen und Anfragen nach einer Person, die ans Team übergeben werden.
Wenn du Modelle für deinen eigenen Support-Content abwägst, gehen meine Leitfäden zu Claude am Helpdesk, zu KI-Agent-Übergaben und zum Verhindern von KI-Halluzinationen im Support weiter, als eine Release-Notiz es kann.
Solltest du auf llama.cpp v1.0 upgraden?
Ja, wenn du libllama einbindest: Das ist das erste Release mit einem schriftlichen Kompatibilitätsversprechen, also pinne auf v1.x und hör auf, Breaking Changes in Nightly-Builds zu jagen. Mach das Aufräumen einmal, und du bist fertig.
Ja, vorsichtig, wenn du llama-server in einem Netzwerk betreibst: Füge einen API-Key hinzu, bevor du upgradest, damit der neue Tool-Check deinen Dienst nicht stoppt.
Kein Handlungsbedarf, wenn du eine Desktop-App nutzt. Du bist wahrscheinlich schon auf einem Nightly-Build, der alles aus v1.0 enthält, und die neue Hugging-Face-Llama-App ist der einfachste Weg, lokale Modelle auszuprobieren, falls du es noch nicht getan hast. Für hostete Alternativen sind meine Übersicht zu Hugging-Face-Alternativen und meine Liste der LLM-Tracking-Tools gute nächste Lektüre.
Probiere eesel für KI auf deiner Support-Warteschlange
Wenn du dir llama.cpp angesehen hast, weil du KI willst, die Kunden antwortet, bringt dich eesel dorthin, ohne dass du eine Quantisierung wählen oder eine GPU dimensionieren musst. Es ist ein KI-Helpdesk-Teammitglied, das sich in Zendesk, Freshdesk und andere Helpdesks einklinkt, nur aus deinem Help Center und vergangenen Tickets antwortet und an historischen Konversationen getestet wird, bevor es eine Live-Konversation berührt, so wie smava es auf 27.000 Tickets pro Monat betreibt. Mit der eesel-CLI kann dein Coding-Agent exportierte Hilfeartikel und Makros hochladen, Testfragen stellen und die Antworten prüfen; das Anbinden des Helpdesks selbst braucht trotzdem jemanden mit Admin-Zugriff. Probiere eesel kostenlos.
Häufig gestellte Fragen
Was ist llama.cpp?
Was hat sich in llama.cpp v1.0.0 geändert?
Ist llama.cpp kostenlos?
Wie installiere ich llama.cpp?
curl -LsSf https://llama.app/install.sh | sh aus, auf Windows irm https://llama.app/install.ps1 | iex. Homebrew, Winget, Docker, conda-forge und vorgefertigte Binärdateien funktionieren ebenfalls. Danach lädt llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF ein Modell von Hugging Face und startet einen Chat.Bricht llama.cpp v1.0 mein bestehendes Setup?
llama_set_warmup und die Option --defrag-thold weg. Wenn du llama-server auf einer Netzwerkadresse mit aktivierten Tools oder MCP ohne API-Key betreibst, startet v1.0 erst gar nicht, bis du --api-key ergänzt oder dich mit --allow-unauthenticated-tools explizit dafür entscheidest. Mein Leitfaden zu MCP im Kundensupport erklärt, warum Toolzugriff diese Hürde verdient.Was ist der Unterschied zwischen llama.cpp und der Llama-App?
localhost:9931/v1 bereitstellt. Tools wie Claude Code oder OpenClaw können auf diesen lokalen Endpunkt zeigen.Kann llama.cpp einen Kundensupport-Chatbot betreiben?
Ist llama.cpp v1.0 die Version, die ich vom Installer bekomme?
llama --version, und schau in meinem Beitrag zu Hugging-Face-Preisen nach, wenn du Modelle selbst hosten willst.