

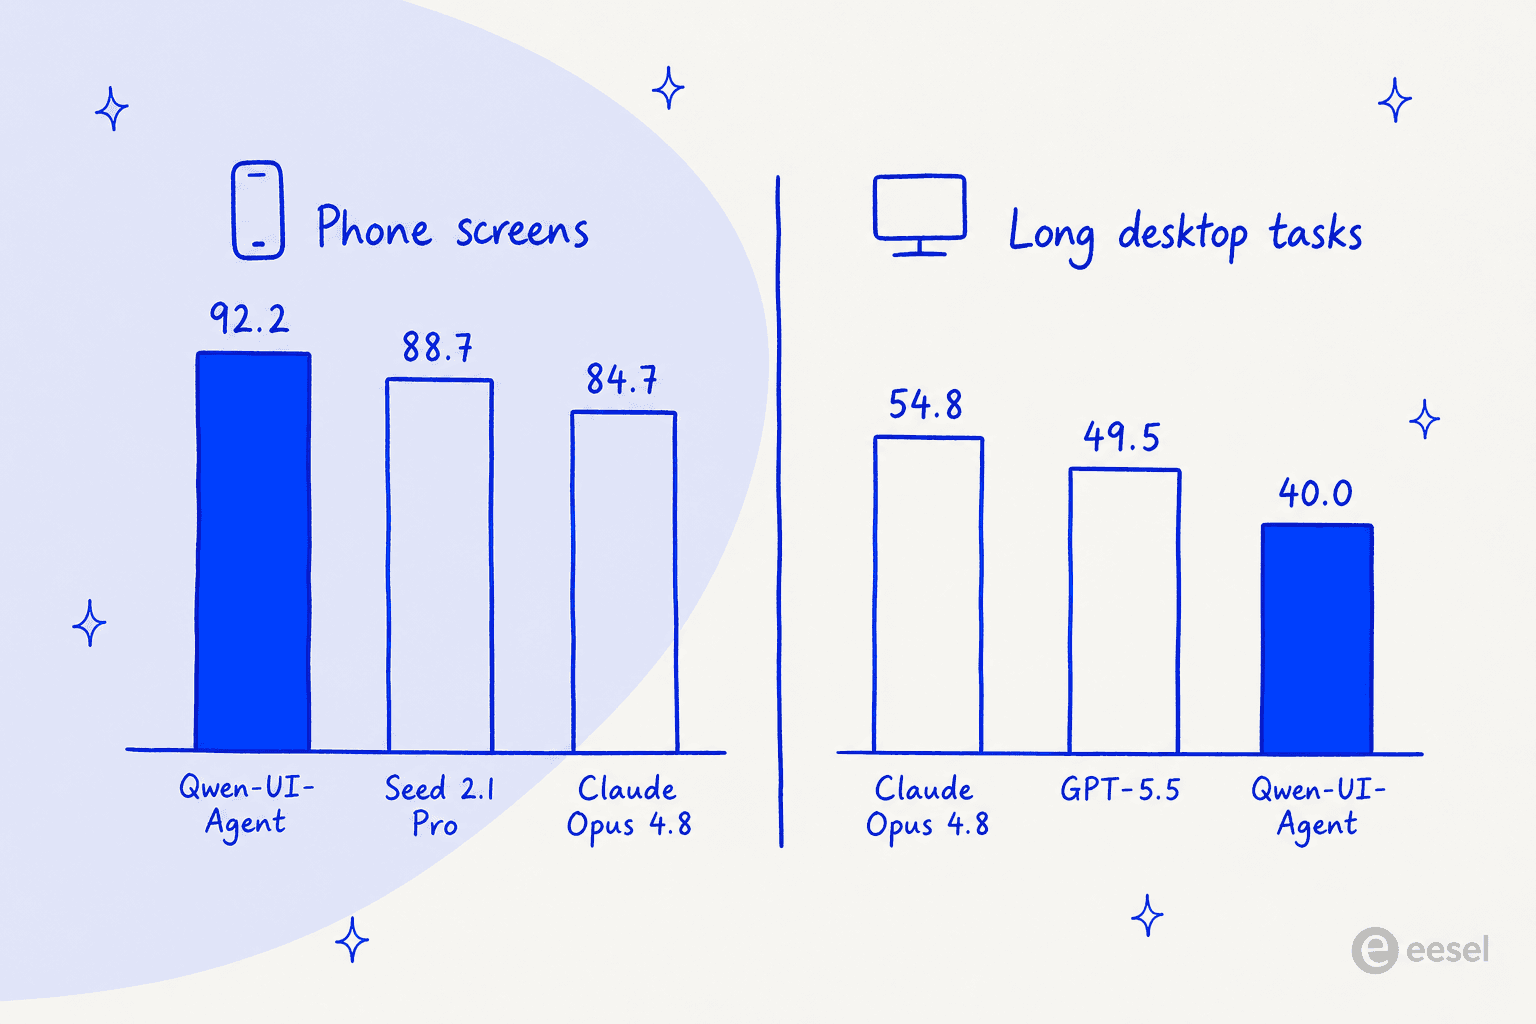
Bei Smartphones schlägt ihn nichts Veröffentlichtes. 92,2 % bei MobileWorld-Real, einem Benchmark mit 400 Aufgaben auf physischen Android-Geräten, vor Seed 2.1 Pro, Gemini 3.1 Pro, GPT-5.6 Sol und Claude Opus 4.8. Das ist Qwen-UI-Agent, Alibabas neuer GUI-Foundation-Agent. Die Technik darunter hat mich aber am meisten beschäftigt. Ein Aktionsraum, der Bildschirmklicks mit Bash-Befehlen mischt. Gebündelte Aktionen, sodass pro Modellrunde mehrere Dinge passieren. Und Online-Reinforcement-Learning über Trajektorien mit mehr als 100 Schritten.
Dann gibt es die Desktop-Zahl, die niemand zitiert. Bei OSWorld-v2, dem Langzeit-Set für Computernutzung, erreicht Qwen-UI-Agent 40,0 % Teilfortschritt gegenüber 54,8 % für Claude Opus 4.8. Also: ein Smartphone-Agent, auf dem Desktop konkurrenzfähig. Kein allgemeiner Bildschirm-Steuerer, der zufällig bei Smartphones gut ist. Das sollten Sie wissen, bevor Sie „State of the Art“ lesen und annehmen, es gelte überall.
Was darüber entscheidet, ob das alles für Sie relevant ist: Sie können ihn nicht ausführen. Keine Gewichte auf Hugging Face. Kein gehosteter Endpunkt und auch keine Preise. Ich baue bei eesel KI-Agenten, die in echten Support-Warteschlangen handeln, und nach über drei Jahren mit Agenten auf Live-Tickets bleibt bei mir hängen: Ein Wert sagt Ihnen eine Obergrenze und nichts über eine Untergrenze. Was einen Agenten tatsächlich an einer Support-Leitung vorbeibringt, ist der Nachweis anhand der eigenen Historie, bevor er einen Kunden berührt, weshalb jeder eesel-Rollout als Simulation über vergangene Tickets beginnt statt als Launch.
Was Qwen-UI-Agent eigentlich ist
Qwen-UI-Agent ist ein einziges Modell, das Software so bedient wie ein Mensch, nämlich indem es auf den Bildschirm schaut und darauf klickt. Es stammt vom MAI-UI-Team im Tongyi-Labor von Alibaba und ist der direkte Nachfolger von MAI-UI 1.0, das im Dezember 2025 mit 8B- und 2B-Checkpoints erschien. Wenn Sie zuerst das größere Alibaba-Bild wollen, decken unsere Qwen-Übersicht und unser Qwen-Test die Modellfamilie ab.
Das Paper erschien am 30. Juli 2026 auf arXiv und wurde auf Hugging Face fast sofort zum Paper des Tages Nummer eins, wo es inzwischen 308 Upvotes hat. Die Projektseite beschreibt es als einen Agenten, der „über Mobilgeräte, Desktop und Web hinweg denkt, sucht und handelt“.
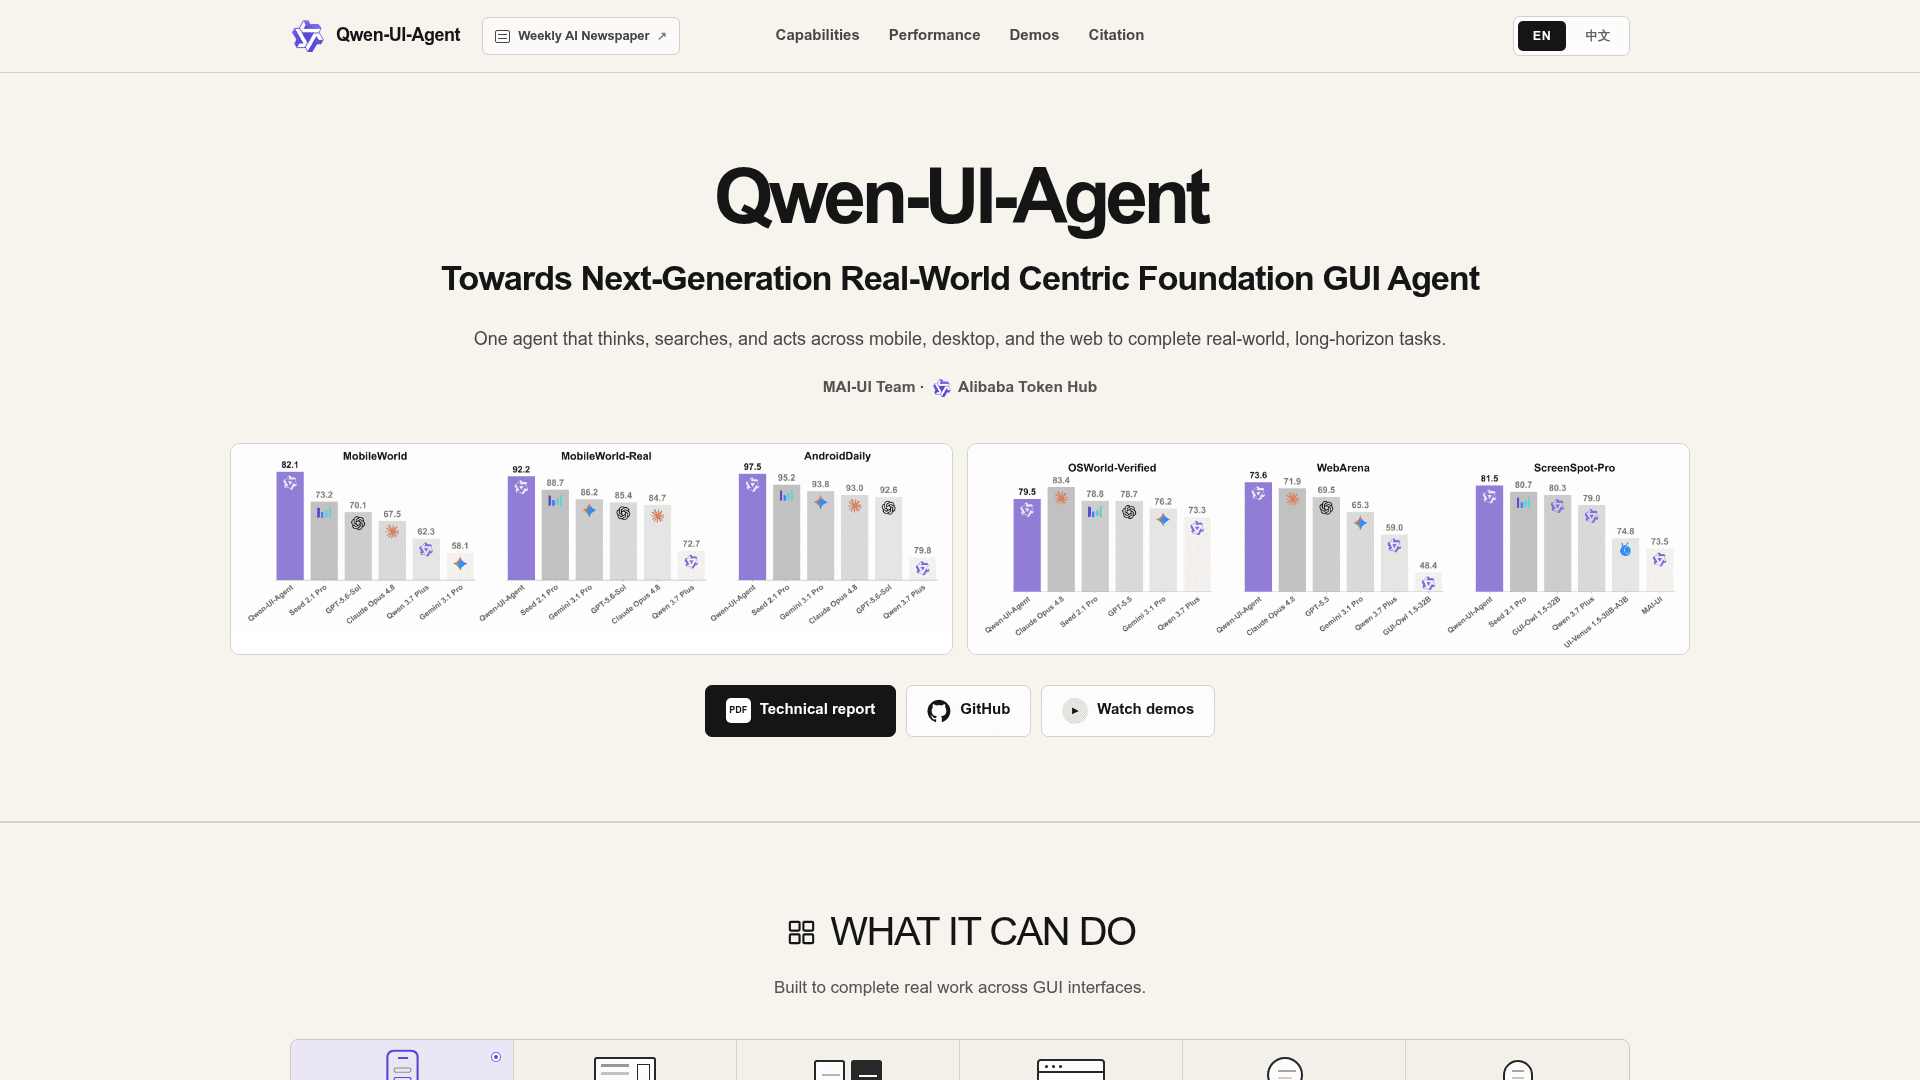
Sehen Sie sich die drei Schaltflächen unter den Diagrammen an. Technischer Bericht, GitHub, Demos ansehen. Das ist derzeit die gesamte Distributionsfläche, und darauf komme ich zurück.
Vier Szenarien stecken in dem einen Modell. Mobile GUI-Nutzung und Computernutzung, dazu Browsernutzung und dann das, was Alibaba DeepSearch nennt. Letzteres ist das Deep-Research-Verhalten und nicht nachträglich angeflanscht. Der Agent kann eine App verlassen, draußen im offenen Web etwas überprüfen und dann in die App zurückkehren, um auf Basis des Gefundenen zu handeln. Eine der veröffentlichten Demos lässt ihn Behauptungen aus einem Social-Video ziehen, sie mit Forschungspapieren abgleichen und dann zurückkehren, um einen Kommentar zu schreiben, der das konkrete Problem benennt.
Wenn Ihnen die Kategorie selbst neu ist, erklären unsere Beiträge zu KI-Agenten und zu Agenten versus Chatbots das Thema schneller als das Paper. Für das Ende des Feldes mit permissiver Lizenz gibt es außerdem unsere Übersicht zu Open-Source-KI-Agenten.
Wie es unter der Haube funktioniert
Das ist der Teil, den ich als jemand, der beruflich Agenten baut, am interessantesten finde, denn drei der Designentscheidungen sind nicht offensichtlich, und alle drei zielen auf denselben Fehlermodus.
GUI und CLI in einem Aktionsraum
Die meisten Bildschirm-Agenten können nur klicken. Qwen-UI-Agent kann klicken oder einen Bash-Befehl ausführen und wählt zwischen beidem innerhalb eines einzigen einheitlichen Aktionsraums. Alibabas eigener Bericht zu Computer-Aufgaben sagt, CLI-Befehle und GUI-Klicks kristallisieren sich als die beiden dominanten Aktionstypen heraus, was eine höfliche Art ist zu sagen, dass das Modell herausgefunden hat, dass manche Aufgaben als ein Shell-Befehl weit günstiger sind als als dreißig Klicks.
Wer je einem Browser-Agenten dabei zugesehen hat, vierzig Dateien per Drag-and-drop umzubenennen, versteht sofort, warum das wichtig ist.
Gebündelte Aktionen
Statt eine Aktion auszugeben, auf einen Screenshot zu warten und dann wieder zu denken, gibt das Modell innerhalb einer einzigen Entscheidung mehrere Aktionen aus. Alibaba meldet, dass etwa 40 % der Aktionsausgaben gebündelt sind, bei Computer-Aufgaben.
Die Kostenfolge ist real. Jede Runde bei einem Bildschirm-Agenten bedeutet einen neuen Screenshot im Kontext, und Screenshots sind teure Tokens. Die Rundenzahl bei einer langen Aufgabe zu halbieren, ist der Unterschied zwischen einem tragfähigen Workflow und einem, der still Ihr Budget auffrisst, und es ist dieselbe Rechnung wie bei den Kosten von KI-Agenten im großen Maßstab.
Auf echten Smartphones trainiert, nicht nur in Simulatoren
Das ist die zentrale Behauptung, und es ist auch die, die ich am liebsten am härtesten überprüfen würde. Alibaba sagt, es habe eine Live-Mobilumgebung aus über 100 physischen Smartphones mit über 150 Apps gebaut und sie für Aufgabenerstellung, Trajektoriensammlung, Training und Evaluierung genutzt. Darauf aufbauend hat es auch einen eigenen Benchmark gebaut, MobileWorld-Real, mit über 400 Aufgaben in über 100 Apps.
Der erklärte Zweck ist, die Sim-to-Real-Lücke zu schließen, und das Design geht tatsächlich das an, was Simulator-Werte überhaupt irreführend macht. Echte Apps haben Ladeanzeigen, A/B-getestete Layouts, abgelaufene Sitzungen und Netzwerkschwankungen, die eine Sandbox nie reproduziert.
Das Training läuft dann als Online-Reinforcement-Learning über Trajektorien mit mehr als 100 Schritten, mit rund 10.000 gleichzeitig laufenden Umgebungen. Gespeist wird das von einem Daten-Schwungrad im AutoResearch-Stil, in dem Agenten die Aufgaben, die Umgebungen und die Verifizierer konstruieren, ihre eigenen Fehler diagnostizieren und dann die nächste Iteration planen.
Ein Harness für proaktive Arbeit
Das letzte Stück ist eine leichte Harness-Schicht, mit der der Agent Arbeit aufgrund eines realen Signals statt eines Prompts beginnen kann. Alibabas Demo ist eine Benachrichtigung über einen stornierten Flug. Der Agent bemerkt sie, öffnet Live-Reise-Apps, vergleicht Flüge und Züge mit dem 14:00-Uhr-Termin des Nutzers und kommt dann mit einer Rangliste von Optionen zurück. Er bucht nicht, was erwähnenswert ist. Er legt eine Entscheidung vor und hält dann an.
Diese Zurückhaltung ist der richtige Instinkt, und es ist derselbe, der hinter guten Übergabepraktiken bei KI-Agenten im Support steht. Google ging mit Chrome auto-browse den entgegengesetzten Weg, das im Browser handelt, statt vorher zu fragen.
Die Benchmark-Ergebnisse, ehrlich gelesen
Hier teilt sich die Geschichte in zwei.
Auf Smartphones gewinnt er klar
| Mobiler Benchmark | Qwen-UI-Agent | Seed 2.1 Pro | Gemini 3.1 Pro | GPT-5.6 Sol | Claude Opus 4.8 |
|---|---|---|---|---|---|
| MobileWorld | 82.1 | 73.2 | 58.1 | 70.1 | 67.5 |
| MobileWorld-Real | 92.2 | 88.7 | 86.2 | 85.4 | 84.7 |
| AndroidDaily | 97.5 | 95.2 | 93.8 | 92.6 | 93.0 |
Der Vorsprung bei MobileWorld sticht für mich hervor. Fast neun Punkte vor dem nächsten Modell und mehr als 14 Punkte vor GPT-5.6 Sol, bei einem Benchmark, in dem die Aufgaben interaktive Wechsel zwischen Agent und Nutzer umfassen statt blinder Ausführung. Das sind keine Rundungsunterschiede.
Auf dem Desktop ist er konkurrenzfähig, dann nicht mehr
| Computer- und Browser-Benchmark | Qwen-UI-Agent | Claude Opus 4.8 | GPT-5.5 | Gemini 3.1 Pro |
|---|---|---|---|---|
| OSWorld-Verified | 79.5 | 83.4 | 78.7 | 76.2 |
| OSWorld-v2 (Teilfortschritt) | 40.0 | 54.8 | 49.5 | nicht gemeldet |
| WebArena | 73.6 | 71.9 | 69.5 | 65.3 |
OSWorld-Verified ist ein knapper Rückstand. Vier Punkte hinter Claude Opus 4.8, aber noch vor GPT-5.5 und Gemini 3.1 Pro. WebArena gewinnt er klar. Dann öffnet OSWorld-v2, das Langzeit-Set, eine Lücke von 14,8 Punkten zu Opus 4.8.
Das Muster passt zu dem, was das mobile Training verrät. Smartphone-Aufgaben sind kurz und begrenzt und in dieser Real-Device-Flotte stark geübt. Lange Desktop-Workflows sind der Ort, an dem Modelle abdriften, und Abdriften ist das, was sich am schwersten wegtrainieren lässt. Alibabas eigenes Abstract verwendet für Computernutzung das Wort „konkurrenzfähig“ und „State of the Art“ nur für Mobile. Das ist eine faire Beschreibung, die die meiste Berichterstattung dann zu einer einzigen Behauptung einebnet.
Beim Grounding räumt er ab
Grounding ist die unscheinbare Fähigkeit, die entscheidet, ob irgendetwas oben tatsächlich funktioniert. Kann das Modell den Cursor auf das richtige Pixel setzen? Qwen-UI-Agent führt jeden Grounding-Benchmark im Bericht an: 81,5 % bei ScreenSpot-Pro mit Zoom, 76,6 % ohne Zoom, 97,5 % bei SS-V2, 70,0 % bei UI-Vision.
Die Zahl ohne Zoom ist hier die ehrliche. Zoom-in ist ein Harness-Trick, der den Bildschirm zuschneidet und neu betrachtet, ein Modell, das nur damit gewinnt, stützt sich also auf Gerüst. Ohne ihn zu gewinnen heißt, dass die Wahrnehmung selbst echt ist.
Und das allgemeine Modell darunter?
Alibaba meldet auch, dass das GUI-Training das Basismodell nicht verkrüppelt hat, und veröffentlicht zum Beleg einen Vergleich mit Qwen3.5-27B.
| Allgemeiner Benchmark | Qwen-UI-Agent | Qwen3.5-27B |
|---|---|---|
| MMLU-Pro | 86.5 | 86.0 |
| MMMU-Pro | 72.4 | 73.5 |
| MathVision | 82.8 | 82.0 |
| IFEval (strict) | 90.2 | 90.4 |
| Tau2-Bench | 89.9 | 89.2 |
| Terminal-Bench 2.0 | 50.1 | 41.1 |
| BrowseComp-ZH | 75.0 | 62.1 |
Dass Terminal-Bench um neun Punkte und BrowseComp-ZH um dreizehn springt, ist das, was man von einem Modell erwartet, dem man den Umgang mit einer Shell und mit Suche beigebracht hat. Der kleine Rückgang bei MMMU-Pro und IFEval ist der Preis dafür, und es ist ein kleiner Preis. Eine Zeile geht in die andere Richtung: QwenClawBench fällt von 48,5 auf 44,2, was der Bericht veröffentlicht, statt es zu verstecken.
Was die Zahlen nicht sagen
Drei Vorbehalte. Zu Alibabas Ehre stammen zwei davon von Alibaba selbst.
Jeder Wert wurde in der eigenen Umgebung der Autoren reproduziert. Der Evaluierungshinweis auf der Projektseite sagt das direkt und fügt hinzu, dass einige Einstellungen bei Harness, Judge, Simulator, Laufzeit oder Aufgaben-Teilmenge von den offiziellen Evaluierungen abweichen. Mehrere der Wettbewerber-Zeilen tragen ein Kreuzzeichen, das sie als von den Autoren reproduziert markiert, statt aus dem Bericht des Anbieters übernommen. Das ist mehr Offenlegung, als die meisten Modell-Launches sich machen, und es bedeutet auch, dass dies nicht dieselben Bedingungen sind, unter denen die Anbieter veröffentlicht haben.
Die Demos bauen auf dem chinesischen App-Ökosystem auf. Douyin, Hema, Trip.com, Amap, Dianping, Xiaohongshu, 12306, DingTalk, Beike. Die Technik lässt sich verallgemeinern. Die konkreten 92,2 % übertragen sich nicht automatisch auf eine Flotte von Smartphones mit Slack, Shopify und Gmail. Wenn Ihre Workflows westliche SaaS sind, behandeln Sie diese mobile Zahl als starkes Signal über die Methode und nicht als Versprechen für Ihre eigenen Apps.
Das Website-Repo verrät den Release-Stand. Das eigene Repository der Projektseite enthält weiterhin eine Bearbeitungsanweisung, die „Coming soon“-Ressourcenkarten zum Release durch die endgültigen URLs für Bericht, Code und Checkpoint zu ersetzen, und einen Hinweis, dass Ergebniszahlen, die sich im Entwurf widersprechen, bewusst weggelassen werden, bis die Werte feststehen. Das ist ein Projekt mitten im Prozess und kein ausgeliefertes Produkt.
Können Sie ihn heute tatsächlich ausführen?
Nein. Und dies ist der Abschnitt, den ich an Ihrer Stelle zuerst lesen würde.
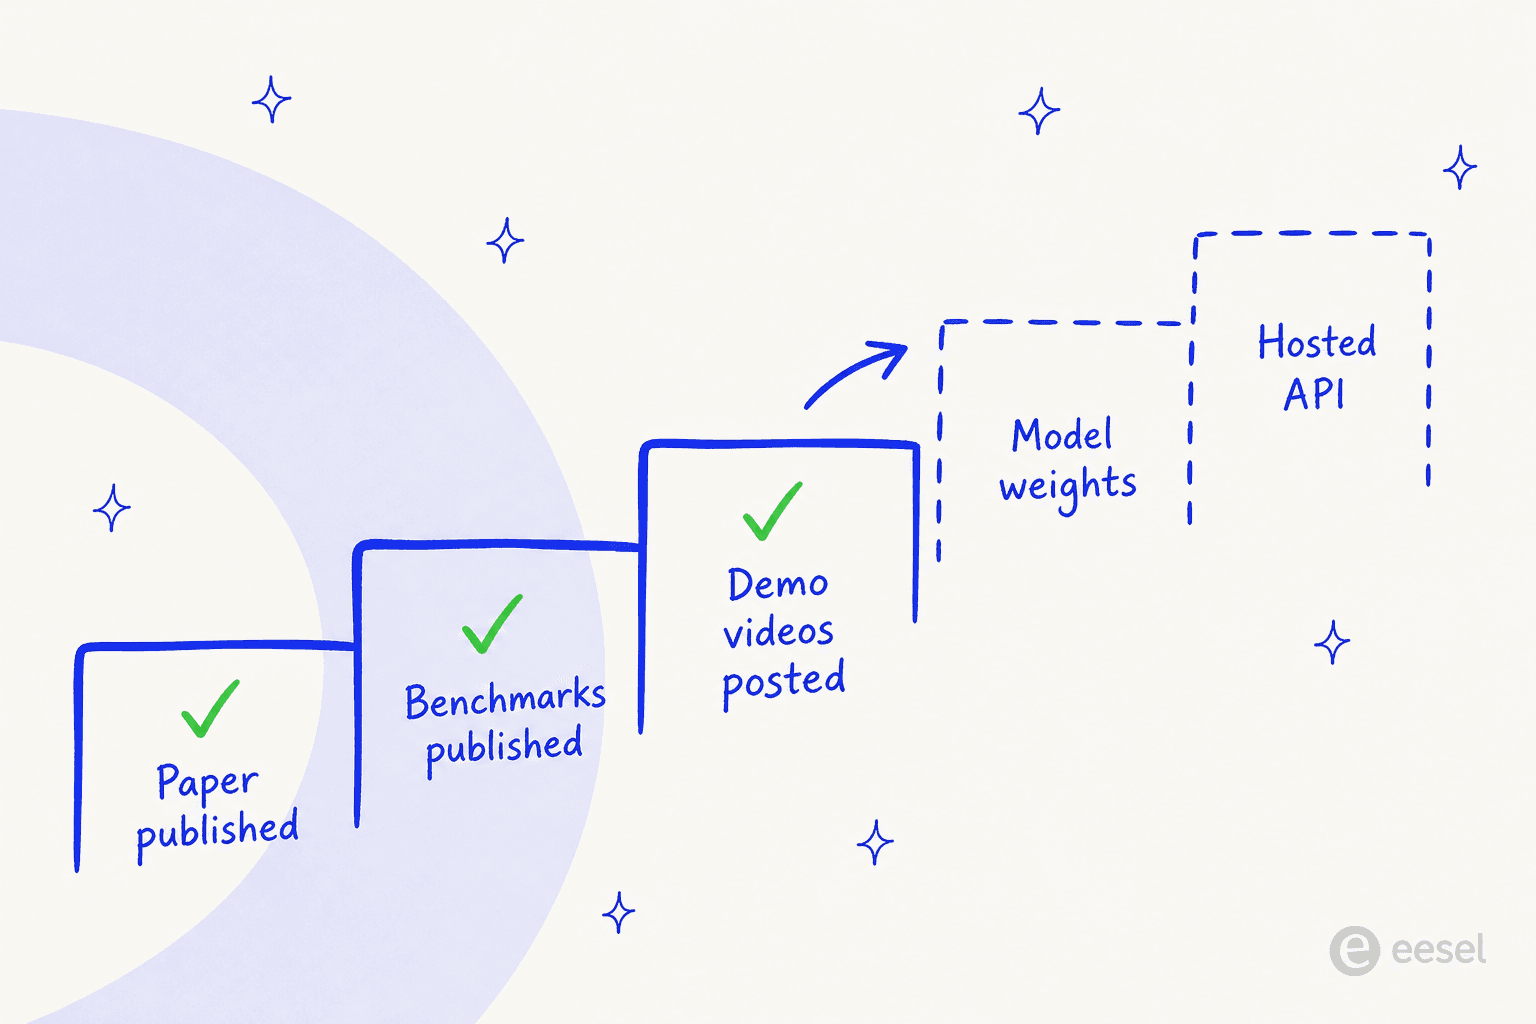
Das habe ich am 24. August 2026 geprüft:
- Die Tongyi-MAI-Organisation auf Hugging Face listet vier Modelle: Z-Image, Z-Image-Turbo, MAI-UI-8B und MAI-UI-2B. Kein Qwen-UI-Agent.
- Die Paper-Seite meldet null verknüpfte Modelle, null Datensätze und null Spaces.
- Das GitHub-Repository namens Qwen-UI-Agent ist nur Website-Quellcode und sagt das oben in der Readme in Fettschrift.
- Das Implementierungs-Repository Tongyi-MAI/MAI-UI hat 2,2k Sterne und keinen Release, keine Tags und keinen Checkpoint-Link für dieses Modell.
- Im Modellkatalog von Alibaba gibt es keinen Eintrag für Qwen-UI-Agent, also keinen Endpunkt und keine Preisliste.
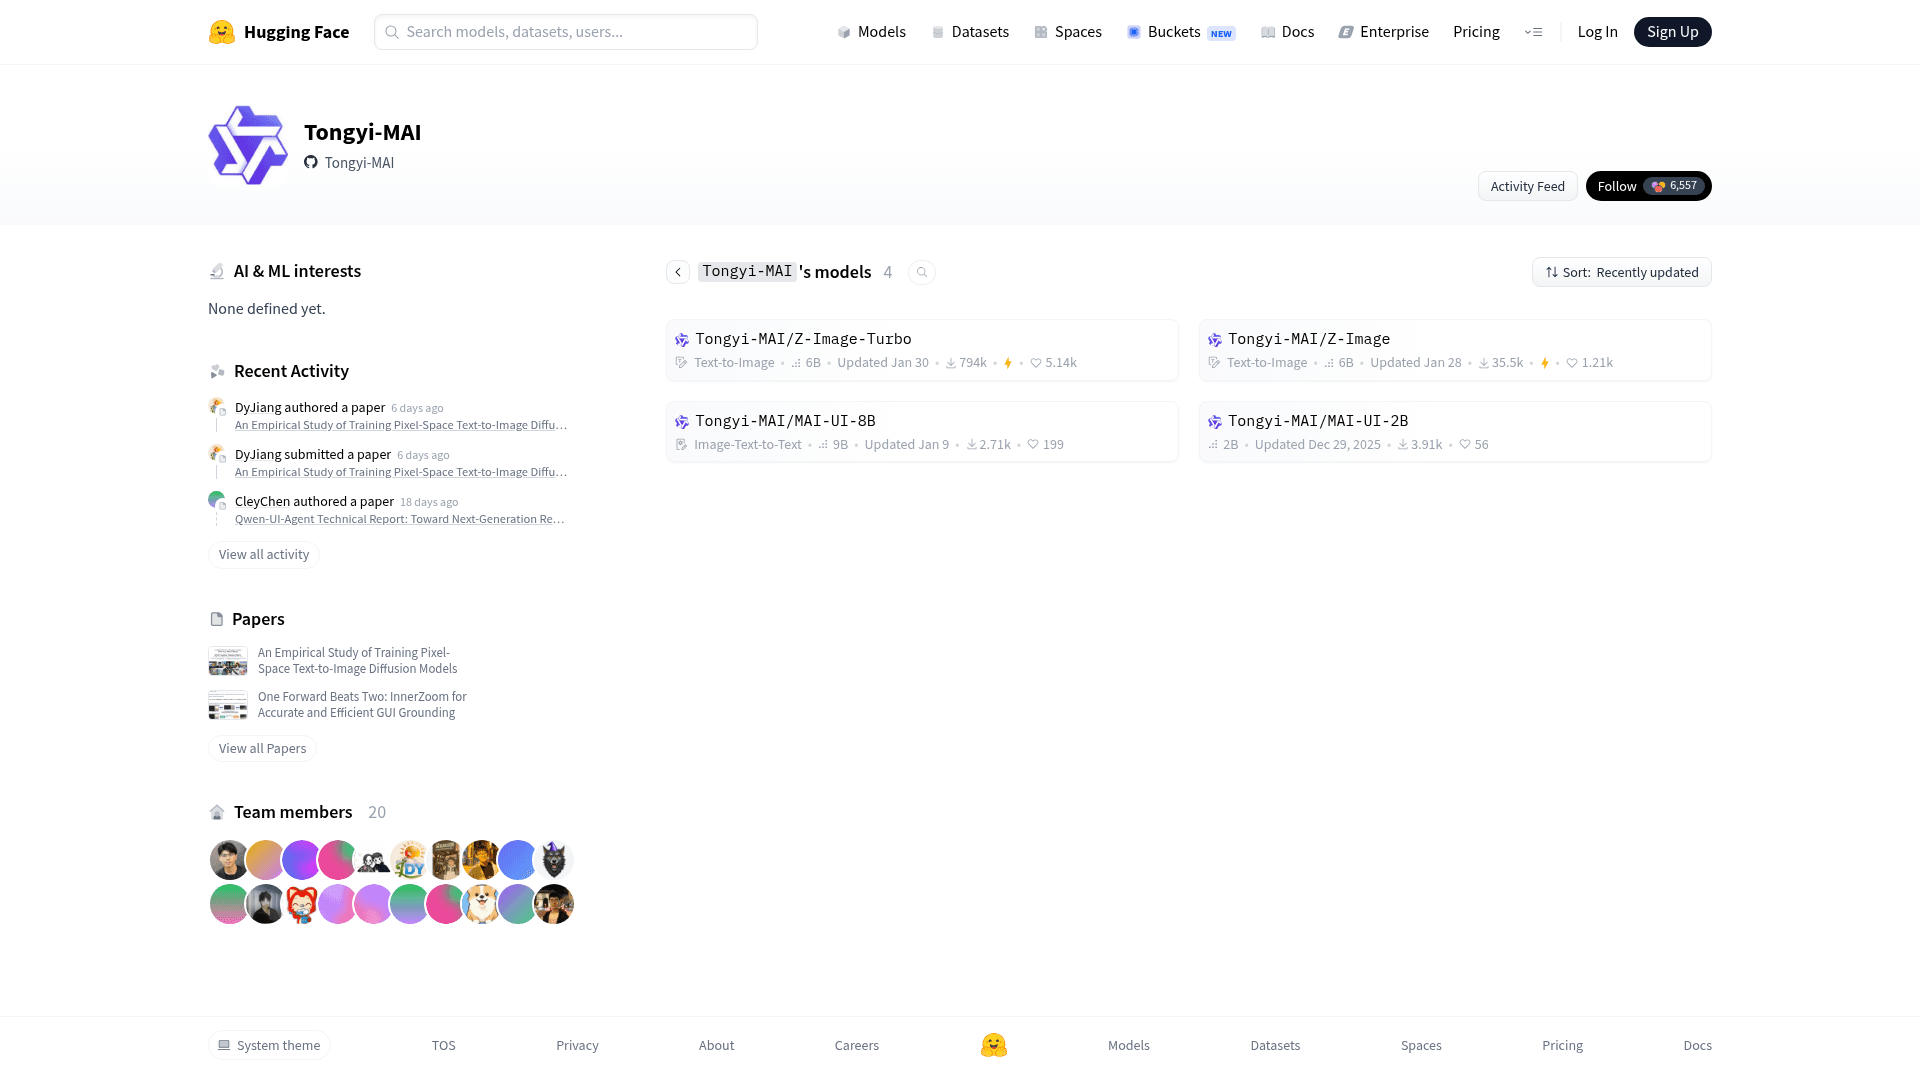
Das eine ermutigende Zeichen ist der Präzedenzfall. Dasselbe Team hat MAI-UI 8B und 2B im Dezember 2025 veröffentlicht, und die Readme gibt an, dass das Projekt unter Apache 2.0 lizenziert ist. Alibaba hat auch für seine Flaggschiff-Linie Gewichte ausgeliefert, wie unser Qwen-3.8-Max-Test behandelt. Eine offene Veröffentlichung ist also plausibel genug. Nur kann man darauf kein Quartal planen.
Wenn Sie diesen Monat etwas Aufrufbares brauchen, führt die praktische Shortlist über Qwen-Alternativen und Kimi K3. Für eine günstigere offene Option gibt es DeepSeek V4 Flash.
Was das bedeutet, wenn Sie eine Support-Warteschlange betreiben
In diesem Abschnitt möchte ich vorsichtig sein, denn „GUI-Agent erreicht 89,9 bei einem Support-Benchmark“ ist genau die Art Schlagzeile, die in einer Vorstandspräsentation landet.
Tau2-Bench ist ein echter Benchmark, und 89,9 ist darin ein guter Wert. Aber sehen Sie sich an, was er misst, im Vergleich zu dem, was eine Support-Leitung tatsächlich braucht. In Gesprächen höre ich immer wieder dieselben Anforderungen. Trainiert es auf unseren eigenen vergangenen Tickets. Setzt eine Quellenangabe an jede Antwort. Und lasst uns sehen, was es getan hätte, bevor es es tut. Ein Bildschirm-steuernder Agent kann die zweite oder dritte strukturell nicht liefern. Er klickt. Es gibt kein Antwortobjekt, an das man eine Quelle hängen könnte, und es gibt auch keinen Trockenlauf-Modus für eine Maus, weshalb Halluzinationsprävention im Support beim Umfang beginnt und nicht bei der Modellwahl.
Ein Hardware-Support-Team, mit dem ich gesprochen habe und das rund 250 Tickets im Monat in Zendesk in mehreren Sprachen bearbeitet, machte Quellenangaben zur harten Anforderung, bevor irgendetwas live ging. Ein anderes, ein IT-Dienstleister des öffentlichen Sektors, der dieses Jahr zwei erfahrene Agenten verliert, wollte die KI auf den eigenen gelösten Tickets trainieren, gerade damit das abwandernde Wissen nicht verloren geht. Beides ist kein Bildschirmproblem. Beides sind Retrieval- und Governance-Probleme, näher an den Fragen in welches LLM für den Support geeignet ist als an irgendetwas in diesem Paper, weshalb das beste KI-Modell für Support-Tickets selten das größte ist.
Das Muster, das tatsächlich funktioniert, ist ein langweiliges, und es gilt für nahezu jeden Rollout, den ich beobachtet habe. Im Entwurfsmodus starten, in dem die KI schreibt und ein Mensch sendet. Dann in die volle Automatisierung übergehen, sobald die Zahlen es verdient haben. Das ist die Form von KI-Agent-Assist-Arbeit, und deshalb sind Containment und Eskalationsqualität bessere Prädiktoren für einen erfolgreichen Einsatz als jeder Benchmark auf dieser Seite. Support-QA ist die andere Hälfte dieses Kreislaufs.
Wo ein GUI-Agent wirklich seinen Platz verdient, ist der lange Schwanz interner Abläufe, für die nie jemand eine API gebaut hat. Ein altes Admin-Panel. Ein Lieferantenportal oder ein internes Tool von 2014. Das ist echter Wert, und er wird unterschätzt. Es ist nur eine andere Aufgabe, als Kundentickets zu lösen, so wie Workflow-Automatisierung eine andere Aufgabe ist als Ticket-Deflection.
Wo eesel passt
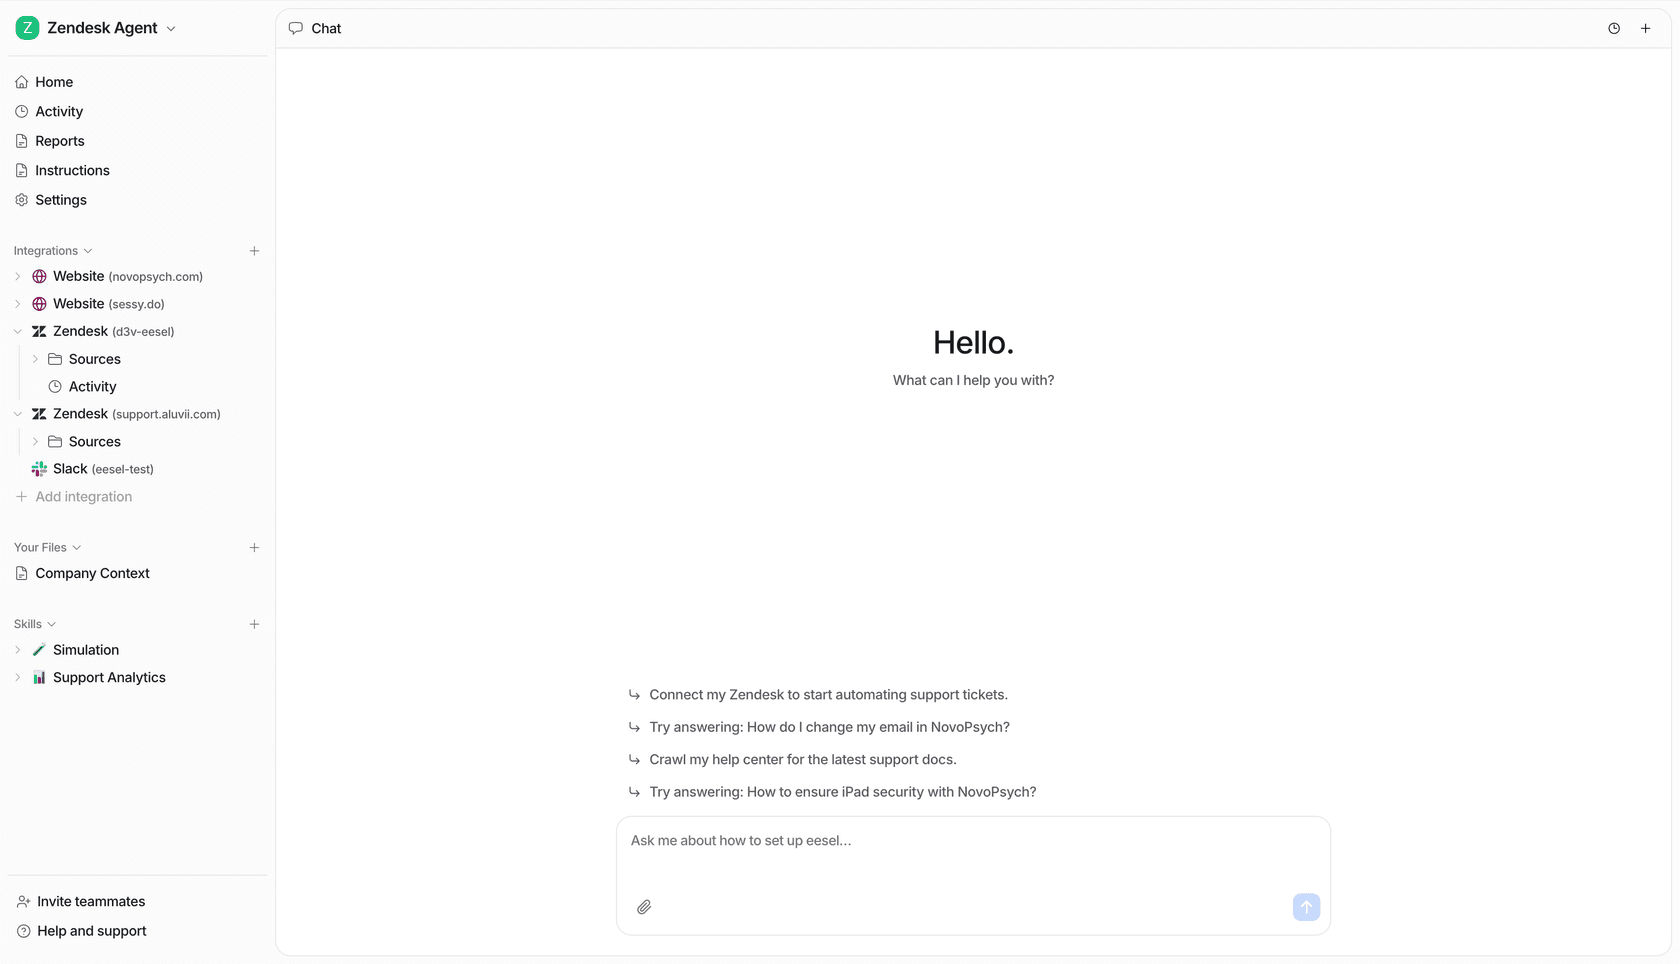
Wenn Sie ein GUI-Agent-Paper lesen, weil Sie eigentlich eine kleinere Helpdesk-Warteschlange wollen, ist die Abkürzung, die Bildschirmebene ganz zu überspringen. eesel verbindet sich direkt mit Zendesk, Freshdesk, Gorgias und dem Rest, lernt aus Ihren eigenen vergangenen Tickets und Ihrem Help-Center statt aus einem öffentlichen Crawl und nennt bei jeder Antwort die Quelle. Es verhält sich weniger wie ein Bildschirm-Steuerer und mehr wie das Framing von KI-Teammitgliedern und KI-Mitarbeitern, das wir für diese Arbeit verwenden.
Der wichtigste Teil für diesen Vergleich: Sie können es in der Simulation über Tausende Ihrer historischen Tickets laufen lassen und genau lesen, was es geantwortet hätte, bevor ein einziger Kunde es sieht. Das ist der „erst beweisen“-Schritt, den ein Benchmark-Wert nie ersetzen kann, und er dauert Minuten statt eines Beschaffungszyklus. Kostenlos testen.
Für wen Qwen-UI-Agent gedacht ist
Genau im Blick behalten, wenn Sie mobile Automatisierung bauen, QA gegen echte Android-Geräte fahren oder GUI-Agenten erforschen und die aktuell am besten dokumentierte Methode wollen. Die Real-Device-Trainingsschleife und der GUI-plus-CLI-Aktionsraum sind die beiden Ideen, die am ehesten im nächsten Release aller anderen auftauchen.
Vorerst ignorieren, wenn Sie in diesem Quartal etwas in Produktion brauchen. Es gibt nichts zu deployen. Lesen Sie das Paper, notieren Sie die Technik und schauen Sie wieder vorbei, wenn ein Checkpoint erscheint. Bis dahin ist Qwen 3.7 Flash das Alibaba-Modell, das Sie tatsächlich aufrufen können.
Skeptisch bleiben, wenn Ihre Workloads lange Desktop-Workflows sind. Die 40,0 % bei OSWorld-v2 sind die Zahl, die diese Entscheidung bestimmen sollte, und nicht die 92,2 % bei Smartphones. Für diese Art von Arbeit bleiben Claude Opus 5 und seine Vorgänger die sicherere Wahl, und unser Beitrag zu Opus-5-Alternativen deckt den Rest des Feldes ab.
Überhaupt nicht das richtige Werkzeug, wenn Sie Kundensupport automatisieren wollen. Nicht weil es schwach ist. Es zielt auf eine andere Oberfläche, das ist alles. Support-Teams brauchen etwas, das sich ins Helpdesk einklinkt und aus Ihrer Wissensdatenbank und gelösten Tickets lernt.
Von dort aus geht es um Routing, Ticket-Klassifizierung und saubere Support-Eskalationen, wenn ein Mensch nötig ist. Bildschirmsteuerung ist dort nicht der Engpass, und sie als solchen zu behandeln, ist der Weg, auf dem Teams mit einer beeindruckenden Demo und einer unveränderten Warteschlange dastehen.
Das Fazit
Qwen-UI-Agent ist das interessanteste GUI-Agent-Paper des Jahres und das am wenigsten nutzbare Produkt in diesem Vergleich. Beides stimmt gleichzeitig.
Das mobile Ergebnis ist die eigentliche Schlagzeile, und das verdient es auch: 92,2 % bei über 400 Aufgaben auf einer Flotte physischer Smartphones, vor vier Frontier-Modellen, ist kein Benchmark-Artefakt. Die Methode dahinter, vor allem das Mischen von Shell-Befehlen in den Klickstrom und das Bündeln von Aktionen pro Runde, ist die Art von Idee, die kopiert wird.
Das Desktop-Ergebnis ist der eigentliche Vorbehalt: 40,0 % bei langfristiger Computernutzung gegenüber 54,8 % für Claude Opus 4.8 ist eine große Lücke, und langfristige Desktop-Arbeit ist ohnehin das meiste von dem, was Leute im Geschäftskontext mit „Computernutzung“ meinen.
Und die Verfügbarkeit ist die eigentliche Blockade. Apache 2.0 in einer Readme ist eine Absicht. Bis tatsächlich ein Checkpoint erscheint, ist dies Forschung zum Lernen, keine Software zum Kaufen. Wenn die Warteschlange vor Ihnen eine Support-Warteschlange ist und kein Bildschirm, wird der beste KI-Agent nicht der sein, der am schnellsten klickt. Es wird der sein, den Sie an Ihren eigenen Tickets testen durften, bevor Sie ihm vertraut haben.