

Was ist Eleven v4?
Eleven v4 ist die vierte Generation des Sprachmodells von ElevenLabs, einem der bekanntesten AI-Voice-Unternehmen. Das Unternehmen nennt es auf seiner Eleven-v4-Dokumentationsseite „the first in a new generation of models".
Laut Launch-Beitrag läuft es auf einer völlig neuen Architektur, die ein Skript liest wie ein Sprecher: Sie achtet darauf, wer spricht und was gerade passiert ist, bevor sie entscheidet, wie eine Zeile wirken soll.
Ich baue bei eesel AI-Agenten (die Plattform für AI-Teammates), und unser Team bringt seit Jahren KI in echte Support-Warteschlangen. Bei einem solchen Launch will ich deshalb vor allem eines wissen: Was ändert sich für jemanden, der es in Produktion bringen muss? Kurze Antwort: v4 ist ein echter Fortschritt, aber auch eine Migration und kein Drop-in-Ersatz.
Laut Modellreferenz gibt es zwei Varianten:
- Eleven v4 (
eleven_v4): das Qualitätsmodell. Limit von 10.000 Zeichen (etwa 10 Minuten Audio), Dialoge mit mehreren Sprechern, bereitgestellt über die Text-to-Dialogue-API. - Eleven v4 Turbo (
eleven_v4_turbo): das Echtzeitmodell mit einer mittleren Inferenzlatenz von ~100 ms, bereitgestellt über den Text-to-Dialogue-WebSocket und in ElevenAgents.
Laut Changelog vom 28. September kannst du beide heute in ElevenCreative (der Web-App), in ElevenAgents und über die API nutzen. ElevenLabs hat außerdem eine kurze Entwickler-Einführung veröffentlicht, falls du lieber Video schaust.
Was hat sich gegenüber v3 tatsächlich geändert?
Ausdrucksstärke und Klongenauigkeit machen die Schlagzeilen. Die Details, nach denen du tatsächlich planst, stehen aber in der Dokumentation, deshalb habe ich diesen Vergleich aus der Modellseite und der API-Preisseite zusammengestellt.
| Eleven v3 | Eleven v4 | Eleven v4 Turbo | |
|---|---|---|---|
| Am besten für | Dramatische Darbietungen | Hörbücher, Voiceovers, Synchronisation | Voice Agents, interaktive Apps |
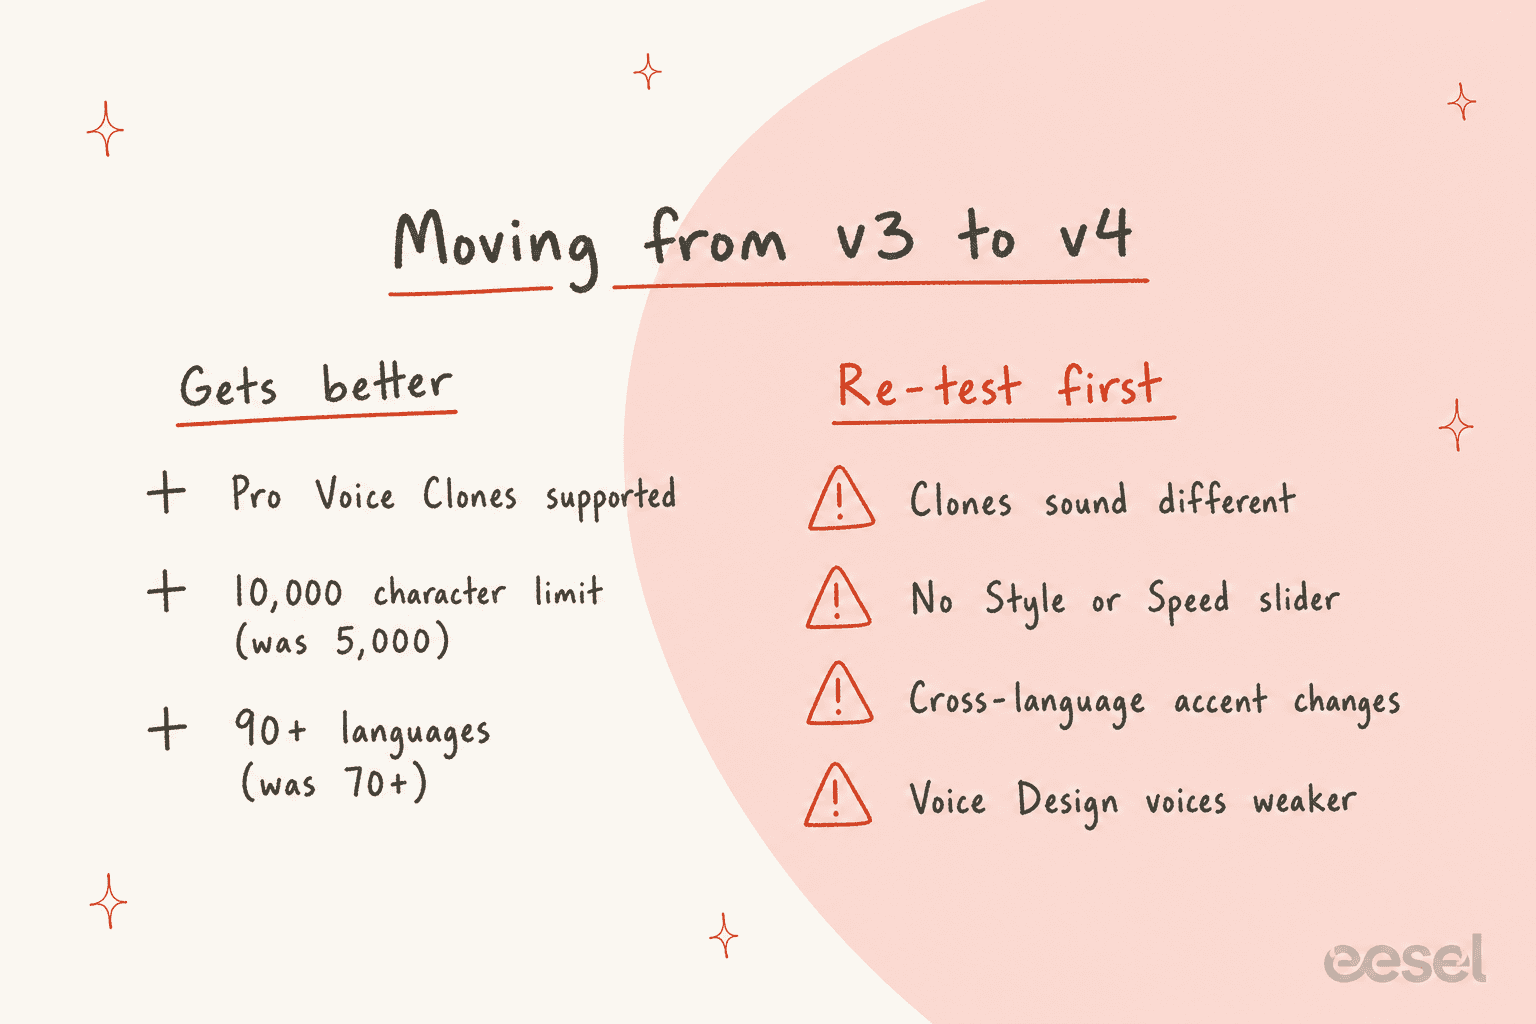
| Sprachen | 70+ | 90+ | 90+ |
| Zeichenlimit pro Anfrage | 5.000 | 10.000 | Streaming |
| Latenz | Nicht in Echtzeit | Nicht in Echtzeit | ~100 ms mittlere Inferenz |
| API-Listenpreis pro 1.000 Zeichen | 0,08 $ | 0,08 $ | 0,04 $ |
| Professional Voice Clones | Nicht vollständig optimiert | Unterstützt | Unterstützt |
| Regler für Style und Speed | Ja | Nein | Nein |
| SSML | Nein | Nein | Nein |
| Arena-Elo (Artificial Analysis) | 1174 | 1321 | 1334 |
Einiges davon braucht mehr Platz, als eine Tabellenzelle bietet.
Professional Voice Clones sind zurück. Laut der Best-Practices-Seite zu v3 waren PVCs für v3 nicht vollständig optimiert, weshalb Teams mit einem teuren professionellen Klon oft bei älteren Modellen blieben. Der Best-Practices-Leitfaden verweist diese Stimmen jetzt direkt auf v4. Es gibt allerdings einen Haken: Laut Dokumentation wird die PVC-Unterstützung „is currently rolling out to everyone", einige Konten warten also eventuell noch.
Instant Clones brauchen weniger Audio. Laut Launch-Beitrag erfassen Instant Voice Clones eine Stimme aus „just 10 seconds of audio", auch wenn die Dokumentation für ein solides Ergebnis weiterhin ein bis zwei Minuten empfiehlt.
Langformate sind stabiler. ElevenLabs sagt, Request Stitching (das Verketten von Generierungen zu einem längeren Stück) sei „significantly more reliable", und das merken vor allem Hörbuchproduzenten, die im Studio arbeiten.
Nur noch zwei Regler. Stability und Similarity bleiben in v4 erhalten. Style und Speed nicht, die Regie steckt jetzt im Skript selbst, als Audio-Tags wie [whispers] oder [sighs].
Warum Turbo für die meisten die richtige Wahl ist
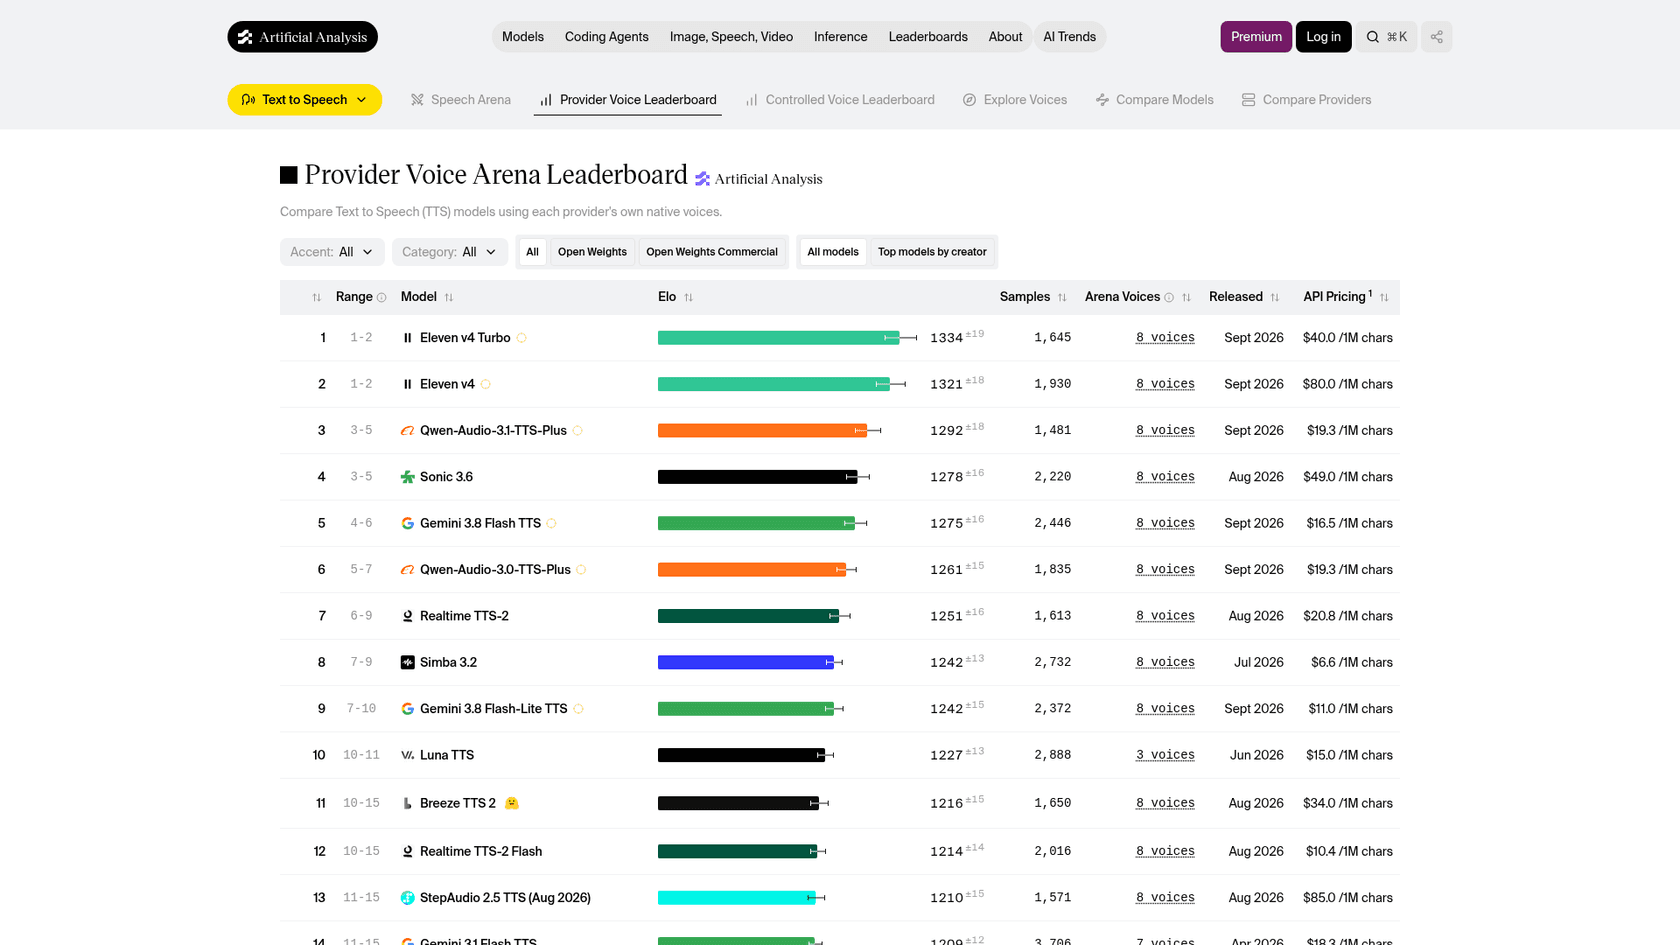
Das hat mich überrascht. Man würde annehmen, dass das „Qualitätsmodell" bei der Qualität das „schnelle" schlägt. In der Artificial Analysis Provider Voice Arena, wo Hörer von zwei Clips den natürlicheren wählen, ohne zu wissen, welches Modell sie erzeugt hat, ist es umgekehrt:
- Eleven v4 Turbo: 1334 Elo bei 1.645 Stimmen, 40 $ pro 1 Mio. Zeichen.
- Eleven v4: 1321 Elo bei 1.930 Stimmen, 80 $ pro 1 Mio. Zeichen.
- Qwen-Audio-3.1-TTS-Plus: 1292 Elo, 19,30 $ pro 1 Mio. Zeichen.
- Cartesia Sonic 3.6: 1278 Elo, 49 $ pro 1 Mio. Zeichen.
- Gemini 3.8 Flash TTS: 1275 Elo, 16,50 $ pro 1 Mio. Zeichen.
Die beiden v4-Modelle überlappen sich innerhalb ihrer Konfidenzbereiche (beide liegen im Rangband „1-2"). Fair gelesen heißt das: Turbo erreicht bei der Natürlichkeit kurzer Clips das volle Modell zum halben Preis. Das volle Modell verdient seinen Preis bei Dingen, die die Arena nicht testet, etwa dem Limit von 10.000 Zeichen und dem Beibehalten des Szenenkontexts über ein langes Skript. Ein ganzes Kapitel ohne Drift zusammenzufügen gehört ebenfalls dazu.
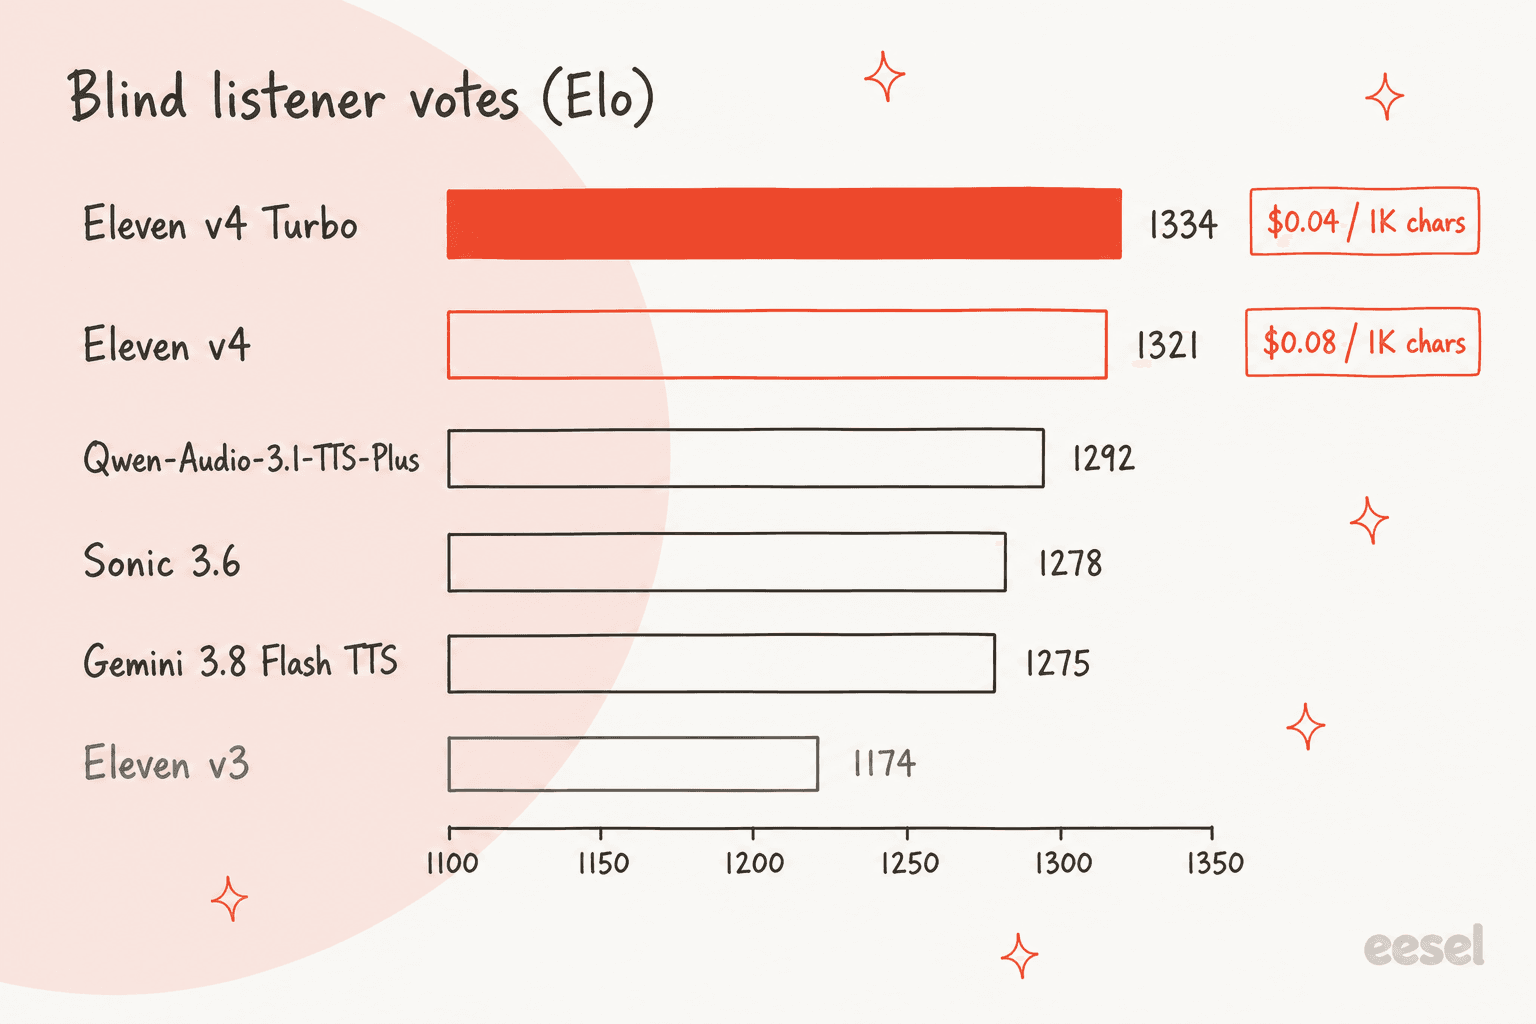
Auch der Abstand zu v3 hält stand und ist keine Marketing-Rundung. v3 liegt auf demselben Board bei 1174, 147 Punkte hinter v4, und auf einer Elo-Skala bedeutet das, dass Hörer v4 meistens vorziehen. Laut den Fußnoten im Launch-Beitrag behauptet ElevenLabs in eigenen Tests, v4 sei von ~75 % der Hörer bevorzugt worden, im Vergleich zu Cartesia Sonic 3.6, Inworld TTS-2 und zwei Gemini-3.8-TTS-Modellen. Ich würde das als Herstellerbehauptung behandeln und mich bei der unabhängigen Prüfung auf die Arena-Zahlen stützen.
Meine Faustregel: standardmäßig Turbo, das volle Modell nur, wenn eine einzelne Anfrage Minuten zusammenhängender Erzählung tragen muss.
Du vergleichst Anbieter? Mein Cartesia Sonic 3 vs. ElevenLabs und der Test zu Gemini 3.8 Flash TTS behandeln die nächsten beiden Namen auf diesem Board.
Der Beitrag zu den Gemini 3.8 Flash TTS-Preisen erklärt, warum Google bei den Kosten alle unterbietet. Eine breitere Shortlist findest du unter ElevenLabs-Alternativen.
Welches Eleven-Modell passt zu deinem Projekt?
Wähle, was du baust. Preise sind API-Listenpreise pro 1.000 Zeichen.
Wie verändert die muttersprachliche Akzentbehandlung mehrsprachige Stimmen?
Die Dokumentation hebt das als eine der größten Änderungen in v4 hervor. Es ist auch die, die bestehende Kunden am ehesten überrascht.
Eine geklonte Stimme nahm ihren Akzent in v3 in andere Sprachen mit. v4 trennt das in zwei Fälle. Stimmt die Ausgabesprache mit der Sprache der Stimme überein, bleibt der Akzent erhalten; wenn nicht, erzeugt v4 stattdessen flüssige Sprache mit einem muttersprachlichen Akzent der Zielsprache. Die Dokumentation nennt dieses Beispiel: Klone einen koreanischen Sprecher, erzeuge Englisch, und du bekommst natürliches Englisch, nicht Englisch mit koreanischem Akzent.
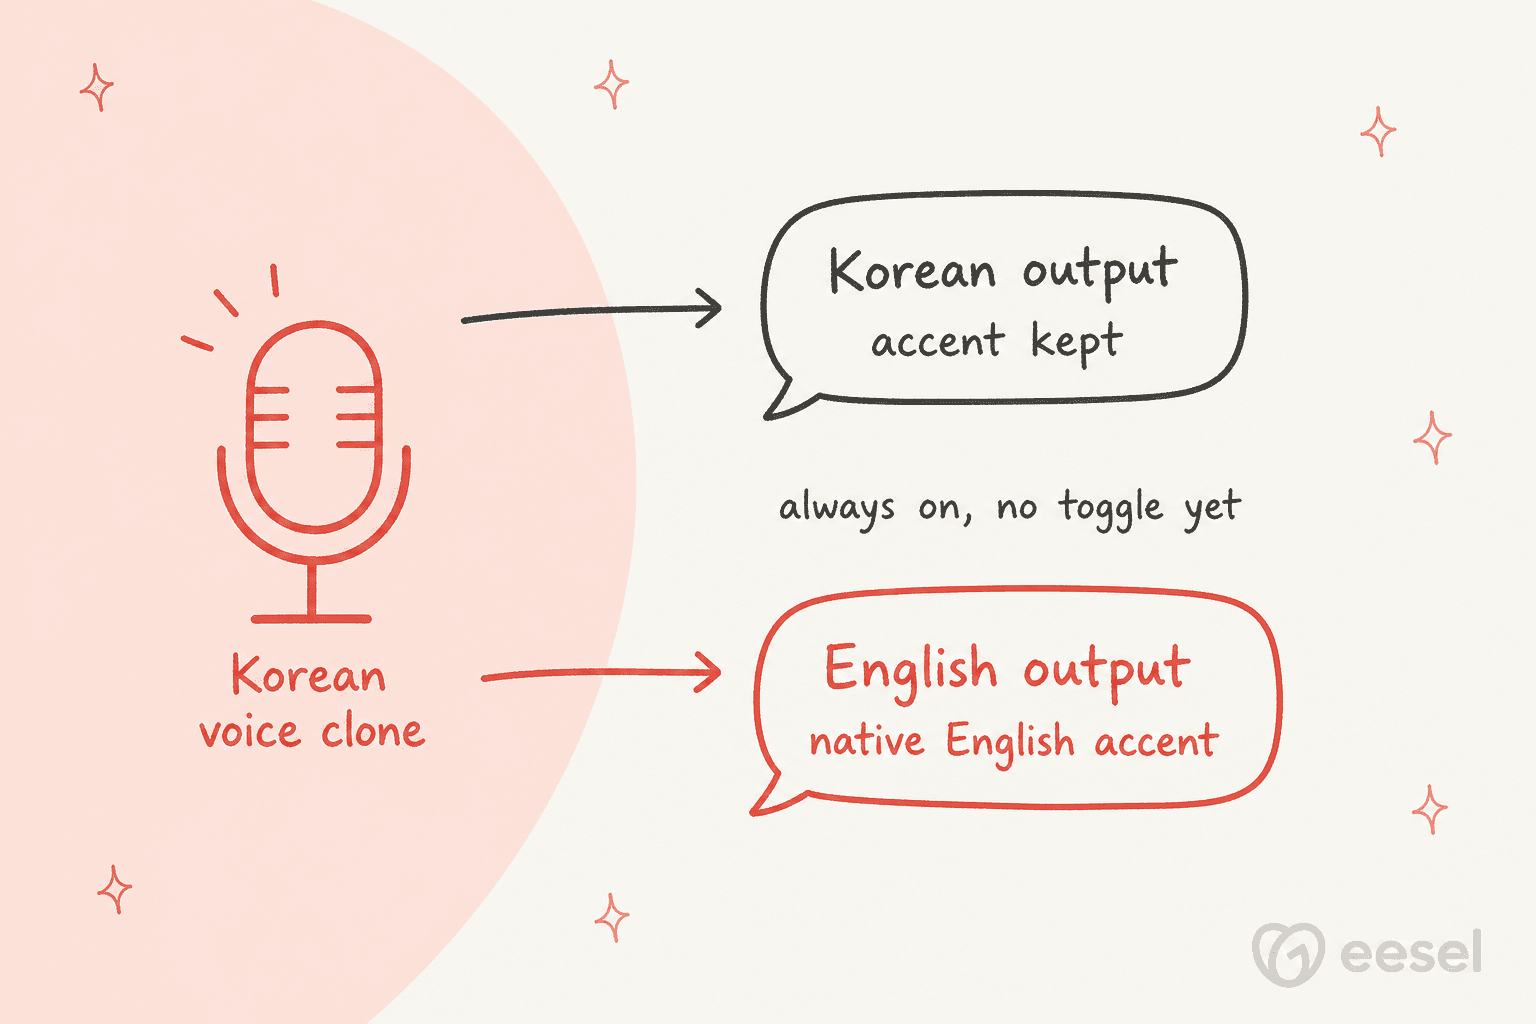
Für Synchronisation ist das ein großes Upgrade, und auch für Agenten, die Anrufer in mehreren Sprachen bedienen, da eine Markenstimme jetzt überall einheimisch klingen kann. Wenn deine Stimme aber der Akzent ist, ist es ein Rückschritt. ElevenLabs sagt offen, dass ein Schalter „still a research project" ist, ohne Zeitplan.
Nicht jeder frühe Nutzer findet, dass es wie beschrieben funktioniert. Im offiziellen Subreddit-Thread stieß ein Kommentator auf das gegenteilige Problem:
"In English it's good but the American accent bleeds terribly into other languages."

Jemand anderes wollte die Akzentsteuerung auf Stimmenebene statt pro Zeile. Für alle, die eine lange Serie produzieren, ist das ein berechtigter Wunsch:
"I want accent/dialects to be encoded at the voice level, not have to prompt for it in every single line. It is really impossible to keep a stable idiolect that way and generic [Scottish] or whatever can still come out a million ways."
Praktisch heißt das: Wenn du mehrsprachigen Kundensupport über einen Voice Agent betreibst, erzeuge vor dem Wechsel ein Testskript in jeder deiner wichtigsten Sprachen. Laut dem Beitrag zu Turbo in Agents gab es die größten Verbesserungen bei Japanisch, brasilianischem Portugiesisch, Mandarin und Kantonesisch, die sich daher gut für den Anfang eignen.
Klingen meine geklonten Stimmen gleich?
Wahrscheinlich nicht, und ElevenLabs sagt das selbst. v4 gibt die Quellstimme genauer wieder (Klangfarbe, Rhythmus, Lautstärke, sogar Aufnahmefehler), sodass ein v4-Klon laut v4-FAQ „may sound quite different from its Eleven v3 version". Außerdem steht dort ein Satz, den jeder Audio-Verantwortliche zweimal lesen sollte: Genauigkeit und persönlicher Geschmack sind nicht immer dasselbe.
Das hat zwei Folgen:
- Dein Trainingsaudio wird wichtiger. v4 kopiert Plosive, harte Zischlaute und auch Lautstärkesprünge originalgetreu. Die Showcase-Clips auf der Doku-Seite sind absichtlich unbearbeitet, um das zu zeigen. Wenn dein Klon aus einer verrauschten Aufnahme stammt, nimm sie neu auf, bevor du dem Modell die Schuld gibst.
- Stimmen aus der Bibliothek können sich unter dir verändern. Nutzer von ElevenReader (der Hör-App) bemerkten, dass sich Stimmen mitten im Buch veränderten. Manche fanden es toll, andere nicht.
"In ElevenReader it genuinely blew me away. I didn't even know the update was coming, but suddenly my narrator sounded like an actual real human was reading my book to me."
Kreative, die eine Stimme auf einen bestimmten, zurückhaltenden Vortrag abgestimmt hatten, erlebten es anders:
"I'm actually having big issues with v4 its super expressive but for my niche its too damn theatrical and you cannot make certain voices be straight/monotone while speaking..."
Für Voice-Design-Stimmen (die aus einer Textbeschreibung erzeugt werden) gibt es ein leiseres Sternchen. Laut Dokumentation funktionieren sie auf v4, „may not be as performative or sound as good as with earlier models".
Wie funktionieren Audio-Tags und Prompting in v4?
Da die Regler für Style und Speed weg sind, muss die Regie aus dem Skript kommen. Du schreibst Tags inline, etwa [whispers], [sighs], [laughs harder] oder Geräuschhinweise wie [door slams] und [light rain], und v4 befolgt sie laut v4-Landingpage „more reliably than v3". Dazu gibt es eine Audio-Tags-Liste von ElevenLabs mit über 50 Beispielen.
Einige Hinweise aus dem Prompting-Leitfaden, die dir ein oder zwei Neugenerierungen sparen können:
- Kein SSML. Weder v4 noch v3 unterstützen SSML-Break-Tags. Das ist eine Umstellung, wenn du von einer älteren Speech-API kommst. Nutze stattdessen Auslassungspunkte und Zeilenumbrüche oder Tags wie
[short pause]oder[long pause]. - Tags können als Soundeffekte missverstanden werden. v4 erzeugt neben Stimmen auch Soundeffekte, ein vager Tag kann also als Geräusch herauskommen. Die Dokumentation empfiehlt etwas Beschreibenderes, etwa
[low, gravelly voice]. - Tags funktionieren am besten innerhalb des Stimmumfangs. Eine Stimme, die in ihren Trainingsdaten nie geflüstert hat, kann
[whispering]trotzdem folgen, aber „the result may not be optimal". - IPA-Aussprache ist jetzt nativ. Du setzt IPA-Symbole direkt im Text in Schrägstriche, XML-Phonem-Tags sind nicht nötig. Das ist praktisch für Medikamentennamen, Produktnamen oder Ortsnamen, die ein Support-Voice-Agent richtig aussprechen muss.
Von allen Beschwerden, die ich gesehen habe, kam der fehlende Speed-Regler am häufigsten vor. Ein Creator schrieb im selben Reddit-Thread, v4 „does seem to be speaking much faster (there isn't a slider in the voice settings to control that)", und der Moderator des Subreddits gab es als Feedback weiter. Bis sich das ändert, regelst du das Tempo im Text, mit kürzeren Sätzen und expliziten Pause-Tags.
Was kostet Eleven v4?
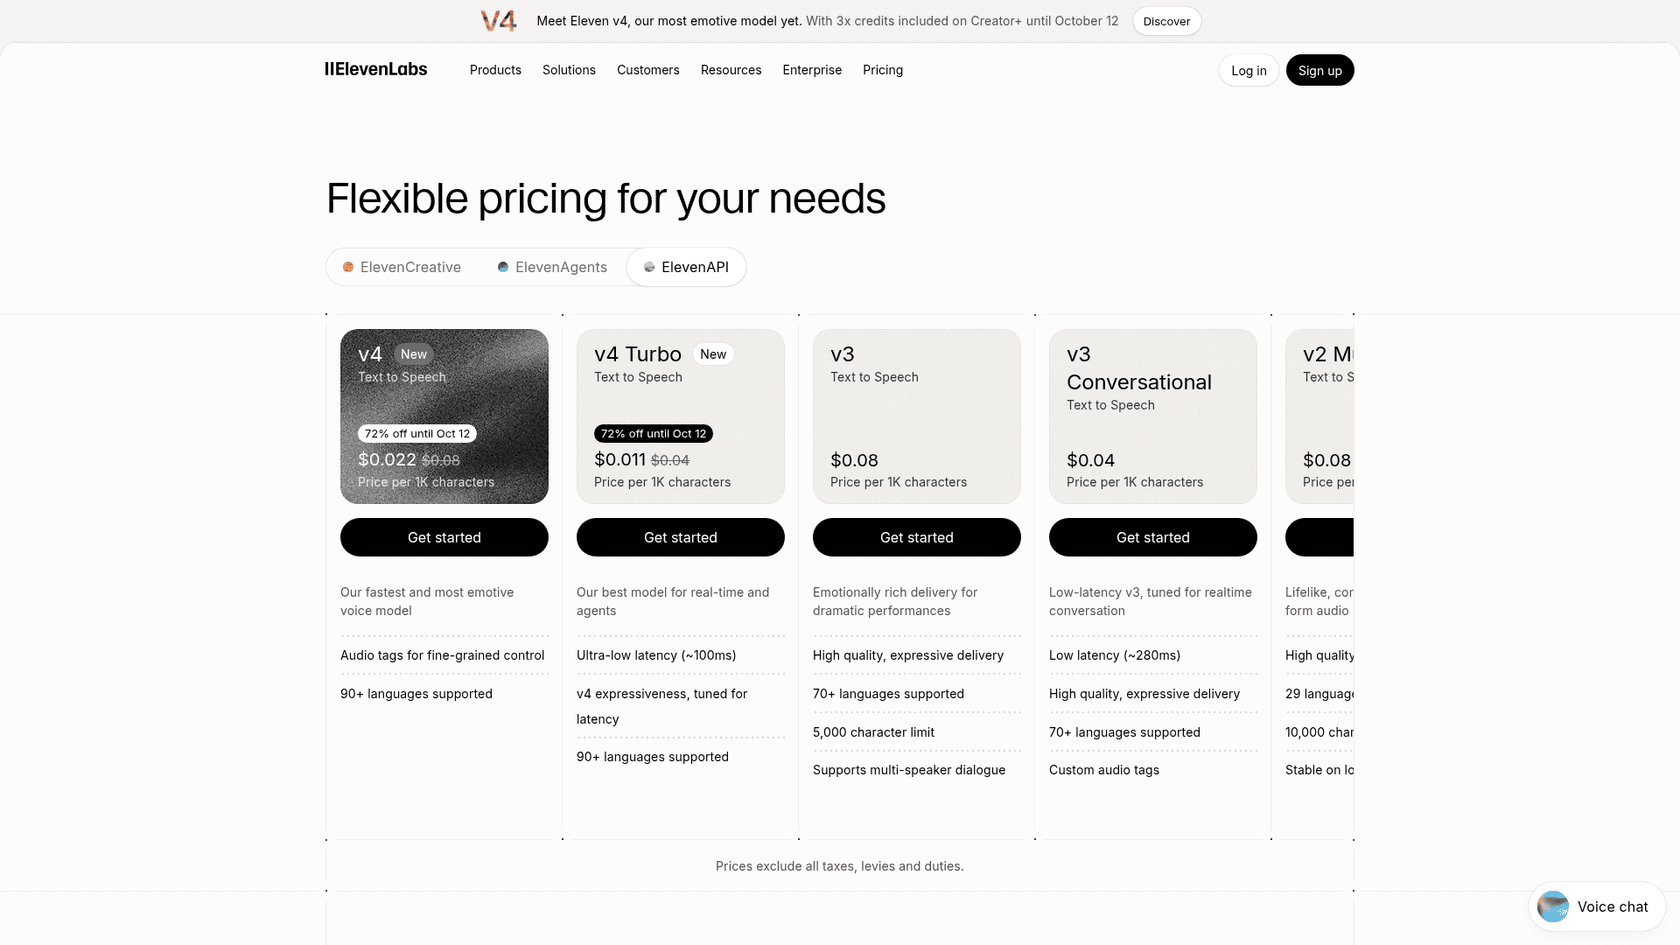
Zum Listenpreis kostet Eleven v4 über die API genauso viel wie v3, und Turbo entspricht v3 Conversational. Derzeit gibt es laut API-Preisseite außerdem einen Launch-Rabatt von 72 % bis zum 12. Oktober 2026.
| Modell | Listenpreis pro 1.000 Zeichen | Launch-Preis (bis 12. Okt.) | Latenz | Zeichenlimit |
|---|---|---|---|---|
| Eleven v4 | 0,08 $ | 0,022 $ | Nicht in Echtzeit | 10.000 |
| Eleven v4 Turbo | 0,04 $ | 0,011 $ | ~100 ms | Streaming |
| Eleven v3 | 0,08 $ | n/a | Nicht in Echtzeit | 5.000 |
| Eleven v3 Conversational | 0,04 $ | n/a | ~280 ms | Streaming |
| Flash v2.5 | 0,04 $ | n/a | ~75 ms | 40.000 |
In der Web-App zieht v4 aus demselben monatlichen Credit-Pool wie alles andere. Die aktuellen Tarife auf der ElevenCreative-Preisseite sind Free (0 $, 10.000 Credits), Starter (6 $, 30.000), Creator (22 $, 121.000), Pro (99 $, 600.000), Scale (299 $, 1,8 Mio.) und Business (990 $, 6 Mio.). Laut Preis-FAQ kostet Text to Speech etwa 1 Credit pro Zeichen. Für Creator-Tarife und höher gibt es zudem eine Launch-Aktion, bei der v4-Nutzung bis zum Doppelten deiner monatlichen TTS-Credits in den Web- und Mobile-Apps nicht auf dein Guthaben angerechnet wird. Merkwürdigerweise widersprechen sich das Banner und der Aktionsabschnitt auf dieser Seite, ob es das Zwei- oder Dreifache ist, prüfe also dein eigenes Guthaben, bevor du damit planst. Mein ElevenLabs-Preisleitfaden geht jeden Tarif durch, und der Beitrag zu den ElevenLabs-Bewertungen zeigt, was zahlende Nutzer zum Credit-System sagen.
Ein Rechenbeispiel. Ein Reddit-Nutzer fragte, was ein 8-stündiges Hörbuch kosten würde, hier die Rechnung. Die Dokumentation setzt 10.000 Zeichen bei etwa 10 Minuten Audio an, was 8 Stunden auf rund 480.000 Zeichen bringt:
- Eleven v4 über die API zum Listenpreis: 480 × 0,08 $ = 38,40 $
- Eleven v4 zum Launch-Preis: 480 × 0,022 $ = 10,56 $
- Eleven v4 Turbo zum Listenpreis: 480 × 0,04 $ = 19,20 $
- In der App: etwa 480.000 Credits, das passt in die 600.000 des Pro-Tarifs für 99 $/Monat.
Voice Agents werden nicht pro Zeichen abgerechnet. Die ElevenAgents-Preise laufen stattdessen pro Gesprächsminute, mit Tarifen von Free (15 Minuten) bis Business (990 $ für 12.375 Minuten), zusätzlichen Minuten zu je 0,08 $ und separat berechnetem LLM. Dieselbe Rechnung habe ich im Überblick zu den besten AI-Voice-Agents aufgeschlüsselt.
Solltest du Eleven v4 Turbo auf deine Support-Hotline legen?

ElevenLabs zielt Turbo eindeutig auf den Kundenservice. Der ElevenAgents-Launch-Beitrag spricht von Agenten, die „apologetic about a missed delivery, brisk when someone just wants a confirmation" klingen, und auf der v4-Seite wird das Agentforce-Voice-Team von Salesforce zitiert, das Turbos „faster, more natural responses" lobt.
Es landet außerdem in einem vollen Monat: OpenAIs GPT-Live-1, xAIs Grok Voice Think Fast 2 und Decagon Voice 3 zielen alle auf dieselben Support-Anrufe.
Auch Salesforce hat mit seinem AI-Voice-Agent eine eigene Geschichte. Für Anrufer ist das eine echte Verbesserung, denn ein monotoner Bot, der eine Erstattungsrichtlinie vorliest, ist ein Grund, warum Leute die Null drücken, um einen Menschen zu erreichen. Was ein TTS-Launch nicht beheben kann, ist die Antwort selbst. Die Stimme liest, was der Agent erzeugt hat, und eine wunderbar mitfühlende Stimme, die die falsche Erstattungsfrist bestätigt, ist trotzdem falsch, nur klingt es jetzt überzeugender.
Jahre der Beobachtung von KI in echten Support-Warteschlangen führen zur selben Lehre. Genauigkeit kommt aus dem, was der Agent weiß (dein Help Center, Makros und bisherige Tickets), und daraus, ihn zu testen, bevor es Kunden tun. Deshalb wird jeder eesel-Rollout zuerst gegen historische Tickets simuliert. Wenn du Voice-Plattformen in die engere Wahl nimmst, vergleichen meine Leitfäden zu AI-Call-Center-Agenten, Retell AI und Vapi, wie jede Wissen und Übergabe sowie Helpdesk-Integrationen handhabt.
Mein Voice-Support-Überblick stellt sie alle nebeneinander.
Voice ist außerdem ein kleinerer Teil des Supports, als es sich anfühlt. Die meisten Teams bekommen den Großteil ihres Volumens weiterhin über Tickets und Chat, dort zeigen sich Probleme mit der Antwortqualität also zuerst. Wenn du schon Zendesk nutzt, können dessen Voice-AI-Agenten und eine AI-Kundensupport-Schicht für die Ticket-Warteschlange dasselbe Wissen teilen.
Teste eesel für die Antworten hinter der Stimme
eesel ist eine Plattform für AI-Teammates, und der AI-Helpdesk-Teammate ist genau für dieses Problem gebaut. Er schaltet sich in deine bestehende Zendesk-, Freshdesk- oder Gorgias-Warteschlange ein, lernt aus deinen bisherigen Tickets und dem Help Center und entwirft oder sendet Antworten im Ton deines Teams. Bevor er einen echten Kunden berührt, kannst du ihn in einer Simulation über deine historischen Tickets laufen lassen und sehen, was er gesagt hätte.
Um beim Umfang ehrlich zu sein: eesel ist heute textbasiert, es bearbeitet Tickets und Chat, kein Telefonaudio. Ein Support-Team, das eesel nutzt, sagte mir, Sprachaufzeichnungs-Support würde „would significantly increase our usage", weshalb es auf dem Radar steht. Wenn du eine Voice-Plattform mit Eleven v4 Turbo kombinierst, deckt eesel die Ticket-Seite desselben Wissens ab, und mit der eesel CLI (mehr in diesem AI-Agent-CLI-Leitfaden) kann ein Skript oder ein Coding-Agent wie Claude Code dieses Wissen aktualisieren und Antworten im Terminal testen, sodass beide Kanäle synchron bleiben. Die Tarife starten kostenlos mit 100 Credits auf der Preisseite, und jedes bearbeitete Ticket oder jeder Chat kostet einen Credit.
Teste eesel und sieh, wie es mit den Tickets des letzten Monats umgeht, bevor du irgendetwas entscheidest.
Häufig gestellte Fragen
Was ist Eleven v4?
eleven_v4 für Inhalte und eleven_v4_turbo für Echtzeit-Einsätze, deckt über 90 Sprachen ab und unterstützt wieder Professional Voice Clones, die in v3 gefehlt haben.