

SeedRealtime ist ByteDance Seeds natives audiovisuelles Full-Duplex-Modell, angekündigt am 5. August 2026. Audio, Video und Text fließen in eine einzige Architektur, sodass das Modell Ihre Kamera sieht, Sie hört und spricht, alles im selben Kreislauf, ohne dass ein separater Sprachaktivitätsdetektor entscheidet, wann sein Redeanteil beginnt. Die Live-Demos drehen sich um das Auflösen von Bezügen, nicht um Geschwindigkeit: Das Modell erkennt, welches Diagramm mit „dieses Diagramm von eben" gemeint ist.
Hier ist der Teil, den die Launch-Berichterstattung übersprungen hat. ByteDance hat genau eine Zahl dazu veröffentlicht, eine firmeneigene menschliche Bewertung, nach der sich Probleme beim Gesprächstempo im Vergleich zu nicht näher benannten „kaskadierten Modellen" halbiert haben. Es gibt kein technisches Paper, keine offenen Gewichte, keine Benchmark-Tabelle, keine API und keinen Preis. Es fehlt auch im Artificial-Analysis-Ranking für Sprache-zu-Sprache, in dem Alibabas Qwen und StepFun beide auftauchen, weshalb es sich um eine Lücke bei ByteDances Einreichung handelt und nicht um eine Lücke bei China.
Und der unangenehme Teil: Die Achse, auf die SeedRealtime optimiert, ist genau die, die das Feld schon fast gelöst hat. Der Bestwert bei der Gesprächsdynamik liegt bei 98,4 %. Der Bestwert beim tatsächlichen Lösen einer Support-Aufgabe liegt bei 56,5 %. Wenn Sie etwas für eine echte Warteschlange suchen: Ich beobachte seit mehr als drei Jahren bei eesel, wie KI-Agenten echte Support-Tickets bearbeiten, und das, was darüber entscheidet, ob ein Rollout überlebt, war noch nie, wie elegant der Bot seinen Redeanteil übernimmt.
Was SeedRealtime wirklich ist
SeedRealtime ist in Seeds Modellindex unter GenMedia eingeordnet, neben Seedance, Seedream und Seeduplex. ByteDances Kurzversion: ein natives audiovisuelles Full-Duplex-LLM, das „Audio-, visuelle und zeitliche Informationen gemeinsam verstehen" kann, herausfindet, von welchem Ding im Raum Sie sprechen, und antwortet, ohne auf ein eindeutiges Signal für das Ende des Redeanteils zu warten.
„Full-Duplex" lohnt sich genauer anzuschauen, weil der Begriff locker verwendet wird. Ein Half-Duplex-Sprachmodell funktioniert wie ein Walkie-Talkie: Sie sprechen, es wartet, Sie hören auf, es antwortet. Ein Full-Duplex-Modell hört zu, während es spricht, kann also unterbrochen werden, merken, dass Sie verstummt sind, oder beschließen, still zu bleiben, weil Sie mit jemand anderem im Raum gesprochen haben. Der größte Teil des Feldes hat Audio-Full-Duplex in den letzten zwei Jahren erreicht, GPT Realtime eingeschlossen. SeedRealtimes Anspruch ist, dass der Videostrom im selben Duplex-Kreislauf steckt, statt als Nebenkanal angeflanscht zu sein.
Der Launch-Beitrag gliedert die Fähigkeiten in drei Teile, und jeder davon verlangt etwas anderes von einem Modell:
- Gemeinsames audiovisuelles Verständnis. Ein Homophon anhand dessen aufzulösen, was auf dem Bildschirm zu sehen ist, einen visuellen Bezug über mehrere Redeanteile hinweg zu verfolgen und eine Stimme an eine Person zu binden, damit das Modell weiß, wer was gesagt hat.
- Proaktive Interaktion. Auf eine Veränderung in der Szene zu reagieren statt nur auf eine Frage, und Tool-Aufrufe mitten im Satz in eine Antwort einzuflechten.
- Gesprächs-Timing. Zu entscheiden, wann es sich einschaltet, pausiert oder zurückhält, und Nebengespräche und Hintergrundgeräusche auszufiltern, statt jedes Geräusch als Eingabe zu behandeln.
Sieben Demo-Videos tragen die Ankündigung: Sprecher an einem Esstisch identifizieren, eine Speisekarte aus Sichuan übersetzen, jemanden im Hebei-Museum daran erinnern, dass er schon zu lange steht, einen Espresso-Bezug korrigieren, einen Abschnitt im ResNet-Paper aufspüren, Fehlauslösungen im Lärm des Flughafens Daxing widerstehen und die Aussprache eines Kindes über Hintergrundgemurmel hinweg coachen. Das ist eine gute Showreel. Es ist aber auch, wie ich noch zeigen werde, die gesamte veröffentlichte Beweisgrundlage.
Wie sich die Architektur von einem kaskadierten Sprach-Stack unterscheidet
Die meisten Sprachassistenten, die Sie kennen, sind ein Staffellauf. Spracherkennung wandelt Ihr Audio in Text um, ein Vision-Modell beschreibt separat Ihr Kamerabild, ein Sprachmodell liest beide Transkripte, und eine Text-to-Speech-Engine liest die Antwort vor. Ein Sprachaktivitätsdetektor sitzt außerhalb der gesamten Kette und entscheidet, wann Ihr Redeanteil endete.
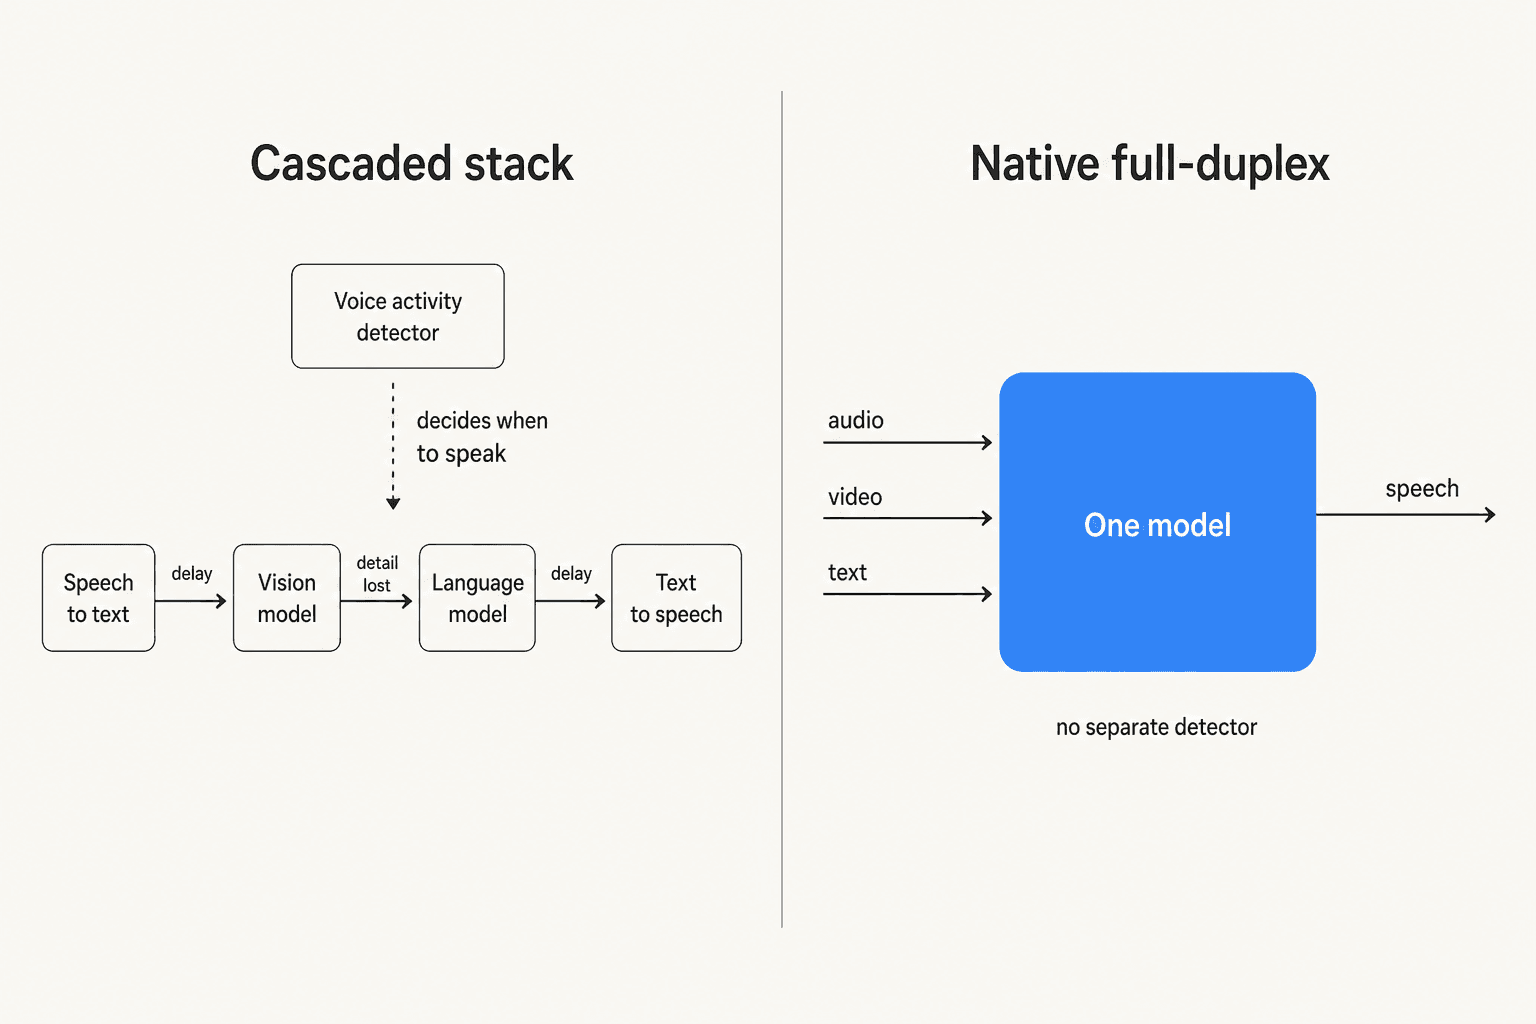
Dieses Design hat zwei Kosten, und ByteDance nennt beide. Jede Nahtstelle fügt Verzögerung hinzu, und jede Nahtstelle wirft Informationen weg. Tonfall, Zögern, die Tatsache, dass Sie beim Sprechen auf etwas gezeigt haben: Nichts davon überlebt die Reise durch ein Transkript. SeedRealtimes Versprechen ist, dass Wahrnehmung, Verständnis, Entscheidungsfindung und Ausdruck alle innerhalb eines Modells über kontinuierliche Datenströme ablaufen, sodass auf dem Weg nichts zu Text verflacht werden muss. Niedrige Latenz kommt aus blockweise verarbeitetem audiovisuellem Input, Streaming-Generierung, Quantisierung und Inferenzoptimierung, nicht aus einem einzelnen Trick.
Das schärfste architektonische Detail ist das, dem am wenigsten Aufmerksamkeit geschenkt wird: Es gibt keinen externen Sprachaktivitätsdetektor. Die Entscheidung, wann jemand an der Reihe ist, trifft das Modell allein aus dem multimodalen Signal. Deshalb funktioniert die Museums-Demo überhaupt, denn „diese Person steht schon eine Weile" ist kein Satz, den irgendjemand laut ausgesprochen hat. Deshalb zählt die Flughafen-Demo auch mehr, als sie zunächst wirkt, denn ein Modell, das selbst entscheidet, wann es dran ist, kann auch falsch entscheiden, und Fehlauslösungen in einem lauten Raum sind genau der Fehlerfall.
Ein Recap-Account auf X brachte den Unterschied zu OpenAI präziser auf den Punkt als die meiste englischsprachige Berichterstattung:
"除了有视觉能力外,跟GPT-Live的委派推理方式不同的是 SeedRealtime将声音、画面、时序与表达纳入到同一个模型实时决策,听、看、理解、推理、说话全在一个模型里"
Die Übersetzung: Über die zusätzliche Bildverarbeitung hinaus liegt der Unterschied zu GPT Lives Ansatz der delegierten Inferenz darin, dass SeedRealtime Klang, Bild, Timing und Ausdruck in ein Modell packt, das in Echtzeit entscheidet, sodass Hören, Sehen, Verstehen, Schlussfolgern und Sprechen alle am selben Ort stattfinden. Das ist eine faire Beschreibung des Designs, und sie stammt von einem Account, der die Ankündigung zusammenfasst, nicht sie getestet hat.
Die eine Zahl, die ByteDance veröffentlicht hat
Ich habe nach einer Benchmark-Tabelle gesucht und einen Satz gefunden. Die einzige quantitative Aussage im gesamten Launch ist, dass eine End-to-End-Bewertung durch Menschen zeigte, dass sich Probleme beim Gesprächstempo im Vergleich zu kaskadierten Modellen halbiert haben, zusammen mit qualitativen Verbesserungen bei Unterbrechungen, Latenz und Fehlauslösungen.
Nimmt man diese Aussage ernst, bleibt sie trotzdem dünn auf jeder Achse, die eine Überprüfung erlauben würde. Keine Zahl zu den Bewertenden. Keine Stichprobengröße. Kein benannter Bewertungsdatensatz. Kein Protokoll. Und die Vergleichsbasis ist die allgemeine Kategorie „kaskadierte Modelle", kein benannter Wettbewerber, den man selbst nachmessen könnte. Ich sage nicht, dass sie falsch ist. Ich sage, dass es eine Herstellerangabe ist, und sie sollte jedes Mal, wenn sie wiederholt wird, auch so gekennzeichnet werden.
Zwei weitere Zahlen kursieren in der Berichterstattung, und beide sind Fallen. Die „2 bis 3 Sekunden" in der Espresso-Demo sind der Ratschlag des Modells zur Espresso-Extraktion, keine Systemlatenz. Und die arXiv-ID, die als SeedRealtime-Paper kursiert ist, 2508.02193, gehört zu etwas völlig anderem: Seed Diffusion, einem Diffusionsmodell mit diskreten Zuständen für Code, ohne jede Verbindung zu Audio oder Video.
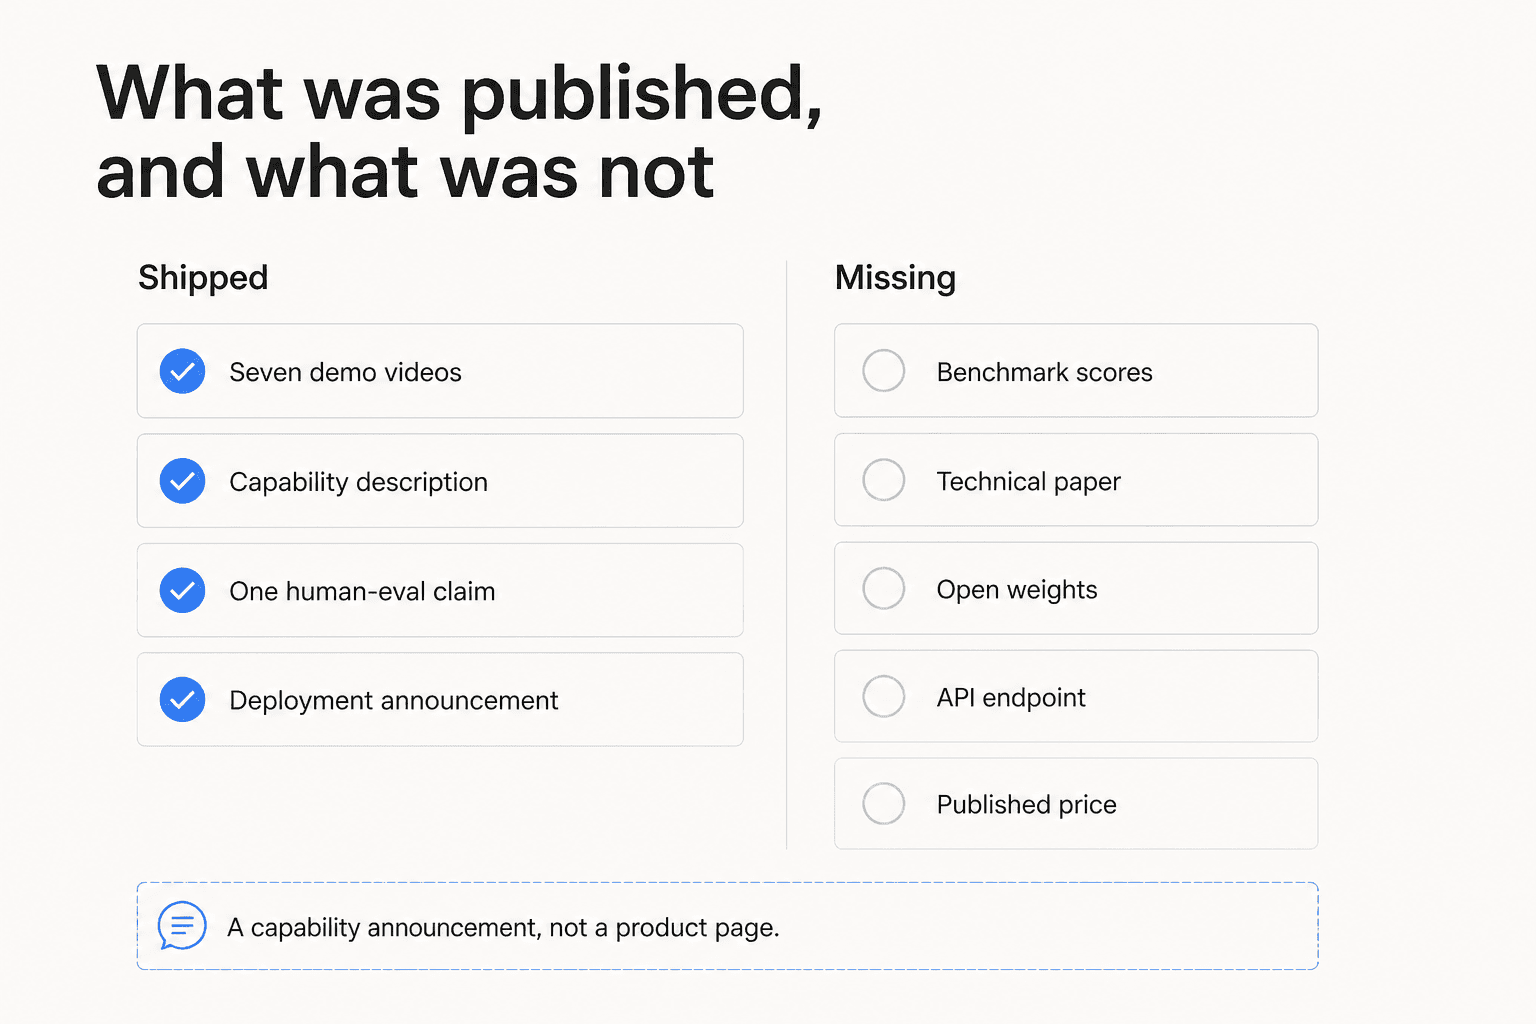
Es gibt kein SeedRealtime-Paper. Eine arXiv-Volltextsuche liefert null Ergebnisse, mit funktionierenden Kontrollsuchen in derselben Sitzung. Das aufschlussreichste Signal kommt aus dem Team selbst: Seed-Forscher Panwang Pan listet SeedRealtime unter seinen eigenen ausgewählten Arbeiten mit Links zu Project, ModelCard und Blog, aber ohne Paper-Link, während jeder andere Eintrag auf dieser Seite einen hat. Die Gewichte sind geschlossen, es gibt kein Repo weder in der ByteDance-Seed-GitHub-Organisation noch auf Hugging Face.
Das ist eine Entscheidung, keine Norm. Kimi K3 kam mit einer vollständigen Benchmark-Tabelle heraus. DeepSeek V4 Flash ebenfalls. Dass ein chinesisches Labor überprüfbare Werte veröffentlicht, ist 2026 nichts Besonderes.
Der Benchmark, den niemand durchgeführt hat
Hier ist der Befund, der den gesamten Beitrag für mich neu einordnete. SeedRealtime taucht nirgends im Artificial-Analysis-Ranking für Sprache-zu-Sprache auf. Auch kein anderes Modell von ByteDance, Doubao, Seed oder Volcengine, über fünf Diagramme und eine Zusammenfassungstabelle mit 36 Zeilen, abgerufen am 18. August 2026. Alibaba Cloud und StepFun sind beide gelistet, und Qwen führt derzeit zwei der drei Teil-Benchmarks an, also ist „chinesisches Labor, deshalb fehlt es" nicht die Erklärung.
Das ist wichtig, weil es um das geht, was die beiden wichtigsten Benchmarks messen.
Full Duplex Bench bewertet die Mechanik eines Live-Gesprächs: während einer Pause nicht zu unterbrechen, den Redeanteil korrekt zu übernehmen, mit einem dazwischenredenden Nutzer umzugehen und über ein „mhm" hinweg weiterzumachen. Genau darum geht es bei SeedRealtimes Tempo-Behauptung. Die Obergrenze liegt bei 98,4 %, gehalten von Qwen Audio 3.0 Realtime Plus, und die aktuelle GPT-Realtime-Familie liegt im Band von 91 bis 96 %. Die Spitze dieser Tabelle ist gestaucht, was die höfliche Art ist zu sagen, dass die Gesprächsdynamik unter den Führenden niemanden mehr unterscheidet. Gemini 3.1 Flash Live mit 74,3 % ist das einzige Spitzenmodell, das sie noch trennt.
𝜏-Voice bewertet etwas anderes: den Anteil der nachgebildeten Kundenservice-Szenarien, die als Support-Agent gelöst wurden. Ein Sprach-Nutzer-Simulator ruft das Modell mit einer Flugänderung, einer strittigen Abbuchung oder einem Telekom-Defekt an. Jede Aufgabe hat einen gültigen Datenbank-Endzustand, und die Bewertung vergleicht den Endzustand mit der Ground Truth. Sie misst, ob die Arbeit erledigt wurde, nicht, ob das Modell hilfsbereit klang. Die Obergrenze liegt dort bei 56,5 %, gehalten von Grok Voice Think Fast 2.0 High.
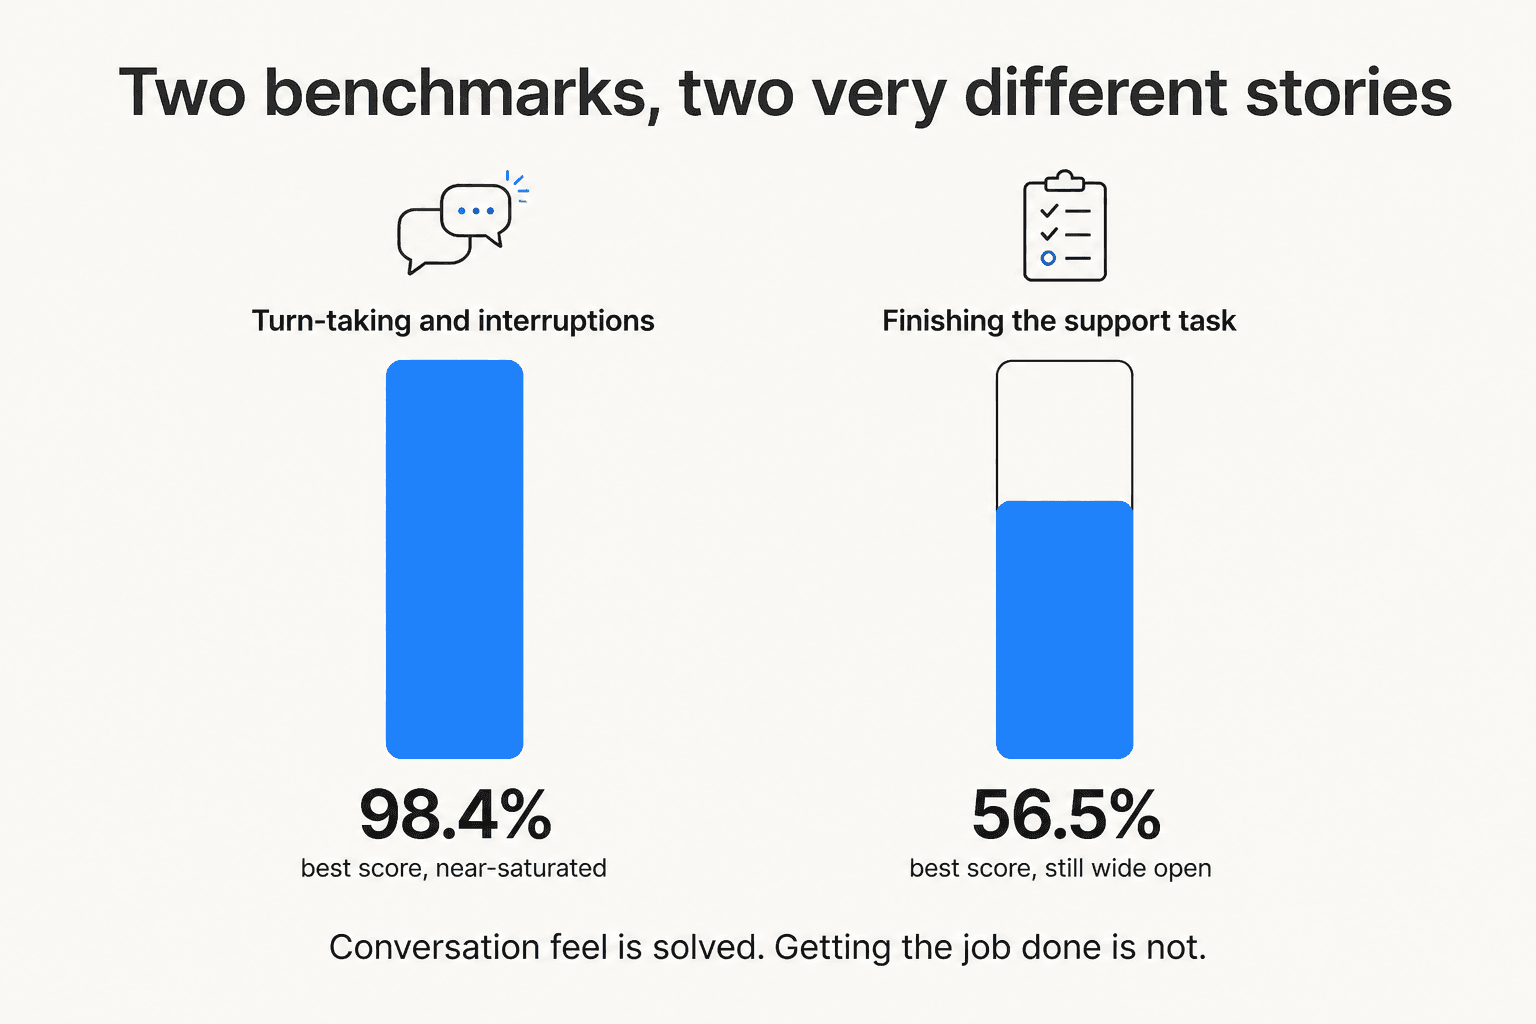
Lassen Sie diese Lücke wirken. Der beste verfügbare Sprach-Agent scheitert an rund 43 % der nachgebildeten Support-Aufgaben, während fast jedes Spitzenmodell den Rhythmus des Gesprächs fast perfekt beherrscht. Die Branche hat gelöst, wie eine Sprach-KI klingt, aber nicht, ob sie die Aufgabe erledigt. Die vollständige Rangliste, für die gemessenen Modelle:
| Modell | S2S-Index | Sprachschlussfolgerung | Gesprächsdynamik | 𝜏-Voice (Aufgabenerfüllung) | Zeit bis zum ersten Audio |
|---|---|---|---|---|---|
| Qwen Audio 3.0 Realtime Plus | 84,1 % | 99 % | 98,4 % | 54,6 % | 1,54 s |
| Grok Voice Think Fast 2.0 High | 82,9 % | 97 % | 95,1 % | 56,5 % | 0,70 s |
| GPT-Realtime-2.1 High | 79,1 % | 96 % | 95,7 % | 45,7 % | 1,21 s |
| Qwen Audio 3.0 Realtime Flash | 76,3 % | 96 % | 96,9 % | 35,9 % | 1,55 s |
| Gemini 3.1 Flash Live High | 69,5 % | 97 % | 74,3 % | 37,7 % | 2,99 s |
| Deepslate Opal | 62,8 % | 85 % | 85,7 % | 17,5 % | 0,44 s |
| SeedRealtime | nicht benchmarkt | nicht benchmarkt | nicht benchmarkt | nicht benchmarkt | nicht veröffentlicht |
Beachten Sie, wo das schnellste Modell landet. Deepslate Opal antwortet in 0,44 Sekunden und löst 17,5 % der Aufgaben. Latenz ist schon seit einer Weile nicht mehr der Flaschenhals, zu demselben Schluss bin ich aus einem anderen Blickwinkel in meiner Modellaufstellung für Support-Tickets gekommen.
Was Leute sagen, die es tatsächlich genutzt haben
Das Community-Signal zu diesem Launch ist dünn und einseitig, und das ist selbst aufschlussreich. Reddit hat nichts: r/LocalLLaMA diskutierte im selben Zeitraum aktiv über Full-Duplex-Optionen und erwähnte SeedRealtime kein einziges Mal, was zu erwarten ist, wenn es keine Gewichte zum Herunterladen gibt. Hacker News hat einen Beitrag mit 1 Punkt und 0 Kommentaren. LinkedIn besteht aus rund zehn Reposts derselben Recap-Schlagzeile. Die eigentliche Reaktion findet auf X statt.
Die fachlich glaubwürdigste Stimme gehört jemandem, der beruflich an Sprachmodellen arbeitet, und sie ist gleichzeitig eine Beschwerde über den fehlenden Zugang:
"why aren't more people talking about this?? audio-visual native FDX model is impressive, especially its ability to proactively detect and interact with the user based on visual cues.
GPT Live 1 is pure audio-only and doesn't have this capability.
has anyone tried it on Doubao? i don't have a Chinese phone number but really want to try 🥹"
Der Account, der die Nachricht zuerst auf Englisch verbreitete, sagte dasselbe mit weniger Worten: „I wish it would be testable globally 😬".
Der einzige inhaltlich substanzielle Praxisbericht, den ich gefunden habe, ist auf Chinesisch, und was er lobt, ist nicht das, was die Schlagzeile verkauft:
"测试让豆包陪我一起看一个Youtube视频,画面出现个人,直接问这人是谁,竟然答对了!画面有个一闪而过的图表,问:"刚才有个图表,你能给我解读下吗?"。它竟然知道我指的是哪个图,并完整解释。"
Er ließ Doubao mit ihm ein YouTube-Video ansehen, fragte, wer eine Person im Bild sei, und bekam die richtige Antwort, fragte dann nach einem Diagramm, das kurz aufgeblitzt war, und das Modell wusste, welches Diagramm er meinte, und erklärte es vollständig. Das ist das Auflösen von Bezügen, nicht Geschwindigkeit, und es ist die konkreteste verifizierte Aussage, die irgendjemand über dieses Modell gemacht hat. Eine Fortsetzung behandelt, wie er mit dem Finger auf einen Knopf an einem physischen Verstärker zeigt und eine sinnvolle Antwort bekommt.
Zwei Einwände kamen auf, beide von einzelnen Accounts mit geringer Reichweite, also eher als Einzelmeinungen zu lesen als als breite Stimmung. Alex Volkov von ThursdAI zur Kostenlos-in-Doubao-Einordnung: „Free or charge... holy surveilance" (Tippfehler im Original). Und ein schärferer methodischer Einwand zur Dinner-Party-Demo:
"holding onto four names through overlapping crosstalk is a harder party trick than watching and listening at the same time, most "multimodal" demos never actually test the crosstalk part."
Das ist der richtige Instinkt. Der Fall mit sich überlappenden Gesprächen ist der interessante, und eine Demo-Reel ist kein adversariales Testen.
Können Sie darauf aufbauen? Die Namensfalle mit drei Modellen
Hier gehen die meisten Berichte schief, deshalb lohnt sich Präzision. ByteDance hat drei Realtime-Modelle mit verwirrend ähnlichen Namen, und nur zwei davon sind käuflich.
| Modell | Was es ist | Heute abrufbar? |
|---|---|---|
| SeedRealtime | Natives audiovisuelles Full-Duplex: Audio, Video und Text in einem Modell | Nein. Nur in der Doubao-App. Keine API, kein Preis. |
Seeduplex (豆包实时语音模型 3.0, Modell 1.2.6.1) | Natives sprachbasiertes Full-Duplex, Zuhören während des Sprechens, adaptive Endpunkterkennung | Ja, über WebSocket |
| Doubao-Seed-RealtimeVoice (O2.0 / SC2.0) | Älteres Half-Duplex, reines Audio-Sprache-zu-Sprache | Ja, aber die Dokumentation ist inzwischen als Legacy eingestuft |
Die schlichte Version: Das Einzige, was Sie kaufen können, ist reine Sprache. Die Bildverarbeitung, die SeedRealtime interessant macht, steht nicht zum Verkauf. Ich habe die Volcengine-Abrechnungsspezifikation für Sprache geprüft, die jede käufliche Sprach-SKU auflistet, die Ark-Modellpreisliste und die Doubao-Produktpreistabelle. SeedRealtime hat auf keiner davon einen Posten, weder Prepaid noch Postpaid. Jeder Hinweis darauf, dass es ausgeliefert wird, bezieht sich auf die App.
Volcengines Dokumentation vermerkt auch, dass die O- und SC-Versionen des älteren Modells keine eigenständige Weiterentwicklung mehr erhalten, da die Fähigkeiten in die 2.0-Linie zusammenfließen. Wenn Sie heute starten, ist Seeduplex also das Modell, auf das Sie bauen sollten.
Was Seeduplex wirklich kostet
Das käufliche Realtime-Modell wird pro Token abgerechnet, nicht pro Minute, und ausschließlich postpaid. Es ist die einzige Sprach-SKU ohne Prepaid-Ressourcenpaket in Volcengines gesamter Rabattstaffel, das heißt, Sie zahlen unabhängig von Ihrem Volumen den Listenpreis. Die Sätze unten sind umgerechnet zu ¥6,74 pro Dollar (USD/CNY 6,7411, 17. August 2026); Volcengine rechnet ausschließlich in Yuan ab.
| Zähler | Preis (CNY) | Ca. USD |
|---|---|---|
| Eingabe, Text | ¥10 / Mio. Token | 1,48 $ / Mio. |
| Eingabe, Audio | ¥80 / Mio. Token | 11,87 $ / Mio. |
| Eingabe, gecacht (Text oder Audio) | ¥5 / Mio. Token | 0,74 $ / Mio. |
| Ausgabe, Text | ¥80 / Mio. Token | 11,87 $ / Mio. |
| Ausgabe, Audio | ¥300 / Mio. Token | 44,51 $ / Mio. |
Volcengine veröffentlicht die Umrechnung von Audio zu Token, was den Vergleich mit einem Minutenpreis erst möglich macht: Eingabe-Audio läuft mit etwa 6,25 Token pro Sekunde, Ausgabe-Audio mit etwa 25 Token pro Sekunde. Rechnet man das durch, wird die Form der Rechnung offensichtlich.
| Abgeleitete Einheit | CNY | USD |
|---|---|---|
| 1 Minute Nutzersprache eingehend | ¥0,030 | 0,0045 $ |
| 1 Minute Modellsprache ausgehend | ¥0,450 | 0,067 $ |
| 1 Stunde Dialog, gleich aufgeteilt, nur Audio | ¥14,40 | 2,14 $ |
| 1 Stunde durchgehende Modellsprache | ¥27,00 | 4,01 $ |
Diese abgeleiteten Zeilen sind meine eigene Rechnung auf Basis von ByteDances eigener Umrechnung, kein veröffentlichter Minutenpreis, und eine echte Rechnung fällt höher aus, weil jeder Redeanteil zusätzlich Text-Token und den anwachsenden Kontext mitträgt. Volcengines eigenes Rechenbeispiel beziffert einen einzelnen 40-Sekunden-Austausch auf ¥0,0974, etwa 0,014 $.
Zur Einordnung, ob das teuer ist: OpenAI listet GPT Realtime-Audio mit 32 $ pro Million Eingabe-Token und 64 $ pro Million Ausgabe, während Googles Gemini 3.1 Flash Live bei 3,00 $ Eingabe und 12,00 $ Ausgabe pro Million liegt, umgerechnet etwa 0,005 $ und 0,018 $ pro Minute. ByteDance liegt bei der Eingabe zwischen beiden und bei der Ausgabe über Google, und meine Aufstellung zu Gemini-Preisen zeigt Googles vollständige Preistabelle. GPT Realtime Mini-Preise deckt OpenAIs günstigere Stufe ab.
Der Hebel steht direkt in der Tabelle. Ausgabe-Audio kostet pro Sekunde fünfzehnmal mehr als Eingabe-Audio, also ist die wichtigste Stellschraube, die Sie kontrollieren, wie viel das Modell redet. Ein Vorbehalt zur Preistabelle selbst: Die Tabelle listet Ausgabe-Text mit ¥80 pro Million Token, aber das Rechenbeispiel auf derselben Seite berechnet damit ¥30, und nur ¥30 passt zur angegebenen Gesamtsumme. Behandeln Sie diese Zeile als ungeklärt, bis Sie eine echte Rechnung gesehen haben.
Die Zugangsdetails, die entscheiden, ob das für Sie real ist
Die Kosten sind der leichte Teil. Die Reibung steckt überall sonst, und es lohnt sich, sie schlicht aufzuzählen, weil nichts davon in der Ankündigung auftaucht.
- Nur WebSocket, unter
wss://openspeech.bytedance.com/api/v3/duplex/realtime/dialogue, mit einem einzigenX-Api-Key-Header undmodelfest auf1.2.6.1. - Im Stil von OpenAI-Realtime, aber nicht OpenAI-kompatibel. Die Event-Namen sind entlehnt (
session.create,conversation.item.create,response.cancel), aber es ist Volcengines Endpunkt mit Volcengines Authentifizierung. Vertraut zu lesen, aber kein direkter Ersatz, was eine andere Situation ist als die in meinem Walkthrough zu Realtime API und WebRTC beschriebene. - Obergrenzen, die Sie sich nicht freikaufen können. 60 Sitzungen pro Minute, 100.000 Token pro Minute, und das Realtime-Modell fehlt in der Concurrency-Add-on-Tabelle, die Text-to-Speech und Spracherkennung abdeckt. Höhere Limits laufen über den Vertrieb.
- Chinesisch-zentriert, und die Dokumentation sagt das auch. Eine Seite nennt Unterstützung für Chinesisch und Englisch; der Abschnitt zu den Einschränkungen auf derselben Seite sagt, dass das End-to-End-Modell nur gute Unterstützung für Chinesisch bietet und andere Sprachen nicht garantiert. Vier Premium-Stimmen auf Chinesisch, drei US-englische Stimmen, die nur in einer älteren Modellversion verfügbar sind.
- In der Praxis ein Festland-China-Konto. Preise nur in Yuan, eine feste Region cn-beijing, ausdrückliche Dienstaktivierung und standardmäßig aktivierte Inhaltsmoderation.
- Der Kontext beträgt insgesamt 12K, inklusive Systemprompt und Gesprächsverlauf.
Für ein Support-Team außerhalb Chinas ist diese Liste die Antwort. Das ist noch keine Plattform-Entscheidung.
Was das bedeutet, wenn Sie KI auf eine Support-Warteschlange setzen wollen
Ich baue KI-Agenten für Helpdesks, also lassen Sie mich direkt sagen, warum nichts von alldem meine Woche ändert.
Der Grund, warum ein Support-Rollout scheitert, ist fast nie, dass sich die Redeanteil-Übernahme der KI steif anfühlte. Es ist, dass die KI selbstbewusst und falsch geantwortet hat, oder dass sie ein Ticket beantwortet hat, das sie an einen Menschen hätte weiterleiten müssen, was ein Problem des Eskalationsdesigns ist. Ein Kunde, ein dänisches Fahrzeugtelematik-Team auf Zendesk mit rund 200 Tickets im Monat, das auf 2.000 zusteuert, traf genau das: Ihre Wissensdatenbank sagte, sie unterstützten alle Modelle, also bestätigte der Bot munter die Unterstützung für Automarken, die gar nicht in der Datenbank standen. Ein geschmeidigerer Gesprächsrhythmus löst das in keiner Weise. Besseres Retrieval und Grounding schon.
Der zweite Grund ist Kontrolle, und das ist der mit Abstand häufigste Einwand, den ich höre. Ein CX-Lead einer DTC-Nahrungsergänzungsmittel-Marke auf Gorgias und Shopify, die rund 7.000 Tickets im Monat bei 30.000 Bestellungen bearbeitet, hat es mir so beschrieben:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist ein 𝜏-Voice-Problem im Alltagsgewand. Er spricht von den 43 %. Ein Modell, das 98,4 % bei der Gesprächsdynamik und 56,5 % bei der Aufgabenerfüllung erreicht, ist aus seiner Sicht ein sehr höflicher Kollege, der in vier von zehn Fällen falschliegt und es nie sagt. Deshalb ist der nützliche Hebel Konfidenzschwellen und ein klarer Eskalationspfad, nicht ein schnelleres Modell.
Also eine praktische Einschätzung zu SeedRealtime, wenn Sie im Support arbeiten:
- Warten Sie nicht darauf. Keine API, kein Preis, kein Benchmark, nur eine chinesische App. Es ist keine Beschaffungsoption.
- Beobachten Sie die Bildverarbeitungs-Achse, nicht die Duplex-Achse. „Dieses Diagramm von eben" anhand dessen aufzulösen, was auf dem Bildschirm zu sehen ist, ist eine echte neue Fähigkeit, und sie wird zuerst beim Support per Bildschirmfreigabe und der visuellen Fehlersuche ankommen, nicht in Telefonwarteschlangen.
- Beurteilen Sie jedes Sprachmodell an der Aufgabenerfüllung. Fragen Sie jeden Anbieter nach seinem 𝜏-Voice-Wert. Gibt es keinen, ist das die Antwort. Meine Übersicht zu KI für Sprachsupport geht die gemessenen Modelle durch, und KI beantwortet Support-Anrufe deckt die operative Seite ab.
- Starten Sie dort, wo das Volumen ist. Die meisten Warteschlangen sind immer noch überwiegend textbasiert, und allein Ticket-Triage bringt mehr als ein Sprachpilot, für einen Bruchteil des Risikos. Ticket-Deflection ist die andere Maßnahme, die es sich lohnt, zuerst anzugehen.
Für das weitere Feld deckt die Übersicht zur besten KI-Helpdesk-Software ab, was dieses Jahr tatsächlich erscheint.
Wenn Sie noch früher stehen und erst herausfinden, was diese Agenten überhaupt tun, ist KI-Kundenservice-Software die Einführung in die Kategorie.
eesel ausprobieren
Wenn Sie das für eine echte Support-Warteschlange bewerten, entscheidet nicht, welches Modell Ihre Kamera sieht. Es entscheidet, ob das Ganze auf Ihren Tickets richtig liegt, mit Ihrem Helpcenter und Ihren vergangenen Gesprächen, bevor ein Kunde darauf trifft.
Genau darum ist eesel gebaut. Es bindet sich in den Helpdesk ein, den Sie bereits betreiben, lernt aus Ihren bestehenden Makros und Ihrer Ticket-Historie, statt eine neue Wissensdatenbank zu brauchen, und spielt Ihre echten vergangenen Tickets in einer Simulation durch, damit Sie die Lösungsquote und die genauen Antworten sehen, bevor irgendetwas live geht. Sie legen fest, welche Ticket-Typen es anfasst und wo es übergibt, sodass das oben genannte „den Rest in Ruhe lassen"-Problem eine Einstellung ist, keine Hoffnung. Es ist kostenlos zum Testen, und Sie können noch am selben Nachmittag simulierte Ergebnisse auf Ihrer eigenen Historie sehen.

Full-Duplex-Sprache wird irgendwann im Support ankommen, und wenn das passiert, gewinnen die Modelle, die eine Zahl zur Aufgabenerfüllung belegen können. Bis dahin kommt die Lösungsquote aus der unspektakulären Arbeit, einen KI-Support-Agenten im eigenen Wissen zu verankern.