Was Gemini 3.8 Flash TTS eigentlich ist
Zunächst die langweiligen, aber wichtigen Fakten, denn ein Großteil der Verwirrung online entsteht dadurch, dass Modell-IDs durcheinandergebracht werden.
Gemini 3.8 Flash TTS ist ein Text-zu-Sprache-Modell: Text geht rein, Audio kommt raus, sonst nichts. Es erschien als stabil, nicht als Preview, unter der ID gemini-3.8-flash-tts, und Google führt es als empfohlenen Ersatz für das ältere gemini-3.1-flash-tts-preview. Es gibt eine günstigere Schwester, gemini-3.8-flash-lite-tts, auf die ich noch zurückkomme.
Ein paar Eckdaten, allesamt aus Googles eigener Dokumentation zur Sprachgenerierung:
- 130 Sprachen bei Flash TTS, mit automatischer Erkennung der Eingabesprache.
- 8.192 Input-Token und 16.384 Output-Token pro Anfrage, also gebaut für Sätze und Absätze, nicht für ganze Romane in einem einzigen Aufruf.
- Die Standardausgabe ist 24 kHz Mono-WAV, mit mulaw- und alaw-Optionen für Telefonie.
- Audio wird mit 25 Token pro Sekunde abgerechnet, das ist das Detail, das die Preisrechnung erst aufgehen lässt.
Es beherrscht kein Function Calling, keine strukturierte Ausgabe, kein Thinking, keine Search Grounding und keine Live API. Das ist eine Rendering-Engine, kein Agent. Diese Einordnung ist wichtig, denn sie spielt später noch eine Rolle.
Wie gut klingt es tatsächlich?
Das ist die einzige Frage, die bei einem Sprachmodell zählt, und genau hier klaffen Marketing und Realität ein wenig auseinander.
Googles Argumentation ist stark. Der Launch-Beitrag beansprucht Platz 1 im Voice Design Benchmark von Hume AI (71,4) sowie Platz 1 und 2 im Overall Quality Index von Hume für Flash und Flash-Lite. Das sind echte Zahlen. Ein Vorbehalt, den ich vorher kennen möchte: Der Gründer von Hume wird als Autor in Googles eigener Ankündigung genannt, der Anbieter und der Benchmark-Autor sind hier also nicht vollständig unabhängig. Das macht die Werte nicht falsch, aber ich gewichte sie dadurch etwas leichter.
Die unabhängige Einschätzung ist aufschlussreicher. Laut Artificial Analysis erreichte Gemini 3.8 Flash TTS Platz 1 bei Pronunciation Robustness mit 89,5 % (hoch von 88,2 % bei 3.1 Flash TTS), aber nur Platz 2 in der blinden Provider Voice Arena, mit einer Elo von rund 1.263, hinter Sonic 3. Die faire Zusammenfassung lautet also: weltklasse darin, Wörter korrekt auszusprechen, Zweiter darin, wie die Stimme zu klingen, die man tatsächlich wählen würde.
"Google hat Gemini 3.8 Flash TTS und Gemini 3.8 Flash-Lite TTS veröffentlicht. Gemini 3.8 Flash TTS startet auf Platz 1 unseres Pronunciation-Robustness-Benchmarks und Platz 2 unseres Provider-Voice-Arena-Leaderboards"
Entwickler, die es tatsächlich ausprobiert haben, waren direkter. Der schärfste Kommentar aus dem Launch-Day-Thread auf Hacker News:
"Die verfügbaren Stimmen klingen für mich alle wie generische Gemini-Stimmen. Nichts wirkt besonders interessant oder beeindruckend daran."

Das deckt sich mit der Benchmark-Lücke. Aussprache ist gelöst, Persönlichkeit nicht. Wenn dein Job ein klarer, korrekter, neutraler Erzähler ist, wirst du sehr zufrieden sein. Wenn du eine Stimme brauchst, an die sich Zuhörer erinnern, solltest du die Erwartungen dämpfen.
Was du tatsächlich steuern kannst
Der Grund, warum man zu Gemini statt zu einer schlichten neuronalen Stimme greift, ist Kontrolle, und das ist der Teil, der mir am besten gefallen hat. Du wählst nicht nur eine Stimme aus dem Regal, du gibst ihr Regieanweisungen.
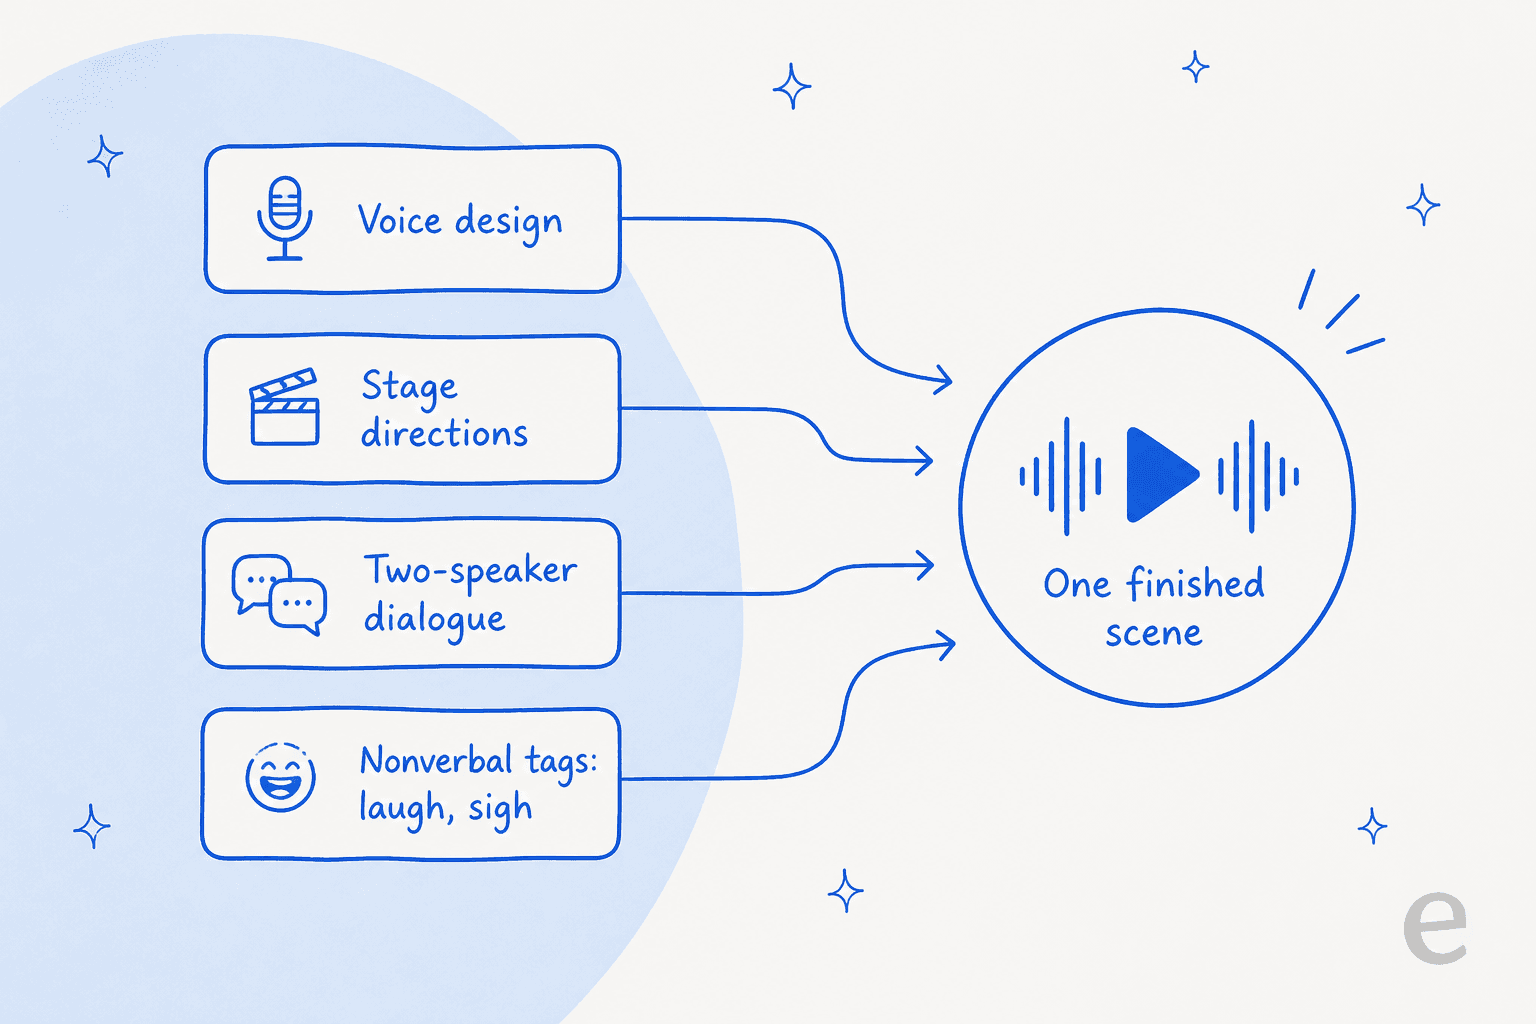
Vier Ebenen greifen ineinander:
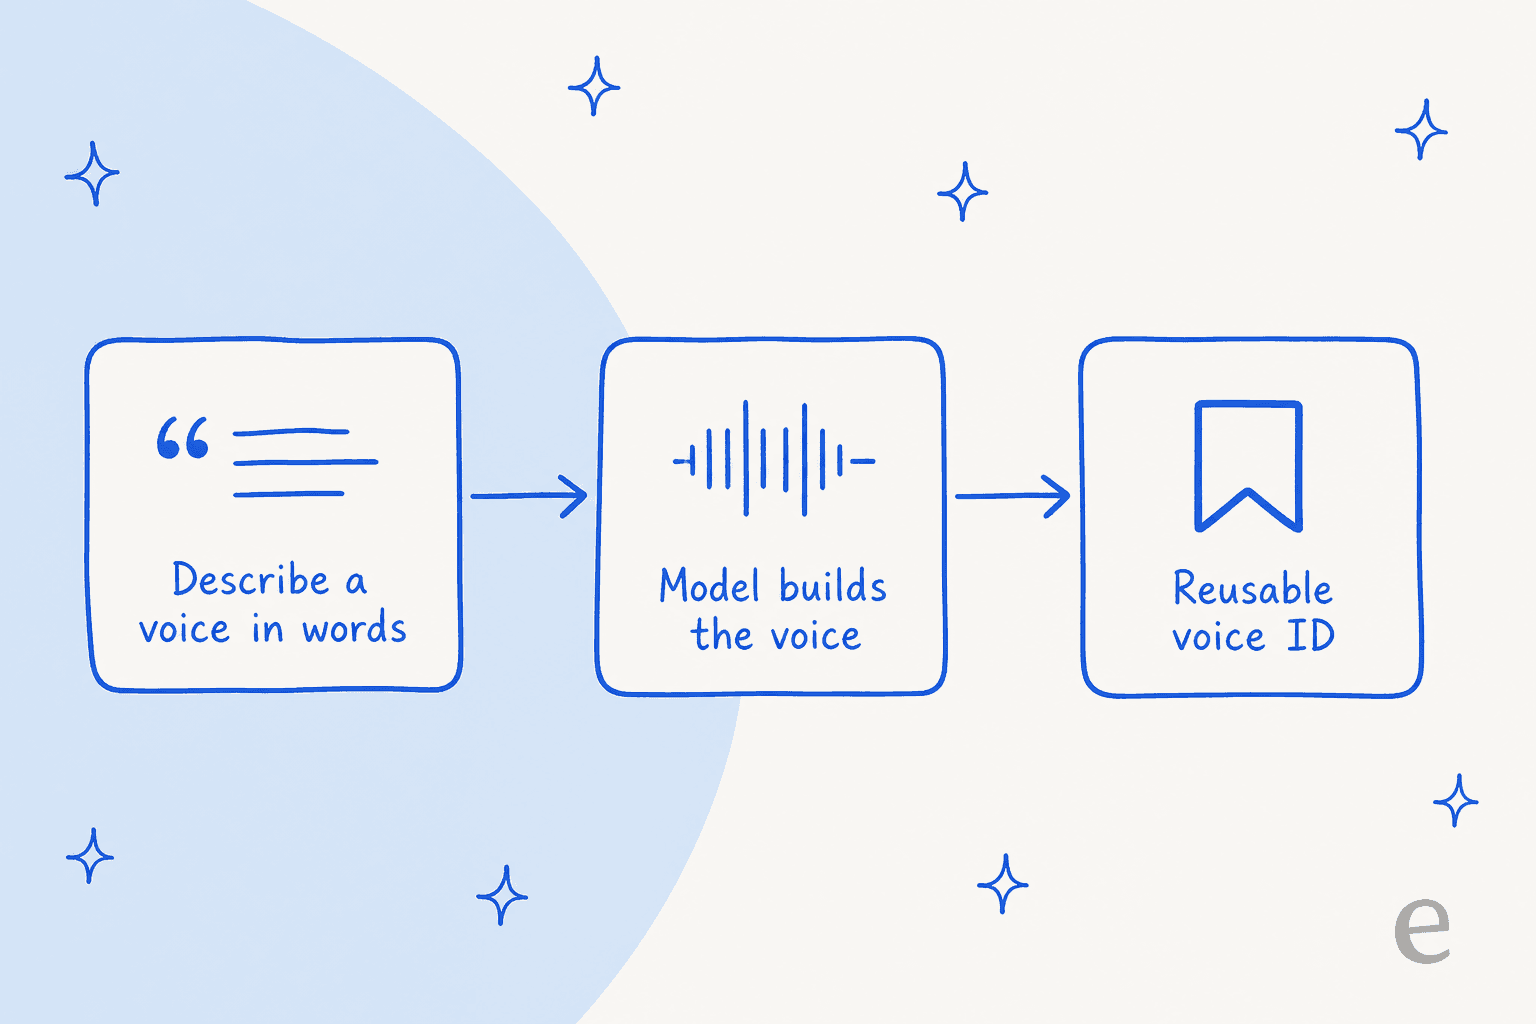
- Stimmendesign. Beschreibe eine Persona in einfachen Worten, und das Modell baut daraus eine Stimme, die du anschließend als wiederverwendbare ID speichern kannst.
- Regieanweisungen. Ein Feld im Stil von
speech_metadatalässt dich Tonfall, Akzent und Tempo pro Redebeitrag steuern ("lies das warm, leicht gehetzt"). - Zwei-Sprecher-Dialog. Ein Konversationsmodus verarbeitet bis zu zwei vorgefertigte Stimmen in einer Anfrage, was schnelle podcastartige Clips möglich macht.
- Nonverbale Tags. Inline-Marker wie
<laugh>,<sigh>,<breath>und<short pause>setzen stimmliche Ereignisse genau dort, wo du sie willst.
Der Stimmendesign-Flow ist das Kernfeature und wirklich clever gemacht: Aus einem Beschreibungssatz wird eine dauerhafte, wiederverwendbare Stimme, ohne dass du jemals etwas aufnehmen musst.
Die ehrliche Grenze: Steuerbarkeit ist real, aber nicht perfekt zuverlässig. Bei einer früheren Gemini-TTS-Version berichtete ein Entwickler, dass Regieanweisungen manchmal komplett ignoriert wurden:
"Egal was ich ins Audioprofil schrieb, AI Studio hat es nie befolgt, unabhängig von Szene oder Kontext. Ich habe zum Beispiel versucht, eine männliche Stimme zu bekommen, und immer wieder weibliche bekommen."
Google sagt, 3.8 verbessere die kreative Steuerung, und meinem Eindruck nach stimmt das, aber plane ein paar Neugenerierungen ein, wenn eine Anweisung beim ersten Versuch nicht sitzt. Es ist ein Prompt, keine Garantie.
Auch die Stimmreplikation (Klonen) ist jetzt verfügbar, wozu Google eine Weile zurückhaltend wirkte. Simon Willison brachte es so auf den Punkt:
"Ich schätze, Stimmklonen ist inzwischen bei anderen Anbietern so weit verbreitet verfügbar, dass Google nicht mehr zögert, es zu veröffentlichen."
Flash vs Flash-Lite: Welches solltest du nutzen
Die Aufteilung in zwei Modelle ist simpel, sobald man sie durchschaut, und die falsche Wahl kostet nur Geld oder Qualität.
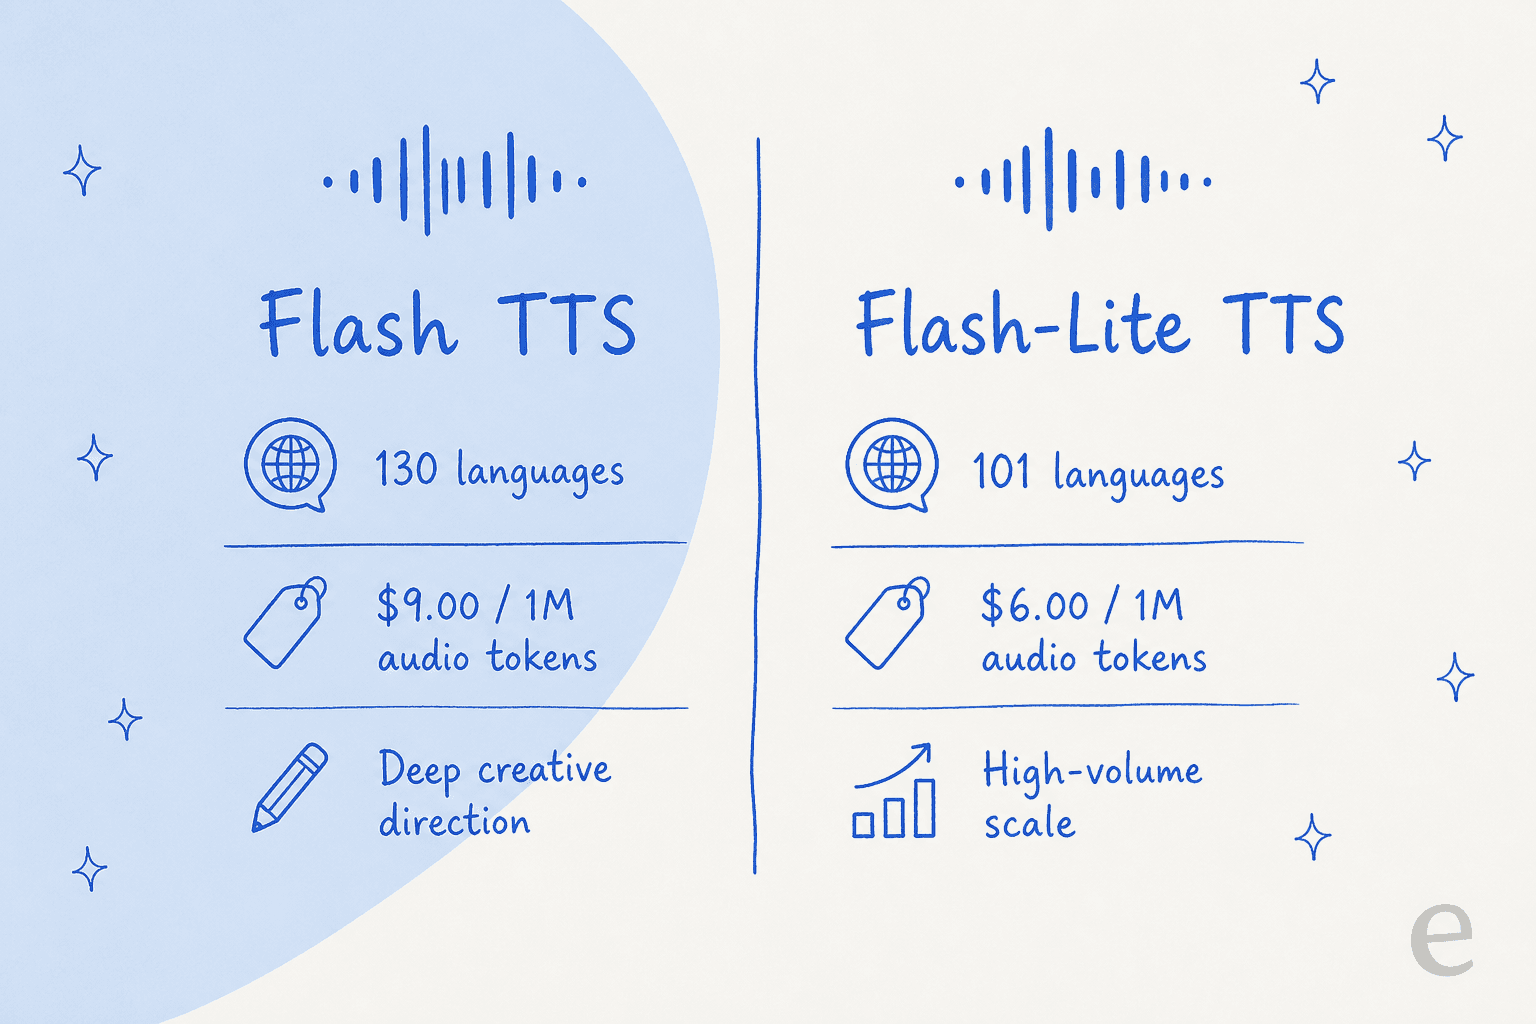
Flash TTS ist das ausdrucksstarke Modell: 130 Sprachen, 9,00 $ pro 1 Million Audio-Token und das komplette Toolkit für kreative Steuerung. Greife danach, wenn das Audio das Produkt ist, etwa bei einem Hörbuch, einer Markenwerbung oder einer Figur.
Flash-Lite TTS ist der Arbeitspferd: 101 Sprachen, 6,00 $ pro 1 Million Audio-Token, ausgelegt auf hochvolumiges Rendering, bei dem "gut und günstig" wichtiger ist als "ausdrucksstark". Greife danach, wenn du Tausende Clips generierst und niemand eine etwas flachere Lesung bemerken wird.
Meine Faustregel: Prototype zuerst mit Flash, damit du die Obergrenze hörst, und wechsle dann für alles, was du in großen Mengen renderst, zu Flash-Lite. Falls keines von beiden passt, sind die Gemini-Alternativen, die einen Versuch wert sind, Cartesias Sonic 3 und ElevenLabs.
Die Preisrealität (und der Haken für 2027)
Die vollständigen Zahlen stehen im Beitrag Gemini 3.8 Flash TTS Preise, aber die für diesen Test relevante Version ist kurz.
Im Standardtarif kostet Flash TTS 9,00 $ pro 1 Million Audio-Output-Token. Da Audio mit 25 Token pro Sekunde abgerechnet wird, sind eine Stunde Sprache etwa 90.000 Token, also rund 0,81 $ pro Stunde generiertes Audio. Batch und Flex kosten 50 % weniger. Es gibt eine echte kostenlose Stufe über Google AI Studio.
Der Haken, den du einplanen musst: Das sind Aktionspreise bis zum 31. Dezember 2026, und sie verdoppeln sich ungefähr am 1. Januar 2027 (Flash steigt auf 18,00 $ pro 1 Million Audio-Token). Wenn du einen Workload für 2027 budgetierst, plane mit der verdoppelten Zahl, nicht mit dem Launch-Preis. Das ist dasselbe Muster wie bei der gesamten Gemini-Preisübersicht, also keine Überraschung, wenn du Gemini aufmerksam verfolgst.
Beim Preis war das Community-Urteil klar, selbst von Skeptikern. Simon Willison beim Testen des Konversationsmodus:
"Der Konversationsmodus ist klasse, und die meisten meiner Experimente haben weniger als einen Cent gekostet."
Wie es im Vergleich zur Konkurrenz abschneidet
Anbieterübergreifende TTS-Preise sind ein Chaos, weil sich die Abrechnungseinheiten unterscheiden: Amazon, Azure und Deepgram rechnen pro Zeichen ab, während OpenAI und Google pro Audio-Token abrechnen. Um fair zu vergleichen, habe ich alles auf Dollar pro Stunde Audio normalisiert (mit Amazons eigenem Richtwert von rund 23 Stunden Sprache pro 1 Million Zeichen). Behandle diese Werte als Schätzungen, da die Sprechgeschwindigkeit die Rechnung verändert.
| Modell | Nennpreis | ~ $/Stunde Audio | Kostenlose Stufe |
|---|---|---|---|
| Gemini 3.8 Flash TTS | 9,00 $ / 1 Mio. Audio-Token | ~0,81 $ | Ja (AI Studio) |
| Gemini 3.8 Flash-Lite TTS | 6,00 $ / 1 Mio. Audio-Token | ~0,54 $ | Ja (AI Studio) |
| Amazon Polly Neural | 16 $ / 1 Mio. Zeichen | ~0,70 $ | 1 Mio. Zeichen/Monat (12 Mon.) |
| Azure Neural / HD Flash | 15 $ / 1 Mio. Zeichen | ~0,65 $ | 0,5 Mio. Zeichen/Monat |
| OpenAI gpt-4o-mini-tts | 12 $ / 1 Mio. Audio-Token | ~0,90 $ | Keine (TTS) |
| Deepgram Aura-2 | 30 $ / 1 Mio. Zeichen | ~1,30 $ | 200 $ Anmeldeguthaben |
| ElevenLabs Business | "ab 5 Cent/Min." | ~3,00 $ | 10.000 Credits/Monat |
Das Fazit: Gemini 3.8 Flash TTS ist wie eine austauschbare neuronale Standardstimme bepreist, verhält sich aber wie eine ausdrucksstarke, generative. Es liegt preislich direkt neben Amazon Polly Neural und Azure, unterbietet OpenAI und Deepgram und kostet nur einen Bruchteil von ElevenLabs pro Stunde. Wer auf das Verhältnis von Preis zu Ausdrucksstärke achtet, hat damit die Schlagzeile des ganzen Launches.
Eine Nuance, die man fair erwähnen sollte: Die ElevenLabs-Preise kaufen dir eine Stimmbibliothek und ein Maß an Charakter, das die Preistabelle nicht abbildet, und genau deshalb zahlen Teams weiterhin dafür, wie die ElevenLabs-Bewertungen zeigen.
Solltest du es nutzen? Eine schnelle Entscheidung
Statt noch eines Absatzes "es kommt darauf an" hier die Entscheidung, die ich je nach Anwendungsfall treffen würde.
Wo es Schwächen zeigt
Um fair zu bleiben, hier die echten Grenzen, die ich vor einer Entscheidung nennen würde:
- Den Stimmen fehlt Charakter. Die meistgewählte Entwicklerkritik war, dass alles "generisch Gemini" klingt. Großartig für den Nutzen, schwächer für die Marke.
- Regieanweisungen können ignoriert werden. Kreative Kontrolle ist ein Prompt, kein Vertrag, also rechne mit gelegentlichen Fehlschlägen und Neugenerierungen.
- Es steht nicht an der Spitze der Arena. Platz 1 bei der Aussprache, aber Platz 2 bei der blinden menschlichen Präferenz hinter Sonic 3. Wenn "beste Stimme" deine Anforderung ist, ist das noch nicht entschieden.
- Der Preis verdoppelt sich 2027. Der Launch-Preis ist eine Aktion. Ein Workload, den du 2026 kalkulierst, wird im Januar doppelt so teuer.
- Lokale Modelle holen auf. Mehrere Entwickler verwiesen auf offene Optionen wie Fish Audio, Higgs und Qwen3 TTS als gut genug für ein finales Rendering, besonders wenn Kosten oder Datenschutzregeln eine Cloud-API ausschließen.
Keiner dieser Punkte ist ein Ausschlusskriterium. Sie machen den Unterschied zwischen "großartig" und "sehr gut und sehr günstig", und dort lande ich.
Der Teil, für den die meisten Leute eigentlich hier sind: Stimme für den Support
Viele Leute, die nach einem Sprachmodell suchen, stellen eigentlich eine andere Frage: Kann ich das meinen Kunden vorsetzen? Diesen Abschnitt würde ich nicht überspringen.
Ein TTS-Modell ist Infrastruktur. Es wandelt Text in Audio um, das ist der ganze Job. Es kennt deine Rückerstattungsrichtlinie nicht, kann deine Kundenservice-Software nicht lesen und weiß nicht, ob der Satz, den es gerade vertont hat, überhaupt stimmt. Wenn du ein rohes Sprachmodell an eine Support-Leitung setzt, liest es eine falsche Antwort selbstbewusst in wunderschönem Klang vor, was schlimmer ist als eine schlichte Fehlermeldung. Das ist das Gegenteil der Kosteneinsparungen, die die meisten Teams anstreben.
Ich arbeite bei eesel an genau diesem Thema, und meine Sichtweise ist simpel: Das Modell ist die Stimme, das Teammitglied ist der Mitarbeiter. eesel ist eine Plattform für KI-Teammitglieder, und das relevante Teammitglied hier ist der KI-Helpdesk-Agent. Er dockt an dein bestehendes Helpdesk an, lernt aus vergangenen Tickets und deinem Help Center, folgt den Regeln, die du festlegst, und wird gegen deine echte Ticket-Historie simuliert, bevor er je einem echten Kunden antwortet. Genau dieser letzte Teil zählt: Wir haben schon selbstbewusst klingende Bots erlebt, die still und leise falsche Antworten gaben, und genau deshalb wird jeder Rollout zuerst an historischen Tickets trockengetestet. Ein Sprachmodell hat kein vergleichbares Sicherheitsnetz.
Wenn du im Terminal arbeitest oder das skripten möchtest, steuert die eesel-CLI dasselbe Teammitglied und denselben Workspace wie das Dashboard. Eine Person kann die Anweisungen eines Teammitglieds über die Kommandozeile einsehen, ein Skript kann einen Workflow automatisieren, und ein Coding-Agent wie Claude Code, Codex oder Cursor kann eesel programmatisch bedienen, JSON-Ergebnisse ausgeben und begrenzte Änderungen zur Freigabe durch einen Verantwortlichen vorschlagen. Das ist die agentenfreundliche Oberfläche für dasselbe Produkt, kein separates Ding. Das ist ein echter Unterschied dazu, Gemini TTS selbst zu verdrahten, wo du die gesamte Orchestrierung, die Support-Kennzahlen, die Eskalationslogik und das SLA-Handling allein trägst.
Also: Nutze Gemini 3.8 Flash TTS für das, worin es wirklich gut ist, nämlich günstige, klare, steuerbare Sprache. Für eine Stimme, die tatsächlich Kundenprobleme löst, brauchst du ein getestetes Teammitglied darauf, nicht das rohe Modell. Wenn das dein eigentliches Ziel ist, starte mit einem echten KI-Helpdesk-Chatbot und dem breiteren Angebot an Support-Automatisierung und vergleiche die Optionen für den besten KI-Agenten für den Kundenservice, bevor du irgendetwas von Grund auf baust.
Mein Fazit
Gemini 3.8 Flash TTS ist ein sehr gutes Sprachmodell zu einem wirklich disruptiven Preis. Es beherrscht die Aussprache, gibt dir echte kreative Kontrolle, bietet Stimmendesign und Klonen und kostet einen Bruchteil von ElevenLabs pro Stunde. Die ehrlichen Sternchen: Den Stimmen fehlt herausragender Charakter, es ist Platz 2 statt Platz 1 bei der blinden Präferenz, und der Preis verdoppelt sich 2027.
Für die meisten Entwickler, die Audio im großen Maßstab rendern, ist es der neue vernünftige Standard. Für eine markante Markenstimme bleiben ElevenLabs und Sonic 3 im Rennen. Und wenn du hier warst, weil du eine KI willst, die mit deinen Kunden spricht und ihre Probleme wirklich löst, denk daran, dass die Stimme der leichte Teil ist: Die KI-Kundenservice-Unternehmen, die deine Zeit wert sind, sind die, die den schweren Teil lösen, und die KI-Helpdesk-Software, die ein Ticket löst, zählt weit mehr als die Stimme, die die Antwort vorliest.

Willst du ein KI-Teammitglied für deine Support-Queue, nicht nur eine schöne Stimme? eesel dockt in wenigen Minuten an dein Helpdesk an, lernt aus deinen eigenen Tickets, und du kannst es vor dem Live-Gang an deiner echten Historie simulieren. eesel testen kostenlos, oder Demo buchen, um es an deinen eigenen Daten zu sehen.
Häufig gestellte Fragen
Ist Gemini 3.8 Flash TTS gut?
Ja, mit einer Einschränkung. Es liefert Studioqualität bei Klarheit und Aussprache und startete auf Platz 1 im Pronunciation-Robustness-Benchmark von Artificial Analysis. Bei der blinden menschlichen Präferenz landete es jedoch auf Platz 2, hinter Cartesias Sonic 3, und mehrere Entwickler fanden die vorgefertigten Stimmen generisch. Es ist ein ausgezeichneter Standard, aber kein klarer Sieg auf der ganzen Linie.
Was kostet Gemini 3.8 Flash TTS?
Es kostet 0,50 $ pro 1 Million Text-Input-Token und 9,00 $ pro 1 Million Audio-Output-Token im Standardtarif bis zum 31. Dezember 2026, was sich auf etwa 0,81 $ pro Stunde Sprache summiert. Beide Sätze verdoppeln sich am 1. Januar 2027. Alle Tarife stehen in meiner Gemini 3.8 Flash TTS Preisübersicht, und die gesamte Modellfamilie findet sich im Gemini 3 Preise-Guide.
Gemini 3.8 Flash TTS vs ElevenLabs: Was ist besser?
Gemini gewinnt beim Preis mit deutlichem Abstand, etwa 4 bis 5 Mal günstiger pro Stunde Audio. ElevenLabs hat weiterhin die Nase vorn bei markanten, charakterstarken Stimmen und seiner Stimmbibliothek. Wenn Kosten und Skalierung am wichtigsten sind, dann Gemini; wenn eine unverwechselbare Stimme im Vordergrund steht, lohnt sich auch ein Blick auf ElevenLabs-Alternativen.
Was ist der Unterschied zwischen Gemini 3.8 Flash TTS und Flash-Lite TTS?
Flash TTS deckt 130 Sprachen für 9,00 $ pro 1 Million Audio-Token ab und ist für ausdrucksstarkes, gezielt gesteuertes Audio gebaut. Flash-Lite TTS deckt 101 Sprachen für 6,00 $ pro 1 Million Audio-Token ab und ist für hochvolumige, kostensensitive Aufgaben ausgelegt. Wähle Flash, wenn kreative Steuerung zählt, und Flash-Lite, wenn du im großen Maßstab renderst.
Kann Gemini 3.8 Flash TTS eine Stimme klonen?
Ja. Es unterstützt Stimmendesign (eine Persona in Worten beschreiben) und Stimmreplikation (Klonen aus einem kurzen Referenzclip plus Zustimmungs-Audio). Geklonte Stimmen lassen sich als wiederverwendbare Stimm-ID speichern, begrenzt auf 200 pro Projekt mit einer Gültigkeit von einem Jahr, oder als 7-tägiger zustandsloser Schlüssel.
Unterstützt Gemini 3.8 Flash TTS mehrere Sprecher?
Bis zu zwei Sprecher pro Anfrage mit vorgefertigten Stimmen, mit einem Konversationsmodus für Dialoge. Für mehr als zwei Stimmen synthetisierst du jeden Redebeitrag separat und fügst das Audio anschließend zusammen.
Reicht ein Sprachmodell wie Gemini TTS für den Kundensupport aus?
Nein. Ein TTS-Modell wandelt Text in Sprache um; es liest nicht dein Help Center, befolgt keine Richtlinien und löst kein Ticket. Für den Support brauchst du ein KI-Teammitglied, das darauf aufsetzt, etwa einen KI-Helpdesk-Agenten, der sich mit deiner Kundenservice-Software verbindet und zuerst an deiner echten Ticket-Historie getestet wird.


Article by
Alicia Kirana Utomo
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.