

Voxtral 3 ist der Sprach-Stack mit dem derzeit besten Preis-Leistungs-Verhältnis eines europäischen Labors, und ich bewerte ihn mit 3,5 von 5: hervorragend für die Batch-Transkription, vielversprechend, aber noch früh als Telefon-Agent. Voxtral Small Transcribe 3 liegt in Mistrals 45-Sprachen-Test mit einer Wortfehlerrate von 4,0 % gleichauf mit Microsoft AI Transcribe 2 und kostet $0.004 pro Minute. Die Stimme kostet $13 pro 1 Mio. Zeichen, und die All-in-One-Voice-Agent-API kostet $0.04 pro Minute.
Drei Dinge bremsen es aus. Alle Modelle sind eine Public Preview, die Gewichte sind diesmal geschlossen (Voxtral 1 und 2 waren offen), und Telefonanrufe über SIP sind zum Start nur für Enterprise-Kunden verfügbar. Mistrals eigene Grafik zeigt außerdem Gemini 3.5 Realtime bei der Live-Transkription in jeder Latenzeinstellung vorn.
Wenn Sie einen Support betreiben, ist die Sprachschicht die leichtere Hälfte. Bei eesel beantworten wir für smava jeden Monat 27,000 Zendesk-Tickets auf Deutsch, und das funktioniert, weil auf vergangenen Tickets trainiert wird, nicht wegen eines besseren Mikrofons. Ein Sprachmodell gibt Ihrem Agenten Ohren und eine Stimme; er muss trotzdem Ihr Geschäft kennen.
Was ist Voxtral 3?
Voxtral 3 ist die Sprachfamilie von Mistral, veröffentlicht am 20. Oktober 2026. Sie bündelt drei Dinge, für die man früher getrennt einkaufen musste: Speech-to-Text-Modelle, ein Text-to-Speech-Modell und ein Voice-Agent-SDK, das sie mit einem Chat-Modell in der Mitte verkettet.
Ich baue beruflich Integrationen und APIs, deshalb lese ich diesen Launch wie die Dokumentation jedes Anbieters: Was macht jede Modell-ID tatsächlich, was kostet sie pro Einheit, und was geht kaputt, wenn ich sie anbinde? Das ist die Aufstellung:
| Modell | Aufgabe | Preis | Hinweise |
|---|---|---|---|
| Voxtral Small Transcribe 3 | Batch-Transkription, Flaggschiff | $0.004/min | 50 Sprachen, Diarisierung, außerdem Übersetzung und Fragen zu Sprache |
| Voxtral Mini Transcribe 3 | Batch-Transkription, Budget | $0.0035/min | 4B Parameter, klein genug für beschränkte Hardware |
| Voxtral Mini Transcribe Realtime 3 | Live-Transkription | $0.008/min | Latenzregler von 80 ms bis 2.400 ms, Erkennung des Sprechende |
| Voxtral TTS 3 | Text-to-Speech | $13/1M chars | 35+ Sprachen, 50+ Dialekte, Stimmklonen |
| Voice-Agent-API (Mistral Small 4) | Komplette Anruf-Pipeline | $0.04/min | Sprache rein, Schlussfolgern, Sprache raus |
| Voice-Agent-API (größeres Modell) | Komplette Anruf-Pipeline | $0.08/min | Dasselbe, mit einem größeren Reasoning-Modell |
Die Preise stammen aus dem Launch-Beitrag und der Doku-Seite jedes Modells, etwa der Karte zu Voxtral Small Transcribe 3. Jede dieser Seiten kennzeichnet das Modell als Public Preview, was wichtiger ist, als es klingt, wenn Sie in diesem Quartal einen Produktivstart planen.
Wie genau ist die Transkription von Voxtral 3?
Sehr, bei aufgezeichnetem Audio. Das ist der Teil des Launches, dem ich am meisten vertraue, denn die Zahlen halten auch dann, wenn man Mistrals Grafiken genauer liest als Mistrals Text.
Im FLEURS-Benchmark über 45 Sprachen erreicht Voxtral Small Transcribe 3 eine Wortfehlerrate von 4.0%, wenn es die Sprache selbst erkennt. So ordnen sich die sieben Modelle in Mistrals Grafik ein:
| Modell | Fehlerrate, Sprache vorgegeben | Fehlerrate, Sprache erkannt |
|---|---|---|
| Voxtral Small Transcribe 3 | 4.1% | 4.0% |
| Microsoft AI Transcribe 2 | 4.1% | 4.0% |
| Voxtral Mini Transcribe 3 | 4.6% | 4.5% |
| Gemini 3.5 Transcribe | 6.1% | 4.5% |
| Scribe v2 | 4.9% | 4.9% |
| GPT Transcribe | 6.3% | 5.6% |
| Whisper large-v3 | 16.0% | 14.9% |
Beachten Sie, dass die oberste Zeile ein Gleichstand ist. Der Launch-Text sagt, Small „übertrifft Whisper, Scribe v2 und Gemini 3.5 Transcribe“, was stimmt, und lässt Microsoft AI Transcribe 2 aus, das auf die Nachkommastelle genau gleichzieht. In Mistrals eigener Grafik zum Artificial-Analysis-Wortfehlerindex steht Voxtral Small Transcribe 3 an dritter Stelle, hinter Fun-Realtime-ASR-preview und Microsoft AI Transcribe 2. Das ist ein großartiges Ergebnis. Es ist nur nicht der klare Sieg, den die Überschrift andeutet.
Das Mini-Modell ist hier der stille Gewinner. Mit 4.5% zieht es bei Audio mit erkannter Sprache mit Gemini 3.5 Transcribe gleich, und laut Mini-Modellkarte ist es klein genug für ressourcenbeschränkte Umgebungen. Wenn Sie aufgezeichnete Anrufe für die Qualitätssicherung transkribieren, ist Mini für $0.0035 pro Minute die Variante, mit der ich anfangen würde.
Wer hat was gesagt: Diarisierung
Bei der Diarisierung (also der Zuordnung, welcher Sprecher welche Zeile gesagt hat) führt Voxtral in seiner Grafik. Im kombinierten Diarisierungs-Benchmark von Mistral, der Meetingaufnahmen und Telefonanrufe mischt, liegen die Fehlerraten bei:
- Voxtral Small Transcribe 3:
18.4% - Voxtral Mini Transcribe 3:
18.6% - Pyannote Orchestrator:
19.0% - Microsoft AI Transcribe 2:
20.3% - Scribe v2:
23.0% - Voxtral Mini Transcribe 2:
30.9% - Gemini 3.5 Transcribe:
38.4%
Der Sprung von 30.9% beim alten Mini auf 18.6% beim neuen ist die größte einzelne Verbesserung des Launches. Für Support-Teams macht die Diarisierung aus einer Anrufaufzeichnung ein brauchbares Transkript: Sie müssen wissen, welche Zeilen vom Kunden und welche vom Agenten stammen, bevor Sie den Anruf bewerten oder die Beschwerde herausziehen können. Sie spielt auch eine Rolle, wenn Sie vorhaben, personenbezogene Daten aus Transkripten zu schwärzen, denn die Schwärzungsregeln unterscheiden sich oft je nach Sprecher.
Produktnamen und Fachjargon: Context Biasing
Mit Context Biasing übergeben Sie dem Modell eine Liste von Begriffen (Produktnamen, Artikelnummern, Personen), damit es sie richtig schreibt. Im Earnings-22-Keyphrase-Test erreicht Voxtral Small 94.6% Recall mit Kontext und 81.4% ohne. Scribe v2 erreicht 94.3% mit Kontext und 84.0% ohne.
Mit Begriffsliste sind die beiden also gleichauf, und ohne sie erinnert sich Scribe v2 tatsächlich an mehr Schlüsselbegriffe. Die praktische Lehre: Wenn Sie Voxtral nutzen, senden Sie immer eine Begriffsliste mit. Der Migrationsleitfaden ergänzt, dass die Einträge jetzt mehrwortige Ausdrücke sein können, sie sich aber das Kontextfenster mit dem Audio teilen, sodass eine lange Liste einen 400-Fehler auslösen kann.
Ist Voxtral 3 gut für Live-Anrufe?
Gut, nicht am besten. Hier wird mein Urteil weicher, und es ist Mistrals eigene Grafik, die es weicher macht.
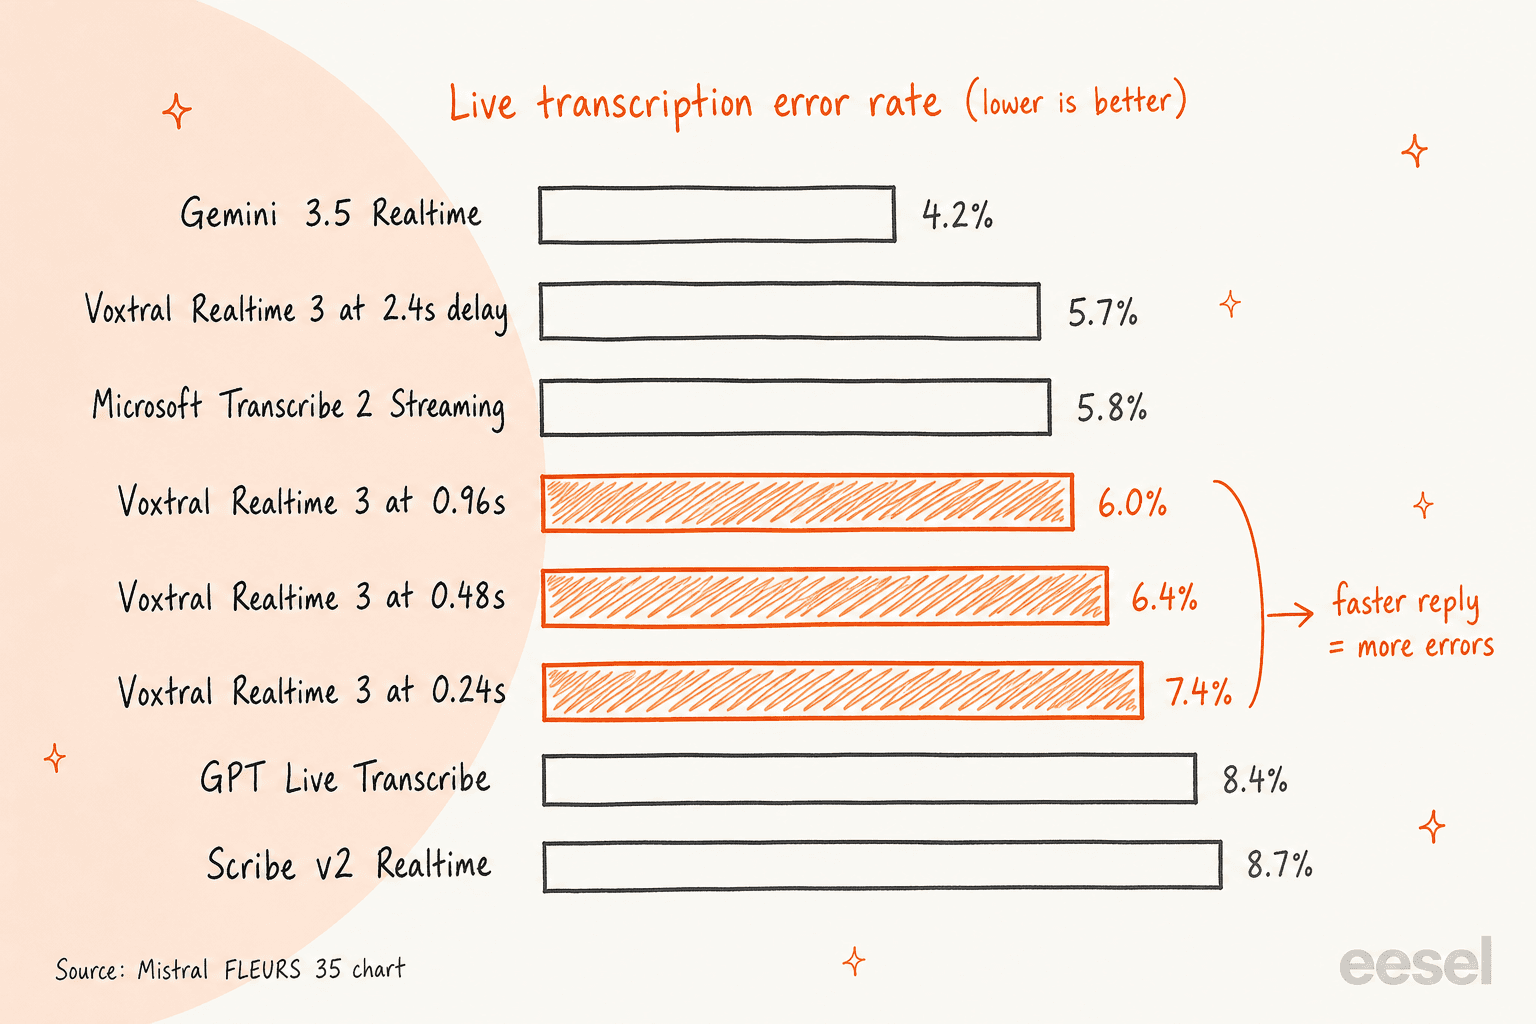
Voxtral Mini Transcribe Realtime 3 hat einen Latenzregler: Sie legen fest, wie lange es wartet, bevor es sich auf Wörter festlegt, zwischen 80 ms und 2.400 ms. Längeres Warten bedeutet mehr Kontext und weniger Fehler. In Mistrals Realtime-Test mit 35 Sprachen:
| Einstellung | Fehlerrate |
|---|---|
| Gemini 3.5 Realtime Transcribe | 4.2% |
| Voxtral Realtime 3 bei 2.400 ms | 5.7% |
| Microsoft AI Transcribe 2 Streaming | 5.8% |
| Voxtral Realtime 3 bei 960 ms | 6.0% |
| Voxtral Realtime 3 bei 480 ms | 6.4% |
| Voxtral Realtime 3 bei 240 ms | 7.4% |
| GPT Live Transcribe | 8.4% |
| Scribe v2 Realtime | 8.7% |
Zwei Dinge fallen auf. Erstens schlägt Gemini 3.5 Realtime in Mistrals eigener Grafik jede Voxtral-Einstellung. Zweitens ist die Einstellung, die Sie für einen flotten Telefon-Agenten tatsächlich nutzen würden (etwa 240 bis 480 ms), diejenige, bei der Voxtral am meisten Genauigkeit abgibt. Es schlägt dennoch GPT Live Transcribe und Scribe v2 Realtime in jeder Einstellung, ist also eine solide Wahl. Nur nicht die genaueste.
Eine Kleinigkeit würde ich prüfen, bevor Sie darauf bauen: Mistrals Seiten sind sich nicht einig, wie viele Sprachen das Realtime-Modell abdeckt. Der Launch-Beitrag sagt mehr als 35, die Preiskarte 40+, und die Grafik testet 35. Testen Sie Ihre genauen Sprachen, statt der größeren Zahl zu trauen.
Die gute Nachricht ist die Erkennung des Sprechendes. Das Realtime-Modell sagt voraus, wann ein Anrufer fertig gesprochen hat, und nutzt dafür sowohl den Klang als auch den Sinn des Gesagten. Das verhindert, dass ein Voice-Agent jemandem ins Wort fällt, der mitten im Satz eine Pause macht. Wer schon einmal einen Bot erlebt hat, der hineinplatzt, während man eine Kartennummer vorliest, weiß, warum das wichtig ist.
Wie natürlich klingt die Stimme von Voxtral 3?
Natürlich genug, und für das Gebotene sehr günstig. Voxtral TTS 3 ist der Teil, der sich im Klang am meisten verbessert hat, wenn auch nicht in einer einzelnen Schlagzeilenzahl.
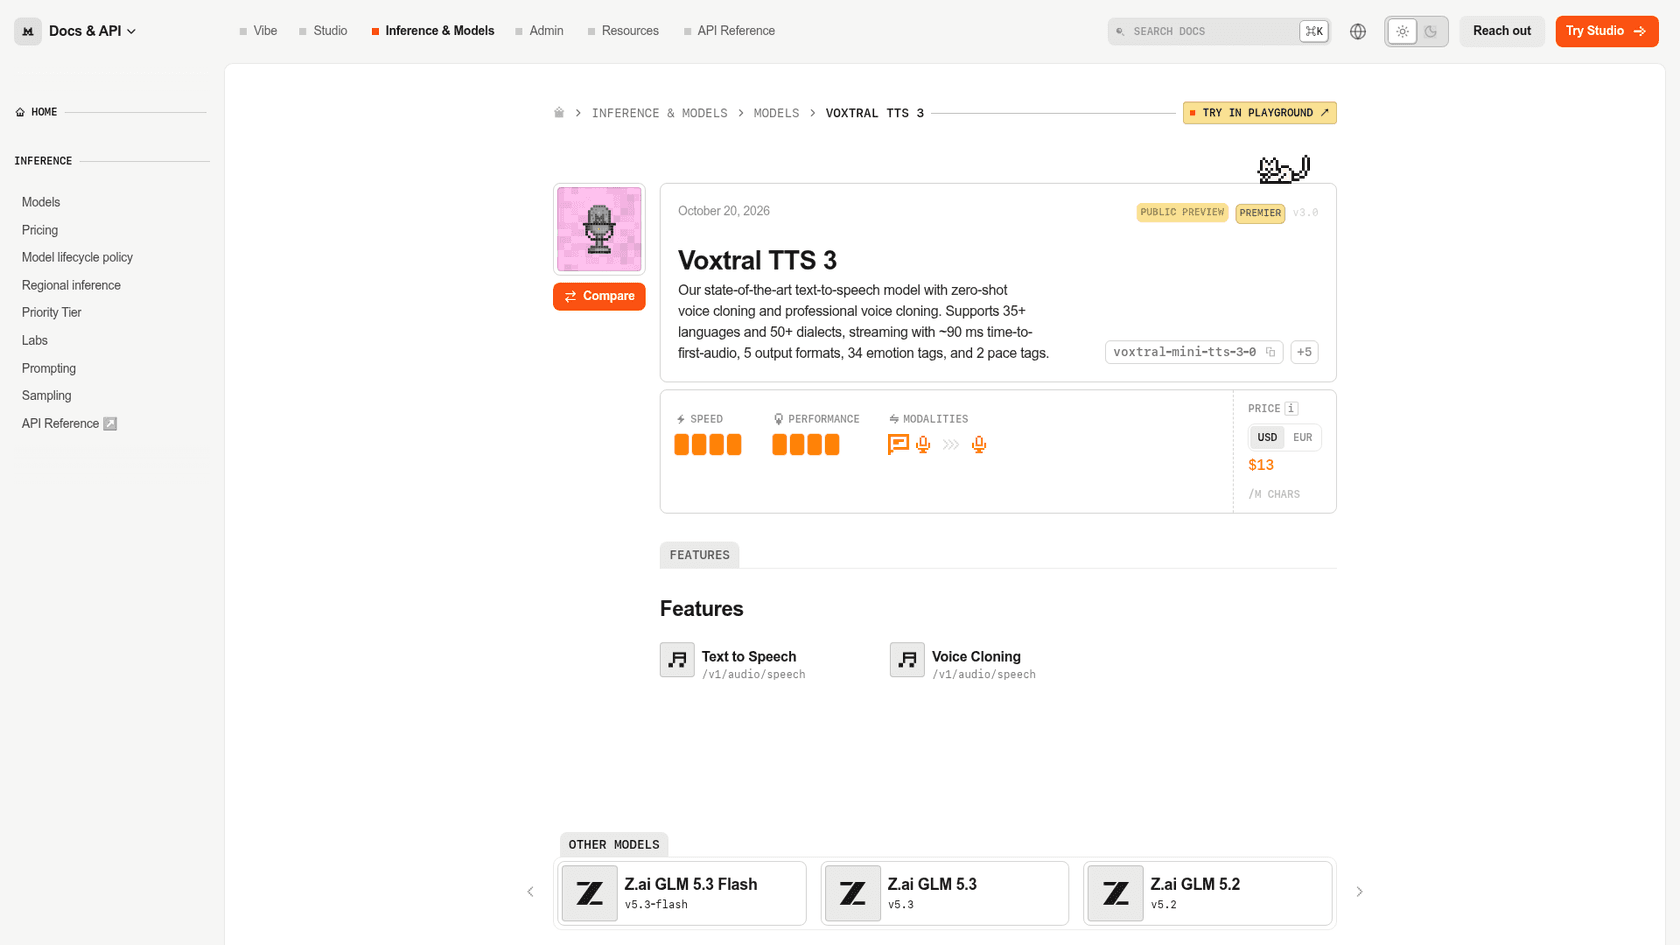
Das Datenblatt aus der Modellkarte:
- 35+ Sprachen und 50+ Dialekte, mit voreingestellten Stimmen in 18 Sprachen
- Etwa
90 msbis zum ersten Audio beim Streaming - 34 Emotions-Tags und 2 Tempo-Tags, die Sie inline einfügen können, wie
[emotion=...] - Zero-Shot-Stimmklonen, plus eine „Pro Voice“-Option, die mit etwa 30 Minuten Audio trainiert wird
- 5 Ausgabeformate
Die Beispiele auf der Launch-Seite sind hörenswert, denn sie zielen genau auf die Stellen, an denen Support-Stimmen scheitern. In einem liest Voxtral 1 eine Flugzeit als „21,000pm on 10 over 10“. Voxtral 3 liest sie als „21pm on October 10th“. Ein anderes liest einem Anrufer eine E-Mail-Adresse sauber vor. Das sind die Momente, in denen eine billige Stimme Sie am Support-Telefon blamiert.
Beim Preis behauptet Mistral, 13 $ pro 1 Mio. Zeichen seien im Betrieb günstiger als OpenAI TTS-1, Deepgram, ElevenLabs Flash und Gemini Flash, und seine Grafiken zum Preis-Leistungs-Verhältnis (basierend auf BeSimple AIs Voice Code Bench, der Zahlen und ungewöhnliche Namen in Support-Skripten testet) platzieren Voxtral TTS am günstigen Ende des Feldes. Das sind vom Anbieter selbst erstellte Grafiken mit einem Gemini-Modell als Juror, behandeln Sie sie also als Vorauswahl, nicht als Urteil. Wenn Sie ernsthaft vergleichen, stellen Sie es mit Ihren eigenen Skripten neben ElevenLabs, Cartesia Sonic 3 und Gemini 3.8 Flash TTS, oder stöbern Sie in der Liste der ElevenLabs-Alternativen.
Ein Hinweis aus dem Migrationsleitfaden: Stilanweisungen, also die Freitext-Steuerung „sag das herzlich“, sind zum Start als nicht verfügbar gekennzeichnet. Emotions- und Tempo-Tags bekommen Sie heute.
Wie funktioniert das Voice-Agent-SDK von Voxtral 3?
Das SDK ist der interessanteste Teil des Launches für alle, die einen Voice-Agent für den Kundensupport bauen, und zugleich der am stärksten gesperrte.
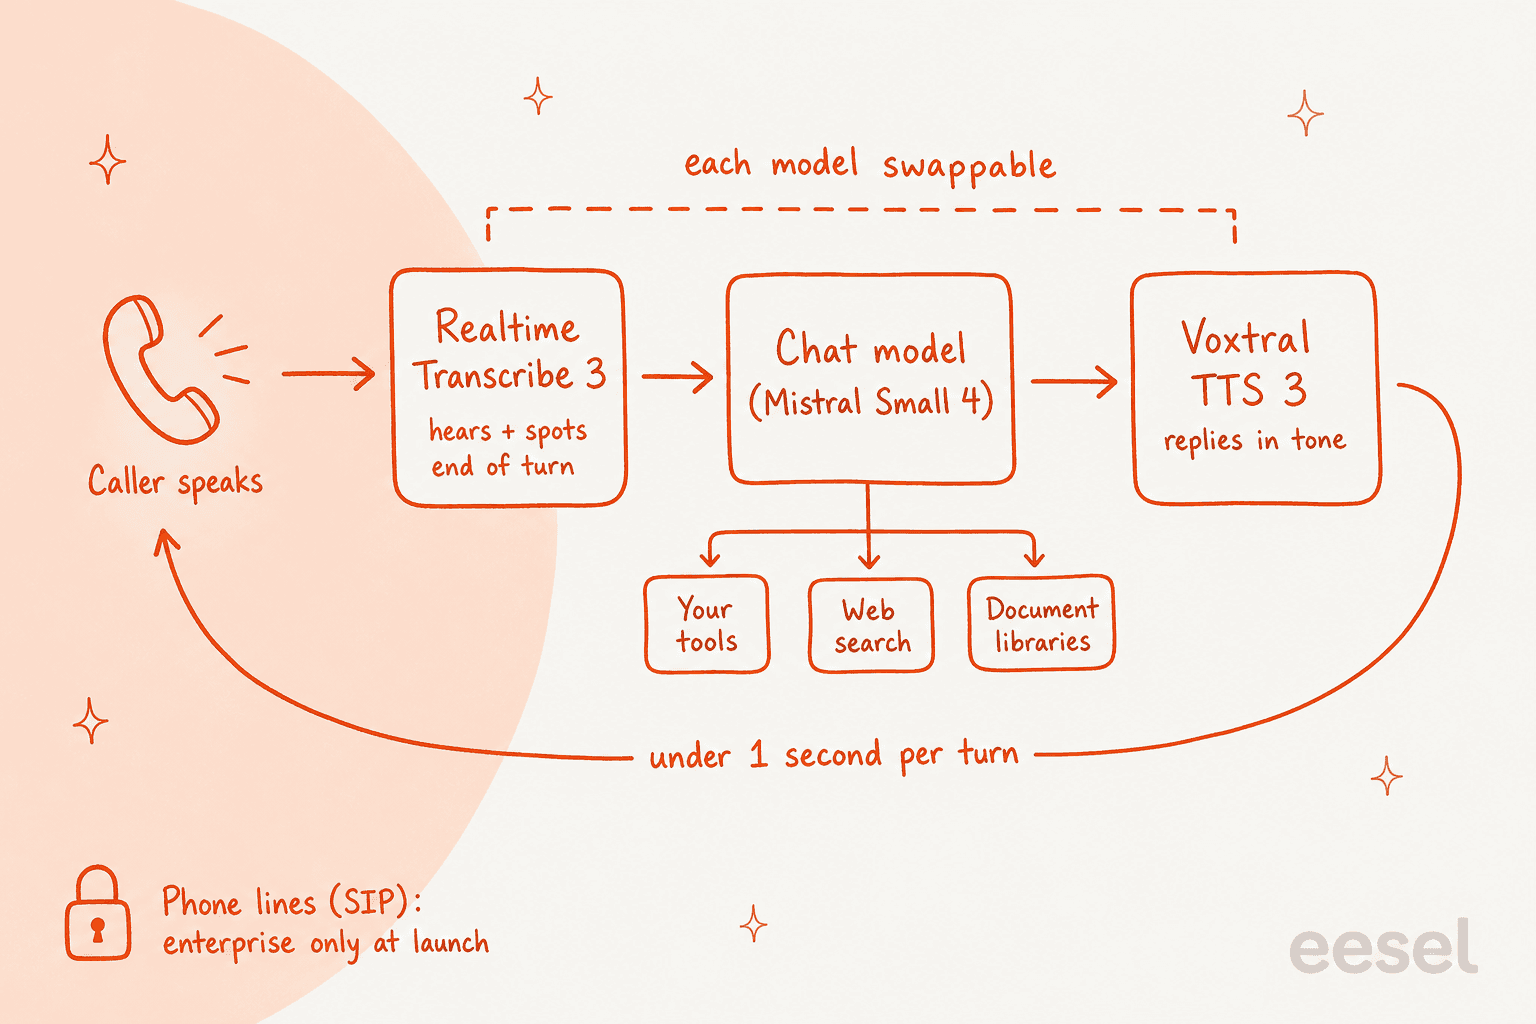
Laut den Voice-Agent-Docs durchläuft jeder Gesprächsdurchgang drei Stufen: Das Realtime-Modell transkribiert und erkennt das Ende des Redebeitrags, ein Chat-Modell wie Mistral Small 4 schreibt die Antwort und ruft Tools auf, und Voxtral TTS spricht sie aus. Mistral sagt, die Stufen streamen ineinander, sodass jeder Durchgang in unter einer Sekunde abgeschlossen ist und der Anrufer unterbrechen kann.
Was mir als Entwickler gefällt:
- Jede Stufe ist ein eigenes Modell. Sie können das Reasoning-Modell gegen ein größeres tauschen oder Stimme und Sprache ändern, ohne den Agenten neu zu schreiben.
- Agenten sind versioniert. Sie speichern eine Agent-Konfiguration, jede Änderung erzeugt eine neue Version, und Sie können die Produktion auf eine bekannte Version festnageln, während Sie die nächste testen. Das ist das richtige Design für alles, womit Kunden sprechen.
- Webhooks feuern, wenn ein Anruf beginnt, endet oder fehlschlägt, sodass Sie jedes Transkript in Ihrem eigenen Leitsystem speichern können.
- Es basiert auf LiveKit für den Audiotransport, mit Python- und TypeScript-Bindings, aber Sie müssen LiveKit nicht kennen, um es zu nutzen.
Was mich zögern lässt:
- Telefonleitungen sind zum Start nur für Enterprise. Die Docs sagen, Telefonie über SIP sei „zum Start für Enterprise-Kunden über Ihr Account-Team verfügbar“. Browser- und App-Sprache (über WebRTC) steht allen offen. Für ein Support-Team, dessen Kunden eine Telefonnummer wählen, ist das die entscheidende Linie.
- Clientseitige Tools scheitern bei Telefonanrufen. Die Docs stellen klar, dass bei einer Telefonleitung kein Code von Ihnen im Anruf läuft, sodass alles, was ein Telefon-Agent braucht (eine Bestellung nachschlagen, eine Rechnung prüfen), ein serverseitiges Tool sein muss.
- Die Tools sind Websuche, Dokumentenbibliotheken, Workspace-Konnektoren und Ihre eigenen Funktionen. Es gibt keinen eingebauten Begriff Ihres Helpdesks oder Ihrer früheren Tickets. In unseren Sales-Gesprächen bei eesel ist die am häufigsten gewünschte Fähigkeit das Training auf vergangenen Tickets, weil dort die echten Antworten eines Unternehmens stecken. Mit Voxtral ist das Integrationsarbeit, die Sie selbst erledigen.
Außerdem gibt es die Sicherheitsfrage, die ein Hacker-News-Kommentator im Launch-Thread aufgeworfen hat, der 770 Punkte und 202 Kommentare erreichte. Ein Voice-Agent, der an interne Systeme angebunden ist, ist ein Prompt-Injection-Ziel, das jeder mit einem Telefon erreichen kann:
"I see companies hooking this up direct to the company intranet, and then users calling up and saying "Can you check this website for me?""

Das ist weniger ein Fehler von Voxtral als die Stellenbeschreibung jedes Voice-Agents mit Tool-Aufrufen. Es ist aber ein guter Grund, Telefon-Agenten bei schmalen, serverseitigen Tools mit klaren Grenzen dessen zu belassen, was sie ändern dürfen. Wenn Sie klären, was ein KI-Agent im Callcenter tun und lassen sollte, fangen Sie dort an.
Was kostet Voxtral 3 in der Praxis?
Die Preise pro Minute sind winzig, bis das Denken dazukommt. So viel kosten 10.000 Anrufe von je fünf Minuten (50.000 Minuten) zu Mistrals Listenpreisen:
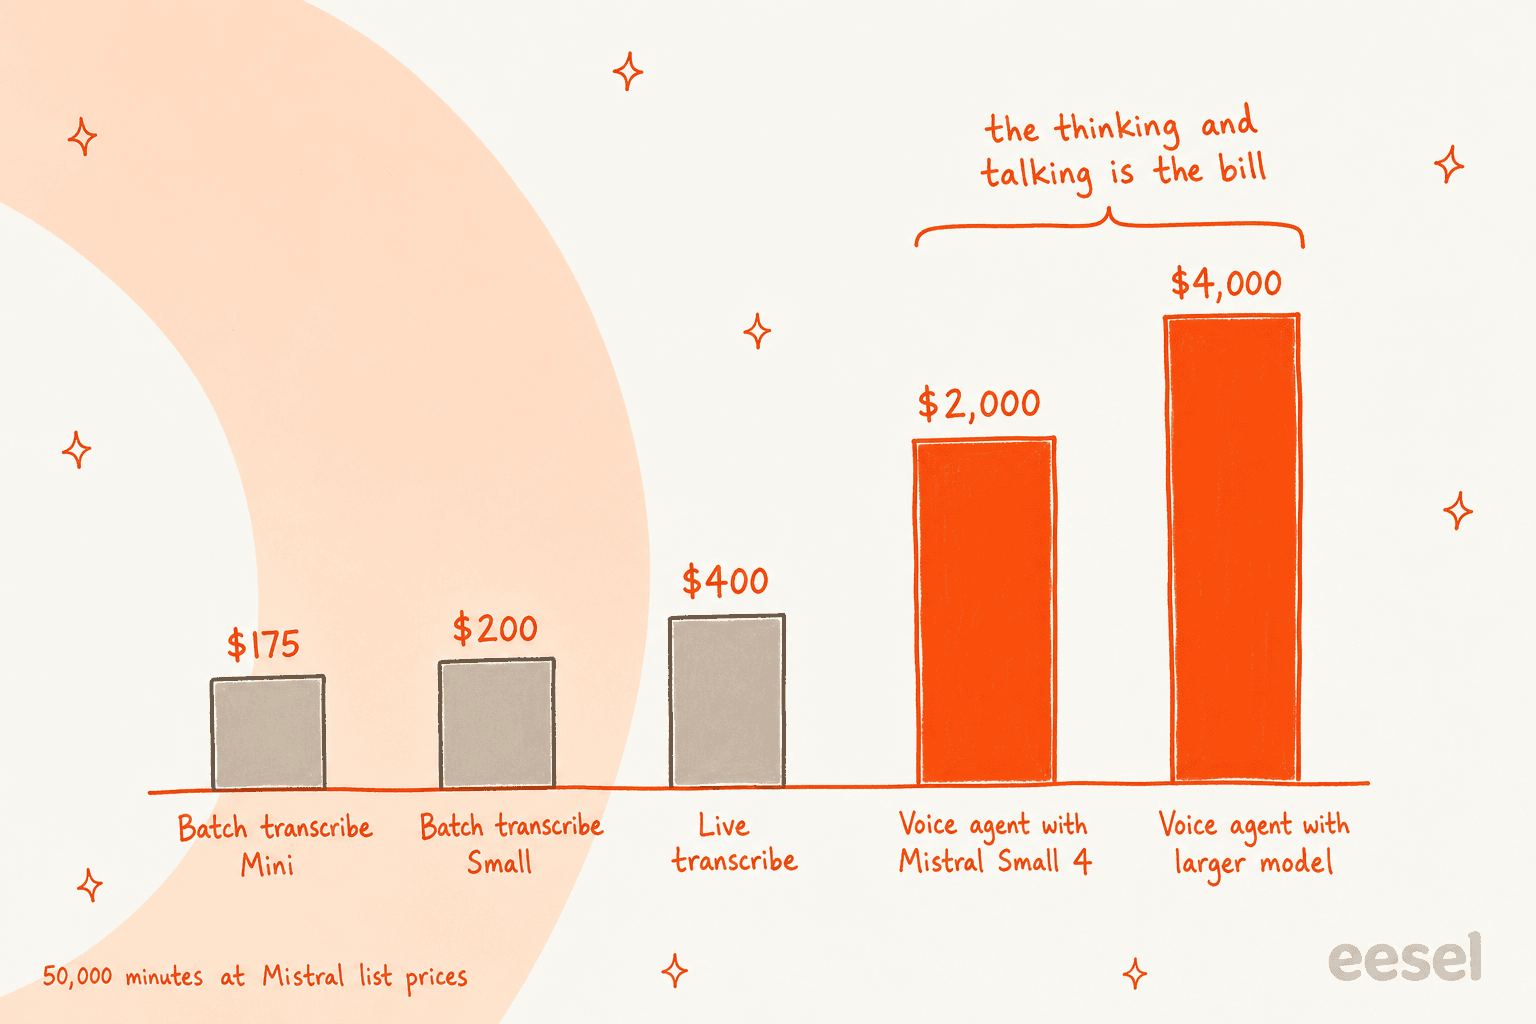
| Was Sie nutzen | Preis | 50.000 Minuten |
|---|---|---|
| Batch-Transkription, Mini | $0.0035/min | $175 |
| Batch-Transkription, Small | $0.004/min | $200 |
| Live-Transkription | $0.008/min | $400 |
| Voice-Agent-API mit Mistral Small 4 | $0.04/min | $2,000 |
| Voice-Agent-API mit einem größeren Modell | $0.08/min | $4,000 |
Das Muster ist der nützliche Teil. Jeden Anruf, den Sie ohnehin annehmen, für die Qualitätssicherung zu transkribieren, kostet ein paar hundert Dollar im Monat. Wenn ein KI-Agent diese Anrufe tatsächlich beantwortet, kostet es das 10- bis 20-Fache, denn das Schlussfolgern und die Sprache sind die Rechnung. Ein einzelner fünfminütiger Support-Anruf über die Agent-API kostet mit Mistral Small 4 $0.20. Diese Zahl gehört in Ihr Modell zum Callcenter-ROI, nicht die $0.004.
Der Agent-Preis von $0.04 ist auf den ersten Blick auch konkurrenzfähig. Zum Vergleich: Mein Grok-Voice-Test im August behandelte einen Konkurrenten für $0.08 pro Minute. Prüfen Sie die aktuellen Preise auf der Seite jedes Anbieters, bevor Sie sich festlegen, denn die Sprachpreise haben sich dieses Jahr schnell bewegt. Die vollständige Aufschlüsselung der Mistral-AI-Preise behandelt die Chat-Modelle hinter dem Agenten.
Warum sind die Gewichte von Voxtral 3 geschlossen?
Das ist die Änderung, die die lauteste Reaktion ausgelöst hat, und sie ist berechtigt. Die ersten Voxtral-Modelle (Mini 3B und Small 24B, Juli 2025) und das Modell Voxtral Mini 4B Realtime vom Januar 2026 erschienen alle mit offenen Gewichten auf Hugging Face. Allein das Realtime-Modell zeigt über 2 Millionen Downloads. Voxtral 3 hat keine öffentlichen Gewichte.
Der Launch sagt, Voxtral 3 sei „für die Selbstbereitstellung auf Ihrer eigenen Infrastruktur“ verfügbar, was Leser verwirrte, bis ein Kommentator es klarstellte:
"You have to call sales to get access for on-prem deployment and the models. If it were open weights, it would be on Huggingface and they would have put a link in the post"
Der Top-Kommentar des Threads brachte die Enttäuschung klar auf den Punkt:
"Closed model unfortunately, continues the theme of TTS / STT being really not great for local deployments."
Fairerweise hat Mistral offene Veröffentlichungen nicht ganz eingestellt, wie die Reihe der neuen Modelle zeigt. Kommentatoren verwiesen auf Timestral in der Woche zuvor und auf die versprochenen Gewichte von Mistral Large 4. Und ein Praktiker führte das kommerzielle Argument an: Gute Sprachmodelle mit Diarisierung sind knapper als gute Textmodelle, und Käufer zahlen dafür einen Aufschlag. Für ein Enterprise-Support-Team sind geschlossene Gewichte plus On-Prem per Vertrag ein normaler Beschaffungsweg. Für einen Hobbyisten, der einen Heimassistenten baut, ist es eine Sackgasse.
Was geht kaputt, wenn Sie auf Voxtral 2 sind?
Wenn Sie Voxtral 2 bereits aufrufen, lesen Sie den Migrationsleitfaden, bevor Sie Modell-IDs austauschen. Er ist gut geschrieben und ehrlich darüber, was kaputtgeht.
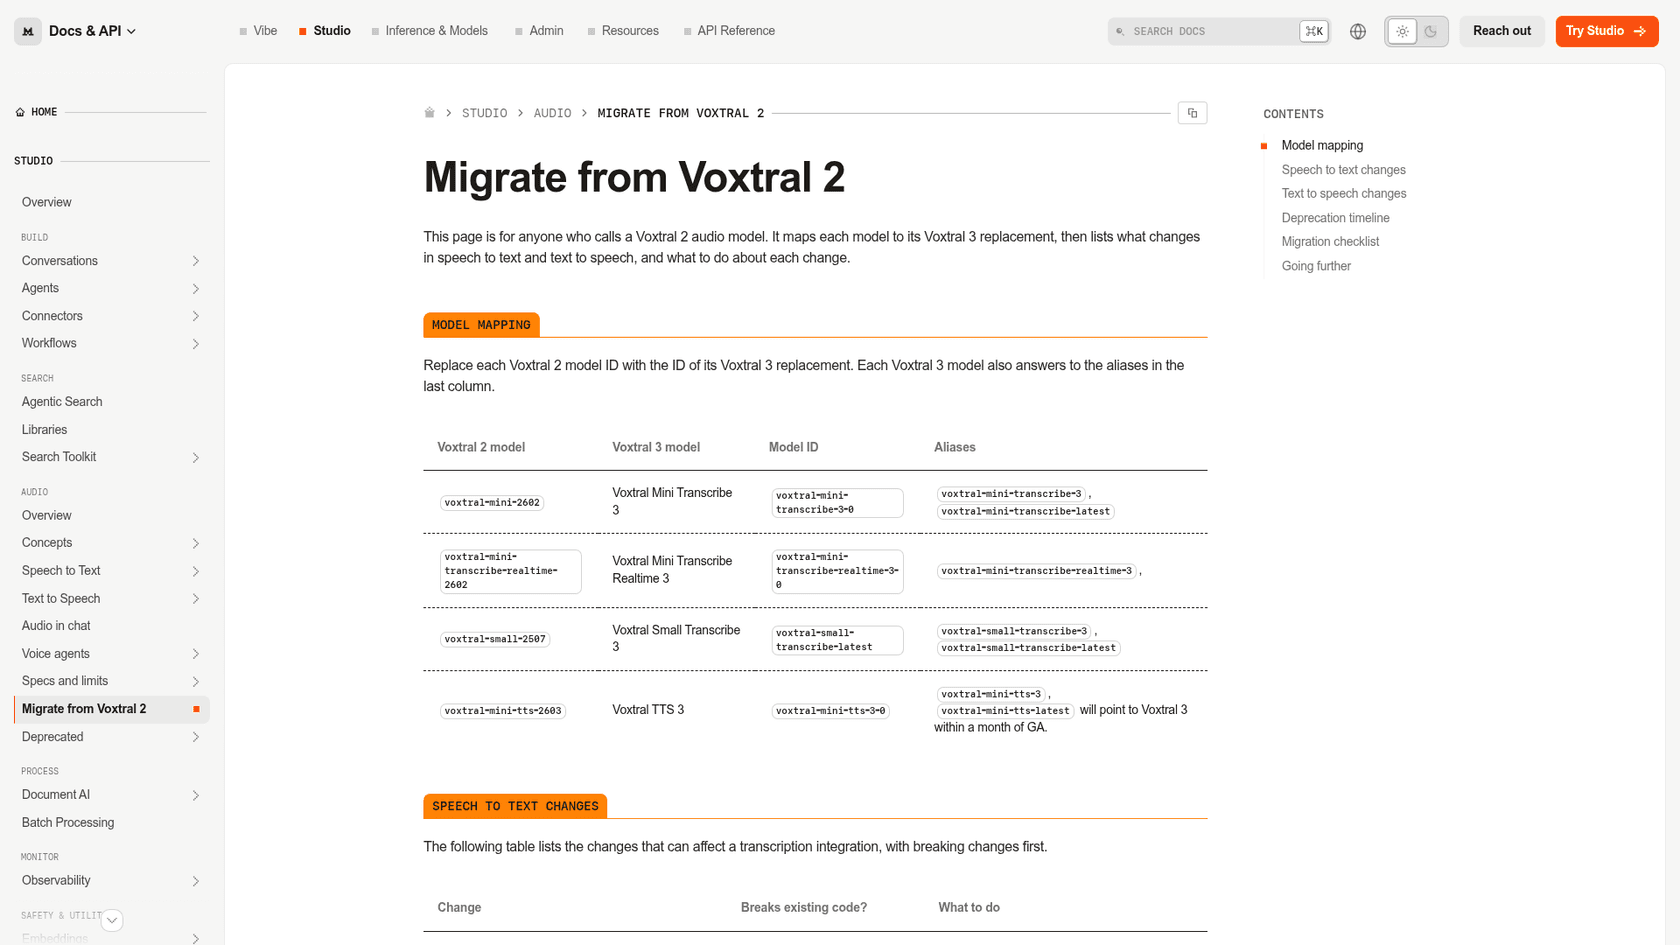
Die Breaking Changes, in der Reihenfolge, in der ich sie prüfen würde:
- Wort-Zeitstempel gibt es nicht mehr.
timestamp_granularitiesakzeptiert nur nochsegment; werwordanfordert, erhält einen400-Fehler. Wenn Sie Wörter während der Wiedergabe hervorheben, tut das weh. - Realtime-Sitzungen sperren ihre Einstellungen, sobald der erste Audio-Chunk eintrifft. Ein späteres
session.updateliefert einen Fehler, senden Sie also alle Einstellungen gleich zu Beginn. - Diarisierte Segmente können sich jetzt überlappen, wenn zwei Personen gleichzeitig sprechen. Wenn Ihre Anzeige davon ausgeht, dass das nie passiert, braucht sie eine Korrektur.
Die TTS-Seite ist sanfter: Alte voreingestellte Stimmen wie gb_jane_sad funktionieren weiter, ebenso das ref_audio-Klonen. Der Alias voxtral-mini-tts-latest wird innerhalb eines Monats nach der allgemeinen Verfügbarkeit auf Voxtral 3 umgestellt, legen Sie sich also auf explizite Modell-IDs fest, wenn Sie keine Überraschung wollen.
Wer sollte Voxtral 3 nutzen?
So lande ich, nach Käufertyp:
| Wenn Sie... | Urteil |
|---|---|
| Aufgezeichnete Anrufe für QA oder Analysen transkribieren | Ja. Fast spitzenmäßige Genauigkeit, die beste Diarisierung in seiner Grafik und $0.0035 bis $0.004 pro Minute. |
| Ein EU-Team sind, das Audio in Europa verarbeiten lassen muss | Ja. In der EU gehostete API und On-Prem per Vertrag. Lesen Sie dazu die Regeln des EU AI Act für den Support. |
| Einen Sprachassistenten für Browser oder App bauen | Wahrscheinlich. Das SDK ist gut gestaltet und der Agent-Preis niedrig, aber es ist eine Preview. |
| Diesen Monat eine KI an Ihre Support-Telefonleitung setzen wollen | Noch nicht, außer Sie sind Enterprise-Kunde. SIP ist für KI-Telefonsupport gesperrt, und die Helpdesk-Integration bauen Sie selbst. |
| Gewichte wollen, um lokal zu laufen | Nein. Schauen Sie sich die Mistral-Alternativen oder die älteren offenen Voxtral-Modelle an. |
Insgesamt gebe ich Voxtral 3 3,5 von 5. Die Transkriptionsmodelle sind eine 4,5, die Stimme eine 4, und das Agent-SDK eine vielversprechende 3, gebremst durch den Preview-Status und die Telefonsperre. Wenn Mistral SIP für alle öffnet und die Modelle zu diesen Preisen die Preview verlassen, steigt diese Bewertung.
Wenn Sie es mit dem übrigen Markt vergleichen, decken meine Übersicht der besten KI für Sprach-Support und die Liste der KI-Sprachunternehmen die anderen Optionen ab. Und wenn Sie noch entscheiden, ob sich die Automatisierung des Telefonsupports überhaupt lohnt, ist Callcenter-Automatisierung der Ausgangspunkt.
Wo eesel neben Voxtral 3 passt
Voxtral 3 ist Infrastruktur: sehr gute Ohren und eine günstige, ausdrucksstarke Stimme. eesel ist der Mitarbeiter. Unser KI-Helpdesk-Teammitglied arbeitet in dem Helpdesk, den Sie schon betreiben (Zendesk, Freshdesk, Gorgias und andere), lernt aus Ihren früheren Tickets, Ihrem Help Center und Ihren Makros und wird an Ihrem echten Ticketverlauf getestet, bevor es auch nur einem Kunden antwortet.
Das ist die Hälfte des Supports, die Voxtral Ihnen überlässt. smava, ein deutsches Kreditvergleichsportal, lässt eesel jeden Monat 27,000 Zendesk-Tickets auf Deutsch bearbeiten, wobei 14,600 davon kategorisiert und 15,300 Antworten aus 820 Makros und Help-Center-Artikeln entworfen werden. Koffer.ch, ein Schweizer Kofferhändler, lässt Freshdesk-Antworten auf Deutsch, Französisch, Englisch oder Italienisch entwerfen, je nachdem, in welcher Sprache der Kunde geschrieben hat, mit Schweizer Rechtschreibung. Das ist mehrsprachiger Support ohne Übersetzungsschritt. Keiner von beiden brauchte dafür ein Sprachmodell, und beide würden genau dieses Ticketwissen brauchen, wenn sie je einen Agenten ans Telefon setzen.
Wenn Ihre Warteschlange heute aus E-Mail und Chat besteht, würde ich dort zuerst automatisieren. Testen Sie eesel kostenlos an Ihren eigenen früheren Tickets und sehen Sie, was es beantwortet hätte.