

Mein Fazit auf einen Blick
Ich arbeite jeden Tag in der Support-Queue von eesel. Wenn ein Modell erscheint, lese ich es deshalb mit einer Frage im Kopf: Wartet ein Kunde weniger oder bekommt er eine bessere Antwort? Haiku 5.5 ist das erste kleine Claude, bei dem die Antwort für einen großen Teil der Tickets ein klares Ja ist. Die vollständige Bewertung steht unten.
| Was ich geprüft habe | Urteil | Die Zahl dahinter |
|---|---|---|
| Preis unter 100k Tokens | Ausgezeichnet | $0.10 Input / $0.50 Output, 90% unter Haiku 4.5 |
| Preis über 100k Tokens | Mittelmäßig | $0.50 / $2.50, Luna bleibt hier günstiger |
| Intelligenz | Beste seiner Klasse | 43 bei AA, vs. 38 für GPT-6 Luna |
| Geschwindigkeit | Ausgezeichnet | 137-243 Tokens/s bei AA, je nach Effort-Level |
| Agentisches Coding | Schwach | 39,2% Terminal-Bench 4.0 vs. 70,6% für Sonnet 5.5 |
| Token-Effizienz | Schlecht bei hohem Effort | ~162k Output-Tokens pro AA-Aufgabe bei Max, ~3x Luna |
| Halluzination | Besser als die Konkurrenz, aber weiter real | 40% bei AA-Omniscience vs. 77% für Luna |
| Migrationsaufwand | Mittel | 6 Breaking Changes, darunter temperature und Prefill |
Was Claude Haiku 5.5 ist
Claude Haiku 5.5 ist Anthropics kleines, schnelles Modell, erschienen am 7. Oktober 2026 unter der Modell-ID claude-haiku-5-5. Anthropic empfiehlt es für „high-volume, cost-sensitive tasks“ wie Zusammenfassungen, Compaction, Klassifizierung und Datenbankabfragen sowie als Subagent für Opus 5.5 und Sonnet 5.5 bei Coding-Aufgaben.
Das Datenblatt ist ein großer Sprung gegenüber Haiku 4.5. Das Kontextfenster wächst von 200k auf 1M Tokens, die maximale Ausgabe von 64k auf 128k, und der Knowledge Cutoff rückt auf Juni 2026. Es ist außerdem das erste Haiku mit einstellbarem Effort und adaptivem Thinking, und dieses Thinking ist standardmäßig auf Medium aktiv.
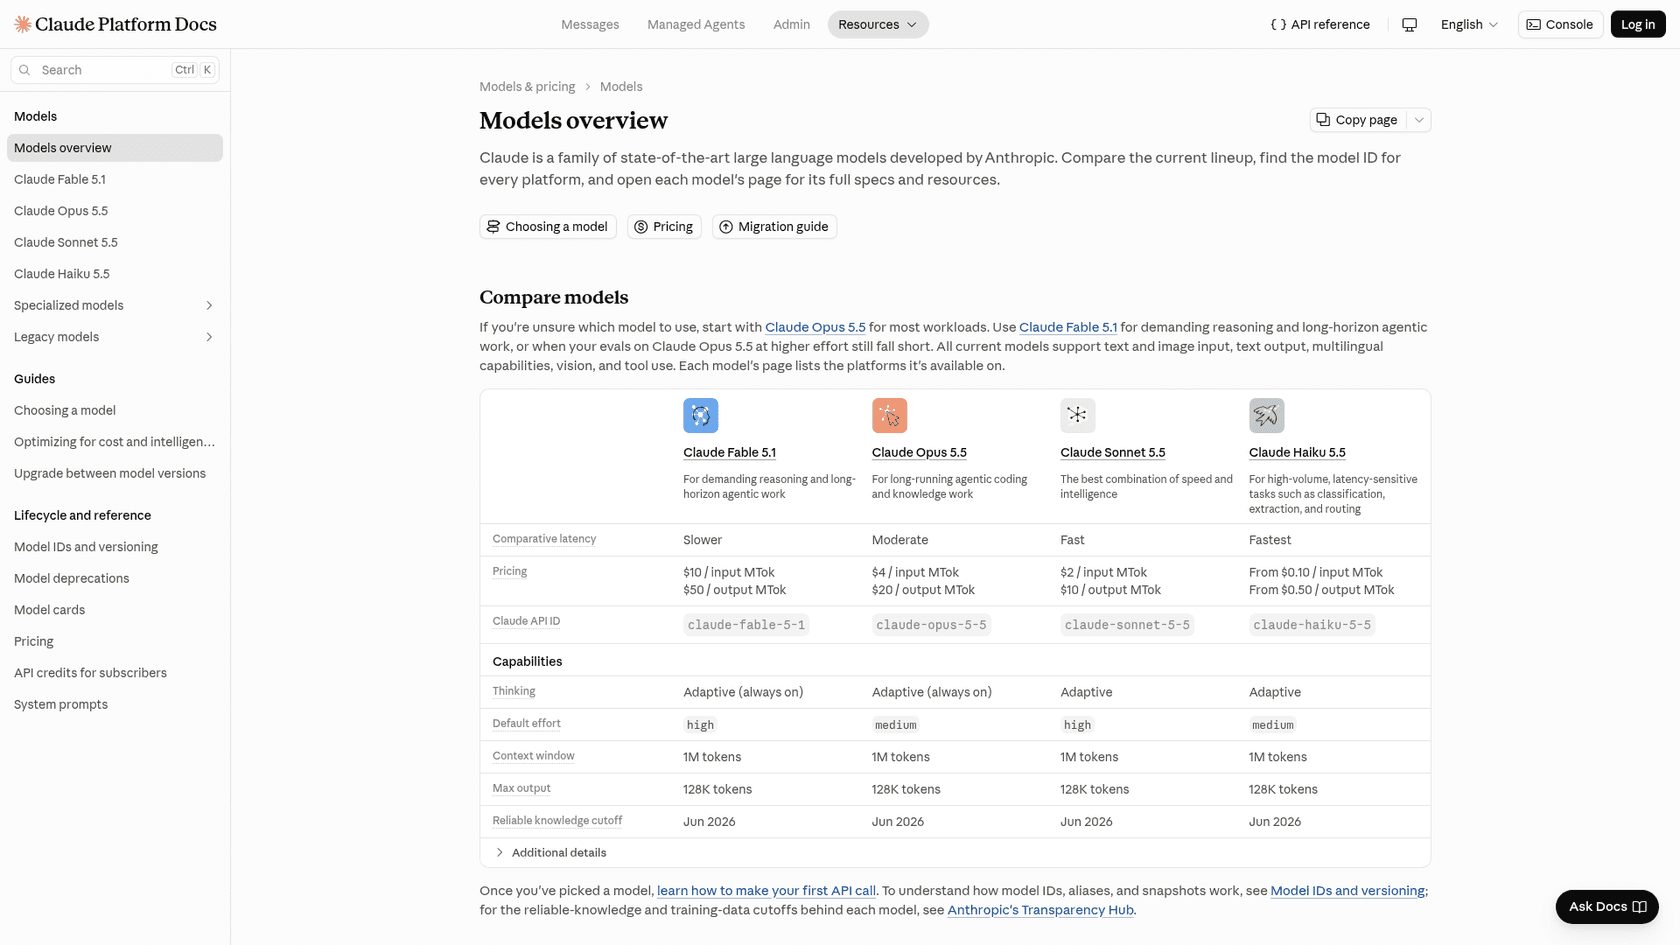
Die Modellübersicht beschreibt es als Modell „for high-volume, latency-sensitive tasks such as classification, extraction, and routing.“ Dieser eine Satz fasst meiner Meinung nach gut zusammen, wo es glänzt und wo nicht.
Wo Claude Haiku 5.5 stark ist
Es gibt viel Gutes, und die Fortschritte gegenüber Haiku 4.5 sind nicht klein. Hier verdient es sich seinen Platz.
Bei den meisten Aufgaben nah an Sonnet 5.5
In Anthropics eigenen Launch-Benchmarks erreicht Haiku 5.5 1620 bei GDPval-AA gegenüber 1840 für Sonnet 5.5 und 72,4% bei OSWorld 2.1 gegenüber 83,9%. Für ein Modell, das ein Zwanzigstel von Sonnets Input-Preis kostet, ist das ein beeindruckendes Ergebnis.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (Wissensarbeit) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (Computernutzung) | 72,4% | 15,7% | 48,9% | 83,9% |
| Humanity's Last Exam, ohne Tools | 45,9% | 10,2% | n/a | 56,9% |
| Terminal-Bench 4.0 | 39,2% | 0,0% | 16,4% | 70,6% |
| FrontierCode 1.1 | 46,4% | n/a | 42,4% | 52,1% (Xhigh) |
| Chartography, ohne Tools | 46,4% | 6,4% | 29,1% | 61,6% |
Das Muster wird klarer, wenn man jeden Haiku-Wert durch den von Sonnet teilt, genau das zeigt das Diagramm unten.
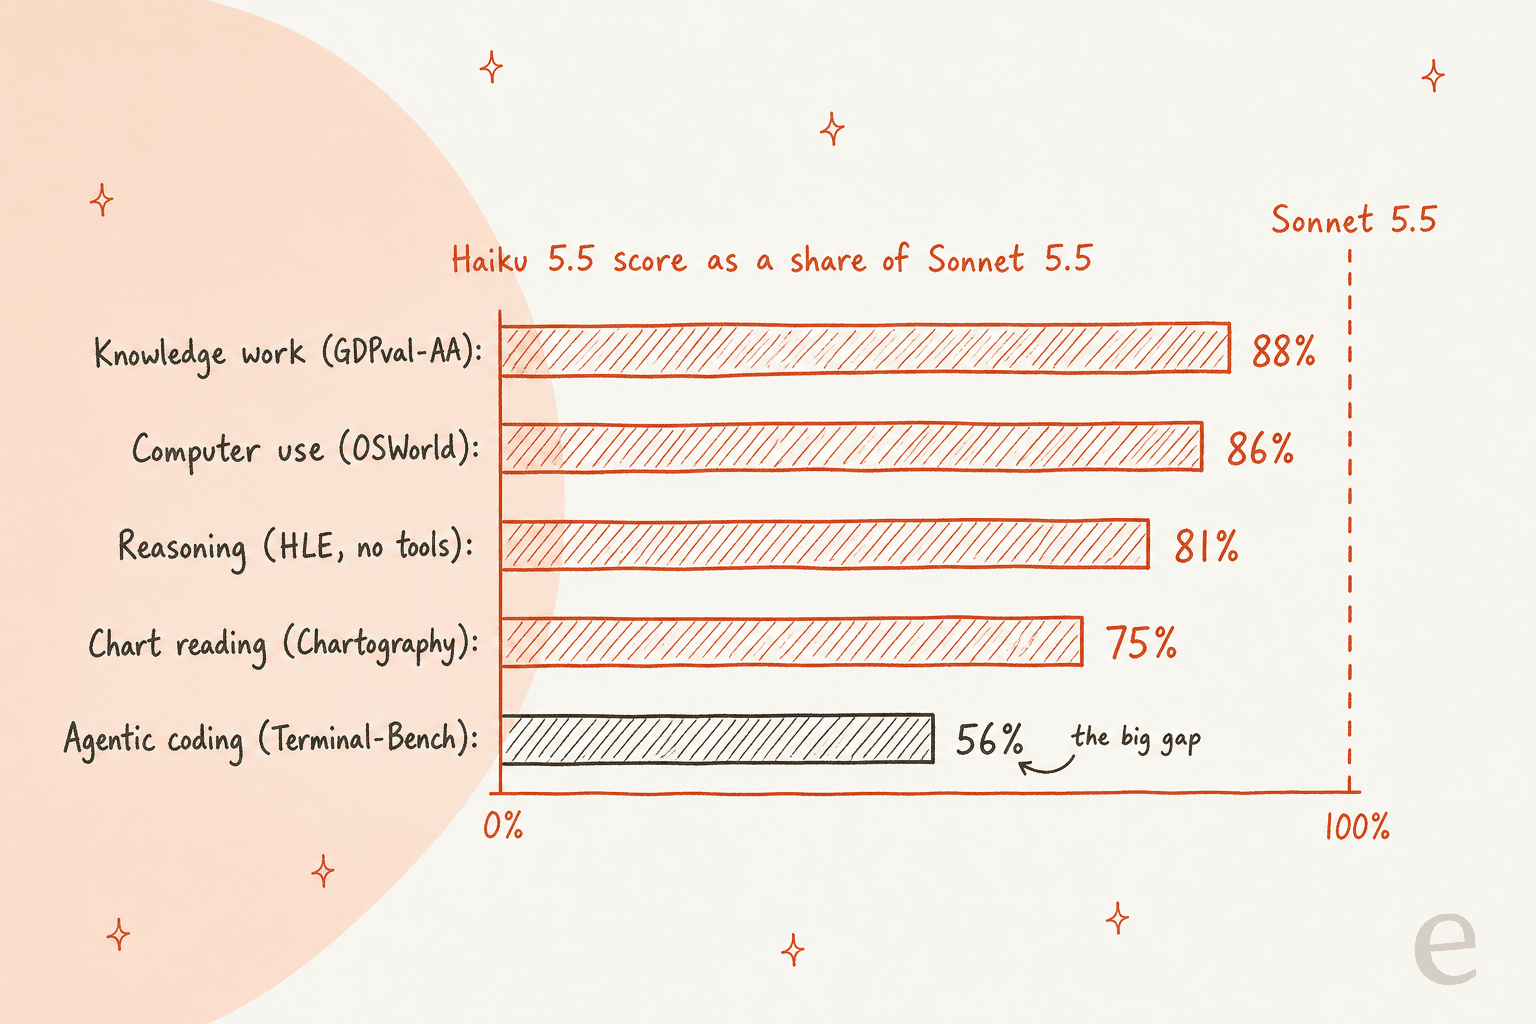
Bei Wissensarbeit und Computernutzung erreicht Haiku 5.5 86-88% von Sonnet 5.5. Beim agentischen Coding sind es 56%. Diese Lücke zeigt genau, welche Aufgaben du ihm geben solltest.
Es schlägt GPT-6 Luna bei Intelligenz und Halluzination
Artificial Analysis sieht Haiku 5.5 bei 43 im Intelligence Index mit Max-Effort, vor GLM-5.3 Flash (42), Gemini 3.8 Flash (41) und GPT-6 Luna (38). Außerdem fand es heraus, dass Haiku eher zugibt, etwas nicht zu wissen: 40% Halluzinationsrate bei AA-Omniscience gegenüber 77% bei Luna.
"Haiku 5.5 is noticeably smarter than GPT-6 Luna, so I can see their pricing strategy here. For a while Anthropic has lacked a cost effective "cheap" LLM for summarisation, compacting, RAG helpers, etc."

Es ist schnell
Anthropic nennt es bei Standardgeschwindigkeit „our fastest model to date“. Artificial Analysis maß je nach Effort 137 bis 243 Output-Tokens pro Sekunde, gegenüber 128 für Luna bei Max und 90 für Haiku 4.5. Kundenberichte passen dazu: Asana sah in seinen AI-Teammates-Evals „over a 30% reduction in latency for task completions“, und Box maß 11 Punkte mehr als Haiku 4.5 „at about half the latency.“
Geschwindigkeit ist im Support keine Eitelkeitskennzahl. Ein Käufer, mit dem ich sprach, führte eine methodische Evaluation mit 67 Tests für ein KI-Chat-Setup durch, fand die Antworten solide und sprang trotzdem ab, weil das Chat-Widget in seinen Worten „slow and often gets stuck“ war. Eine großartige Antwort, die zu spät kommt, fühlt sich einfach wie ein kaputtes Produkt an.
Es ist stark bei kurzen, fundierten Aufgaben
Die besten Kundenzitate zum Launch drehen sich alle um enge, wiederholte Aufgaben. HubSpot meldete 92,8% bei seiner CRM-Eval-Suite, „the best score we've seen on this suite yet“, mit der niedrigsten Falsch-Positiv-Rate bei einem Audit veralteter Datensätze. AlphaSense sah bei seinem Dokument-Q&A mit 8M Aufrufen pro Woche einen statistisch signifikanten Sprung von 0,76 auf 0,84.
Die Community sah dasselbe bei retrieval-lastigen Aufgaben.
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
Das ist die Form der meisten Support-Tickets: Du liest ein paar Help-Artikel und das Ticket und beantwortest dann die Frage. Deshalb halte ich Haiku 5.5 für die KI-Ticket-Klassifizierung und die Ticket-Zusammenfassung für wichtiger als für Coding.
Es funktioniert als Sidekick-Modell
Anthropics eigener Pitch ist Haiku als Subagent für ein größeres Modell, und die frühen Berichte bestätigen das. Rogo nutzt einen Haiku-5.5-Subagenten, um eine Umsatzzeile aus einem 10-K zu ziehen, während ein größeres Modell die Präsentation baut. Cognition sagt, sein Devin-Fusion-Setup mit Opus 5.5 als Lead und Haiku 5.5 als Sidekick „holds a top-tier FrontierCode score of 66.2 while cutting cost and latency.“
Ein Hacker-News-Tester sah sogar, wie es einen komplexen UI-Bau von selbst an Opus delegierte, und bemerkte, dass es „at least knows what it isn't good at.“ Wenn du bereits Claude-Code-Subagents einsetzt, ist das Haiku-in-Claude-Code-Setup der naheliegende Ort, um es zuerst auszuprobieren.
Wo Claude Haiku 5.5 schwächelt
Keiner dieser Punkte ist für sich ein Ausschlusskriterium, aber zusammen entscheiden sie, ob Haiku 5.5 dir Geld spart oder leise mehr kostet als geplant.
Die Preisklippe bei 100k Tokens
Das ist der große Punkt. Haiku 5.5 ist das einzige aktuelle Claude-Modell ohne einheitlichen Preis über das gesamte Kontextfenster. Laut Preisdokumentation zahlt ein Prompt über 100.000 Tokens den höheren Preis in jeder Zeile: Input, Output und Cache.
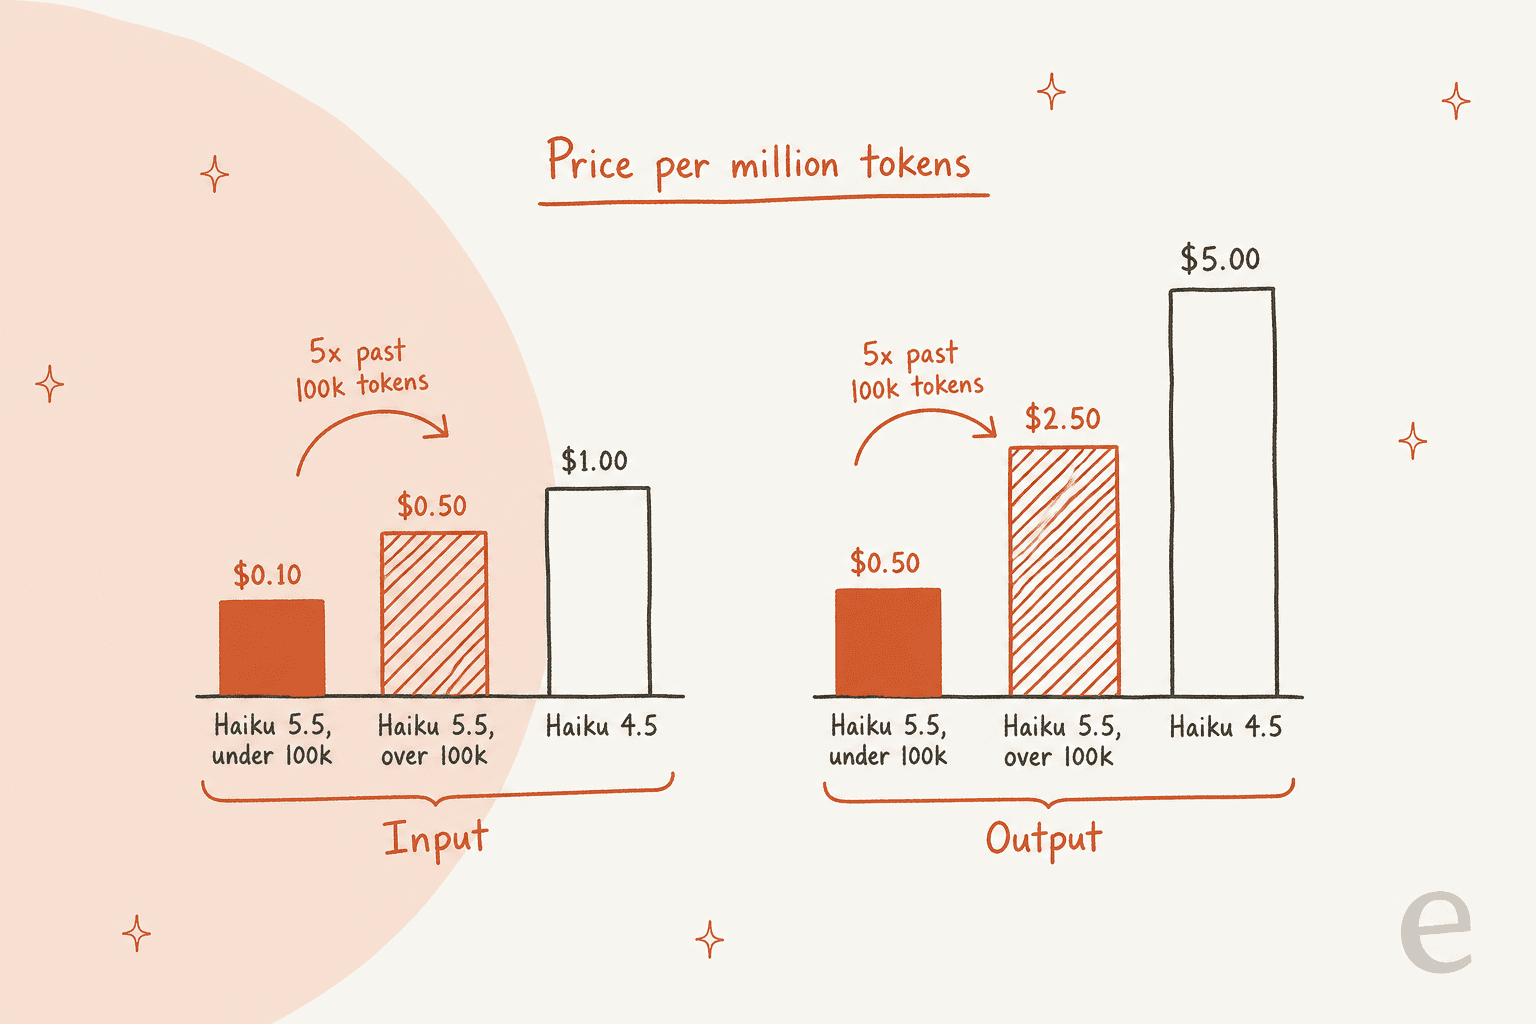
Laut Anthropic machen Prompts unter 100k rund 90% der Anfragen an das vorherige Haiku aus, die meisten klassischen Haiku-Jobs landen also in der günstigen Stufe. Bei Agent-Schleifen sieht es anders aus, weil sich die Gesprächshistorie schnell aufbaut.
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value"
Simon Willisons Launch-Artikel fasst den Zielkonflikt gut zusammen: Unter 100k entspricht Haiku dem Preis von Luna bei höheren Werten, aber „Above 100,000 tokens, Luna looks like a much better deal.“ Lunas eigene Preisstufe kommt erst bei 272k Tokens und steigt nur auf $0.20/$0.75.
Ein neuer Tokenizer fügt unbemerkt Tokens hinzu
Der Migrationsleitfaden sagt, derselbe Text erzeuge „approximately 30% more tokens than on Haiku 4.5.“ Simon Willison maß bei einem langen Prompt etwa das 1,25-Fache und nannte es „a hidden price increase.“ Es bedeutet auch, dass du die 100k-Grenze früher erreichst, als die reine Zeichenzahl vermuten lässt.
Ein Tester legte mit einem Klassifizierungsjob echte Zahlen vor.
| Modell | Input-Tokens | Output-Tokens | Batch-Kosten | Sync-Kosten |
|---|---|---|---|---|
| Haiku 5.5 | 11,893,643 | 240,451 | $0.21 | $0.42 |
| GPT-6 Luna | 7,903,468 | 177,602 | $0.16 | $0.31 |
Diese Zahlen stammen von Farmadupe auf Hacker News. Gleicher Preis pro Token, aber Luna kam beim selben Job etwa 26% günstiger weg, weil es weniger Tokens zum Lesen und Schreiben derselben Sache brauchte.
Max-Effort ist ein Token-Ofen
Effort-Einstellungen sind neu bei Haiku, und das obere Ende ist teuer. Artificial Analysis fand, dass Haiku 5.5 bei Max rund 162k Output-Tokens pro Intelligence-Index-Aufgabe nutzt, etwa das 3-Fache von Luna bei Max. Die Time to First Token lag bei Max bei 415 Sekunden.
| Effort | AA Intelligence Index | Kosten für den Index-Lauf | Output-Tokens | Time to First Token |
|---|---|---|---|---|
| Low | 29.4 | $34.31 | 32M | 13.6s |
| Medium (Standard) | 34.5 | $56.36 | 54M | 14.2s |
| High | 37.8 | $94.07 | 97M | 26.2s |
| Xhigh | 41.2 | $157.58 | 180M | 86.8s |
| Max | 43.4 | $330.25 | 440M | 415.3s |
Von Medium auf Max zu gehen bringt 9 Punkte für fast das 6-Fache der Kosten. Artificial Analysis merkt außerdem an, dass diese Kosten die 100k-Preisstufe noch nicht enthalten, lange Aufgaben werden also teurer, als die Tabelle sagt. Simon Willisons Pelikan-Test zeigt dasselbe im Kleinen: Low brauchte 7 Sekunden und kostete 0,0936 Cent, Max brauchte 5 Minuten 9 Sekunden.
Für Live-Chat lohnt es sich, die Time to First Token bei Medium in diesem Benchmark (etwa 14 Sekunden) an deinen eigenen Tickets zu testen, denn adaptives Thinking läuft, bevor die Antwort beginnt. Laut Dokumentation lässt niedrigerer Effort das Modell das Thinking bei einfachen Anfragen überspringen, und Thinking lässt sich bei High oder darunter weiterhin ganz abschalten.
Es liegt bei Fakten immer noch falsch, wenn es nichts zu lesen hat
Anthropics System Card ist hier ehrlich. Beim Closed-Book-Test AA-Omniscience beantwortete Haiku 5.5 44% richtig, 32% falsch und enthielt sich bei 24%. Netto ist das besser als Haiku 4.5, aber eine Fehlerquote von etwa einem Drittel bei Fragen, die es nicht nachschlagen kann, ist genau der Grund, warum ein Support-Modell deine Wissensdatenbank vor sich braucht.
Die System Card weist außerdem darauf hin, dass es im automatisierten Verhaltens-Audit häufiger als jedes andere Modell Anfragen zu Unrecht abgelehnt hat, und Artificial Analysis sagt, sein AutomationBench-Wert von 35% sei wegen eines Over-Refusal-Problems vor dem Release, das Anthropic behebt, „likely understated“.
Deine eigenen Evals können widersprechen
Nicht bei allen liefen die Tests am ersten Tag gut, und ich finde, das sollte man hören, bevor man einen Produktionsschalter umlegt.
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
Ein zweiter Kommentator antwortete, dass auch seine Evals und menschlichen Paarvergleiche Haiku 4.5 vorn sahen und er deshalb seine Prompts überarbeite. Haiku 4.5 ist weiterhin als aktiv gelistet, die Abschaltung erfolgt frühestens am 15. Oktober 2026, es gibt also ein Zeitfenster, um beide nebeneinander laufen zu lassen.
Was bei der Migration bricht
Die What's-new-Seite listet mehrere Breaking Changes auf. Für Support-Bots und Klassifizierer sind das die, die wehtun.
| Änderung | Was jetzt passiert | Die Lösung |
|---|---|---|
| Manuelle Thinking-Budgets | budget_tokens liefert einen 400 | Adaptives Thinking plus effort nutzen |
| Sampling-Parameter | Jedes top_k oder temperature ungleich 1 liefert einen 400 | Entfernen; über den Prompt steuern |
| Assistant-Prefill | Liefert einen 400, auch bei ausgeschaltetem Thinking | messages mit einem User-Turn beenden |
| Append-only-Historie | Das Bearbeiten von system, Tools oder früheren Turns und anschließendes Wiedergeben von Thinking liefert einen 400 | Historie append-only halten |
| Computer-Use-Tool | computer_20250124 wird in der API und bei Google Cloud abgelehnt | Auf computer_toolset_20260801 umsteigen |
| Tokenizer | ~30% mehr Tokens für denselben Text | max_tokens und Budgets neu berechnen |
Die temperature-Änderung ist für den Support die tückische. Viele Ticket-Triage-Pipelines laufen mit temperature 0 für konsistente Labels, und diese Anfrage scheitert jetzt komplett. Prefill ist der andere verbreitete Trick (oft genutzt, um eine öffnende JSON-Klammer zu erzwingen), und der ist ebenfalls weg.
Erzwungenes tool_choice funktioniert weiterhin, was nach dem Wegfall bei Sonnet 5.5 eine gute Nachricht ist. Der Haken: Ein erzwungener Tool-Aufruf kommt laut Migrationsleitfaden ohne Thinking-Block zurück. Wenn das Modell nachdenken soll, bevor es dein Erstattungs- oder Routing-Tool aufruft, nutze auto und sage es im Prompt.
Claude Haiku 5.5 Preise in einer Tabelle
Hier die vollständige Preisliste aus der Claude-Preisdokumentation, mit Haiku 4.5 und Sonnet 5.5 als Referenz. Alle Preise pro Million Tokens.
| Posten | Haiku 5.5, bis 100k | Haiku 5.5, über 100k | Haiku 4.5 | Sonnet 5.5 |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $1.00 | $2.00 |
| Output | $0.50 | $2.50 | $5.00 | $10.00 |
| 5-Minuten-Cache-Write | $0.125 | $0.625 | $1.25 | $2.50 |
| 1-Stunden-Cache-Write | $0.20 | $1.00 | $2.00 | $4.00 |
| Cache-Read | $0.01 | $0.05 | $0.10 | $0.10 |
| Batch Input / Output | $0.05 / $0.25 | $0.25 / $1.25 | $0.50 / $2.50 | $1.00 / $5.00 |
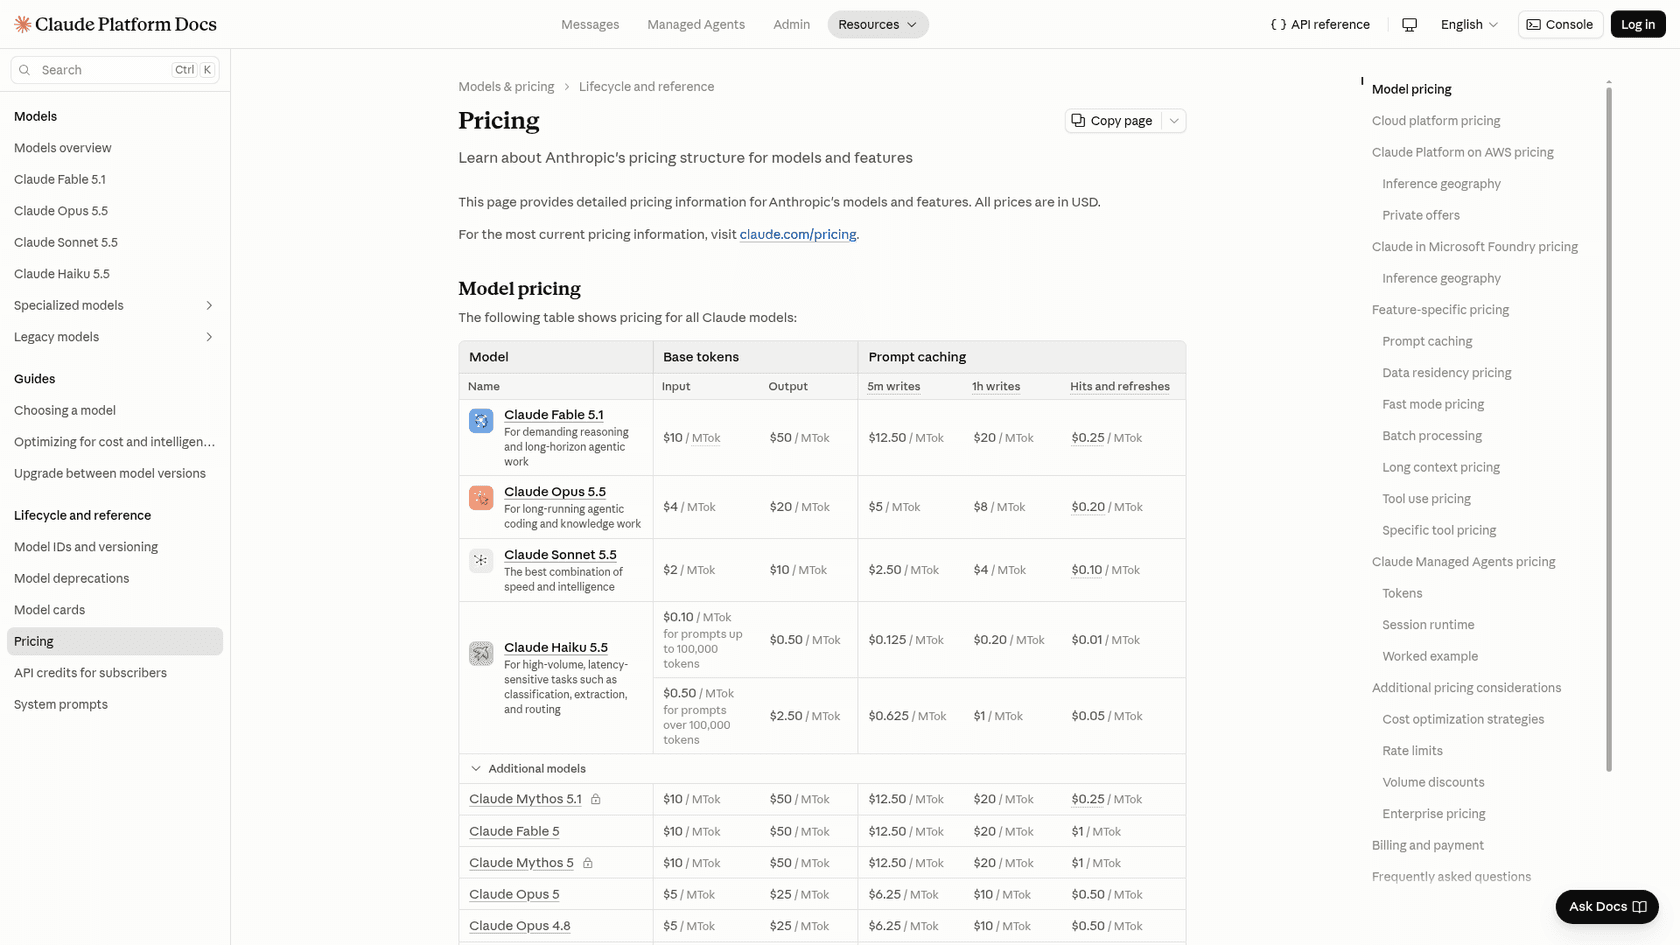
Zur Veranschaulichung: Eine Support-Antwort mit einem 8.000-Token-Prompt (Anweisungen, ein paar Help-Artikel und das Ticket) und 600 Output-Tokens inklusive Thinking. Mit Haiku 5.5 sind das etwa $0.0011 pro Ticket, also rund $11 für 10.000 Tickets. Wächst dieselbe Unterhaltung auf einen 150.000-Token-Prompt, kostet allein der Input $0.075, das Fünffache dessen, was es unter der Grenze wäre. Für Haiku 5.5 gibt es keinen Fast-Modus, und Anthropic hat am selben Tag auch Sonnet 5.5s Cache-Reads auf $0.10 halbiert, was die Lücke für cache-lastige Agents verkleinert. Mein Sonnet-5.5-Preisleitfaden behandelt diese Seite.
Wie ich es in einer Support-Queue einsetzen würde
Wie ich Haiku 5.5 im Support betreiben würde, folgt ziemlich direkt aus den Stärken und den Klippen oben. Lass es die schnelle, kurze, volumenstarke Arbeit bei jedem Ticket erledigen und gib die schweren Fälle nach oben weiter.
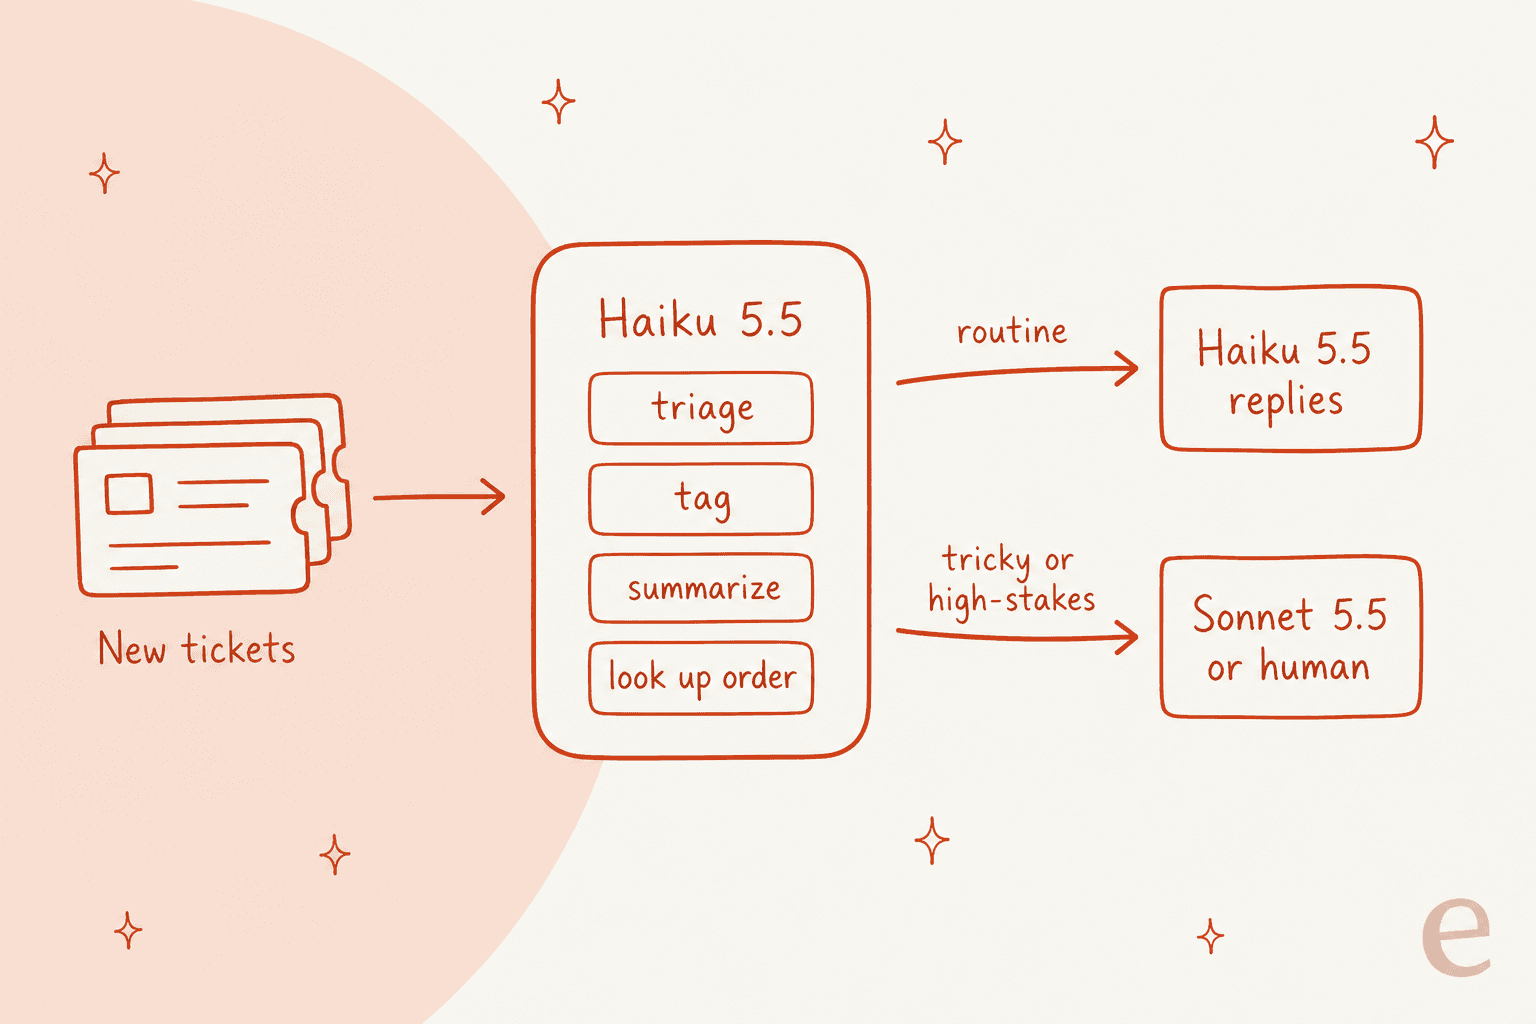
In der Praxis heißt das:
- Triage und Tagging bei Low-Effort. Kurze Prompts, eine feste Label-Liste, keine lange Historie. Dafür wurde die 100k-Stufe gebaut, und es eignet sich auch für die Ticket-Priorisierung.
- Zusammenfassungen und Übergabenotizen bei Medium. Schnell genug, um bei jedem Ticket zu laufen, ohne dass jemand die Kosten bemerkt.
- Routine-Antworten, gestützt auf dein Help Center. Bestellstatus, Passwort-Resets, Rückgabefristen. Halte den abgerufenen Kontext schlank, damit der Prompt unter 100k bleibt.
- Den Rest eskalieren. Erstattungsstreitigkeiten, mehrstufige Fehlersuche und alles mit langem Thread gehen an Sonnet 5.5 oder einen Menschen.
So sieht ungefähr auch ein echter Test aus, wenn er gut läuft. In einem E-Commerce-Test mit Live-Zendesk-Traffic war Triage die stärkste Aufgabe für die KI, mit 93% Genauigkeit und 100% Spam-Erkennung, während vollständige Entwürfe mehr Hilfe durch die früheren Antworten des Teams brauchten. Ein kleines, schnelles Modell passt meiner Meinung nach gut zu dieser ersten Aufgabe.
Was Entwickler sagen
Der Hacker-News-Launch-Thread kam auf über 770 Punkte und 380 Kommentare, und die Reaktion teilte sich entlang einer Linie: Wer kurze, klar umrissene Jobs hatte, liebte es, und wer lange Agent-Sessions fuhr, rechnete die 100k-Klippe durch.
"Ran our DataAnalyticsBench benchmark on it: 9x cheaper than Haiku 4.5 and 2 letter grades better. It's also now the fastest model (using the default speeds, not trying any of the other models "Fast" mode) to complete the exam."
Derselbe Tester ergänzte, es habe jede einfache Analytics-Frage gemeistert, bei Fragen mit tieferer statistischer Arbeit aber nachgelassen, und GPT-6 Luna habe etwas besser abgeschnitten, bei etwa 30% der Kosten.
"With that said, the real reason to use Haiku is that it's faster than all of these models. OpenRouter is showing an average so far of 93 tokens/sec, and AA got at least 137 in each of their benchmarks. So it might be valuable for speed at lower thinking levels."
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."
Das Artificial-Analysis-Team fasste es als „notably fast, however very verbose“ zusammen, was zu allem oben passt.
Wer wechseln sollte und wer warten
So würde ich entscheiden, nach Aufgabe statt nach Benchmark-Diagramm.
| Du betreibst | Mein Urteil | Warum |
|---|---|---|
| Klassifizierung, Tagging, Routing | Wechseln, nach kurzer Eval | Günstigste Stufe, schnellstes Modell, kleine Prompts |
| RAG-Antworten über ein Help Center | Wechseln, Prompts unter 100k halten | Starke fundierte Ergebnisse, 1M-Fenster bei Bedarf |
| Subagents unter einem Sonnet- oder Opus-Lead | Wechseln | Der Anwendungsfall, auf den Anthropic und frühe Kunden verweisen |
| Lange Agent-Schleifen über 100k Tokens | Warten oder Luna wählen | 5-fache Preisstufe plus der schwerere Tokenizer |
| Komplexes agentisches Coding | Bei Sonnet 5.5 bleiben | 39,2% vs. 70,6% bei Terminal-Bench 4.0 |
| Pipelines mit temperature 0 oder Prefill | Migrationszeit einplanen | Beides liefert jetzt einen 400-Fehler |
Wenn du es mit externen Optionen vergleichst, behandeln meine Beiträge zu GPT-6-Luna-Alternativen, Gemini 3.8 Flash und Kimi K3 den Rest des Feldes der kleinen und mittelgroßen Modelle.
Speziell für den Support geht der Leitfaden zu welches LLM zum Support passt weiter.
Ein schnelleres Modell behebt keine falsche Antwort
Eines kann dir ein Modell-Test nicht zeigen: Die meisten Support-Bot-Fehler, die ich sehe, haben nichts mit dem Modell zu tun. Ein B2B-Fahrzeug-Telematik-Team stellte fest, dass sein Bot Kunden erzählte, er unterstütze Automarken, die gar nicht in der Datenbank standen. Das Modell hat sich nichts ausgedacht, um fair zu bleiben. Die Wissensdatenbank sagte, man unterstütze „all models“, und der Bot glaubte es. Haiku 5.5 hätte dieselbe falsche Antwort gegeben, nur schneller und günstiger.
Deshalb wird jeder eesel-Rollout an historischen Tickets simuliert, bevor das Teammate mit einem Kunden spricht. In diesem Schritt findest du die Wissenslücken, die kein Modell-Upgrade beheben kann, und bei einem Modell, das 32% der Closed-Book-Fakten falsch beantwortet, ist das noch wichtiger.
eesel mit schnellen Claude-Modellen in deiner Queue testen
Wenn du Haiku 5.5s Geschwindigkeit bei deinen Tickets willst, ist eesel die Abkürzung. Das KI-Helpdesk-Teammate arbeitet in deinem bestehenden Helpdesk, etwa Zendesk, Freshdesk oder Gorgias, lernt aus deinen früheren Tickets und deinem Help Center und triagiert, taggt und antwortet mit einem Frontier-Modell darunter. Die 100k-Klippe, das Effort-Tuning, die Breaking Changes oben, all das wird zu eesels Problem und nicht zu deinem.

Wenn du im Terminal lebst: Die eesel CLI bedient dasselbe Teammate und denselben Workspace wie das Dashboard. Du kannst sie skripten oder einen Coding-Agent wie Claude Code steuern lassen, also dasselbe Lead-und-Sidekick-Muster aus diesem Test, angewandt auf dein Support-Setup.
Meine Beiträge zur AI-Agent-CLI und zu MCP-Servern gehen tiefer.
Bezahlte Pläne beginnen bei $299 für 500 Credits, und du kannst es vorher kostenlos an einem Teil deiner echten Tickets testen. Probiere eesel aus und sieh, ob sich ein schnelleres Modell tatsächlich als schnellere Antworten für deine Kunden zeigt.
Lohnt sich Claude Haiku 5.5?
Ja, wenn deine Arbeit kurz und repetitiv ist. Unter 100k Prompt-Tokens und bei Low- oder Medium-Effort ist Claude Haiku 5.5 das beste kleine Modell, das ich von Anthropic gesehen habe: schlauer als GPT-6 Luna zum gleichen Listenpreis und schneller als alles andere, was Anthropic verkauft, und es liegt bei Wissensarbeit nah genug an Sonnet 5.5, um einen großen Teil einer Support-Queue zu übernehmen.
Jenseits beider Grenzen kippt die Rechnung: Lange Agent-Sessions zahlen das 5-Fache, Max-Effort verbrennt Tokens, und der neue Tokenizer lässt beides früher eintreten. Führe deine eigene Eval gegen Haiku 4.5 durch, solange es noch verfügbar ist, halte Prompts schlank und überlasse den größeren Modellen, was Haiku 5.5 nach oben weitergibt.