
Was Claude Sonnet 5.5 eigentlich ist
Claude Sonnet 5.5 ist das Mittelklasse-Modell von Anthropic und der zweite Release der Claude-5.5-Familie, sechs Tage nach Opus 5.5. Anthropic positioniert es als "a faster, lower-cost complement" zu Opus: Opus bleibt für komplexe Arbeit, die sorgfältiges Urteilsvermögen braucht, und Sonnet übernimmt die klar umrissenen Alltagsaufgaben. Ein Haiku 5.5 wurde ebenfalls "in the coming weeks" versprochen.
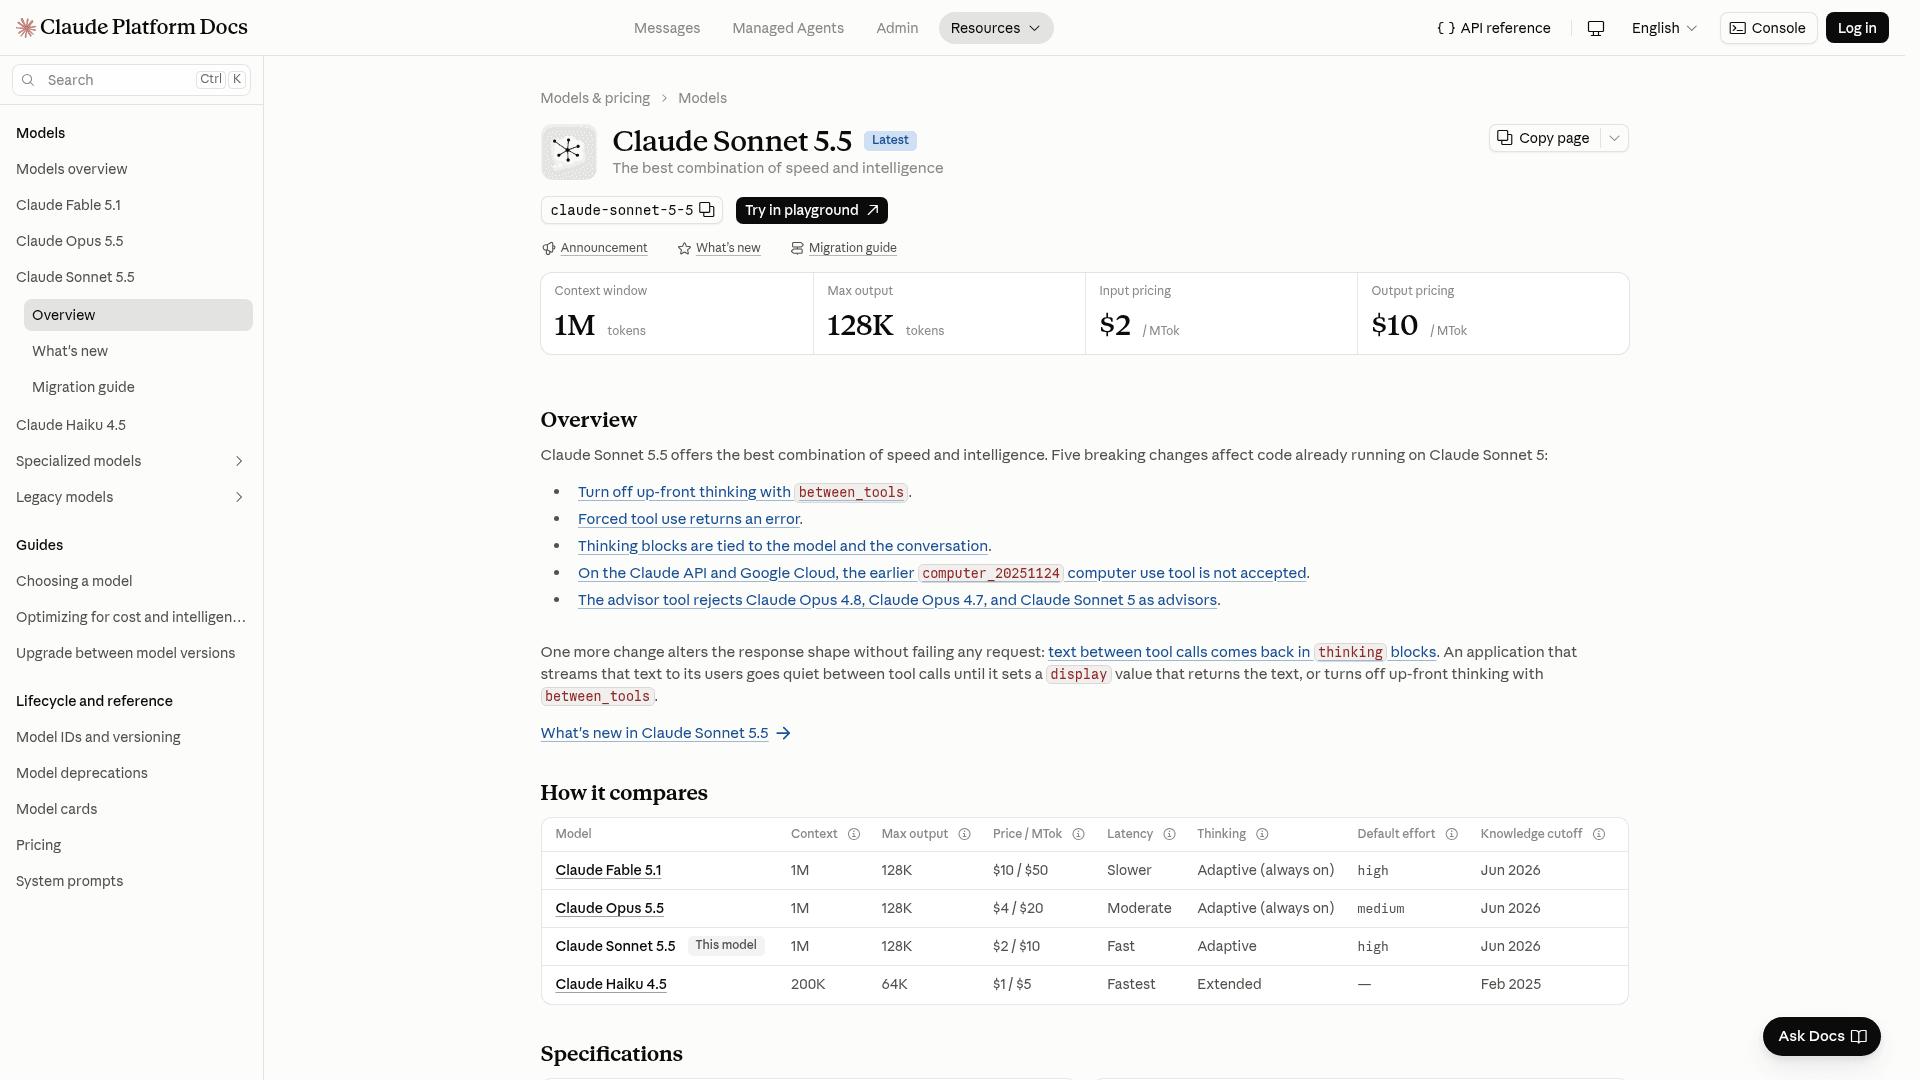
Hier die Spezifikationen laut Modellübersicht:
- Die Modell-ID lautet
claude-sonnet-5-5in der Claude API, Google Cloud, Microsoft Foundry und Claude Platform on AWS sowieanthropic.claude-sonnet-5-5auf Amazon Bedrock. - Der Kontext beträgt 1M Tokens Input und 128K Output, bei der Batch API mit einem Beta-Header 300K Output.
- Der verlässliche Wissensstand ist Juni 2026, wie bei Opus 5.5 und Fable 5.1.
- Thinking ist adaptiv, und der Standard-Effort ist
highin der API, aber Medium in den Claude-Apps und in Claude Code. - Die Abschaltung erfolgt "not sooner than September 28, 2027", Sie haben also mindestens ein Jahr, bevor der nächste Wechsel ansteht.
Der Tokenizer ist derselbe wie bei Claude Sonnet 5, laut What's-new-Seite. Derselbe Text ergibt also dieselbe Token-Zahl. Dieses Detail ist wichtiger, als es klingt: Jede Einsparung, die Anthropic angibt, kommt daher, dass das Modell weniger schreibt, und nicht von einer freundlicheren Zählweise.
Die eigentliche Geschichte: gleicher Preis, kleinere Rechnung
Beim Listenpreis hat sich nichts bewegt. Sonnet 5.5 kostet genau das, was Sonnet 5 kostet: 2 $ Input, 10 $ Output, 0,20 $ für Cache-Lesezugriffe. Geändert hat sich, wie viele Tokens es braucht, um eine Aufgabe zu erledigen.
Die Zahlen aus dem Early Access im Launch-Beitrag sind so konkret, wie man es selten sieht:
- Balyasny Asset Management ließ 2.441 Finanzaufgaben laufen und sah bei Sonnet 5.5 etwa 121k Tokens pro Antwort, wo Sonnet 5 497k brauchte, bei besserem Ergebnis.
- Slack sah bessere Ergebnisse bei "almost all" seiner Offline-Slackbot-Evals "with about 14% fewer output tokens", und das ohne Änderungen an den Prompts.
- Base44 schloss App-Builds im Schnitt in 3,6 Iterationen ab, wo Opus 5 7,7 brauchte.
- Lovable maß "a third fewer tool calls and roughly half the shell runs to finish a task".
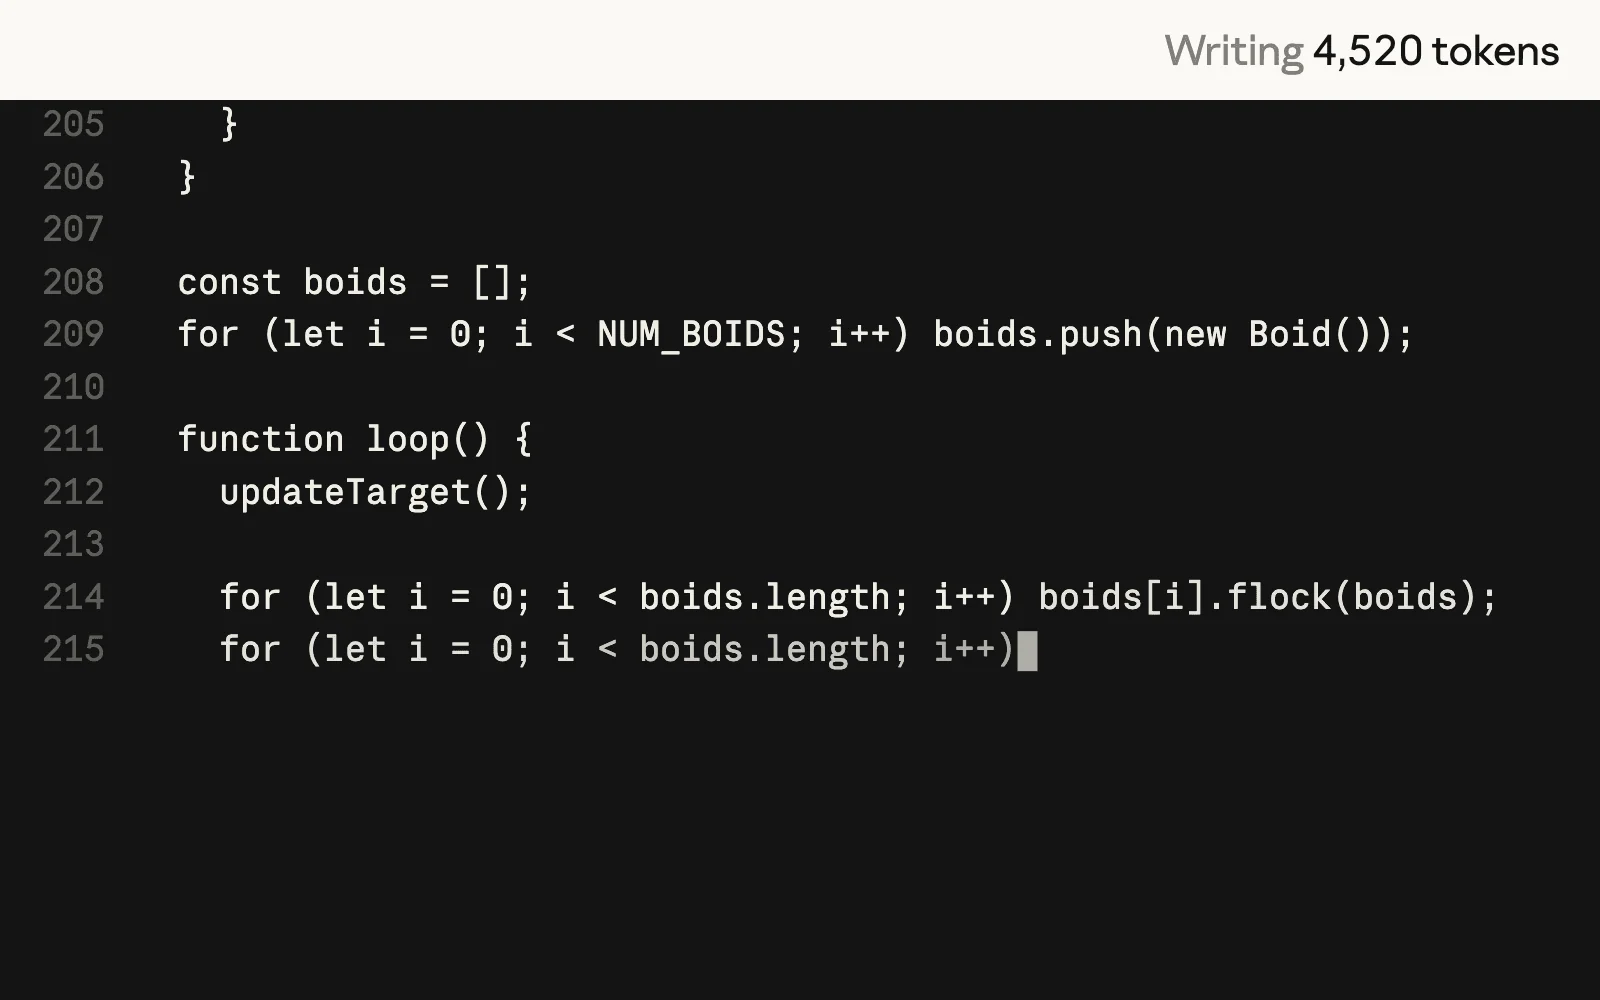
Anthropics eigener direkter Vergleich zeigt dasselbe, nur anschaulicher. Als beide gebeten wurden, in einer einzigen HTML-Datei einen Starenschwarm mit 400 Vögeln zu bauen, schrieb Sonnet 5 bei 4.520 Tokens noch Code:
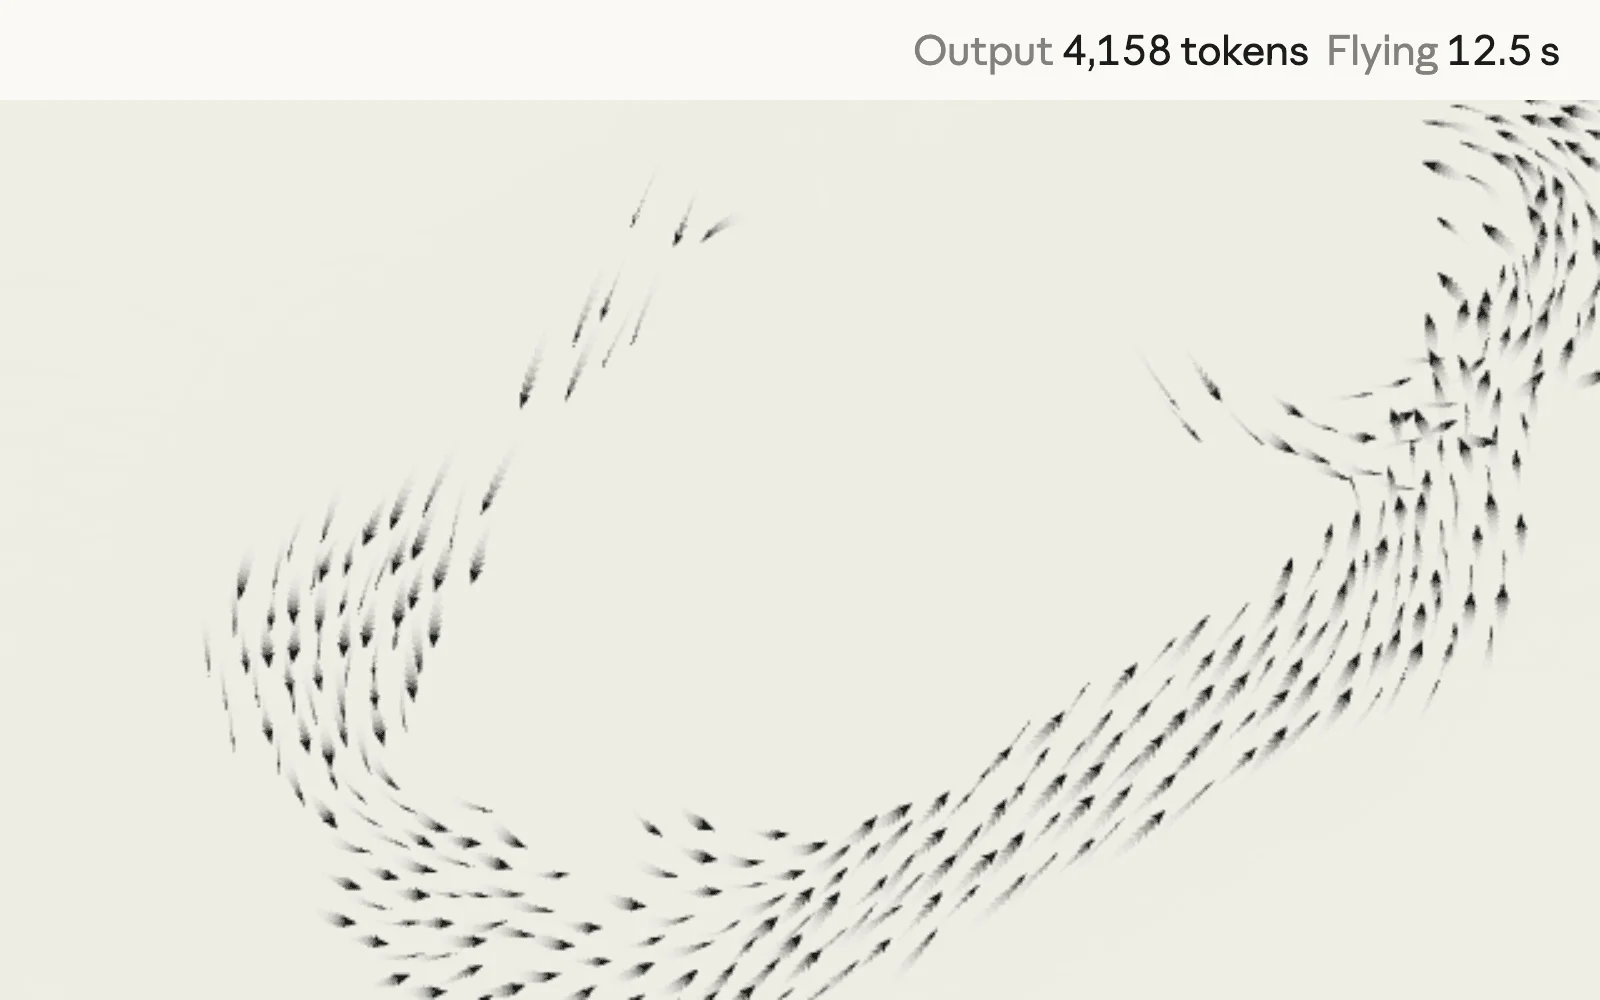
Sonnet 5.5 war schon bei 4.158 Tokens fertig, und sein Schwarm flog zu diesem Zeitpunkt bereits seit 12,5 Sekunden:
Die Streuung zwischen den Kunden ist der Ort, an dem die ehrliche Lesart liegt. Balyasnys 4x weniger Tokens und Slacks 14 % sind beide echt, was zeigt, dass die Einsparung stark davon abhängt, wie aufgebläht Ihre Sonnet-5-Läufe von Anfang an waren. Anthropics Schlagzeile sagt "up to 30% less per task", und das "up to" trägt in diesem Satz viel Gewicht. Sonnet 5 neigte bekanntermaßen dazu, lange zu laufen: In Tests von Artificial Analysis brauchte es bei Max Effort 183 Turns pro Aufgabe, der schlechteste Wert im Diagramm. Wenn Ihre Workload dort lag, können Sie mit der großen Zahl rechnen. Wenn Ihre Prompts Antworten ohnehin kurz hielten, erwarten Sie eher etwas in Richtung von Slack.
Wie nah es an Opus 5.5 herankommt
Für alle, die Opus-Preise zahlen, wird der Release hier interessant. In Anthropics Launch-Benchmark-Tabelle schließt Sonnet 5.5 den Großteil des Abstands zu einem Modell, das pro Token doppelt so viel kostet.
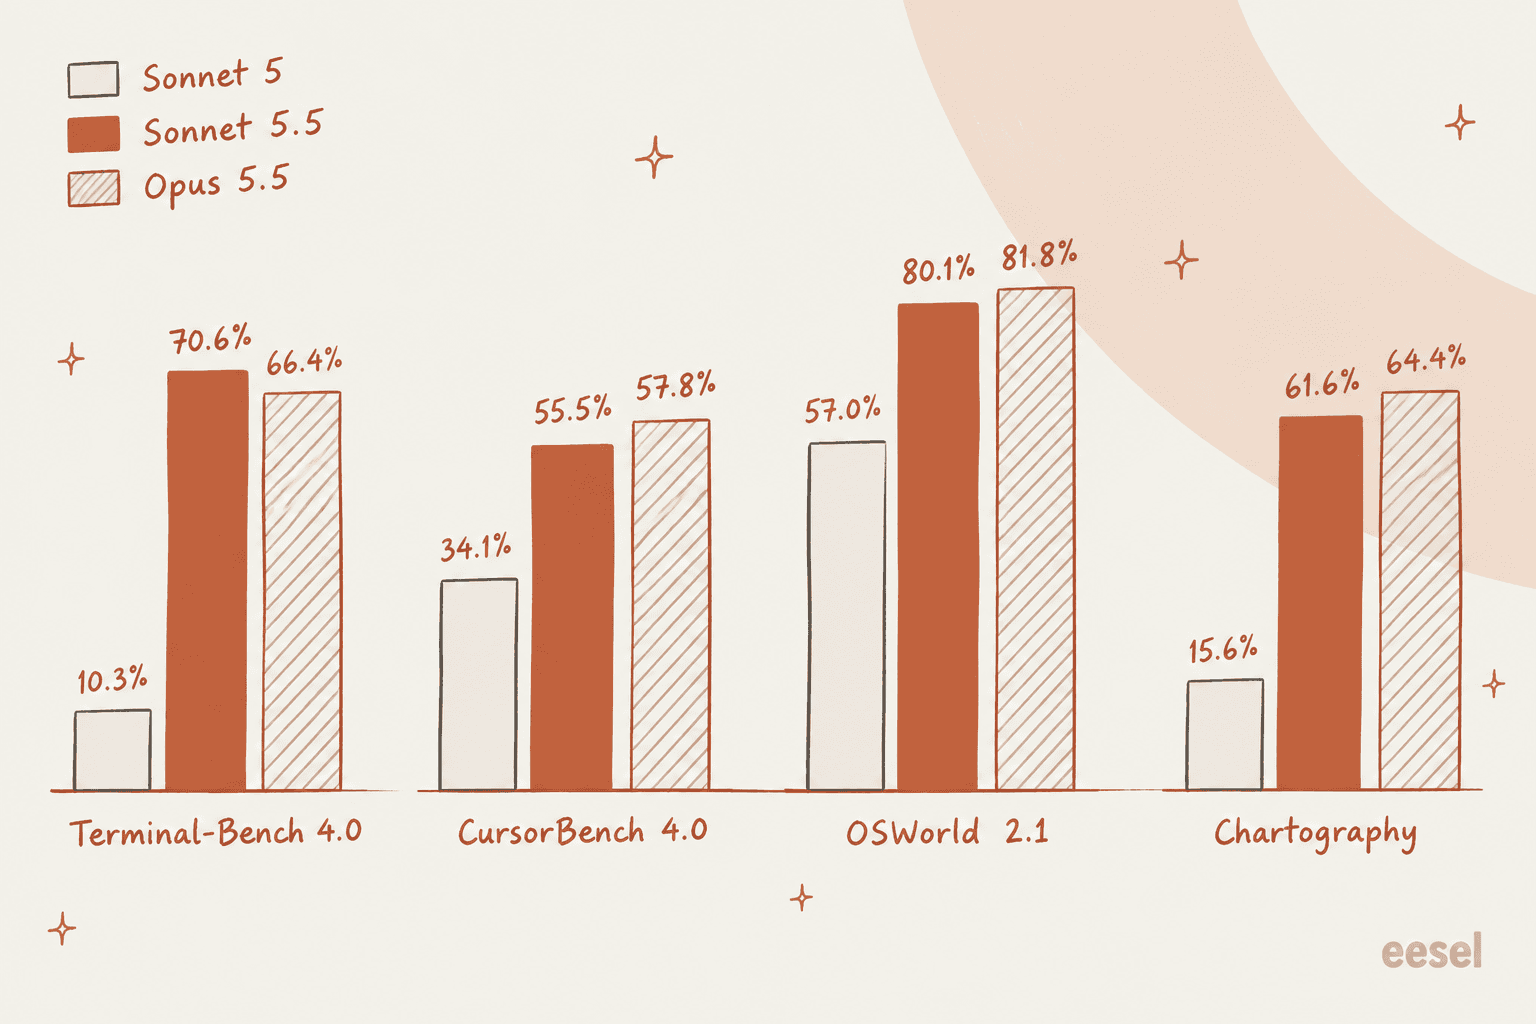
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (Agentic Coding) | 70.6% | 10.3% | 66.4% | nicht angegeben |
| FrontierCode 1.1 (merge-fähiger Code) | 52.1% (Xhigh) | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 55.5% | 34.1% | 57.8% | nicht angegeben |
| GDPval-AA v2.1 (Wissensarbeit, Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Langzeitaufgaben, Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam (mit Tools) | 64.5% | 54.9% | 67.7% | nicht angegeben |
| OSWorld 2.1 (Computer Use) | 80.1% | 57.0% | 81.8% | nicht angegeben |
| Chartography (Diagramme lesen) | 61.6% | 15.6% | 64.4% | 53.6% |
Einiges fällt auf. Erstens ist der Sprung bei Terminal-Bench von 10,3 % auf 70,6 % enorm, und dort schlägt Sonnet 5.5 sogar Opus 5.5. Bei GDPval-AA, einem Test für reale Arbeit in 44 Berufen, liegt es zwei Elo-Punkte hinter Opus 5.5 und rund 400 vor Sonnet 5. Gegenüber GPT-6 Sol, dem Konkurrenten, den Anthropic für den Vergleich gewählt hat, liegt Sonnet 5.5 auf der besten Effort-Stufe in jeder Zeile vorn, für die das OpenAI-Modell einen Wert hat, und bei High Effort erreicht es GPT-6 Sols bestes FrontierCode-Ergebnis für etwa ein Fünftel der Kosten pro Aufgabe.
Ich schätze, dass Anthropic bei der Grenze offen ist. Der Launch-Beitrag sagt: "in our own testing, and in that of external testers, Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment". Benchmarks belohnen tendenziell Aufgaben mit einer klar richtigen Antwort. Offene Entscheidungen, etwa ob ein verärgerter Enterprise-Kunde eine Rückerstattung, eine Entschuldigung oder vielleicht eine Eskalation braucht, sind genau dort, wo sich der Mehrpreis von Opus weiterhin lohnt. Der Vergleich Opus 5.5 vs. GPT-6 Sol geht auf diese Spitzenklasse ausführlicher ein.
Noch eine Fußnote, die sich zu lesen lohnt: Die FrontierCode-Werte sinken bei Max Effort (46.2%) gegenüber Xhigh (52.1%). Anthropic erklärt das damit, dass Sonnet 5.5 bei Max das Code-Review häufiger auf Subagents aufteilte, was zu Timeouts oder Änderungen über den Aufgabenumfang hinaus führte. Mehr Denken ist nicht immer besser, ein Muster, das auch der Opus-5-Effort-Leitfaden beobachtet hat.
Was Sonnet 5.5 für Support-Teams bedeutet
Wenn ich einer Support-Leitung nur ein Zitat aus dem Launch-Beitrag vorlegen dürfte, wäre es dieses. Zendesks Director of AI hat das Modell an echten Tickets getestet:
"We fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions and resolved tickets faster than the Claude models we use in production today. Tickets were processed 20% faster, getting our customers the help they need without the wait."
Abhinay Kathuria, Director of AI bei Zendesk, in Anthropics Ankündigung
"Fewer wrong decisions" ist hier der entscheidende Teil. Geschwindigkeit ist schön, aber in einer Support-Warteschlange kostet eine schnelle falsche Antwort mehr als eine langsame richtige: Sie erzeugt ein zweites Ticket und eine verärgerte Nachfrage, manchmal noch eine Rückerstattung obendrauf. Zendesk AI nutzt Claude-Modelle bereits in der Produktion. Wenn es also behauptet, bessere Eskalationsentscheidungen als mit dem eigenen aktuellen Setup zu treffen, hat das echtes Gewicht. Atlassian machte einen verwandten Punkt zur Skalierung und sagte, Teams würden ihre Rovo-Agents "up to 30% faster than they could with Sonnet 5" betreiben, und Slack AI testet es bereits für Slackbot.
Von der Warteschlange aus betrachtet, würde ich die Claude-Reihe so den Support-Aufgaben zuordnen:
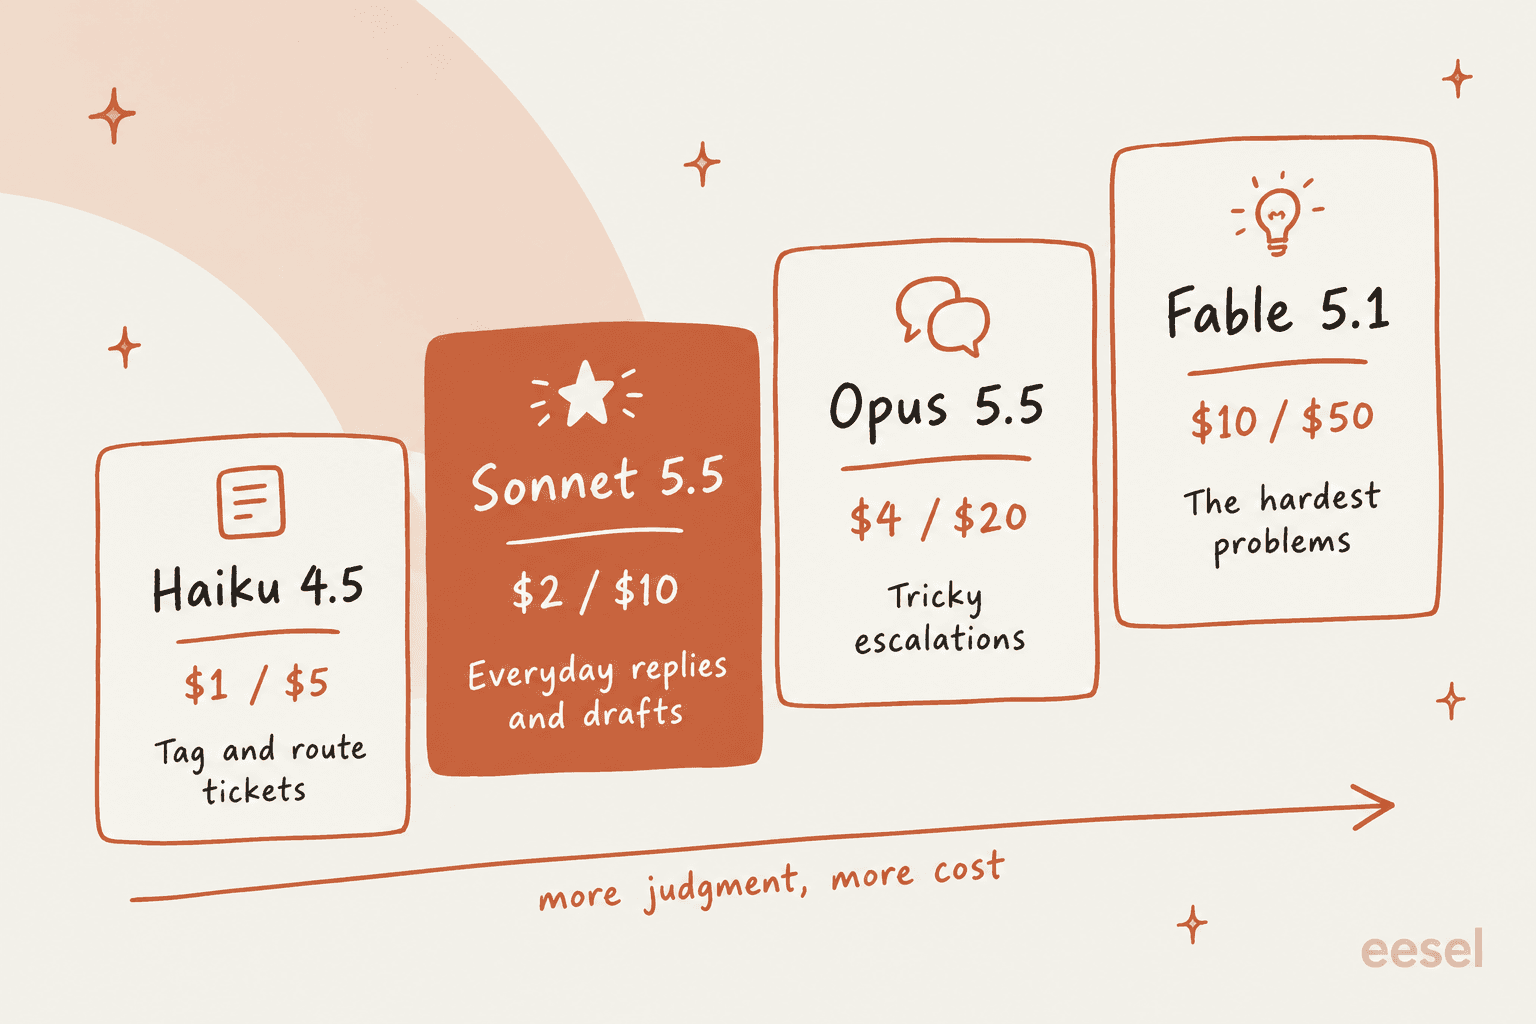
Sonnet 5.5 ist der naheliegende Standard für den Großteil einer Warteschlange: Bestellfragen, How-to-Antworten, Richtlinienabfragen und erste Entwürfe, die ein Mitarbeiter freigibt. Haiku bleibt die günstige Wahl für Ticket-Triage und Tagging. Opus 5.5 würde ich für Tickets einsetzen, die Urteilsvermögen brauchen, also die, die Ihre erfahrenen Mitarbeiter ohnehin übernehmen würden. Der Geschwindigkeitsgewinn von 30 %+ zählt am meisten im Live-Chat, weil dort ein Kunde sitzt und auf die Tippanzeige schaut.
Die ehrliche Einschränkung: Ein besseres Modell behebt keine fehlende Antwort. Ich habe erlebt, wie ein Support-Bot einem Kunden selbstsicher sagte, ein Produkt werde unterstützt, weil das Help Center "we support all models" sagte, und ich habe einen anderen gesehen, der Antworten erfand, wenn die Suche nichts zurückgab. Beides waren keine Modellqualitätsprobleme. Beides waren Grounding-Probleme, und ein klügeres Modell kann eine selbstsichere falsche Antwort sogar überzeugender klingen lassen. Deshalb simuliert eesel jeden Rollout an historischen Tickets, bevor eine KI irgendjemandem antwortet, egal welches Modell darunter läuft.
Vor der Migration: fünf Dinge, die jetzt Fehler liefern
Die meiste Launch-Berichterstattung überspringt diesen Abschnitt, und er ist der, der Ihnen tatsächlich den Nachmittag kostet. claude-sonnet-5 in claude-sonnet-5-5 zu ändern, ist eine Zeile. Dahinter listet die What's-new-Seite fünf Breaking Changes auf, und eine weitere Regel gehört auf dieselbe Checkliste.
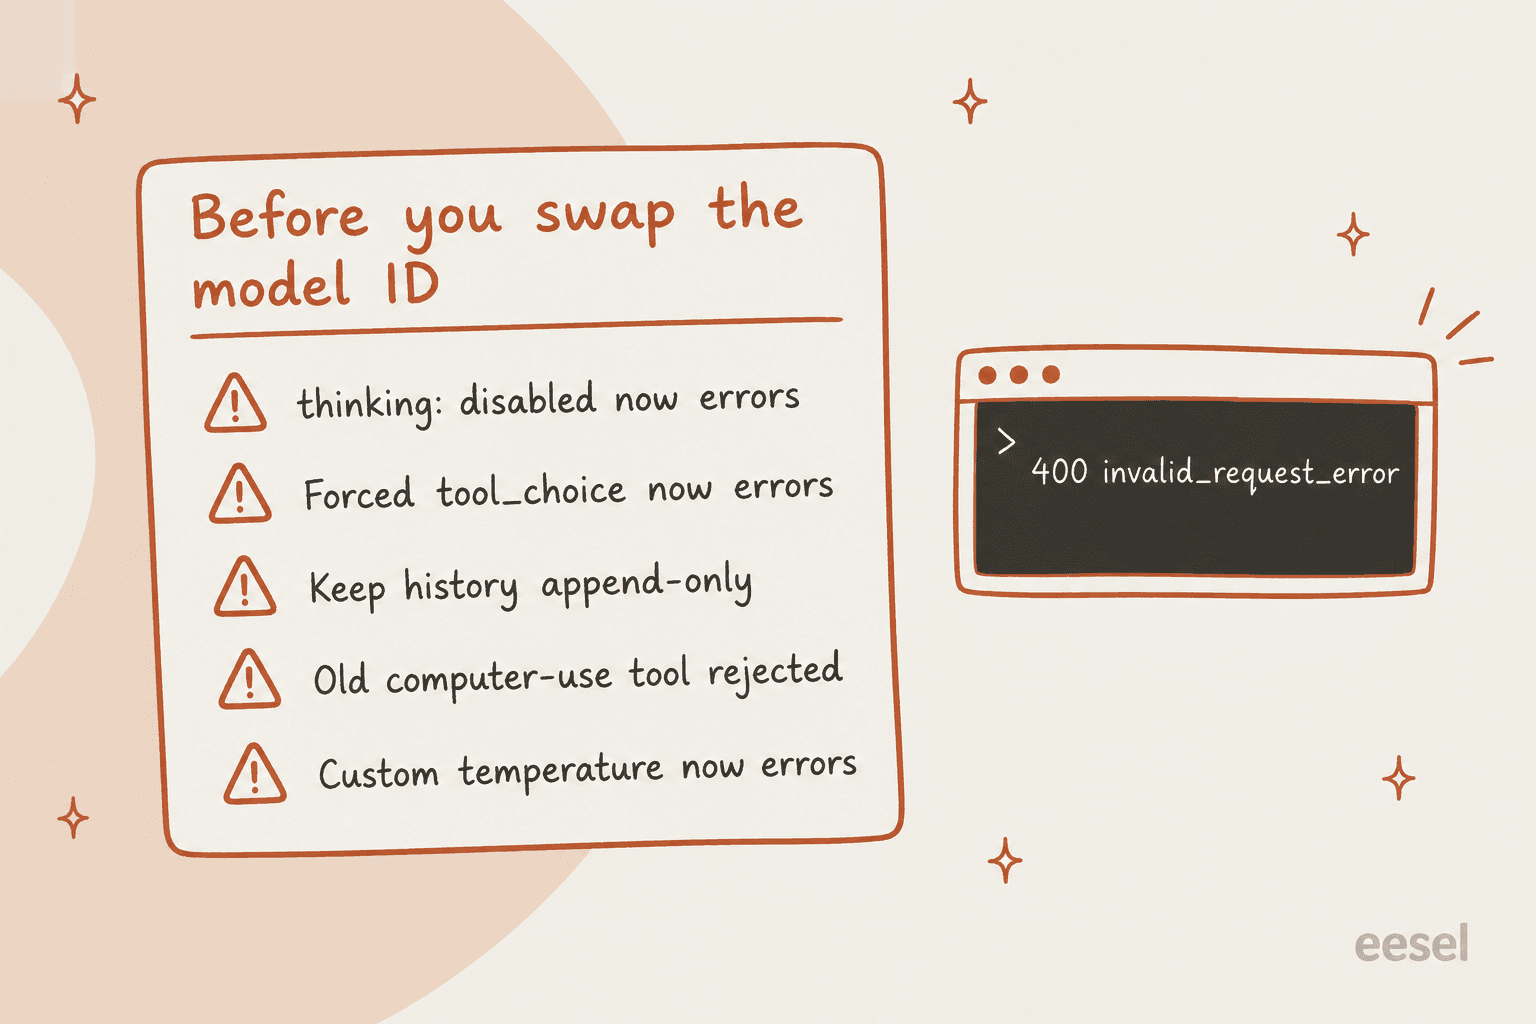
thinking: disabledliefert einen 400. Senden Sie stattdessenthinking: {"type": "between_tools"}, was das Thinking vorab abschaltet. Das funktioniert nur beihighEffort oder darunter; beixhighodermaxgibt es ebenfalls einen Fehler.- Erzwungene Tool-Nutzung entfällt.
tool_choicemitanyoder einem benanntentoolliefert einen Fehler. Die Lösung istautoplus Strict Tool Use. - Thinking-Blöcke sind an Modell und Konto gebunden. Wenn Sie frühere Nachrichten, den System-Prompt oder die Tools bearbeiten und dann einen Sonnet-5.5-Thinking-Block erneut abspielen, erhalten neuere Konten einen 400. Halten Sie Konversationen also append-only.
- Das alte Tool
computer_20251124wird abgelehnt in der Claude API und auf Google Cloud. Bedrock akzeptiert es weiterhin. - Einige Advisor-Kombinationen werden abgelehnt. Opus 4.8, Opus 4.7 und Sonnet 5 können einen Sonnet-5.5-Executor nicht mehr beraten.
Zu der zusätzlichen Regel: Laut Doku liefert das Setzen von temperature, top_p oder top_k auf einen nicht standardmäßigen Wert bei diesem Modell einen 400.
Die Support-Falle ist Nummer zwei. Viele Helpdesk-Bots erzwingen einen Tool-Aufruf, um strukturierte Ausgabe zu garantieren: "always call classify_ticket", "always call draft_reply". Bei Sonnet 5.5 schlägt diese Anfrage einfach fehl. Wenn Sie Ihre eigene Integration auf der Anthropic API gebaut haben, suchen Sie zuerst per grep nach tool_choice, bevor Sie die Modell-ID anfassen.
Es gibt auch eine leisere Änderung, die keinen Fehler auslöst, Nutzer aber trotzdem verwirren wird. Text, den das Modell zwischen Tool-Aufrufen schreibt, kommt jetzt in thinking-Blöcken zurück, und bei der Standardeinstellung display: "omitted" ist dieser Text leer. Wenn Ihr Chat-Widget "Checking your order status..." streamt, während der Agent arbeitet, wird es stumm, bis Sie einen display-Wert setzen. Anthropic hat außerdem die Effort-Stufen neu kalibriert, testen Sie Ihre Effort-Einstellungen also neu, statt die von Sonnet 5 zu übernehmen. Der Leitfaden zur KI-Agent-Übergabe lohnt sich, falls ein Modellwechsel verändert, wann Ihr Bot eskaliert.
Zuletzt die Sicherheit. Sonnet 5.5 ist das erste Sonnet, das mit Cyber-Schutzmaßnahmen startet, weil seine Cyber-Fähigkeiten mit Opus 5 vergleichbar sind. Anfragen mit höherem Cybersicherheitsrisiko "visibly fall back to Sonnet 5", und eine abgelehnte Anfrage liefert HTTP 200 mit stop_reason: "refusal". Für einen Support-Bot wird das selten auftreten. Wenn Sie aber Sicherheits- oder IT-Kunden bedienen, sollten Sie den Refusal-Fall behandeln, statt eine leere Antwort anzuzeigen.
Claude Sonnet 5.5: Preise und Zugang
Das ist die vollständige Preisliste aus Anthropics Preisdokumentation, pro Million Tokens:
| Preis pro 1M Tokens | Claude Sonnet 5.5 | Claude Sonnet 5 | Claude Opus 5.5 | Claude Haiku 4.5 |
|---|---|---|---|---|
| Input | $2 | $2 | $4 | $1 |
| Output | $10 | $10 | $20 | $5 |
| Cache-Schreiben, 5 Minuten | $2.50 | $2.50 | $5 | $1.25 |
| Cache-Schreiben, 1 Stunde | $4 | $4 | $8 | $2 |
| Cache-Lesen | $0.20 | $0.20 | $0.20 | $0.10 |
| Batch Input / Output | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Kontextfenster | 1M | 1M | 1M | 200K |
Ein paar Anmerkungen zur Tabelle. Thinking wird als Output-Tokens abgerechnet, ein Lauf mit high Effort zahlt also auch für sein Reasoning 10 $ pro Million. Und der minimal cachebare Prompt liegt laut Modellübersicht jetzt bei 512 Tokens, was es einfacher macht, einen stabilen Support-System-Prompt zu cachen.
Um diese Preise in Support-Begriffen darzustellen, hier eine Beispielrechnung, die nur veröffentlichte Preise verwendet. Angenommen, eine Ticket-Antwort sendet 6.000 Input-Tokens (das Ticket plus abgerufene Hilfeartikel) und erhält 800 Output-Tokens zurück. Das sind 0,012 $ für Input und 0,008 $ für Output, also etwa 2 Cent pro Ticket. Wenn 5.000 dieser Input-Tokens ein gecachter System-Prompt sind, sinkt die Input-Seite auf etwa 0,003 $, und die ganze Antwort liegt bei rund 1,1 Cent. Bei 10.000 Tickets im Monat sind das etwa 200 $ ohne Cache gegenüber 110 $ mit Cache, vor Thinking-Tokens. Ihre eigenen Zahlen hängen von Effort und Retrieval-Größe ab, aber es zeigt, warum die Modellzeile auf der Rechnung selten der große Kostenpunkt bei einem KI-Support-Agenten ist.
Hier können Sie es nutzen:
- Die Claude API, als
claude-sonnet-5-5, mit Prompt Caching und der Batch API. Zero Data Retention ist verfügbar. - Claude-Apps. Anthropic sagt "anyone can chat with Claude using Sonnet 5.5 on Claude.ai" im Web, auf iOS und Android. Die kostenpflichtigen Tarife behandelt der Leitfaden zu Claude-Pro-Preisen.
- Claude Code, wo der Standard-Effort Medium ist. Der Leitfaden zu Claude-Code-Preisen behandelt die Rechnung Abo gegen API, und ein Modell festzulegen braucht eine Einstellung.
- Die Clouds: Amazon Bedrock, Google Cloud, Microsoft Foundry und Claude Platform on AWS, alle am ersten Tag.
Wenn Sie eher Anbieter als Stufen abwägen, sind der Dreifachvergleich der APIs und die Aufschlüsselung der GPT-6-Sol-Preise die schnellsten Plausibilitätschecks.
Was Entwickler sagen
Der Launch-Thread auf Hacker News knackte an einem Tag 550 Kommentare, und die Reaktion teilt sich ziemlich sauber. Die Leute mögen die Geschwindigkeit und respektieren die Benchmarks, während sich die Kritik vor allem darum dreht, wo es neben Opus 5.5 einzuordnen ist.
"Playing around with it for a few minutes, Sonnet 5.5 feels very fast, much quicker than Opus 5.5. Can't tell yet if it's a lot worse but the speed is definitely welcome."

Die schärfste Kritik betrifft die hohen Effort-Stufen. Simon Willison maß seinen üblichen SVG-Test auf jeder Effort-Stufe und fand bei low 1,6 Cent, bei medium 1,8 Cent und bei high 2,3 Cent, aber max verbrannte sein gesamtes Thinking-Budget:
"Sonnet 5.5 has the same problem as Opus 5.5: on "max" thinking effort it burned through 128,000 thinking tokens (taking 15 minutes to do that) and ran out before it had produced the final SVG."
Ein Reddit-Nutzer zog dasselbe Muster aus Artificial Analysis und berichtete, "sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98", wobei Sonnet 193k Tokens pro Aufgabe nutzte gegenüber 119k bei Opus (u/ex-procrastinator, Reddit). Ein anderer Kommentator fasste zusammen, was die Diagramme nahelegen:
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost."
Anthropic sagt im eigenen Launch-Beitrag Ähnliches: Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings", und "at higher settings, it can perform comparably at a similar cost". Die praktische Erkenntnis, und das, was ich jedem Team sagen würde, das wechselt, ist also: Nutzen Sie Sonnet 5.5 bei Low oder Medium Effort, dort liegen die Einsparungen tatsächlich. Die API nutzt standardmäßig high, die günstige Version dieses Modells ist also eine, die Sie ausdrücklich anfordern müssen. Support-Antworten sind genau die Art klar umrissener Arbeit, die Medium gut bewältigt.
Eine Regression ist erwähnenswert. Ein Entwickler, der einen Adversarial-Benchmark betreibt, fand, dass Sonnet 5.5 schlechter abschnitt als Sonnet 5, "mainly because it is more reluctant to keep going to get an answer, instead it returns to ask the user questions" (dom96, Hacker News). Für einen Coding-Agent ist das lästig, aber für einen Support-Bot ist es oft genau das, was man will, nachzufragen statt zu raten.
Ein schnelleres Modell braucht trotzdem ein Teammitglied drumherum
Jeder Modell-Launch löst bei technischen Kunden dasselbe Gespräch aus: Das ist jetzt günstig und gut genug, warum also nicht auf der rohen API einen eigenen Support-Bot bauen? Das ist eine berechtigte Frage, und Sonnet 5.5 macht die Modellhälfte davon einfacher als je zuvor.
Was die Preisliste weglässt, ist alles rund um das Modell. Sonnet 5.5 ist eine hervorragende Engine. Es ist kein Support-Agent, bis jemand das Retrieval über Ihr Help Center und Ihre bisherigen Tickets baut, dazu die Eskalationsregeln und die Behandlung von Refusals, das Effort-Tuning und jetzt auch die Migrationsarbeit für fünf Breaking Changes. Das Modell ist die Infrastruktur, und der Mitarbeiter ist das, was Sie darauf aufbauen.
eesel verkauft genau diesen Teil fertig gebaut. Das KI-Helpdesk-Teammitglied kommt in Ihre bestehende Warteschlange in Zendesk, Freshdesk, Gorgias und mehr. Es lernt aus Ihren bisherigen Tickets und Ihrem Help Center und entwirft oder sendet dann Antworten, mit einem Frontier-Modell darunter. Wenn Anthropic ein Modell wie dieses veröffentlicht, sind der Wechsel und die Breaking Changes das Problem von eesel, nicht Ihres.

Wenn Sie programmatische Kontrolle wollen: eesel hat ein CLI, das dasselbe Teammitglied und denselben Workspace bedient wie das Dashboard. Sie können es aus einem Terminal steuern oder skripten, und Sie können auch einen Coding-Agent wie Claude Code damit arbeiten lassen. So bekommen Sie den agentischen Workflow, den Leute auf rohen Modellen bauen, ohne den Grounding- und Retry-Stack selbst zu besitzen. Meine Beiträge zum KI-Agent-CLI und zu MCP-Servern zeigen, wie das zusammenpasst.
Die Preise basieren auf festen monatlichen Credits: Ein bearbeitetes Ticket oder ein Chat ist ein Credit, der kostenlose Tarif enthält 100 Credits ohne Karte, und bezahlte Tarife beginnen bei 299 $ für 500. Sie können das Teammitglied an Ihren eigenen historischen Tickets simulieren, bevor es einem einzigen Kunden antwortet. Testen Sie eesel kostenlos in Ihrer Zendesk-Warteschlange und erleben Sie den Sonnet-Geschwindigkeitsgewinn an Tickets, deren Antworten Sie bereits kennen.
Lohnt sich Claude Sonnet 5.5?
Wenn Sie heute Sonnet 5 nutzen, ja, und es ist eines der einfacheren Upgrades, die Anthropic geliefert hat. Sie zahlen denselben Preis für ein Modell, das deutlich besser abschneidet und mit weniger Tokens fertig wird, und es läuft auch schneller. Der einzige echte Aufwand ist die Migration, und das ist eine bekannte Liste mit fünf Punkten, kein Rätsel.
Wenn Sie Opus 5.5 für Alltagsaufgaben nutzen, testen Sie Sonnet 5.5 an Ihrem eigenen Traffic bei Medium Effort, bevor Sie diese Gewohnheit erneuern. Bei klar umrissenen Aufgaben beträgt der Benchmark-Abstand ein paar Punkte und der Preisunterschied pro Token das Doppelte. Oberhalb von high Effort verschwindet dieser Vorteil. Wenn eine Aufgabe also maximales Reasoning braucht, schicken Sie sie an Opus. Behalten Sie Opus für die offenen Urteilsentscheidungen, bei denen Anthropic selbst sagt, dass es weiterhin deutlich stärker ist. Ein Hacker-News-Kommentator beschrieb ein Muster, "80% Sonnet 5.5, Opus 5.5 to finish the last 20%", und es ist auch eine sinnvolle Art, eine Warteschlange aufzuteilen. Für das weitere Feld sind mein Sonnet-5-Review und der Überblick über Opus-5.5-Alternativen die nächsten Lesetipps.
Häufig gestellte Fragen
Was ist Claude Sonnet 5.5?
Was kostet Claude Sonnet 5.5?
Ist Claude Sonnet 5.5 günstiger als Sonnet 5?
Ist Claude Sonnet 5.5 besser als Opus 5.5?
Eignet sich Claude Sonnet 5.5 für den Kundensupport?
Was geht kaputt, wenn ich von Sonnet 5 auf Sonnet 5.5 wechsle?
Kann ich Claude Sonnet 5.5 in Claude Code nutzen?
Was sind die besten Alternativen zu Claude Sonnet 5.5?

Article by
Riellvriany Indriawan
Riell is a designer and writer at eesel AI with about two years of experience researching CX platforms, AI chatbots, and helpdesk software. She combines her design background with a sharp eye for how these tools actually look and feel in practice — making her comparisons unusually visual and user-focused.