Mein Fazit auf einen Blick
Am Tag nach dem Launch habe ich Anthropics Ankündigung und die Modelldokumentation gelesen, dann den Migrationsleitfaden und außerdem den Hacker-News-Launch-Thread mit rund 550 Kommentaren. Meine Aufgabe ist der Bau von KI-Agenten für den Helpdesk-Kollegen von eesel, also bin ich mit einer Frage an alles herangegangen: Würde ich dieses Modell morgen unter eine echte Support-Queue setzen?
Hier die Kurzfassung, bewertet nach dem, was zählt, sobald man live geht:
| Was ich geprüft habe | Note | Warum |
|---|---|---|
| Code-Qualität | 9/10 | 70,6 % bei Terminal-Bench 4.0, über Opus 5.5 |
| Wissensarbeit | 8/10 | GDPval-AA 1844, zwei Punkte hinter Opus 5.5 mit 1846 |
| Token-Effizienz | 9/10 bei Low/Medium, 4/10 bei Max | ~121k vs. 497k Tokens pro Antwort bei Balyasny, aber 193k pro Aufgabe bei Max |
| Tempo | 8/10 | 30 %+ schnellere Ausgabe als Sonnet 5 |
| Migrationsaufwand | 5/10 | Fünf Breaking Changes, einer davon heikel für Support-Bots |
| Eignung für Support | 8/10 | Zendesk sah 20 % schneller bearbeitete Tickets |
| Gesamt | 8/10 | Bestes Preis-Leistungs-Verhältnis im Lineup, mit einer teuren Einstellung, die man meiden sollte |
Kurz zur Methode, damit klar ist, worauf diese Noten beruhen. Ich habe keinen monatelangen Produktivtest gemacht, da das Modell erst einen Tag alt ist. Die Noten stützen sich auf Anthropics veröffentlichte Zahlen und die namentlich genannten Kundenergebnisse im Launch-Beitrag, dazu unabhängige Benchmark-Läufe, die andere öffentlich gepostet haben, und meine eigene Lesart der API-Dokumentation im Vergleich dazu, wie eesel Modelle in Ticket-Workflows einbindet. Wo eine Zahl von Anthropic stammt, sage ich das.
Was Claude Sonnet 5.5 ist
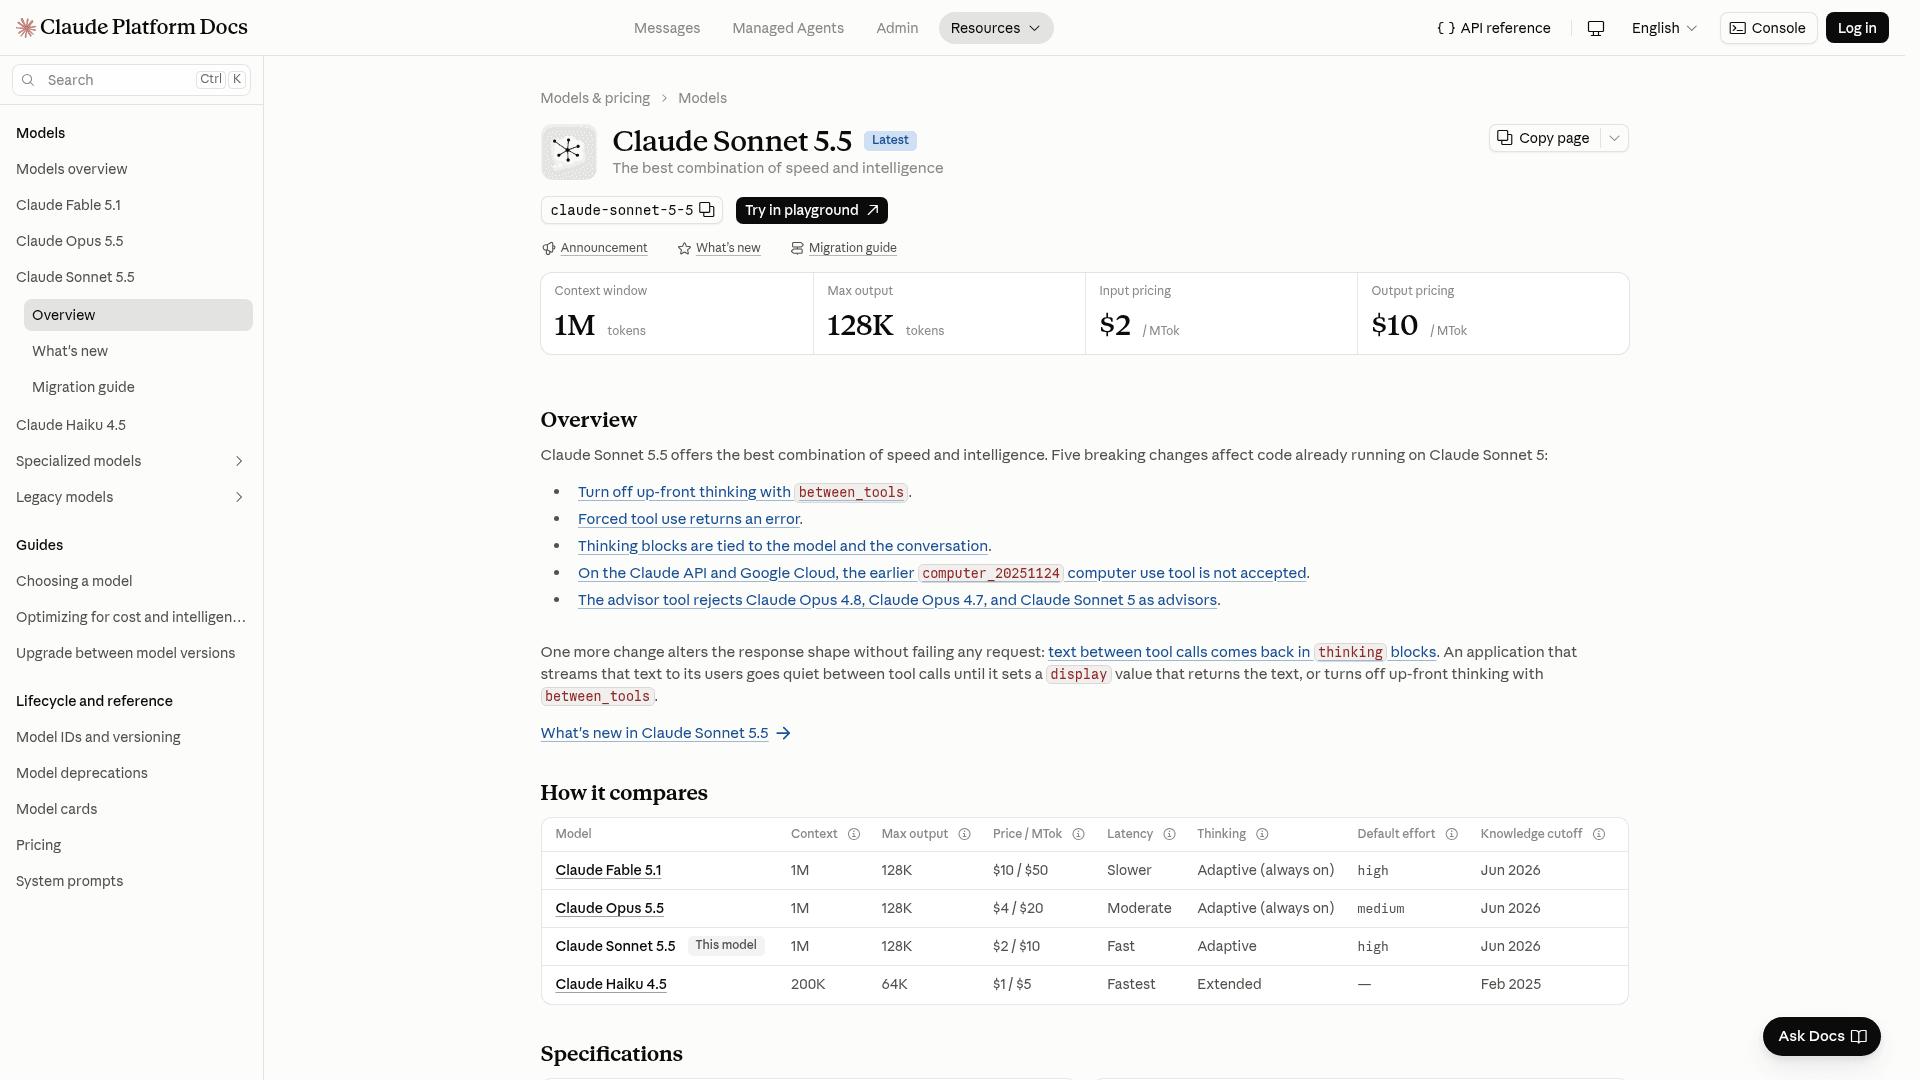
Claude Sonnet 5.5 ist das Mittelklasse-Modell in Anthropics Claude-5.5-Familie, veröffentlicht am 28. September 2026. Es sitzt unter Claude Opus 5.5 und über Haiku 4.5, während Claude Fable 5.1 die absolute Spitze des Angebots hält. Anthropic bezeichnet es als "a faster, lower-cost complement" zu Opus, am stärksten bei "well-scoped everyday tasks, fixing bugs, and creating polished documents, slides, and spreadsheets."
Zu den Specs: Die Modellübersicht nennt ein Kontextfenster von 1M Tokens und 128K maximale Ausgabe (300K bei Batch), Wissensstand Juni 2026 und denselben Tokenizer wie Claude Sonnet 5. Für den vollständigen Launch-Überblick ist die Sonnet-5.5-Übersicht meines Kollegen gut. Dieser Beitrag ist eher das Urteil.
Wo Claude Sonnet 5.5 stark ist
Drei Dinge stachen in den Launch-Daten heraus, und alle drei zeigen sich in namentlich genannten Kundenergebnissen, nicht nur in Anthropics eigenen Diagrammen.
Es programmiert wie ein Opus-Modell
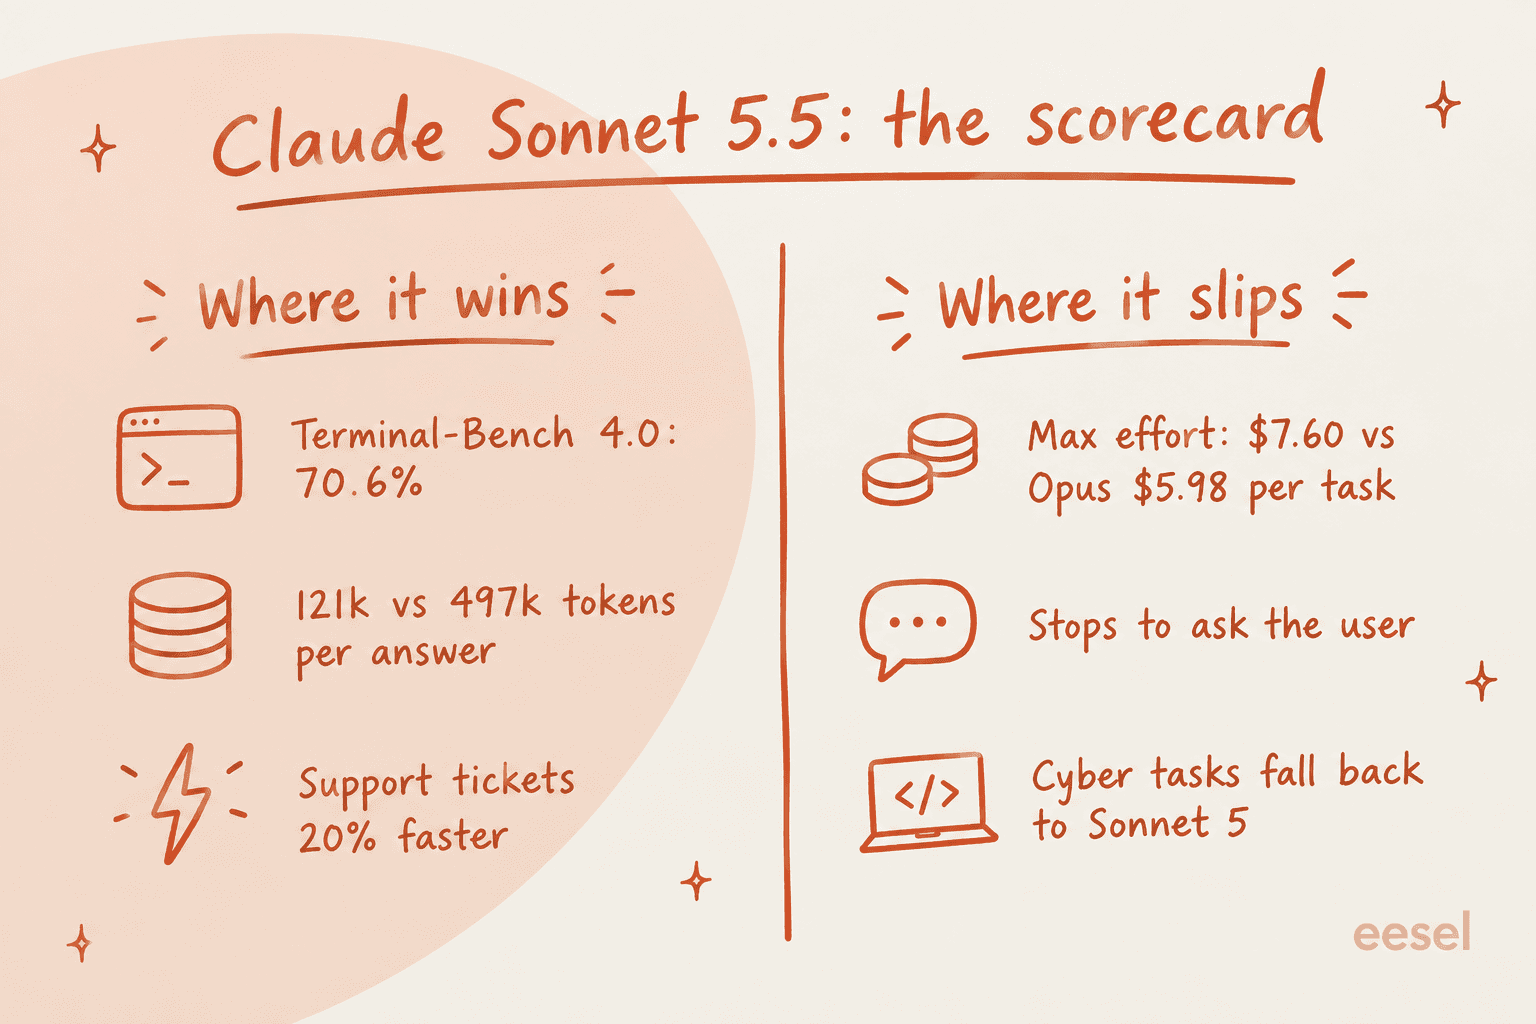
Die Schlagzeile ist Terminal-Bench 4.0, ein agentischer Coding-Test, der in der Kommandozeile läuft. Sonnet 5 erreichte dort 10,3 %, und Sonnet 5.5 erreicht 70,6 %, mehr als Opus 5.5 mit 66,4 %. Das ist kein Tippfehler. Es ist der größte Sprung von einer Generation zur nächsten, den ich bisher bei einem Sonnet-Modell gesehen habe.
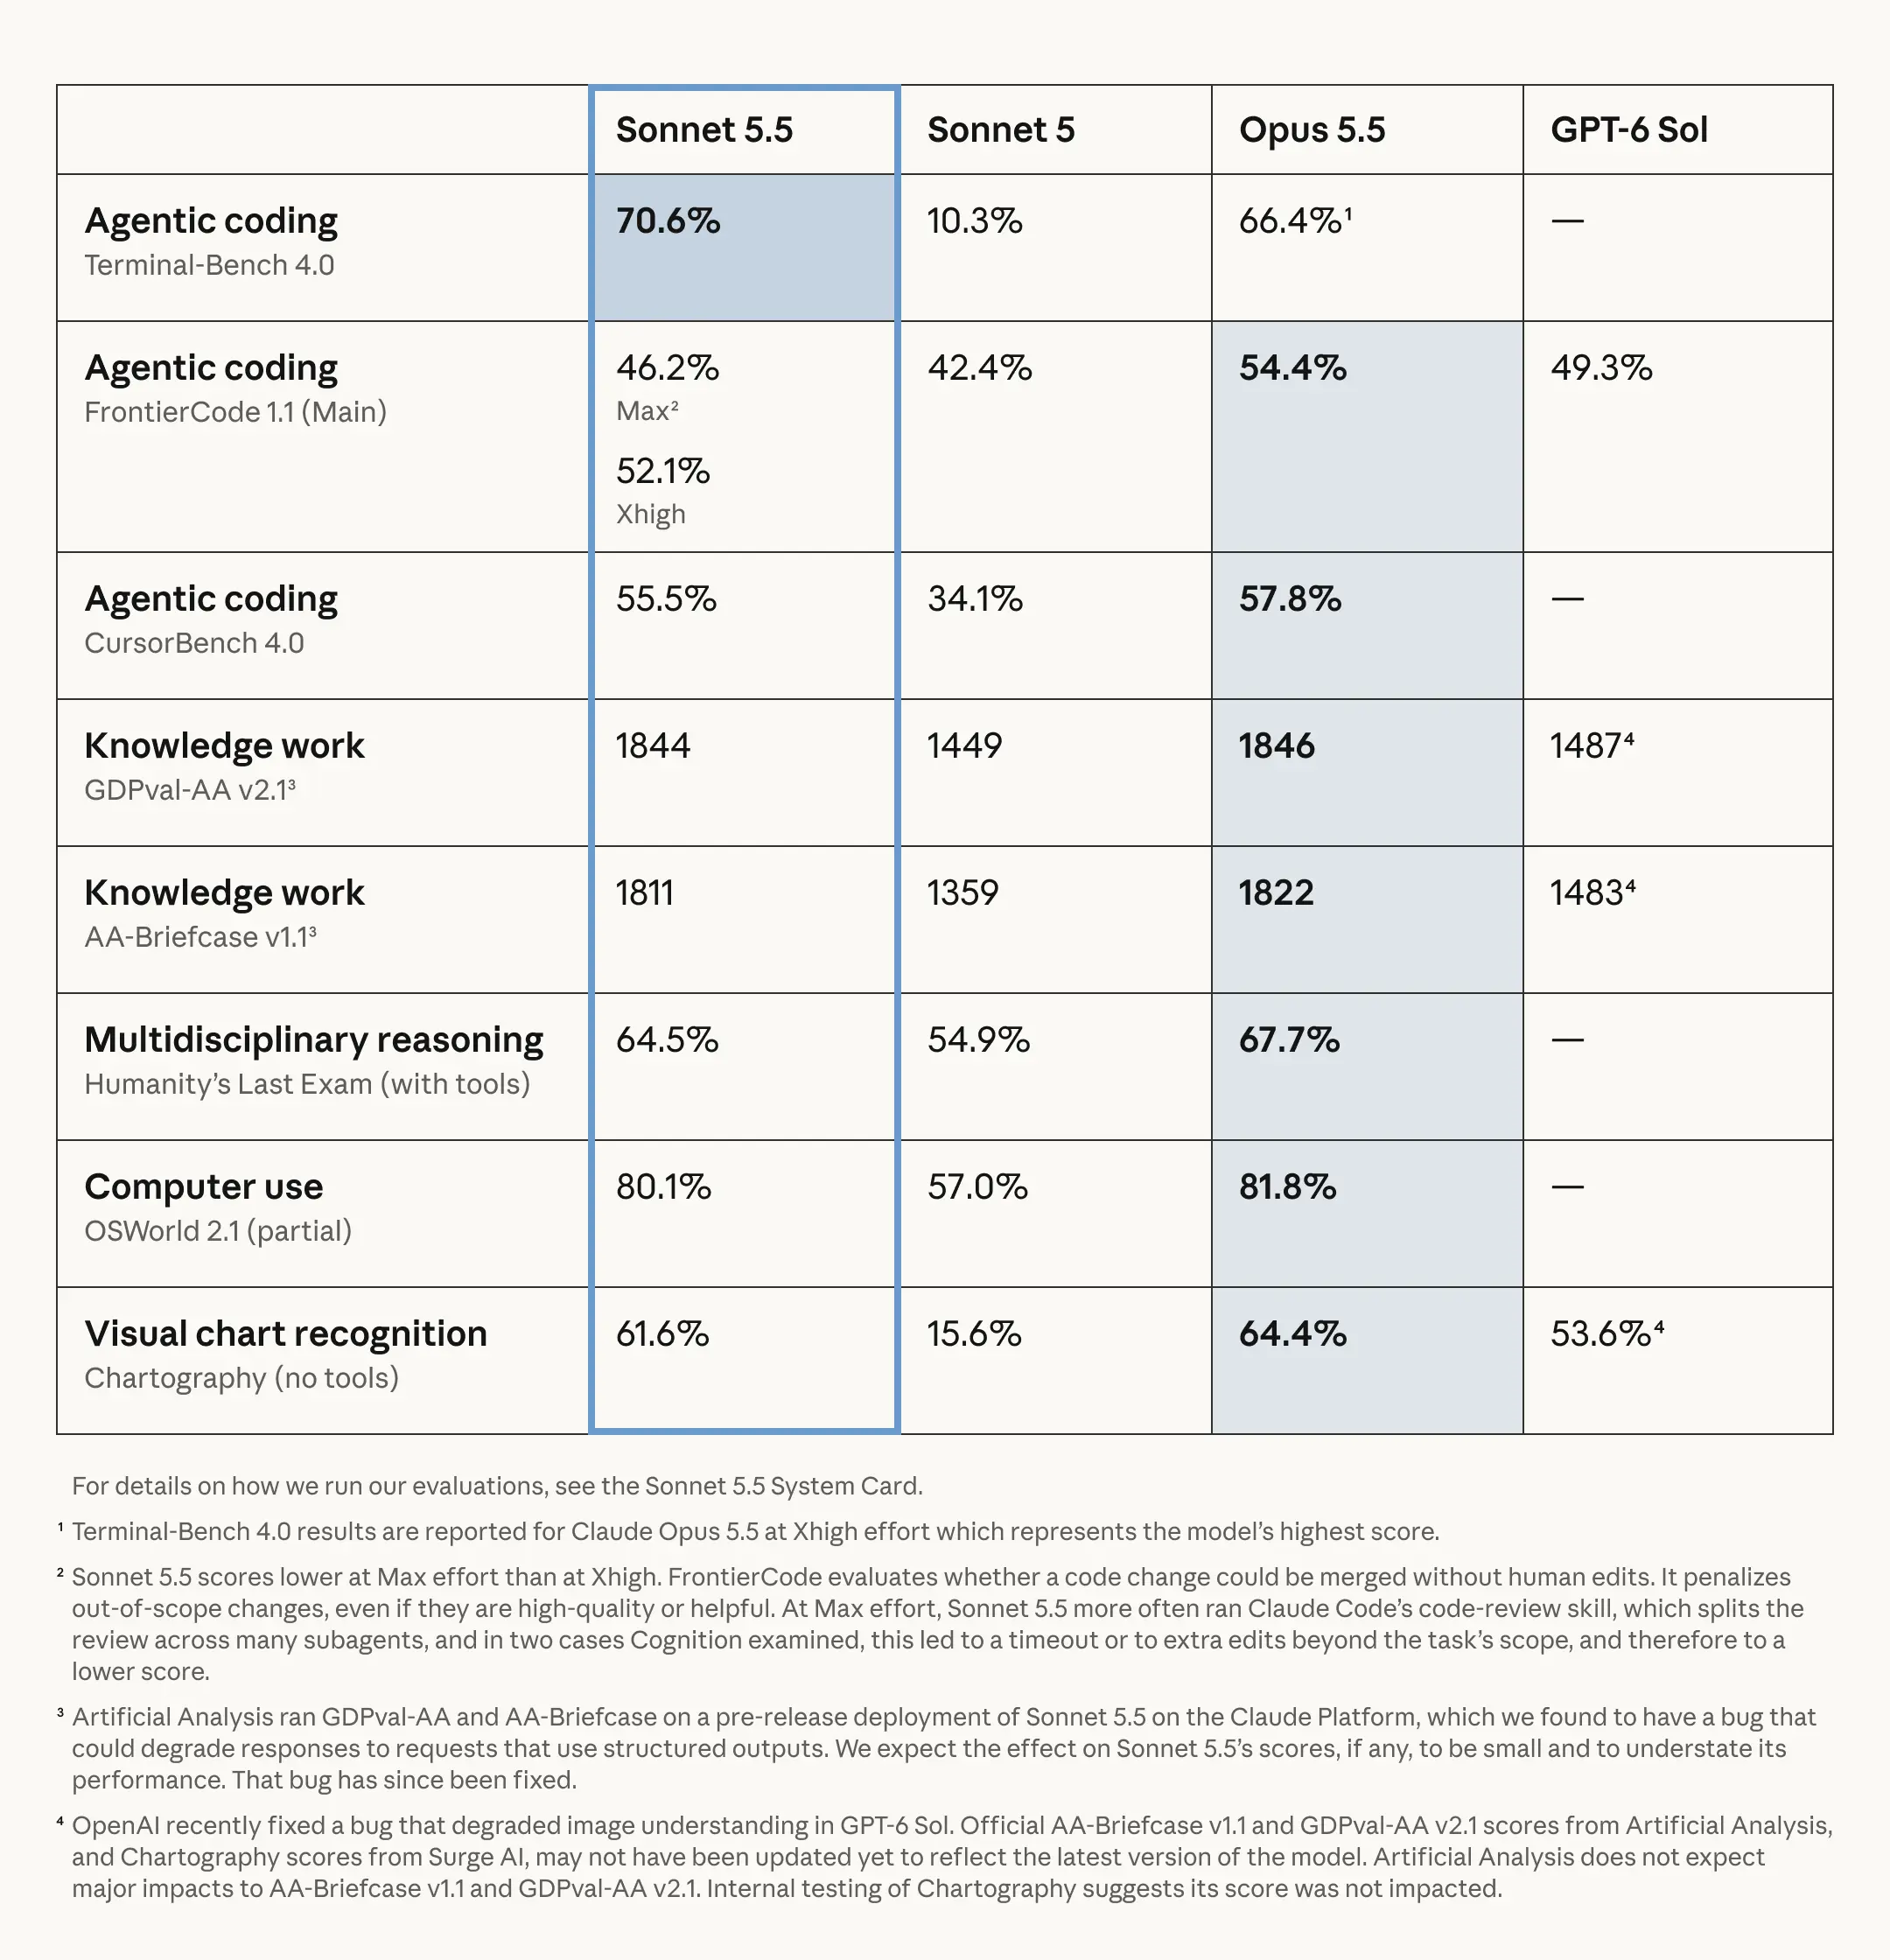
Bei den anderen Coding-Tests liegt es etwas hinter Opus: CursorBench 4.0 steht bei 55,5 % gegenüber 57,8 %, und FrontierCode bei 52,1 % (Xhigh) gegenüber 54,4 %. Bei einem Modell zum halben Token-Preis ist eine Lücke von zwei Punkten ehrlich gesagt ein Schnäppchen. Genau deshalb haben die Leute in der Debatte Opus vs. Sonnet größtenteils aufgehört, über Qualität zu streiten, und diskutieren nun über Kosten.
Auch die Kundenzahlen stützen das. Base44 sagte, dass Sonnet 5.5 über 118 echte App-Builds "produced apps that scored level with Opus 5" lieferte, und zwar in 3,6 Iterationen pro Build, wo Opus 5 7,7 brauchte. Unity gibt an, 90 % der Aufgaben in seinem mehrstufigen Editor-Benchmark gelöst zu haben. Und wenn Sie in Claude Code programmieren, ist dies jetzt das Modell, das Sie bei Medium standardmäßig sehen.
Es kommt mit deutlich weniger Tokens ans Ziel
Der Preis pro Token hat sich nicht geändert; geändert hat sich die Zahl der Tokens. Balyasny Asset Management führte 2.441 Finanzaufgaben aus und stellte fest, dass Sonnet 5.5 etwa 121k Tokens pro Antwort nutzte, wo Sonnet 5 497k brauchte. Bei seinen Slackbot-Evals sah Slack rund 14 % weniger Output-Tokens ohne Prompt-Änderungen, und Lovable meldete ein Drittel weniger Tool-Aufrufe.
Anthropics eigene Demo zeigt dasselbe. Bei einem Prompt "wind shaping sand dunes" schrieb Sonnet 5 noch Code, als Sonnet 5.5 bereits eine laufende Animation hatte:
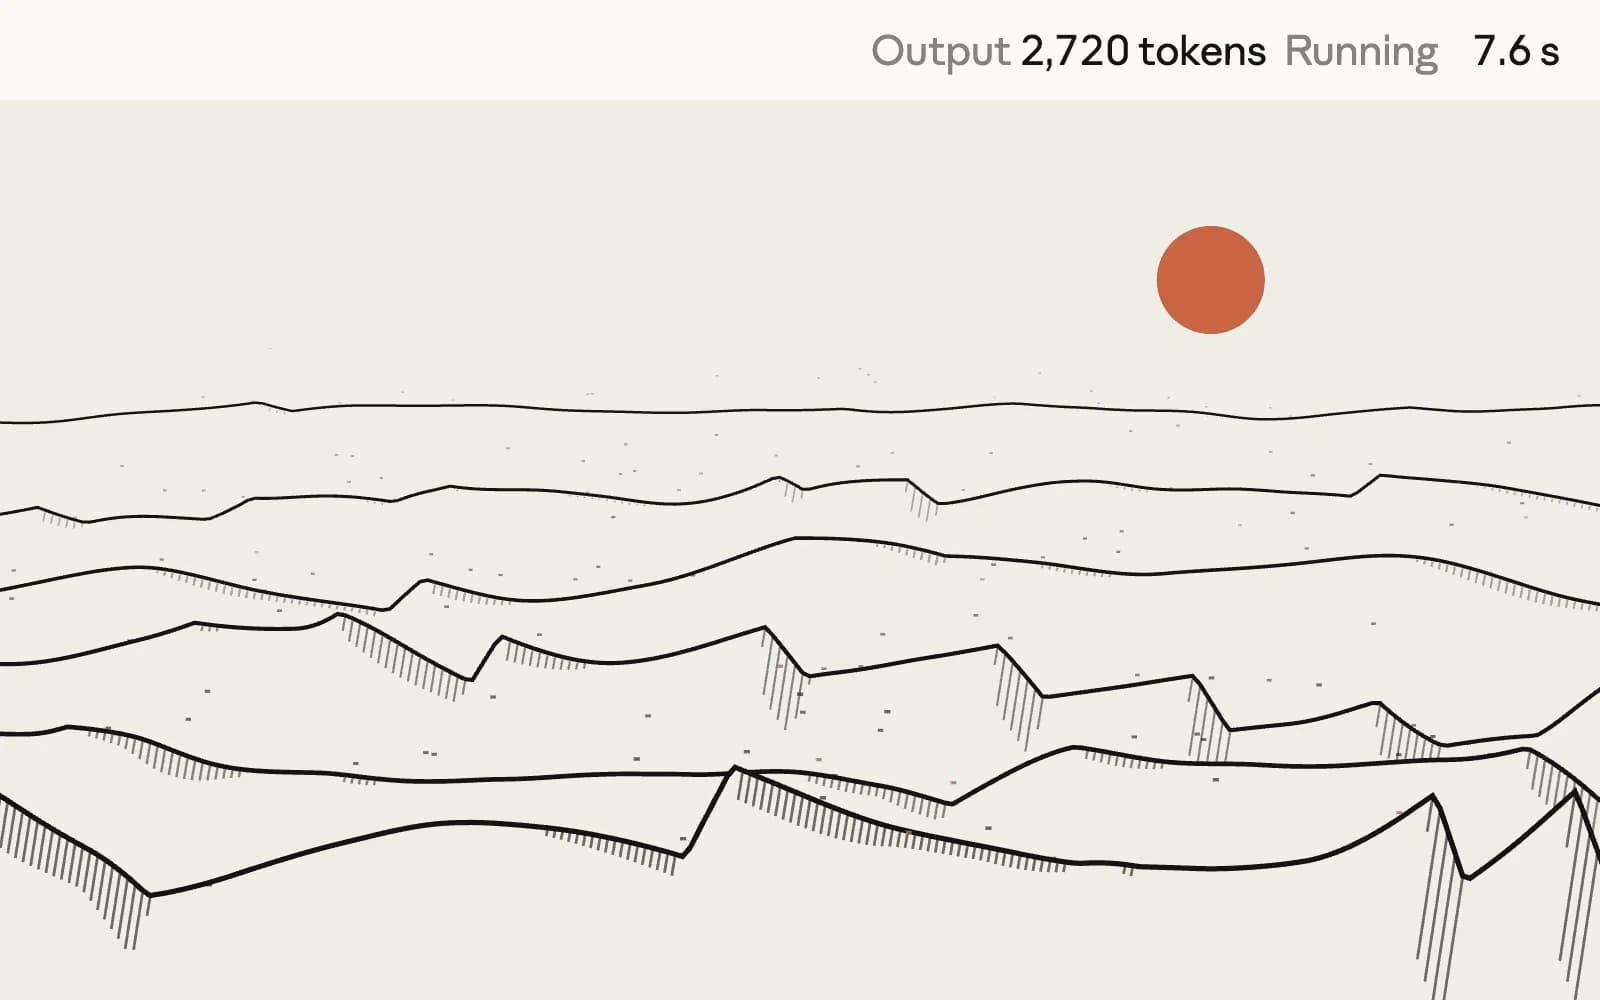
Diese Effizienz ist eigentlich das Produkt. Laut Anthropic ergibt sich "up to 30% less per task" gegenüber Sonnet 5. Bei den Teams, mit denen ich spreche, bedeuten weniger Tokens auch weniger Sekunden, die ein Kunde auf eine Antwort wartet, und das ist ihnen wichtiger als die Rechnung.
Es bewältigt Support-Tickets gut
Das ist der Teil, der mir am wichtigsten ist. Zendesks Director of AI sagte im Launch-Beitrag, sie hätten "fed Claude Sonnet 5.5 hundreds of real support use cases across replies and escalation requests. It made fewer wrong decisions," und Tickets wurden 20 % schneller bearbeitet. Auf Seiten von Atlassian sagt das Unternehmen, dass Rovo-Agents bis zu 30 % schneller laufen werden als mit Sonnet 5.
Für Arbeit im Stil von Zendesk AI sind diese beiden Zahlen die entscheidenden: weniger falsche Eskalationsentscheidungen und weniger Warten. Beide haben sich in die richtige Richtung bewegt.
Wo Claude Sonnet 5.5 schwächelt
Die Schwachstellen sind enger begrenzt, als Skeptiker behaupten, aber eine davon verändert, wie Sie das Modell betreiben sollten.
Max kostet mehr als Opus
Das ist der Befund, der mein Urteil verändert hat. Anthropics eigener Launch-Beitrag räumt ein, dass Sonnet 5.5 "complements Opus 5.5 best when running at lower effort settings" und dass es "at higher settings, it can perform comparably at a similar cost". Die unabhängigen Läufe gehen noch einen Schritt weiter.
Bei Artificial Analysis kostet, wie ein Redditor anmerkte, Sonnet 5.5 bei Max 7,60 $ pro Aufgabe gegenüber 5,98 $ für Opus 5.5 bei Max, weil es 193k Tokens pro Aufgabe nutzte, wo Opus 119k brauchte. Simon Willison ließ am Launch-Tag denselben SVG-Prompt auf jeder Effort-Stufe laufen. Low kostete 1,6 Cent und dauerte 10 Sekunden. Max kostete 1,28 $ und lief 15 Minuten 40 Sekunden, verbrannte seine vollen 128.000 Thinking-Tokens und scheiterte dann daran, das Bild zu erzeugen.
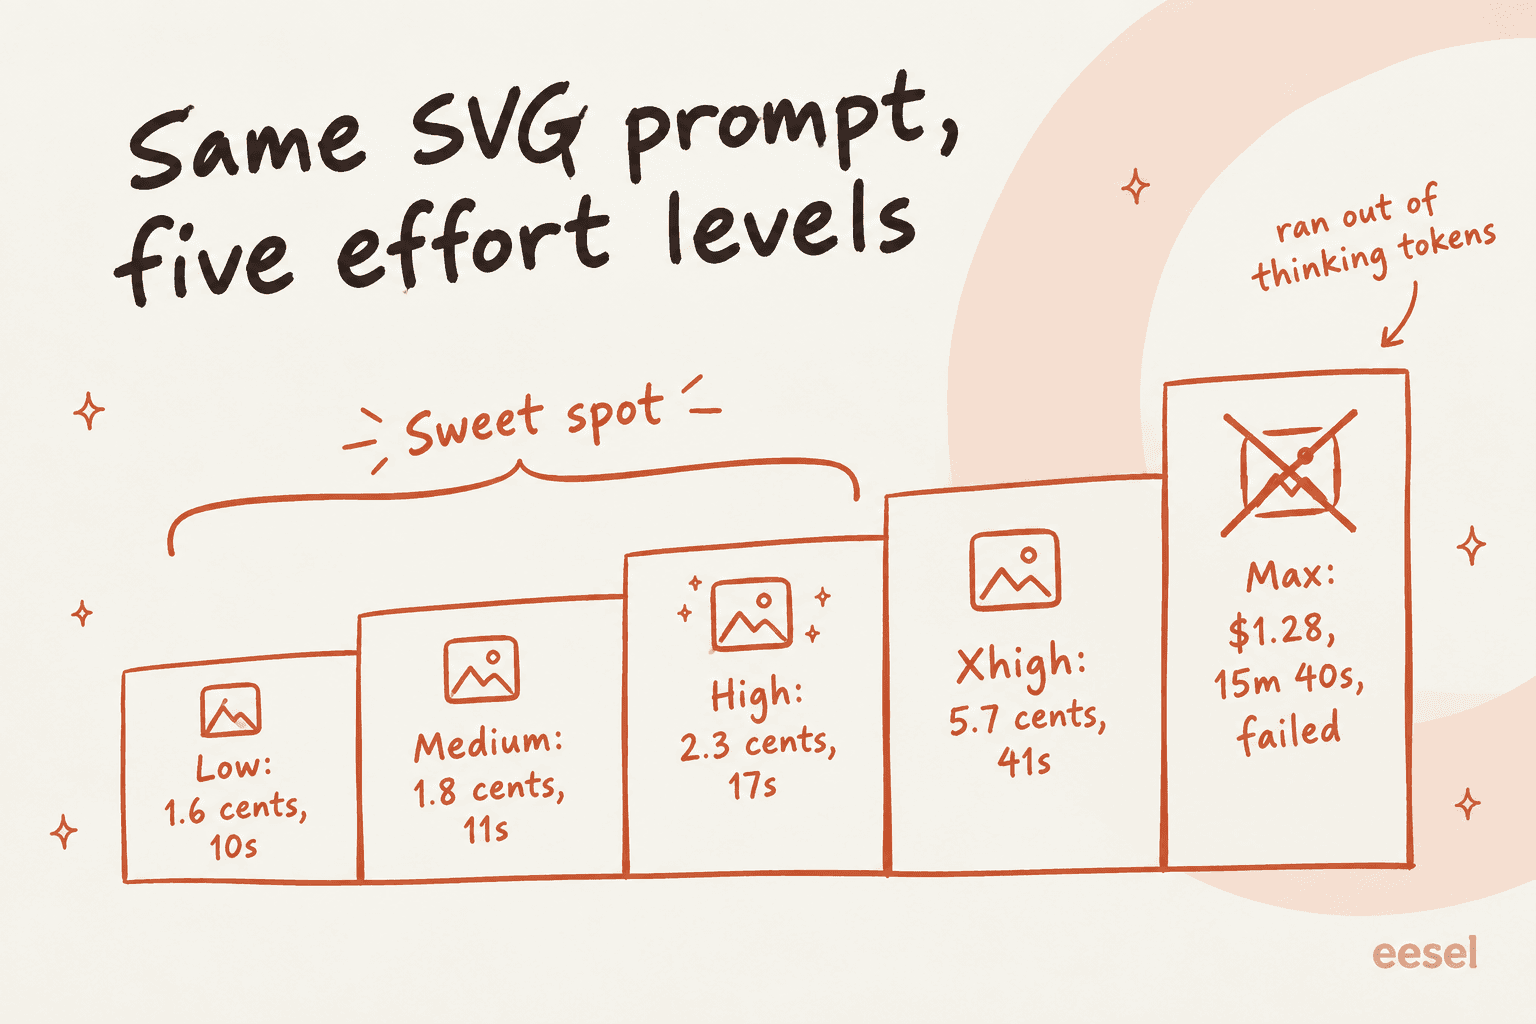
Selbst die FrontierCode-Fußnote von Anthropic hat dasselbe Muster. Sonnet 5.5 erreicht 52,1 % bei Xhigh, aber nur 46,2 % bei Max, weil es bei Max "more often ran Claude Code's code-review skill", was zu Timeouts oder Änderungen außerhalb des Aufgabenumfangs führte. Mehr Nachdenken machte das Ergebnis hier schlechter.
Die Regel ist also einfach: Behandeln Sie Max für Sonnet 5.5 als tabu. Eine Aufgabe, die so viel Reasoning braucht, gehört zu Opus 5.5, das mit weniger Tokens ans Ziel kommt.
Opus ist bei offenem Urteilsvermögen weiterhin besser
Anthropic ist hier ziemlich offen: "Opus 5.5 remains clearly stronger at complex, open-ended work requiring sustained judgment." Die ersten Praxisberichte stimmen zu.
"Tried Sonnet 5.5 but worse than OPUS for thinking for sure, less error/inconsistency check. I used Opus 5.5 med vs. Sonnet 5.5 High on hermes with the same agent.md, and soul.md"

Auf den Support übertragen ist das der verärgerte Enterprise-Kunde mit einem Abrechnungsstreit und drei früheren Tickets. Dieses Ticket würde ich Sonnet 5.5 nicht unbeaufsichtigt geben. Das Zurücksetzen eines Passworts, die Abfrage des Bestellstatus oder die Frage "Wie exportiere ich meine Daten" würde ich ihm dagegen den ganzen Tag überlassen.
Es hält an, um Fragen zu stellen
Ein Entwickler betreibt einen adversarialen Benchmark auf Basis einer esoterischen Programmiersprache. Dort erreichte Sonnet 5.5 7,4 % gegenüber 17,8 % bei Sonnet 5, und seine Erklärung war, es "is more reluctant to keep going to get an answer, instead it returns to ask the user questions whether to keep going." Base44 dagegen sagte, es "rarely stopped mid-build to ask the user a question."
Meine Einschätzung: In interaktiver Arbeit ist ein Innehalten zur Rückfrage oft ohnehin das, was man will. In einer unbeaufsichtigten Pipeline ist es anders: Ein Modell, das nachfragt, kann einen Job über Nacht blockieren. Testen Sie es also in Ihrer eigenen Agent-Schleife, bevor Sie ihm headless vertrauen.
Cyber-Safeguards und fünf Breaking Changes
Sonnet 5.5 ist das erste Sonnet, das mit Cyber-Safeguards wie bei Opus 5.5 startet, sodass "higher-risk cybersecurity tasks will visibly fall back to Sonnet 5." Routinemäßige Bugfixes sind nicht betroffen. Trotzdem stammte der größte Unter-Thread auf Hacker News von Leuten, die autorisierte Sicherheitsarbeit machen und trotzdem markiert wurden.
Der Migrationsleitfaden nennt fünf Breaking Changes, die jeweils einen 400-Fehler zurückgeben:
| Änderung | Was bricht | Lösung |
|---|---|---|
thinking: disabled | Anfragen mit komplett abgeschaltetem Thinking | Die neue Einstellung between_tools verwenden |
Erzwungenes tool_choice (any oder tool) | Bots, die ein Klassifizierungs-Tool erzwingen | Das Modell wählen lassen, dann validieren |
| Bearbeiteter Verlauf vor einem Thinking-Block | Apps, die vergangene Turns umschreiben | Den Verlauf nur anhängend führen |
computer_20251124 | Altes Computer-Use-Tool in der API und Google Cloud | computer_toolset_20260801 verwenden |
| Einige Advisor-Tool-Paarungen | Ein Sonnet-5- oder Opus-4.8-Advisor bei einem Sonnet-5.5-Executor | Mit Opus 5.5 oder Sonnet 5.5 paaren |
Für Support-Teams ist das erzwungene tool_choice die Falle. Viele KI-Helpdesk-Integrationen erzwingen bei jeder Anfrage ein Tool "Ticket klassifizieren" für das Ticket-Triage. Tauschen Sie die Modell-ID, ohne das zu beheben, läuft jedes Ticket in einen Fehler. Es gibt auch eine leisere Änderung: Text zwischen Tool-Aufrufen kommt jetzt innerhalb von Thinking-Blöcken an, sodass ein Chat-Widget, das "Ich prüfe Ihre Bestellung..." streamt, verstummen kann. Warum diese Stille für Kunden wichtig ist, behandelt mein Leitfaden zu Übergaben bei KI-Agenten.
Was Entwickler sagen
Die Aufnahme am Launch-Tag war gemischt, aber auf nützliche Weise. Niemand bestreitet die Benchmarks; gestritten wird eher darüber, wo Sonnet 5.5 neben Opus einzuordnen ist.
"It appears, at least from a quick look, to be noticeably faster than Opus. If true, and you don't need xhigh/max reasoning for your use case (like a well-defined set of code changes), Sonnet might get the job done much more quickly."
Die Skeptiker konzentrieren sich auf den Preis, besonders darauf, dass Cache-Reads mit 0,20 $ genauso viel kosten wie bei Opus 5.5:
"I feel like sonnet is priced too close to opus right now. If Sonnet 5.5 were half its current price it would make sense to use."
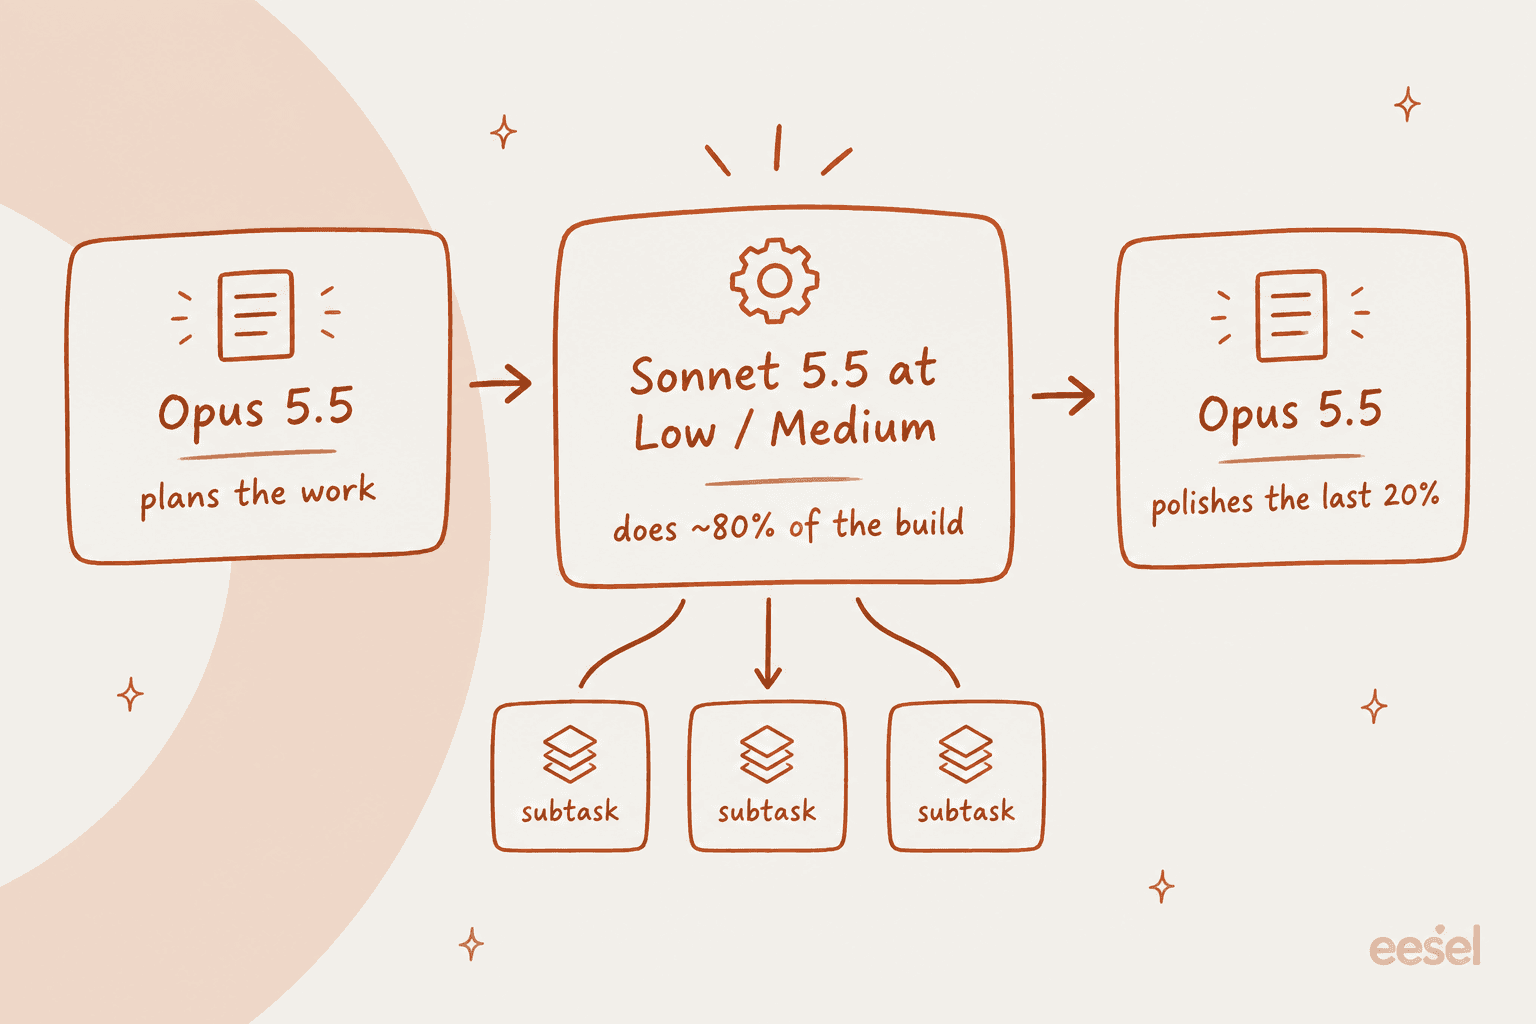
Der Anwendungsfall, auf den die Leute immer wieder zurückkommen, ist Sonnet als schneller Umsetzer unter einem Opus-Planer:
"Firmly places itself as a solid subagent for opus, great work from anthropic, for once I'm interested in what haiku turns out as."

Ein anderer Kommentator beschrieb seine eigene Aufteilung als "80% Sonnet 5.5, Opus 5.5 to finish the last 20%." Das Muster passt recht gut zu Claude-Code-Subagents, und es ist das Setup, das ich selbst übernehmen würde.
Claude Sonnet 5.5 Preise in einer Tabelle
Die Preise pro Million Tokens stammen aus Anthropics Preisdokumentation:
| Preis pro 1M Tokens | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | Haiku 4.5 |
|---|---|---|---|---|
| Input | $2 | $2 | $4 | $1 |
| Output | $10 | $10 | $20 | $5 |
| 5-Minuten-Cache-Write | $2.50 | $2.50 | $5 | $1.25 |
| Cache-Read | $0.20 | $0.20 | $0.20 | $0.10 |
| Batch Input / Output | $1 / $5 | $1 / $5 | $2 / $10 | $0.50 / $2.50 |
| Kontextfenster | 1M | 1M | 1M | 200K |
Thinking-Tokens werden als Output abgerechnet, und deshalb ist die Effort-Einstellung so wichtig. Eine Support-Antwort bei Medium denkt vielleicht einige hundert Tokens lang, dieselbe Antwort bei Max kann zehntausende denken, alle zu 10 $ pro Million. Die Modellzeile ist selten der größte Posten bei den Kosten eines KI-Support-Agenten, aber der Effort-Regler ist der schnellste Weg, sie dazu zu machen.
Der Zugang für Privatnutzer ist der einfachere Teil. Laut Anthropic kann jeder auf Claude.ai mit Sonnet 5.5 chatten, und die Bezahlpläne stehen in meinem Claude-Pro-Preisguide. Ab dem ersten Tag ist es auch auf Amazon Bedrock und Google Cloud sowie Microsoft Foundry verfügbar. Wenn Sie Anbieter abwägen, beginnen Sie mit dem Dreier-Vergleich der APIs. Für den direkten Vergleich mit OpenAI lesen Sie die Gegenüberstellung GPT-6 Sol vs. Opus 5.5.
Wer wechseln sollte und wer warten sollte
So würde ich entscheiden, je nachdem, was Sie heute betreiben:
| Sie betreiben... | Meine Empfehlung | Effort-Einstellung |
|---|---|---|
| Sonnet 5 in Produktion | Diese Woche wechseln, nach den Migrationsfixes | Medium |
| Opus 5.5 für alltägliches Coding | Routineaufgaben auf Sonnet-5.5-Sub-Agents verlagern | Low oder Medium |
| Opus 5.5 für offene Planung | Bei Opus bleiben | n/a |
| Einen Support-Bot mit erzwungenen Tool-Aufrufen | Warten, bis tool_choice behoben ist | Medium |
| Security- oder Pentest-Workflows | Warten und sich für das Cyber Verification Program bewerben | n/a |
| Tagging und Routing in hohem Volumen | Bei Haiku 4.5 bleiben, bis Haiku 5.5 erscheint | n/a |
Laut Anthropic stößt Claude Haiku 5.5 "in the coming weeks" zur Familie, wenn also die Kosten pro Ticket Ihre Hauptsorge sind, lohnt sich das Warten. Für einen breiteren Blick auf Optionen deckt meine Übersicht zu Alternativen für den Kundenservice mit Claude supportspezifische Optionen ab. Für allgemeine Modellwechsel siehe die Liste der Sonnet-Alternativen.
Ein klügeres Modell behebt keine falsche Wissensbasis
Eines kann ein Modelltest nicht zeigen: Die meisten Ausfälle von Support-Bots, die ich gesehen habe, haben nichts mit dem Modell zu tun. Ein B2B-Telematik-Team für Fahrzeuge mit etwa 200 Zendesk-Tickets im Monat stellte fest, dass sein Bot Kunden erzählte, er unterstütze Automarken, die nicht in der Datenbank waren. Das Modell halluzinierte allerdings nicht. Die Wissensbasis sagte, man unterstütze "alle Modelle", und der Bot glaubte das einfach. Der Sprung von Sonnet 5 auf Sonnet 5.5 hätte dieselbe falsche Antwort geliefert, nur 30 % schneller.
Deshalb beurteile ich ein Modell für den Support nie allein anhand von Benchmarks. Bei eesel wird jeder Rollout gegen historische Tickets simuliert, bevor der Kollege je mit einem Kunden spricht, denn dort fängt man die Wissensprobleme ab, die ein besseres Modell nicht beheben kann.
eesel mit Claude-Klasse-Modellen in Ihrer Queue testen
Wenn Sie das Tempo von Sonnet 5.5 bei Ihren Tickets wollen, ohne die Migration selbst zu tragen, ist eesel die Abkürzung. Der KI-Helpdesk-Kollege stößt zu dem Helpdesk, den Sie schon haben, etwa Zendesk, lernt aus Ihren bisherigen Tickets und dem Help Center und entwirft oder sendet dann Antworten mit einem Frontier-Modell darunter. Das gesamte Effort-Tuning und alle Breaking Changes aus diesem Test werden zu eesels Aufgabe statt zu Ihrer.

Wenn Sie gern im Terminal arbeiten: Die eesel CLI bedient denselben Kollegen und dasselbe Workspace wie das Dashboard. Sie können sie skripten oder einen Coding-Agent wie Claude Code steuern lassen, was im Grunde dasselbe Muster "Opus plant, Sonnet baut" von oben ist, nur auf Ihr Support-Setup angewendet. Mein Beitrag zur KI-Agent-CLI geht tiefer, und der zu MCP-Servern behandelt die Connector-Seite.
Der kostenlose Plan enthält 100 Credits und braucht keine Karte, und bezahlte Pläne beginnen bei 299 $ für 500 Credits. Testen Sie eesel an einem Ausschnitt Ihrer echten Tickets und sehen Sie, ob sich das schnellere Modell tatsächlich in schnelleren Antworten zeigt.
Lohnt sich Claude Sonnet 5.5?
Ja, mit einer Regel. Bei Low oder Medium liefert Claude Sonnet 5.5 Coding und Wissensarbeit nahe an Opus zum halben Token-Preis, und es ist 30 %+ schneller bei deutlich weniger Tokens. Damit ist es der neue Standard für klar abgegrenzte Arbeit und Sub-Agents, und auch für alltägliche Support-Antworten.
Bei Max kostet es mehr als Opus und scheitert manchmal trotzdem, nutzen Sie es dort also nicht. Behalten Sie Opus 5.5 für die schweren, offenen Entscheidungen und beheben Sie Ihre erzwungenen Tool-Aufrufe vor der Migration. Danach soll der Effort-Regler Ihre Rechnung bestimmen, nicht der Modellname.
Häufig gestellte Fragen
Ist Claude Sonnet 5.5 gut?
Ist Claude Sonnet 5.5 besser als Sonnet 5?
Lohnt sich Claude Sonnet 5.5 gegenüber Opus 5.5?
Was kostet Claude Sonnet 5.5?
Welche Effort-Stufe sollte ich mit Claude Sonnet 5.5 nutzen?
Eignet sich Claude Sonnet 5.5 für den Kundensupport?
Was sind die Nachteile von Claude Sonnet 5.5?
Welche Alternativen gibt es zu Claude Sonnet 5.5?


Article by
Kira
Kira is a writer at eesel AI with a Computer Science background and over a year of hands-on experience evaluating AI-powered customer service tools. She focuses on breaking down how helpdesk platforms and AI agents actually work so that support teams can make better buying decisions.