

Warum Menschen nach Claude-Haiku-5.5-Alternativen suchen
Zuerst die gute Nachricht, denn die hat Haiku 5.5 verdient. Claude Haiku 5.5 erschien am 7. Oktober 2026, erreicht 43 Punkte im Intelligence Index von Artificial Analysis und liegt damit vor jedem anderen kleinen Modell in diesem Beitrag. Es gibt 243 Tokens pro Sekunde aus und kostet unter 100.000 Prompt-Tokens $0.10 Input und $0.50 Output pro Million. All das habe ich in meinem Haiku-5.5-Test behandelt.
Ich schreibe bei eesel die API-Anbindung und lese solche Launches deshalb von der Integrationsseite. Ich frage, was kaputtgeht, was es bei einer realen Last kostet und was ich neu schreiben muss. Nach diesen Prüfungen sehe ich vier Gründe, aus denen ein Team entscheiden könnte, dass Haiku 5.5 nicht sein Modell ist.
- Die Preisklippe bei 100k. Laut den Claude-Preisdokumenten zahlt ein Prompt über 100.000 Tokens $0.50 Input und $2.50 Output, dazu das 5-Fache bei Cache-Lese- und Schreibzugriffen. Haiku 5.5 ist das einzige aktuelle Claude-Modell ohne Pauschalpreis über sein gesamtes 1M-Fenster.
- Der Tokenizer. Die Seite „What's new" sagt, derselbe Text erzeuge „approximately 30% more tokens" als bei Haiku 4.5. Sie zahlen für mehr Tokens und erreichen die 100k-Grenze früher.
- Brechende API-Änderungen. Jedes nicht standardmäßige
temperature,top_podertop_kliefert jetzt einen Fehler, ebenso Assistant-Prefill. Viele Klassifikatoren wurden genau auf diesen beiden Tricks aufgebaut, deshalb tut das so weh. - Weitschweifigkeit. Artificial Analysis zählte für Haiku 5.5 440M erzeugte Tokens auf seinem Index gegenüber 140M bei GPT-6 Luna. Gleicher Listenpreis, aber dann ungefähr die dreifache Rechnung für dieselbe Arbeit.
Fairerweise: Hacker News hat die Rechnung für lange Prompts schon eine Stunde nach dem Launch aufgemacht.
"noticeably smarter remains to be seen in practice. For now, Haiku is a bit more expensive than Luna on < 100k token, but I just don't have any agentic work below 100k, so this is going to be 5x more expensive than shown on these charts."

Die richtige Alternative hängt also davon ab, welcher dieser vier Punkte Sie getroffen hat, und hier ist die Karte, die ich dafür nutze.
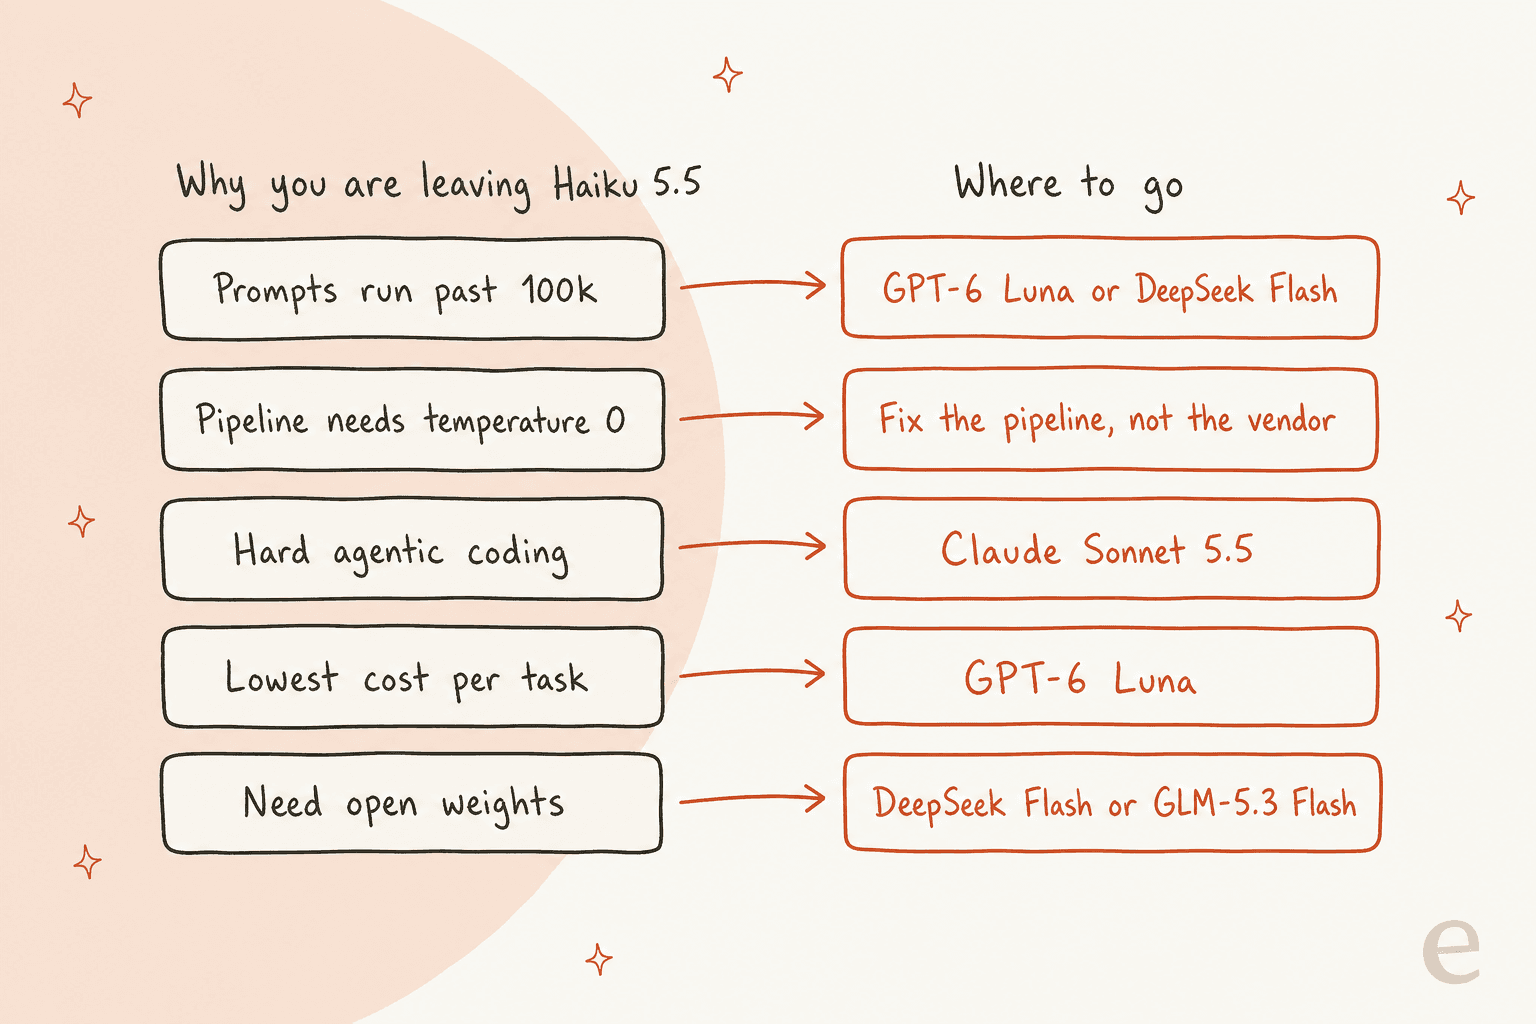
Claude-Haiku-5.5-Alternativen im Überblick
Jeder Preis unten gilt pro Million Tokens zu Standardtarifen und wurde am 8. Oktober 2026 auf der Preisseite des jeweiligen Anbieters geprüft. Die Spalten von Artificial Analysis (AA) nutzen deren Intelligence Index v4.3.2 auf der von AA angegebenen Effort-Stufe.
| Modell | Input / Output | Regel für lange Prompts | Kontext | AA-Index | AA-Kosten pro Aufgabe | Ausgabegeschwindigkeit | Temperature 0 | Offene Gewichte | Am besten für |
|---|---|---|---|---|---|---|---|---|---|
| Claude Haiku 5.5 (Referenz) | $0.10 / $0.50 | 5x auf jede Zeile über 100k | 1M | 43 | $0.21 | 243 tok/s | Fehler | Nein | Kurze, kluge, schnelle Jobs |
| GPT-6 Luna | $0.10 / $0.50 | 2x Input, 1.5x Output über 272k | 1.05M | 38 | $0.07 | 128 tok/s | Nur bei Effort none | Nein | Niedrigste Kosten pro Aufgabe |
| Claude Haiku 4.5 | $1 / $5 | Pauschal | 200k | k. A. | k. A. | k. A. | Funktioniert | Nein | Zeit gewinnen für alte Prompts |
| Claude Sonnet 5.5 | $2 / $10 | Pauschal | 1M | 56 (max) | $7.60 (max) | k. A. | Fehler | Nein | Schwieriges Reasoning und Coding |
| DeepSeek V4.1 Flash | $0.30 / $1.20 zur Spitzenzeit, halb so viel außerhalb | Pauschal | 1M | 39 | $0.27 (Spitzenzeit) | k. A. | Im Thinking-Modus ignoriert | Ja, MIT | Lange Prompts mit knappem Budget |
| GLM-5.3 Flash | $0.15 / $0.50 | Pauschal | 1M | 42 | $0.25 | 51 tok/s | Thinking immer an | Ja | Offene Gewichte nahe an Haikus Wert |
| Gemini 3.5 Flash-Lite | $0.30 / $2.50 | Pauschal | 1M | 22 | $0.19 | 346 tok/s | Google rät zu 1.0 | Nein | Reiner Durchsatz |
| Gemini 3.8 Flash | $0.75 / $3.75 (verdoppelt sich am 1. Jan. 2027) | Pauschal | 1M | 41 (high) | $1.24 | k. A. | Google rät zu 1.0 | Nein | Lange Agentenaufgaben in Googles Stack |
Eine Anmerkung zur Geschwindigkeitsspalte: „k. A." heißt, dass ich keinen vertrauenswürdigen AA-Wert vom selben Tag hatte, nicht dass das Modell langsam ist.
Wie ich diese ausgewählt habe
Ich habe die Liste auf Modelle beschränkt, zu denen ein Haiku-5.5-Nutzer diese Woche tatsächlich wechseln könnte: allgemein verfügbar, öffentlich bepreist und in derselben Klasse klein und schnell, dazu eine Stufe darüber (Sonnet 5.5) und eine zurück (Haiku 4.5). Ich habe jeden Preis auf der Seite des Anbieters geprüft, jedes API-Verhalten in der Dokumentation des Anbieters und jeden Benchmark bei Artificial Analysis statt in Launch-Grafiken.
Die Kennzahl, auf die ich mich am meisten stütze, sind die Kosten pro erledigter Aufgabe, nicht der Preis pro Token. Haiku 5.5 und Luna haben identische Preise pro Token, aber sehr verschiedene Rechnungen, und das ist die ganze Geschichte dieser Klasse.
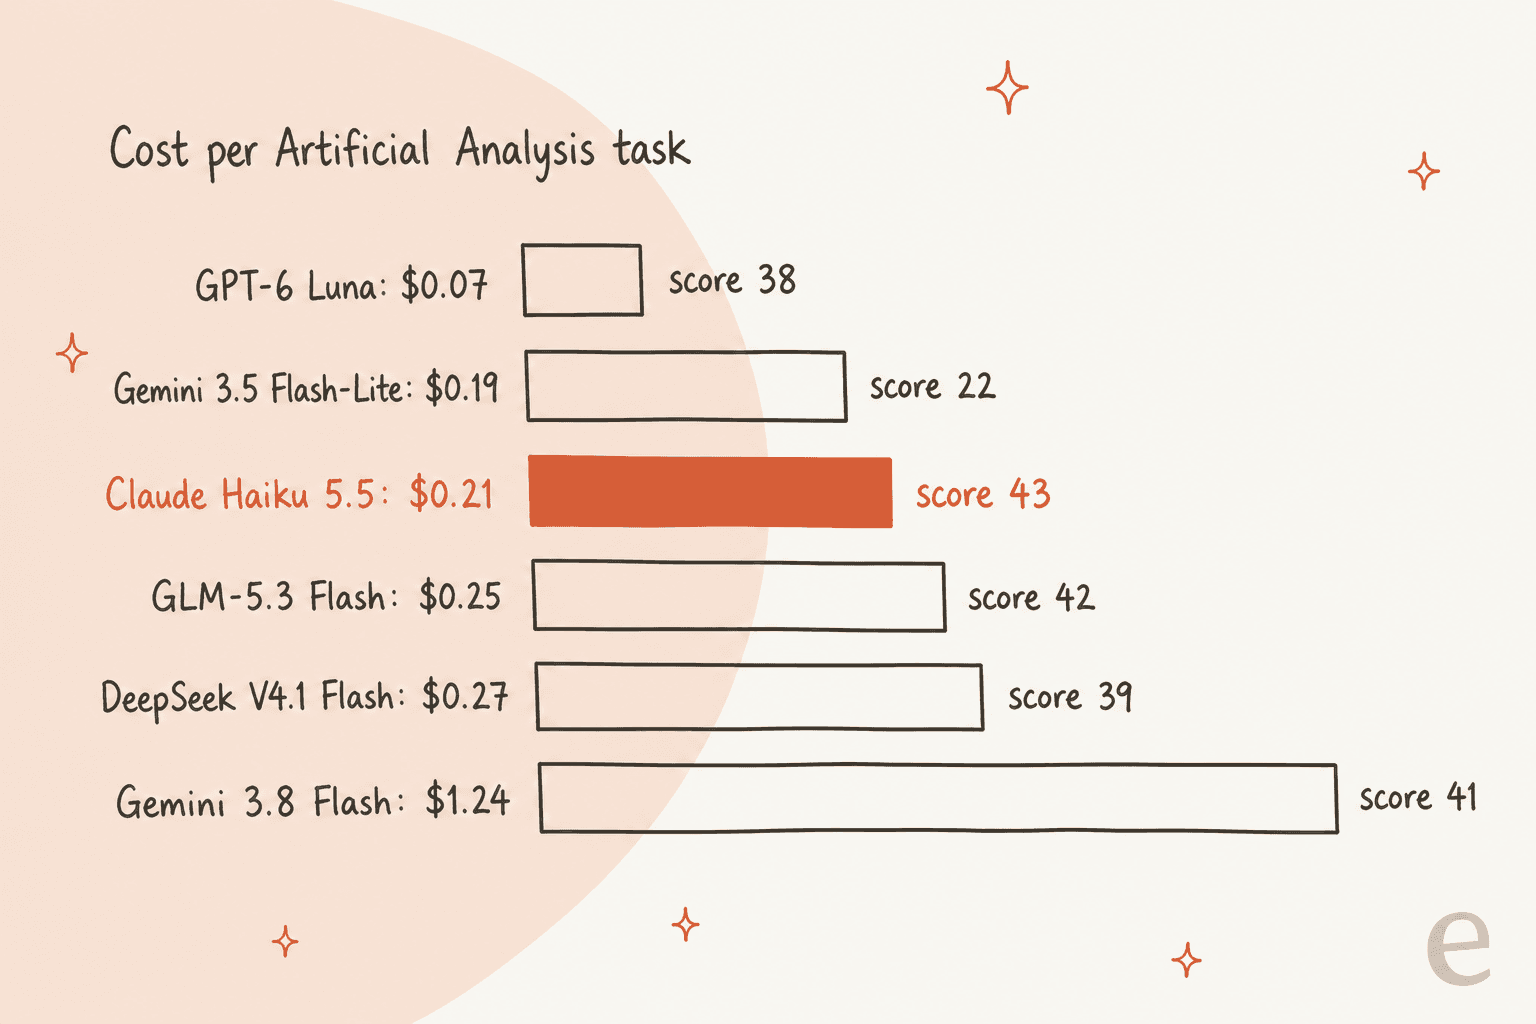
Lesen Sie die Grafik als Abwägung, nicht als Rangliste. Haiku 5.5 verschafft Ihnen 5 Indexpunkte mehr als Luna für das Dreifache der Kosten pro Aufgabe. Ob das lohnt, hängt also davon ab, ob Ihre Aufgabe von der Art ist, bei der sich diese 5 Punkte zeigen.
1. GPT-6 Luna
Am besten für: Teams, die Haiku-Preise ohne die 100k-Klippe wollen und die niedrigste Rechnung pro erledigtem Job.
Was es besser macht als Haiku 5.5
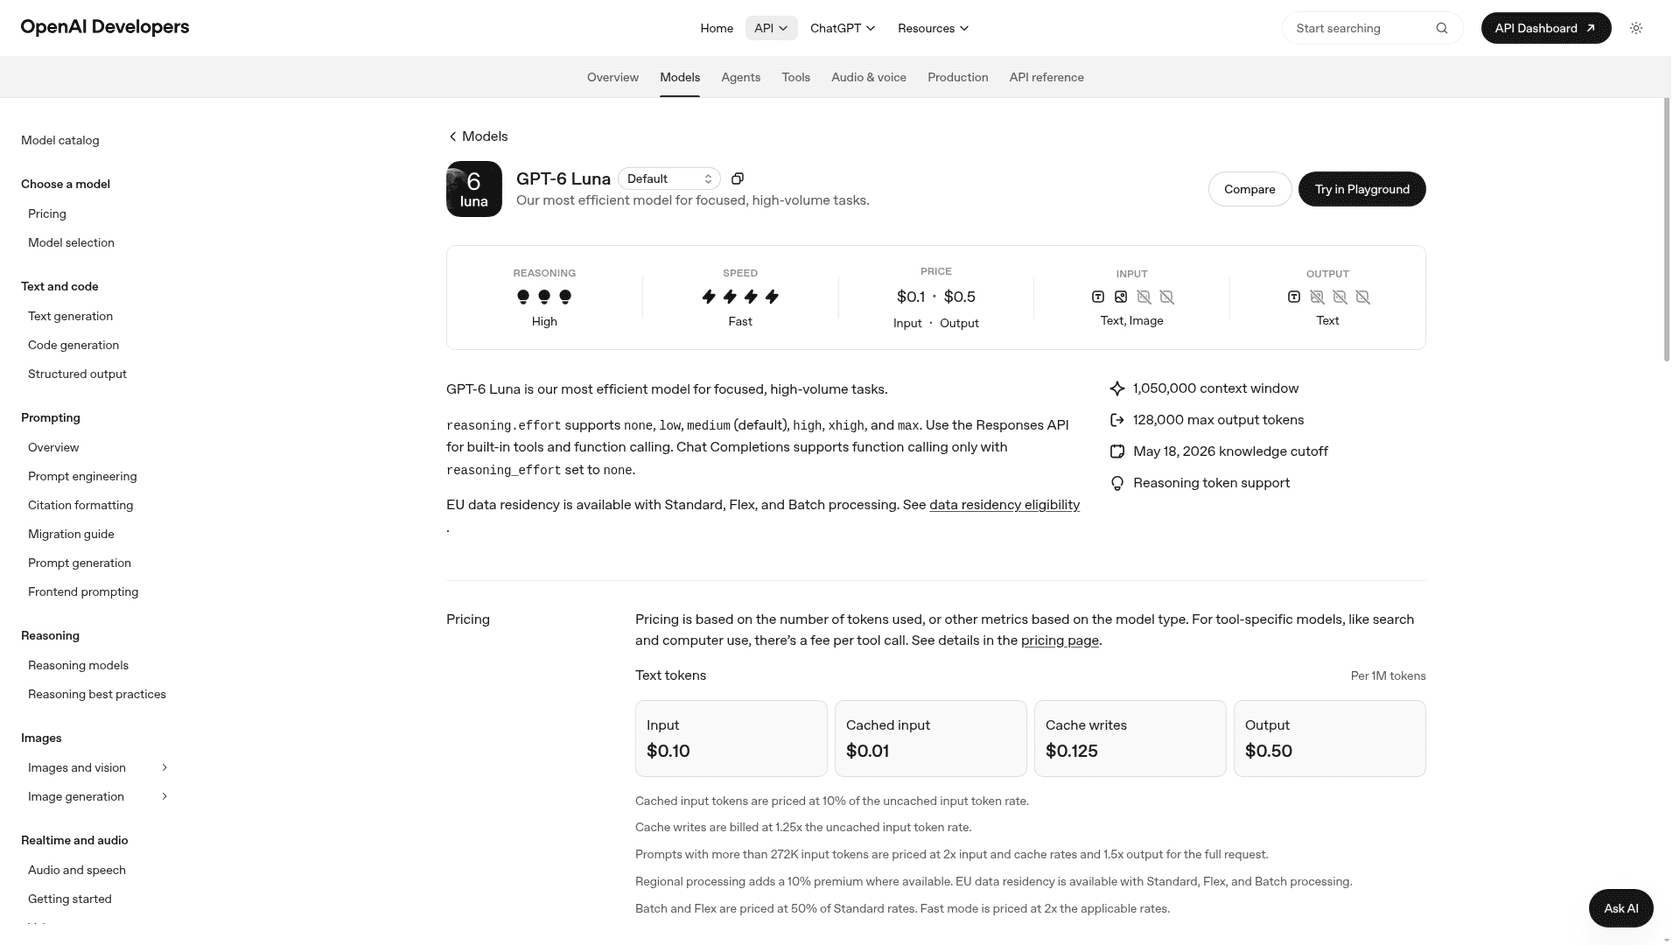
Luna ist das Modell, dessen Preis Haiku 5.5 angleichen sollte, und es gewinnt bei zwei Dingen, die für echte Rechnungen zählen. Erstens ist seine Long-Context-Regel deutlich milder. Die Modellseite sagt, Prompts über 272K Input-Tokens zahlen das 2-Fache auf Input und Cache und das 1.5-Fache auf Output, was $0.20 Input und $0.75 Output ergibt. Haiku 5.5 steigt schon bei 100k und gleich um das 5-Fache.
Zweitens schreibt es weniger, und das zeigt sich schnell auf der Rechnung. AA setzte Luna bei 140M Tokens auf seinem Index an gegenüber 440M bei Haiku und bei $0.07 pro Aufgabe gegenüber $0.21. Ein Hacker-News-Tester ließ denselben Klassifizierungsjob auf beiden laufen und fand Luna etwa 26% günstiger bei identischem Preis pro Token. Auch Tokenizer spielen eine Rolle:
"There's also a tokenizer efficiency difference: modern Claude's 100K tokens are about ~60-65K modern GPT tokens, so in reality the Luna cutoff is much further away than the Haiku one."
Wo es schwächelt
Luna erreicht 38 bei AA gegenüber 43 bei Haiku, und AAs Halluzinationstest zeigt die größere Lücke: 77% bei Luna gegenüber 40% bei Haiku 5.5, laut meinem Haiku-Test. Es ist auch langsamer, mit 128 Output-Tokens pro Sekunde, und das zählt im Live-Betrieb. Und die API hat ihren eigenen Haken. Der Leitfaden zum neuesten Modell von OpenAI sagt, dass Sie temperature und top_p entfernen müssen, wenn der Reasoning-Effort nicht none ist, und Chat Completions unterstützt Function Calling nur bei Effort none. Für Tools mit Reasoning nutzen Sie die Responses API.
Preise
| Tarif | Bis 272K Input | Über 272K Input |
|---|---|---|
| Input | $0.10 | $0.20 |
| Gecachter Input | $0.01 | $0.02 |
| Output | $0.50 | $0.75 |
| Batch / Flex Input / Output | $0.05 / $0.25 | $0.10 / $0.375 |
Quelle: OpenAI-API-Preise. Der Luna-Preisleitfaden erklärt den Fast-Modus und regionale Tarife.
Mein Fazit
Ehrlich gesagt ist das der Standardwechsel. Wenn Ihre Haiku-5.5-Nutzung regelmäßig 100k Tokens überschreitet oder Ihnen die Kosten pro Aufgabe wichtiger sind als die letzten Qualitätspunkte, wechseln Sie hierher. Bleiben Sie bei Haiku, wenn Ihre Evals zeigen, dass die zusätzlichen 5 Punkte (oder die niedrigere Halluzinationsrate) bei Ihrer tatsächlichen Aufgabe ankommen. Mein Beitrag zu den GPT-6-Luna-Alternativen führt den Vergleich von der anderen Seite durch.
2. Claude Haiku 4.5
Am besten für: Pipelines, die von temperature: 0, Prefill oder manuellen Thinking-Budgets abhängen, während Sie sie umschreiben.
Was es besser macht als Haiku 5.5
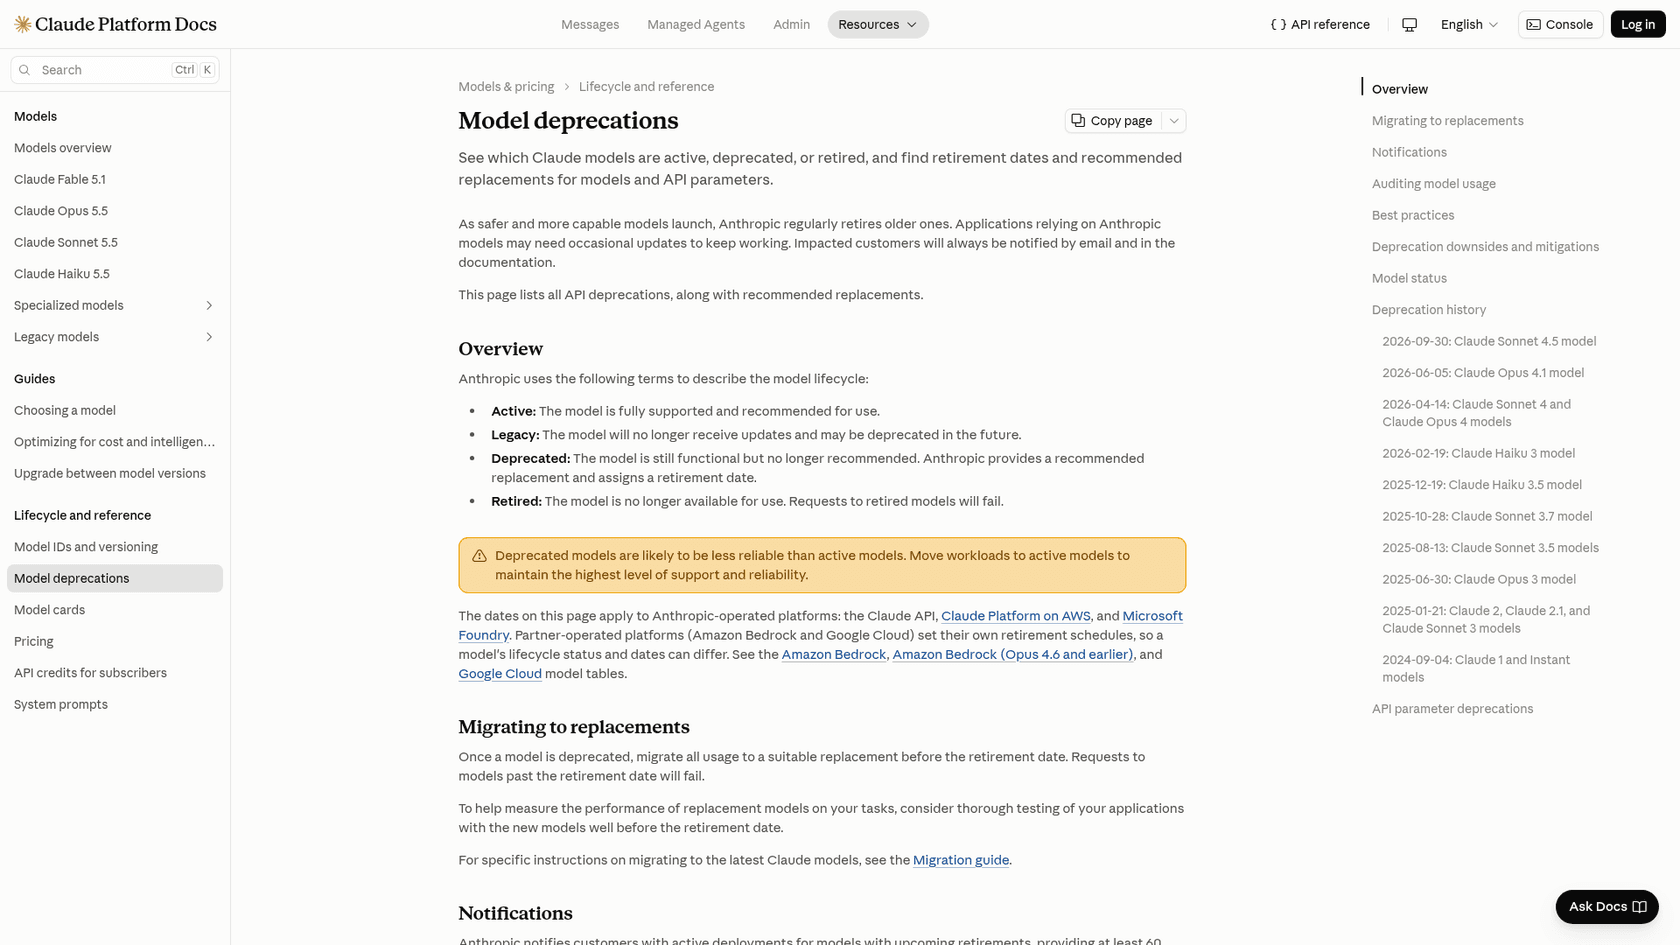
Bei Benchmarks nichts, aber es macht Ihren Code nicht kaputt. Haiku 4.5 akzeptiert weiterhin die Sampling-Parameter, Prefill und budget_tokens, die Haiku 5.5 ablehnt, sein Preis ist über sein 200k-Fenster pauschal, und sein älterer Tokenizer zählt für denselben Text weniger Tokens. Manche Teams mögen auch einfach seine Ausgabe bei ihrem engen Anwendungsfall.
"Not really. We use Haiku 4.5 to turn users' natural language queries and requests into fairly complex structured specs for interior design and construction. It has near perfect accuracy."
Wo es schwächelt
Es kostet pro Token das 10-Fache von Haiku 5.5 unter 100k ($1 / $5 gegenüber $0.10 / $0.50), und die Fähigkeitslücke ist riesig: OSWorld 2.1 ging zwischen den beiden von 15.7% auf 72.4%. Das größere Problem ist die Zeit. Die Seite zu Abschaltungen führt claude-haiku-4-5-20251001 als Active, mit Abschaltung „Not sooner than October 15, 2026". Das ist eine Untergrenze, kein geplanter Termin, und Anthropic sagt, dass es Kunden vor einer Abschaltung benachrichtigt. Etwas Neues darauf zu bauen ist also eine Wette gegen den Kalender.
Preise
| Tarif | Claude Haiku 4.5 |
|---|---|
| Input / Output | $1 / $5 |
| Cache-Schreiben 5 Minuten / 1 Stunde | $1.25 / $2 |
| Cache-Lesen | $0.10 |
| Batch Input / Output | $0.50 / $2.50 |
Quelle: Claude-Preisdokumente. Der Leitfaden zu den Anthropic-API-Preisen deckt das gesamte Angebot ab.
Mein Fazit
Nutzen Sie es als Brücke: Lassen Sie die alte Pipeline auf 4.5 weiterlaufen, während Sie die Labels auf strukturierte Ausgaben umstellen, und lassen Sie dann beide Modelle nebeneinander auf denselben Tickets laufen. Fangen Sie hier nichts Neues an.
3. Claude Sonnet 5.5
Am besten für: die Aufgaben, die Haiku 5.5 nach oben weitergibt, besonders agentisches Coding und lange mehrstufige Arbeit.
Was es besser macht als Haiku 5.5
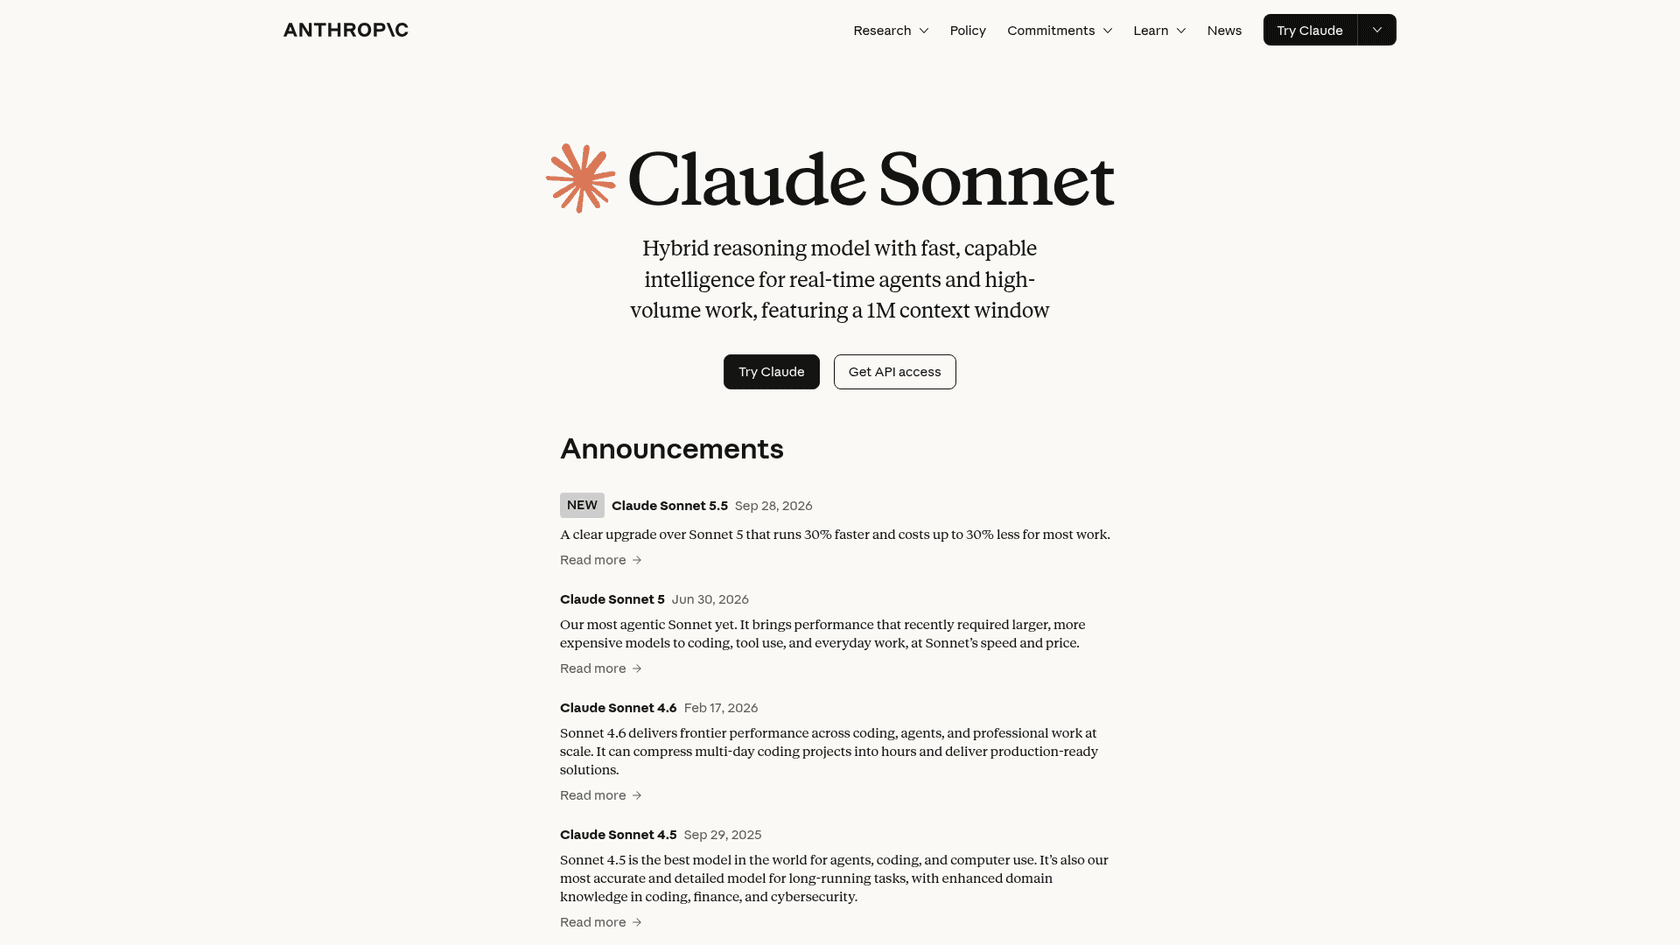
Die Lücke ist genau dort am größten, wo Haiku am schwächsten ist, nämlich beim Coding. Bei Anthropics Launch-Benchmarks erreicht Sonnet 5.5 70.6% auf Terminal-Bench 4.0 gegenüber 39.2% bei Haiku 5.5. Bei Wissensarbeit ist die Lücke klein (1840 gegenüber 1620 bei GDPval-AA), was zeigt, wo sich Sonnet lohnt. Claude Sonnet 5.5 hat außerdem Pauschalpreise über sein volles 1M-Fenster, und Anthropic hat am Launch-Tag von Haiku seine Cache-Lesezugriffe auf $0.10 halbiert.
Wo es schwächelt
Es kostet pro Token unter 100k das 20-Fache von Haiku 5.5 ($2 / $10), und es hat dieselben Sampling- und Prefill-Beschränkungen plus einige eigene, etwa die Ablehnung von erzwungenem tool_choice. Bei den Kosten spielt auch die Effort-Stufe eine große Rolle: AA hat bei maximalem Effort $7.60 pro Aufgabe gemessen, weshalb mein Sonnet-5.5-Test für die meiste Arbeit Medium empfiehlt.
Preise
| Tarif | Claude Sonnet 5.5 |
|---|---|
| Input / Output | $2 / $10 |
| Cache-Schreiben 5 Minuten / 1 Stunde | $2.50 / $4 |
| Cache-Lesen | $0.10 |
| Batch Input / Output | $1 / $5 |
Quelle: Claude-Preisdokumente. Der Beitrag zu den Sonnet-5.5-Preisen rechnet reale Rechnungen nach Effort-Stufe durch.
Mein Fazit
Ersetzen Sie Haiku nicht durch Sonnet, routen Sie dorthin. Lassen Sie die kurze Arbeit mit hohem Volumen auf einem kleinen Modell und schicken Sie Coding, lange Fehlersuche und alles mit hohem Risiko eine Stufe höher. Wenn Sonnet 5.5s eigene Eigenheiten das Hindernis sind, behandelt mein Beitrag zu den Sonnet-5.5-Alternativen diese Klasse.
4. DeepSeek V4.1 Flash
Am besten für: lange Prompts und Batch-Jobs mit knappem Budget, mit offenen Gewichten als Rückfallebene.
Was es besser macht als Haiku 5.5
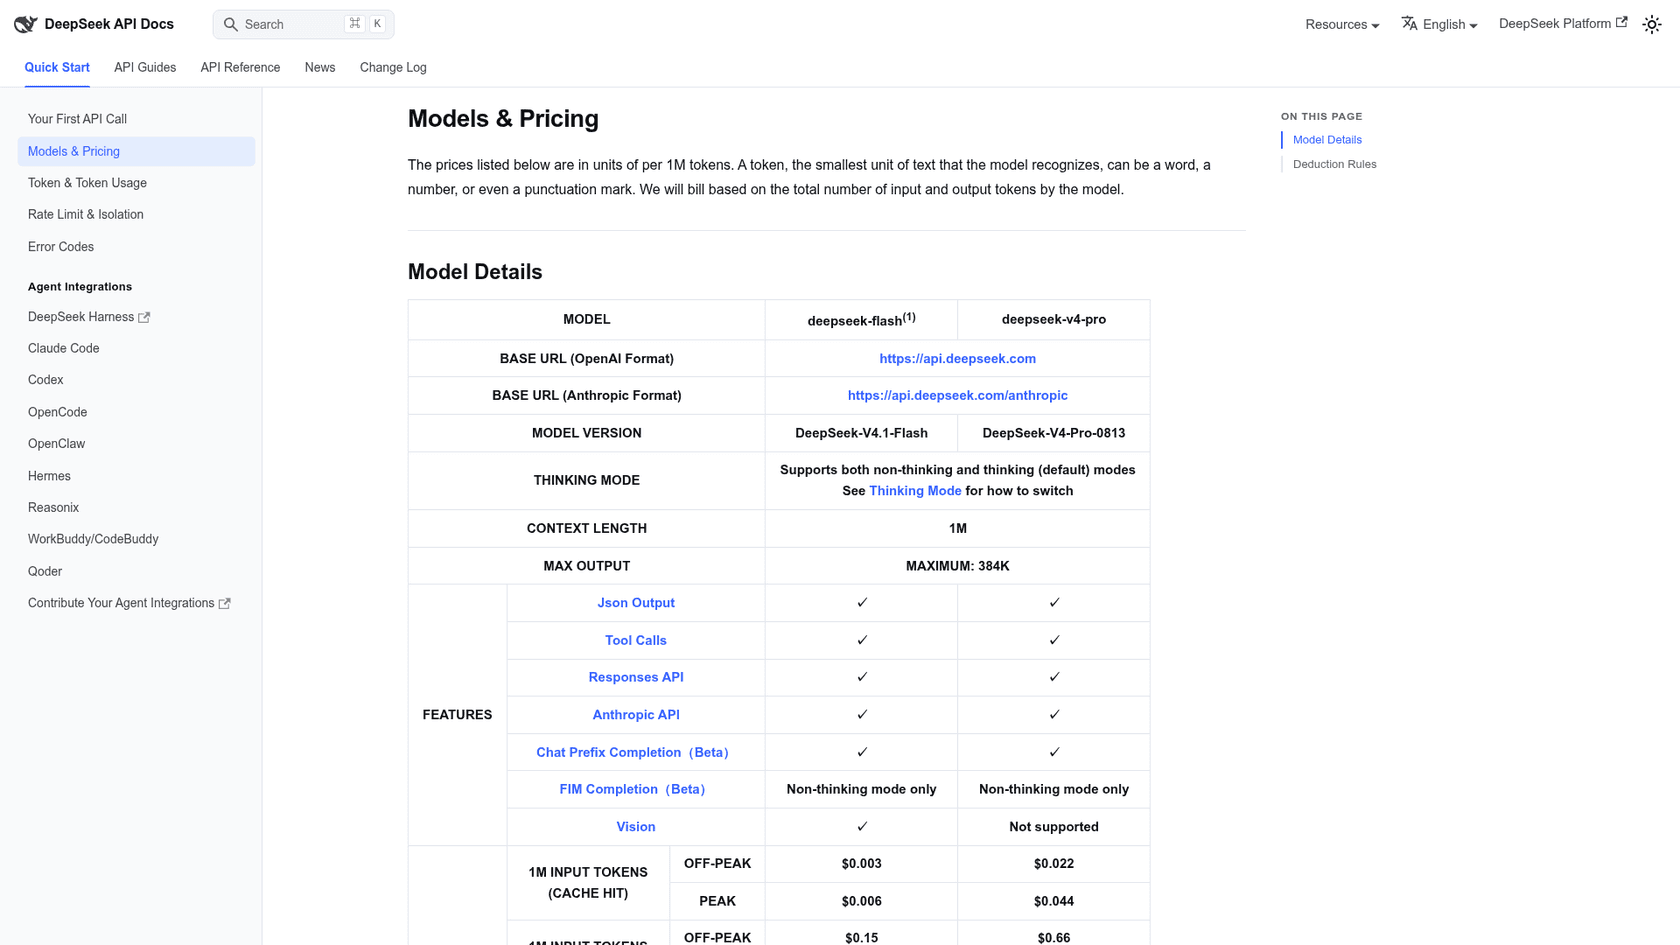
Keine Preisklippe. DeepSeek V4.1 Flash berechnet vom ersten bis zur millionsten Token denselben Satz, und außerhalb der Spitzenzeiten sind das $0.15 Input und $0.60 Output. Cache-Treffer kosten außerhalb der Spitzenzeiten $0.003, ein Drittel von Haikus $0.01. Bei einem Prompt von 150.000 Tokens kostet der DeepSeek-Input außerhalb der Spitzenzeiten also $0.0225, Haiku 5.5 dagegen $0.075.
Es spricht außerdem Anthropics API-Format, das heißt, eine bestehende Claude-Integration darauf umzulenken ist meist nur eine Änderung der Basis-URL, und es unterstützt Chat Prefix Completion (in Anthropic-Begriffen Prefill) als Beta. Die Gewichte liegen auf Hugging Face unter einer MIT-Lizenz.
Wo es schwächelt
Zwei Haken. Der Spitzenzeit-Preis ist doppelt so hoch, und die Spitzenzeiten sind werktags 01:00 bis 04:00 und 06:00 bis 10:00 UTC, also der europäische Arbeitsmorgen. Und im Thinking-Modus sagt DeepSeeks Leitfaden zum Thinking-Modus, temperature „will not trigger an error but will also have no effect", sodass Ihnen das Problem deterministischer Labels auch hier folgt, nur stillschweigend. AA bewertet es mit 39, vier Punkte unter Haiku.
Preise
| Tarif | Außerhalb der Spitzenzeit | Spitzenzeit |
|---|---|---|
| Input, Cache-Miss | $0.15 | $0.30 |
| Input, Cache-Treffer | $0.003 | $0.006 |
| Output | $0.60 | $1.20 |
Quelle: DeepSeek-Preise. Mein Beitrag zu den V4.1-Flash-Preisen behandelt die Rechnung für die Spitzenzeiten.
Mein Fazit
Die erste Wahl für Long-Context-Batch-Arbeit, wo die 100k-Klippe am meisten wehtut, etwa beim nächtlichen Zusammenfassen langer Ticketverläufe. Prüfen Sie vorher Datenresidenz und die Anbieterregeln Ihres Unternehmens, denn manche Teams dürfen keine Kundendaten an eine API mit Sitz in China senden, und Self-Hosting der offenen Gewichte ist der Ausweg.
5. GLM-5.3 Flash
Am besten für: Teams, die ein Open-Weight-Modell wollen, das innerhalb eines Punkts von Haiku 5.5 liegt.
Was es besser macht als Haiku 5.5
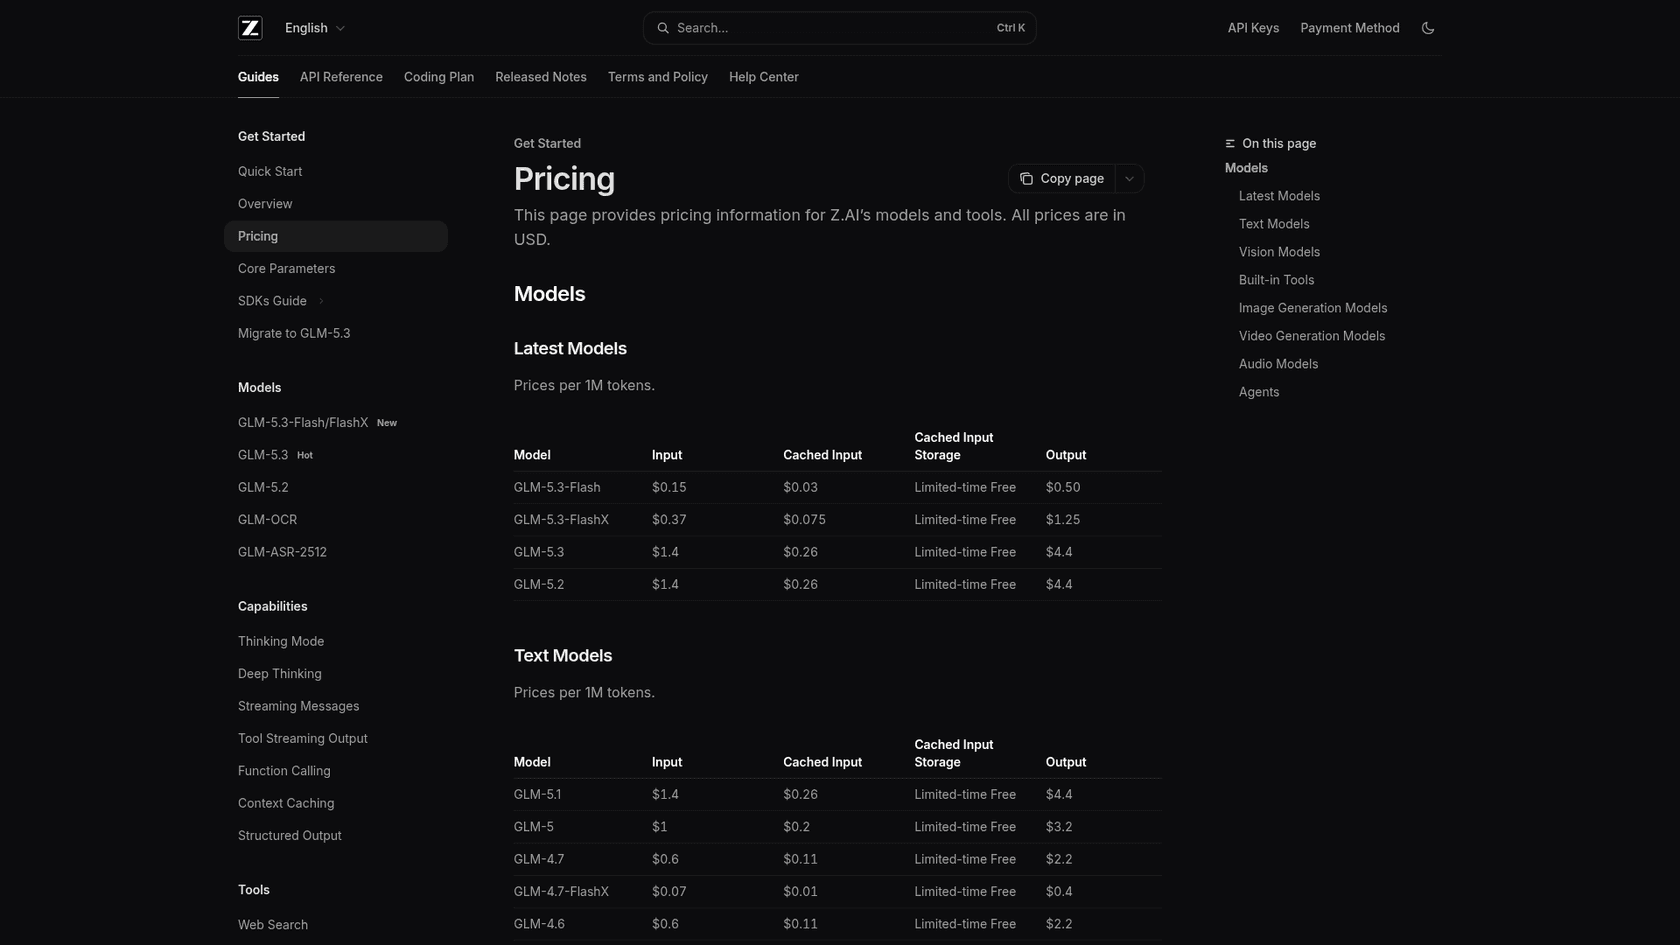
Punkte pro Dollar ohne Klippe. GLM-5.3 Flash erreicht bei Artificial Analysis 42 Punkte, einen unter Haiku 5.5, bei $0.15 Input und $0.50 Output pauschal über ein 1M-Fenster. Der Output-Preis entspricht Haikus günstiger Stufe, und den 5-fachen Sprung zahlen Sie nie. Die Gewichte sind öffentlich auf Hugging Face, Sie können es also auf eigener Hardware oder über einen Drittanbieter betreiben.
Manche Entwickler nutzen es schon als ihr günstiges Alltagsmodell:
"Not me, I use GLM-5.3-Flash for almost everything (the subscription-subsidized pricing on a legacy Z.ai plan makes it the best value model by a wide margin), along with some MiMo and DeepSeek."
Wo es schwächelt
Die Geschwindigkeit ist das Problem. AA misst 51 Output-Tokens pro Sekunde über die First-Party-API gegenüber 243 bei Haiku 5.5, es passt also schlecht zu allem, worauf ein Mensch wartet. Thinking lässt sich auch nicht abschalten: Die Modellseite sagt „thinking.type only supports enabled", und Z.ai empfiehlt temperature: 1. Der Input kostet außerdem $0.15 gegenüber Haikus $0.10, sehr kurze, input-lastige Prompts kosten also etwas mehr.
Preise
| Tarif | GLM-5.3 Flash | GLM-5.3 FlashX |
|---|---|---|
| Input | $0.15 | $0.37 |
| Gecachter Input | $0.03 | $0.075 |
| Output | $0.50 | $1.25 |
Quelle: Z.AI-Preise. Mein GLM-5.3-Flash-Test und der Preisbeitrag gehen tiefer.
Mein Fazit
Die beste Open-Weight-Antwort auf Haiku 5.5 bei der Qualität und eine starke Wahl für Hintergrundjobs, auch wenn ich es für Live-Chat auslassen würde, wo seine Geschwindigkeit auffällt. Der Beitrag zu den GLM-5.3-Flash-Alternativen behandelt seine Nachbarn.
6. Gemini 3.5 Flash-Lite
Am besten für: sehr hohes Volumen bei einfachen Jobs, wo Durchsatz wichtiger ist als Intelligenz.
Was es besser macht als Haiku 5.5
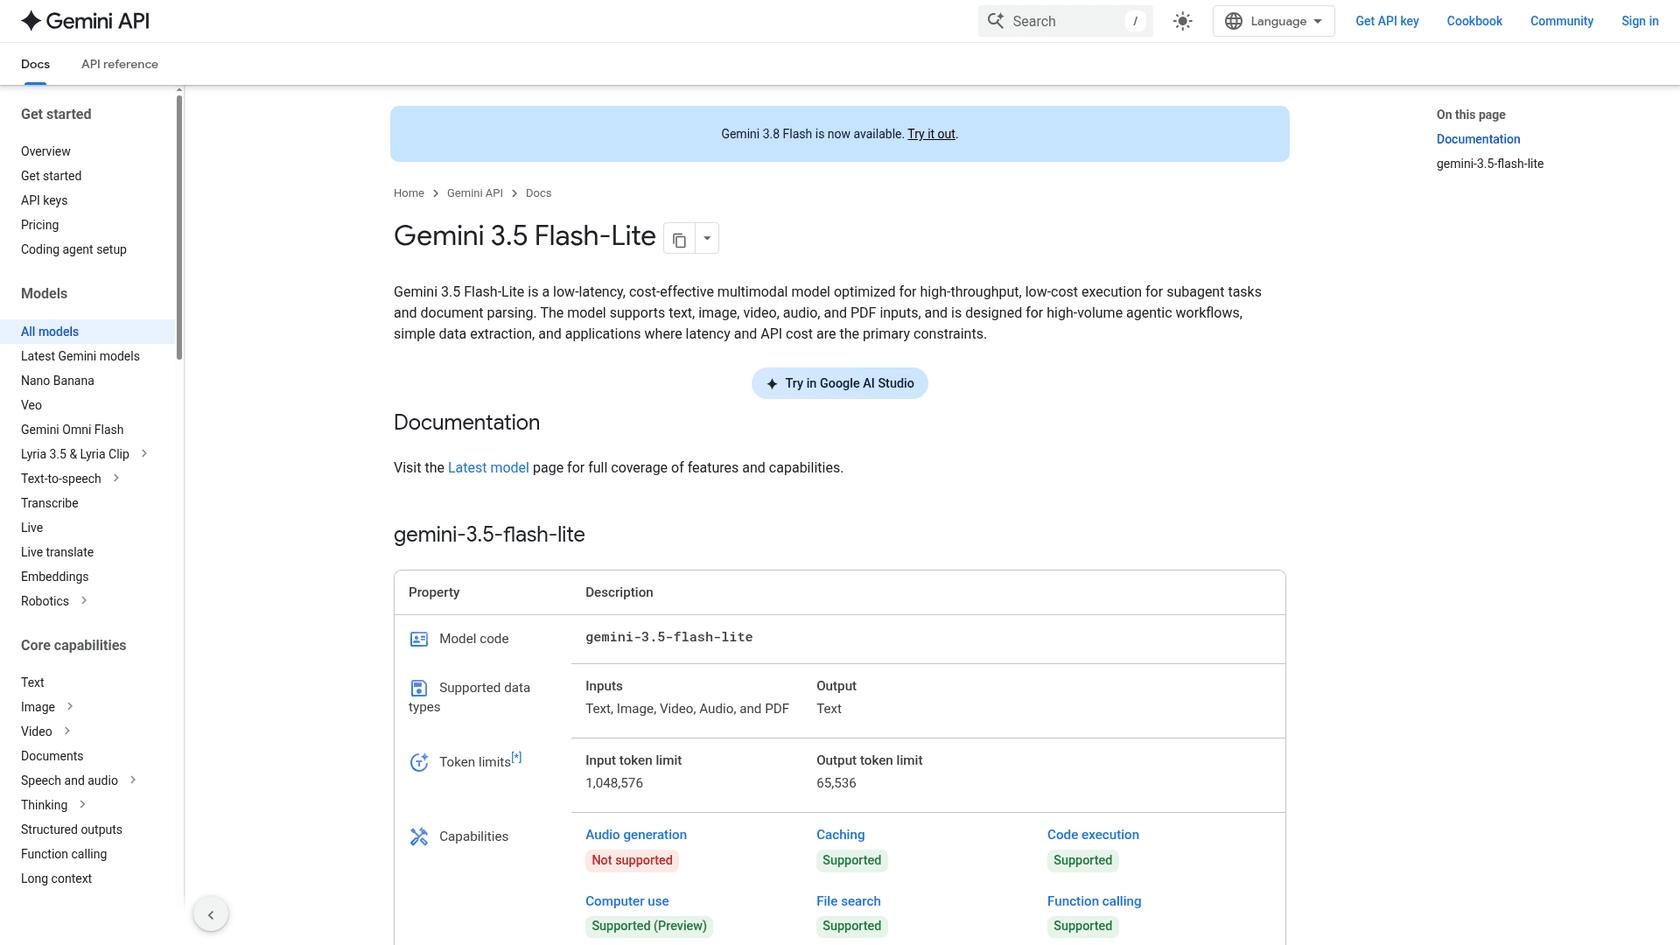
Es ist hier das schnellste Modell, mit 346 Output-Tokens pro Sekunde laut Artificial Analysis, und das am wenigsten wortreiche: 59M Tokens auf dem AA-Index gegenüber Haikus 440M. Der Preis ist pauschal über sein 1M-Fenster, es nimmt Text, Bild, Video, Audio und PDF als Input, und Google bietet außerdem eine kostenlose Stufe zum Testen. Gemini 3.5 Flash-Lite ist für Parsing, Tagging und Routing im großen Maßstab gebaut.
Wo es schwächelt
Die Intelligenz ist die Lücke. Es erreicht 22 bei AA, etwa die Hälfte von Haiku 5.5s 43, und seine Kosten pro Aufgabe ($0.19) landen trotzdem nahe bei Haiku, weil sein Output-Preis $2.50 beträgt, das Fünffache von Haikus günstiger Stufe. Die maximale Ausgabe liegt bei 65.536 Tokens. Und Googles Gemini-3-Leitfaden empfiehlt dringend, Temperature für alle Gemini-3-Modelle bei 1.0 zu lassen, und warnt, niedrigere Werte könnten „looping or degraded performance" verursachen.
Preise
| Tarif | Gemini 3.5 Flash-Lite |
|---|---|
| Input / Output | $0.30 / $2.50 |
| Kontext-Cache | $0.03, plus Speicherung |
| Kostenlose Stufe | Ja |
Quelle: Gemini-API-Preise. Der Beitrag zu den Flash-Lite-Preisen behandelt die Batch- und Prioritätsstufen.
Mein Fazit
Nutzen Sie es für den dümmsten Schritt mit dem höchsten Volumen in einer Pipeline, etwa Spracherkennung oder Spamfilterung, und halten Sie es von allem fern, was Urteilsvermögen braucht. Ehrlich gesagt ist es für die meisten Haiku-5.5-Nutzer ein Rückschritt, kein Seitwärtsschritt.
7. Gemini 3.8 Flash
Am besten für: lange Agentenaufgaben für Teams, die schon in Google Cloud sind und bei denen sich das zusätzliche Reasoning des Modells auszahlt.
Was es besser macht als Haiku 5.5
Pauschalpreise über ein 1M-Fenster und eine starke Leistung bei langer agentischer Arbeit, dazu das ganze Google-Werkzeugset (Search Grounding, eine kostenlose Stufe, Vertex AI). Gemini 3.8 Flash erreicht bei AA mit hohem Effort 41 Punkte, nahe an Haiku 5.5, und ist die naheliegende Wahl, wenn Ihre Daten und Verträge ohnehin in Google Cloud liegen.
Wo es schwächelt
Hauptsächlich Kosten und Wartezeit. AA setzt es bei $1.24 pro Aufgabe an, etwa das 6-Fache von Haiku 5.5, und der Preis auf Googles Preisseite verdoppelt sich am 1. Januar 2027 von $0.75/$3.75 auf $1.50/$7.50. AA hat beim Launch außerdem 13.3 Sekunden bis zum ersten Token gemessen, was mein Gemini-3.8-Flash-Test als Problem für alles markiert, was ein Kunde mitansieht. Der Temperature-Rat ist derselbe wie bei Flash-Lite: bei 1.0 lassen.
Preise
| Tarif | Bis 31. Dez. 2026 | Ab 1. Jan. 2027 |
|---|---|---|
| Input | $0.75 | $1.50 |
| Output, Thinking eingeschlossen | $3.75 | $7.50 |
| Cache-Lesen | $0.075 | $0.15 |
| Batch Input / Output | $0.375 / $1.875 | $0.75 / $3.75 |
Quelle: Gemini-API-Preise. Der Beitrag zu den Gemini-3.8-Flash-Preisen enthält die Prioritätsstufe.
Mein Fazit
Kein gleichwertiger Haiku-Ersatz. Es ist ein teureres Modell für schwerere Agentenarbeit, und damit macht die Preisänderung im Januar es nächstes Jahr zu einem schlechteren Angebot. Wenn Sie die Google-Option wollen, kalkulieren Sie schon jetzt mit dem Tarif von 2027. Der Beitrag zu den Gemini-3.8-Flash-Alternativen behandelt diese Klasse.
Das Temperature-0-Problem folgt Ihnen
Das ist der Grund, den ich am häufigsten höre, wenn Teams erklären, warum sie wechseln, und deshalb bekommt er einen eigenen Abschnitt. Haiku 5.5 liefert bei jedem nicht standardmäßigen temperature einen Fehler, und viele Ticket-Triage-Pipelines wurden auf Temperature 0 für konsistente Labels gebaut, plus Prefill, um eine öffnende JSON-Klammer zu erzwingen.
Das Unbequeme ist also, dass sich der Rest der günstigen Klasse in dieselbe Richtung bewegt hat.
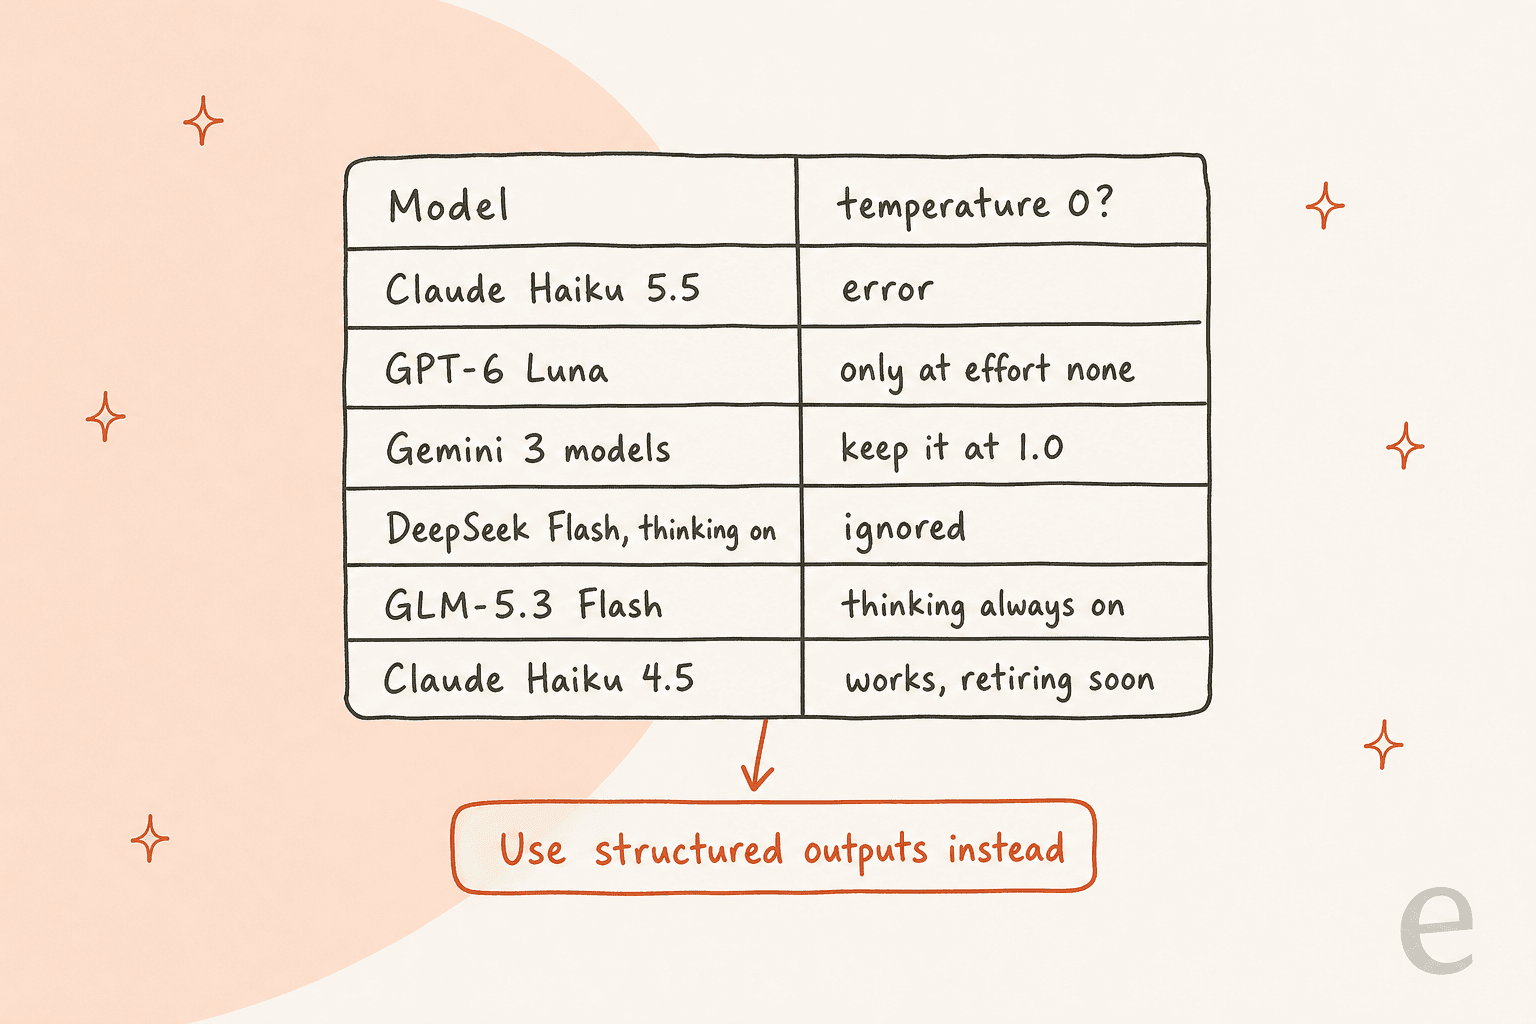
Reasoning-Modelle sampeln ihr Denken, und die Anbieter haben entschieden, dass niedrige Temperaturen mehr schaden als nützen. Der Anbieterwechsel, um Temperature 0 zu behalten, kauft Ihnen höchstens ein paar Monate. Die dauerhafte Lösung ist also, sich für Konsistenz nicht mehr auf Sampling zu verlassen.
- Nutzen Sie strukturierte Ausgaben oder strikte Tool-Schemas, um ein festes Label-Set zu erzwingen. Das Modell kann dann nur mit einer Ihrer Kategorien antworten, egal bei welcher Temperature.
- Lassen Sie Prefill weg. Beenden Sie Ihre Nachrichten mit einem User-Turn und legen Sie die Formatregel in den Prompt oder das Schema.
- Fahren Sie bei Klassifizierung niedrigen Effort. Weniger Denken heißt weniger Chancen abzuschweifen und außerdem eine niedrigere Rechnung.
- Messen Sie Konsistenz, nehmen Sie sie nicht an. Lassen Sie dieselben 200 Tickets zweimal laufen und zählen Sie die Label-Wechsel. Diese Zahl sagt mehr als jede Temperature-Einstellung.
Aus eesels Vertriebsgesprächen gibt es eine verwandte Lektion. Ein CX-Leiter einer DTC-Marke für Nahrungsergänzungsmittel, der etwa 7.000 Tickets im Monat bearbeitet, sagte dem Team, was er wirklich wollte:
"I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist das eigentliche Ziel hinter den meisten Temperature-0-Setups. Nicht identischer Wortlaut, sondern zu wissen, wann das Modell sicher ist. Konfidenzbasiertes Routing, bei dem die KI beantwortet, was sie sicher kann, und den Rest einem Menschen überlässt, bringt Sie zuverlässiger dorthin als jede Sampling-Einstellung und funktioniert bei jedem Modell dieser Liste gleich.
Welche Claude-Haiku-5.5-Alternative zu welchem Job passt
So würde ich entscheiden, nach Job statt nach Benchmark.
| Sie betreiben | Meine Wahl | Warum |
|---|---|---|
| Kurze Klassifizierung, Tagging, Routing | Bei Haiku 5.5 bleiben, oder Luna, wenn die Kosten pro Aufgabe zählen | Beide $0.10/$0.50 unter 100k; Luna schreibt weniger Tokens |
| Agentenschleifen über 100k Tokens | GPT-6 Luna | Der Sprung kommt bei 272k und nur mit 2x / 1.5x |
| Long-Context-Batch-Zusammenfassungen | DeepSeek V4.1 Flash, außerhalb der Spitzenzeit | Pauschal $0.15 / $0.60 bis 1M Tokens |
| Pipelines mit Temperature 0 oder Prefill | Kurzfristig Haiku 4.5, langfristig strukturierte Ausgaben | Jedes Reasoning-Modell schränkt Sampling ein |
| Agentisches Coding | Claude Sonnet 5.5 | 70.6% gegenüber 39.2% auf Terminal-Bench 4.0 |
| Offene Gewichte oder Self-Hosting | GLM-5.3 Flash oder DeepSeek V4.1 Flash | AA 42 und 39, beide auf Hugging Face |
| Einfaches Filtern in riesigem Volumen | Gemini 3.5 Flash-Lite | 346 tok/s, am wenigsten wortreich |
Noch ein praktischer Punkt vor der Migration. Die meisten Teams enden mit zwei Modellen, nicht einem: einem günstigen für die Masse und einem klügeren für die Eskalationen. Dieses Muster funktioniert mit jedem Paar hier, Sie sind also nicht an einen Anbieter gebunden. Für den Support gehen mein Leitfaden dazu, welches LLM zum Support passt, und die Liste der besten KI-Modelle für Tickets weiter in die Breite.
Probieren Sie eesel, statt Ihre Ticket-Pipeline neu zu bauen
Wenn Sie eine Haiku-5.5-Alternative für eine Support-Warteschlange suchen, ist das Modell ehrlich gesagt die kleinere Hälfte des Problems. eesel ist ein KI-Helpdesk-Teammitglied, das in den Helpdesk einsteigt, den Sie schon nutzen, etwa Zendesk, Freshdesk oder Gorgias, aus Ihren vergangenen Tickets und Ihrem Help Center lernt und Ticketklassifizierung, Zusammenfassungen und Antworten übernimmt. Wenn ein Anbieter eine Preisklippe einbaut oder einen Parameter ablehnt, ist das eesels Migration, nicht Ihre.

Bevor es auch nur einen Kunden beantwortet, wird jeder Rollout gegen Ihre historischen Tickets simuliert, sodass Sie sehen, welche Tickets es lösen würde und welche es an Ihr Team übergibt. Das gibt Ihnen das konfidenzbasierte Routing, nach dem der CX-Leiter mit den 7.000 Tickets gefragt hat, ganz ohne Temperature-Einstellung.
Wenn Sie im Terminal arbeiten, steuert die eesel-CLI dasselbe Teammitglied und denselben Workspace wie das Dashboard. Sie können sie skripten oder in CI einbinden, und Sie können auch einen Coding-Agenten wie Claude Code sie bedienen lassen. Mein Beitrag zur KI-Agenten-CLI behandelt dieses Setup.
Bezahlte Tarife beginnen bei $299 für 500 Credits, und Sie können es vorher kostenlos an einem Ausschnitt Ihrer echten Tickets testen. Probieren Sie eesel aus.