

Was ist Claude Haiku 5.5?
Claude Haiku 5.5 ist das kleine Modell in Anthropics aktueller Modellreihe. Du greifst danach, wenn eine Aufgabe tausende Male am Tag läuft und jeder einzelne Durchlauf kurz ist. Anthropics Launch-Beitrag nennt es "the cheapest, fastest, and most capable small model we've ever released" und führt die Aufgaben auf, für die es gebaut wurde: Zusammenfassungen, Kompaktierungen, Datenbankabfragen, Klassifizierung, Live-Kundensupport und Browser-Nutzung.
Ich baue bei eesel KI-Agenten, und ehrlich gesagt ist das meiste, was diese Agenten den ganzen Tag tun, gar kein schweres Schlussfolgern. Sie lesen ein Ticket und entscheiden, wohin es geht, sie ziehen eine Bestellnummer aus einer Nachricht, manchmal schreiben sie eine Zusammenfassung in drei Zeilen, damit die nächste Person nicht scrollen muss. Jahrelang saß diese Arbeit an einer unbequemen Stelle: Ein gutes Modell war dafür zu teuer, und ein billiges Modell hat sie ständig vermasselt. Haiku 5.5 zielt genau auf diese Stelle.
Auch in Anthropics Sortiment gab es eine Lücke, und die wird hiermit geschlossen. Vor diesem Launch war das günstigste aktuelle Claude Sonnet 5.5 für $2/$10, und Haiku 4.5 für $1/$5 war gegenüber günstigeren Konkurrenten wie GPT-6 Luna deutlich zurückgefallen. Wie ein Entwickler eine Woche vor dem Launch auf X schrieb, war der Markt für kleine, günstige Modelle "mostly chinese labs", mit Luna als einziger Ausnahme.
Claude Haiku 5.5 Spezifikationen im Überblick
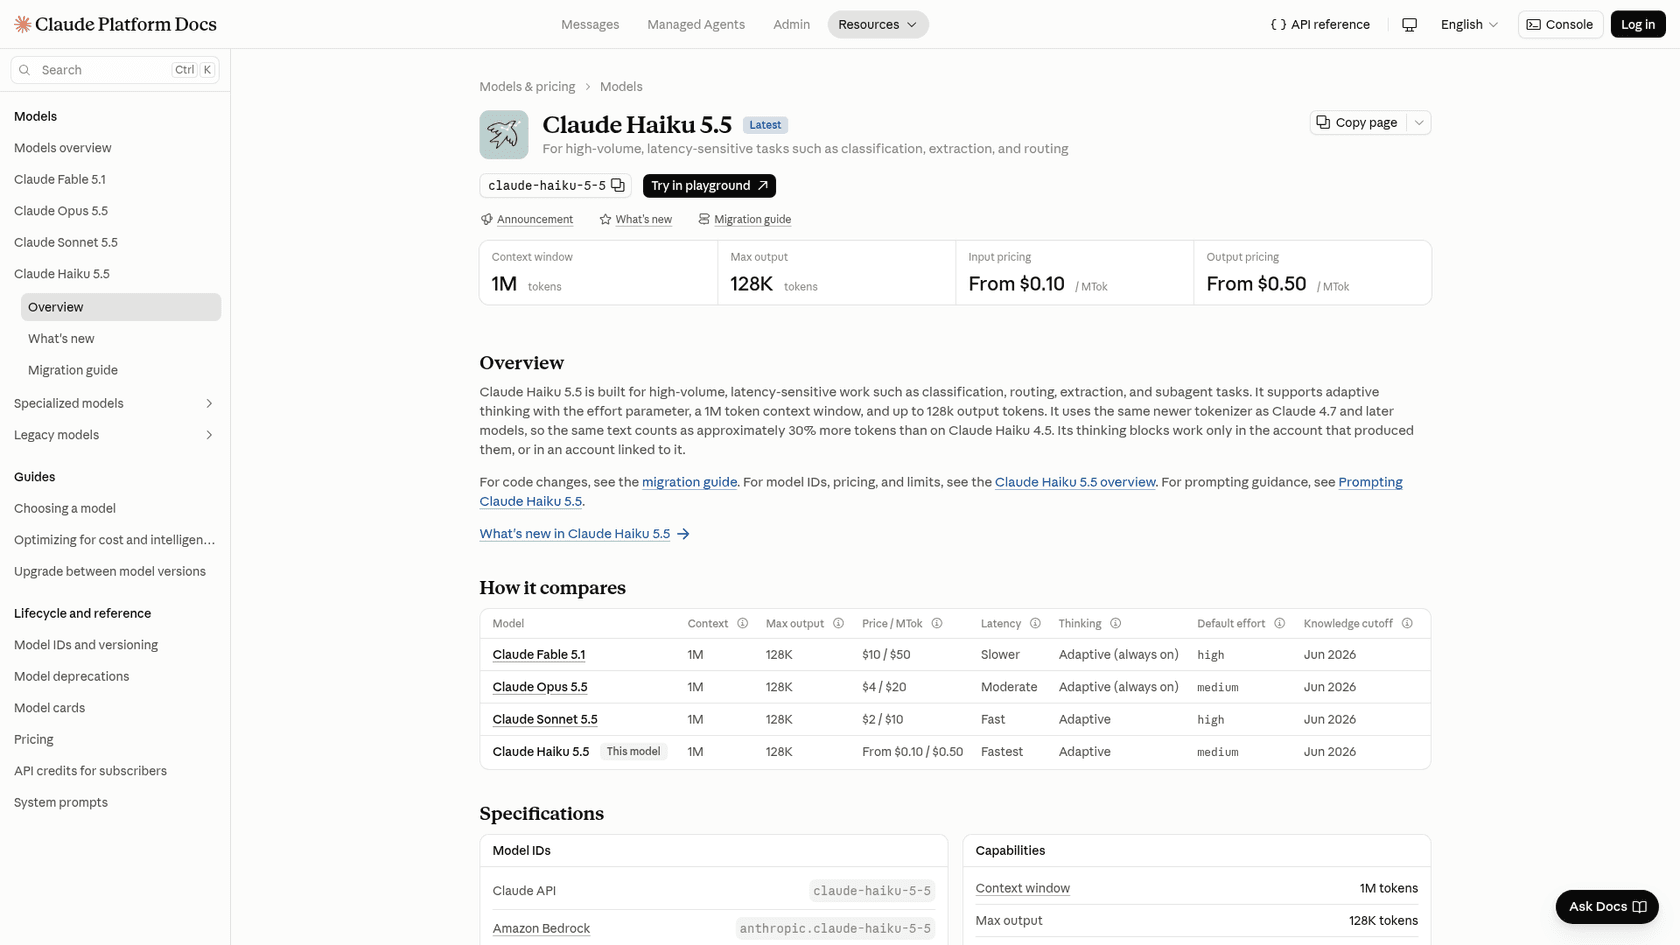
Das ist das Datenblatt, wie es aktuell aussieht, entnommen der Haiku-5.5-Übersichtsseite in Anthropics Docs.
| Spezifikation | Claude Haiku 5.5 |
|---|---|
| API-Modell-ID | claude-haiku-5-5 (kein Datumssuffix, kein separater Alias) |
| Amazon-Bedrock-ID | anthropic.claude-haiku-5-5 |
| Veröffentlicht | 7. Oktober 2026 |
| Kontextfenster | 1M Tokens |
| Max. Output | 128K Tokens (300K in der Batch API, in Beta) |
| Denken | Adaptiv, standardmäßig aktiv |
| Standard-Effort | medium |
| Input / Output | Text und Bilder rein, Text raus |
| Wissensstand | Juni 2026 |
| Plattformen | Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry, Claude Platform on AWS |
| Abkündigung | Nicht vor dem 7. Oktober 2027 |
Ein paar Details in dieser Tabelle gehen leicht unter. Erstens hat die Modell-ID keinen datierten Snapshot, claude-haiku-5-5 ist also der feste Name und kein Alias, der sich später verschiebt. Zweitens kann die Batch API mit einem Beta-Header bis zu 300K Output-Tokens liefern, was praktisch ist, wenn du Haiku über Nacht lange strukturierte Dateien schreiben lässt.
Wo Haiku 5.5 in der Claude-Reihe steht
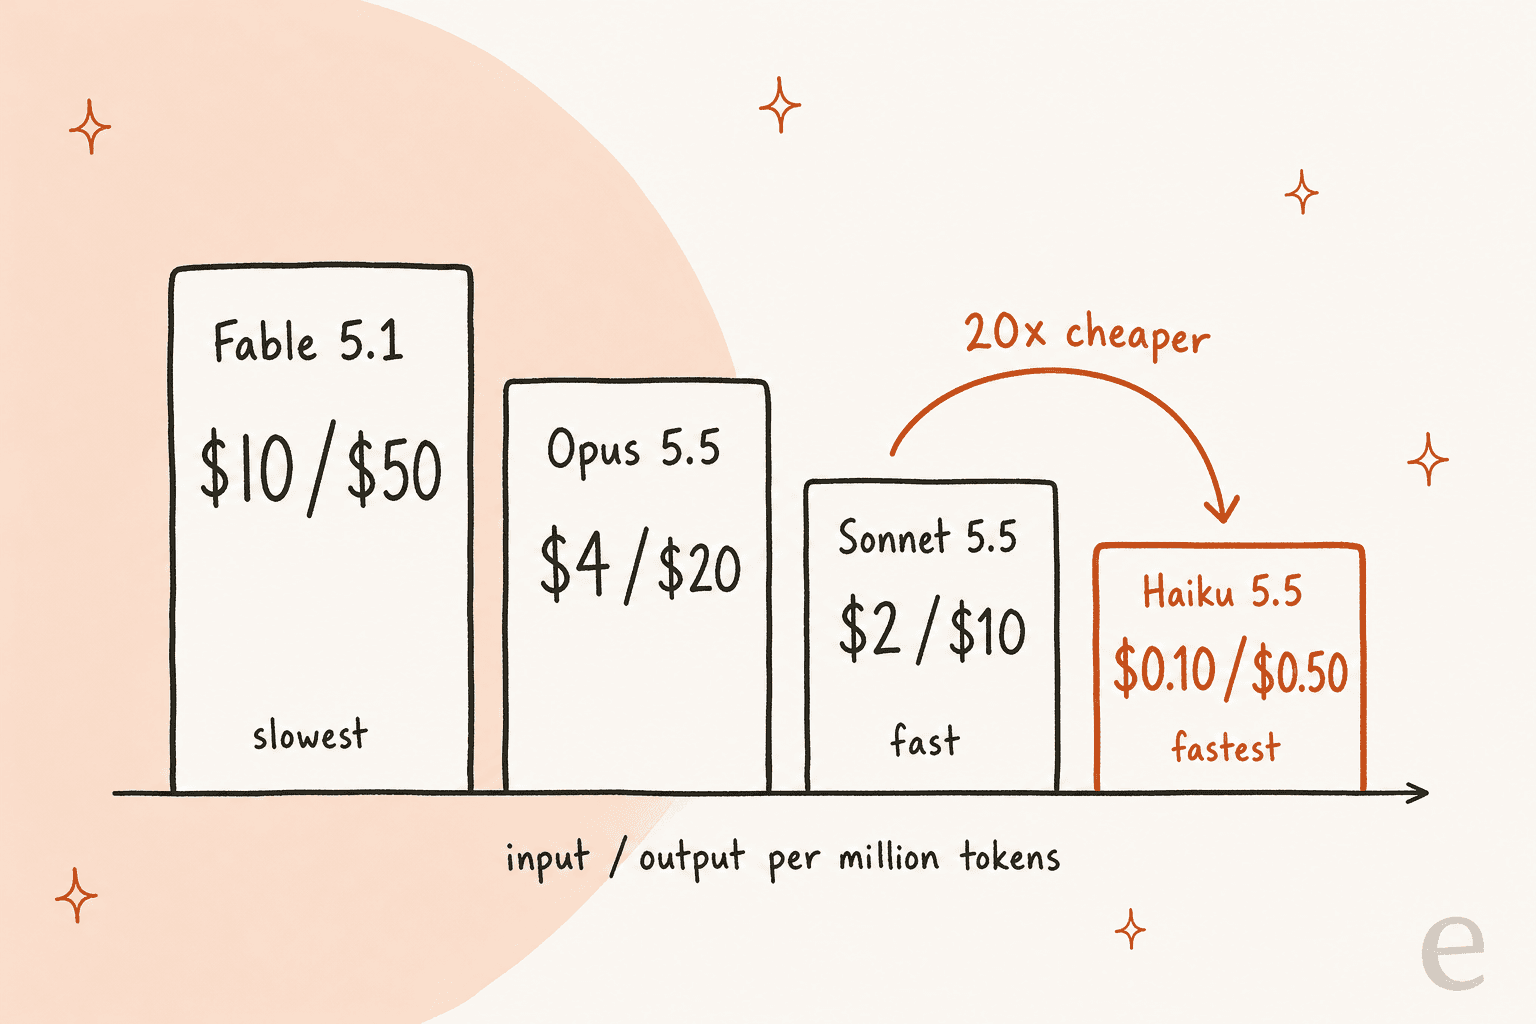
Anthropic betreibt jetzt vier aktuelle Modelle. Haiku 5.5 steht am unteren Ende der Leiter, und das ist hier das schnelle und günstige Ende.
| Modell | Am besten für | Latenz | Preis Input / Output pro 1M | Standard-Effort |
|---|---|---|---|---|
| Claude Fable 5.1 | Anspruchsvolles Schlussfolgern, Agenten mit langem Horizont | Langsamer | $10 / $50 | high |
| Claude Opus 5.5 | Lang laufendes agentisches Coding und Wissensarbeit | Mittel | $4 / $20 | medium |
| Claude Sonnet 5.5 | Beste Mischung aus Geschwindigkeit und Intelligenz | Schnell | $2 / $10 | high |
| Claude Haiku 5.5 | Klassifizierung, Extraktion, Routing, Subagenten | Am schnellsten | Ab $0.10 / ab $0.50 | medium |
Alle vier teilen sich laut Modellübersicht dasselbe 1M-Kontextfenster, dasselbe Output-Limit von 128K und den Wissensstand Juni 2026. Das Fenster ist kein Grund mehr, das eine Modell dem anderen vorzuziehen. Entscheidend sind jetzt Preis und Geschwindigkeit sowie die Frage, wie schwer die Aufgabe wirklich ist.
Anthropic tut auch nicht so, als wäre Haiku ein billiges Sonnet. Im Launch-Beitrag heißt es, Sonnet 5.5 und Opus 5.5 "remain better choices for complex agentic coding tasks", und dass Haiku 5.5 für eng umrissene Arbeit wie Kompaktierung, Zusammenfassung und Subagent-Aufgaben taugt. Für mich ist dieser Satz mehr wert als alles andere in der Ankündigung, und ich behalte ihn bei jeder Entscheidung unten im Kopf.
Was neu ist gegenüber Haiku 4.5
Haiku 4.5 erschien ein Jahr vor diesem. Nach der Versionsnummer würde man einen kleinen Schritt erwarten, aber der Sprung ist deutlich größer.
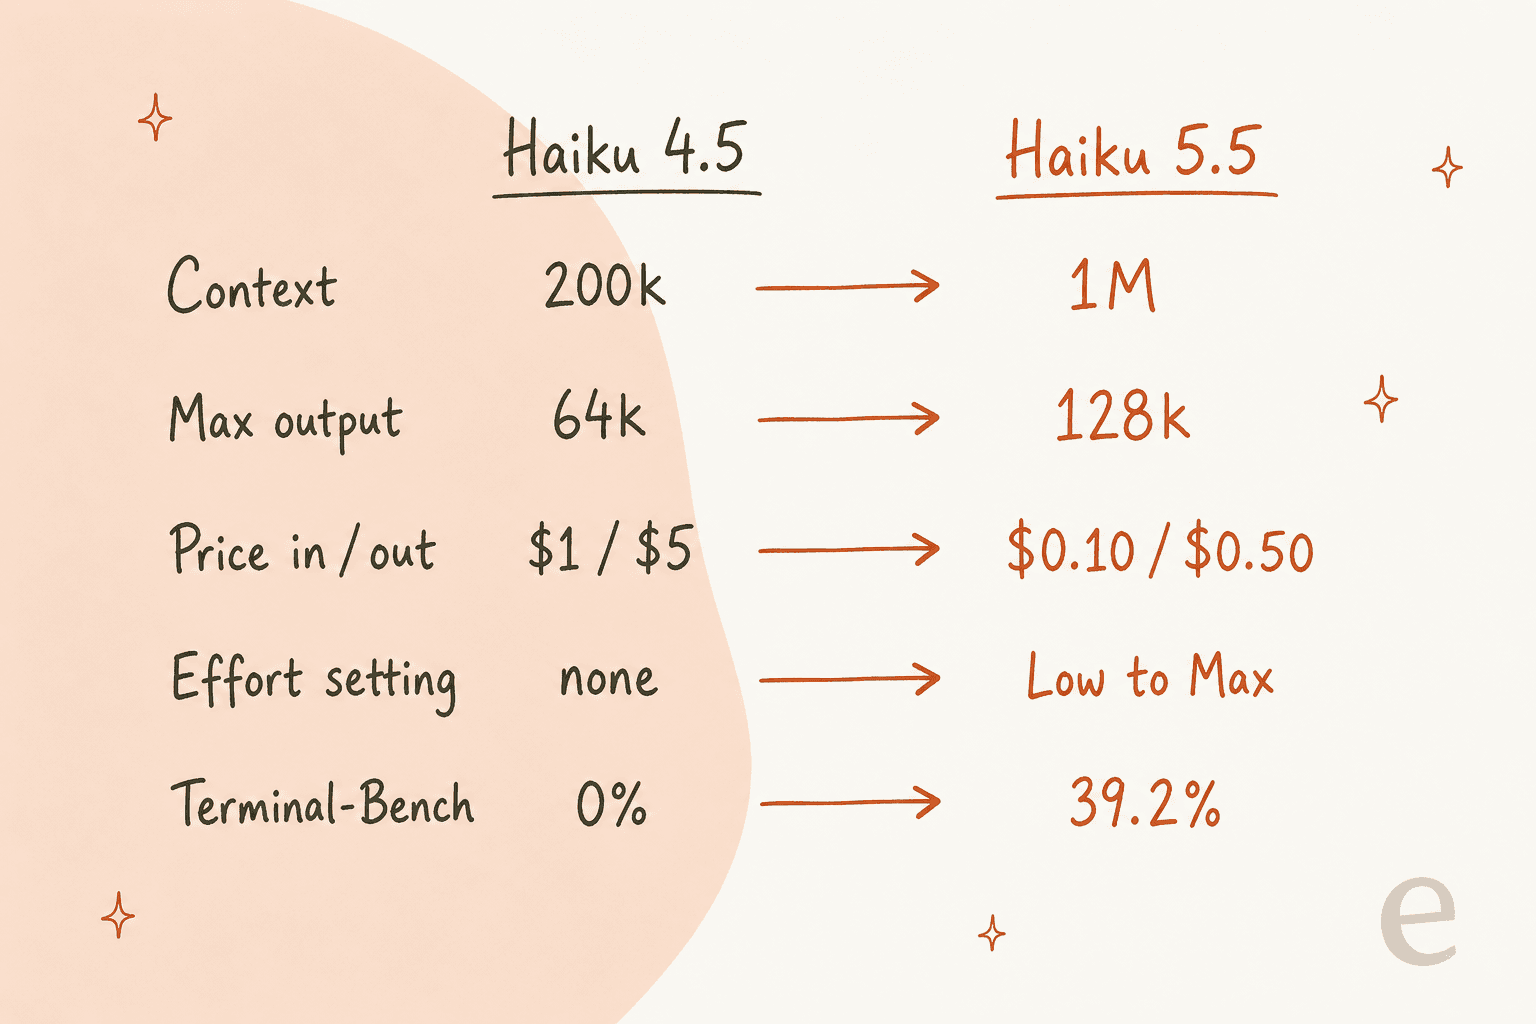
Anthropics What's-new-Seite listet 13 Änderungen auf: 4 neue Fähigkeiten, 5 Breaking Changes und 4 Verhaltensänderungen. Unten gehe ich nur die durch, die ändern, wie du das Modell tatsächlich nutzt.
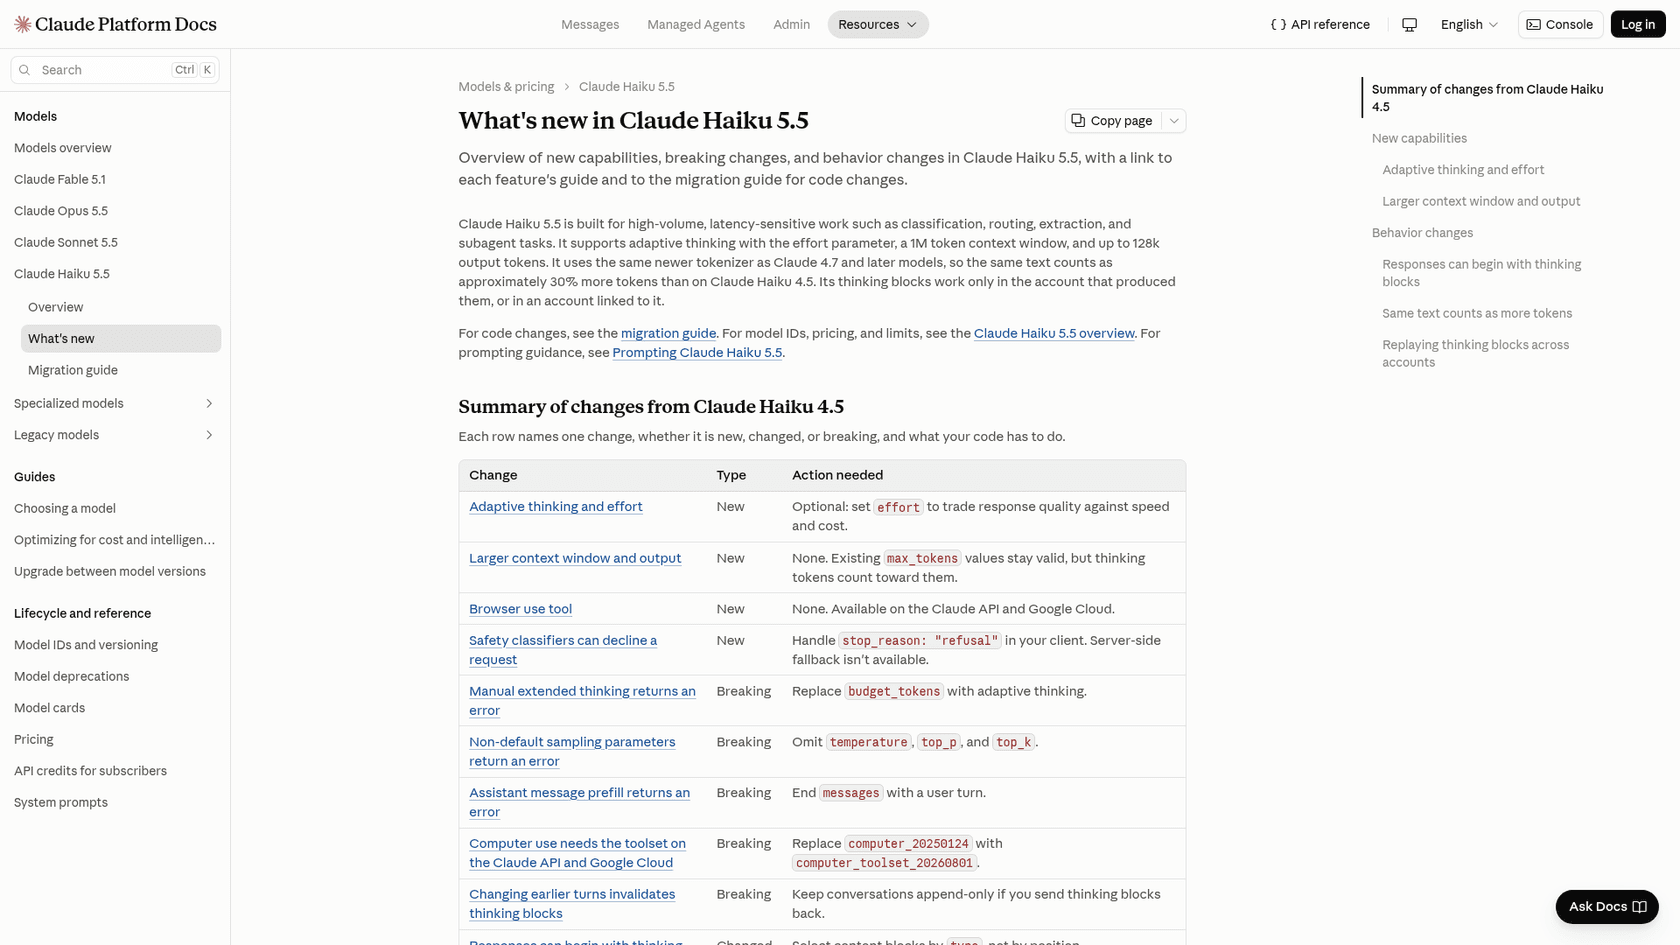
Adaptives Denken und eine Effort-Einstellung
Haiku 5.5 ist das erste Modell der Haiku-Klasse mit einstellbarem Effort. Das Denken ist adaptiv und standardmäßig aktiv. In der Praxis entscheidet das Modell selbst, wann und wie lange es denkt, und dein Hebel ist effort statt eines festen Denkbudgets. Bei niedrigerem Effort bekommt eine einfache Anfrage unter Umständen gar kein Denken. Was jede Stufe bewirkt, behandle ich weiter unten.
Ein 1M-Fenster und 128K Outputs
Der Kontext wuchs von 200k auf 1M Tokens und der maximale Output von 64k auf 128K. Aufgepasst: Denk-Tokens zählen zu max_tokens. Wenn du dieses Limit für Haiku 4.5 knapp eingestellt hast, kann die Antwort jetzt direkt nach dem Thinking-Block enden, noch bevor Text kommt.
Browser- und Computer-Nutzung
Haiku 5.5 unterstützt das Browser-Use-Tool auf der Claude API und Google Cloud, und Anthropic hat am selben Tag ein Browser- und Computer-Use-SDK für Python und TypeScript veröffentlicht. Laut Anthropic ist Haiku 5.5 wegen Geschwindigkeit und Preis für diese Aufgaben "especially well-suited". Der OSWorld-2.1-Wert von 72,4 % (gegenüber 15,7 % bei Haiku 4.5) stützt diese Aussage.
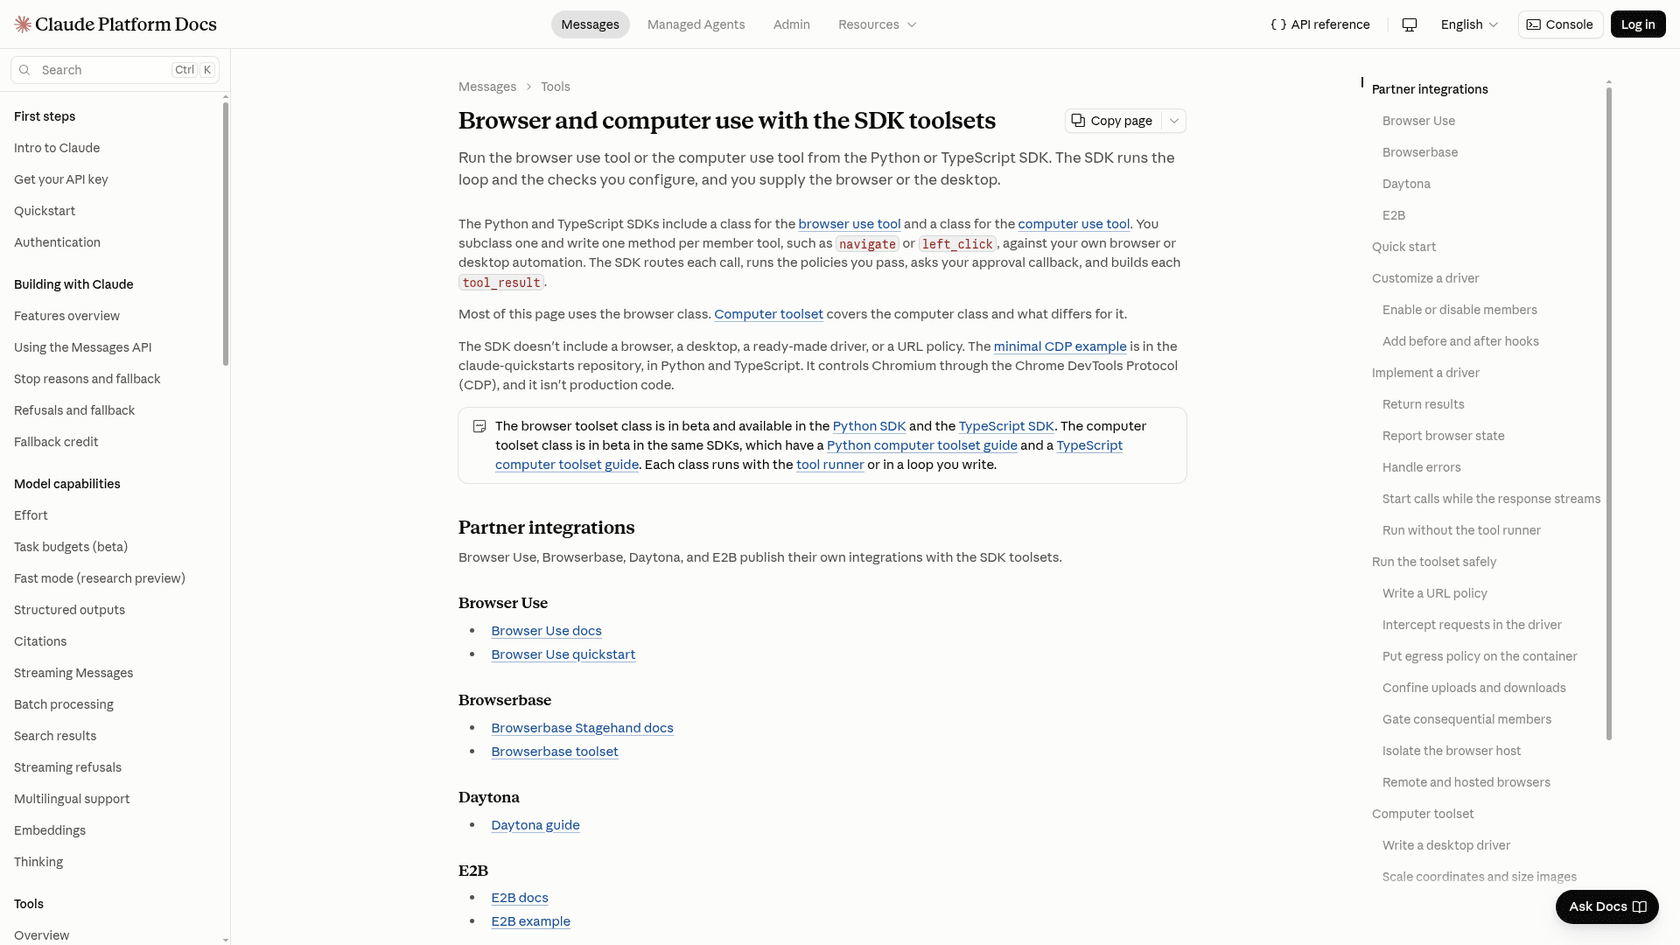
Gut zu wissen, bevor du dich freust: Das SDK kommt ohne Browser, ohne Desktop und ohne URL-Richtlinie. Den Treiber musst du selbst mitbringen, und die Starter-Beispiele in den Docs tragen den Hinweis "not production code". Wenn du keine Lust hast, selbst einen zu schreiben, veröffentlichen Browser Use, Browserbase, Daytona und E2B bereits fertige Integrationen.
Ein neuer Tokenizer
Haiku 5.5 nutzt denselben neueren Tokenizer wie Sonnet 5.5 und Opus 5.5, und laut Migrationsleitfaden erzeugt derselbe Text etwa 30 % mehr Tokens als bei Haiku 4.5. Das erklärt, warum Anthropics eigene Schlagzeilenzahl "around 75% less to run" lautet und nicht 90 %. Pro Token ist der Preis um 90 % gefallen, nur verbraucht jede Aufgabe jetzt mehr Tokens.
Wie die Effort-Einstellung Haiku 5.5 verändert
Wenn ich meine Zeit nur auf einen Teil von Haiku 5.5 verwenden dürfte, wäre es dieser, denn nichts anderes verändert das Verhalten des Modells so stark. Die Effort-Docs beschreiben fünf Stufen, und Haiku nutzt standardmäßig medium, wo die meisten Claude-Modelle high verwenden.
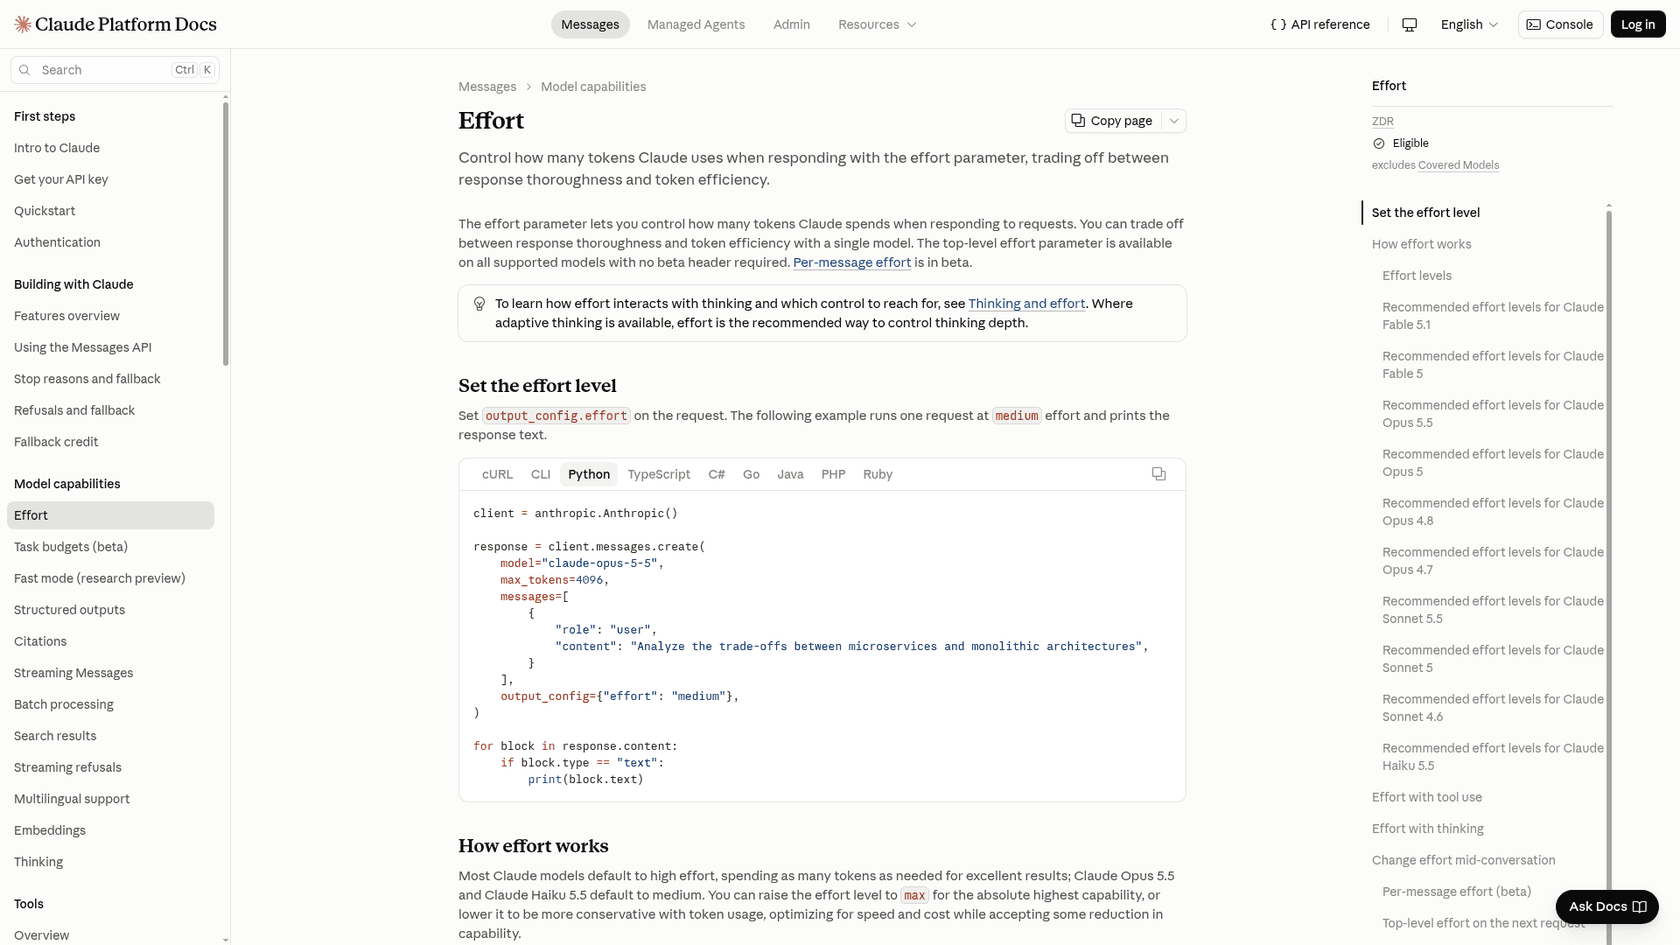
Artificial Analysis hat Haiku 5.5 auf jeder Stufe getestet, und der Kompromiss ist alles andere als subtil. Der Intelligence-Index-Wert steigt von 29,4 bei Low auf 43,4 bei Max, aber die Zeit bis zum ersten Output-Stück, Denken eingeschlossen, wächst von etwa 14 Sekunden auf 415 Sekunden.
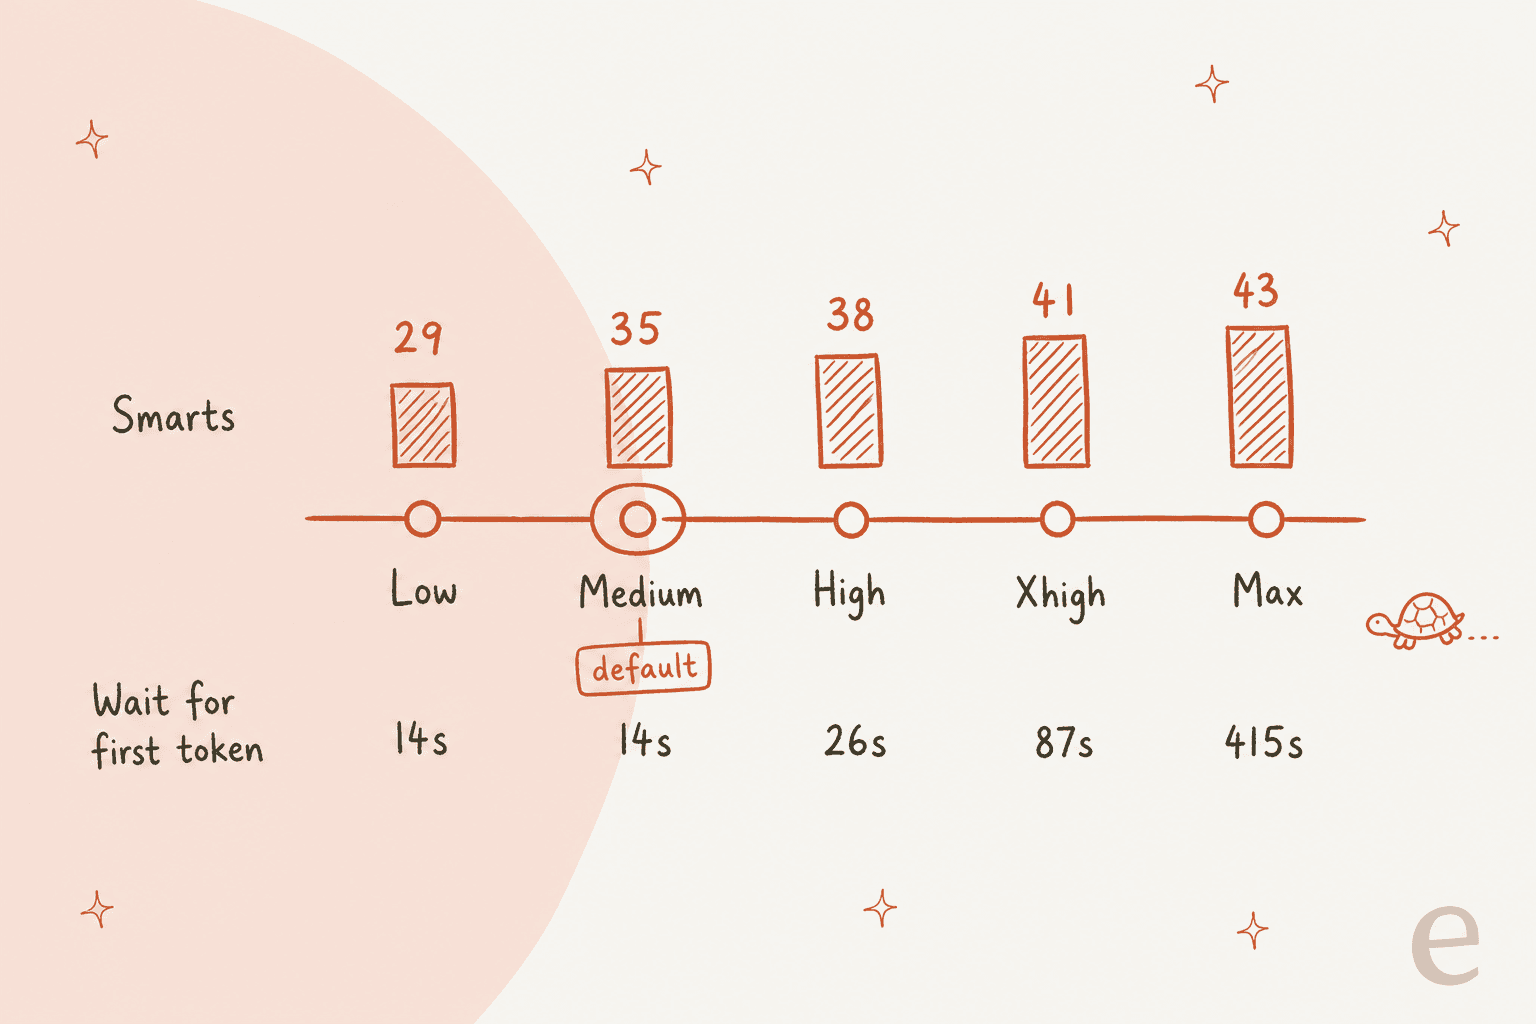
| Effort | AA Intelligence Index | Output-Tokens für den Index-Lauf | Output-Geschwindigkeit | Zeit bis zum ersten Stück |
|---|---|---|---|---|
| Low | 29.4 | 32M | 181 tokens/s | 13.6 s |
| Medium (Standard) | 34.5 | 54M | 137 tokens/s | 14.2 s |
| High | 37.8 | 97M | 173 tokens/s | 26.2 s |
| Xhigh | 41.2 | 180M | 188 tokens/s | 86.8 s |
| Max | 43.4 | 440M | 243 tokens/s | 415.3 s |
Ich lese diese Tabelle eher wie eine versteckte Preisliste. Der Wechsel von Medium auf Max bringt 9 Punkte, und du bezahlst sie mit etwa dem 8-Fachen an Output-Tokens. Artificial Analysis merkte in seinem Launch-Beitrag auf X außerdem an, dass der Wechsel von Xhigh auf Max "adds 2 points for ~1.8x the tokens".
Bei einer winzigen Aufgabe zeichnet Simon Willisons Pelikan-Test dieselbe Kurve nach:
"Low messes up the bicycle frame, but medium/high/xhigh/max all get the bicycle frame right. The max one took 5 minutes 9 seconds and cost 3.3826 cents. The cheapest one (low) cost 0.0936 cents and took 7 seconds."

Die Faustregel, bei der ich durch den Bau von Agenten gelandet bin, lautet so: Alles mit festem Antwortsatz, etwa Tags oder Routing, startet bei Low. Alles, was Prosa schreibt, die ein Kunde liest, startet bei Medium. Und wenn eine Aufgabe nur bei High oder höher richtig herauskommt, war es meistens von Anfang an eine Sonnet-Aufgabe.
Wie gut ist Claude Haiku 5.5?
Für seine Größe ist es sehr gut, auch wenn man merkt, dass es ein kleines Modell ist. Unten stehen Anthropics veröffentlichte Benchmarks bei den Schlagzeilen-Einstellungen.
| Benchmark | Haiku 5.5 | Haiku 4.5 | GPT-6 Luna | Sonnet 5.5 |
|---|---|---|---|---|
| GDPval-AA v2.1 (Wissensarbeit, Elo) | 1620 | 735 | 1437 | 1840 |
| AA-Briefcase v1.1 (Wissensarbeit, Elo) | 1578 | 614 | 1336 | 1824 |
| OSWorld 2.1 (Computer-Nutzung) | 72.4% | 15.7% | 48.9% | 83.9% |
| Humanity's Last Exam (ohne Tools) | 45.9% | 10.2% | n/a | 56.9% |
| Terminal-Bench 4.0 (agentisches Coding) | 39.2% | 0.0% | 16.4% | 70.6% |
| FrontierCode 1.1 (agentisches Coding) | 46.4% | n/a | 42.4% | 52.1% |
| Chartography (visuelles Schlussfolgern, ohne Tools) | 46.4% | 6.4% | 29.1% | 61.6% |
Das Muster zieht sich durch alle Tests. Überall, wo getestet wurde, schlägt Haiku 5.5 GPT-6 Luna, und bei Wissensarbeit und Computer-Nutzung liegt es nah an Sonnet 5.5. Bei langem agentischem Coding fällt es deutlich hinter Sonnet zurück.
Auf der Launch-Seite erzählen die frühen Kundenberichte mehr oder weniger dieselbe Geschichte, nur in einfacheren Worten. HubSpot sagte, es habe bei seinen CRM-Aufgaben "the best score we've seen on this suite yet, at 92.8%" erzielt. AlphaSense maß 0,84 gegenüber 0,76 bei Haiku 4.5 bei einer Dokument-Q&A-Last von etwa 8M Aufrufen pro Woche. Box meldete 11 Punkte mehr als Haiku 4.5 bei etwa halber Latenz.
Eine Warnung von Artificial Analysis würde ich mir merken. Haiku 5.5 kennt weniger Fakten als die größeren Modelle und erreicht bei seinem AA-Omniscience-Test 36 % Genauigkeit, sagt aber bereitwilliger "I don't know", sodass seine Halluzinationsrate bei 40 % liegt, gegenüber 77 % bei GPT-6 Luna. Wenn ein Kunde den Output liest, ist mir diese Zahl wichtiger als der Index-Wert. Die praktische Lehre: Gib Haiku dein Help Center und verlass dich nicht auf das, was es auswendig weiß.
Claude Haiku 5.5 Preise
Von den aktuellen Claude-Modellen hat nur Haiku 5.5 zwei Preisstufen. Welche du zahlst, hängt von der Prompt-Länge ab, und die Preisseite listet jede Zeile auf.
| Preis pro 1M Tokens | Prompts bis 100.000 Tokens | Prompts über 100.000 Tokens | Haiku 4.5 (pauschal) | Sonnet 5.5 |
|---|---|---|---|---|
| Input | $0.10 | $0.50 | $1.00 | $2.00 |
| Output | $0.50 | $2.50 | $5.00 | $10.00 |
| Cache-Lesen | $0.01 | $0.05 | $0.10 | $0.10 |
| Cache-Schreiben 5 Minuten | $0.125 | $0.625 | $1.25 | $2.50 |
| Cache-Schreiben 1 Stunde | $0.20 | $1.00 | $2.00 | $4.00 |
| Batch API | 50 % Rabatt auf Input und Output | 50 % Rabatt | 50 % Rabatt | 50 % Rabatt |
Anthropic hat die Grenze bei 100.000 Tokens gezogen, weil laut Launch-Beitrag rund 90 % der Anfragen an Haiku 4.5 darunter lagen. Bei einer Last in dieser Form entspricht Haiku 5.5 dem Listenpreis von GPT-6 Luna mit $0.10/$0.50. Bei einer anderen Form hat der HN-Thread schnell gerechnet:
"100k tokens is an absurdly low cutoff and it is only applicable to Haiku and not Sonnet or Opus. It's a low enough cutoff that it will be quickly exceeded if you are doing anything with Agents; for typical generation or Jev-like classifiers, it's a good value and as noted in this article, that is apparently the vast majority of Haiku use."
Eine leisere Lücke besteht auch zwischen Claude-Tokens und OpenAI-Tokens. Ein anderer Kommentator wies darauf hin, dass "modern Claude's 100K tokens are about ~60-65K modern GPT tokens", dasselbe Dokument erreicht Haikus Grenze also früher als die von Luna. Mehr zur Kostenseite findest du in meinem Claude-Haiku-5.5-Review und in den GPT-6-Luna-Preisen.
Trage unten deine eigenen Zahlen ein, um zu sehen, was ein Monat Aufrufe kostet und wo die 100k-Grenze zu beißen beginnt. Nutze Token-Zahlen so, wie Haiku 5.5 sie zählt.
Als Beispiel probiere 50.000 Anfragen mit 6.000 Prompt-Tokens und 800 Output-Tokens. Auf Haiku 5.5 sind das $50 im Monat, bei Sonnet 5.5 $1.000. Setze den Prompt dann auf 120.000 Tokens, und du siehst, wie Haiku auf das 5-Fache springt.
So greifst du auf Claude Haiku 5.5 zu und nutzt es
Haiku 5.5 ist auf jeder Plattform live, über die Anthropic verkauft: Claude API, Amazon Bedrock, Google Cloud, Microsoft Foundry und Claude Platform on AWS. Du kannst es auch in den claude.ai-Apps nutzen, und dort veröffentlicht Anthropic seinen System-Prompt.
Hier ein minimaler API-Aufruf. Der Effort ist explizit gesetzt, und es gibt keine Sampling-Parameter:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-haiku-5-5",
    max_tokens=4096,
    output_config={"effort": "low"},
    messages=[
        {"role": "user", "content": "Tag this ticket as billing, shipping, bug or other: ..."}
    ],
)

for block in response.content:
    if block.type == "text":
        print(block.text)
Ein paar Gewohnheiten, die mir später Debugging-Zeit gespart haben:
- Wähle Content-Blöcke nach
typeaus. Eine Antwort kann mit einem Thinking-Block beginnen, auch wenn du nie Denken angefordert hast. Nimm also nicht an, dass der erste Block die Antwort ist. - Lass
temperature,top_pundtop_kweg. Bei Haiku 5.5 führt jeder Nicht-Standardwert zu einem 400-Fehler. - Behandle
stop_reason: "refusal". Haiku 5.5 betreibt Sicherheits-Klassifikatoren, die manchmal eine Anfrage ablehnen, und laut Migrationsleitfaden fängt kein serverseitiges Fallback-Modell das ab.
Wer einen Claude-Tarif hat, kann es jetzt mehr oder weniger kostenlos ausprobieren. Ab der Launch-Woche gibt Anthropic Max- und Team-Abonnenten monatliches API-Guthaben: $100 im Monat bei Max 5x, $200 bei Max 20x und bis zu $500 gemeinsam bei Team. Du kannst das Guthaben für jedes Modell ausgeben. Nicht abgedeckt sind interaktive Claude-Code-Sitzungen.
In Claude Code selbst ist Haiku eine häufige Wahl für Subagenten, und mein Leitfaden zur Claude-Code-Modellauswahl erklärt, wann du wechseln solltest.
Was kaputtgeht, wenn du von Haiku 4.5 wechselst
Haiku 5.5 als Drop-in-Ersatz zu bezeichnen stimmt nur, wenn dein Code schon für die neueren Claude-Modelle geschrieben war. Der Migrationsleitfaden hat eine Checkliste mit 10 Schritten, und diese fünf liefern Fehler:
| Was dein Code heute tut | Was bei Haiku 5.5 passiert | Die Lösung |
|---|---|---|
Sendet thinking mit budget_tokens | 400-Fehler | Nutze {"type": "adaptive"} und setze effort |
Setzt temperature, top_p oder top_k | 400-Fehler | Entferne sie |
Beendet messages mit einem Assistant-Turn (Prefill) | 400-Fehler | Ende mit einem User-Turn, nutze Structured Outputs |
Nutzt computer_20250124 auf der Claude API oder Google Cloud | Abgelehnt | Wechsle zu computer_toolset_20260801 |
| Ändert frühere Turns und schickt Thinking-Blöcke zurück | Thinking-Blöcke ungültig | Halte die Unterhaltung append-only |
Von diesen würde ich die Temperatur-Änderung fest einplanen. Viele Klassifizierungs-Pipelines setzen temperature auf 0, um wiederholbaren Output zu bekommen, und bei Haiku 5.5 schlägt diese Anfrage einfach fehl. Willst du jetzt Konsistenz, sind Structured Outputs mit festem Schema der bessere Weg. Noch etwas: Priority Tier wird für Haiku 5.5 nicht angeboten, ein Team mit Priority-Zusage für 4.5 muss seine Kapazität also anders planen.
Wofür ist Claude Haiku 5.5 gut?
Wenn ich ein kleines Modell beurteile, frage ich zuerst nach der Aufgabe. Ist der Prompt kurz, gibt es eine klar richtige Antwort, und läuft es obendrein mit hohem Volumen? Haiku 5.5 ist für Aufgaben gebaut, bei denen die Antwort auf all das ja lautet.
| Aufgabe | Eignung | Warum |
|---|---|---|
| Ticket-Klassifizierung und Tagging | Stark | Kurze Prompts, feste Labels, Low-Effort reicht |
| Ticket-Zusammenfassungen und Übergabenotizen | Stark | Schnell bei Medium, günstig genug für jedes Ticket |
| Routing und Priorisierung | Stark | Geschwindigkeit zählt mehr als Tiefe |
| Help-Center-Antworten (RAG) | Stark, wenn Prompts unter 100k bleiben | Niedrigere Halluzinationsrate als Luna, 1M-Fenster bei Bedarf |
| Subagenten unter einem Sonnet- oder Opus-Lead | Stark | Anthropic und Cognition verweisen beide auf diesen Einsatz |
| Browser- und Computer-Nutzung | Gut | 72,4 % bei OSWorld 2.1, schnellstes Claude |
| Lange Agenten-Schleifen und schweres Coding | Schwach | 39,2 % gegenüber 70,6 % bei Sonnet 5.5 auf Terminal-Bench 4.0 |
Geschwindigkeit wird unterschätzt. In einer eesel-Evaluation prüfte ein Käufer den eesel-Support-Bot in einem sorgfältigen Review mit 67 Tests und fand die Wissensantworten solide. Er sprang trotzdem ab, weil sich das Chat-Widget langsam anfühlte und hängen blieb. Gute Antworten konnten ein langsames Erlebnis nicht retten. Haiku 5.5 ist Anthropics schnellstes Modell bei Standardgeschwindigkeit, und eine auf HN geteilte OpenRouter-Messung sieht es bei etwa dem Doppelten von Lunas Durchsatz, es spricht also genau diese Art verlorener Abschlüsse an.
Auf Hacker News mochten es die Entwickler am meisten, die genau diese Art kurzer, fundierter Aufgaben erledigen:
"Tested on my RAG system containing all of cloudflare docs (more than 3000 A4 sized highly technical documents): best
quality*speed/priceratio of any other model. And I have tested more than a 100 different models."
Ein anderer Tester gab ihm eine zu große Aufgabe, und es schien seine eigenen Grenzen zu kennen:
"One interesting thing is it took a look at the job at hand, and immediately delegated it to Opus 5.5. It at least knows what it isn't good at. Very fast though, and likely best used for small subagent tasks / tightly scoped work."
Was Entwickler sagen
Der Hacker-News-Launch-Thread war bei Preis und Geschwindigkeit überwiegend positiv. Die echten Beschwerden liefen auf zwei hinaus: die 100k-Grenze und Teams, deren eigene Evals nicht zu Anthropics Diagrammen passten.
"It's absolutely better than Luna. It feels closer to a "sonnet 5.2" if that makes sense. Of course it's not as big, and hence falls-off quicker."
"At work we use haiku 4.5 for a handful of latency sensitive tasks that are fairly simple. It performs well. Just started testing 5.5 as I've been anticipating a nice improvement since it was teased. Results so far are trash. Prompt leakage even. And it's slower."
Den zweiten Kommentar würde ich ernst nehmen. Haiku 4.5 lief standardmäßig ohne Denken, ein darauf abgestimmter Prompt kann sich also anders verhalten bei einem Modell, das gleich ab Werk bei Medium-Effort denkt. Anthropic hat dafür einen Prompting-Leitfaden für Haiku 5.5 veröffentlicht. Wenn ein migrierter Prompt langsamer wird, wäre mein erster Schritt, den Effort auf Low zu senken.
Das weitere Feld kleiner Modelle behandle ich in meinen Beiträgen zu Claude-Haiku-5.5-Alternativen, Gemini 3.8 Flash und GLM-5.3 Flash.
Haiku-schnelle Antworten in deiner Support-Queue mit eesel
Wenn du wegen einer Support-Queue über Haiku 5.5 liest, ist das Modell der leichte Teil. Der schwere Teil ist alles drumherum: welche Tickets das schnelle Modell bekommen, wie Prompts unter der 100k-Grenze bleiben, mit welchem Effort jede Aufgabe läuft und wie falsche Antworten abgefangen werden, bevor ein Kunde je eine sieht.
Diese Arbeit nimmt dir eesels KI-Helpdesk-Teammate ab. Es zieht in den Helpdesk ein, den du schon nutzt, etwa Zendesk, Freshdesk oder Gorgias, lernt aus deinen vergangenen Tickets und deinem Help Center und sortiert, taggt, fasst zusammen und antwortet. Jeder Rollout wird gegen deine historischen Tickets simuliert, bevor er mit einem einzigen Kunden spricht, sodass du zuerst siehst, wie er die Queue des letzten Monats bearbeitet hätte.

Wenn du es lieber vom Terminal aus steuerst: Die eesel-CLI führt dasselbe Teammate und denselben Workspace aus wie das Dashboard, sodass ein Skript oder ein Coding-Agent wie Claude Code es einrichten und seine Arbeit prüfen kann. Im Grunde ist es das Lead-und-Sidekick-Muster, das Anthropic für Haiku empfiehlt, nur auf dein Support-Setup gerichtet. Meine Beiträge zur KI-Agenten-CLI und zu MCP-Servern gehen tiefer.
Tarife beginnen bei $299 für 500 Credits, du kannst es aber kostenlos an einem Ausschnitt echter Tickets laufen lassen, bevor du etwas zahlst. Probiere eesel aus und sieh, ob schnellere Antworten bei deinen Kunden wirklich ankommen.
Häufig gestellte Fragen
Was ist Claude Haiku 5.5?
claude-haiku-5-5 veröffentlicht. Es hat ein Kontextfenster von 1M Tokens, bis zu 128K Output-Tokens, adaptives Denken mit einer Effort-Einstellung und ist für Aufgaben mit hohem Volumen gebaut, etwa Klassifizierung, Routing, Extraktion, Zusammenfassungen und Subagent-Aufgaben.Was kostet Claude Haiku 5.5?
Ist Claude Haiku 5.5 besser als Haiku 4.5?
Was ist der Unterschied zwischen Claude Haiku 5.5 und Sonnet 5.5?
Wie nutze ich Claude Haiku 5.5?
model: "claude-haiku-5-5" auf oder nutze anthropic.claude-haiku-5-5 auf Amazon Bedrock. Lass temperature, top_p und top_k weg und setze output_config.effort auf low, medium, high, xhigh oder max. Es ist außerdem auf Google Cloud, Microsoft Foundry und Claude Platform on AWS verfügbar. Für Support-Teams führt eesels KI-Helpdesk-Teammate schnelle Modelle ganz ohne Code in deinem Helpdesk aus.Eignet sich Claude Haiku 5.5 für den Kundensupport?
Was geht kaputt, wenn ich auf Claude Haiku 5.5 wechsle?
budget_tokens, nicht standardmäßige temperature, top_p oder top_k, Assistant-Message-Prefill, das alte Tool computer_20250124 auf der Claude API und Google Cloud sowie Änderungen an früheren Turns, wenn du Thinking-Blöcke zurückschickst. Der neue Tokenizer zählt für denselben Text außerdem etwa 30 % mehr Tokens. Der Beitrag zu Claude-Haiku-5.5-Alternativen zeigt, wohin du ausweichen kannst, wenn dir diese Änderungen nicht passen.