

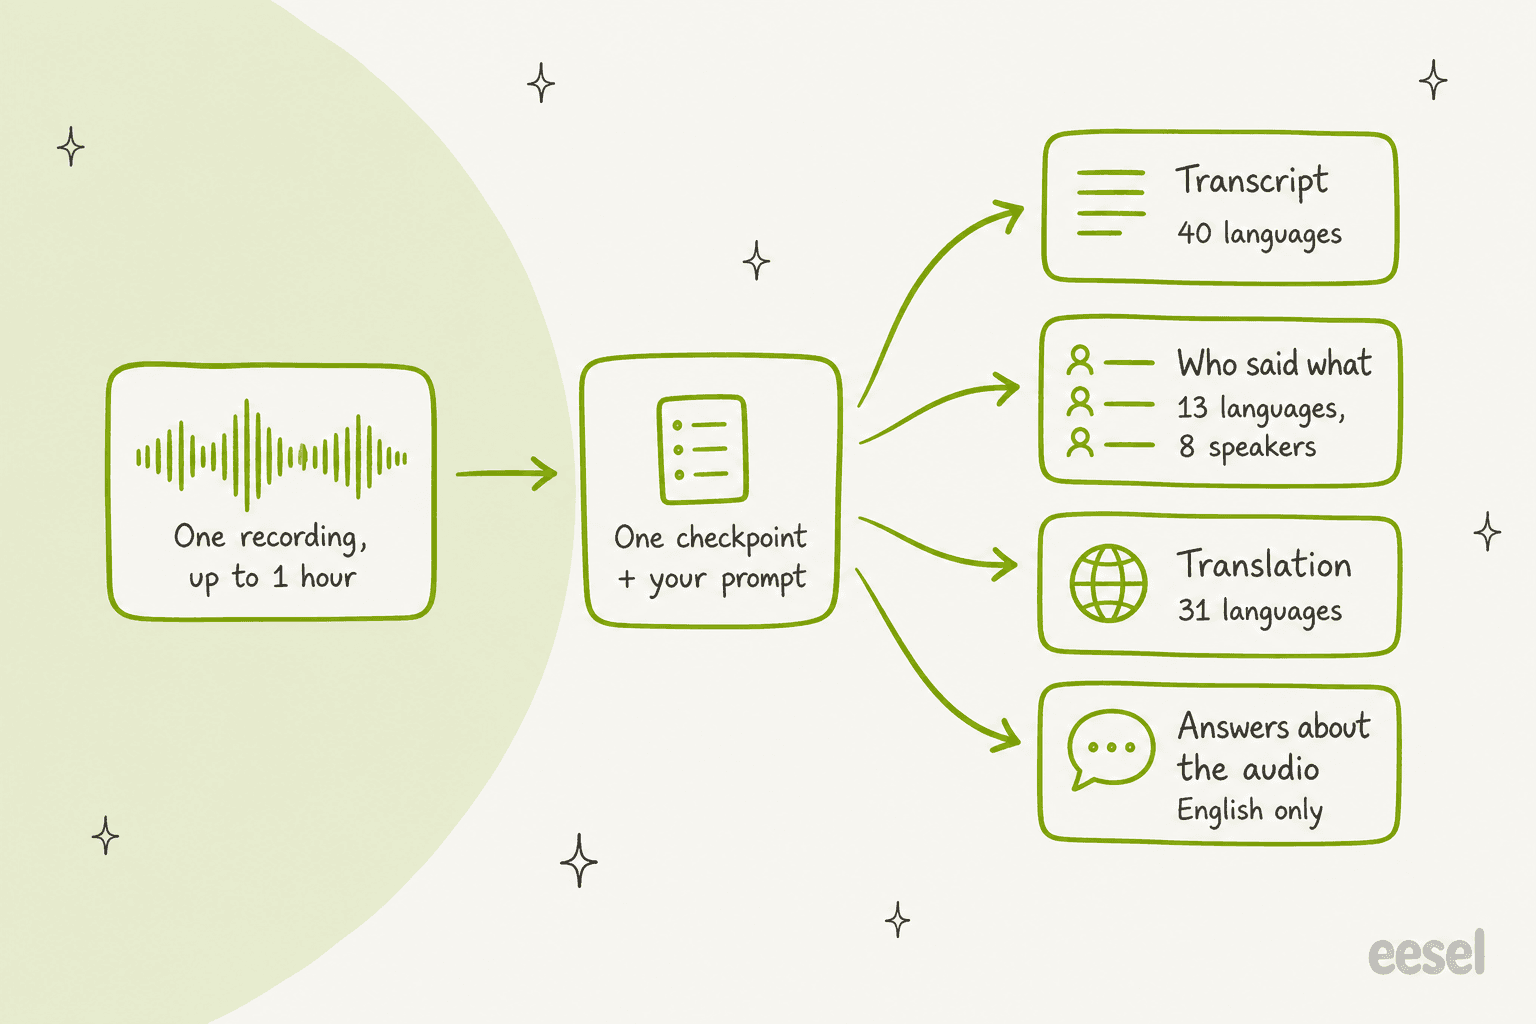
Nemotron 3.5 Transcribe ist NVIDIAs kostenloses Sprachmodell mit offenen Gewichten, veröffentlicht am 28. Oktober 2026, und ein Checkpoint erledigt vier Aufgaben: Transkripte in 40 Sprachen, „Wer hat was gesagt“-Labels für bis zu acht Sprecher, Übersetzung in 31 Sprachen und Antworten zum Audio. Welche Aufgabe Sie wollen, sagen Sie ihm mit einem einfachen Prompt in normaler Sprache.
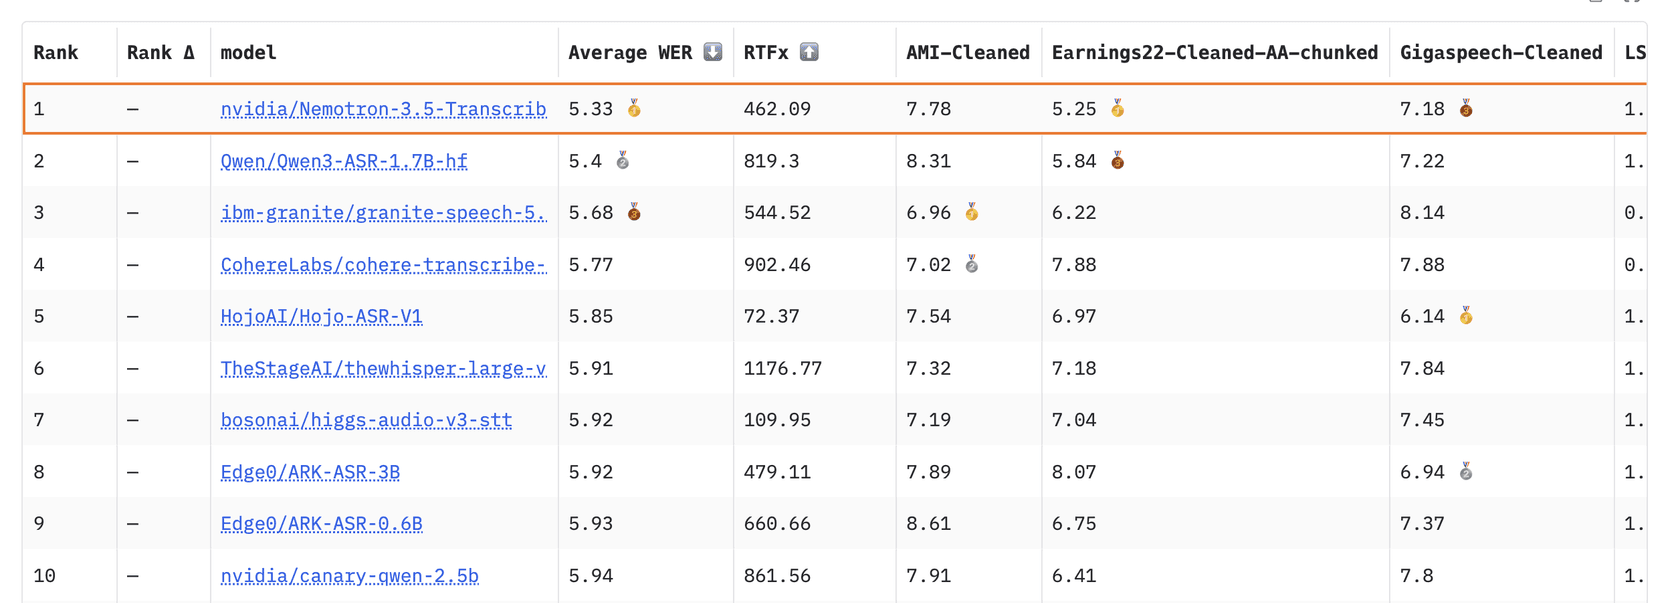
Für ein offenes Modell ist es genau: 2,81 % Wortfehlerrate bei Artificial Analysis, Platz zwei unter den offenen Modellen, und Platz eins auf Hugging Faces offenem englischen Leaderboard mit 5,33 %. Der Haken sind Größe und Zeitpunkt. Heute braucht es eine Rechenzentrums-GPU mit 80 GB, und es funktioniert nur mit Aufnahmen, nicht mit Live-Anrufen. Wenn Sie die Hardware nicht wollen, hostet DeepInfra es für 0,002 $ pro Minute, etwa die Hälfte dessen, was die meisten Transkriptions-APIs verlangen.
Für ein Support-Team ist ein Transkript der erste Schritt, nicht der letzte. Ich arbeite bei eesel, und das KI-Helpdesk-Teammitglied, an dem ich mitbaue, übernimmt das Ticket, das aus einem Anruf oder einer Voicemail entsteht, und beantwortet es in der Sprache des Kunden, so wie bei Koffer.ch auf Deutsch, Französisch, Englisch und Italienisch.
Was ist Nemotron 3.5 Transcribe?
Nemotron 3.5 Transcribe ist ein Sprachmodell mit offenen Gewichten von NVIDIA. Es nimmt eine aufgezeichnete Datei, wandelt sie in Text um und danach in jede Art von Text, die Sie verlangen. NVIDIA nennt es ein Speech-Augmented Language Model: Ein Audio-Encoder speist ein Sprachmodell, sodass Sie die Ausgabe mit Anweisungen statt mit Einstellungen steuern (Model Card).
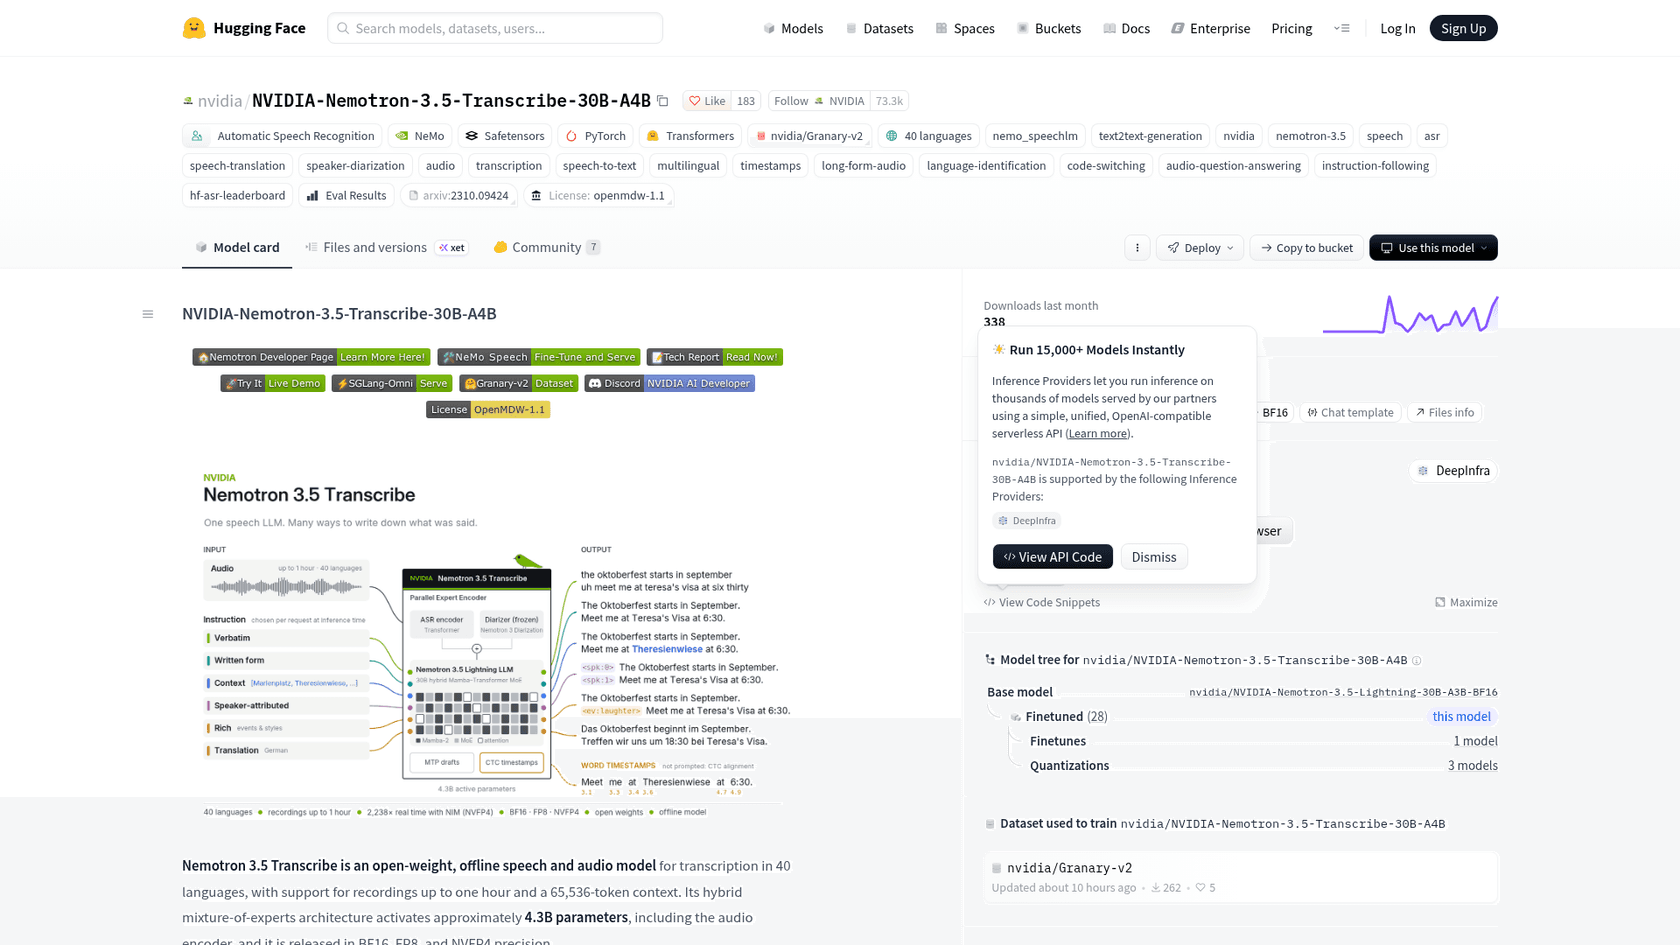
Die wichtigsten Zahlen, alle aus NVIDIAs Launch-Blog und der Model Card:
| Spezifikation | Nemotron 3.5 Transcribe |
|---|---|
| Veröffentlicht | 28. Oktober 2026 |
| Größe | Mixture of Experts der 30B-Klasse, rund 4B aktiv pro Token (die Card zählt 34B insgesamt, 4,3B aktiv, inklusive Audio-Encoder) |
| Transkription | 40 Sprachen |
| Übersetzung | 31 Sprachen, von oder ins Englische |
| Sprecherlabels | 13 Sprachen, bis zu 8 Sprecher |
| Längste Aufnahme | 1 Stunde (Kontext von 65.536 Token) |
| Live-Streaming | Nein, nur aufgezeichnetes Audio |
| Lizenz | OpenMDW-1.1, kommerzielle Nutzung erlaubt |
| Präzisionen | jetzt BF16; FP8 und NVFP4 als „kommend“ aufgeführt |
Der Teil „rund 4B aktiv“ ist der eigentliche Grund, warum ein Modell dieser Größe überhaupt nutzbar ist. Es ist ein hybrides Mamba-Transformer-Mixture-of-Experts auf Basis von NVIDIAs Sprachmodell Nemotron 3.5 Lightning, sodass nur ein kleiner Teil der Gewichte pro Token arbeitet. Es ist derselbe Trick wie beim Rest der Familie, etwa Nemotron 3.5 Super VL.
Eine Namensfalle möchte ich hier erwähnen. „Nemotron 3.5 ASR“ ist ein anderes, winziges Streaming-Modell. Wenn Sie online einen Preis oder eine Geschwindigkeitsangabe sehen, prüfen Sie, auf welches der beiden sie sich bezieht.
Was können Sie es tun lassen?
Sie können ein wörtliches Transkript, ein bereinigtes, eines mit Sprecherlabels, eine Übersetzung oder eine Antwort verlangen, alles aus derselben Datei. Zwischen diesen Varianten ändert sich nur eine Zeile im Prompt. NVIDIAs eigene Beispiele sind so schlicht wie „Transcribe this recording and label each speaker“ oder „What decisions were made in this meeting?“ (Launch-Blog).
Die für die Praxis wichtigsten Prompts, aus der Model Card:
- Wörtlich oder bereinigt. Jedes „äh“ und jede Wiederholung behalten oder weglassen und den Rest unverändert lassen.
- Kontextbegriffe. Produktnamen, Personen oder Fachjargon vorab auflisten. Bei NVIDIAs Kontexttest mit Quartalsgesprächen stieg die Schlüsselwort-Trefferquote von 58,16 % auf 96,05 %, sobald die Begriffe mitgegeben wurden.
- Sprecher und Zeitstempel. Sprecher-Tags und Wortzeiten in einem Durchgang anfordern, statt danach ein separates Diarisierungs-Tool laufen zu lassen.
- Exakte Werte. Ein Preset hält E-Mail-Adressen, URLs, Dateipfade und Bestellnummern so, wie sie gesprochen wurden, also genau das, was ein Support-Transkript nicht falsch haben darf.
- PII-Markierung. Das Modell wurde darauf trainiert, persönliche Angaben zu markieren oder zu schwärzen, nützlich, wenn Sie Support-Transkripte schwärzen, bevor sie jemand liest.
Die Card nennt sogar „support recordings“ als passenden Fall für den Kontextbegriff-Prompt und führt den Kundenservice als Anwendungsfeld auf. Callcenter hat NVIDIA hier also ziemlich klar im Blick.
Wie gut ist es wirklich?
In den öffentlichen Tests ist es das beste oder zweitbeste offene Sprachmodell und einen Schritt hinter den besten geschlossenen. Unten steht, was die Zahlen sagen und wo sie sich widersprechen.
Hugging Face Open ASR Leaderboard (Englisch). Platz eins unter den Modellen mit offenen Gewichten mit 5,33 % durchschnittlicher Wortfehlerrate, knapp vor Qwen3-ASR-1.7B mit 5,4 % (Leaderboard). Die Wortfehlerrate ist der Anteil falsch erkannter Wörter, niedriger ist also besser.
Artificial Analysis. 2,81 % auf dem Fehlerindex, zweiter unter den offenen Modellen, knapp hinter Voxtral Small mit 2,77 %, das etwa sechsmal so viele aktive Parameter nutzt (Artificial Analysis). NVIDIAs eigener Blog nennt das einen geteilten ersten Platz. Geschlossene Modelle führen insgesamt weiter: MAI-Transcribe-2 liegt bei 2,04 % und Gemini 3.5 Transcribe bei 2,60 %. Auf dem Sprachagenten-Set AgentTalk erreicht es 1,78 %, nahe an der Spitze der gesamten Tabelle.
Ich würde diese Zahl allerdings mit zwei Sternchen versehen. Der öffentliche DeepInfra-Endpunkt misst auf demselben Index 3,4 %, die 2,81 % stammen also aus einem Setup, das die meisten noch nicht erreichen können. Und bei Quartalsgesprächen erreicht es 5,69 %, hinter ElevenLabs Scribe v2 mit 3,95 %.
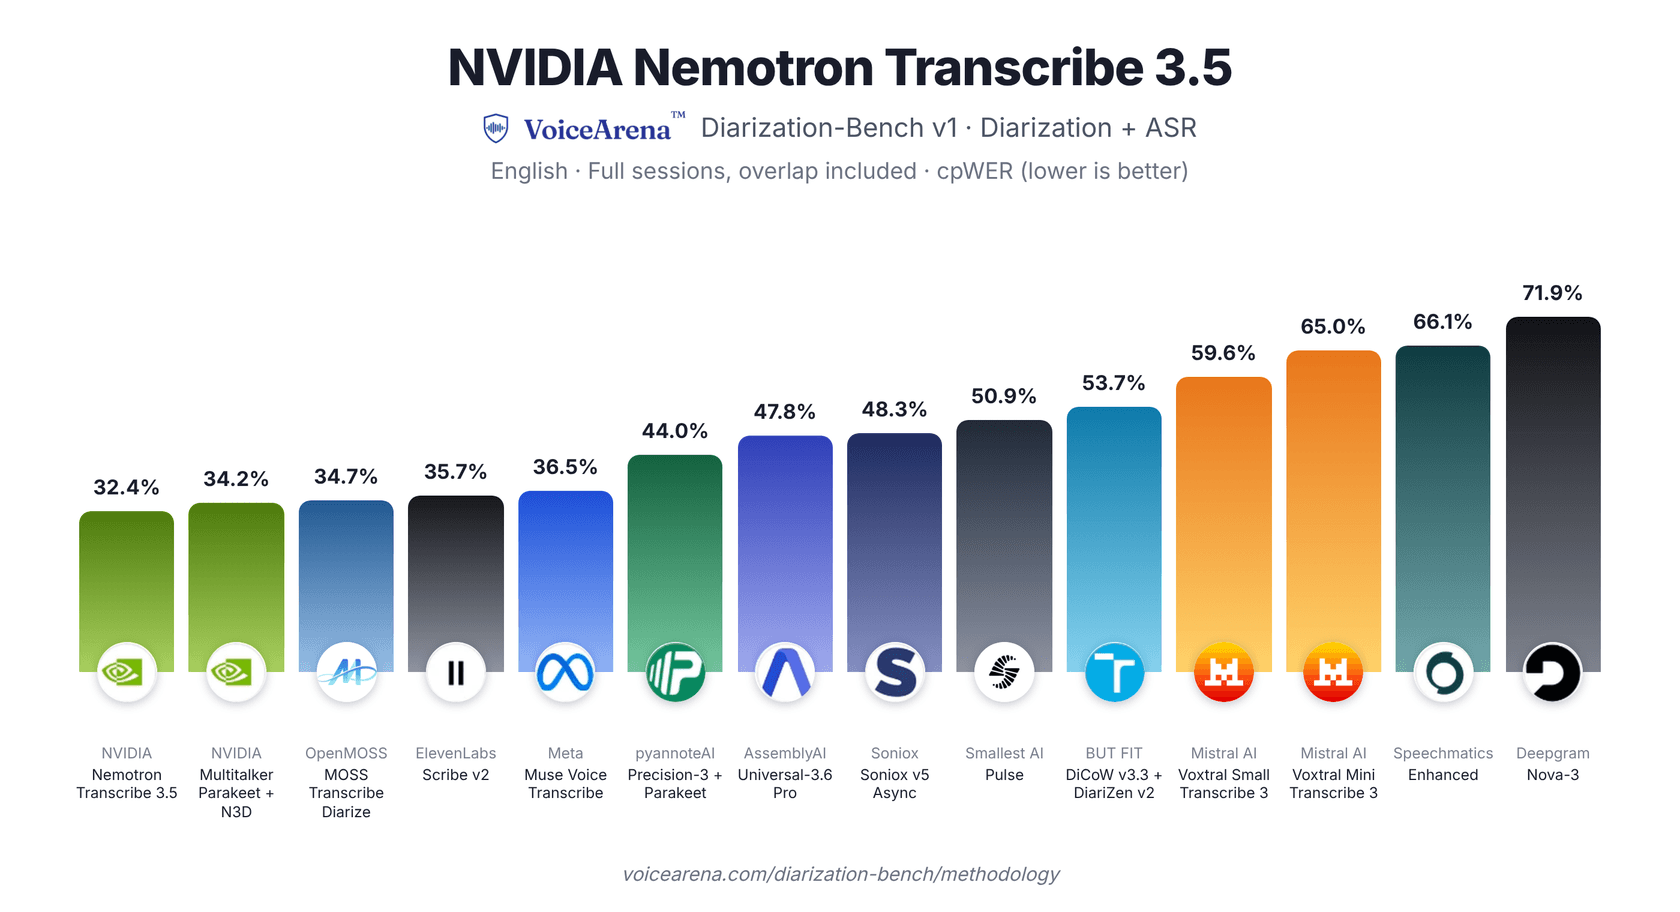
Wer hat was gesagt. Hier ist es am stärksten. Im Diarisierungs-Benchmark von VoiceArena, mit englischen Vollsitzungen und überlappendem Sprechen, kam es von 14 Systemen auf Platz eins mit 32,4 % Fehler nach Sprecherzuordnung und ließ weit weniger Wörter aus als die übrigen: 8,32 % gegenüber einem Median von rund 31 % (Launch-Blog).
Sprachen sind nicht gleichwertig. NVIDIA stuft 13 Sprachen als „leading“ ein, darunter Englisch, Spanisch, Deutsch, Französisch, Hindi und Koreanisch, und 15 weitere als produktionsreif. Manche fallen deutlich ab: Der FLEURS-Fehler liegt bei 26,93 % für Griechisch und 20,97 % für Hebräisch, und Norwegisch mit 63,76 % hat gar keine Transkriptionsunterstützung (Model Card). Wenn Ihre Kunden auf Norwegisch anrufen, ist dieses Modell also noch nichts für Sie.
Was sagen die Leute nach dem ersten Tag?
Die ersten Reaktionen sind begeistert von der Funktionsliste, aber gemischt, sobald man es ausprobiert. Der Thread auf r/LocalLLaMA hatte innerhalb eines Tages über 193 Upvotes, und der Top-Kommentar gab den Ton vor:
"Holy! This might be the holy grail of OS ASR models I have been looking for - something to dethrone venerable Qwen ASR."

Der einzige echte Test bisher, auf Hacker News, stammt von jemandem, der eine 4-Bit-Community-Quantisierung mit japanischem Audio ausprobierte und anmerkte, dass sie womöglich nicht die volle Genauigkeit hat:
"testing it against parakeet right now for ASR, it's slower, heavier, and has a higher error rate. but i'm doing a pass with the embedded translation to see if that's any good, it might be worth it."

Das Folgeurteil zur Übersetzung fiel nicht freundlicher aus („disappointing model“). Betrachten Sie die Benchmark-Siege daher als NVIDIAs Zahlen, bis unabhängige Tests mit Gewichten in voller Präzision vorliegen. Das andere Dauerthema ist die Größe. Wie ein Reddit-Kommentator sagte: „30b for ASR is such a luxury“, wo NVIDIAs eigenes 0,6B-Modell Parakeet auf fast allem läuft (Reddit).
Den Anwendungsfall, der den Leuten am besten zu gefallen schien, kennen Support- und Ops-Teams gut: chaotische Meetings und Anrufe, in denen alle durcheinanderreden.
"finally a model that can follow a standup where everyone unmutes at once"
Wie betreibt man Nemotron 3.5 Transcribe?
Aktuell gibt es drei Wege. Sie können eine kostenlose Demo ausprobieren oder eine gehostete API aufrufen, und wenn Sie die Hardware haben, es auf der eigenen GPU betreiben.
- Die Demo ausprobieren. NVIDIAs Hugging Face Space nimmt einen Upload und einen Prompt entgegen. So prüfen Sie Ihr eigenes Audio, bevor Sie sich festlegen.
- Eine gehostete API aufrufen. DeepInfra listet es für 0,002 $ pro Minute ohne Datenspeicherung. Baseten und Simplismart hosten es ebenfalls, verkaufen aber GPU-Zeit oder individuelle Angebote statt eines Minutenpreises.
- Selbst hosten. Die Model Card enthält ein vLLM-0.32.0-Rezept für eine H100 mit 80 GB sowie Optionen für Transformers und SGLang-Omni. Der vLLM-Server spricht das OpenAI-Chat-Format, sodass Code für OpenAIs Audio-API mit kleinen Änderungen übernommen werden kann.
Die Card enthält außerdem ein paar leicht zu übersehende Stolperfallen:
- Die schnelle Version ist noch nicht offen. NVIDIAs Schlagzeile von 100 Stunden Audio in unter drei Minuten nutzt die unveröffentlichten NVFP4-Gewichte und einen eigenen optimierten Server. Das offene vLLM-Setup sei „expected to be roughly two times slower“.
- SGLang-Omni kann nur transkribieren. Dieser Weg lässt Zeitstempel, Sprecherlabels und Übersetzung aus, die zur Hälfte der Grund sind, dieses Modell zu wählen.
- Kleinere GPUs müssen warten. Die Unterstützung für die RTX 5090 gibt es nur mit NVFP4, für die L40S nur mit FP8, und keines der Repos war am 29. Oktober öffentlich.
- Es kann in Schleifen geraten. NVIDIA liefert einen Bereinigungs-Regex für den seltenen Fall, dass die Ausgabe nicht endet, und warnt vor halluzinierter Sprache. Prüfen Sie Namen und Sprecherwechsel stichprobenartig.
Wenn der Betrieb offener Modelle auf eigener Hardware neu für Sie ist, erklärt der Hugging-Face-Leitfaden die Grundlagen des Hubs, über den NVIDIA ausliefert.
Was kostet es?
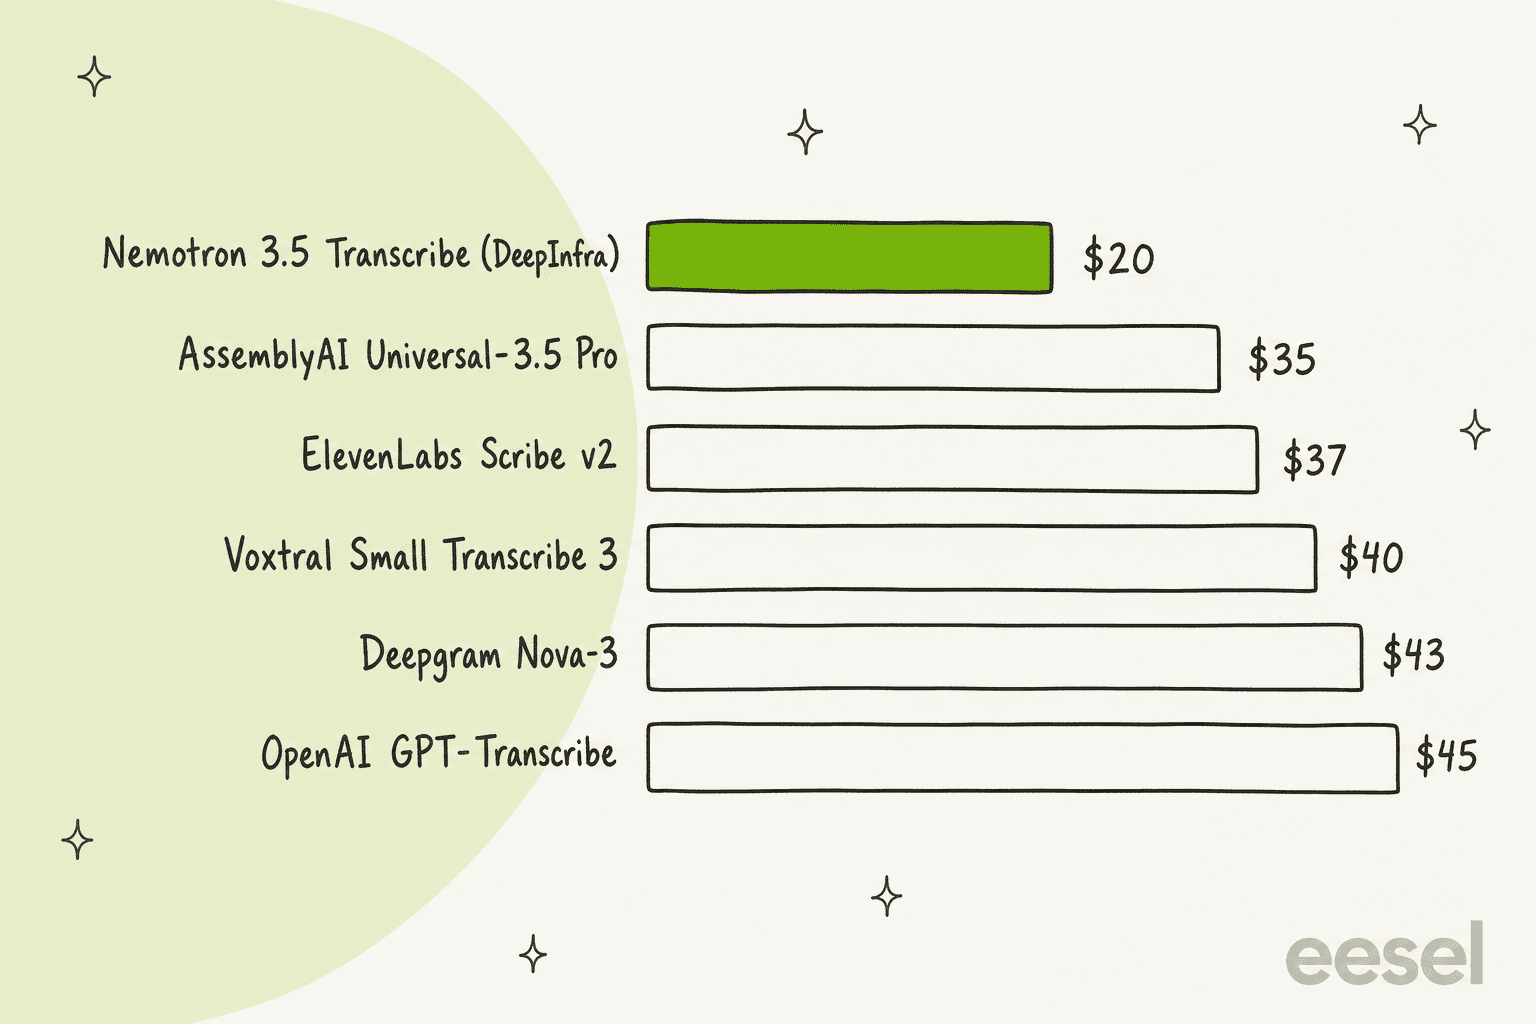
Die Gewichte kosten nichts, der wahre Preis ist also das, was Sie für GPU oder API zahlen. Bei den gehosteten Preisen war es die günstigste genaue Option, die ich gefunden habe. Hier sind 10.000 Minuten aufgezeichneter Anrufe pro Monat, etwa 167 Stunden, bepreist nach der jeweiligen Seite des Anbieters:
| Modell | Batch-Preis | 10.000 Minuten | Quelle |
|---|---|---|---|
| Nemotron 3.5 Transcribe (DeepInfra) | 0,002 $/Min. | 20 $ | DeepInfra |
| AssemblyAI Universal-3.5 Pro | 0,21 $/Std. | 35 $ | AssemblyAI |
| ElevenLabs Scribe v2 | 0,22 $/Std. | etwa 37 $ | ElevenLabs |
| Mistral Voxtral Small Transcribe 3 | 0,004 $/Min. | 40 $ | Mistral |
| Deepgram Nova-3, aufgezeichnet | 0,0043 $/Min. | 43 $ | Deepgram |
| OpenAI GPT-Transcribe | 0,0045 $/Min. | 45 $ | OpenAI |
| Gemini 3.5 Transcribe | etwa 0,005 $/Min. | etwa 50 $ |
Die Lücke wächst, sobald man bei den Funktionen gleiches mit gleichem vergleicht. Nemotron enthält Prompting, Kontextbegriffe und Sprecherlabels im Basisaufruf. Bei AssemblyAI steigt Universal-3.5 Pro mit Prompting (0,05 $/Std.) und Diarisierung (0,02 $/Std.) auf 0,28 $ pro Stunde, mehr als das Doppelte von Nemotrons 0,12 $. Einen genaueren Blick auf die Konkurrenz bieten die Beiträge zu Gemini 3.5 Transcribe und Voxtral 3.
Selbst hosten ist pro Audiostunde nur dann günstiger, wenn die GPU ausgelastet bleibt. Baseten vermietet eine H100 für 0,10833 $ pro Minute (Baseten), etwa 6,50 $ pro Stunde. NVIDIA misst auf dieser Karte das 260- bis 410-Fache der Echtzeit für englische Batches, eine GPU-Stunde deckt also 260 bis 410 Stunden Audio ab. Nach meiner Rechnung sind das etwa 2 bis 3 Cent pro Audiostunde gegenüber 12 Cent bei DeepInfra, aber nur bei einem gleichmäßigen Batch-Strom. Ein Team mit 167 Stunden im Monat würde für eine meist leere GPU zahlen, die API gewinnt also, bis das Volumen wirklich groß wird.
Wo passt es für ein Support-Team?
Es passt überall dort, wo Sie bereits Aufnahmen haben und Text wollen, den Sie durchsuchen, bewerten oder weiterverarbeiten können. Bei Live-Gesprächen passt es nicht.
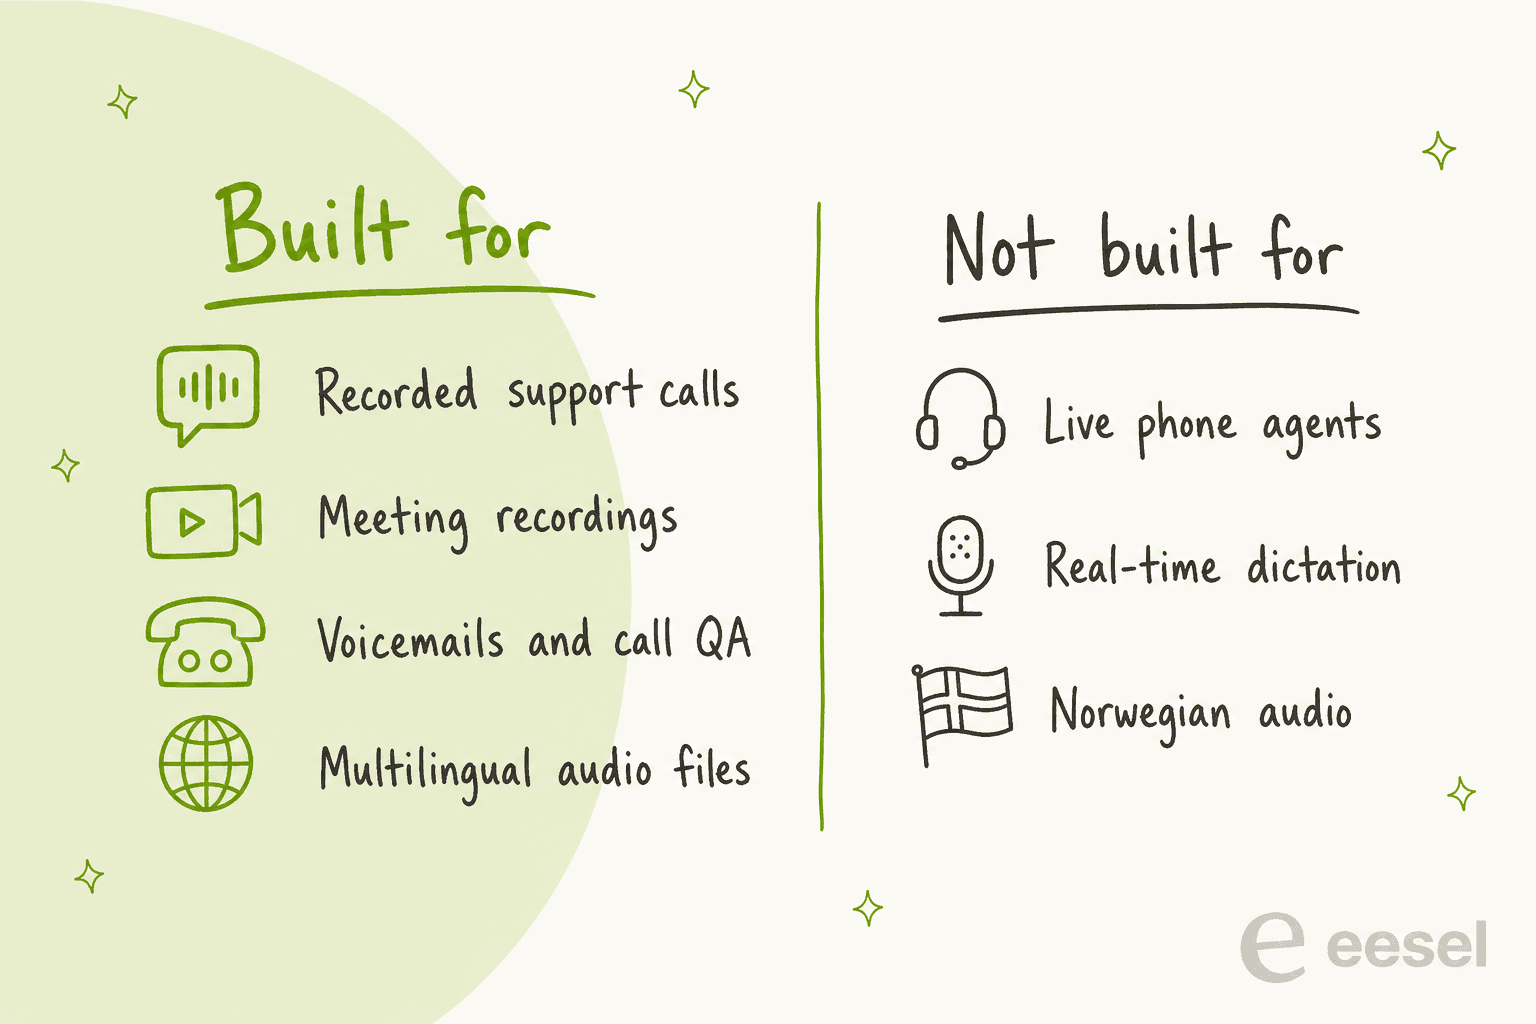
- Anruf-QA. Transkripte mit Sprecherlabels machen es leicht zu bewerten, wie Agenten Anrufe führen, den langweiligen Teil der Qualitätssicherung im Callcenter. Kombinieren Sie es mit KI-Support-QA, um den Text zu bewerten.
- Voicemails und Rückrufe. Transkribieren, dann den Text im Ticket mitführen, damit, wer es übernimmt, nicht erst zuhören muss.
- Zusammenfassungen und Stimmung. Das Transkript speist die Ticket-Zusammenfassung und die Stimmungsanalyse, genauso wie Chat-Transkripte.
- Mehrsprachige Warteschlangen. Ein Modell für 40 Sprachen schlägt ein eigenes Tool pro Markt, und das ist die halbe Miete im mehrsprachigen Kundensupport.
Mit dem Anrufer sprechen kann es nicht. Dafür brauchen Sie ein Streaming-Modell in einem KI-Sprachagenten oder eines der Tools in meiner Liste der besten KI-Sprachagenten. Es entscheidet auch nicht, was geantwortet werden soll. Ein perfektes Transkript einer Erstattungsanfrage braucht trotzdem jemanden, oder etwas, der Ihre Erstattungsrichtlinie kennt.
Dieser zweite Teil ist der, mit dem ich die meiste Zeit verbringe. In den Jahren, in denen eesel KI in Live-Support-Warteschlangen betreibt, war nie die Umwandlung von Wörtern in Text das Schwierige. Schwierig war, korrekt aus den eigenen Richtlinien eines Unternehmens zu antworten und zu wissen, wann man übergibt, und deshalb wird jeder Rollout zuerst an den früheren Tickets eines Teams getestet, bevor er jemandem antwortet.
Warum Nemotron 3.5 Transcribe wichtig ist
Es ist wichtig, weil „das Audio an die Cloud eines anderen schicken“ damit optional wird. Bisher waren die genauen Sprachmodelle mit integrierten Sprecherlabels und Übersetzung geschlossene APIs, und die offenen waren kleine Ein-Zweck-Modelle, die man verketten musste. Nemotron 3.5 Transcribe packt alles in einen offenen Checkpoint, den Sie im eigenen Rechenzentrum betreiben können, mit kommerzieller Lizenz und NVIDIAs veröffentlichten Trainingsdaten Granary v2 (463.062 Stunden in 48 Sprachen).
Die andere Veränderung ist, dass die Anpassung jetzt billig ist. NVIDIAs medizinische Fallstudie hat es auf indisch akzentuierter klinischer Sprache feinabgestimmt und die Fehler von 30,8 % ab Werk auf 11,8 % gesenkt, in etwa 14 GPU-Stunden auf einer GB300 (Fallstudie).
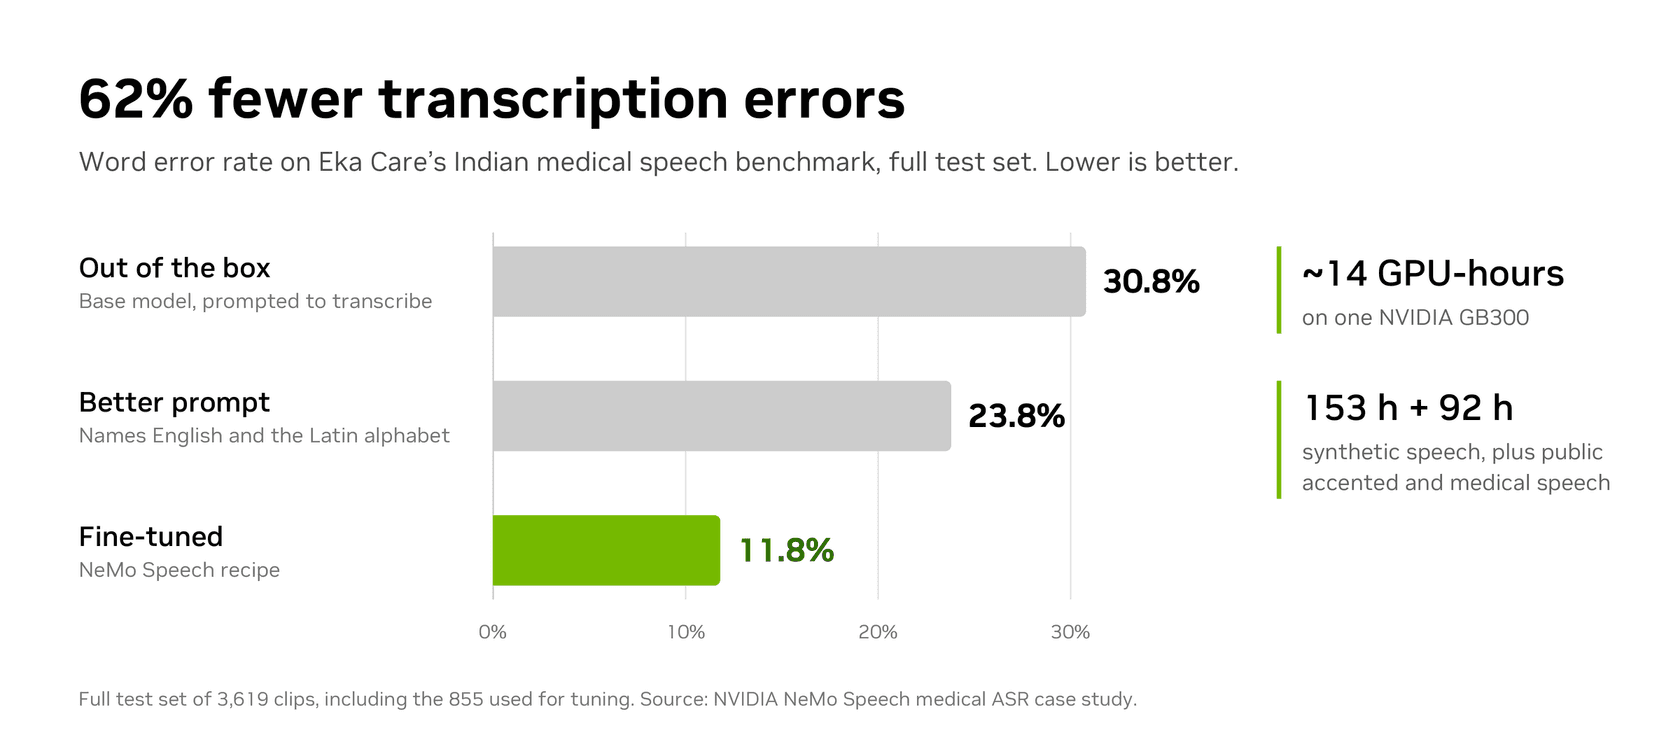
Der mittlere Balken ist der, auf den es ankommt. Ein besserer Prompt allein brachte es vor jedem Training von 30,8 % auf 23,8 %. Meine Meinung: Probieren Sie den Prompt, bevor Sie das Fine-Tuning probieren. Dem Modell Sprache und Schriftsystem sowie Ihre Produktnamen mitzuteilen, kostet nichts und ist für die meisten Support-Teams der größte Teil des Gewinns.
Wenn Sie es für einen größeren Stack mit anderen offenen Modellen vergleichen, behandeln NVIDIAs offene Agenten-Sicherheitsplattform und meine Liste der Open-Source-KI-Agenten die Bausteine drumherum.
eesel testen
Nemotron 3.5 Transcribe ist Infrastruktur: hervorragende Ohren, aber keine Stellenbeschreibung. Es macht aus einem Anruf Text. Was danach kommt, das Ticket lesen, die Bestellung prüfen, in der Sprache des Kunden antworten, den verärgerten eskalieren, ist ein Job, und den übernimmt eesels KI-Helpdesk-Teammitglied. Es arbeitet mit Zendesk, Freshdesk oder Gorgias, lernt aus Ihren früheren Tickets und dem Help Center, und Sie können es an Hunderten dieser Tickets testen, bevor es irgendjemandem antwortet.

Bei der Sprache zahlt sich das am meisten aus. Bei smava bearbeitete es 27.000 Zendesk-Tickets in einem Monat, versah jedes mit Sprache und Kategorie und entwarf Antworten auf Deutsch. Bei Koffer.ch entwirft es Freshdesk-Antworten in jeder der vier Sprachen, in der der Kunde geschrieben hat, im Deutschen mit Schweizer Schreibweise.
Wenn Sie Modelle gern über das Terminal steuern, bedient die eesel CLI dasselbe Teammitglied: Anweisungen lesen und bearbeiten, auf einen Menschen wartende Aktionen freigeben und das Aktivitätsprotokoll jedes Laufs prüfen, mit JSON-Ausgabe und Probeläufen bei Schreibvorgängen. Ein Coding-Agent wie Claude Code kann Ihr Support-Teammitglied neben Ihrer Transkriptions-Pipeline verwalten. Testen Sie eesel kostenlos oder buchen Sie eine Demo, um es an Ihren eigenen Tickets zu sehen.