

Qwen-UI-Agent ist der beste veröffentlichte Agent zur Smartphone-Bedienung, und Sie können ihn nicht nutzen. Alibabas Tongyi-MAI-Team hat am 30. Juli 2026 ein Paper, ein Demo-Video und einen Benchmark veröffentlicht. Das GitHub-Repository hat 2.2k Sterne und null Releases. Auf Hugging Face gibt es keine Gewichte, keine API und keine Preisliste.
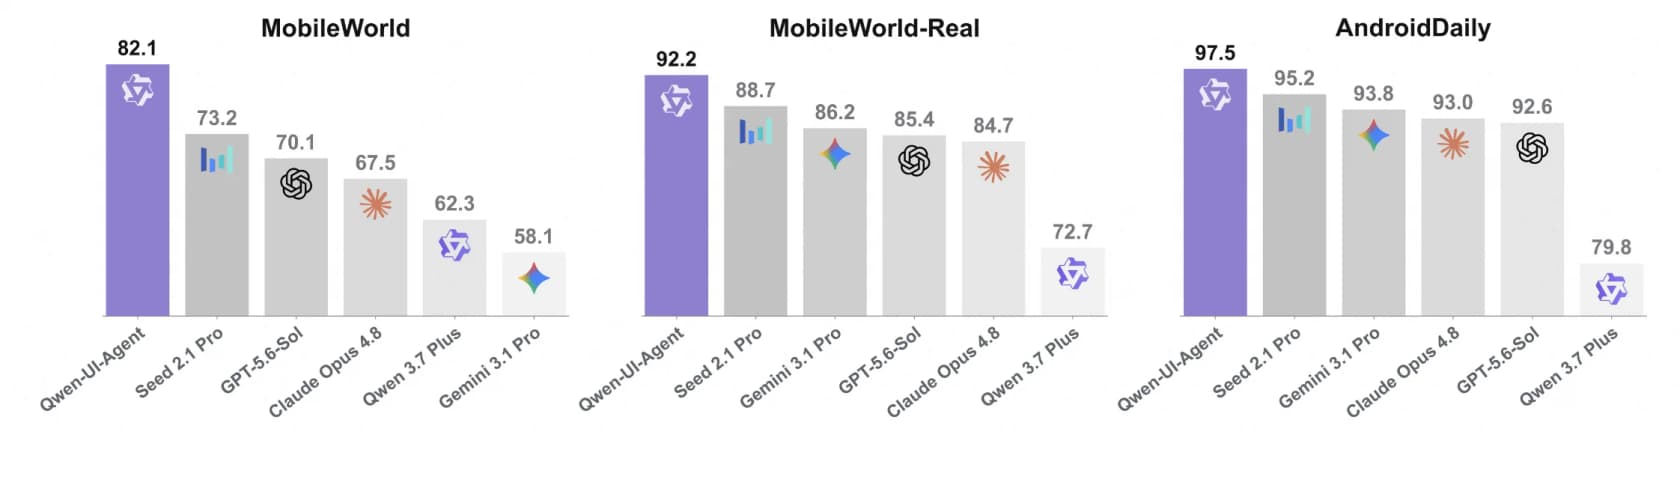
Die mobilen Zahlen sind echt und groß. 82.1% bei MobileWorld, das sind 14.6 Punkte mehr als Claude Opus 4.8 und 38.2 Punkte mehr als das beste spezialisierte GUI-Modell davor. Bei den Desktop-Zahlen ist die englischsprachige Berichterstattung falsch abgebogen. Bei OSWorld-Verified setzt Alibabas eigene Grafik Opus 4.8 auf 83.4 und Qwen-UI-Agent auf 79.5. Bei langen Desktop-Aufgaben schließt er 13.9% der Aufgaben ab. Bei schwieriger englischer Webrecherche erreicht er 64.1 gegenüber 90.1 für GPT-5.5.
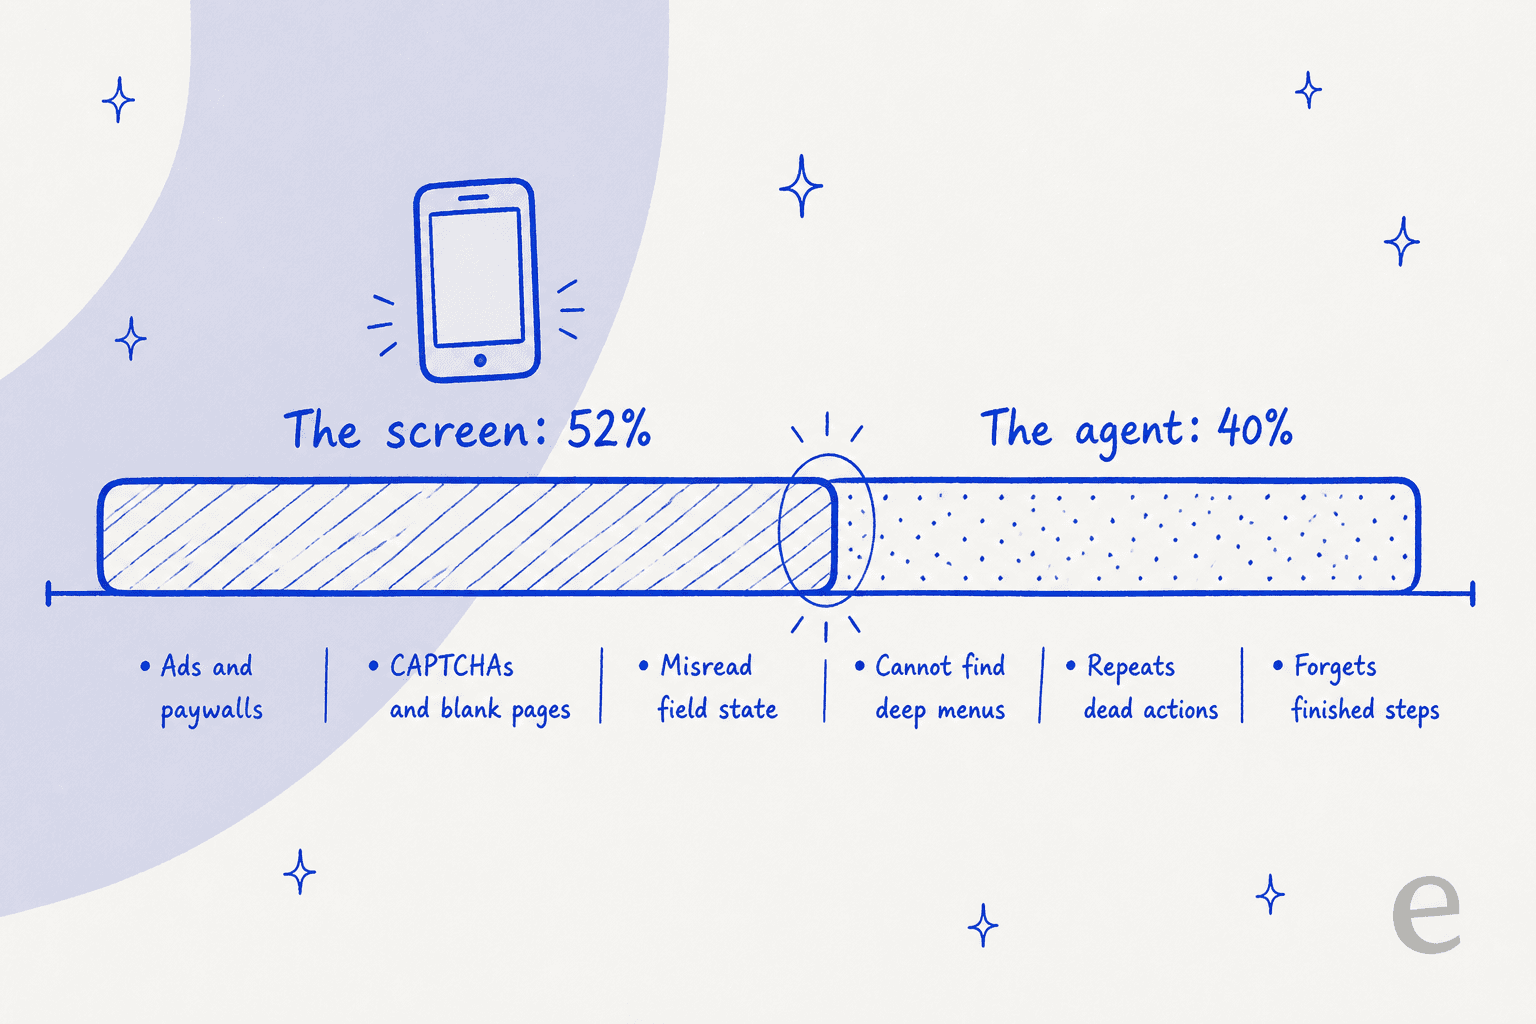
Ich baue die Agent-Seite von eesel, deshalb lese ich an diesem Paper nicht die Bestenliste immer wieder, sondern Tabelle 10. Dort hat das Team jeden Fehler auf echten Geräten klassifiziert. 52% davon lagen am Bildschirm, nicht am Modell: Werbung, Bezahlschranken, CAPTCHAs, leere Seiten, ein grauer Platzhalter, der für eingegebenen Text gehalten wurde. Diese Zahl zeigt, wohin Bildschirmsteuerung gehört und wohin nicht.
Was Qwen-UI-Agent eigentlich ist
Die meisten Modelle, über die man liest, beantworten Fragen. Dieses hier bedient Geräte. Sie geben ihm eine Aufgabe in normaler Sprache, es schaut auf einen Screenshot und gibt einen Tipp, eine Wischgeste, einen Tastendruck oder einen Bash-Befehl aus. Dann schaut es wieder hin.
Das Paper bewertet drei Größen: ein 27B-Modell, eine sparse Variante mit 35B-A3B und ein 4B-Modell. Jede Schlagzeilenzahl gehört zum 27B. Die Basis ist mit hoher Wahrscheinlichkeit Qwen3.5-27B, denn die Tabellen zu den allgemeinen Fähigkeiten stellen beide nebeneinander und die Werte sind nahezu identisch: 72.4 gegenüber 73.5 bei MMMU-Pro, 83.1 gegenüber 83.1 bei RealWorldQA. Was auch immer das GUI-Training bewirkt hat, es hat das allgemeine Denkvermögen des Modells nicht aufgefressen, was man von den meisten spezialisierten Fine-Tunes nicht behaupten kann.
Es ist ein Nachfolger von MAI-UI 1.0, der früheren Arbeit desselben Teams, und übernimmt dessen Angewohnheit, Dinge nach dem zu benennen, was sie messen. Wenn Sie die Familie noch nicht kennen: Unsere Qwen-Übersicht behandelt die Hauptmodelle, und das Qwen-Review bietet die geschäftliche Einordnung. Alibabas aktuelles Flaggschiff Qwen3.8-Max ist ein ganz anderes Tier: größer, gesprächiger und nicht dafür gebaut, Knöpfe zu drücken.
Was es zu einem GUI-Basisagenten statt zu einem Mobile-Bot macht, ist die Bandbreite. Ein Modell, vier Umgebungen: Android-Smartphones, Linux-Desktop, Webbrowser und ein API-basierter Tiefensuchmodus. Benannte Produkte, die eines davon können, gibt es. Alle vier in einem einzigen Checkpoint zu beherrschen, ist der Anspruch.
Die Benchmark-Tabelle und der Teil, der überinterpretiert wurde
Hier ist jede veröffentlichte Schlagzeilenzahl an einem Ort, samt der Angabe, wer tatsächlich Platz eins hält.
| Achse | Benchmark | Qwen-UI-Agent | Beste veröffentlichte Zahl | Fazit |
|---|---|---|---|---|
| Mobile GUI | MobileWorld (50 Schritte) | 82.1% | Qwen-UI-Agent | Führt mit 8.9 vor Seed 2.1 Pro |
| Mobil, echte Geräte | MobileWorld-Real | 92.2% | Qwen-UI-Agent | Führt mit 3.5 vor Seed 2.1 Pro |
| Mobil, Alltagsaufgaben | AndroidDaily | 97.5% | Qwen-UI-Agent | Führt mit 2.3 |
| Desktop | OSWorld-Verified | 79.5% | Claude Opus 4.8, 83.4% | Zweiter |
| Desktop, lange Abläufe | OSWorld-v2 partial | 40.0% | Claude Opus 4.8, 54.8% | Dritter, hinter GPT-5.5 |
| Desktop, abgeschlossene Aufgaben | OSWorld-v2 binary | 13.9% | Claude Opus 4.8, 20.6% | Zweiter |
| Browser | WebArena | 73.6% | Qwen-UI-Agent | Führt mit 1.7. Mensch: 78.2% |
| Grounding | ScreenSpot-Pro (zoom) | 81.5% | Qwen-UI-Agent | Führt mit 0.8 |
| Tiefensuche, EN | BrowseComp | 64.1% | GPT-5.5, 90.1% | 26 Punkte zurück |
| Tiefensuche, ZH | BrowseComp-ZH | 75.0% | Apodex-1.0-mini, 80.6% | Zweiter |
Die mobile Seite dieser Tabelle ist nicht knapp. Schauen Sie selbst.
Schauen Sie nun auf dieselben Diagramme für Desktop und Web. Das mittlere und das rechte Feld sind Siege. Das linke nicht, und der Balken, der es schlägt, ist beschriftet.
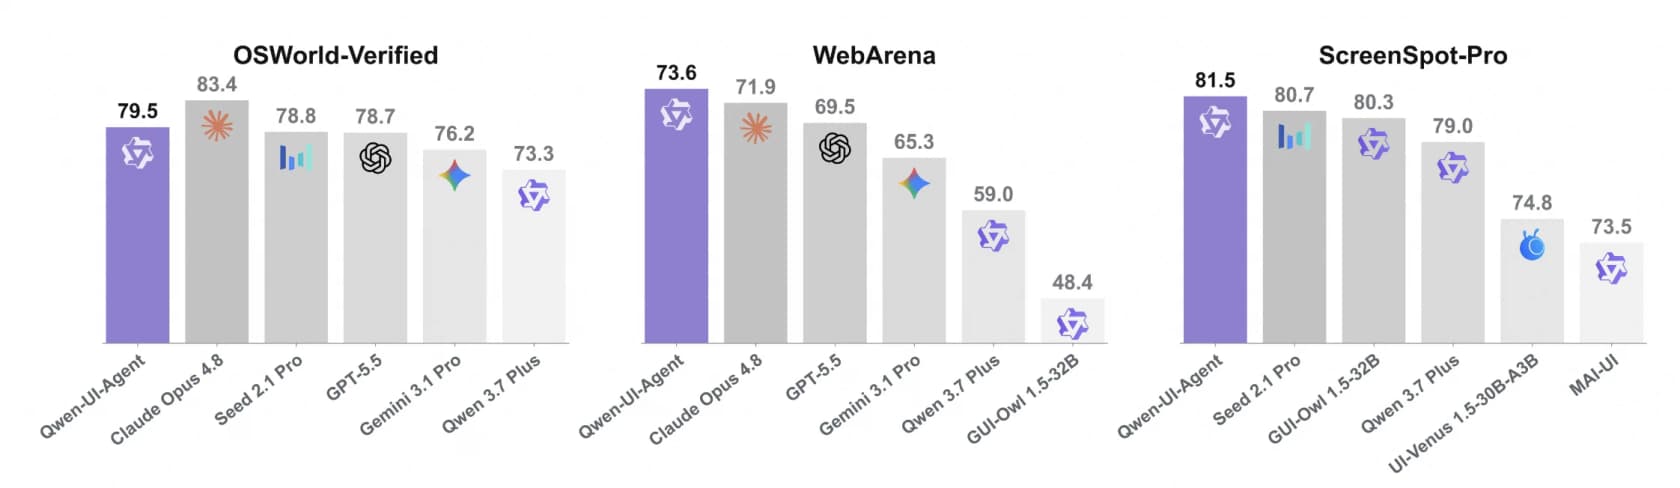
Alibaba war hier ehrlich. Das Paper sagt, das Modell liege bei OSWorld-Verified "second among all compared models and trailing only Claude Opus 4.8", und die Zusammenfassung teilt die Aussage sauber auf: Stand der Technik auf dem Smartphone, konkurrenzfähig auf Computer und Browser. Das Aufrunden geschah später. Ein vielgeteilter wöchentlicher China-KI-Rückblick meldete Bestwerte bei allen drei Benchmarks MobileWorld, OSWorld-Verified und WebArena und schrieb, das Modell schlage "GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro." Zwei dieser drei stimmen. Der Desktop-Wert nicht, laut Alibabas eigenem Balkendiagramm.
Das ist wichtig, weil die beiden Achsen unterschiedliche Aufgaben beschreiben. Ein Zugticket in einer App zu buchen, ist eine Mobile-Aufgabe. Eine Tabelle über vier Fenster hinweg abzugleichen, ist eine Desktop-Aufgabe. Ein Modell kann die eine beherrschen und die andere verlieren, und dieses hier tut genau das.
Erst die Aufgabe wählen, dann die Zahl lesen
Ein Aktionsraum für Taps und Terminal-Befehle
Die Designentscheidung, die ich am interessantesten finde, hat nichts mit Bildverarbeitung zu tun. Es ist die Aktionsliste.
Neben den erwartbaren GUI-Verben click, long_press, type, drag, system_button, wait bekommt das Modell cli_command zum Ausführen von Bash, api_call für strukturierte Dienstaufrufe und ask_user, um einen Menschen zu fragen. Alles in einem flachen Raum, Zug um Zug gewählt. Der Agent muss also nie "vierzig Dateien umbenennen" als vierzig einzelne Klicks ausdrücken. Er kann einfach den Befehl schreiben.
Und das tut er ständig. Bei OSWorld-v2 sind 55.1% der Aktionen des Agenten getippte Befehle statt Bildschirmaktionen. Bei OSWorld-Verified sind es 40.7%, und sie kommen in 92.0% der Aufgaben vor.
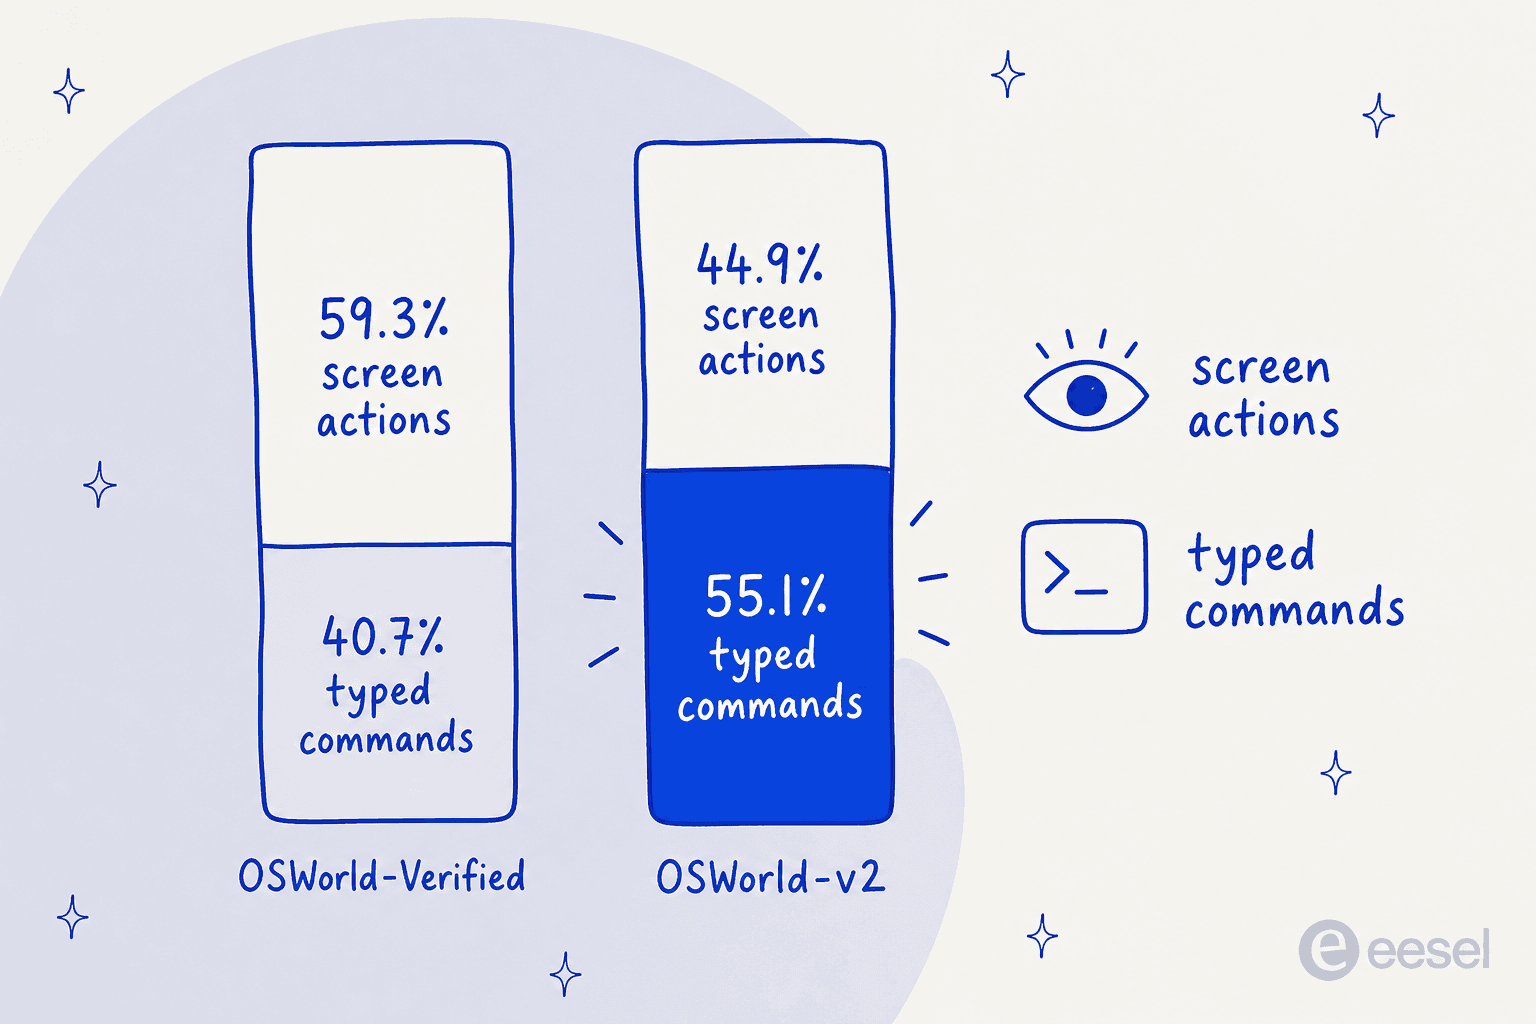
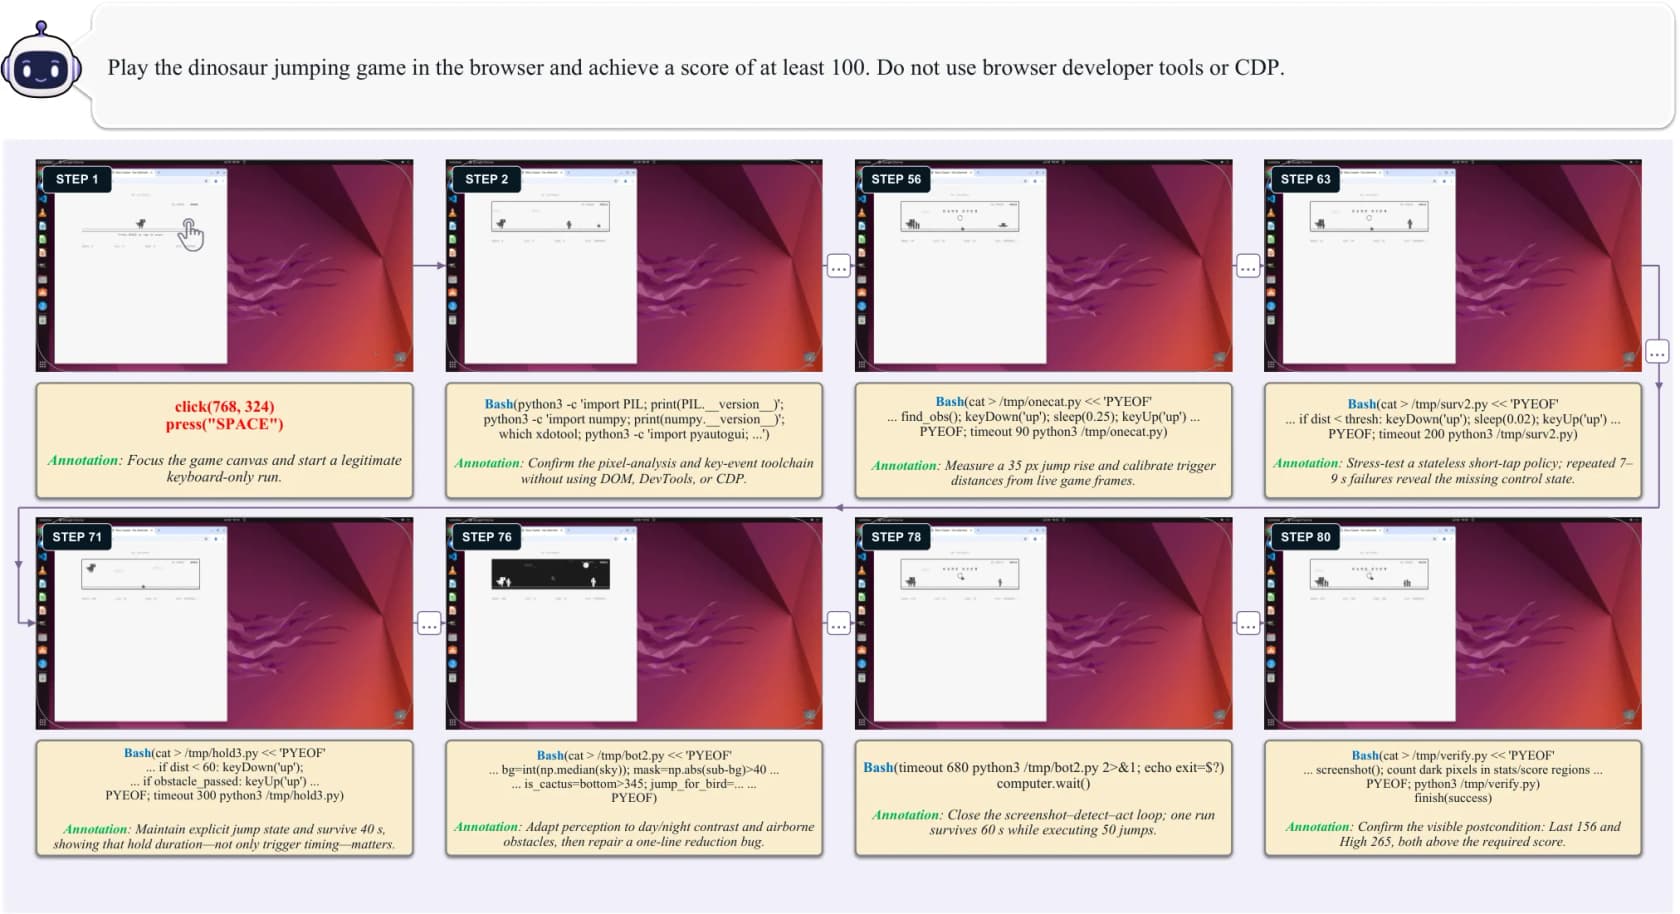
Lassen Sie das kurz auf sich wirken. Das Hauptprodukt ist ein Bildschirm-Agent. Gibt man ihm Tastatur und Shell, verbringt er beim härteren Desktop-Benchmark die meisten Aktionen damit, den Bildschirm gar nicht zu berühren. Das Paper nennt das Muster selbst Bash als Hände, GUI als Augen, und die Trajektorie, die es am besten zeigt, ist die Aufgabe, im Dinosaurier-Spiel des Browsers 100 Punkte zu erreichen, ohne die Entwicklertools zu öffnen. Über 80 Schritte beobachtet der Agent die Canvas per Screenshot und schreibt und überarbeitet dann Python, um die Sprünge zu timen.
Der zweite Effizienztrick ist das Bündeln. Statt einer Aktion pro Modellzug gibt es mehrere aus: 39.6% der Aktionen bei OSWorld-Verified und 41.6% bei OSWorld-v2 kommen gebündelt an, im Schnitt mit 3.1 Primitiven. Ein Beispiel im Paper ist eine Sequenz aus 21 Aktionen, die eine E-Mail ausfüllt und bis zum Dialog für Anhänge läuft und dann stoppt, weil die nächste Entscheidung einen frischen Screenshot braucht. Jeder eingesparte Zug ist ein Screenshot, ein Inferenzdurchlauf und ein Roundtrip weniger, genau die Kosten, die das Paper im Abschnitt zur künftigen Arbeit als Haupthindernis für den praktischen Einsatz nennt.
Wenn Sie je einen Browser-Agenten beobachtet haben, der sich Feld für Feld durch ein Formular quält, ist das die Lösung. Chrome Auto-Browse hat dieselbe Art von Problem, und deshalb ist es meist die Latenz pro Schritt und nicht die Genauigkeit, die eine Demo killt.
Die Zahl auf echten Geräten ist die interessante
Die meisten GUI-Agenten werden in Simulatoren trainiert und bewertet, weil man einen Simulator zurücksetzen und verifizieren kann. Alibaba hat das Gegenteil gebaut: eine Laufzeitumgebung mit mehr als 100 physischen Smartphones und über 150 Apps sowie einen passenden Benchmark.
MobileWorld-Real besteht aus 409 von Menschen geschriebenen Aufgaben in 104 Live-Android-Apps, die vom Training ausgenommen wurden. Echte Konten, wechselnde Inhalte, echte Berechtigungen, echtes Netzwerk. Die Aufgabenliste liest sich wie der Samstag eines Menschen: den meistgespeicherten Rezeptbeitrag finden, die Zutaten ohne Gewürze für eine Lieferung um 18:45 kaufen, Gehzeiten von drei Hotels zu einer Brücke vergleichen, herausfinden, wann der Zug ankommt, und für die nächste volle Stunde danach ein Meeting buchen.
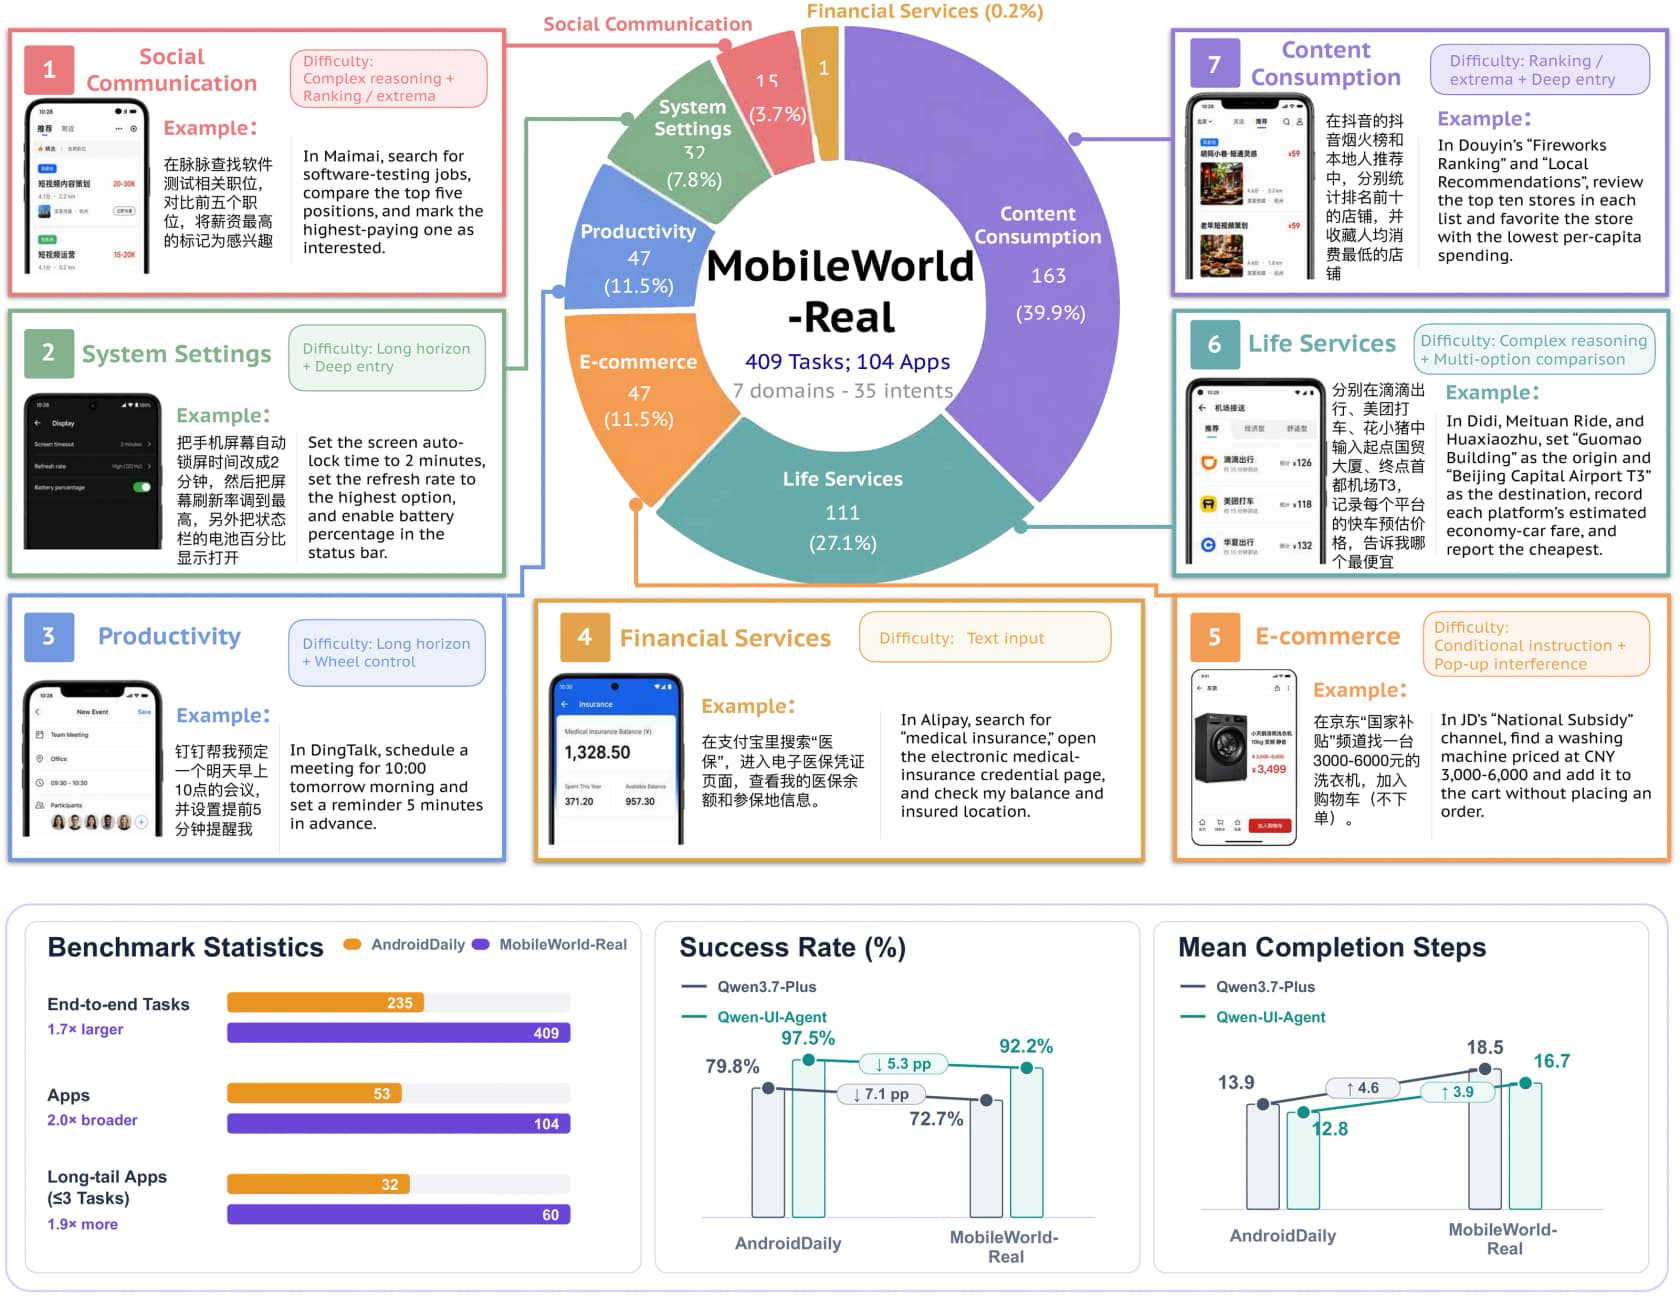
Zwei ehrliche Einschränkungen gehören zu den 92.2%. Erstens ist es Alibabas eigener Benchmark, was in Ordnung und normal ist, aber keine unabhängige Bestenliste. Zweitens legen physische Telefone keine App-Interna offen, es gibt also keinen deterministischen Prüfer. Die Bewertung übernimmt ein Agent namens AutoJudge, der die Anweisung plus die vollständige Spur aus Aktionen und Screenshots liest und pass, fail oder Umgebungsfehler zurückgibt. Das Team bezifferte seine Genauigkeit auf 92.8% exakte Übereinstimmung mit 666 von Experten geprüften Beispielen und nannte den Fehler des Prüfers als erste Einschränkung im Paper. Ich respektiere, dass sie damit angefangen haben. Es bedeutet aber auch, dass die Spitze dieser Bestenliste ein Toleranzband hat.
Der Lohn für all die Hardware zeigt sich in der Fehleranalyse, dem Abschnitt, den ich zuerst lesen würde, wenn ich nur fünf Minuten hätte. Das Team nahm jede gescheiterte Qwen-3.7-Plus-Trajektorie auf echten Geräten und klassifizierte sie.
| Fehlermuster | Anteil | Wie es aussieht |
|---|---|---|
| Fehllesen der Oberfläche | 24.7% | Grauer Platzhaltertext wird als Eingabe gelesen, also leert er ein leeres Feld immer wieder |
| Störung durch Pop-ups | 18.2% | Werbung, Bezahlschranken, CAPTCHAs, leere Seiten |
| Fehlgeschlagene Erkundung | 19.5% | Findet eine Funktion nicht, die hinter mehreren Menüs steckt |
| Fehlerhafte Aktionsschleifen | 14.3% | Wiederholt zwölfmal eine Aktion, die nichts bewirkt hat |
| Steuerung physischer Widgets | 9.1% | Schießt bei einem Zeitwähler in beide Richtungen über das Ziel hinaus und landet nie |
| Verlorener Ausführungsstatus | 6.5% | Vergisst, welche Teilaufgaben schon erledigt sind, und fängt von vorn an |
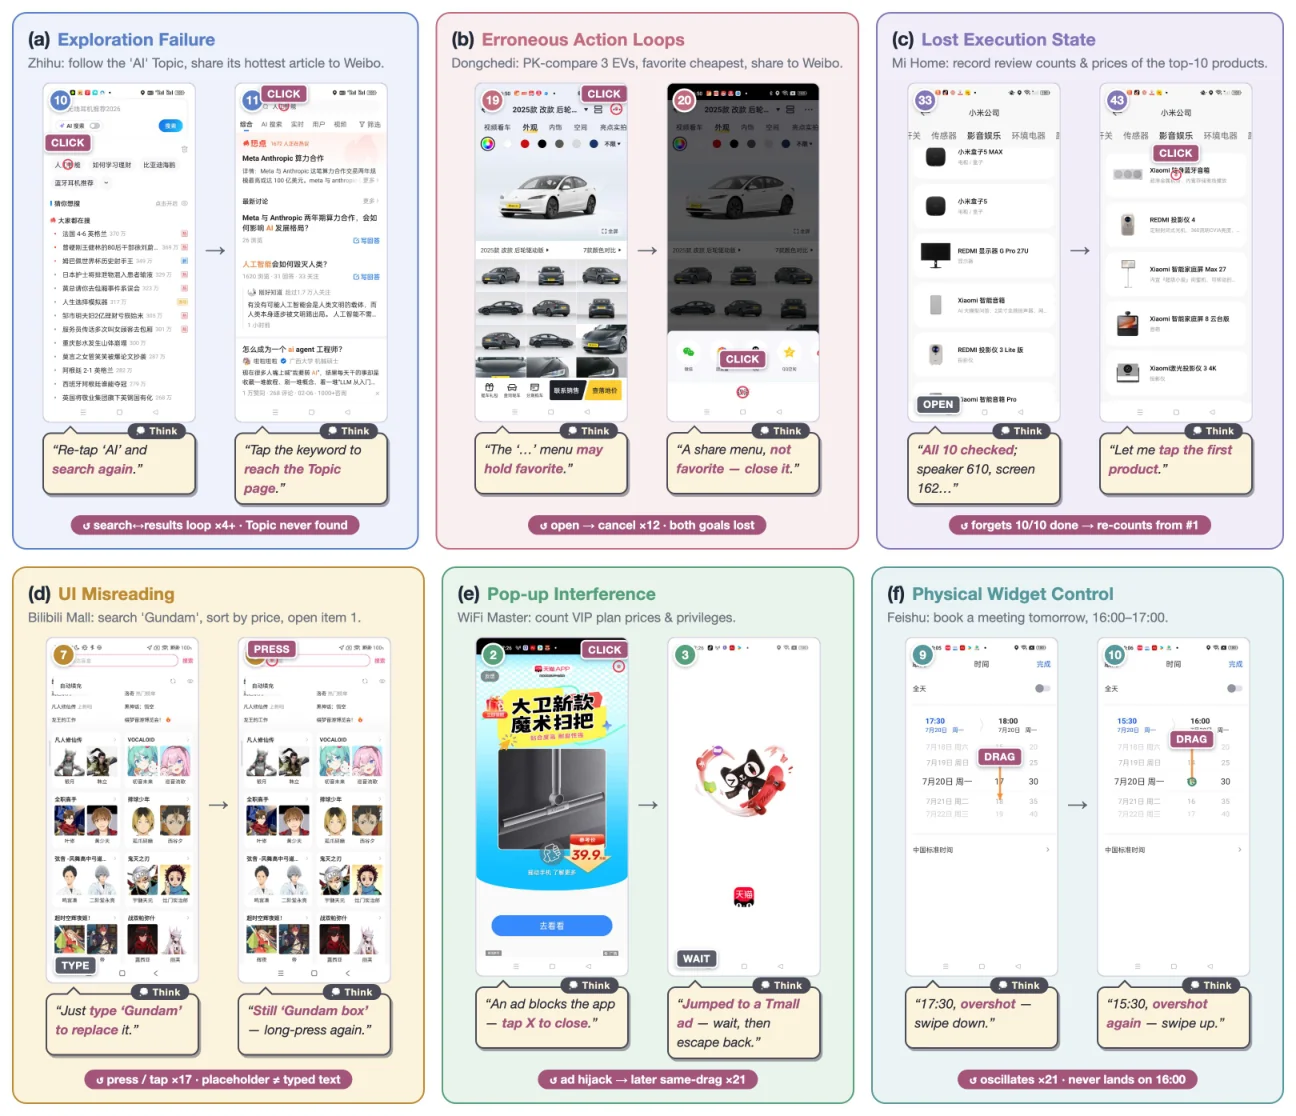
Addiert man die obersten Zeilen, liegen 52.0% der Fehler an der Umgebung und nicht am Denken: Eine Anzeige tauchte auf, eine Seite blieb leer, ein Platzhalter sah wie Text aus. Nur 40.3% sind der Agent, der nach eigenen Maßstäben scheitert. Der eigentliche Gegner eines GUI-Agenten ist die Oberfläche, und Oberflächen ändern sich, ohne dass es jemand ankündigt.
Kann man ihn tatsächlich nutzen? Nein, noch nicht
Das ist der Teil, den jeder Ankündigungs-Thread übersprungen hat, also sage ich klar, was existiert.
| Was Sie vielleicht wollen | Was es heute gibt |
|---|---|
| Modellgewichte | Keine. Tongyi-MAI auf Hugging Face hat MAI-UI-2B und MAI-UI-8B von Dezember 2025 und Januar 2026, nichts Neueres |
| Inferenzcode | Keiner. Das Repository hat 2.2k Sterne, 199 Forks, null Releases, null Pakete |
| Eine gehostete API | Keine veröffentlicht |
| Preise | Keine, weil es nichts abzurechnen gibt |
| Eine Verbraucher-App | Nicht angekündigt |
| Was Sie lesen können | Den technischen Bericht, die Projektseite, Demo-Videos und den Benchmark MobileWorld-Real |
Die Apache-2.0-Lizenz in der README gilt für den Inhalt des Repositorys, nicht für einen Checkpoint, was man wissen sollte, bevor jemand Ihnen erzählt, dieses Modell sei offen. Alibaba hat Erfahrung damit, Gewichte irgendwann zu veröffentlichen, die vernünftige Lesart ist also "noch nicht" statt "nie". Aber im Moment ist Qwen-UI-Agent ein Forschungsergebnis und nichts, was Sie in einen Workflow einbauen können. Der Leitfaden zu den Qwen-Preisen behandelt die Modelle, die Sie tatsächlich aufrufen können, und Qwen 3.7 Flash ist das günstige, das Leute im Produktivbetrieb nutzen.
Wenn Sie einkaufen statt lesen, besteht der ehrliche Vergleichssatz aus den Modellen, die schon heute auf Ihre API-Aufrufe antworten. Bei Desktop-Steuerung ist das zuerst Claude Opus 5, und unser Opus-5-Review erklärt im Detail, warum.
Darunter ist Gemini 3.5 Pro die günstigste glaubwürdige Option mit Bildverarbeitung, und GPT-5.6 ist die, für die die meisten Teams bereits einen Schlüssel haben.
Wenn offene Gewichte eine Anforderung und keine Vorliebe sind, lohnt sich der direkte Vergleich von Kimi K3 und DeepSeeks günstiger Stufe. Unser Artikel zu DeepSeek V4 Flash erklärt, warum die günstige Stufe diejenige ist, die Leute tatsächlich einsetzen.
Was das bedeutet, wenn Sie eine Support-Warteschlange betreuen
Hier muss ich ein Interesse offenlegen, denn das ist mein Tagesgeschäft. Ich baue Agent-Funktionen bei eesel, und die Fantasie, die ein GUI-Agent Support-Leitern verkauft, ist konkret und verlockend: eine KI, die sich ins Helpdesk einloggt und Tickets wie eine neue Kollegin bearbeitet, ohne Integrationsprojekt.
Zwei Dinge in diesem Paper sprechen dagegen, zuerst danach zu greifen.
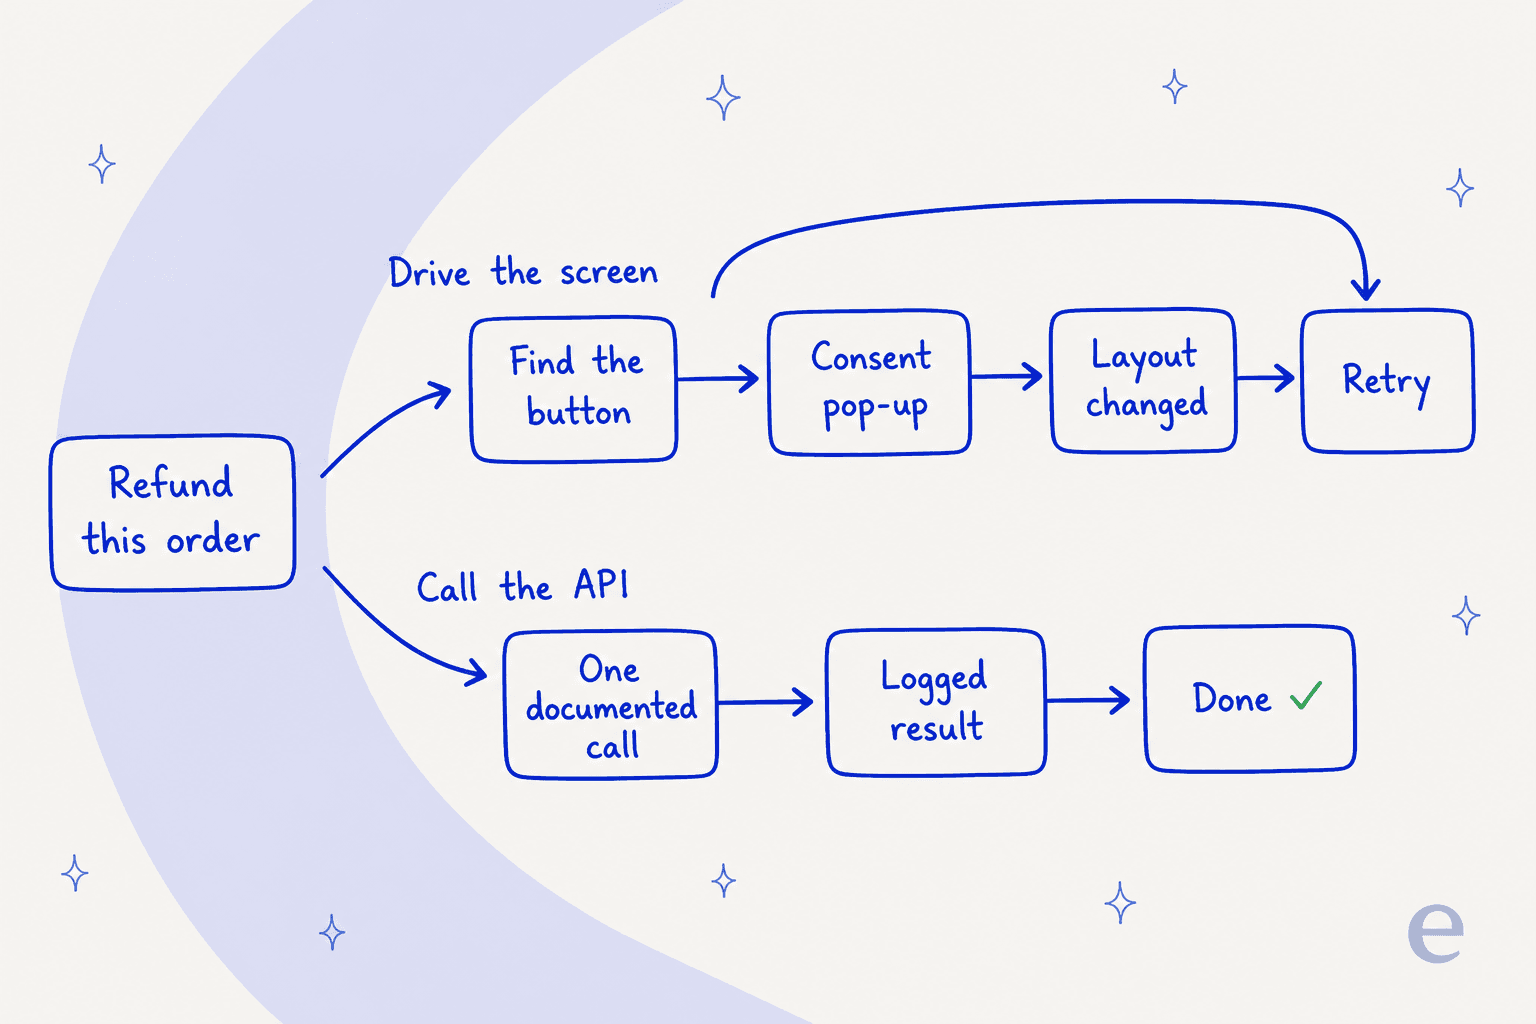
Das erste ist die Fehlertabelle. Werbung, Bezahlschranken, leere Seiten und falsch gelesene Feldzustände sind die Mehrheit der Fehler auf echten Geräten, und eine Helpdesk-Oberfläche hat alle dieselben Gefahren in milderer Form: ein Einwilligungsbanner, einen Tooltip der Funktionstour, ein Modal, das nur für Admins erscheint, eine Tabelle, die bei anderem Zoom umbricht. Ihr Erstattungsablauf sollte nicht ein CSS-Release vom Ausfall entfernt sein. Jedes brauchbare Helpdesk hat aus gutem Grund eine API. Die Zendesk-API erledigt mit einem dokumentierten Aufruf, was ein Pixel-Agent sich mit sechs Klicks und etwas Glück erarbeiten muss. Das gilt auch für Freshdesk API v2 mit veröffentlichten Ratenlimits, mit denen Sie planen können. Bildschirmsteuerung ist das richtige Werkzeug für den langen Schwanz interner Systeme, die nie eine API bekommen haben, nicht für die, die eine haben.
Das zweite ist ask_user, und ich meine das als Lob. Alibaba hat "anhalten und beim Menschen nachfragen" in den Aktionsraum aufgenommen, statt es später anzuflicken, sodass der Agent den Alipay-Betrag und die Notiz einträgt und dann beim Zahlungsschritt anhält. Das entspricht genau dem Einwand, den ich im Support am häufigsten höre. Ein CX-Leiter mit rund 7.000 Tickets im Monat sagte es uns so, und es ist mir seitdem im Gedächtnis geblieben:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist kein Feature-Wunsch zu Bildschirmen. Es ist der Wunsch nach einer Konfidenzgrenze, also derselben Designidee, die Alibaba als Aktion ausgeliefert hat. Wenn Sie darauf hinarbeiten, sind Übergaberegeln der praktische Startpunkt. Die Mechanik des Auslösers selbst steht in den Eskalationsregeln. Was entscheidet, in welchen Topf ein Gespräch zuerst fällt, ist meist die Ticket-Klassifizierung.
Das dritte ist das, was Alibaba mit 100 Telefonen bewiesen hat, und es gilt über das Smartphone hinaus. Eine Zahl aus einem Simulator sagt das Verhalten in der echten Umgebung nicht voraus. Das ist das ganze Argument für ihre Echtgeräte-Laufzeit, und es ist dasselbe Argument dafür, einen KI-Agenten über Ihre eigenen historischen Tickets laufen zu lassen, bevor er je ein Live-Ticket beantwortet. Wir haben das vor Jahren auf die harte Tour gelernt, als wir einen selbstsicher klingenden Bot mit völliger Gelassenheit falsche Antworten geben sahen, und deshalb geht bei eesel nichts live ohne vorherigen Simulationslauf. Die breitere Version dieses Arguments behandelt die Support-Qualitätssicherung, wo es darum geht, wie Teams das tatsächlich messen. Das menschliche Gegenstück ist das Agent-Coaching.
Nichts davon ist Kritik an Qwen-UI-Agent. Er ist ein Geräte-Operator, und auf Smartphones ein sehr guter. Er hat kein Ticketmodell, keine Wissensdatenbank, keine Warteschlange und keinen Begriff von einem Kunden, er liegt also eine Ebene unter den Tools in unserer Übersicht der besten KI-Agenten und der engeren Liste des besten KI-Agenten für den Support. Eine ganz andere Aufgabe.
Wenn Sie die Kategorienkarte wollen, zeigen KI-Agenten-Beispiele, wo sich jede Art lohnt. KI-Agenten vs. Chatbots zieht die Linie, nach der die meisten Käufer tatsächlich fragen, und regelbasierte Chatbots behandelt die Generation vor dieser.
eesel ausprobieren
Wenn Sie eine KI wollen, die Ihre Warteschlange abarbeitet statt in ihr herumzuklicken, bauen wir genau das. eesel verbindet sich über die API des Helpdesks, das Sie ohnehin betreiben, lernt aus Ihren vergangenen Tickets und dem Hilfecenter, statt zu raten, und führt eine Simulation über Ihren echten Ticketverlauf aus, bevor ein einziger Kunde eine Antwort sieht. Sie bekommen vorab die Erfolgsquote, die Lücken und die Formulierungen, die Sie korrigieren sollten. Abgerechnet wird pro bearbeitetem Ticket, nicht pro Arbeitsplatz, ein ruhiger Monat kostet also weniger als ein hektischer.

Dieses Genehmigungsfeld ist die ask_user-Idee im Produktivbetrieb: jede Tool-Aktion, die der Agent ausführen wollte, und ob ein Mensch sie genehmigt, abgelehnt oder noch nicht entschieden hat.
Beginnen Sie mit Helpdesk-KI für den Überblick, Ticket-Deflection, wenn Sie eine bestimmte Zahl anpeilen, oder Support-Automatisierungstools, wenn Sie noch vergleichen.
Ansonsten: eesel testen, kostenlos. Kein Anruf nötig.
Wo steht das Modell also
Qwen-UI-Agent ist der bisher stärkste veröffentlichte Beleg dafür, dass ein mittelgroßes Modell mit offener Architektur ein Smartphone besser bedienen kann als ein generalistisches Spitzenmodell. 82.1% bei MobileWorld gegen 67.5% für Opus 4.8 ist kein Rundungsfehler, und 38.2 Punkte über dem bisherigen Spezialisten-Bestwert sind ein Sprung. Der hybride Aktionsraum ist die richtige Idee und das Bündeln die richtige Optimierung. Alibaba hat zudem die Teile berichtet, die nicht schmeicheln, was seltener ist, als es sein sollte.
Er ist aber auch nicht verfügbar, auf westlichen App-Stacks unbewiesen, auf dem Desktop Zweiter und bei englischer Recherche 26 Punkte zurück. Wenn Sie über die Bestenliste hinaus nur eine Sache lesen, dann Tabelle 10. Der Bildschirm ist der Gegner, nicht das Modell, und das gilt, ob die Oberfläche Douyin ist oder Ihr Helpdesk. Wo eine API existiert, nutzen Sie die API. Wo nicht, wird diese Forschungslinie die Lücke irgendwann füllen, und genau deshalb lohnt es sich, sie zu beobachten.
Inzwischen sind die Fragen, die Ihr Quartal entscheiden, die langweiligen. Ob Ihre KI-Wissensdatenbank gut genug ist, um daraus zu antworten. Ob das Ticket-Routing Dinge an die richtige Stelle schickt, bevor eine KI sie anfasst.
Dann die Geldfrage, nämlich KI-Agent vs. menschlicher Agent: Kosten bei Ihrem tatsächlichen Volumen, nicht dem eines Anbieters. Und die Rahmenfrage, denn das Versprechen der KI-Teammitglieder und das des KI-Mitarbeiters gehen weiter auseinander, als das Marketing nahelegt.
Zuletzt die Frage, die man aufschiebt: ob sich ein KI-Ticketsystem die Migration vom bestehenden lohnt. Für den Rest von Alibabas Sortiment ist Qwen-Alternativen die Übersicht und das Qwen3.8-Max-Review der engste Verwandte dieses Beitrags.
Häufig gestellte Fragen
Was ist Qwen-UI-Agent?
Ist Qwen-UI-Agent Open Source oder herunterladbar?
Wie gut ist der Qwen-UI-Agent im Vergleich zu Claude und GPT?
Was kostet Qwen-UI-Agent?
Kann ein GUI-Agent mein Helpdesk für mich bedienen?
Was passiert, wenn der Agent bei einem echten Ticket danebenliegt?
ask_user, damit er vor einer Zahlung oder einer Löschung anhalten kann. Das ist dieselbe Idee wie ein Konfidenz-Schwellenwert im Support: Der Agent beantwortet automatisch, was er sicher weiß, und übergibt den Rest. Unsere Leitfäden zu Übergaberegeln und Eskalationsregeln zeigen, wie man das einrichtet.