Qwen-UI-Agent-Alternativen: 8 GUI-Agenten, die Sie 2026 wirklich einsetzen können

Rama Adi

Katelin Teen
Zuletzt bearbeitet August 24, 2026
Sie können nicht von Qwen-UI-Agent wegwechseln, weil es noch nichts gibt, wovon man wegwechseln könnte. Alibabas Tongyi-MAI-Team hat am 30. Juli 2026 einen technischen Bericht mit hervorragenden Mobile-Werten veröffentlicht und danach weder einen Checkpoint noch eine API noch einen Preis geliefert. Die Hugging-Face-Organisation listet vier Modelle, und keines ist dieses. Die Suche nach Alternativen ist also in Wahrheit die Suche nach einem GUI-Agenten, den es tatsächlich gibt.
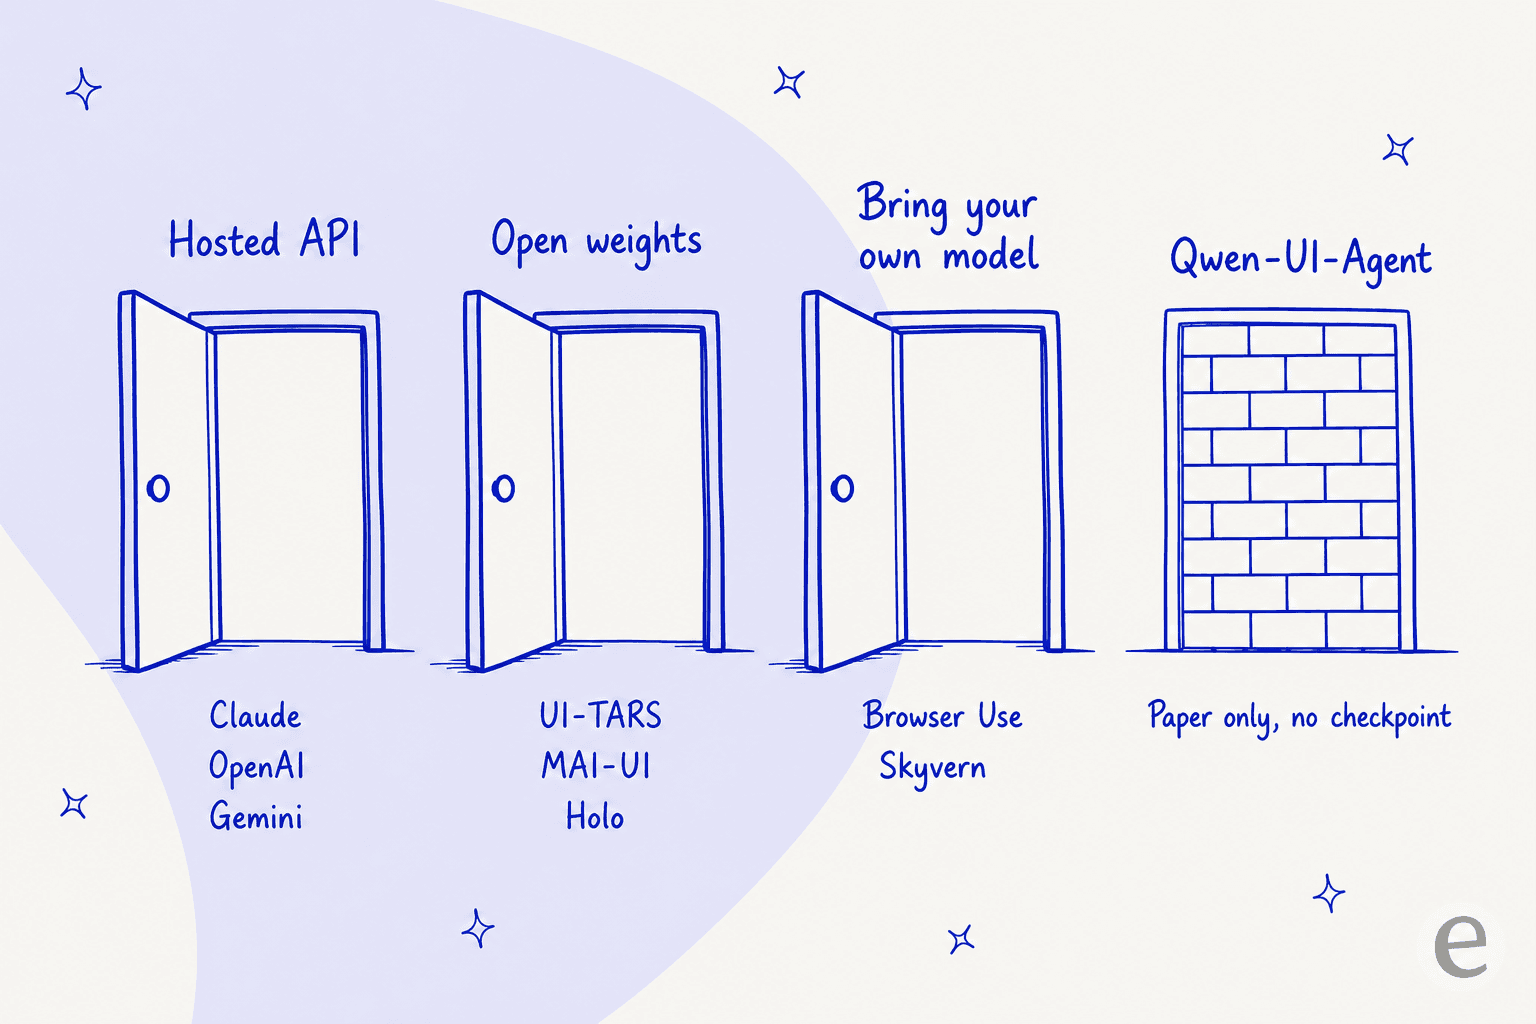
Acht gibt es, und sie sortieren sich in drei Wege statt in ein Ranking. Gehostete APIs von Anthropic, OpenAI und Google liefern die stärksten Modelle und die beste Sicherheitsinfrastruktur, wobei Google als Einziger auch Android steuert. Offene Gewichte von UI-TARS, MAI-UI und Holo 3.1 bieten Apache 2.0 und einen Laptop unter Ihrer Kontrolle, bei spürbar geringerer Genauigkeit. Browser Use und Skyvern bieten weder ein eigenes Modell noch ein Geheimnis: Sie steuern Chromium mit dem LLM, auf das Sie sie richten, und sind der günstigste Weg, eine Web-Aufgabe zu erledigen.
Zwei Dinge haben mich überrascht. Jeder offene GUI-Agent, den Sie herunterladen können, ist ein Qwen-Fine-Tune, der Abschied von Alibaba ist also eine Lizenzentscheidung und keine architektonische. Und in den eigenen Traces von Qwen-UI-Agent waren 55,1 % der Aktionen im schwersten Desktop-Benchmark getippte Befehle, keine Klicks. Der beste bildschirmsteuernde Agent der Welt meidet den Bildschirm, wenn er kann. Wenn Ihre Aufgabe Support-Tickets sind, nehmen Sie den Hinweis ernst: eesel spricht über die APIs mit Zendesk und Gorgias und lässt sich an den Tickets des letzten Monats im Trockenlauf testen, was mit keiner Maus möglich ist.
Wonach Leute eigentlich suchen, wenn sie das eingeben
Ich baue beruflich Integrationen, mein erster Reflex bei jedem neuen Agentenmodell ist deshalb, den Endpunkt zu suchen. Bei Qwen-UI-Agent gibt es keinen.
Das ist schade, denn Alibaba liefert normalerweise. Wenn Sie von unserer Übersicht zu Qwen-Alternativen oder dem Qwen-Test kommen, wissen Sie, dass die Textmodelle öffentliche Preislisten und echte Endpunkte haben. Dieses hier nicht.
Das sollte man genau sagen, denn die Berichterstattung war es nicht. Die Projektseite hat genau drei Schaltflächen: technischer Bericht, GitHub und ein Demo-Video. Das GitHub-Repository hat 2,2k Sterne und null Releases, null Tags und null Pakete. Die Tongyi-MAI-Organisation auf Hugging Face veröffentlicht Z-Image, Z-Image-Turbo, MAI-UI-8B und MAI-UI-2B, und das ist die ganze Liste. Apache 2.0 steht im README, aber eine Lizenz auf einem Repository voller Abbildungen ist kein Modell, das Sie ausführen können.
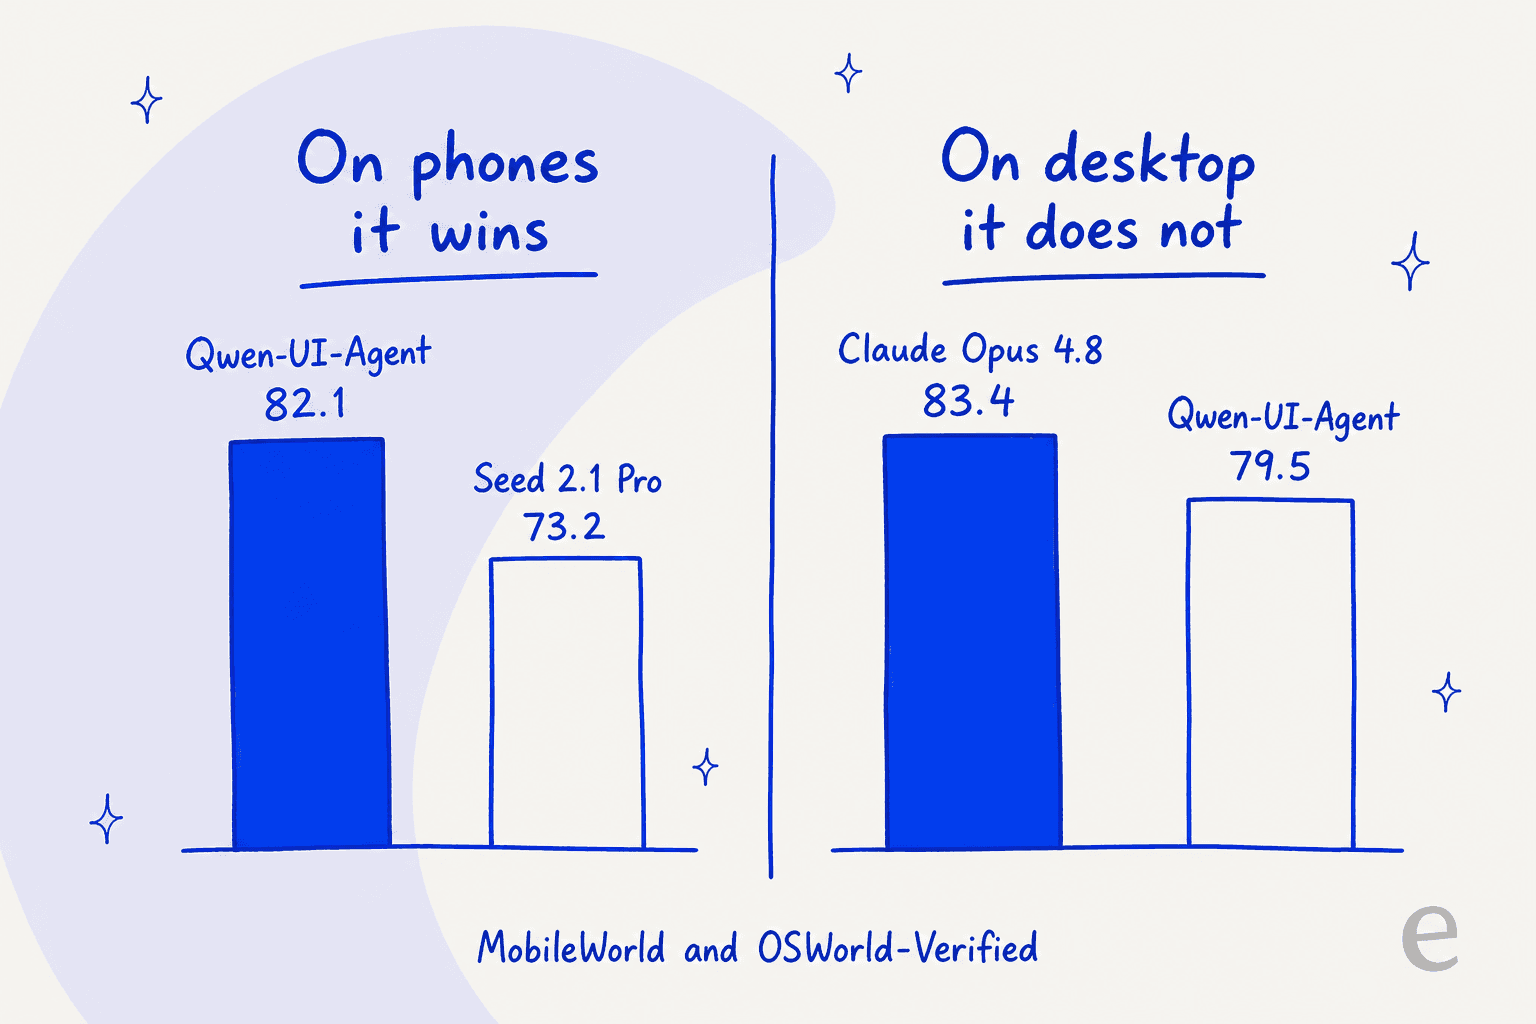
Das schmälert die Arbeit nicht. Die Schlagzeile des Papers ist eine 27B-Variante, die die Autoren laut technischem Bericht als ihr primäres Modell für die Ende-zu-Ende-Auswertung bezeichnen, und auf Smartphones ist sie klar das Beste, was bisher veröffentlicht wurde: 82,1 % auf MobileWorld gegenüber 73,2 bei Seed 2.1 Pro und 92,2 % auf einem zurückgehaltenen Benchmark mit 409 Aufgaben in 104 Live-Android-Apps, ausgeführt auf einer Flotte von mehr als 100 physischen Geräten. Die letzte Zahl ist die interessante, weil sie auf echten Geräten statt auf Emulatoren gemessen wurde.
Beim Desktop wird die Geschichte in der Weitererzählung eingeebnet. Ein viel geteilter Wochenrückblick formulierte es so:
"Alibaba also released Qwen-UI-Agent, a 27B GUI agent model that claims top scores on MobileWorld (82.1%), OSWorld-Verified (79.5%), and WebArena (73.6%), beating GPT-5.6 Sol, Claude Opus 4.8, and Gemini 3.1 Pro."
Alibabas eigene Grafik sagt bei der mittleren Zahl etwas anderes. Auf OSWorld-Verified erreicht Claude Opus 4.8 83,4 und Qwen-UI-Agent 79,5, und das Paper hält ausdrücklich fest, dass es auf Platz zwei liegt und nur hinter Opus 4.8 zurückbleibt. Im schwereren Langzeit-Set OSWorld-v2 wächst der Abstand auf 40,0 gegenüber 54,8 bei Opus 4.8 im Teilfortschritt. Die Behauptung "schlägt" gilt für Mobile und für WebArena. Für den Desktop-Benchmark, den die meisten Käufer zitieren, gilt sie nicht.
Man sollte auch daran denken, dass diese Kategorie eine Geschichte des Zu-viel-Versprechens hat. Adept AI lieferte mit ACT-1 den ersten ernsthaften Agenten, der Bildschirme anklickt, und schwenkte dann um; Rabbit AI verkaufte ein großes Aktionsmodell in einem Consumer-Gerät. Demos von Agenten, die Software bedienen, waren der Realität schon früher voraus, ein guter Grund, jede Grafik in diesem Beitrag zweimal zu lesen.
Die ehrliche Rahmung dieses Beitrags lautet also: Sie ersetzen kein Produkt, Sie wählen Ihr erstes. Und die Wahl hängt weniger vom Score ab als davon, durch welche von drei Türen Sie gehen.
Was das neutrale Leaderboard sagt
Fast jede Zahl im vorigen Abschnitt stammt vom Anbieter selbst, auch Alibabas. Bevor die Liste kommt, hier derselbe Benchmark, durchgeführt von jemandem, der nichts zu verkaufen hat.
OSWorld-Verified hat ein von den Maintainern betriebenes Board, auf dem das OSWorld-Team Einreichungen selbst unter einheitlichen Bedingungen auf denselben 361 Aufgaben auswertet. Es wird auf der Seite nicht als Tabelle gerendert, sondern clientseitig aus einer Tabellendatei geladen. Hier sind deshalb die acht besten Bestwerte aus dieser Datei.
| Rang | Agent oder Modell | Institution | Typ | Erfolgsquote |
|---|---|---|---|---|
| 1 | Intelligence-Indeed Agent | Intelligence Indeed | Agentisches Framework | 90.19 |
| 2 | claude-fable-5[1m] | Anthropic | Allgemeines Modell | 85.96 |
| 3 | Pointer Agent w/ Opus 4.7 | Pointer | Agentisches Framework | 83.64 |
| 4 | claude-opus-5[1m] | Anthropic | Allgemeines Modell | 83.39 |
| 5 | Coasty CUA v1 | Coasty Team | Allgemeines Modell | 82.81 |
| 6 | Holo3-35B-A3B | H Company | Spezialisiertes Modell | 82.56 |
| 7 | Pointer Agent w/ Sonnet 4.6 | Pointer | Agentisches Framework | 81.45 |
| 8 | Muse Spark 1.1 | Meta Superintelligence Labs | Allgemeines Modell | 80.67 |
Daraus ergeben sich drei Dinge, die alle diesen Beitrag geprägt haben.
Qwen-UI-Agent steht nicht darauf und kann es nicht. Die Einreichungsregel des Boards lautet: Sie vereinbaren einen Termin, und die Maintainer führen Ihren Agent-Code auf ihrer Seite aus. Ohne Checkpoint und ohne API gibt es nichts, was sie ausführen könnten. Die einzigen Alibaba-Einträge in der gesamten Tabelle mit 66 Einträgen sind Qwen 3.7 Plus mit 73,3 und GUI-Owl-1.5 32B mit 55,44. Nimmt man Alibabas selbst gemeldete 79,5 für bare Münze und setzt sie in diese Tabelle ein, landet sie auf Platz 9 von 66, außerhalb der ersten acht.
Die Spitze ist ein Harness, kein Modell. Fünf der besten zwölf sind agentische Frameworks, die das Modell eines anderen umhüllen, und der Eintrag auf Platz eins ist mit 90,19 einer davon. Wer erwartet hatte, ein Modell zu kaufen und fertig zu sein, erfährt vom Board: Das Gerüst bringt mehr Punkte als die Gewichte.
Ein Modell mit offenen Gewichten ist tatsächlich dabei. Holo3-35B-A3B liegt mit 82,56 auf Platz 6, höher als H Companys eigene veröffentlichte Angabe von 78,85, und wurde von jemand anderem als H verifiziert. Das ist die glaubwürdigste Zahl für jeden herunterladbaren GUI-Agenten, und sie hat Holo auf meiner Liste nach oben gebracht.
Wer diese Zahlen zitiert, sollte wissen: Die menschliche Leistung auf OSWorld liegt bei 72,36 %, und alles in diesen Top zwölf liegt inzwischen darüber. Außerdem eine Benennungsfalle: Anthropic meldet für Opus 4.8 selbst 83,4, während die Zeile mit 83,39 in dieser Tabelle claude-opus-5[1m] heißt und es dort gar keine Opus-4.8-Zeile gibt. Die Zahl passt, das Label nicht.
Wie ich ausgewählt habe und was ich gemessen habe
Ich habe diese Woche in den Dokumentationen, Modellkarten, Lizenzdateien und Preislisten jedes Kandidaten verbracht und alles verworfen, was ich nicht auf den eigenen Seiten des Anbieters verifizieren konnte. Sechs Dinge haben die Liste entschieden.
Ob Sie es heute bekommen. Ein Paper ist keine Alternative. Entweder sind die Gewichte herunterladbar, oder es gibt einen Endpunkt mit Preis, oder es fliegt raus.
Wer den Bildschirm liefert. Jeder davon braucht etwas, das er steuern kann: eine VM, ein Headless-Chromium, ein Android-Gerät. Fast keiner liefert das mit. Das ist der Posten, den alle vergessen.
Welche Bildschirme er steuert. Browser, Desktop und Mobile sind drei verschiedene Produkte unter einem Namen, und die Anbieter sind nicht gleich ehrlich darüber, welche sie können.
Wessen Harness den Score erzeugt hat. Jede Zahl in diesem Beitrag stammt vom Anbieter, sofern ich nichts anderes sage, und mehrere wurden auf veränderten Benchmarks gemessen. Ich sage es jedes Mal dazu. Wie groß dieser Abstand ist, ist keineswegs hypothetisch. In einem Launch-HN-Thread wurde ein Gründer zu einer SOTA-Behauptung herausgefordert und antwortete mit beiden Zahlen in einem Satz:
"We've hit 82.8% on OSWorld Verfied(on the official page) and with our latest internal testing we're hitting 85.6% which we've posted"

Das ist ein selbst gemessener Aufschlag von 2,8 Punkten, ehrlich benannt, von einem Anbieter, dessen Zahl auf dem neutralen Board ich nachprüfen kann. Nehmen Sie an, dass hinter jeder Grafik dieser Kategorie etwas Ähnliches steckt, auch hinter Alibabas.
Was ein Lauf kostet. Nicht der Preis pro Million Token, sondern der Preis pro Lauf, der von der Schrittzahl dominiert wird, weil jeder Schritt den ganzen Verlauf plus einen neuen Screenshot erneut sendet. Wer dieselbe Rechnung auf Personal anwenden will, findet sie in unserem Kostenvergleich von Agenten. Praktiker verfolgen das akribisch, und ihre Zahlen sind nicht zimperlich:
"Numbers I was seeing: - 20 to 50 LLM calls per task - $0.50 to $3.00 per task at Claude Sonnet 4.6 prices - Half the runs drifted off-task halfway through"

Ob Sie vor der Produktion testen können. Das ist der wichtigste Punkt in der Praxis, und keiner löst ihn. Für Text-Agenten ist es ein halbwegs gelöstes Problem, wie unser Leitfaden zu OpenAI Evals zeigt, und ein ungelöstes, sobald die Ausgabe eine Mausbewegung ist.
Zum Kostenpunkt hier die Rechnung, die meine Sicht auf GUI-Agent-Budgets verändert hat. Ziehen Sie die Schrittzahl und sehen Sie, wie sich die Kurve biegt.
Die acht Alternativen im Überblick
| Tool | Am besten für | So bekommen Sie es | Gesteuerte Bildschirme | Lizenz oder Preis | Bester veröffentlichter Score und wessen Harness | Wer den Bildschirm liefert | Trockenlauf vor Produktion | Schutz vor Injection | Kostenlose Stufe |
|---|---|---|---|---|---|---|---|---|---|
| Claude computer use | Desktop-Arbeit, die stimmen muss | Gehostete API, GA | Desktop, Browser | Opus 5 $5 / $25 pro MTok | 83.4% OSWorld-Verified (Opus 4.8, Anthropic) | Sie | Nein | Klassifikatoren standardmäßig an | Nein |
| Gemini computer use | Eine API für Smartphone und Desktop | Gehostete API, Preview-Flag | Browser, Mobile, Desktop | 3.7 Flash $0.75 / $3.75 pro MTok | 83.0% OSWorld-Verified (3.6 Flash, Google) | Sie | Nein | Opt-in, standardmäßig aus | Nein |
| OpenAI computer use | Teams, die schon die Responses API nutzen | Gehostete API, GA | Desktop, Browser | Sol $4 / $20, Luna $0.20 / $1.20 | 92.8% Online-Mind2Web (OpenAI) | Sie | Nein | Richtlinie veröffentlicht, Sie setzen sie durch | Nein |
| ByteDance UI-TARS | Eine permissive Lizenz, mit der Sie ausliefern können | Gewichte auf Hugging Face | Desktop, Browser, Android per Vorlage | Apache 2.0 | 27.5% OSWorld für das offene 8B (ByteDance) | Sie | Nein | Keiner | Gewichte sind kostenlos |
| MAI-UI 8B und 2B | Der nächste herunterladbare Verwandte | Gewichte auf Hugging Face | Mobile, Desktop | Apache 2.0 | 65.7% ScreenSpot-Pro für das 8B (Alibaba) | Sie | Nein | Keiner | Gewichte sind kostenlos |
| Holo 3.1 | Offene Gewichte mit gehostetem Fallback | Gewichte plus gehostete API | Web, Desktop, Mobile | Apache 2.0, API $0.25 / $1.80 | 82.56% OSWorld-Verified, 6. (vom Maintainer betriebenes Board) | Sie, oder H's Managed Agents | Nein | Nicht dokumentiert | 10 RPM, keine Karte |
| Browser Use | Browser-Jobs im großen Maßstab | Python-Bibliothek plus Cloud | Nur Browser | MIT-Bibliothek, Cloud ab $29/Monat | 87.4% auf Odysseys (von Dritten gehostet) | Cloud liefert Chromium | Nein | Nicht dokumentiert | 10 Aufgaben/Monat |
| Skyvern | Eingeloggte Abläufe mit 2FA im Weg | Selbst hosten oder Cloud | Nur Browser | AGPL-3.0, Cloud ab $29/Monat | 85.85% WebVoyager, Jan. 2025 (Skyvern) | Cloud liefert Chromium | Nein | Nicht dokumentiert | 5.000 Credits |
Zwei Spalten lohnen den genauen Blick. Niemand bietet einen Trockenlauf, die größte betriebliche Lücke der ganzen Kategorie. Und wer den Bildschirm liefert teilt die Liste sauber: Die drei Frontier-Labs geben Ihnen ein Modell und wünschen viel Glück mit der VM, während Browser Use und Skyvern Ihnen einen laufenden Browser geben und Sie das Modell wählen lassen.
1. Claude computer use
Am besten für Desktop-Automatisierung, bei der ein falscher Klick teuer ist.
So funktioniert es. Sie deklarieren einen einzelnen Tool-Eintrag, und Anthropics Modell liefert Aktionen zurück, die Ihr Code ausführt. Die aktuelle Version ist ein Client-Toolset, computer_toolset_20260801, das 17 Mitglieds-Tools hinter einer Deklaration bündelt und keinen Beta-Header braucht. Es läuft auf Fable 5, Mythos 5, Opus 5, Opus 4.8 und Sonnet 5, ausdrücklich nicht auf Haiku 4.5. Für alle, die eine echte Pipeline bauen, ist das Schöne, dass Sie demselben Modell im selben tools-Array ein Bash-Tool und einen Dateieditor mitgeben können, sodass es mitten in der Aufgabe aus der GUI ins Terminal wechseln kann.
Zwei benachbarte Angebote sind interessant, wenn Sie diesen Weg gehen: Claude Managed Agents zum Hosten und Beaufsichtigen der Schleife und die Claude-Desktop-Plattform, wenn Sie einen Agenten lieber auf eine App als auf ein ganzes Betriebssystem beschränken.
Was mir gefällt. Die Scores sind die besten veröffentlichten auf dem Desktop: 83,4 % auf OSWorld-Verified für Opus 4.8 und 70,57 % auf dem neueren, schwereren OSWorld 2.0 für Opus 5 gegenüber 62,6 bei GPT-5.6 Sol. Was ich aber wirklich schätze, ist die Sicherheitsschicht. Deklarieren Sie das offizielle Tool, lässt Anthropic automatisch Prompt-Injection-Klassifikatoren über jeden Screenshot laufen, und wenn einer anschlägt, wird das Modell dazu gebracht, vor der nächsten Aktion bei Ihnen um Bestätigung zu bitten. Laut Anthropic läuft das parallel zur Inferenz mit nahezu null zusätzlicher Latenz und ohne zusätzliche Kosten. Niemand sonst in dieser Liste liefert das standardmäßig aktiv aus.
Wo es an Grenzen stößt. Es gibt überhaupt keine Mobile-Geschichte. Die Referenzumgebung ist X11 unter Linux in einem Container, das Vokabular besteht ganz aus Maus und Tastatur, und in den 17 Mitgliedern gibt es nirgends Tippen, Wischen oder Pinch. Genau auf der Achse, auf der Qwen-UI-Agent am stärksten ist, ist das also kein Ersatz. Anthropic nennt Latenz selbst als erste Einschränkung, in eigenen Worten möglicherweise zu langsam im Vergleich zu einem Menschen, der dieselben Klicks macht. Und der Token-Overhead ist real: Die Toolset-Definition kostet bei jeder einzelnen Anfrage rund 4.520 Eingabe-Token, bevor Sie ein Pixel gesendet haben, und jeder Screenshot fügt 1.000 bis 1.800 hinzu. Noch eine Falle für Implementierer: Die API skaliert zu große Bilder nicht für Sie herunter, sie lehnt sie ab.
Preise.
| Modell | Eingabe / MTok | Ausgabe / MTok | Cache-Lesen | Hinweise |
|---|---|---|---|---|
| Opus 5 | $5.00 | $25.00 | $0.50 | Fast Mode ist genau 2x |
| Opus 4.8 | $5.00 | $25.00 | $0.50 | Hält den Score von 83,4 % |
| Sonnet 5 | $2.00 | $10.00 | $0.20 | Toolset unterstützt |
| Fable 5 | $10.00 | $50.00 | $1.00 | Toolset unterstützt |
| Haiku 4.5 | $1.00 | $5.00 | $0.10 | Toolset nicht unterstützt |
Batch halbiert beide Seiten, der volle 1M-Kontext läuft zu Standardpreisen ohne Sprung, und Computer Use ist für Zero Data Retention geeignet, weil die Schleife auf Ihrer Seite läuft.
Fazit: Wenn die Arbeit auf einem Desktop stattfindet und der Schaden eines Fehlers mehr als ein Ärgernis ist, würde ich hiermit anfangen, und die eingebauten Injection-Klassifikatoren sind der Grund. Lassen Sie es aus, wenn die Arbeit auf einem Smartphone stattfindet, denn das kann es schlicht nicht. Wenn die Sorge Vendor-Lock-in statt Fähigkeit ist, deckt unsere Liste der Claude-Alternativen den Rest des Feldes ab. Wer die beiden großen API-Anbieter direkt vergleicht, hat mehr von unserem Leitfaden zu OpenAI- vs. Anthropic-APIs als von einer Benchmark-Grafik.
2. Gemini computer use
Am besten für Smartphones und Desktops über einen einzigen gehosteten Endpunkt.
So funktioniert es. Es gibt kein eigenes Computer-Use-Modell mehr. Google hat die Fähigkeit in ein eingebautes computer_use-Tool gefaltet, das sich an allgemeine Flash-Modelle hängt, und das alte gemini-2.5-computer-use-preview-10-2025 ist jetzt als Legacy-Preview gekennzeichnet. Das Tool selbst kostet nichts extra und wird als normale Token zum Preis des Modells abgerechnet. Koordinaten kommen auf ein Raster von 0 bis 999 normalisiert zurück, und Google stellt klar, dass dies ein clientseitiges Tool ist, die Schleife also Ihnen gehört.
Was mir gefällt. Dies ist die einzige gehostete API der Liste mit dokumentierter Mobile-Umgebung, und das ist ein echtes Unterscheidungsmerkmal, kein Marketingsatz. Es gibt drei getrennte Aktionstabellen: ENVIRONMENT_BROWSER mit 21 Aktionen, ENVIRONMENT_MOBILE mit 10, die Google als Android-optimiert beschreibt und die open_app, list_apps und long_press hinzufügt, während scroll und hotkey entfallen, und ENVIRONMENT_DESKTOP mit 17 für Cursorsteuerung auf Betriebssystemebene. Auch die Desktop-Entwicklung ist steil: OSWorld-Verified ging von 65,1 bei 3 Flash über 78,4 bei 3.5 Flash auf 83,0 bei 3.6 Flash, womit Google auf einen halben Punkt an Anthropics Bestwert herankommt. Und es ist mit Abstand der günstigste gehostete Weg.
Wo es an Grenzen stößt. Die Dokumentation ist auf eine Weise chaotisch, die Sie einen Nachmittag kosten wird. Die Modellübersicht listet unter Tool- und Agentenmodellen weiterhin nur das alte 2.5-Modell, der höchste von Google veröffentlichte OSWorld-Score gehört zu einem Modell, das die Computer-Use-Seite nicht auflistet, und Computer Use steht selbst beim allgemein verfügbaren gemini-3.7-flash noch als "Supported (Preview)". Google hat außerdem Online-Mind2Web, WebVoyager oder AndroidWorld für kein 3.x-Modell neu veröffentlicht, die Mobile-Fähigkeit hat also einen dokumentierten Aktionsraum und keinen aktuellen Benchmark dahinter. Prompt-Injection-Erkennung gibt es, sie ist aber standardmäßig aus, das Gegenteil von Anthropics Haltung. Eine kostenlose Stufe gibt es dafür gar nicht. Und der Preis des empfohlenen Modells verdoppelt sich am 1. Januar 2027.
Preise.
| Modell | Eingabe / MTok | Ausgabe / MTok | Hinweis |
|---|---|---|---|
gemini-3.7-flash | $0.75 | $3.75 | Empfohlen. Steigt am 1. Jan. 2027 auf $1.50 / $7.50 |
gemini-3.5-flash | $1.50 | $9.00 | |
gemini-3.5-flash-lite | $0.30 | $2.50 | Günstigster Weg in diesem ganzen Beitrag |
gemini-2.5-computer-use-preview | $1.25 | $10.00 | Legacy-Preview |
Fazit: Die Wahl, wenn Sie einen Anbieter für Browser, Desktop und Android brauchen, und die Wahl, wenn die Kosten pro Lauf die entscheidende Grenze sind. Schalten Sie die Injection-Erkennung ein, bevor Sie irgendetwas anderes tun, und kalkulieren Sie Ihr Budget für 2027 mit dem Preis nach der Erhöhung. Unsere Aufschlüsselung zu den Gemini-3-Preisen hat die breitere Preisliste, falls Sie ernsthaft kalkulieren, und Gemini Agentic Vision erklärt, wie aus dem Screenshot ein Klickziel wird. Google gegen das Feld abzuwägen ist Aufgabe unseres Beitrags zu Gemini-Alternativen.
3. OpenAI computer use
Am besten für Teams, deren Stack ohnehin bei der Responses API endet.
So funktioniert es. computer-use-preview ist veraltet und aus der Preisliste verschwunden. Computer Use ist jetzt tools: [{ type: "computer" }] bei allen drei GPT-5.6-Stufen, ohne Gebühr pro Aufruf für das Tool selbst. Der Leitfaden dokumentiert drei Harness-Formen statt einer, was ich gut fand: die eingebaute Schleife, die strukturierte UI-Aktionen zurückgibt, ein eigenes Tool über einem Playwright- oder Selenium-Harness, den Sie schon haben, und ein Code-Ausführungs-Harness, in dem das Modell zwischen Klicken und dem Schreiben kurzer Skripte wechselt. Das Aktionsvokabular umfasst neun Typen, und sie werden in einem actions[]-Array gebündelt, statt einzeln zu kommen.
Was mir gefällt. Die Browser-Zahlen sind hier mit deutlichem Abstand die stärksten: 92,8 % auf Online-Mind2Web, 67,3 % auf WebArena-Verified, 90,4 % auf BrowseComp. OpenAI veröffentlicht außerdem ein Kundenergebnis statt nur einen Benchmark: 95 % Erfolg beim ersten Versuch bei rund 30.000 Grundsteuerportalen, innerhalb von drei Versuchen steigend auf 100 %. Und die Luna-Stufe macht Experimente mit 0,20 $ Eingabe und 1,20 $ Ausgabe günstig.
Wo es an Grenzen stößt. Kein Mobile, auf fünf Arten bestätigt: Beide dokumentierten Umgebungen sind Desktops, die empfohlenen Auflösungen heißen Desktop, im Vokabular gibt es kein Tippen, Wischen oder Zurück, und jeder veröffentlichte Benchmark ist Desktop oder Browser. Auch das Sicherheitsmodell ging in die falsche Richtung. Das allgemein verfügbare Tool hat den pending_safety_checks-Handshake der Preview-Zeit gestrichen, übrig bleiben eine veröffentlichte dreistufige Bestätigungsrichtlinie, ein Prompt-Injection-Snippet zum Einfügen und die Anweisung, eine Domain-Allowlist zu führen, was Sie alles selbst umsetzen. Wichtig zu wissen, bevor Sie um die Consumer-Seite herum planen: Der ChatGPT agent ist eingestellt, und sein Nachfolger, der Cloud-Browser in ChatGPT Work, nimmt keine Zugangsdaten an, nutzt weder Autofill noch Passwortmanager, meldet sich nicht auf Websites an und schließt keine Zahlungen ab. OpenAIs eigene API schlägt den eigenen Consumer-Agenten auf Online-Mind2Web um 21,9 Punkte.
Preise.
| Modell | Eingabe / MTok | Gecacht | Ausgabe / MTok | Langer Kontext Ein / Aus |
|---|---|---|---|---|
gpt-5.6-sol | $4.00 | $0.40 | $20.00 | $8.00 / $30.00 |
gpt-5.6-terra | $2.00 | $0.20 | $12.00 | $4.00 / $18.00 |
gpt-5.6-luna | $0.20 | $0.02 | $1.20 | $0.40 / $1.80 |
Batch und Flex kosten beide die Hälfte, der Fast Mode das Doppelte, und dies sind Aktionspreise bis 21. November 2026. Der Launch-Beitrag nannte Sol mit $5 / $30 und Luna mit $1 / $6, Luna läuft derzeit also bei einem Fünftel des eigenen Listenpreises. Außerdem gibt es eine Kontextstufen-Grenze bei 270K Token, die eine Screenshot-Schleife schneller erreicht, als Sie denken, und die kostenlose Stufe wird gar nicht unterstützt. Auf der Consumer-Seite stehen die Zahlen in unserem Leitfaden zu den Atlas-Preisen, einem anderen Produkt zu einem anderen Preis.
Fazit: Die Wahl für Browser-zuerst und die, die ich träfe, wenn das umgebende System schon Function Calling spricht und Sie lieber ein Tool hinzufügen als einen Anbieter übernehmen. Planen Sie Entwicklungszeit für die Sicherheitsschicht ein, denn diese Arbeit liegt jetzt bei Ihnen. Wie sich die drei Stufen anderswo unterscheiden, steht unter OpenAI-Modelle.
4. ByteDance UI-TARS
Am besten für eine permissive Lizenz, mit der Sie tatsächlich ein kommerzielles Produkt ausliefern können.
So funktioniert es. Sechs Checkpoints liegen in der ByteDance-Seed-Organisation unter Apache 2.0, ohne Sperre und ohne Klickzustimmung: ein 2B, zwei 7B-Varianten, zwei 72B-Varianten und das 1.5-7B, das alle tatsächlich nutzen. Die Repository-Namen untertreiben die Größen, denn das "7B" hat in Wahrheit 8,3B Parameter und das "72B" 73,4B. Drei Prompt-Vorlagen werden mitgeliefert, COMPUTER_USE, MOBILE_USE und GROUNDING, Mobile ist also eine dokumentierte Modellfähigkeit mit den Aktionen long_press, open_app, press_home und press_back.
Was mir gefällt. Apache 2.0 ohne Nicht-kommerziell-Zusatz, bestätigt in der LICENSE-Datei, auf allen sechs Modellkarten und im Desktop-App-Repository. Das Ökosystem rund um das 8B ist das tiefste aller offenen GUI-Agenten: 11 Fine-Tunes, 13 Quantisierungen und GGUF-Builds für llama.cpp, LM Studio, Jan und Ollama. Deshalb kommt es auf rund 808.000 Downloads pro Monat, während das 72B auf 446 kommt. Sie können heute Abend kommerziell und kostenlos einen GUI-Agenten auf einem Laptop laufen lassen.
Wo es an Grenzen stößt. Die Schlagzeilen-Benchmarks gehören zu einem Modell, das Sie nicht bekommen können. ByteDances eigene Skalentabelle weist für das herunterladbare 1.5-7B 27,5 % auf OSWorld und 49,6 % auf ScreenSpot-Pro aus, gegenüber 42,5 % und 61,6 % für das interne 1.5, über das die Presse berichtete. Das ist eine Lücke von 15 und von 12 Punkten, und seltsamerweise schneidet das 72B in beiden schlechter ab als das 7B. Das Community-Eval-Panel von Hugging Face verwischt das weiter, indem es dem 7B 61,6 % auf ScreenSpot-Pro zuschreibt, im Widerspruch zu ByteDances eigenen 49,6 %, betrachten Sie diese Spalte also als ungeklärt. UI-TARS-2 wurde im September 2025 angekündigt und hat nie Gewichte bekommen, was Alibabas eigener Bericht unabhängig bestätigt, indem er es als Closed Source aufführt. ByteDance hat überhaupt keine OSWorld-Verified-Zahl veröffentlicht, obwohl es als Mitwirkender an der Korrektur genannt wird, die sie hervorbrachte.
Das Bild zur Dynamik würde ich am stärksten gewichten. Das Modell-Repository hat 11.374 Sterne, null Tags, nie ein Release und den letzten Commit vom 5. September 2025. Das Desktop-Monorepo hat 38.697 Sterne und einen letzten Commit vom Juli 2026. Das Tooling lebt, die Modelllinie ist eingefroren. Die installierbare App gibt es nur für macOS und Windows, ohne Linux-Build, und das letzte Release mit Installern ist v0.2.4 vom August 2025, während /releases/latest auf ein CLI-Release ohne angehängte Dateien zeigt, genau den Link, auf den die Schnellstartanleitung Sie klicken lässt.
Wenn Sie ein kleines Modell für die eigene Hardware dimensionieren, statt einem Leaderboard nachzujagen, ist unser Beitrag zu kleinen Sprachmodellen der bessere Rahmen für diese Entscheidung als jede Benchmark-Tabelle.
Preise. Die Gewichte sind kostenlos. Der gehostete Weg ist doubao-1-5-ui-tars-250428 auf Volcengine zu gelisteten ¥1,75 pro Million Eingabe-Token und ¥3,50 pro Million Ausgabe-Token, wobei diese Seite ihre Preise clientseitig rendert, ich würde sie vor der Budgetierung also erneut prüfen, und Volcengine ist eine Cloud in der Region China. Der Nachfolger Doubao-Seed-2.1-Pro wird mit ¥6 und ¥30 gelistet, ein anderes Produkt zu einem anderen Preis. Für ein westliches Deployment ist Selbst-Hosting oder ein Inferenzanbieter eines Dritten der praktische Weg.
Fazit: Nehmen Sie es wegen Lizenz und Ökosystem, nicht wegen des Scores, und kalibrieren Sie auf 27,5 % statt auf 42,5 %. Ein Risiko sollte man beim Namen nennen: ByteDances eigener Abschnitt zu Einschränkungen weist darauf hin, dass das Modell CAPTCHAs bearbeitet, beschreibt das als Bedenken wegen unbefugten Zugriffs, und bei einem Apache-2.0-Checkpoint gibt es keine technische Schutzvorrichtung. Wenn Sie offene Gewichte generell abwägen, behandelt unser Beitrag zu Kimi-K2.5-Alternativen, wie der Rest dieses Feldes bepreist ist.
5. MAI-UI 8B und 2B
Am besten für das, was Qwen-UI-Agent am nächsten kommt und tatsächlich herunterladbar ist, aus demselben Labor.
So funktioniert es. Das sind die beiden Checkpoints, die Alibabas MAI-Team tatsächlich veröffentlicht hat, am 25. Dezember 2025 hochgeladen und vier Tage später angekündigt, beide unter Apache 2.0, beide auf der Architektur qwen3_vl. MAI-UI-8B hat 8,77B Parameter in vier Shards mit 16,33 GiB, und MAI-UI-2B hat 2,13B in einer einzigen 3,96-GiB-Datei. Sie sind die direkten Vorgänger von Qwen-UI-Agent und damit der ehrlichste verfügbare Stellvertreter dafür, was das Post-Training dieses Teams tatsächlich bringt.
Was mir gefällt. Dasselbe Labor, dieselbe Linie, Apache 2.0 und klein genug, um praktikabel zu sein. Das 2B passt nach Gewichtsrechnung bequem auf eine 8-GB-Karte. Für beide gibt es Community-Quantisierungen, sieben für das 8B und fünf für das 2B. Und der MobileWorld-Benchmark selbst ist offen herunterladbar, obwohl das Modell, das ihn anführt, es nicht ist, sodass Sie wenigstens ehrlich auswerten können.
Wo es an Grenzen stößt. Lesen Sie die Modellkarten genau, denn sie nennen Zahlen der Familien-Flaggschiffe statt der eigenen Checkpoints. Die 76,7 % auf AndroidWorld auf der Karte des 2B gehören zu einem 235B-Modell, das nie erschienen ist. Die einzigen größenaufgelösten Zahlen, die das Team je veröffentlicht hat, sind ScreenSpot-Pro ohne Zoom aus dem News-Log des Repos: 67,9 % für ein 32B, das ebenfalls nie erschien, 65,7 % für das 8B und 57,4 % für das 2B. Gegenüber den 76,6 % von Qwen-UI-Agent im selben Setting sind das 10,9 und 19,2 Punkte Rückstand beim Grounding. Bei Ende-zu-Ende-Arbeit ist die Lücke weit hässlicher: MAI-UIs bestes MobileWorld-Ergebnis lag bei 41,7 % gegenüber 82,1 %, ein Unterschied von 40,4 Punkten. Grounding ist bei offenen Gewichten fast ein gelöstes Problem. Einen mehrstufigen Ablauf zu Ende zu bringen ist es nicht.
Zwei praktische Hinweise. Nirgends, weder auf den Karten noch im Repo, wird ein VRAM-Wert veröffentlicht, die obigen Zahlen sind also meine Rechnung aus der Gewichtsgröße und keine Herstellerangabe. Und kein Hugging-Face-Inferenzanbieter bedient eines der beiden Modelle, lokal ist also der einzige Weg.
Preise. Kostenlos, Apache 2.0, und die gesamten Kosten sind Ihre GPU-Zeit.
Für den Kontext, wie der Rest der Open-Weight-Welt Erwartungen setzt: Mistral AI veröffentlicht mehr Details pro Checkpoint als beide dieser Karten. DeepSeek V3.2 ebenso.
Fazit: Das interessanteste Modell hier, um zu verstehen, was Qwen-UI-Agent sein wird, und eines der schwächsten, um tatsächlich zu arbeiten. Ich würde das 8B laufen lassen, um den Aktionsraum zu lernen und Erwartungen zu kalibrieren, und dann für alles, was ein Kunde sieht, eine gehostete API nutzen. Aufschlussreich ist auch, dass die MAI-UI-Kollektion weiterhin zwei Einträge zeigt, zuletzt aktualisiert am 6. Januar 2026, sechs Monate bevor Qwen-UI-Agent angekündigt wurde.
6. Holo 3.1
Am besten für offene Gewichte, wenn Sie zusätzlich einen gehosteten Endpunkt als Fallback wollen.
So funktioniert es. Das in Paris ansässige H Company hat in zwölf Monaten fünf Generationen ausgeliefert, und Holo 3.1 erschien am 1. Juni 2026. Ungewöhnlich ist, dass derselbe Checkpoint auf zwei Arten verkauft wird. Die API von H dokumentiert einen Agent-Loop-Modus, in dem Holo das Gehirn eines Browser- oder Desktop-Agenten ist, und einen Element-Lokalisierungsmodus, in dem Sie ein Bild plus Zielbeschreibung übergeben und {x, y} auf einem Raster von 0 bis 1000 zurückbekommen. Dieser zweite Modus macht es zu einer einsetzbaren Grounding-Komponente im Agenten eines anderen, was keine der Frontier-APIs bietet.
Was mir gefällt. Dies ist der einzige Eintrag im ganzen Beitrag, dessen Schlagzeilenzahl ich nicht auf Vertrauen hin nehmen musste. Holo3-35B-A3B liegt mit 82,56 % auf Platz 6 des von den Maintainern betriebenen OSWorld-Verified-Boards, vor Metas Muse Spark 1.1 und binnen eines Punkts von Anthropics Opus-Zeile, und es ist das einzige spezialisierte Open-Weights-Modell in den ersten sechs. Hs eigene Angabe für Holo3 lag bei 78,85 %, der Anbieter hat sich also ausnahmsweise unter Wert verkauft.
Darüber hinaus ist Holo 3.1 die permissivste Veröffentlichung, die H bisher gemacht hat: sieben Checkpoints, alle Apache 2.0, von 0,8B, 4B, 9B bis zu einem 35B-A3B-Mixture-of-Experts, dazu FP8-, NVFP4- und Q4-GGUF-Builds des Flaggschiffs. H berichtet, dass die quantisierten Builds auf OSWorld etwa zwei Punkte unter dem BF16-Checkpoint landen. Mobile ist der Hauptgewinn dieser Generation, AndroidWorld steigt bei 35B-A3B von 67 % auf 79,3 %. Und der gehostete Preis ist der niedrigste aller Modelle in diesem Beitrag mit $0,25 Eingabe und $1,80 Ausgabe, mit einer kostenlosen Stufe bei 10 Anfragen pro Minute und ohne Karte.
Wo es an Grenzen stößt. Die Großzügigkeit bei der Lizenz hat einen Haken. In früheren Generationen lautete das Muster: kleine Modelle Apache 2.0, große nur für Forschung: Holo2-30B-A3B und Holo2-235B-A22B stehen beide unter CC BY-NC 4.0, ebenso Holo1.5-72B, keines davon ist also ohne Aufruf bei H in einem Produkt nutzbar. Und das aktuelle Flaggschiff ging weiter als nur Forschung. holo3-122b-a10b hat gar keine Gewichte, nur API, und Hs eigene Modellliste sagt das. Zwei von Hs eigenen Seiten widersprechen sich um einen Punkt bei der AndroidWorld-Zahl der kleinen Variante, 71 % gegenüber 72 %. Das Raster pro Benchmark von Holo 3.1 ist nur in einem Bild auf der Modellkarte veröffentlicht, nicht als Text. Der Gesamtwert in der Schlagzeile bezieht H Corporate Benchmarks mit ein, 486 Aufgaben, gebaut mit Hs eigener synthetischer Umgebungsfabrik, jede Pareto-Behauptung aus dieser Grafik wird also teils an unveröffentlichten Hausaufgaben bewertet. Und das im Juli 2026 gestartete Managed-Produkt Computer-use Agents veröffentlicht überhaupt keine Preisliste.
Preise.
| Weg | Preis | Kontext | Hinweise |
|---|---|---|---|
| Gewichte, Holo-3.1-Familie | Kostenlos, Apache 2.0 | k. A. | 0.8B bis 35B-A3B, plus FP8, NVFP4, GGUF |
holo3-1-35b-a3b API | $0.25 Ein / $1.80 Aus pro MTok | 65.536 | Function Calling, kostenlose Stufe 10 RPM |
holo3-122b-a10b API | $0.40 Ein / $3.00 Aus pro MTok | 65.536 | Keine Gewichte, kein Function Calling |
| Computer-use Agents | Nicht veröffentlicht | k. A. | Browser und Desktop live, Mobile nicht aufgeführt |
Fazit: Meine Wahl unter den Open-Weight-Optionen und die einzige, die ich auf Verdienst vor eine gehostete API setzen würde, weil die 82,56 % auf dem Board eines anderen stehen und nicht auf dem von H. Es ist auch die bestgeformte Option für ein Team, das gehostet starten und ohne Wechsel der Modellfamilie auf Selbst-Hosting umsteigen will, und die einzige, bei der dieselben Gewichte als Grounding-Unterroutine in einem anderen Agenten dienen können. Lesen Sie die Lizenz der gewählten Generation, statt sie vorauszusetzen, denn sie ändert sich zwischen den Größen, und das aktuelle Flaggschiff hat gar keine Gewichte.
7. Browser Use
Am besten für Browser-Aufgaben, die Sie tausendmal ohne Aufsicht ausführen müssen.
So funktioniert es. Das ist die Option, die die meisten falsch beschreiben, deshalb lohnt Genauigkeit. Browser Use begann als Harness statt als Modell: eine Agent-Klasse, die die Schleife Beobachten, Entscheiden, Handeln gegen Chromium ausführt, mit dem LLM als austauschbarem Konstruktorargument. Inzwischen liefert es auch Modelle, gehostete bu-*-Endpunkte mit bu-2-0 als Standard sowie ein Open-Weights-bu-30b-a3b-preview. Aber das Harness gab es vor dem Modell und braucht es nicht, und die Anbieterliste ist ungewöhnlich lang: Google, OpenAI, Anthropic, Azure, Bedrock, Groq, Cerebras, DeepSeek, Mistral, OpenRouter, LiteLLM, lokales Ollama und alles OpenAI-Kompatible über eine eigene Basis-URL. Sie bringen durchgehend Ihren eigenen Schlüssel mit.
Was mir gefällt. 110,3k Sterne, 12,1k Forks, MIT auf der Bibliothek und ein Release-Rhythmus, der nicht nachgelassen hat. Es ist außerdem der einzige Eintrag, bei dem die Cloud den Browser liefert, was den größten versteckten Kostenpunkt der ganzen Kategorie beseitigt. Und die Preisgestaltung ist ungewöhnlich nachvollziehbar: Abos kaufen einen Credit-Pool Dollar für Dollar, den zwei Zähler aufbrauchen, sodass man tatsächlich planen kann.
Wo es an Grenzen stößt. Nur Browser, und sie sagen das direkt. Jede Sitzung ist ein entferntes Chromium über CDP, die API-Oberfläche ist /runs und /browsers, und sie positionieren sich gegen Computer-Use-Agenten statt als einer. Achten Sie auf eine subtile Falle in der Doku: macOS, Windows und Linux erscheinen als Fingerprints, die der Stealth-Modus imitiert, nicht als Plattformen, die gesteuert werden. Die über 1.000 Integrationen sind APIs, die der Agent aufruft, keine Anwendungen, die er bedient.
Auch ihre Benchmark-Geschichte will mit Vorsicht gelesen werden. Die oft zitierten 89,1 % auf WebVoyager stammen aus einem Lauf auf gpt-4o mit modifizierter Codebasis und Prompts, 55 entfernten Aufgaben und manuell korrigierten fehlgeschlagenen oder unklaren Auswertungen, und Browser Use selbst sagt in diesem Beitrag, dass der Benchmark nicht wirklich das Richtige testet. Die aktuelle Schlagzeile sind 82 % strikte Genauigkeit auf einem internen Satz nicht öffentlicher Aufgaben. Die stärkste Behauptung ist die von Dritten gehostete: Platz eins auf Odysseys mit 87,4 % bei 200 langen Web-Aufgaben. Beachten Sie auch, dass MIT nur die Bibliothek abdeckt, die Cloud unter separaten Bedingungen läuft und die Doku Sie für CAPTCHAs, Speicherverwaltung und Parallelausführung zur Cloud schickt.
Preise.
| Tarif | Monatlich | Credits | Gleichzeitige Sitzungen |
|---|---|---|---|
| Free | $0 | Nur Aufladungen, 10 Aufgaben/Monat | 3, oder 10 nach einer Aufladung |
| Dev | $29 | $29 | 25 |
| Business | $299 | $299 | 200 |
| Scaleup | $999 | $999 | 500 |
Die beiden Zähler darunter sind wichtiger als der Tarif. Die Browser-Infrastruktur wird mit $0,02 pro Browserstunde abgerechnet, also praktisch nichts, während der verwaltete Proxy mit $5 pro GB abgerechnet wird, bei Scaleup $4, und proxyloser Egress mit $0,20 pro GB. Ein Gigabyte Proxy-Traffic kostet so viel wie 250 Browserstunden, der Proxy ist also der eigentliche Kostenschwerpunkt. Gehostete Agenten laufen zum 1,2-Fachen der Preise des zugrunde liegenden Anbieters, und das Mitbringen eines eigenen Schlüssels fügt eine Orchestrierungsgebühr vom 0,2-Fachen hinzu, BYOK kauft Ihnen also Kontrolle statt Ersparnis. Die günstigste Variante ist, BU 2.0 in Ihrer eigenen Bibliothek zu betreiben, mit $0,60 Eingabe und $3,50 Ausgabe ohne Browserstunden-Gebühr. Ein Enterprise-Tarif ist nicht veröffentlicht, SLAs und Aufbewahrungsbedingungen laufen also über den Vertrieb.
Fazit: Wenn das Ziel eine Website ist, fangen Sie hier an statt mit einer Frontier-Computer-Use-API. Sie bekommen einen laufenden Browser, ein austauschbares Modell und eine vorhersehbare Rechnung, und das Odysseys-Ergebnis von Dritten ist die glaubwürdigste Zahl in diesem Beitrag. Wer das mit einem einfachen Scraper vergleicht, sollte zuerst unseren Beitrag zu Web-Scraping-Alternativen lesen, denn viele Jobs, die agentisch wirken, sind es nicht.
8. Skyvern
Am besten für eingeloggte Web-Abläufe, bei denen 2FA das eigentliche Hindernis ist.
So funktioniert es. Skyvern ist nicht rein visuell, und genau diese Designentscheidung prägt es. Ein Screenshot und ein vereinfachter DOM-Baum gehen gemeinsam an das Modell, und ihre eigene Rahmung lautet, dass das Bild Layout und visuellen Kontext liefert, während das DOM die Element-Kennungen liefert, die Playwright ansteuern kann. Dann führt Playwright aus. Zugangsdaten werden in den Browser statt in den Prompt injiziert, das Modell sieht sie also nie. Ihre Ablation ist erfrischend öffentlich: Ein einzelner Actor erreicht auf WebVoyager etwa 45 %, ein Planner hebt es auf 68,7 %, und ein Validator auf 85,85 %.
Was mir gefällt. Es ist der einzige Eintrag hier, der um die langweilige Realität eingeloggter Web-Arbeit herum gebaut ist, und genau dort scheitert der rein visuelle Ansatz. Ein Praktiker, der vier Agenten nebeneinander laufen ließ, beschrieb die Schwelle so:
"the pattern that actually mattered wasn't which agent, it was that any task with login + 3 or more steps breaks on every screenshot-driven approach. … once you drop the browser sandbox and drive the OS accessibility tree directly, you get real element handles instead of pixel guesses and the failure rate falls roughly 4x on long tasks."
Skyverns DOM-plus-Screenshot-Design ist dieselbe Erkenntnis, eine Ebene höher angewandt. Dazu kommen: TOTP-, E-Mail- und SMS-Zweitfaktoren werden gehandhabt, es gibt einen Credential-Tresor mit Unterstützung für Bitwarden, 1Password und Azure Key Vault, und einen "Take Control"-Button, der eine laufende Sitzung mitten im Lauf an einen Menschen zurückgibt. Route Memorization ist der kluge Teil der Roadmap: Ein erfolgreicher Agentenlauf wird zu einem günstigen Playwright-Skript kompiliert und repariert sich selbst, wenn es bricht, was als Code-Caching bereits ausgeliefert wird. Das ist die richtige Antwort auf die Kosten pro Schritt.
Wo es an Grenzen stößt. Die Lizenz hat eine Ausnahme, die Sie lesen müssen. Das README sagt, die Kernlogik sei AGPL-3.0 mit Ausnahme der Anti-Bot-Maßnahmen in der verwalteten Cloud, die Anti-Bot-Schicht ist also bewusst nicht im Repo. Selbst-Hosting ist softwarekostenfrei, hat aber zwei Klippen: Automatisches CAPTCHA-Lösen gibt es dort nicht, und der Agent pausiert stattdessen 30 Sekunden für manuelles Eingreifen. Auch die CAPTCHA-Aussagen werden schmaler, je tiefer man geht, von natives Lösen ohne Drittdienste auf der Startseite zu Dokumenten, die bestimmte Typen nennen und dann sagen, Lösen sei nicht garantiert. Nur Browser, in ihren eigenen Worten: Wenn es in einem Browser passiert, den Skyvern ausführen kann, geht es. Die 85,85 % auf WebVoyager stammen von Januar 2025 mit GPT-4o und 8 entfernten Aufgaben, und Skyvern sagt auf derselben Seite, dass das Leaderboard seither weitergezogen ist. Ihre frischere Zahl sind 64,4 % auf dem eigenen WebBench. Einige ihrer eigenen Seiten widersprechen sich auch, etwa bei den Aktionen der kostenlosen Stufe und der Proxy-Länderabdeckung.
Preise.
| Free | Hobby | Pro | Enterprise | |
|---|---|---|---|---|
| Preis | $0 | $29/Monat | $149/Monat | Individuell |
| Credits | 5.000 einmalig | 30.000/Monat | 150.000/Monat | Individuell |
| Geschätzte Aktionen | ~170 | ~1.200 | ~6.200 | Individuell |
| Gleichzeitige Läufe | 1 | 10 | 25 | 100 |
| 2FA und TOTP | Nein | Nein | Ja | Ja |
| Proxy | Rechenzentrum | Rechenzentrum | Residential | Residential |
Die Credit-Kosten pro Schritt werden nie veröffentlicht, ich habe sie also abgeleitet: etwa 25 Credits pro Aktion ergeben rund $0,024 pro Schritt in beiden bezahlten Stufen, identisch in jeder, das Upgrade kauft also Volumen, Parallelität und 2FA statt eines besseren Stückpreises. Eine typische Aufgabe umfasst 2 bis 10 Schritte, also etwa $0,05 bis $0,24. Ein Überschreitungspreis wird nirgends veröffentlicht, und fehlgeschlagene Läufe verbrauchen trotzdem Credits.
Fazit: Die Spezialisten-Wahl, und Spezialisten werden unterschätzt. Wenn die Aufgabe ist, sich in ein Portal einzuloggen, das Ihnen nicht gehört, und ein Formular hinter einem zweiten Faktor auszufüllen, ist das besser geformt als jede allgemeine Computer-Use-API. Behalten Sie 2FA beim Tarifvergleich im Blick, denn es beginnt bei $149 und nicht bei $29. Wenn Sie einen lernenden Agenten gegen fest codierte Selektoren abwägen, rahmt unser Beitrag zu KI-Agent vs. Chatbot diesen Zielkonflikt gut.
Die Zahl aus dem Qwen-UI-Agent-Paper, die niemand zitiert
Hier ist der Befund, der die Kategorie für mich neu gerahmt hat, und er stammt aus den eigenen Traces des Platzhirschs, nicht von einem Wettbewerber.
Der Aktionsraum von Qwen-UI-Agent ist nicht rein grafisch. Neben click, type, drag und long_press bietet er cli_command für Bash, api_call, ask_user und terminate. Läuft das Modell also eine Desktop-Aufgabe, kann es zwischen einem Klick auf einen Button und dem Tippen eines Befehls wählen. Und es wählt oft den Befehl. Auf OSWorld-Verified machen CLI-Aktionen 40,7 % aller Aktionen aus und kommen in 92,0 % der Aufgaben vor. Auf dem schwereren OSWorld-v2 steigt das auf 55,1 % der Aktionen in 98,2 % der Aufgaben.
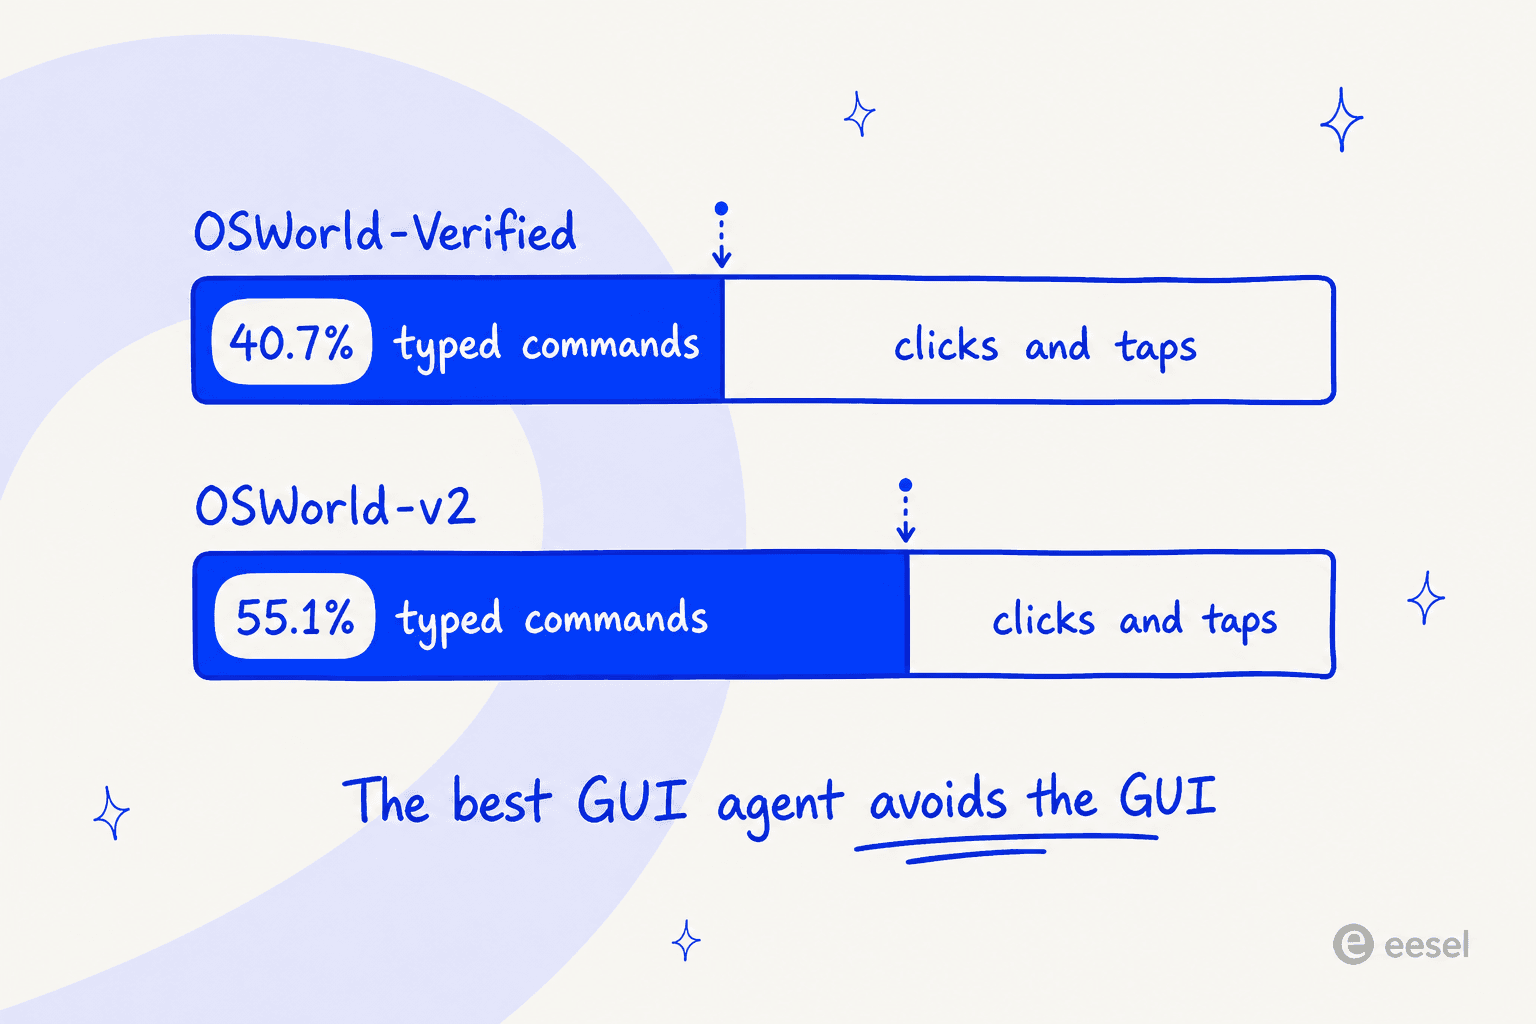
Lesen Sie das noch einmal. Der beste bildschirmsteuernde Agent, der 2026 veröffentlicht wurde, verbringt bei freier Wahl im schwersten Desktop-Benchmark mehr als die Hälfte seiner Aktionen damit, den Bildschirm nicht zu steuern.
ByteDances Zahlen sagen dasselbe aus der Gegenrichtung. UI-TARS-2 erreicht 29,6 % auf BrowseComp mit dem vollen Toolkit und 7,0 %, wenn es auf reine GUI-Bedienung ohne SDK beschränkt wird. Das ist deren eigene Ablation und bedeutet, dass etwa drei Viertel dieses Scores aus Terminal- und Tool-Zugriff kamen, nicht aus Pixeln.
Deshalb schneiden agentische CLI-Tools bei allem, was ein Terminal erreichen kann, still besser ab als Bildschirm-Agenten, und deshalb schlägt eine API-first-Automatisierung wie Zapier AI eine pixelklickende, wann immer der Endpunkt existiert.
Die praktische Erkenntnis ist eine Frage, die Sie vor der Wahl aus der obigen Tabelle stellen sollten: Hat diese Aufgabe eine API? Wenn ja, ist ein bildschirmsteuernder Agent der teure, brüchige, nicht prüfbare Weg, etwas zu tun, das Sie mit einem authentifizierten Aufruf erledigen könnten. GUI-Agenten verdienen ihr Geld auf den Oberflächen ohne API, und das ist eine echte und große Kategorie: Legacy-Interna, Behördenportale, Desktop-Software von 2009, Anbieter-Dashboards ohne Integrationsgeschichte. Sie ist nur viel kleiner, als die Demos andeuten.
Die Hälfte der Fehler lag nie am Modell
Das andere Nützliche im Qwen-UI-Agent-Bericht ist Tabelle 10, in der die Autoren ein Basismodell, Qwen 3.7 Plus, genommen und jeden seiner fehlgeschlagenen Real-Device-Verläufe klassifiziert haben, statt nur eine Erfolgsquote zu nennen. Ich habe das von keinem anderen Labor gesehen, und es sollte Ihr Budget verändern.
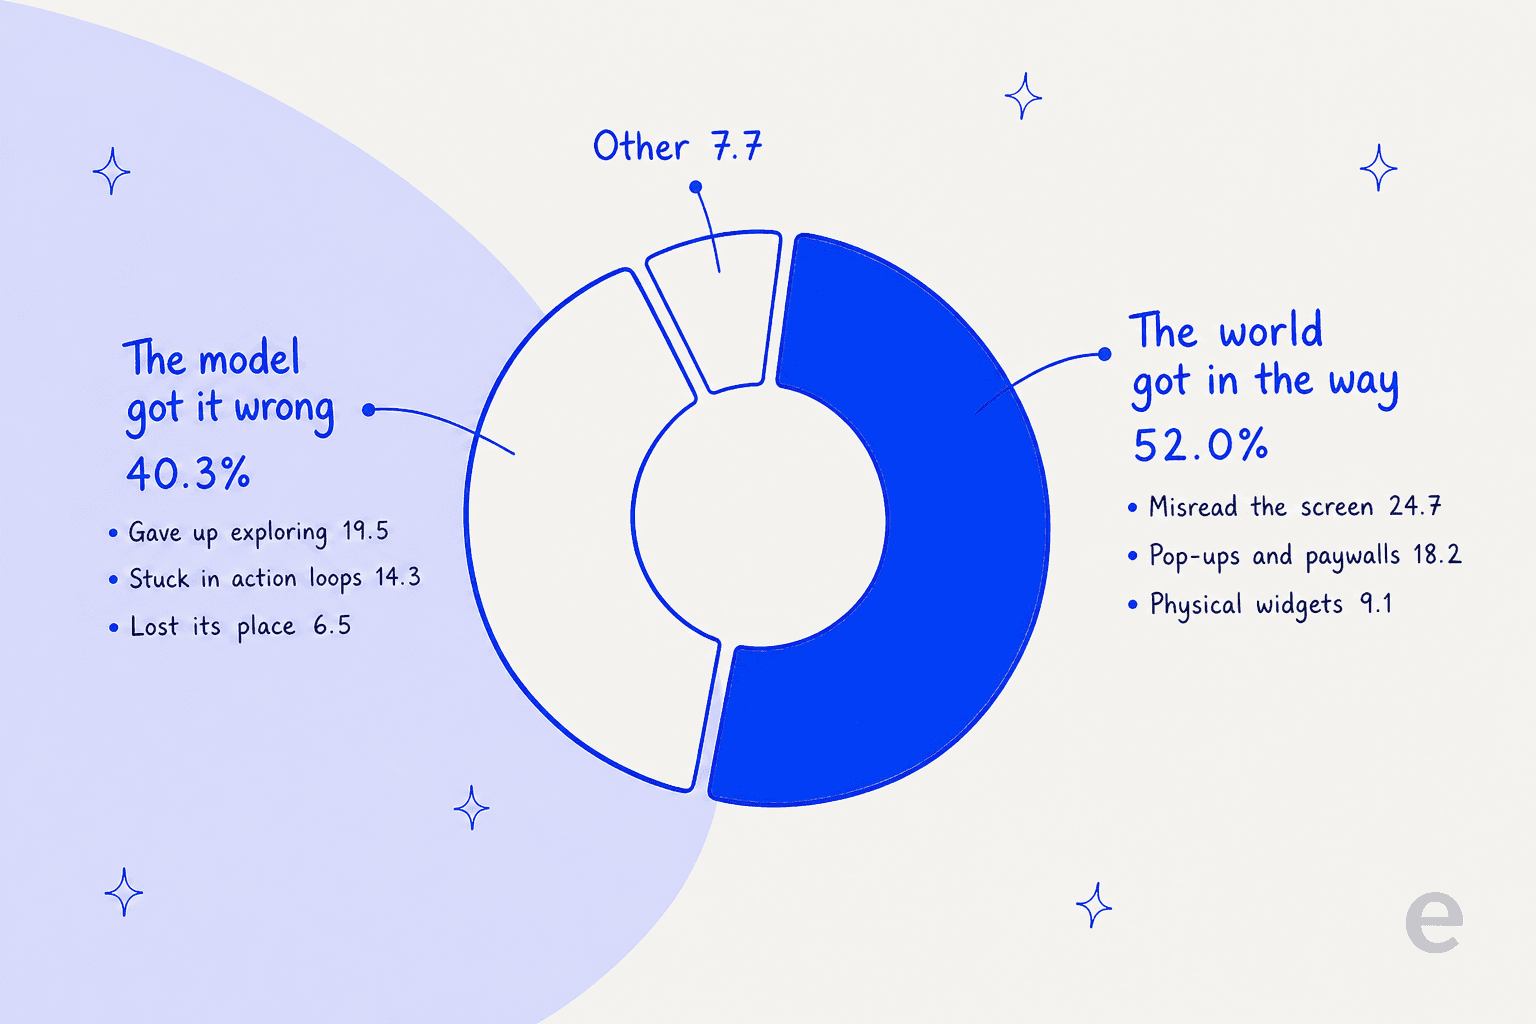
Über die fehlgeschlagenen Läufe von Qwen 3.7 Plus hinweg machen Herausforderungen des realen Szenarios 52,0 % aus: Fehllesen der UI mit 24,7 %, Störungen durch Pop-ups, Werbung, Paywalls und CAPTCHAs mit 18,2 % und Probleme mit physischen Widgets mit 9,1 %. Einschränkungen der Ausführungsfähigkeit machen 40,3 % aus: fehlende Exploration mit 19,5 %, Hängenbleiben in Aktionsschleifen mit 14,3 % und Verlust des Ausführungszustands mit 6,5 %. Qwen-UI-Agent ist das stärkere Modell, seine eigene Mischung wird also anders aussehen, aber die Form der Verteilung ist der Befund.
Der Grund, warum diese Aufteilung zählt: Ein besseres Modell zu kaufen adressiert nur die kleinere Hälfte. Ein modaler Dialog, ein Cookie-Banner, eine Paywall und ein CAPTCHA sind keine Modellprobleme, und sie sind der Großteil dessen, was schiefgeht. Deshalb sind auch Browser Uses Proxy-Posten und Skyverns CAPTCHA-Behandlung keine Nebensächlichkeiten. Sie greifen die tatsächliche Fehlerverteilung an, während eine Frontier-API die 40 % angreift.
Eine Einschränkung muss ich nennen, da ich mich durchgehend auf Alibabas Zahlen gestützt habe. MobileWorld-Real ist Alibabas eigener Benchmark und wird von AutoJudge bewertet, Alibabas eigenem Agenten-Richter, der laut Paper 92,8 % exakte Übereinstimmung auf 666 von Experten geprüften Beispielen erreicht. Die Autoren nennen Richterfehler als ihre erste erklärte Einschränkung, was der richtige Instinkt ist. Die Demo-Apps stammen außerdem aus dem chinesischen Verbraucher-Ökosystem, 92,2 % auf echten Geräten sind also ein Signal über die Methode und kein Versprechen für westliche SaaS.
Jede offene Alternative ist ein Qwen-Fine-Tune
Das hat mich überrascht. Ich suchte einen architektonischen Ausweg aus Alibaba, und es gibt keinen.
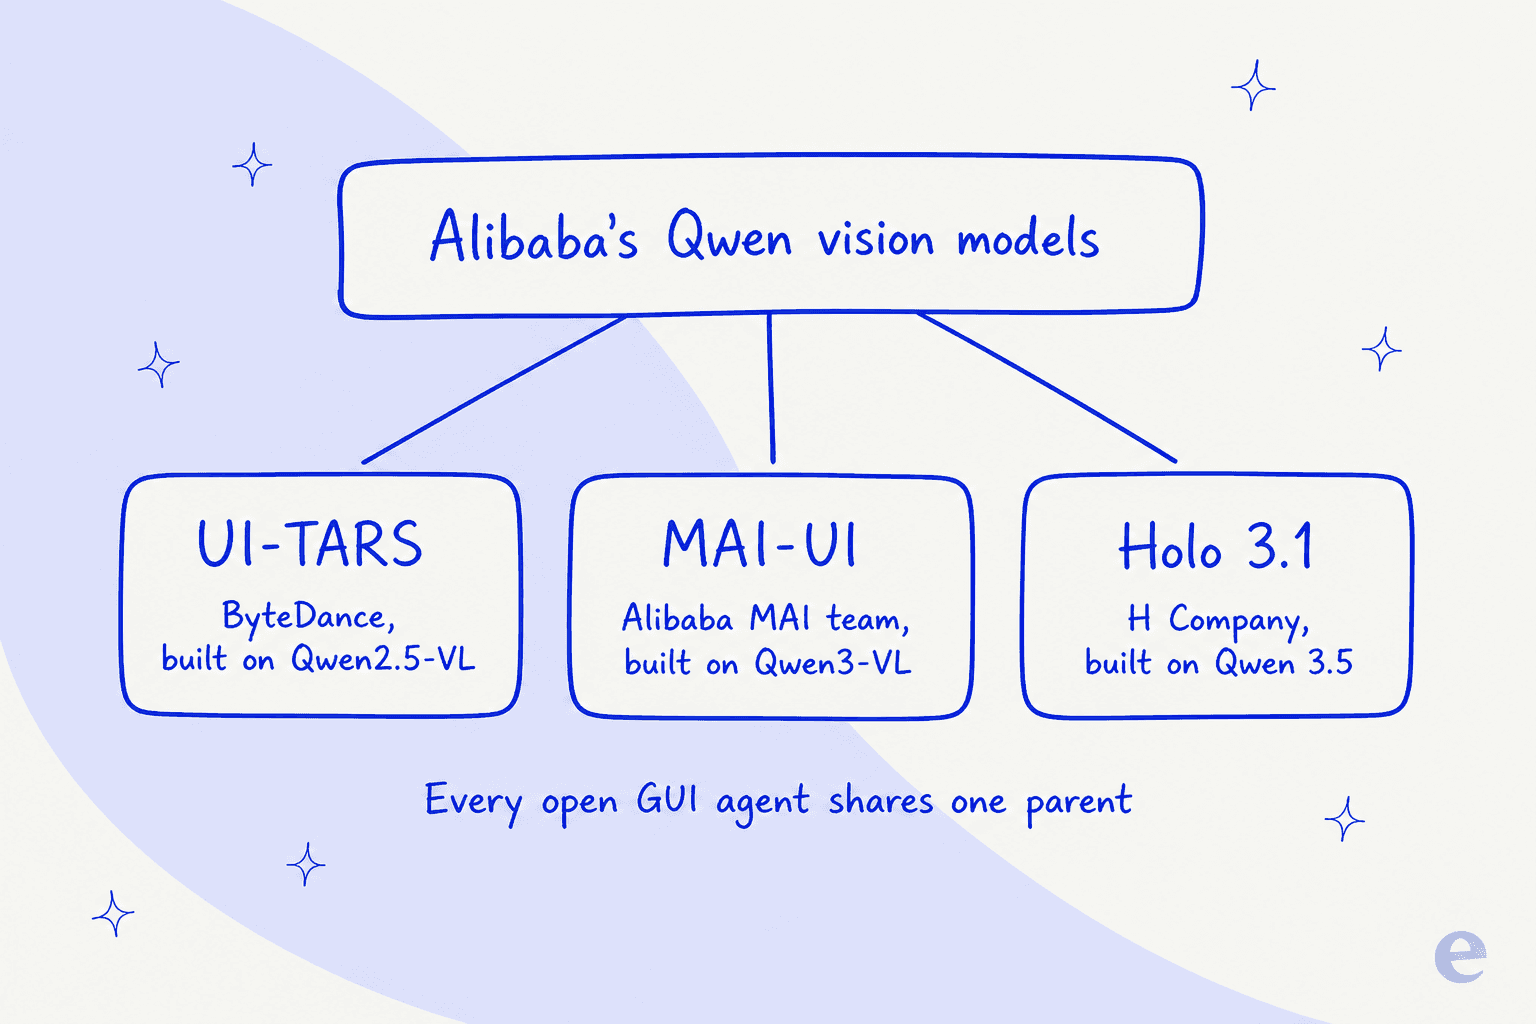
UI-TARS-1.5-7B ist aus Qwen2.5-VL-7B trainiert, ausdrücklich auf ByteDances eigener Seed-Seite gesagt, und sein Architektur-Tag auf Hugging Face ist qwen2_5_vl. MAI-UI ist qwen3_vl. Jede Holo-Generation ist ein Qwen-Derivat, von Qwen2.5-VL über Qwen3-VL bis zur Qwen-3.5-Familie, und die Holo1-Lizenzdatei sagt, das Produkt sei mit Qwen gebaut worden und die Qwen Research License habe im Konfliktfall Vorrang. Jede Benchmark-Grafik der Holo-3.1-Veröffentlichung vergleicht Holo mit der Qwen-3.5-Familie statt mit Alibabas GUI-Agent-Linie.
"Von Alibaba wegzugehen" heißt bei offenen GUI-Agenten also, Lizenz, Rechtsraum und Post-Training-Team zu wechseln, nicht die Basisarchitektur. Das kann man durchaus wollen, besonders wenn die Lizenz Sie blockiert, und H Companys Beitrag ist ein eigener: das GUI-spezifische Post-Training, die Fabrik für synthetische Umgebungen, das Harness. Aber niemand sollte eines dieser drei wählen im Glauben, Qwen entkommen zu sein. Die ehrliche Lesart ist, dass Alibabas Vision-Modelle das Substrat dieser gesamten offenen Kategorie sind, weshalb auch ein Alibaba-GUI-Agent sie anführt.
Wen ich weggelassen habe und warum
Manus. Ich habe versucht, es zu bewerten, und konnte mich nicht anmelden. Ihre Seite zeigt derzeit einen Hinweis, dass der Zugang am 25. August 2026 um 8:00 Uhr wieder aufgenommen wird, mit der Erklärung, dass sie geplante Datenlöschungen zur Einhaltung regulatorischer Vorgaben in bestimmten Rechtsgebieten verarbeiten, während Manus sich darauf vorbereitet, den Betrieb als unabhängiges Unternehmen wieder aufzunehmen. Ich kann kein Produkt empfehlen, das ich heute nicht öffnen konnte. Einen erneuten Blick wert, und unsere Übersicht zu Manus AI und die Aufschlüsselung der Manus-AI-Preise decken es in der Zwischenzeit ab.
Seed 2.1 Pro. ByteDances aktuelles Frontier-Computer-Use-Modell ist real und wettbewerbsfähig, mit 78,8 % auf OSWorld-Verified in Alibabas Vergleich. Es ist aber nur per API in einer Cloud der Region China für ¥6 und ¥30 pro Million Token verfügbar, und ByteDances eigene Ankündigung von Seed 2.1 erwähnt UI-TARS nie, die von den meisten Berichten angenommene Abstammung ist also eine Schlussfolgerung und keine Aussage.
GUI-Owl-1.5-32B-Instruct. Es taucht in Alibabas Tabellen durchgehend als stärkster früherer offener Spezialist auf, und bei 43,9 % auf MobileWorld gegenüber 82,1 % ist der Generationenabstand zu groß, um es als aktuelle Option zu empfehlen.
Bildschirmlesende Assistenten, die nie handeln. Tools nach Art von Cluely schauen auf Ihren Bildschirm und beraten, und Browser-Copiloten wie Edge Copilot fassen die aktuelle Seite zusammen. Nützlich, aber nicht dieselbe Aufgabe wie eine Aufgabe zu erledigen, also hier außerhalb des Rahmens.
Alles ohne Preis. H Companys Managed-Produkt Computer-use Agents und jede "Kontaktieren Sie uns"-Agentenplattform, die ich mir angesehen habe. Wenn ein Anbieter für ein nutzungsabhängiges Produkt keinen Preis veröffentlicht, kann ein Käufer nicht vergleichen, und ich werde nicht so tun, als wäre es anders.
Wenn es um Support-Tickets geht, ist der Bildschirm die falsche Tür
Ein guter Teil der Leute, die danach suchen, will keine Legacy-Desktop-App automatisieren. Sie wollen eine KI, die einen Helpdesk bearbeitet, und ein bildschirmsteuernder Agent wirkt wie der Allzweckweg dorthin.
Dem würde ich widersprechen, und nicht nur, weil ich an der Alternative arbeite. Ihr Helpdesk hat bereits eine API. Zendesk, Freshdesk, Gorgias, Front und Jira Service Management stellen das Ticket alle als Objekt bereit, das Sie lesen und schreiben können, ein bildschirmsteuernder Agent entscheidet sich also dafür, das Ticket zu finden, indem er danach sucht und darauf klickt. Deshalb schlagen spezialisierte Tools für Ticket-Triage und ein KI-Helpdesk-Agent Bildschirmautomatisierung bei derselben Warteschlange. Jede Layout-Änderung, jedes Modal und jeder A/B-Test wird zu einem neuen Fehlermodus, und laut Tabelle 10 oben ist diese Problemklasse der Großteil dessen, was kaputtgeht.
Es gibt auch ein subtileres Problem, das ein Team im Produktivbetrieb auf die harte Tour fand, und es ist das Schärfste, was ich diese Woche gelesen habe:
"we run screen-driven agents against web forms in production and the failure mode that took us longest to find wasn't navigation, it was commits that don't commit. a react controlled select can render the right value after a click while the framework's internal state never updated, so every pixel says done and the submitted payload says null. vision-only verification passes because the screen genuinely looks correct."
Jedes Pixel sagt erledigt, und die gesendete Nutzlast sagt null. Das ist das ganze Risiko eines pixelgesteuerten Agenten an einer Ticket-Warteschlange in einer Zeile, und der Anbieter, der in diesem Thread herausgefordert wurde, räumte es ein: Sein Agent wird über den Bildschirm gesteuert, also behaupten sie nicht, dass Pixel jeden verborgenen Zustandsübergang beweisen können. Ein API-Aufruf hat entweder 200 geliefert oder nicht.
Das größere Problem ist das Testen. Jeder Anbieter in diesem Beitrag empfiehlt eine isolierte VM, eine Domain-Allowlist und einen Menschen im Prozess, und keiner bietet einen Trockenlauf an Ihrer eigenen früheren Arbeit. Diese Lücke ist nicht akademisch. Es ist die erste Frage, die ein Support-Leiter stellt, in fast genau diesen Worten:
"The AI will never be able to answer 100% of the questions, but if it tries and just answers 'sorry I don't know this,' I cannot go and check all my 7,000 tickets to see if the AI actually made a good answer, then the point is a little bit gone. I need an AI who is only handling the tickets that it's confident to handle and all the other ones, leave them alone."
Das ist ein CX-Leiter einer Direct-to-Consumer-Marke für Nahrungsergänzungsmittel, die rund 7.000 Tickets im Monat über Gorgias und Shopify bearbeitet. Ein GUI-Agent hat darauf keine Antwort, weil ein Klick keinen Konfidenzwert trägt, und er hat auch nichts, was einer KI-Eskalation ähnelt. Die Modellwahl ist hier weit weniger wichtig als das Retrieval, worauf unser Beitrag zum besten LLM für den Support eingeht.
Diesen Teil habe ich auf die harte Tour gelernt, nicht theoretisch. Früh hatten drei zahlende eesel-Konten Bots, die Antworten erfanden, wenn das Retrieval leer zurückkam, weil der harte Fallback fehlte. Einer erfand Abo-Behauptungen über Solarzellen und schickte sie an echte Kunden. Ein anderer antwortete auf eine Produktfrage mit "Oxygen" direkt aus dem Periodensystem. Nichts im Produkt hat mich angelogen, es erzählte nur von Erfolg, den es nicht erreicht hatte, dieselbe Art von Behauptung wie ein GUI-Agent, der meldet, er habe den Button geklickt. Der Unterschied ist, dass ein API-Aufruf eine überprüfbare Spur hinterlässt und eine Koordinate nicht. Dieser Vorfall ist der Grund, warum jeder Rollout jetzt gegen historische Tickets simuliert wird, bevor er in die Nähe eines Kunden kommt, und er ist das stärkste Argument, das ich kenne, Halluzinationen zu verhindern, per Design statt per Prompt.
eesel für Ihren Helpdesk testen
Wenn Sie eigentlich einen KI-Teamkollegen für Ihre Ticket-Warteschlange brauchen und keine Roboter-Maus, ist das, was eesel ist. Es verbindet sich über deren APIs mit Zendesk, Freshdesk, Gorgias, Front, Help Scout, HubSpot, Salesforce Service Cloud und Jira Service Management und ruft benannte Tools auf, eine Aktion ist also ein protokollierter API-Aufruf statt einer Koordinate, von der jemand hofft, dass sie auf dem richtigen Pixel gelandet ist.
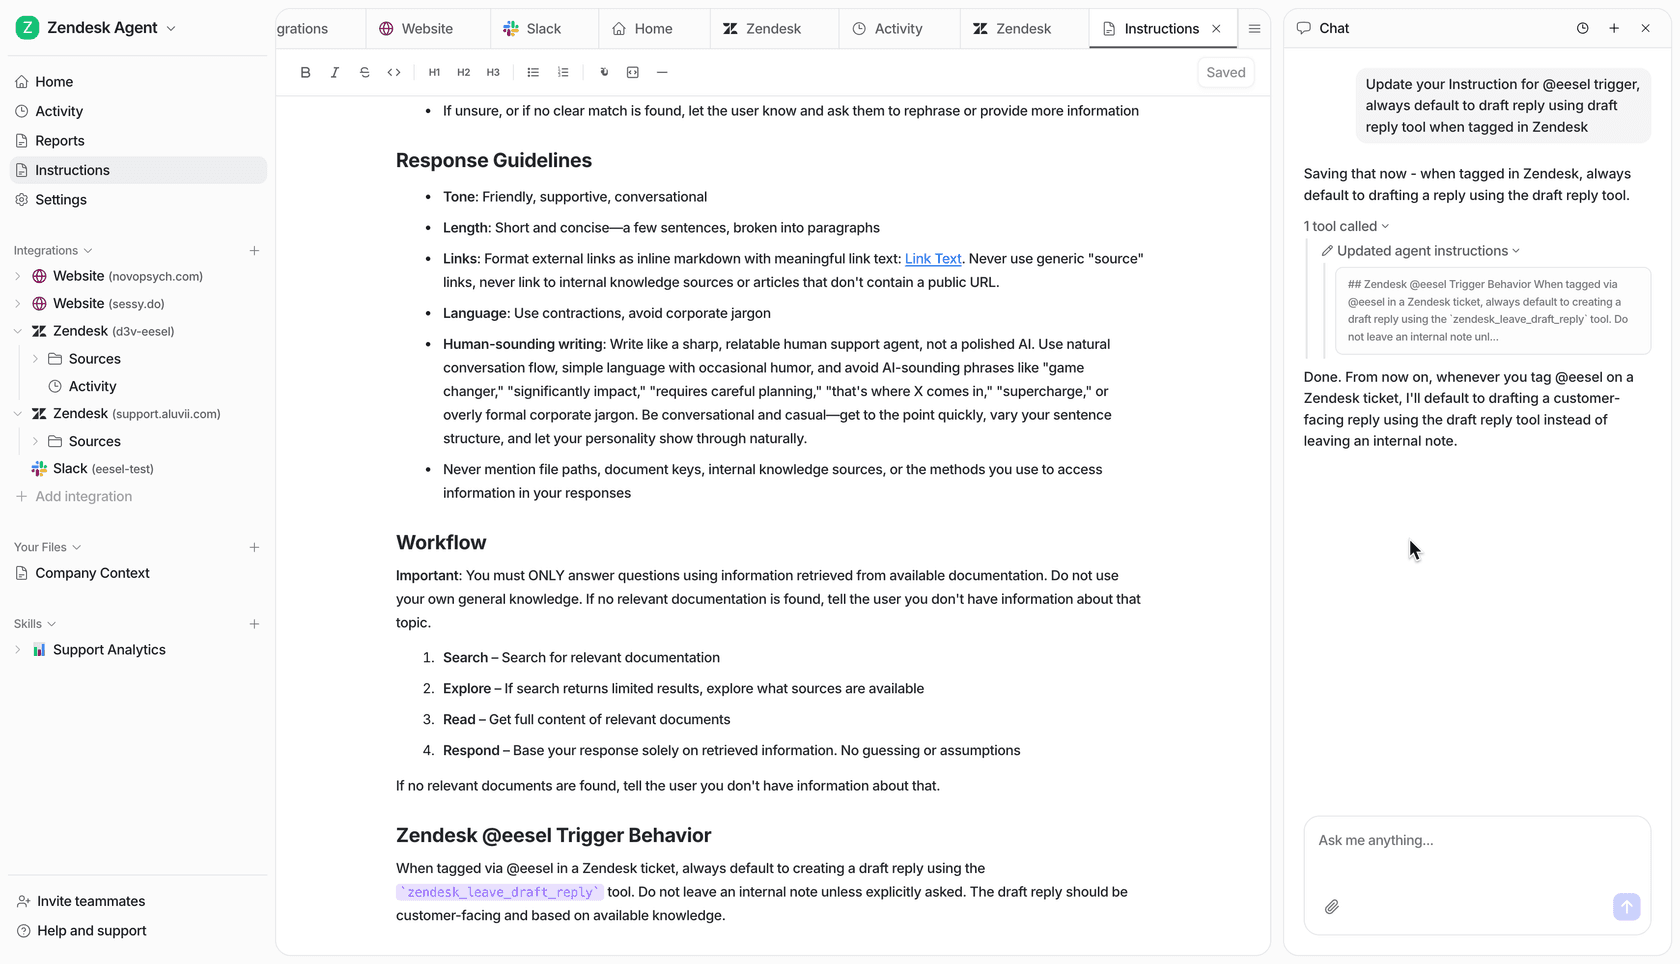
Der Teil, der für alle, die gerade acht Abschnitte über nicht testbare Agenten gelesen haben, am wichtigsten ist, ist die Simulation. Richten Sie sie auf Ihre eigenen früheren Tickets, und sie führt die komplette Agenten-Pipeline in einer Sandbox aus, ohne tatsächlich Antworten zu senden, lässt einen Richter jede Antwort bewerten, zeigt einen Vergleich nebeneinander mit dem, was Ihr Team wirklich gesendet hat, markiert jede als Perfekt, Akzeptabel oder Fehlgeschlagen und liefert pro Thema Abdeckungslücken mit vorgeschlagenen Anweisungskorrekturen zurück. Dann führen Sie sie erneut aus. Das ist der Trockenlauf, den nichts in diesem Beitrag bietet.
Die Preisgestaltung funktioniert so, wie das Widget oben es nahelegt: ein fester Monatspreis, ab 299 $/Monat für 500 Credits, wobei 1 Credit ein Ticket oder Chat ist, egal wie viele Nachrichten hin- und hergehen, ohne Plattformgebühr und ohne Gebühr pro Nutzer. Leiten Sie 200 Ihrer 1.000 Tickets weiter, verbrauchen nur diese 200 Credits; 1.000 Credits im Monat kosten 499 $. Vergleichen Sie das mit einem Zähler pro Schritt, bei dem dasselbe Ticket kostet, was die UI an diesem Tag verlangt. Eine ehrliche Einschränkung: Ein Credit wird verbraucht, egal ob das Ergebnis perfekt ist oder nicht, es zählt also pro bearbeitetem Ticket und nicht pro gelöstem Ticket.
Das Grounding ist die andere Hälfte. eesel liest Ihr bestehendes Help Center, Ihre Doku und frühere Tickets, statt auf einen Bildschirm zu schauen, und unsere Anleitungen, wie Sie auf einer Wissensdatenbank trainieren und Wissensdatenbanken verbinden, erklären, wie das in der Praxis funktioniert.
Wie das in der Produktion aussieht: Gridwise meldete, im ersten Monat nach einer siebentägigen Testphase 73 % der Tier-1-Anfragen gelöst zu haben, und Smava bearbeitet auf Zendesk mehr als 100.000 Tickets im Monat vollautomatisch auf Deutsch. Wenn Sie sich zuerst das breitere Feld ansehen möchten, ist unsere Übersicht zu KI für den Kundenservice der ehrliche Vergleich.
Starten Sie mit 100 kostenlosen Credits, ohne Karte, mit allen freigeschalteten Funktionen. eesel testen, oder richten Sie es zuerst auf die Tickets des letzten Monats und sehen Sie den Score, bevor Sie entscheiden.