Die 8 besten Laya-AI-Alternativen 2026

Rama Adi

Katelin Teen
Zuletzt bearbeitet September 21, 2026
Warum Leute nach Laya-AI-Alternativen suchen
Ich baue beruflich Integrationen und APIs, deshalb habe ich eine Schwäche für Laya. Das Design ist ehrliche Ingenieursarbeit: Statt ein riesiges autoregressives Modell zu bitten, „bitte nur JSON zu antworten", und dann zu hoffen, lässt Laya einen bidirektionalen Encoder über deinen Zustand laufen, wertet typisierte Fragen in einem einzigen Forward-Pass aus und liefert kalibrierte Wahrscheinlichkeiten. Keine Token-Generierung heißt: keine halluzinierten Felder und kein fehlerhaftes JSON, konstruktionsbedingt. Es steht unter Apache 2.0, läuft selbst gehostet für 0,00 $ pro 1 Mio. Token und wird klar als offene Antwort auf TypeSafes geschlossenes Jev positioniert.
Der Ärger beginnt im Abschnitt zu Layas eigenen Einschränkungen, auf den sich der Hacker-News-Thread sofort stürzte. Direkt nach dem Download erreicht das Basismodell etwa 0,35 im Benchmark für typisierte Entscheidungen, kaum über der Zufallsbasis von 0,318. Die beeindruckende 0,766 erscheint erst nach dem Fine-Tuning auf dem Trainingssplit des Benchmarks. Das ist ein großes Sternchen, und die Praktiker im Thread sagten es unverblümt:
"Idk, your limitations section sure makes it seem less drop in and less general than Jev. Like the point here isn't your ML aptitude it's how easy is it for developers to drop this into a product and use it. I'm more than capable of training a bert classifier... I don't want to manage GPUs / CPUs now. I don't want to maintain my corpus and retrain as my product's data distribution shifts... I do just want a reasonably good general classifier served to me with a great devex and calibrated confidence scores."

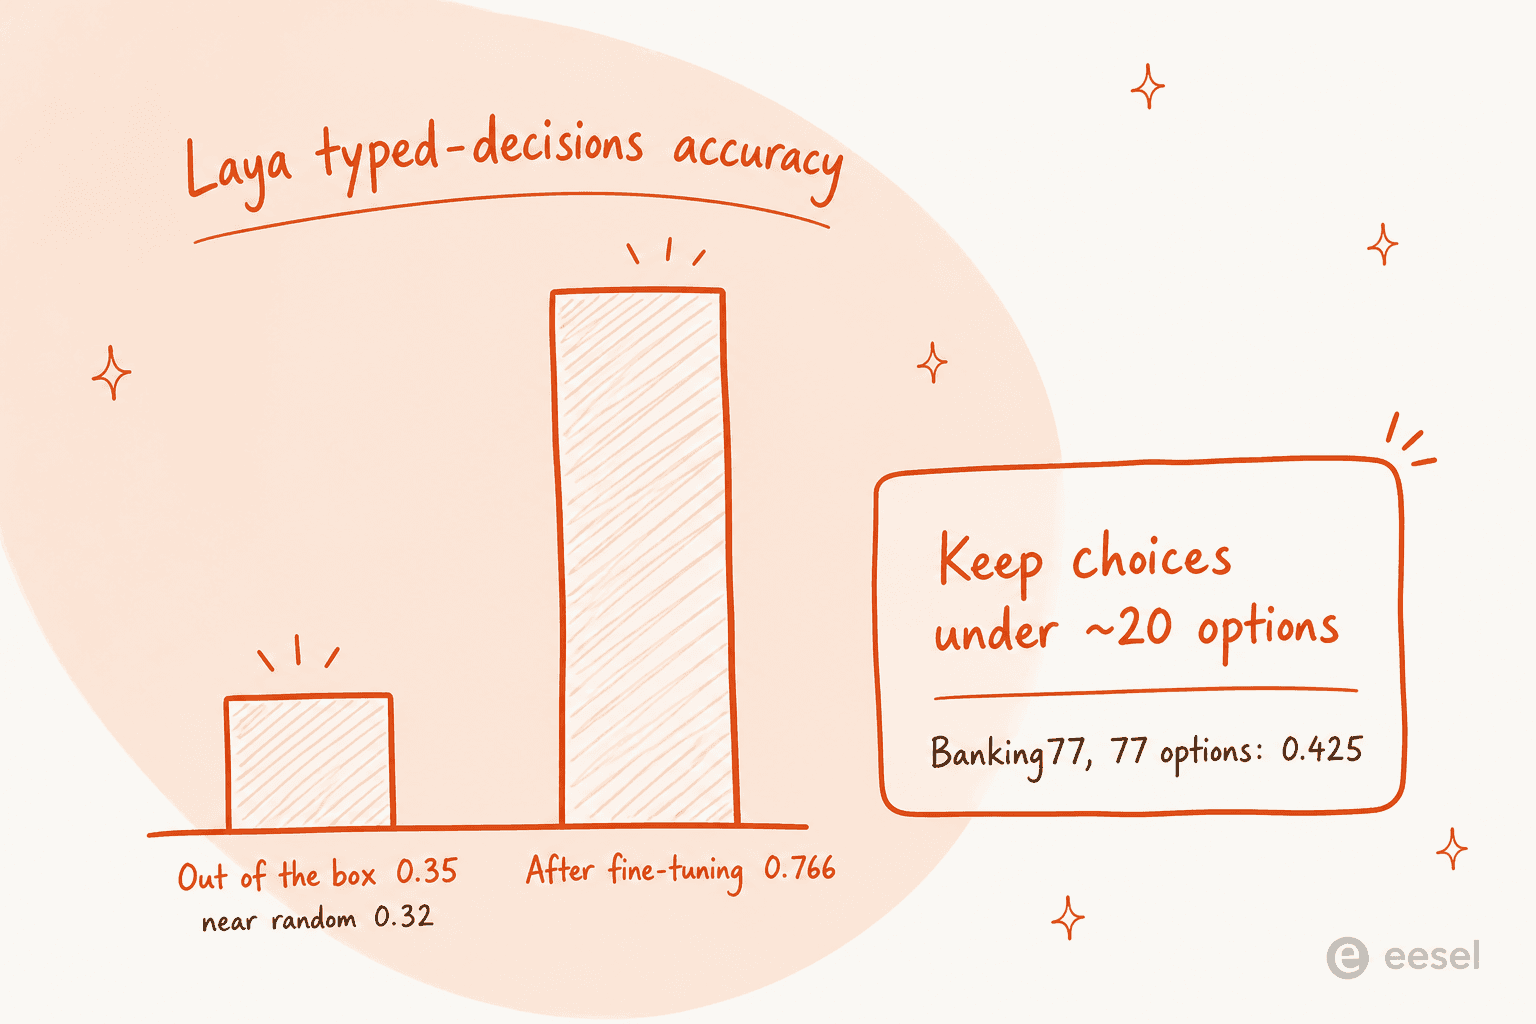
Es gibt eine zweite Obergrenze, die du vor der Entscheidung kennen solltest. Layas Choice-Fragen verschlechtern sich ab etwa 20 Optionen, weil sich die Kandidatenlabels ein festes Token-Budget teilen. Bei Banking77, einem Intent-Set mit 77 Labels, erreichte Laya 0,425, Jev dagegen 0,870. Viele reale Routing-Probleme haben mehr als 20 Kategorien, das ist also nicht für jeden ein Randfall.
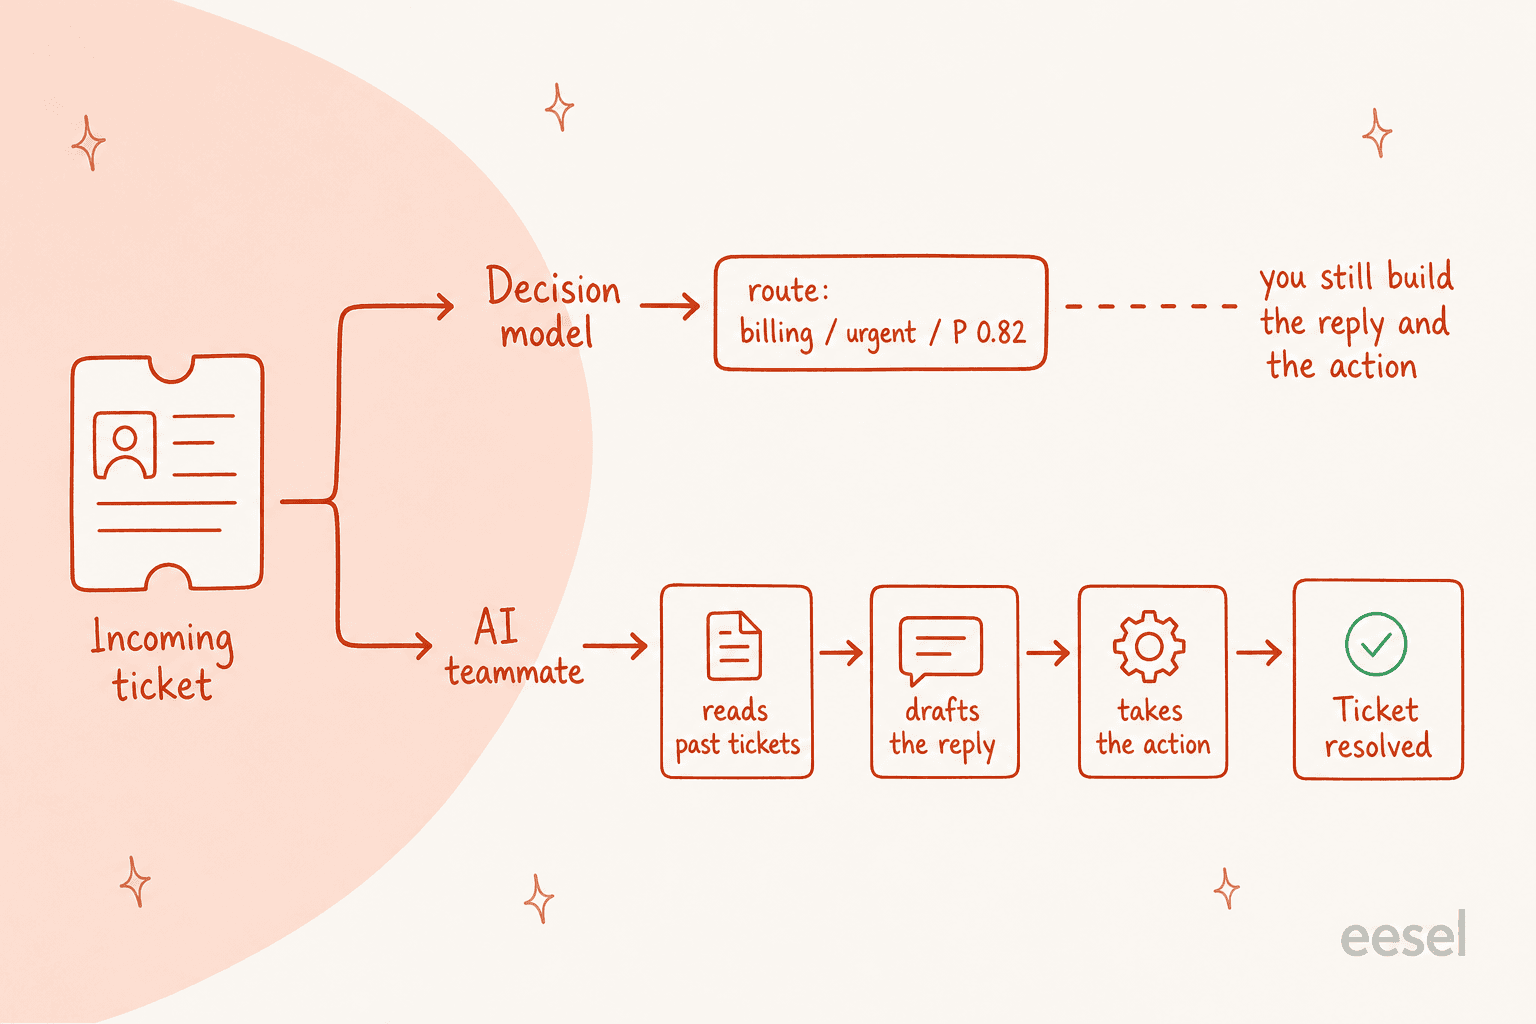
Und dann der Punkt, der mir am wichtigsten ist. Selbst im besten Fall beantwortet Laya eine Frage. Es sagt dir dieses Ticket ist Abrechnung, dringend, P(0,82). Es schreibt weder die Antwort, noch erstattet es die Bestellung, noch eskaliert es an einen Menschen. Das ist in Ordnung, wenn du das Produkt drumherum selbst baust, und ein K.-o.-Kriterium, wenn du dachtest, du kaufst ein Ergebnis. Ein Kommentator hat den Reiz der ganzen Kategorie gut beschrieben:
"The ability to knock out any arbitrary classification problem in minutes instead of in a week is a big deal... I don't want to spend a week to create a dataset, finetune a model, and set up infrastructure to run the model, every time I have a small routing or classification problem."
Das ist die Spannung, die jede der folgenden Alternativen anders auflöst: Wie viel willst du selbst betreiben, und willst du eine Entscheidung oder eine Lösung?
Wie ich diese Alternativen ausgewählt habe
Ich habe jede Option an fünf Punkten gemessen:
- Was sie tatsächlich tut - reiner Klassifikator, typisierte Decision-API, Bibliothek für eingeschränkte Ausgabe oder ein vollständiges Teammitglied, das handelt.
- Selbst gehostet vs. verwaltet - betreibst du die Gewichte oder rufst du einen Endpunkt auf?
- Die Vertrauensfrage - kannst du dem Score genug vertrauen, um automatisch zu handeln, oder ist er eine Blackbox? Layas ganzes Verkaufsargument ist Kalibrierung, also müssen Alternativen diese Latte nehmen.
- Echte Kosten - Lizenz, Preis pro Aufruf und die Engineering-Zeit, die niemand ins Angebot schreibt.
- Mehrsprachige Reichweite - Laya deckt über 100 Sprachen ab, globale Support-Teams müssen also wissen, worauf sie verzichten würden.
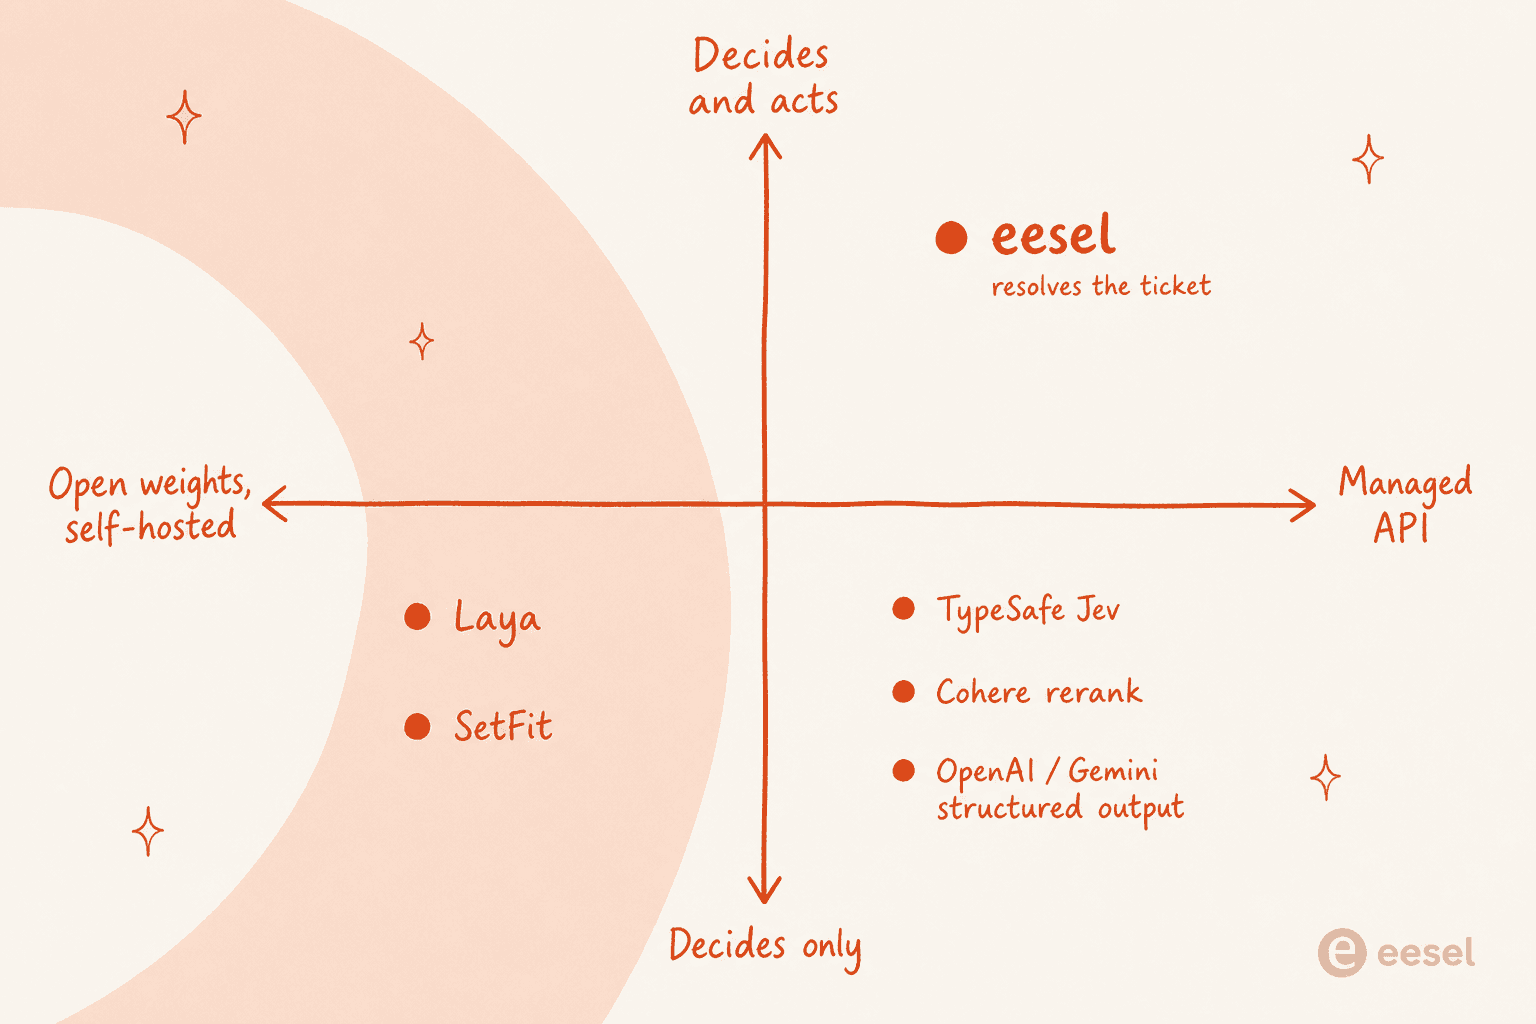
Hier ist die Landschaft in einem Bild, bevor wir in die einzelnen Tools einsteigen.
Laya-AI-Alternativen im Überblick
| Tool | Am besten für | Typ | Selbst hosten? | Entscheidet oder handelt | Abrechnungseinheit | Einstiegspreis |
|---|---|---|---|---|---|---|
| eesel | Support-Tickets tatsächlich lösen | KI-Teammitglied | Verwaltet | Entscheidet und handelt | Credit-Pläne ab 299 $/Monat | Gratisplan (100 Credits) |
| TypeSafe Jev | Ein verwalteter Zwilling von Laya | Decision-API | Verwaltet | Entscheidet | Pro 1 Mio. Token | 0,042 $ / 1 Mio. Input, Output gratis |
| SetFit | Few-Shot-Klassifikation in Eigenregie | OSS-Klassifikator | Ja | Entscheidet | Keine (Rechenleistung) | 0 $ (Apache 2.0) |
| Cohere | RAG-Relevanz + Klassifikation | Verwaltete API | VPC- / On-Prem-Option | Entscheidet | Pro Suche / pro 1 Mio. | ca. 2,00 $ / 1.000 Suchen |
| OpenAI Structured Outputs | Teams, die schon GPT nutzen | LLM-Funktion | Verwaltet | Entscheidet | Pro 1 Mio. Token | Kein Aufschlag aufs Modell |
| Google Gemini | Günstigste verwaltete strukturierte Klassifikation | LLM-Funktion | Verwaltet | Entscheidet | Pro 1 Mio. Token | Flash-Lite ist am günstigsten |
| Outlines / Instructor | Schema-Sicherheit für dein eigenes LLM | OSS-Bibliotheken | Ja | Entscheidet | Keine (Rechenleistung) | 0 $ (Apache-2 / MIT) |
| Cloudflare Workers AI | Edge-Inferenz, auch für Jev | Verwalteter Katalog | Verwaltet | Entscheidet | Neurons | Gratis-Kontingent, danach nutzungsbasiert |
1. eesel
Am besten für: Teams, die merken, dass die Entscheidung nur Schritt eins war und sie eigentlich das gelöste Support-Ticket brauchen.
Ich sage es gleich ehrlich, weil der Blog-Skill, unter dem ich schreibe, darauf besteht: eesel ist kein Decision Model, und wenn du speziell einen typisierten 33-ms-Klassifikations-Baustein für deine eigene Pipeline brauchst, ist eines der folgenden Tools der bessere direkte Ersatz. Aber die meisten, die Laya für einen Support-Fall prüfen, wollen kein Label, sondern das Ergebnis, zu dem das Label führen sollte. Diese Lücke füllt eesel.

eesel ist eine Plattform für KI-Teammitglieder: Du stellst einsatzbereite Teammitglieder für bestimmte Aufgaben ein, und aktuell besteht das Team aus einem KI-Helpdesk-Teammitglied und einem KI-Blogautor. Das Helpdesk-Teammitglied erledigt den ganzen Kreislauf, den ein Decision Model nicht schafft: Es liest deine jahrelangen früheren Tickets und dein Help Center, entwirft die Antwort, führt die Aktion aus und leitet weiter oder eskaliert, wenn es unsicher ist. Routing ist ein Teil davon, nicht das ganze Produkt.
Hier zählen unsere Jahre mit KI in echten Support-Queues für diesen Vergleich. Layas eigene Daten zeigen etwas, bei dem man kurz innehalten sollte: Im mehrsprachigen Test erreichte das englische Modell bei Khmer 0,000 Genauigkeit, meldete aber 0,952 mittlere Konfidenz. Ein Modell kann selbstsicher und kalibriert falsch liegen. Wir haben das auf die harte Tour gelernt, als wir Bots beobachteten, die überzeugt völlig falsche Antworten gaben, und genau deshalb wird jeder eesel-Rollout gegen deine historischen Tickets simuliert, bevor er je eine Live-Konversation berührt. Du siehst zuerst die echte Deflection-Rate auf deinen eigenen Daten, keine Benchmark-Zahl.
Für Entwickler, denen Layas Programmierbarkeit gefiel, bietet eesel dasselbe Teammitglied über die eesel-CLI und MCP an: Du kannst es installieren, Wissensquellen anbinden, Anweisungen setzen, eine Simulation laufen lassen und die Aktivität per Terminal oder Skript prüfen. Coding-Agenten wie Claude Code, Codex und Cursor können es genauso steuern. Es ist dasselbe Teammitglied, das eine nicht-technische Support-Leitung im Dashboard konfiguriert, nur als Code bedient.
Vorteile:
- Entscheidet und löst, über Zendesk, Freshdesk, Slack, E-Mail und über 100 weitere Tools.
- Simuliert vor dem Go-live auf deiner echten Ticket-Historie, sodass die Konfidenz in deinen Daten verankert ist.
- In einfacher Sprache coachbar, dazu eine vollständige CLI- und MCP-Oberfläche für die programmierende Fraktion.
Nachteile:
- Kein roher Klassifikations-Baustein. Wenn du wirklich einen einzelnen Modellaufruf in deinem eigenen Stack brauchst, hat es die falsche Form.
- Es ist ein verwaltetes Teammitglied, keine Gewichte, die du Air-Gapped betreiben kannst.
Preise: Gratis zum Start, danach ein fester Monatspreis ab 299 $/Monat für 500 Credits (1 Credit pro Ticket oder Chat). Du zahlst also für bearbeitete Tickets statt pro geratenem Token.
Fazit: Wenn die Routing-Entscheidung immer der Lösung einer Support-Queue diente, überspring den Baustein und stell das Teammitglied ein. Wenn du wirklich einen eigenständigen Klassifikator brauchst, lies weiter.
2. TypeSafe Jev
Am besten für: genau den Laya-Anwendungsfall, aber verwaltet, ohne Fine-Tuning und ohne eigenes Hosting.
Jev ist das Modell, auf das Laya die Antwort sein wollte, also die naheliegendste Alternative der Liste. TypeSafe, gegründet von Diogo Almeida (Miterfinder von RLHF bei OpenAI), nennt es das erste öffentliche „System-1-Modell": Du schickst unstrukturierten Zustand plus typisierte Fragen, und es gibt in einem parallelen Durchlauf typisierte probabilistische Entscheidungen zurück, mit denselben drei Primitiven, die Laya übernommen hat: noul, choice und score.
Der Tausch gegenüber Laya ist klar. Jev ist geschlossen und kostenpflichtig, aber wirklich Drop-in ohne Trainingsschritt, genau das, was laut Hacker-News-Publikum Laya fehlte. Layas eigene Benchmarks behaupten, es sei 7,8-mal schneller und besser kalibriert als Jev, aber das sind Layas Zahlen auf Layas Setup, und sie gelten erst nach dem Fine-Tuning, das Jev dir nicht abverlangt. Bei einer 77-Klassen-Aufgabe, wohlgemerkt, schlug Jev Laya tatsächlich mit 0,870 zu 0,425.
Vorteile:
- Keine Gewichte, keine GPU, kein Fine-Tuning, das Drop-in-Erlebnis, das Laya nicht bietet.
- Stark bei Choice-Aufgaben mit hoher Kardinalität, bei denen Laya abfällt.
- Output-Token sind gratis, leseintensive Entscheidungen sind also günstig.
Nachteile:
- Geschlossen und proprietär, keine Air-Gapped- oder On-Prem-Option.
- Noch Early Access, keine öffentliche Preisseite über den untenstehenden Satz hinaus, und eine Warteliste.
Preise: 0,042 $ pro 1 Mio. Input-Token, Output gratis, abgerechnet über die API.
Fazit: Wenn dir Layas Konzept gefiel, aber nicht die Fine-Tuning-Hausaufgaben oder die GPU, ist Jev die verwaltete Version derselben Idee. Du tauschst nur Offenheit gegen Komfort. Für einen ausführlichen Vergleich auf der verwalteten Seite geht mein Jev-Alternativen-Überblick tiefer.
3. SetFit
Am besten für: Teams, die gern ein paar Beispiele labeln und trainieren und einen Klassifikator wollen, der ihnen ganz gehört.
Wenn Layas Fine-Tuning-Pflicht der Knackpunkt ist, macht SetFit daraus das Feature. Es ist ein Hugging-Face-Framework (mit Intel Labs und dem UKP Lab) für Few-Shot-Textklassifikation: Es feintunt kontrastiv einen Sentence-Transformer-Körper und trainiert dann einen kleinen Klassifikationskopf auf den Embeddings. Keine Prompts, keine Verbalizer.
Das Spitzenergebnis ist der gute Teil: Mit nur 8 gelabelten Beispielen pro Klasse hält SetFit mit dem Fine-Tuning von RoBERTa Large auf einem vollen Set mit 3.000 Beispielen mit, mit einer Größenordnung weniger Parametern und deutlich schnellerem Training. Es läuft auf einer CPU oder einer bescheidenen GPU, steht unter Apache-2.0, und mehrsprachige Unterstützung gibt es gratis, indem du einen mehrsprachigen Sentence-Transformer-Körper einsetzt. Da du Laya ohnehin feintunen wolltest, ist SetFit wohl der ausgereiftere, besser dokumentierte Weg zum selben Ziel eines „kleinen, schnellen Klassifikators".
Vorteile:
- Wirklich Few-Shot, mit ~8 Beispielen pro Klasse kommst du voran.
- Komplett offen (Apache-2.0), selbst gehostet, 0 $ Inferenz, wie Laya.
- Klein genug, um auf Standard-Hardware zu trainieren und zu betreiben.
Nachteile:
- Nur Klassifikator, keine kalibrierte „Decisions"-API, keine noul/choice/score-Primitive.
- Kein eingebauter Sprach-Router, den mehrsprachigen Körper wählst du selbst.
- Du brauchst weiter gelabelte Daten und den zweistufigen Fit.
Preise: kostenlos, Apache-2.0. pip install setfit und los geht's.
Fazit: der engste echte Open-Source-Geistesverwandte von Laya für Klassifikation. Wenn die kalibrierte Konfidenzschicht und der mehrsprachige Router keine K.-o.-Kriterien sind, ist SetFit ein dramaärmerer Weg zu einem eigenen Klassifikator.
4. Cohere
Am besten für: die RAG-Relevanz- und Klassifikationsaufgaben, für die man zu Laya greift, geliefert als verwaltete, unternehmenstaugliche API.
Mehrere von Layas Showcase-Anwendungen, besonders das Filtern nach RAG-Passagen-Relevanz, sind genau das, was Cohere seit Jahren leise besetzt. Seine Rerank-Modelle bewerten, wie relevant jede Passage für eine Anfrage ist, und seine Embed- und Classify-Endpunkte übernehmen die Arbeit „in welchen Bucket gehört dieser Text", alles ohne dass du etwas trainierst oder hostest.
Coheres Retrieval-Stack ist der Teil, den Praktiker wirklich lieben. Teams beschreiben Rerank regelmäßig als den Grund, warum sie bleiben, auch wenn sie mit dem Modell eines anderen Anbieters generieren, denn Relevanz-Ranking ist die Aufgabe, für die es gebaut wurde.
Der Unterschied zu Laya: Das ist eine verwaltete API, keine Gewichte, auch wenn Cohere hier ungewöhnlich entgegenkommend ist und VPC- und On-Prem-„Model Vault"-Deployments für Teams anbietet, deren Daten vor Ort bleiben müssen. Das ist ein Mittelweg, den Laya (komplett selbst gehostet) und Jev (komplett geschlossen) nicht bieten.
Vorteile:
- Rerank ist erstklassig für RAG-Relevanz, ein zentraler Laya-Anwendungsfall.
- Unterstützung für über 100 Sprachen bei Embed 4 und Rerank 4.
- VPC- / On-Prem-Option für regulierte Teams, plus kostenloses Entwickler-Kontingent.
Nachteile:
- Standardmäßig verwaltet und kostenpflichtig, nicht das 0-$-Self-Hosting von Laya.
- Auf Unternehmen ausgerichtet, den Retrieval-Stack in Produktion zu bringen ist also echte Engineering-Arbeit, keine Ein-Zeilen-Installation.
Preise: Rerank 4 Fast kostet 2,00 $ / 1.000 Suchen, Rerank 4 Pro 2,50 $ / 1.000, Embed 4 0,12 $ / 1 Mio. Token (Text). Kostenloses Testkontingent für Entwickler.
Fazit: Wenn du von Laya Relevanz-Ranking oder Klassifikation wolltest und keine GPU betreiben möchtest, ist Cohere die erwachsene verwaltete Antwort, besonders wenn du eine On-Prem-Lösung brauchst.
5. OpenAI Structured Outputs
Am besten für: Teams, die schon auf GPT setzen und typisierte, schemagarantierte Entscheidungen ohne ein weiteres Modell wollen.
Für typisierte Ausgabe brauchst du nicht zwingend ein eigenes Decision Model. Die Funktion Structured Outputs von OpenAI lässt ein GPT-5.6-Modell ein von dir geliefertes JSON-Schema einhalten, sodass die Antwort garantiert deinen Typen entspricht (oder eine explizite Ablehnung zurückkommt), und sie lässt sich direkt in Pydantic oder Zod einbinden.
Der ehrliche Haken ist der, um den sich die ganze „kann nicht halluzinieren"-Debatte drehte: Schema-gültig heißt nicht korrekt. Ein Modell kann dir eine perfekt typisierte Antwort liefern, die schlicht falsch ist, und anders als bei Laya bekommst du von einem allgemeinen LLM ein unschärferes Konfidenzsignal (du kannst logprobs lesen, aber das ist nicht die kalibrierte Verteilung, die Laya liefern soll). Außerdem zahlst du bei jedem Aufruf volle LLM-Latenz und Token-Kosten, genau den Overkill jenseits der 500 ms, den Laya für einfache Reflex-Entscheidungen ersetzen wollte.
Vorteile:
- Kein neues Modell nötig, wenn du schon bei OpenAI bist.
- Garantierte Schema-Einhaltung, mit expliziten Ablehnungen aus Sicherheitsgründen.
- Structured Outputs selbst verursacht keinen Aufschlag auf den Basis-Token-Preis.
Nachteile:
- Volle LLM-Kosten und -Latenz für das, was Laya in 33 ms erledigt.
- Konfidenz über
logprobsist ein Näherungswert, keine kalibrierten Entscheidungswahrscheinlichkeiten.
Preise: kein Funktionsaufschlag, du zahlst die Token-Preise des zugrunde liegenden Modells (GPT-5.6-Flaggschiffe liegen zwischen 0,20 $ und 5,00 $ pro 1 Mio. Input).
Fazit: der Weg des geringsten Widerstands, wenn GPT schon in deinem Stack ist und dein Entscheidungsvolumen überschaubar. Bei hohem Volumen treiben genau die Kosten pro Aufruf Leute zu einem eigens gebauten Decision Model.
6. Google Gemini
Am besten für: den günstigsten verwalteten Weg zu strukturierter Klassifikation, mit einem Modell, das sie ausdrücklich als Kernanwendung nennt.
Die strukturierte Ausgabe von Gemini funktioniert nach demselben Prinzip wie die von OpenAI: Du übergibst ein Antwortschema und Gemini hält es ein, und Googles Doku nennt „strukturierte Klassifikation" ausdrücklich als unterstützten Anwendungsfall statt als Hack.
Gemini verdient sich einen eigenen Platz neben OpenAI durch den Preis am unteren Ende: Die Flash-Lite-Stufe zielt klar auf Klassifikation mit hohem Volumen und niedrigen Kosten, also genau den wirtschaftlichen Druck, der Leute überhaupt zu Laya bringt. Wenn du verwaltete strukturierte Entscheidungen willst, dich die Token-Rechnung eines Flaggschiffmodells aber abschreckt, sind Geminis kleine Modelle der günstigste verwaltete Hebel hier. Der Vorbehalt „typisiert, aber nicht unbedingt korrekt" aus dem OpenAI-Abschnitt gilt auch hier: Das ist ein allgemeines LLM, kein kalibriertes Decision Model.
Vorteile:
- Strukturierte Klassifikation ist ein dokumentierter, erstklassiger Anwendungsfall.
- Flash-Lite-Preise sind für günstige Entscheidungen mit hohem Volumen gebaut.
- Große mehrsprachige Abdeckung ohne zusätzliche Einrichtung.
Nachteile:
- Weiter LLM-Latenz und ein Näherungs-Konfidenzsignal, nicht Layas Kalibrierung.
- Bindet dich an Googles API-Oberfläche.
Preise: kein Funktionsaufschlag auf die Token-Preise von Gemini-Modellen, Flash-Lite ist die günstigste Stufe.
Fazit: die beste verwaltete Wahl, wenn Kosten pro Entscheidung das ganze Spiel sind und du keine kalibrierte Konfidenz brauchst. Im Grunde OpenAIs strukturierte Ausgabe mit günstigerem Boden.
7. Outlines und Instructor
Am besten für: Teams, die ihr eigenes LLM (offen oder gehostet) behalten, aber beim Decodieren ein Schema erzwingen wollen.
Wenn dein Einwand gegen Laya lautet „ich will kein ganz eigenes Modell, mein vorhandenes soll nur aufhören, Müll zu liefern", lösen zwei Open-Source-Bibliotheken das direkt. Outlines (von dottxt) erzwingt Struktur beim Decodieren, das Modell kann nur Token ausgeben, die zu deinem Schema passen, und arbeitet mit OpenAI, Ollama und vLLM. Instructor umhüllt Modellaufrufe mit Pydantic und Validierung und ist zum Standardweg für typisierte Ausgabe über mehr als 15 Anbieter geworden.
Das sind keine Decision Models, sondern Leitplanken um das Modell, das du ohnehin betreibst. Das ist ihre Stärke (eigene Gewichte, keine neue Abhängigkeit zum Betreiben) und ihre Grenze (du erbst Latenz, Kosten und fehlende kalibrierte Konfidenz deines Basismodells). Outlines steht unter Apache-2, Instructor unter MIT, beide gratis. Beachte, dass dottxt auch eine kostenpflichtige gehostete API auf Basis der offenen Bibliothek verkauft, falls du sie nicht selbst betreiben willst.
Vorteile:
- Behalte dein vorhandenes Modell, mach nur seine Ausgabe typsicher.
- Komplett offen (Apache-2 / MIT), selbst gehostet, aktive Projekte.
- Die Durchsetzung von Outlines beim Decodieren ist wirklich schwer zu brechen.
Nachteile:
- Kein Modell, kein Geschwindigkeits- oder Kostenvorteil gegenüber dem LLM darunter.
- Keine kalibrierten Entscheidungswahrscheinlichkeiten, kein mehrsprachiger Router.
Preise: kostenlos und Open Source. Outlines hat eine kostenpflichtige gehostete dottxt-API, wenn du es verwaltet willst.
Fazit: das richtige Werkzeug, wenn das eigentliche Problem Schema-Sicherheit war und nicht Entscheidungsgeschwindigkeit. Kombiniert mit einem kleinen lokalen Modell bekommst du das meiste von Layas „nie fehlerhaft"-Garantie, ohne ein neues Modell einzuführen.
8. Cloudflare Workers AI
Am besten für: Teams, die kleine Modelle (auch Jev selbst) am Edge betreiben und nach Nutzung abrechnen wollen.
Cloudflare Workers AI ist ein etwas anderes Tier: ein Katalog aus über 65 gehosteten Modellen, die du am Edge nahe bei deinen Nutzern betreibst, ohne eigene Infrastruktur. Es ist hier aus einem bestimmten Grund relevant: Es hostet typesafe/jev. Wenn dich also das Decision-Model-Konzept interessiert, ist Cloudflare eine Möglichkeit, es tatsächlich aufzurufen.
Das Argument gegen selbst gehostetes Laya sind Latenz und Betrieb: Deine Entscheidung läuft an einem Edge-Standort nahe der Anfrage, und du fasst nie eine GPU an. Das Argument gegen Layas 0-$-Kosten ist Ehrlichkeit: Du zahlst nach Nutzung (in Cloudflares Einheit „Neurons"), auch wenn es ein Gratis-Kontingent zum Start gibt. Es ist weniger ein gleichwertiger Laya-Ersatz als eine Bereitstellungsfläche für die ganze Kategorie.
Vorteile:
- Edge-Inferenz, geringe Netzwerklatenz, keine Infrastruktur zu verwalten.
- Hostet Jev und Dutzende weitere kleine Modelle auf einer Abrechnungsfläche.
- Gratis-Kontingent, danach transparente Abrechnung in Neurons.
Nachteile:
- Kostenpflichtig, nicht das kostenlose Self-Hosting, das Laya bietet.
- Du wählst aus Cloudflares Katalog, statt beliebige eigene Gewichte zu betreiben.
Preise: Gratis-Kontingent, danach Abrechnung in Neurons.
Fazit: eher eine Antwort auf „wo betreiben" als auf „was betreiben". Wenn Edge-Latenz und kein Betriebsaufwand wichtiger sind als der letzte Cent, ist es ein sauberer Weg, ein Decision Model ohne GPU bereitzustellen.
Welche solltest du wirklich wählen?
Die Karte oben sagt es am besten: Deine zwei echten Fragen sind wie viel willst du selbst betreiben und willst du eine Entscheidung oder eine Lösung. Dieser kleine Wegweiser führt dich zur Shortlist.
eesel ausprobieren
Wenn du auf Laya gestoßen bist, weil du eine Support-Queue intelligenter machen wolltest, hier die Abkürzung: Die Routing-Entscheidung war nie das Ziel, sondern das Schließen des Tickets. eesel ist das KI-Helpdesk-Teammitglied, das die Triage-Entscheidung trifft und danach handelt, die Antwort entwirft, die Aktion ausführt und eskaliert, wenn es unsicher ist, live in Zendesk, Freshdesk, Slack und über 100 weiteren Tools.
Der Teil, der Layas größten Vorbehalt beantwortet: Weil auch ein selbstsicheres Modell falsch liegen kann, simuliert eesel jeden Rollout auf deinen historischen Tickets, bevor er einen echten Kunden berührt, sodass du die wahre Lösungsrate auf deinen Daten siehst, nicht auf einem Benchmark. Und für Entwickler, denen Layas Programmierbarkeit gefiel, lassen dich die eesel-CLI und MCP dasselbe Teammitglied per Terminal, Skript oder Coding-Agent steuern. Kostenlos starten.