Die 9 besten Grok-Voice-3-Alternativen 2026

Rama Adi

Katelin Teen
Zuletzt bearbeitet October 15, 2026
Warum überhaupt über Grok Voice 3 hinausschauen?
Ich beginne mit dem ehrlichen Teil: Grok Voice 3.0 ist sehr gut. In meinem Grok-Voice-3-Test habe ich es zu meiner ersten Wahl für einen Telefon-Agenten erklärt, der Aktionen ausführen muss, und nichts in den letzten Tagen hat das geändert. Artificial Analysis hat es auf Platz 1 seines Speech-to-Speech-Index gesetzt, auf Platz 1 bei der Aufgabenerfüllung in Live-Anrufen (94,8 %) und auf Platz 2 bei τ-Voice, dem Benchmark, der echte Support-Anrufe mit Tools und einem Richtliniendokument simuliert.
"SpaceXAI's Grok Voice 3.0 is the new leading Speech to Speech model, debuting at #1 on the Artificial Analysis Speech to Speech Index at 86.9, while also being competitive on latency"
Warum suchen Leute dann schon einen Tag nach dem Start nach Grok-Voice-3-Alternativen? Nach Durchsicht der Dokumentation und der Benchmark-Tabellen gibt es fünf echte Gründe:
- Parallelität bei einem neuen Konto. Die Parallelität bei Speech-to-Speech steigt jetzt mit den Gesamtausgaben: 10 Sessions bei 0 $, 20 bei 50 $, 50 bei 250 $, 100 bei 1.000 $ und 200 bei 5.000 $. Im Produktivbetrieb ist das in Ordnung, aber ein Team, das am ersten Tag 50 gleichzeitige Anrufe testen will, muss im Voraus zahlen, um die Stufe freizuschalten.
- Sprachen. Die Speech-to-Speech-Dokumentation von xAI nennt 20+ Sprachen. Gemini Live nennt 70, ElevenLabs 90+.
- Es ist eine API, kein Callcenter. Sie bringen Telefonleitung, Gesprächsablauf, Analysen und Eskalationsweg selbst mit. xAI verkauft zwar einen No-Code-Voice Agent Builder, aber viele Teams wollen eine vollständige Plattform.
- Die Latenz ist in die falsche Richtung gegangen. Die Zeit bis zum ersten Audio beträgt 0,81 Sekunden, gegenüber 0,70 Sekunden bei Grok Voice 2.0. Das ist immer noch schneller als jedes Modell in der Nähe im Index, aber nicht das schnellste Grok.
- Preis. 0,08 $ pro Minute (4,80 $ pro Stunde) ist Mittelfeld. Gemini 3.8 Live wird mit 0,84 $ pro Stunde gemessen.
Wenn keiner dieser fünf Punkte zutrifft, können Sie hier aufhören und grok-voice-3.0 festschreiben. Wenn einer zutrifft, hängt die richtige Alternative davon ab, welcher es ist, und genau das zu klären, ist Aufgabe des restlichen Beitrags. Für das größere Bild über den Anbieter hinaus behandelt mein Beitrag zu xAI-Alternativen auch die Textmodelle.
Drei Arten von Alternativen
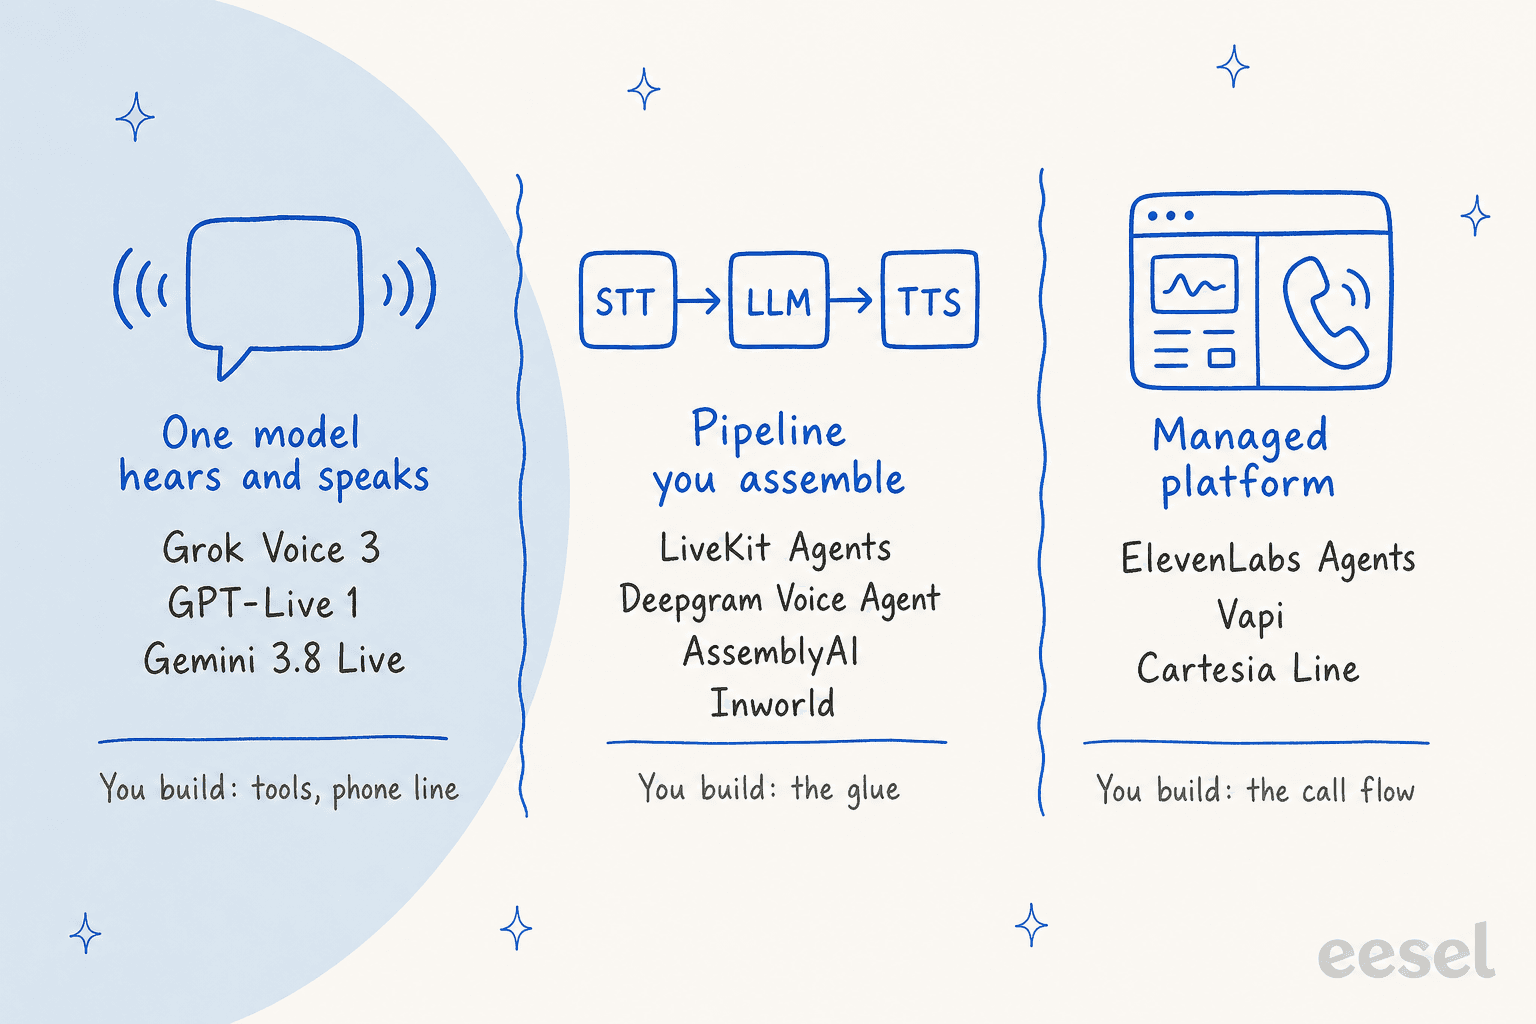
Als ich ChatGPT nach Grok-Voice-3-Alternativen gefragt habe, hat es die Antwort in drei Gruppen sortiert, und ich halte diese Einteilung für das Nützlichste, was ein Käufer von dieser Seite mitnehmen kann. Die Tools unten sind nicht austauschbar: Der Wechsel von einer Gruppe in eine andere ändert, wer den Sprecherwechsel und die Telefonie steuert, und auch die Tool-Aufrufe.
- Speech-to-Speech-Modelle hören Audio und antworten in einem einzigen Modell mit Audio. Die geringste Zahl beweglicher Teile, natürliches Dazwischenreden und die besten Benchmark-Werte. Die Tools und die Telefonanbindung bauen Sie weiterhin selbst.
- Pipelines verketten Speech-to-Text, ein Text-LLM und Text-to-Speech. Mehr Zwischenschritte, aber Sie können jeden Baustein austauschen, jedes LLM verwenden und bei jedem Schritt ein sauberes Transkript lesen.
- Verwaltete Plattformen verpacken eine Pipeline mit Telefonnummern, Builder, Tests und Analysen. Sie bauen den Gesprächsablauf, sie betreiben die Infrastruktur.
Ein Entwickler auf Hacker News hat gegen die erste Gruppe Einspruch erhoben, und das sollte man im Hinterkopf behalten:
"Yeah, sadly "audio to audio" seems to mean "we transcript it automatically for you internally which gets passed to the model", otherwise we'd be seeing models that are able to hear nuance in the input voice and pronunciation, which AFAIK, no model does yet."

Für eine Support-Hotline ist das weniger ein Problem als der Klang. Anrufer wollen, dass ihre Bestellung gefunden wird, sie brauchen keine Würdigung ihres Akzents.
Wie ich diese neun ausgewählt habe
Ich baue bei eesel die Integrationsschicht, also den Code, der einen KI-Agenten mit einem Live-Helpdesk verbindet, und betrachte diese Tools deshalb als Entwickler. Für jedes habe ich am 15. Oktober 2026 die Dokumentation und die Preisseite des Anbieters gelesen, die Produktseiten selbst festgehalten und jede Benchmark-Zahl aus dem Speech-to-Speech-Leaderboard von Artificial Analysis gezogen. Preise stammen ausschließlich von Anbieterseiten.
Was ich nicht gemacht habe: tausend Produktivanrufe durch jedes Tool zu schicken, denn Grok Voice 3.0 ist erst einen Tag alt. Wo ich eine Latenz nenne, ist es entweder die von Artificial Analysis gemessene Zeit bis zum ersten Audio oder die vom Anbieter selbst veröffentlichte Zahl, und ich sage dazu, welche von beiden.
Die Auswahl begann mit den sechs Tools, die ChatGPT genannt hat (OpenAI, Google, ElevenLabs, Deepgram, LiveKit, Vapi). Dann habe ich drei ergänzt, die in den eigenen Tests des Benchmarks mit kaskadierten Systemen auftauchten oder eine echte Voice-Agent-API haben: Cartesia, AssemblyAI und Inworld. Retell AI habe ich weggelassen, weil sich seine Nische mit Vapi überschneidet. Mein Retell-AI-Test behandelt es, falls Sie die beiden abwägen.
Grok-Voice-3-Alternativen im Vergleich
Hier ist das ganze Feld in einer Tabelle. „Headline-Preis" ist die Zahl auf der Preisseite des Anbieters, in der nächsten Spalte steht, was sie nicht abdeckt.
| Tool | Typ | Headline-Preis | Nicht enthalten | Kostenloser Start | Parallelität (Einstieg bis höchster veröffentlichter Wert) | Zeit bis zum ersten Audio | Sprachen | Telefon | Compliance (laut Anbieter) |
|---|---|---|---|---|---|---|---|---|---|
| Grok Voice 3.0 (Vergleichsbasis) | Speech-to-Speech | $0.08/min | Ihr Carrier | Kein kostenloser Tarif angegeben | 10 bis 200 je nach Gesamtausgaben | 0.81s (AA) | 20+ | Natives SIP, Twilio, LiveKit | SOC 2 Type II, HIPAA-fähig mit BAA, GDPR-AVV |
| GPT-Live 1 | Speech-to-Speech | $0.05/min | Backend-Modell und Tool-Nutzung | Nein | Nicht auf der Preisseite | 1.24s bis 1.34s (AA) | Nicht auf der Modellseite angegeben | Direktes SIP, Twilio, Telnyx, Bandwidth | SOC 2 Type 2, BAA verfügbar |
| Gemini 3.8 Live | Speech-to-Speech | $0.005/min Eingabe, $0.018/min Ausgabe | Search Grounding über 5,000/Monat | Ja, kostenloser Tarif | Nicht auf der Preisseite | 1.18s (AA) | 70 | Nur WebSocket | Daten im bezahlten Tarif werden nicht fürs Training genutzt |
| LiveKit Agents | Pipeline (Open Source) | $0.01/min Agent-Session | STT, LLM, TTS, Telefonie | 1,000 Agent-Min./Monat | 5 bis 600 | Abhängig von den Modellen | Abhängig von den Modellen | US-Nummern, SIP, Twilio, WhatsApp | SOC 2 Type II, BAA bei Scale |
| Deepgram Voice Agent | Pipeline (verwaltet) | $0.075/min | Bei Standard nichts | $200 Guthaben | Bis 45 bei Pay-as-you-go | Nicht gemessen | 45+ (Nova) | Telefonie-Dokumentation | SOC 2 Type 2, HIPAA-BAA, EU-Endpunkt |
| AssemblyAI Voice Agent | Pipeline (verwaltet) | $0.075/min | Nichts angegeben | Kostenlose Registrierung | Nicht auf der Preisseite | Nicht gemessen | 32 | Anleitung zur Telefonnummer | SOC 2 Type 2, BAA |
| Inworld Realtime | Pipeline (S2S-artige API) | Pro Baustein: STT $0.15/hr, TTS ab $15/1M Zeichen | LLM-Tokens | Kostenloser On-Demand-Start | Nicht veröffentlicht | 204ms am besten, 462ms Median (Anbieter) | ~500 (TTS) | G.711 von Twilio | SOC 2 Type II, GDPR, HIPAA als Zusatz |
| ElevenLabs Agents | Verwaltete Plattform | $0.08/min | LLM, Ihr Carrier | 15 Min./Monat | 4 bis 40, Burst bis 3x | Nicht gemessen | 90+ | Twilio, SIP-Trunk | BAAs im Enterprise-Tarif |
| Vapi | Verwaltete Plattform | $0.05/min Hosting | STT, LLM, TTS zum Selbstkostenpreis | $5 Guthaben | 4 bis 30, +$10 pro Leitung | Nicht gemessen | Abhängig von den Modellen | Kostenloses Vapi-SIP, Twilio-Durchleitung | HIPAA-Zusatz $2,000/Monat |
| Cartesia Line | Verwaltete Plattform | $0.06/min | $0.014/min Cartesia-Nummer | $1 Agent-Guthaben (~17 Min.) | 8 bis 60 | Nicht gemessen | Abhängig von der Stimme | Cartesia-Nummern | SOC 2 Type II, HIPAA, GDPR |
Die AA-Latenzspalte ist nur für die Speech-to-Speech-Modelle gefüllt, da Artificial Analysis die Zeit bis zum ersten Audio nur bei diesen misst. Bei Pipelines und Plattformen hängt die Latenz davon ab, welche Modelle Sie einstecken, und das ist die Variable, die Sie selbst steuern.
Was die Minuten wirklich kosten
Headline-Preise passen nicht zusammen, weil jeder Anbieter etwas anderes weglässt. Der Rechner unten stellt alle Tools auf dieselbe Grundlage: eine Minute eines Support-Anrufs, in der der Agent etwa die Hälfte der Zeit spricht. Geben Sie Ihre monatlichen Gesprächsminuten ein, und die Balken bauen sich neu auf.
Geben Sie Ihre monatlichen Gesprächsminuten ein, um die Rechnung zum Listenpreis jedes Tools zu sehen. Preise von der jeweiligen Anbieter-Preisseite am 15. Oktober 2026. Bei GPT-Live 1, Inworld und ElevenLabs ist ein Teil der LLM-Kosten nicht enthalten, betrachten Sie sie also als Untergrenzen.
Zwei Dinge fallen auf. Erstens liegt der Großteil des Feldes zwischen 0,075 $ und 0,083 $ pro Minute, was bedeutet, dass Grok Voice 3.0 für das, was es leistet, nicht teuer ist. Zweitens tauschen Sie bei den beiden Ausreißern bei den Kosten (Gemini 3.8 Live und Inworld) etwas Reales ein: bei Gemini die Genauigkeit bei Support-Aufgaben, bei Inworld eine selbst zusammengestellte LLM-Wahl. Zum Kontext, was eine Minute KI-Stimme im Vergleich zu einem Menschen wert ist, rechnet mein Beitrag zu KI-Agent vs. menschlicher Agent: Kosten nach.
Speech-to-Speech-Wechsel
Diese beiden sind der direkte Ersatz, dieselbe Architektur wie bei Grok, mit einem Modell, das zuhört und auch spricht. Wenn Ihr Code bereits das OpenAI-Realtime-Eventformat spricht (Groks API ist darauf ausgelegt, damit kompatibel zu sein), besteht der Wechsel hauptsächlich aus einem Endpunkt und einem Schlüssel.
Der wichtigste Benchmark für eine Support-Hotline ist τ-Voice, er bewertet, ob das Problem eines simulierten Anrufers tatsächlich gelöst wurde. Hier trennen sich drei Speech-to-Speech-Familien:
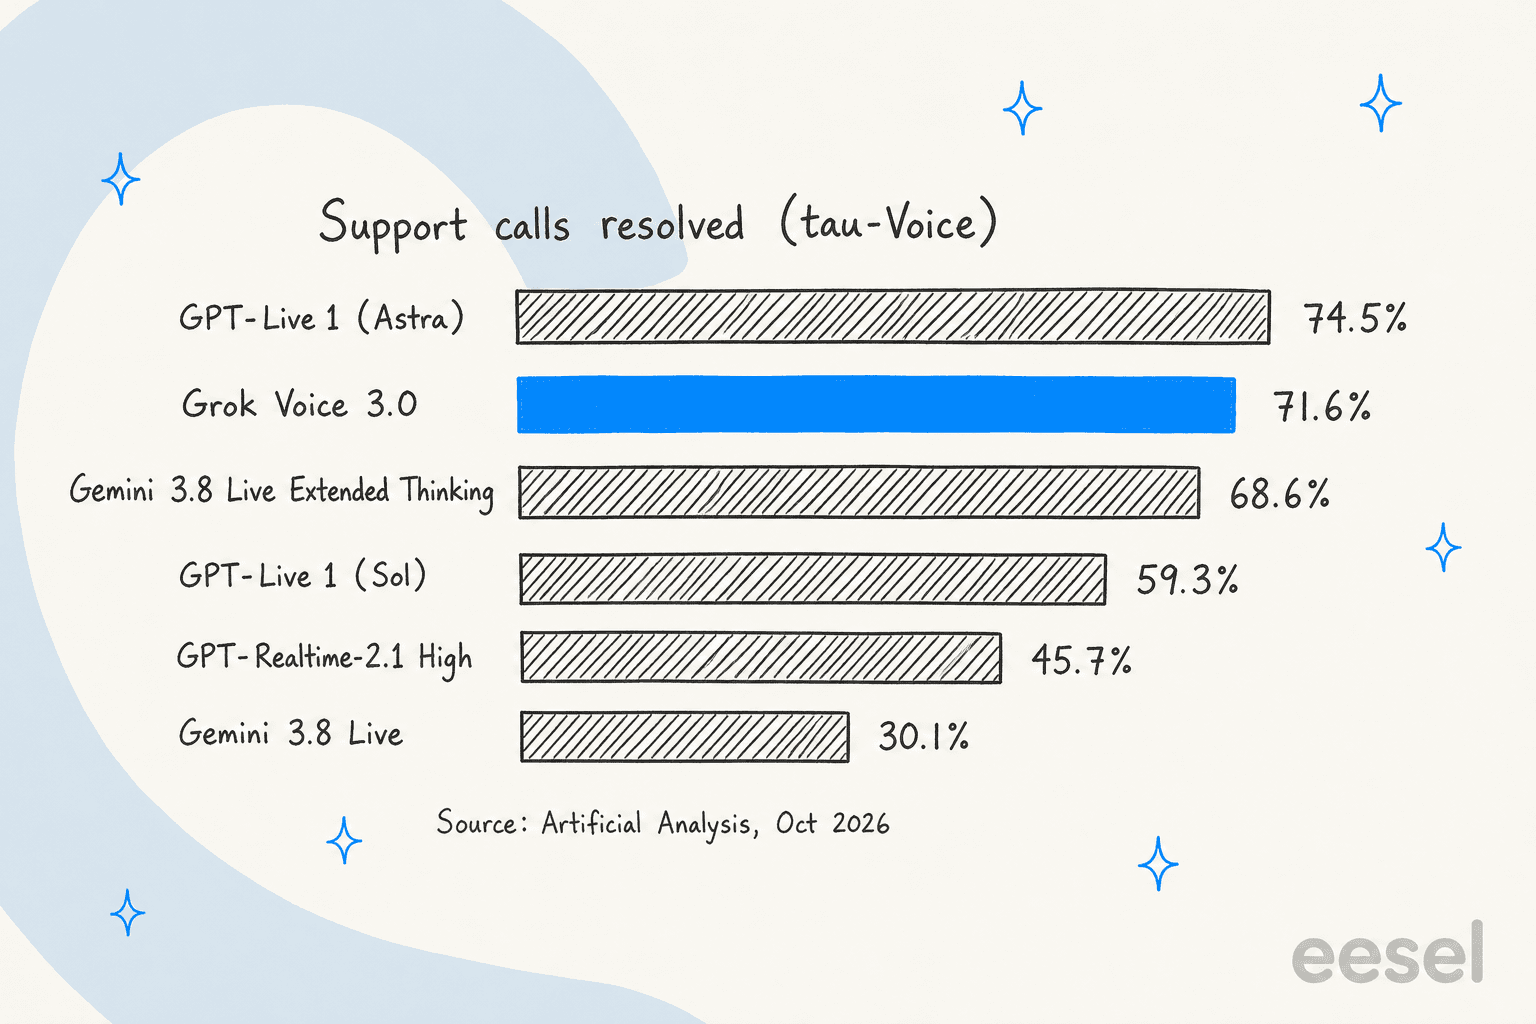
Beachtenswert ist der unterste Balken. Gemini 3.8 Live ist in Blindhörtests die am zweitbesten bewertete Stimme und das günstigste Modell hier, löst aber trotzdem nur 30,1 % der Anrufe. Angenehm und korrekt sind unterschiedliche Werte.
1. OpenAI GPT-Live 1 und die Realtime API
Am besten für: Support-Hotlines, bei denen der Abschluss der Aufgabe wichtiger ist als alles andere, und Teams, die bereits OpenAI nutzen.
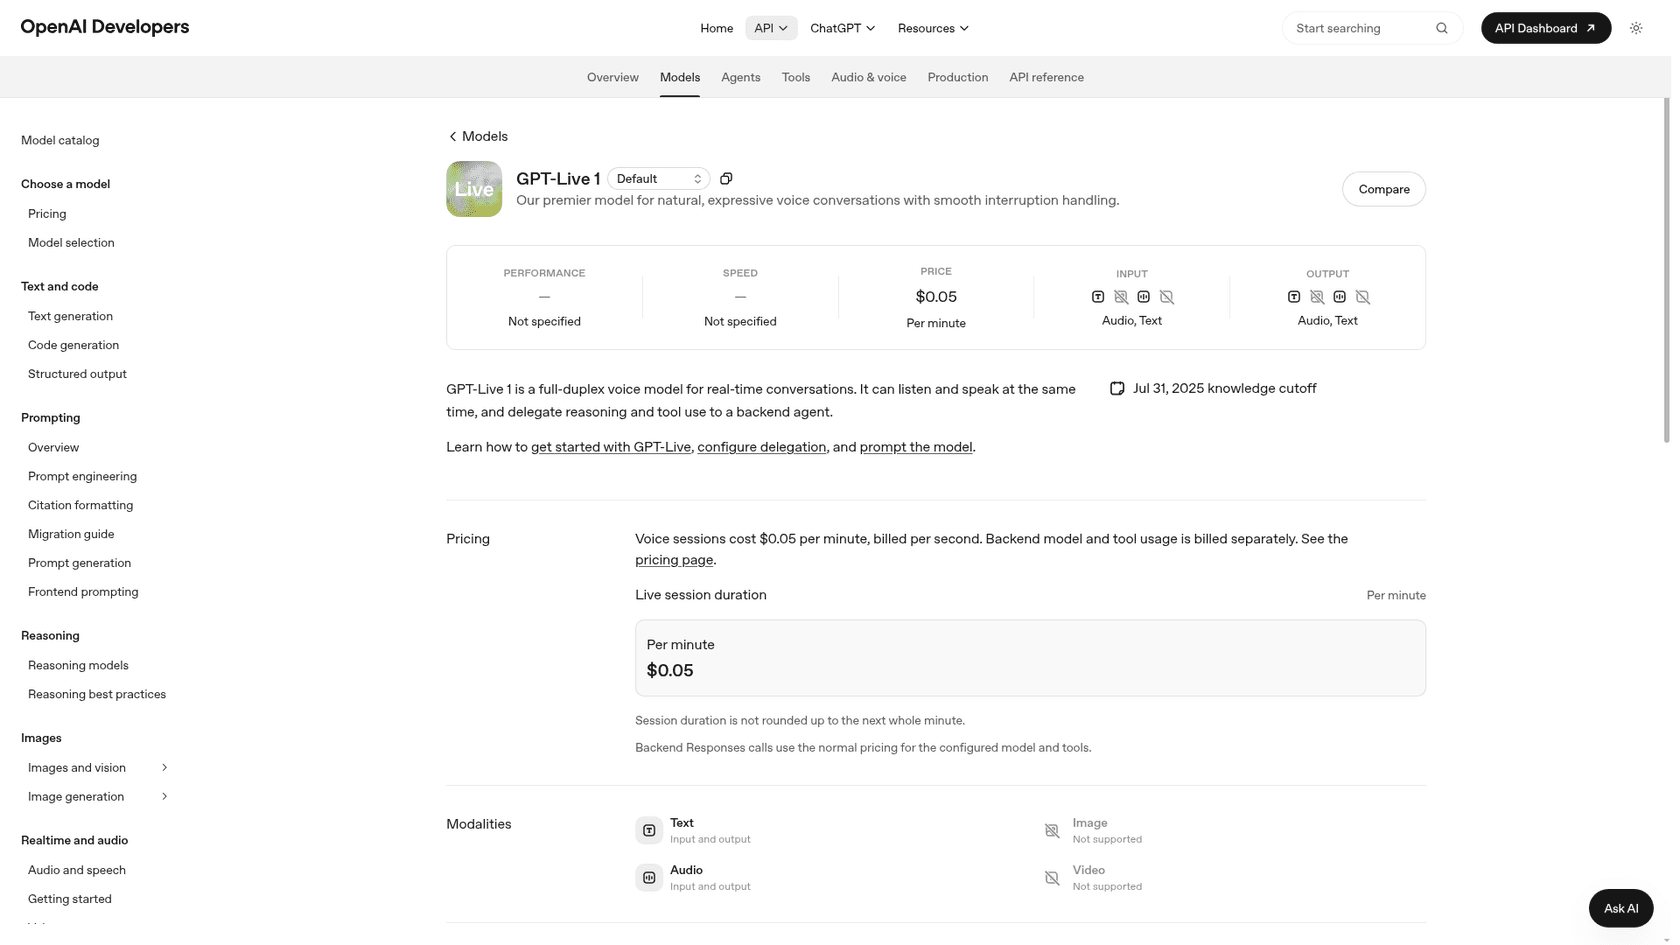
OpenAI hat jetzt zwei Sprachwege. GPT-Live 1 ist ein Vollduplex-Modell, das laut seiner Modellseite "can listen and speak at the same time, and delegate reasoning and tool use to a backend agent". Die ältere Realtime API mit gpt-realtime-2.1 ist ein einzelnes Speech-to-Speech-Modell, das Audio-Gesprächsrunden, Tools und Unterbrechungen in einer Session erledigt. Die Trennung ist für den Support wichtig: GPT-Live überlässt das schwere Denken einem separaten Textmodell (im Benchmark Astra oder Sol), und genau dieser Aufbau führt bei τ-Voice.
Telefonanrufe erreichen es über einen direkten SIP-Trunk, und OpenAI veröffentlicht in seiner Telefonie-Dokumentation Partner-Anleitungen für Twilio, Telnyx, Bandwidth, LiveKit und Daily/Pipecat. Entwickler auf Hacker News waren zum Start begeistert:
"I was excitedly awaiting this hitting the API, because ofc there wasn't a super high fidelity option for drop-in voice interface in front of a given harness. This is blowing me away so far!"
Was es besser macht als Grok:
- Das einzige Modell, das Grok bei τ-Voice schlägt: 74,5 % für GPT-Live 1 (Astra, medium) gegenüber 71,6 %.
- Der Backend-Agent ist ein beliebiges Modell, das Sie konfigurieren, sodass Ihr bestehender Text-Agent samt Tools hinter der Stimme sitzen kann.
- Abrechnung pro Sekunde zu 0,05 $ pro Minute, ohne Aufrunden auf eine volle Minute.
Wo es schwächelt:
- Es beginnt langsamer zu sprechen: 1,34 s bis zum ersten Audio bei Astra und 1,24 s bei Sol, gegenüber 0,81 s bei Grok.
- Die Headline-Zahl von 0,05 $ schließt das Backend-Modell nicht ein. Artificial Analysis hat das Astra-Setup mit 5,83 $ pro Stunde gemessen, mehr als Groks 4,80 $.
- Artificial Analysis weist darauf hin, dass die τ-Voice-Werte von GPT-Live aus einem Durchlauf stammen, gegenüber drei bei den meisten Modellen.
- Die Modellseite nennt keine unterstützten Sprachen, eine Lücke, die ein HN-Nutzer ebenfalls bemängelt hat.
Preise:
| Modell | Preis | Hinweise |
|---|---|---|
| GPT-Live 1 | $0.05/min, sekundengenau abgerechnet | Backend-Responses-Aufrufe werden zu den Preisen dieses Modells abgerechnet |
| gpt-realtime-2.1 | $32 / $64 pro 1M Audio-Tokens Ein / Aus | Text $4 / $24 pro 1M |
| gpt-realtime-2.1-mini | $10 / $20 pro 1M Audio-Tokens Ein / Aus | Text $0.60 / $2.40 pro 1M |
Alles von der Preisseite von OpenAI. Die ganze Rechnung steht in meinem Beitrag zu den GPT-Live-1-Preisen, und es gibt eine eigene Liste mit GPT-Live-1-Alternativen, wenn Sie von der anderen Seite kommen.
Mein Fazit: der stärkste Wechsel, wenn Ihre Anrufe aufgabenlastig sind (Erstattungen, Buchungen, Kontoänderungen) und Sie mit einer halben Sekunde mehr bis zur ersten Antwort leben können. Verzichten Sie darauf, wenn Sie eine veröffentlichte Sprachliste oder ein festes Budget pro Minute brauchen. Wenn Sie Tools anbinden, lesen Sie sich zuerst zu Realtime-Tool-Aufrufen ein, denn die Stille, während eine Funktion läuft, ist der Moment, in dem Anrufer auflegen.
2. Google Gemini 3.8 Live
Am besten für: Anrufe mit hohem Volumen und geringem Risiko (Infoleitungen, Buchungserinnerungen, mehrsprachige Eingangstüren), bei denen Kosten und Sprachabdeckung wichtiger sind als Aufgabengenauigkeit.
Google nennt Gemini 3.8 Live "the default option for most low-latency voice agent experiences", und es ist ein stabiles Modell, keine Vorschau. Die Live API ist ein zustandsbehafteter WebSocket, der Audio, Bilder und Text aufnimmt und in 70 Sprachen per Audio antwortet. Funktionsaufrufe laufen jetzt standardmäßig asynchron, sodass das Modell weiterreden kann, während eine Abfrage läuft.
Es gibt auch eine Extended-Thinking-Variante, die im Hintergrund nachdenkt. Sie erreicht bei τ-Voice 68,6 %, nahe an Grok, aber ihre Zeit bis zum ersten Audio beträgt 1,35 s, und Artificial Analysis hat sie mit 3,50 $ pro Stunde gemessen. Googles Live-Familie umfasst außerdem Live Translate für Speech-to-Speech-Übersetzung, ein eigenes Modell.
Was es besser macht als Grok:
- Preis: 0,005 $ pro Minute Audio-Eingabe und 0,018 $ Ausgabe. Artificial Analysis hat 0,84 $ pro Stunde gemessen, gegenüber Groks 4,80 $.
- 70 unterstützte Sprachen gegenüber 20+.
- Ein kostenloser Tarif auf der Preisseite, und im bezahlten Tarif werden Ihre Daten nicht zur Verbesserung von Googles Produkten genutzt.
- Der zweithöchste Wert bei der menschlichen Präferenz auf der Liste (Elo 1088).
Wo es schwächelt:
- τ-Voice von 30,1 % für das Standardmodell. Es klingt gut und erledigt die Aufgabe oft nicht.
- Sessions ohne Kontextkomprimierung sind bei Audio auf 15 Minuten begrenzt, und eine Verbindung lebt etwa 10 Minuten, bevor Sie Session Resumption brauchen.
- Nur WebSocket. Es gibt kein natives SIP, eine Telefonleitung läuft also über einen Partner wie LiveKit.
- Das Modell hat ein Eingabe-Token-Limit von 131.072.
Preise:
| Posten | Kostenloser Tarif | Bezahlter Tarif |
|---|---|---|
| Audio-Eingabe | Kostenlos | $3.00 pro 1M Tokens oder $0.005/min |
| Audio-Ausgabe | Kostenlos | $12.00 pro 1M Tokens oder $0.018/min |
| Text Ein- / Ausgabe | Kostenlos | $0.75 / $4.50 pro 1M Tokens |
| Google Search Grounding | Unterstützt | 5,000 kostenlos/Monat, dann $14 pro 1,000 |
Mein Fazit: die richtige Wahl, wenn die Kosten pro Minute alles entscheiden und der Agent überwiegend informiert statt handelt. Für eine Leitung, die Bestellungen ändern oder Gutschriften ausstellen muss, würde ich Extended Thinking direkt neben Grok testen, bevor ich dem Standardmodell vertraue. Wenn Sie bereits Gemini 3.8 Flash für Text nutzen, ist das gemeinsame Abrechnungskonto ein kleiner Bonus.
Pipelines zum Selbstbauen
Diese vier verketten Speech-to-Text, ein Text-LLM und Text-to-Speech. Die zusätzlichen Zwischenschritte kosten Latenz, und ein Reddit-Entwickler hat den Zielkonflikt gut zusammengefasst:
"The core problem I found with the Retell/Vapi approach was the latency that chaining 3 services sequentially together added. STT provider → LLM → TTS provider. Each hop adds latency and you're managing 3 WebSocket connections plus your own VAD and turn-taking logic."

Die Kehrseite ist Kontrolle. Bei einer Pipeline ist das LLM ein beliebiges Modell Ihrer Wahl, auch das, das Ihr Text-Agent schon nutzt, und Sie erhalten bei jedem Schritt ein sauberes Transkript für die Qualitätssicherung und Anrufzusammenfassungen. Deepgram, AssemblyAI und Inworld betreiben die Pipeline für Sie als eine einzige API, während LiveKit Ihnen das Framework gibt, um sie selbst zu betreiben.
3. LiveKit Agents
Am besten für: Engineering-Teams, die den Stack selbst besitzen, Modelle frei tauschen und eigene Telefonnummern betreiben wollen.
LiveKit Agents ist ein Open-Source-Framework (Apache 2.0), mit dem Sie ein Python- oder Node.js-Programm als vollwertigen Teilnehmer in einen Anruf einbinden. Es übernimmt die schwierigen Teile von Sprache: das Streamen von Audio durch die Pipeline, Turn Detection, Unterbrechungen und die LLM-Orchestrierung. Es unterstützt auch Realtime-Modelle, darunter GPT-Live und Gemini Live, und die Dokumentation von xAI nennt LiveKit als unterstützten Weg, Grok anzubinden. LiveKit ist also weniger ein Grok-Ersatz als eine Schicht, die es Ihnen erlaubt, Grok später ohne Umschreiben zu ersetzen.
LiveKit Cloud ergänzt Hosting und Telefonnummern, Simulationen und Observability sowie einen gehosteten Inferenz-Katalog, mit dem Sie Modelle ohne separate API-Schlüssel aufrufen können.
Was es besser macht als Grok:
- Modellfreiheit: Die Preisseite listet Dutzende LLMs, STT- und TTS-Modelle mit Preisen pro Minute auf, von GPT-5 nano mit 0,0002 $/min bis Deepgram Flux mit 0,0065 $/min.
- Eingebaute Telefonie: eine kostenlose US-Nummer, SIP-Trunks sowie Twilio- und WhatsApp-Konnektoren.
- Bis zu 600 parallele Sessions im Scale-Tarif, auf der Seite veröffentlicht.
- Text- und Audio-Simulationen, um den Agenten zu testen, bevor echte Anrufer ihn erreichen, kostenlos bis zum 31. Oktober.
Wo es schwächelt:
- Sie sind der Integrator. Drei Modelle auszuwählen und abzustimmen ist echte Arbeit.
- Die Latenz hängt von Ihren Entscheidungen ab, und für „LiveKit" als Ganzes gibt es keine unabhängige Zahl für die Zeit bis zum ersten Audio.
- HIPAA mit unterschriebenem BAA beginnt im Scale-Tarif, ab 500 $ im Monat.
Preise:
| Tarif | Preis | Enthaltene Agent-Minuten | Parallele Sessions | Besonderheiten |
|---|---|---|---|---|
| Build | $0 | 1,000 | 5 | 1 kostenlose US-Nummer, 50 eingehende Minuten |
| Ship | Ab $50/Monat | 5,000, dann $0.01/min | 20 | Team-Zusammenarbeit, sofortiger Rollback |
| Scale | Ab $500/Monat | 50,000, dann $0.01/min | Bis zu 600 | HIPAA-BAA, Regionsbindung |
| Enterprise | Individuell | Individuell | Individuell | Volumenpreise für Inferenz, SSO |
LiveKits eigener Rechner bepreist einen Beispiel-Telefon-Agenten (Gemma 4 31B, AssemblyAI-STT, Fish-Audio-TTS, eine US-Nummer und Observability) mit 0,0479 $ pro Minute, etwa 40 % unter Grok.
Mein Fazit: meine Wahl für ein Team mit Entwicklern, das mehr als einmal die Modelle wechseln dürfte. Es ist die einzige Option hier, bei der der Wechsel von Grok zu Gemini oder GPT-Live eine Konfigurationsänderung ist. Lassen Sie es sein, wenn niemand im Team eine Voice-Pipeline betreuen will.
4. Deepgram Voice Agent API
Am besten für: Teams, die eine verwaltete Pipeline-API zu einem Festpreis wollen, mit der Option, ein eigenes LLM mitzubringen.
Deepgrams Voice Agent API "handles the full speech pipeline (listening, thinking, and speaking)" über einen einzigen WebSocket. Sie konfigurieren das Sprachmodell und den LLM-Anbieter, die Stimme und das Endpointing und legen dann Funktionsaufrufe und Multi-Agent-Übergaben darüber. Das Sprachmodell Flux ist für Voice Agents gebaut, mit eingebauter Turn Detection und Unterbrechungsbehandlung. Als Artificial Analysis Deepgrams Standard-Stack getestet hat, bestand er aus Nova-3 zum Zuhören, GPT-4o Mini zum Denken und Aura-2 zum Sprechen.
Was es besser macht als Grok:
- Ein kostenloses Guthaben von 200 $ ohne Karte, das laut Deepgram etwa 43.000 Minuten Nova-Transkription abdeckt.
- Bring-your-own-Optionen senken den Preis: 0,050 $ pro Minute, wenn Sie sowohl das LLM als auch die Stimme stellen.
- Bis zu 45 gleichzeitige Agent-Verbindungen bei einfachem Pay-as-you-go, ohne Ausgabenstaffel.
- SOC 2 Type 2, HIPAA mit BAA für Enterprise und ein dedizierter EU-Endpunkt.
Wo es schwächelt:
- Das Standard-LLM im Test von Artificial Analysis war GPT-4o Mini, ein kleines Modell für komplexe Support-Anrufe. Planen Sie, für alles Richtlinienlastige ein eigenes mitzubringen.
- Kein τ-Voice- oder Latenzwert von Artificial Analysis für den vollständigen Agenten.
- Abgerechnet wird nach WebSocket-Verbindungszeit, ein offener, ungenutzter Socket kostet also trotzdem Geld.
Preise:
| Stufe | Pay-as-you-go | Growth |
|---|---|---|
| Standard | $0.075/min | $0.068/min |
| Standard, eigenes TTS | $0.065/min | $0.051/min |
| Custom, eigenes LLM | $0.059/min | Nicht angegeben |
| Custom, eigenes LLM + TTS | $0.050/min | $0.041/min |
| Advanced | $0.163/min | $0.146/min |
Growth erfordert laut Preisseite von Deepgram eine Bindung ab 4.000 $ pro Jahr.
Mein Fazit: die sauberste „eine API, ein Preis"-Pipeline hier. Eine gute Wahl für ein Team, das bereits einen LLM-Agenten hat und Deepgrams Ohren und Stimme für 0,050 $ pro Minute darum legen will. Weniger überzeugend, wenn das Standard-LLM das Denken übernehmen soll.
5. AssemblyAI Voice Agent API
Am besten für: Teams, die den einfachsten Gesamtpreis und starke Spracherkennung wollen und mit AssemblyAIs eigenem LLM leben können.
AssemblyAI ist vor allem für Speech-to-Text bekannt, und die Voice Agent API stapelt drei eigene Bausteine: das Sprachmodell Universal-3.6 Pro Realtime, ein proprietäres LLM, "tuned for spoken conversation rather than text chat", und eine eigene Stimme mit niedriger Latenz. Die Kurzanleitung bringt in vier Befehlen einen Browser-Agenten zum Sprechen und legt ihn dann auf eine Telefonnummer.
Was es besser macht als Grok:
- Ein Festpreis von 4,50 $ pro Stunde (0,075 $ pro Minute), mit Spracherkennung, LLM und Stimme inklusive.
- Das Sprachmodell unterstützt 32 Sprachen mit Keyterm-Prompting, nützlich für Produktnamen und SKUs.
- Bezahlte Konten können dem Training widersprechen, und ein unterschriebenes BAA bewirkt das automatisch, laut AssemblyAIs Sicherheitsseite.
Wo es schwächelt:
- Das enthaltene LLM ist AssemblyAIs eigenes. Es gibt keinen veröffentlichten Benchmark dazu, wie es mit einer Support-Richtlinie und Tools umgeht.
- Kein Wert von Artificial Analysis für den vollständigen Agenten.
- Die Grenzen bei der Parallelität stehen nicht auf der Preisseite, Volumenkonditionen laufen über den Vertrieb.
Preise:
| Komponente | Preis |
|---|---|
| Voice Agent API (Orchestrierung und Hosting) | $4.50/hr ($0.075/min) |
| Sprachmodell Universal-3.6 Pro Realtime | Inklusive |
| Voice-Agent-LLM | Inklusive |
| Voice-Agent-TTS | Inklusive |
| Mengenrabatte, Forward Deployed Engineer | Vertrieb kontaktieren |
Mein Fazit: ein vernünftiger Standard für ein Team, dem es am meisten darauf ankommt, Anrufer richtig zu verstehen (Akzente, laute Leitungen, Produktnamen), und das eine einzige Zeile auf der Rechnung will. Ich würde sein LLM an 30 meiner schwierigsten Anrufe testen, bevor ich mich festlege, denn für diesen Teil gibt es keinen öffentlichen Wert.
6. Inworld Realtime API
Am besten für: Teams, die eine Speech-to-Speech-artige API mit eigener LLM-Wahl und den niedrigsten Stimmkosten pro Minute wollen.
Inworlds Realtime API sieht von außen wie ein Speech-to-Speech-Modell aus: eine WebSocket- oder WebRTC-Verbindung, die "listens, reasons and talks back". Darunter steckt eine Pipeline aus Inworlds eigenem Speech-to-Text, Ihrer Wahl unter 8 gehosteten LLMs und den TTS-2-Stimmen am Ende. Der Reiz für Grok-Nutzer: Ihre Events und Session-Konfiguration stimmen mit der OpenAI Realtime API überein, ein Client zieht also mit einem neuen Endpunkt und Schlüssel um.
Was es besser macht als Grok:
- Keine Speech-to-Speech-Gebühr obendrauf. Jeder Baustein wird zu seinem eigenen Preis abgerechnet: Speech-to-Text zu 0,15 $ pro Stunde, TTS-2 Flash ab 15 $ pro Million Zeichen On-Demand.
- Das LLM ist frei wählbar, das Denken kann also so stark (oder so günstig) sein, wie Sie wollen.
- Vom Anbieter gemessenes erstes Audio ab 204 ms, mit einem Median von 462 ms über 17 gemessene Gesprächsrunden.
- GDPR und SOC 2 Type II in jedem Tarif.
Wo es schwächelt:
- Die Latenzwerte sind Inworlds eigene Messungen, keine unabhängigen.
- Der Preis ist eine Summe aus Teilen, die Prognose einer Rechnung ist daher aufwendiger als bei einem festen Minutenpreis.
- HIPAA und BAA sind im höchsten veröffentlichten Tarif Zusatzoptionen.
- Telefon-Audio kommt als G.711 von Twilio, die Telefonnummer bringen Sie also selbst mit.
Preise:
| Tarif | Monatlich | TTS-2 Flash pro 1M Zeichen | STT 1 pro Stunde |
|---|---|---|---|
| On-Demand | $0 | $15 | $0.15 |
| Creator | $25 | $10 | $0.10 |
| Builder | $100 | $9 | $0.10 |
| Developer | $300 | $8 | $0.10 |
| Growth | $1,500 | $7 | $0.10 |
Inworld schätzt etwa 1.000 Zeichen Sprache pro Minute, die Sprachausgabe kostet also grob 0,01 $ bis 0,015 $ pro Minute, in der der Agent spricht, plus LLM-Tokens. Mehr in meiner Aufschlüsselung der Inworld-AI-Preise und der Liste der Inworld-Alternativen.
Mein Fazit: das interessanteste Kostenspiel für Teams, die mit einem Text-LLM bereits zufrieden sind. Es bietet die Entwicklererfahrung im Grok-Stil mit der Flexibilität einer Pipeline. Warten Sie, wenn Sie unabhängige Latenzzahlen oder eine schlüsselfertige Telefonleitung brauchen.
Verwaltete Voice-Agent-Plattformen
Diese drei verpacken eine Pipeline mit allem, was ein Support-Leiter braucht, um einen Telefon-Agenten tatsächlich zu betreiben: Nummern und einen Builder, Tests und Analysen sowie Parallelität, die man dazukaufen kann. Sie tauschen etwas Kontrolle und eine Plattformgebühr dagegen, nichts davon selbst bauen zu müssen. Wenn Ihr Team überhaupt eine Plattform abwägt, deckt meine Übersicht zur besten KI für Voice-Support mehr davon ab, ebenso die Liste der Voiceflow-Alternativen.
7. ElevenLabs Agents
Am besten für: Teams, die einen verwalteten Agenten mit der größten Sprachabdeckung und den natürlichsten Stimmen wollen.
ElevenLabs hat sich mit Stimmen einen Namen gemacht, und ElevenAgents ist seine Plattform für "natural, human-sounding agents in 90+ languages" über Sprache, Chat und E-Mail. Sie konfigurieren einen Agenten mit einem Workflow-Builder, hängen eine Wissensdatenbank und Tools an, stellen ihn auf einer Telefonleitung, im Web oder mobil bereit und überwachen ihn mit eingebauten Tests und Analysen. Der von Artificial Analysis getestete Standard-Stack war Scribe v2 Realtime, Gemini 2.5 Flash und Eleven Flash v2, und Sie können aus einer langen Liste von LLMs wählen oder ein eigenes mitbringen.
Was es besser macht als Grok:
- 90+ Sprachen, die größte Abdeckung in dieser Liste.
- Veröffentlichte Parallelität in jedem Tarif, von 4 Anrufen bei Free bis 40 bei Business, und Burst-Preise, mit denen Agenten das bis zu 3-Fache dieser Grenze zum doppelten Preis annehmen können.
- Keine Telefoniegebühr: Bringen Sie Twilio oder einen SIP-Trunk mit und zahlen Sie Ihren Carrier direkt.
- Ein vollständiger Agent-Builder, sodass ein Support-Leiter den Ablauf ohne Deployment ändern kann.
Wo es schwächelt:
- Die 0,08 $ pro Minute gelten vor dem LLM. Der Preisrechner zeigt Gemini 2.5 Flash mit 0,0029 $ pro Minute, stärkere Modelle kosten mehr.
- BAAs für HIPAA gibt es nur im Enterprise-Tarif.
- Kein unabhängiger τ-Voice-Wert für den vollständigen Agenten.
Preise:
| Tarif | Monatlich | Enthaltene Gesprächsminuten | Parallele Anrufe |
|---|---|---|---|
| Free | $0 | 15 | 4 |
| Starter | $6 (erster Monat $1) | 75 | 6 |
| Creator | $22 (erster Monat $11) | 275 | 10 |
| Pro | $99 | 1,238 | 20 |
| Scale | $299 | 3,738 | 30 |
| Business | $990 | 12,375 | 40 |
| Enterprise | Individuell | Individuell | Erhöht |
Zusatzminuten kosten in jedem Tarif 0,08 $, Burst-Minuten 0,16 $, laut der ElevenAgents-Preisseite. Mehr Details in meinem Beitrag zu den ElevenLabs-Preisen und der Liste der ElevenLabs-Alternativen.
Mein Fazit: der einfachste verwaltete Wechsel für ein Support-Team, besonders für ein mehrsprachiges. Bei Business sind 12.375 enthaltene Minuten für 990 $ dieselben 0,08 $ wie bei Grok, mit Builder, Telefonie und Analysen obendrauf. Lassen Sie es sein, wenn Sie HIPAA ohne Enterprise-Vertrag brauchen.
8. Vapi
Am besten für: Entwickler, die eine verwaltete Plattform wollen, aber trotzdem jedes Modell selbst wählen und Anbieter zum Selbstkostenpreis bezahlen möchten.
Vapi sitzt zwischen LiveKit und ElevenLabs. Es betreibt die Infrastruktur (Hosting und Telefonie, Monitoring sowie Tests mit Simulation), und Sie wählen Transcriber, LLM und Stimme aus dem Katalog, abgerechnet "with no markup". Auf der Startseite wird zitiert, dass Rings Support-Team in zwei Wochen von null in die Produktion kam. Ein Reddit-Entwickler, der Produktivsysteme darauf betreibt, hat der Vorstellung widersprochen, es sei nur etwas für Prototypen:
"Vapi is good at PoC stage and it is good at production usage, it is not a fair criticism at all - I have many production AI voice systems running on Vapi right now with no issues."
Was es besser macht als Grok:
- Jede Modellkombination, auch Speech-to-Speech-Modelle, wobei Anbieter zum Selbstkostenpreis durchgereicht werden.
- Vapi-Telefonie und -SIP sind kostenlos, und zusätzliche Parallelität kostet pauschal 10 $ pro Leitung und Monat.
- Simulierte Testanrufe, bevor echte Kunden den Agenten hören.
Wo es schwächelt:
- Die Hosting-Gebühr von 0,05 $ kommt zu jedem Modell hinzu. Vapis eigene Schätzung für 1.000 Minuten liegt bei 82 $ bis 129 $, also 0,082 $ bis 0,129 $ pro Minute.
- HIPAA ist ein Zusatz für 2.000 $ im Monat.
- Uptime-SLAs beginnen beim Pro-Paket für 999 $ im Monat.
Preise:
| Paket | Monatlich | Parallele Anrufe | Besonderheiten |
|---|---|---|---|
| Kein Paket | $0, $5 Gratisguthaben | 4 | $0.05/min Hosting, 14 Tage Datenaufbewahrung |
| Core | $29 | 10 | Zero Data Retention, Support-SLA von 2 Werktagen |
| Pro | $999 Minimum (10 % der Hosting-Gebühr) | 30 | RBAC, Slack-Support, 99 % Uptime-SLA |
| Premier | Individuell | Erhöht | 99,9 % Uptime-SLA, dediziertes SIP |
Alles von der Preisseite von Vapi.
Mein Fazit: der richtige Mittelweg, wenn Sie Plattformfunktionen wollen, sich aber nicht an die Modelle eines Anbieters binden lassen möchten. Planen Sie die Hosting-Gebühr plus drei Anbieter ein, und die Summe landet meist bei oder über Groks 0,08 $.
9. Cartesia Line
Am besten für: Teams, die einen verwalteten Agenten mit Kontrolle auf Code-Ebene und den niedrigsten flachen Plattformpreis wollen.
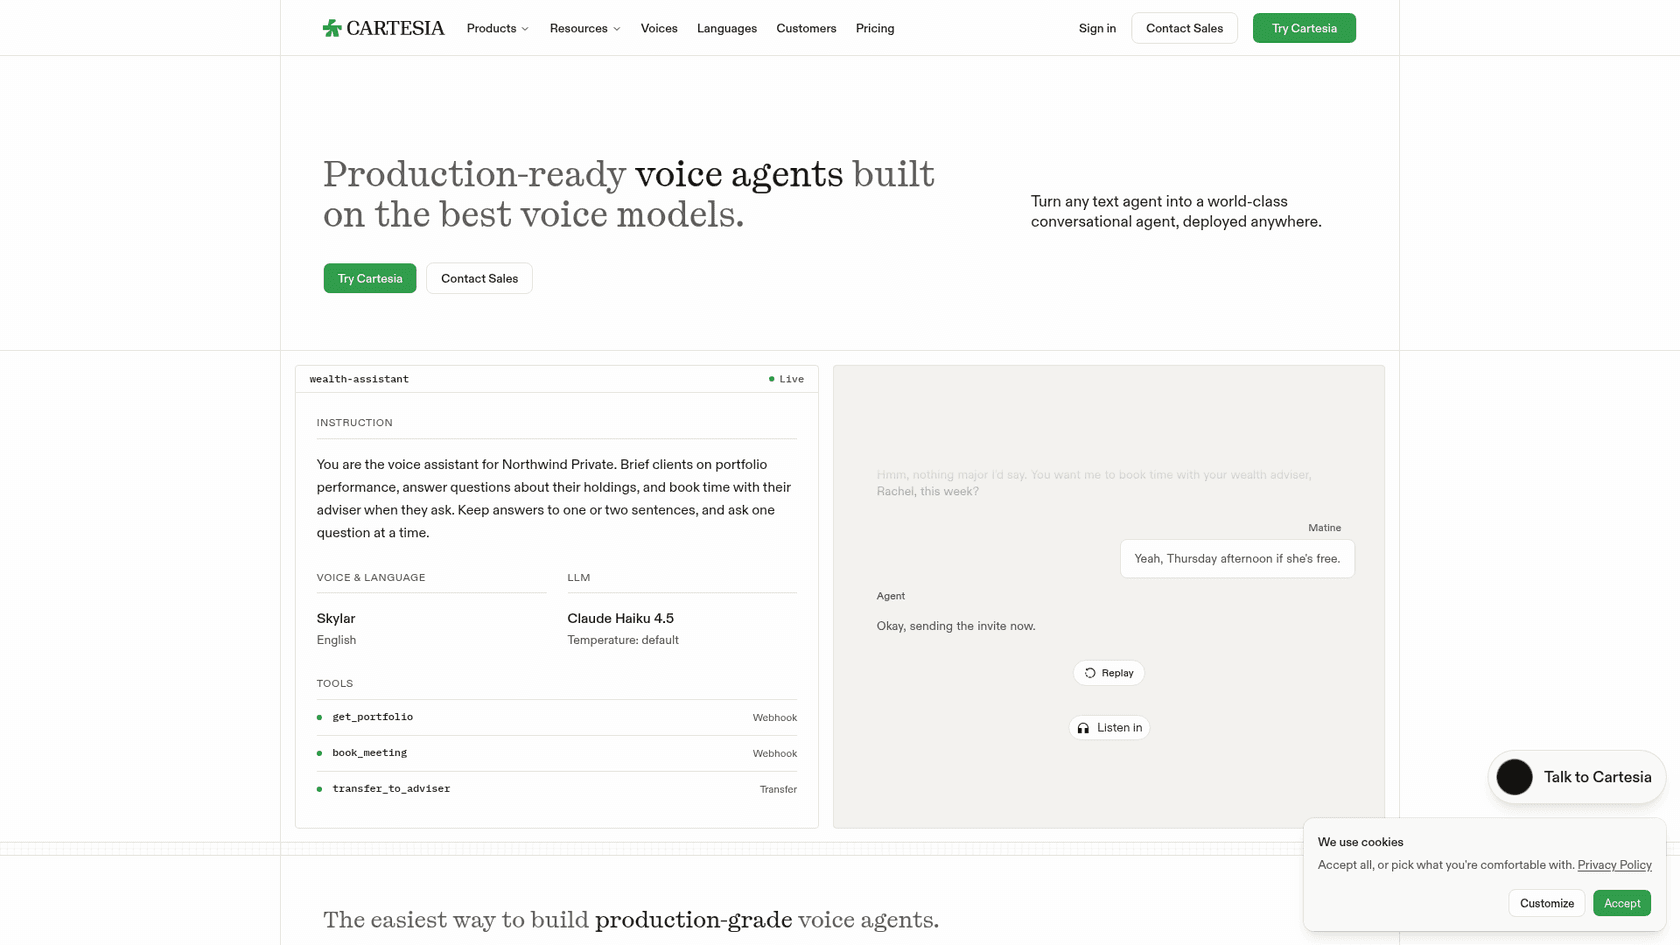
Line "brings voice to your text agents" mit Cartesias Ink-Speech-to-Text und den Sonic-Stimmen, die ich in meinem Test zu Cartesia Sonic 3 behandelt habe. Sie schreiben die Logik im Code mit dem SDK (beliebiges LLM, beliebige API) oder prototypen im No-Code-Builder und deployen dann in Cartesias verwaltete Laufzeit mit Anruf-Logs, Evaluierungen und versionierten Deployments, die Sie zurückrollen können. Es gibt eine CLI zum Deployen und Testen vom Terminal aus.
Was es besser macht als Grok:
- 0,06 $ pro Minute für den verwalteten Agenten, der niedrigste flache Plattformpreis in dieser Liste.
- LLM-Nutzung ist für in der UI gebaute Agenten befristet kostenlos.
- SOC 2 Type II, HIPAA und GDPR auf der Website aufgeführt.
- Tarifgebühren kommen als Agent-Guthaben zurück: Der Scale-Tarif für 299 $ enthält 299 $ für Agenten.
Wo es schwächelt:
- Die LLM-Aktion ist befristet, planen Sie Ihr Budget also so, als würden Sie für Tokens zahlen.
- Die Parallelität endet im Scale-Tarif bei 60 Anrufen, danach kommt Enterprise.
- Kein unabhängiger τ-Voice-Wert für den vollständigen Agenten.
Preise:
| Tarif | Monatlich | Enthaltenes Agent-Guthaben | Parallele Anrufe |
|---|---|---|---|
| Free | $0 | $1 (~17 Min.) | 8 |
| Pro | $5 | $5 | 12 |
| Startup | $49 | $49 | 20 |
| Scale | $299 | $299 | 60 |
| Enterprise | Individuell | Individuell | Individuell |
Anrufe kosten 0,06 $ pro Minute, plus 0,014 $ pro Minute für eine Cartesia-Telefonnummer, laut Preisseite von Cartesia. Wenn die Stimmqualität den Ausschlag gibt, geht mein Vergleich Cartesia vs. ElevenLabs tiefer.
Mein Fazit: eine starke Wahl für ein Entwicklerteam, das den verwalteten Ansatz von ElevenLabs mag, den Agenten aber in Code schreiben will. Behalten Sie die LLM-Zeile auf Ihrer Rechnung im Blick, sobald die Aktion endet.
So finden Sie in einer Woche den Gewinner
Benchmarks grenzen die Liste ein, dann entscheiden Ihre eigenen Anrufe. ChatGPTs Rat war, dieselben 20 bis 50 Testgespräche durch Ihre zwei oder drei Top-Kandidaten zu schicken, und ich stimme zu, mit einer Änderung: Nutzen Sie echte Anrufe, keine erfundenen.
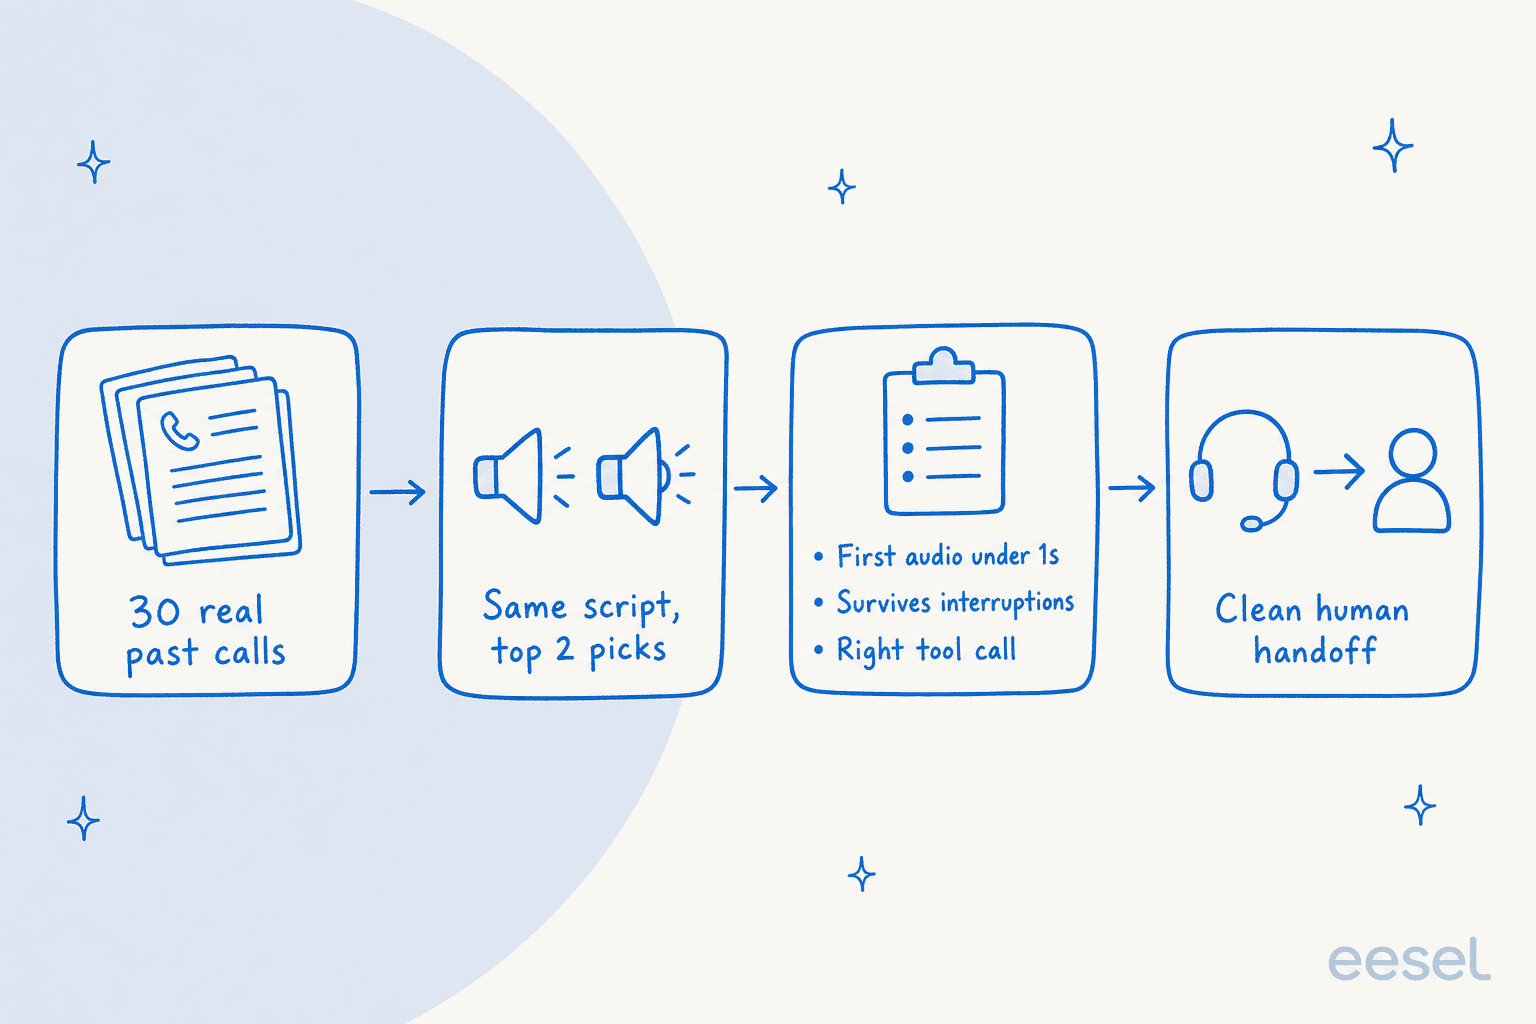
- Ziehen Sie 30 echte vergangene Anrufe. Transkripte aus Ihrer Telefonanlage, gewichtet zu den Anrufen, die Ihr Team am schwierigsten findet: Erstattungen, verärgerte Anrufer, Kontoänderungen.
- Lassen Sie dasselbe Skript durch Ihre Top 2 laufen. Grok Voice 3.0 sollte meistens eines davon sein, da es die Messlatte ist.
- Bewerten Sie drei Dinge. Zeit bis zum ersten Audio (hört der Anrufer in unter einer Sekunde eine Antwort?), Unterbrechungen (hört es auf und hört zu, wenn der Anrufer dazwischenredet?) und Tool-Aufrufe (hat es die richtige Funktion mit der richtigen Bestellnummer aufgerufen?).
- Prüfen Sie die Übergabe. Jeder Voice Agent scheitert bei manchen Anrufen. Entscheidend ist, ob er den Anrufer mit dem Kontext an einen Menschen weitergibt. Mein Beitrag zu Best Practices für die Übergabe behandelt, was dieser Kontext enthalten sollte.
Wenn Sie bereits Zendesk-Voice-KI-Agenten oder die Voice Agents von Freshcaller einsetzen, nehmen Sie auch die native Option Ihres Helpdesks in den Test auf. Manchmal gewinnt die langweilige Antwort.
Was keine dieser neun löst
Jedes Modell und jede Plattform oben ist in dem, was sie tut, eine Gesprächs-Engine. Der τ-Voice-Benchmark gibt jedem ein Richtliniendokument und eine Reihe von Tools, die für den Test geschrieben wurden. An Ihrer Telefonleitung weiß der Agent genau das, was Sie ihm anbinden, und nicht mehr.
Genau dort verbringen die meisten echten Voice-Support-Rollouts ihre Zeit: festzulegen, was der Agent sagen darf, die Antworten aktuell zu halten und ihn mit den Bestell- und Kontodaten zu verbinden. In unseren Verkaufsgesprächen ist der beständigste Wunsch über alle Käufer hinweg derselbe: die KI auf den bisherigen Tickets des Teams zu trainieren. Eine Direct-to-Consumer-Supplement-Marke aus diesen Gesprächen schickt etwa 7.000 Tickets im Monat durch Gorgias und Shopify, mit einem separaten Telefonsystem daneben. Ihr Telefon-Agent und ihre Ticket-Warteschlange brauchen dieselben Antworten.
Die Teams, die das richtig machen, behandeln den Telefon-Agenten wie einen Wissensdatenbank-Chatbot mit Stimme: eine gepflegte Quelle für Antworten, aus der jeder Kanal liest. Wenn Sie noch entscheiden, ob KI Support-Anrufe beantworten kann oder ob Sie den Telefon-Support überhaupt automatisieren wollen, beginnen Sie mit den Textkanälen. Sie sind pro Interaktion günstiger, leichter zu messen und bauen das Wissen auf, das der Voice Agent später braucht.
Mein Leitfaden zur Automatisierung des Kundensupports zeigt die Reihenfolge, in der ich vorgehen würde.
Kombinieren Sie jede davon mit eesel
Die Voice-API ist die Infrastruktur, und eesel ist der Mitarbeiter. eesels KI-Helpdesk-Teammitglied schließt sich Ihrem Zendesk, Freshdesk oder Gorgias an, lernt aus Ihren bisherigen Tickets und Ihrem Help Center und arbeitet die E-Mail- und Chat-Warteschlange ab, die hinter jeder Telefonleitung sitzt. Bevor es live geht, können Sie es gegen Ihre eigenen bisherigen Tickets laufen lassen und seine Antworten mit dem vergleichen, was Ihr Team tatsächlich gesendet hat.

Für Entwickler ist der Anschlusspunkt MCP. Jeder eesel-Workspace ist ein MCP-Server: npx @eesel/cli mcp token aus der eesel-CLI gibt die URL und ein 30-Tage-Token aus, sodass ein Voice Agent auf Grok, GPT-Live oder LiveKit dieselben Antworten abrufen kann wie Ihr Ticket-Agent. Mit derselben CLI können Sie den Agenten vom Terminal aus skripten oder an einen Coding-Agenten wie Claude Code übergeben. Ich habe diese Kombination noch nicht an einer Live-Telefonleitung getestet, betrachten Sie sie also als vielversprechenden Aufbau und achten Sie auf die Latenz eines Tool-Aufrufs mitten im Satz.
Die Preise sind ein fester monatlicher Credit-Tarif: 299 $ im Monat für 500 Credits, wobei ein Ticket oder Chat einen Credit kostet, mit 100 kostenlosen Credits und ohne Karte zum Start. Probieren Sie eesel an einem Ausschnitt Ihrer Warteschlange aus, bevor Sie sich für eine Stimme entscheiden, damit die Gewinnerin etwas Sinnvolles zu sagen hat.