Die 8 besten Alternativen zu MAI-Transcribe-2 im Jahr 2026

Kira

Katelin Teen
Zuletzt bearbeitet September 8, 2026
MAI-Transcribe-2 ist das neue Speech-to-Text-Modell von Microsoft AI, und es ist hervorragend: eine durchschnittliche Wortfehlerrate von 5,2 % über 60 Sprachen und ein Einführungspreis von 0,10 $ pro Stunde. Wenn es zu Ihrem Stack passt, gehört es zu den stärksten verfügbaren Optionen. Aber der Preis ist ein Einführungsangebot, es ist eine reine Batch-Vorschau ohne SLA, und es lebt innerhalb von Azure, sodass viele Teams lieber etwas anderes wählen werden.
Hier sind die acht besten Alternativen und jeweils der Ein-Satz-Grund, zu ihnen zu greifen:
- Google Gemini 3.5 Transcribe - die ähnlichste Genauigkeit und die naheliegende Wahl, wenn Sie ohnehin bei Google sind.
- ElevenLabs Scribe v2 - am besten für Medien- und Synchronisationsarbeit, mit Sprechererkennung für 32 Sprecher und Tagging von Audioereignissen.
- Deepgram - die Wahl für Echtzeit-Sprachagenten und Telefon-Streaming.
- AssemblyAI - Transkription plus eine integrierte Ebene für Zusammenfassungen, Stimmungsanalyse und Schwärzung.
- OpenAI GPT-Transcribe - am einfachsten an eine bestehende OpenAI-Pipeline anzuschließen.
- Speechmatics - die größte Sprachabdeckung und echtes On-Premises-Deployment.
- Amazon Transcribe - die Standardwahl, wenn Ihre Daten bereits in AWS liegen.
- OpenAI Whisper - das kostenlose Open-Source-Modell zum Selbsthosten.
Eines vorab, weil ich bei eesel KI-Agenten baue und das meinen Blick auf die ganze Kategorie prägt: Ein genaues Transkript ist nicht das, was irgendjemand eigentlich wollte. Es ist das Rohmaterial. Welches Modell Sie auch wählen, jemand muss den Text weiterhin lesen, die Antwort finden und das Ticket lösen, und das ist eine andere Aufgabe als Transkription.
Warum überhaupt über MAI-Transcribe-2 hinausschauen
Zunächst fair gegenüber dem Platzhirsch, denn er hat es verdient. MAI-Transcribe-2 steht an der Spitze von Microsofts FLEURS-Genauigkeitsvergleich, transkribiert eine Stunde Audio in etwa zehn Sekunden und unterbietet mit 0,10 $ pro Stunde alle anderen. Als ich die ersten Entwicklerstimmen las, waren die Reaktionen von der Art, die man nicht vortäuschen kann. Ein Indie-Entwickler ließ einen schwierigen Praxis-Clip durchlaufen:
"Ich habe eine Predigt auf Slowakisch mit viel Hall durchlaufen lassen... Das Ergebnis war deutlich besser als bei ElevenLabs, bei 45 % des Preises."
Verrauschtes, hallendes, nicht-englisches Audio bringt schwächere Modelle genau zum Scheitern, das ist also ein echtes Signal. Warum also überhaupt woanders schauen? Aus drei konkreten Gründen, von denen keiner eine Kritik am Modell selbst ist.
Erstens ist der Preis ein bewegliches Ziel. Die 0,10 $ sind ein Einführungsangebot, das "bis Ende des Jahres" läuft, und Microsoft hat nicht gesagt, was danach passiert. Zum Vergleich: Das ältere MAI-Transcribe-1.5 kostet weiterhin 0,36 $ pro Stunde, ein regulärer v2-Preis in diesem Bereich würde also niemanden überraschen. Ein Hacker-News-Kommentator stellte genau die Frage, die Microsoft offenließ:
"Lässt sich das für Streaming nutzen oder nur im Batch? Nennen sie den Preis nach dem Ende des Einführungsrabatts (bis Jahresende)?"

Zweitens ist es eine öffentliche Vorschau ohne SLA, die Microsoft als nicht für den Produktivbetrieb gedacht kennzeichnet, und die Haupt-API arbeitet nur im Batch mit einer Dateigrößengrenze von 300 MB. Live-Audio erfordert ein separates Voice-Live-Setup. Drittens ist es ein Azure-Modell, Sie erreichen es also über Azure Speech, einen Entwickler-Playground oder Router von Drittanbietern, nicht über eine eigenständige App. Wer woanders baut, zahlt für diese Ökosystem-Schwerkraft einen echten Preis.
Nichts davon macht MAI-Transcribe-2 zu einer schlechten Wahl. Es heißt nur, dass "heute am günstigsten und genauesten" nicht dasselbe ist wie "die richtige Lösung für Ihr Projekt", und in dieser Lücke leben diese Alternativen.
Wie ich sie verglichen habe
Ich habe viel Zeit in diesen APIs verbracht und Dokumentation, Preisseiten und Parameterlisten gelesen. Deshalb habe ich die Dimensionen gewählt, die Ihre Architektur tatsächlich verändern, nicht die Marketing-Stichpunkte. Fünf Dinge zählen:
- Genauigkeit, gemessen als Wortfehlerrate (WER, der Prozentsatz der Wörter, die das Modell falsch erkennt). Niedriger ist besser.
- Preis pro Stunde Audio, normalisiert, damit Sie Gleiches mit Gleichem vergleichen können.
- Batch vs. Echtzeit, denn ein reines Batch-Modell kann keinen Live-Telefonagenten antreiben, egal wie genau es ist.
- Sprechererkennung und Zeitstempel, also die Sprecherlabels und das wortgenaue Timing, die aus einer Textwand etwas Brauchbares machen.
- Deployment, also ob Sie es auf eigener Hardware betreiben können oder Audio an die Cloud des Anbieters senden müssen.
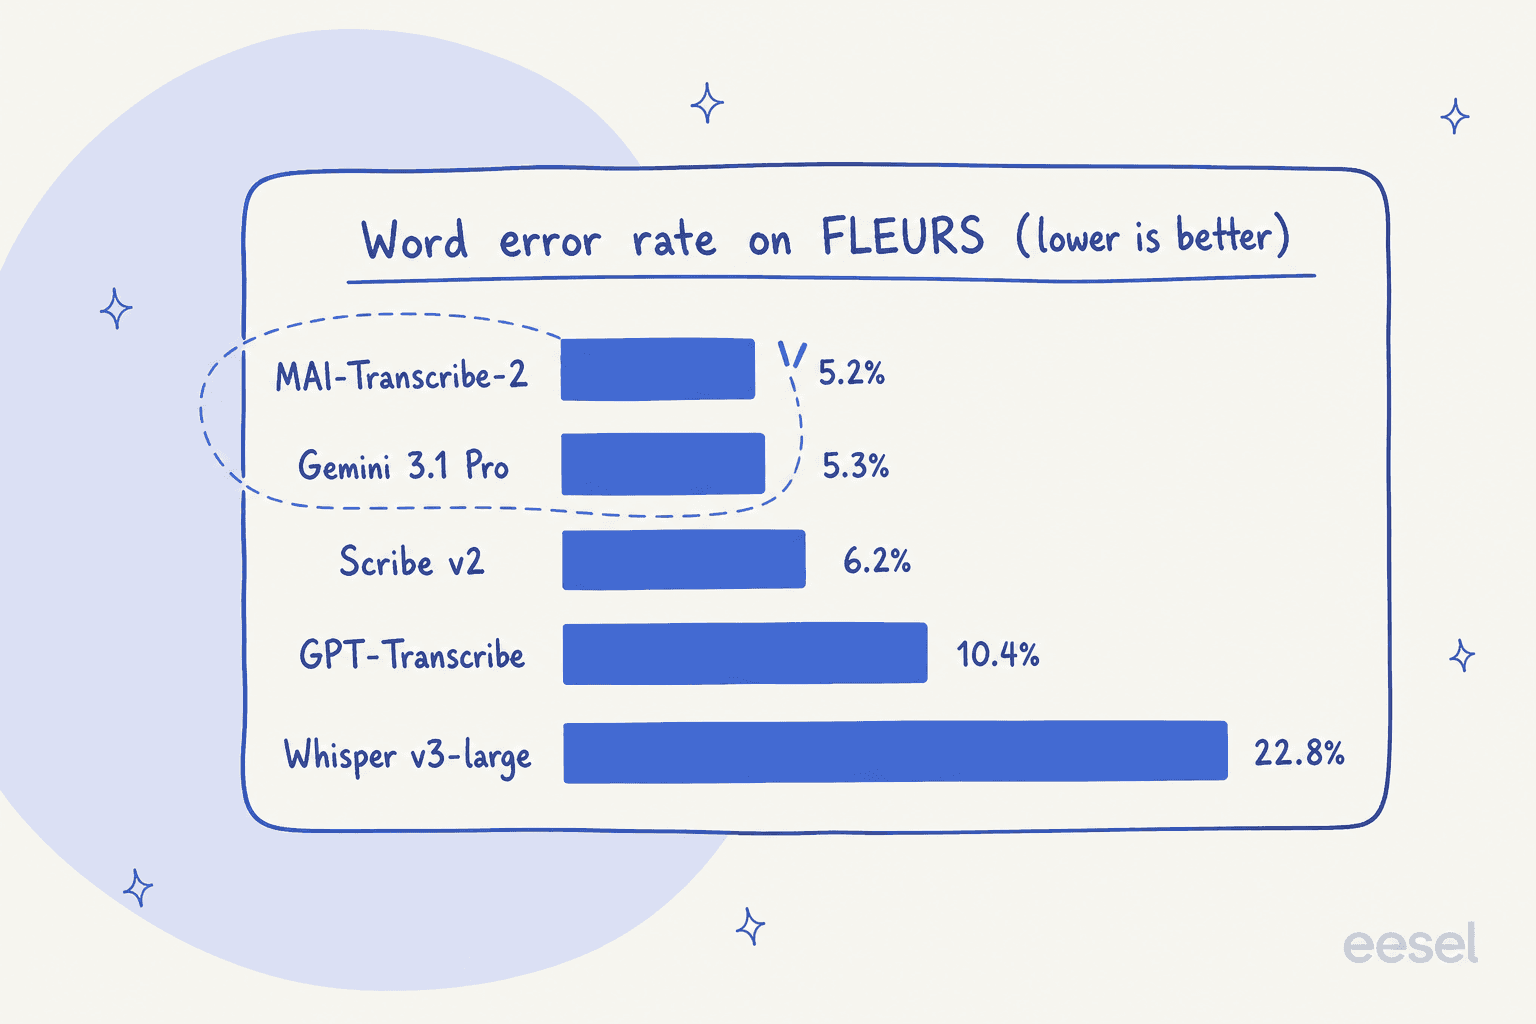
Bei der reinen Genauigkeit sieht das Feld im Microsoft-eigenen FLEURS-Vergleich so aus. Eine Erkenntnis aus dieser Grafik sollten Sie verinnerlichen: Die Spitze ist ein Beinahe-Gleichstand, und der eigentliche Abstand liegt zwischen den Spitzenreitern und dem älteren offenen Whisper.
Die besten Alternativen zu MAI-Transcribe-2 im Überblick
Vor den Detailanalysen hier das gesamte Feld in einer Tabelle. Die Preise gelten pro Stunde Audio für Standard-Batch-Transkription, umgerechnet aus dem veröffentlichten Minuten- oder Token-Preis des jeweiligen Anbieters.
| Modell | Am besten für | Batch-Preis/Std. | Echtzeit-Streaming | Sprachen | Sprechererkennung | Selbst hosten | Gratisstufe |
|---|---|---|---|---|---|---|---|
| MAI-Transcribe-2 | Günstigster mehrsprachiger Batch | 0,10 $ (Aktion) | Nur über Voice Live | 60+ | Ja | Nein | Nein |
| Gemini 3.5 Transcribe | Ähnlichste Genauigkeit | ~0,30 $ | Ja (Live-Modell) | 85+ | Bis zu 8 | Nein | Ja |
| ElevenLabs Scribe v2 | Medien und Synchronisation | 0,22 $ | Ja (Realtime) | 90+ | Bis zu 32 | Nein | 10.000 Credits/Monat |
| Deepgram | Echtzeit-Sprachagenten | 0,26 $ | Ja (Stärke) | 40+ | Ja | Ja (Enterprise) | 200 $ Guthaben |
| AssemblyAI | Audio Intelligence | 0,21 $ | Ja | 99+ | Ja | Nein | 185 Std. |
| OpenAI GPT-Transcribe | OpenAI-native Pipelines | 0,27 $ | Streaming-Ausgabe | 99+ | Separates Modell | Nein | Nein |
| Speechmatics | Sprachbreite, On-Prem | 0,24 $ | Ja (<1 s) | 55+ | Ja | Ja (Enterprise) | 100 $ Guthaben |
| Amazon Transcribe | Teams, die schon auf AWS sind | 0,36 $ | Ja | 100+ | Ja | Nein | 60 Min./Monat (12 Monate) |
| Whisper (Open Source) | Null API-Kosten | 0 $ (selbst gehostet) | Nein (Batch) | 99+ | Als Zusatz | Ja | Kostenlos |
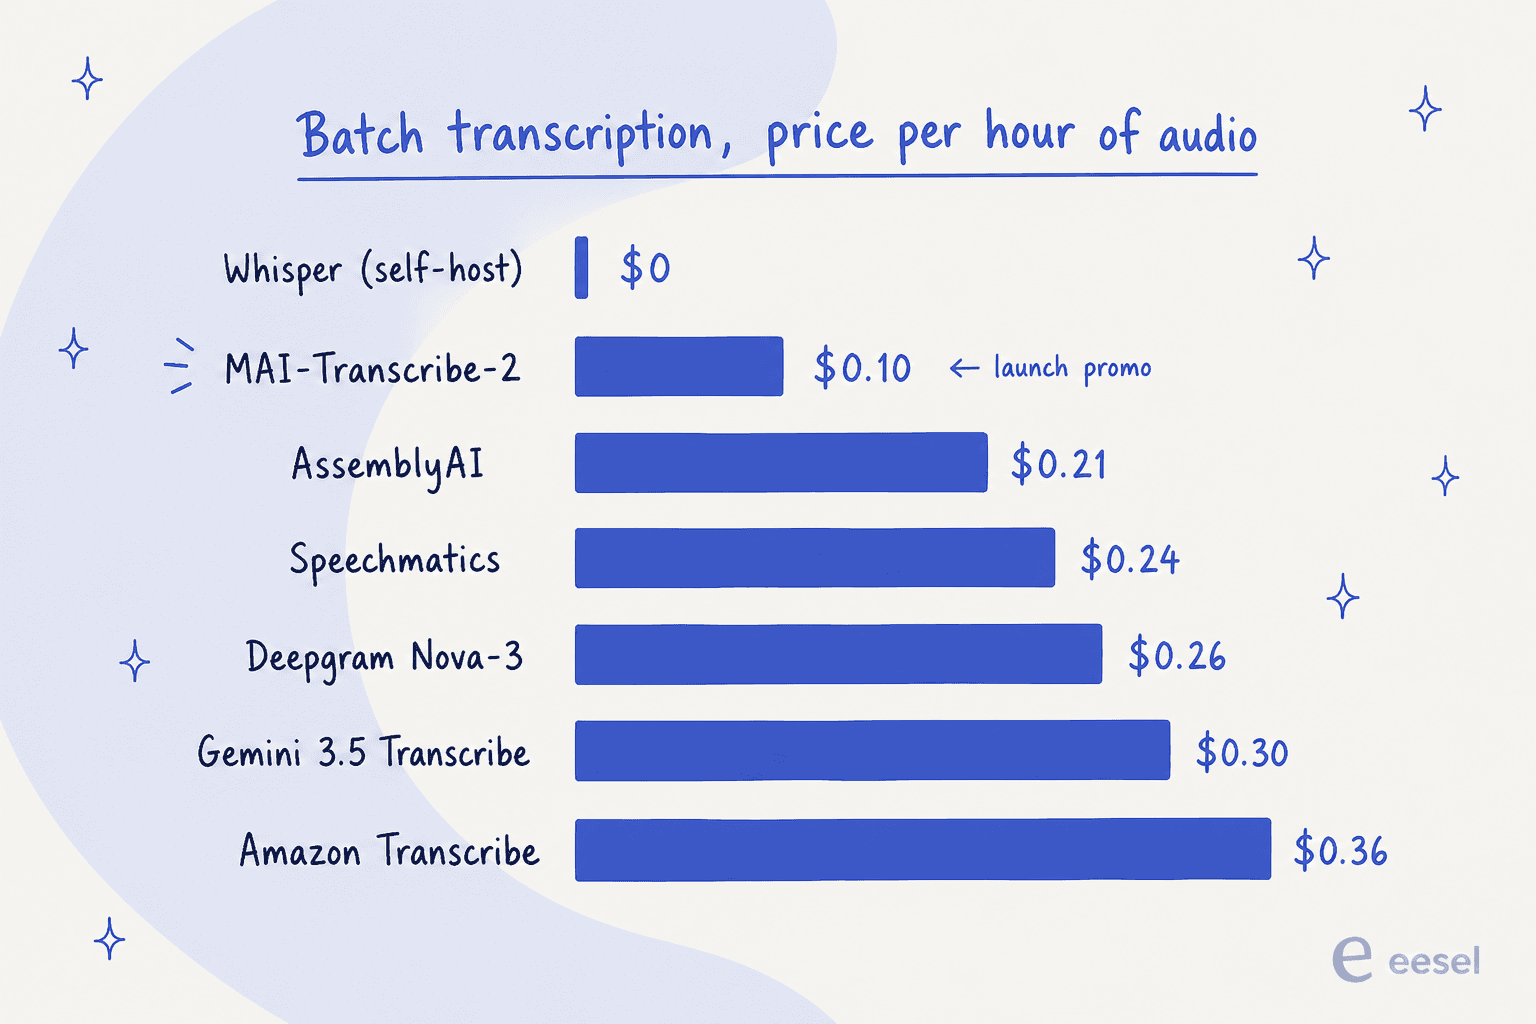
Die Preise für kostenpflichtigen Batch liegen viel enger beieinander, als die meisten erwarten. Sobald das Einführungsangebot von MAI-Transcribe-2 ausläuft, liegt das gesamte Feld nur wenige Cent auseinander.
1. Google Gemini 3.5 Transcribe
Am besten für: Teams, die die Genauigkeit möchten, die MAI-Transcribe-2 am nächsten kommt, und bereits auf Google aufbauen.
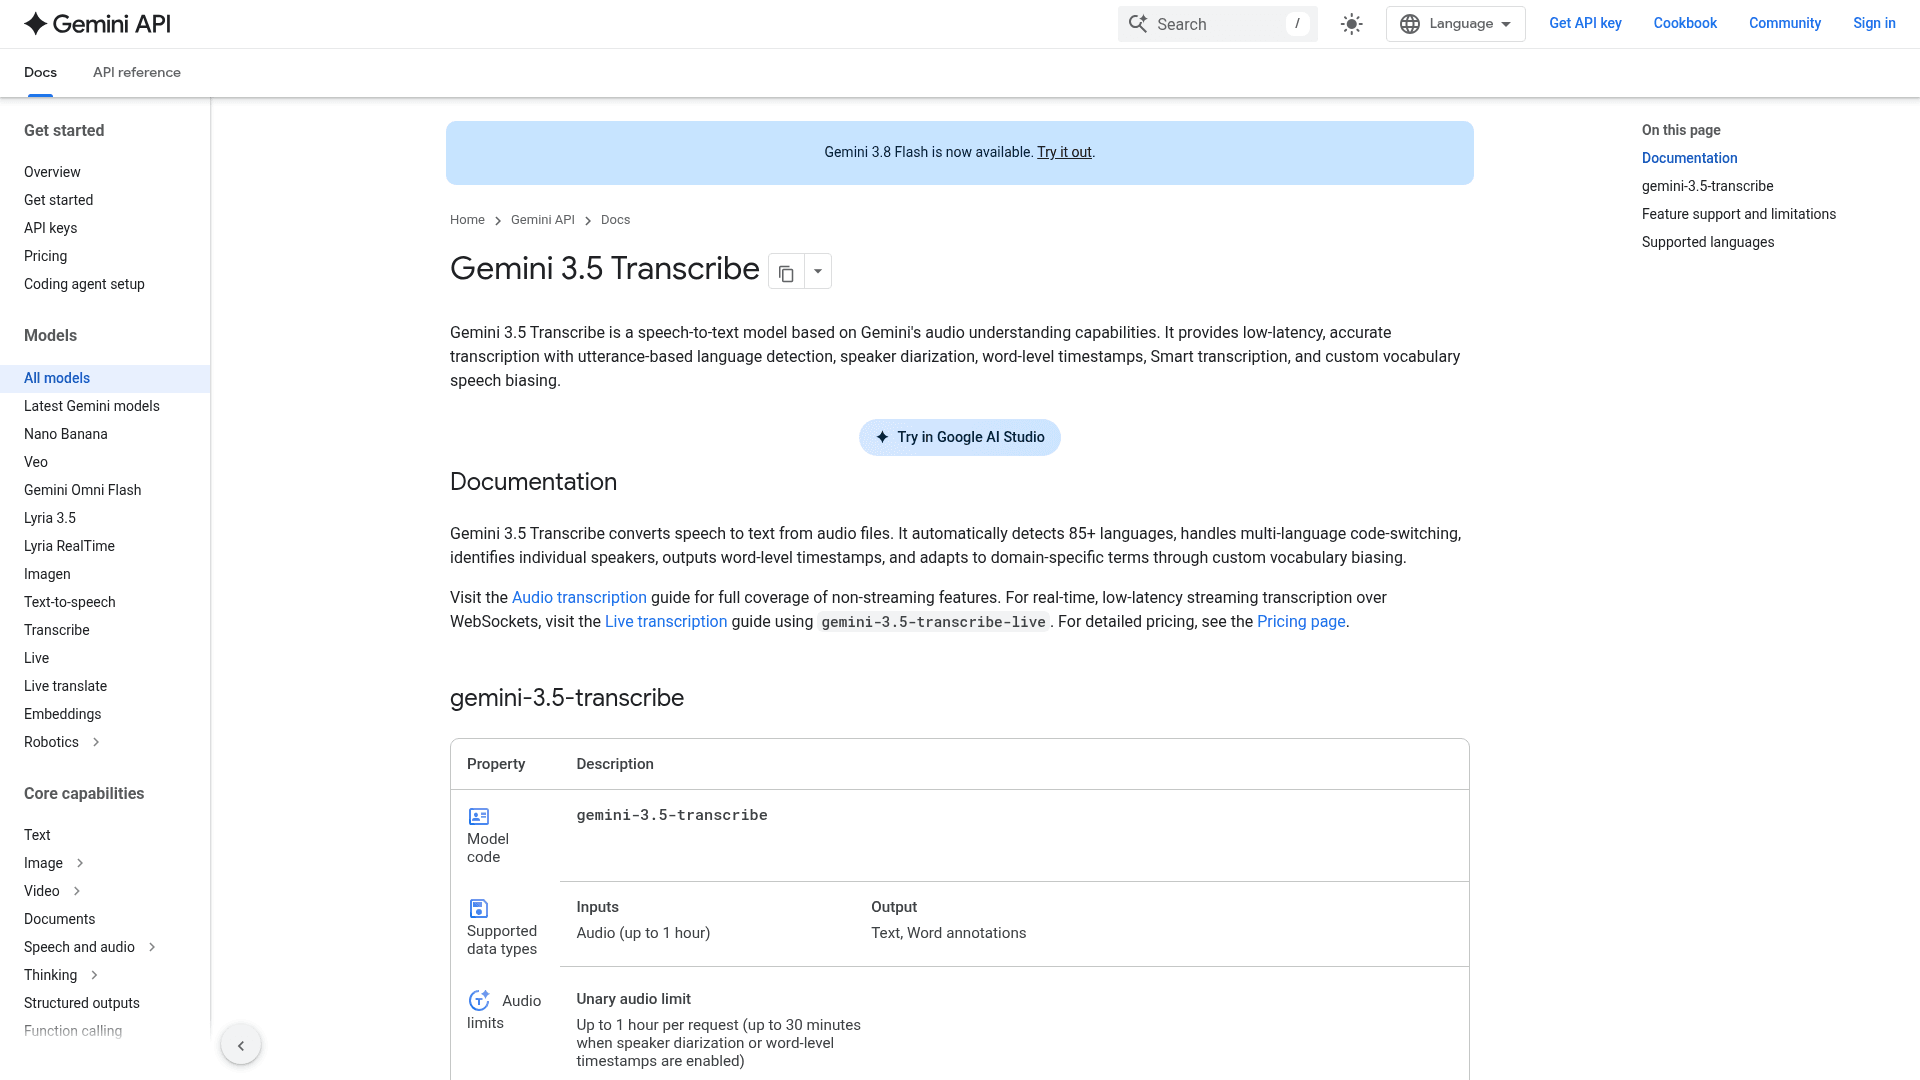
Google ist die Alternative, die MAI-Transcribe-2 Kopf an Kopf Paroli bietet. In Microsofts eigener FLEURS-Tabelle erreicht Gemini 3.1 Pro 5,3 %, ein Zehntel Punkt dahinter, und Google liefert zusätzlich ein dediziertes Speech-to-Text-Modell, gemini-3.5-transcribe, sowie eine Streaming-Variante namens gemini-3.5-transcribe-live. Diese Trennung ist wichtig: Das Dateimodell verarbeitet Audio bis zu einer Stunde pro Anfrage (30 Minuten, wenn Sie Sprechererkennung oder wortgenaue Zeitstempel aktivieren), während das Live-Modell Streaming mit niedriger Latenz über WebSockets bietet.
Sie bekommen einen vollständigen Funktionsumfang: mehr als 85 Sprachen mit Code-Switching mitten im Satz, Sprechererkennung für bis zu acht Sprecher, wortgenaue Zeitstempel und Vokabular-Biasing mit bis zu 1.000 Begriffen. Es wirkt eher wie ein vollständiger Audio-Verständnis-Stack als wie ein bloßer Transkriptionsendpunkt.
Beim Preis ist das dedizierte Modell tokenbasiert: Audioeingabe kostet 2,00 $ pro Million Tokens und Textausgabe 12,00 $ pro Million, was einem gemischten Satz von etwa 0,005 $ pro Minute oder rund 0,30 $ pro Stunde entspricht. Es gibt eine Gratisstufe zum Testen, ein netter Einstieg.
Unser Fazit: Wenn Genauigkeit Ihr einziges Entscheidungskriterium ist und Sie nicht an Azure gebunden sind, ist das die Wahl. Es ist das einzige Modell, das im Benchmark mit MAI-Transcribe-2 mithält, und eine erstanbieterseitige Streaming-Variante schließt die eine große Lücke, die MAI offenlässt. Der Haken: Google hat keine eigene WER-Schlagzeile veröffentlicht, Sie vertrauen für die exakten Zahlen also Microsofts Vergleich.
2. ElevenLabs Scribe v2
Am besten für: Medien-, Podcast- und Synchronisationsteams, die detaillierte Sprecherlabels und Tagging von Audioereignissen brauchen.
ElevenLabs hat sich mit Sprachgenerierung einen Namen gemacht, und Scribe ist die Speech-to-Text-Seite. Das aktuelle Flaggschiff ist scribe_v2, mit einer Variante scribe_v2_realtime, die rund 150 ms Latenz erreicht. Im FLEURS-Vergleich von Microsoft landet es bei 6,2 %, einen Schritt hinter den Spitzenreitern, aber in starker Gesellschaft, und ElevenLabs selbst gibt über 98 % Transkriptionsgenauigkeit an, mit WER-Aufschlüsselungen pro Sprache.
Scribe punktet mit der Detailtiefe der Ausgabe. Es deckt mehr als 90 Sprachen ab, erkennt bis zu 32 Sprecher (der höchste Wert hier), taggt dynamische Audioereignisse wie Lachen und Musik und erkennt 65 Entitätstypen. Für alle, die Untertitel schneiden oder Aufnahmen mit mehreren Sprechern transkribieren, ist genau dieses Detail der Kern der Sache.
Die Abrechnung erfolgt pro Stunde: Scribe v2 kostet 0,22 $ pro Stunde im Batch und 0,39 $ in Echtzeit, plus Add-ons wie Entitätserkennung (+0,070 $/Std.) und Keyterm-Prompting (+0,050 $/Std.). Die Gratisstufe bietet 10.000 Credits pro Monat, allerdings ohne kommerzielle Lizenz. Ein Entwickler fasste den praktischen Reiz auf Hacker News so zusammen:
"ElevenLabs' Scribe-Modell ist ebenfalls besonders genau, und ich nutze es für hochwertige Transkriptionen oder lade Dateien manuell in ihre API hoch, um Sprechererkennung und Zeitstempel zu bekommen."
Unser Fazit: Scribe v2 ist das Modell, das es für Medienarbeit zu schlagen gilt, wo sich Sprechererkennung für 32 Sprecher und Audio-Tagging bezahlt machen. Bei der reinen WER liegt es leicht zurück und ist teurer als die günstigsten Optionen, aber für Content-Teams ist die Ausgabequalität das wert. Für schlichte Transkription von Support-Anrufen erledigen günstigere Modelle dieselbe Kernaufgabe.
3. Deepgram
Am besten für: Echtzeit-Sprachagenten, Telefonsysteme und jedes Produkt mit Live-Audio-Streaming.
Deepgram ist der Favorit der Entwickler für Echtzeit-Transkription und die klarste Antwort auf das eine, was MAI-Transcribe-2 von Haus aus nicht gut kann: Live-Streaming. Es taucht aus gutem Grund in den meisten Übersichten zu KI-Sprachunternehmen auf. Das Flaggschiffmodell Nova-3 beherrscht Batch und Streaming, und ein neueres Modell namens Flux ist speziell für Sprachagenten gebaut, mit integrierter Erkennung von Sprecherwechseln. Wer Sprache in einen Telefonbaum oder einen Live-Agenten einbindet, fängt hier an.
Die Preise sind aggressiv und ungewöhnlich transparent. Nova-3 kostet 0,0043 $ pro Minute für aufgezeichnetes Audio (etwa 0,26 $ pro Stunde) und 0,0048 $ pro Minute für Streaming, sekundengenau und ohne Aufrundung abgerechnet. Zum Testen gibt es 200 $ Gratisguthaben, rund 750 Stunden. Es deckt mehr als 40 Sprachen ab, bietet Sprechererkennung und Wort-Zeitstempel und unterstützt Keyterm-Prompting für Ihr Fachvokabular.
Erwähnenswert ist außerdem das Deployment. Deepgram bietet selbst gehostete Container im Enterprise-Tarif, mit SOC 2, HIPAA, DSGVO und EU-Datenresidenz, sodass regulierte Teams Audio auf eigener Infrastruktur halten können. Das ist ein echter Unterschied zu den reinen Cloud-APIs hier.
Unser Fazit: Für alles in Echtzeit ist Deepgram meine Standardempfehlung gegenüber MAI-Transcribe-2. Weniger Sprachen als Gemini oder Whisper, aber Streaming-Latenz, sekundengenaue Abrechnung und die Selbsthosting-Option machen es zur praktischen Wahl für Live-Sprachprodukte. Besteht Ihr Audio nur aus aufgezeichneten Dateien, haben die Genauigkeits-Spitzenreiter womöglich die Nase vorn.
4. AssemblyAI
Am besten für: Teams, die Transkription plus Zusammenfassungen, Stimmungsanalyse und Schwärzung in einem API-Aufruf wollen.
AssemblyAIs Argument lautet, dass Transkription nur der erste Schritt ist. Das Flaggschiffmodell Universal-3.5 Pro übernimmt das Speech-to-Text, und darüber liegt eine ganze Audio-Intelligence-Ebene: Zusammenfassung, Stimmungsanalyse, Themenerkennung, Entitätserkennung, PII-Schwärzung und ein LLM Gateway, um Sprachmodell-Prompts über das Audio laufen zu lassen. Wer sonst drei Dienste zusammenstückeln würde, bekommt das bei AssemblyAI aus einer Hand.
Die Preise gelten pro Stunde und gehören zu den niedrigsten hier. Universal-3.5 Pro kostet 0,21 $ pro Stunde asynchron und 0,45 $ in Echtzeit, während das ältere Universal-2 auf 0,15 $ pro Stunde sinkt. Die Intelligence-Funktionen werden zusätzlich separat pro Stunde berechnet, Sie zahlen also nur für das, was Sie einschalten. Die Gratisstufe ist großzügig: 185 Stunden aufgezeichnetes und 333 Stunden gestreamtes Audio, ohne Karte.
Ein ehrlicher Hinweis: AssemblyAI wirbt mit "branchenführender Genauigkeit bei realem Audio", nennt aber auf den Hauptseiten keine einzige FLEURS-Zahl und taucht deshalb nicht in Microsofts Vergleich auf. Sie wählen es wegen der Intelligence-Ebene und des Preises, nicht wegen einer überprüfbaren WER-Schlagzeile.
Unser Fazit: Wenn Ihr Produkt die Analyse braucht und nicht nur das Transkript, etwa Anrufzusammenfassungen oder Stimmungsbewertung, erspart Ihnen AssemblyAI einen zweiten Anbieter. Für reine Transkription ist es konkurrenzfähig, aber nicht eindeutig besser als die Genauigkeits-Spitzenreiter. Die riesige Gratisstufe macht das Ausprobieren leicht.
5. OpenAI GPT-Transcribe
Am besten für: Teams, die bereits eine OpenAI-Pipeline betreiben und Transkription im selben SDK wollen.
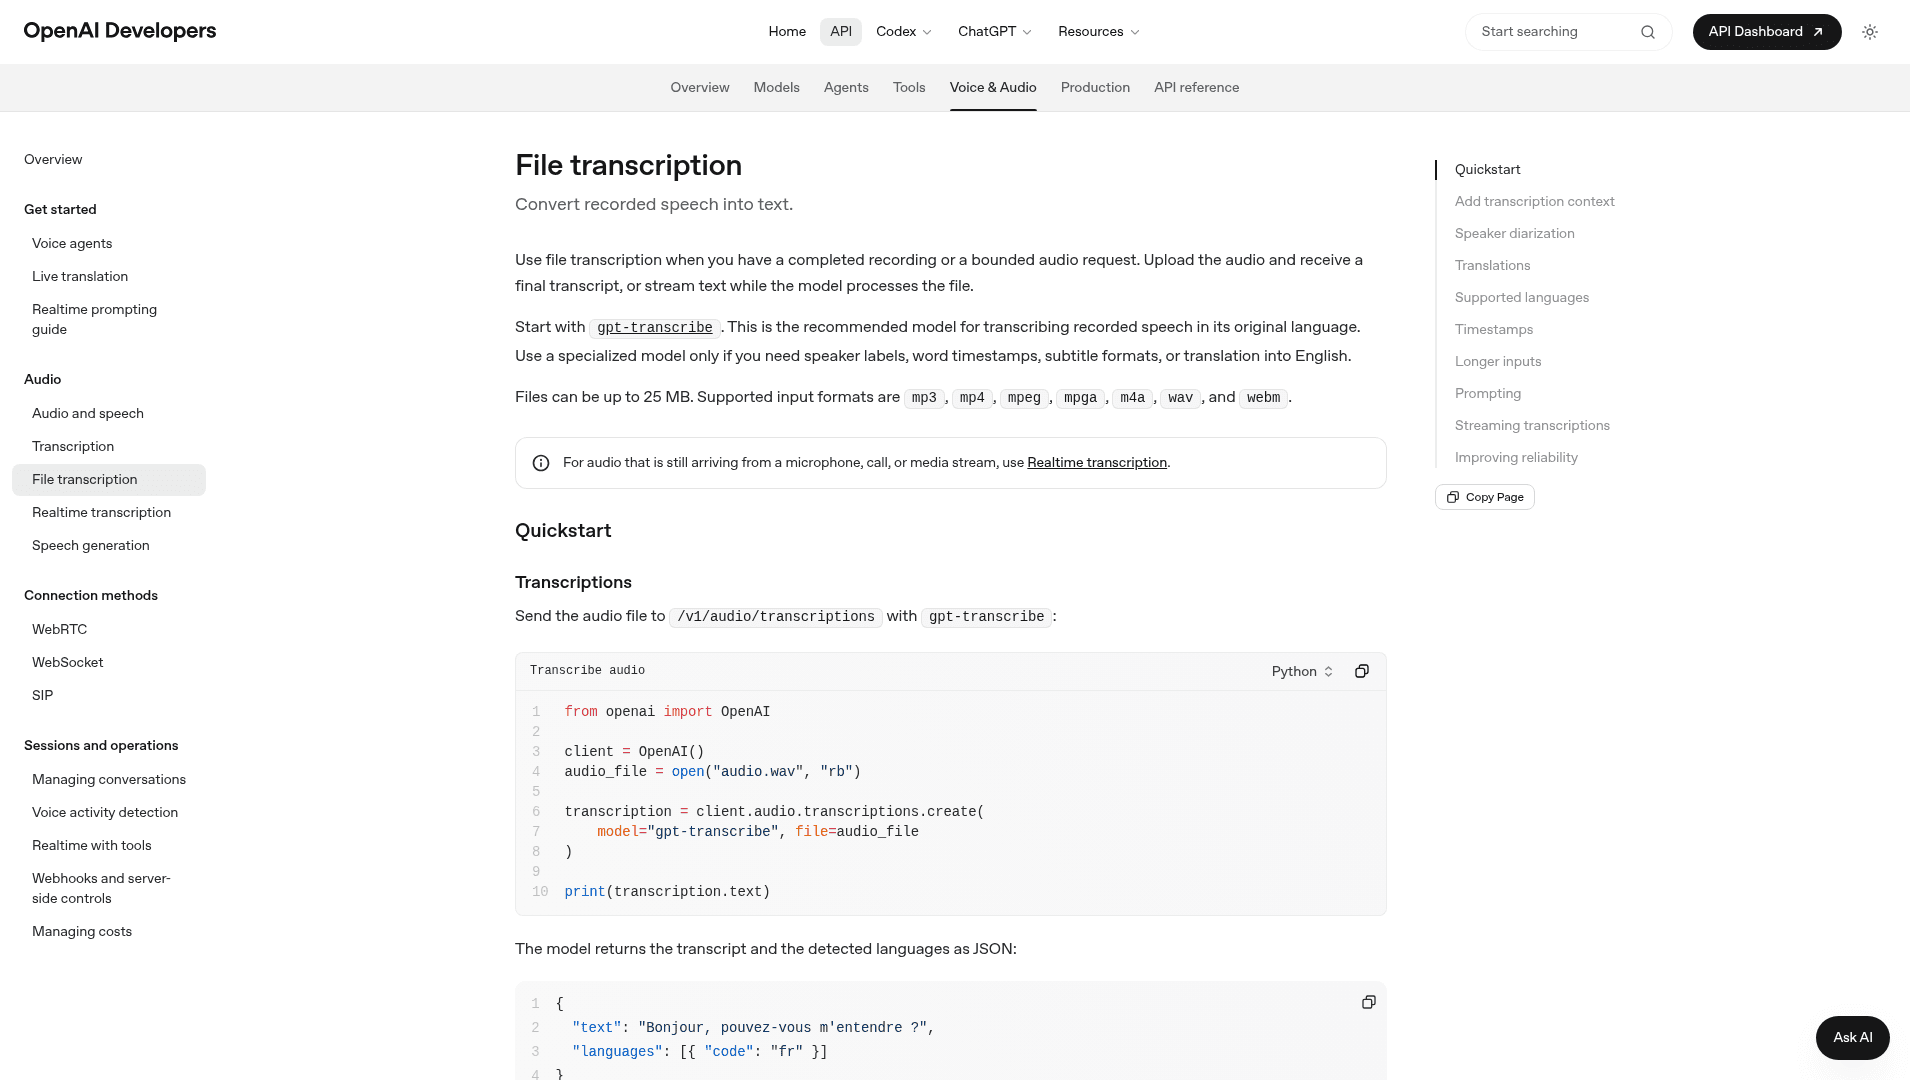
OpenAI hat sein Transkriptionsangebot still aufgefrischt. gpt-transcribe ist jetzt der empfohlene Standard, während gpt-4o-transcribe, gpt-4o-mini-transcribe und das ältere whisper-1 weiter verfügbar sind. In Microsofts FLEURS-Tabelle landet GPT-Transcribe bei 10,4 %, deutlich hinter den Spitzenreitern, doch die Praxiserfahrungen fallen wärmer aus, als diese Zahl vermuten lässt:
"Utter nutzt standardmäßig GPT-4o Transcribe für die Cloud-Transkription, und meiner Erfahrung nach ist es das Beste seiner Klasse. Der Abstand ist bei Namen, Nischenbegriffen und technischem Vokabular am deutlichsten."
Abgerechnet wird pro Audiominute: gpt-transcribe kostet 0,0045 $ pro Minute (etwa 0,27 $ pro Stunde), gpt-4o-transcribe 0,006 $ und gpt-4o-mini-transcribe günstige 0,003 $. Dateien sind auf 25 MB begrenzt, und rund 99 Sprachen werden mit automatischer Erkennung unterstützt.
Ein Stolperstein, den Sie einplanen sollten: Die einfachen Modelle liefern keine Sprecherlabels. Die Sprechererkennung steckt in einem separaten Modell, gpt-4o-transcribe-diarize, und wortgenaue Zeitstempel gibt es nur über das ältere whisper-1. Die saubere Geschichte von der "einen API" hat also je nach benötigten Metadaten ein paar Sternchen.
Unser Fazit: Der Grund für GPT-Transcribe ist die Integration, nicht die Genauigkeit. Wenn Sie ohnehin OpenAI aufrufen, ist das Hinzufügen von Transkription eine Ein-Zeilen-Änderung, und die praktische Qualität bei Namen und Fachbegriffen ist beliebt. Steht Genauigkeit über viele Sprachen im Vordergrund, sagt der Benchmark: erst Gemini oder MAI ansehen.
6. Speechmatics
Am besten für: die größte Sprach- und Akzentabdeckung und Teams, die On-Prem-Deployment brauchen.
Speechmatics ist der Enterprise-Spezialist, aufgebaut um akzentunabhängige Genauigkeit und eine "Global-first"-Sprachphilosophie. Es deckt mehr als 55 Transkriptionssprachen und Dialekte sowie 69 Übersetzungspaare ab, und sein mehrsprachiges Modell Melia beherrscht den Sprachwechsel mitten im Gespräch, ein echter Vorteil bei gemischtsprachigem Audio.
Die Preise gelten pro Stunde und sind creditbasiert, mit klaren Stufen. Batch reicht von 0,129 $ pro Stunde beim Modell Melia bis 0,40 $ beim Enhanced-Modell, die Standard-Stufe liegt bei 0,24 $; Echtzeit kostet 0,24 $ bis 0,43 $. Es gibt 100 $ Gratisguthaben und automatisch 20 % Rabatt ab 500 Stunden pro Monat. Auf G2 erzielt es 4,7 von 5 bei 70 Bewertungen.
Herausragend ist das Deployment. Speechmatics bietet echtes Selbsthosting: Private Cloud, Container, Virtual Appliance und sogar On-Device-Optionen, alle im Enterprise-Tarif, mit SOC 2 Type II, ISO 27001, DSGVO und HIPAA. Adobe Premiere und Stenograph sollen es Berichten zufolge auf dem Gerät einsetzen. Wenn Ihr Audio rechtlich das Haus nicht verlassen darf, ist dies eines der wenigen Modelle hier, das das erlaubt.
Unser Fazit: Speechmatics ist die Antwort, wenn Compliance und Sprachbreite wichtiger sind als ein Kampfpreis. Es ist weder das günstigste noch der FLEURS-Meister, aber die On-Prem-Story und die akzentunabhängige Genauigkeit machen es zur sicheren Wahl für regulierte, mehrsprachige Unternehmen. Kleinere Teams auf der Jagd nach der niedrigsten Rechnung schauen sich anderswo um.
7. Amazon Transcribe
Am besten für: Teams, deren Daten und Infrastruktur bereits in AWS liegen.
Amazon Transcribe ist die Option des etablierten Cloud-Anbieters, und sein ganzer Wert liegt darin, dass es nativ zu AWS gehört. Batch-Jobs lesen und schreiben S3, es fügt sich in Lambda-Event-Pipelines ein und speist Bedrock und Amazon Connect Contact Lens für generative Zusammenfassungen. Wer bereits AWS nutzt, braucht keinen neuen Anbieter, keine separate Abrechnung und keine neue Sicherheitsprüfung.
Die Abrechnung erfolgt pro Sekunde, gestaffelt und mit sinkenden Preisen bei Volumen. Standard-Batch kostet 0,006 $ pro Minute (etwa 0,36 $ pro Stunde) und Streaming 0,01 $ pro Minute, mit enthaltener Sprechererkennung, benutzerdefiniertem Vokabular und Spracherkennung. Die Gratisstufe umfasst 60 Minuten pro Monat für die ersten 12 Monate. Es gibt außerdem eine HIPAA-taugliche Stufe Transcribe Medical für etwa 0,075 $ pro Minute, die geschützte Gesundheitsdaten automatisch erkennt.
Es deckt mehr als 100 Sprachen ab und bietet die üblichen Funktionen: Sprechererkennung, benutzerdefiniertes Vokabular, PII-Schwärzung und Call-Analytics-Einblicke. Eine Genauigkeits-Schlagzeile veröffentlicht es nicht, deshalb fehlt es in Microsofts Vergleich, und seine reale Genauigkeit hat im Vergleich zu den neueren modellorientierten Anbietern einen gemischten Ruf.
Unser Fazit: Das Argument für Amazon Transcribe ist operativ, nicht genauigkeitsgetrieben. Innerhalb von AWS ist es der Weg des geringsten Widerstands, und einheitliche Abrechnung und IAM sind echtes Geld wert. Außerhalb von AWS gibt es wenig Grund, es den schärferen, günstigeren Spezialmodellen vorzuziehen, und zum Standardpreis zahlen Sie einen Aufschlag.
8. OpenAI Whisper (Open Source)
Am besten für: Teams mit eigenen GPUs, die null Kosten pro Stunde und volle Kontrolle wollen.
Whisper ist das Modell, das Open-Source-Transkription zum Mainstream gemacht hat, und es ist weiterhin der Referenzpunkt für Selbsthosting. Es steht mit Code und Gewichten unter der MIT-Lizenz, kommt in sechs Größen von tiny (39 Mio. Parameter) bis large-v3 (1550 Mio.) plus einem 809-Mio.-Turbo-Build und lässt sich mit einem einzigen pip install installieren. Es gibt überhaupt keine API-Rechnung, Sie zahlen nur für die Rechenleistung, für large-v3 grob 10 GB VRAM.
Der ehrliche Kompromiss sind Genauigkeit und Aufwand. In Microsofts FLEURS-Vergleich liegt whisper-large-v3 bei 22,8 %, weit hinter den modernen Modellen, was am deutlichsten zeigt, wie schnell sich dieses Feld bewegt hat. Es hat außerdem keine integrierte Sprechererkennung (Sie ergänzen pyannote oder WhisperX) und kein natives Streaming. Für viele Workloads reicht die Qualität aber völlig, wie ein Selbsthoster es ausdrückte:
"Ich betreibe whisper large-v3 auf einem M2 Max über einen selbst gehosteten Endpunkt, und ehrlich gesagt ist die Genauigkeit gut genug, dass ich keine Bereinigungsmodelle mehr benutze. Das größere Ärgernis war für mich die Latenz bei längeren Abschnitten."
Wer Whisper ohne eigene Server will: OpenAI hostet whisper-1 auch als API für 0,006 $ pro Minute.
Unser Fazit: Whisper ist die Wahl, wenn Datenkontrolle und null Grenzkosten wichtiger sind als Spitzengenauigkeit. Im großen Maßstab kann Selbsthosting jede kostenpflichtige API hier unterbieten. Planen Sie nur die GPU-Zeit, das Sprechererkennungs-Add-on und den Genauigkeitsabstand zu einem 2026er Modell wie MAI-Transcribe-2 oder Gemini ein.
Welches sollten Sie wirklich wählen?
Die ehrliche Antwort: Transkription ist zu einer Commodity-Schicht geworden, die Wahl hängt also vom Einsatz ab, nicht von einem einzelnen "besten" Modell, ähnlich wie die Wahl von KI-Helpdesk-Software eher an der Passung hängt als an einer Rangliste. Hier die Faustregel, die ich verwenden würde.
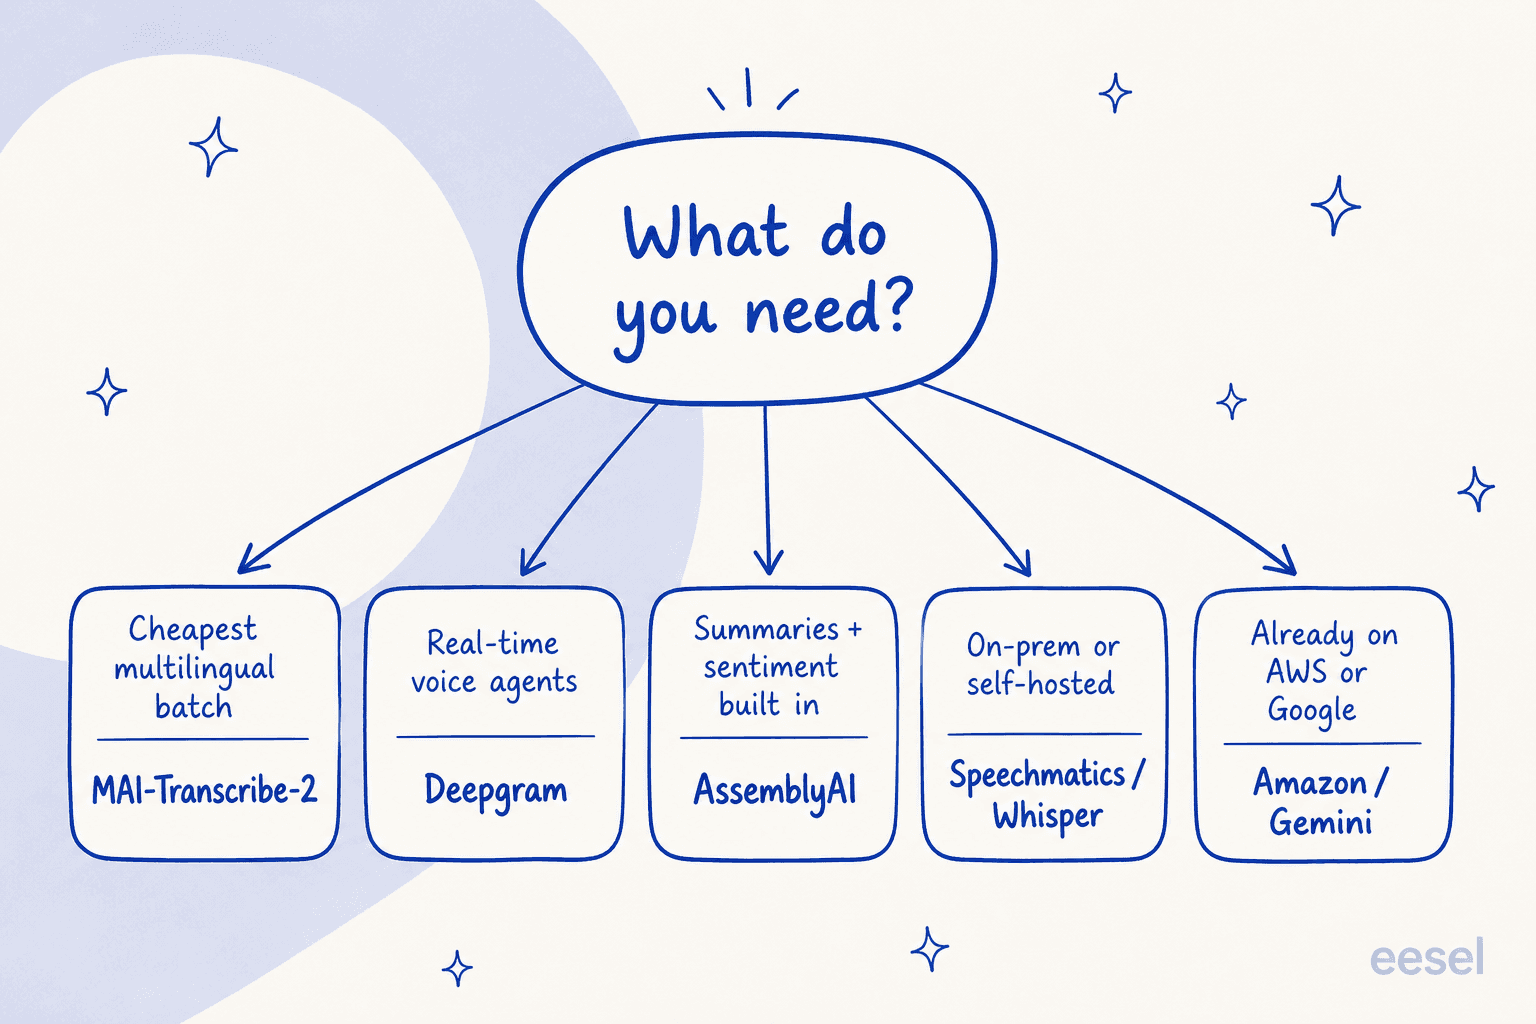
Wer die niedrigste Rechnung für mehrsprachigen Batch sucht, wählt MAI-Transcribe-2 oder Deepgram. Wer Live-Sprachagenten baut, nimmt Deepgram oder Speechmatics. Wer Zusammenfassungen und Stimmungsanalyse direkt braucht, AssemblyAI. Bei Compliance- oder On-Prem-Vorgaben Speechmatics oder Whisper. Wer bereits in einer Cloud lebt, nutzt Amazon Transcribe oder Gemini und spart sich die Integrationsarbeit.
Was die Rangliste nicht zeigt
Hier die Neubewertung, auf die ich bei der Recherche immer wieder kam, und sie ist das, was im Support tatsächlich zählt. Transkription war früher der schwierige, teure Teil. Das ist sie nicht mehr. MAI-Transcribe-2 und jedes Modell auf dieser Liste haben sie in eine schnelle, günstige, nahezu gelöste Commodity verwandelt. Das ist großartig, bedeutet aber, dass der Wert weitergewandert ist.
Ein genaues Transkript eines Support-Anrufs ist nicht das, was irgendjemand wollte. Der Text muss weiterhin gelesen werden, die Antwort muss weiterhin in Ihren Dokumenten und früheren Tickets gefunden werden, und die Antwort muss weiterhin geschrieben und das Ticket gelöst werden. Das Modell liefert die Ohren. Es liefert nicht das Teammitglied.
Ich erlebe das bei eesel seit Jahren. Wir haben KI in Live-Support-Warteschlangen über Tausende echte Tickets betrieben, und die bleibende Lektion ist, dass die Transkriptionsgenauigkeit nie der Engpass war, sondern die Lösung. Deshalb simulieren wir auch jeden Rollout anhand der echten früheren Tickets eines Teams, bevor er je einem Kunden antwortet, damit Sie sehen, wie er Ihre Warteschlange bearbeitet hätte, statt einem Benchmark zu vertrauen. Ein selbstsicher klingendes Modell, das falsche Antworten gibt, ist schlechter als gar keins, und dieses Risiko sitzt in der Lösungsebene, nicht in der Transkription.
eesel ausprobieren, um Transkripte in Lösungen zu verwandeln
Jedes Modell auf dieser Liste ist Infrastruktur. eesel ist der Mitarbeiter, der darauf arbeitet. Wir bauen KI-Teammitglieder, die Sie für eine bestimmte Aufgabe einstellen, und das KI-Helpdesk-Teammitglied setzt genau dort an, wo ein Transkriptionsmodell aufhört: Es liest den Text, holt die Antwort aus Ihrem Help Center und früheren Tickets und entwirft oder sendet die Antwort direkt in Zendesk, Freshdesk oder Slack. Kombinieren Sie ein Modell wie MAI-Transcribe-2 mit eesel, und aus einem transkribierten Sprachticket wird ein gelöstes, nicht nur ein ordentlicher Absatz.
Und weil all das API-first-Modelle sind, wollen die Entwickler, die danach greifen, meist dieselbe Kontrolle über ihre Support-Automatisierung. eesel hat dafür eine öffentliche CLI: Sie steuert dasselbe Teammitglied und denselben Workspace aus einem Terminal, sodass ein Mensch sie von Hand ausführen kann, ein Skript sie automatisieren kann und Coding-Agenten wie Claude Code oder Cursor sie headless bedienen können, ganz ohne Dashboard. Sie schalten Transkription an den Anfang der Pipeline und eesel ans lösende Ende. Es ist kostenlos testbar, lässt sich in wenigen Minuten in Ihren Helpdesk einbinden und simuliert gegen Ihre echten früheren Tickets, bevor es je einem Kunden antwortet.