Die 8 besten Alternativen zu Claude Sonnet 5.5 im Jahr 2026 (nach Wechselgrund)

Kurnia Kharisma

Katelin Teen
Zuletzt bearbeitet September 29, 2026
Warum Leute über Claude Sonnet 5.5 hinausschauen
Zuerst das Faire. Sonnet 5.5 ist ein großer Sprung gegenüber Claude Sonnet 5. Anthropics Launch-Tabelle nennt 70,6 % bei Terminal-Bench 4.0, vor den 66,4 % von Opus 5.5, und Zendesk hat Anthropic gesagt, Tickets würden damit 20 % schneller bearbeitet. Das Sonnet-5.5-Review geht das alles durch, und das Fazit meines Kollegen gilt weiterhin: großartig bei mittlerem Effort.
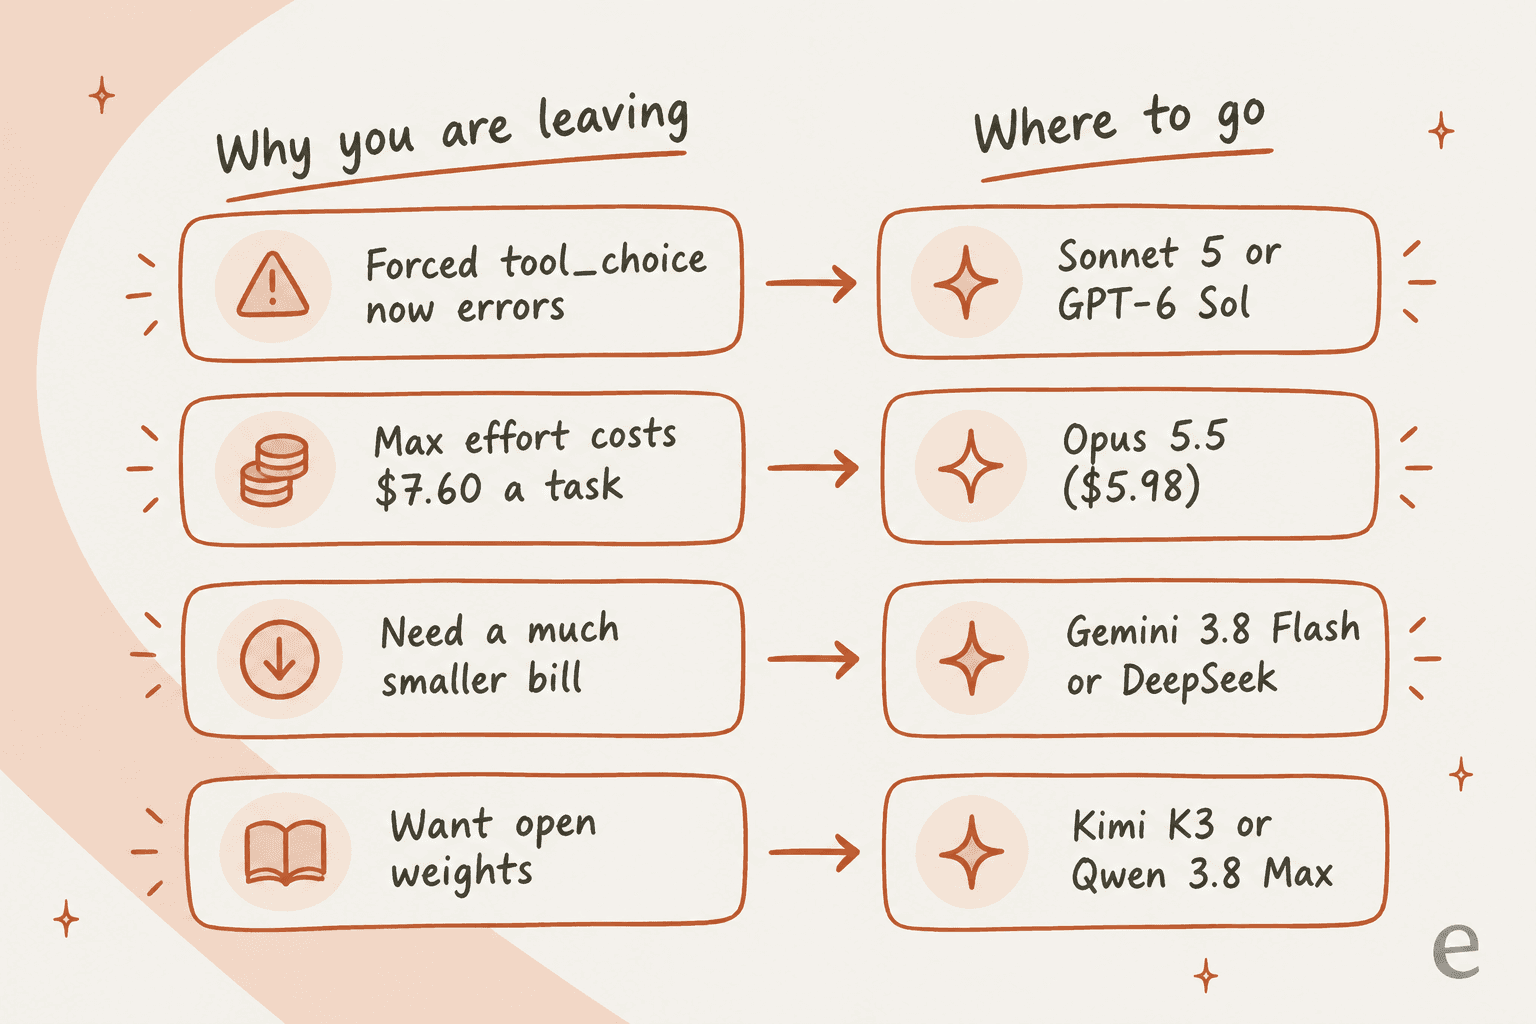
Ich beschäftige mich seit zwei Jahren mit SEO, deshalb hat mir das Suchverhalten rund um dieses Modell schon vor jedem Benchmark etwas verraten. „Sonnet 5.5 Alternativen“ tauchte am Tag nach dem Launch auf, viel zu früh, als dass jemand dem Modell entwachsen sein könnte. Die Leute suchten, weil etwas kaputtging oder weil eine Rechnung sie überrascht hat. Das sind die vier Gründe, um die ich den Rest des Beitrags aufbaue.
Grund 1: fünf Breaking Changes, und eine trifft Bots am härtesten
Anthropic listet fünf Breaking Changes für Code, der auf Sonnet 5 lief. thinking: disabled liefert jetzt 400 und verweist auf between_tools. Das alte Tool computer_20251124 wird in der Claude API und in Google Cloud abgelehnt. Auch manche Advisor-Tool-Kombinationen werden verweigert.
Die Änderung, die Produktiv-Bots zerbricht, ist das erzwungene Tool-Calling. tool_choice mit any oder einem benannten Tool liefert bei Sonnet 5.5 einen 400er invalid_request_error. Anthropic empfiehlt, auto beizubehalten, strict: true zu setzen oder auf Structured Outputs umzusteigen und „im Prompt zu sagen, wann das Tool zutrifft“. Das funktioniert, tauscht aber am Ende eine Garantie gegen eine Bitte. Wenn Ihr Ticket-Triage- oder Extraktionsschritt darauf baute, dass das Modell immer classify_ticket aufruft, haben Sie jetzt ein Verhalten, das Sie neu testen müssen, statt einer Zeile, die Sie ändern. Und der Aufstieg auf Opus 5.5 hilft hier nicht: Dessen Migrationshinweise nennen denselben 400er.
Grund 2: Maximaler Effort kostet mehr als Opus
Der Standard-Effort der API ist bei Sonnet 5.5 high. Ganz oben auf der Leiter wird es teuer. Im Intelligence Index von Artificial Analysis erreichte Sonnet 5.5 bei max 56 Punkte für $7.60 pro Aufgabe, Opus 5.5 bei max 58 Punkte für $5.98. Sonnet hat schlicht mehr Token gebraucht, um auf diesen Wert zu kommen.
"I'm a bit confused myself. On artificial analysis, sonnet 5.5 max has a cost per task of $7.60 while opus 5.5 max has $5.98. Sonnet 5.5 max was using 193k tokens per task while opus 5.5 max was using 119k."

Simon Willison sah dasselbe Muster, nur bei einem einzigen Prompt. Seine Effort-Tabelle reichte von 1,6 Cent bei low bis $1.28 bei max, wo das Modell „burned through 128,000 thinking tokens“ in etwa 15 Minuten und nicht fertig wurde (simonw auf Hacker News).
Grund 3: Cache-Reads kosten so viel wie bei Opus
Sonnet 5.5 kostet bei Input, Output und Cache-Writes halb so viel wie Opus 5.5. Die Ausnahme sind Cache-Reads mit $0.20 pro Million bei beiden, weil Opus 5.5 Cache-Reads mit 0,05x abrechnet. In einer langen Agent-Schleife geht der Großteil der Token in Cache-Reads, die Lücke schließt sich also. Die Seite zu den Anthropic-API-Preisen nennt die Multiplikatoren.
"Cache read is the same as Opus as well where most agentic workflow cost comes from. Not quite sure where this fits well."

Grund 4: Derselbe Listenpreis kauft sehr unterschiedliche Arbeit
Diese Grafik hat mich bei der Recherche am meisten überrascht. Drei Modelle haben exakt denselben Preis von $2 Input / $10 Output. Bei maximalem Effort erzeugen sie dennoch sehr verschiedene Rechnungen pro erledigter Aufgabe.
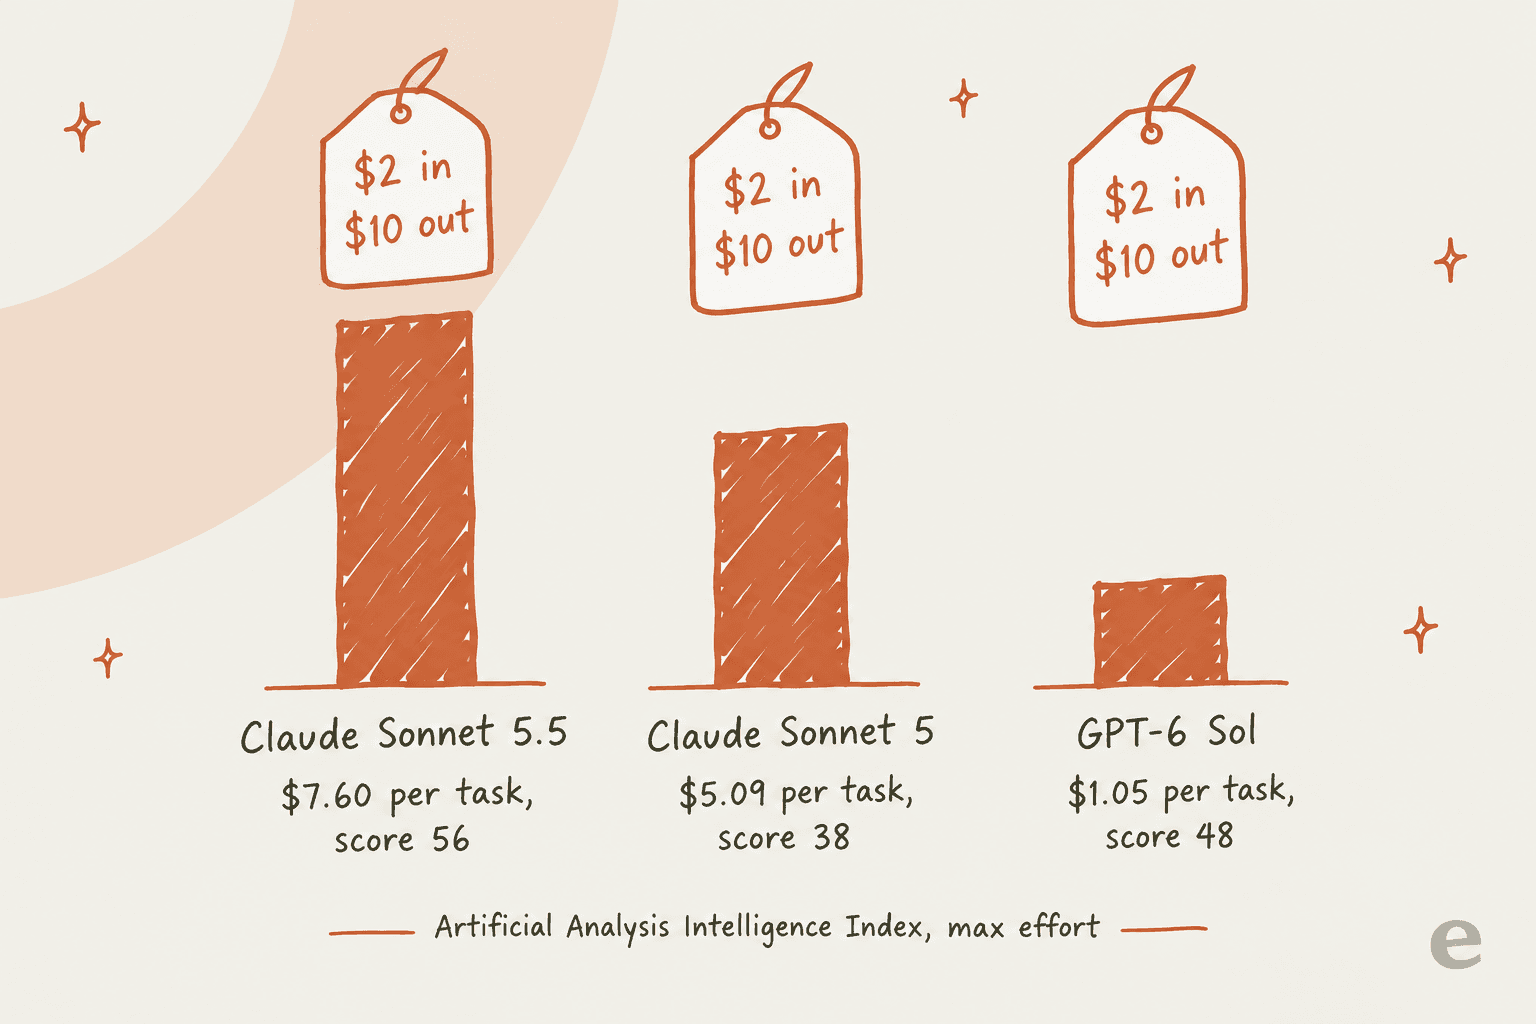
Sonnet 5.5 ist das klügste der drei. Es ist auch mit deutlichem Abstand das teuerste pro Aufgabe. Der Preis pro Token verrät fast nichts über die Rechnung. Entscheidend sind die Token pro Aufgabe, eine Modelleigenschaft, die man nur durch Ausprobieren erfährt.
Alternativen zu Claude Sonnet 5.5 im Überblick
Die Preise gelten pro Million Token laut der jeweiligen Preisseite des Anbieters, geprüft am 29.09.2026. Die Spalte zu Artificial Analysis nutzt die aktuelle Skala des Intelligence Index, mit dem von AA getesteten Effort-Setting in Klammern. Ich habe lieber eine Zelle leer gelassen, als einen Score von der älteren Skala daruntermischen.
| Modell | Input / Output | Cache-Read | Kontext | AA-Score, Kosten pro Aufgabe | Erzwungene Tool-Wahl | Offene Gewichte | Am besten für |
|---|---|---|---|---|---|---|---|
| Claude Sonnet 5.5 (Basis) | $2 / $10 | $0.20 | 1M | 56, $7.60 (max) | Nein, liefert 400 | Nein | Schnelles Coding bei Low/Medium |
| Claude Opus 5.5 | $4 / $20 | $0.20 | 1M | 58, $5.98 (max) | Nein, liefert 400 | Nein | Schwere Aufgaben bei hohem Effort |
| Claude Sonnet 5 | $2 / $10 | $0.20 | 1M | 38, $5.09 (max) | Ja | Nein | Fallback ohne Umbau |
| GPT-6 Sol | $2 / $10 | $0.20 | 1.05M | 48, $1.05 (max) | Ja (Responses API) | Nein | Gleicher Preis, kleinere Rechnung |
| Gemini 3.8 Flash | $0.75 / $3.75 | $0.075 | 1M | 41, $1.24 (high) | Ja (any-Modus) | Nein | Günstige multimodale Batch-Arbeit |
| Grok 4.7 | $2 / $6 | $0.50 | 500K | 46, $3.74 (xhigh) | Ja (required oder benannt) | Nein | Lange Agent-Schleifen |
| Qwen 3.8 Max | $2 / $6 | $0.25 | 1M | - | Benanntes Tool, nur ohne Thinking | Basismodell, eigene Lizenz | Günstigerer Output, offene Basis |
| Kimi K3 | $3 / $15 | $0.30 | 1M | - | Nur required | Ja, eigene Lizenz | Offene Gewichte mit Vision |
| DeepSeek V4.1 Flash | $0.15 / $0.60 außerhalb der Spitzenzeiten | $0.003 | 1M | 39, $0.27 (max) | Nur ohne Thinking | Ja, MIT | Die Preisuntergrenze |
Die Spalte zur erzwungenen Tool-Wahl stammt aus der Function-Calling-Dokumentation der jeweiligen Anbieter. Lesen Sie sie genau, denn diese Spalte verstehen die meisten falsch. Anthropics Tool-Definitions-Dokumentation führt Opus 5.5, Sonnet 5.5 und Fable 5.1 gemeinsam als Modelle auf, bei denen any und tool einen 400er liefern. DeepSeek und Qwen erlauben erzwungene Tools nur mit abgeschaltetem Thinking, und Kimi K3, das immer nachdenkt, akzeptiert required, aber kein benanntes Tool. Nur Sonnet 5, GPT-6 Sol, Gemini 3.8 Flash und Grok 4.7 erzwingen einen Tool-Aufruf bei aktivem Reasoning.
Wie ich diese ausgewählt habe
Ich bin von den vier Gründen oben ausgegangen und habe für jeden Kandidaten eine Frage gestellt: Löst dieses Modell einen konkreten Grund, Sonnet 5.5 zu verlassen, ohne einen schlimmeren zu schaffen? Jeder Preis stammt von der eigenen Preisseite des Anbieters. Jede Zahl zu den Kosten pro Aufgabe stammt von Artificial Analysis, das denselben Intelligence Index für jedes Modell laufen lässt und veröffentlicht, was es ausgegeben hat. Die Community-Zitate stammen aus Hacker-News- und Reddit-Threads, in denen Leute die Modelle selbst ausprobiert haben.
Claude Haiku 4.5 habe ich nicht als Hauptempfehlung aufgenommen. Es ist mit $1/$5 eine echte Option, aber Anthropic nennt als früheste Einstellung den 15. Oktober 2026, in etwa zwei Wochen, und ich würde keine Migration auf ein Modell mit diesem Datum beginnen.
Finden Sie Ihre Alternative in zehn Sekunden
Tippen Sie auf den Grund, der Sie hierhergeführt hat.
Warum verlassen Sie Claude Sonnet 5.5?
Wählen Sie einen Grund, um zu sehen, wohin ich gehen würde.
1. Claude Opus 5.5
Am besten für: Teams, die Sonnet 5.5 mit xhigh oder max Effort betreiben und dafür zahlen.
Die kontraintuitive Empfehlung stelle ich an den Anfang. Claude Opus 5.5 kostet pro Token doppelt so viel und kann trotzdem das günstigere Modell sein. Bei max Effort erreichte Opus 5.5 bei Artificial Analysis 58 Punkte für $5.98 pro Aufgabe, Sonnet 5.5 56 Punkte für $7.60. Opus erschien als Anthropics erstes Opus, das günstiger wurde: $4/$20 statt $5/$25, und seine Cache-Reads werden mit 0,05x abgerechnet, weshalb sie mit Sonnets $0.20 gleichauf liegen.
Es belohnt auch den Schritt nach unten. Die Aufschlüsselung der Sonnet-5.5-Preise ergab: Opus 5.5 bei Medium erreichte 51 Punkte für $1.34 pro Aufgabe, Sonnet 5.5 bei Xhigh 52 Punkte für $2.74. Fast derselbe Score für etwa die Hälfte des Geldes.
Vorteile
- Höhere Obergrenze als Sonnet 5.5 im Intelligence Index, 58 zu 56 bei max.
- Bei max Effort pro Aufgabe günstiger als Sonnet 5.5.
- Dieselbe Claude API, dasselbe Tooling, dieselben Claude-Code-Workflows.
Nachteile
- Doppelter Token-Preis von Sonnet bei Input, Output und Cache-Writes, bei Low und Medium gewinnt also Sonnet 5.5.
- Langsamer, was den Leuten im Launch-Thread sofort auffiel.
- Lehnt erzwungenes
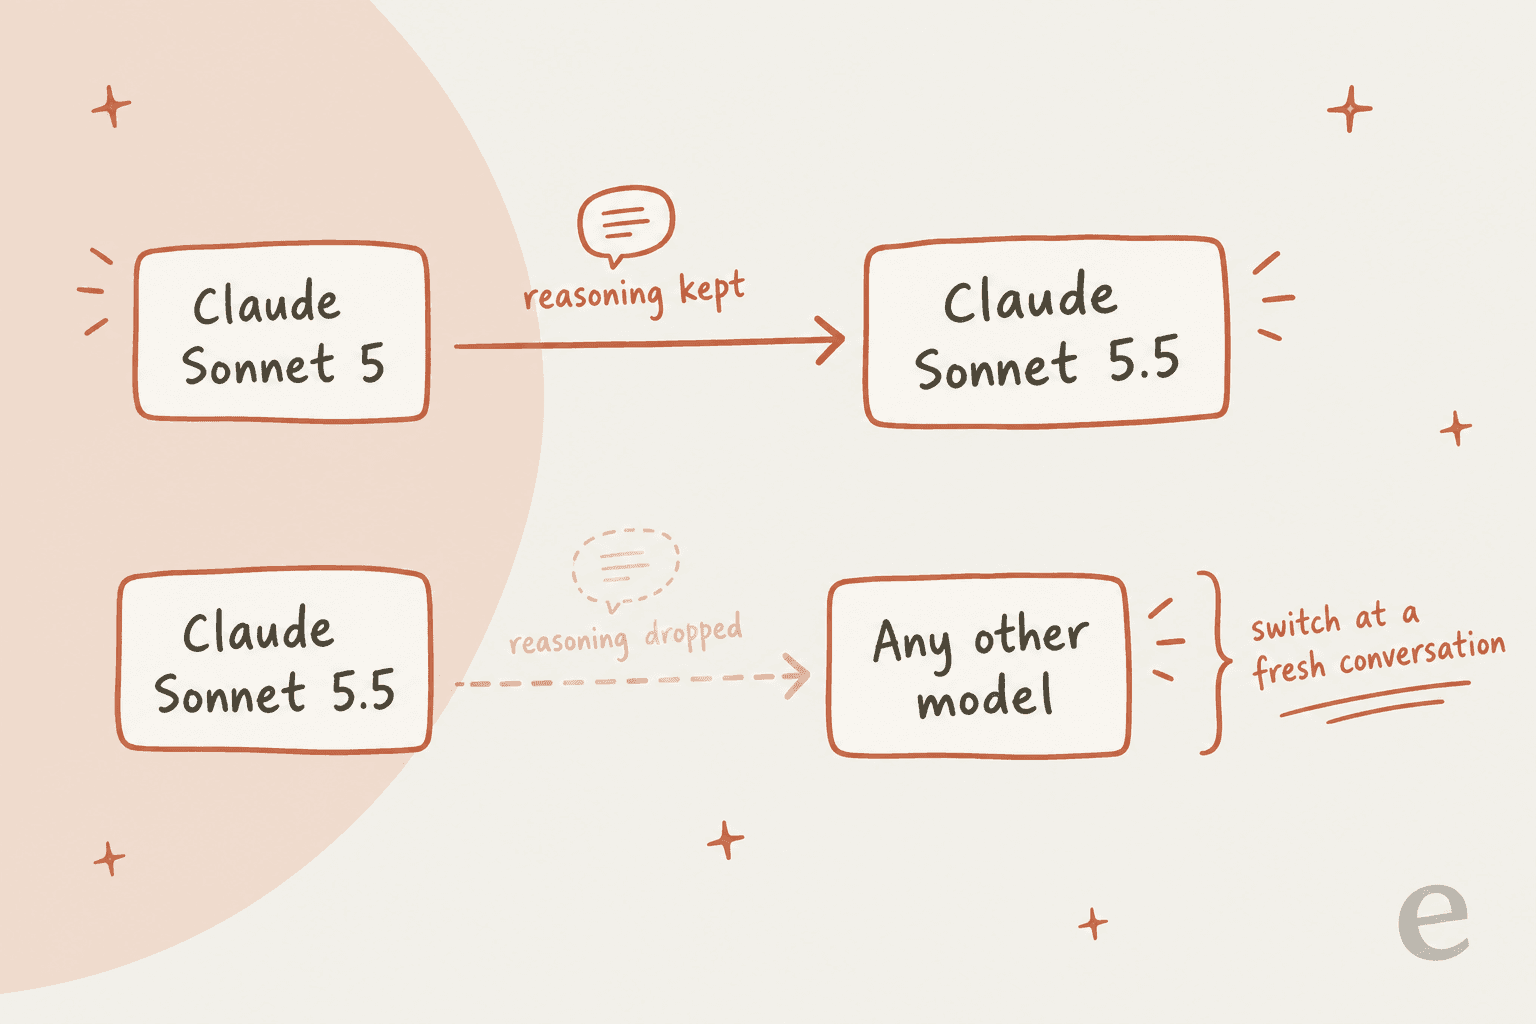
tool_choicegenauso ab wie Sonnet 5.5, ist also keine Lösung für diese Breaking Change. - Sonnet 5.5 kann die Thinking-Blöcke von Opus 5.5 nicht lesen und umgekehrt, das Mischen in einer Unterhaltung verwirft daher Reasoning.
Preise
$4 Input, $20 Output, $0.20 Cache-Read pro Million Token, Batch zum halben Preis. Alle Zeilen finden Sie im Beitrag zu den Preisen von Claude Opus 5.5.
Mein Fazit: Wenn Ihre Last bei xhigh oder max liegt, wechseln Sie zu Opus 5.5 und gehen einen Effort-Level runter. Sie zahlen wahrscheinlich weniger und bekommen die bessere Antwort. Bei Low oder Medium bleiben Sie bei Sonnet 5.5, diese Empfehlung gilt für Sie nicht.
2. Claude Sonnet 5
Am besten für: alle, deren Produktionscode an der Änderung von Sonnet 5.5 bei erzwungenem Tool-Calling oder thinking: disabled zerbrochen ist.
Das ist die langweilige Antwort, aber an dem Tag, an dem Ihre Pipeline 400er wirft, ist sie die richtige. Claude Sonnet 5 ist das Modell, an dem alle fünf Breaking Changes gemessen werden, also trifft per Definition keine davon zu. Es kostet dasselbe $2/$10. Anthropics Deprecation-Seite führt es als aktiv, ohne Einstellung vor dem 30. Juni 2027.
Für alle, die einen schrittweisen Umstieg planen, gibt es ein nettes Detail in der Dokumentation. Sonnet 5.5 kann die Thinking-Blöcke von Sonnet 5 lesen, eine Unterhaltung, die auf Sonnet 5 beginnt und nach oben wechselt, behält also ihr Reasoning. Umgekehrt funktioniert es nicht.
Vorteile
- Ein Rollback in einer Zeile: Modell-ID ändern, sonst nichts.
- Behält erzwungenes
tool_choice, manuelle Thinking-Budgets und das ältere Computer-Use-Tool. - Untergrenze für die Einstellung mehr als 20 Monate entfernt.
Nachteile
- Deutlich weniger leistungsfähig. Terminal-Bench 4.0 liegt laut Anthropics Launch-Tabelle bei 10,3 % gegenüber 70,6 % bei Sonnet 5.5.
- Pro Aufgabe auch nicht günstiger. Bei max wurden
$5.09für einen Score von 38 gemessen. - Nicht mehr in Anthropics Tabelle der aktuellen Modelle, neue Features landen also zuerst bei 5.5.
Preise
$2 Input, $10 Output, $0.20 Cache-Read pro Million Token. Der Beitrag zu den Preisen von Claude Sonnet 5 enthält Details zu Plänen und Batch.
Mein Fazit: Nutzen Sie Sonnet 5 als Parkplatz, nicht als Ziel. Heute zurückrollen, Ihre Tool-Aufrufe auf einem Branch gegen Sonnet 5.5 oder GPT-6 Sol reparieren, dann vorwärts. Die Liste der Alternativen zu Claude Sonnet 5 ist einen Blick wert, falls Sie länger parken.
3. GPT-6 Sol
Am besten für: Teams, die Preise auf Sonnet-Niveau mit erzwungenen Tool-Aufrufen und einer kleineren Rechnung pro Aufgabe wollen.
GPT-6 Sol hat denselben Listenpreis wie Sonnet 5.5: $2 Input, $0.20 gecacht, $2.50 Cache-Writes, $10 Output (OpenAI-Preise). Der Unterschied liegt darin, wie viele Token es verbraucht. Bei max Effort erreichte GPT-6 Sol bei Artificial Analysis 48 Punkte für $1.05 pro Aufgabe, etwa ein Siebtel der Max-Effort-Rechnung von Sonnet 5.5. An der Spitze ist es weniger leistungsfähig: 48 gegenüber 56.
Für alle, die erzwungenes Tool-Calling brauchen, dokumentiert OpenAIs Function-Calling-Leitfaden required und die Tool-Wahl per benannter Funktion. Ein Haken auf der Modellseite: Über Chat Completions unterstützt GPT-6 Sol Function Calling nur mit reasoning_effort auf none. Nutzen Sie die Responses API, wenn Sie Tools und Reasoning zusammen wollen.
Vorteile
- Gleicher Token-Preis wie Sonnet 5.5, bei max deutlich niedrigere Kosten pro Aufgabe.
- Dokumentierte erzwungene Tool-Wahl.
- Kontext mit 1.050.000 Token und ein vollständiges Tool-Set der Responses API.
Nachteile
- Niedrigere Obergrenze: 48 im Intelligence Index gegenüber 56 bei Sonnet 5.5.
- Prompts mit mehr als 272K Input-Token werden für die gesamte Anfrage mit 2x Input und 1,5x Output berechnet.
- Ein Anbieterwechsel bedeutet neuen SDK-Code, neues Prompt-Tuning und neue Evals.
"Sonnet 5.5 is way better than GPT 6 Sol. Does that even make sense?"
Dieser Kommentar ist ein ehrliches Gegengewicht zu den Zahlen. Bei anspruchsvoller Coding-Arbeit bevorzugen viele Sonnet 5.5, und die Benchmarks geben ihnen recht.
Preise
$2 Input, $0.20 gecacht, $10 Output, Batch und Flex zum halben Preis. Der Beitrag zu den GPT-6-Sol-Preisen und die Liste der GPT-6-Sol-Alternativen gehen tiefer.
Mein Fazit: Der beste direkte Tausch für Arbeit mit hohem Volumen und vielen Tools, bei der „gut und günstig pro Aufgabe“ schwerer wiegt als „das Beste“. Für Coding-Spitzenqualität bleiben Sie bei Anthropic.
4. Gemini 3.8 Flash
Am besten für: Batch- und multimodale Arbeit mit hohem Volumen, bei der niemand auf das erste Token wartet.
Gemini 3.8 Flash kostet $0.75 Input und $3.75 Output pro Million Token, Thinking-Token eingeschlossen, bis zum 31. Dezember 2026 (Gemini-API-Preise). Das sind unter 40 % der Sonnet-5.5-Preise. Es nimmt Text, Bild, Audio, Video und PDF als Input, bei Audio und Video zieht Sonnet nicht mit. Bei Artificial Analysis erreichte es mit hohem Effort 41 Punkte für $1.24 pro Aufgabe.
Zwei Dinge sollten Sie einplanen. Der Preis verdoppelt sich am 1. Januar 2027 auf $1.50/$7.50. Und Artificial Analysis maß die Zeit bis zum ersten Token mit 13,3 Sekunden, weit über dem Median der Klasse, obwohl die Ausgabegeschwindigkeit nahe an der Spitze liegt. Gut für einen Nachtjob, schlecht für eine Live-Chat-Antwort.
Vorteile
- Pro Token deutlich günstiger, Batch und Flex nochmals zum halben Preis.
- Breiteste Input-Typen auf dieser Liste.
- Ein kostenloser Tarif zum Prototyping.
Nachteile
- Der Preis verdoppelt sich in drei Monaten.
- Das langsame erste Token schließt es für alles aus, worauf ein Mensch wartet.
- Google sagt, 3.8 „works harder“ und verbraucht mehr Token, und empfiehlt für effizienzorientierte Arbeit weiterhin 3.7 Flash.
Preise
$0.75 Input, $3.75 Output, $0.075 Cache-Read bis Jahresende. Siehe Gemini-3.8-Flash-Preise und das Gemini-3.8-Flash-Review.
Mein Fazit: Eine starke Wahl für Dokumentenverarbeitung, Transkripte und alles mit Video. Planen Sie die Preisänderung im Januar jetzt ein, nicht erst im Dezember.
5. Grok 4.7
Am besten für: lang laufende Agent-Schleifen, bei denen sich günstigere Output-Token summieren.
Grok 4.7 kostet $2 Input und $6 Output pro Million unter 200K Prompt-Token (xAI-Preise). Das ist 40 % günstigerer Output als bei Sonnet 5.5, und beim Output geben Reasoning-Modelle ihr Geld aus. xAI hat es auf einem größeren Basismodell mit einem längeren RL-Lauf für mehrstündige Aufgaben gebaut, und es hat Grok 4.6 bei Terminal-Bench 4.0 fast verdoppelt, 37,6 gegenüber 20,3 in xAIs eigener Tabelle. Bei Artificial Analysis erreichte es mit xhigh 46 Punkte für $3.74 pro Aufgabe.
Vorteile
- Output für
$6, 40 % unter Sonnet 5.5. - 500K Kontext und eine Context-Compaction-API für lange Sitzungen.
- Starke Agent-Scores bei xAIs EEBench- und Briefcase-Zahlen.
Nachteile
- Über 200K Prompt-Token wird die ganze Anfrage mit
$4/$12berechnet, nicht nur der Überhang. - Terminal-Bench 4.0 mit 37,6 liegt deutlich unter den 70,6 von Sonnet 5.5.
- Gecachte Reads für
$0.50kosten mehr als Anthropics$0.20.
Preise
$2 Input, $0.50 gecacht, $6 Output unter 200K. Der Beitrag zu den Grok-4.7-Preisen behandelt die Zähler für Tool-Aufrufe.
Mein Fazit: Einen Test wert, wenn Ihre Agents viel Output erzeugen und unter 200K Kontext bleiben. Halten Sie Prompts schlank, denn die Klippe bei langem Kontext ist steil.
6. Qwen 3.8 Max
Am besten für: Teams, die Input-Preise auf Sonnet-Niveau, günstigeren Output und ein herunterladbares Basismodell wollen.
Qwen 3.8 Max kostet $2 Input und $6 Output pro Million bei Qwen Cloud, mit 1M Kontext, 131K maximalem Output und bis zu 262K Reasoning-Token. Es ist ein Mixture-of-Experts-Modell mit 2,4T Parametern und 95B aktiven. Die Basisgewichte liegen bei Hugging Face als Qwen3.8-2.4T-A95B, unter einer eigenen Qwen-Lizenz statt Apache.
Lizenz und Funktionsumfang sollte man zusammen lesen. Das gehostete Max bringt Vision-Input, einen Modus ohne Thinking und eingebaute Tools mit, die die offene Basis nicht hat. „Offen“ heißt hier, dass Sie das Basismodell betreiben können, nicht, dass Sie das gehostete Produkt bekommen.
Vorteile
- Gleicher Input-Preis wie Sonnet 5.5, 40 % günstigerer Output.
- Starke Rankings bei menschlichen Präferenzen, darunter Text-Platz 5 auf LMArena im August.
- Ein Self-Hosting-Weg, falls Sie ihn je brauchen.
Nachteile
- Die offene Basis hat nicht denselben Funktionsumfang wie das gehostete Modell.
- Eigene Lizenz, klären Sie sie also mit der Rechtsabteilung, bevor Sie damit ausliefern.
- Daten gehen in Alibabas Cloud, außer Sie hosten selbst.
Preise
$2 Input, $6 Output, $0.25 impliziter Cache-Read. Siehe Qwen-3.8-Max-Preise und das Qwen-3.8-Max-Review.
Mein Fazit: Eine gute mittlere Option, wenn der Output-Preis von Sonnet das Problem ist und Sie sich später von einem einzelnen Anbieter lösen wollen.
7. Kimi K3
Am besten für: Teams, die offene Gewichte mit nativer Vision brauchen und bereit sind, ernsthafte Hardware zu betreiben.
Kimi K3 ist das Flaggschiff von Moonshot AI: 2,8T Parameter mit 104B aktiven, 1M Kontext und native Bild- und Videoverarbeitung. Die Gewichte liegen bei Hugging Face, was keines der westlichen Modelle hier bietet. Über die API kostet es $3 Input, $0.30 gecacht und $15 Output pro Million (Moonshot-Preise), Cache-Writes werden je nach TTL separat mit $3 oder $6 berechnet.
Damit ist es über die API teurer als Sonnet 5.5. Der Grund, es zu wählen, ist die Kontrolle, nicht die Kosten.
Vorteile
- Offene Gewichte in Frontier-Größe, mit eingebauter Vision.
- 1M Kontext und Output, einstellbar bis 1M Token.
- Ein Self-Hosting-Weg für Daten, die Ihr Netzwerk nicht verlassen dürfen.
Nachteile
- Über die gehostete API pro Token teurer als Sonnet 5.5.
- Reasoning lässt sich auf keiner Effort-Stufe abschalten.
- Das Gewichte-Repository ist etwa 1,5 TB groß, Self-Hosting ist also ein Cluster-Job.
Preise
$3 Input, $0.30 gecacht, $15 Output. Siehe Kimi-K3-Preise und Kimi-K3-Alternativen.
Mein Fazit: Wählen Sie Kimi K3 nur, wenn Sie wirklich selbst hosten. Wenn Sie ohnehin die API aufrufen, ist Sonnet 5.5 bei Medium günstiger und einfacher.
8. DeepSeek V4.1 Flash
Am besten für: die niedrigstmögliche Rechnung und die einzige permissive offene Lizenz auf dieser Liste.
DeepSeek V4.1 Flash kostet $0.15 Input und $0.60 Output pro Million außerhalb der Spitzenzeiten und $0.30/$1.20 zu Spitzenzeiten (DeepSeek-Preise). Der API-Name lautet jetzt deepseek-flash. Bei Artificial Analysis erreichte es mit max Effort 39 Punkte für $0.27 pro Aufgabe, berechnet zu Spitzenpreisen, außerhalb der Spitzenzeiten also etwa die Hälfte. Die Gewichte stehen unter MIT-Lizenz.
Es ist auch das Modell, auf das DeepSeek seinen V4-Pro-Traffic umgezogen hat, was zeigt, wie sicher sie sich sind. Es unterstützt Tool-Aufrufe, das Anthropic-API-Format und die Responses API, sodass eine Codebasis mit Anthropic-SDK oft mit einer Änderung der Base-URL darauf zeigen kann.
Vorteile
- Laut AA-Zahlen bei max etwa 28x günstiger pro Aufgabe als Sonnet 5.5.
- MIT-Gewichte und ein Anthropic-kompatibler Endpunkt.
- Vision im Hauptmodell eingebaut.
Nachteile
- Eine deutlich niedrigere Obergrenze: 39 im Intelligence Index.
- Die Bedingungen der bezahlten API veröffentlichen weder eine Auftragsverarbeitungsvereinbarung noch eine Zero-Retention-Option, und Daten werden in China verarbeitet.
- Der Spitzenpreis verdoppelt den Tarif wochentags von 01:00-04:00 und 06:00-10:00 UTC.
"I have been using DeepSeek since forever and it's so good I was able to write a compiler and native desktop applications with it."
Preise
Außerhalb der Spitzenzeiten $0.15 Input, $0.60 Output, $0.003 Cache-Hit, zu Spitzenzeiten das Doppelte. Siehe DeepSeek-V4.1-Flash-Preise.
Mein Fazit: Hervorragend für interne Tools, Codegenerierung und Batch-Jobs. Bei allem, was Kundendaten trägt, denken Sie über die Datenbedingungen nach, bevor Sie auf den Preis schauen.
Was Entwickler über Sonnet 5.5 im Vergleich zum Feld sagen
Der Launch-Thread auf Hacker News kam auf 556 Kommentare, und die Aufteilung war klar. Die Leute mögen das Tempo und den Benchmark-Sprung. Sie sind unsicher, wo es neben Opus 5.5 hingehört.
"Per the charts, there is largely no point to using Sonnet 5.5 at high+ as opus low generally will give similar performance at similar or lower cost. But Sonnet 5.5 at medium and below gives you a cheaper option at a performance worse than the lowest thinking Opus (low), which may be viable for "low intelligence" use cases."
Das Muster, auf das sich mehrere Leute einigten, ist gar kein „Sonnet 5.5 verlassen“. Es ist eine Aufteilung der Arbeit: Opus plant, Sonnet baut bei Low oder Medium, Opus räumt auf. Ein Kommentator formulierte es als „80% Sonnet 5.5, Opus 5.5 to finish the last 20%“ (vektormemory auf Hacker News). Passt das zu Ihrem Setup, zeigt der Leitfaden zu Claude-Code-Subagents, wie man es verdrahtet.
Eine Qualitätsregression sollten Sie ebenfalls kennen. Ein Entwickler mit einem adversarialen Benchmark sah Sonnet 5.5 bei 7,4 % gegenüber 17,8 % bei Sonnet 5, weil es „returns to ask the user questions whether to keep going“ (dom96 auf Hacker News). Für einen unbeaufsichtigten Agent ist das eine Verhaltensänderung, auf die Sie testen sollten.
Der Wechsel ist ein Support-Problem, nicht nur ein Modellproblem
Jedes Modell auf dieser Liste bekommt innerhalb von Monaten eine neue Version, und manche davon brechen etwas. Sonnet 5.5 kam mit fünf Breaking Changes. Der Preis von Gemini 3.8 Flash verdoppelt sich im Januar. Haiku 4.5 hat ein Einstellungsdatum in zwei Wochen. Was auch immer Sie heute wählen: Jemand in Ihrem Team ist nächstes Quartal für den erneuten Test zuständig.
Diesen Teil unterschätzen Käufer. In einem eesel-Verkaufsgespräch, das ich mir angesehen habe, sagte ein preisbewusster Käufer bei einem kleinen Hardware-Unternehmen, er sei verbrannt worden, als der Preis eines früheren Anbieters sich „more than doubled“ habe, und er wolle eine vertragliche Preisgarantie, bevor er irgendetwas unterschreibe. Die Modellschicht birgt dasselbe Risiko, nur in schnellerem Takt.
Speziell für eine Support-Warteschlange würde ich hier aufhören, Modelle zu wählen. eesel betreibt KI-Teammitglieder in Live-Helpdesk-Warteschlangen, und jeder Rollout wird gegen die historischen Tickets des Teams simuliert, bevor er einem echten Kunden antwortet. Ändert sich das Modell darunter, finden Sie mit dieser Simulation die Regression beim erzwungenen Tool-Aufruf, bevor es ein Kunde tut. Die Übersicht zum besten Support-Ticket-Modell vergleicht die Modelle für diese Aufgabe, und der Leitfaden zu den Kosten eines KI-Support-Agents behandelt die Budgetseite.
Testen Sie eesel, wenn das Modell in Ihr Helpdesk soll
Ein rohes Modell ist Infrastruktur. Sie wählen es aus, verdrahten seine Tool-Aufrufe, schreiben die Evals und führen sie erneut aus, wenn eine Breaking Change landet. eesel ist der Mitarbeiter obendrauf: ein KI-Helpdesk-Teammitglied, das in Ihr Zendesk oder ein anderes Helpdesk einsteigt, aus Ihren früheren Tickets und Ihrem Help Center lernt und an Ihren historischen Tickets getestet wird, bevor es jemandem antwortet. Sie setzen nie tool_choice, und die Breaking Change eines Modells fängt eesel ab statt Ihrer Support-Warteschlange.
Wenn Sie aus einem Terminal kommen: Die eesel-CLI steuert dasselbe Teammitglied. Installieren Sie sie mit npm i -g @eesel/cli, verbinden Sie ein Helpdesk mit eesel integrations connect, bearbeiten Sie die festen Regeln mit eesel instructions und lesen Sie jeden Lauf als JSON mit eesel activity. Schreibzugriffe akzeptieren --dry-run, und jeder Workspace ist zugleich ein MCP-Server, sodass Claude Code, Codex oder Cursor ihn für Sie bedienen können. Es ist die programmierbare Kontrolle, die Sie sich von einer Modell-API wünschen würden, gerichtet auf ein Teammitglied, das die Arbeit bereits macht.

eesel-Preise sind ein fester monatlicher Credit-Plan, mit kostenlosem Tarif, um es an Ihren eigenen Tickets zu testen. Testen Sie eesel und sehen Sie Ihre Warteschlange beantwortet, ohne zuerst ein Modell zu wählen.
Häufig gestellte Fragen
Was ist die beste Alternative zu Claude Sonnet 5.5?
Gibt es eine Alternative zu Claude Sonnet 5.5, die erzwungenes Tool-Calling unterstützt?
tool_choice weiterhin mit any oder einem benannten Tool und wird nicht vor dem 30. Juni 2027 eingestellt. GPT-6 Sol, Gemini 3.8 Flash und Grok 4.7 erzwingen ebenfalls Tool-Aufrufe. Beachten Sie: Auch Claude Opus 5.5 lehnt das ab, ein Aufstieg in der Claude-Reihe löst das Problem also nicht. Der Leitfaden zur AI-Helpdesk-API zeigt, wo erzwungene Tool-Aufrufe im Support eine Rolle spielen.Ist Claude Opus 5.5 günstiger als Claude Sonnet 5.5?
Was ist die günstigste Alternative zu Claude Sonnet 5.5?
Gibt es Open-Source-Alternativen zu Claude Sonnet 5.5?
Kann ich mitten in einer Unterhaltung von Claude Sonnet 5.5 zu einem anderen Modell wechseln?
Welche Alternative zu Claude Sonnet 5.5 eignet sich am besten für einen Kundensupport-Bot?


Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.