

MAI-Transcribe-2 ist das neue Speech-to-Text-Modell von Microsoft AI, angekündigt am 3. September 2026 und beworben als „das schnellste, genaueste und günstigste Spracherkennungsmodell der Welt". Nach Microsofts eigenen Zahlen stimmt das größtenteils: eine durchschnittliche Wortfehlerrate von 5,2 % über 60 Sprachen, bei langem Audio etwa 10-mal schneller als GPT-Transcribe (laut Microsofts eigenen Benchmarks) und 0,10 $ pro Stunde Audio als Einführungspreis.
Ein paar Haken sollten Sie kennen, bevor Sie darauf aufbauen. Die 0,10 $ sind ein zeitlich begrenztes Angebot bis Ende 2026, der Standardpreis ist nicht veröffentlicht. Es ist ein Batch-Modell in der öffentlichen Preview (ohne SLA), Dateien sind auf 300 MB begrenzt, und Echtzeit-Anwendungen brauchen ein separates Voice-Live-Setup. Die Benchmark-Tabelle stammt zudem von Microsoft selbst, in einem Ranking, in dem das Modell insgesamt auf Platz zwei steht.
Wenn Sie nur Audio per API in sauberen, mehrsprachigen Text verwandeln wollen, ist es derzeit eine der stärksten und günstigsten Optionen. Geht es Ihnen aber um einen Support-Workflow, bedenken Sie: Das Transkript ist der Anfang, nicht das Ende. Jemand muss es noch lesen, die Antwort finden und das Ticket lösen. Genau das ist die Aufgabe eines KI-Teammitglieds wie eesel, und dort liegt jetzt der eigentliche Wert.
Ich baue bei eesel Integrationen und APIs und lese einen solchen Launch deshalb wie ein Entwickler: Was kann die API wirklich, wenn man über die Schlagzeile hinausschaut? Ich habe mich mit der MAI-Transcribe-2-Modellseite, der Azure-Speech-Dokumentation, dem Playground und den ersten Entwicklerstimmen beschäftigt. Das habe ich gefunden.
Was MAI-Transcribe-2 eigentlich ist
MAI-Transcribe-2 ist ein Speech-to-Text-Modell, das Microsoft AI intern entwickelt hat, dieselbe Gruppe hinter den Modellen MAI-Voice und MAI-1. Das Versprechen ist erfrischend schmal: Es macht eine Sache, nämlich Audio in Text umwandeln, und das in einem einzigen Modell über viele Sprachen hinweg, statt Sie eine Engine pro Sprache wählen zu lassen.
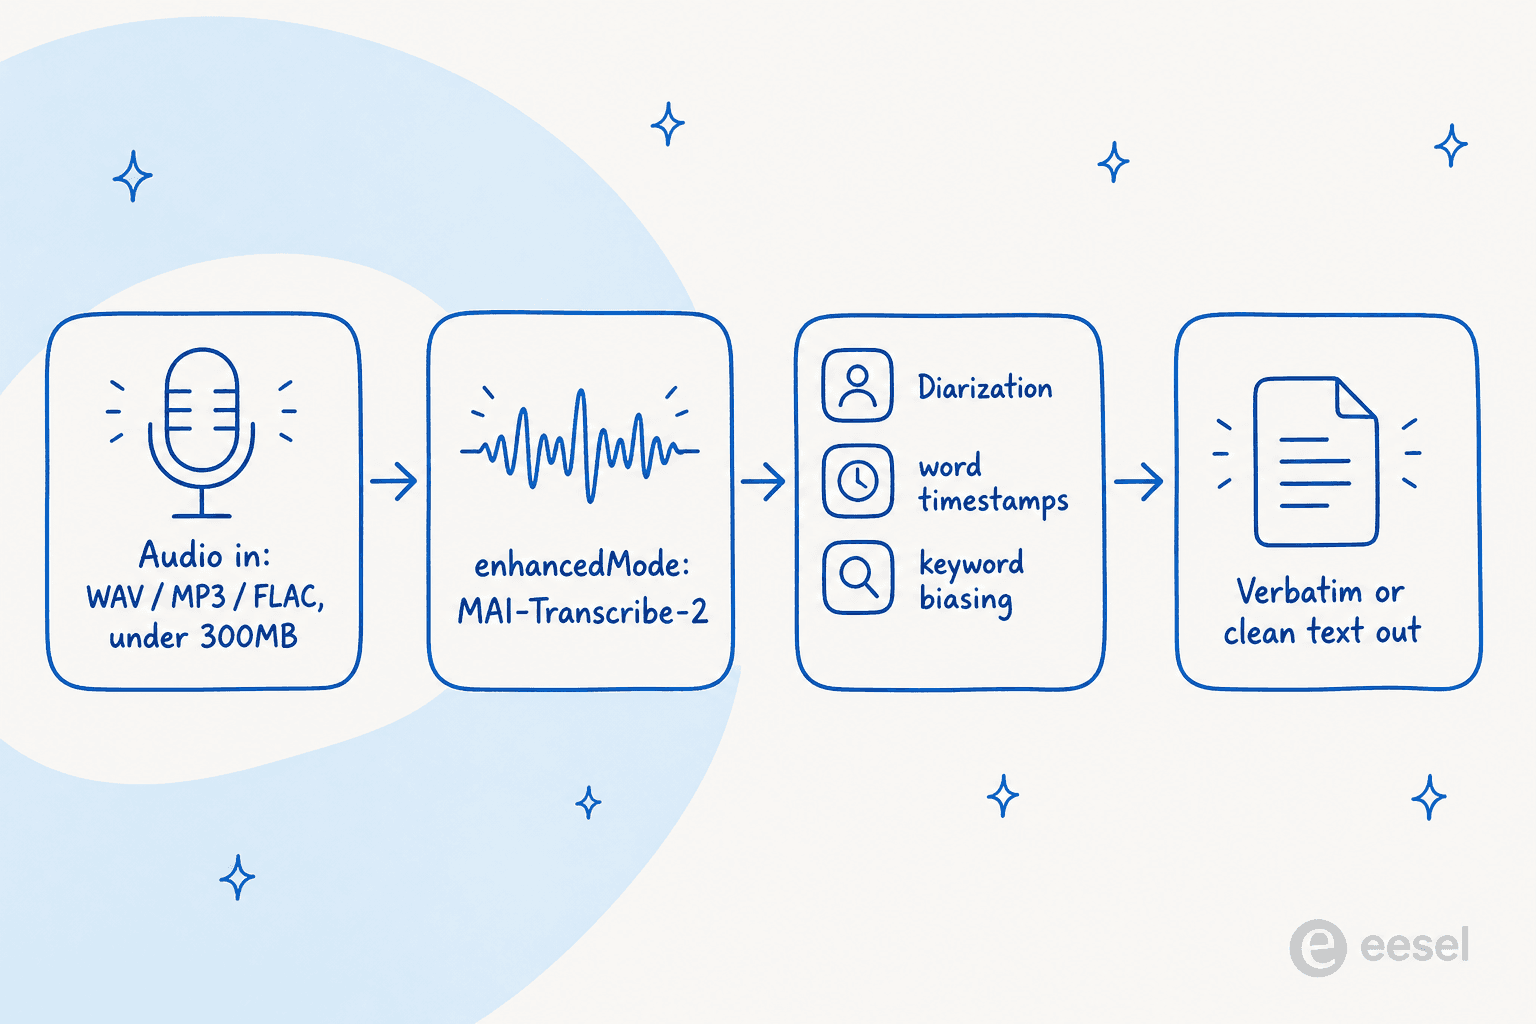
Heraus kommt mehr als ein roher String. Das Modell beherrscht Sprechererkennung (wer wann gesprochen hat), Zeitstempel auf Wortebene, Keyword-Biasing, damit Produktnamen und Fachjargon bevorzugt werden, und die Wahl zwischen einem „Verbatim"-Stil, der jedes Füllwort und jeden Neuanfang für Compliance-Zwecke beibehält, und einem „Clean"-Stil, der lesbare Untertitel formatiert. Es löst MAI-Transcribe-1.5 und MAI-Transcribe-1 ab, die laut Azure-Speech-Dokumentation seit dem 20. August 2026 als veraltet gelten.
Ehrlich betrachtet: Dies ist ein Modell von Microsoft AI und damit klar Teil des Azure-Speech-Ökosystems, keine eigenständige Verbraucher-App. Sie erreichen es über eine API, einen Entwickler-Playground oder Drittanbieter-Router, nicht über ein ausgefeiltes Endnutzerprodukt. Wer eine Meeting-App im Stil von Otter erwartet hat: Das hier ist die Schicht darunter, nicht die App selbst.
Die Schlagzeile: am schnellsten, am genauesten und am günstigsten
Microsoft hat sich nicht abgesichert. Der Launch-Beitrag nennt MAI-Transcribe-2 „das schnellste, genaueste und günstigste Spracherkennungsmodell der Welt", eine dreifache Behauptung, die normalerweise beim zweiten Teil zerbricht. Diese hier hält größtenteils, mit ein paar Sternchen.
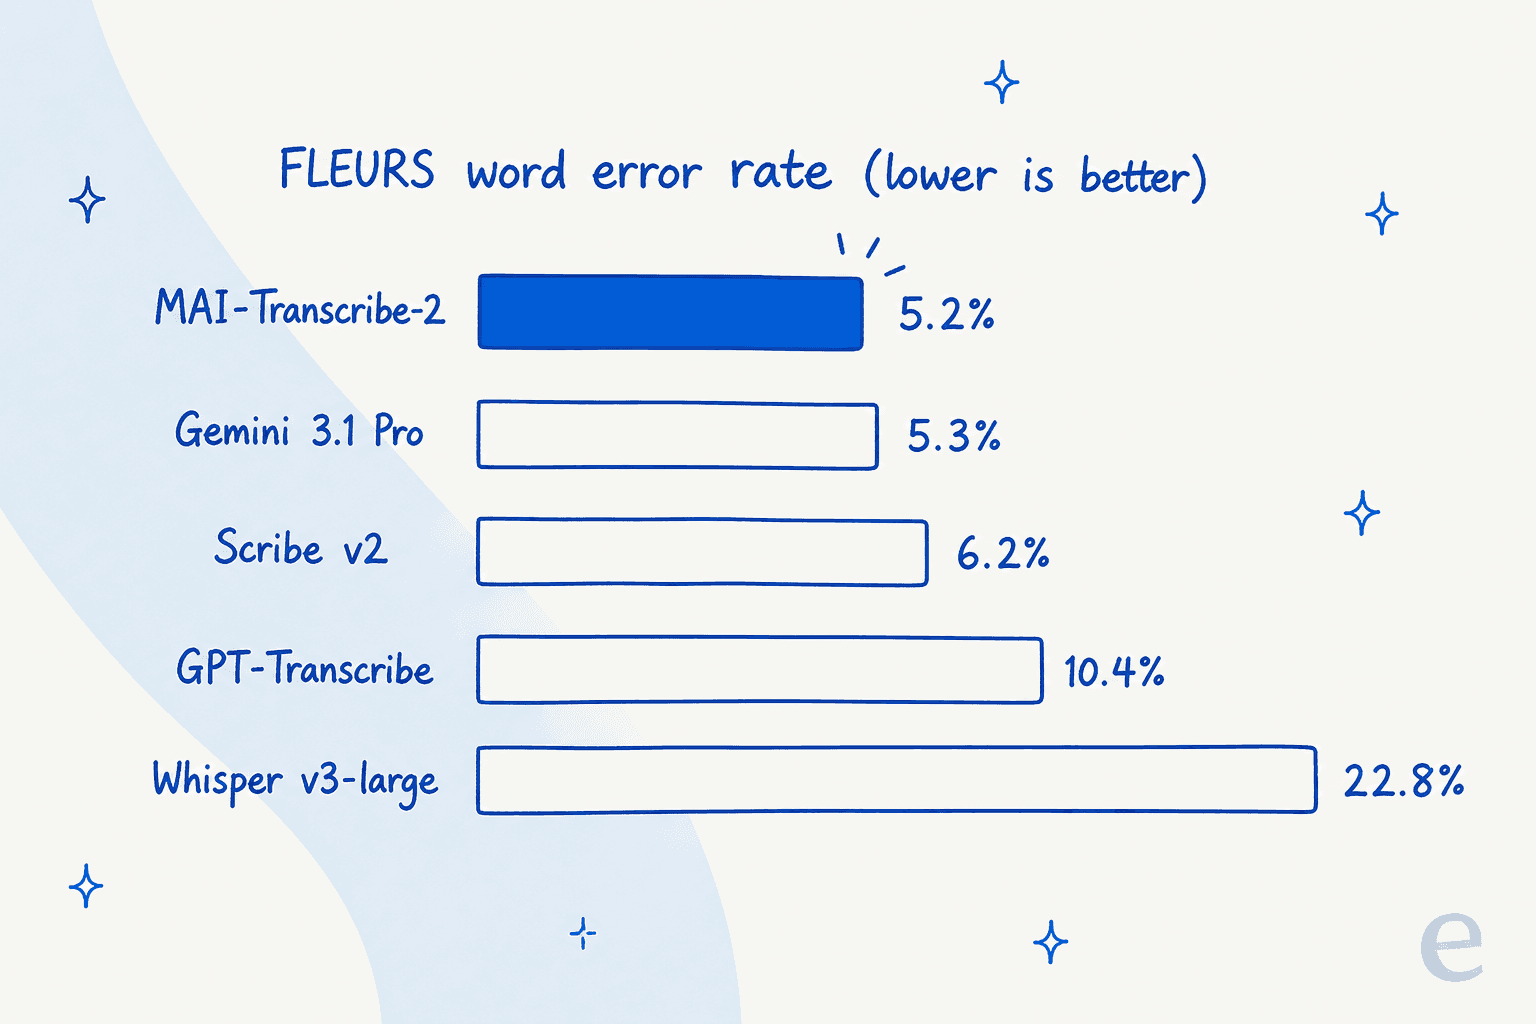
Bei der Genauigkeit erreicht das Modell eine durchschnittliche Wortfehlerrate von 5,2 % im FLEURS-Benchmark über 60 Sprachen, was laut Microsoft Platz 1 bei FLEURS und Platz 2 im Wortfehlerraten-Ranking von Artificial Analysis bedeutet. Bei den 25 wichtigsten FLEURS-Sprachen sinkt der Wert auf 3,4 %. So stellt die Modellseite es dem Feld gegenüber (niedriger ist besser):
| Modell | FLEURS-WER über 60 Sprachen (forced) |
|---|---|
| MAI-Transcribe-2 | 5,2 % |
| Gemini 3.1 Pro | 5,3 % |
| Scribe v2 (ElevenLabs) | 6,2 % |
| Gemini 3.5 Transcribe | 5,9 % |
| GPT-Transcribe (OpenAI) | 10,4 % |
| Whisper v3-large (OpenAI) | 22,8 % |
Der Abstand zum älteren offenen Whisper v3-large ist riesig, und der Vorsprung vor Gemini 3.5 Transcribe und GPT-Transcribe ist real. Der Vorsprung vor Gemini 3.1 Pro beträgt dagegen nur ein Zehntel Prozentpunkt, „am genauesten" stimmt also, aber nur knapp an der Spitze der Tabelle.
Bei der Geschwindigkeit sind die Zahlen wirklich beeindruckend. Microsoft misst eine Stunde Audio bei etwa 10 Sekunden Modell-Inferenz, und die Launch-Benchmarks zeigen es 10-mal schneller als GPT-Transcribe, 7-mal schneller als ElevenLabs Scribe v2 und 5-mal schneller als Gemini 3.5 Transcribe, und das alles auf der Pareto-Grenze zwischen Genauigkeit und Latenz. Ein HN-Kommentator, der es ausprobiert hat, fasste es schlicht zusammen:
"According to Artificial Analysis it is on the pareto frontier."

Beim Lesen sollten Sie eines im Kopf behalten: Das sind Microsofts eigene Benchmark-Zahlen und Microsofts eigene Wahl der Vergleichspunkte. Das macht sie nicht falsch, und die bisherigen unabhängigen Tests gehen in dieselbe Richtung. Es heißt nur, dass „das Beste der Welt" die Sicht des Anbieters ist und der zweite Platz im Gesamtranking von Artificial Analysis die nüchternere Lesart.
So nutzen Sie es konkret
Hier meldete sich mein Entwickler-Ich, und hier wird das Modell interessanter als das Leaderboard. MAI-Transcribe-2 läuft über die Azure Speech Fast Transcription API, und Sie aktivieren es mit einem enhancedMode-Flag statt über einen neuen Endpunkt. Ein minimaler Aufruf sieht so aus:
curl --location 'https://YourResourceName.cognitiveservices.azure.com/speechtotext/transcriptions:transcribe?api-version=2025-10-15' \
--header 'Content-Type: multipart/form-data' \
--header 'Ocp-Apim-Subscription-Key: <YourSpeechResourceKey>' \
--form 'audio=@"YourAudioFile.wav"' \
--form 'definition={
  "enhancedMode": {
    "enabled": true,
    "model": "MAI-Transcribe-2"
  }
}'
Die Parameter sind übersichtlich: diarization.enabled für Sprecherlabels, phraseList.phrases für Keyword-Biasing, modelOptions.transcribeStyle, um wortgetreu oder bereinigt zu wählen, und locales, wenn Sie die automatische Erkennung überspringen wollen. Dateien werden als WAV, MP3 oder FLAC hochgeladen und sind auf 300 MB begrenzt. Es ist ein unkomplizierter Batch-Upload, was je nach Vorhaben gut oder schlecht ist.
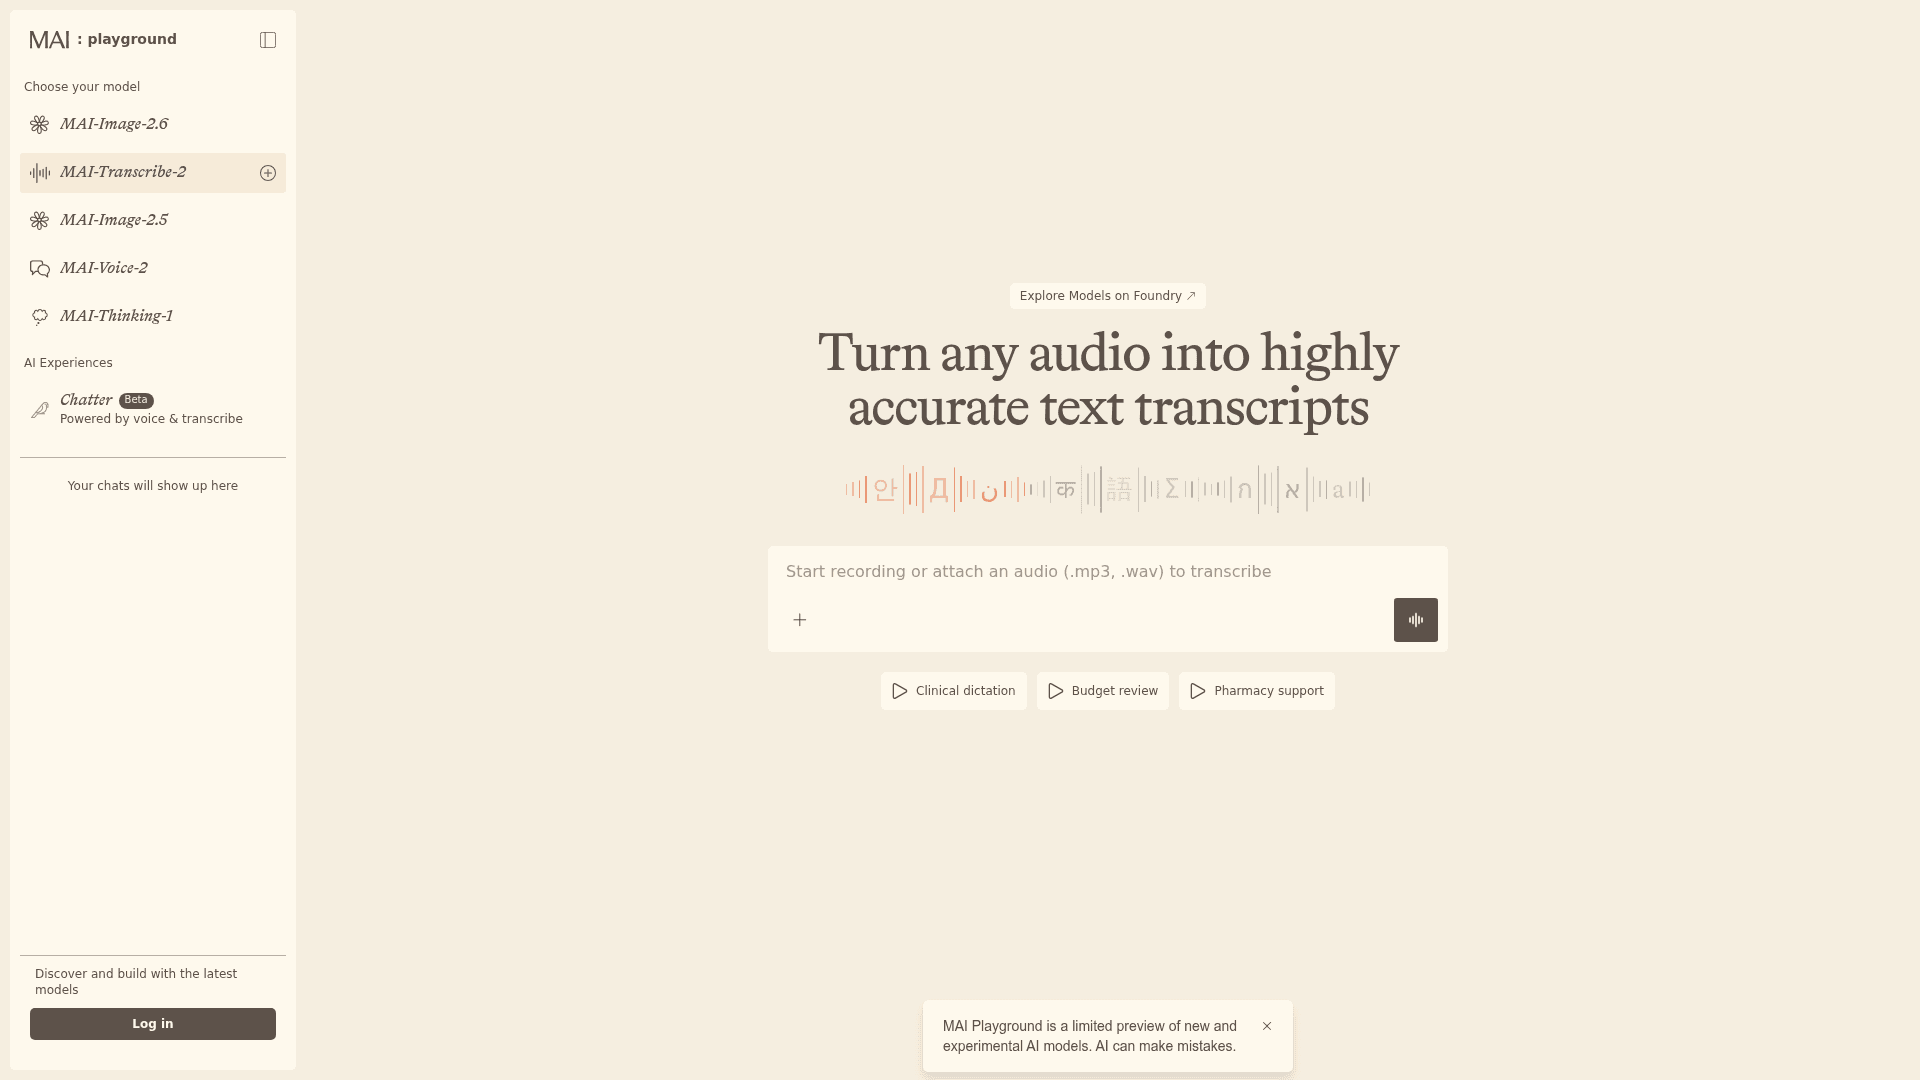
Wer lieber klickt als curlt, hat zwei einfachere Zugänge. Im MAI Playground können Sie eine MP3 ablegen oder direkt im Browser aufnehmen, mit Beispielen für klinisches Diktat und Support-Anrufe, und das Modell ist außerdem auf OpenRouter und im Azure-AI-Foundry-Katalog gelistet.
Wo es wirklich gut ist und wo die Haken liegen
Zuerst gebe ich MAI-Transcribe-2, was ihm zusteht. Die stärkste unabhängige Reaktion, die ich fand, war kein Nachposten des Datenblatts. Vojtech Rinik, der Indie-Entwickler hinter der Whisper-Memos-App, ließ einen schwierigen Praxisclip durchlaufen:
"I tried running a church homily with lots of echo in Slovak language through this... It did much better than ElevenLabs at 45% of the price."
Verrauschtes, hallendes Nicht-Englisch-Audio ist genau der Fall, an dem schwächere Modelle scheitern. Wenn ein Entwickler es also einem Tool vorzieht, auf dem er bereits ausliefert, sagt das etwas, was die Benchmark-Tabelle nicht kann.
Nun die Haken, denn sie zählen im Produktivbetrieb. Der Preis von 0,10 $ pro Stunde ist eine Einführungsaktion, die „bis Ende des Jahres" läuft, und Microsoft hat nicht veröffentlicht, was danach passiert. Zum Vergleich: Die Modellseite führt MAI-Transcribe-1.5 weiterhin mit 0,36 $ pro Stunde, ein regulärer v2-Preis in dieser Größenordnung wäre also keine Überraschung. Ein Hacker-News-Kommentator stellte die zwei Fragen, die Microsoft zum Start offenließ:
"is this usable for streaming or only batch? do they give the price after the launch-discount (till end of year) goes away?"
Zur Streaming-Frage gibt es eine Antwort, und sie ist umständlich: Die Fast Transcription API arbeitet nur im Batch-Modus, und für Live-Audio müssen Sie das Modell als Eingabetranskriptionsmodell in die separate Voice Live API einbinden. Das ist machbar, aber nicht derselbe Aufruf, also einplanen. Außerdem ist es noch eine öffentliche Preview ohne SLA, die Microsoft ausdrücklich als nicht für den Produktivbetrieb geeignet kennzeichnet.
Die Integrationsform ist der andere Punkt. Als reines Transkriptionsmodell passt es nicht in Chat-Completions-Tooling wie ein allgemeines LLM. Entwickler auf Reddit stießen früh darauf:
"OpenRouter requires a dedicated endpoint (
/api/v1/audio/transcriptions) for pure transcription models like MAI-Transcribe-2."

Nichts davon ist ein Ausschlusskriterium. Es ist die normale Beschaffenheit eines wenige Tage alten Preview-Modells, und es lohnt sich, es zu benennen, damit Sie nicht überrascht werden.
Was das Benchmark-Diagramm nicht zeigt
Das ist die Neubewertung, zu der ich immer wieder zurückkam. Transkription war früher der schwierige, teure Teil. MAI-Transcribe-2 hat sie, zusammen mit Gemini 3.5 Transcribe und ElevenLabs Scribe, leise zu einer schnellen, günstigen, fast gelösten Commodity-Schicht gemacht. Das ist eine gute Nachricht, bedeutet aber auch, dass der Wert weitergewandert ist. Ein genaues Transkript ist nicht das, was jemand eigentlich wollte; es ist der Rohstoff für das, was er wollte.
Nirgends ist das klarer als im Kundensupport. Ein Transkriptionsmodell kann einen Support-Anruf oder eine Sprachnachricht in etwa zehn Sekunden in fehlerfreien Text mit Sprecherzuordnung und Zeitstempeln verwandeln. Und dann? Der Text muss noch gelesen werden, die Antwort muss noch in Ihren Dokumenten und früheren Tickets gefunden werden, die Antwort muss noch geschrieben und das Ticket gelöst werden. Das Modell liefert die Ohren. Es liefert nicht das Teammitglied.
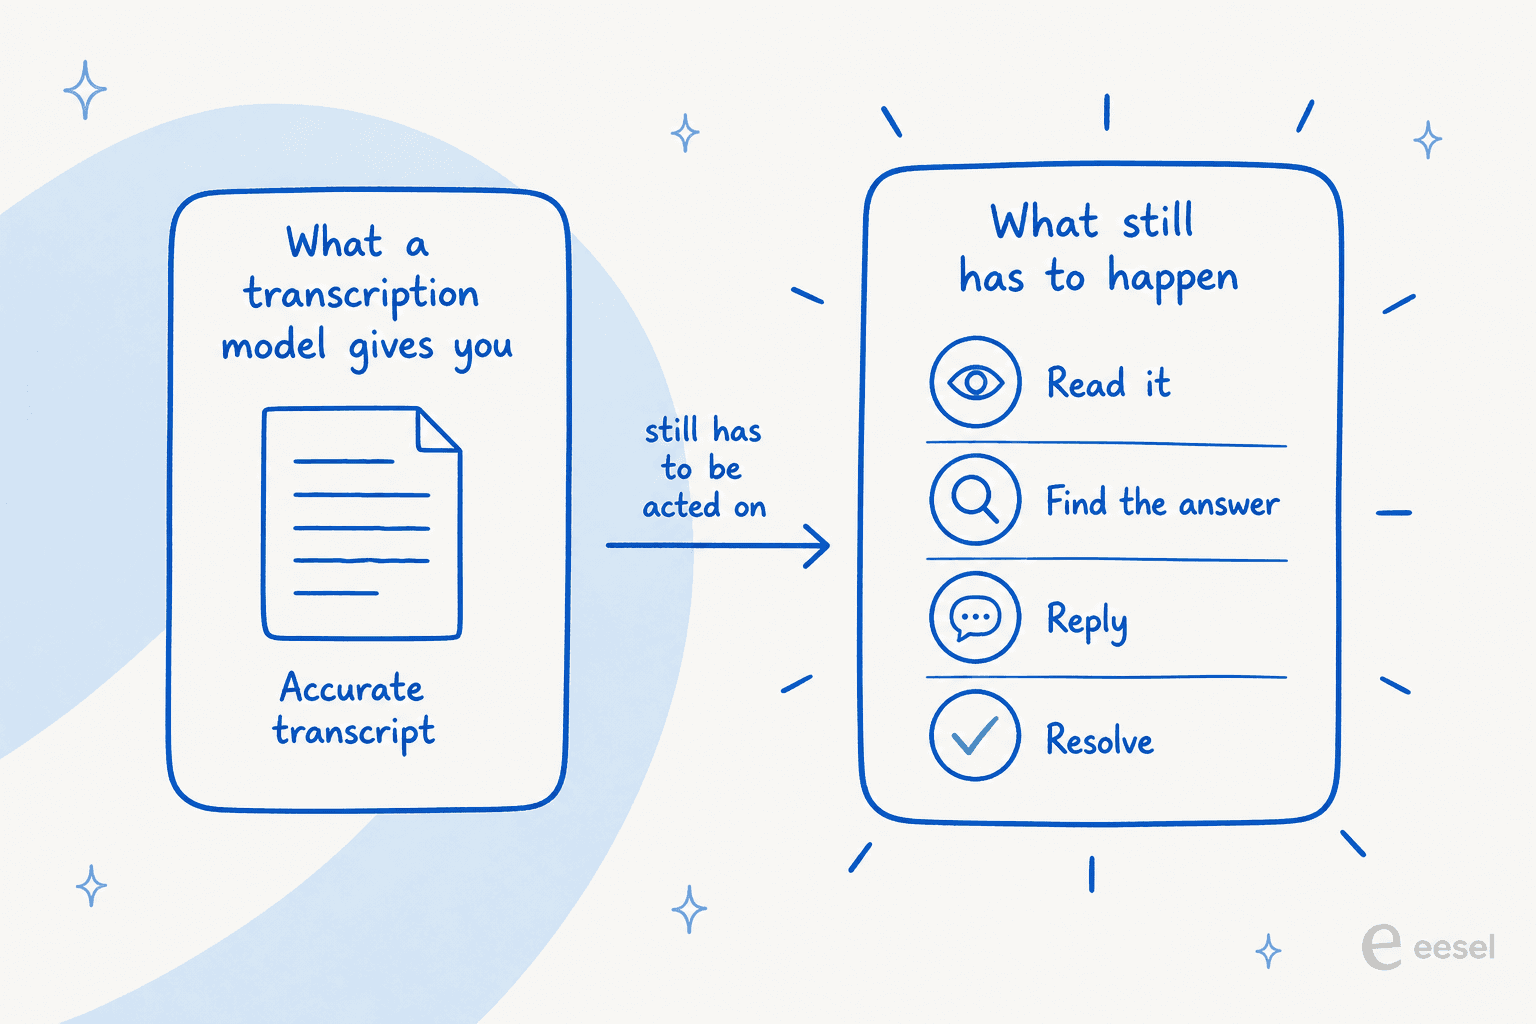
Das ist die ehrliche Grenze eines Modells wie MAI-Transcribe-2, und es ist keine Kritik. Es erledigt seine Aufgabe außerordentlich gut. Es ist nur eine andere Aufgabe als die Lösung des Gesprächs, und für ein Support-Team ist die zweite Aufgabe diejenige, die die Kennzahlen wirklich bewegt.
Wo eesel ins Spiel kommt
MAI-Transcribe-2 ist Infrastruktur. eesel ist der Mitarbeiter, der darauf arbeitet. Wir bauen KI-Teammitglieder, die Sie für eine bestimmte Aufgabe einstellen, und das KI-Helpdesk-Teammitglied setzt dort an, wo ein Transkriptionsmodell aufhört: Es liest den Text, holt die Antwort aus Ihrem Help Center und früheren Tickets und entwirft oder sendet die Antwort direkt in Zendesk, Freshdesk oder Slack. Kombinieren Sie beides, wird aus einem transkribierten Sprachticket ein gelöstes, nicht nur ein ordentlicher Absatz.

Und weil MAI-Transcribe-2 ein API-first-Modell ist, wollen die Entwickler, die danach greifen, meist dieselbe Kontrolle über ihre Support-Automatisierung. eesel hat dafür eine öffentliche CLI: Sie steuert dasselbe Teammitglied und denselben Workspace aus einem Terminal, sodass ein Mensch sie von Hand ausführen kann, ein Skript sie automatisieren kann und Coding-Agenten wie Claude Code oder Cursor sie headless bedienen können, ganz ohne Dashboard. Sie können Transkription an den Anfang dieser Pipeline setzen und eesel ans lösende Ende. Es ist kostenlos testbar, lässt sich in wenigen Minuten in Ihr Helpdesk einbinden und simuliert gegen Ihre echten früheren Tickets, bevor es je einem Kunden antwortet, sodass Sie sehen, wie es Ihre Warteschlange bearbeitet hätte, bevor Sie es loslassen.