

Cohere Parse 5 (parse-v5.0) ist ein kleines, kostenorientiertes Vision-Modell, das Dokumentseiten in sauberes Markdown für Suche, RAG und Agenten umwandelt. Es wurde am 27. August 2026 allgemein verfügbar.
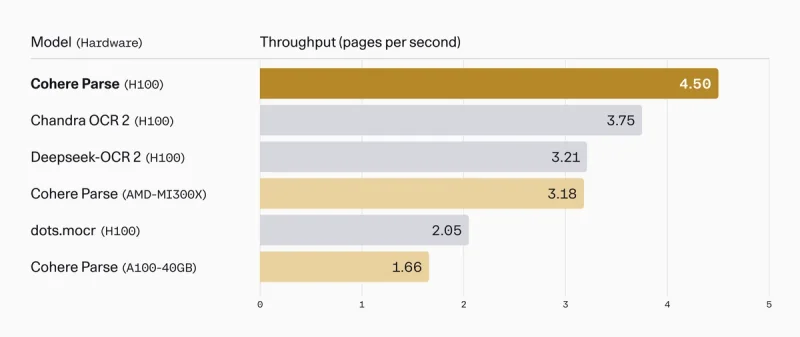
Das ehrliche Fazit: Parse 5 ist nicht der genaueste Parser auf dem Markt und will es auch nicht sein. Auf Coheres eigenem ParseBench erreicht es 79,2 und liegt damit hinter den Frontier-LLMs (GPT-5.5 mit 84,4, Opus 4.8 mit 84,3, Gemini 3.5 Flash mit 81,8), aber vor den meisten spezialisierten OCR-Tools. Es punktet bei Preis und Durchsatz: 1,50 $ pro 1.000 Seiten und 4,5 Seiten pro Sekunde, wobei Model Vault die Kosten pro Seite bei hohem Volumen weiter senkt.
Kaufen Sie es, wenn Sie Hunderttausende bis Millionen Seiten für eine RAG-Pipeline verarbeiten und planbare Kosten wollen. Vorsicht ist geboten, wenn Sie heute eine feste Integration brauchen (der Live-Endpunkt nimmt Bilder, keine PDFs), strukturierte JSON-Ausgabe oder Konfidenzwerte pro Feld, denn nichts davon bietet Parse 5. Und denken Sie daran: Parse ist nur der erste Schritt. Es liefert sauberen Text, keine Antworten.
Cohere Parse 5 kam mit einem sehr konkreten Versprechen auf den Markt. Nicht „der beste Dokumenten-Parser", sondern „das stärkste Preis-Leistungs-Profil auf dem Markt". Das ist eine erfrischende Aussage für einen Launch, und es ist zugleich die ganze Geschichte darüber, ob dieses Modell zu Ihnen passt.
Ich baue beruflich Integrationen und API-Anbindungen, und bei eesel habe ich viel Zeit mit dem unglamourösen Teil dieser Arbeit verbracht: unordentliche Unternehmensdokumente in eine Form zu bringen, die eine KI wirklich nutzen kann. Beim Parsing gewinnt oder verliert eine Retrieval-Pipeline unbemerkt. Ein Parser, der eine Preistabelle zerstört oder ein Formularfeld verliert, vergiftet jede nachgelagerte Antwort, und man merkt es meist erst, wenn ein Kunde die falsche Zahl genannt bekommt. Deshalb habe ich die Parse-5-Dokumentation so gelesen wie bei jedem Parser: nicht „wie gut ist die Demo", sondern „was geht in der Produktion kaputt".
Das habe ich gefunden.
Was Cohere Parse 5 eigentlich ist
Parse ist der Einstieg von Cohere in die Dokumentenintelligenz für Unternehmen. Der Produkt-Einzeiler lautet „Verwandeln Sie Ihre Unternehmensdokumente in KI-fertige Daten", und technisch bedeutet das: Es wandelt komplexe, multimodale Dateien (Tabellen, Formulare, Diagramme, eingebettete Bilder) in strukturiertes, maschinenlesbares Markdown um, das Sie in Indexierung, Retrieval und Agenten-Workflows einspeisen können.
Die Details zählen, denn „Vision-Sprachmodell für Dokumente" deckt vieles ab. Laut Modelldokumentation ist parse-v5.0 ein Modell mit 2,3 Mrd. Parametern, rund 4,6 GB groß, mit 8.192 Token Kontext, aufgebaut auf Coheres Architektur north-micro-vision-instruct. Das ist ein bewusst kleines Modell. Cohere sagt offen, dass die Frontier-LLMs, mit denen es verglichen wird, „jeweils Allzweckmodelle und deutlich größer als Parse" sind. Klein zu sein ist der Punkt: Nur so funktionieren Preis und Durchsatz.
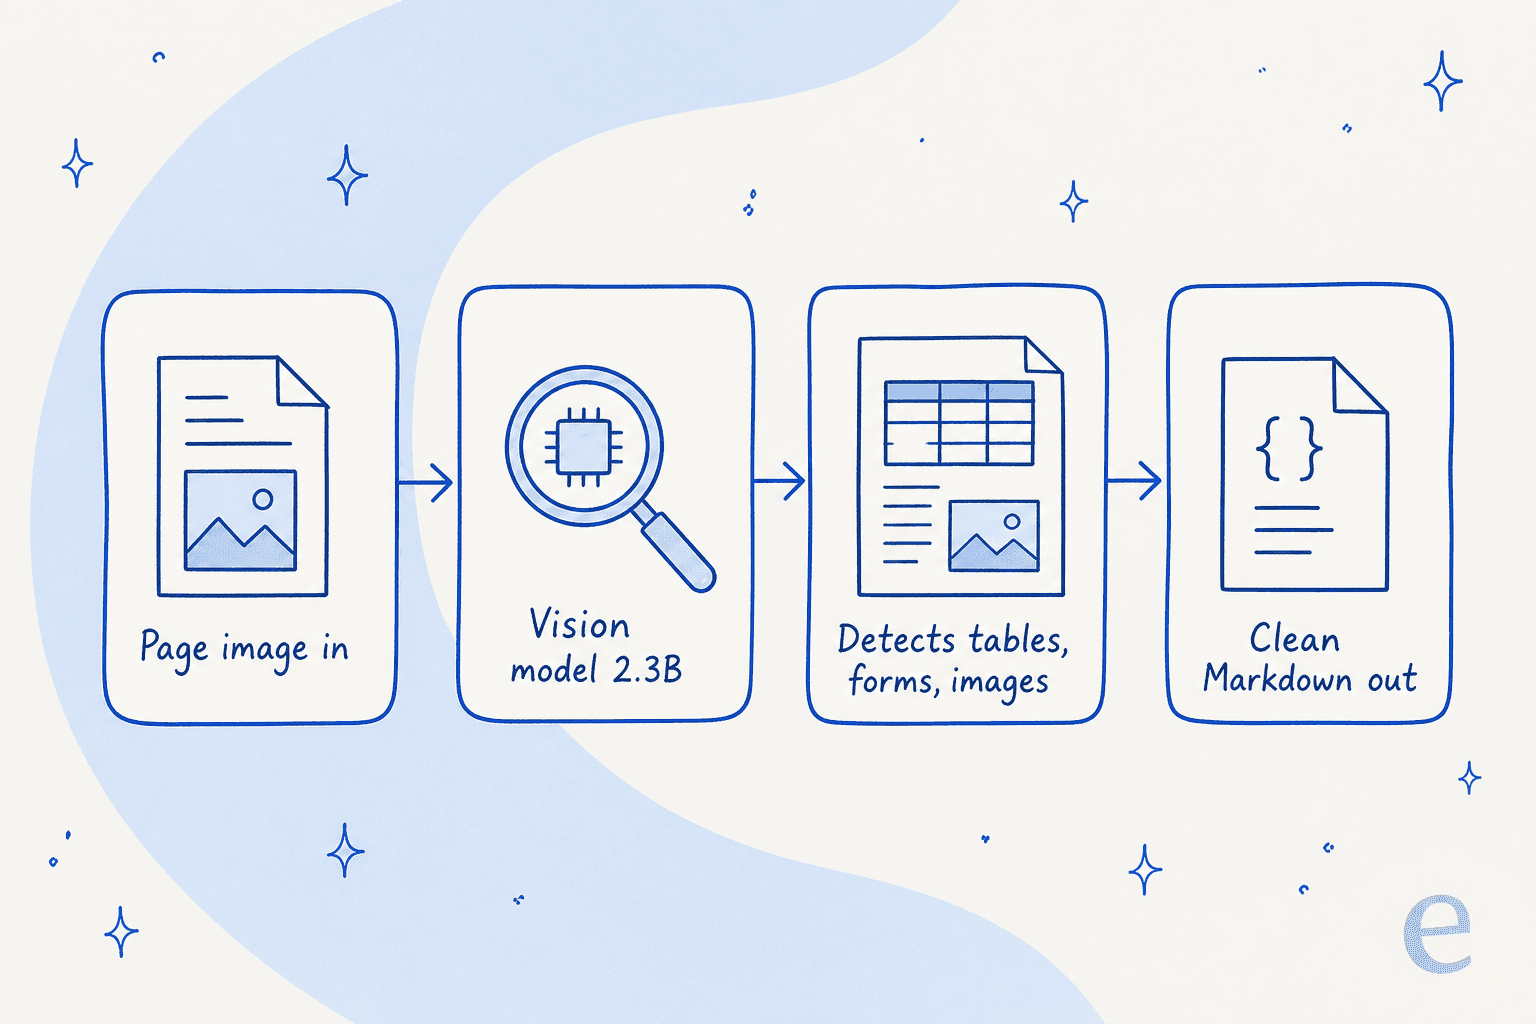
Der Ablauf ist einfach. Sie geben ihm ein Seitenbild, es erkennt die visuelle Struktur und liefert sauberes Markdown, in dem Tabellen als HTML eingebettet sind, plus Begrenzungsrahmen für die visuellen Elemente.
Der Benchmark: stark, aber nicht an der Spitze
Cohere hat mit ParseBench einen eigenen Benchmark gebaut, um die „agententaugliche Parsing-Leistung" in drei Dimensionen zu messen: Tabellenextraktion, inhaltliche Treue (Auslassungen, Halluzinationen, kaputte Lesereihenfolge) und semantische Formatierung (Stile, die die Bedeutung ändern, etwa Durchstreichungen).
Parse kommt auf 79,2 im Durchschnitt der drei Dimensionen, und die Form dieses Werts ist interessant. Es ist bei Tabellen (87,0) und inhaltlicher Treue (86,6) wirklich stark und bei semantischer Formatierung (64,0) schwächer. Es liest und strukturiert Ihre Inhalte also zuverlässig, geht aber weniger sorgfältig mit Nuancen wie Kursivschrift oder Durchstreichungen um, die gelegentlich die Bedeutung des Textes verändern.
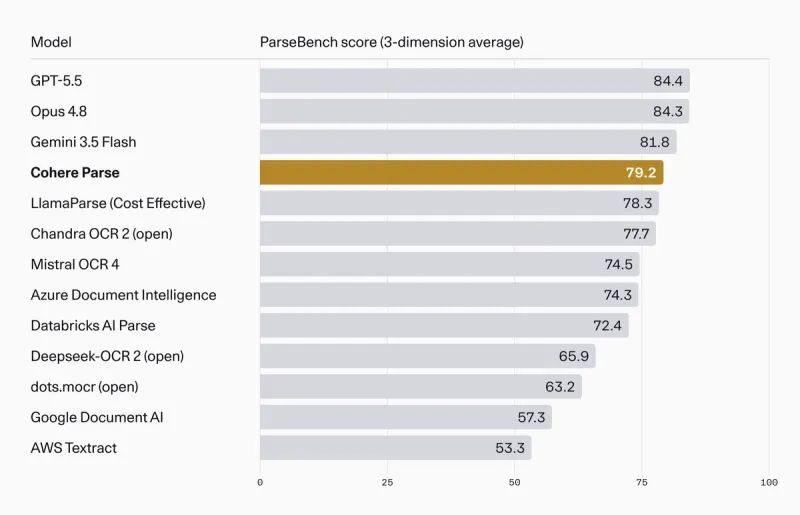
Liest man das Diagramm ehrlich, stimmen zwei Dinge gleichzeitig. Parse wird von den drei Frontier-Modellen geschlagen: GPT-5.5 (84,4), Opus 4.8 (84,3) und Gemini 3.5 Flash (81,8). Und Parse schlägt jeden spezialisierten Parser, den Cohere getestet hat, darunter die kostengünstige Stufe von LlamaParse (78,3), Chandra OCR 2 (77,7), Mistral OCR 4 (74,5) und Databricks AI Parse (72,4). Gegenüber den klassischen Cloud-OCR-Diensten ist der Abstand groß: Cohere nennt eine Verbesserung von über 20 Punkten sowohl gegenüber AWS Textract (53,3) als auch Google Document AI (57,3).
Eine Einschränkung sollte man nennen: Es ist der Benchmark des Anbieters, und das Modell, das er verkauft, gewinnt in der preisbereinigten Betrachtung. Das macht die Zahlen nicht falsch, aber deshalb ist das nächste Diagramm nützlicher, in dem die Genauigkeit gegen die Kosten aufgetragen ist.
Durchsatz und Preis: Hier gewinnt Parse wirklich
Das ist das ganze Argument für Parse, daher lohnt es sich, hier langsamer zu werden.
Beim Preis verlangt die Cohere API 1,50 $ pro 1.000 Seiten. Beim Durchsatz verarbeitet das Modell 4,5 Seiten pro Sekunde; Cohere gibt auf einem 8×H100-Knoten 36 Seiten pro Sekunde (2.160 Seiten pro Minute) an, etwa das 1,4-Fache des Durchsatzes von RedNotes dots.mocr und das 2,2-Fache von Chandra OCR 2 auf derselben Hardware, alles betrieben mit vLLM.
Trägt man Genauigkeit und Preis auf denselben Achsen auf, wird Parses wahre Position sichtbar. Im ParseBench-Pareto-Diagramm liegt es im günstigen, hochbewerteten Quadranten, während die Frontier-LLMs einige Punkte mehr Genauigkeit zum 30- bis 50-Fachen der Kosten pro Seite liefern.
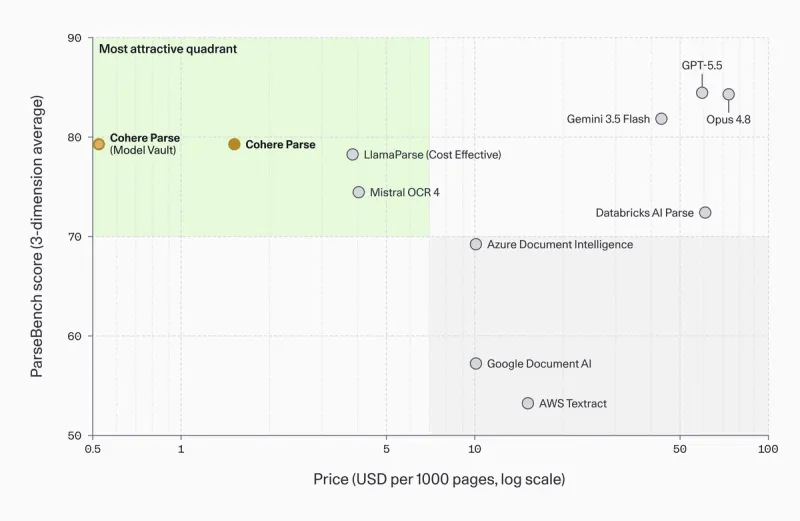
Die Einsparungen werden bei hohem Volumen konkreter. Coheres Rechenbeispiel: Ein Kreditorenbuchhaltungs-Workflow, der etwa 13 Millionen Seiten pro Monat auf Model Vault statt über die API verarbeitet, spart rund 12.000 $ pro Monat, also 144.000 $ pro Jahr. Gegenüber einem Hyperscaler-Parser zu 10 $ pro 1.000 Seiten würde derselbe einzelne Workflow jährlich etwa 1,47 Millionen $ sparen. Solche Zahlen bringen eine Parsing-Entscheidung auf den Tisch der Finanzabteilung, und genau dafür gibt es Parse.
Cohere Parse 5: Preise im Überblick
Parse wird über mehrere Wege verkauft, und der günstigste hängt davon ab, wie gleichmäßig Sie es auslasten. Hier das ganze Bild.
| Zugangsweg | Was Sie bekommen | Preis |
|---|---|---|
| Cohere API | Verwalteter Endpunkt, Bezahlung pro Seite, keine Infrastruktur | 1,50 $ pro 1.000 Seiten |
| Model Vault (50 % GPU-Auslastung) | Single-Tenant-Instanz mit Stundenabrechnung | ca. 23 % unter API |
| Model Vault (volle Auslastung) | Single-Tenant-Instanz mit Stundenabrechnung | bis zu 61 % unter API |
| Microsoft Foundry | Modell Cohere-parse-v5 in Azure | Azure-Instanzpreise |
| Amazon SageMaker | Marketplace-Bereitstellung | AWS-Instanzpreise |
| Hugging Face Space | Kostenlose Demo zum Ausprobieren | Kostenlos |
Meine Einschätzung: Die API ist die richtige Wahl für schwankende oder geringe Volumen, weil Sie nur die gesendeten Seiten bezahlen. Model Vault gewinnt, sobald Sie ein gleichmäßiges, hohes Volumen haben, das die Instanzen auslastet, also genau die Last in Kreditoren-Größenordnung, für die Parse gebaut ist. Wenn Ihr Volumen ungleichmäßig ist, rechnen Sie nach, bevor Sie sich auf eine dedizierte Instanz festlegen, denn Leerlauf der GPU frisst die Einsparung pro Seite schnell auf.
Wie sich das in Coheres breiteren Katalog und die Tarife einfügt, behandelt unsere Aufschlüsselung zu Cohere-AI-Preisen mit den Tarifen für Command, Embed und Rerank.
Was es extrahiert und was nicht
Ein Parser wird ebenso sehr durch das definiert, was er weglässt, wie durch das, was er erfasst, und Parse hat einige scharfe Kanten, die Sie kennen sollten, bevor Sie darauf aufbauen.
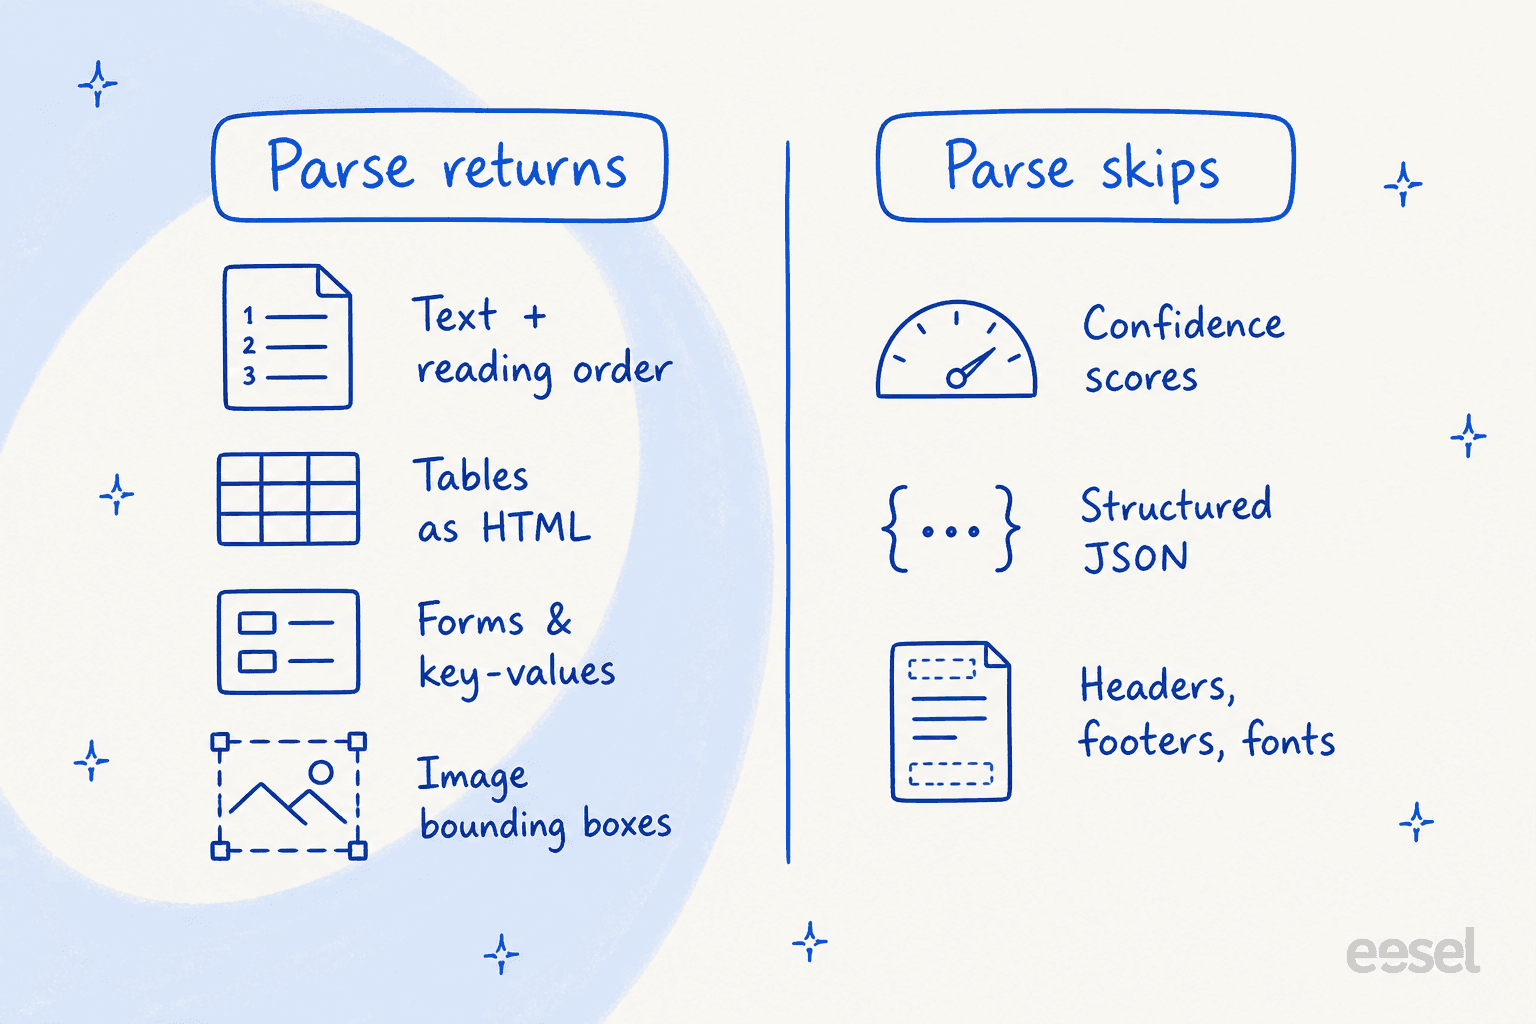
Positiv: Parse liefert Text in korrekter Lesereihenfolge, Tabellen als HTML, Formulare und Schlüssel-Wert-Paare sowie Bildbeschreibungen mit Begrenzungsrahmen. Das ist ein solider Funktionsumfang, um eine Wissensdatenbank oder einen KI-Wissensdatenbank-Chatbot zu füttern.
Die Grenzen, direkt aus der Dokumentation, verdienen Ihre Aufmerksamkeit:
- Keine Konfidenzwerte. Sie können Parse nicht fragen, wie sicher es sich bei einer Extraktion ist, was automatisierte Qualitätskontrollen erschwert. In einem Kreditoren- oder Schadensfall-Ablauf ist das eine echte Lücke.
- Nur Markdown, kein strukturiertes JSON. Wenn Ihre Pipeline von Haus aus typisierte Felder erwartet, müssen Sie das Markdown selbst nachbearbeiten.
- Keine Erkennung von Kopf- und Fußzeilen oder Schrifthierarchie. Es liest den Inhalt, kennzeichnet aber weder Dokumentbeiwerk noch Überschriftenebenen.
- Begrenzungsrahmen nur für Tabellen und Bilder. Laut Fußnote 2 des Launches gibt Parse keine Rahmen pro Element für Text aus. Cohere stellt das als bewusste Entscheidung für die Lesereihenfolge dar, nicht als Fehler, und für die meisten RAG-Anwendungen spielt es keine Rolle, aber wenn Sie Koordinaten auf Wortebene brauchen, suchen Sie anderswo.
Keine davon ist ein K.-o.-Kriterium für den Ingestion-Einsatz, auf den Parse zielt. Sie sind es, wenn Sie gehofft hatten, Parse in ein Produkt zur strukturierten Dokumentenextraktion einzubauen, das typisierte Felder und Konfidenzprüfung braucht. Passen Sie das Werkzeug an die Aufgabe an.
Den API-Aufruf (und der eine Haken)
Die Entwicklererfahrung ist sauber. Sie installieren das SDK, erstellen einen Client und rufen co.parse in der Cohere-v2-API auf.
Der minimale Aufruf aus dem Quickstart ist so einfach, wie Parsing nur sein kann:
import base64, cohere

co = cohere.ClientV2("COHERE_API_KEY")

with open("document.png", "rb") as f:
    b64 = base64.b64encode(f.read()).decode("utf-8")
data_uri = f"data:image/png;base64,{b64}"

response = co.parse(
    model="parse-v5.0",
    document={"type": "image_url", "image_url": data_uri},
)

for page in response.pages:
    print(page.markdown.content)
Hier kommt der Haken, und er ist für jeden, der heute etwas bauen will, ein großer. Die Dokumentation nennt PDF, PPT und JPEG als unterstützte Typen, aber die API-Referenz ist eindeutig: Der Endpunkt unterstützt derzeit nur document.type = image_url, also eine Data-URI oder eine Bild-URL. Direkte PDF- und Datei-URL-Eingaben werden noch nicht unterstützt. In der Praxis rastern Sie Ihre PDF-Seiten also zuerst zu Bildern und senden sie einzeln. Die Bildgrenzen sind großzügig (20 MB Dateigröße, 50 Megapixel), und Sie können output_format auf blocks umstellen, wenn Sie statt flachem Markdown das geordnete Array aus Text-, Tabellen- und Bildbereichen mit ihren Begrenzungsrahmen wollen.
Die Sprachabdeckung umfasst neun Eingabesprachen, derzeit stabil: Arabisch, Englisch, Französisch, Deutsch, Japanisch, Koreanisch, Italienisch, Portugiesisch und Spanisch, mit Zero-Shot-Unterstützung für weitere Sprachen bei geringerer Genauigkeit.
Wo Parse hingehört: Es ist Schritt eins, nicht die ganze Pipeline
Das ist der Teil, den die meiste Launch-Berichterstattung überspringt. Parse wandelt Dokumente in sauberen Text um. Es bettet sie nicht ein, ruft sie nicht ab und beantwortet nichts. Es ist die Eingangstür einer Retrieval-Pipeline, nicht die Pipeline selbst.
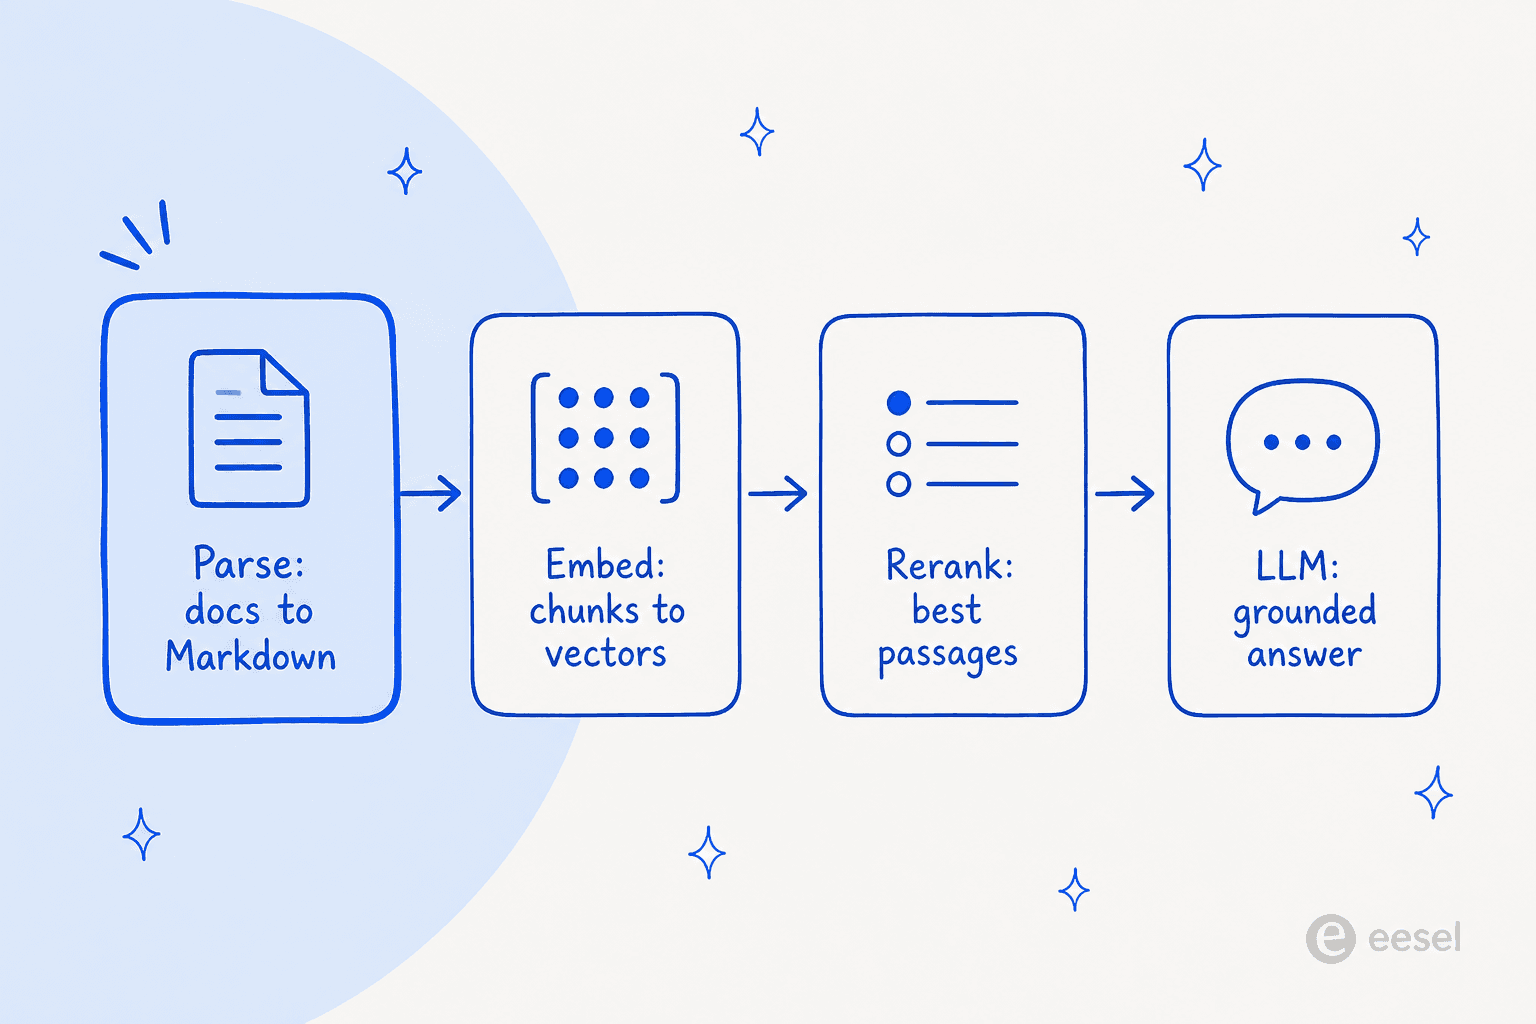
Cohere weiß das, weshalb Parse als Komponente von Compass, dem Stack für Dokumentenintelligenz und Suche, zusammen mit Embed und Rerank ausgeliefert wird. Wenn Sie bereits ganz auf Cohere setzen, ist dieser integrierte Weg wirklich bequem. Wenn nicht, lohnt es sich, Cohere-Alternativen abzuwägen, bevor Sie sich auf einen Stack festlegen.
Die einzige glaubwürdige externe Stimme, die ich zum Launch fand, machte denselben Punkt, dass Parsing schwieriger ist, als es aussieht. Der Enterprise-Tech-Journalist Sean Kerner formulierte es treffend:
"Text, document parsing should be a solved problem at this point right? But it's not.. every few weeks there is another option that claims to make it better. This week it's @cohere Parse 5."
Diese Skepsis ist berechtigt. Parse 5 ist eine gute Veröffentlichung, aber nur ein starker Parser in einem sich ständig bewegenden Feld, und es löst genau ein Glied einer Kette mit vier oder fünf Gliedern. Wenn Ihr eigentliches Ziel ist, Fragen aus Ihren Dokumenten zu beantworten, ist die Wahl eines Parsers der Anfang des Projekts, nicht das Ende.
Wer Cohere Parse 5 wirklich nutzen sollte
Nach der Durchsicht lande ich hier.
Greifen Sie zu Parse 5, wenn Sie große Mengen an Unternehmensdokumenten (denken Sie an Hunderttausende bis Millionen Seiten) in ein RAG- oder Wissensmanagement-System einspeisen, planbare Kosten pro Seite wollen und „nahe an der Frontier-Genauigkeit zu einem Bruchteil des Preises" der Kompromiss ist, den Sie wollen. Die Model-Vault- und On-Prem-Option macht es außerdem zu einer starken Wahl für regulierte Branchen, die Dokumente nicht an eine öffentliche API senden dürfen.
Verzichten Sie vorerst, wenn Sie heute direkte PDF-Aufnahme, strukturierte JSON-Ausgabe, Konfidenzwerte pro Feld oder die letzten Punkte Formatierungsgenauigkeit brauchen, die nur ein Frontier-Modell liefert. Und verzichten Sie, wenn Sie eigentlich Antworten statt sauberem Text wollten, denn ein Parser allein bringt Sie nicht dorthin.
eesel: wenn Sie Antworten wollen, nicht nur geparsten Text
Wenn Sie bei Parse 5 gelandet sind, weil eine KI wirklich Fragen aus den Dokumenten Ihres Unternehmens beantworten soll (Support-Tickets, Hilfeartikel, interne Wikis), lohnt es sich zu benennen, was der Parser nicht leistet. Parse liefert sauberes Markdown. Embedding, Retrieval, Ranking und die Antwortschicht müssen Sie selbst darüber bauen und dann aktuell halten, wenn sich Ihre Inhalte ändern.
eesel ist die einsatzbereite Version dieser gesamten Pipeline. Statt Infrastruktur, die Sie zusammenbauen, ist es ein KI-Helpdesk-Teammitglied, das Sie einstellen: Es verbindet sich mit Ihrem Help Center, früheren Tickets und Tools wie Zendesk oder Confluence, lernt den Kontext Ihres Unternehmens und beantwortet echte Kunden- und Mitarbeiterfragen. Es gehört zu den besten KI-Helpdesk-Optionen, gerade weil die gesamte Pipeline für Sie erledigt ist. Parse 5 ist ein Baustein; eesel ist die fertige Lösung.

Der Teil, den ich hervorheben würde, weil ich ihn mir in jeder Parsing-zuerst-Pipeline wünsche: Mit eesel können Sie einen Rollout simulieren, und zwar anhand Ihrer eigenen historischen Tickets, bevor es je einem Live-Kunden antwortet. So sehen Sie die echte Lösungsquote und die genauen Antworten auf Ihren tatsächlichen Inhalten, nicht in einer Demo. Das ist der Unterschied zwischen dem Ausliefern eines Parsers und dem Ausliefern von etwas, dem Sie vertrauen. Sie können eesel kostenlos ausprobieren.
Häufig gestellte Fragen
Was ist Cohere Parse 5?
parse-v5.0) ist ein Vision-Modell mit 2,3 Mrd. Parametern, das Dokumentseiten in sauberes, maschinenlesbares Markdown für Suche, RAG und KI-Agenten umwandelt. Es wurde am 27. August 2026 allgemein verfügbar und positioniert sich über das Preis-Leistungs-Verhältnis statt über Spitzengenauigkeit.