

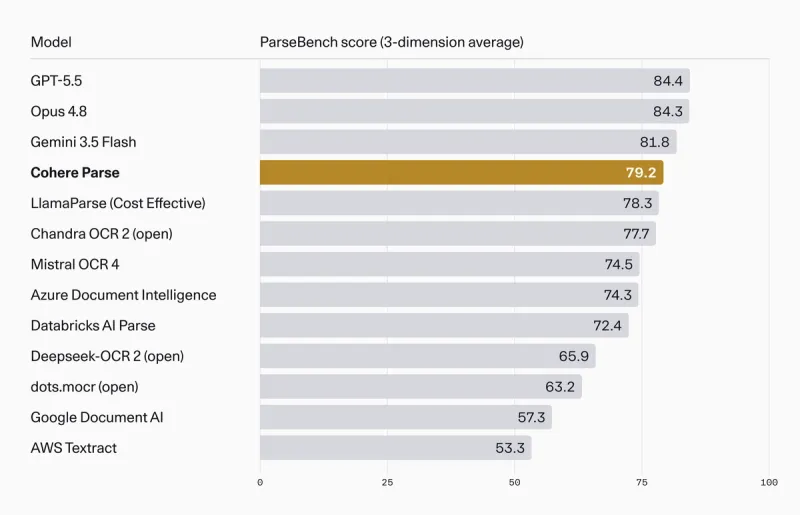
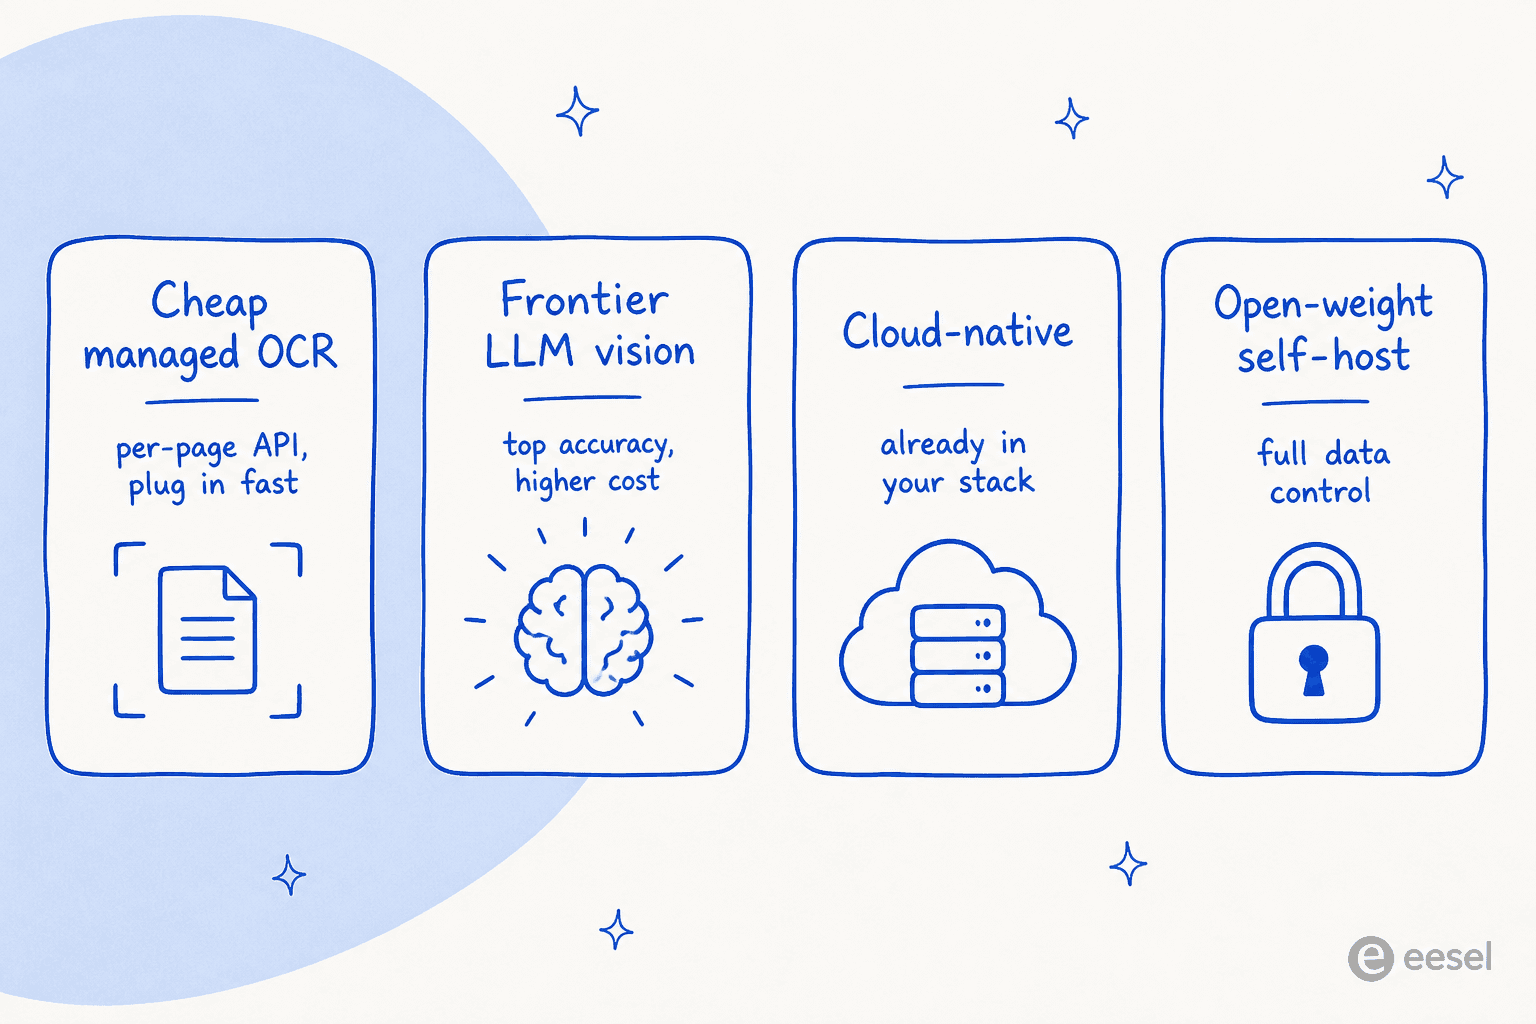
Cohere Parse 5 (parse-v5.0) ist ein starker, günstiger Dokumenten-Parser: Er wandelt Seiten für 1,50 $ pro 1.000 Seiten in sauberes Markdown um und erreicht 79,2 auf der ParseBench. Es gibt drei Gründe, nach Alternativen zu suchen: höhere Genauigkeit, ein Tool innerhalb einer Cloud, die man ohnehin bezahlt, oder Self-Hosting für mehr Datenkontrolle.
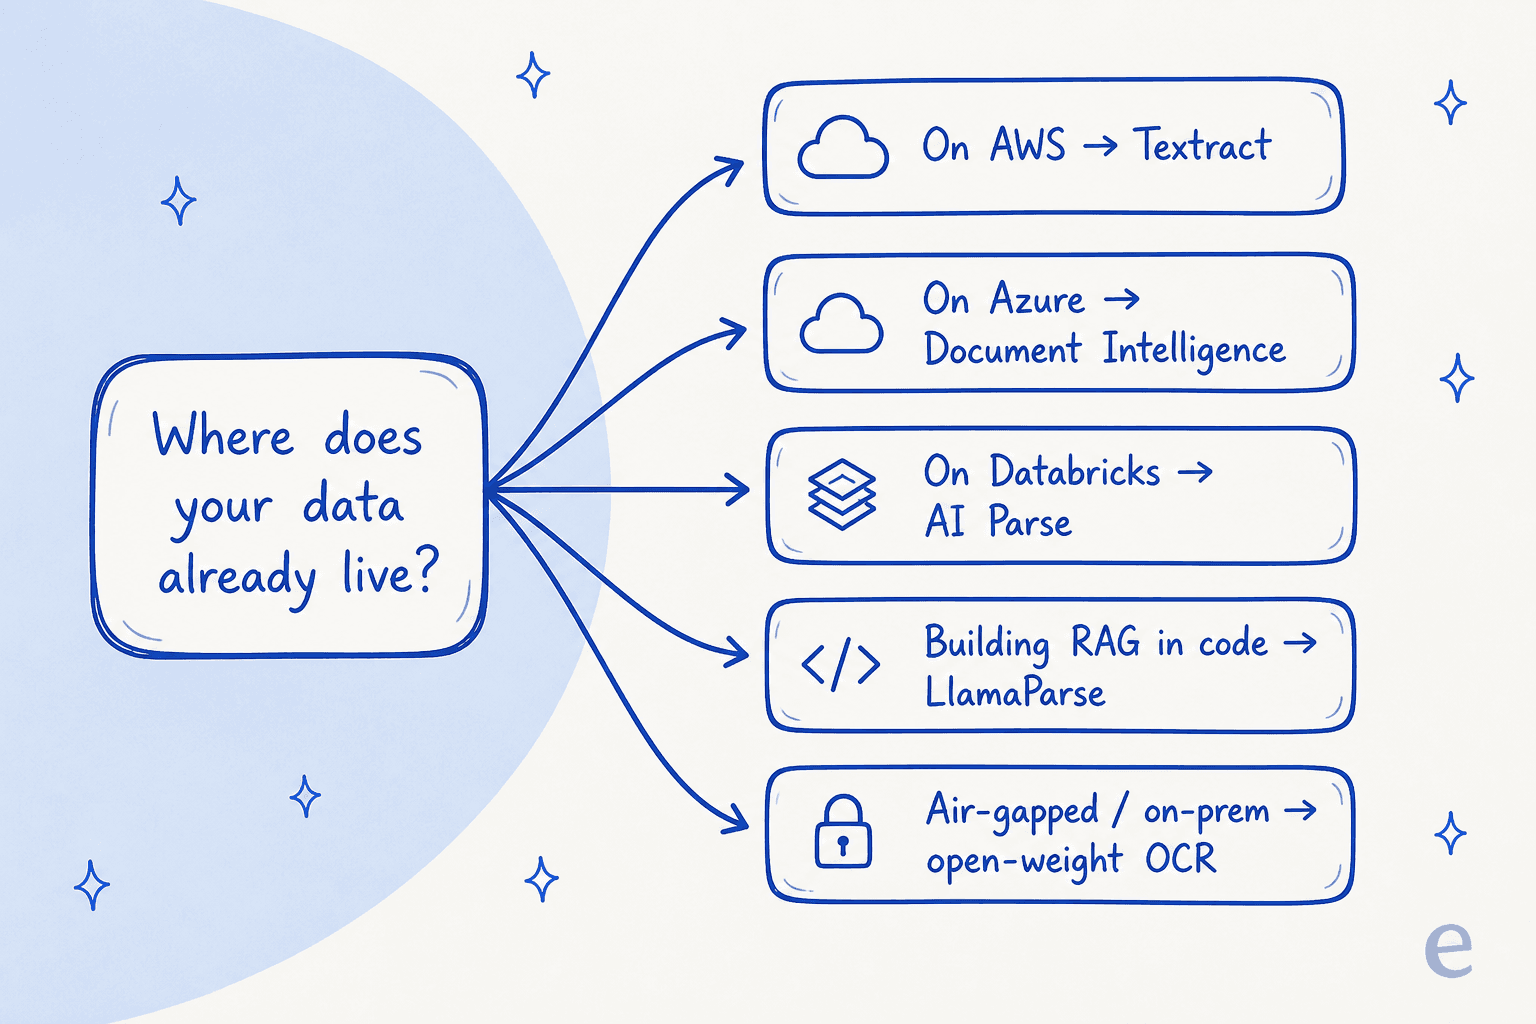
Hier die Kurzfassung, wohin Sie gehen können:
- Beste Genauigkeit, egal was es kostet? Ein Frontier-Modell, GPT-5.5 (84,4) oder Gemini 3.5 Flash (81,8), führt die Tabelle an.
- Eine Pro-Seite-API wie Parse? Mistral OCR ist der engste Ersatz.
- RAG im Code bauen? LlamaParse fügt sich in den LlamaIndex-Stack ein.
- Schon auf AWS, Azure oder Databricks? Nutzen Sie den nativen Parser (Textract, Document Intelligence, AI Parse) und sparen Sie sich einen Anbieter.
- Volle Datenkontrolle nötig? Hosten Sie ein Open-Weight-OCR-Modell selbst.
Vorab noch eins: Jedes Tool auf dieser Liste wandelt Dokumente nur in Text um. Wenn Ihr eigentliches Ziel ist, Fragen aus diesen Dokumenten zu beantworten, ist Parsing Schritt eins von vier. Hier kommt ein einsatzbereiter KI-Helpdesk-Agent wie eesel ins Spiel, der die ganze Kette statt nur des ersten Glieds übernimmt.
Warum überhaupt über Cohere Parse 5 hinausschauen?
Zuerst fair zu Parse, denn es ist ein wirklich gutes Release. Cohere hat es am 27. August 2026 veröffentlicht, als „ein Vision-Parsing-Modell mit hohem Durchsatz und dem stärksten Preis-Leistungs-Profil am Markt“, und die Zahlen stützen diese Darstellung. Es verarbeitet 4,5 Seiten pro Sekunde, liefert sauberes Markdown, das direkt in eine RAG-Pipeline passt, und kostet pauschal 1,50 $ pro 1.000 Seiten. Wenn Sie Hunderttausende Seiten pro Monat einlesen, ist dieses Preis-Leistungs-Argument schwer zu entkräften. Ich bin in unserem ausführlichen Cohere-Parse-5-Test auf all das eingegangen.
Warum also vergleicht trotzdem jemand? Drei echte Gründe tauchen immer wieder auf.
Genauigkeit. Parse ist ausdrücklich auf Preis-Leistung positioniert, nicht darauf, der genaueste Parser zu sein. In der ParseBench erreicht es 79,2 und wird „nur von den Frontier-LLMs übertroffen“ (GPT-5.5, Opus 4.8, Gemini 3.5 Flash). Bei unübersichtlichen, dichten Dokumenten oder verschachtelten Tabellen zählen diese zusätzlichen Punkte, und vielleicht zahlen Sie dafür gern mehr pro Seite.
Passung zum Stack. Liegen Ihre Daten schon in AWS, Azure oder Databricks, bedeutet Cohere einen weiteren Anbieter, einen weiteren Schlüssel, eine weitere Rechnung und einen weiteren Auftragsverarbeitungsvertrag. Der native Parser Ihrer Cloud ist oft „gut genug“ und erspart den ganzen Aufwand.
Eingabegrenzen und Datenkontrolle. Der Live-Endpunkt von Parse akzeptiert derzeit nur Bildeingaben, PDFs müssen also zuerst in Bilder umgewandelt werden, und es ist eine verwaltete API. Teams in regulierten Branchen wollen häufig direkte PDF-Verarbeitung oder ein Modell, das sie komplett auf eigener Hardware betreiben. Einige Alternativen bieten beides.
Nichts davon ist Kritik an Parse. Es sind einfach die Stellen, an denen ein anderes Tool besser passt. So gliedert sich der Markt.
Wie ich diese Alternativen ausgewählt und verglichen habe
Jedes Tool hier erledigt dieselbe Kernaufgabe wie Parse: Es nimmt Dokumentseiten und liefert strukturierten, maschinenlesbaren Text oder Markdown. Ich habe sie nach vier Kriterien eingeordnet, die Käufer wirklich interessieren:
- Genauigkeit - wo es auf der ParseBench landet, dem Benchmark, den Cohere selbst nutzte, damit der Vergleich fair bleibt.
- Kostenmodell - pro Seite, pro Token oder auf eigener Rechenleistung, und was das bei Volumen ergibt.
- Bereitstellung - verwaltete API, innerhalb einer bereits genutzten Cloud oder selbst gehostet.
- Eingabeverarbeitung - nur Bilder, PDFs direkt oder viele Dateitypen.
Hier das ganze Feld auf einen Blick. Die ParseBench-Werte stammen direkt aus Coheres veröffentlichter Tabelle.
| Tool | ParseBench-Schnitt | Am besten für | Bereitstellung | Eingabe | Kostenmodell |
|---|---|---|---|---|---|
| Cohere Parse 5 | 79,2 | Günstiges Parsing mit hohem Volumen | API, Model Vault, Cloud-Marktplätze | Bilder | 1,50 $ / 1.000 Seiten |
| GPT-5.5 | 84,4 | Schwierigste Dokumente, höchste Genauigkeit | API | Bilder, PDFs (über LLM) | Pro Token |
| Opus 4.8 | 84,3 | Höchste Genauigkeit, langer Kontext | API | Bilder, PDFs (über LLM) | Pro Token |
| Gemini 3.5 Flash | 81,8 | Günstiges Parsing auf Frontier-Niveau | API | Bilder, PDFs (über LLM) | Pro Token |
| LlamaParse | 78,3 | Codebasierte RAG-Pipelines | API / Cloud | PDFs, Office, Bilder | Credits pro Seite |
| Mistral OCR 4 | 74,5 | Pro-Seite-API mit Self-Hosting | API, Self-Hosting | Bilder, PDFs | 4 $ / 1.000 Seiten |
| Databricks AI Parse | 72,4 | Teams im Lakehouse | In Databricks | PDFs, Bilder | DBUs |
| Azure Document Intelligence | 69,3 | Strukturierte Formulare, vorgefertigte Modelle | Azure | PDFs, Bilder | Pro 1.000 Seiten |
| AWS Textract | 53,3 | AWS-native, regulierte Stacks | AWS | PDFs, Bilder | Pro 1.000 Seiten |
| Unstructured | Nicht in der ParseBench | Offene Ingestion, viele Dateitypen | API, Open Source | 25+ Dateitypen | Pro Seite / Open Source |
Ein kurzer Hinweis zum Lesen der Tabelle: Ein niedrigerer ParseBench-Wert ist nicht automatisch „schlechter für Sie“. Textract steht in diesem allgemeinen Benchmark ganz unten, ist aber trotzdem eine völlig sinnvolle Wahl, wenn Sie in einem AWS-Umfeld nur sauberen Text aus Standard-PDFs brauchen. Wählen Sie das Tool nach der Aufgabe, nicht nach der Bestenliste.
1. LlamaParse
Am besten für: Teams, die eine RAG-Pipeline im Code bauen und bereits im LlamaIndex-Ökosystem arbeiten.
LlamaParse ist der Parsing-Dienst von LlamaIndex, dem beliebten Open-Source-Framework für LLM-Apps über eigene Daten. Es ist genau für die Aufgabe gebaut, auf die Parse zielt: komplexe PDFs, Foliensätze und Tabellen in sauberes, chunk-fertiges Markdown für das Retrieval umzuwandeln. In der ParseBench erreicht das Cost-Effective-Angebot 78,3, praktisch gleichauf mit den 79,2 von Parse.
Funktionen. LlamaParse nimmt PDFs, Office-Dateien und Bilder direkt entgegen (ohne Bildkonvertierung), bietet mehrere Parsing-Modi, die Kosten gegen Tiefe abwägen, und fügt sich direkt in eine LlamaIndex-Retrieval-Pipeline ein. Es verarbeitet Tabellen, eingebettete Bilder und mehrspaltige Layouts und kann pro Dokument natürlichsprachigen Parsing-Anweisungen folgen.
Vorteile. Wenn Sie ohnehin Python schreiben und LlamaIndex nutzen, ist das die reibungsloseste Option auf der Liste. Direkte PDF- und Office-Unterstützung spart echte Entwicklungszeit, und die 10.000 kostenlosen Credits pro Monat machen Prototypen ohne Kosten möglich.
Nachteile. Es ist ein Entwickler-Tool, kein Klick-Produkt. Das Credit-Modell erfordert kurz Nachdenken, da verschiedene Parsing-Modi unterschiedlich viele Credits pro Seite verbrauchen. Und die Retrieval- und Antwortschichten bauen Sie weiterhin selbst.
Preise. LlamaParse rechnet in Credits ab: 1.000 Credits kosten 1,25 $, und einfaches Parsing beginnt bei 1 Credit pro Seite (die layoutbewussten Agentic-Modi kosten mehr). Der Gratis-Tarif enthält 10.000 Credits pro Monat, und ein Auto-Modus leitet jede Seite an die günstigste Stufe, die die Aufgabe erledigt.
Fazit: die natürliche Wahl, wenn Sie RAG im Code bauen und Parsing möchten, das in den Rest Ihres Stacks einrastet. Wenn Sie nicht ohnehin in der LlamaIndex-Welt sind, ist die Ökosystem-Bindung ein Grund, anderswo zu suchen.
2. Mistral OCR
Am besten für: Teams, die die einfache Pro-Seite-API-Erfahrung von Parse von einem anderen Anbieter wollen, mit Self-Hosting-Option.
Mistral OCR ist der engste philosophische Verwandte von Cohere Parse: ein dediziertes OCR-Modell mit hohem Durchsatz, verkauft als schlanke Pro-Seite-API. Mistral positioniert es als Dokumentenverständnis, das strukturiertes Markdown mit erhaltenen Tabellen und Bildern liefert, von einem Modell, das Sie auch selbst betreiben können. In der ParseBench erreicht Mistral OCR 4 74,5, eine Stufe unter Parse, aber noch vor den meisten Cloud-nativen Optionen.
Funktionen. Es verarbeitet Bilder und PDFs direkt, extrahiert Tabellen und eingebettete Abbildungen, unterstützt viele Sprachen und liefert Markdown, das für die nachgelagerte Indexierung gebaut ist. Mistral bietet zudem Self-Hosting für Teams, deren Dokumente auf der eigenen Infrastruktur bleiben müssen.
Vorteile. Schnell und denkbar einfach zu integrieren, wenn Sie schon einmal eine API im OpenAI-Stil aufgerufen haben. Die Self-Hosting-Option ist ein echter Unterschied zum rein verwalteten Endpunkt von Parse, und die europäische Datenresidenz spricht Teams mit EU-Compliance-Anforderungen an.
Nachteile. Es liegt in der ParseBench hinter Parse und den Frontier-Modellen, besonders bei der semantischen Formatierung, und das aktuelle Modell ist nicht mehr das Preisschnäppchen, das das ursprüngliche war. Bei den dichtesten Finanz- oder Wissenschaftsdokumenten kann sich die Genauigkeitslücke in gelegentlich kaputten Tabellen zeigen.
Preise. Das aktuelle Mistral OCR 4 kostet 4 $ pro 1.000 Seiten, im Batch-API 2 $ pro 1.000; die No-Code-Schicht Document AI kostet 5 $ pro 1.000. Das liegt über dem Pauschalpreis von 1,50 $ bei Parse, der Wechsel kostet Sie also etwas mehr pro Seite.
Fazit: Wenn Ihnen die Idee von Parse gefällt, Sie aber eine zweite Quelle, EU-Datenresidenz oder einen Self-Hosting-Weg wollen, ist Mistral OCR der direkteste Ersatz. Sie tauschen allerdings ein paar Genauigkeitspunkte ein und zahlen etwas mehr pro Seite.
3. GPT-5.5
Am besten für: die unübersichtlichsten, wertvollsten Dokumente, bei denen Genauigkeit wichtiger ist als die Rechnung pro Seite.
Sie müssen gar keinen eigens gebauten Parser verwenden. Ein multimodales Frontier-Modell wie GPT-5.5 kann ein Seitenbild lesen und strukturierten Text zurückgeben, und es führt mit 84,4 die gesamte ParseBench-Tabelle an, über fünf Punkte vor Parse. Cohere selbst räumt ein, dass Parse „nur von den Frontier-LLMs übertroffen wird“, und GPT-5.5 ist eines davon.
Funktionen. Als Allzweckmodell transkribiert GPT-5.5 nicht nur, es denkt über eine Seite nach. Sie können es bestimmte Felder extrahieren lassen, komplexe Formatierungsregeln befolgen oder ein nie gesehenes Layout bewältigen, alles in einem Aufruf. Es liest Bilder und, über die API, PDFs.
Vorteile. Die beste Genauigkeit im Benchmark und unübertroffene Flexibilität. Wenn ein Dokument ein ungewöhnliches Layout hat, an dem ein Parser mit festem Schema scheitert, kommt ein LLM oft einfach damit klar. Es ist zudem wahrscheinlich dasselbe Modell, das Sie schon anderswo nutzen, also kein neuer Anbieter.
Nachteile. Kosten. Sie zahlen pro Token, und eine dichte Seite kann viele Token bedeuten, sodass es bei Millionen Seiten im Vergleich zum Pauschalpreis pro Seite von Parse schnell teuer wird. Es ist außerdem pro Seite langsamer, und allgemeine Modelle können Inhalte halluzinieren, wozu ein schmales OCR-Modell weniger neigt.
Preise. Pro Token, abgerechnet nach Ein- und Ausgabe, die Kosten skalieren also mit der Seitenkomplexität statt mit einer festen Zahl pro Seite. OpenAIs aktuelles Flaggschiff GPT-5.6 Sol kostet 4 $ pro Million Eingabe-Token und 20 $ pro Million Ausgabe-Token zum Aktionspreis, mit günstigeren Geschwistern (Luna mit 0,20 $ / 1,20 $) für leichtere Aufgaben. Eine dichte Seite verbraucht viele Token, bei Millionen Seiten summiert sich das schnell.
Fazit: Greifen Sie zu GPT-5.5, wenn die Dokumente wertvoll und in geringer Menge anfallen oder die Layouts zu vielfältig für einen festen Parser sind. Bei hohem Volumen und vorhersehbaren Seiten macht die Token-Rechnung einen dedizierten Parser wie Parse zum klügeren Kauf.
4. Gemini 3.5 Flash
Am besten für: Teams, die Parsing-Genauigkeit auf Frontier-Niveau ohne den vollen Frontier-Modell-Preis wollen.
Gemini 3.5 Flash ist Googles schnelles, günstiges multimodales Modell und der Sweet Spot zwischen den beiden Extremen dieser Liste. Es erreicht 81,8 in der ParseBench, schlägt damit Parse und jeden Cloud-nativen Parser und ist pro Token weit günstiger als ein Flaggschiff wie GPT-5.5 oder Opus 4.8.
Funktionen. Wie GPT-5.5 ist es ein allgemeines Modell, das Seitenbilder und PDFs liest und auf Anweisung strukturierte Daten extrahiert. Flash ist auf Tempo und niedrige Kosten getrimmt, mit einem großen Kontextfenster, das lange Dokumente in einem Rutsch erlaubt.
Vorteile. Eine seltene Kombination: höhere Genauigkeit als Parse und die Flexibilität eines LLM, zu einem Preis, der auch im großen Maßstab vernünftig bleibt. Wenn Sie ohnehin auf Google Cloud sind oder Vertex AI nutzen, ist die Integration trivial.
Nachteile. Weiterhin pro Token, also weniger vorhersehbar als ein Parser mit Pauschalpreis pro Seite, und bei wirklich riesigem Volumen kann Parse mit 1,50 $ pro 1.000 Seiten bei den Gesamtkosten immer noch gewinnen. Wie bei jedem LLM tragen Sie ein kleines Halluzinationsrisiko, das ein schmales OCR-Modell nicht hat.
Preise. Pro Token, zu Flashs niedrigen Tarifen. Das aktuelle Gemini 3.7 Flash kostet zum Aktionspreis 0,75 $ pro Million Eingabe-Token und 3,75 $ pro Million Ausgabe-Token, und es gibt eine wirklich kostenlose (ratenbegrenzte) Stufe für Prototypen. Das ist ein Bruchteil der Token-Kosten eines Flaggschiffs.
Fazit: meine Standardempfehlung für Teams, die mehr Genauigkeit als Parse wollen, aber vor Flaggschiff-Preisen zurückschrecken. Flash ist der Preis-Leistungs-Tipp der Frontier-Modell-Gruppe.
5. Databricks AI Parse
Am besten für: Datenteams, deren Dokumente bereits im Databricks-Lakehouse liegen.
Databricks AI Parse (ai_parse_document) ist Dokumenten-Parsing, das direkt in die Databricks-Plattform eingebaut ist und als SQL-Funktion über Daten aufgerufen wird, die Sie schon im Lakehouse haben. Es erreicht 72,4 in der ParseBench. Das Verkaufsargument ist nicht Spitzengenauigkeit, sondern null Datenbewegung.
Funktionen. Sie rufen das Parsing inline in einem SQL- oder Notebook-Workflow auf, und der extrahierte Text landet direkt wieder in Ihren Delta-Tabellen, bereit für nachgelagertes Wissensmanagement und Analysen. Kein separater Dienst, keine Daten, die die Plattform verlassen.
Vorteile. Wenn Ihre Pipeline schon auf Databricks läuft, ist das der Weg des geringsten Widerstands: kein neuer Anbieter, kein Egress, und die Governance übernimmt Unity Catalog. Um Dokumenten-Parsing mit dem Rest Ihres Data Engineering zu vereinen, ist nichts so nahtlos.
Nachteile. Es ergibt nur Sinn, wenn Sie ein Databricks-Betrieb sind; die Plattform nur fürs Parsen von Dokumenten aufzusetzen wäre absurd. Und mit 72,4 liegt es beim allgemeinen Parsing hinter Parse und den Frontier-Modellen.
Preise. Abgerechnet in DBUs (Databricks Units) als Teil Ihrer normalen Rechenkosten, statt über einen öffentlichen Preis pro Seite. Prüfen Sie die Databricks-Preisseite und den Tarif Ihres Workspace.
Fazit: ein klares Ja für bestehende Databricks-Teams, die Daten an Ort und Stelle halten wichtiger finden als die letzten Genauigkeitspunkte. Für alle anderen irrelevant.
6. Azure AI Document Intelligence
Am besten für: Azure-Teams, die mit vorgefertigten Modellen strukturierte Daten aus Formularen, Rechnungen und Ausweisen extrahieren müssen.
Azure AI Document Intelligence (früher Form Recognizer) ist Microsofts ausgereifter Dokumentenverarbeitungsdienst. Es erreicht 69,3 in der ParseBench, doch dieser allgemeine Wert unterschlägt seine eigentliche Stärke: vorgefertigte Modelle, die strukturierte Felder aus bestimmten Dokumenttypen ziehen, etwa Rechnungen, Belege, Steuerformulare und Ausweise, ohne dass Sie etwas trainieren.
Funktionen. Neben reinem Text-OCR (dem Read-Modell) bringt es vorgefertigte Extraktoren für gängige Geschäftsdokumente und einen Custom-Modell-Workflow mit, um mit wenigen Beispielen ein eigenes zu trainieren. Es nimmt PDFs und Bilder direkt entgegen und liefert strukturiertes JSON mit Konfidenzwerten pro Feld, was der Live-Endpunkt von Parse derzeit nicht ausgibt.
Vorteile. Bei strukturierten Formularen liegt es eine Stufe über generischem Parsing: Es liest die Rechnung nicht nur, sondern liefert Summe, Lieferant und Fälligkeitsdatum als benannte Felder mit Konfidenz. Die tiefe Azure-Integration und Enterprise-Compliance machen es in Microsoft-Umgebungen leicht verkäuflich.
Nachteile. Der Fokus liegt auf Formularfeld-Extraktion statt auf sauberem Markdown für RAG, bei allgemeiner Dokument-zu-Text-Umwandlung hinkt es also den neueren Parsern hinterher. Konfidenzwerte und vorgefertigte Modelle bringen Konfigurationsaufwand mit, den Sie nicht brauchen, wenn Sie nur Text wollen.
Preise. Pro 1.000 Seiten, nach Modelltyp: Das Read-OCR-Modell kostet 1,50 $ pro 1.000 Seiten (wie Parse), vorgefertigte Modelle 10 $ und benutzerdefinierte Extraktion 30 $ pro 1.000. Eine kostenlose F0-Stufe deckt 500 Seiten pro Monat ab.
Fazit: die beste Wahl, wenn Ihr eigentliches Problem die strukturierte Extraktion aus bekannten Formularen ist, nicht allgemeines Parsing, und Sie schon auf Azure sind. Für sauberes Markdown für einen RAG-Index passt ein neuerer Parser besser.
7. AWS Textract
Am besten für: AWS-native Teams und regulierte Stacks, die Dokumenten-OCR in ihrer bestehenden Cloud wollen.
AWS Textract ist Amazons langjähriger OCR- und Dokumentenanalysedienst. Es steht mit 53,3 am Ende der allgemeinen ParseBench-Tabelle, und Cohere nennt eine „Verbesserung um über 20 Punkte“ dagegen, niemand wählt Textract also wegen modernster Markdown-Qualität. Man wählt es, weil es bereits im eigenen AWS-Konto liegt.
Funktionen. Textract erkennt Text, Tabellen und Formular-Schlüssel-Wert-Paare, dazu spezialisierte APIs für Spesen und Ausweisdokumente. Es nimmt PDFs und Bilder, integriert sich nativ mit S3, Lambda und dem Rest von AWS und erbt die Compliance-Zertifizierungen von AWS von Haus aus.
Vorteile. Für einen AWS-Betrieb ist die Integrations- und Governance-Story unschlagbar: kein neuer Anbieter, kein Datenabfluss, IAM und Audit-Logging, denen Sie schon vertrauen. Es ist im Enterprise-Maßstab erprobt, und die Tabellen- und Formularextraktion bei sauberen Standarddokumenten ist zuverlässig.
Nachteile. Im modernen Benchmark liegt es weit hinter dem Feld, besonders bei der semantischen Formatierung (dort 2,8). Es ist eine OCR-Engine älterer Generation, kein Vision-Language-Modell, und tut sich bei unübersichtlichen oder ungewöhnlichen Layouts schwer, wo neuere Tools zurechtkommen.
Preise. Pro 1.000 Seiten, je API separat: Reines Detect Text kostet 1,50 $ pro 1.000 Seiten, während Analyze Document für Tabellen auf 15 $ und für Formulare auf 50 $ springt, strukturierte Felder werden also schnell teuer. Neue Konten erhalten drei Monate kostenlos.
Fazit: die sichere, unspektakuläre, richtige Wahl für AWS-native Teams, die Standarddokumente parsen und In-Cloud-Betrieb höher gewichten als Benchmark-Werte. Wenn die Parsing-Qualität bei schwierigen Layouts Ihr Engpass ist, schauen Sie weiter oben in dieser Liste.
8. Unstructured
Am besten für: Teams, die viele Dateitypen in eine saubere Pipeline einlesen müssen, mit Open-Source-Option.
Unstructured ist weniger ein einzelnes OCR-Modell als eine vollständige Ingestion-Schicht: Es nimmt über 25 Dateitypen (PDF, Word, PowerPoint, HTML, E-Mail, Bilder) und normalisiert sie zu sauberem, in Chunks zerlegtem JSON, bereit zum Embedding. Es steht nicht in der ParseBench, weil es eine etwas andere Rolle spielt: die Verrohrung, die alles in Ihren Vektorspeicher bringt, nicht nur PDFs.
Funktionen. Konnektoren zu Dutzenden Quellen, eine riesige Bandbreite an Eingabeformaten, layoutbewusstes Chunking und eine bekannte Open-Source-Bibliothek neben der verwalteten API. Es ist gerade deshalb ein verbreiteter Standard in selbstgebauten RAG-Stacks, weil es den Long Tail an Dateitypen abdeckt, den Einzweck-Parser ignorieren, was zählt, wenn Ihr Wissensmanagement über ein Dutzend Apps verstreut ist.
Vorteile. Breite. Wenn Ihr Wissen in PDFs, Confluence-Exporten, E-Mails und Foliensätzen liegt, erledigt Unstructured alles in einer Pipeline. Der Open-Source-Kern erlaubt es, kostenlos zu starten und selbst zu hosten.
Nachteile. Die reine OCR-Qualität bei komplexen Dokumenten ist nicht die beste ihrer Klasse, weshalb viele Teams es mit einem stärkeren Parser für die schwierigen PDFs kombinieren. Und die Open-Source-Version im großen Maßstab zu betreiben ist echte Ingenieursarbeit, kein verwalteter Komfort.
Preise. Die Open-Source-Bibliothek lässt sich kostenlos selbst hosten; die verwaltete Unstructured Platform wird pro Seite abgerechnet. Aktuelle API-Preise finden Sie auf deren Website.
Fazit: die beste Wahl, wenn Ihr Problem die Formatvielfalt ist, nicht die reine Parsing-Genauigkeit bei einem Typ. Viele Teams nutzen Unstructured für die Breite und ein Modell wie Parse oder Gemini für die kniffligen Dokumente.
Ein Hinweis zu Open-Weight-Parsern
Wenn Datenkontrolle Ihr Antrieb ist, ist der sich am schnellsten bewegende Teil dieses Bereichs die Open-Weight-OCR-Modelle, die Sie selbst hosten: Dinge wie dots.ocr, Chandra OCR 2 und DeepSeek-OCR 2 erscheinen alle in der ParseBench (Chandra OCR 2 erreicht respektable 77,7). dots.ocr steht unter MIT-Lizenz und läuft lokal über vLLM, der Tausch ist also klar: nie eine Gebühr pro Seite und volle Kontrolle darüber, wo Dokumente verarbeitet werden, dafür gehören Ihnen die GPUs und der Betrieb. In einer abgeschotteten oder stark regulierten Umgebung lohnt sich dieser Tausch oft. Für alle anderen ist eine verwaltete API weniger Aufwand.
Das, was jedes Tool auf dieser Liste Ihnen zu bauen überlässt
Dieser Punkt geht beim Vergleich von Parsern leicht unter. Jede Option oben, Parse eingeschlossen, erledigt nur eine Aufgabe: Sie wandelt Dokumente in sauberen Text um. Dieser Text ist keine Antwort. Um Ihre Dokumente tatsächlich zu nutzen, müssen Sie den Text noch in Chunks teilen und einbetten, speichern, für eine gegebene Frage die richtige Passage abrufen und darauf eine fundierte Antwort erzeugen.
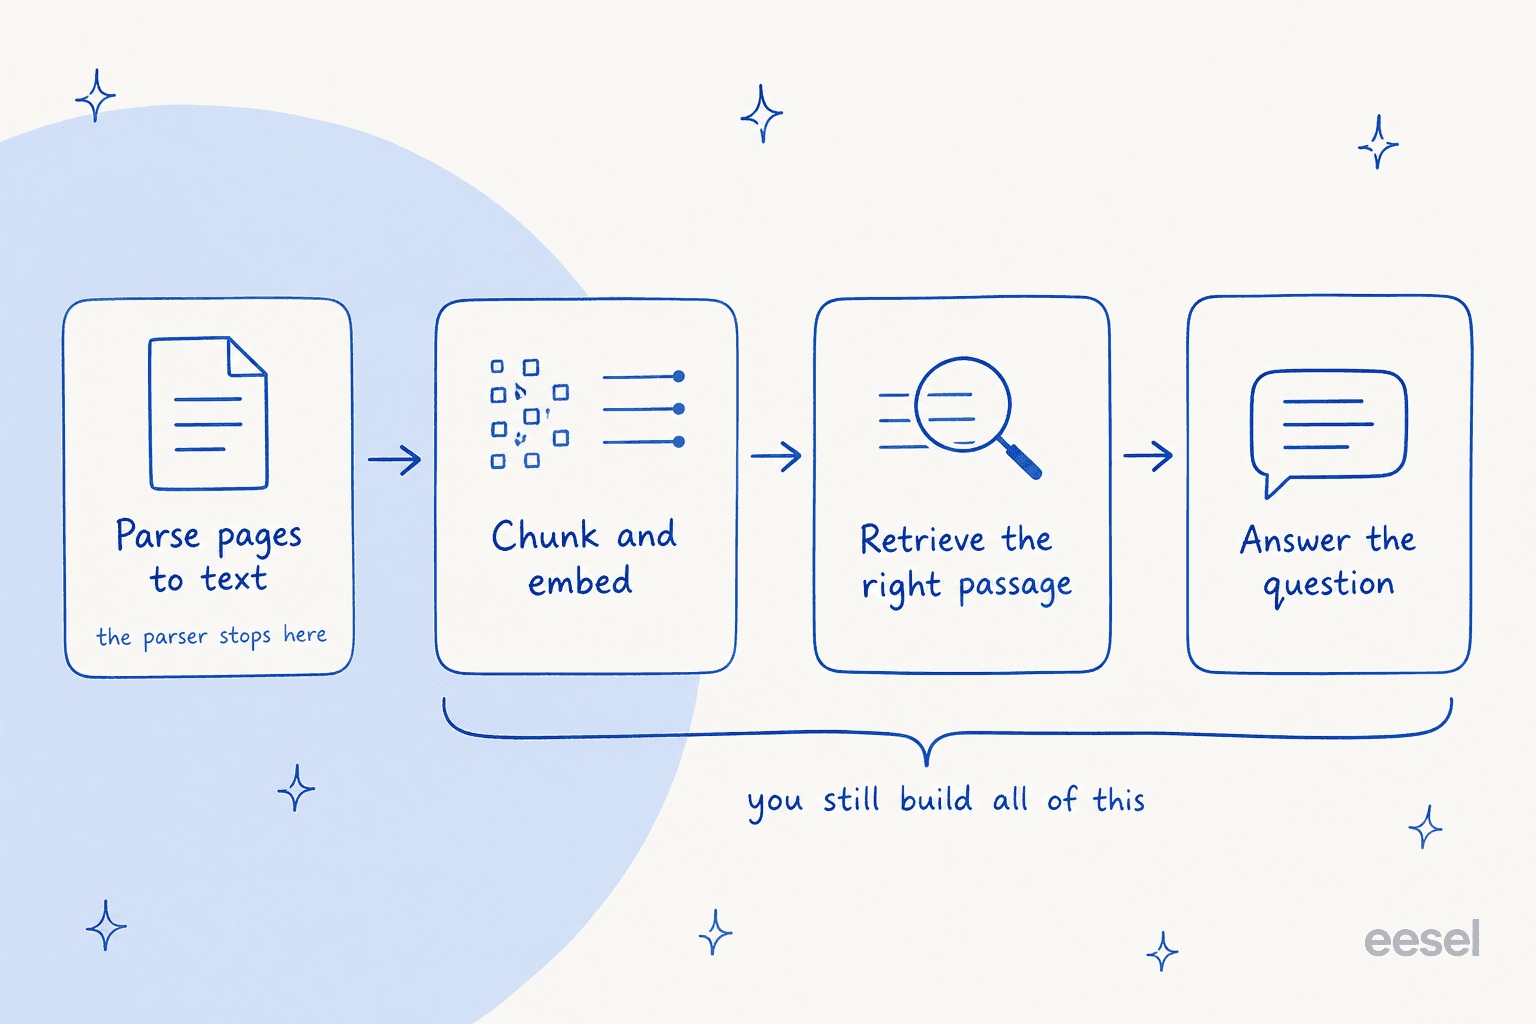
Wenn Sie ein Datenteam sind, das ein individuelles Produkt baut, ist das Verdrahten dieser vier Stufen genau die Arbeit, für die Sie sich entschieden haben, und den richtigen Parser aus dieser Liste zu wählen, ist eine echte Entscheidung. Aber viele, die nach „Cohere Parse Alternativen“ suchen, bauen keine Parser-Pipeline um ihrer selbst willen. Sie wollen das Ergebnis: Antworten auf Kunden- oder Mitarbeiterfragen, gezogen aus den eigenen Dokumenten. Für sie ist die Wahl eines OCR-Modells ein Mittel zum Zweck, das drei Schritte weiter vorne in der Kette liegt.
eesel ausprobieren
Diese Lücke füllt eesel. eesel ist eine KI-Teammate-Plattform: Statt eines Baukastens, den Sie zusammensetzen, stellen Sie ein einsatzbereites Teammate für eine bestimmte Aufgabe ein. Der KI-Helpdesk-Agent ist hier der relevante, und als KI-Agent für den Kundenservice liest er Ihr Help Center, interne Dokumente und frühere Tickets ein, übernimmt Parsing, Embedding und Retrieval für Sie und beantwortet dann tatsächlich Fragen, live in Ihrem Helpdesk.

Ehrlich gesagt also: Wenn Sie eine Dokumenten-Pipeline bauen und einen Parser als eine Komponente brauchen, wählen Sie aus den acht oben. Wenn Ihr eigentliches Ziel ist, Fragen aus Ihrem Wissen zu beantworten, müssen Sie gar kein OCR-Modell wählen, Sie brauchen die Schicht darüber. eesel ist kostenlos testbar, verbindet sich in Minuten, und Sie können es auf Ihre vorhandenen Dokumente richten und Antworten sehen, bevor Sie sich festlegen. (Im Team gibt es auch einen KI-Blog-Writer-Teammate, für eine ganz andere Aufgabe.)