
Kurzfassung
GPT-6.1 Sol erschien auf OpenAIs DevDay am 29. September 2026, genau eine Woche nach GPT-6 Sol. Das Sol der Vorwoche war eine Preissenkung im Gewand einer neuen Versionsnummer. Dieses hier ist das Gegenteil: gleicher Preis von 2 $/10 $, aber ein echter Leistungssprung.
- Es kommt nahe an Astra heran. OpenAI berichtet, es erreicht bei DeepSWE-Coding das Niveau von GPT-6 Astra bei etwa einem Fünftel der Kosten und liegt bei der Computernutzung in OSWorld 2.0 innerhalb von 2,1 Punkten von Astra, bei etwa einem Siebtel der Kosten pro Aufgabe.
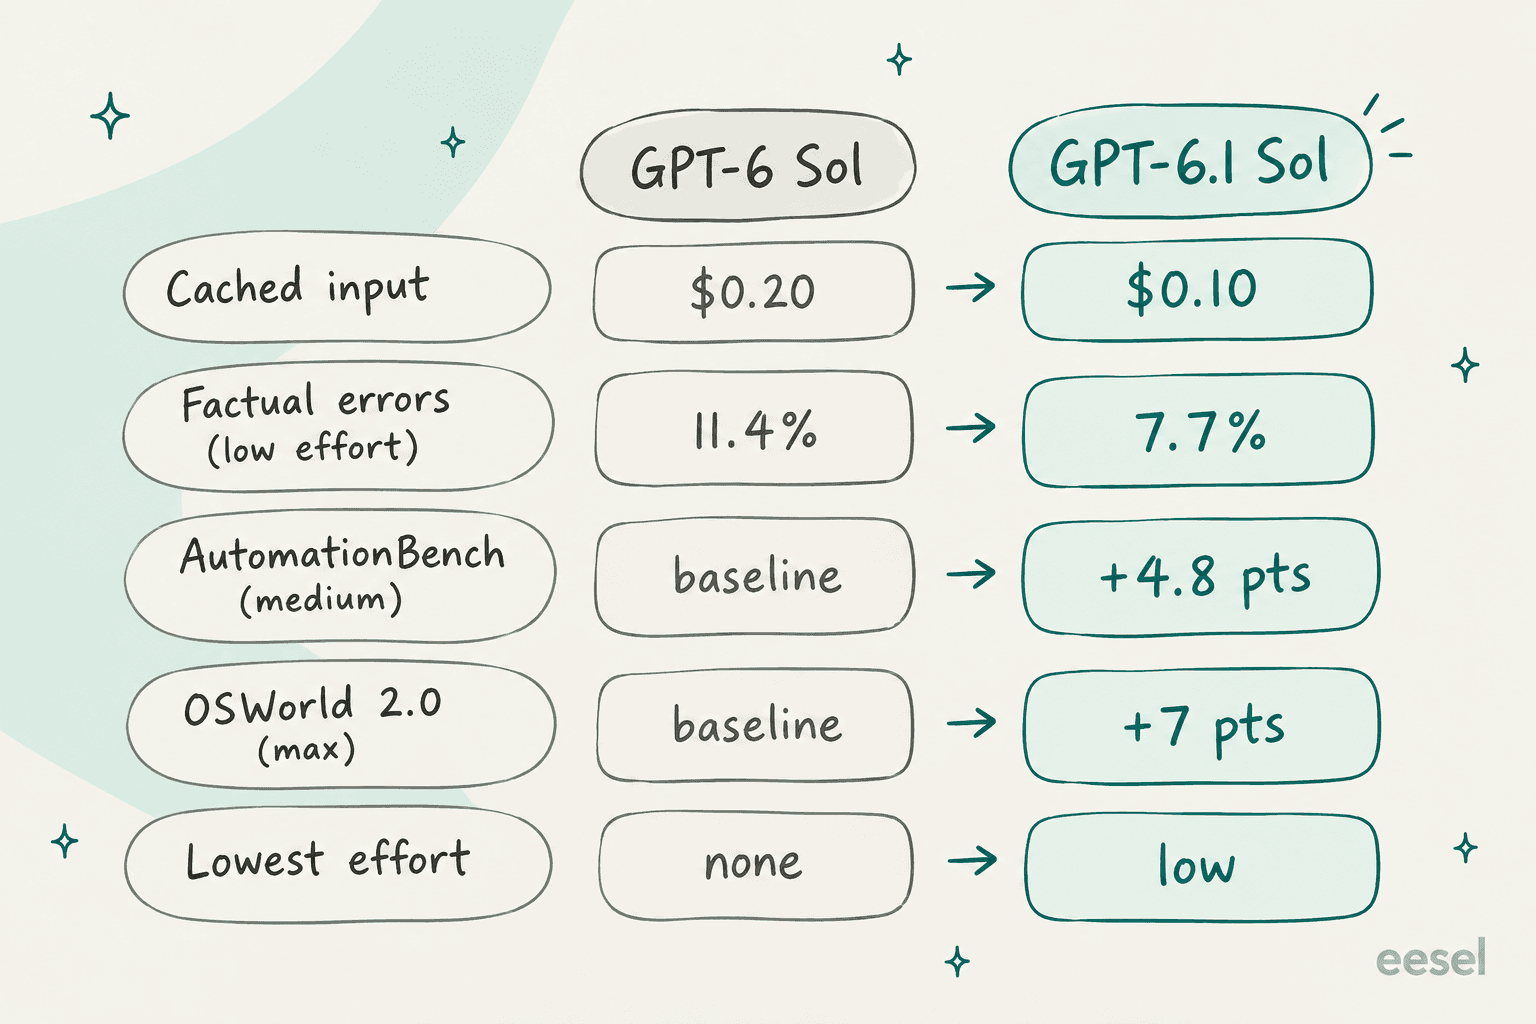
- Der Preis hat sich kaum bewegt, ein Teil wurde billiger. Die Standard-API-Preise bleiben bei 2 $ für Input und 10 $ für Output pro Million Tokens, aber gecachter Input halbiert sich auf 0,10 $ pro Million.
- Die Haken sind klein, aber real. Die Reasoning-Stufe
noneist weg, Chat Completions läuft ohne Tool-Calling, es ist noch nicht im normalen ChatGPT-Chat, und die Ultrafast-Stufe kommt „bald".
Meine Einschätzung: Für die meisten Teams macht GPT-6.1 Sol Astra zu einem Spezialwerkzeug und nicht zur Standardwahl. Wer eine Support-Queue betreibt: Ein klügeres Modell kennt trotzdem Ihre Erstattungsrichtlinie nicht. Die Lösungsquote verbessert der KI-Helpdesk-Agent drumherum, und genau das ist die Aufgabe von eesel, zuerst an Ihren eigenen alten Tickets getestet.
Was GPT-6.1 Sol eigentlich ist
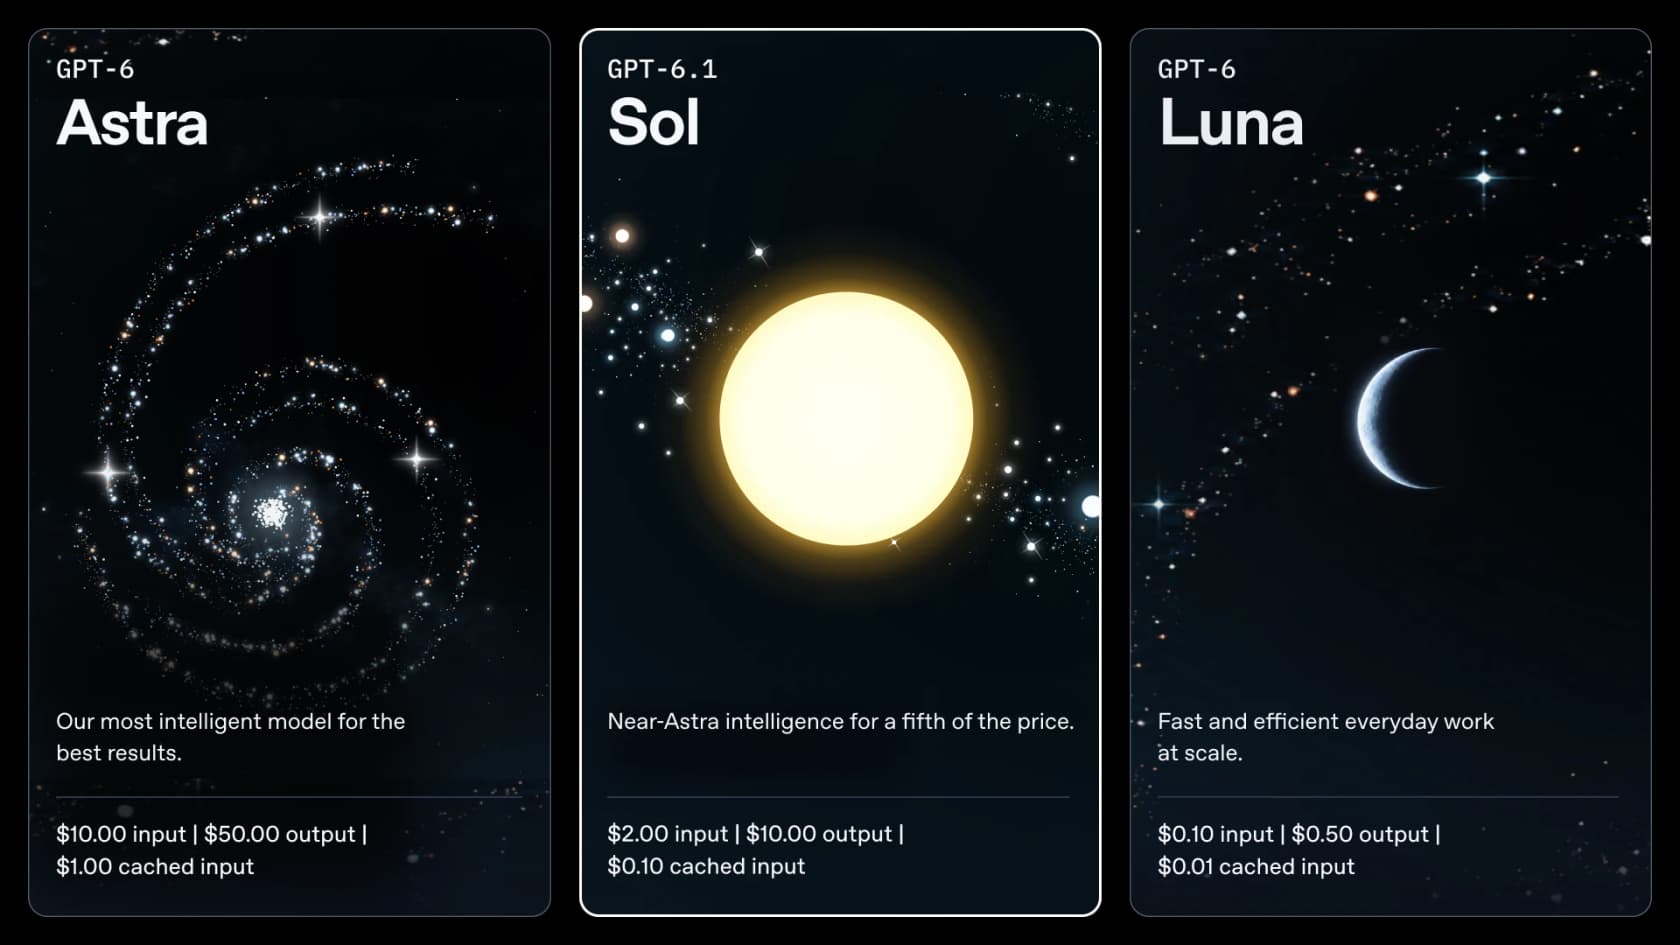
GPT-6.1 Sol ist ein Upgrade des Mittelklassemodells in OpenAIs GPT-6-Familie. Die Familie sieht jetzt so aus: Astra ganz oben, 6.1 Sol in der Mitte und GPT-6 Luna unten. Der Slogan, den OpenAI gewählt hat, lautet „Near-Astra intelligence for a fifth of the price", und er steht auch direkt auf den Preiskarten zum Launch.
Das meiste, was ich über KI-Modelle schreibe, kommt von der Suchseite, und die Suchabsicht ist hier leicht zu lesen. Wer einen Tag nach dem Launch nach „GPT-6.1 Sol" sucht, fragt nicht, was ein Sprachmodell ist, sondern nur eines: Muss ich noch für Astra zahlen? Um diese Frage habe ich diesen Beitrag gebaut.
Auf der Modellseite sieht das Datenblatt fast genauso aus wie beim Vorgänger. Die Modell-ID ist gpt-6.1-sol, mit einem Kontextfenster von 1.050.000 Tokens, 128.000 maximalen Output-Tokens und einem Wissensstand vom 30. April 2026 (zehn Tage später als der 20. April von GPT-6 Sol). Input kann Text oder Bild sein, zurück kommt Text. In der Responses API unterstützt es Websuche, Dateisuche, einen Code-Interpreter, eine gehostete Shell, Apply Patch, Skills, Computernutzung, Tool-Suche und MCP. Es gibt außerdem Datenresidenz in den USA und der EU, wobei der Fast-Modus bei EU-Residenz nicht verfügbar ist.
Was sich gegenüber GPT-6 Sol eine Woche später geändert hat
Als GPT-6 Sol am 22. September erschien, lautete die ehrliche Zusammenfassung „gleiche Intelligenz wie GPT-5.6 Sol zum halben Preis". Artificial Analysis sah es im Intelligence Index nur etwa einen Punkt über GPT-5.6 Sol, nicht viel mehr. GPT-6.1 Sol ist die Version, bei der sich die Leistung tatsächlich bewegt.
Laut OpenAIs Launch-Beitrag sind das die Unterschiede zu GPT-6 Sol:
- Coding: Bei DeepSWE v1.1 schlägt es den Bestwert von GPT-6 Sol um 6,4 Prozentpunkte, bei niedrigerem Reasoning-Aufwand und niedrigeren Kosten.
- Geschäftsabläufe: Bei AutomationBench liegt es mit mittlerem Aufwand 4,8 Punkte über GPT-6 Sol.
- Computernutzung: Beim Offline-Set von OSWorld 2.0 schlägt es GPT-6 Sol mit maximalem Aufwand um 7 Punkte, bei weniger als der Hälfte der Kosten.
- Wissenschaft: Bei Terminal-Bench Science 0.1 mehr als verdoppelt es den Wert von GPT-6 Sol mit maximalem Aufwand.
- Faktentreue: Bei niedrigem Aufwand sinkt der Anteil der Antworten mit einem Faktenfehler von 11,4 % auf 7,7 %, etwa 32 % weniger.
Auch bei der Sicherheit hat sich etwas bewegt. Der Nachtrag zur System Card berichtet, dass GPT-6.1 Sol bei einem defekten Suchwerkzeug in 2,08 % der Fälle nicht darauf hinweist, gegenüber 4,92 % bei GPT-6 Sol. Wenn das, was Sie bauen, kundennah ist, ist ein Modell, das „zugibt, wenn es etwas nicht nachschlagen kann", mehr wert als ein paar Benchmark-Punkte.
Eine Kleinigkeit ist schlechter geworden, auf die ich im Abschnitt über die Haken zurückkomme: Die niedrigste Reasoning-Einstellung ist jetzt low, nicht none.
Wie nah kommt es an Astra heran?
Dieser Teil entscheidet, ob Sie weiter für das Flaggschiff zahlen. OpenAI formuliert es als „nearly matches", und die Zahlen stützen das größtenteils.
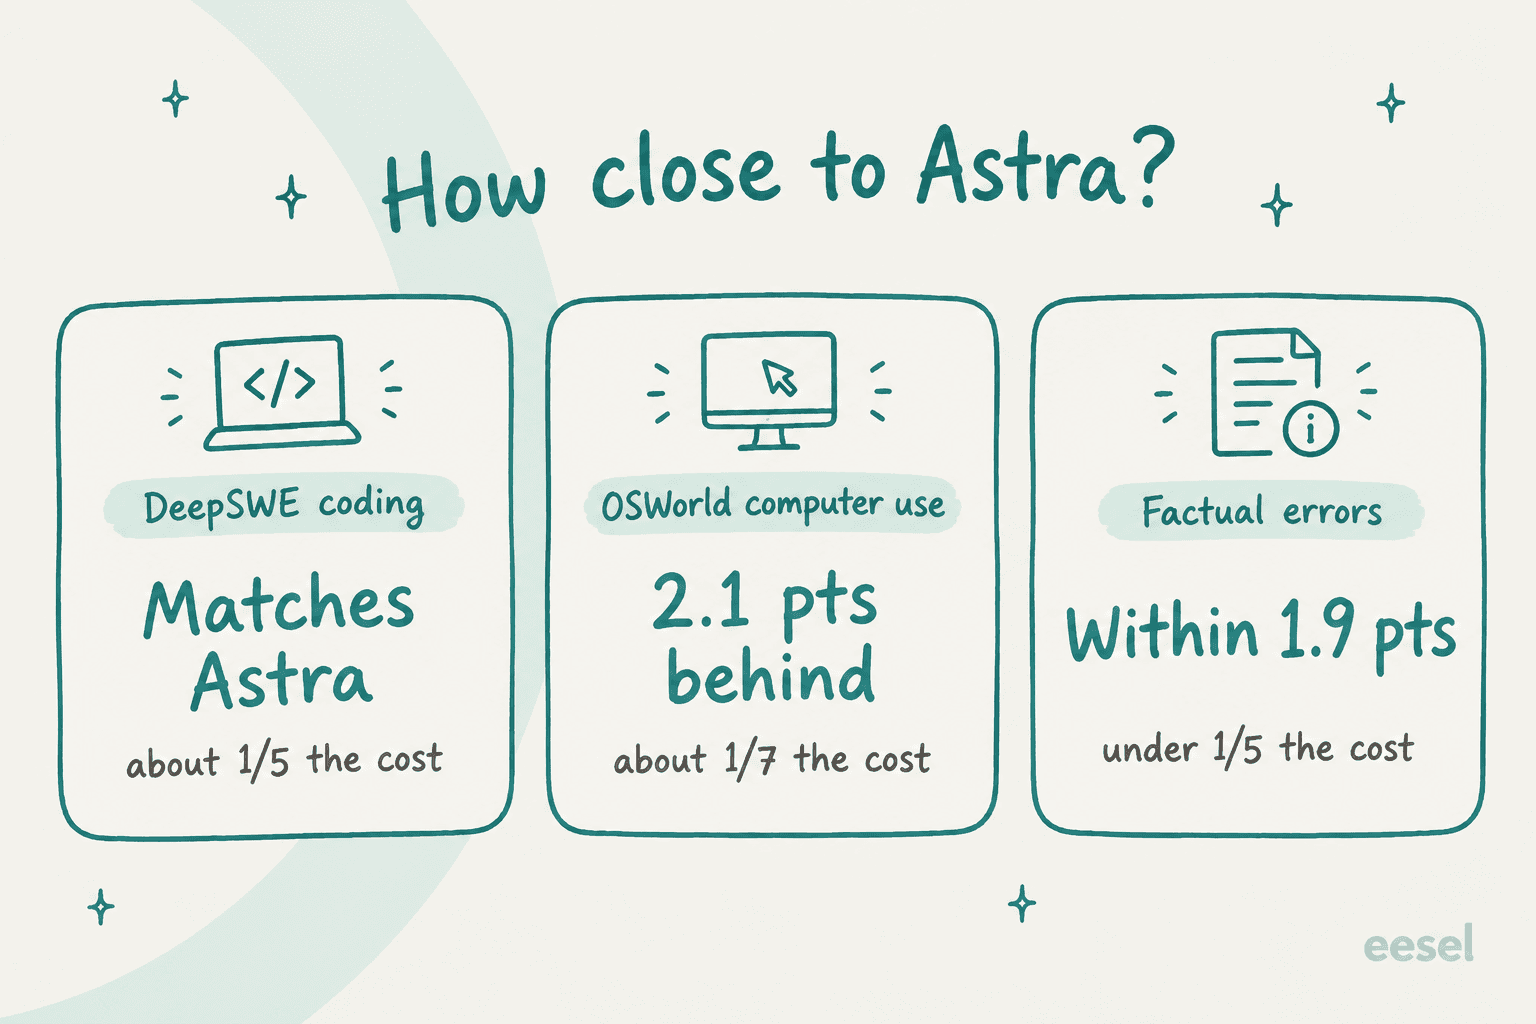
Bei DeepSWE v1.1 sagt OpenAI, 6.1 Sol erreicht GPT-6 Astra bei etwa einem Fünftel der Kosten. Bei OSWorld 2.0 kommt es mit maximalem Aufwand auf 2,1 Punkte an Astra heran, für etwa ein Siebtel der Kosten pro Aufgabe. Und über alle getesteten Reasoning-Einstellungen bleibt die Faktenfehlerrate innerhalb von 1,9 Punkten von Astra, bei weniger als einem Fünftel der Kosten pro Aufgabe.
Auch gegenüber Anthropic schlägt es sich gut. Bei GDP.pdf, einem Test zum Beantworten professioneller Fragen aus komplexen PDFs, erreicht 6.1 Sol laut OpenAI höhere Werte als Claude Opus 5.5 mit Fallbacks, bei weniger als der Hälfte der Kosten pro Aufgabe. Bei AutomationBench liegt es mit mittlerem Aufwand 2,2 Punkte über Opus 5.5, für etwa ein Drittel der Kosten.
Am größten ist die Kostenlücke bei wissenschaftlicher Arbeit. Bei maximalem Aufwand auf Terminal-Bench Science setzt OpenAI 6.1 Sol bei durchschnittlich 5,47 $ pro Aufgabe an, gegenüber 23,21 $ für Opus 5.5 und 23,80 $ für Astra.
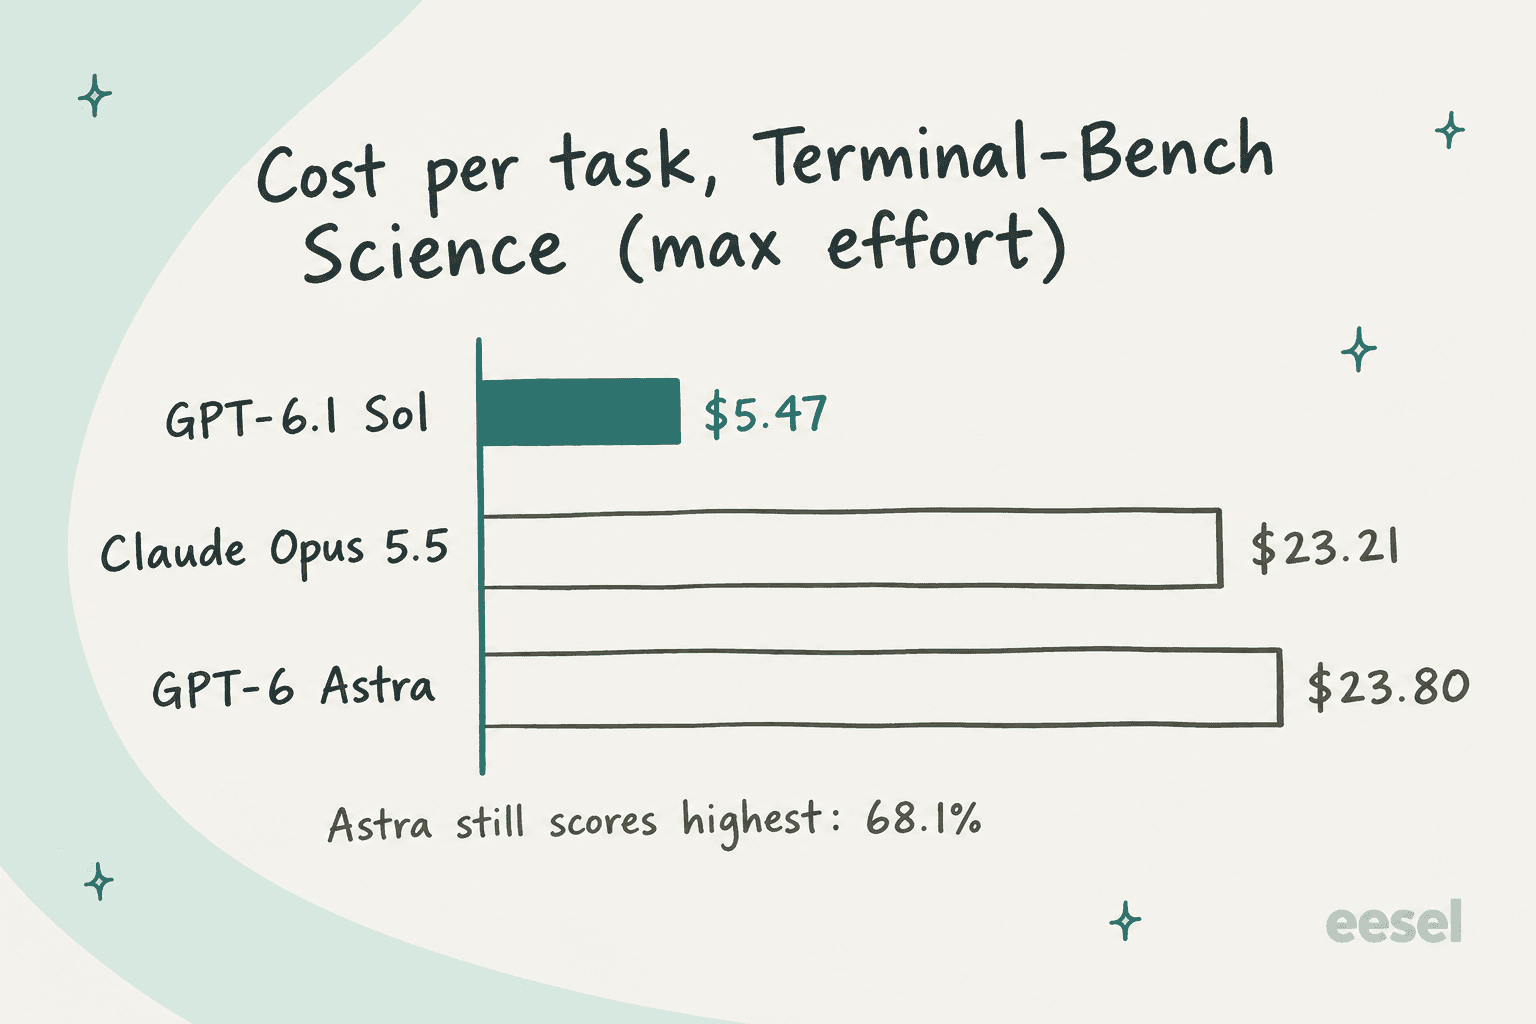
Ein fairer Vorbehalt gilt für all das. Jede Zahl oben stammt aus OpenAIs eigener Auswertung, und die Zahlen der Konkurrenz kommen laut Fußnote des Launch-Beitrags aus „publicly available reports". OpenAI sagt außerdem, Astra erreiche weiterhin den höchsten Wissenschaftswert von 68,1 % und „should be used for the most difficult scientific research tasks". Die Lücke ist also klein, aber nicht null. Die gute Nachricht: Die unabhängigen Zahlen unten erzählen mehr oder weniger dieselbe Geschichte.
Was unabhängige Tests und frühe Nutzer sagen
Artificial Analysis hatte am Launch-Tag Zahlen online, und ehrlich gesagt stützen sie OpenAIs Kernaussage stärker, als ich erwartet hatte. Mit maximalem Aufwand erreicht GPT-6.1 Sol 51,8 im Intelligence Index, gegenüber 47,5 für GPT-6 Sol und 52,7 für GPT-6 Astra. Das gelingt bei 0,72 $ pro Aufgabe gegenüber 3,26 $ für Astra, also etwa 22 % der Kosten des Flaggschiffs für rund einen Punkt weniger.
"GPT-6.1 Sol replaces GPT-6 Sol after just 7 days. It scores 1 point below GPT-6 Astra in the Intelligence Index at less than one quarter of the Cost per Task"
Für mich ist die Tabelle pro Aufwandsstufe das Nützlichste an ihren Daten, weil die Kurve oben stark abflacht:
| Aufwand | Intelligence Index | Kosten pro Aufgabe | Zeit pro Aufgabe |
|---|---|---|---|
| low | 42,1 | 0,13 $ | 56 s |
| medium | 47,8 | 0,21 $ | 131 s |
| high | 50,2 | 0,32 $ | 205 s |
| xhigh | 51,0 | 0,39 $ | 271 s |
| max | 51,8 | 0,72 $ | 569 s |
Quelle: Artificial Analysis. Mit xhigh kommen Sie für etwa die Hälfte der Kosten auf einen Punkt an max heran, und auch die Wartezeit halbiert sich. Artificial Analysis stellte außerdem fest, dass xhigh max bei seinem Coding Agent Index um 3 Punkte schlug und damit 1 Punkt über Astra landete, „for less than 15% of the Cost per Task". Wer Coding-Agenten betreibt, für den scheint xhigh der Sweet Spot zu sein.
Dieselben Daten enthalten zwei ehrliche Vorbehalte. Erstens ist es langsamer als GPT-6 Sol: 67 gegenüber 76 Tokens pro Sekunde und 569 gegenüber 408 Sekunden pro Aufgabe bei max, weil es mehr Output-Tokens schreibt. Zweitens verbesserte sich die Halluzinationsrate von 60 % auf 54 %, was besser ist, aber noch nicht an die 51 % des Flaggschiffs heranreicht.
Im Hacker-News-Launch-Thread waren die Leute bei den Kosten überwiegend positiv und beim Feinschliff gemischter, wobei der Cache-Preis die lauteste Reaktion bekam:
"This is the actual big announcement. 50% cheaper cache than GPT-6 Sol will get you far more mileage on Codex."

Ein Entwickler ließ denselben Bild-zu-HTML-Auftrag auf 6.1 Sol und Claude Opus 5.5 laufen und kam mit einem fairen, gemischten Urteil zurück:
"Overall, opus executes a bit better than 6.1 sol, which surprises me. [...] It's not bad by any means, but I think where Opus really wins is the motion animation of the svgs / final polish [...] Still, it executed quick and was quite cheap to run."
Auf X war die Meinung, die ich am häufigsten sah, eine deutlichere:
"OpenAI just launched GPT-6.1 Sol, and for coding it can replace Astra outright at 1/5 the price."
Der einzige Wermutstropfen betraf eher Abos als das Modell selbst. Ein Kommentator auf Hacker News sagte, die Kontingente der ChatGPT-Tarife seien gleichzeitig gekürzt worden, sodass es „even in the best case scenario it's about 2.5 times cheaper for Codex users" sei. Das ist eine Aussage eines Nutzers und keine Zahl von OpenAI, aber wer Sol über einen Tarif statt über die API nutzt, sollte die eigene Verbrauchsanzeige prüfen, bevor er 5-fache Ersparnis annimmt.
GPT-6.1-Sol-Preise
Die Kernaussage ist einfach: Nichts wurde teurer. Auf der API-Preisseite ersetzt GPT-6.1 Sol GPT-6 Sol in der Haupttabelle zum gleichen Standardsatz von 2 $/10 $. Nur eine Zeile hat sich geändert, der gecachte Input, und er sinkt von 0,20 $ auf 0,10 $ pro Million, also 5 % des ungecachten Preises.
| Stufe | Input | Gecachter Input | Cache-Schreibvorgänge | Output |
|---|---|---|---|---|
| Standard (bis 272K Input) | 2,00 $ | 0,10 $ | 2,50 $ | 10,00 $ |
| Standard (über 272K Input) | 4,00 $ | 0,20 $ | 5,00 $ | 15,00 $ |
| Batch / Flex | 1,00 $ | 0,05 $ | 1,25 $ | 5,00 $ |
| Fast | 4,00 $ | 0,20 $ | 5,00 $ | 20,00 $ |
| Ultrafast | Bald verfügbar |
Alle Preise pro 1 Mio. Tokens. Quelle: OpenAI-API-Preise. Regionale Verarbeitung (Datenresidenz) kostet 10 % Aufschlag.
Diese Senkung beim gecachten Input ist wichtiger, als sie zunächst wirkt. Ein Agent nutzt bei jedem Aufruf denselben langen System-Prompt und dieselben Tool-Definitionen wieder, dazu den Gesprächsverlauf, sodass der gecachte Anteil des Inputs tendenziell groß ist. OpenAI weist im Beitrag direkt darauf hin: Die Senkung gebe Entwicklern „more room to build and run capable agents that reuse context across requests."
Über die Familie hinweg steigt der Output um das 20-Fache von Luna zu Sol und um das 5-Fache von Sol zu Astra:
| Modell | Input / Output (pro 1 Mio.) | Gecachter Input | Am besten für |
|---|---|---|---|
| GPT-6 Luna | 0,10 $ / 0,50 $ | 0,01 $ | Aufgaben mit hohem Volumen und geringem Risiko |
| GPT-6.1 Sol | 2,00 $ / 10,00 $ | 0,10 $ | Der neue Standard für echte Arbeit |
| GPT-6 Astra | 10,00 $ / 50,00 $ | 1,00 $ | Schwierigste Forschung und Aufgaben mit langem Horizont |
Quelle: OpenAI-API-Preise. Für den ganzen Katalog, einschließlich Bild- und Audiomodellen, hat der Leitfaden zu OpenAI-API-Preisen alles.
Sol oder Astra: welches sollten Sie nehmen?
Wenn Sie bei einem echten Projekt zwischen beiden wählen, hängt die Antwort davon ab, wie schwer die Aufgabe ist und wie lange sie läuft, nicht davon, welches Modell das neueste ist. Wählen Sie die Option, die am besten passt.
Worum geht es bei der Aufgabe?
Die Haken, die niemand in die Schlagzeile schreibt
Der Launch ist stark, aber es gibt vier Details, die jeden stolpern lassen, der eine bestehende Integration migriert.
- Keine Reasoning-Stufe
none. Die Modellseite sagt, der Aufwand unterstütztlow,medium(Standard),high,xhighundmax, und dassnoneundminimalnicht unterstützt werden. GPT-6 Sol unterstütztenone. Wenn Sie also einen latenzkritischen Pfad auf Null-Reasoning gebaut haben, testen Sie ihn vor dem Wechsel. - Chat Completions hat kein Tool-Calling. OpenAI sagt, für Tool-Calling solle die Responses API verwendet werden; Chat Completions wird ohne unterstützt. Älterer Agentencode, der auf Chat Completions läuft, muss umgezogen werden.
- Noch nicht im normalen ChatGPT-Chat. Es ist in ChatGPT Work und Codex für Plus, Pro, Business, Enterprise und Edu, aber OpenAI sagt, es sei „not yet available in Chat". Free- und Go-Nutzer bekommen es nicht.
- Ultrafast ist ein Versprechen, kein Produkt. Der DevDay-Rückblick sagt, Ultrafast laufe in Codex bis zu 8-mal schneller (300 Tokens pro Sekunde) und in der API bis zu 6-mal, und dass „GPT-6.1 Sol Ultrafast is coming soon". Heute hat nur Astra einen Ultrafast-Preis.
Keiner davon ist für sich ein Ausschlusskriterium. Es sind die kleinen Änderungen, die aus einer Migration per „einfach die Modell-ID tauschen" einen halben Tag Debugging machen, wenn es einem vorher niemand gesagt hat.
So bekommen Sie Zugang
- API: Verwenden Sie die Modell-ID
gpt-6.1-solin der Responses API. Es gibt keinen kostenlosen Tarif, Tier 1 ist also der Einstieg, mit 500 Anfragen und 500.000 Tokens pro Minute, skalierend auf 15.000 Anfragen und 40 Millionen Tokens pro Minute bei Tier 5. Der Leitfaden zu Rate Limits erklärt, wie die Stufen steigen. - ChatGPT Work und Codex: Ab dem Launch-Tag für Plus-, Pro-, Business-, Enterprise- und Edu-Nutzer verfügbar. Wenn Sie in Codex für agentisches Coding leben, ist dies das Modell, auf das Sie wechseln sollten, und die Aufschlüsselung der Codex-Preise behandelt die Tarifkontingente.
- Business und Enterprise: ChatGPT Enterprise und Business-Workspaces bekommen es ab Tag eins in ChatGPT Work und Codex, genau wie Plus und Pro.
Was es für Entwickler bedeutet
Wenn Sie bereits GPT-6 Sol betreiben, ist dies das einfachste Upgrade des Jahres: Der Preis bleibt gleich, Sie bekommen mehr Leistung und obendrein günstigeren gecachten Kontext. Prüfen Sie zuerst die vier Haken oben und zeigen Sie dann Ihre Integration auf gpt-6.1-sol.
Die größere Entscheidung betrifft Astra. Vor einer Woche war der Griff zu Astra bei Coding-Agenten noch leicht zu verteidigen. Heute, wo Sol bei DeepSWE gleichzieht, sollten die meisten Teams, die das 5-Fache für Astra zahlen, ihr eigenes Testset auf beiden laufen lassen und schauen, wo Sol tatsächlich zurückbleibt. Bei langen Aufgaben bestehen die Kosten eines KI-Agenten hauptsächlich aus Output-Tokens, und genau beim Output liegt die 5-fache Lücke.
Wenn Sie einen solchen Workflow lieber aus dem Terminal steuern, lohnt sich ein Blick auf die eesel CLI. Sie bedient dasselbe eesel-Teammitglied und denselben Workspace wie das Dashboard: Sie können eesel chat von Hand ausführen, mit eesel activity per Skript auslesen, was der Agent bei jedem Lauf getan hat, mit --dry-run genau sehen, was ein Schreibvorgang senden würde, bevor er es sendet, und Coding-Agenten wie Claude Code, Codex und Cursor direkt aufrufen lassen. Zusätzlich stellt jeder Workspace einen MCP-Server bereit, sodass eine Codex-Sitzung mit GPT-6.1 Sol Ihr Support-Teammitglied als Tool bedienen kann, statt dass Sie sich dafür durch eine Oberfläche klicken.
Was es für ein Support-Team bedeutet
Jetzt kommt der kontraintuitive Teil. Dass ein Modell bei Coding-Benchmarks nahe an Astra liegt, ändert für eine Support-Queue weniger, als der Launch vermuten lässt.
Bessere Faktentreue ist real und willkommen, denn weniger selbstsichere falsche Antworten sind genau das, was der Support braucht. Aber im Support kommen die meisten falschen Antworten nicht daher, dass das Modell etwas erfindet, sondern aus dem Wissen, das dem Modell von Anfang an gegeben wurde. Ein B2B-Support-Team für Fahrzeug-Telematik, das eesel auf Zendesk einrichtete, stieß früh darauf: Ihr Bot beantwortete „Unterstützen Sie mein Automodell?" mit Ja für Marken, die nicht in ihrer Datenbank standen, weil das Help Center „wir unterstützen alle Modelle" sagte. Das Modell las die Quelle korrekt, die Quelle war falsch. Kein Modell-Upgrade behebt das, und das Team beschrieb die frühe Einrichtung als Versuch und Irrtum.
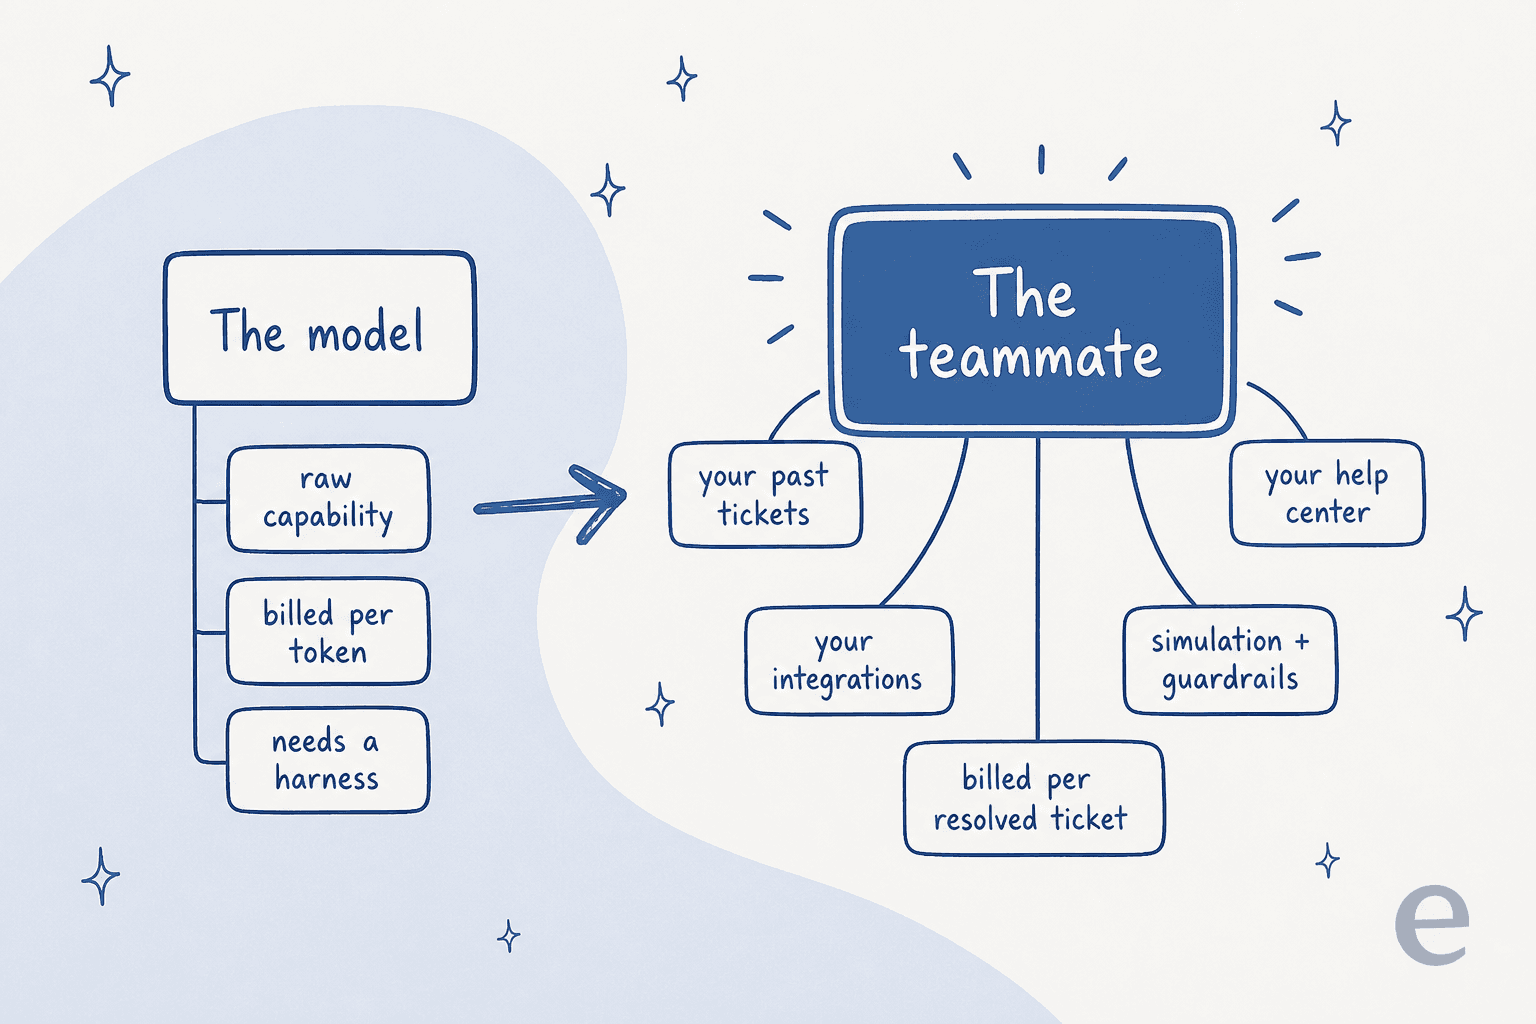
Deshalb würde ich ein neues Modell ans Ende der Prioritätenliste eines Support-Teams setzen. Die Lösungsquote bewegt die Schicht um das Modell: das Training auf Ihren alten Tickets, die Anbindung des Helpdesks, den Sie bereits nutzen, und dann das Testen der Antworten an Ihrem eigenen Verlauf vor dem Livegang. Wenn Halluzinationen die Sorge sind, liegt die Lösung ebenfalls größtenteils in dieser Schicht. Die besten KI-Agenten sind modellflexibel, sodass Sie ein besseres Modell wie GPT-6.1 Sol erben, statt die Plattform zu wechseln.
eesel ausprobieren
Wenn Sie von GPT-6.1 Sol eigentlich weniger Tickets in der Queue wollen, müssen Sie das Harness nicht selbst bauen. GPT-6.1 Sol ist Infrastruktur; eesel ist der Mitarbeiter. Das KI-Helpdesk-Teammitglied von eesel lernt aus Ihren alten Tickets und Ihrem Help Center, bindet sich in Zendesk, Freshdesk, Gorgias und die anderen Helpdesks ein, die Sie bereits nutzen, und führt eine Simulation an Ihren echten alten Tickets durch, damit Sie seine Antworten mit dem vergleichen können, was Ihr Team tatsächlich gesendet hat, bevor es einem einzigen Kunden antwortet.
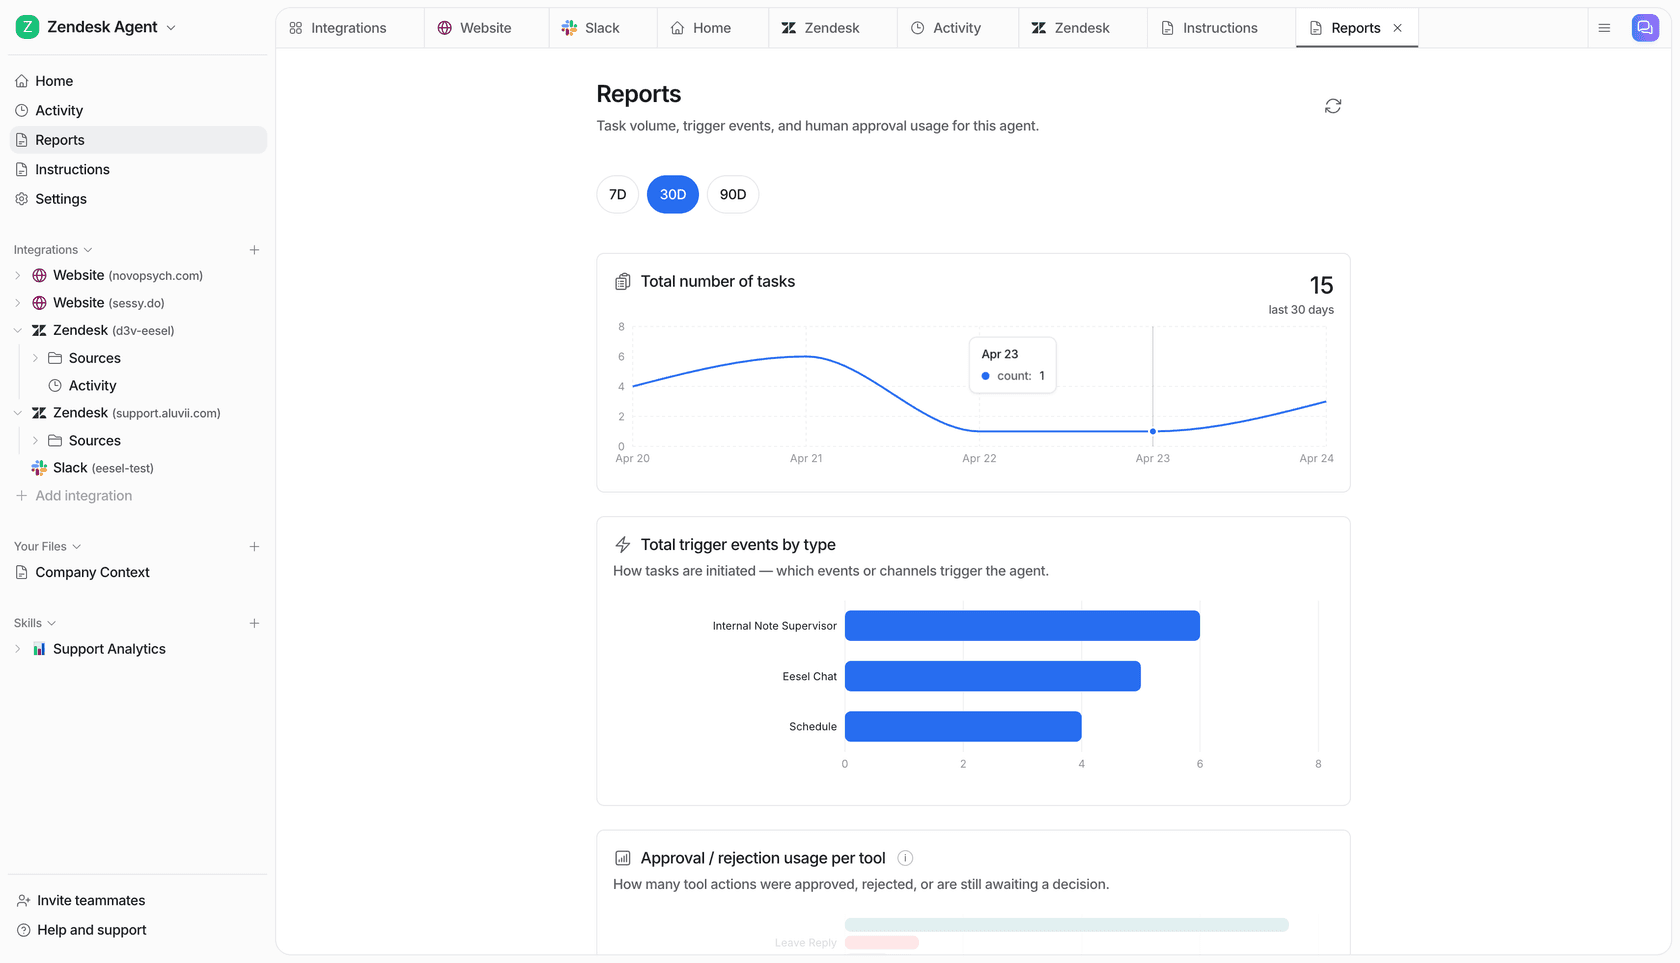
Die Preise sind ein fester monatlicher Credit-Tarif, bei dem ein Ticket oder Chat einen Credit kostet, mit allen Funktionen und unbegrenzten Plätzen inklusive, plus einem kostenlosen Tarif mit 100 Credits und ohne Karte. Es gibt keine Gebühr pro Token, sodass die Rechnung planbar bleibt, egal ob darunter GPT-6.1 Sol oder das nächste Release läuft. Probieren Sie eesel an einem Teil Ihrer Queue aus und sehen Sie die Antworten an Ihren eigenen Tickets.
Häufig gestellte Fragen
Was ist GPT-6.1 Sol?
Was kostet GPT-6.1 Sol?
Was ist der Unterschied zwischen GPT-6 Sol und GPT-6.1 Sol?
none entfällt, low ist jetzt das Minimum. Der ursprüngliche Beitrag zu GPT-6 Sol behandelt das frühere Modell.Ist GPT-6.1 Sol so gut wie GPT-6 Astra?
Ist GPT-6.1 Sol in ChatGPT verfügbar?
gpt-6.1-sol, ohne Zugang im kostenlosen Tarif.Hat GPT-6.1 Sol einen Ultrafast-Modus?
Wie sind die Rate Limits von GPT-6.1 Sol?
Sollte ich GPT-6.1 Sol für die Automatisierung im Kundensupport verwenden?

Article by
Kurnia Kharisma
Kurnia is a software engineer and writer at eesel AI with two years of SEO experience, writing about AI tools, helpdesk software, and customer support. He pairs a developer's understanding of how these products are built with search-driven research into what actually ranks and resonates with the people searching for them.