
GPT-6.1 Sol Preise auf einen Blick
GPT-6.1 Sol wurde am 29. September 2026 auf der DevDay von OpenAI vorgestellt und übernahm auf der API-Preisseite schlicht die Zeile von GPT-6 Sol. Ich baue bei eesel Integrationen. Wann immer ein Modell erscheint, bin ich derjenige, der für irgendeinen Kunden dieselbe Kostentabelle neu aufbaut, also habe ich die Tabelle diesmal einfach als Beitrag ausgeschrieben.
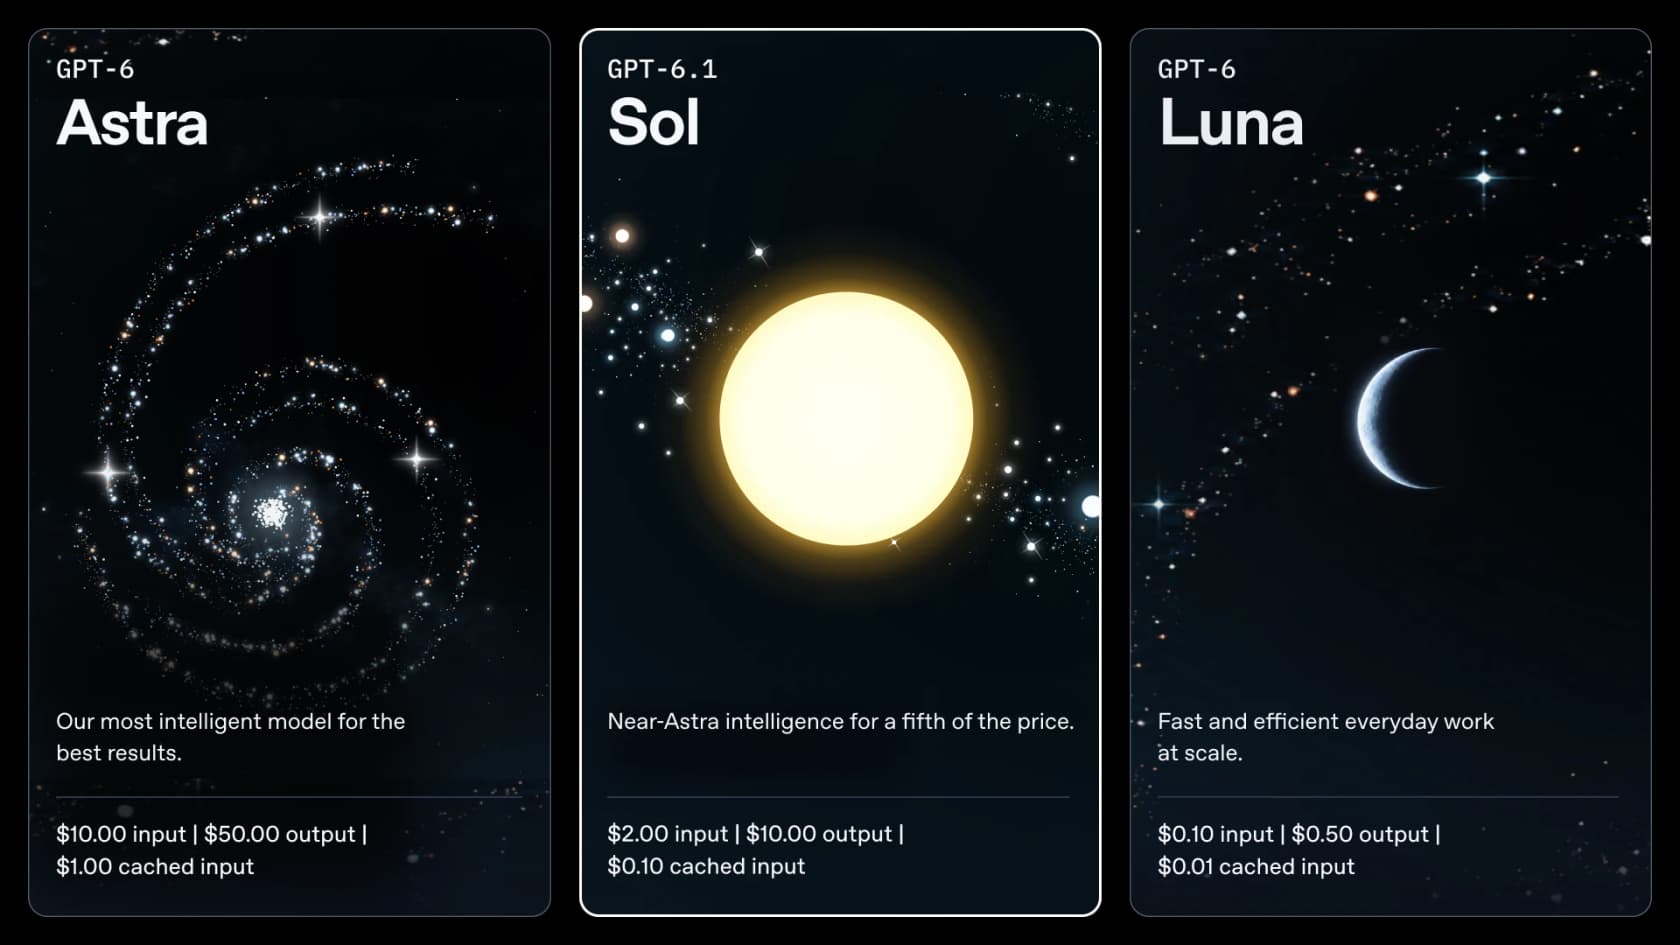
Unten steht die vollständige Preistabelle der Standardstufe mit beiden Kontextbereichen:
| Standardstufe (pro 1 Mio. Tokens) | Kurzer Kontext (bis 272K Eingabe) | Langer Kontext (über 272K Eingabe) |
|---|---|---|
| Eingabe | $2,00 | $4,00 |
| Gecachte Eingabe | $0,10 | $0,20 |
| Cache-Schreibvorgänge | $2,50 | $5,00 |
| Ausgabe (inkl. Reasoning) | $10,00 | $15,00 |
Quelle: OpenAI API pricing, erneut geprüft am 1. Oktober 2026. Die Modellseite nennt die Verhältnisse hinter diesen Zahlen: Gecachte Eingabe beträgt 5 % des ungecachten Preises, Cache-Schreibvorgänge das 1,25-Fache, und lange Prompts kosten "2x input and cache rates and 1.5x output for the full request."
Es ist das mittlere Modell im OpenAI-Modellangebot, und ein paar Spezifikationsdetails zählen, sobald Sie budgetieren. Die Modell-ID lautet gpt-6.1-sol, mit einem Kontextfenster von 1.050.000 Tokens und 128.000 maximalen Ausgabe-Tokens. Die API hat keine kostenlose Stufe, daher ist Tier 1 (500 Anfragen und 500.000 Tokens pro Minute) die Untergrenze.
Was sich gegenüber den GPT-6 Sol Preisen geändert hat
Auf dem Papier kaum etwas. Das ist der gesamte Unterschied:
| Posten | GPT-6 Sol | GPT-6.1 Sol |
|---|---|---|
| Eingabe (pro 1 Mio.) | $2,00 | $2,00 |
| Gecachte Eingabe | $0,20 | $0,10 |
| Ausgabe | $10,00 | $10,00 |
| Niedrigster Reasoning-Aufwand | none | low |
| Ausgabe-Tokens pro Aufgabe (AA, max) | 31,1K | 38,1K |
| Kosten pro Aufgabe (AA, max) | $1,05 | $0,72 |
Quellen: OpenAI API pricing, Artificial Analysis. Der Beitrag zu den GPT-6 Sol Preisen behandelt das vollständige Bild der letzten Woche.
Zwei dieser Zahlen ziehen in entgegengesetzte Richtungen. GPT-6.1 Sol schreibt mehr Ausgabe. Artificial Analysis maß "~10-30% more output tokens than GPT-6 Sol" über die Aufwandsstufen hinweg. Trotzdem war es bei maximalem Aufwand 31 % günstiger pro Aufgabe, weil es die Arbeit mit weniger fehlgeschlagenen Läufen erledigt und seine gecachte Eingabe nur halb so viel kostet. Gleicher Preis pro Token heißt nicht gleicher Preis pro Aufgabe. Hier hat sich die Zahl pro Aufgabe zumindest zu Ihren Gunsten bewegt.
Die Änderung, die eine Rechnung tatsächlich nach oben treiben kann, ist die Reasoning-Untergrenze. GPT-6 Sol erlaubte den Betrieb mit none-Aufwand, und das bedeutete null Reasoning-Tokens. Bei 6.1 Sol steht auf der Modellseite, dass none und minimal "are not supported" sind, also ist low die günstigste Einstellung. Angenommen, Sie hatten einen Klassifikator mit hohem Volumen auf none. Er rechnet nun bei jedem einzelnen Aufruf etwas Reasoning-Ausgabe ab, deshalb würde ich das testen, bevor ich die Modell-ID tausche.
Die Senkung der gecachten Eingabe ist die eigentliche Preisänderung
Das ist der Teil der GPT-6.1 Sol Preise, der die Schlagzeile hätte sein sollen, und Leute im Launch-Tag-Thread bemerkten es sofort:
"This is the actual big announcement. 50% cheaper cache than GPT-6 Sol will get you far more mileage on Codex."

Der Grund ist einfach. Agenten senden bei jedem Aufruf dasselbe Material erneut, also den System-Prompt und die Tool-Definitionen, plus einen Gesprächsverlauf, der immer weiter wächst. Dieses wiederholte Präfix wird gecacht. Bei einem lang laufenden Agenten wird dann der Großteil der Eingabe zum Cache-Preis abgerechnet statt zum Listenpreis von $2. Ihr realer Eingabepreis ist also ein Mischwert, und was den Mix bestimmt, ist vor allem Ihr Cache-Trefferanteil.
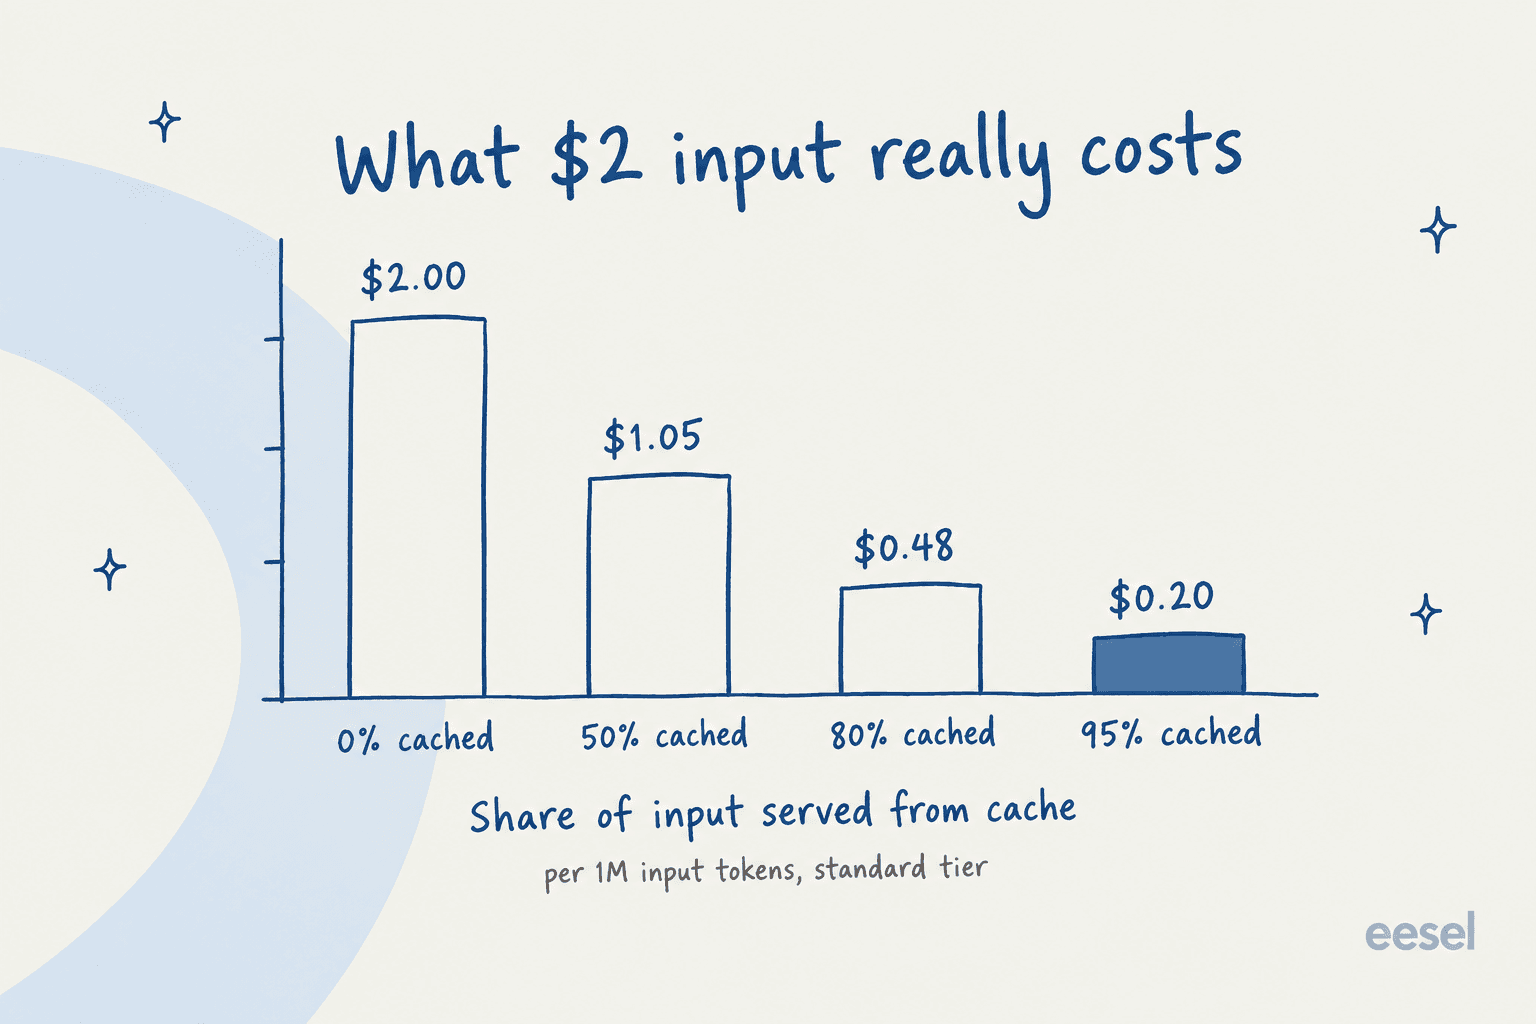
Rechnet man dasselbe über die ganze Familie durch, sieht man, wie weit die Cache-Senkung den Abstand zum Flaggschiff vergrößert hat:
| Anteil gecachter Eingabe | GPT-6.1 Sol | GPT-6 Sol | GPT-6 Astra |
|---|---|---|---|
| 0 % | $2,00 | $2,00 | $10,00 |
| 50 % | $1,05 | $1,10 | $5,50 |
| 80 % | $0,48 | $0,56 | $2,80 |
| 95 % | $0,20 | $0,29 | $1,45 |
Effektiver Eingabepreis pro 1 Mio. Tokens, Standardstufe, berechnet aus OpenAIs Preistabelle. Bei einem Cache-Trefferanteil von 80 % kostet die Eingabe von GPT-6.1 Sol etwa ein Sechstel von Astra, und der Beitrag zu den GPT-6 Astra Preisen enthält die vollständige Karte des Flaggschiffs. Zwei Einschränkungen gibt es allerdings. Cache-Schreibvorgänge kosten $2,50 pro Million, das 1,25-Fache des normalen Eingabepreises, was bedeutet, dass der erste Aufruf, der ein Präfix speichert, etwas mehr kostet als ein ungecachter. Außerdem hilft Caching nur, solange das Präfix Byte für Byte identisch bleibt. Setzen Sie einen Zeitstempel an den Anfang Ihres System-Prompts, und der Rabatt fällt unbemerkt auf null.
Servicestufen: Batch, Flex, Fast und das fehlende Ultrafast
Ein Modell, vier Preise, und die gewählte Stufe verändert die Rechnung stärker als jede Prompt-Optimierung:
| Stufe (pro 1 Mio., kurzer Kontext) | Eingabe | Gecachte Eingabe | Cache-Schreibvorgänge | Ausgabe | Langer Kontext Eingabe / Ausgabe |
|---|---|---|---|---|---|
| Batch | $1,00 | $0,05 | $1,25 | $5,00 | $2,00 / $7,50 |
| Flex | $1,00 | $0,05 | $1,25 | $5,00 | $2,00 / $7,50 |
| Standard | $2,00 | $0,10 | $2,50 | $10,00 | $4,00 / $15,00 |
| Fast | $4,00 | $0,20 | $5,00 | $20,00 | $8,00 / $30,00 |
| Ultrafast | Demnächst |
Quelle: OpenAI API pricing. Was jede Stufe in der Praxis bedeutet:
- Batch und Flex kosten beide die Hälfte des Standards. Batch ist für Jobs, die Sie einreichen und später abholen; Flex ist für Anfragen, die gern langsamer laufen dürfen. Wenn ein Job keine Antwort binnen Sekunden braucht, gehört er hierher.
- Fast verdoppelt den Preis für geringere Latenz. Die Preisseite vermerkt, dass Priority Processing "was renamed Fast mode on July 30, 2026."
- Ultrafast ist für Sol nicht verfügbar. Der DevDay-Rückblick sagt "GPT-6.1 Sol Ultrafast is coming soon." Heute hat nur GPT-6 Astra einen Ultrafast-Preis, nämlich $60/$300 pro Million.
- Datenresidenz kostet 10 % extra. Regionale Verarbeitungs-Endpunkte tragen für nach dem 5. März 2026 veröffentlichte Modelle einen Aufschlag von 10 %, und die Modellseite ergänzt, dass der Fast-Modus mit EU-Datenresidenz nicht verfügbar ist.
Beim Kombinieren summieren sich die Einsparungen wirklich. Ein stapelverarbeitbarer Job mit großem gecachtem Präfix läuft zu $1 Eingabe, $0,05 gecacht und $5 Ausgabe. Verglichen mit dem Standardpreis von Astra ist das allein bei der Ausgabe eine Senkung um 90 %.
Die 272K-Klippe
Die Langkontext-Regel ist die am leichtesten zu übersehende Zeile der Preistabelle. Sie ist auch die teuerste, über die man stolpern kann. Sobald ein Prompt 272K Eingabe-Tokens überschreitet, wird die gesamte Anfrage zum Langkontext-Preis abgerechnet, nicht nur die Tokens jenseits der Grenze.
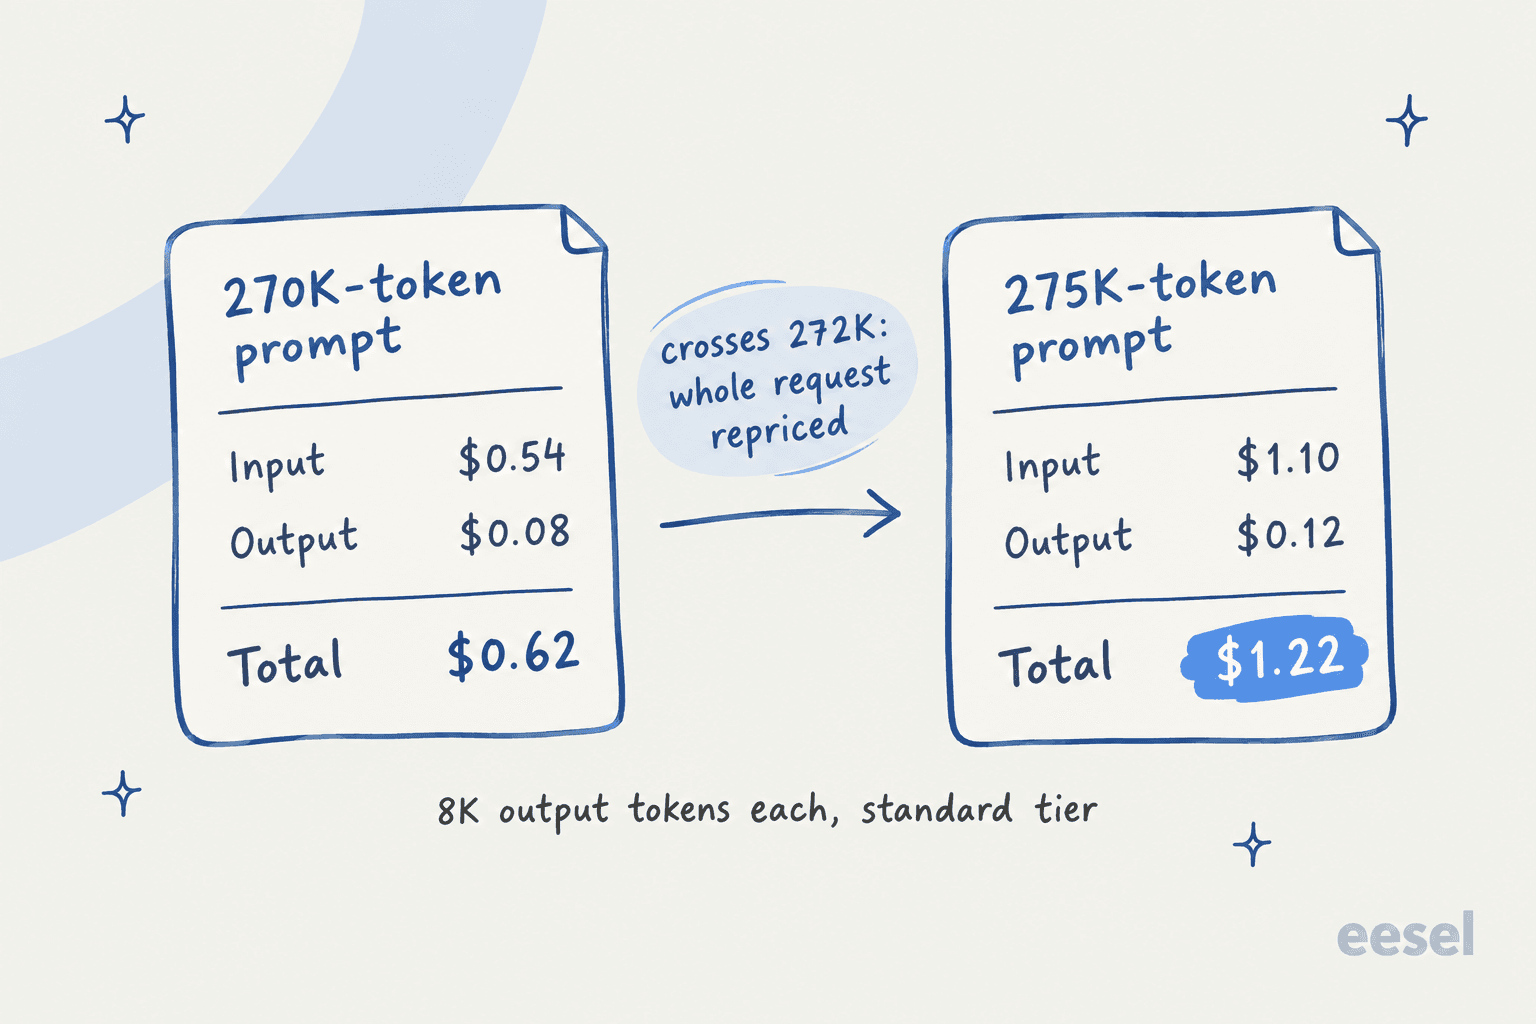
Dieses Bild ist die ganze Falle: 5.000 zusätzliche Eingabe-Tokens verdoppeln die Anfrage fast, von $0,62 auf $1,22. Das Fenster von 1.050.000 Tokens ist real. Es hat nur etwa ein Viertel des Weges hinein eine Preisstufe. Wer Dokumentenanalyse oder repo-weite Coding-Aufgaben betreibt, sollte prüfen, wo die eigenen Prompts landen. Einen 400K-Job in zwei Aufrufe mit je 200K aufzuteilen ist oft besser, als ihn am Stück zu senden. Retrieval, das nur die relevanten Abschnitte sendet, schlägt beides.
Kosten pro Aufgabe: die Zahl, auf die es wirklich ankommt
Ein Token-Preis nennt den Kraftstoffpreis. Er sagt nicht, wie viel Kraftstoff die Fahrt braucht. Bei Reasoning-Modellen kann diese zweite Zahl je nach Aufwand um mehr als das Fünffache schwanken, weshalb ich von ihr aus budgetiere.
Artificial Analysis ließ seinen vollständigen Intelligence Index einmal pro Aufwandsstufe laufen:
| Aufwand | Intelligence Index | Kosten pro Aufgabe | Ausgabe-Tokens pro Aufgabe | Zeit pro Aufgabe |
|---|---|---|---|---|
| low | 42,1 | $0,13 | 4,0K | 56 s |
| medium | 47,8 | $0,21 | 8,1K | 131 s |
| high | 50,2 | $0,32 | 13,2K | 205 s |
| xhigh | 51,0 | $0,39 | 17,6K | 271 s |
| max | 51,8 | $0,72 | 38,1K | 569 s |
Quelle: Artificial Analysis. Nahe der Spitze wird die Kurve fast flach. Der Wechsel von xhigh zu max verdoppelt die Kosten nahezu, und Sie bekommen dafür 0,8 Punkte.
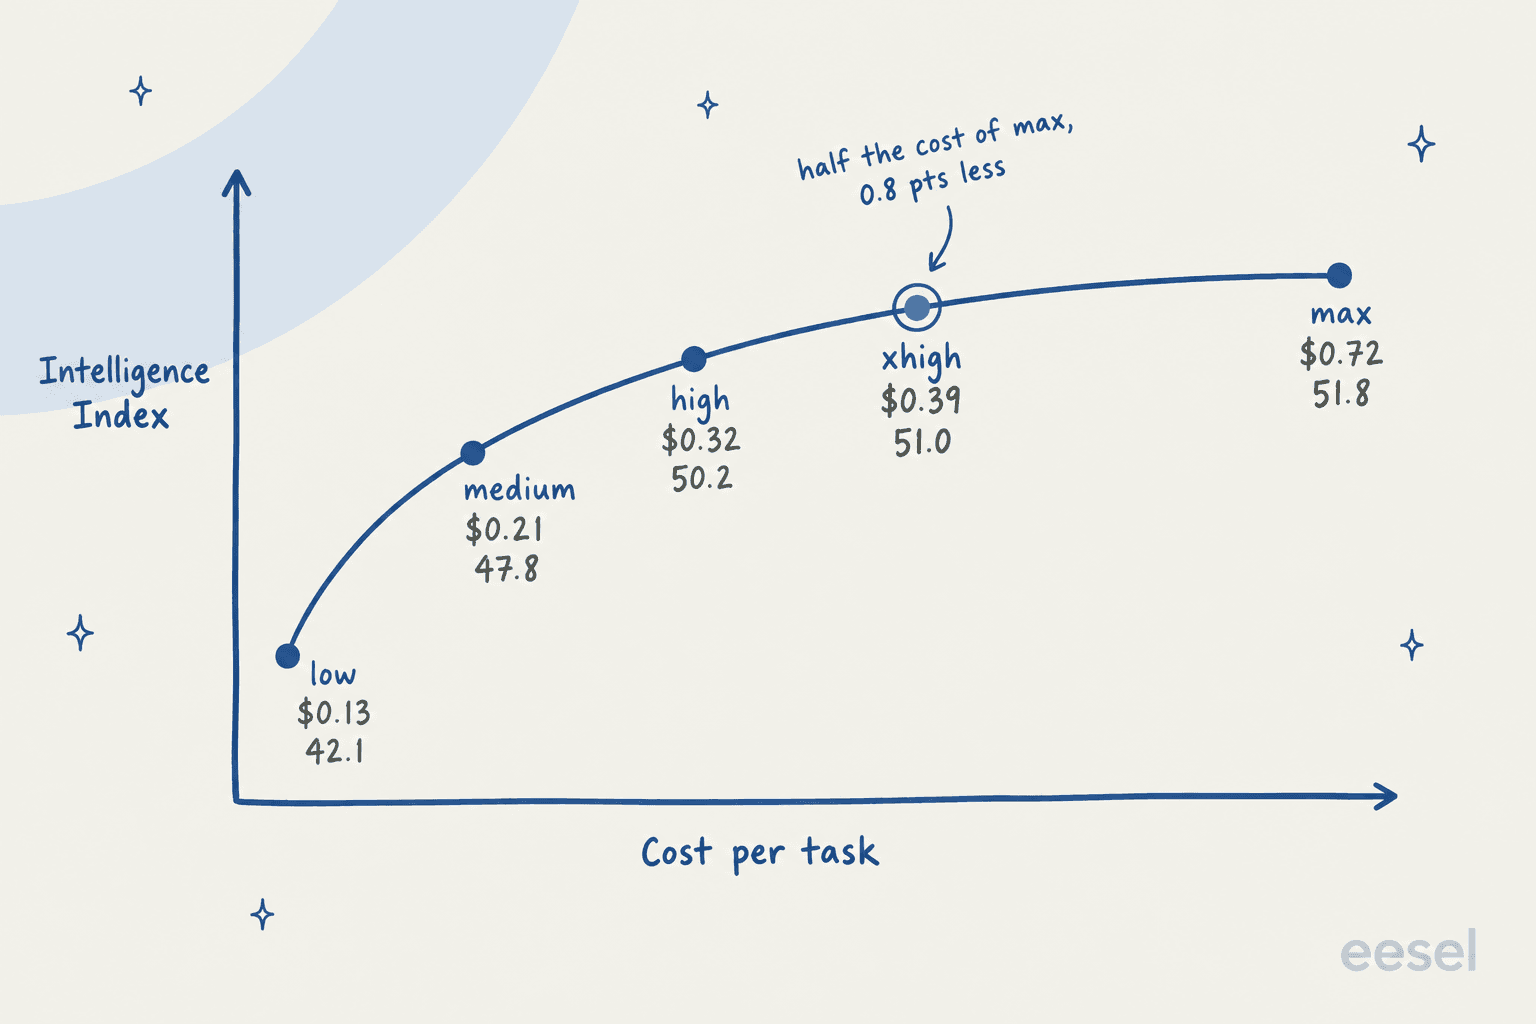
Beim Coding sieht xhigh sogar noch besser aus. Artificial Analysis berichtete, dass xhigh max in seinem Coding Agent Index um 3 Punkte schlug und damit 1 Punkt über GPT-6 Astra landete, "for less than 15% of the Cost per Task." Mein Ausgangswert ist medium für die tägliche Arbeit und xhigh für Coding-Agenten. Zu max würde ich nur greifen, wenn ein Test zeigt, dass sich der Mehrpreis lohnt.
Der Blick pro Aufgabe sortiert auch neu, wie die günstig aussehenden Modelle abschneiden. Ein Entwickler im Launch-Thread machte diesen Punkt anhand von Zahlen von Artificial Analysis:
"Chinese models are cheap and fast by token, but they generate oceans of thinking tokens in order to accomplish the same result GPT-6.1-Sol accomplishes in, comparatively, two drops of thinking tokens, making the Chinese models come out costlier and slower per actual task performed end-to-end."
Ich habe die Zahlen in diesem Kommentar mit Artificial Analysis abgeglichen, und sie stimmen: 6.1 Sol bei medium liegt bei $0,21 pro Aufgabe mit 8,1K Ausgabe-Tokens, während der Kommentator DeepSeek V4.1 Flash bei max mit $0,27 und 89K erzeugten Tokens angibt.
Die Posten, die nicht in der Preistabelle stehen
Einige Kosten liegen außerhalb der Token-Tabelle, und jeder davon taucht auf echten Rechnungen auf:
- Reasoning-Tokens sind Ausgabe. Jedes Reasoning-Token wird zum Ausgabepreis von $10 abgerechnet. Bei
maxmaß Artificial Analysis 38,1K Ausgabe-Tokens pro Aufgabe, und das meiste davon ist Denken statt Antwort. - Eingebaute Tools haben eigene Preise. Laut Preisseite kostet die Websuche $10 pro 1.000 Aufrufe plus Such-Inhalts-Tokens zu Modellpreisen, Aufrufe des Dateisuch-Tools $2,50 pro 1.000, und gehostete Shell- oder Code-Interpreter-Container laufen ab $0,03 pro 20-Minuten-Sitzung (1 GB) bis $1,92 (64 GB).
- Tool Calling erfordert die Responses API. Die Modellseite sagt, Chat Completions funktioniert "without tool calling." Das ist kein Posten auf der Rechnung, aber ältere Agenten-Code zu portieren kostet trotzdem Entwicklungszeit.
- Cloud-Marktplätze rechnen separat ab. Wenn Sie OpenAI-Modelle über Amazon Bedrock oder Microsoft Azure betreiben, legen diese Dienste den Preis fest und rechnen ihn ab, laut OpenAIs Preisseite.
GPT-6.1 Sol Rechnung schätzen
Geben Sie hier Ihr eigenes Traffic-Profil ein, von Anfragen pro Monat und Tokens pro Anfrage bis zu Ihrem Cache-Trefferanteil und der Stufe. Überschreitet eine Anfrage 272K, wechselt der Rechner von selbst zum Langkontext-Preis. Er zeigt auch, was derselbe Traffic mit GPT-6 Astra und GPT-6 Luna kosten würde.
Die Standardwerte bilden einen Coding-Agenten mit großem gecachtem Präfix ab. Ziehen Sie den Cache-Regler auf null, und die Eingabezeile springt hoch. Setzen Sie als Nächstes die Ausgabe-Tokens auf 20.000, dann sehen Sie, was eine max-Aufwand-Gewohnheit kostet. Meistens fließt das Geld in die Ausgabe. Für Bild, Audio und ältere Modelle hat der Leitfaden zu den OpenAI API Preisen den Rest des Katalogs.
Durchgerechnete Beispiele in drei Größen
Listenpreise ergeben mehr Sinn, sobald ein reales Traffic-Profil daran hängt. Das sind drei, auf die ich oft stoße, alle aus der Preistabelle berechnet. Die Token-Zahlen sind meine Annahmen zur Veranschaulichung, keine Messungen, tragen Sie also Ihre eigenen Zahlen in den Rechner oben ein.
| Workload | Traffic-Profil | GPT-6.1 Sol | Vergleich |
|---|---|---|---|
| Coding-Agent-Schleife | 30.000 Aufrufe/Monat, 60K Eingabe (50K gecacht), 3K Ausgabe, Standard | $1.650/Monat | Astra: $9.000. GPT-6 Sol: $1.800 |
| Nächtliche Dokumentenextraktion | 20.000 Dokumente/Monat, 40K Eingabe (nichts gecacht), 2K Ausgabe, Batch | $1.000/Monat | Derselbe Job im Standard: $2.000 |
| Support-Ticket-Triage | 100.000 Tickets/Monat, 2,5K Eingabe (2K gecacht), 600 Ausgabe, Standard | $720/Monat | Luna: $37. Astra: $3.700 |
Ein paar Dinge fallen an dieser Tabelle auf:
- Der Coding-Agent ist größtenteils eine Ausgabe-Rechnung. Von den $1.650 sind $900 Ausgabe und nur $150 die 1,5 Milliarden gecachten Eingabe-Tokens. Gegenüber GPT-6 Sol sparte die Cache-Senkung $150 im Monat. Der Rest hängt an der Aufwandseinstellung.
- Batch ist die günstigste Zeile, die Sie je ändern werden. Ein Parameter umgestellt, und der Extraktionsjob kostet die Hälfte, ohne Qualitätsänderung.
- Triage ist ein Luna-Job. Für kurze, unkritische Labels in großer Menge erledigt GPT-6 Luna dasselbe Profil für etwa 5 % des Preises. Ich würde Sol für die Antworten behalten, die stimmen müssen. Der Beitrag zu den GPT-6 Luna Preisen hat die vollständige Preiskarte.
GPT-6.1 Sol Preise in ChatGPT und Codex
GPT-6.1 Sol über ein Abo statt über die API zu nutzen, funktioniert anders: Sie zahlen einen festen Monatspreis und verbrauchen ein Kontingent. OpenAI sagt, es sei verfügbar "to all Plus, Pro, Business, Enterprise, and Edu users in ChatGPT Work and Codex," und "not yet available in Chat."
| Tarif | Monatspreis | GPT-6.1 Sol | Hinweise |
|---|---|---|---|
| Free | $0 | Nein | GPT-5.6 Luna für den Alltagschat |
| Go | $8 | Nein | Kann Werbung enthalten |
| Plus | $20 | Ja | Erweiterte Codex-Nutzung |
| Pro 100 | $100 | Erweitert | Kein Ultrafast |
| Pro 200 | $200 | Erweitert | Mehr Nutzung als Pro 100 |
| Pro 500 | $500 | Erweitert | Höchstes Kontingent, inkl. Ultrafast |
| Business / Enterprise / Edu | Pro Sitz | Ja | In ChatGPT Work und Codex |
Quellen: ChatGPT pricing, About ChatGPT Pro tiers und der Launch-Beitrag. Der Leitfaden zu den ChatGPT Preisen behandelt jeden Tarif, ChatGPT Work Preise geht tiefer auf Work ein, und ChatGPT Enterprise deckt Sitzplatz-Deals ab.
Abos haben einen Haken, den die API nicht hat. OpenAIs Pro-Hilfeseite sagt, neue Pro-200-Abos "include a lower usage allowance than previously offered," wobei Bestandskunden das alte Kontingent nur bis zum 29. Oktober 2026 behalten. Der DevDay-Rückblick nennt Pro 500 "25 times the ChatGPT Plus allowance." Sobald Sie das Limit erreichen, kann laut derselben Hilfeseite berechtigte Codex- und ChatGPT-Work-Nutzung auf gekaufte Credits zurückgreifen.
Einige frühe Nutzer haben ausgerechnet, was das für Codex bedeutet:
"They have also cut allowances for subscriptions in half. So even in the best case scenario it's about 2.5 times cheaper for Codex users."
Das ist die Schätzung eines Nutzers, keine Zahl von OpenAI. Trotzdem ist es eine berechtigte Warnung. Ein Modell, das in der API 5-mal günstiger als Astra ist, wird innerhalb eines Tarifs nicht zu 5-mal mehr Arbeit. Wenn Sie in Codex leben, würde ich eine Woche lang Ihren eigenen Nutzungszähler beobachten, bevor ich mit den Einsparungen rechne.
Wie sich die GPT-6.1 Sol Preise vergleichen
Beim Listenpreis entspricht GPT-6.1 Sol genau Claude Sonnet 5.5 und liegt deutlich unter allem darüber:
| Modell | Eingabe / Ausgabe (pro 1 Mio.) | Cache-Treffer | Kosten pro Aufgabe (AA) | Intelligence Index (AA) |
|---|---|---|---|---|
| GPT-6 Luna | $0,10 / $0,50 | $0,01 | k. A. | k. A. |
| GPT-6.1 Sol (medium) | $2 / $10 | $0,10 | $0,21 | 47,8 |
| GPT-6.1 Sol (max) | $2 / $10 | $0,10 | $0,72 | 51,8 |
| Claude Sonnet 5.5 (high) | $2 / $10 | $0,20 | $1,08 | 47 |
| Claude Opus 5.5 (medium) | $4 / $20 | $0,20 | $1,34 | 51 |
| GPT-6 Astra (max) | $10 / $50 | $1,00 | $3,26 | 52,7 |
| Claude Opus 5.5 (max) | $4 / $20 | $0,20 | $5,98 | 58 |
Quellen: OpenAI pricing, Anthropic pricing und Artificial Analysis für Kosten pro Aufgabe und Punktzahlen.
Mein Fazit hat zwei Teile. Bei gleicher Punktzahl ist GPT-6.1 Sol pro Aufgabe deutlich günstiger: 47,8 für $0,21 gegenüber 47 für $1,08 bei Sonnet 5.5, und 51,8 bei max für etwa die Hälfte dessen, was Opus 5.5 bei medium für 51 verlangt. Artificial Analysis formulierte es klar: "for a given level of intelligence, there is no cheaper model."
Nicht erreicht es dagegen die Spitze. Opus 5.5 und Sonnet 5.5 bei max erzielen mehr, und in einem praktischen Vergleich im Launch-Thread fand ein Entwickler, dass Opus 5.5 beim finalen Feinschliff "executes a bit better". Damit geht es bei der Wahl um die benötigte Punktzahl, nicht um den Listenpreis. Wenn 48 bis 52 in diesem Index Ihre Aufgabe abdeckt, ist GPT-6.1 Sol der günstigste Weg dorthin. Brauchen Sie die Spitze der Rangliste? Dann zahlen Sie dafür woanders. Der Vergleich OpenAI vs. Anthropic API geht tiefer auf diesen Zielkonflikt ein.
Was die GPT-6.1 Sol Preise für ein Support-Team bedeuten
Dieser Teil läuft der Intuition zuwider. In einer Support-Warteschlange ist ein günstigeres Modell der kleinste Posten im Projekt, während die Token-Rechnung der am schwersten vorherzusagende ist.
Bedenken Sie, was die obigen Zahlen antreibt: Prompt-Länge, Cache-Trefferanteil, Reasoning-Aufwand, Wiederholungen, Tool-Aufrufe und ob ein Prompt 272K überschritten hat. Keiner davon lässt sich auf „bearbeitete Tickets" abbilden. Eine Support-Leitung kann der Finanzabteilung kein Budget vorlegen, das sagt: „irgendwo zwischen $400 und $2.000, je nachdem, wie gesprächig das Modell ist." Das kommt in echten eesel-Evaluierungen vor. Ein Käufer auf Freshdesk erreichte an einem einzigen Testtag 200 Interaktionen und rechnete sofort die Kosten auf 9.000 im Monat hoch. Beunruhigt hat ihn nicht der Preis. Es war, die Gesamtsumme nicht zu kennen.
Dazu kommt der Reiz, es selbst zu bauen, der jedes Mal stärker wird, wenn ein Modell günstiger wird. Ein abgewanderter Mittelstandskunde, der nach einer kaputten Integration zu einem günstigeren Tool wechselte, formulierte es in einer Antwort an den eesel-Gründer so:
"We switched to a system [...] that is working well at half the cost. But long term we will just build our own, which is so possible now with AI."
Das ist ein vernünftiger Plan, und GPT-6.1 Sol zu $2/$10 macht den Modellteil tatsächlich günstig. Das Modell war aber nie der teure Teil. Die Arbeit steckt in der Schicht drumherum: Training auf Ihren früheren Tickets, Anbindung des Helpdesks, den Sie bereits betreiben, sichere Aktionen und das Testen von Antworten gegen die echte Historie vor dem Go-live. Wenn Halluzinationen die Sorge sind, liegt die Lösung ebenfalls in dieser Schicht, nicht in der Preistabelle. Deshalb sind die besten KI-Agenten für den Support modellflexibel: Wenn ein günstigeres Modell erscheint, erben Sie es, statt neu zu bauen. Die Aufschlüsselung der KI-Agent-Kosten zeigt, wohin dieses Geld tatsächlich fließt.
eesel ausprobieren
Wenn Sie von GPT-6.1 Sol eigentlich weniger Tickets in der Warteschlange wollen, müssen Sie Tokens gar nicht bepreisen. eesel ist eine Plattform für KI-Teammitglieder, und das KI-Helpdesk-Teammitglied ist das passende für diese Aufgabe. GPT-6.1 Sol ist Infrastruktur; eesel ist der Mitarbeiter. Es lernt aus Ihren früheren Tickets und Ihrem Help Center, bindet Zendesk, Freshdesk, Gorgias und die anderen Helpdesks an, die Sie bereits nutzen, und führt eine Simulation mit Ihren echten früheren Tickets durch, damit Sie seine Antworten mit dem vergleichen können, was Ihr Team tatsächlich gesendet hat.
Die Abrechnung funktioniert umgekehrt zu einem Token-Zähler. Die eesel-Preise sind ein fester monatlicher Credit-Tarif ab $299 für 500 Credits, bei dem ein bearbeitetes Ticket oder ein Chat einem Credit entspricht. Alle Funktionen und unbegrenzte Nutzer-Sitze sind enthalten, und ein kostenloser Tarif gibt Ihnen 100 Credits ohne Karte. Welches Modell auch darunter läuft, Ihre Rechnung für Support-Automatisierung bleibt jeden Monat dieselbe Zahl.
Da dies ein Preisbeitrag für Entwickler ist, noch ein Hinweis. Die eesel CLI bedient dasselbe Teammitglied und denselben Workspace wie das Dashboard, aus einem Terminal. Mit eesel integrations connect verbinden Sie einen Helpdesk, mit eesel activity lesen Sie jeden Lauf zurück, und mit eesel approvals sichern Sie riskante Aktionen ab. Jeder Befehl gibt JSON aus, und --dry-run zeigt den genauen Aufruf, den ein Schreibvorgang auslösen würde, bevor er gesendet wird. Jeder Workspace ist außerdem ein MCP-Server, sodass eine Codex-Sitzung mit GPT-6.1 Sol Ihr Support-Teammitglied als Tool steuern kann, nach demselben Muster wie jedes MCP für den Support. Sie erhalten die Skript-Kontrolle, die Sie von einem selbstgebauten Agenten erwarten würden, mit der Abrechnung pro Ticket, die Sie tatsächlich in ein Budget schreiben können.
Häufig gestellte Fragen
Was kostet GPT-6.1 Sol in der API?
Ist GPT-6.1 Sol teurer als GPT-6 Sol?
Was kostet GPT-6.1 Sol im Langkontext?
Ist GPT-6.1 Sol in ChatGPT kostenlos?
Was kostet GPT-6.1 Sol in Codex?
Was kostet GPT-6.1 Sol pro Aufgabe?
Ist GPT-6.1 Sol günstiger als Claude Sonnet 5.5?
Was bedeuten die GPT-6.1 Sol Preise für ein Support-Team?

Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.