GPT-6-Astra-API-Preise: die Standardstufe
Hier ist die Zahl, wegen der die meisten Leute hier sind. Auf der API-Preisseite liegt der Standardpreis von GPT-6 Astra bei $10,00 pro Million Input-Tokens und $50,00 pro Million Output-Tokens. Gecachter Input sinkt auf $1,00, und Cache-Writes kosten $12,50 pro Million.
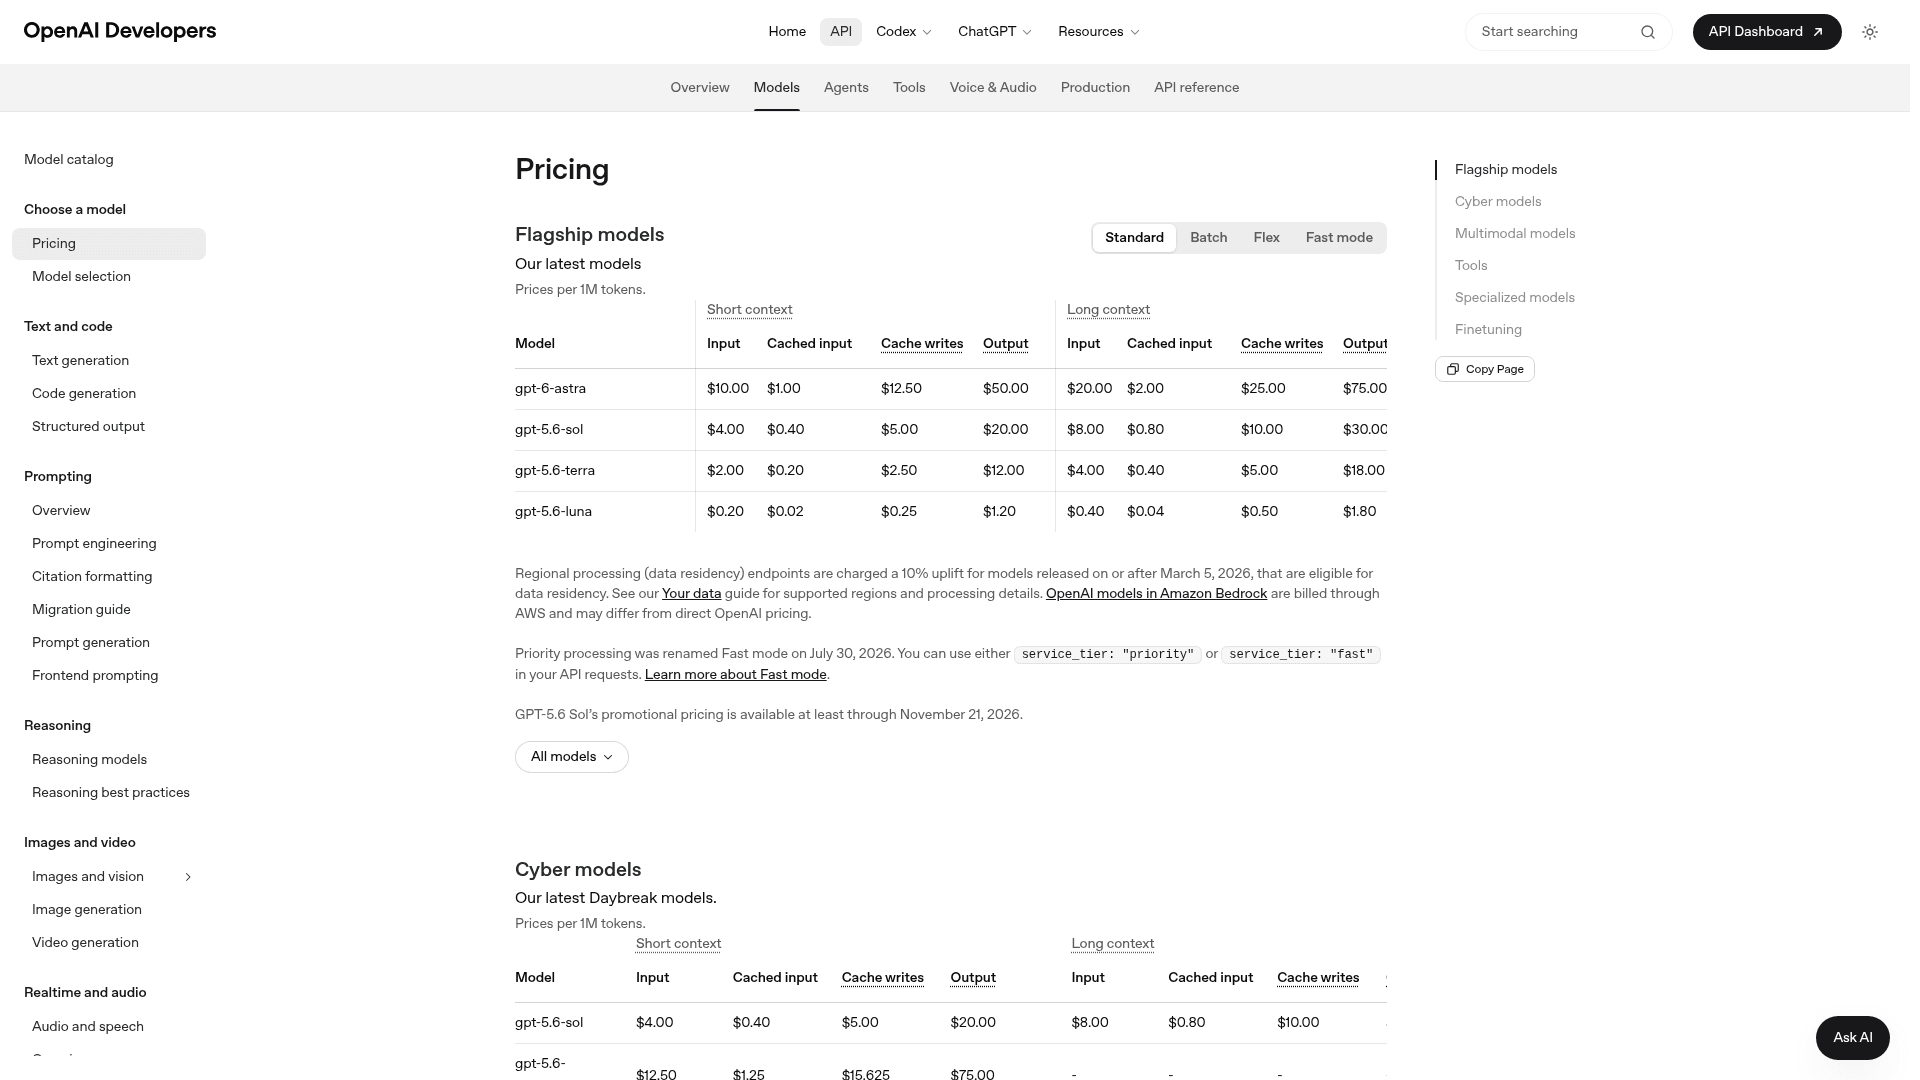
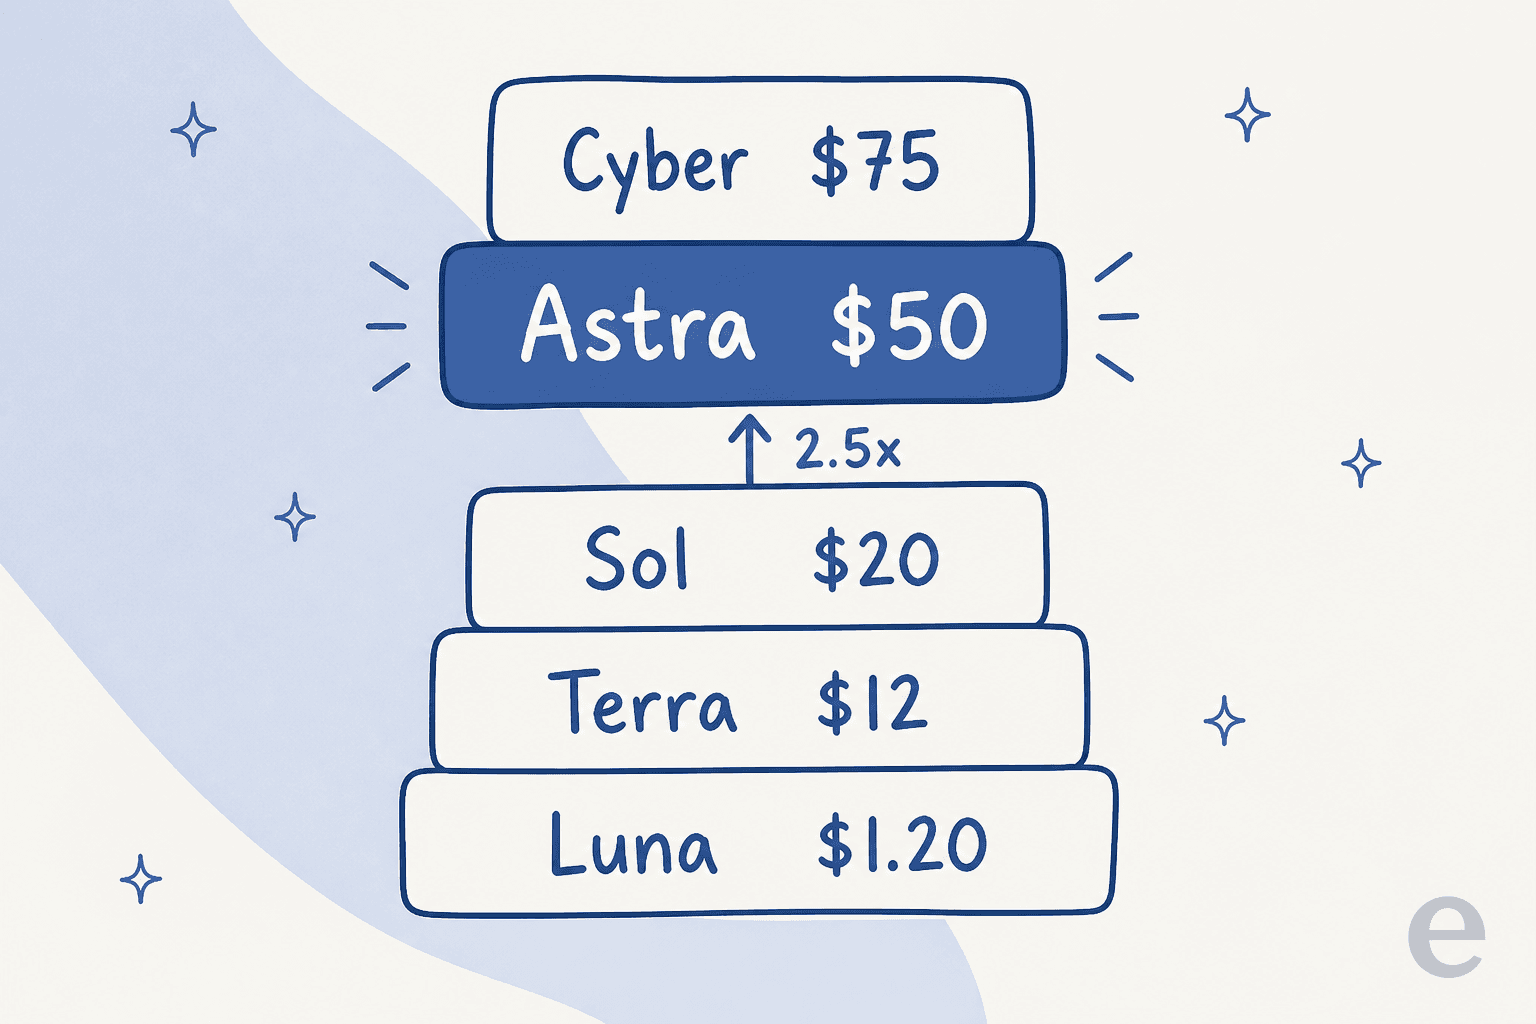
Im Kontext ist das ein echter Sprung gegenüber dem Rest der OpenAI-Modellreihe. Astra ist nun das zweitteuerste Modell, das OpenAI anbietet, nur übertroffen vom Spezialmodell gpt-5.6-cyber. So positionieren sich die Flaggschiff-Modelle in der Standard-Kurzkontext-Stufe:
| Modell | Input (pro 1M) | Gecachter Input | Output (pro 1M) | Position |
|---|---|---|---|---|
| gpt-6-astra | $10.00 | $1.00 | $50.00 | Neues Flaggschiff |
| gpt-5.6-sol | $4.00 | $0.40 | $20.00 | Vorheriges Flaggschiff (Aktion) |
| gpt-5.6-terra | $2.00 | $0.20 | $12.00 | Mittelklasse |
| gpt-5.6-luna | $0.20 | $0.02 | $1.20 | Günstigstes |
| gpt-5.6-cyber | $12.50 | $1.25 | $75.00 | Spezialmodell (Daybreak) |
Quelle: OpenAI-API-Preise. Ein Detail mit Datum, das man festhalten sollte: GPT-5.6 Sols $4/$20 ist Aktionspreis, garantiert mindestens bis zum 21. November 2026 — die "2,5-fache" Lücke wird also gegen einen Rabatt gemessen, der nicht von Dauer sein muss.
Diese Preisparität mit Anthropics Fable 5.1 blieb Praktikern nicht verborgen. Wie ein Hacker-News-Kommentator es formulierte, habe OpenAI "endlich einen Weg gefunden, aufzuhören, billig zu verkaufen, und stattdessen von zahlungskräftigen Kunden zu profitieren, wie Anthropic es tut." Die leisere Konsequenz, die einige bemerkten: Jetzt, da beide Frontier-Labs bei $10/$50 liegen, ist die Möglichkeit, allein nach Preis zwischen ihnen zu wählen, verschwunden.
Service-Stufen: die 4-fache Schwankung, die die meisten übersehen
Der Standardsatz ist ein Ausgangspunkt, nicht die ganze Geschichte. GPT-6 Astra läuft auf vier Service-Stufen, und die Lücke zwischen der günstigsten und der teuersten beträgt das 4-Fache für exakt dasselbe Modell. Das ist der größte Hebel, den Sie bei den Kosten haben — und ein größerer Faktor als jede Prompt-Optimierung.
| Stufe | Input (pro 1M) | Gecachter Input | Output (pro 1M) | Kompromiss |
|---|---|---|---|---|
| Batch | $5.00 | $0.50 | $25.00 | 50 % günstiger, asynchron, bis zu 24 Std. |
| Flex | $5.00 | $0.50 | $25.00 | 50 % günstiger, langsamer, kann warten |
| Standard | $10.00 | $1.00 | $50.00 | Standardlatenz |
| Fast mode | $20.00 | $2.00 | $100.00 | 2-fach, niedrigste Latenz |
Quelle: OpenAI-API-Preise. Ein paar Dinge, die Sie vor der Wahl wissen sollten:
- Batch und Flex kosten gleich viel, sind aber für verschiedene Aufgaben gedacht. Batch ist für asynchrone Workloads, die Sie einreichen und später abholen; Flex ist für interaktive Anfragen, bei denen Sie langsamere Ausführung oder Warteschlangen akzeptieren. Beide halbieren Ihre Rechnung.
- Fast mode wurde umbenannt — am 30. Juli 2026 von Priority. Sie können weiterhin
service_tier: "priority"oderservice_tier: "fast"übergeben. Es verdoppelt den Satz für die niedrigste Latenz. - Fast mode hat einen regionalen Haken. Es ist für GPT-6 Astra mit EU-Data-Residency nicht verfügbar; diese Anfragen fallen auf Standard zurück.
Wenn ein Workload Latenz verkraften kann, halbiert die Umstellung auf Batch oder Flex effektiv Ihre Astra-Ausgaben, ohne die Ausgabequalität zu verändern. Das ist das Erste, was ich bei jeder Pipeline mit hohem Volumen prüfen würde.
Die Fallstricke: langer Kontext und regionaler Aufschlag
Zwei Aufschläge verstecken sich im Kleingedruckten der Modellseite, und beide können ein Budget still und leise durcheinanderbringen.
Erstens: Langer Kontext wird für die gesamte Anfrage zu einem höheren Satz abgerechnet. Astras Kontextfenster ist mit 1.050.000 Tokens riesig, aber jeder Prompt über 272K Input-Tokens kippt die gesamte Anfrage auf den Long-Context-Satz: $20 pro Million Input und $75 pro Million Output in der Standardstufe. Das ist das 2-Fache beim Input und das 1,5-Fache beim Output, und es gilt für jeden Token der Anfrage, nicht nur für die Tokens über der Schwelle.
| Standardstufe | Kurzer Kontext (≤272K) | Langer Kontext (>272K) |
|---|---|---|
| Input (pro 1M) | $10.00 | $20.00 |
| Gecachter Input | $1.00 | $2.00 |
| Output (pro 1M) | $50.00 | $75.00 |
Zweitens: Regionale Verarbeitung bringt einen Aufschlag von 10 %. Data-Residency-Endpunkte für Modelle, die am oder nach dem 5. März 2026 veröffentlicht wurden, werden 10 % teurer berechnet. Wer aus Compliance-Gründen an eine bestimmte Region gebunden ist, sollte das zusätzlich einkalkulieren.
Und eine Grenze, die man sich merken sollte: Astra ist nirgendwo in der kostenlosen Stufe verfügbar, sodass Tier 1 für Entwickler der Einstiegspunkt ist.
Schätzen Sie Ihre GPT-6-Astra-API-Rechnung
Preisschilder bleiben abstrakt, bis Sie Ihre eigenen Zahlen eingeben. Geben Sie die Millionen an Input- und Output-Tokens ein, die Sie pro Monat erwarten, wählen Sie eine Service-Stufe, und der Rechner ermittelt die monatlichen Kosten. Der Long-Context-Aufschlag wird automatisch berücksichtigt.
Das Muster, das die meisten Teams feststellen: Output-Tokens dominieren die Rechnung, da Output das 5-Fache des Input-Satzes kostet. Wenn Ihr Workload lange Antworten erzeugt, fließt dort das Geld hin — und genau dort zahlt sich die Umstellung eines batch-tauglichen Jobs auf die Batch-Stufe am schnellsten aus.
GPT-6-Astra-Preise in ChatGPT
Wenn Sie nicht die API aufrufen, erreicht Sie GPT-6 Astra stattdessen über ChatGPT-Pläne, und die Preisseite zieht eine klare Linie, wer es bekommt.
| Plan | Preis | GPT-6-Astra-Zugang |
|---|---|---|
| Free | $0 | Nein (nur Luna) |
| Go | $8/Monat | Nein |
| Plus | $20/Monat | Ja |
| Pro | Ab $100/Monat | Erweitert, plus eine Pro-Variante |
| Business / Enterprise | Pro Sitzplatz | Ja (Enterprise standardmäßig aus) |
Quelle: ChatGPT-Preise. Ein paar Dinge fallen auf:
- Astra beginnt bei Plus. Der Plus-Plan für $20/Monat ist der Einstiegspunkt für ChatGPT-Nutzer. Weder Free noch der $8-Go-Plan enthalten es, und Free-Nutzer sind auf GPT-5.6 Luna beschränkt.
- Pro bringt mehr Spielraum. Pro, ab $100/Monat, gibt 5-fache oder 20-fache Nutzung sowie einen aufwendigeren Pro-Reasoning-Modus, angetrieben von Astra.
- Enterprise hat einen Schalter. Bei Business und Enterprise ist Astra pro Sitzplatz verfügbar, aber beim Start standardmäßig deaktiviert — ein Admin muss es aktivieren. Non-Profits können bis zu 75 % Rabatt auf Business oder Enterprise erhalten.
Wie sich die GPT-6-Astra-Preise im Vergleich schlagen
Zoomt man heraus: Wo steht Astra im Vergleich zum Rest der Frontier-Modelle? Kurz gesagt: OpenAI hat aufgehört, an der Spitze über den Preis zu konkurrieren.
- Im Vergleich zur eigenen Modellreihe: Bei $10/$50 ist Astra 2,5-mal so teuer wie GPT-5.6 Sol und etwa 4-mal so teuer wie GPT-5.6 Terra. Für die meisten alltäglichen Aufgaben liefern Terra oder Luna den Großteil des Werts zu einem Bruchteil der Kosten.
- Im Vergleich zu Anthropic: Astra trifft Fable 5.1 exakt bei $10/$50, sodass die beiden Flaggschiffe jetzt identisch bepreist sind.
- Im Vergleich zu Google: Es liegt deutlich über Geminis Preisen für vergleichbare Stufen und noch weit über leichteren Optionen wie Gemini 3 Flash.
Die Preis-Sorgen der Community drehten sich weniger um das Preisschild selbst als um den Verbrauch. Ein Nutzer mit Codex-Abo warnte, Sol sei bereits "ein token-hungriges Modell", und befürchtete, Astra werde bei 2,5-fachem Satz das Kontingent schneller aufbrauchen. Die Nuance: Astra verbraucht pro agentischer Aufgabe weniger Tokens, sodass sich die beiden Effekte teilweise ausgleichen. Genau deshalb sind die Kosten eines KI-Agenten nie nur der Preis pro Token. Der Verbrauch ist die andere Hälfte der Gleichung, und man sieht ihn nur am eigenen Traffic.
Was die GPT-6-Astra-Preise für ein Support-Team bedeuten
Hier möchte ich nützlich sein, statt nur Preise aufzuzählen, denn ich baue selbst in diesem Bereich, und die ehrliche Antwort ist etwas gegenintuitiv.
Wenn Sie Kundensupport oder internen Ops-Betrieb leiten, ändert die Ankunft eines stärkeren, teureren Frontier-Modells weniger, als die Schlagzeilen suggerieren. Ein rohes Modell wie Astra ist Infrastruktur. Es ist ein spektakulärer Motor, kennt aber ohne Weiteres nicht Ihre Rückgaberichtlinie, sieht Ihre letzten 50.000 Tickets nicht, hat keinen Zugriff auf Ihr Bestellsystem und keine sichere Möglichkeit, an Ihrer echten Warteschlange getestet zu werden, bevor es Kunden antwortet. Es wird pro Token fürs Denken abgerechnet, nicht pro gelöstem Problem. Die meisten verwechseln "das Modell wurde schlauer und teurer" mit "meine Support-Rechnung hat sich verändert" — das sind zwei verschiedene Projekte.
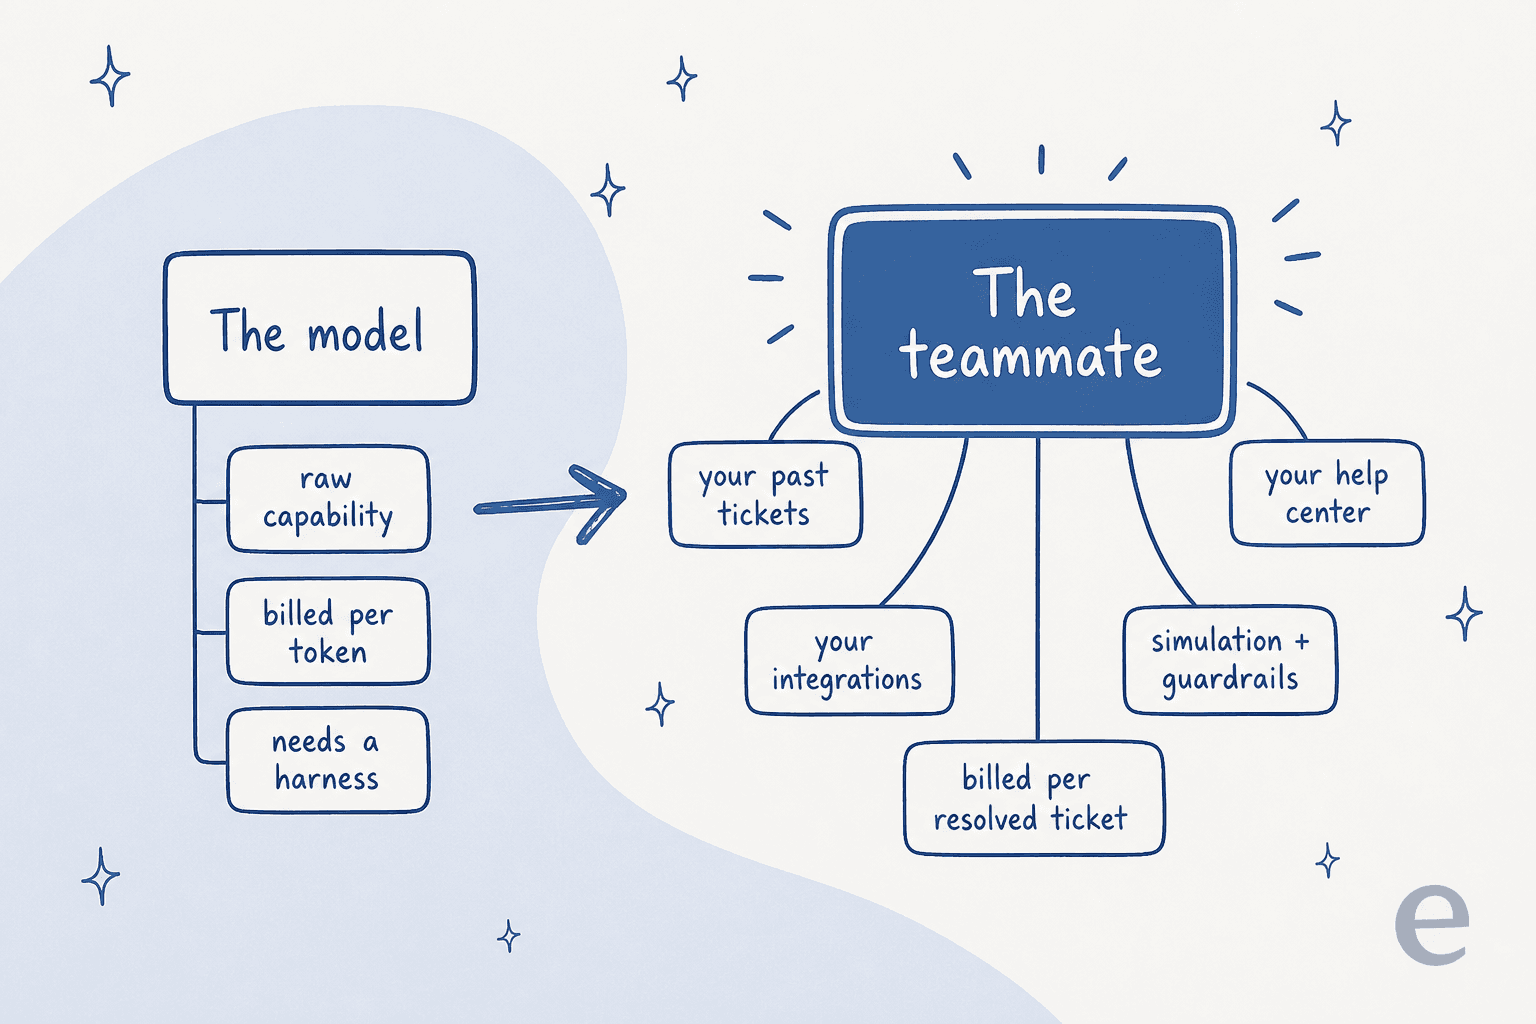
Die Einheit, die für ein Support-Team wirklich zählt, sind Kosten pro Lösung, nicht Kosten pro Token. Eine Token-Rechnung ist unberechenbar: Sie schwankt mit Prompt-Länge, Wiederholungen und wie gesprächig das Modell an einem bestimmten Tag ist. Wir haben Jahre damit verbracht, KI-Agenten auf lebende Support-Warteschlangen zu setzen, und die Lektion, die sich immer wiederholt: Teams wollen wissen, was die Bearbeitung eines Tickets kostet, Punkt — nicht, was eine Million Output-Tokens kostet, bevor sie herausgefunden haben, wie viele Tokens ein Ticket überhaupt braucht. Das ist die Lücke zwischen einem Modell und einem System, das darum herum gebaut ist: Ihr Wissen, Ihre Integrationen, sichere Aktionen und eine Möglichkeit, es an Ihrer Historie zu simulieren, bevor es live geht.
Das ist auch, warum ich Ihre Support-Automatisierung nicht in der Woche neu aufsetzen würde, in der ein neues Modell erscheint. Die besten KI-Helpdesk-Agenten und Kundenservice-Tools sind von Natur aus modellflexibel, sodass Sie beim Erscheinen eines wirklich besseren Modells das Upgrade erben, ohne etwas neu bauen oder Ihr Budget um einen neuen Token-Satz herum neu verhandeln zu müssen.
eesel ausprobieren
Wenn Ihr Interesse an Astras Preis eigentlich lautet "was wird mich eine KI kosten, um Tickets tatsächlich zu lösen", ist das genau die Aufgabe, für die ein KI-Teammitglied gebaut ist, und dort setzt eesel an. GPT-6 Astra ist der Motor; eesel ist der Mitarbeiter, den Sie einstellen, um ihn zu steuern. Der KI-Helpdesk-Agent trainiert auf Ihren vergangenen Tickets und Ihrem Helpcenter, klinkt sich in das Helpdesk ein, das Sie bereits nutzen, statt es zu ersetzen, und lässt Sie es simulieren gegen Tausende Ihrer echten historischen Tickets, sodass Sie genau sehen, wie es abschneiden und was es kosten wird, bevor es je ein Live-Gespräch berührt.
Die Abrechnung erzählt die Geschichte, die Astras Token-Preise nicht erzählen können. Statt pro Token fürs Denken zu zahlen, zahlen Sie 40 Cent pro Ticket, das tatsächlich bearbeitet wird, ohne Sitzplatzgebühren und ohne Plattform-Minimum, sodass die Kosten den Ergebnissen folgen statt dem Modell-Geplauder. Sie können kostenlos mit $50 an Nutzung und ohne Kreditkarte starten, es auf einen Teil Ihrer Warteschlange ansetzen und die Lösungszahlen an Ihren eigenen Tickets sehen — das ist deutlich entscheidungsrelevanter als jede Preis-Tabelle pro Million Tokens.

Die GPT-6-Astra-Preise sind ein echter Sprung, und für autonome Computer-Nutzung und Sicherheitsarbeit kann sich die Prämie lohnen. Aber für die meisten Support-Teams war der Token-Satz nie die Zahl, die zählte. Ein getestetes, angebundenes, rechenschaftspflichtiges Teammitglied in Ihren bestehenden Workflow zu holen, abgerechnet nach Ergebnis, ist der Teil, in den es sich lohnt, Ihr Budget zu investieren.
Häufig gestellte Fragen
Wie viel kostet GPT-6 Astra über die API?
Warum sind die GPT-6-Astra-Preise höher als bei GPT-5.6 Sol?
Ist GPT-6 Astra in der kostenlosen Stufe verfügbar?
Was ist der Long-Context-Aufschlag bei GPT-6 Astra?
Wie viel kostet GPT-6 Astra in ChatGPT?
Was ändern Batch, Flex und Fast-Modus an den GPT-6-Astra-Preisen?
GPT-6 Astra vs. GPT-5.6 Sol Preise: Was sollte ich nutzen?


Article by
Rama Adi
Rama is a software engineer at eesel AI with two years of experience writing about B2B SaaS, AI tools, and customer support technology. Based in Bali, Indonesia, he brings a developer's perspective to product comparisons — cutting through marketing copy to what the integrations and APIs actually do.